30K
标准完整训练
真实场景通常训练 30,000 iteration;论文另报 7K 快速版本,用来展示约 5–10 分钟即可达到竞争质量。
把连续辐射场的可优化性,装进显式点基元与 GPU 光栅化管线。
这篇论文的突破不是“把点画大一点”。它把各向异性 3D Gaussian、可增删的密度控制和一次按 tile 排序的可微光栅器组成同一个训练系统,使 1080p 新视角合成第一次同时接近顶级 NeRF 画质与真正的实时帧率。
真实场景通常训练 30,000 iteration;论文另报 7K 快速版本,用来展示约 5–10 分钟即可达到竞争质量。
1080p 级原生分辨率下,30K 模型在三组真实场景分别为 134、154、137 FPS;速度不是低分辨率演示。
真实场景常见规模。显式表示换来高速,也造成数百 MB 模型与较高训练显存。
一手材料:本页逐页读取官方 14 页 PDF(含 Appendix A–D),交叉核对官方项目页、arXiv v1 与作者公开代码在 2023-08-03 的提交 ba43a8c。结果数字以论文表格为准;论文没有写出的默认学习率等单独标注为“参考实现”。
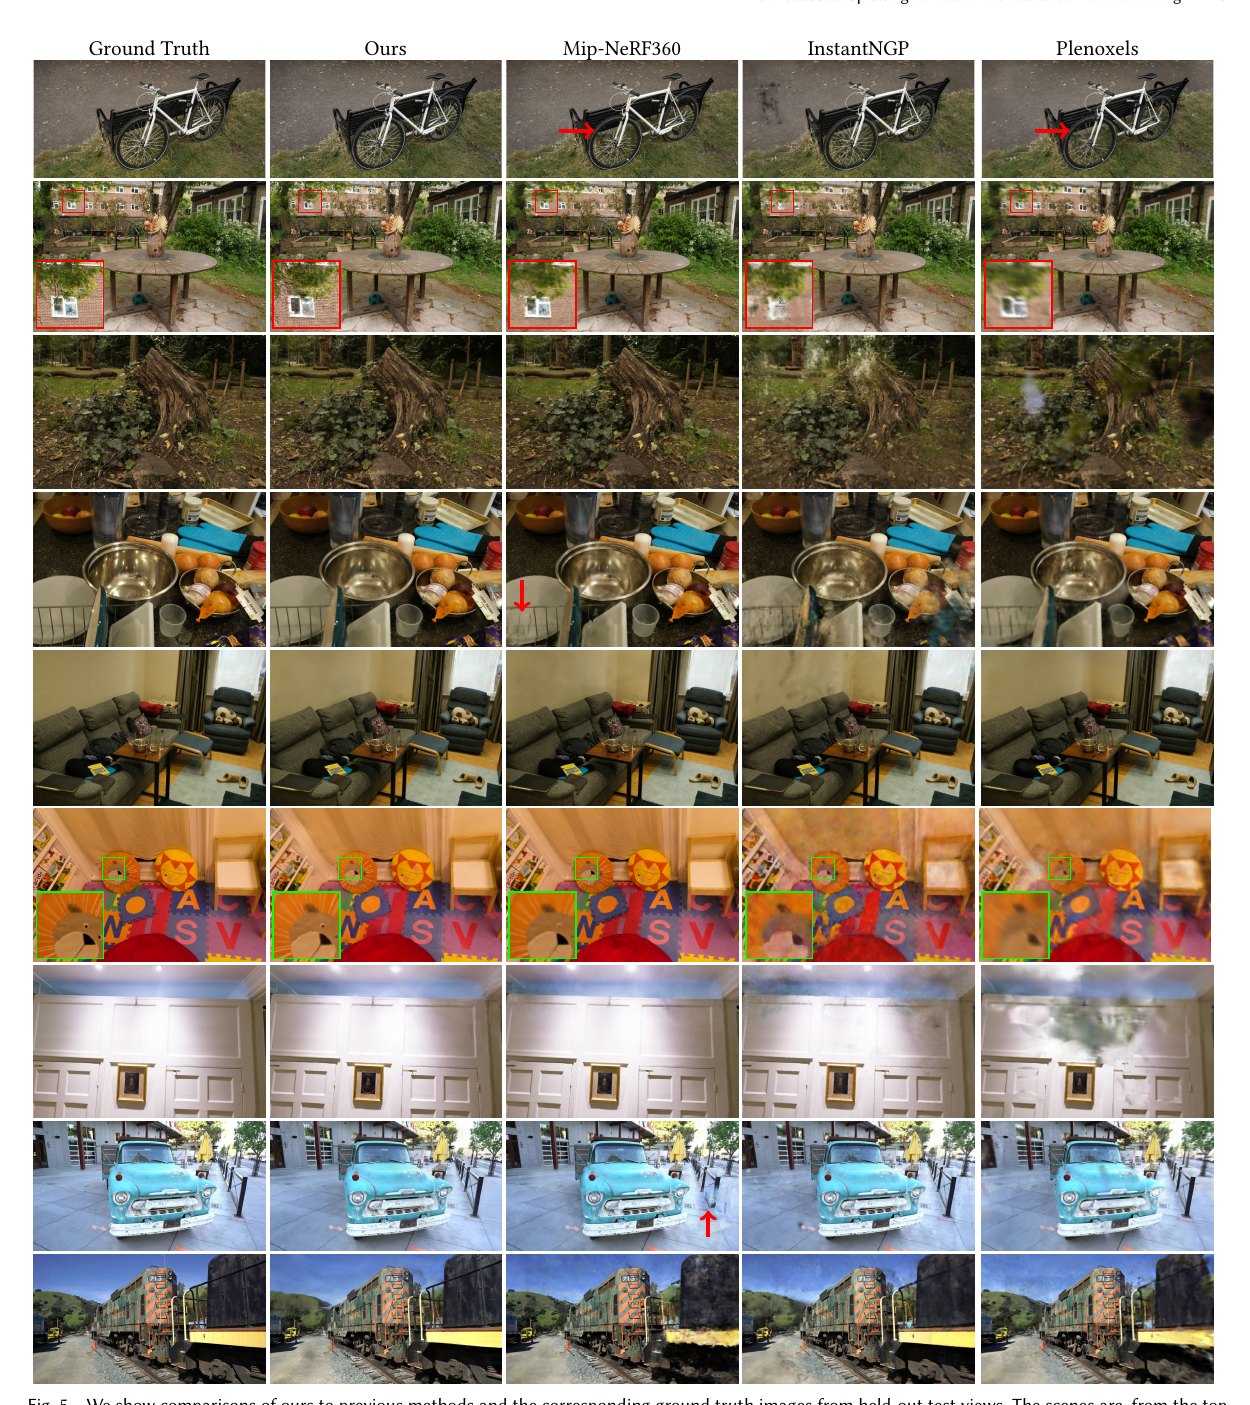
Mip-NeRF360 对无界真实场景很强,但论文对照需等效约 48 GPU-hours,渲染约 10 秒一帧。
InstantNGP、Plenoxels 将连续场存进 hash/voxel 结构,训练快,却仍需沿射线查询很多 sample,且画质受结构化网格限制。
显式点适合 GPU,但固定点大小会孔洞与 aliasing;神经点渲染多依赖 MVS、CNN 或近似可见性,完整场景质量仍不足。
核心假设:辐射场真正需要的是可微的体积合成与方向外观,并不必然需要连续 MLP。若每个显式基元本身是平滑、可投影、可优化的 3D Gaussian,就能保留体积表示的梯度性质,同时跳过空空间采样,用光栅化直接处理“确实存在的基元”。
对第 \(i\) 个 Gaussian,模型保存中心 \(\mathbf{\mu}_i\in\mathbb{R}^3\)、尺度 \(\mathbf{s}_i\in\mathbb{R}^3\)、旋转四元数 \(\mathbf{q}_i\in\mathbb{R}^4\)、不透明度 \(\alpha_i\),以及最高 3 阶 spherical harmonics(4 个 band、每颜色 16 个系数)。颜色随观察方向变化,而位置、形状与 opacity 是场景坐标中的显式参数。
优化目标:随机抽一张训练相机,将当前 Gaussians 投影、合成图像 \(I\),与真实图 \(\widehat I\) 计算重建损失并反传。没有 dataset-level 预训练网络;每个场景单独优化一套参数。
稀疏 SfM 点没有可靠法线。用带法线的 surfel 会把极噪的几何先验带进优化;直接优化 \(3\times3\) covariance 又可能失去 positive semi-definite 性质。作者改为尺度与旋转的可微参数化:
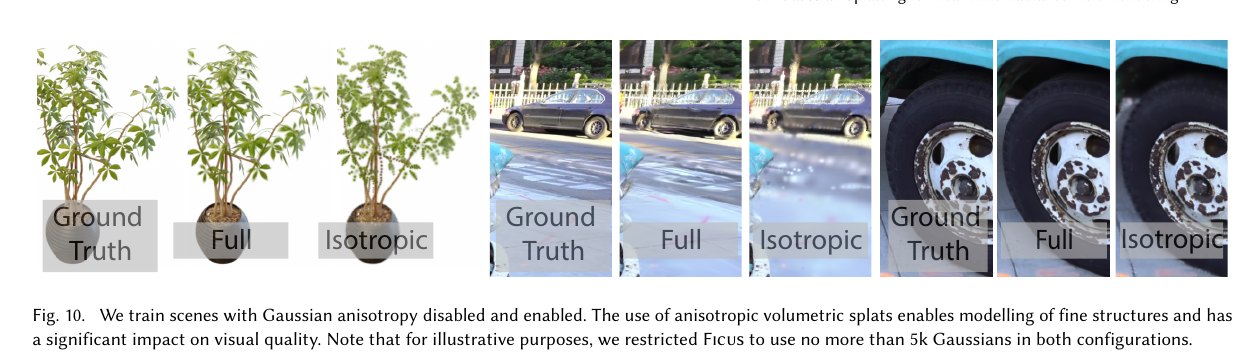
它可以沿表面切向拉长、沿法向压扁:大而平滑的面由少量大椭球覆盖,细线与边缘由小椭球表达。各向同性球只有一个半径,在固定点数下难以贴合细长结构。
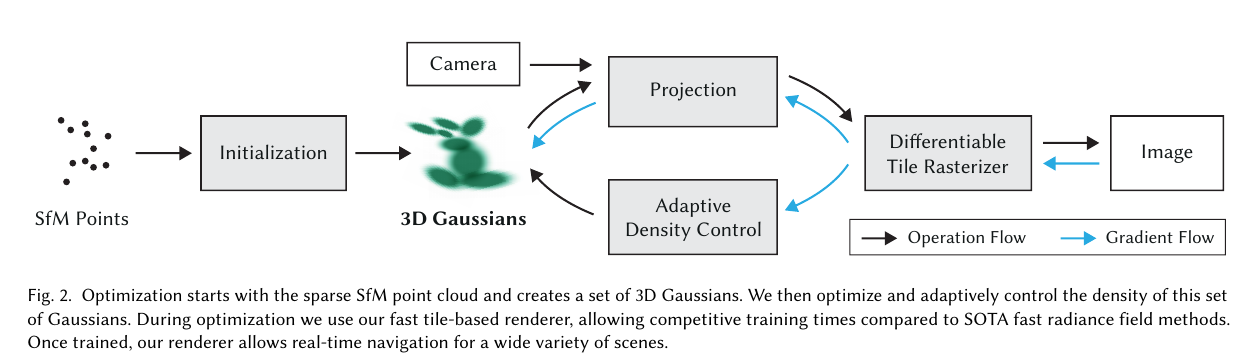
初始 covariance 是各向同性,轴长来自最近三个 SfM 点距离的均值。500 次 warm-up 后,每 100 iteration 累积每个 Gaussian 的屏幕空间位置梯度;平均范数高于 \(\tau_{\mathrm{pos}}=0.0002\) 就进入 densification。
若 Gaussian 较小(参考实现判据:最大尺度不超过场景尺度的 1%),复制它。论文直觉是副本沿位置梯度继续移动,扩大总覆盖体积,补齐尚未表达的小结构。
若 Gaussian 太大,将原基元替换成两个较小基元;新中心从原 Gaussian 分布采样,尺度除以 \(1.6\)。总覆盖近似保留,但局部自由度增加。
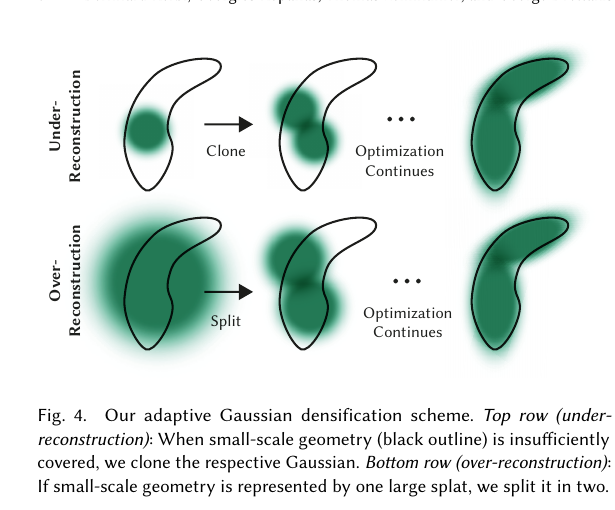
Prune:低 opacity Gaussian 被删;3000 iteration 将 opacity 上限重置到 0.01,使无用基元有机会被淘汰。参考实现还在 3000 次后删除屏幕半径大于 20 px 或世界尺度过大的点,densification 在 15K iteration 停止。
对于一个像素,按深度从前到后排列的 splats 使用与 NeRF 相同的 alpha compositing:
为数值稳定,reference rasterizer 忽略 \(\alpha\lt 1/255\) 的更新,并把单项 alpha clamp 到 0.99。论文的关键质量选择是不限制可接收梯度的前景 splat 数;饱和才停止,而不是固定 top-\(N\)。
| 项目 | 配置 | 证据与作用 |
|---|---|---|
| 输入 / split | COLMAP 相机与 sparse points;每第 8 张图作 test | 沿 Mip-NeRF360 协议;其余为训练视图 |
| 图像 warm-up | 先以 1/4 分辨率;250、500 iteration 各上采样一次 | 论文 §7.1;降低早期不稳定 |
| 优化器 | Adam,30K iteration;\(\epsilon=10^{-15}\)(实现) | 多参数组,同一图像损失 |
| 位置 LR | \(1.6\times10^{-4}\rightarrow1.6\times10^{-6}\),delay multiplier 0.01(实现) | 仅位置使用 exponential schedule;再乘场景尺度 |
| 其他 LR | DC feature .0025;其余 SH .000125;opacity .05;scale .005;rotation .001(实现) | 对应显式属性参数组 |
| SH | degree 0 起步;每 1000 iteration 加一阶,最高 degree 3 | 4 band;缓解角度覆盖不足时 base color 被错误补偿 |
| Densify | 500–15K,每 100 次;grad threshold .0002(实现与论文一致) | clone / split / prune 交替发生 |
| Opacity | 初始 0.1(实现);每 3000 次 reset 到不高于 .01;prune threshold .005(实现) | 控制 floater 与点数膨胀 |
| 硬件 | NVIDIA A6000;Mip-NeRF360 对照为 4×A100 训练 12h,折算 48 GPU-hours | 训练时间并非全在同一硬件;作者指出 A100 更快 |
| 软件 | Python/PyTorch + custom CUDA/CUB + SIBR viewer | 原始环境 Python 3.7.13、PyTorch 1.12.1、CUDA 11.6 |
| 方法 | Mip-NeRF360 | Tanks & Temples | Deep Blending | |||||||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SSIM | PSNR | LPIPS | 训练 | FPS | Mem | SSIM | PSNR | LPIPS | 训练 | FPS | Mem | SSIM | PSNR | LPIPS | 训练 | FPS | Mem | |
| Plenoxels | .626 | 23.08 | .463 | 25m49s | 6.79 | 2.1GB | .719 | 21.08 | .379 | 25m5s | 13.0 | 2.3GB | .795 | 23.06 | .510 | 27m49s | 11.2 | 2.7GB |
| INGP-Base | .671 | 25.30 | .371 | 5m37s | 11.7 | 13MB | .723 | 21.72 | .330 | 5m26s | 17.1 | 13MB | .797 | 23.62 | .423 | 6m31s | 3.26 | 13MB |
| INGP-Big | .699 | 25.59 | .331 | 7m30s | 9.43 | 48MB | .745 | 21.92 | .305 | 6m59s | 14.4 | 48MB | .817 | 24.96 | .390 | 8m | 2.79 | 48MB |
| Mip-NeRF360 | .792 | 27.69 | .237 | 48h | .06 | 8.6MB | .759 | 22.22 | .257 | 48h | .14 | 8.6MB | .901 | 29.40 | .245 | 48h | .09 | 8.6MB |
| Ours-7K | .770 | 25.60 | .279 | 6m25s | 160 | 523MB | .767 | 21.20 | .280 | 6m55s | 197 | 270MB | .875 | 27.78 | .317 | 4m35s | 172 | 386MB |
| Ours-30K | .815 | 27.21 | .214 | 41m33s | 134 | 734MB | .841 | 23.14 | .183 | 26m54s | 154 | 411MB | .903 | 29.41 | .243 | 36m2s | 137 | 676MB |
量化解读:Ours-30K 相比 Mip-NeRF360,在 Mip-NeRF360 数据集 SSIM +0.023、LPIPS 改善 0.023,但 PSNR 低 0.48 dB;Tanks & Temples 三项都更好;Deep Blending 几乎持平(SSIM +0.002、PSNR +0.01、LPIPS 改善 0.002)。因此“全面超过”不准确,更严谨的说法是综合质量持平或略优,并把渲染速度提高约三数量级。
| 方法 | Mic | Chair | Ship | Materials | Lego | Drums | Ficus | Hotdog | 平均 |
|---|---|---|---|---|---|---|---|---|---|
| Plenoxels | 33.26 | 33.98 | 29.62 | 29.14 | 34.10 | 25.35 | 31.83 | 36.81 | 31.76 |
| INGP-Base | 36.22 | 35.00 | 31.10 | 29.78 | 36.39 | 26.02 | 33.51 | 37.40 | 33.18 |
| Mip-NeRF | 36.51 | 35.14 | 30.41 | 30.71 | 35.70 | 25.48 | 33.29 | 37.48 | 33.09 |
| Point-NeRF | 35.95 | 35.40 | 30.97 | 29.61 | 35.04 | 26.06 | 36.13 | 37.30 | 33.30 |
| Ours-30K | 35.36 | 35.83 | 30.80 | 30.00 | 35.78 | 26.15 | 34.87 | 37.72 | 33.32 |
合成数据先把 100K 随机点 prune 到约 6–10K,再长到 200–500K;最终平均只比 Point-NeRF 高 0.02 dB,属于数值持平。其意义更在于说明 SfM 初始化不是算法必需条件,但真实无界背景中随机初始化明显更差。
| 配置 | Truck-5K | Garden-5K | Bicycle-5K | Truck-30K | Garden-30K | Bicycle-30K | 平均-5K | 平均-30K |
|---|---|---|---|---|---|---|---|---|
| Limited-BW | 14.66 | 22.07 | 20.77 | 13.84 | 22.88 | 20.87 | 19.16 | 19.19 |
| Random Init | 16.75 | 20.90 | 19.86 | 18.02 | 22.19 | 21.05 | 19.17 | 20.42 |
| No-Split | 18.31 | 23.98 | 22.21 | 20.59 | 26.11 | 25.02 | 21.50 | 23.90 |
| No-SH | 22.36 | 25.22 | 22.88 | 24.39 | 26.59 | 25.08 | 23.48 | 25.35 |
| No-Clone | 22.29 | 25.61 | 22.15 | 24.82 | 27.47 | 25.46 | 23.35 | 25.91 |
| Isotropic | 22.40 | 25.49 | 22.81 | 23.89 | 27.00 | 24.81 | 23.56 | 25.23 |
| Full | 22.71 | 25.82 | 23.18 | 24.81 | 27.70 | 25.65 | 23.90 | 26.05 |
| 核查项 | 论文说法 | 2023 参考实现与影响 |
|---|---|---|
| Clone 是否主动移动 | 复制后沿位置梯度方向移动 | densify_and_clone 创建同位置副本;下一轮由梯度把两个参数分开。概念方向一致,但不是 densify 操作当场位移。 |
| Split 缩放 | 两个新点,scale 除以 \(\phi=1.6\) | 代码为 scale / (0.8*N),默认 \(N=2\),正好也是 1.6;中心按旋转后的原尺度 Gaussian 采样。 |
| Prune threshold | 删除 \(\alpha\lt\epsilon_{\alpha}\),未在正文给数值 | 调用时为 .005;3K 后还删屏幕半径 >20 与世界尺度 >0.1×extent 的点。 |
| 初始 opacity | 未给数值 | 0.1,经 inverse sigmoid 存 raw parameter。每 3K reset 为不高于 .01。 |
| Optimizer | “SGD techniques”与位置 exponential schedule | 实际是 Adam 多参数组;这里 SGD 是随机梯度优化的泛称,不是 torch.optim.SGD。 |
| SH 与特征维度 | 4 bands,逐 1000 iteration 开启 | sh_degree=3,共 16 basis / color;DC LR .0025,其余系数 LR 为其 1/20。 |
| 复现资源 | 源代码和数据可用 | 代码、viewer、预训练模型与评测图公开;许可证限研究/评估,并非宽松商用许可。24GB VRAM 是 README 对论文质量训练的硬件建议。 |
| 后续仓库 | 不适用 | 主分支后来加入抗锯齿、depth、exposure、Sparse Adam 等功能;不能反向归因给 2023 原论文。 |
训练视图覆盖不足时出现伪影;大而各向异性的 Gaussian 可能突然切换顺序;超大场景可能需降低位置学习率;已训练模型与 rasterizer 都吃显存;约 80% 训练时间仍在 Python 逻辑。作者建议更合理 culling、anti-aliasing、regularization、压缩与全 CUDA 优化。
用误差、可见次数、尺度、梯度历史与多视图一致性学习 clone/split/prune,替代固定阈值;目标可同时惩罚点数、显存与闪烁。
对深度相近或相交 ellipsoid 做局部排序修正、stochastic order averaging 或可微 order uncertainty,专门降低 popping。
加入 normal、depth 或 multi-view geometry regularization,让小特征仍享受 anisotropy,同时约束最小轴贴合表面。
量化 SH/scale/rotation,学习码本并在训练期加入 bitrate penalty,让“可实时渲染”和“可分发”成为同一个目标。
检测 novel trajectory 上的高不确定区域,回到最有信息量的训练视图局部 densify / prune,而不是整场景重训。
把 SH 颜色替换为可 relight 的 BRDF/材质参数,再用光照显式建模;否则当前 view-dependent color 会把反射、曝光与几何误差混在一起。
拖动三项,观察一个示意性的研究评分。它不是论文 metric,只用来展示后续工作会遇到的多目标 trade-off。
综合研究效用:—
核查日期:2026-09-26。页面未独立训练模型或重跑 benchmark;所有实验数值来自论文,代码结论来自固定历史提交的静态核查。Figure 2、4、5、10 为官方 PDF 原图裁切,未改变内容。