3DV 2017
正式会议论文
官方项目页与 DBLP 均记录 3DV 2017、67–77 页;作者主页注明 oral。现有 note 中的“arXiv preprint”应更新。
ShapeMVD 把难以直接生成的网格,改写成十二个规则二维视图上的深度、法线与前景,再用几何优化将它们重新缝成三维。
这篇工作的重要性不只在“sketch-to-3D”。它展示了一种至今仍有启发的表示策略:让神经网络负责规则网格上的预测,让显式几何求解负责一致性与可执行曲面。
官方项目页与 DBLP 均记录 3DV 2017、67–77 页;作者主页注明 oral。现有 note 中的“arXiv preprint”应更新。
arXiv v3,2017-09-29;正文 11 页。另读官方 14 页合并 PDF 中的 supplementary 部分。
公开 GitHub 仓库当前提交前缀;TensorFlow 1.0.1 网络与 Visual Studio C++ 融合代码均可读。
三维规则网格的内存与计算随边长立方增长。论文基线在 12 GB 显存上只能做到 \(128^3\),而视图输出是 \(256\times256\) 的表面图。
不同拓扑的网格没有稳定的顶点对应,难以把卷积直接套在“同一位置”。2017 年的网络尤其缺少可泛化的网格生成算子。
没有纹理、阴影和颜色;同一轮廓对应许多三维解释。纯几何规则要求精确的特定线型,学习方法则可从类别形状分布中补全不可见部分。
研究缺口由此很具体:如何保留二维卷积的高分辨率和稳定训练,同时产生不依赖固定拓扑、能转成网格的三维表面?作者的假设是:从少量输入线稿预测一组覆盖物体的深度/法线图,再通过显式几何一致性恢复曲面。
若有 \(C\) 张输入草图,论文把它们按已知顺序堆叠为 \(\mathbf{S}\in\mathbb{R}^{256\times256\times C}\)。前/侧/顶视图组合分别训练独立网络;它不是拿任意相机位姿直接推理。所有训练形状被统一朝向并缩放进同一个二十面体相机包围体,渲染采用正交投影。
十二个相机位于正二十面体的等距顶点并看向物体中心。第 \(v\) 个 branch 输出 \(\mathbf{I}_v\in\mathbb{R}^{256\times256\times5}\):一通道深度 \(d\)、三通道单位法线 \(\mathbf{n}\)、一通道前景概率 \(f\)。阈值 \(f\gt0.5\) 得到有效表面像素。
\(p=(p_x,p_y)\) 是像素,\(v\) 是输出视图;\(\mathbf{R}_v,\mathbf{e}_v\) 是已知相机外参;\(\kappa\) 把相邻像素间距换算到物体坐标。公式将一个有效深度像素反投影成三维点 \(\mathbf{q}_{p,v}\)。
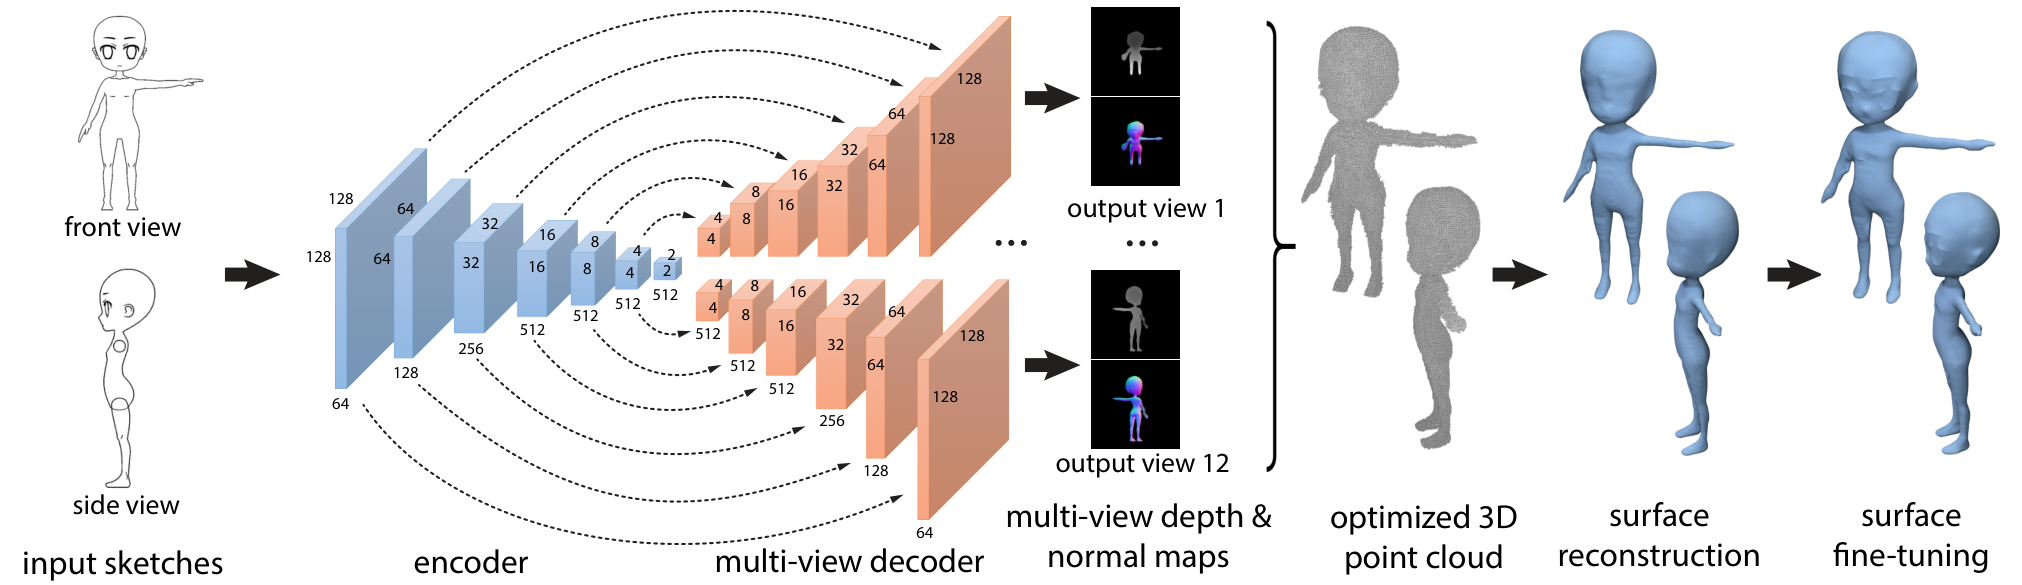
七层步长为 2、核大小为 4 的二维卷积,把 \(256^2\) 逐级缩到 \(2\times2\times512\)。通道为 64、128、256、512、512、512、512。除首层实现细节外,层使用 batch normalization 与 slope 0.2 的 leaky ReLU。展平后是 2048 维,可作为 sketch-based retrieval 描述符。
每个视点有独立上采样分支,从 \(2^2\) 恢复到 \(256^2\),并按 U-Net 将同尺度 encoder feature 拼接进 decoder。输出层用 tanh 将深度/法线压到 \([-1,1]\),法线另做 \(\ell_2\) 归一化。论文说前三个 decoder layer 使用 dropout;公开代码的主 U-Net 路径只在最深的两个层调用 dropout,这一差异见实现审计。
每个 branch 固定对应一个世界视角,独立参数可把同一 latent 变换到专用深度/法线图;代价是参数量大、视点集合固定,并且不能自然插值到任意新相机。论文的 Tatarchenko baseline 正是“连续视角编码 + 单一 decoder”,结果较弱,但这个对比同时牵涉 U-Net 连接和分支结构,不能只归因于离散视角。
论文在 validation set 上选 \(\lambda_1=\lambda_2=\lambda_3=1\),\(\lambda_4=0.01\)。四项分别约束深度、法线方向、前景分类与整张输出图的高层结构。
帽号表示 ground truth;\(\hat f\) 把损失限制在真实前景内。深度使用 \(\ell_1\),作者称 \(\ell_2\) 会产生更模糊的图。法线项最小化 \(1-\cos\theta\)。深度也归一化到 \([-1,1]\),因此两项每像素范围都约在 \([0,2]\)。
前景项为 binary cross-entropy。GAN 判别器判断每视图的深度、三通道法线和前景组合是否真实;generator 以 \(-\log P(\mathrm{real}\mid\mathbf I_v)\) 受罚。正文把判别输入写成五通道输出图,公开实现实际还拼入输入草图,形成 conditional discriminator。
每个物体、每个输入视角生成四种线型:(1) silhouette;(2) silhouette + suggestive contours;(3) 再加 ridges、valleys 与 apparent ridges;(4) 对 Phong render 做 edge-preserving filtering。这既替代昂贵的人类标注,也作为 style augmentation。测试时的人手线稿却来自纸笔扫描,只做裁剪和缩放;这说明泛化证据存在,但 domain gap 并未被系统测量。
| 训练设置 | 论文/代码值 | 证据边界 |
|---|---|---|
| Optimizer | Adam,\(\beta_1=0.9,\beta_2=0.999\) | 论文 Implementation + 代码 |
| Learning rate | \(10^{-4}\),每 10,000 step 乘 0.96 | 仅代码明确 |
| Epoch | 默认 100 | README / CLI 默认 |
| Batch | 物理 2(12 GB)或 4(24 GB);有效 batch 40 | README;梯度累积 |
| 训练耗时 | 10K meshes / 40K sketches,Titan X 约 2 天 | 论文 |
| 框架 | TensorFlow 1.0.1,Python 3.5 | 官方 README |
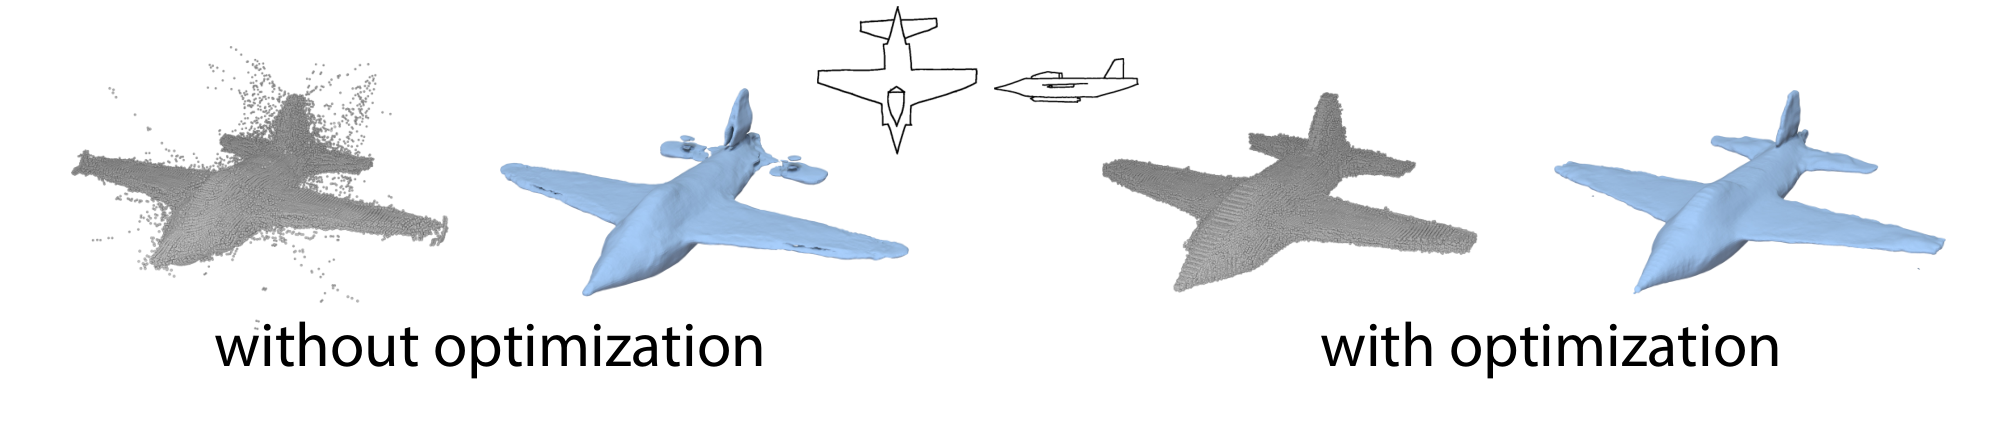
初始点集先做 all-pairs ICP 刚性对齐,但直接合并仍会在重叠区域形成错层。作者把所有有效像素深度 \(\mathbf D=\{d_{p,v}\}\) 当作未知量,构造二次能量:
\(\tilde d\) 是 ConvNet 的初值。这里改用 \(\ell_2\) 不是为了图像锐利度,而是让总能量保持 quadratic,能写成稀疏线性系统。
法线应与局部两条切线正交;偏导通过 \(3\times3\) 梯度核近似。轮廓附近导数不稳定,因此论文从该项排除 silhouette pixels。
把 \(\mathbf q_{p,v}\) 投到另一视图 \(v'\),得到 \(p'=\Pi_{v'}(\mathbf q_{p,v})\)。如果可见且落在前景,目标视图保存的深度应等于该点在其坐标系下的深度,目标局部切线也应与变换后的法线正交。两部分权重 \(w_3=w_4=0.3\)。若一个点投到多数视图的背景,它被当作 outlier 删除;实际每个前景像素常有 3–4 个对应像素。
对应关系随深度变化,所以算法交替“解稀疏 least-squares 线性系统 → 更新点位置与投影对应”,论文报告 3–5 轮实践收敛。然后以 screened Poisson reconstruction 生成网格。可选 fine-tuning 将网格投影轮廓拉向输入线条,同时以 Laplacian 坐标保留局部细节;它只能变形,不能增加或删除拓扑部件。
Titan X GPU。
双 Xeon E5-2699v3 CPU。
包含约 4 s 网格重建与 fine-tuning;分项相加约 8.5 s,论文用“about 10 seconds”。
| 类别 | 训练形状 | View A | View B | 来源 |
|---|---|---|---|---|
| Characters | 10,000 | front | side | The Models Resource |
| Airplanes | 3,667 | top | side | ShapeNet |
| Chairs | 9,573 | front | side | ShapeNet |
每类另选 40 个测试形状,共 120 个。作者没有随机切分:先对候选与集合形状做最佳 affine alignment,用每形状均匀采样 10K surface points 的 Chamfer distance 排除近重复;再用 encoder feature 最近邻距离复核,最后人工检查。论文只说“高于阈值”,未公开阈值,这是可复现缺口。
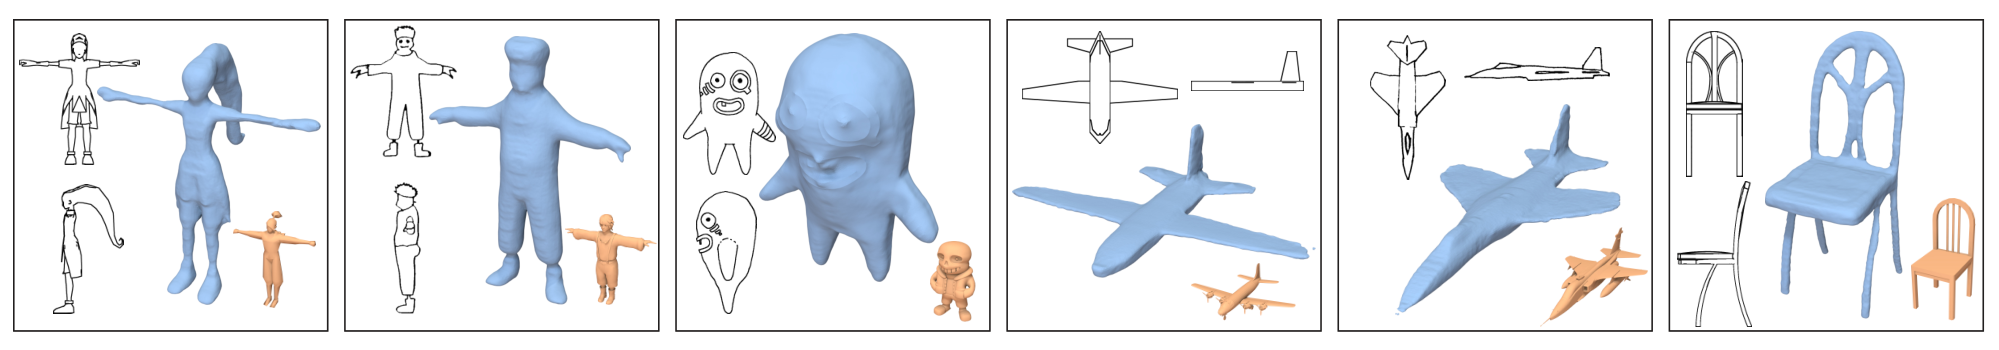
每类 30 个测试形状使用合成草图,10 个使用人手草图,所以合计 90 synthetic + 30 human。两位 artist 观看 Phong shading 的参考形状,在纸上画 A/B 两视图;扫描后裁剪、缩放到与训练图平均绘制区域相近。没有报告每位艺术家分配、重复绘制或 inter-artist variance。
重建表面点到参考表面的最近距离之最大值,对单个坏区域敏感。
表面最近距离平均,较反映整体几何,但会弱化少数严重缺陷。
最近参考点法线夹角均值;以及十二输出深度图的像素绝对误差均值。
在 \(128^3\) 栅格上计算 \(1-\mathrm{IoU}\),有分辨率依赖。
所有主表方法均不做轮廓微调,避免后处理掩盖表示差异。
man-made 把 airplane 与 chair 平均;character 单独报告。
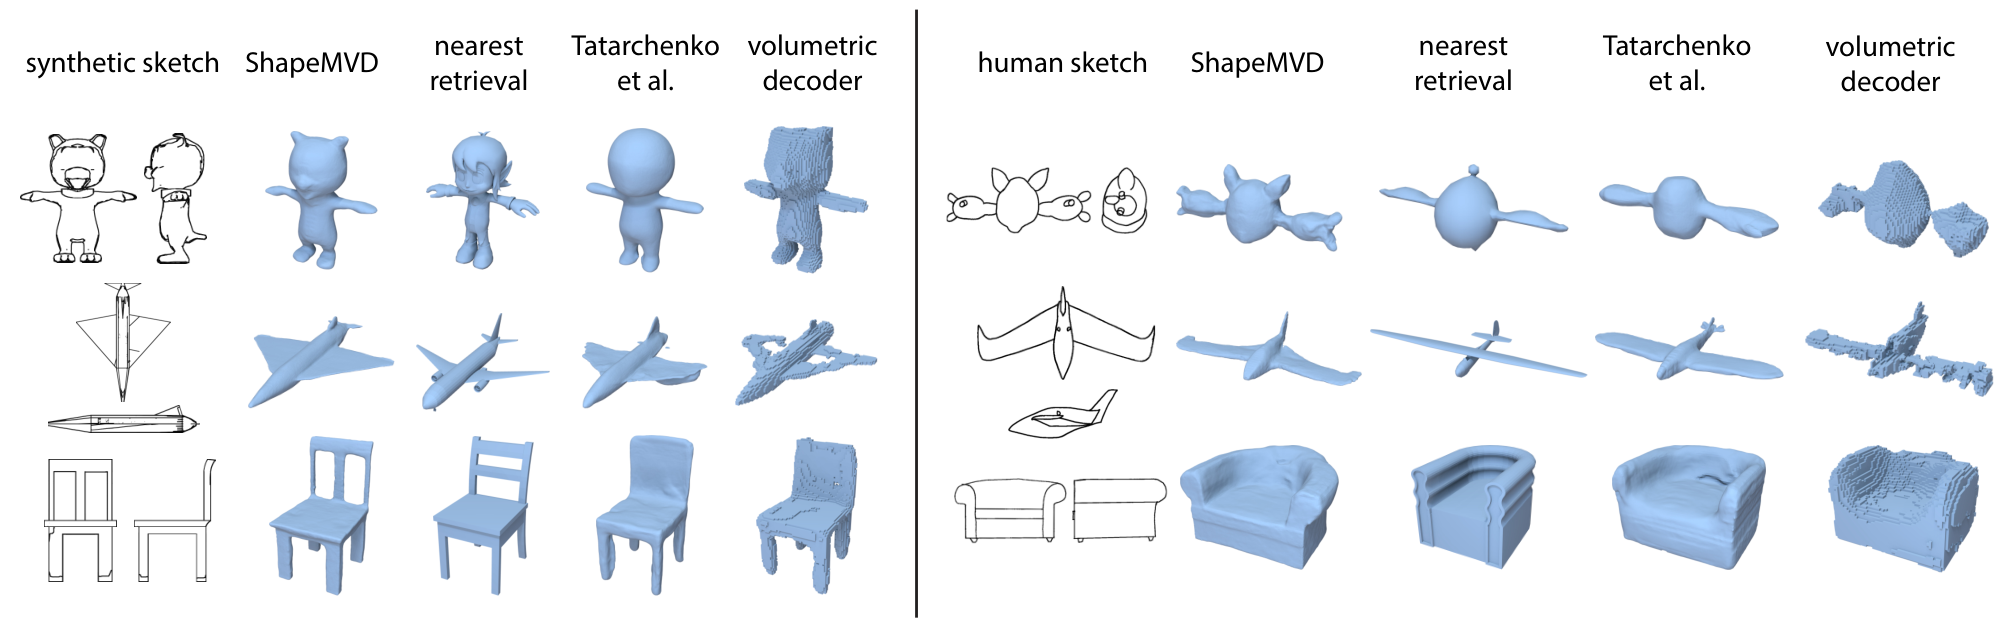
比较方法包括:latent 最近邻检索;Tatarchenko et al. 连续视角 decoder;加 U-Net skip 的同一变体;参数量相当的 \(128^3\) volumetric decoder;以及作者直接采用公开实现的 3D-R2N2。前四个学习基线使用相同数据划分;volumetric 与 Tatarchenko 分支做了参数量对齐,但 volumetric 无法使用同构 skip connection,因此“表示”与“可用架构”并未完全解耦。
| Man-made / synthetic | ShapeMVD | Retrieval | Tatarchenko | + U-Net | Volumetric | R2N2 |
|---|---|---|---|---|---|---|
| Hausdorff | 0.092 | 0.165 | 0.142 | 0.121 | 0.113 | 0.144 |
| Chamfer | 0.015 | 0.025 | 0.022 | 0.017 | 0.021 | 0.026 |
| Normal | 30.66 | 42.57 | 35.58 | 32.32 | 49.40 | 48.78 |
| Depth | 0.026 | 0.049 | 0.039 | 0.030 | 0.038 | 0.045 |
| Volumetric | 0.344 | 0.501 | 0.442 | 0.374 | 0.432 | 0.512 |
| Characters / synthetic | ShapeMVD | Retrieval | Tatarchenko | + U-Net | Volumetric | R2N2 |
|---|---|---|---|---|---|---|
| Hausdorff | 0.089 | 0.200 | 0.119 | 0.092 | 0.152 | 0.148 |
| Chamfer | 0.015 | 0.036 | 0.025 | 0.016 | 0.026 | 0.032 |
| Normal | 30.61 | 44.93 | 34.98 | 31.00 | 53.84 | 53.13 |
| Depth | 0.018 | 0.040 | 0.030 | 0.019 | 0.031 | 0.036 |
| Volumetric | 0.313 | 0.541 | 0.428 | 0.329 | 0.437 | 0.493 |
| Man-made / human | ShapeMVD | Retrieval | Tatarchenko | + U-Net | Volumetric | R2N2 |
|---|---|---|---|---|---|---|
| Hausdorff | 0.116 | 0.176 | 0.153 | 0.153 | 0.130 | 0.149 |
| Chamfer | 0.017 | 0.031 | 0.024 | 0.025 | 0.022 | 0.028 |
| Normal | 27.04 | 40.96 | 32.40 | 30.45 | 48.32 | 48.12 |
| Depth | 0.021 | 0.042 | 0.033 | 0.032 | 0.032 | 0.042 |
| Volumetric | 0.311 | 0.544 | 0.405 | 0.403 | 0.405 | 0.500 |
| Characters / human | ShapeMVD | Retrieval | Tatarchenko | + U-Net | Volumetric | R2N2 |
|---|---|---|---|---|---|---|
| Hausdorff | 0.117 | 0.188 | 0.139 | 0.136 | 0.178 | 0.168 |
| Chamfer | 0.021 | 0.036 | 0.025 | 0.024 | 0.032 | 0.036 |
| Normal | 33.44 | 43.81 | 36.11 | 34.74 | 54.91 | 54.29 |
| Depth | 0.026 | 0.040 | 0.031 | 0.027 | 0.037 | 0.040 |
| Volumetric | 0.298 | 0.458 | 0.342 | 0.307 | 0.420 | 0.436 |
Table II 全量重建。Normal distance 的论文单位未在正文表头明确标成 degrees,但数值与“角度均值”的定义相符;页面保留原数值,不擅自添加单位。
量级示例:man-made synthetic 上,ShapeMVD 对参数量相当的 volumetric decoder,Hausdorff 从 0.113 降到 0.092(约 18.6%),Chamfer 从 0.021 降到 0.015(约 28.6%),volumetric distance 从 0.432 降到 0.344(约 20.4%)。这支持高分辨率多视图表面表示,但仍混合了 skip connection 与显式融合的收益。
| Man-made | Full | No fusion | No normal | No GAN | Single input |
|---|---|---|---|---|---|
| Hausdorff | 0.092 | 0.102 | 0.108 | 0.107 | 0.134 |
| Chamfer | 0.015 | 0.015 | 0.017 | 0.016 | 0.020 |
| Normal | 30.66 | 30.78 | 31.22 | 30.89 | 34.49 |
| Depth | 0.026 | 0.027 | 0.029 | 0.028 | 0.035 |
| Volumetric | 0.344 | 0.356 | 0.354 | 0.347 | 0.428 |
| Characters | Full | No fusion | No normal | No GAN | Single input |
|---|---|---|---|---|---|
| Hausdorff | 0.089 | 0.090 | 0.088 | 0.098 | 0.113 |
| Chamfer | 0.015 | 0.015 | 0.016 | 0.016 | 0.021 |
| Normal | 30.61 | 30.84 | 30.85 | 30.72 | 34.15 |
| Depth | 0.018 | 0.019 | 0.020 | 0.019 | 0.026 |
| Volumetric | 0.313 | 0.318 | 0.323 | 0.320 | 0.396 |
Single vs. two inputs:man-made 的 Hausdorff 由 0.134 降至 0.092,volumetric distance 由 0.428 降至 0.344;这是表中最大的系统性增益。No GAN 的退化较小,例如 man-made volumetric 0.347 vs. 0.344,说明 adversarial term 是轻量结构正则,而非性能主因。No normal 时,Poisson 所需法线由局部最小二乘平面拟合得到;因此它测试的是“预测法线 + 联合融合”相对后估计法线的收益。
MTurk 每题展示两张输入线稿和两种方法的重建图,询问哪个三维模型更像线稿。每份 questionnaire 30 个 query,其中 15 个唯一 query 重复一次并随机左右翻转,用来检测不一致;每题由 5 个可靠参与者回答。完成一份问卷奖励 1 美元,每人每类别最多一份。
157 reliable,10 rejected;过滤规则是 15 个唯一题中超过 7 个重复回答不一致,或用时少于 2 分钟。
三组 pairwise comparison 各 600;120 个测试 sketch pair × 5 人。
补充材料称参与者彼此同意的比例;没有给 chance-adjusted agreement。
原始票中 ShapeMVD 分别获得 94.7%、92.8%、81.2%;“both / neither”也计入分母。人评非常强地支持可感知匹配,但它评价的是渲染图与输入线稿的相似性,不是网格 watertightness、编辑友好度或生产质量。它也是 pairwise,而非所有方法同时排序。
| 项目 | 论文描述 | 公开代码快照 3dd6a34 | 影响 |
|---|---|---|---|
| 输入通道 | \(C\) 张草图按通道拼接。 | data.py 又拼接每张输入的水平翻转版本,实际进入网络为 \(2C\) 通道,并标为 HACK。 | 属于未披露的确定性输入增强/对称先验;尤其可能帮助飞机和正面角色。 |
| 判别器条件 | 判别五通道 depth + normal + foreground map 的真假。 | monnet.py 将输入 sketch 也拼入 real/fake map,再送判别器。 | 实现是 conditional GAN,约束输出与输入相符;比正文公式更强。 |
| Dropout | decoder 前 3 层使用 dropout。 | network.py 主 U-Net 只在 d6、d5 两层显式调用 dropout。 | 复现时应以代码为准或做版本核查,不能照正文机械设三层。 |
| 训练 recipe | Adam \(\beta_1=0.9,\beta_2=0.999\),2 天。 | 补充 \(10^{-4}\) 初始学习率、10K step × 0.96、100 epoch、有效 batch 40;判别器按 loss heuristic 有条件更新。 | 公开实现提供关键缺失超参,但 checkpoint/数据下载体量大且依赖旧 TF 1.0.1。 |
| 融合权重 | \(w_1=w_2=1,w_3=w_4=0.3\),迭代 3–5 次。 | OptimizeDepths.cpp 有 lambda=0.3、原视图 alpha=3.0、深度断裂阈值为局部最小 gap 的 10 倍等 UNDONE 参数。 | 实现重组了求解过程并加入硬编码启发式,不能把这些常数直接等同论文四权重。 |
| 部署链 | 点云 → screened Poisson → 可选微调。 | C++ 只支持 Visual Studio;PoissonRecon 是外部可执行文件,推荐 depth 11、samplesPerNode 5、pointWeight 0.1。 | 完整复现不是单一 Python pipeline,存在外部二进制与 Windows 工程依赖。 |
这些差异不是“论文错误”的自动证明:公开代码可能对应最终工程版本,而论文受篇幅限制。但它们会改变复现实验,因此必须透明记录。此页未下载 14 GB training data 与 12 GB checkpoint,也未在现代环境重跑 TF 1.0.1 / Visual Studio pipeline;代码审计是静态核查,不是假装复现结果。
多视图 depth + normal 把三维输出转成 CNN 擅长的二维密集预测,又以显式投影和法线正交恢复一致曲面。网络和几何各做自己擅长的部分。
实验并非只与一个 voxel baseline 比:作者控制 encoder、参数量、数据划分,并加入连续视角、U-Net 变体、R2N2 和 retrieval;补充材料提供组件消融、人评与标准差。
测试集主动排除 affine-aligned 近重复,并用 encoder 距离复核,明显优于随意 random split。
每个类别与输入视角组合要单独训练,物体必须规范化与对齐;任意视角、未知朝向和开放类别未解决。人类线稿只有两位 artist、30 个形状。
最佳基线对比未完全拆分 view representation、U-Net skip、normal supervision 与 fusion;主表证明完整系统强,却不精确定位每个收益来源。
测试去重阈值、validation split 数量、随机种子、参数量、fine-tuning 约束权重未完整报告。代码与正文在输入、判别器和 dropout 上有差异。
输出缺少细节,Laplacian fine-tuning 无法修正错误拓扑;作者自己承认适合作为 proxy,而非 production asset。
把输入视图作为带相机参数的无序集合,通过 cross-view attention 聚合;输出用 camera-conditioned decoder 或 triplane / implicit field,解除每个视图组合单独训练。
论文已提出这一方向。现代实现可把可微投影、深度一致性与 normal integration 作为训练层,让几何约束同时影响 latent,而不仅在推理后修补。
单图歧义不该被一个确定结果隐藏。输出每区域的不确定性,主动建议用户从最能消除歧义的视角补画,形成 active reconstruction。
将 mesh validity、部件存在性和轮廓覆盖组成 test-time objective,通过搜索或 graph repair 纠正 fine-tuning 无法新增/删除部件的问题。
把 12 个 depth/normal view 类比成材质节点的多通道 preview:生成器提议结构,renderer 产生观测,跨视图/跨通道一致性优化参数。必须把这一点标为研究延伸,而非论文已验证。
按 artist、类别、视角和线条风格分层;报告 calibration、拓扑错误、mesh 可编辑性与 runtime;用预注册的开放类别 split 防止训练集形状先验掩盖泛化失败。
3dd6a341b8aeea1367fe4470600f8cbfd45dac03。未执行完整训练/推理;未下载 14 GB 训练数据与 12 GB checkpoint;未独立复算 3D 指标。网页数值逐项取自主文 Table II 与 supplementary Tables 2–4,事实、作者解释、本站解读与研究延伸已分开标示。