全量微调的问题
每个任务都保存整套 backbone,存储与训练成本高;在 Pascal VOC 这类低数据设置上,198M Swin-L 全量更新还可能过拟合。
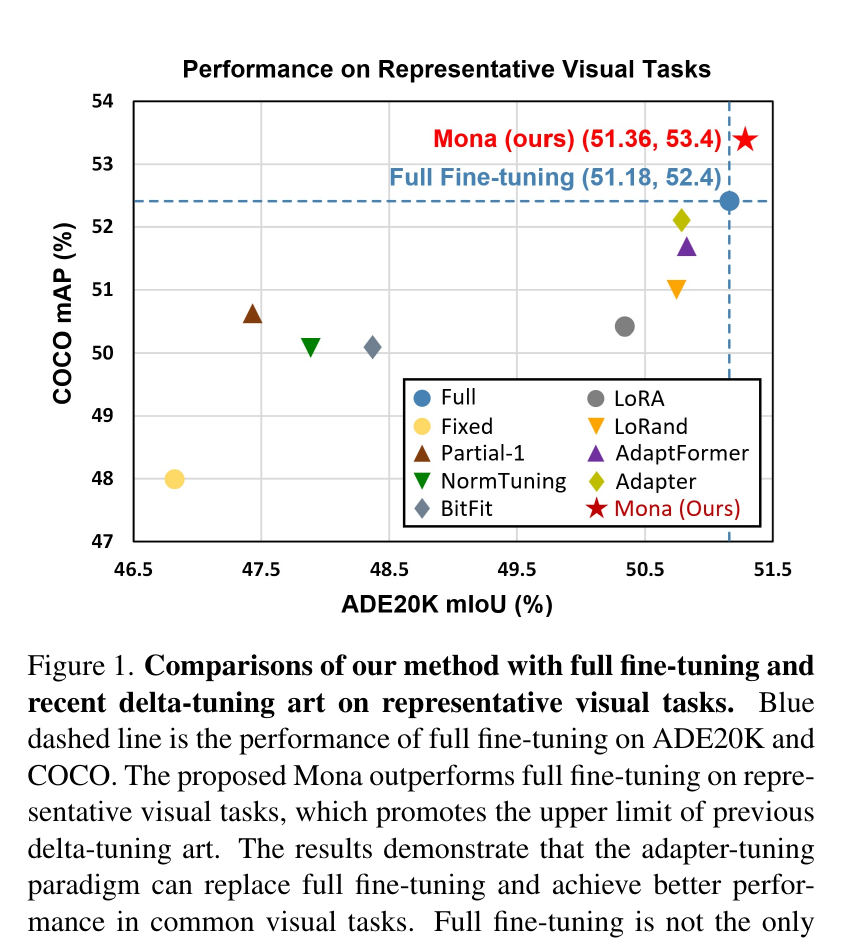
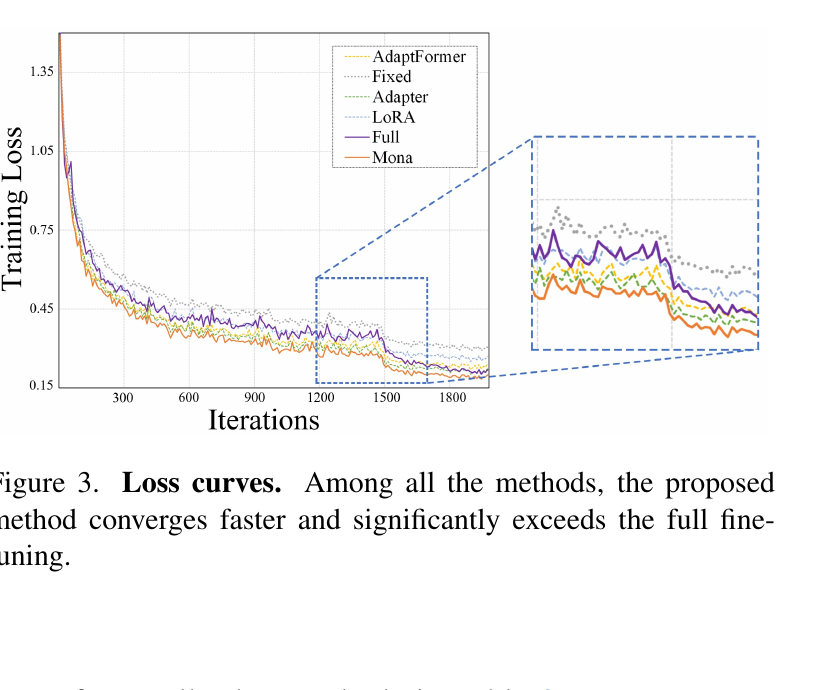
Mona 只训练少量视觉适配器,却在论文覆盖的八个视觉数据集与多种密集预测任务上超过全量微调。真正值得读的不是口号,而是多尺度深度卷积、输入分布调节、实验口径与公开实现之间的关系。
这篇论文最初以 arXiv:2408.08345 发布,后正式发表于 CVPR 2025。本页以 CVF 的 11 页正式版本为方法与实验主依据,以官方仓库固定提交 5deeac9f4fc5e788b7fa0132ec568cd256afca12补充复现配置与实现审计。
| 证据 | 固定版本 | 用途与边界 |
|---|---|---|
| CVPR 正式论文 | CVPR 2025, 20071–20081 | 标题、作者、公式、全部图表与出版身份 |
| Obsidian 现有 PDF | 2408.08345v2.pdf,10 页,SHA-256 dfe33b…a6d8c5 | 旧 arXiv v2;保留归档与 PDF++ anchors,不把旧 metadata 当最新出版状态 |
| 官方代码 | 5deeac9f…fca12 | 当前公开实现快照;不等于论文训练时的私有环境 |
| 官方仓库 README | 2026-09-26 核查 | 训练入口、预训练权重与 CVPR 信息 |
论文表格的百分比是可训练 backbone 参数占预训练 backbone 参数的比例。检测/分割 neck 与 head 仍然训练,且 Mona 增加新结构。COCO 的 Mona 为 4.16M、4.67%;Swin-L 任务为 5.08M、2.56%。因此“5% > 100%”是简洁口号,不是所有训练参数或总计算量的严格比例。
作者与机构:正式版把 Dongshuo Yin 标为上海交通大学与清华大学双重署名,并说明工作始于上海交大、完成于清华;Leiyi Hu 属中国科学院大学;Bin Li 与 Youqun Zhang 属阿里巴巴;Xue Yang 属上海交大并明确为通讯作者。现有笔记只写 institute: Tsinghua University,因此元数据不完整。
每个任务都保存整套 backbone,存储与训练成本高;在 Pascal VOC 这类低数据设置上,198M Swin-L 全量更新还可能过拟合。
多数沿用 NLP 的线性 down/up projection。它们能省参数,却没有显式利用二维邻域与尺度结构,在 COCO、ADE20K 等密集预测上仍低于 full fine-tuning。
冻结预训练层后,adapter 先校正输入分布,再以多个卷积核观察局部尺度,能以更少参数保留并重组预训练视觉知识。
真正填补的 gap:不是第一个视觉 PEFT,也不是第一个密集预测 adapter。Mona 的贡献是证明一个带视觉滤波器的 adapter,在同一套 Swin / OpenMMLab 体系下,能跨分类、水平检测、旋转检测、语义分割与实例分割同时超过 full fine-tuning。
证据边界:“full fine-tuning 不再最优”只被这组数据集、backbone、训练 recipe 支持。论文没有不同随机种子的均值/方差、显著性检验、现代 ConvNet/ViT 大范围复现,也没有与后来方法比较。更强的普遍性措辞应视为 Author Claim。
给定下游数据集 \(D=\{(x_i,y_i)\}_{i=1}^{N}\),全量微调更新模型全部参数;adapter-tuning 固定预训练参数 \(\theta_F\),只优化 Mona 与 backbone 外任务模块的参数 \(\omega\)。
| 符号 | 含义 | 实际对象 |
|---|---|---|
| \(x_i,y_i\) | 样本与监督 | 分类标签、框/旋转框、实例 mask 或语义像素标签 |
| \(\theta\) | full fine-tuning 的全模型参数 | backbone 及任务模块一起更新 |
| \(\theta_F\) | adapter 模式下固定的预训练参数 | ImageNet-22K 监督预训练的 Swin backbone 原参数 |
| \(\omega\) | 可训练参数 | 每个 Swin block 两个 Mona,以及 neck/head 等 backbone 外参数 |
| \(m,n\) | 输入通道与中间宽度 | \(n=64\);\(m\) 随 Swin stage 为 192/384/768/1536 等 |
论文比较的是两种训练方案最终达到的验证/测试性能,并未证明 PEFT 的理论最优解高于 full fine-tuning。若是同一架构,限制可训练参数可以产生正则化效果;但 Mona 还新增了卷积 adapter,和原始 full 模型并非严格的参数子空间包含关系。因此“少参数更好”只能作为结构化正则与视觉归纳偏置的经验解释,不能由参数空间大小直接推出。
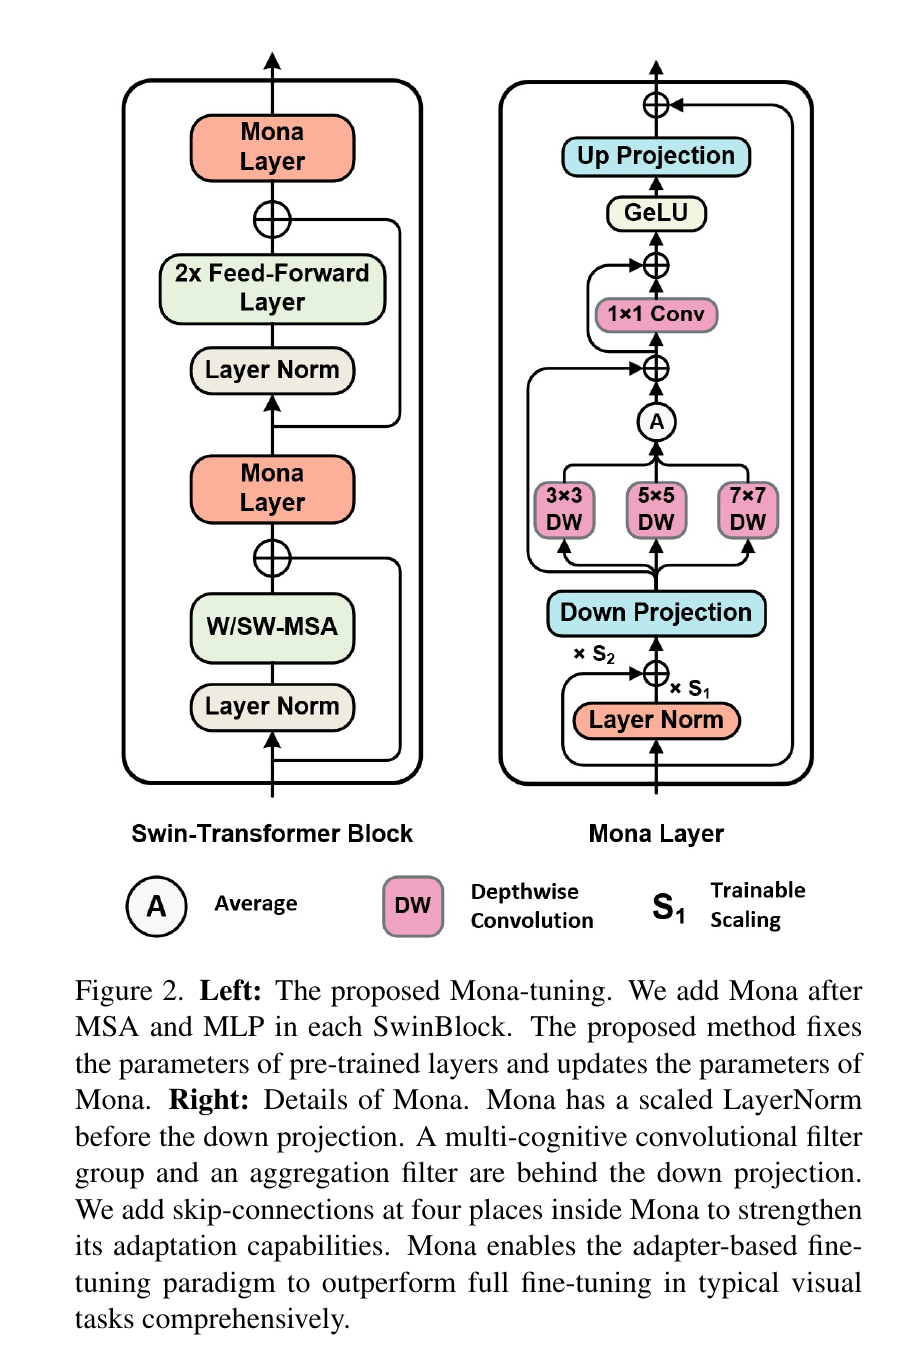
论文把 \(s_1,s_2\) 描述成两个 learnable weights;公开实现是长度为 \(m\) 的可学习向量 gamma 与 gammax,因此用逐通道乘法 \(\odot\) 更贴近代码。初始化分别为 \(10^{-6}\mathbf{1}\) 与 \(\mathbf{1}\):开始训练时近似保留原特征,让归一化支路逐步进入。
为什么 depthwise + pointwise?depthwise 的空间成本与通道数线性增长,适合低成本加入二维局部归纳偏置;pointwise 再负责通道混合。三个尺度并非“人眼认知”的数学模型,而是 Inception 风格多尺度滤波的工程选择。论文消融支持 \([3,5,7]\) 在 VOC 上最好,但没有证明视觉系统确实按这种方式工作。
论文按两个缩放标量计数:LayerNorm 与缩放为 \(2m+2\),down/up projection 为 \(2mn+m+n\),三组 depthwise conv 为 \(83n\),pointwise conv 为 \(n^2+n\)。单个 Mona:
每个 Swin block 有两个 Mona,因此:
代码中的 gamma 与 gammax 各有 \(m\) 个元素,不是两个标量,所以 scaled-normalization 部分是 \(4m\)(LayerNorm 为 \(2m\),两个向量再提供 \(2m\)),单模块比论文公式多 \(2m-2\) 个参数。整体量级仍小,但严格复现参数表时应以运行模型逐项统计,而不是直接套公式。
中间宽度固定为 64,使 backbone 越大时 Mona 占比越低:论文 Table 6 中 Swin-T/B/L 分别为 4.87%、4.06%、2.56%。但推理仍执行两次 Mona/block;参数存储低不等于 FLOPs、显存、吞吐或延迟同比例下降。论文主动承认 adapter 引入额外 inference cost,却没有给实际时延。
| 任务 | 模型/数据 | 公开 Mona 配置 | 指标 |
|---|---|---|---|
| 实例分割 | Swin-B + Cascade Mask R-CNN;COCO 118k/5k | AdamW, lr \(10^{-4}\), \(\beta_1=0.9,\ \beta_2=0.999\), weight decay 0.05;36 epochs,step 27/33;混合精度;多尺度+crop;README 文件名暗示总 batch 16 | box AP / mask AP |
| 语义分割 | Swin-L + UperNet;ADE20K 20k/2k | AdamW, lr \(3\times10^{-4}\), \(\beta_1=0.9,\ \beta_2=0.999\), weight decay 0.01;poly 160k iters;linear warmup 1500;8 GPU × 2 images;SyncBN | mIoU |
| 水平检测 | Swin-L + RetinaNet;VOC 0712 约16k/5k | AdamW, lr \(10^{-4}\), \(\beta_1=0.9,\ \beta_2=0.999\), weight decay 0.05;runner 写 4 epochs 且注释“actual 12”;step 3;混合精度;输出 stage 1–3 | box AP |
| 分类 | Swin-L;Flowers102 / OxfordPets / VOC2007 | 4 GPU × 4 images;AdamW lr \(3.125\times10^{-5}\),weight decay 0.05,\(\varepsilon=10^{-8}\),100 epochs;dynamic loss scale;224 crop | top-1 / top-5 |
| 旋转检测 | Swin-B;DOTA-v1.0 / STAR;Oriented R-CNN, KLD, H2RBox-v2 | 主仓库不含这些配置,README 指向外部 STAR-MMRotate 仓库;固定 commit、统一预处理和完整超参未在正文给出 | oriented box AP |
所有 backbone 使用 ImageNet-22K 监督预训练 Swin;COCO、DOTA、STAR 用 Swin-B,其余主要用 Swin-L。论文使用 MMDetection、MMSegmentation、MMRotate 与 MMClassification。Mona 的 inference 不含采样、beam search 或 test-time optimization:训练完成后,只做常规前向和任务头解码。
# Only for evaluation,但 README 又直接把它作为训练命令;checkpoint 保存间隔 101 大于 100 epochs。复现者应先验证 runner 行为。| 方法 | 训练 backbone 参数 | 占比 | Box AP | Mask AP |
|---|---|---|---|---|
| Full | 89.14M | 100% | 52.40 | 45.10 |
| Fixed | 0 | 0% | 48.00 (−4.40) | 41.60 (−3.50) |
| BitFit | 0.21M | 0.23% | 50.10 | 43.60 |
| NormTuning | 0.06M | 0.07% | 50.10 | 43.50 |
| Partial-1 | 12.95M | 14.53% | 50.60 | 43.70 |
| Adapter | 3.19M | 3.58% | 52.10 | 45.00 |
| LoRA | 3.06M | 3.43% | 50.40 | 43.90 |
| AdaptFormer | 1.60M | 1.79% | 51.70 | 44.60 |
| LoRand | 4.68M | 5.23% | 51.90 | 44.70 |
| Mona | 4.16M | 4.67% | 53.40 (+1.00) | 46.00 (+0.90) |
| 方法 | 训练 backbone 参数 | 占比 | VOC Box AP | ADE20K mIoU |
|---|---|---|---|---|
| Full | 198.58M | 100% | 83.70 | 51.18 |
| Fixed | 0 | 0% | 83.80 | 46.84 |
| BitFit | 0.30M | 0.15% | 85.40 | 48.37 |
| NormTuning | 0.10M | 0.05% | 85.50 | 47.89 |
| Partial-1 | 28.77M | 14.53% | 85.50 | 47.44 |
| Adapter | 4.61M | 2.33% | 86.70 | 50.78 |
| LoRA | 4.57M | 2.31% | 85.40 | 50.34 |
| AdaptFormer | 2.34M | 1.18% | 86.60 | 50.83 |
| LoRand | 5.20M | 2.62% | 86.90 | 50.93 |
| Mona | 5.08M | 2.56% | 87.30 (+3.60) | 51.36 (+0.18) |
VOC 提升最大。所有 PEFT baseline 都超过 full,说明这更像低数据下的正则化优势,而不是 Mona 独有现象。
COCO box / mask AP 相对 full。这里其他 PEFT 多数仍落后,最能支持 Mona 的视觉结构有价值。
ADE20K 的领先很小。没有方差时,只能说报告值更高,不能说显著更好。
| 方法 | Flowers102 | OxfordPets | VOC2007 | 平均 |
|---|---|---|---|---|
| Full | 99.5772 / 99.8536 | 94.6579 / 99.6257 | 84.1276 / 96.9507 | 92.7876 / 98.8100 |
| Fixed | 99.3007 / 99.8374 | 94.2219 / 99.9182 | 85.0162 / 98.9499 | 92.8463 / 99.5685 |
| BitFit | 99.5772 / 99.8211 | 95.3393 / 99.9182 | 85.6018 / 99.3336 | 93.5061 / 99.6910 |
| NormTuning | 99.5284 / 99.8374 | 95.2303 / 99.8910 | 85.5210 / 99.2528 | 93.4266 / 99.6604 |
| Partial-1 | 99.6585 / 99.8374 | 95.3938 / 99.8637 | 84.9354 / 98.6066 | 93.3292 / 99.4359 |
| Adapter | 99.5934 / 99.8536 | 95.3393 / 99.8092 | 87.0355 / 99.1317 | 93.9894 / 99.6144 |
| LoRA | 99.5446 / 99.8536 | 95.1485 / 99.8910 | 85.7028 / 99.3134 | 93.4653 / 99.6860 |
| AdaptFormer | 99.5609 / 99.8536 | 95.2576 / 99.8365 | 86.2884 / 99.2730 | 93.7023 / 99.6544 |
| LoRand | 99.5725 / 99.8536 | 95.3515 / 99.8910 | 86.6534 / 99.3741 | 93.8591 / 99.7062 |
| Mona | 99.6764 / 99.9024 | 95.4765 / 99.9182 | 86.9709 / 99.5057 | 94.0413 / 99.7592 |
Mona 的平均 top-1 最高,但 VOC2007 top-1 低于 Adapter(86.9709 vs. 87.0355),OxfordPets top-5 与多方法并列。这修正了“所有单项都最好”的强读法;作者正文准确说在 Flowers102、OxfordPets 与平均结果领先。
| 方法 | DOTA / Oriented R-CNN | STAR / Oriented R-CNN | STAR / KLD | STAR / H2RBox-v2 |
|---|---|---|---|---|
| Full | 78.31 | 38.63 | 30.33 | 30.29 |
| Fixed | 74.10 | 30.83 | 23.81 | 26.01 |
| BitFit | 76.05 | 34.51 | 28.17 | 29.41 |
| NormTuning | 75.82 | 33.13 | 27.12 | 27.79 |
| Partial-1 | 75.72 | 33.96 | 28.53 | 28.89 |
| Adapter | 78.27 | 37.97 | 30.35 | 30.24 |
| LoRA | 75.91 | 33.80 | 27.48 | 28.95 |
| AdaptFormer | 77.43 | 35.95 | 29.36 | 30.11 |
| LoRand | 77.65 | 36.44 | 29.83 | 28.85 |
| Mona | 78.44 | 39.45 | 30.90 | 31.34 |
| 消融 | 设置 | VOC Box AP | 说明 |
|---|---|---|---|
| 中间宽度 | 32 / 64 / 128 | 86.8 / 87.3 / 87.1 | 参数更多不保证更好;64 是经验甜点 |
| scaled norm | 无 / 有,kernel [3,5,7] | 86.9 / 87.3 | +0.4 pp;没有单独拆 LN、残差支路、缩放向量 |
| kernel | [3] / [5] / [7] | 86.9 / 87.0 / 86.7 | 单尺度都低于多尺度 |
| kernel | [3,3,3] / [3,5] / [5,7] | 86.8 / 86.9 / 87.1 | [3,5,7] 报告值最高 |
| 模型规模 | Swin-T full→Mona | 80.1→83.5 | +3.4 pp;Mona 4.87% |
| 模型规模 | Swin-B full→Mona | 81.6→86.5 | +4.9 pp;Mona 4.06% |
| 模型规模 | Swin-L full→Mona | 83.7→87.3 | +3.6 pp;Mona 2.56% |
| backbone | PVT-L full / Adapter / LoRA / AdaptFormer / LoRand / Mona | 76.1 / 78.9 / 77.6 / 79.2 / 79.3 / 80.3 | 显示不只适用于 Swin;仍只有一个额外 backbone/任务 |
实际证明:scaled normalization 与多尺度 kernel 的组合在 VOC 单一设置中有效;64 维优于两个邻近候选;结果能迁移到 PVT-L。没有证明:“多认知”是唯一原因、三个 kernel 都必须、逐通道缩放优于标量、dropout 的贡献、或提升来自更好归纳偏置而非额外深度/优化 recipe。
| 核查项 | 论文 | 固定提交中的行为 | 影响 |
|---|---|---|---|
| scaled weights | 两个 learnable weights,参数式只加 2 | gamma/gammax 是两个长度 (m) 的向量 | 代码比公式每模块多 (2m-2) 参数;表达力也不同 |
| 未写出的 dropout | 公式为 GeLU 后上投影 | GeLU 后 Dropout(p=0.1) | 训练正则化的一部分;不计参数但影响复现 |
factor | 中间维度固定 64 | 构造器收 factor=4/8,但始终 Linear→64,参数未使用 | 配置接口容易误导;改变 factor 不改变宽度 |
| 冻结机制 | 固定预训练 backbone,只训 Mona | init_weights 后凡名称不含 my_module 的 backbone 参数都冻结 | 与论文意图一致;neck/head 仍由框架训练 |
| 插入位置 | MSA 与 MLP 后各一个 Mona | 两个模块均在对应残差加和之后调用 | 与 Figure 2 一致;不是并联 AdaptFormer |
| 分类入口 | 100 epoch 分类实验 | README 训练命令引用顶部写“Only for evaluation”的配置;checkpoint interval=101 | 需要先验证是否会保存最终 checkpoint、是否缺训练专用文件 |
| 旋转检测 | DOTA/STAR 四列主结果 | 主仓库无 MMRotate 配置,只链接另一个活跃仓库,未固定 revision | 跨时间复现可能漂移;主结果不在一个自包含版本中 |
| 路径与环境 | OpenMMLab toolkits | 权重与数据路径大量硬编码为 /pretrained_model/...、data/... | README 要求手改;不是开箱即复现 |
仓库是三个 OpenMMLab / Swin 代码库的大型快照,几乎重复维护 Mona backbone。优点是能接近原环境;缺点是依赖版本旧、实现分散,容易让修复只落在某一任务副本。论文没有公开完整运行日志、预训练权重哈希或每张表对应 commit。
问题明确;模块简单;将空间滤波引入视觉 adapter 的动机合理;覆盖八个数据集、五类任务与两个 backbone;在 COCO/ADE20K 等密集预测上突破 full 的结果比只做分类更有说服力。
缺少多 seed 与统计;没有训练/推理成本曲线;参数公式与代码缩放向量不一致;dropout 未在方法中说明;旋转检测复现链分散;超参数可能对 full 与 PEFT 的公平性产生显著影响。
在作者 recipe 下,Mona 的单次报告值跨任务超过 full。它没有证明任意视觉模型、数据规模和预算下 PEFT 都优于 full,也没有证明多尺度卷积是唯一解释。
Research Extension:让不同 stage/样本选择 3、5、7 或空操作,以延迟预算约束训练;比较固定平均、soft gate 与离散路由。
Research Extension:探索把训练时多分支卷积折叠为单个等效 depthwise kernel,减少部署延迟;需要处理残差与最大核对齐。
Research Extension:同一冻结 backbone 保存多个 Mona,研究 adapter fusion、冲突检测与按场景组合,而不只比较单任务 checkpoint 存储。
对程序化材质研究的启发不是直接拿 Mona 生成 graph,而是把可学习的视觉适配层放入材质图评价器、VLM 图像编码器或 renderer-feedback 网络,让少量任务参数适配新材质域。可进一步测试:多尺度纹理统计是否改善节点检索、图修复奖励或 test-time search 的候选排序。以上均未被原论文验证。
5deeac9f4fc5e788b7fa0132ec568cd256afca12。页面所有实验数字均来自 CVPR 正式版 Tables 1–8;实现结论来自上述固定代码提交。未运行论文训练、未验证 checkpoint 数值、未把一次静态代码审计等同于独立复现。