NeRF 补上了 MVS 的空缺
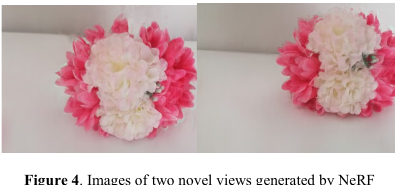
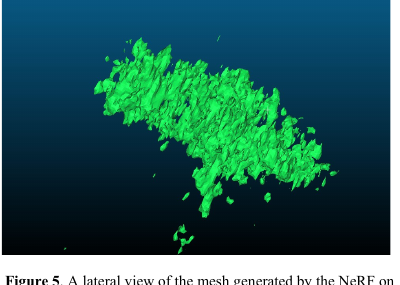
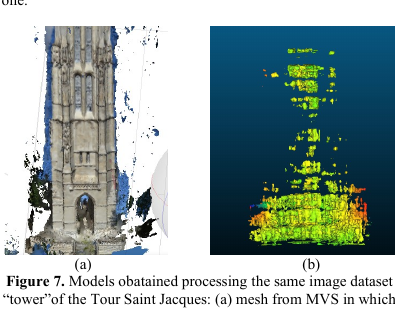
在具有大量相似高频纹理的花卉对象上,COLMAP 的 MVS 阶段失败;NeRF 仍生成新视角和三角网格。塔数据中,MVS 只重建一面立面,NeRF 展示出两面。
一篇早期、样本很小,却把“照片真实感”与“测量可靠性”放到同一张桌上的探索性比较
A Comparison Between 3D Reconstruction Using NeRF Neural Networks and MVS Algorithms on Cultural Heritage Images
论文让原始 NeRF 与 COLMAP SfM/MVS 处理相同图像:花卉案例中 MVS 失败而 NeRF 得到网格;Saint-Jacques 塔案例中两者均成功,NeRF 覆盖更多立面,MVS 网格更细。它提供了有价值的可行性信号,但没有形成足以判定方法优劣的统一 benchmark。
在具有大量相似高频纹理的花卉对象上,COLMAP 的 MVS 阶段失败;NeRF 仍生成新视角和三角网格。塔数据中,MVS 只重建一面立面,NeRF 展示出两面。
塔案例中,作者明确指出 MVS mesh resolution 高于 NeRF。NeRF 的覆盖优势没有同时转化为更高表面分辨率。
花卉只量了 4 条、长度 4–10 cm 的线段,绝对残差 1–2 cm;没有重复测量、标尺精度、相对误差或统计区间。
它证明“原始 NeRF 可以被转换成可测网格并与摄影测量比较”,没有证明 NeRF 在文化遗产测绘上普遍优于 MVS。
历史照片常是已消失或已改变建筑的唯一痕迹。标准 SfM/MVS 需要足够的纹理、重叠视角和稳定成像条件;历史档案恰好经常缺少这些条件。作者的研究问题不是“谁生成的新视角更漂亮”,而是:当原始 NeRF 被提取成 mesh 后,它在困难图像上能否提供传统摄影测量缺失的几何,并且是否具有可接受的量测尺度。
同一组静态场景 RGB 图像;由 COLMAP SfM 估计的相机外参与内参;NeRF 还需要 scene bounds。
COLMAP MVS 的稠密点云/Poisson surface mesh,与 NeRF 密度场经过 marching cubes 得到的三角网格;最终以成功率、覆盖、视觉网格分辨率和少量距离误差比较。
MVS 通过多视图匹配恢复每像素深度与法线,再融合成稠密点云;其隐含目标是跨视图光度一致与几何一致。NeRF 则学习连续辐射场:给定空间位置 \(\mathbf{x}=(x,y,z)\) 与观看方向 \(\mathbf{d}\),预测颜色和体密度:
这里 \(\Theta\) 是每个场景单独训练的 MLP 参数;\(\mathbf{c}=(r,g,b)\) 是视角相关颜色,\(\sigma\) 是只依赖位置的体密度。NeRF 原生输出可渲染场,而非有物理表面的测绘模型;论文额外对 \(\sigma\) 的规则网格采样并运行 marching cubes,才得到 mesh。
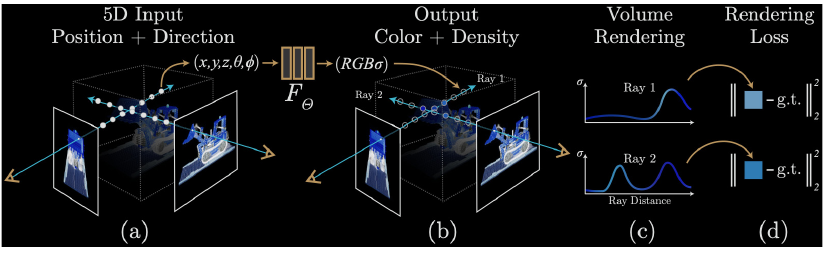
对射线 \(\mathbf{r}(t)=\mathbf{o}+t\mathbf{d}\),连续颜色是沿深度的加权积分:
\(T(t)\) 是光线从近端 \(t_n\) 到深度 \(t\) 尚未被吸收的透射率;\(T(t)\sigma(\mathbf{r}(t))\) 是该位置对最终像素的贡献权重。论文文字解释了这一机制,但未把积分公式完整排出;上式按其引用的原始 NeRF 形式补全,属于标准方法解释。
位置编码把低维坐标投到多频正弦空间,使普通 MLP 能表达高频几何和颜色。每批随机取 4096 条像素射线;coarse 网络每条取 64 个样本,fine 网络再按 coarse 权重集中取 128 个样本。两者都对真实像素颜色监督:
\(\mathcal{R}\) 是当前 batch 的射线集合;\(C\) 为真实 RGB;\(\widehat{C}_{c}\) 与 \(\widehat{C}_{f}\) 分别是 coarse 与 fine 渲染。损失约束渲染一致性,不直接监督 mesh 顶点或真实表面距离;因此,从低重建误差推到度量几何准确仍需要独立测量。
作者采集 10 张图,按粗略网格从上到下拍摄;相邻视角最大视差遵循约不超过水平视场的 \(1/8\) 建议。花瓣具有重复、高频、相似图案,预期让特征匹配和 MVS 失败。
巴黎 Tour Saint-Jacques 实地调查图像并非为 NeRF 设计。高塔迫使相机近距离仰拍,视角覆盖不均;它模拟历史档案的随机图像,但仍是现代、高质量实拍,不是真正的历史黑白档案。
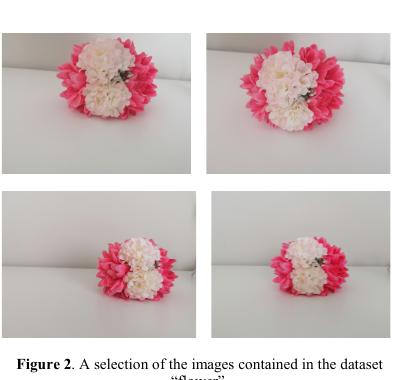
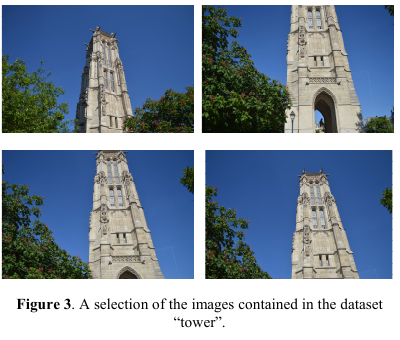
| 项目 | Flower | Tower |
|---|---|---|
| 对象 | 室内花卉,小物体 | 巴黎 Saint-Jacques 塔,文化遗产建筑 |
| 图像数 | 10 | 未报告 |
| 采集方式 | 粗略网格;为本研究采集 | 现场调查;并非按 NeRF 规范采集 |
| 预期难点 | 重复的高频相似纹理 | 近距离仰拍、视角分布不足 |
| 参考 | 对象表面 4 条直接测量 | Iconem 的近期 UAV mesh |
| 公开性 | 未给数据下载 | 未给数据或 UAV 模型下载 |
| 数据集 | NeRF | MVS | 参考 | 可支持的结论 |
|---|---|---|---|---|
| Flower | 成功 | 失败 | 直接量测 | 在这一组重复纹理图像上,NeRF 表面提取比该次 COLMAP MVS 更鲁棒。 |
| Tower | 成功,两面 | 成功,一面 | UAV mesh | 在视角覆盖不足时,NeRF 输出的可见覆盖更完整;MVS 网格分辨率更高。 |
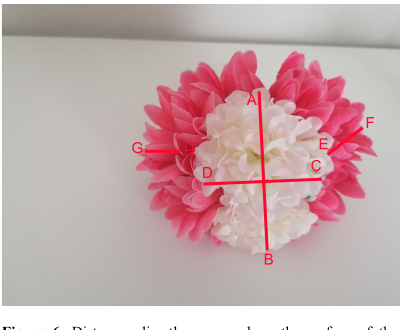
| 线段 | Mesh | 参考 | 绝对残差 | 相对参考误差 |
|---|---|---|---|---|
| AB | 0.09 m | 0.10 m | 0.01 m | 10.0% |
| DC | 0.04 m | 0.05 m | 0.01 m | 20.0% |
| EF | 0.04 m | 0.06 m | 0.02 m | 33.3% |
| GH | 0.05 m | 0.07 m | 0.02 m | 28.6% |
原 Table 2 的列标为 cm,但数值 0.04–0.10 与正文“1–2 cm 残差”一致时,数值单位应解释为 m。若真按 cm,残差只有 0.1–0.2 mm,与正文冲突。页面保留这一原文单位歧义,并按正文语义换算。
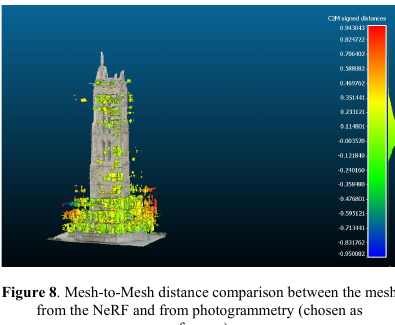
塔 mesh 的距离“通常约为 0.003 m”,作者认为在建筑语境可接受。
NeRF 与 MVS 的结合是该方法的优势;论文没有实现自动融合算法,也没有展示融合后的单一模型。
Figure 8 是彩色误差可视化,缺少分布统计,且只比较 NeRF 与 UAV 参考。由于 MVS 缺面,论文没有在同一有效区域给出 NeRF 与 MVS 的对称定量比较。
| 环节 | 论文报告 | 复现缺口 |
|---|---|---|
| 相机求解 | COLMAP SfM;特征检测、匹配与几何验证,再恢复结构与运动 | COLMAP 版本、camera model、匹配策略和阈值未报告 |
| MVS | COLMAP 深度/法线估计、融合、Poisson surface reconstruction | PatchMatch、融合、Poisson 参数与后处理未报告 |
| NeRF 架构 | 原始官方实现;8 层、每层 256 channels;ReLU;位置编码;coarse/fine 网络 | 密度阈值、场景 bounds、随机种子未报告 |
| 训练 | batch 4096 rays;每射线 64 coarse + 128 fine samples;Adam;约 300k iterations | 学习率、\(\beta\) 参数、scheduler、数据缩放与 train/test views 未在本文报告;只能参考原始 NeRF 默认值 |
| 硬件与时间 | CINECA Marconi100;NVIDIA V100;完整运行约 24 h | V100 数量、具体数据集对应耗时、显存、软件栈未报告 |
| 表面提取 | marching cubes 从规则笛卡尔网格上的场提取三角面 | 网格分辨率、density iso-value、裁剪、去噪与尺度恢复未报告 |
| 度量 | CloudCompare Mesh-to-Mesh;文中又描述 M3C2 plugin | 到底使用原生 mesh distance 还是 M3C2 点云距离存在术语混用;配准、法线尺度、置信区间参数未报告 |
论文没有 prompt、agent、token 或 learned prior;它是每场景优化的经典 NeRF。训练输入是像素射线及真实 RGB,推理输出首先是 novel view,网格是额外离散化结果。停止条件约为 300k 次迭代,并非基于验证集早停。作者没有提供本研究的数据、配置文件、训练日志或提取 mesh 脚本。
Paper verified 在两个作者选定的数据集与未完全公开的配置上,原始 NeRF 能提取 mesh;其中一个数据集的 MVS 失败,另一个数据集上 NeRF 覆盖更多立面;报告的少量距离差值在厘米或毫米量级。
Evidence limited 这不足以证明 NeRF 对历史照片普遍更可靠,也不足以证明网格满足测绘、保护决策或形变监测的精度标准。真正的历史档案图、透明尺度恢复、已知 ground-truth scanner、跨场景统计与不确定性评估都缺失。
先用 SfM/MVS 的 track length、重投影误差、深度一致性和 coverage 估计置信度;只在低置信区域调用 radiance-field reconstruction,形成有预算约束的混合系统。
对训练视角、密度阈值与随机种子 bootstrap,输出每个表面点的分布,而非单一 mesh。把“可看”与“可测”分成两个置信通道。
系统改变图像数量、重叠、模糊、压缩、黑白化、曝光和瞬态遮挡;比较 COLMAP、NeRF-W、现代 NeRF/3DGS 与传统 dense matching。
以激光扫描或高精 UAV 模型为真值,固定配准,分别报告 accuracy、completeness、Chamfer、法向误差、尺度漂移与可见区域 mask,避免“缺面”让均值失真。
对 procedural material / inverse graphics 的启发不在于直接迁移 NeRF,而在于评测设计:视觉拟合目标可能在不可观察区域“补全”出看似合理的结构。renderer-in-the-loop 系统需要把外观误差、结构合法性、度量准确性和不确定性分开记录,尤其不能用单一感知相似度替代可编辑图结构或物理参数的验证。
本文页面依据正式出版 PDF 全 6 页逐页核对。所有嵌入图均裁自原论文 Figures 1–8,原论文采用 CC BY 4.0。未发现补充材料、项目数据页或本研究专属代码仓库。网页中的相对误差为由原 Table 2 数值计算的解释性派生量,已与作者原始结论区分。