3DV 2020
正式会议论文
IEEE 3DV 2020,160–170 页。Google Research 出版页和 DBLP 均支持正式会议身份;现有 Obsidian note 的“arXiv preprint”不完整。
Divide et Impera 把“未知相机姿态下的稀疏多视图重建”拆成三个可解释模块:成对相对姿态、全局图优化、带学习先验的软体素雕刻。
它没有把所有输入压进一个黑箱,也不要求物体预先摆在统一朝向。真正的贡献是职责分工:网络识别跨视图旋转,几何约束清理不一致,轮廓把可见证据写入体素,3D CNN 再补全低分辨率形状。
IEEE 3DV 2020,160–170 页。Google Research 出版页和 DBLP 均支持正式会议身份;现有 Obsidian note 的“arXiv preprint”不完整。
arXiv:2011.08534v2,主文 11 页,随后附 3 页 supplementary。本文数字均来自该合订本。
论文给出 TensorFlow 2.0、Ceres、网络、损失与核心超参,但未找到作者正式公开实现;无法审计训练脚本、数据预处理与随机种子。
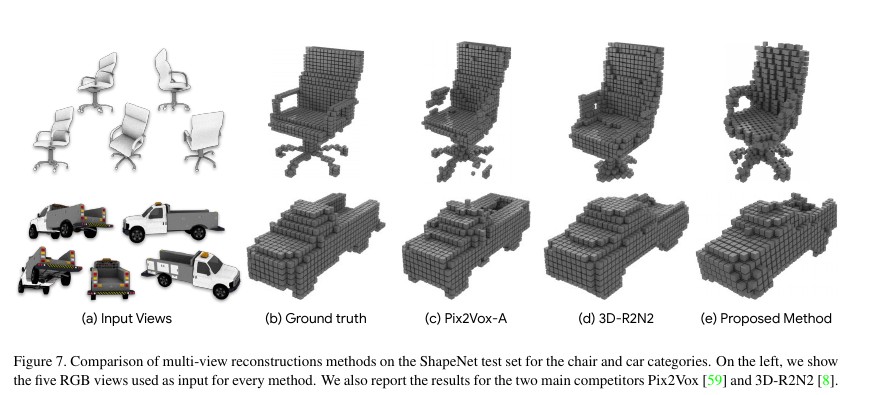
被遮挡区域本质上多解。直接回归完整形状容易输出训练集平均结构:例如图 1 的椅子底座即使在输入中清楚可见,canonical-shape 方法仍可能把它改回常见四腿椅。
SfM/MVS/SLAM 靠特征匹配;大基线、弱纹理、非重叠视图让对应点失效。电商商品图恰好经常是稀疏、独立拍摄的角度。
很多 learned reconstructor 默认所有训练物体朝同一方向,或推理时已知相机姿态。真实对象数据库通常不提供这样的坐标规范。
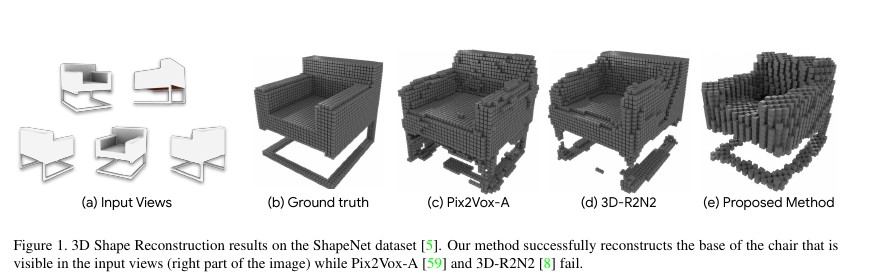
\(N\) 张同一物体 RGB 图像 \(\mathcal{I}=\{I_i\}_{i=1}^{N}\),每张都有二值 silhouette \(S_i\)。视图可能大基线、非重叠,旋转未知。
论文合成实验还已知相机内参 \(\pi\) 与固定平移 \(t^{\ast}\)。这两个条件在“无姿态”口号下仍然存在。
选择第一张图为 reference,求每张图相对该坐标系的绝对旋转 \(\hat q_i\),并生成同一坐标系下的 \(32\times32\times32\) occupancy volume。
输出不是纹理网格、点云或隐式曲面;测试时以阈值 \(\tau_r=0.3\) 二值化。
| 符号 | 含义 | 在流程中的位置 |
|---|---|---|
| \(\tilde q_{i,j}\) | 网络由 \(I_i\) 到 \(I_j\) 回归的单位四元数 | pairwise pose estimation |
| \(\hat q_i\) | 图优化后的第 \(i\) 个视图绝对旋转;\(\hat q_1\) 固定为单位旋转 | global rectification |
| \(V_t,D_t\) | 目标视图轮廓对应的三维点集与二维 distance transform | contour loss supervision |
| \(V(x)\) | 体素中心 \(x\) 在各视图 silhouette 中的加权支持度,范围 \([0,1]\) | soft occupancy construction |
| \(p_i^{\ast},\tilde p_i\) | 第 \(i\) 个体素的真值占用与 refiner 预测概率 | voxel BCE training |
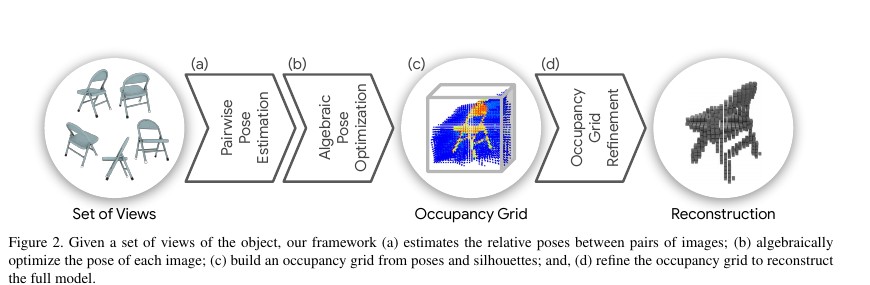
模块化带来清晰的可诊断性:姿态表可独立评估,图优化可直接消融,visual hull 先验可视化,refiner 的鲁棒性也能通过注入角度噪声单独测试。代价是误差逐级传播,而且不同模块分别训练,无法让最终重建损失反向校正姿态。
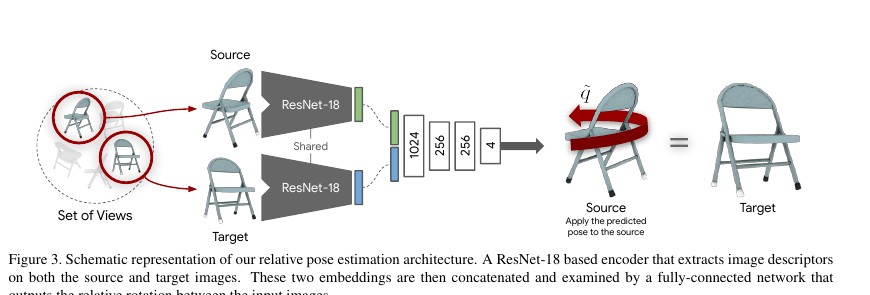
网络学习 \(\mathcal{N}(I_s,I_t)\rightarrow\mathbb{R}^{4}\)。论文对每个 3D 模型渲染五个随机视图,再把全部有序二元组作为训练样本。因此同一无序 pair 会出现两个方向,且网络并不显式保证 \(\tilde q_{s,t}=\tilde q_{t,s}^{-1}\);这一不一致留给下一阶段处理。
\(q^{\ast}\) 是 source 到 target 的真值相对旋转;\(v\in V_t\) 是目标轮廓上的三维点;先用真值把点从 target 变回 source,再用预测 \(\tilde q\) 转到 target,投影 \(\pi(\cdot)\) 后查询目标 distance transform \(D_t\)。落在目标轮廓上损失小。
这个写法避免直接拿 source contour 匹配 target contour,因为大基线遮挡会改变可见轮廓。但它仍有对称性局部极小值:汽车头尾的 silhouette 近似时,错误近 \(180^\circ\) 也可能有很小 contour loss。
Angular loss 提供明确方向信号,却会惩罚“视觉相同但标注旋转不同”的对称对象。Contour loss 作为视觉代理允许这种等价性。最终 \(\alpha=0.1,\ \beta=0.9\),说明数值权重并不能直接解释哪项更重要;两种损失尺度不同,而消融显示 angular-only 远强于 contour-only。
变量是每张图的绝对旋转 \(\hat q_i\)。由它们诱导的相对旋转 \(R(\hat q_j)R(\hat q_i)^{-1}\) 应接近网络对该有向边的预测。固定第一视图为 identity 消除全局旋转 gauge freedom;Ceres 用 Cholesky solver 求解 over-determined least squares。
正反向边不互逆、三角 cycle 不闭合、单条边的随机预测噪声。所有边共同决定每个 node pose,因此冗余视图提供平均化作用。
目标中没有 silhouette reprojection、图像光度或置信度;所有 pair 默认同等可信。若许多边系统性错误,图优化只会得到“最一致的错误”。
作者称旋转矩阵差优于直接 angular difference,并引用 rotation representation 研究作理论背景;正文只报告最终数值对比,没有给出两种优化目标的独立表格。
对每个体素中心 \(x\),将其按第 \(i\) 个优化姿态投影到 silhouette:若投影在物体内,\(S_i=1\),否则为 0。加权平均让 \(V(x)\) 成为多视图支持率,而不是传统 visual hull 的硬 intersection。参考视图 \(w_1\) 高于其余相等权重,因为输出必须与它对齐;论文没有公开具体 \(w_1\) 数值。
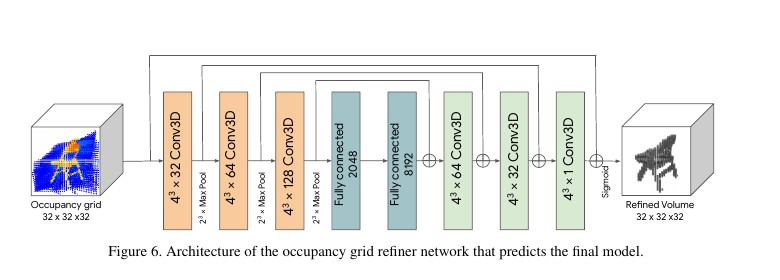
论文公式排版漏写了常见 BCE 的负号,却称其“minimize binary cross entropy”;按语义必须取负。本页将该项写成可被最小化的标准形式,并把这一区别标为解释性修正。真值先旋转到 reference view,再 voxelize 为 \(32^3\)。测试时 sigmoid 概率以 0.3 阈值二值化。
| 部分 | 论文公开设置 | 仍缺失 |
|---|---|---|
| Dataset | ShapeNetCore.v1;airplane、car、chair;pose split 复用 [17,45],shape split 复用 [8,59] | 每类确切 train/val/test 数量未在本文列出 |
| Rendering | 每模型 5 视图;azimuth 均匀采样 \([0^\circ,360^\circ)\),elevation 均匀采样 \([-20^\circ,40^\circ]\);光源位置随机;固定相机距离 | 分辨率以外的 renderer 参数、背景、焦距数值未给 |
| Pose model | ResNet-18 siamese;224×224 RGB;batch 24;Adam;固定 LR 0.001;\(\alpha=0.1,\ \beta=0.9\) | epoch/steps、Adam betas、weight decay、初始化、augmentation、GPU/训练时间 |
| Refiner | 输入输出 \(32^3\);5 视图;随机 reference;GT pose 加最大 \(10^\circ\) 扰动;batch 16;Adam;固定 LR 0.001 | 训练长度、reference 权重 \(w_1\)、noise 分布细节、类别采样 |
| Inference | 所有有向 pair → Ceres/Cholesky → soft occupancy → refiner → 0.3 threshold;主比较统一使用 5 视图 | 运行时间、内存、失败处理、silhouette 获取方法 |
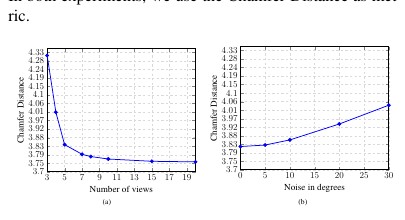
Refiner 训练时使用 ground-truth poses 再人工加最多 \(10^\circ\) 噪声,测试时输入 pose network + graph optimization 的真实误差分布。补充材料表明 median 约 \(5^\circ\),且随机最大噪声到 \(15^\circ\) 时性能平滑下降,但这仍不是对真实相关误差、类别混淆或 outlier edge 的完全建模。
| 方法 | Airplane | Car | Chair | Mean | ||||
|---|---|---|---|---|---|---|---|---|
| Acc ↑ | Med° ↓ | Acc ↑ | Med° ↓ | Acc ↑ | Med° ↓ | Acc ↑ | Med° ↓ | |
| GT poses [45] | 0.79 | 10.70 | 0.90 | 7.40 | 0.85 | 11.20 | 0.85 | 9.77 |
| MVC [45] | 0.69 | 14.30 | 0.87 | 5.20 | 0.81 | 7.80 | 0.79 | 9.10 |
| DPCD [17] | 0.75 | 8.20 | 0.86 | 5.00 | 0.86 | 8.10 | 0.82 | 7.10 |
| Ours | 0.79 | 6.40 | 0.93 | 3.10 | 0.85 | 7.00 | 0.86 | 5.50 |
| – without optimization | 0.79 | 6.49 | 0.92 | 3.32 | 0.85 | 7.18 | 0.86 | 5.66 |
| – one net all categories | 0.77 | 6.80 | 0.90 | 3.40 | 0.82 | 6.80 | 0.83 | 5.70 |
准确率指角误差低于 \(30^\circ\) 的 pair 比例。Ours 平均 accuracy 0.86、median \(5.50^\circ\),相对 DPCD 的 median 改善 \(1.60^\circ\);论文正文写 raw prediction 比 state of the art 好 \(1.44^\circ\),对应 7.10 − 5.66。图优化只再改善 \(0.16^\circ\),说明主要收益来自相对旋转建模,优化是小而一致的修正。
| 方法 | Airplane | Car | Chair | Mean | ||||
|---|---|---|---|---|---|---|---|---|
| IoU ↑ | CD×100 ↓ | IoU ↑ | CD×100 ↓ | IoU ↑ | CD×100 ↓ | IoU ↑ | CD×100 ↓ | |
| 3D-R2N2 | 0.585 | 3.77 | 0.851 | 3.58 | 0.575 | 4.21 | 0.670 | 3.86 |
| Pix2Vox | 0.723 | 3.20 | 0.876 | 3.54 | 0.612 | 3.77 | 0.737 | 3.50 |
| Ours | 0.538 | 4.81 | 0.627 | 3.93 | 0.510 | 4.75 | 0.559 | 4.50 |
| – with GT poses | 0.654 | 3.85 | 0.659 | 3.63 | 0.592 | 4.06 | 0.635 | 3.85 |
| – in Canonical | 0.732 | 2.92 | 0.874 | 3.51 | 0.648 | 3.39 | 0.751 | 3.28 |
完整 pipeline 的 mean IoU 0.559 明显低于 Pix2Vox 0.737,CD 4.50 也更差。给 GT pose 后到 0.635 / 3.85,说明姿态误差解释了相当部分差距;切到 canonical task 后达到 0.751 / 3.28,超过两条 baseline。这个实验支持“重建器在相同坐标条件下有竞争力”,却不能把 full pipeline 宣称为数值 SOTA。
| Angular | Contour | Accuracy ↑ | Median° ↓ |
|---|---|---|---|
| ✕ | ✓ | 0.45 | 78.23 |
| ✓ | ✕ | 0.84 | 8.24 |
| ✓ | ✓ | 0.86 | 5.50 |
Contour-only 基本失败,证明它不能独自解决大旋转和形状对称;angular-only 已经很强。两者结合 accuracy 增 0.02、median 减 \(2.74^\circ\)(正文写 2.77°,按表值 \(8.24-5.50=2.74\)),支持视觉轮廓作为 regularizer,而非主监督信号。
mean median 从 5.66° 到 5.50°,accuracy 仍为 0.86。它有效,但幅度小;没有与 robust loss、edge confidence 或 sparse graph 比较。
单网络覆盖三类时 mean accuracy 从 0.86 降至 0.83,median 从 5.50° 变 5.70°。证明可共享,但仅三类。
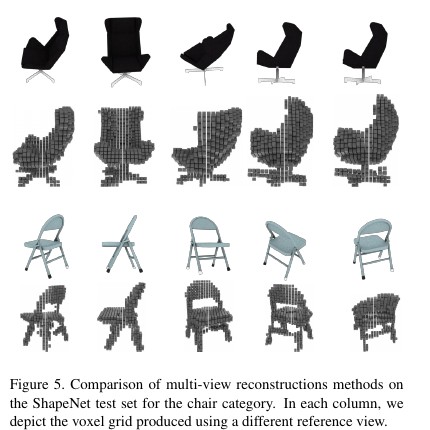
补充 Figure 5 显示选择不同 reference 会改变可见细节;系统并非旋转等变,结果质量依赖参考视图中结构是否清楚。
| 结论 | 证据 | 判断 |
|---|---|---|
| 相对 pose 优于 absolute-pose baselines | Table 1,三类 ShapeNet,相同 pose protocol | 在该合成 protocol 内支持较强 |
| 图优化改善姿态 | 5.66° → 5.50° | 支持,但增益有限 |
| full pipeline 与 SOTA “on par” | 0.559 IoU vs 0.737 Pix2Vox | 数值不支持直接等价;任务难度不同只能解释,不是控制变量 |
| canonical reconstruction framework 更好 | 0.751 / 3.28 超过 baselines | 支持同坐标设置下的竞争力;真值分辨率差异仍需谨慎 |
| 可扩展到真实 AR/robotics | 只有合成 ShapeNet | 属于作者动机,未被实证 |
pose network 同时输出 quaternion 与 uncertainty,以 robust rotation averaging 降低对称物体和错误 pair 的影响;对 graph cycle residual 做显式诊断。
以 SDF、occupancy network、triplane 或 3D Gaussian 替代 dense voxel,让 silhouette cone 提供空间约束,神经场只补足分辨率与遮挡。
通过可微渲染让 silhouette、RGB、surface normal 与重建损失共同更新 pose 和 shape;保留模块接口,同时允许 end-to-end correction。
显式建模 segmentation error、不同焦距、背景遮挡与光照变化;用 synthetic-to-real adaptation 和 calibrated confidence 评价失败概率。
把 reference 从固定第一张改成以 coverage、sharpness 与 pose uncertainty 评分的离散选择,或在多个 reference 输出间做一致性融合。
将多视图 silhouette 换成多条件 render observations:每个材质图候选产生不同光照与视角渲染,再用图优化聚合相容证据,refiner 对应 graph repair / parameter optimization。此为研究延伸,论文未验证。
应同时报告 rotation error、translation/intrinsic error、silhouette reprojection、surface CD/F-score、thin-structure recall、真实照片泛化、相机数量曲线与运行成本;baseline 必须在相同 unknown-pose 条件下运行。还需把 pose oracle、silhouette oracle、reference oracle 与 representation oracle 分开,避免把 task mismatch 当成方法优劣。