ACE++
本页对象
2025 年图像生成与编辑方法,核心是 LCU++、FLUX 后训练与 content filling。
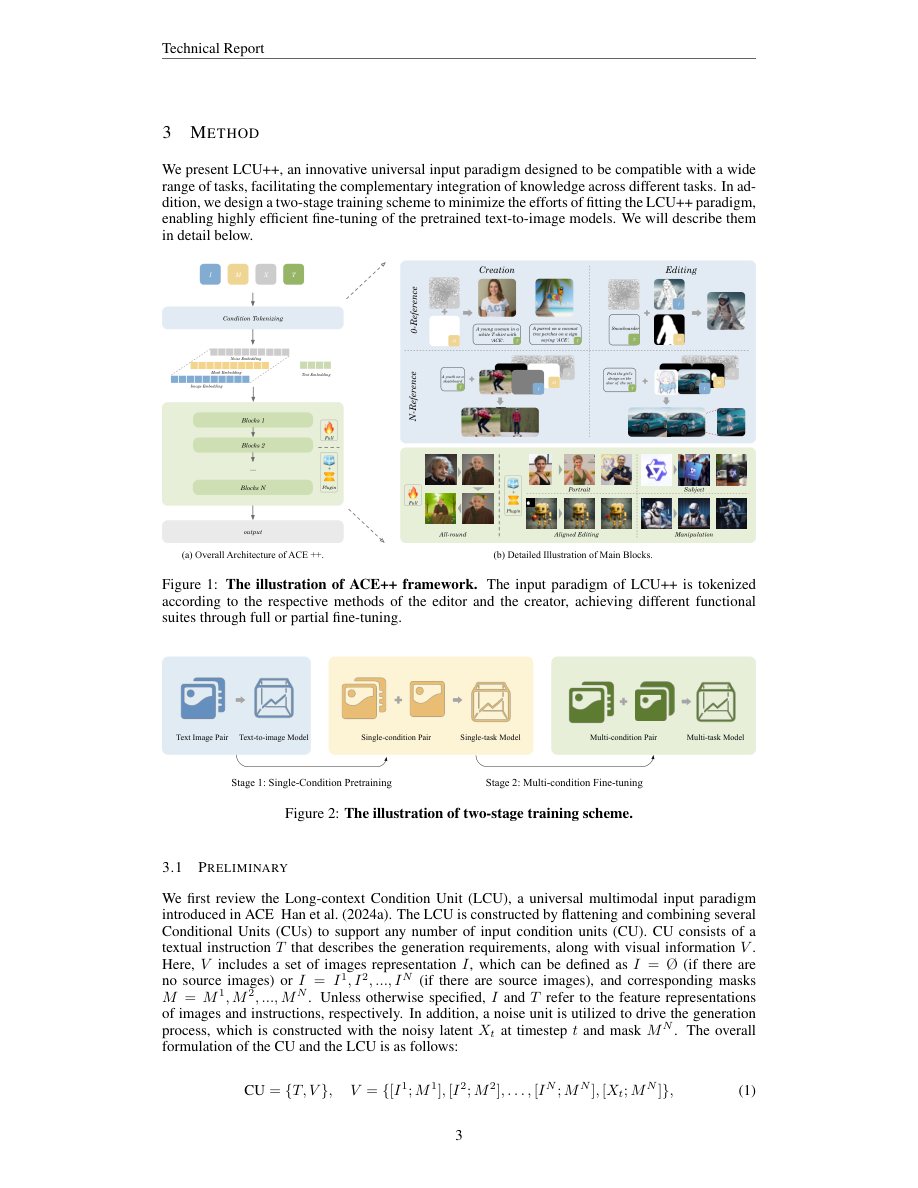
统一编辑的关键,不是再造一套大模型,而是把参考图、编辑图、mask 与噪声改写成同一种“待填内容”。
ACE++ 把 ACE 的 Long-context Condition Unit 从主要依赖序列拼接,改成先在通道维合并图像、mask 与 noisy latent,再把多个 condition unit 作为序列送入 FLUX Transformer。这个结构使 0-reference 任务能贴近现成 inpainting 模型,也让 N-reference 任务保留统一接口。
2025 年图像生成与编辑方法,核心是 LCU++、FLUX 后训练与 content filling。
ICLR 2025 的 All-round Creator and Editor,提出 CU / LCU 与八类任务;ACE++ 继承其数据和任务定义。
不是 Anti-Editing Concept Erasure,也不是其他以 ACE 为缩写的概念擦除工作。
本页以 arXiv v3 的 13 页 technical report 为方法、公式与完整尺寸图像的主证据;另逐页核对 CVF 正式 9 页版本,方法、公式、实现细节及只有 qualitative results 的证据结构一致。正式发表身份为 ICCV 2025 HiGen Workshop,页码 1979–1987。官方项目页与代码仓库用于核对公开模型、推理参数与后续实现状态。
ACE、OmniGen、UniReal 等希望用一个模型接收文字、图像与 mask,覆盖生成、局部编辑、参考生成和多轮任务。但新增视觉条件往往变成额外 token sequence,改变了文本到图像基础模型已经学好的 attention 上下文,并增加序列长度与后训练成本。
ControlNet、inpainting、身份保持等方法容易继承强 T2I 模型,却通常为单一任务设计。它们能低成本适配,却不能自然表达“参考物体 + 待编辑图 + 局部 mask + 指令”的组合。
核心直觉:FLUX.1-Fill-dev 已经证明,编辑图、mask 与 noisy latent 可以在通道维合并后复用强生成先验。ACE++ 将这个 fill 格式推广到每个 condition unit,再沿序列维连接多个 unit,试图同时得到“单个 unit 的低扰动适配”和“多个 unit 的长上下文组合”。
| 维度 | ACE | ACE++ | 实际意义 |
|---|---|---|---|
| 基本单元 | 文字 \(T\) 与若干 \([I;M]\),另含 noisy target \([X_t;M]\) | 每个 unit 将 \(I\)、\(M\)、\(X_t\) 在 channel 维组成同一 feature map | 把编辑看作 content filling,x-embed 直接接收完整空间上下文 |
| 多个条件 | 视觉条件与目标常作为额外 sequence | unit 内 channel concat;unit 之间 sequence concat | 既保留多参考图,又减少 0-ref 的序列扰动 |
| 基础模型 | ACE 自有 DiT 系列 | FLUX.1-dev / FLUX.1-Fill-dev | 更直接继承强 T2I 与 inpainting 先验 |
| 训练 | 八类任务统一训练 | 0-ref 预训练,再以全部 ACE 任务做 multi-condition fine-tuning | 先学“怎样填”,再学“参考什么来填” |
| 公开套件 | 统一模型 | 全量 FFT + portrait / subject / local-editing LoRA | 论文写四个 vertical domain,当前仓库实际列出三类 LoRA |
一次请求可包含指令 \(T\)、待编辑图 \(I^{\mathrm{edit}}\)、编辑区域 \(M^{\mathrm{edit}}\)、零到多张参考图 \(I^{\mathrm{ref}}_i\),以及目标画布上的 noisy latent \(X^o_t\)。输出是去噪后的目标图 \(I^o\)。mask 指定哪些位置需要生成;无待编辑图的 reference generation 可把目标底图设为全零。
0-reference:没有独立参考图;待编辑图、mask 与 noisy target 在同一个 unit 内完成 channel 拼接。
ACE++ 采用 FLUX 的 rectified-flow / velocity prediction 形式。论文以线性插值从起点样本 \(x_0\) 构造到数据样本 \(x_1\) 的路径;在时间 \(t\) 上,模型预测速度 \(v_t\),监督速度为 \(u_t=\mathrm{d}x_t/\mathrm{d}t\)。
对 editing,最后一个输入样本 \(I^N\) 是待编辑图;对 reference generation,最后一个输入样本是全零画布。mask 决定需要填充的区域,因此局部编辑与整图再生成可由同一采样过程表达。
| 项目 | 论文值 | 解释与边界 |
|---|---|---|
| Base | FLUX.1-dev;垂直模型以 FLUX.1-Fill-dev 初始化 | 参数量沿用 FLUX,论文没有单列总参数和可训练参数数 |
| Optimizer | AdamW | weight decay \(10^{-2}\),gradient clip 的 L2 threshold 为 \(1.0\) |
| Learning rate | \(10^{-3}\) | 论文未区分 FFT 与 LoRA;当前 FFT config 实为 \(5\times10^{-5}\) |
| Guidance during training | \(\omega=1.0\) | 配合 FLUX guidance distillation;conditional prediction 不再额外放大 |
| Unconditional probability | (0.1) | 混合 unconditional / conditional training |
| 未公开 | 数据量 / split / GPU / 时长 / batch / steps | 不能从正文推断;仓库默认只能视为后续参考实现 |
官方脚本把 reference image、edit image、edit mask、prompt 统一传入 pipeline。当前仓库默认输出 \(1024\times1024\),采用 flow_euler、28 steps、guidance scale 50;seed 为 \(-1\) 时由 pipeline 选择。LoRA 推理还暴露 repainting_scale,默认 1.0,并要求从 portrait、subject、local_editing 三个 task type 选择 adapter。
这些是提交 f3e410b 的公开实现默认值,不是论文实验节完整报告。论文没有说明 temperature、top-k、beam、reranking、样本数或 best-of-N;这些语言模型式参数也不适用于其 flow sampler。
| 任务 | 必需输入 | 目标 unit | 公开模型建议 |
|---|---|---|---|
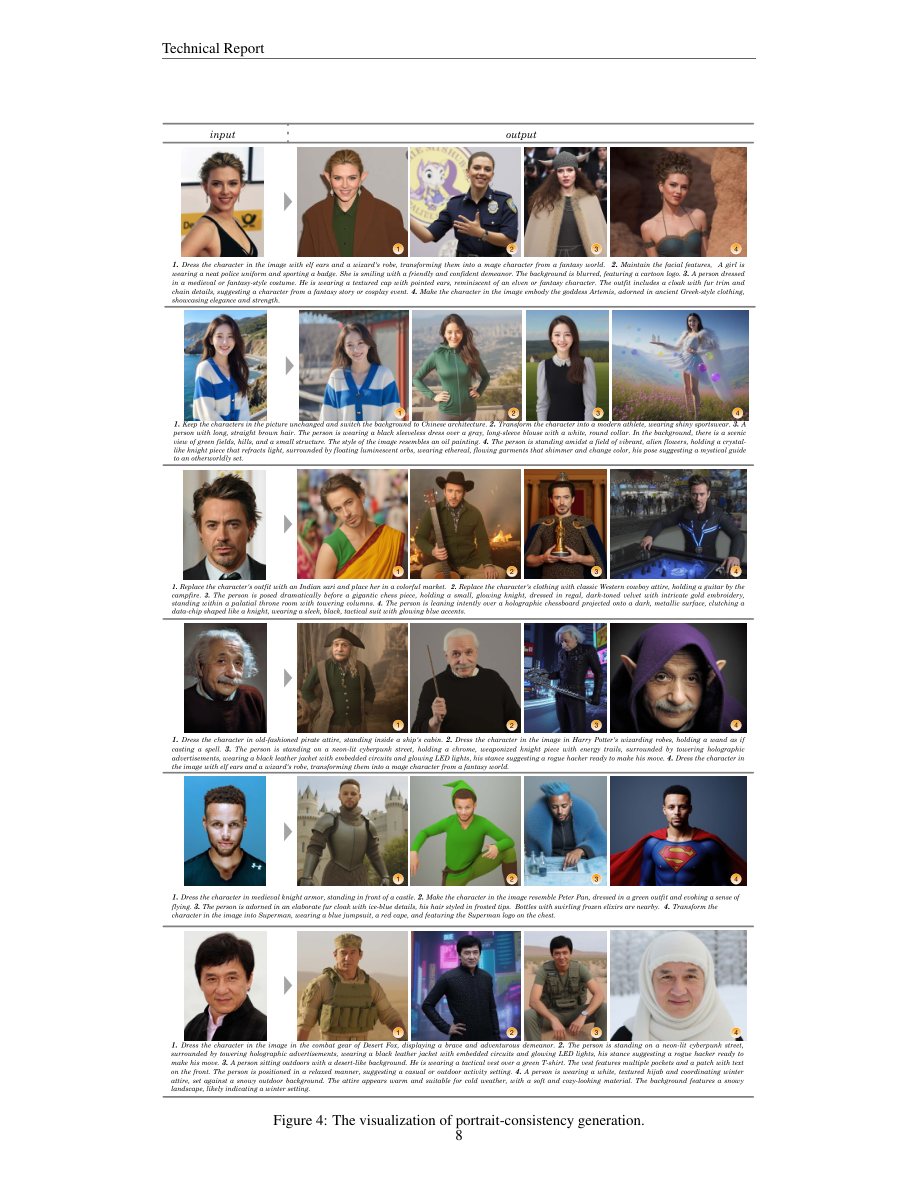
| Portrait generation | 人脸参考图 + 指令 | 全零 target + 全图 mask | Portrait LoRA |
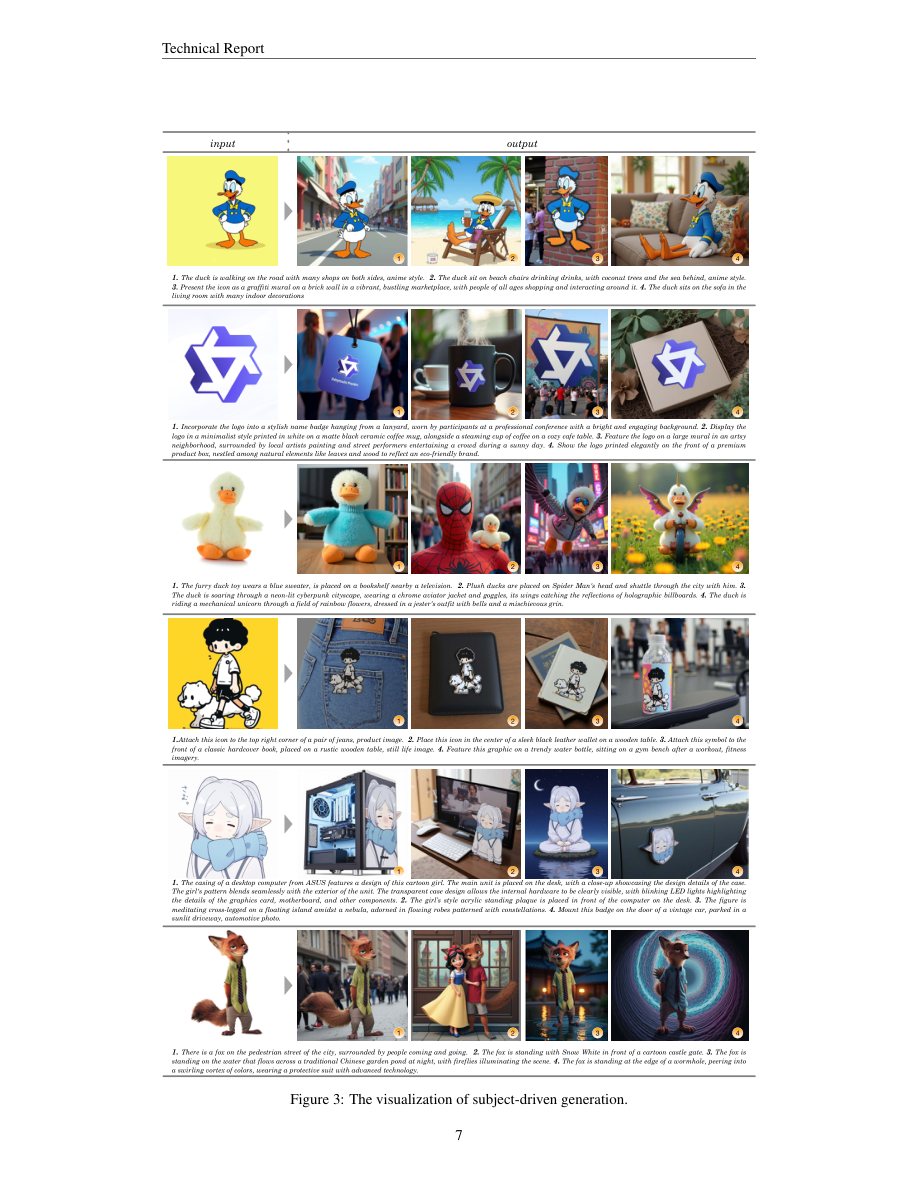
| Subject generation | 物体 / logo 参考图 + 指令 | 全零 target | Subject LoRA |
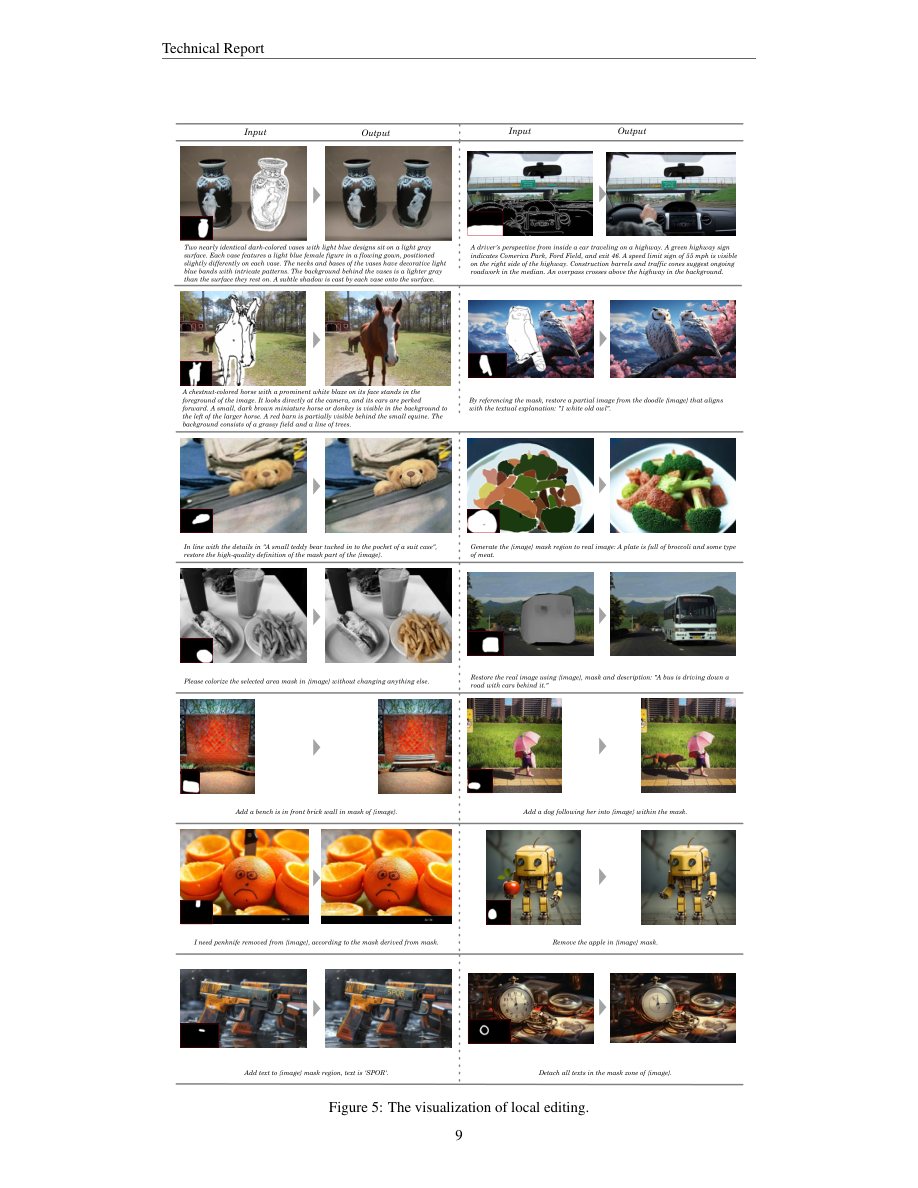
| Local editing | 编辑图 + 局部 mask + 指令 | 保留非 mask 区域,生成 mask 区域 | Local Editing LoRA |
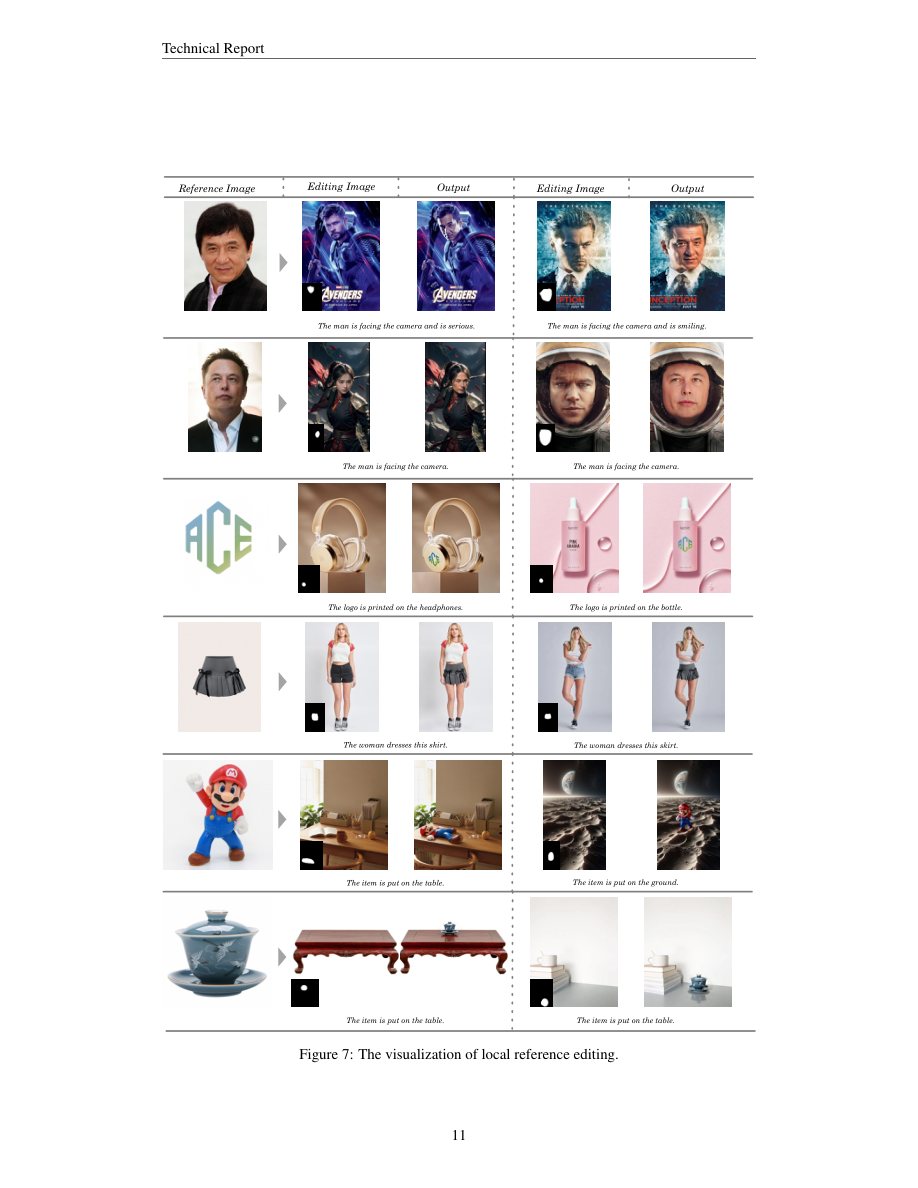
| Local reference editing | 参考图 + 编辑图 + mask + 指令 | 以参考身份填入指定区域 | Subject / Portrait LoRA 或 FFT |
| General editing | 编辑图 + 指令,可带 mask | 局部或全局再生成 | FFT,仓库同时警告其稳定性较弱 |
| 项目 | 论文 | 仓库提交 f3e410b | 审计结论 |
|---|---|---|---|
| 模型形态 | general FFT + 四个 vertical domain | FFT + portrait / subject / local-editing 三类 LoRA | image variation 没有独立 adapter;论文与公开产品枚举不完全一致 |
| FFT 输入 | LCU++ 的 channel concat | 在 FLUX-Fill 384 channels 上额外增加 64 channels,变为 448;用于区分 repainting 与 editing,并容纳 edit-image latent | 这是 README 才写清的关键实现细节 |
| 学习率 | \(10^{-3}\) | FFT \(5\times10^{-5}\);LoRA \(10^{-3}\) | 复现时应按所选 config,不能把论文单值直接用于 FFT |
| 训练默认 | 大量细节未报 | 100k steps、batch 1、bf16、FSDP、cosine、zero warmup、max sequence 2048、seed 1999 | 是当前代码默认,不证明原论文实验使用完全相同 recipe |
| LoRA | lightweight strategy | rank 64、alpha 64、dropout 0;目标覆盖 double / single blocks 的 attention、MLP 与 modulation | 公开配置允许训练,但没有公开原训练数据 |
| 数据 | ACE 收集的全任务数据 | train.csv/eval.csv 仅各含 6 个演示样例,字段为 edit_image、edit_mask、ref_image、target_image、prompt、data_type | 示例 CSV 不是论文数据集,无法从仓库独立重现报告模型 |
| FFT 质量 | 定性称表现优越 | README 后续公告称异质数据使 FLUX post-training 高度不稳定,蒸馏模型 negative prompt 影响不明;FFT 在多任务上弱于 LoRA,推荐 LoRA | 作者自己的后续披露,应视为论文结论的重要限制 |
| 已知失败 | 正文未单列 limitation | 物体删除 / 添加的 instruction following 有缺陷;手部常有 artifact | 对开放式编辑的可靠性不能只看成功样例 |
论文没有公开 ACE++ 所用数据规模、构造流程细节、完整 prompt 模板、两阶段各自步数、GPU 数、训练时长、随机种子、评测集或定量指标。官方仓库提供训练框架与示例行,但不含原训练 corpus,因此不能声称端到端复现了论文。
| 比较 | 应测什么 | 它能回答什么 |
|---|---|---|
| sequence concat vs channel concat | 训练 FLOPs、显存、收敛步数、编辑质量 | LCU++ 是否真降低适配成本,而非只换了接口 |
| 无 \(\mathcal{L}_{\mathrm{ref}}\) | identity / subject similarity | reference reconstruction 是否带来 context awareness |
| single-stage vs two-stage | 同预算下多任务平均与最差任务 | 阶段设计是否优于直接混合训练 |
| FFT vs task LoRA | 每任务质量、训练成本、吞吐 | 通用性与垂直稳定性的真实 trade-off |
| 0 / 1 / N references | 随参考数增加的 fidelity 与干扰 | LCU++ 是否能扩展长上下文,而不发生条件冲突 |
为每个 unit 学习 relevance gate,避免多参考图在 full attention 中互相污染;用 counterfactual mask 验证每个 reference 是否真正被使用。
按 mask 外保持、身份相似、文字一致性建立组合 reward,对 seed 与 repainting scale 做低成本搜索;这直接针对仓库承认的不稳定性。
把 segmentation、OCR、pose 或 depth verifier 放入闭环:发现文本拼写、手部或结构失败后,仅重采样相应区域。
f3e410b835920c9b2d254a1ebba471db79c92ec6;模型公告、训练与推理配置、公开限制。核查日期:2026-09-26。本文所有性能判断均按论文证据强度标注;未独立下载模型权重或运行 FLUX 推理,未把官方挑选样例当成独立复现。