13
残差注入位置
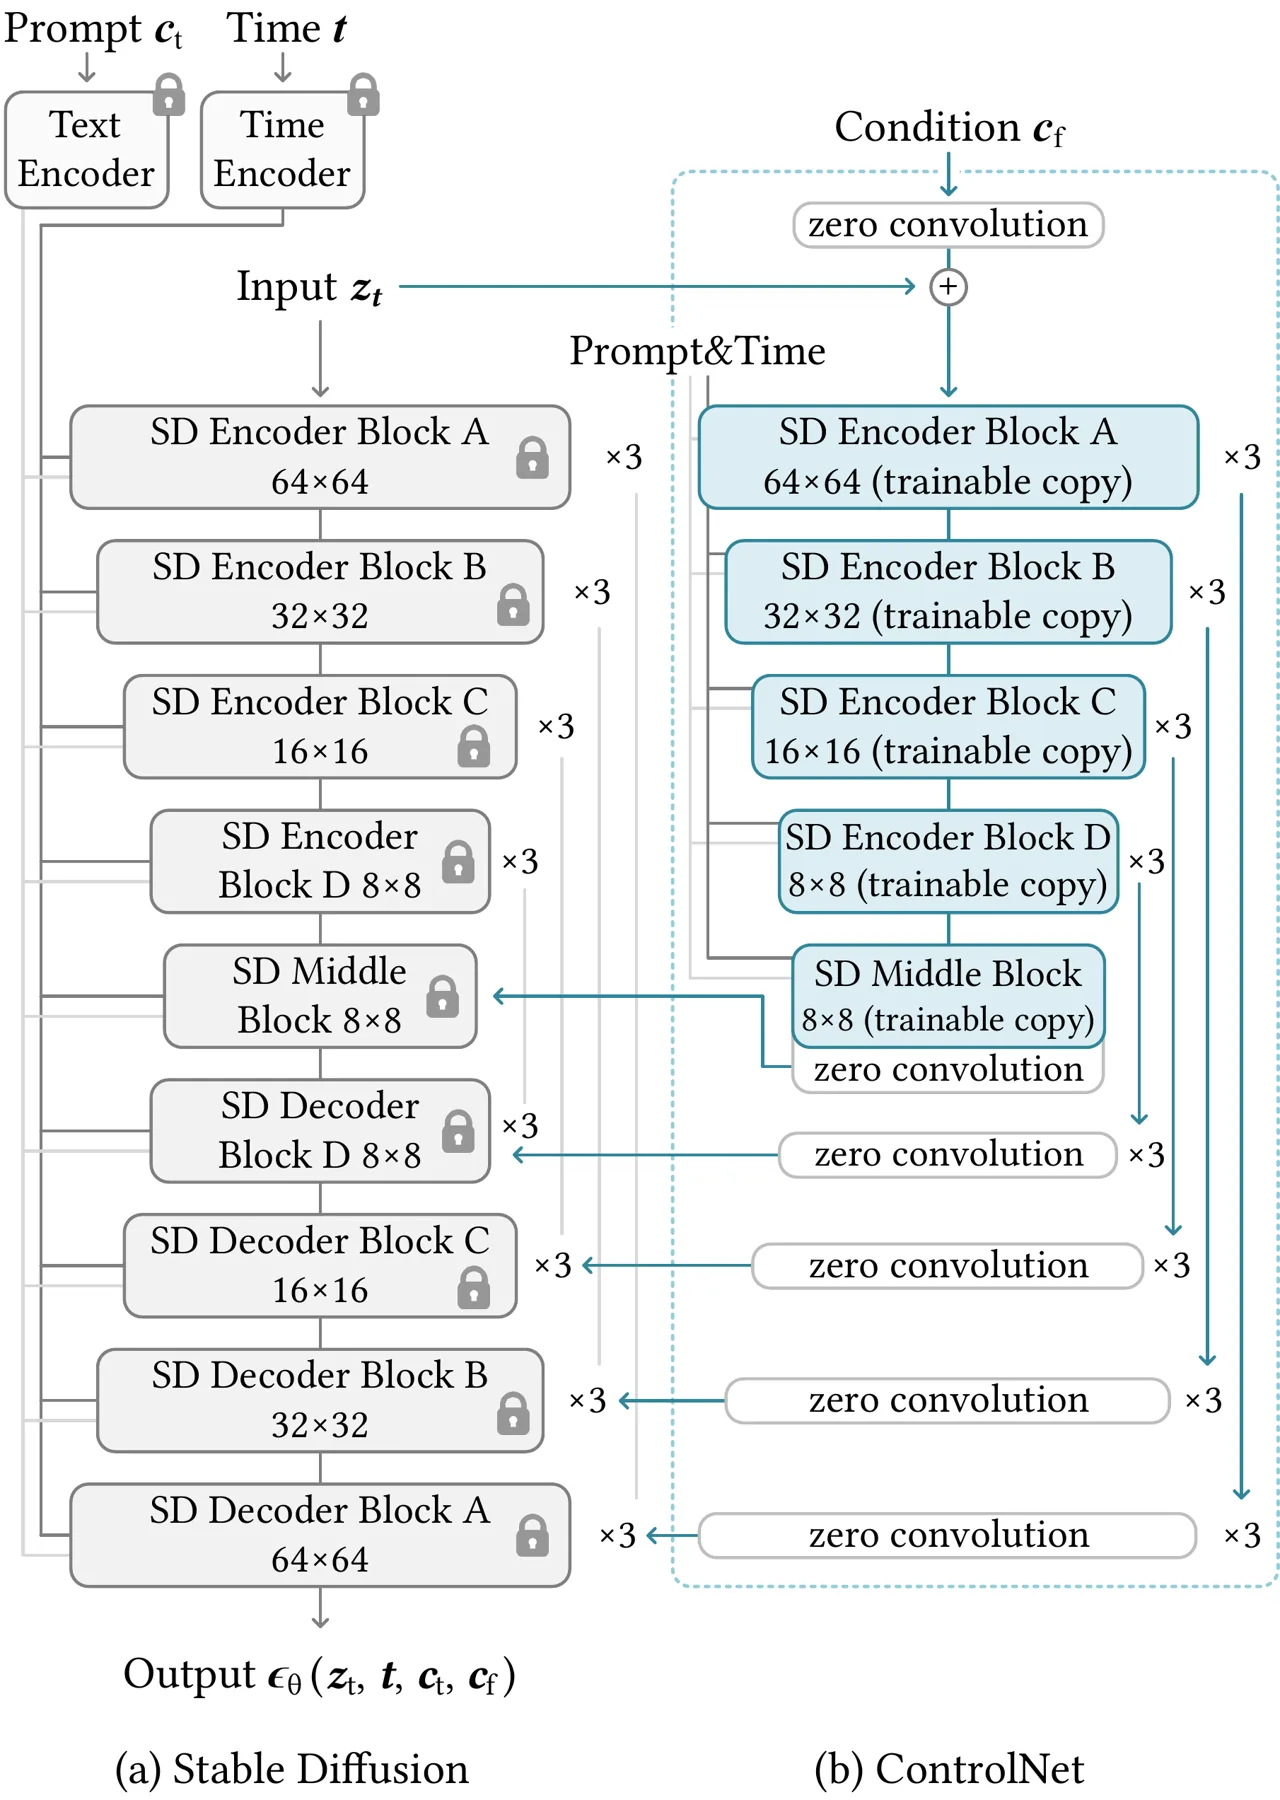
复制 Stable Diffusion U-Net 的 12 个 encoder blocks 与 1 个 middle block,输出逐尺度加到冻结 U-Net 的 skip / middle features。
冻结一个已经会画画的扩散模型,再复制它的编码器,让空间条件从零开始、逐层长进网络。
ControlNet 的影响力来自一个很实用的系统答案:如何把边缘、深度、姿态、分割等像素对齐的条件接入 Stable Diffusion,同时尽量不破坏原模型已经学到的生成能力。它的关键不只是“加一条支路”,而是深度副本、13 路残差注入与 zero convolution 的组合。
复制 Stable Diffusion U-Net 的 12 个 encoder blocks 与 1 个 middle block,输出逐尺度加到冻结 U-Net 的 skip / middle features。
A100 PCIe 40GB 上,相对直接优化 Stable Diffusion,论文测得显存约增加 23%,每 iteration 时间约增加 34%。
Canny scale test 从 1K 到 3M。1K 不会训练崩溃,但只证明单个示例上还能形成可识别结果,不等于小数据全面泛化。
论文身份。CVF Open Access 的 ICCV 2023 camera-ready 为 12 页;另有 33 页官方 supplementary。正文与 arXiv 源文件一致。IEEE 正式 DOI 为 10.1109/ICCV51070.2023.00355,会议记录页码为 3836–3847。
核查材料。本文逐页读取正文与补充材料,并核对官方 GitHub 仓库在 2023-09-09 的提交 ed85cd1。网页中的“论文设置”与“发布代码默认值”分别标注;后来的 ControlNet 1.1、Diffusers 重实现和 WebUI 插件不倒灌成原论文设定。
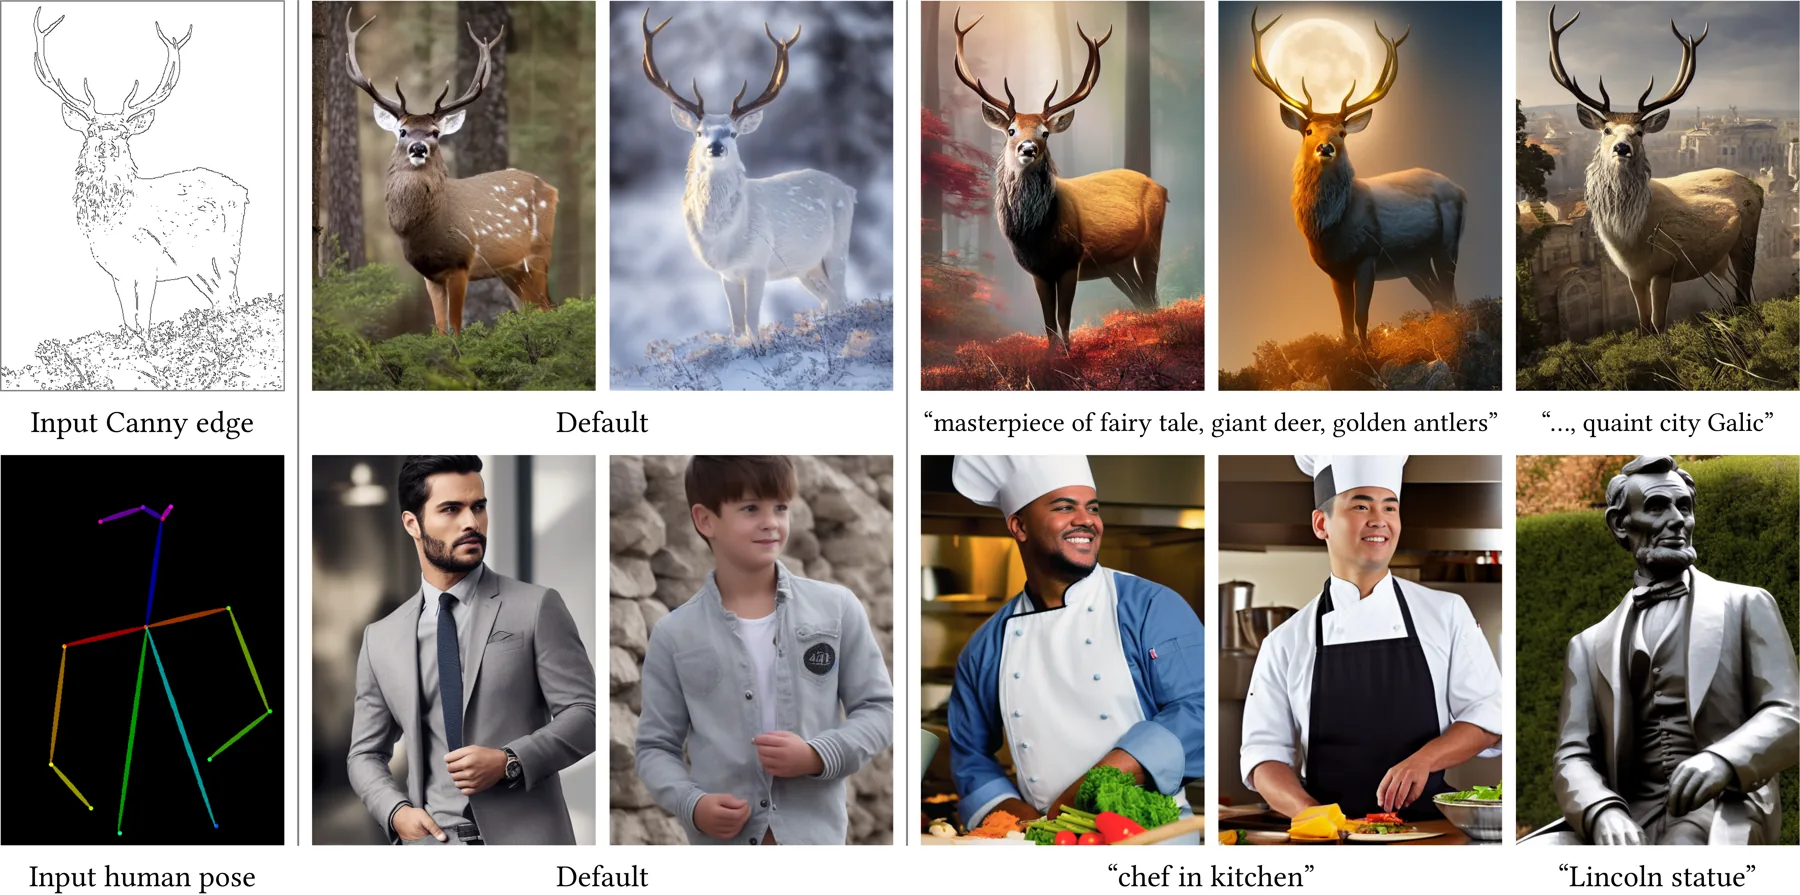
用户很难只靠 prompt 指定人体关节、轮廓、透视直线或语义区域。反复改词仍无法稳定复现同一构图。
特定控制任务常只有约 \(10^5\) 对数据,远小于 Stable Diffusion 背后的 LAION-5B 规模。全量继续训练可能过拟合、mode collapse 或 catastrophic forgetting。
空间条件含局部细节与高层语义。只加浅卷积,可能不足以解释“这几条线是一栋房子”或“这组点是一种人体姿态”。
冻结生成模型保存画质;复制其深 encoder 复用语义能力;以初始为零的残差连接让新路径平稳介入。
ControlNet 与 DreamBooth 的目标不同:后者让模型记住新主体或风格,本文让模型在每次采样时读取一张空间条件图。它也不同于只改 cross-attention 的 prompt editing,因为 condition 在多个 U-Net resolution 直接进入空间 feature maps。
一个训练样本是三元组:目标 RGB 图像、文字 caption、与目标图像空间对齐的 condition image。条件图可能是从目标图像用 Canny、MiDaS、OpenPose 等 detector 自动提取,也可能是分割标注或合成 scribble。VAE 把 \(512\times512\) 目标图编码为 \(64\times64\times4\) latent;文本由冻结 CLIP text encoder 编码。
输出。训练时输出噪声估计;推理时 DDIM 反复调用它,从随机 latent 逐步去噪,再由 VAE decoder 得到 RGB 图像。ControlNet 本身不是一个独立 image generator,也不输出 edge 或 depth。
优化变量。默认只训练 ControlNet 副本、hint encoder 和 zero convolutions。原 Stable Diffusion U-Net、VAE 与 text encoder 冻结。官方代码的 sd_locked=False 会额外解锁原 U-Net decoder/output blocks,但这属于可选训练模式。
先看一个抽象 block。预训练 block \(\mathcal{F}(\cdot;\Theta)\) 把 feature map \(x\in\mathbb{R}^{h\times w\times c}\) 映射为:
ControlNet 冻结 \(\Theta\),复制出可训练参数 \(\Theta_c\),并使用两个 zero convolutions \(\mathcal{Z}\) 接入条件与输出:
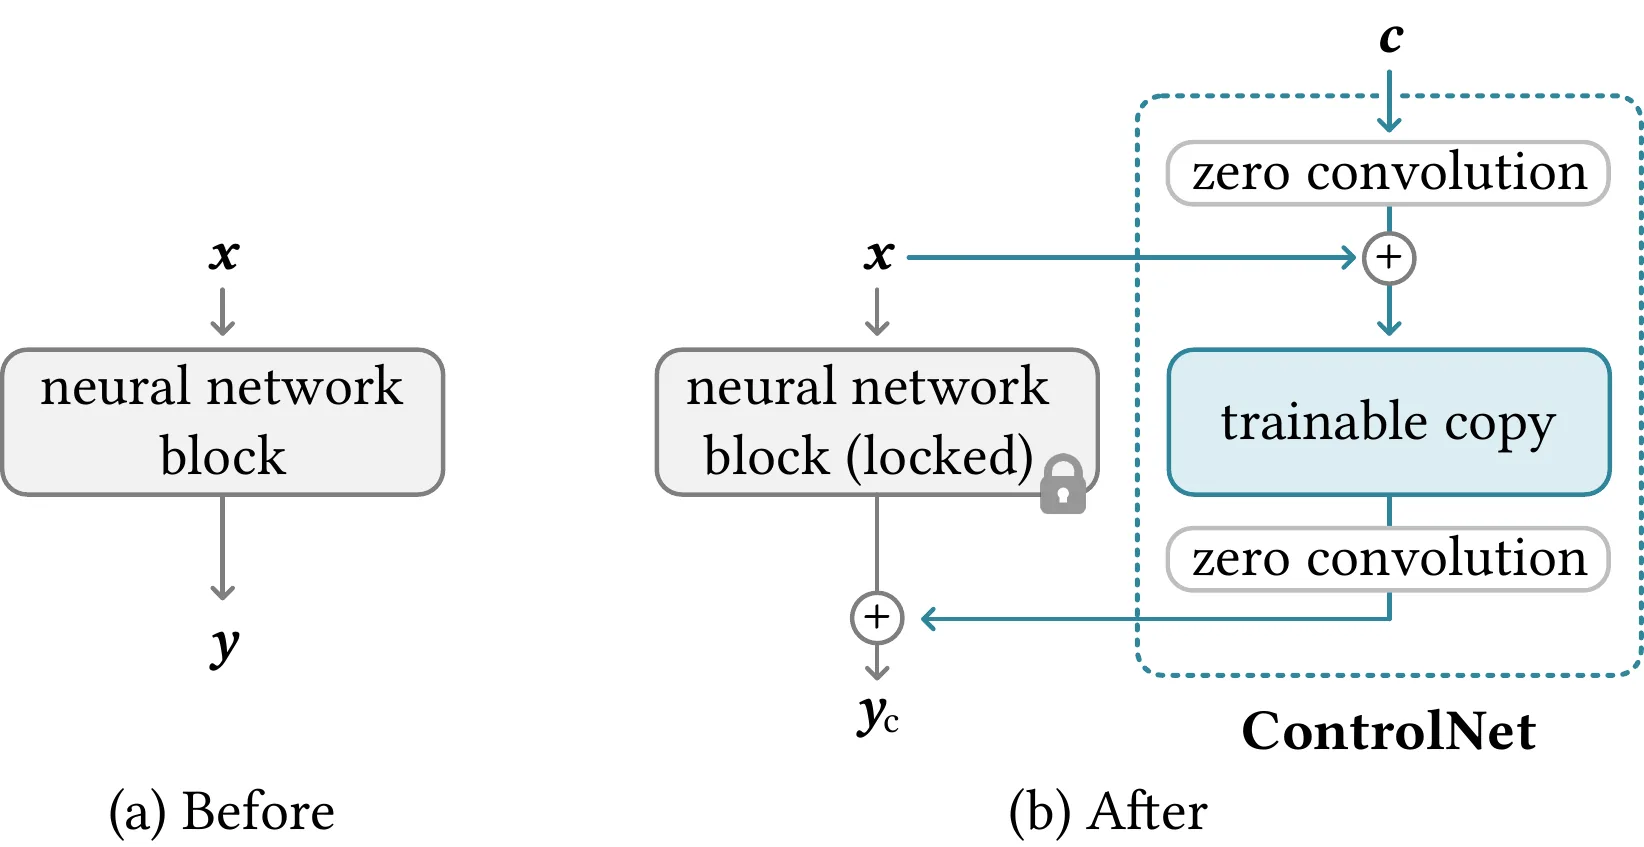
论文把 SD U-Net 描述为 encoder 12 blocks、middle 1 block、decoder 12 blocks,共 25 blocks。ControlNet 复制 encoder 的 12 blocks 和 middle block;四个 spatial scales 是 \(64\times64\)、\(32\times32\)、\(16\times16\)、\(8\times8\),每级 3 个输出。13 个 ControlNet outputs 分别注入 12 条 decoder skip connections 与 middle feature。
这解释了为什么它比一个浅 adapter 重:训练支路几乎复制了半个 U-Net,仍包含 ResNet 与 spatial transformer/cross-attention。原 encoder 在 torch.no_grad() 中运行,不保存 backward activations;因此参数量明显增加,但训练显存不是简单翻倍。
论文正文写四个 \(4\times4\)、stride 2 的卷积,通道为 16、32、64、128,ReLU 激活,并称把 \(512\times512\) 条件图编码到 \(64\times64\) feature。这里原文本身算术不自洽:四次 stride 2 会得到 \(32\times32\),而三次才是 \(64\times64\)。发布代码确实只有三次下采样:
对 \(1\times1\) convolution,在位置 \(p\)、输出通道 \(i\) 上:
令 \(W=0,B=0\)。三个局部导数是:
所有主要模型的共同设置是 learning rate \(10^{-5}\)、不使用 EMA;多数 batch size 为 32。训练中随机把 50% text prompts 替换为空字符串,迫使 ControlNet 不能总靠 caption 猜语义,而要从 condition image 自身识别内容。优化器类型正文/补充材料未写;官方代码使用 AdamW,但未显式写 betas、weight decay 或 scheduler,所以不能把 PyTorch 默认值当作论文已报告超参。
| Condition | 数据 / 来源 | 计算 | Base / 初始化 | batch |
|---|---|---|---|---|
| Canny edge | 3M Internet;随机 Canny thresholds;网页 caption | 约 600 A100 80GB GPU-hours | SD 1.5 | 32 |
| Hough / M-LSD line | 600K Places2;BLIP caption | 约 150 A100 | resume Canny | 32 |
| HED boundary | 3M Internet;与 Canny 同源 | 约 300 A100 | SD 1.5 | 32 |
| User scribble | 500K Internet;HED + threshold/mask/morphology/NMS augmentation | 段落:300 A100;Table 1:150 A100 | 段落:SD 1.5;Table 1:resume Canny | 32 |
| Pose (OpenPifPaf) | 段落:80K Internet;Table 1:200K OpenPifPaf | 约 400 RTX 3090 Ti | SD 2.1 | 18 = physical 3 × accumulation 6 |
| Pose (OpenPose) | 200K Internet / OpenPose visualized skeleton | 约 300 A100 | SD 1.5 | 32 |
| Semantic mask (COCO) | 164K COCO-Stuff;BLIP caption | 约 400 RTX 3090 Ti | SD 1.5 | 18 = 3 × 6 |
| Semantic mask (ADE20K) | 20K ADE20K;BLIP caption | 约 200 A100 | SD 1.5 | 256,4× accumulation |
| Depth, large | 3M Internet;MiDaS + BLIP | 约 500 A100 | SD 1.5 | 32 |
| Normal | 25,452 DIODE;BLIP caption | 约 100 A100 | SD 1.5 | 32 |
| Normal extended | 3M Internet;MiDaS depth → coarse normal | 再训练约 200 A100 | resume DIODE normal | 32 |
| Cartoon line | top 1M Internet;line extractor + Danbooru tags | 约 300 A100 | Waifu Diffusion | 32 |
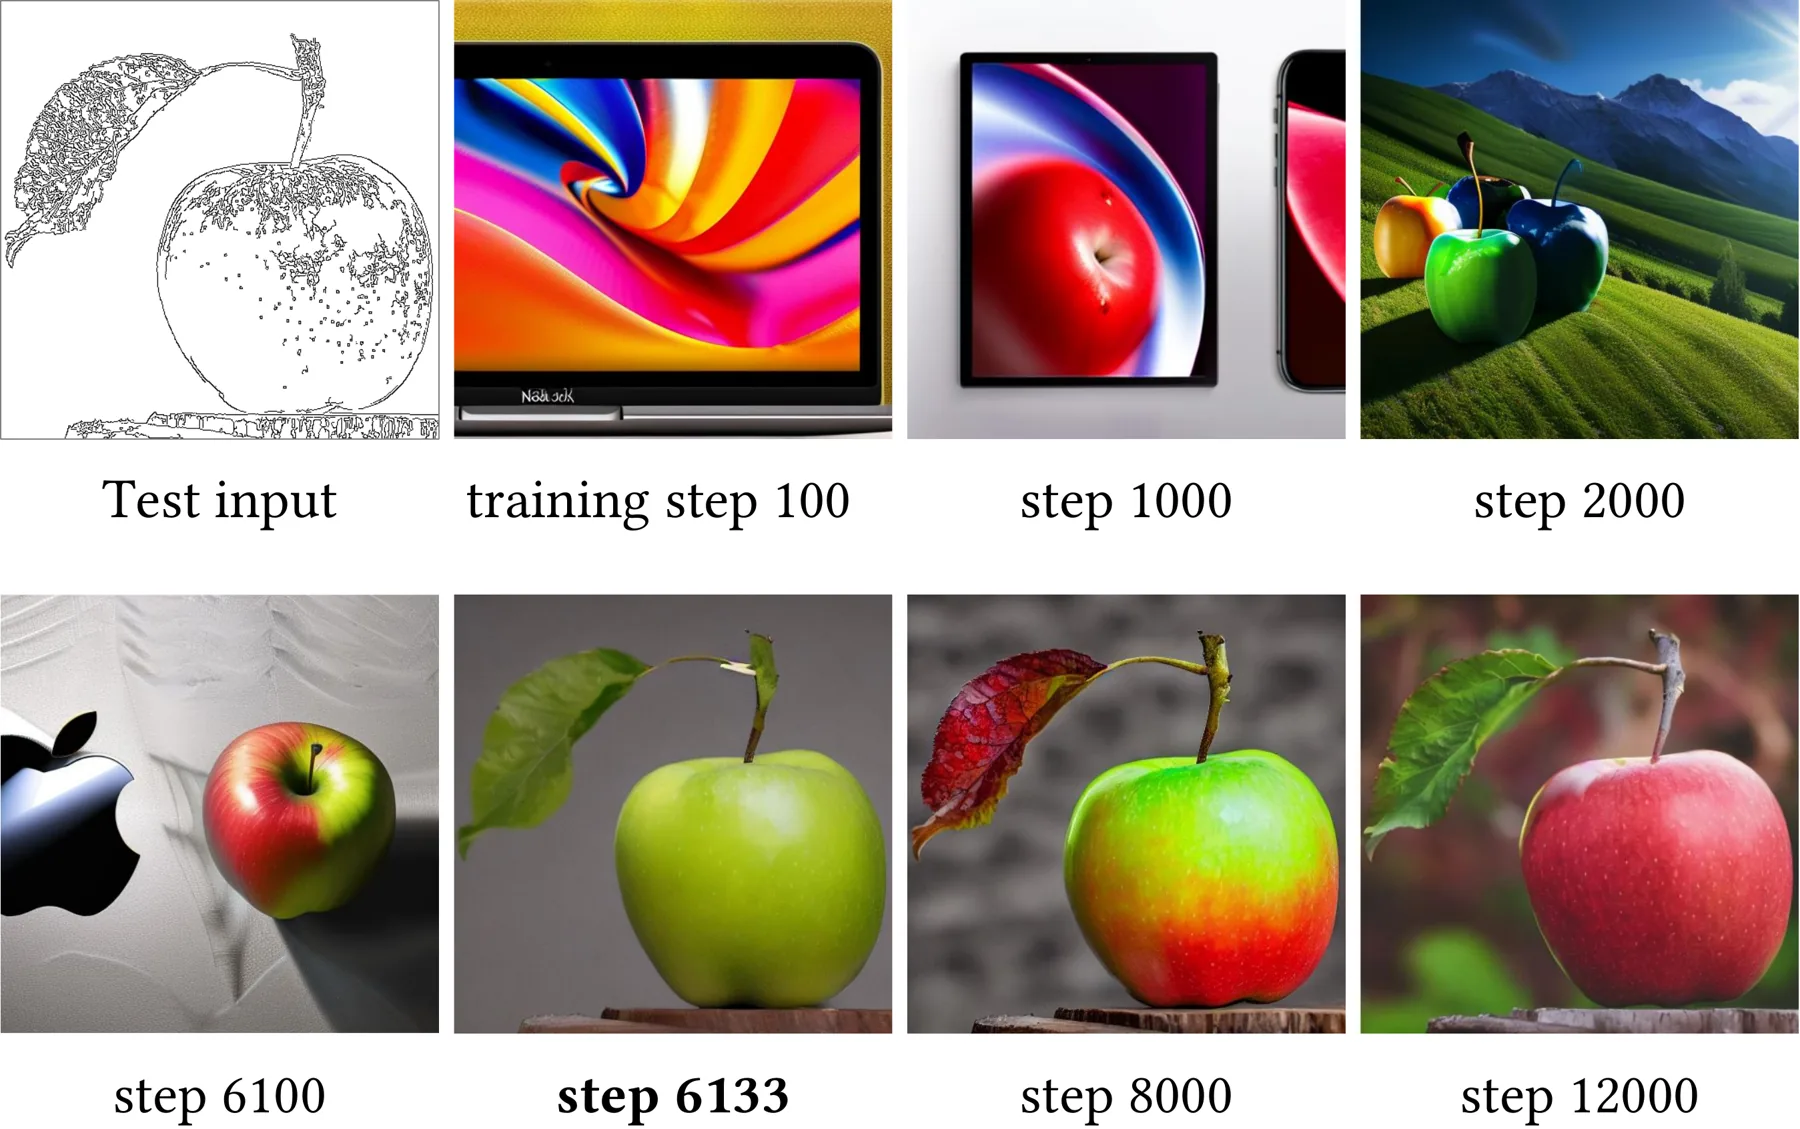
作者观察到模型先保持高画质但不听条件,随后在少于 10K steps 的某一点突然开始遵循输入;supplement 称 \(10^{-5}\) learning rate 下通常在 5K–10K。官方教程对 Fill50K 给出 3K–7K,并建议优先增大 effective batch 而不是盲目把 step 拉很长。这是经验现象,不是论文给出的收敛定理。
Internet 训练集没有公开完整 URL、license、deduplication、train/validation split 或过滤规则。作者只说使用 LAION utilities,实际来源由作者自行构建以减少版权与重复问题。caption 有网页原文、BLIP 或 Danbooru tags 三种来源。公开仓库提供的是 50K 彩色圆形 toy dataset 与训练接口,并非论文 3M 数据集。
论文做法是只把 control 给 conditional branch,并按 block resolution 缩放连接:
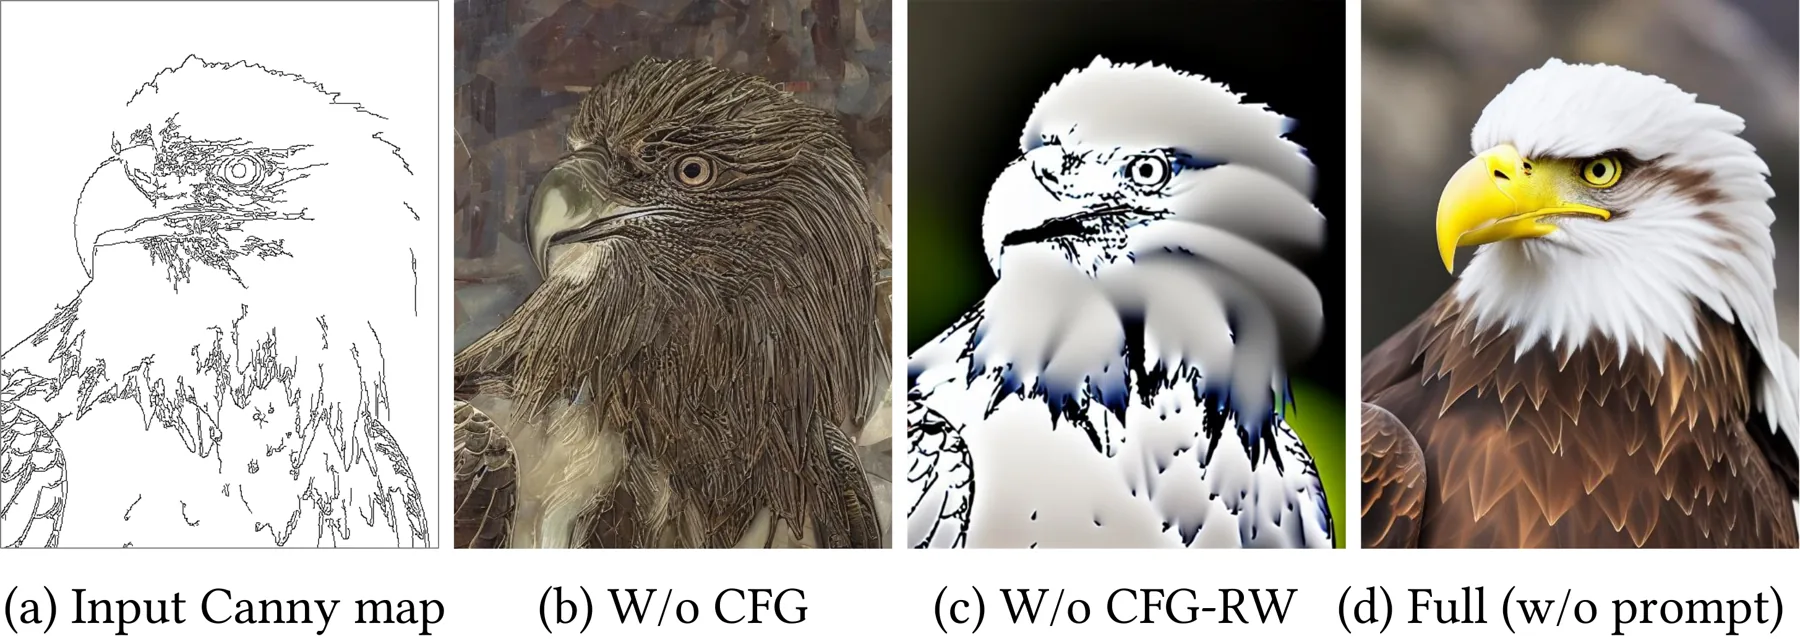
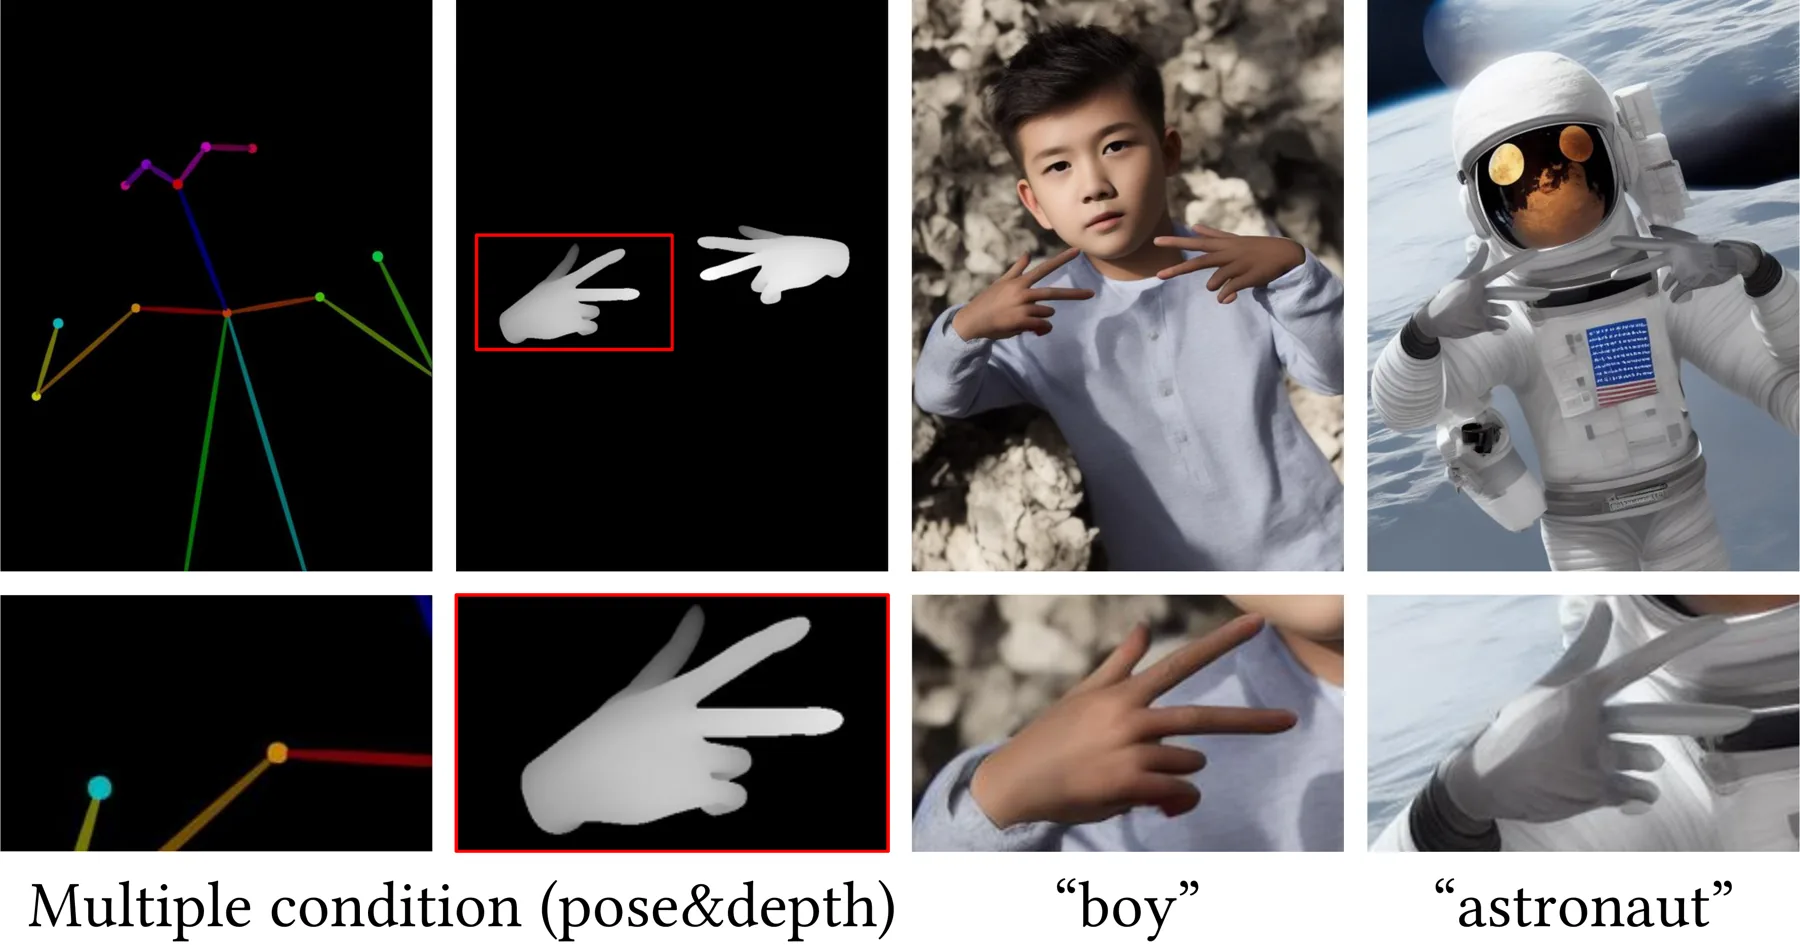
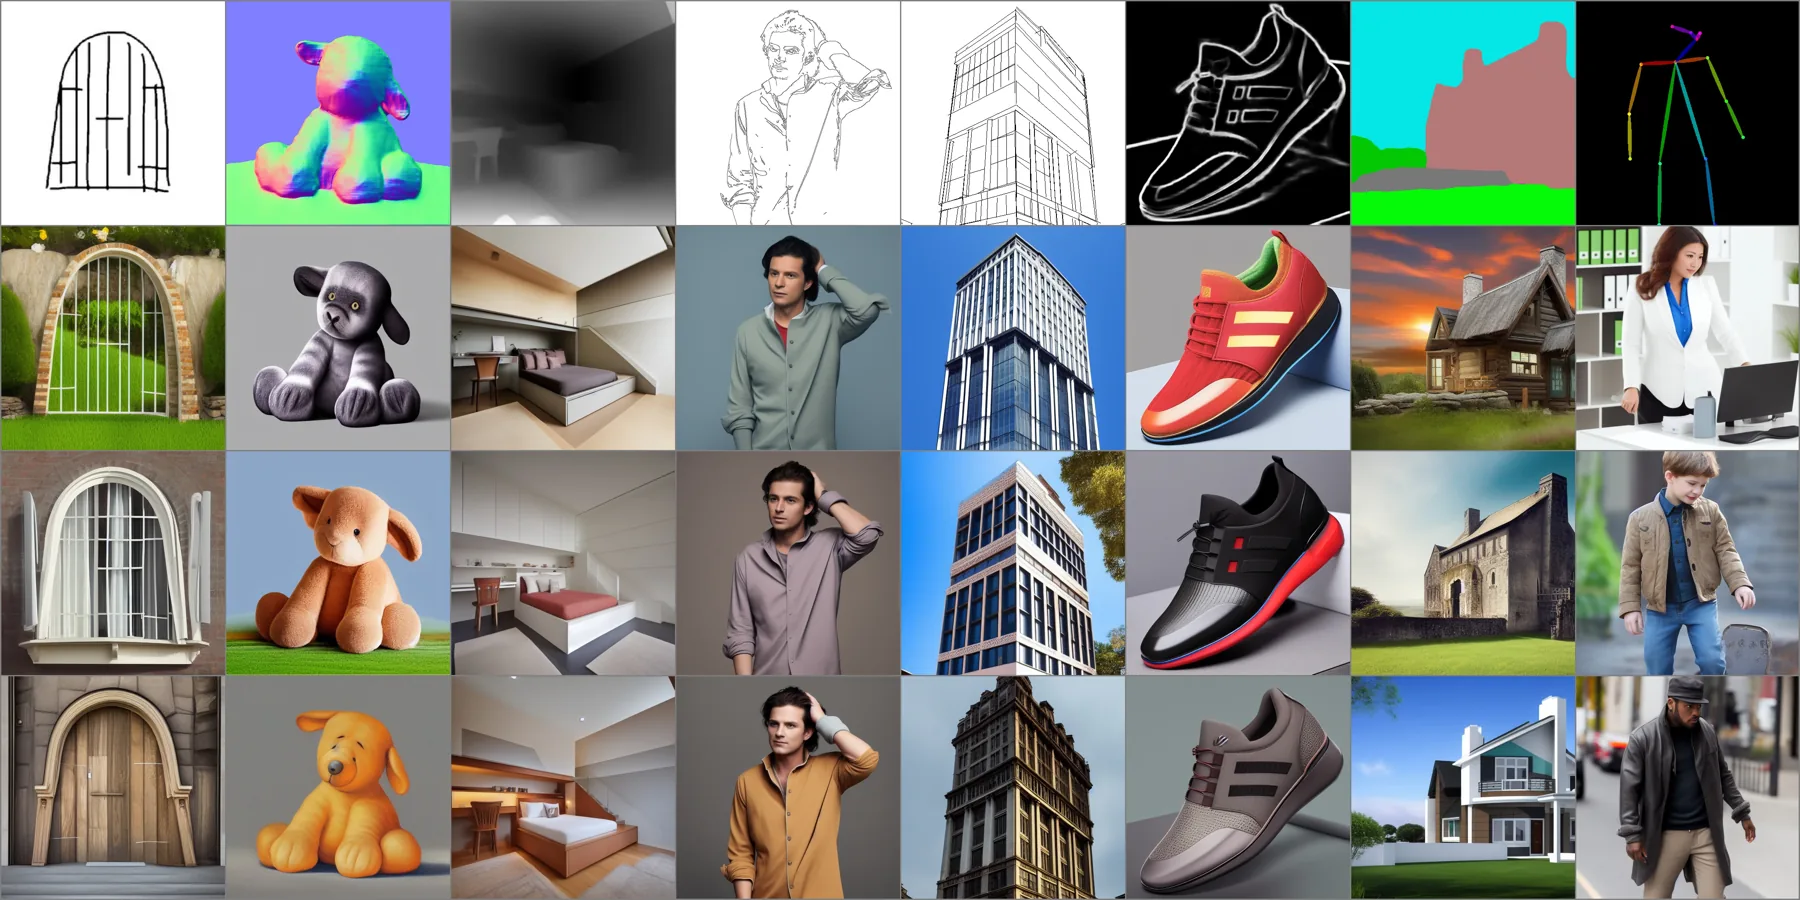
12 名参与者(10 名非艺术专业 amateurs,2 名具艺术/设计知识者)看 20 个 unseen sketches × 5 methods,分别为画质与 sketch fidelity 排序。论文称各得到 100 rankings;数值是 1–5 的平均名次,越高越好。
| 方法 | Result quality ↑ | Condition fidelity ↑ | 角色 / 公平性 |
|---|---|---|---|
| PITI (sketch) | 1.10 ± 0.05 | 1.02 ± 0.01 | GLIDE backbone;跨 backbone 画质不完全可比 |
| Sketch-Guided, \(\beta=1.6\) | 3.21 ± 0.62 | 2.31 ± 0.57 | 作者按论文重实现;低 guidance 偏画质 |
| Sketch-Guided, \(\beta=3.2\) | 2.52 ± 0.44 | 3.28 ± 0.72 | 高 guidance 提 fidelity、损画质 |
| ControlNet-lite | 3.93 ± 0.59 | 4.09 ± 0.46 | 本文 shallow ablation |
| ControlNet | 4.22 ± 0.43 | 4.28 ± 0.45 | 两个维度最高 |
相对 ControlNet-lite,ControlNet 画质平均排名 +0.29,条件一致性 +0.19;相对最佳 Sketch-Guided setting 分别 +1.01 与 +1.00。论文没有报告显著性检验、inter-rater agreement 或 participant-level variance,因此不能仅凭均值断言差异在统计上显著。
| ADE20K GT 经 OneFormer | VQGAN | LDM | PITI | ControlNet-lite | ControlNet |
|---|---|---|---|---|---|
| 0.58 ± 0.10 | 0.21 ± 0.15 | 0.31 ± 0.09 | 0.26 ± 0.16 | 0.32 ± 0.12 | 0.35 ± 0.14 |
生成图由 OneFormer 再分割,与输入 ADE20K mask 计算 IoU。GT 自己经 OneFormer 也只有 0.58,说明 metric 同时包含 generator error 与 evaluator error。ControlNet 比 lite +0.03,比 LDM +0.04;仍明显低于 GT 经 OneFormer 得到的 0.58 参考水平;该数不是严格 ceiling,因为生成图可能比真实图更容易被分割。
| 方法 | FID ↓ | CLIP text-image ↑ | CLIP aesthetic ↑ |
|---|---|---|---|
| Stable Diffusion(无 segmentation control) | 6.09 | 0.26 | 6.32 |
| VQGAN (seg.)* | 26.28 | 0.17 | 5.14 |
| LDM (seg.)* | 25.35 | 0.18 | 5.15 |
| PITI (seg.) | 19.74 | 0.20 | 5.77 |
| ControlNet-lite | 17.92 | 0.26 | 6.30 |
| ControlNet | 15.27 | 0.26 | 6.31 |
* 表示从头训练。ControlNet 在受控方法中 FID 最低,比 lite 改善 2.65(14.8%),同时保持 SD 级 CLIP/aesthetic;但无控制 SD 的 FID 仍远好于 15.27。作者正确指出:若只看 FID,完全忽略 condition 的模型反而占便宜,因此必须与 fidelity 指标联合评估。
SDv2 Depth-to-Image 据作者描述用超过 12M images、A100 cluster、数千 GPU-hours;ControlNet depth 只用 200K pairs、单张 RTX 3090 Ti 训练 5 天。12 名用户先看双方各 100 张 labeled images 学习区分,再判断 200 张新图,平均 precision \(0.52\pm0.17\)。接近随机并不等同于两个模型在 depth fidelity 上完全相同:研究测的是“人能否辨认来源”,没有报告 accuracy 的类别平衡细节或配对几何误差。
主文比较 PITI、Sketch-Guided Diffusion、Taming Transformer、VQGAN、LDM、ControlNet-lite、无控制 Stable Diffusion 与 SDv2 Depth-to-Image;supplement 另定性比较 Palette 和同期 T2I-Adapter。Palette/Taming/LDM/PITI 的 Canny comparison 声称在同一数据与同一 GPU-hours 下实现,但完整训练代码与逐方法超参未公开,公平性不能独立复核。
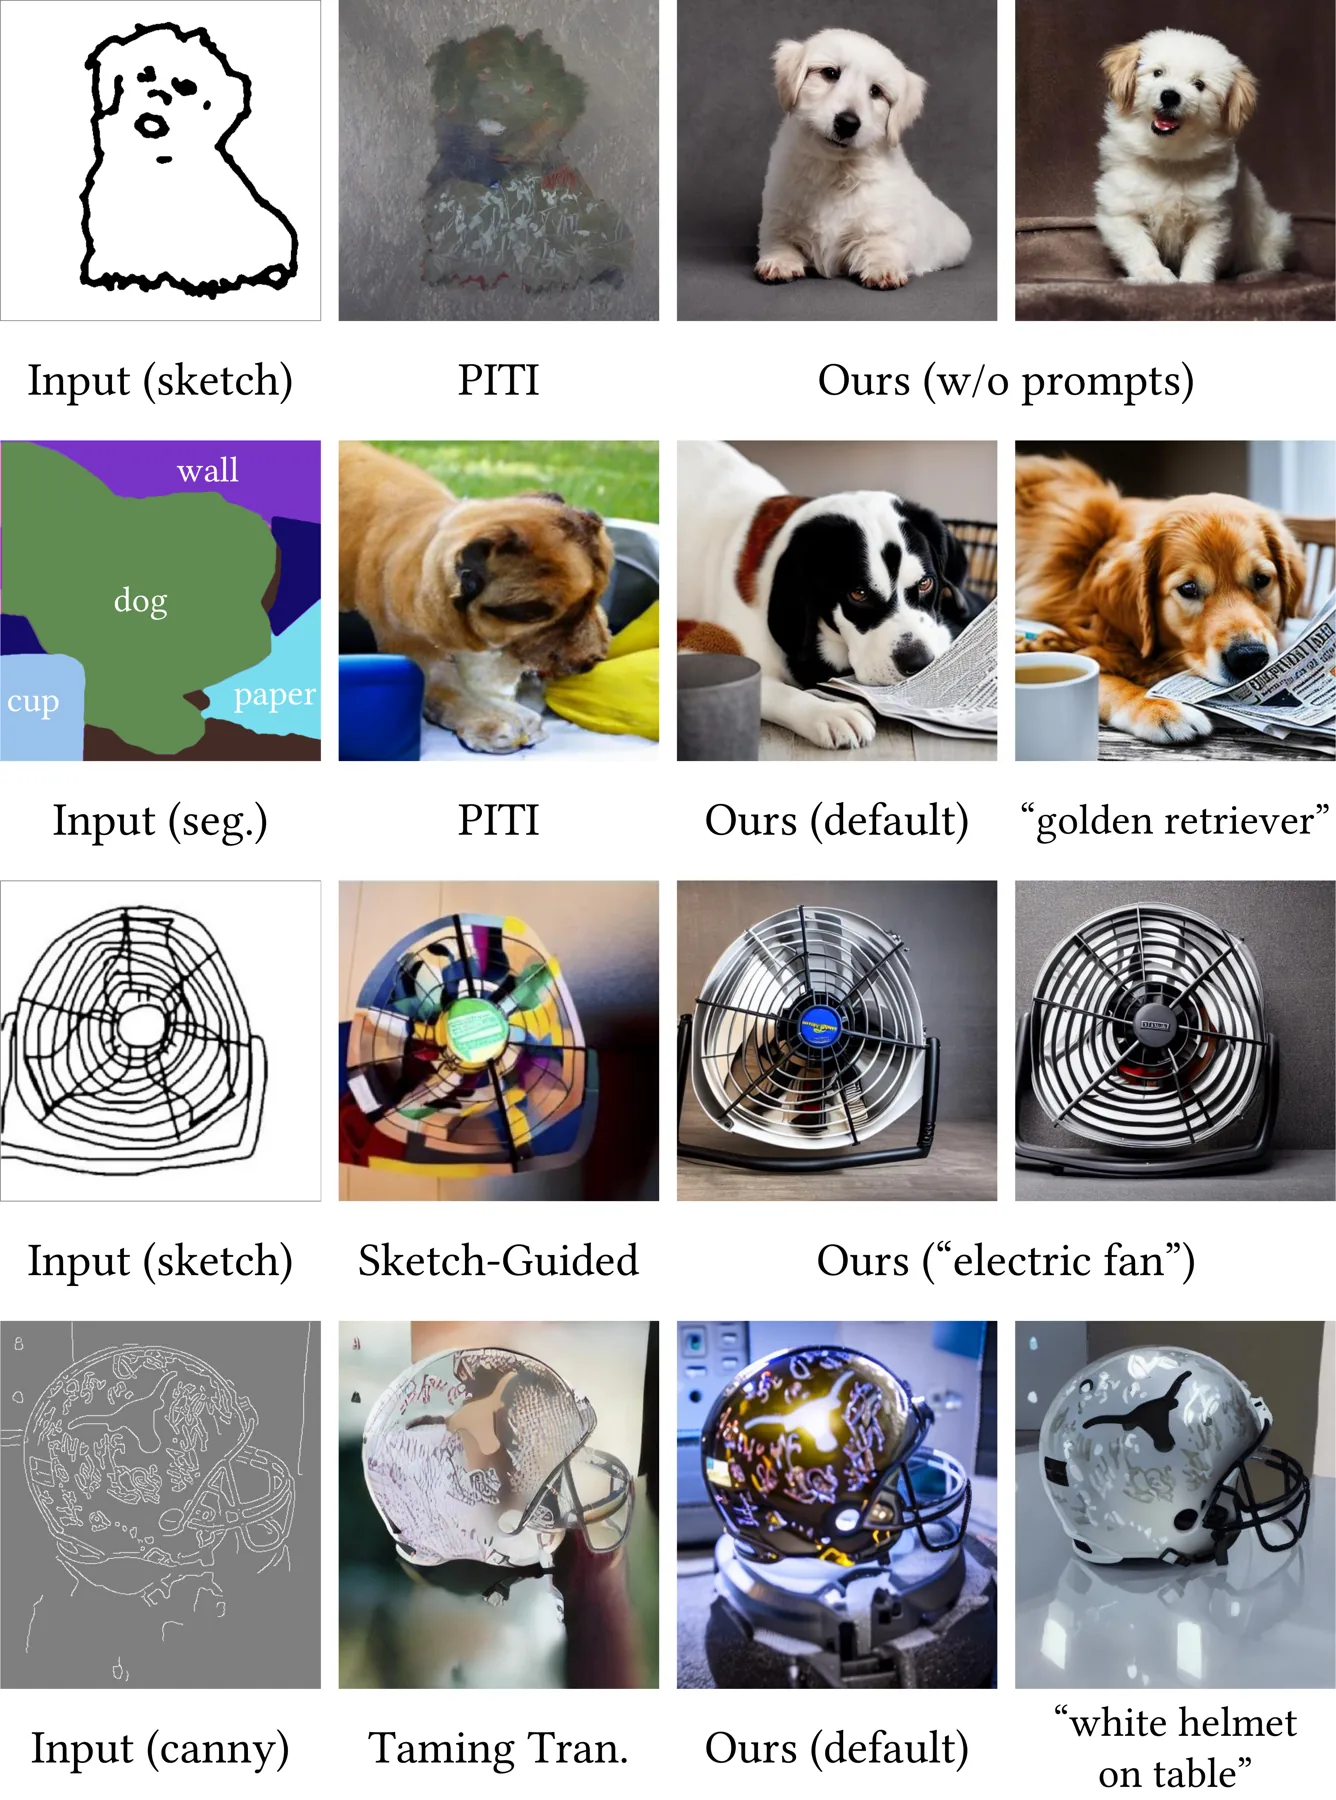
| 变体 | 改动 | 论文观察 | 能证明什么 |
|---|---|---|---|
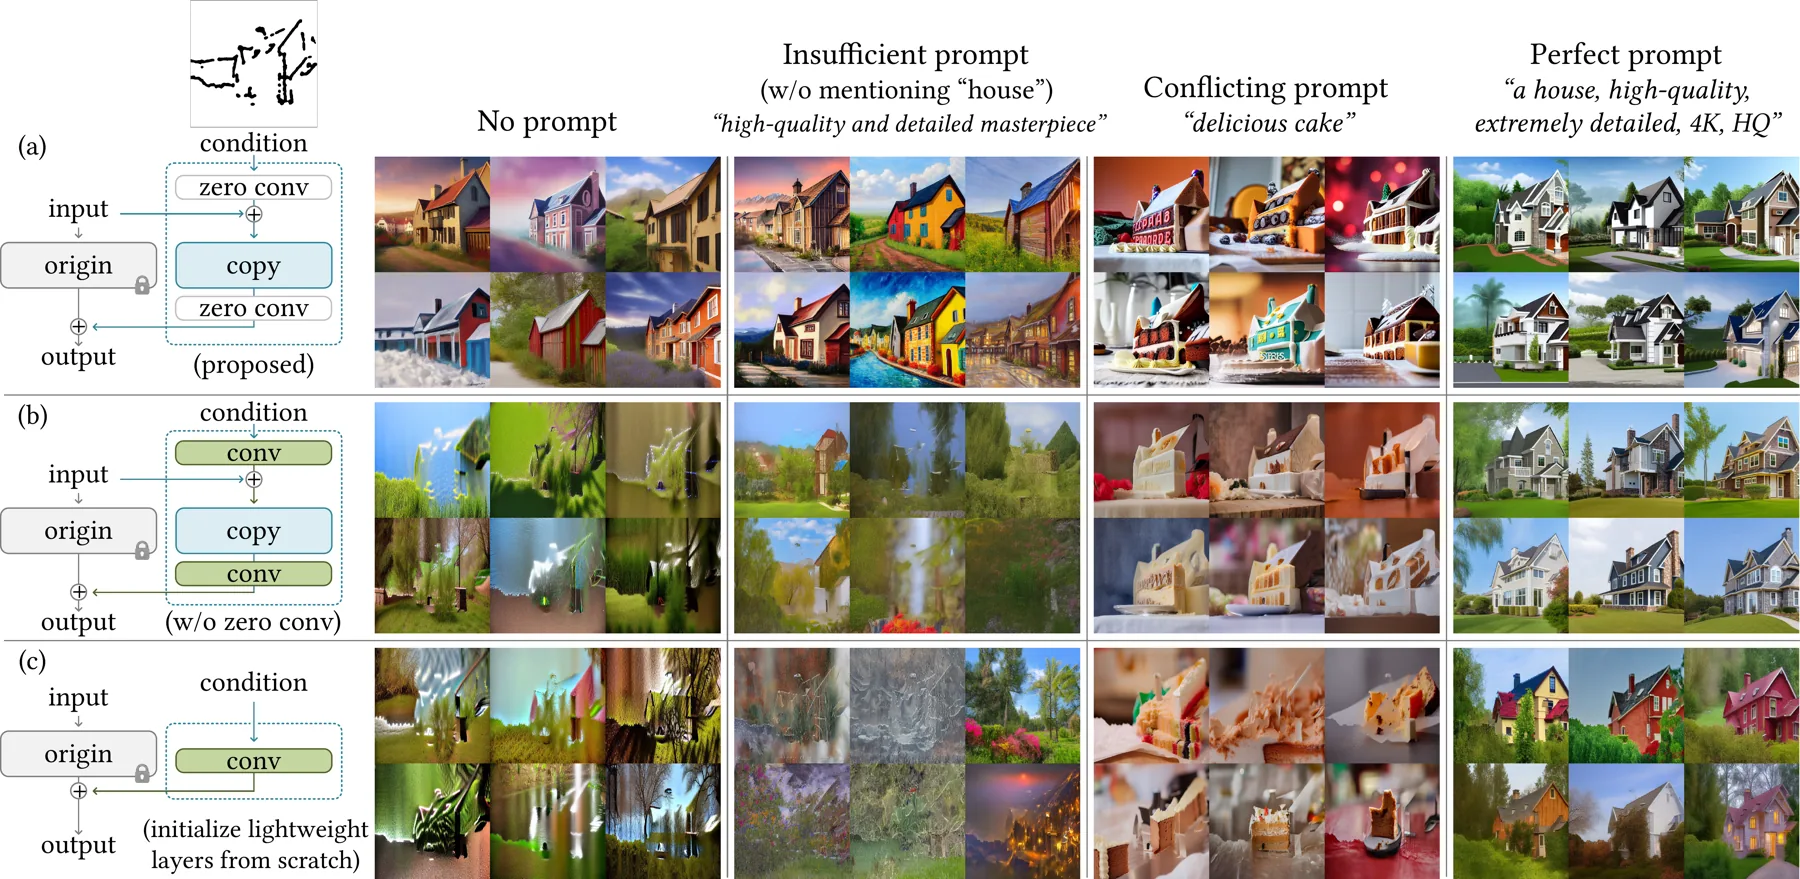
| Proposed | 深 encoder/middle copy + zero conv | 无 prompt、信息不足、冲突、perfect prompt 都较稳 | 完整系统有效 |
| w/o zero convolution | 连接层改为 Gaussian-initialized conv | 退化到接近 lite | 初始化函数扰动有害;不直接证明“副本已被摧毁” |
| Lightweight encoder injection | 不复制深层,只训练浅 conv,接 encoder | 无/不足 prompt 难解释 condition 语义 | 浅支路表征能力不足 |
| Lightweight decoder injection | 浅 conv 接 decoder | supplement 定性较弱 | 注入位置与深度都重要,但没有量化 |
| Lightweight decoder + zero conv | 浅 decoder adapter 加 zero init | 仍不及完整架构 | zero init 不能替代深语义 encoder |
| Direct finetune SD | 第一层加条件通道,训练原 SD | 可工作,但作者指出小数据遗忘、多控制与迁移受限 | supplement 的限制主要是结构分析与定性展示 |
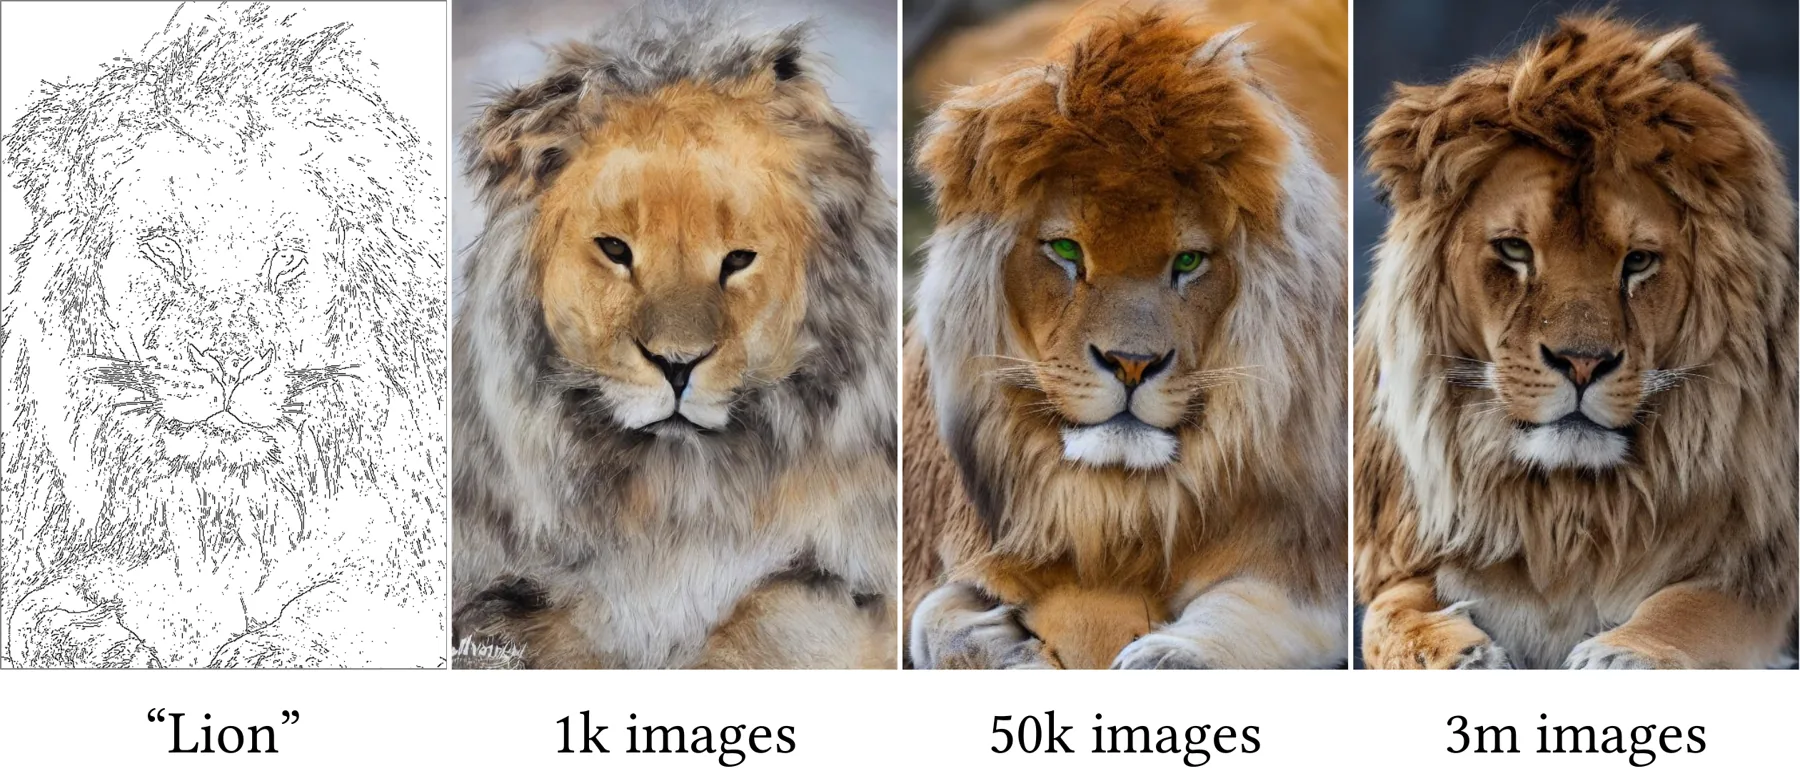
实际支持的 claim:1K 条件对没有立刻 collapse,单个 lion example 可识别;更多数据带来更丰富与稳定的生成。未支持:没有完整 test set 曲线、FID/IoU、置信区间或等 step/等 epoch 对照,无法估计样本效率 scaling law。
supplement Figure 27 展示只在一半 diffusion iterations 施加控制可以放松 shape fidelity。这是推理时控制强弱的一种手段,但论文没有系统定义 schedule 或量化 trade-off。
| 项目 | 论文 / supplement | 官方 v1.0 repo | 判断 |
|---|---|---|---|
| Condition encoder | 4 个 \(4\times4\), stride 2 conv;16/32/64/128;ReLU | 8 个 \(3\times3\) conv,三次 stride 2;16→32→96→256;SiLU;末端 zero \(3\times3\) | 结构不一致,代码更深 |
| 输出 zero conv | \(1\times1\),weight/bias zero | 13 个 \(1\times1\) zero modules | 一致 |
| 冻结主 U-Net | 锁定 production model | torch.no_grad() 包住 input/middle;optimizer 默认只收 control_model | 一致 |
| 优化器 | 未报告 | torch.optim.AdamW(params, lr) | 代码事实,不能当论文超参 |
| 论文 LR / EMA | \(10^{-5}\),no EMA | tutorial \(10^{-5}\);YAML use_ema: False | 一致 |
| 论文 batch | 18/32/256,依任务 | tutorial batch 4、单 GPU、precision 32 | toy recipe,不复现主实验 |
| 50% prompt dropout | 明确报告 | tutorial dataset 原样返回 prompt;公开简版训练脚本无 dropout | 主实验逻辑未公开 |
| CFG-RW | \(w_i=64/h_i\) | guess mode 用 \(0.825^{12-i}\) | heuristic 不同 |
| 数据 | 最高 3M,部分 Internet 自建 | 公开 Fill50K toy dataset;不含主训练集构建 pipeline | 不能完整复现 |
| Checkpoint 初始化 | 复制 SD encoder/middle | tool_add_control.py 从 SD checkpoint 复制匹配 weights | 一致 |
ControlNet.forward 先把 hint 通过 input_hint_block,只在第一个 input block 后加一次 guided hint;随后逐 block 运行可训练副本,每一级经 zero conv 加入 outputs。ControlledUnetModel.forward 在 frozen input/middle blocks 中禁用梯度,再在 decoder 把 hs.pop() + control.pop() 拼接进去。
configure_optimizers 默认只优化 control_model.parameters()。当 sd_locked=False 时,它额外训练原 U-Net 的 output blocks 与 out layer,并非解锁“全部 Stable Diffusion”。官方训练文档把这个模式类比于同时训练 ControlNet 与 DreamBooth,并建议更低 LR 如 \(2\times10^{-6}\),但这是文档建议,不是论文实验。
仓库包含 9 个 Gradio apps、detector wrappers、模型配置、toy training tutorial 和 conversion script。它没有论文全部 11 个任务的训练 manifests、Internet 图像清单、caption/dedup filters、每个任务的 exact step count、random seeds、validation protocol 或 baseline recipes。Cartoon model 在 README 当时还因风险评估未发布。
| 结论 | 证据强度 | 边界 |
|---|---|---|
| ControlNet 提升 sketch 画质与 fidelity | 较强 | 12 人、20 sketches;无显著性检验 |
| 深副本优于 shallow adapter | 中等 | 定性 + lite 主表;架构与参数量同时变化 |
| Zero conv 保护预训练 backbone | 中等 | 初始化等价严格成立;“保护表征”主要靠定性消融推断 |
| 小数据也 robust | 有限 | 1K 图只是定性例子,且 subset 按分辨率筛选 |
| 可媲美工业 depth model | 有限 | 来源辨认 precision 接近随机,不是直接 fidelity/quality metric |
| 多 ControlNets 可直接相加 | 概念验证 | 只展示 depth + pose;无冲突/scale 系统实验 |
学习 condition type tokens、共享多尺度 encoder 与稀疏 experts,减少每种条件复制半个 U-Net 的存储与训练成本。
生成后用 pose/depth/segmentation detector 重提条件,形成 cycle consistency 或 learned reward,直接补上原文“只训练 denoising loss”的盲区。
把固定 \(64/h_i\) 或 0.825 schedule 换成随 timestep、block、condition conflict 学习的 gates;同时约束 residual norm。
以低秩更新、feature modulation、distillation 或 shared adapter 保留深语义能力,量化画质、fidelity、显存与速度 Pareto front。
对 seed、control scale、start/end timestep 做有预算搜索,用 condition reconstruction + aesthetic score rerank,而不是依赖单次采样。
多 ControlNet 相加前估计 residual directions 的冲突,动态正交化、裁剪或分配 resolution,避免姿态、深度、边缘互相拉扯。
ed85cd1e25a5ed592f7d8178495b4483de0331bf。图像均来自论文作者发布的 arXiv source / CVF 正式材料;表格数值按 camera-ready 与 supplementary 重建。页面核查日期:2026-09-26。