Paper Verified
真实图像泛化确实改善
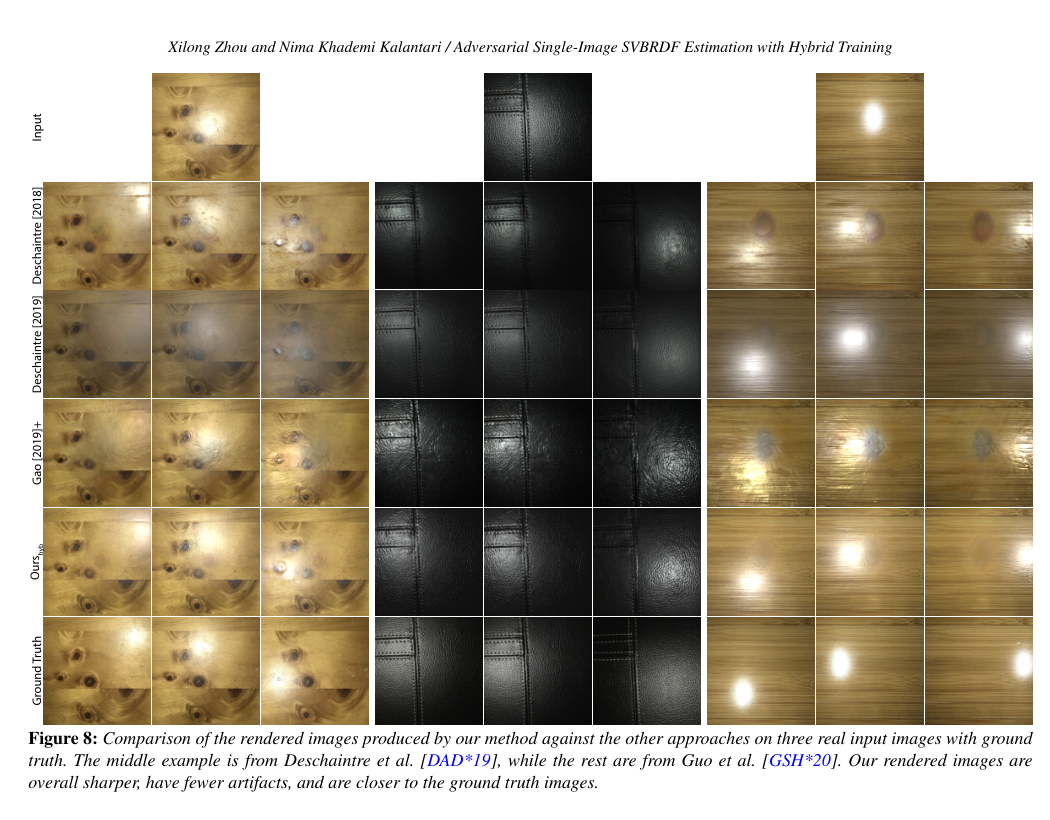
36 个真实场景上,hybrid 模型从 synthetic-only 的 LPIPS 0.306 降至 0.279;加入测试时 refinement 后从 0.275 降至 0.256。论文同时报告对应 RMSE 从 0.148 降至 0.138,refinement 后从 0.121 降至 0.119。
一张近正视、带闪光灯的平面材质照片,恢复法线、漫反射、粗糙度与镜面反射四张空间变化贴图。论文的关键不是“用了 GAN”这么简单,而是用真实物体的异光照图像对,把没有 SVBRDF 真值的真实照片变成可监督训练信号。
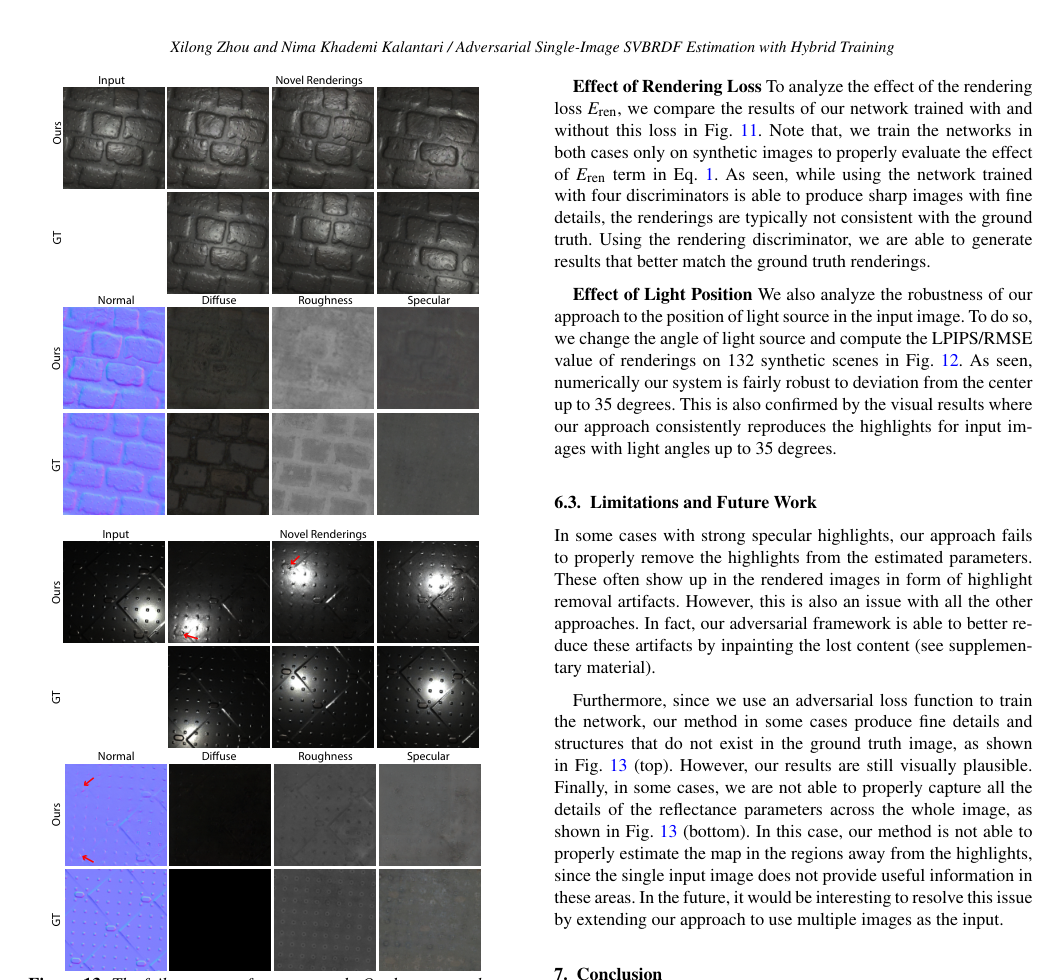
这项工作把“唯一像素真值”改造成“真实感分布 + 可重渲染一致性”的训练目标。它在 perceptual quality 上有效,特别是 real test 的 LPIPS;但它不会消除单图逆渲染的不可辨识性,也会因 adversarial prior 产生看似合理却并不存在的细节。
36 个真实场景上,hybrid 模型从 synthetic-only 的 LPIPS 0.306 降至 0.279;加入测试时 refinement 后从 0.275 降至 0.256。论文同时报告对应 RMSE 从 0.148 降至 0.138,refinement 后从 0.121 降至 0.119。
作者认为逐像素 L1 把网络强迫到单一 ground truth,压缩了病态逆问题的合理解空间。实验支持“结果更锐利、LPIPS 更好”,但没有建立一个可测量的解空间覆盖率,也没有证明 adversarial loss 恢复了真实物理参数。
真实图像对监督可理解为 appearance-cycle:从 \(I_a\) 估计材质,从 \(I_b\) 估计光源,再要求重渲染 (R\(\hat F_a,\hat b\)) 与 \(I_b\) 一致。它把未标注 real data 接入训练,却仍依赖平面、固定视角、点光源与已知渲染模型。
把确定性四贴图输出升级为 posterior / diffusion distribution;用 multi-hypothesis rendering consistency、uncertainty calibration 与真实多光照验证器分开处理“外观可解释”和“参数可辨识”。
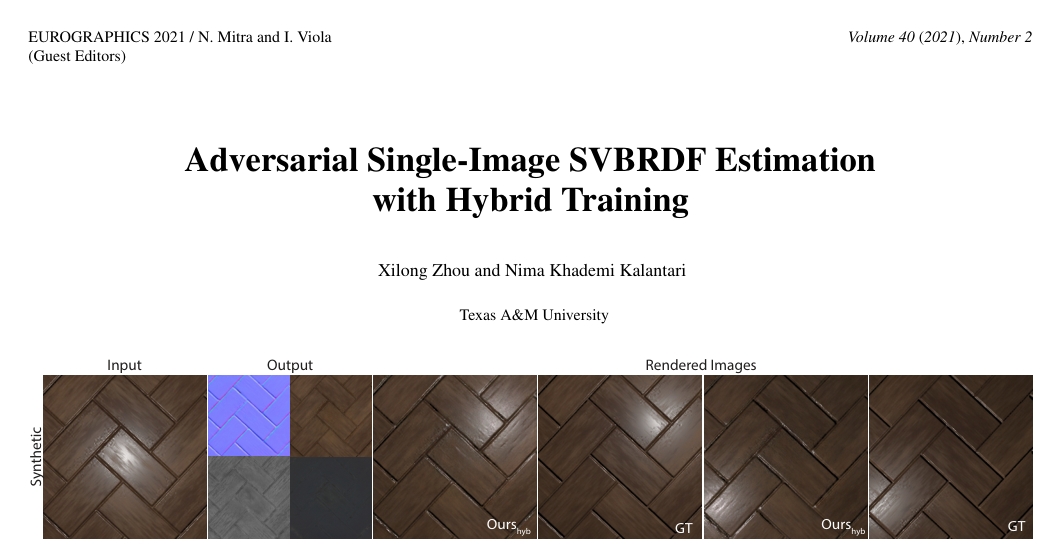
输入 \(I_q\in[0,1]^{H\times W\times3}\) 是平面材质在位置 \(q=(x,y,z)\) 的近点光源下拍摄的 RGB 图像。目标是空间变化材质集合:
\(N\) 是三通道 surface normal;\(\rho_d\) 是三通道 diffuse albedo;\(\alpha\) 是一通道 roughness;\(\rho_s\) 是三通道 specular albedo。网络还从共享 encoder 特征估计光源 \(\hat q=G_l(I_q)\)。最终的 renderer \(R(\mathbf F,p)\) 使用 Cook–Torrance 模型,在新光源 \(p\) 下合成外观。
单张照片只有颜色观测,却同时混合材质、法线、光照与曝光。明亮像素可能来自较高 diffuse、较强 specular、更小 roughness,或法线朝向光源。因而多个 \(\mathbf F\) 可产生相似的 \(I_q\)。
输入默认是正交视图下的平面材质;训练 renderer 使用点光源和固定相机;输出遵循 Cook–Torrance 参数化。它不是任意几何、环境光或复杂镜头成像条件下的通用 inverse rendering。
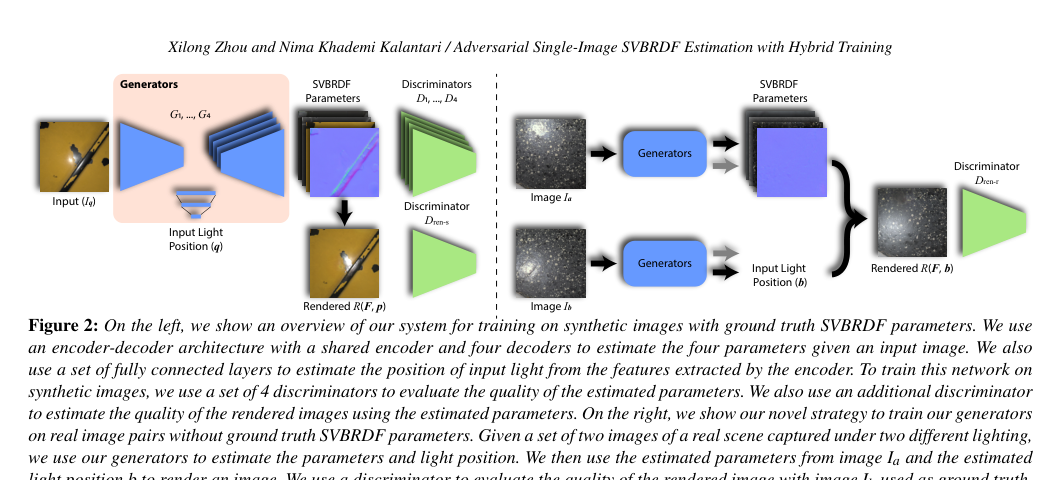
四个 \(E_i\) 分别约束四张参数图;\(E_{\mathrm{ren}}\) 约束这些图作为一个整体能否解释 novel-light appearance;\(E_l\) 训练光源回归头。
\(L_{\mathrm{adv}}\) 是 conditional LSGAN;判别器同时看到 input 与真/假参数图。feature matching 对齐判别器多层特征,稳定训练;L1 保留与 synthetic truth 的对应关系。论文取 \(\lambda_{1,p}=10,\lambda_{2,p}=10\)。
随机新光源 \(p\) 下,四张预测贴图必须共同产生正确外观。权重为 \(10,50,10\)。它约束跨通道一致性,弥补四个独立参数判别器“各自真实、组合错误”的风险。
synthetic data 知道真实光源坐标,因此可监督六层 MLP。光源头不是最终材质输出,却是 real-pair training 把另一张图变成监督信号的必要桥梁。
论文最终写为 \(E=E_{\mathrm{syn}}+\lambda E_{\mathrm{real}}\),实现取 \(\lambda=5\)。这并不是 real SVBRDF truth:它只要求一个预测材质在估计光照下解释另一张照片。
对抗参数先验使单张贴图看起来“像真实材质” → rendering discriminator 使四张贴图能协同重现外观 → real-pair branch 缩小 synthetic-to-real appearance gap。三者分别处理 distribution realism、cross-map consistency 与 domain gap,职责不同。
仅保留 Deschaintre 2018 的 local encoder-decoder branch,使用 skip connections;共享 encoder,四个 decoder 输出 3 / 3 / 1 / 3 通道。256×256 输入的 bottleneck 是 1×1×512。
512 → 256 → 128 → 64 → 32 → 16 → 3;除最后线性层外使用 leaky ReLU。输出 Cartesian 点光源坐标。
论文采用 Wang et al. 2018 的 conditional discriminator。公开代码默认单尺度、3 层 PatchGAN、首层 64 filters、instance normalization、LSGAN。
复用 Deschaintre et al. 2018 的 SVBRDF dataset。正交相机;上半球用 cosine-weighted distribution 采样点光源方向;距离为 \(\exp(d)\),\(d\sim\mathcal N(1.0,0.75^2)\)。Cook–Torrance 渲染后 clamp 到 1、gamma correction,再映射到 ([-1,1])。论文没有给出训练材质实例总数或明确 train/validation split。
三脚架固定相机,移动闪光灯拍摄平面表面:约 500 段视频;每段选 1–3 个光照合理 crop,形成约 1,000 个视频片段;每个片段抽 5–10 帧并 resize 到 256×256。训练时在同一场景随机抽两帧。公开数据页面提供下载,但论文未说明相机型号、曝光锁定、色彩标定、对象清单与正式 split。
| 阶段 | 数据 | 主要目标 | 预算 | Batch |
|---|---|---|---|---|
| Stage 1 | Synthetic | 4 个参数判别器;不含 \(E_{\mathrm{ren}}\) | 250,000 iterations | 4 |
| Stage 2 | Synthetic | 加入 rendering discriminator / \(E_{\mathrm{ren}}\) | 200,000 iterations | 4 |
| Stage 3 | Hybrid | Synthetic + real-pair supervision | 100,000 iterations | 4 synthetic + 1 real |
统一配置:PyTorch;Adam,learning rate \(2\times10^{-5}\),\(\beta_1=0.5\),其余 Adam 参数默认(代码明确 \(\beta_2=0.999\),weight decay 0);单张 GeForce RTX 2080 Ti 约 3 天。论文未报告随机种子、训练集精确大小、验证协议、checkpoint 选择与显存占用。
测试时单张 RGB resize 到 256×256,经一次 encoder / four-decoder forward 输出四贴图;如果选择 `ALL_5D`,还可用预测光源重渲染。论文的 “+” 结果另做测试时 refinement:先用全图平均梯度只优化 roughness 与 specular,再逐像素优化全部参数,使渲染更接近输入;论文没有公开 refinement 的迭代数、优化器和步长,所以“+” 结果不能凭正文完整复现。
N / D / R / S 为四张参数图 RMSE;Ren RMSE 与 Ren LPIPS 在每个 scene 的 20 个新光照 rendering 上计算。所有指标越低越好。粗体为原表 best,次优以棕色标记。
| 方法 | N RMSE | D RMSE | R RMSE | S RMSE | Ren RMSE | Ren LPIPS |
|---|---|---|---|---|---|---|
| Des18 | 0.065 | 0.058 | 0.175 | 0.129 | 0.086 | 0.278 |
| Des19 | 0.092 | 0.062 | 0.129 | 0.066 | 0.100 | 0.223 |
| Gao19 | 0.068 | 0.065 | 0.123 | 0.065 | 0.072 | 0.274 |
| Ourssyn | 0.054 | 0.062 | 0.100 | 0.065 | 0.078 | 0.193 |
| Ourshyb | 0.056 | 0.062 | 0.104 | 0.066 | 0.074 | 0.187 |
| Gao19+ | 0.069 | 0.065 | 0.123 | 0.070 | 0.068 | 0.177 |
| Ourssyn+ | 0.053 | 0.063 | 0.115 | 0.079 | 0.058 | 0.153 |
| Ourshyb+ | 0.054 | 0.063 | 0.124 | 0.090 | 0.059 | 0.155 |
无 refinement 时 Ourshyb 的 Ren LPIPS 0.187,比最佳 baseline Des19 的 0.223 低 16.1%;但 diffuse RMSE 0.062 不如 Des18 的 0.058,specular RMSE 0.066 也略逊 Gao19 / Ourssyn 的 0.065。
对抗目标更偏好感知锐度:它改善 rendering LPIPS,却不保证每张物理参数图的 L2 准确性。refinement 使 rendering RMSE 大幅下降,但 roughness / specular 参数 RMSE 反而变差,说明“重渲染相似”与“分解正确”不是同一目标。
每个 scene 用 1 张输入,其余 8 张异光照图作为 ground truth;因此比较的是 novel-light rendering,而不是 real SVBRDF 参数真值。
| 方法 | LPIPS ↓ | RMSE ↓ |
|---|---|---|
| Des18 | 0.349 | 0.131 |
| Des19 | 0.335 | 0.168 |
| Gao19 | 0.419 | 0.132 |
| Ourssyn | 0.306 | 0.148 |
| Ourshyb | 0.279 | 0.138 |
| Gao19+ | 0.307 | 0.133 |
| Ourssyn+ | 0.275 | 0.121 |
| Ourshyb+ | 0.256 | 0.119 |
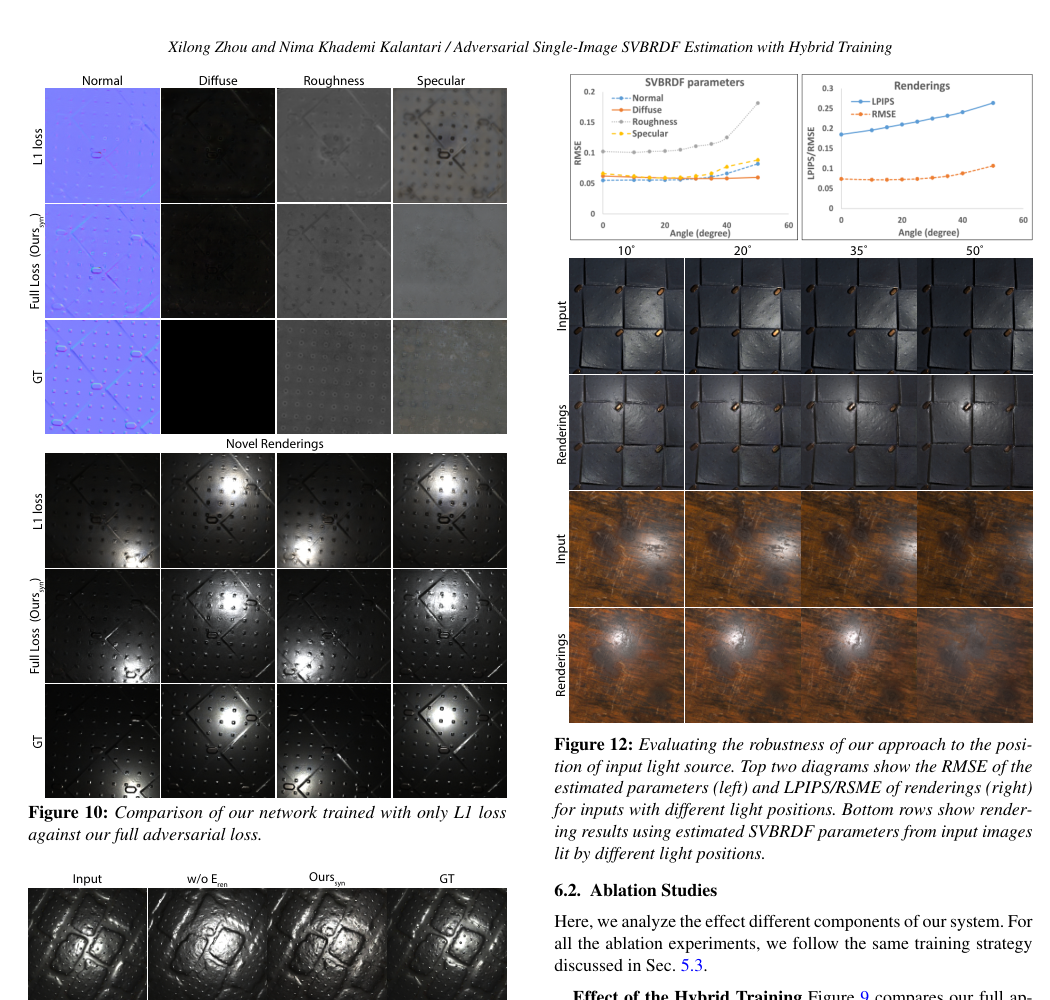
132 synthetic scenes:L1-only 的 LPIPS / RMSE 为 0.236 / 0.073;full adversarial 为 0.193 / 0.078。感知指标提升 18.2%,代价是 RMSE 增加 6.8%。这直接支持“更锐利”,也直接否定“所有数值指标都更好”。
去掉 \(E_{\mathrm{ren}}\) 时,单独的四个参数判别器仍能生成清晰贴图,但组合后的 rendering 与 GT 不一致。论文只给定性 Figure 11,没有报告数值差值。
Figure 9 展示划痕粗糙度、高光处 diffuse artifact 与锈蚀金属 roughness 的改善;Table 2 则给出真实场景 quantitative support。没有 real-training dataset size / category-wise breakdown,泛化范围仍不透明。
输入闪光灯偏离中心不超过约 35° 时,论文称参数 RMSE 与 rendering LPIPS / RMSE “fairly robust”;50° 明显恶化。图中有曲线但正文未给逐点数值表。
| 核查点 | 论文描述 | 公开代码快照 9c565c2 | 影响 |
|---|---|---|---|
| 真实分支 loss | Eq. 4:GAN + feature + L1 | 默认还计算 real rendering 的 VGG loss;可用 flag 关闭 | 论文公式与默认实现并不完全一致,复现实验应记录 flag |
| 光源梯度 | 从 \(I_b\) 估计 \(\hat b\) 后重渲染 | renderer 调用使用 `fakeLightB.detach()` | real-pair rendering loss 不反传到 light head;light head 主要由 synthetic \(E_l\) 学习 |
| Real pair 对称性 | \(I_a\rightarrow I_b\) | 默认只用 A 材质 + B 光源;额外 A self-render 分支由 `gan_realA/L1_realA/vg_realA` flags 开启 | README 命令未开启这些 flags,默认是单向交叉重渲染 |
| 训练预算 | 250k / 200k / 100k iterations | CLI 的 `--niter` 实际是 epoch loop;README 用 `$epoch` | 必须知道 dataset length 才能把 paper iterations 换算成 CLI epochs |
| Randomness | 未报告 seed | `train.py` 每次随机生成 seed 并写到 options log | 若未保存 `opt.txt`,难以精确重放;结果方差未报告 |
| 输入预处理 | clamp、gamma、归一化 | Synthetic loader 对 input 做 (1/2.2) gamma;real loader 使用独立 linear-to-gamma 路径;默认 256 resize/crop | 准备自有 real 输入时必须匹配 code path,不能只按论文一句话处理 |
| 版本环境 | PyTorch | Python 3.6.12、PyTorch 1.6.0、CUDA 10.1、torchvision 0.7、LPIPS 0.1.3 | 环境较旧;现代 PyTorch 需处理 API / checkpoint 兼容性 |
| 公开性 | 方法可实现 | 代码、real dataset link、pretrained checkpoint link 均在 README;无正式 release/tag,仅 2 commits | 可运行性比只有伪代码强,但实验配置不是完整封装 |
本页没有声称重新训练或独立复现实验。论文没有公开完整 refinement recipe、validation / checkpoint-selection protocol、真实拍摄标定和统计显著性;本次审计也没有下载大体量训练数据与 checkpoint。代码中的默认值能说明实现路径,不能自动证明它们就是所有论文表格的最终运行参数。
L1→adversarial 的 ablation 清楚展示 LPIPS / RMSE trade-off;\(E_{\mathrm{ren}}\) 展示组合一致性;hybrid 展示 real-domain appearance improvement。它们没有证明恢复的 normal / roughness / specular 是唯一或真实的材料属性。
本文直接输出 raster SVBRDF maps,不生成 SBS/SBSAR、shader graph、node topology 或可编辑程序,也没有 constrained decoding、graph execution 或 topology search。可借用的不是表示形式,而是监督机制:对 procedural graph 生成,可把 \(R(\mathbf F,p)\) 替换成真实 graph executor,在多光照、多尺度和多视角下验证外观;再把 adversarial prior 用于判别 node-level preview / rendered material distribution,同时保持 graph validity、可编辑性与参数语义。这属于研究延伸,论文没有验证。
9c565c22d6431ec4fc98cc23032dbec01f6ed921。核查日期:2026-09-26。正文事实来自 11 页正式 PDF、官方项目 / supplement 与官方代码;未用搜索摘要替代论文阅读。图像均为原论文 Figure 的页面裁切并以 base64 内嵌。数值表由原 Table 1–2 重建。本文主页面无外部运行依赖,MathJax 3.2.2 离线内嵌。