这篇论文究竟证明了什么?
它用一个刻意简单的实验回答:在图像分类上,卷积的局部性、平移等变性和二维邻域结构是否是不可替代的?答案是有条件的——中小数据上仍然重要;达到 ImageNet-21k / JFT-300M 规模后,纯 Transformer 的扩展性与迁移效率占上风。
Research gap
此前视觉注意力方法通常嵌在 CNN 中,或使用局部、稀疏、轴向等专门结构;这些结构难以在当时硬件上高效扩展。本文测试标准、全局的 NLP Transformer 是否能“几乎开箱即用”地扩展到图像。
核心假设
卷积先验提高小数据效率,但不是大规模视觉表示学习的必要条件。只需用 patch 降低序列长度,剩余空间关系可以由数据学习。
输入、输出与学习目标
输入
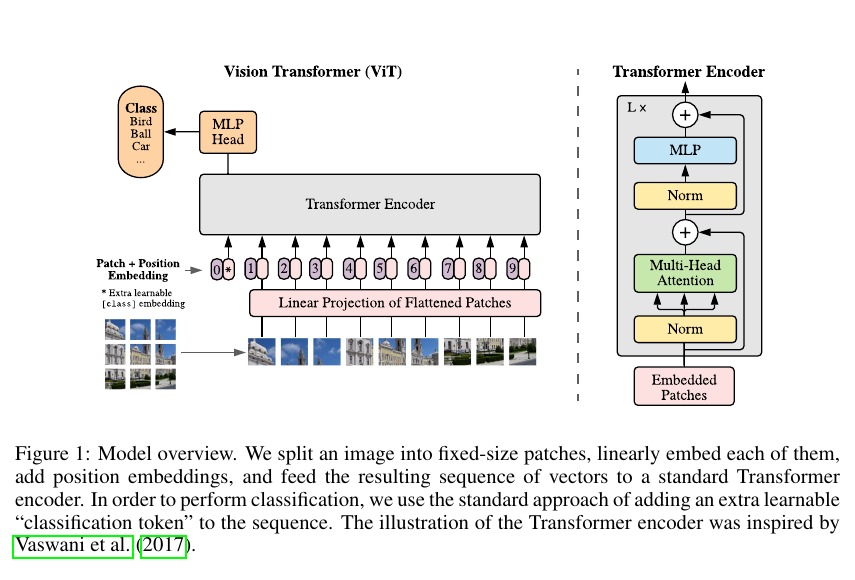
一张图像 \(\mathbf{x}\in\mathbb{R}^{H\times W\times C}\)。以边长 \(P\) 的不重叠方块切分,patch 数 \(N=HW/P^2\),每块展平为 \(\mathbf{x}_p^i\in\mathbb{R}^{P^2C}\)。
输出
encoder 最终层的 class token 表示 \(\mathbf{y}\),送入分类头得到 \(K\) 类 logits。预训练与下游微调均为分类;论文主体并非生成模型,也没有 decoder。
监督目标
论文按分类监督训练,核心优化是预测数据集标签。正文未把交叉熵单列为公式;不可把后续 MAE、DINO 或 CLIP 的目标倒写成本论文方法。
迁移
去掉预训练的两层 MLP head,接一个零初始化的 \(D\times K\) 线性层;若提高分辨率,则固定 patch 尺寸并对 learned positional embeddings 做二维插值。
从像素到 token,只改入口
视觉先验在哪里?
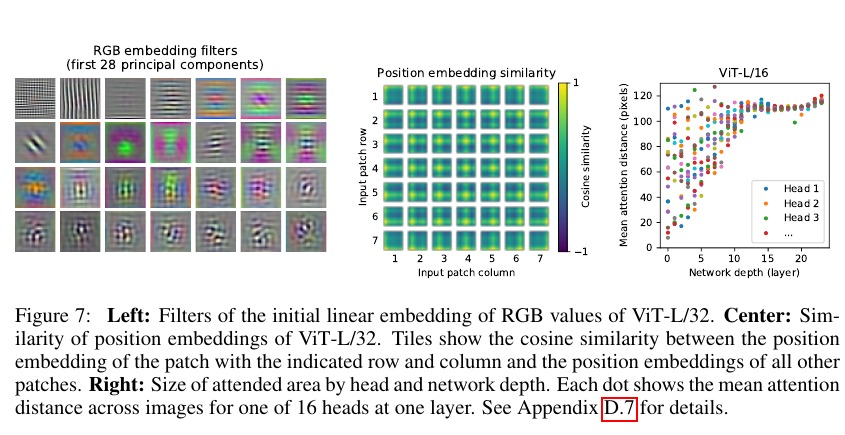
只有 patch 切分显式使用二维局部结构;高分辨率迁移时的位置编码插值再次使用二维网格。encoder 内部是全局序列处理,初始 position embedding 也没有预置“相邻 patch 更近”。
Hybrid 对照
可先用 ResNet 生成 feature map,再把每个 feature patch(极端时为 \(1\times1\))投影成 token。这个对照检验卷积局部前端在不同计算预算下是否仍有优势。
参数规模与计算旋钮
| 变体 | 层数 \(L\) | 隐藏维 \(D\) | MLP 维 | Heads | 参数量 | 常见 patch |
|---|---|---|---|---|---|---|
| ViT-Base | 12 | 768 | 3072 | 12 | 86M | 16 / 32 |
| ViT-Large | 24 | 1024 | 4096 | 16 | 307M | 16 / 32 |
| ViT-Huge | 32 | 1280 | 5120 | 16 | 632M | 14 |
命名 ViT-L/16 = Large 主干 + 16 像素 patch。768 是沿用 BERT-Base 的 hidden size,不是为了令 \(16\times16\times768\) 等于图像像素数;现有笔记中的那个解释是巧合推测,不是论文设计依据。
数据、训练、微调与推理
ImageNet
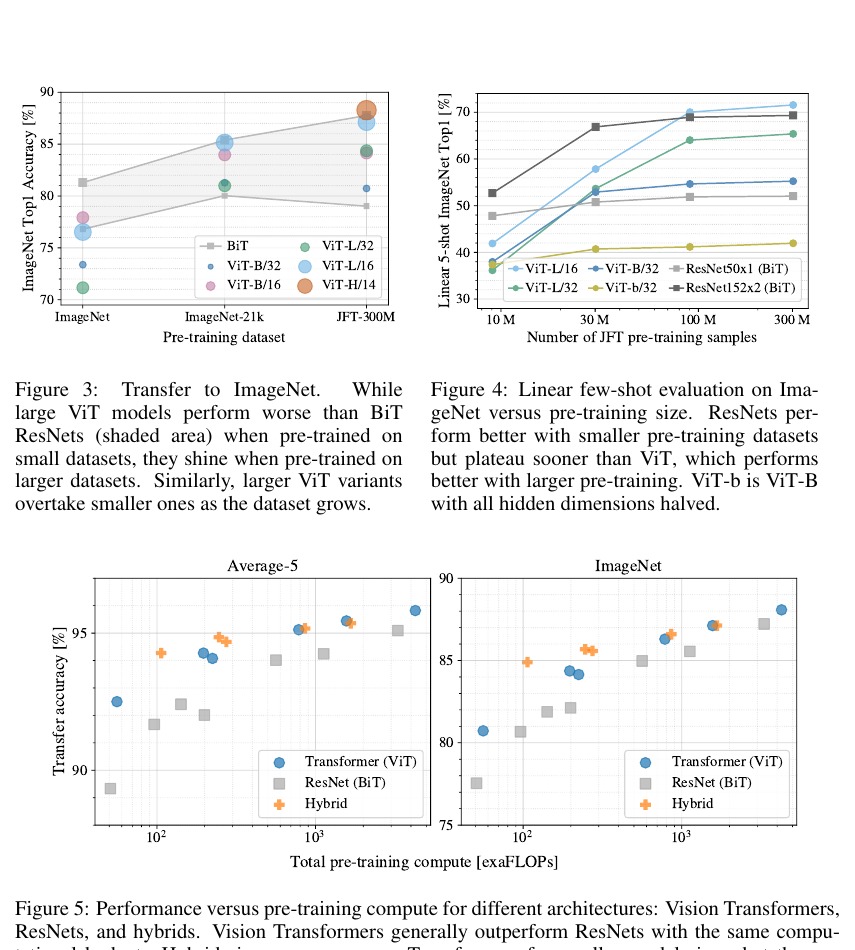
1.3M 图像、1k 类。训练分辨率 224。直接从头训练时需更强正则,且大 ViT 不如同规模 ResNet。
ImageNet-21k
14M 图像、21k 类。公开大规模预训练集,显著缩小 ViT 的数据劣势。
JFT-300M
303M 高分辨率图像、18k 类,内部数据集。预训练集相对下游测试集做去重。
| 预训练设置 | Epoch | Base LR | Decay | Weight decay | Dropout |
|---|---|---|---|---|---|
| ViT-B/{16,32}, JFT | 7 | \(8\times10^{-4}\) | linear | 0.1 | 0.0 |
| ViT-L/32, JFT | 7 | \(6\times10^{-4}\) | linear | 0.1 | 0.0 |
| ViT-L/16, JFT | 7 / 14 | \(4\times10^{-4}\) | linear | 0.1 | 0.0 |
| ViT-H/14, JFT | 14 | \(3\times10^{-4}\) | linear | 0.1 | 0.0 |
| ViT-B/{16,32}, I21k | 90 | \(10^{-3}\) | linear | 0.03 | 0.1 |
| ViT-L/{16,32}, I21k | 30 / 90 | \(10^{-3}\) | linear | 0.03 | 0.1 |
| ViT-*,ImageNet | 300 | \(3\times10^{-3}\) | cosine | 0.3 | 0.1 |
统一预训练细节
- Adam:\(\beta_1=0.9, \beta_2=0.999\)
- batch size 4096,warmup 10k steps
- 训练分辨率 224;ImageNet 额外 global norm 1 梯度裁剪
- dropout 用在 dense 后(qkv projection 除外)与 patch + position 相加后
- JFT 对比中的 ResNet 也用 Adam,以降低优化器混杂;Appendix D.1 给出 Adam/SGD 对照
微调细节
- SGD momentum 0.9,batch size 512
- cosine decay、无 weight decay、global norm 1 梯度裁剪
- 默认 384 分辨率;ImageNet 最佳结果用 L/16 的 512、H/14 的 518
- ImageNet 20k steps;CIFAR 10k;Pets / Flowers 500;VTAB 2.5k
- 按开发子集搜索 learning rate;最佳 ImageNet 结果再用 Polyak averaging 0.9999
推理实际发生什么
确定性前向分类:resize / crop 输入,patchify,插值后位置编码,encoder,读取 class token,线性 head 输出 logits,取最大类别。没有 beam search、temperature、采样、rerank、外部工具或 test-time optimization。
Few-shot 评估
冻结表示,把少量样本映射到 \(\{-1,1\}^{K}\) 目标,解带正则的 least-squares 闭式解。它是便宜的表示质量探针,不等同于端到端低样本微调。
结果强,但比较必须读条件
| 下游指标 | ViT-H/14 JFT | ViT-L/16 JFT | ViT-L/16 I21k | BiT-L JFT | Noisy Student |
|---|---|---|---|---|---|
| ImageNet | 88.55 ± 0.04 | 87.76 ± 0.03 | 85.30 ± 0.02 | 87.54 ± 0.02 | 88.4 / 88.5 |
| ImageNet-ReaL | 90.72 ± 0.05 | 90.54 ± 0.03 | 88.62 ± 0.05 | 90.54 | 90.55 |
| CIFAR-10 | 99.50 ± 0.06 | 99.42 ± 0.03 | 99.15 ± 0.03 | 99.37 ± 0.06 | — |
| CIFAR-100 | 94.55 ± 0.04 | 93.90 ± 0.05 | 93.25 ± 0.05 | 93.51 ± 0.08 | — |
| Oxford Pets | 97.56 ± 0.03 | 97.32 ± 0.11 | 94.67 ± 0.15 | 96.62 ± 0.23 | — |
| Oxford Flowers | 99.68 ± 0.02 | 99.74 ± 0.00 | 99.61 ± 0.02 | 99.63 ± 0.03 | — |
| VTAB-19 mean | 77.63 ± 0.23 | 76.28 ± 0.46 | 72.72 ± 0.21 | 76.29 ± 1.70 | — |
| TPUv3 core-days | 2.5k | 0.68k | 0.23k | 9.9k | 12.3k |
准确率均为百分数;论文报告三次微调的均值与标准差。Noisy Student 使用 ImageNet + 去标签 JFT 的半监督训练,目标和配方不同;表中“更少计算”主要对相同 JFT 监督迁移的 BiT-L 比较最有说服力。
数据规模是结论的一部分
ImageNet 预训练下 ViT-L 比 ViT-B 更差;ImageNet-21k 时接近;JFT 时大型模型才显示完整收益。论文没有证明“Transformer 在任何数据条件下优于 CNN”。
VTAB 的细节
ViT-H/14 在 Natural 与 Structured 组超过 BiT-R152x4;Specialized 组两者相近。整体均值领先不能概括为所有 19 个任务都领先。
计算控制实验
Table 6 对 JFT 预训练的 ViT、BiT 与 hybrid 统一报告 exaFLOPs。ViT-L/16 14 epoch:1567 exaFLOPs、ImageNet 87.12;ResNet200x3 14 epoch:3306 exaFLOPs、87.22,展示接近性能下约 2.1× 计算差距。
自监督只是预实验
masked patch prediction 的 ViT-B/16 达到 ImageNet 79.9%,比从头训练高约 2%,仍比监督预训练低约 4%。它不能支撑“ViT 已解决自监督视觉学习”的强结论。
消融告诉我们的,比主表更细
位置编码
ViT-B/16 的 ImageNet 5-shot:无位置 0.61382;默认 1D 0.64206;2D 0.64001;relative 0.64032。证明“需要位置信息”,但不支持“1D 比二维更本质”;不同编码几乎打平。
Class token vs GAP
附录显示两者调到合适 learning rate 后相近。早期 GAP 失败来自学习率不匹配,而非 class token 必不可少。这是一个很好的负结果修正。
如何扩模型
以 8 层、\(D=1024\)、\(D_{\mathrm{MLP}}=2048\)、patch 32 为交点:增加深度收益最大,16 层后已出现 diminishing returns;缩小 patch 也稳定提升,但增加序列计算;单纯增宽最弱。
Hybrid 的局部先验
小计算预算时 CNN stem 稍有优势,大模型时差距消失。证据支持“局部先验提高数据 / 计算效率”,但不支持它在大规模下始终有害。
官方代码核查:能复现什么,不能声称什么
✓ Encoder:LayerNorm → MultiHeadDotProductAttention → residual;LayerNorm → GELU MLP → residual,吻合 pre-norm 公式。
✓ Tokens:classifier=token 时创建零初始化 cls token;position embedding 为 stddev 0.02 的 learned parameter。
✓ Configs:当前 ViT-B/16 仍是 12 层、768 维、3072 MLP、12 heads;L/16 与 H/14 同样吻合 Table 1。
△ 版本界线:核查的是官方仓库 2026-09-26 当前 commit
64801f1b…,仓库已在 2021-06 改写为 Flax Linen 并继续加入 AugReg、LiT、SAM 等内容;它不是论文提交时训练代码的冻结快照。△ 不可复现项:JFT 数据、内部预处理与 TPU 训练环境不公开。README 的后来 checkpoint 结果不能混作论文 Table 2 数字。
官方仓库还明确说明开源版本从 Big Transfer 工程 fork / 修改;因此“结构一致”与“完全重演 2020 年内部训练流水线”是两个不同的复现层次。
如果把它当作一篇研究论文来审
Strengths
- 贡献极其简洁,变量控制清楚:尽量不改 Transformer,把问题聚焦到数据规模与 inductive bias。
- 不仅报 SOTA,还做 JFT 子集、compute frontier、hybrid、位置编码、head type、模型 shape 等诊断。
- 统一 Adam、硬件和 core-days / exaFLOPs,较认真处理 CNN 公平性。
- Appendix 提供训练与微调网格、逐模型迁移结果和 19-task VTAB breakdown,远强于只报单点。
Weaknesses
- 最强证据依赖不可公开的 JFT-300M,限制独立复现与数据治理审计。
- 任务主要是分类 / 迁移;关于“通用视觉骨干”的外推当时尚未由检测、分割和密集预测直接验证。
- compute 比较仍受 schedule、optimizer、regularization 和实现效率影响,作者也明确承认这一点。
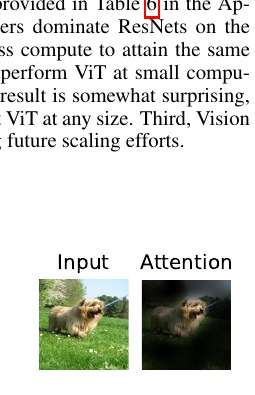
- attention rollout 是表征探针,不是可验证的决策解释。
最可信的因果链
子集实验显示在固定训练超参数下,小数据 ResNet 更好、大数据 ViT 反超;hybrid 在小规模略优且随规模消失。两条证据共同支持“卷积先验主要改善小数据 / 小计算条件”的机制解释。
仍未被隔离的变量
patch 尺寸同时改变空间粒度、序列长度和计算量;更小 patch 的收益不能单独归因于精细空间信息。JFT 的标签噪声、类分布和去重细节也可能参与结果。
沿着论文边界继续做什么
Token budget
学习内容自适应 patch 或 token pruning,使细节区高分辨率、背景区低分辨率;评价时同时报告准确率、延迟、显存与吞吐。
Small-data prior
将卷积 locality、蒸馏、增强或自监督作为可控先验,追踪它们在数据规模增长时何时失去边际收益。
Resolution transfer
把位置插值改成连续坐标编码或相对位置机制,系统测试训练 / 微调分辨率错位与非方形输入。
Procedural material 连接
Research Extension,不是论文已验证内容。
材质图像具有强平铺规律、长程重复与局部微结构。可把多尺度材质 patch 当 token,以 ViT 编码外观,再条件化节点图 / shader program 生成;对比纯全局注意力、卷积 stem 与频域 tokenization,研究程序先验在数据规模下是否也呈现类似拐点。
Execution-aware decoding
Research Extension,不是论文已验证内容。
若输出从类别改为 material graph,ViT 只负责图像条件表征;decoder 需要结构约束、renderer-in-the-loop、graph validity 与 backtracking。不能直接把分类 class token 等同于可执行材质表示。
一手资料与证据边界
- Dosovitskiy et al., arXiv:2010.11929v2 — 本页方法、公式、训练、实验、消融与 Appendix 的主来源。
- ICLR 2021 OpenReview — 会议版本身份与评审记录入口。
- Google Research publication — 官方出版条目、作者与 venue。
- google-research/vision_transformer — 官方 JAX/Flax 实现、预训练 checkpoint 与当前配置;代码核查固定到本地记录的 commit。
- Google Research Blog — 官方方法说明与可视化背景。