3–5
概念图像
同一对象或风格的少量样本,最好覆盖不同背景与姿态。
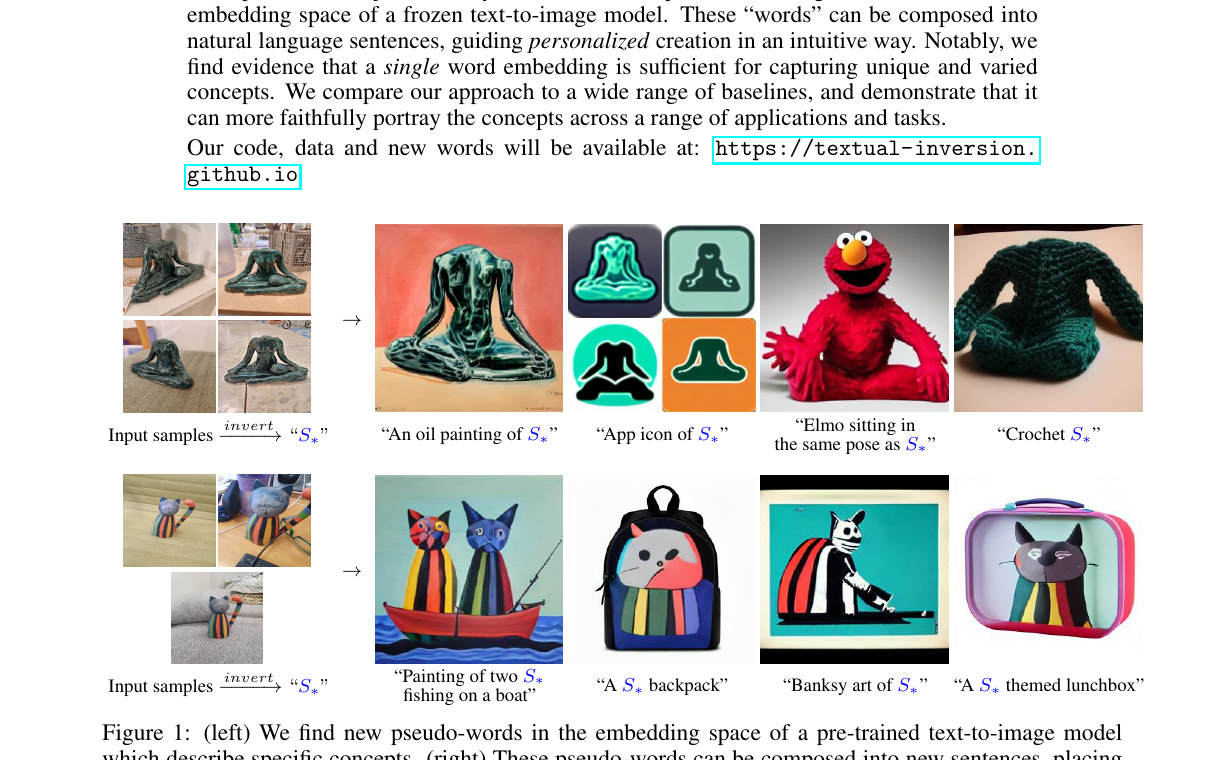
不改 14 亿参数生成器,只学习一个 1280 维词向量:Textual Inversion 把“我的猫、我的玩具、这一种画风”接入冻结扩散模型的语言接口。
它的贡献不只是“小样本微调更省参数”。真正的新意是把个性化概念放进模型已有词汇表的同一坐标系,使新概念仍能与场景、风格和动作词组合。代价也很清楚:身份与精确形状保真有限,单概念约两小时,复杂关系经常失败。
同一对象或风格的少量样本,最好覆盖不同背景与姿态。
LDM 的 BERT token embedding。生成器、文本 Transformer 与 autoencoder 都冻结。
2 × V100、batch 4、有效学习率 0.04;论文报告单概念约两小时。
现有本地 PDF 是 arXiv v1:正文 18 页,Supplementary Materials 8 页,合计 26 页。论文随后作为 ICLR 2023 Oral 发表;正式会议身份由 ICLR Oral 列表和 OpenReview camera-ready 首页交叉确认。实验细节以本地 v1 正文与附录为主,会议身份以最终官方记录为主。
长 caption 能说“彩色茶壶”“金属神灯”,却很难完整表达独特花纹、比例与身份细节;模型只理解训练词汇中已有的粗类别。
每个新概念都重训模型成本高,且少样本微调容易灾难性遗忘。即使加 adapter,也可能无法同时调用原知识与新概念。
核心 hypothesis:冻结模型的词嵌入空间已经是生成器的可组合接口。若能用生成重建损失找到一个新的嵌入 \(v_{\ast}\),它既能承载概念的视觉细节,又能像普通词一样继续被下游文本 Transformer 解释。
这与传统 GAN inversion 不同:目标不是把一张图映射到能重建它的 image latent,而是把一组图中共享的“概念”映射到 text conditioning space。因此输出不是某个固定噪声或某张图,而是可在许多随机采样与新句子中复用的 pseudo-word。
| 符号 | 含义 | 训练中是否更新 |
|---|---|---|
| \(x\) | 用户概念图像;对象或共享风格样本。 | 数据 |
| \(E,D\) | LDM autoencoder 的图像编码器与解码器,\(z=E(x)\),\(x^{\prime}=D(z_0)\)。 | 冻结 |
| \(S_{\ast}\) | 占位 pseudo-word;公开 LDM 代码默认字符串是 *。 | 离散标识,不更新 |
| \(v_{\ast}\) | 与 \(S_{\ast}\) 绑定的新 embedding;主实验为单个 1280 维向量。 | 唯一主要可训练参数 |
| \(c_{\theta}(y)\) | 文本编码器把 prompt \(y\) 映射到 conditioning code。 | 函数冻结,但输入中的 \(v_{\ast}\) 有梯度 |
| \(\epsilon_{\theta}\) | 条件扩散去噪网络,输入 \(z_t,t,c_{\theta}(y)\),预测所加噪声。 | 冻结 |
| \(t,\epsilon\) | 随机 diffusion timestep 与高斯噪声 \(\epsilon\sim\mathcal N(0,\mathbf I)\)。 | 每步采样 |
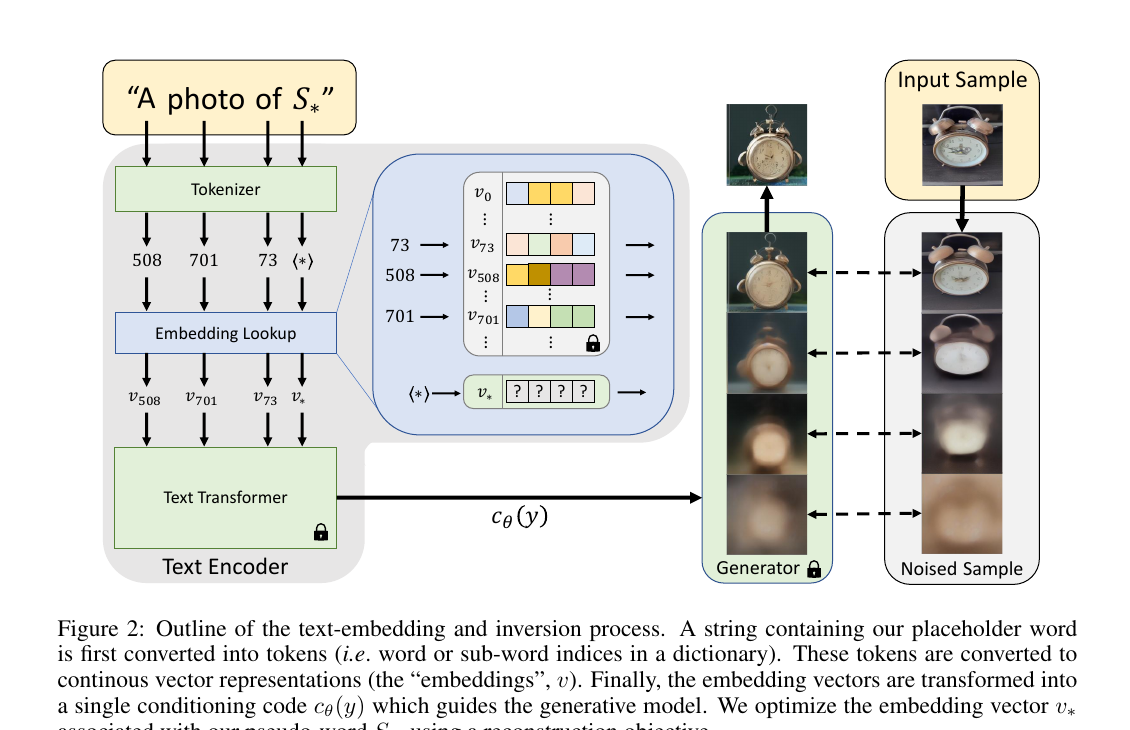
LDM 先在 autoencoder latent 中做 diffusion。给图像 \(x\)、latent \(z=E(x)\)、条件文本 \(y\),在时间步 \(t\) 加噪得到 \(z_t\)。原始条件扩散目标为:
Textual Inversion 把优化变量缩成一个 embedding:
为什么这能学到视觉概念?若 \(v\) 只表达粗类别,冻结 UNet 无法在所有训练图与随机噪声/时间步上准确预测噪声;优化必须把能解释共享颜色、结构或笔触的信息编码进 conditioning。随机模板则阻止向量只适配一句固定 prompt。
| 项目 | 论文设置 | 公开实现补充 | 证据边界 |
|---|---|---|---|
| Backbone | Rombach et al. 的 1.4B text-to-image LDM,LAION-400M 预训练;BERT text encoder。 | UNet context dim 1280;图像 latent 4 channels、下采样 8 倍;输入 256。 | 论文没有重新训练 backbone。 |
| 训练参数 | 2 × NVIDIA V100;batch size 4;base LR 0.005,按 GPU 数和 batch 缩放为 0.04;5,000 steps。 | AdamW;默认配置 max_steps: 6100,每 500 step 保存/记录;README 指向 embeddings_gs-5049.pt。 | 论文未报告 AdamW 的 betas、weight decay、precision、scheduler、warmup、V100 型号或训练显存。 |
| 数据 | 每概念通常 3–5 图,覆盖背景或姿态;对象与风格均可。 | 随机水平翻转 \(p=0.5\)、bicubic resize 到 \(256^2\),默认不 center crop;训练集重复 100 次。 | 概念数量与完整 train/eval 清单未在正文给出;官方仓库称部分数据因版权未发布。 |
| 初始化 | 单词级粗类别 embedding,例如 sculpture、cat。 | 对象默认 sculpture;style 配置默认 painting;若字符串不是单 token,代码直接拒绝。 | 每个概念具体初始化词未形成完整公开表。 |
| 冻结范围 | 生成器与 text encoder 固定。 | configure_opt_embedding() 显式冻结 cond stage 和 model,只向 AdamW 传 embedding 参数。 | 这是本文关键可复现事实。 |
| 耗时 | 单概念约 2 小时。 | README 称后续 gradient memory 优化把内存与训练时间降低约 55%。 | 后者是仓库更新说明,不是论文 benchmark。 |
Supplement D 列出 27 个对象模板,核心是 photo / rendition 与 clean、dirty、dark、cool、close-up、bright、nice、small、weird、large 等轻量变化。它们不是自然语言指令数据集,也没有 system prompt、few-shot 或 chain-of-thought。Style 使用形如 “a painting in the style of \(S_{\ast}\)” 的专门模板。
含占位词的 prompt、embedding checkpoint、冻结 LDM checkpoint 与随机 noise。
论文评测:50 DDIM steps。官方 README 示例:\(\eta=0\)、guidance 10、每轮 8 张 × 2 轮。
论文展示通常每 prompt 生成 16 个候选后人工选最好;DALL-E 2 只生成 6 个。附录另给 uncurated galleries。
没有 beam search、top-\(k\)、top-\(p\)、reranking model 或 stopping controller。失败时论文工作流依赖换 seed / 重采样与人工挑选;仓库也提示结果对 seed 敏感,并建议在 prompt 中加入 “a photo of” 提高概念一致性。
“A photo of \(S_{\ast}\)” 生成新的视角与实例;相比人类 caption 更能保留花纹和独特外观,但不是精确重建。
把玩具做成巧克力、背包、邮票或置入月球等新场景,调用冻结模型已有先验。
用共享画风样本学习 style token,再生成新主题。不同于传统 style transfer,它不保留某张 content image。
两个 learned token 可组合成“时钟以某风格绘制”,但复杂空间关系失败。
用小型多样数据学习替代 doctor embedding,视觉上提高性别与族裔多样性;论文只给定性示例。
与同一 LDM 上的 Blended Latent Diffusion 兼容,无需再改该编辑器。
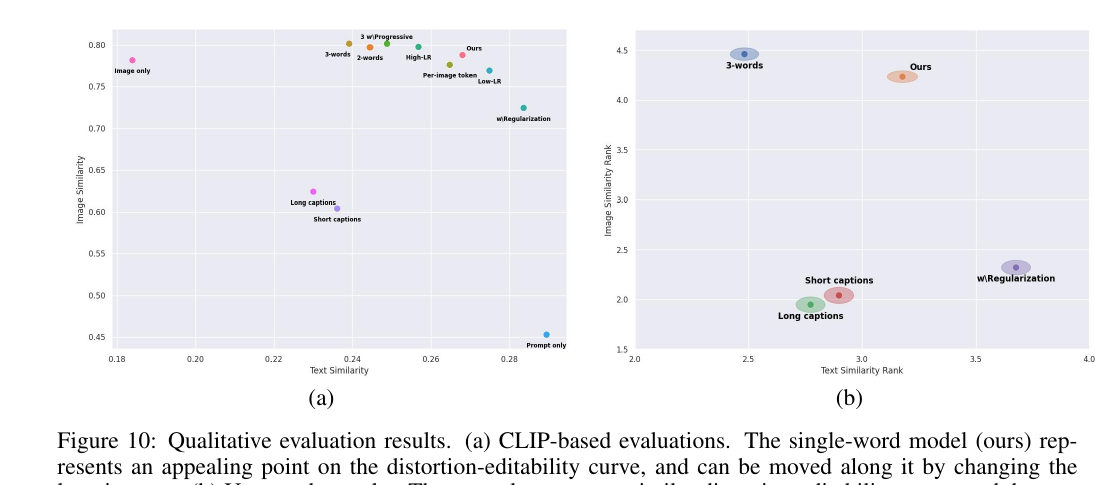
论文没有发布 Figure 10 数值表。下表是为帮助阅读而从坐标图 约读 的值,只用于理解相对位置;任何复现对比都应使用原图或作者原始数据,而不是把这些近似值当 ground truth。
| 设置 | CLIP Text Similarity ↑(约) | CLIP Image Similarity ↑(约) | 人评 text mean rank ↑(约) | 人评 image mean rank ↑(约) | 读图结论 |
|---|---|---|---|---|---|
| Image Only | 0.18 | 0.78 | — | — | 像训练图,但完全不执行编辑。 |
| 3 words | 0.24 | 0.80 | 2.50 | 4.46 | 概念保真很高,但文本编辑遵循较弱。 |
| 2 words | 0.25 | 0.79 | — | — | 额外容量没有带来更好编辑。 |
| Progressive | 0.25 | 0.80 | — | — | 高 image CLIP,editability 仍落后。 |
| High-LR | 0.26 | 0.79 | — | — | 向保真端移动。 |
| Per-image token | 0.26 | 0.78 | — | — | 没有优于单词方案。 |
| Ours | 0.27 | 0.79 | 3.14 | 4.25 | 作者选择的折衷点:明显右于多词,同时保持接近最高的概念相似性。 |
| Low-LR | 0.27 | 0.77 | — | — | 更可编辑,但概念保真下降。 |
| L2 regularization | 0.28 | 0.73 | 3.65 | 2.34 | 最能执行编辑,但概念相似性明显损失。 |
| Long captions | 0.23 | 0.62 | 2.77 | 1.94 | 概念保真在人评与 CLIP 两侧都明显较低。 |
| Short captions | 0.24 | 0.61 | 2.90 | 2.03 | 略更贴合编辑文本,但仍难表达独特细节。 |
| Prompt Only | 0.29 | 0.45 | — | — | 执行文本但丢失个性概念。 |
用户研究:两份问卷分别测概念相似与文本相似;每题把 5 个模型排序。每份收集 600 responses,共 1,200,误差条是 95% confidence interval。论文没有披露独立参与者数、每位答题数、随机化与显著性检验,因此“与 CLIP 一致”应理解为曲线趋势相似。
| 变体 | 改了什么 | 观察 | 实际支持的结论 |
|---|---|---|---|
| 2/3 words | 为一个概念学习 2 或 3 个 embedding。 | 重建相近,editability 明显落后单词。 | 在当前优化与 LDM 中,容量不是主要瓶颈;多向量更易离开真实词分布。 |
| Progressive | 第 0 步一个向量,2,000 步加入第二个,4,000 步加入第三个。 | 未优于单向量折衷。 | GAN 的 progressive \(W^+\) 思路不能直接迁移。 |
| L2 regularization | 把 \(v_{\ast}\) 拉向 coarse descriptor embedding。 | 文本可编辑性升,图像相似性降。 | 存在离真实词分布距离与重建/编辑之间的 trade-off。 |
| Per-image tokens | 共享 token + 每图私有 token,25% 概率使用双 token 模板。 | 未明显改善共享概念分离。 | 背景信息不一定会自然被私有 token 吸收。 |
| 学习率 | 论文将 High-LR 写为 \(2\times10^{-2}\),Low-LR 写为 \(10^{-4}\)。这些与 base LR 0.005 同属论文报告口径;论文未说明 ablation 数值是否也经 GPU × batch 缩放,不能直接拿它们和标准 effective LR 0.04 比大小。 | 曲线中 High-LR 偏重建,Low-LR 偏编辑。 | LR 是曲线位置的简单控制杆;复现必须明确 base/effective 口径。 |
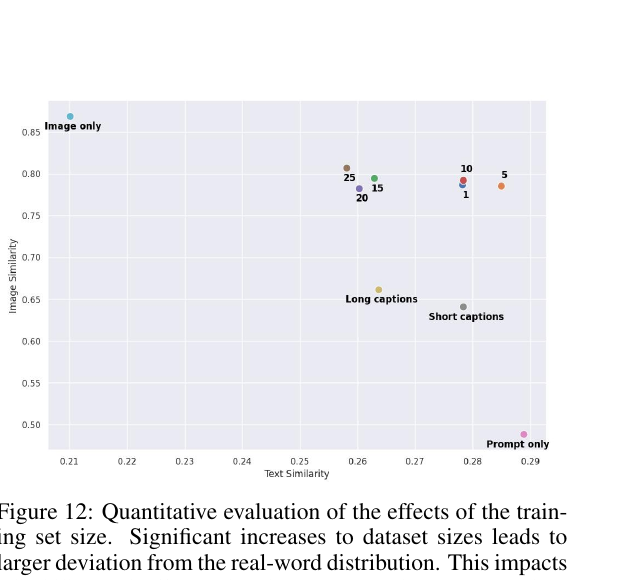
| 训练图数量 | 同一雕塑从 1 图扫到 25 图。 | 约 5 图最好;更多图仅微增重建,却进一步伤编辑。 | 在这个单对象 case 中,更多数据会让 embedding 更偏离词分布;不是普遍样本复杂度定律。 |
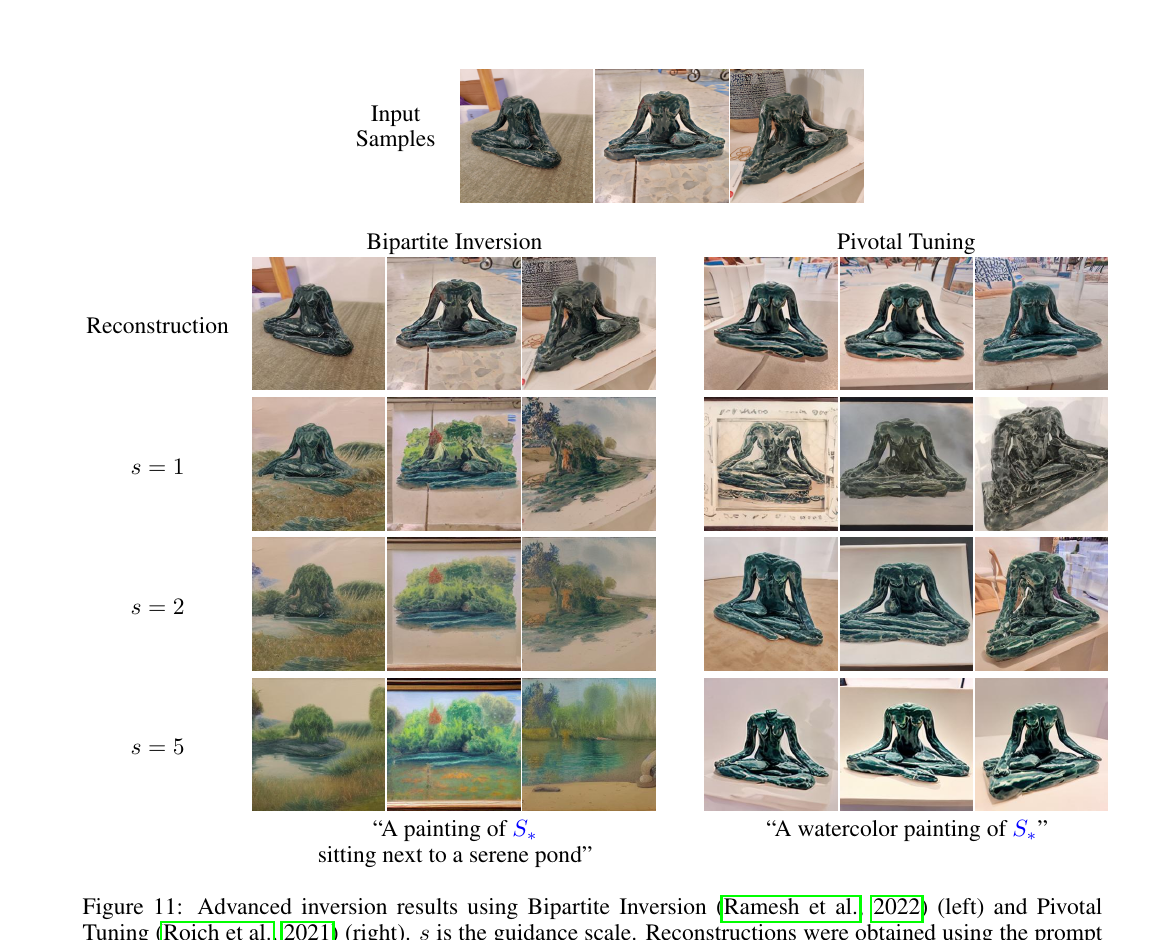
| Bipartite DDIM inversion | 固定能重建某图的噪声 \(x_T\),再换 prompt。 | 低 guidance 保结构但不跟 prompt;高 guidance 结构漂移。 | 更精确 image inversion 不等于可编辑 concept inversion。 |
| Pivotal tuning | 先学词,再微调 generator 以重建训练集。 | 形状改善,但高 guidance 编辑坍塌并出现 artifacts。 | 朴素模型微调破坏通用生成先验。 |
审计官方仓库默认分支固定提交 424192de1518a358f1b648e0e781fdbe3f40c210。这是 17 commits 的轻量实现,构建在原 LDM 代码上。
| 核查点 | 论文说法 | 代码观察 | 影响 |
|---|---|---|---|
| 冻结是否真实 | 只优化新 embedding。 | optimizer 只收 embedding_manager.embedding_parameters();text encoder 与 diffusion model 均 requires_grad=False。 | 核心 claim 与实现一致。 |
| 单 token 限制 | pseudo-word 作为一个词。 | BERT/CLIP tokenizer 检查会 assert placeholder 与 initializer 恰为单 token。 | 自定义字符串并非任意;复现需先测 tokenizer。 |
| 对象模板 | Supplement D 称给出“the list”,共 27 个 photo/rendition 模板。 | personalized.py 的主模板列表还追加 illustration 与 depiction 变体,合计远多于 27;公开默认训练会从扩展列表采样。 | 论文与当前代码模板集合不完全一致;可能影响 conditioning 多样性。 |
| 训练步数 | 所有结果 5,000 steps。 | 配置 max_steps: 6100,README 示例加载 embeddings_gs-5049.pt,并声明曾修复 training duration/checkpoint save iterations。 | 应显式停在约 5,000,而不是盲用 config 上限。 |
| Style 路径 | 使用 “painting in the style of” 模板。 | 独立 personalized_style.py 有 19 个 style 模板,initializer 是 painting。 | 对象与风格实验不能共用同一 dataset class。 |
| Stable Diffusion | 论文实验是 LDM。 | 仓库包含 SD configs 和 sampler,但 README 仍写 support work in progress,pretrained embeddings TODO。 | 不能把后续社区 SD textual inversion 结果归因给本文实验。 |
| 数据完整性 | 代码、数据和 new words 将公开。 | README 称部分数据因 ownership 不可用,pretrained embeddings 仍 TODO。 | 完整复现实验概念集与 Figure 10 原始数据不可直接获得。 |
| 图像方向 | 正文未强调。 | PIL 不读取部分手机 EXIF orientation;README 要求手动确认输入竖直。 | 一个未文档化到论文的预处理陷阱。 |
| Claim | 证据 | Reviewer 判断 |
|---|---|---|
| 单 embedding 足以表示新概念 | Figure 10 中单词方案在 CLIP 曲线上优于多词的 editability;人评仍认为其概念更像训练集。 | 对本文 LDM 与测试概念有支持;“足以”应理解为可用折衷,不是无损编码。 |
| 比 caption 更忠实 | Figure 3 定性结果、Figure 10 CLIP image score 与 user study。 | 总体支持,但 caption collection 与概念难描述程度可能偏向本方法。 |
| 可组合 | 多种新 prompt 与双 token 图;附录失败例。 | 支持属性/风格组合,关系组合证据反而显示明显不足。 |
| 能减少偏差 | doctor 的 uncurated 定性图。 | 仅 proof of concept;没有公平性 metric、组别定义或不同 seed 的统计。 |
| 易迁移到更大模型 | 方法只依赖 token embedding 接口。 | 架构上合理,但属于作者推测;本文没有在更大封闭模型上验证。 |
训练 set encoder 直接预测 \(v_{\ast}\),把两小时优化变成一次前向;需要跨大量身份/对象训练,并处理 set size 与视角不变性。
单向量受限时,可让概念表示随 cross-attention layer 或 diffusion timestep 变化;要加 regularization 保住 editability,不能只堆容量。
用 DINO/face/object-specific feature、局部 correspondence 或 segmentation-aware loss 补足 CLIP 对形状不敏感的问题。
训练模板加入多对象、空间关系与 hard negatives,明确约束 token 绑定;评测要拆分属性组合与关系组合。
把 reconstruction 与 editability 组成 Pareto validation,动态选 step/LR,避免固定 5,000 步对风格过拟合。
embedding 文件带 provenance、授权范围、撤销与水印信息;风格 token 的治理应成为系统设计而非页末声明。
拖动权重,理解为什么论文没有单一最优点。这个教学计算不是论文 metric。
建议关注:Ours / 标准 LR
核查日期:2026-09-27。网页没有独立训练 LDM 或重跑用户研究;实验数字来自论文,Figure 10 表内数字明确为原图约读。原论文 Figure 1、2、10、11、12 均从本地 PDF 渲染后裁切并内嵌;页面无需联网即可阅读与渲染公式。