本文明确完成
给出 DLVM 背景、ELBO 等式推导、随机梯度与重参数化、Gaussian posterior、重要性采样、IAF、多层潜变量和应用回顾。
Paper Reading / Variational Inference
从不可积的潜变量模型,到可微、可扩展、可采样的学习框架。
这篇 2019 年教程真正讲清楚的,不是“一个 encoder 接一个 decoder”,而是如何把近似后验、证据下界与低方差梯度估计器组合成可用 minibatch SGD 训练的深度潜变量模型。
身份说明:这是对 2013/2014 年 Auto-Encoding Variational Bayes 的扩展教程与选择性综述,不是原始 AEVB 论文,也不是全面覆盖所有 VAE 文献的 survey。核查日期:2026-09-27。
01 / WHAT THIS WORK IS
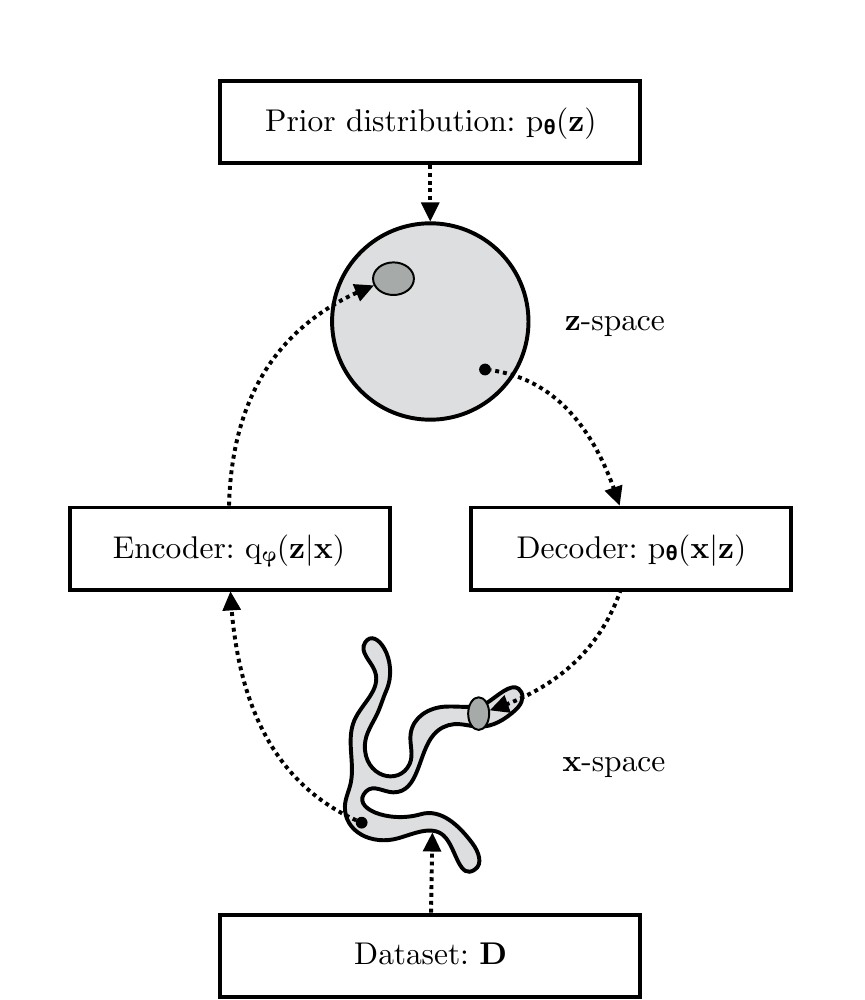
作者把 VAE 定义为两个耦合但独立参数化的概率模型:生成模型 \(p_{\theta}(\mathbf{x},\mathbf{z})\) 解释数据如何由潜变量产生;推断模型 \(q_{\phi}(\mathbf{z}\mid\mathbf{x})\) 近似无法直接计算的真实后验。两者通过同一个 ELBO 目标联合优化。encoder 的价值不是压缩本身,而是把每个样本都要单独迭代求解的 variational inference,摊销为一次前向传播。
给出 DLVM 背景、ELBO 等式推导、随机梯度与重参数化、Gaussian posterior、重要性采样、IAF、多层潜变量和应用回顾。
VAE 把 directed graphical model 与 deep learning 接起来,使连续潜变量的近似后验推断和近似最大似然学习可扩展到大数据。
“VAE”首先是一套目标与梯度估计框架。卷积层数、latent 维度、decoder 类型不是此教程规定的固定结构。
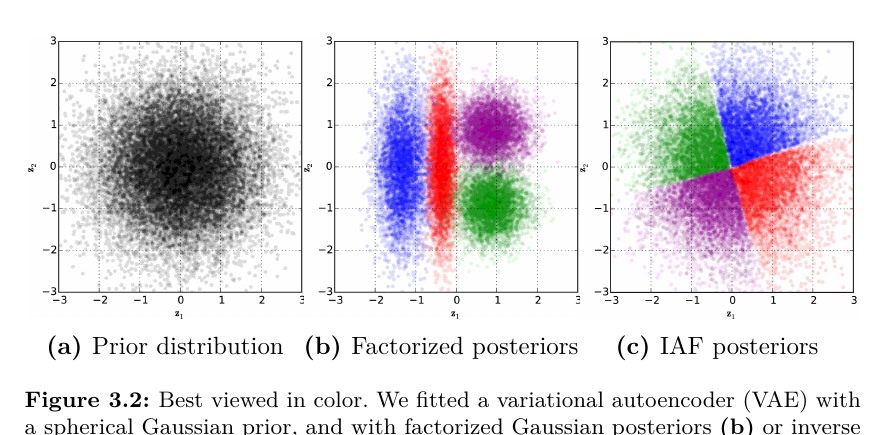
文中的 MNIST、ImageNet、化学设计、文本插值与图像编辑数字或图片来自被引用的后续工作;Figure 3.2 是用于说明 IAF 灵活性的 toy fit。本文没有重新训练一组统一 baseline、没有新数据集,也没有自己的系统消融表。
02 / FORMULATION
给定 i.i.d. 数据集 \(\mathcal{D}=\{\mathbf{x}^{(i)}\}_{i=1}^{N}\),作者希望学习一个含未观测变量 \(\mathbf{z}\) 的 joint model。最常见分解是:
但边际似然需要消去潜变量:
VAE 引入 \(q_{\phi}(\mathbf{z}\mid\mathbf{x})\) 近似真实后验。其参数 \(\phi\) 在所有数据点之间共享,这就是 amortized inference:用训练 encoder 的成本,换掉测试时对每个样本单独做 variational optimization 的内循环。
| 符号 | 含义 | 在计算图中的作用 |
|---|---|---|
| \(\mathbf{x}\) | 观测数据,可连续或离散 | encoder 输入、decoder 的 likelihood 目标 |
| \(\mathbf{z}\) | 模型中的未观测随机变量 | 解释变化因素;训练时由近似后验采样 |
| \(\theta\) | 生成模型参数 | 决定 joint / decoder;最大化近似数据似然 |
| \(\phi\) | 推断模型的 variational parameters | 由 encoder 产生 posterior distribution 的参数 |
| \(q_{\phi}\) | 近似后验,不是 prior | 训练时给出易采样、易算密度的 proposal |
| \(\mathbf{\epsilon}\) | 与 \(\mathbf{x},\phi\) 独立的基础噪声 | 把随机性移出计算路径,使梯度可反传 |
03 / EVIDENCE LOWER BOUND
教程刻意不从 Jensen 不等式开始,而是把任意 \(q_{\phi}(\mathbf{z}\mid\mathbf{x})\) 乘入再除去,直接显示“下界差多少”。
ELBO 的最一般形式是:
若 joint 分解为 \(p(\mathbf{z})p_{\theta}(\mathbf{x}\mid\mathbf{z})\),得到最常见的“重建 + 正则”写法:
提升 joint model 对数据与潜变量样本的解释能力,因而近似提升 marginal likelihood。
缩小 \(q_{\phi}(\mathbf{z}\mid\mathbf{x})\) 与当前真实 posterior 的 KL,使 encoder 更接近有效推断。
最大化 ELBO 不等于直接最大化精确 likelihood。模型误差与 posterior family 受限时,ELBO 可能通过改变生成模型来配合一个容易近似的 posterior;这被称作 variational bias。教程通过 joint-space KL 分解说明了这点。
04 / PATHWISE GRADIENT
对 \(\theta\) 求梯度较直接,因为采样分布 \(q_{\phi}\) 不依赖 \(\theta\)。困难在 \(\phi\):期望的 measure 自身会随 \(\phi\) 变化,不能把梯度简单移入 expectation。
对于连续潜变量,选一个与 \(\mathbf{x},\phi\) 无关的噪声分布 \(p(\mathbf{\epsilon})\),并构造可微映射:
于是:
pathwise gradient 本身只要求能把样本写成对 \(\phi\) 可微的变换;不要求该变换可逆。本文随后为计算 \(\log q_{\phi}(\mathbf{z}\mid\mathbf{x})\) 选择可逆变换,并用 change-of-variables 与 Jacobian determinant 得到密度。可逆性服务于 density evaluation,不是重参数化梯度的一般必要条件。
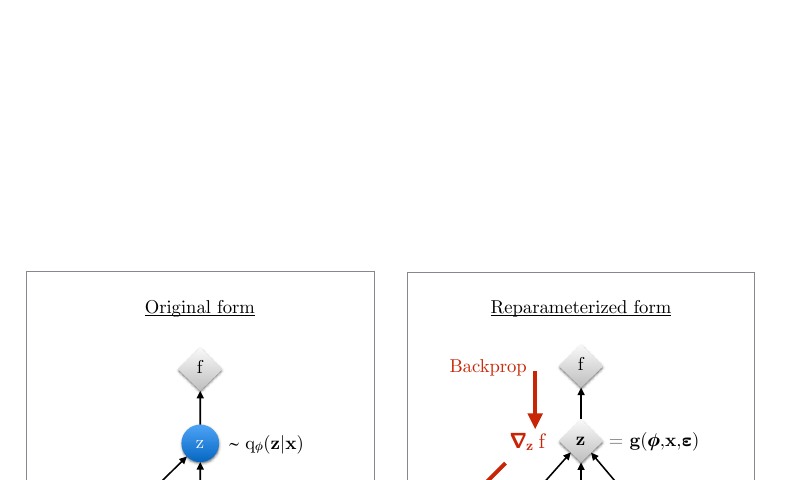
一般地,若 \(f_{\phi}\) 还显式依赖 \(\phi\),右侧必须再加 \(\mathbb{E}_{q_{\phi}}[\nabla_{\phi}f_{\phi}(\mathbf{z})]\)。对 ELBO 令 \(f_{\phi}=\log p_{\theta}(\mathbf{x},\mathbf{z})-\log q_{\phi}(\mathbf{z}\mid\mathbf{x})\) 时,这个显式项不能在逐样本推导中凭空忽略;其期望中的 score 部分为零,才得到常见 likelihood-ratio 形式。该估计器不要求连续、可微的 \(\mathbf{z}\),可用于离散 latent;代价是只通过标量 reward 传信息,通常方差高,需要 baseline / control variate。教程引用 Kucukelbir 等人的结果:在其比较中,复杂的 score-function estimator 为达到同等方差需要约两个数量级更多样本。这个数字来自外部研究,不是本文重新实验。
05 / ALGORITHM
其 Jacobian 是 \(\operatorname{diag}(\mathbf{\sigma})\),所以:
若 \(p(\mathbf{z})=\mathcal{N}(\mathbf{0},\mathbf{I})\) 且 \(q_{\phi}=\mathcal{N}(\mathbf{\mu},\operatorname{diag}(\mathbf{\sigma}^2))\),Gaussian KL 可化为:
全协方差 Gaussian 用 Cholesky-like 下三角矩阵 \(\mathbf{L}\):\(\mathbf{z}=\mathbf{\mu}+\mathbf{L}\mathbf{\epsilon}\),且 \(\log|\det\mathbf{L}|=\sum_i\log|L_{ii}|\)。表达力增加到维度间线性相关,但 encoder 输出与计算量从 \(\mathcal{O}(D)\) 上升到 \(\mathcal{O}(D^2)\) 量级。
| 训练/评估量 | 估计方式 | 注意点 |
|---|---|---|
| ELBO | 通常一份或少量 posterior samples | 单样本 pathwise gradient 无偏,但方差仍存在 |
| marginal likelihood | \(\log\frac{1}{L}\sum_{l=1}^{L}\frac{p_{\theta}(\mathbf{x},\mathbf{z}^{(l)})}{q_{\phi}(\mathbf{z}^{(l)}\mid\mathbf{x})}\) | \(L\to\infty\) 时一致;有限 (L) 的 log-estimate 有偏 |
| IWAE objective | 把同一个多样本重要性下界用于训练 | 随 (L) 增大界更紧,但高维 latent 的 importance weights 易退化 |
06 / POSTERIOR FAMILIES
可用的 approximate posterior 必须同时满足:能快速采样;能快速计算并微分 \(\log q_{\phi}(\mathbf{z}\mid\mathbf{x})\);高维时最好能并行。简单 diagonal Gaussian 满足工程条件,却无法表达多峰、偏斜或复杂相关结构。
| 选择 | 优势 | 代价 / 边界 |
|---|---|---|
| Diagonal Gaussian | 采样、log-density、Jacobian 都是逐维并行 | 仅能表达条件独立的椭球轴向后验 |
| Full-covariance Gaussian | 表达线性相关 | 输出矩阵,仍是单峰 Gaussian |
| Auxiliary variables | 积分掉辅助变量后可产生更复杂隐式 posterior | 需要扩展 generative model,增加辅助 KL 代价 |
| Normalizing flow | 可逆变换链逐步弯曲基础分布 | 每步必须有可计算的 Jacobian determinant |
| IAF | posterior sampling across dimensions 可并行;log-det 简单 | 每个 flow step 需 autoregressive network,求逆方向较慢 |
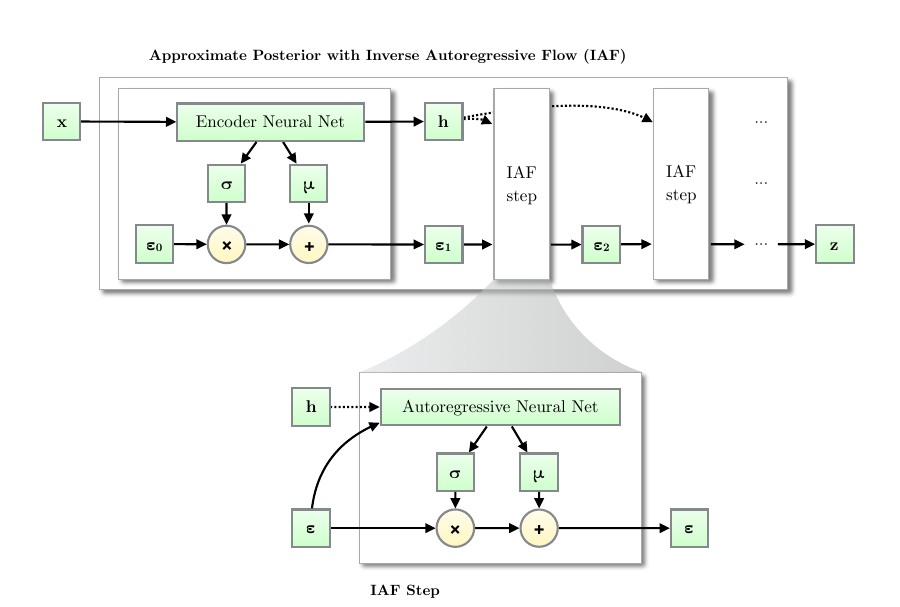
IAF 使用 autoregressive parameterization 让 Jacobian 成为三角矩阵,determinant 只需对角项之积。它把“复杂 posterior”化为“简单 base density + 多个可逆、可微、易算体积变化的变换”。
07 / DEEPER GENERATIVE MODELS
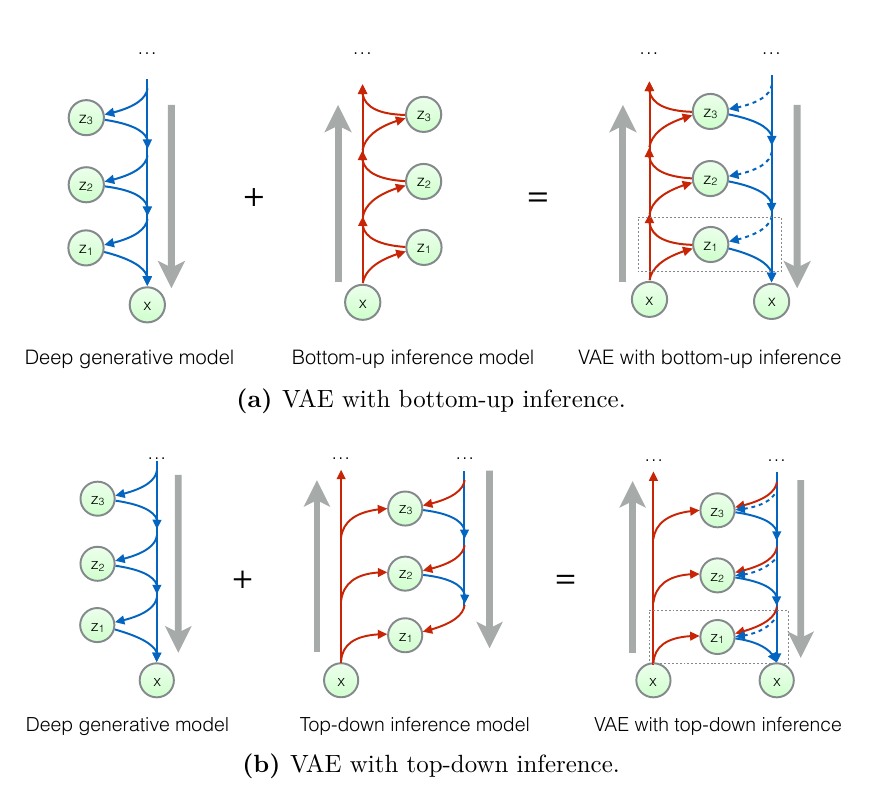
对于 \(\mathbf{z}=\{\mathbf{z}_1,\ldots,\mathbf{z}_K\}\),inference model 按自己的 DAG 做 ancestral sampling;每个随机节点都重参数化:
采完全部 latent 后,只需计算标量 \(\log p_{\theta}(\mathbf{x},\mathbf{z})-\log q_{\phi}(\mathbf{z}\mid\mathbf{x})\),整个图便可微。生成模型与推断模型的 latent ordering 可以相反,也可以相同;作者引用多项工作说明,同向 top-down inference 便于共享 prior 与 posterior 参数,可能训练更快、解更好。
通过积分混合大量条件分布;合成可并行,但 likelihood 依赖近似推断。
\(p(\mathbf{x})=\prod_j p(x_j\mid\mathbf{x}_{\lt j})\)。density 精确,采样长度通常是 \(\mathcal{O}(D)\),且需选择 ordering。
数据与简单 base distribution 间可逆;likelihood 精确,受同维可逆映射与 Jacobian 结构约束。
教程的判断是,当时 likelihood 最好的系统通常组合以上策略。它引用 Kingma et al. 2016 的实验称 latent-variable model 的并行 synthesis 可获得约 \(100\times\) 的速度改善;这不是本教程独立复测,且依赖具体比较对象与实现。
08 / FAILURE MODES
训练早期 decoder 的 likelihood 信号弱,\(q_{\phi}(\mathbf{z}\mid\mathbf{x})\approx p(\mathbf{z})\) 可能成为稳定点,latent 不携带数据相关信息。教程给出两类缓解:
作者引用其 2016 工作称 \(\lambda\in\{0.125,0.25,0.5,1,2\}\) nats 在一个 benchmark 中都有效;这只是被引用实验的经验范围,不是通用定律。
教程从 joint-space 的 forward KL 解释:优化 ELBO 等价于最小化 \(D_{\mathrm{KL}}(q_{\mathcal{D},\phi}(\mathbf{x},\mathbf{z})\,\|\,p_{\theta}(\mathbf{x},\mathbf{z}))\)。当模型不能完美拟合时,把 probability mass 放到数据未覆盖区域的惩罚相对弱,模型分布可能更分散。作者建议提升 inference model 或 generative model 的灵活性。
这个解释揭示了 KL 方向的影响,但并不把所有视觉模糊归因于同一个原因。Gaussian observation 的均值预测、decoder capacity、数据多模态、optimization 和 evaluation criterion 都可能参与;教程没有做因果消融来分离这些因素。
本文强调 amortized inference 的速度优势,却没有系统量化两种误差:posterior family 无法表示真实 posterior 的 approximation gap,以及共享 encoder 没有为每个样本找到该 family 最优参数的 amortization gap。更强 encoder、per-example refinement 或 semi-amortized inference 可针对后者,但超出本文实证范围。
09 / EVIDENCE MAP
| 教程中的陈述 | 证据性质 | 可得结论 |
|---|---|---|
| Figure 3.2:IAF 比 factorized Gaussian 更贴合 toy posterior | 教程内展示的四点二维 toy fit | 说明 IAF family 更灵活;不能推成所有真实数据必然提升 |
| free bits 在 \(\lambda=0.125\) 到 2 nats 的多值上改善 likelihood | 引用 Kingma et al. 2016 的一个 benchmark | 给出实用经验范围;不是本教程新消融 |
| score-function 为同方差需约 \(100\times\) 样本 | 引用 Kucukelbir et al. 2017 | 支持连续 latent 下 pathwise gradient 的效率优势 |
| MNIST 仅每类 10 标签时低于 1% error | 引用 Maaløe et al. 2016 等 semi-supervised work | VAE 可辅助低标签分类;不代表普通 VAE 的默认表现 |
| ImageNet 1% 标签:监督约 5%,VAE 半监督约 45% | 引用 Pu et al. 2016 | 展示特定模型与协议的数据效率差异 |
| latent model synthesis 约 \(100\times\) 更快 | 引用 Kingma et al. 2016 | 针对与 sequential autoregressive synthesis 的特定比较 |
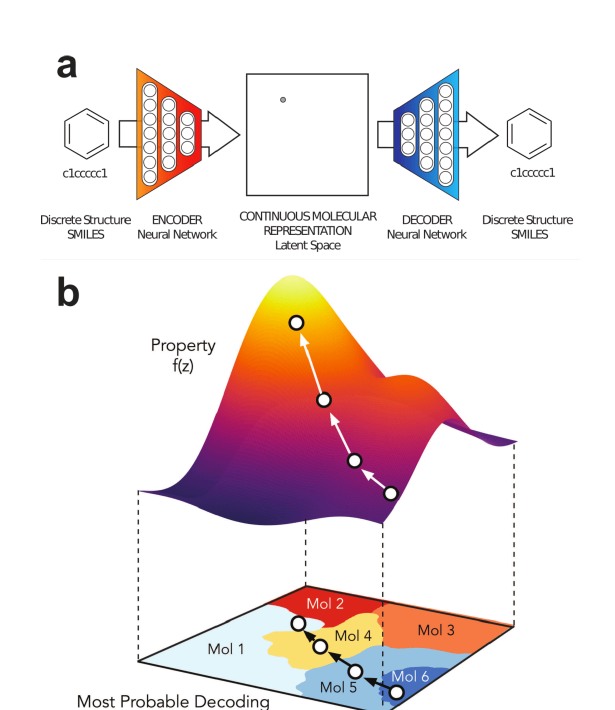
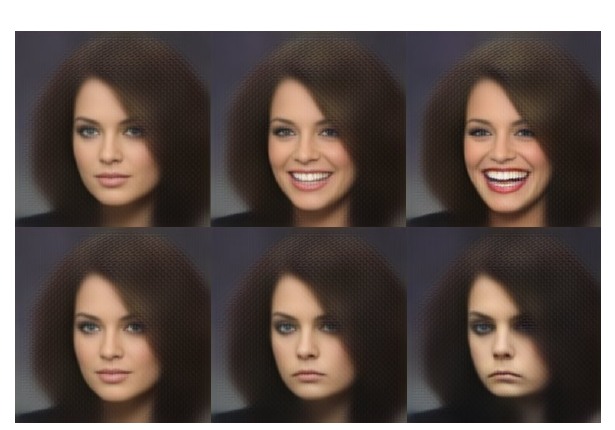
10 / REPRODUCTION LENS
| 项目 | 本文提供 | 本文没有统一规定 |
|---|---|---|
| Generative model | joint factorization、Bernoulli example、层次 DAG 原则 | 具体 backbone、层数、参数量 |
| Inference model | diagonal/full Gaussian、auxiliary、NF/IAF | 固定 latent size、flow depth |
| Objective | ELBO、importance estimate、free bits 形式 | 针对某数据集的 loss 权重表 |
| Optimization | minibatch SGD 与 doubly stochastic algorithm | optimizer、learning rate、schedule、warmup、batch size、epoch |
| Data / evaluation | 应用与 follow-up work 的选择性综述 | 本教程自己的 train/val/test split、统一 baseline、算力与耗时 |
11 / REVIEWER COMMENTARY
从 log-evidence 的精确分解解释 lower bound tightness,读者能看见近似后验为何同时影响推断和生成模型学习。
posterior 不仅要“更灵活”,还必须能采样、算密度、算 Jacobian,并适应 GPU 并行;IAF 的设计动机因此完整。
作者明确说不是 comprehensive review;大量篇幅围绕他们参与的 AEVB、IAF 与 deep hierarchy 工作,替代方法覆盖不均。
没有统一代码快照、数据协议和结果表。引用数字跨论文,比较对象与实现背景不同,不应横向拼成 leaderboard。
结论中“唯一框架”等措辞是 2019 年语境下的作者主张,且没有在本文通过穷举比较证明;不应当作长期定理。
它提供从 graphical model 到工程实现的连续推理链,对理解现代 amortized inference、flow 与 latent generative model 仍很有价值。
让高层变量表示 material graph topology,低层变量表示连续节点参数;用 execution-valid decoder 或约束分布避免无效图。
encoder 条件可同时包含目标渲染、当前 graph 与多视图 residual;flow posterior 表达一张图对应多组等价材质参数的多模态不确定性。
encoder 给快速初始化,再对单样本用 renderer feedback 优化 variational parameters,显式测量 amortization gap 与额外渲染预算。
以上三项是基于教程框架提出的研究设想,原论文没有在 procedural material、shader graph 或 renderer-in-the-loop 上验证。
12 / SOURCES
本地 arXiv PDF 有 89 个文件页,包含封面、目录与参考文献;正式出版页码为 307–392,共 86 页。页面中的 PDF 链接使用文件页定位。