它解决的不是“让图动起来”,而是三种约束同时成立
已有姿态迁移或通用 image-to-video 方法分别容易丢服装细节、动作不准、跨帧闪烁。Animate Anyone 将角色外观、逐帧姿态和时间连续性拆成三个模块,再用两阶段训练避免“每帧清晰”与“整段平滑”互相吞噬。
Research gap
CLIP 图像编码器在 \(224\times224\) 输入上偏向高层语义,不能稳妥搬运纹理、Logo、服饰结构;ControlNet 假设条件与目标空间对齐,而参考图和新姿态并不像边缘图与目标图那样像素对齐。
核心假设
若 ReferenceNet 与去噪 UNet 同构、都由 Stable Diffusion 初始化,二者特征天然处于相近空间;让目标帧 token 在空间注意力中读取参考特征,可比外部语义 embedding 保留更多细节。
输入、输出与变量
输入
参考图 \(I_{\mathrm{ref}}\) 描述角色外观;驱动姿态序列 \(P_{1:F}\) 由 DWPose 提取身体与手部关键点,再按 OpenPose 骨架绘成对齐图像。生成从高斯潜变量噪声 \(z_T\) 开始。
输出
VAE 解码后的角色视频 \(\hat V_{1:F}\)。每帧要贴合 \(P_f\),同时保持 \(I_{\mathrm{ref}}\) 的身份、服装、纹理和背景信息,并使相邻帧连续。
固定组件
Stable Diffusion 的 VAE encoder / decoder 与 CLIP image encoder 在第一阶段均固定。论文未报告它采用具体哪个 Stable Diffusion checkpoint,也未报告参数量。
可训练组件
阶段一训练 denoising UNet、ReferenceNet 与 Pose Guider;阶段二插入由 AnimateDiff 初始化的 temporal layers,只训练这些时序层,其余全部冻结。
一条去噪主干,三路条件
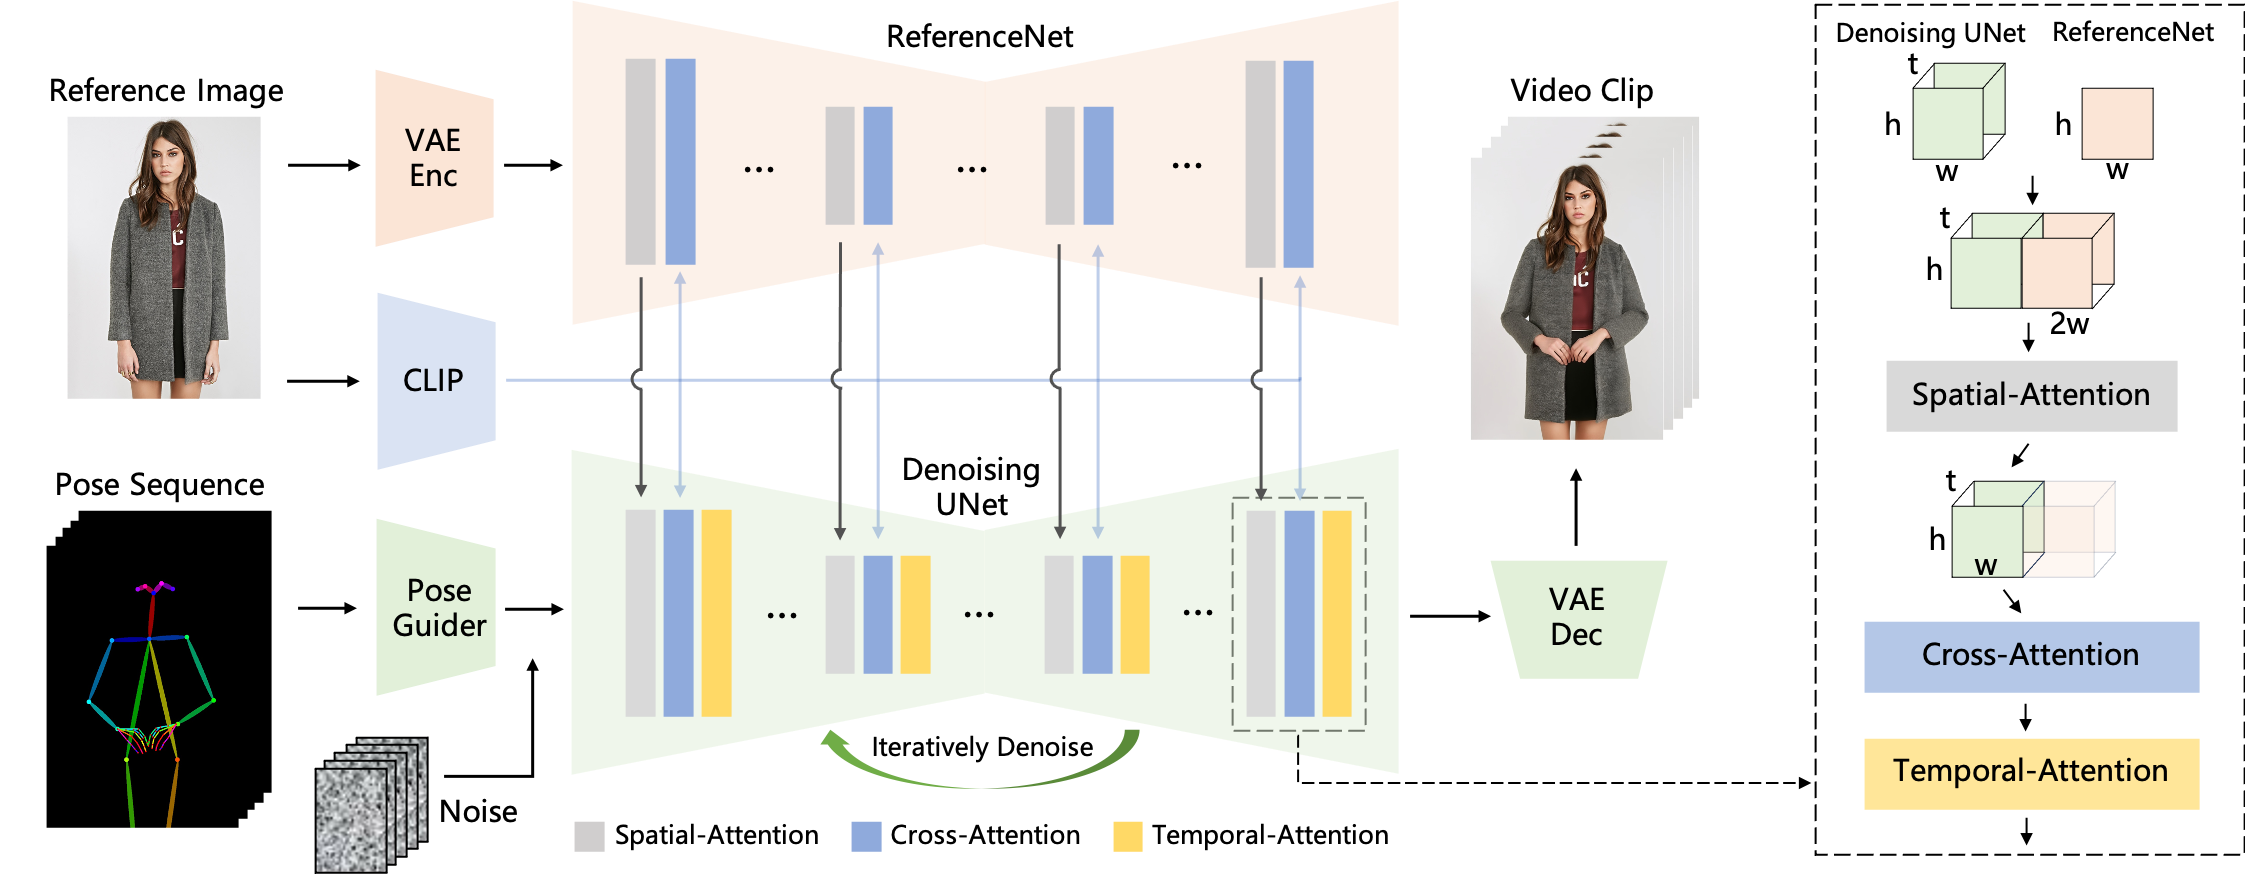
ReferenceNet
结构与去噪 UNet 对称,但不含 temporal layer。二者都继承 SD 权重,之后独立更新。Supplement 进一步说明:ReferenceNet 的 Transformer 保留 self-attention 与 cross-attention;去噪 UNet 将 self-attention 换成 spatial-attention,并额外加入 temporal-attention。
Pose Guider
四个 \(4\times4\) 卷积,stride 均为 \(2\times2\),通道数依次 16、32、64、128;论文称输出与噪声 latent 同分辨率。四次 stride 2 名义上下采样率为 \(1/16\),而标准 SD VAE latent 通常为 \(1/8\);论文未说明额外插值、padding 或 projection 如何匹配,因此复现时不能直接假定尺寸天然相等。主体高斯初始化,末端 projection 用 zero convolution。
两阶段训练:先把单帧做清楚,再只学时间
| 项目 | 阶段一:单帧 | 阶段二:视频 |
|---|---|---|
| 输入 | 随机抽目标帧;参考图从同一 clip 随机选 | 24 帧 video clip |
| 训练模块 | Denoising UNet、ReferenceNet、Pose Guider | 仅 temporal layers |
| 冻结 | VAE encoder/decoder、CLIP image encoder | 除 temporal layers 外全部 |
| 初始化 | 两套 UNet 用 SD;Pose Guider 高斯,末层 zero conv | Temporal layers 用 AnimateDiff 预训练权重 |
| 分辨率 | \(768\times768\),resize + center crop | 正文未另报;按同一模型设置理解,未明确重述 |
| 步数 / batch | 30,000 steps / 64 | 10,000 steps / 4 |
| 学习率 | \(10^{-5}\) | \(10^{-5}\) |
数据与姿态
通用模型使用从互联网收集的 5K character video clips。DWPose 提取身体和手,渲染为 OpenPose 风格骨架图。论文没有给出视频总时长、fps、分辨率分布、角色类别占比、筛选去重、许可、train/val split。
硬件
4 张 NVIDIA A100。论文未说明显存规格、optimizer、β 参数、weight decay、scheduler、warmup、gradient accumulation、precision、训练墙钟时间或随机种子。
基准公平性
UBC Fashion、TikTok、Ted-talk 实验各自只用对应训练集,不使用内部 5K 数据。这使 benchmark 数字可与专用方法比较,但无法证明 5K 通用模型在同一分布上的量化收益。
为什么分两段
阶段一让空间主干专注每帧外观与姿态;阶段二冻结空间能力,只训练时间模块。Tab. 6 支持这一选择:直接全网多帧训练会使图像质量指标下降。
姿态重定向、20 步去噪与长视频拼接
单 clip
先将 source skeleton 各 limb bone 按参考角色对应骨长比例缩放;以肩中心重新计算关键点,再将整副骨架对齐到参考角色位置:全身以脚为参照,半身以肩中心为参照。使用 DDIM 采样 20 步。
限制条件
Supplement 明确说,这只是近似 retargeting,要求源姿态与目标角色是正面、四肢伸展的可比姿势;作者不能保证适用于任意参考图和源姿态。这是通用性主张的重要限定。
任意长度:4 + 20 帧 inter-clip fusion
每个 24 帧 clip 推理时,保存每一步去噪中最后 4 帧的中间结果。下一 clip 由这 4 帧和后续 20 帧组成;每个去噪步都用前一 clip 已保存的 4 帧覆盖当前前 4 帧。由此把 clip 串起来。作者同时承认复杂背景与角色外观下仍会在边界轻微抖动。
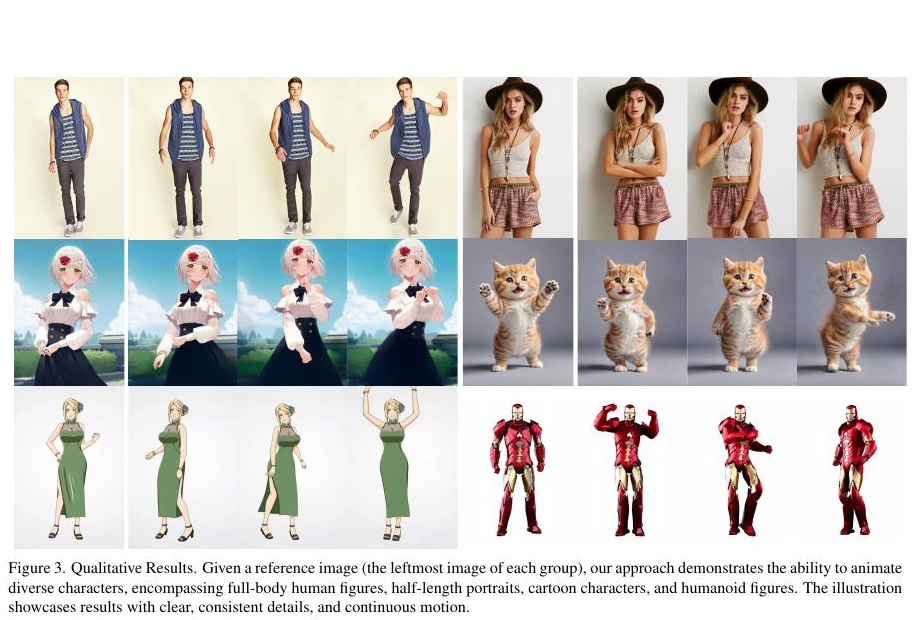
三张主表:整体领先,但并非每个单项第一
SSIM / PSNR 越高越好,LPIPS / FVD 越低越好。前三者测帧级重建,FVD 评估视频分布与时序质量。数值来自 CVPR 版本 Tables 1–3。
Table 1 · UBC Fashion video synthesis
| 方法 | SSIM ↑ | PSNR ↑ | LPIPS ↓ | FVD ↓ |
|---|---|---|---|---|
| MRAA | 0.749 | — | 0.212 | 253.6 |
| TPSMM | 0.746 | — | 0.213 | 247.5 |
| BDMM | 0.918 | 24.07 | 0.048 | 148.3 |
| DreamPose | 0.885 | — | 0.068 | 238.7 |
| DreamPose*(无 sample finetuning) | 0.879 | 34.75 | 0.111 | 279.6 |
| SD-I2V | 0.894 | 36.01 | 0.095 | 175.4 |
| Ours | 0.931 | 38.49 | 0.044 | 81.6 |
对最强非本文行(BDMM)而言,FVD 从 148.3 降至 81.6,约下降 45%;但 DreamPose 的完整版本包含逐样本微调,部署成本与本文不同。论文用其开源代码另跑 DreamPose* 展示无微调情形。
Table 2 · TikTok human dance generation
| 方法 | SSIM ↑ | PSNR ↑ | LPIPS ↓ | FVD ↓ |
|---|---|---|---|---|
| FOMM | 0.648 | 29.01 | 0.335 | 405.2 |
| MRAA | 0.672 | 29.39 | 0.296 | 284.8 |
| TPSMM | 0.673 | 29.18 | 0.299 | 306.1 |
| DisCo | 0.668 | 29.03 | 0.292 | 292.8 |
| SD-I2V | 0.670 | 29.11 | 0.295 | 225.5 |
| Ours | 0.718 | 29.56 | 0.285 | 171.9 |
本文只用 TikTok 训练,而 DisCo 另有人体属性预训练;即便如此 FVD 仍由 292.8 降至 171.9。优势最强在视频分布指标,帧级 PSNR 的绝对差异小得多。
Table 3 · Ted-talk talking gesture
| 方法 | SSIM ↑ | PSNR ↑ | LPIPS ↓ | FVD ↓ |
|---|---|---|---|---|
| MRAA | 0.826 | 33.86 | 0.160 | 82.8 |
| TPSMM | 0.830 | 33.81 | 0.157 | 80.7 |
| DisCo | 0.754 | 31.25 | 0.193 | 223.5 |
| SD-I2V | 0.773 | 32.11 | 0.179 | 158.3 |
| Ours | 0.832 | 33.91 | 0.159 | 80.5 |
本文并非所有单项都最佳:TPSMM 的 LPIPS 0.157 略优于 0.159。MRAA / TPSMM 使用 GT 图像作 driving signal(视频重建),而本文只用 pose;因此该任务的对比条件对本文更难,但方法间条件并非完全同质。
消融给出了强信号,也留下了归因空缺
Table 4 · 图像条件建模(UBC)
| 设计 | SSIM ↑ | PSNR ↑ | LPIPS ↓ | FVD ↓ |
|---|---|---|---|---|
| CLIP | 0.897 | 36.09 | 0.089 | 208.5 |
| ControlNet | 0.892 | 35.89 | 0.105 | 213.9 |
| CLIP + ControlNet | 0.898 | 36.03 | 0.086 | 205.4 |
| ReferenceNet(Ours) | 0.931 | 38.49 | 0.044 | 81.6 |
CLIP 单独能保留相似语义,但细节搬运不足;ControlNet 的逐位置控制不适合非对齐参考图。ReferenceNet 相对最强替代方案把 FVD 205.4 降至 81.6。
Table 5 · ReferenceNet 设计
| 替代项 | SSIM ↑ | PSNR ↑ | LPIPS ↓ | FVD ↓ |
|---|---|---|---|---|
| ResNet + ImageNet weights | 0.901 | 36.21 | 0.084 | 165.4 |
| Feature concatenation | 0.909 | 36.53 | 0.071 | 132.8 |
| SD-UNet + spatial attention | 0.931 | 38.49 | 0.044 | 81.6 |
该表同时改了 backbone/预训练和融合机制;它支持“同域 SD 特征”和“spatial attention”各自有用,却没有完整 \(2\times2\) 因子实验,因此无法量化二者独立贡献与交互。
Table 6 · Temporal modeling
| 设置 | SSIM ↑ | PSNR ↑ | LPIPS ↓ | FVD ↓ |
|---|---|---|---|---|
| w/o Temporal Layer | 0.925 | 38.28 | 0.049 | 176.7 |
| w/o Two Stage Training | 0.917 | 38.01 | 0.056 | 89.3 |
| Ours | 0.931 | 38.49 | 0.044 | 81.6 |
去 temporal layer 时帧级指标只轻微下降,但 FVD 从 81.6 恶化到 176.7,说明时序层的主要收益确实位于视频连续性。取消两阶段训练时 FVD 只到 89.3,帧级质量却全面变差;这与作者“多帧联合训练弱化单帧细节”的解释一致,但仍属于机制解释而非直接因果测量。
官方没有发布本论文模型代码
官方仓库事实
main: docs/ · LICENSE · README.md
12 commits · no releases · no packages
无训练脚本、推理脚本、config、checkpoint
截至 2026-09-27,官方仓库只托管项目页与引用信息。README 现在引导读者查看团队后续开源的 Wan-Animate;这不等于 Animate Anyone v1 代码已开源。
社区复刻
MooreThreads/Moore-AnimateAnyone、MusePose、ComfyUI 节点等属于第三方复刻或受启发项目。它们可帮助理解一种可运行实现,但其中 SD 版本、attention processor、训练配置、CFG、窗口策略和 checkpoint 均不能作为原论文事实。
可从论文复现
模块拓扑、Pose Guider 四层卷积、两阶段训练、步数/batch/lr、24 帧、DDIM 20 steps、4+20 clip fusion、数据集与指标。
仍不可确定
SD/CLIP 精确 checkpoint、UNet channel 规格是否原样沿用、optimizer、scheduler、噪声 schedule、guidance scale、采样随机性、5K 数据明细与训练时长。
贡献扎实,复现透明度与评估覆盖是主要短板
Strengths
- 问题拆解清楚:外观、姿态、时序各有专门接口。
- ReferenceNet 与去噪 UNet 同域初始化,设计与“非对齐细节条件”高度匹配。
- 三套 benchmark 和三组模块消融,FVD 上的变化与设计目的对应。
- Supplement 坦率披露姿态重定向和长视频拼接的局限。
Weaknesses
- 5K 内部数据不可审计,且通用模型没有统一量化 benchmark。
- 官方模型代码和 checkpoint 未发布,很多关键超参数缺失。
- 对照训练预算、参数量、推理速度、显存与用户研究均未报告。
- “arbitrary characters”主要由精选定性样例支撑;手部、背面新生内容和复杂背景是已知失败点。
Claim audit
“细节一致性更好”由 UBC LPIPS / FVD 与消融支持;“时间更稳定”由去时序层的 FVD 大幅恶化支持;“通用到任意角色”证据有限;“ReferenceNet 开销不大”只有结构性论证,没有端到端测速。
Potential improvements
使用 dense pose / 3D body surface 减少姿态歧义;显式建模不可见区域与服装拓扑;训练跨 clip memory 或长程状态替代固定 4 帧覆盖;加入身份、手部、背景和 boundary-jitter 指标,并建立带授权的数据与 checkpoint。
一手资料与核查范围
- Hu et al., arXiv:2311.17117v3,11 页,2024-06-13;本页方法、训练与数值主来源。
- CVPR 2024 Open Access,正式发表信息:pp. 8153–8163,Supplement ZIP 含 2 页 PDF 与演示视频。
- 官方项目页,方法图、视频结果与推理加速展示。
- 官方 GitHub,截至核查日只有 docs、LICENSE 与 README,无本论文实现。
- Moore-AnimateAnyone,社区复刻,仅用于说明生态,不作为论文超参数证据。