论文改变的是计算路径
2017 年的主流 sequence-to-sequence 系统依赖 RNN 或 CNN,attention 只是辅助模块。本文提出完整的 encoder-decoder Transformer,以 self-attention、cross-attention 与逐位置 FFN 取代序列对齐的循环和卷积。
Research gap
RNN 把位置绑定到顺序时间步,单个样本内部无法并行;卷积可以并行,但远距离位置需要跨过多层。作者要验证:是否可以只用 attention 完成通用序列转导,并同时获得质量、并行性与短依赖路径。
论文的证据边界
实验覆盖 WMT14 英德、英法翻译,以及 Penn Treebank 英文成分句法分析。图像、音频、视频只是结论中的未来方向;本文没有训练今天常见的 decoder-only 大语言模型。
条件序列生成如何写成概率模型
输入与 encoder
源序列 \((x_1,\ldots,x_n)\) 经 token embedding 与位置编码,encoder 输出连续 memory \(\mathbf{z}=(z_1,\ldots,z_n)\)。每层都保留序列长度与维度 \(d_{\mathrm{model}}\)。
输出与 decoder
目标序列 \((y_1,\ldots,y_m)\) 自回归生成。训练时将目标右移一位并用 causal mask;推理时每一步把已生成 token 作为下一步条件。
优化目标
论文没有单独打印这条负对数似然公式,但明确称 decoder 为 auto-regressive,并说明右移目标与 mask 保证位置 \(t\) 只依赖较早输出。训练另使用 \(\epsilon_{ls}=0.1\) 的 label smoothing,所以实际目标标签是平滑分布。
六层 encoder,六层 decoder
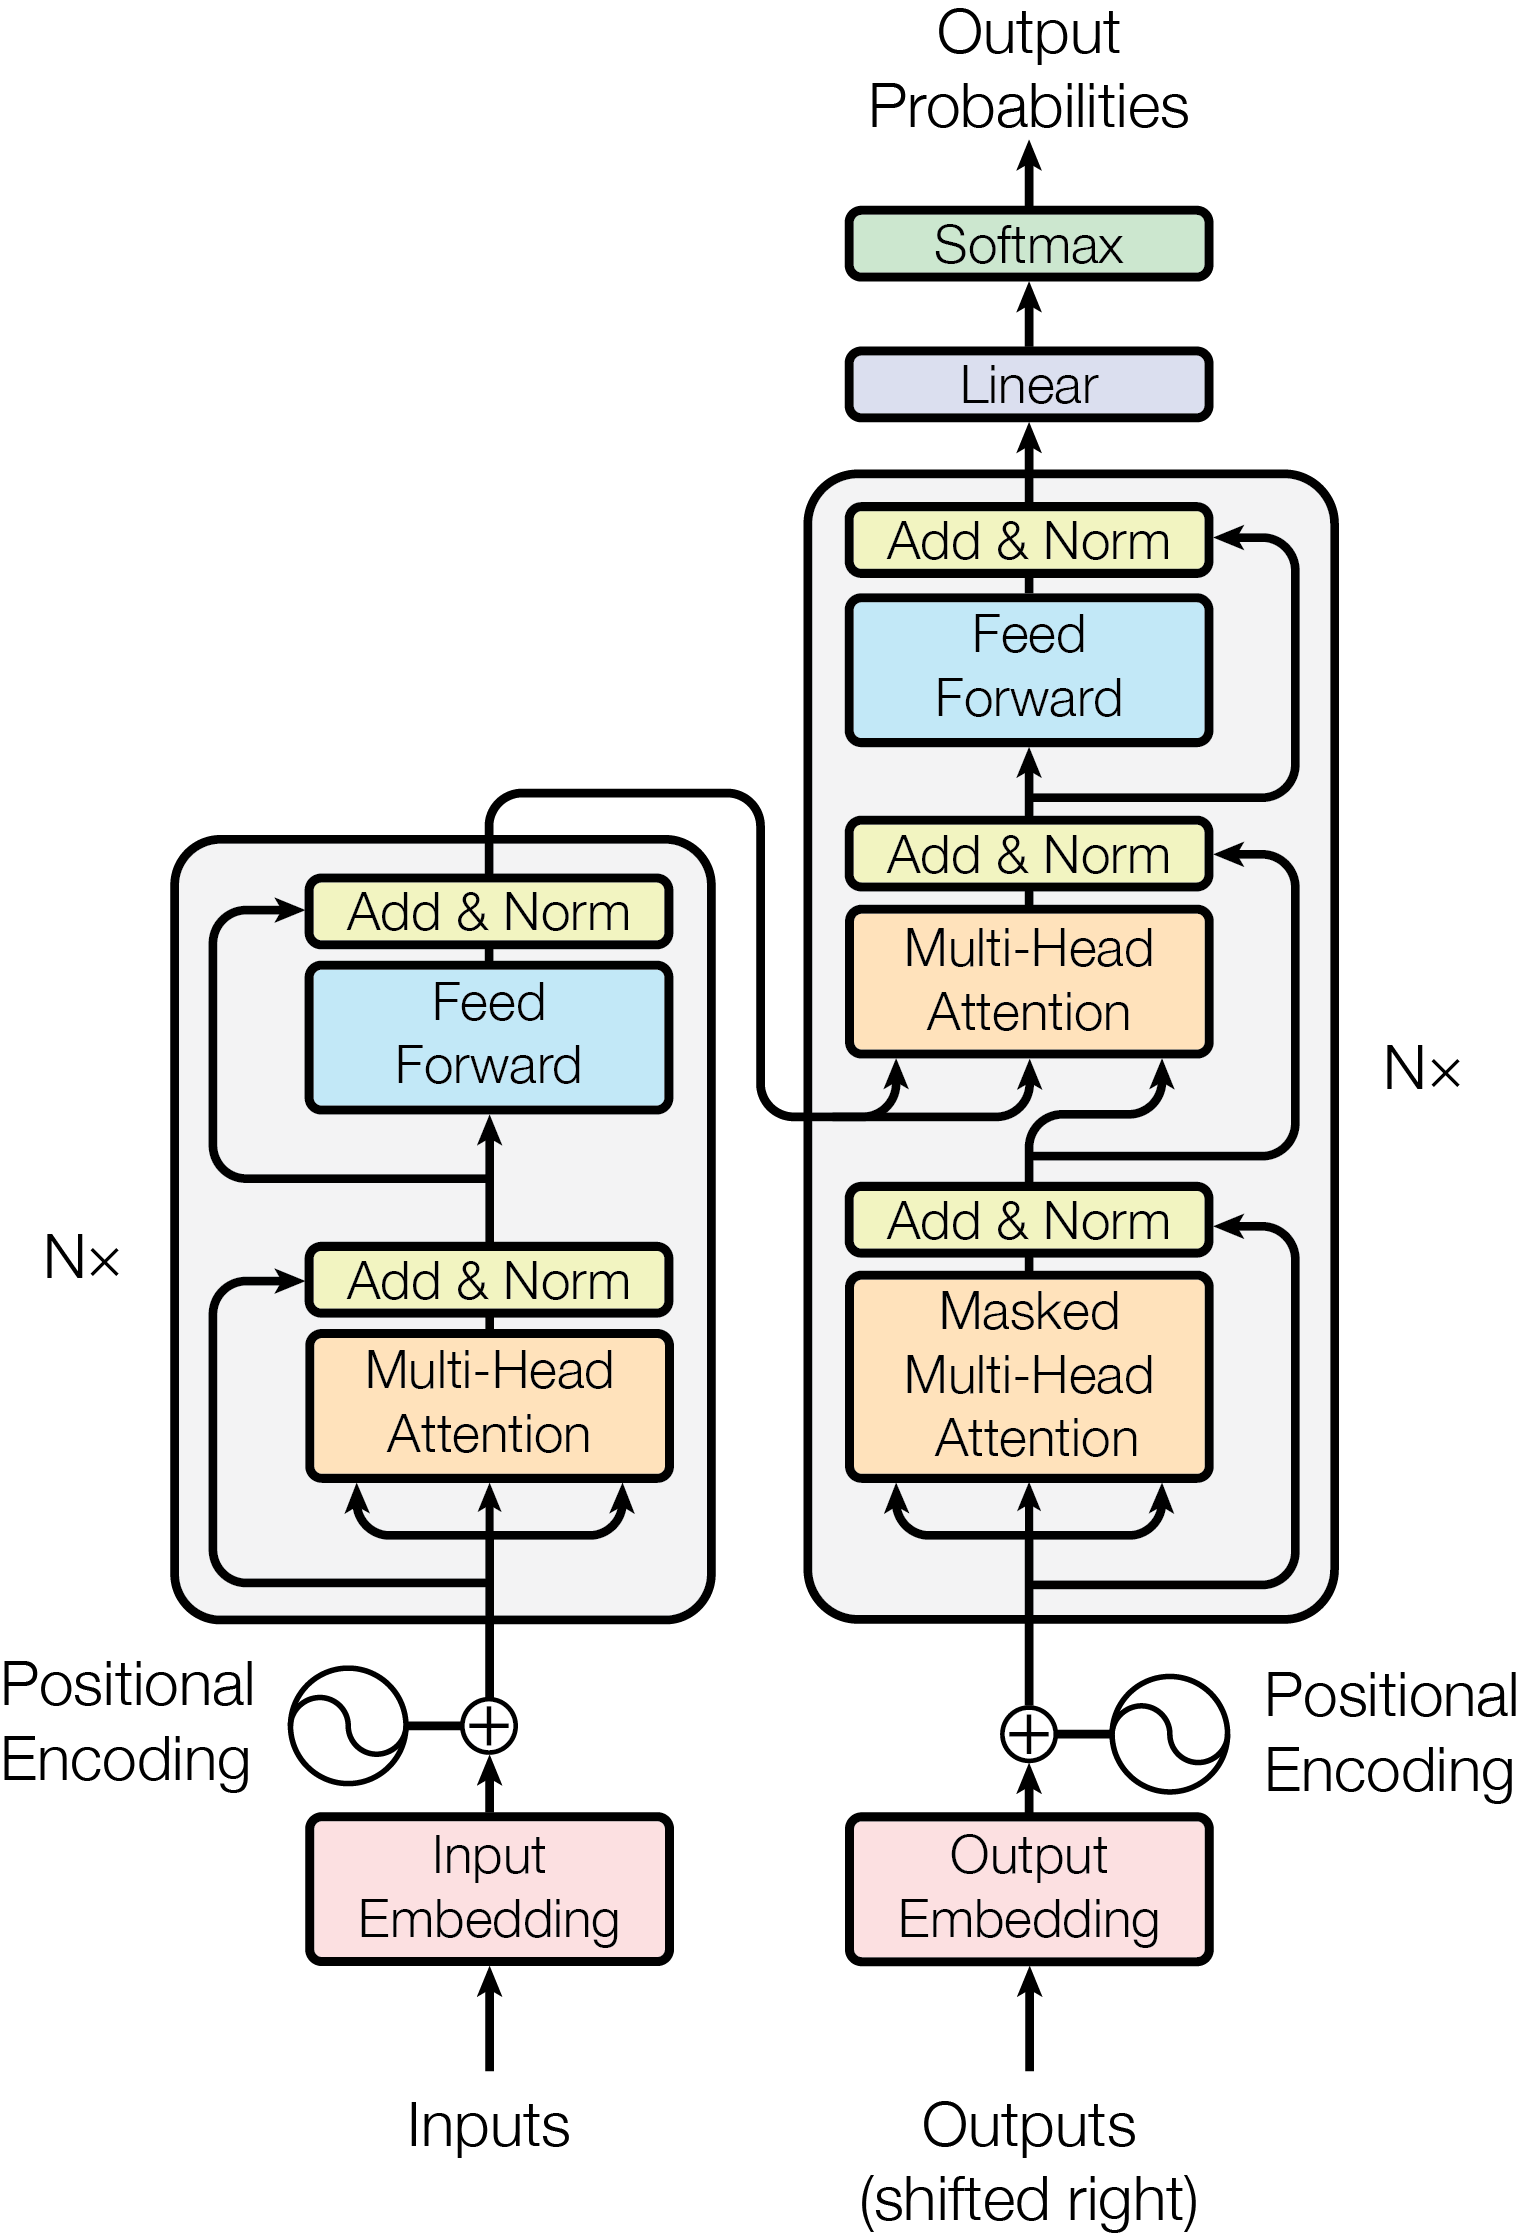
Encoder layer
\(\mathrm{LayerNorm}(x+\mathrm{Sublayer}(x))\) 围绕 multi-head self-attention 与 FFN。原论文采用 post-norm:先残差相加,再 LayerNorm。
Decoder layer
每层有三个子层:masked self-attention、cross-attention、FFN。目标 embedding 右移一位,非法的未来连接在 softmax 前被设为 \(-\infty\)。
维度
base:\(N=6\),\(d_{\mathrm{model}}=512\),\(d_{\mathrm{ff}}=2048\),\(h=8\),\(d_k=d_v=64\),约 65M 参数。
权重共享
源 embedding、目标 embedding 与 pre-softmax 线性变换共享同一权重矩阵;embedding 输出乘 \(\sqrt{d_{\mathrm{model}}}\)。
Q、K、V 分别做什么
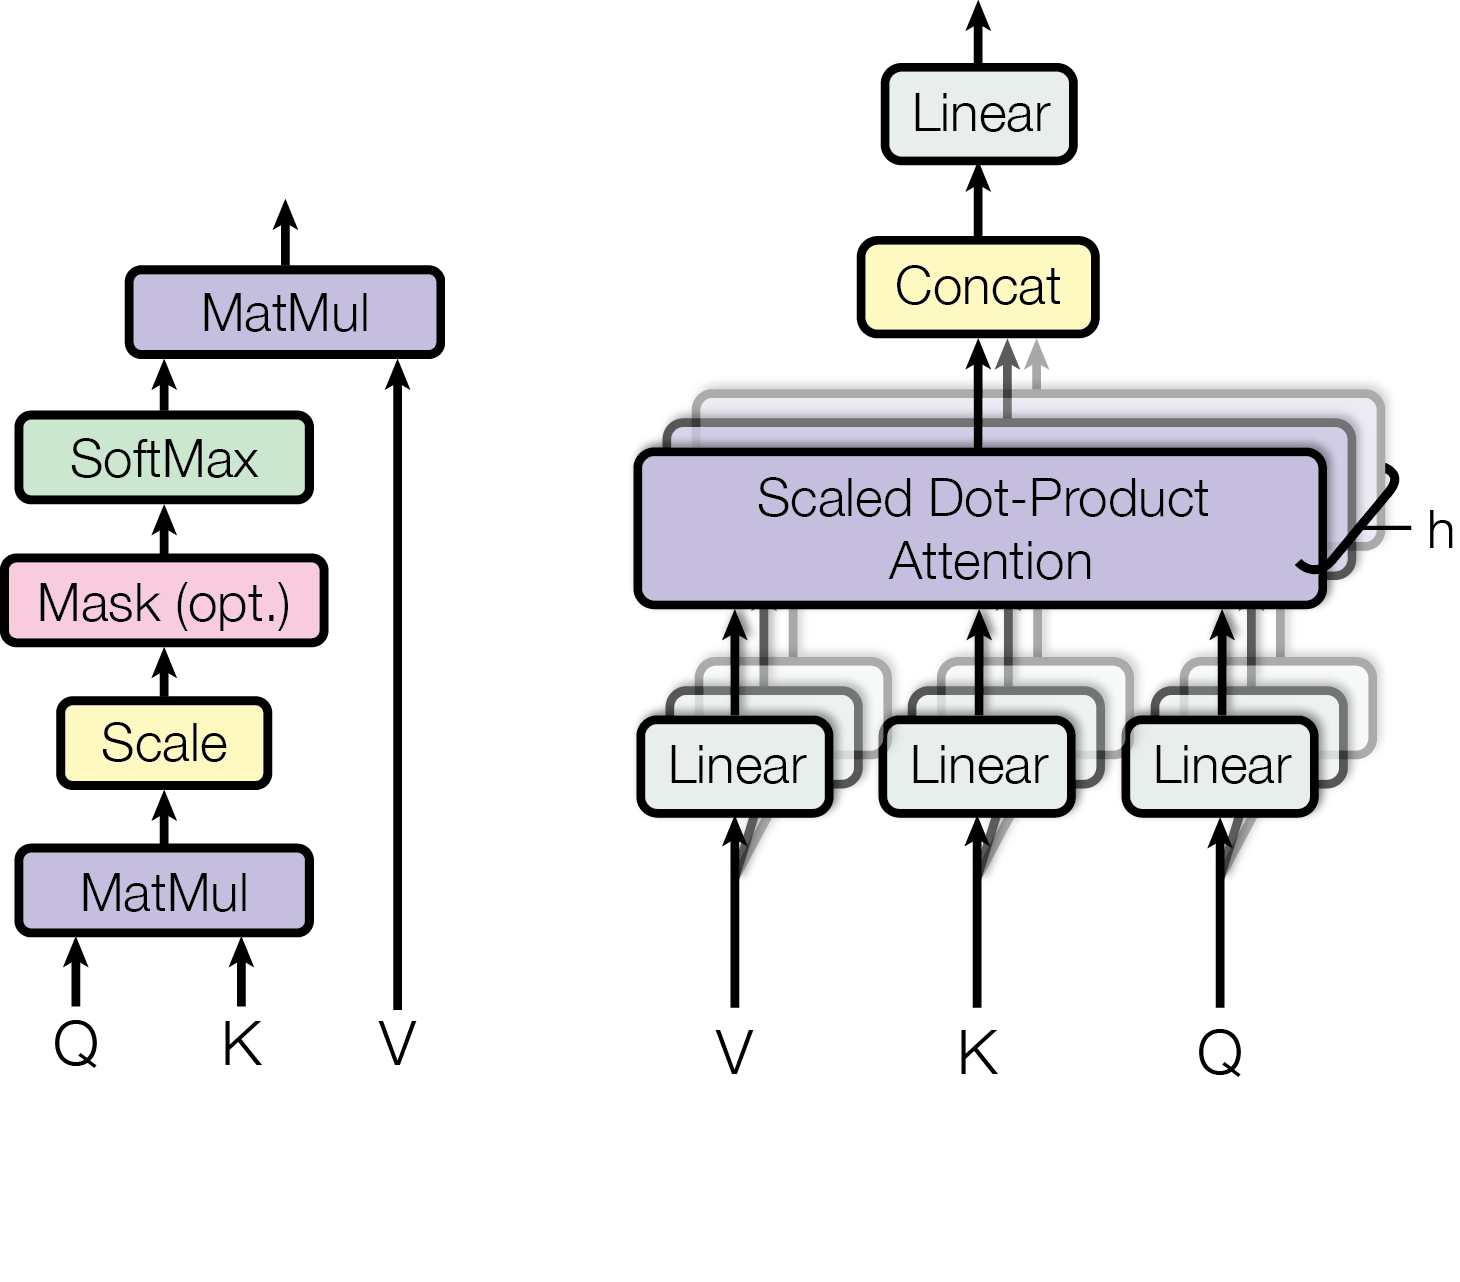
每个 query 与所有 key 做相似度计算,softmax 把分数变成归一化权重,再对 values 求加权和。\(M\) 表示 mask:encoder 主要屏蔽 padding,decoder 还屏蔽未来位置。
为什么除以 \(\sqrt{d_k}\)
若 \(q_i,k_i\) 独立、均值为 0、方差为 1,则 \(q\cdot k\) 的方差为 \(d_k\)。维度增大会使 logits 变大、softmax 饱和、梯度变小;除以 \(\sqrt{d_k}\) 把方差恢复到常数量级。
三种 attention
Encoder self-attention:Q/K/V 均来自 encoder。
Decoder self-attention:Q/K/V 均来自 decoder,并带 causal mask。
Cross-attention:Q 来自 decoder,K/V 来自 encoder memory。
base 使用 \(h=8\) 个 head。每个 head 在 64 维子空间中计算,拼接后仍回到 512 维,所以总体计算量与单个 512 维 attention 处于同一数量级。多头的价值来自不同投影子空间与位置模式。
FFN 对每个位置独立使用相同参数;不同 Transformer 层使用不同参数。base 把 512 维扩张到 2048 维,经 ReLU 后再投影回 512 维。
没有递归以后,顺序从哪里来
位置编码与 token embedding 同维并直接相加。不同维度使用从 \(\,2\pi\,\) 到 \(\,10000\cdot2\pi\,\) 的几何级数波长。作者的假设是固定偏移 \(k\) 下,\(\mathrm{PE}_{pos+k}\) 可表示为 \(\mathrm{PE}_{pos}\) 的线性函数,从而便于学习相对位置;论文没有用长度外推实验直接验证这一假设。
| Layer | 每层复杂度 | 顺序操作 | 最大路径长度 |
|---|---|---|---|
| Self-attention | \(O(n^2d)\) | \(O(1)\) | \(O(1)\) |
| Recurrent | \(O(nd^2)\) | \(O(n)\) | \(O(n)\) |
| Convolutional | \(O(knd^2)\) | \(O(1)\) | \(O(\log_k n)\) |
| Restricted self-attention | \(O(rnd)\) | \(O(1)\) | \(O(n/r)\) |
可复现设置
WMT14 English-German
约 4.5M 句对;共享 source-target BPE 词表约 37k。每个 batch 约 25k source tokens 加 25k target tokens,并按近似长度分组。
WMT14 English-French
36M 句对;32k word-piece 词表。big 英法模型使用 dropout 0.1,而 Table 3 的通用 big 配置列为 0.3。
Hardware
单机 8×NVIDIA P100。base 每 step 约 0.4 秒,100k steps、约 12 小时;big 每 step 约 1 秒,300k steps、约 3.5 天。
Regularization
base residual dropout 0.1;dropout 也用于 embedding 与 positional encoding 之和。label smoothing \(\epsilon_{ls}=0.1\),论文指出它降低 perplexity 的观感,却改善 accuracy 与 BLEU。
Adam 参数为 \(\beta_1=0.9,\ \beta_2=0.98,\ \epsilon=10^{-9}\)。学习率先按 step 线性升高,4000 步后按 inverse square root 衰减;\(d_{\mathrm{model}}^{-1/2}\) 还让不同宽度模型的步长具有统一尺度。
Checkpoint averaging
base 平均最后 5 个 checkpoint,间隔 10 分钟;big 平均最后 20 个 checkpoint。Table 3 的消融没有做 checkpoint averaging。
Translation decoding
beam size 4,length penalty \(\alpha=0.6\),最大输出长度为输入长度 + 50,并允许 EOS 提前结束。超参数在 development set 上选择。
Parsing decoding
beam size 21,\(\alpha=0.3\),最大输出长度为输入长度 + 300;其余参数大体沿用英德 base 设置。
未公开细节
论文没有提供随机种子、完整数据清洗脚本、所有 tokenizer 训练细节、每个实验的方差与多次运行统计。代码入口是 Tensor2Tensor,现已归档且实现随时间继续演化。
翻译质量与训练代价
Table 2 · WMT 2014 newstest2014
| 模型 | EN-DE BLEU | EN-FR BLEU | 训练 FLOPs | |
|---|---|---|---|---|
| ByteNet | 23.75 | — | — | — |
| Deep-Att + PosUnk | — | 39.2 | — | \(1.0\times10^{20}\) |
| GNMT + RL | 24.6 | 39.92 | \(2.3\times10^{19}\) | \(1.4\times10^{20}\) |
| ConvS2S | 25.16 | 40.46 | \(9.6\times10^{18}\) | \(1.5\times10^{20}\) |
| MoE | 26.03 | 40.56 | \(2.0\times10^{19}\) | \(1.2\times10^{20}\) |
| Deep-Att + PosUnk Ensemble | — | 40.4 | — | \(8.0\times10^{20}\) |
| GNMT + RL Ensemble | 26.30 | 41.16 | \(1.8\times10^{20}\) | \(1.1\times10^{21}\) |
| ConvS2S Ensemble | 26.36 | 41.29 | \(7.7\times10^{19}\) | \(1.2\times10^{21}\) |
| Transformer base | 27.3 | 38.1 | \(3.3\times10^{18}\) | |
| Transformer big | 28.4 | 41.8 | \(2.3\times10^{19}\) | |
Table 2 的核心比较是质量与估算训练 FLOPs 的组合:base 英德模型已经超过当时列出的 ensemble,且估算训练成本明显更低;big 把英德结果推到 28.4 BLEU。FLOPs 来自训练时间、GPU 数量与作者估算的单卡持续 FP32 吞吐相乘,属于近似成本指标。表中破折号表示原表没有报告该值。Transformer base 与 big 的训练 FLOPs 在原表中跨两种语言合并报告,没有分别列值。
公平性
不同系统使用不同硬件、模型规模、训练语料处理与工程实现;表中 FLOPs 试图统一硬件差异,但不能当作严格的端到端能耗或 wall-clock 基准。Transformer 的核心优势由相同任务上的质量与训练代价共同支持。
版本差异
NeurIPS proceedings 页面保存更早的 165M 参数、27.5 EN-DE 与 41.1 EN-FR 摘要;本页分析本地保存的 arXiv v7,使用其 213M big 配置与 Table 2 的 28.4 / 41.8。
Table 4 · English constituency parsing
| Parser | 训练设置 | WSJ Section 23 F1 |
|---|---|---|
| Vinyals & Kaiser et al. (2014) | WSJ only, discriminative | 88.3 |
| Petrov et al. (2006) | WSJ only, discriminative | 90.4 |
| Zhu et al. (2013) | WSJ only, discriminative | 90.4 |
| Dyer et al. (2016) | WSJ only, discriminative | 91.7 |
| Transformer, 4 layers | WSJ only, discriminative | 91.3 |
| Zhu et al. (2013) | semi-supervised | 91.3 |
| Huang & Harper (2009) | semi-supervised | 91.3 |
| McClosky et al. (2006) | semi-supervised | 92.1 |
| Vinyals & Kaiser et al. (2014) | semi-supervised | 92.1 |
| Transformer, 4 layers | semi-supervised | 92.7 |
| Luong et al. (2015) | multi-task | 93.0 |
| Dyer et al. (2016) | generative | 93.3 |
解析实验使用 4 层、\(d_{\mathrm{model}}=1024\) 的 Transformer。WSJ-only 约 40k 句、16k 词表;半监督设置约 17M 句、32k 词表。结果说明架构能迁移到结构化输出任务,但 92.7 仍低于表中的 93.3,无法支持跨任务全面领先的结论。
Table 3 · 完整架构变体
所有变体在 English-German newstest2013 development set 上评测,不做 checkpoint averaging。破折号表示沿用 base 值;参数量单位为百万。
| 组别 | \(N\) | \(d_{\mathrm{model}}\) | \(d_{\mathrm{ff}}\) | \(h\) | \(d_k\) | \(d_v\) | \(P_{\mathrm{drop}}\) | \(\epsilon_{ls}\) | Steps | PPL | BLEU | Params |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| base | 6 | 512 | 2048 | 8 | 64 | 64 | 0.1 | 0.1 | 100K | 4.92 | 25.8 | 65 |
| A · heads | — | — | — | 1 | 512 | 512 | — | — | — | 5.29 | 24.9 | — |
| A · heads | — | — | — | 4 | 128 | 128 | — | — | — | 5.00 | 25.5 | — |
| A · heads | — | — | — | 16 | 32 | 32 | — | — | — | 4.91 | 25.8 | — |
| A · heads | — | — | — | 32 | 16 | 16 | — | — | — | 5.01 | 25.4 | — |
| B · key | — | — | — | — | 16 | — | — | — | — | 5.16 | 25.1 | 58 |
| B · key | — | — | — | — | 32 | — | — | — | — | 5.01 | 25.4 | 60 |
| C · depth | 2 | — | — | — | — | — | — | — | — | 6.11 | 23.7 | 36 |
| C · depth | 4 | — | — | — | — | — | — | — | — | 5.19 | 25.3 | 50 |
| C · depth | 8 | — | — | — | — | — | — | — | — | 4.88 | 25.5 | 80 |
| C · width | — | 256 | — | — | 32 | 32 | — | — | — | 5.75 | 24.5 | 28 |
| C · width | — | 1024 | — | — | 128 | 128 | — | — | — | 4.66 | 26.0 | 168 |
| C · FFN | — | — | 1024 | — | — | — | — | — | — | 5.12 | 25.4 | 53 |
| C · FFN | — | — | 4096 | — | — | — | — | — | — | 4.75 | 26.2 | 90 |
| D · dropout | — | — | — | — | — | — | 0.0 | — | — | 5.77 | 24.6 | — |
| D · dropout | — | — | — | — | — | — | 0.2 | — | — | 4.95 | 25.5 | — |
| D · label smoothing | — | — | — | — | — | — | — | 0.0 | — | 4.67 | 25.3 | — |
| D · label smoothing | — | — | — | — | — | — | — | 0.2 | — | 5.47 | 25.7 | — |
| E · learned position | — | — | positional embedding instead of sinusoids | 4.92 | 25.7 | — | ||||||
| big | 6 | 1024 | 4096 | 16 | 64 | 64 | 0.3 | 0.1 | 300K | 4.33 | 26.4 | 213 |
论文与 Tensor2Tensor 的关系
可核对的实现入口
官方论文指向 tensorflow/tensor2tensor。仓库的 Transformer 文件明确包含 encoder/decoder、causal attention bias、multi-head attention、FFN、beam search 与论文链接。
复现边界
公开仓库后来持续加入新 attention 类型、数据问题与训练选项,并已被归档。当前 master 不能视为 2017 年实验环境的逐字快照;复现需要固定历史 revision、TensorFlow 版本与 WMT 数据处理。
LayerNorm 顺序
论文公式明确是 post-norm:\(\mathrm{LayerNorm}(x+\mathrm{Sublayer}(x))\)。许多现代实现使用 pre-norm,训练性质不同,不能把后续惯例倒写回原论文。
注意力可解释性
Appendix 的 Figures 3–5 展示若干 head 与长距离依赖、指代或句法模式相关。它们是选取的可视化案例,没有系统因果干预或大规模定量可解释性评测。
技术贡献、局限与延伸
Strengths
- 把 attention 从辅助模块提升为完整 sequence transduction backbone。
- 架构、关键公式、训练设置、推理设置与消融都足够具体。
- 同时比较质量、复杂度、顺序路径长度与训练成本。
- 翻译之外加入 parsing,给出有限但有意义的泛化证据。
Weaknesses
- 长序列的 \(O(n^2)\) 时间与内存成本已经可从 Table 1 预见。
- 只报告单次结果,没有随机种子、误差条或多次运行统计。
- 训练 FLOPs 是估算值,跨系统数据与工程条件并不完全一致。
- EN-FR 41.8 与 41.0 的 v7 内部冲突损害结果可读性。
- Appendix 的 head 可视化不足以证明稳定、可因果解释的语言结构。
Potential improvements
后续研究可以直接从本文留下的瓶颈出发:局部、稀疏、线性或 memory-compressed attention 处理长上下文;相对或旋转位置表示增强长度泛化;pre-norm、改进激活与初始化提升深层训练;KV cache、并行解码或非自回归生成降低 inference 顺序成本;用 controlled intervention 评估 head 作用,避免仅凭 attention map 解释模型行为。
建议如何读原论文
一手来源
- arXiv record · 1706.03762:版本历史、作者、摘要、分类与 15 页说明。
- arXiv v7 HTML:正文、公式、表格、Figure caption 与脚注;本页主要技术依据。
- arXiv v7 PDF:完整 15 页主文、参考文献与 Figures 3–5 Appendix。
- NIPS 2017 proceedings:正式会议记录与早期版本摘要。
- Tensor2Tensor repository:论文公开实现入口;仓库现已归档。
- Tensor2Tensor transformer.py:Transformer 模型实现与调用结构。
本页以 2023-08-02 的 arXiv v7 为主,并明确标记 proceedings 与 v7 的版本差异。页面中的研究延伸属于分析者建议。