学到的是程序
在 TextArena 上合成每个环境专用的函数,经实际交互筛选与修订。基础模型不做参数微调;“训练”指搜索代码。
PAPER READING / CODE SYNTHESIS · AGENT RELIABILITY
把反复犯的错误,
变成可执行的规则。
Improving LLM agents by automatically synthesizing a code harness
让 Gemini 2.5 Flash 根据环境报错,反复修改自己的 Python 验证器;规则检查交给代码,决策仍由语言模型完成。进一步,还可以把整个策略写成程序,在游戏运行时完全省去 LLM 调用。
数字来自论文 §4 / Table 1;“145 个游戏合法率 100%”与端到端 Figure 7 的统计不能混为一谈。本文保留两者差异,未进行独立游戏复现实验。资料核查:2026-09-18。
01 / MOTIVATION
一个动作可能战略上很差,也可能根本不被环境接受。下棋走入将军、提交错误坐标、在不允许的阶段使用某个操作,都属于后者。语言模型即使能讲出规则,仍可能在漫长交互中丢失局部状态、误读棋盘或拼错动作。论文引用 GameArena 的观察:Gemini 2.5 Flash 的国际象棋败局中,78% 被归因于非法走法。这个分母是败局,不是全部动作,也不是本文 TextArena 上测出的错误率。§1,p.1
手写每个游戏的 guard 可以拦住错误,但维护不同规则、变体和文本格式需要人工;微调则改动模型权重,训练成本更高。本文提出的研究问题是:能否利用模型的代码生成能力,把环境反馈积累为可重复执行的约束,而不是每个回合重新在语言里推理全部规则?
在 TextArena 上合成每个环境专用的函数,经实际交互筛选与修订。基础模型不做参数微调;“训练”指搜索代码。
作者把 agent 看作 LLM 与 harness 的组合,认为模型可以为自己补上控制逻辑。实验支持特定文本游戏,尚未覆盖通用工具或多模态任务。
把可计算的合法性检查交给程序,把策略选择留给 LLM。它能改善系统行为,但不能据此说底层模型的推理能力变强了。
核心贡献是环境反馈驱动的 harness 程序搜索:保存多个代码版本,用 Thompson sampling 决定继续修哪一个,LLM 负责提出代码变更,环境负责给出合法性和最终奖励。它将代码合成、失败诊断与交互 rollout 接起来;没有提出新神经网络架构,也没有证明一种新的通用搜索收敛定理。§2–3,p.2
| 相关方向 | 本文如何定位差异 |
|---|---|
| CoT / Tree of Thoughts | 语言推理仍可能误判规则;本文把验证逻辑外置到可运行的函数。但该函数也是学出来的,不自动等于正确 oracle。 |
| Reflexion / Voyager | 同样复用反馈与经验;本文主要保存、搜索代码假设,并将错误用于函数修复。 |
| Code as Policies | 直接用程序做决策是上限形态;AutoHarness 还研究“代码验证+LLM 决策”的中间形态。 |
| Code World Models | 世界模型要预测状态转移;合法性函数只回答一个动作能否执行,目标更窄。纯代码策略也不必显式模拟整个环境。 |
| REx / AlphaEvolve | 借鉴程序搜索与 LLM 变异;本文的对象是多回合环境里的 harness,而非仅一次性的编程解答。 |
作者:Xinghua Lou、Miguel Lázaro-Gredilla、Antoine Dedieu、Carter Wendelken、Wolfgang Lehrach、Kevin P. Murphy;机构为 Google DeepMind。以 arXiv v1 的 21 页 PDF 为内容基准。
arXiv 元数据和页边版本标记显示 2026-02-10,PDF 标题页日期是 2026-03-05;两项分别记录,不强行归一。RSI Workshop 官方接收列表将其列为 Poster #68,不能写成 ICLR 主会论文。
搜索会出现 AIMing Lab 的同名 AutoHarness 框架,其作者与引用信息不同,不把该仓库当作本文实现。截至核查日,在论文、附录和本次检索的一手入口中,未确认与本论文对应的完整官方复现仓库。
02 / REPRESENTATION & PIPELINE
外层是代码版本搜索:哪份程序值得继续修?内层是游戏交互:这一步该采取什么动作?训练时生成并执行候选代码;评测时使用已选定的 harness。不要把代码搜索树当作运行时的棋局搜索树,也不要把每次拒绝重试当作重新训练模型。
| 对象 | 输入 | 输出 / 作用 |
|---|---|---|
| Refiner / 代码生成 LLM | 游戏名、规则描述、动作空间、观测与错误反馈、当前代码、函数签名 | 新的 Python 函数;是代码变异算子,模型权重固定。 |
propose_action(board) | 文本棋盘 / observation 字符串 | 动作字符串;Verifier 设置要求有效的随机动作,Policy 设置要求有利于最终奖励的动作。 |
is_legal_action(board, action) | 文本状态及候选动作字符串 | 布尔值;无法判断可抛异常,异常成为外层修复信号。 |
| 环境 / Evaluator | 真正执行的动作 | 新观测、合法性反馈、错误与奖励;此处才是最终裁判。 |
| 搜索树 | 代码版本、父子修改关系、评估反馈 | 下一次被选中修订的代码版本;不表示材质图、神经隐变量或动作序列。 |
表示层面没有 image encoder、latent token 或可微 renderer。状态首先是字符串,生成的代码可自行解析成棋盘数组、坐标、集合和约束。函数签名不显式传入环境隐藏状态;论文未完整披露每个游戏的 observation/history 包装方式,因此不能假定单个棋盘字符串在所有游戏中都是完备状态。Appendix C
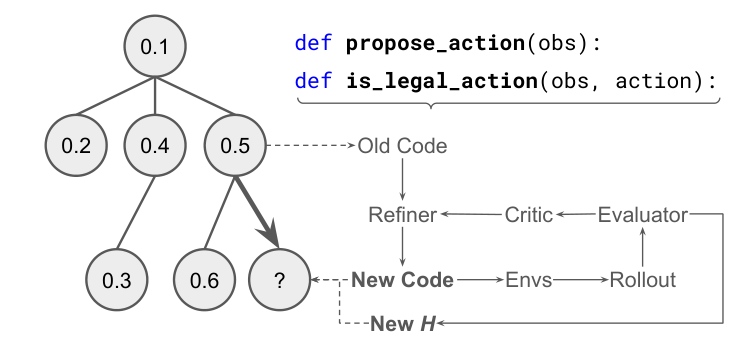
图 1 将代码、反馈和评分连成循环;初始化代码模板、树先验、扩展次数的更新公式没有在本文展开。可确认的是“多个假设+反馈修复+Thompson selection”,不能把自己补写的树搜索控制器称为作者开源实现。
| 模式 | 动作路径 | 运行时 LLM | 本文证据 |
|---|---|---|---|
| Action-filter | 代码提出一组合法候选 → LLM 排序选择 → 环境 | 需要,用于策略选择 | §3 描述的可选形式;没有单独完整的 filter 对照实验。 |
| Action-verifier | LLM 提议 → 代码校验 → 通过则执行;拒绝则带非法动作提示重新生成 | 需要,拒绝时还会增加调用 | 主实验 Flash+Harness;16 个 1P 与 16 个 2P 游戏。 |
| Harness-as-policy | 观测 → Python 策略函数 → 动作 → 环境 | 本文实现不需要 | 16 个 1P 游戏的初步实验;没有报告 2P 纯代码结果。 |
接口细节:Appendix C 的 propose_action 返回单个字符串,而 §3 的 filter 描述需要候选集合;如何反复调用、去重以及候选数量,本文未明确。不要据描述擅自指定 top-k。
若验证器返回 True,环境仍判非法,正文要求同时修复 proposer 与 verifier;若验证器返回 False,而所提动作确实非法,则只修 proposer。对“合法动作被误拒绝”如何系统采样和训练,论文没有给出完整方案。这关系到验证器是否会把好动作排除。
Reasoning:游戏 LLM 的策略分析与 Refiner 的代码诊断属于不同调用。Action:提交给游戏的动作字符串。Observation:文字棋盘及游戏信息。Feedback:环境错误、合法性与终局奖励。Reflection:Critic 整理失败并驱动代码修订。Retry:Verifier 的同一步重提动作,与外层代码重修分开。Memory:持久化的知识主要在候选程序树;没有单独评估长期 episodic memory 模块。Tools:Python 执行与 TextArena 交互,本文没有视觉渲染反馈。
03 / MATHEMATICAL VIEW
除明确标注的 policy heuristic 外,本节公式是 Our Interpretation:把正文机制形式化,方便理解与复现;不是原文给出的定理或完整实现规范。
| 符号 | 定义 |
|---|---|
| \(o_t,a_t,s_t\) | 第 t 步的可见文本观测、动作、真实环境状态;s 可能含隐藏信息。 |
| \(p_{\theta}(a\mid o),\theta\) | 固定基础 LLM 的动作分布及权重;实际提示还可包含历史与拒绝反馈。 |
| \(c,\ v_c(o,a),\ g_c(o)\) | 候选 Python 程序、它的验证函数、它的提议 / 策略函数。 |
| \(\ell(s,a),\tau,r(\tau)\) | 环境真实合法性、完整交互轨迹、终局奖励;不能把 \(v_c\) 当成 \(\ell\)。 |
| \(H,\mathcal{T},\mathcal{D}\) | 搜索用 heuristic、代码版本树、已取得的执行反馈;不是梯度 loss 或训练语料库。 |
优化变量是代码 c,而不是模型权重 θ。LLM 读取失败状态生成新代码,环境评估新代码。这里没有反向传播、学习率或 optimizer;“14.5 次训练迭代”是代码搜索迭代,不是 epoch,也不必等于所有 LLM API 请求的总数。
它概括正文“平均合法动作准确率”的含义:N 是被计数的动作数,指示函数记录环境是否接受。论文没有完全说明终止 rollout、失败动作与异常的聚合权重,故上式仅作概念表达。通过运行代码产生测试动作,与随机构造全部合法/非法动作做二分类测试并不相同;它不能给出验证器的完整 recall / precision,更不是所有可达状态的证明。
在每次提议独立、提示固定、接受概率非零的理想条件下,代码把分布重新归一化到它认可的动作集合上;期望提议次数为 \(1/Z_c(o)\)。但真实方法会把非法警告写进下次提示,因此提议分布会变,上式并非对其运行过程的精确描述。
若 \(v_c\) 错放一个非法动作,它仍可能进入环境;若错拒所有可行动作,循环可能无法退出。即使验证器完美,也只是过滤无效动作,不会自动把合法但低奖励的动作变成好策略。
假定验证器完美、每次独立采样,最多重提 5 次;这些不是论文设置。
无重试上限时的期望调用次数
5 次仍未获得合法动作的概率
计算为 \(1/p\) 与 \((1-p)^5\)。这解释了为什么“没有非法动作进入环境”和“便宜、快速地完成任务”必须分别评测。
Paper Verified · §4.3 这是论文明确给出的目标。奖励只在轨迹结束时可用;合法但零奖励也得到 0.5,而有非法动作则得到 0。它把“能执行”设为首要门槛,在合法轨迹内部才按奖励排序。例:合法且 r=0.8 时 H=0.9;高回报轨迹若出现一次非法动作,H 仍为 0。它不是逐步提供密集策略奖励。
训练平均 H=0.939 与测试平均奖励 0.870 不是同一量。即使假设全部训练轨迹合法,从前者反算得到 r=0.878,也不能拿它替代独立测试分数。
这是 Thompson sampling 的一般解释:从每个候选的不确定性分布采样“值得继续探索”的分数,再选最大者。已经不错的代码通常被选中,尚不确定的分支也有机会。这里 u 是通用价值变量,不代表本文具体实现了某个 Beta 后验;本文只给出 heuristic weight=1.0,并引用 REx,未公开完整先验、更新和回传方程。不能替作者补出一套确定的 Beta-Bernoulli 算法。
04 / REPRODUCTION
| 项目 | 论文公开的设置 | 复现含义 / 缺口 |
|---|---|---|
| 代码合成模型 | Gemini 2.5 Flash | 固定模型调用;没有训练可学习参数。参数量、具体模型快照及 provider 配置未给出。 |
| 任务集合 | TextArena 1P / 2P,剔除 9 个自由文本 / 对话动作游戏,剩 145 个环境条目。 | 包括难度和尺寸变体,不是 145 个完全独立游戏机制;完整列表见下文 Table 1。 |
| 观测处理 | 对部分游戏人工移除 Available Moves 类提示;Appendix A.4–A.5 给出 Chess 示例。 | 移除的是合法动作枚举,规则、棋盘、动作格式仍然可见;完整修改脚本与清单未提供。 |
| 训练数据来源 | 候选代码与环境在线交互,产生状态、动作、报错;最多抽取 5 个失败步骤交给 Critic。 | 不是固定规模的监督语料;未报告全部状态数、去重策略及保留历史的范围。 |
| Verifier rollout | 每次 10 个并行环境,最多 1000 步,自动 reset;非法动作或执行失败时终止 rollout。 | 1000 步在并行环境之间的精确计数实现未展开;不能据此认定每轮必定采集 10,000 个有效动作。 |
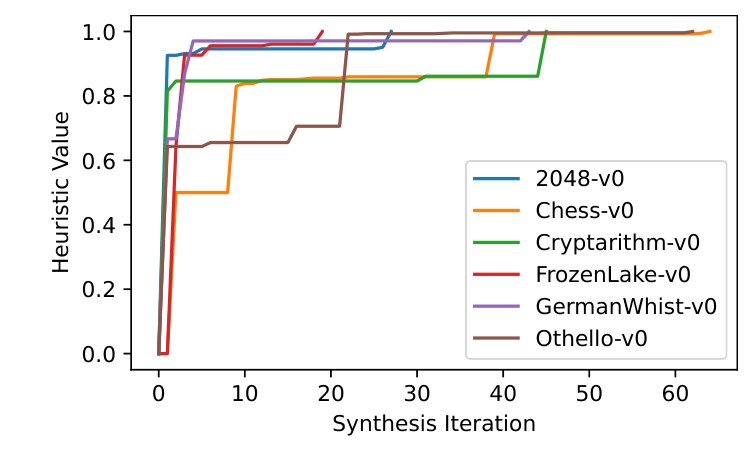
| Verifier 搜索 | Thompson heuristic weight=1.0;合法性 heuristic 达到 1.0 或超时即停。 | 未给出 timeout 具体数值。32 个主评测游戏平均 14.5 次,19/32 少于 10 次。 |
| 合法性独立测试 | 新 rollout,长度 1000,每游戏 10 个随机 seeds。 | 正文与 Table 1 报告所有 145 项为 1.0;实际 seed 列表未公开。 |
| Policy 搜索 | 奖励感知 H,最多 256 轮,平均 89.4 轮,平均训练 H=0.939。 | 训练成本更高;没有逐游戏 API 成本、墙钟和硬件明细。 |
| 常规训练超参 | 学习率、batch size、epoch、weight decay、warmup、梯度累积、训练 precision:不适用于此处的权重训练。 | 需要报告的是合成请求、token 数、环境步数、候选数、选择与停止规则。GPU 与墙钟时间未报告。 |
| 实验 | 协议 | 注意 |
|---|---|---|
| 1P:单人游戏 | 16 个游戏;Flash、Pro、Flash+Harness、纯代码策略各 20 局 / 游戏,评价平均 reward。 | 随机种子列表、episode 上限及逐游戏归一化细节未完整列出。 |
| 2P:对战游戏 | 16 个游戏;每游戏 40 局,随机 seeds,先后手各半;统计胜、平、负。 | Flash+Harness 对战 Pro 和 Flash;并非所有模型两两交叉对战。 |
| GPT 对照 | GPT-5.2 无 thinking:10 局 / 游戏;GPT-5.2-High:5 局 / 游戏。 | 因成本限制样本不等量;与 20 局策略分数相比,方差和置信程度不同。 |
| 语言提示 | 作者称各实验使用相同优化 prompt,先分析再输出一个动作。 | 没有单独披露模型消息 role 的封装、思考 token 上限或不同模型 prompt 适配。 |
| Verifier 推理 | 校验失败后加入非法动作警告并重新请求动作。 | temperature、top-p / top-k、最大重试次数、超时、重试耗尽 fallback、精确重试提示均未给出。 |
| Policy 推理 | 仅 Python / numpy 等标准库处理观测并返回动作。 | 不调用 LLM ≠ 不消耗 CPU 或不可能超时;纯代码也可能包含随机选择。 |
Appendix B.1 将 {player_id} 和 {observation} 放入游戏玩家模板,要求先分析再给出一个最佳动作,以 <move>...</move> 包裹,闭合标签后不再添加内容。这是作者的原始提示设计描述,不代表额外公开了模型的内部推理轨迹。
B.2 向 Refiner 提供 {name}、{description}、{action_space}、{tasks_with_feedback}、{code} 与 {code_signatures}。它要求定位失败步骤、修复当前错误、兼容全部已见棋盘、提高进度、避免循环;必要时从最佳合法动作中随机取一个,禁止 try-except,代码放在 Python code block。禁止捕获异常使失败更容易暴露,但提示词本身不是执行沙箱。
原论文 Appendix B,CC BY 4.0;保留原始文字与拼写,非本页补写的提示。
You are an expert, logical, and strategic AI game player. Your task is to analyze the following game information and determine the single best move to make.

Read the game rules, your player role, the current game state, and all available moves carefully. Your objective is to play optimally to maximize your chances of winning the game.

You are now player {player_id}.

The game information is as follows:
{observation}

**YOUR TASK:**

You must now analyze the situation and provide your move. Follow these two steps precisely.

**Step 1: Think**
First, provide your step-by-step reasoning. Analyze the current game state, your goal, and the available moves. Evaluate the pros and cons of the most promising options and explain why you are selecting your final move.

**Step 2: Move**
After your thinking block, provide *only* the single best move you have chosen. The move must be one of the valid moves listed in the game information.

Enclose your final move in `<move></move>` tags. Do not add any other text, explanation, or punctuation after the closing `</move>` tag.

Example of a correct response format:
<move>
[Your chosen move]
</move>原论文 Appendix B,CC BY 4.0;保留原始文字与拼写,非本页补写的提示。
You are a python programmer with expertise in text games.

You are given a text game with the following name: {name}

Here is a description of the game.
{description}

Here is a description of the action space of the game.
{action_space}

You are observing the following game boards as text with error feedback.
{tasks_with_feedback}

Your task is to write or refine the following python functions.
```python
{code}
```

Make sure to follow these function signatures.
```python
{code_signatures}
```

Make sure to follow these instructions.

* Think step by step about the code, the game boards and the error feedback.

* Reason about each action through the game board and write down critical failure steps.

* Reason about code refinements that can help fix the failure steps.

* Reason about the entire sequence of actions and write down the progress of the game as a value between 0 and 1.

* Reason about code refinements that can help improve the game progress.

* Reason about code refinements that can avoid running in loops.

* Write down your thoughts before writing the code.

* Make sure to follow the given function signatures.

* Make sure the new code can satisfy all the observed game boards.

* Make sure the new code can fix all the current errors.

* Make sure to only produce code that is safe to execute.

* Make sure the code is concise and precise.

* If necessary, randomply sample one of the best legal actions and return it as the proposed action.

* Do not use any the try-except blocks.

* Write your functions in a python code block enclosed in ```pythonB.1 仍要求最终动作来自游戏信息中列出的合法动作,但实验已经移除了部分游戏的合法动作列表。这里保留原文事实,不替作者悄悄修正 prompt;这可能影响表现,影响程度需要单独对照实验。
上述步骤是可复现工程建议;论文并未提供这些步骤中所有实现与对照。
05 / RESULTS
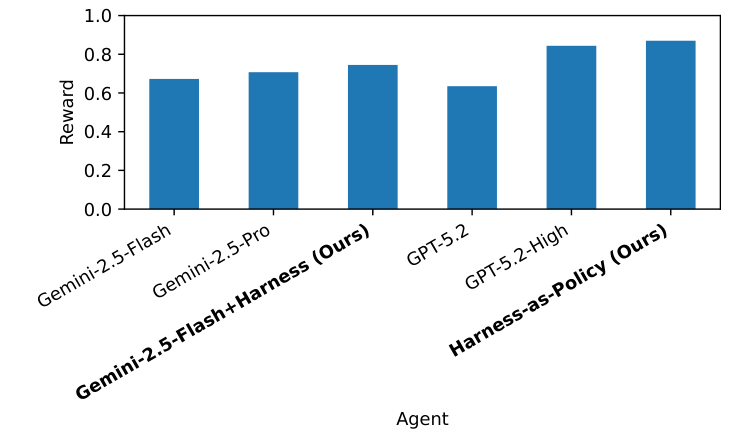
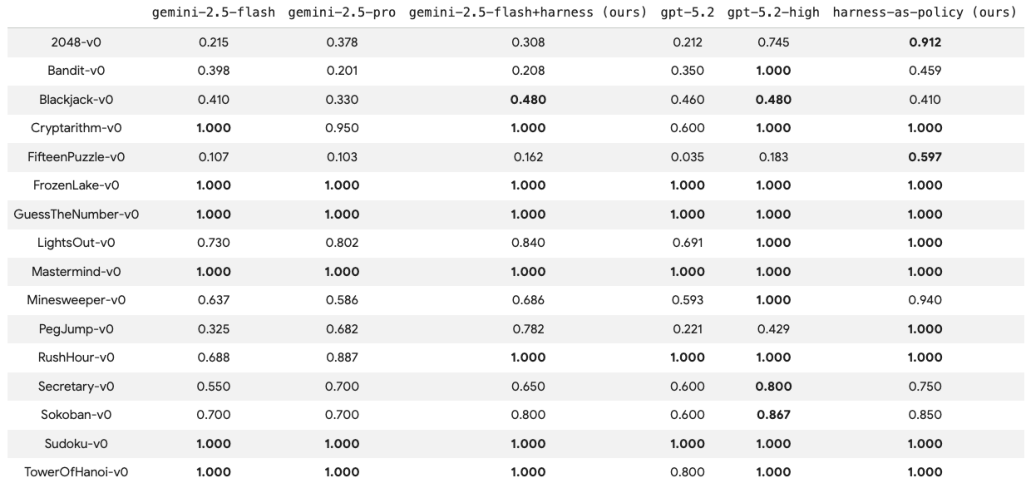
下表重建正文 §4.2–4.3 / Figure 5 的均值。奖励按原文保留三位小数;最佳加粗、次佳加下划线。不同模型重复次数不同,不把 0.026 的均值差直接表述为统计显著。
| 方法 | 每游戏局数 | 平均奖励 ↑ | 运行时行为 |
|---|---|---|---|
| Gemini 2.5 Flash | 20 | 0.673 | 裸模型 |
| Gemini 2.5 Pro | 20 | 0.707 | 裸模型 |
| Flash+Harness | 20 | 0.745 | LLM+代码验证与重试 |
| GPT-5.2 | 10 | 0.635 | 无 thinking |
| GPT-5.2-High | 5 | 0.844 | 高 thinking |
| Harness-as-Policy | 20 | 0.870 | 纯代码策略 |
Our Interpretation · 根据报告均值计算 Flash+Verifier 相对 Flash 增加 0.072(约 10.7%),相对 Pro 增加 0.038(约 5.4%);纯代码策略比 GPT-5.2-High 高 0.026(约 3.1%)。这些是平均奖励的差 / 相对变化,不是准确率的百分点。
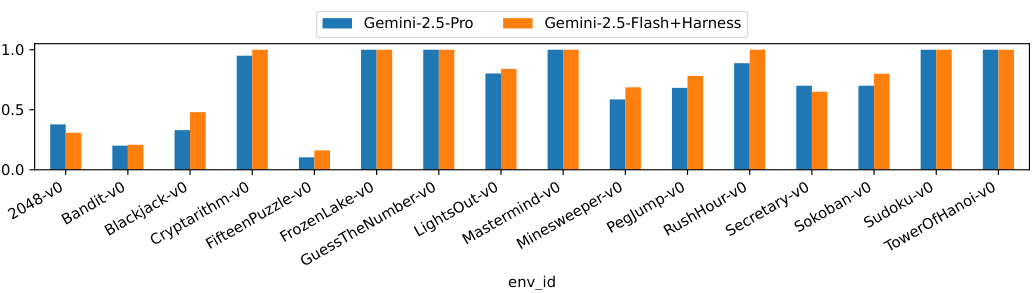
直接按原论文图内数字转录。每行最高值加粗,次高的不同数值加下划线;并列保留。Flash+H 指 Verifier;Code 指 Harness-as-Policy。可横向滚动。
| 游戏 | Flash | Pro | Flash+H | GPT-5.2 | GPT-5.2-High | Code |
|---|---|---|---|---|---|---|
| 2048-v0 | 0.215 | 0.378 | 0.308 | 0.212 | 0.745 | 0.912 |
| Bandit-v0 | 0.398 | 0.201 | 0.208 | 0.350 | 1.000 | 0.459 |
| Blackjack-v0 | 0.410 | 0.330 | 0.480 | 0.460 | 0.480 | 0.410 |
| Cryptarithm-v0 | 1.000 | 0.950 | 1.000 | 0.600 | 1.000 | 1.000 |
| FifteenPuzzle-v0 | 0.107 | 0.103 | 0.162 | 0.035 | 0.183 | 0.597 |
| FrozenLake-v0 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 |
| GuessTheNumber-v0 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 |
| LightsOut-v0 | 0.730 | 0.802 | 0.840 | 0.691 | 1.000 | 1.000 |
| Mastermind-v0 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 |
| Minesweeper-v0 | 0.637 | 0.586 | 0.686 | 0.593 | 1.000 | 0.940 |
| PegJump-v0 | 0.325 | 0.682 | 0.782 | 0.221 | 0.429 | 1.000 |
| RushHour-v0 | 0.688 | 0.887 | 1.000 | 1.000 | 1.000 | 1.000 |
| Secretary-v0 | 0.550 | 0.700 | 0.650 | 0.600 | 0.800 | 0.750 |
| Sokoban-v0 | 0.700 | 0.700 | 0.800 | 0.600 | 0.867 | 0.850 |
| Sudoku-v0 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 | 1.000 |
| TowerOfHanoi-v0 | 1.000 | 1.000 | 1.000 | 0.800 | 1.000 | 1.000 |
纯代码策略在 2048(0.912 vs 0.745)、FifteenPuzzle(0.597 vs 0.183)和 PegJump(1.000 vs 0.429)明显超过 GPT-5.2-High;后者在 Bandit、Blackjack、Minesweeper、Secretary、Sokoban 五个任务领先,另外八项持平。这解释了“平均更高”与“赢的任务更少”可以同时成立:差值幅度比简单计胜更重要。Figure 6,p.11
Verifier 的强项也不是一概增益。相比裸 Flash,Bandit 从 0.398 降至 0.208,Secretary 从 0.550 升至 0.650 但低于 Pro 的 0.700;在已满分的任务上则没有额外空间。合法性约束能移除错误,也可能改变动作采样、限制探索;论文没有用单独实验分解这些成因。
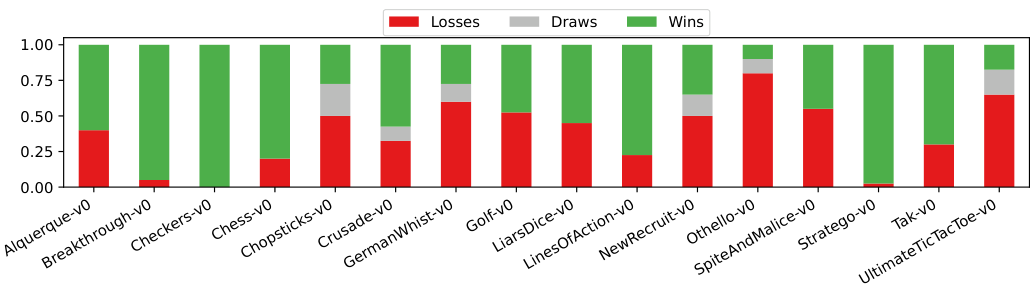
| 对手 | Flash+Harness 胜率 | 对手胜率 | 平局 | 游戏层面的比较 |
|---|---|---|---|---|
| Gemini 2.5 Pro | 56.3% | 38.2% | 约 5.5%(按已四舍五入数值相减) | 正文报告在 9/16 个游戏上获胜 |
| Gemini 2.5 Flash | 64.8% | 正文未单独给出 | 正文未单独给出 | 正文报告在 12/16 个游戏上获胜 |
每游戏 40 局、16 个游戏,意味着每组对手比较计划包含 640 局。9/16 是环境层面的计数,56.3% 是对局胜率;数值碰巧相近,不能把它们视为同一个统计量。图 3 中 Othello、GermanWhist 等仍然难打;Chess、Checkers、Stratego 上则优势更明显,说明检查动作并不能替代全部对抗规划。
作者报告 GPT-5.2 与 GPT-5.2-High 的实验约花费 640 美元,纯代码策略测试时成本近零。这里的近零主要指没有 LLM 推理费用,不能理解成总项目成本为零;Policy 先做了平均 89.4 次代码合成迭代,Verifier 运行时仍需模型,拒绝时还可能多次调用。原文没有提供完整、统一的 token / 延迟 / 合成成本表。§4.3
Our Interpretation:当分母为正时,这个摊销关系说明高频使用更有利于代码策略。论文没有给出足够数据求实际 break-even 局数;640 美元不是所有方法在等量任务上的统一预算。
06 / EVIDENCE AUDIT
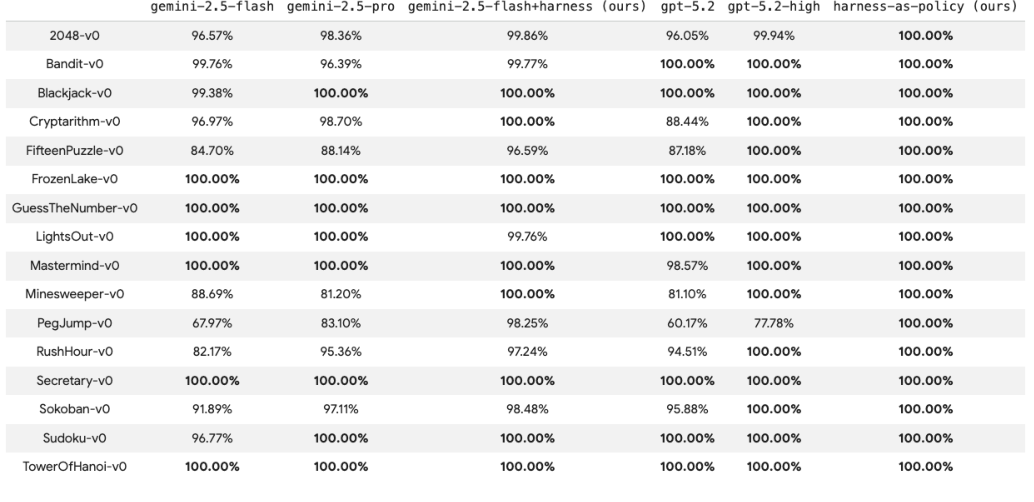
Table 1 对 145 个环境的独立合法性 rollout 都报告 1.0;但 Appendix Figure 7 的端到端 Flash+Harness列中,有 7 个单人游戏小于 100%。例如 FifteenPuzzle 是 96.59%,RushHour 是 97.24%,PegJump 是 98.25%。因此网页不会把“自动 harness 永远消除所有非法动作”当成已被全面证明的结论。
| 游戏 | Flash | Pro | Flash+H | GPT-5.2 | GPT-5.2-High | Code |
|---|---|---|---|---|---|---|
| 2048-v0 | 96.57% | 98.36% | 99.86% | 96.05% | 99.94% | 100.00% |
| Bandit-v0 | 99.77% | 96.39% | 99.77% | 100.00% | 100.00% | 100.00% |
| Blackjack-v0 | 99.38% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% |
| Cryptarithm-v0 | 96.97% | 98.70% | 100.00% | 88.44% | 100.00% | 100.00% |
| FifteenPuzzle-v0 | 84.70% | 88.14% | 96.59% | 87.18% | 100.00% | 100.00% |
| FrozenLake-v0 | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% |
| GuessTheNumber-v0 | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% |
| LightsOut-v0 | 100.00% | 100.00% | 99.76% | 100.00% | 100.00% | 100.00% |
| Mastermind-v0 | 100.00% | 100.00% | 100.00% | 98.57% | 100.00% | 100.00% |
| Minesweeper-v0 | 88.69% | 81.20% | 100.00% | 81.10% | 100.00% | 100.00% |
| PegJump-v0 | 67.97% | 83.10% | 98.25% | 60.17% | 77.78% | 100.00% |
| RushHour-v0 | 82.17% | 95.36% | 97.24% | 94.51% | 100.00% | 100.00% |
| Secretary-v0 | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% |
| Sokoban-v0 | 91.89% | 97.11% | 98.48% | 95.88% | 100.00% | 100.00% |
| Sudoku-v0 | 96.77% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% |
| TowerOfHanoi-v0 | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% | 100.00% |
Figure 7 的纯代码策略列为全部 100%。两组实验的动作来源不同,确实可能造成差异;然而正文没有把 Figure 7 的“legal action rate”分母讲清楚:是在过滤之前计数,还是最终提交之后?失败重试是否纳入?是分布变化还是统计口径?目前只能确认报告差异,不能替作者给出已证实的解释。独立 rollout 的通过率也不是验证器在所有状态上的形式正确性。Figure 7,p.11
我们对 Table 1 做了复算:带星号的 32 个游戏学习步数平均正好为 14.5,其中 19 个少于 10 次,与正文一致。若使用全部 145 行,则均值为 10.303;最大值是 Breakthrough-v0-small 的 136。因此正文关于“最难游戏”的讨论应放在所选子集内理解,不能套到所有变体。Table 1 表头叫 Learning Steps,caption 又描述 LLM calls;由于系统还有 Critic 等角色,不将其等同于完整账单请求数。
正文称 Flash+Harness 对比 Pro 是 8 胜、5 平,余下 3 负。但按 Figure 6 的三位小数逐行比较,得到 9 胜、5 平、2 负(负项是 2048、Secretary)。Bandit 的 0.208 与 0.201 也构成一个表面胜项。未知作者是否使用了未报告的容差或另一份统计;这里不擅自修正原文,也不把微小差值当显著改进。纯代码对 GPT-5.2-High 的 3 胜、8 平、5 负则与表一致。
原始编号、学习步数和合法率按 Appendix Table 1 转录。* 表示参加 32 游戏端到端评测。筛选只改变显示,不改数据;“全部 145”包含同一游戏的多种配置。
| 编号 | 游戏 ID | 玩家数 | 学习步数 | 合法率 |
|---|---|---|---|---|
| 0 | 2048-v0* | 1 | 27 | 1.0 |
| 1 | 2048-v0-easy | 1 | 4 | 1.0 |
| 2 | 2048-v0-extreme | 1 | 44 | 1.0 |
| 3 | 2048-v0-hard | 1 | 47 | 1.0 |
| 4 | 2048-v0-mega-easy | 1 | 31 | 1.0 |
| 5 | 2048-v0-super-easy | 1 | 6 | 1.0 |
| 6 | 2048-v0-ultra-easy | 1 | 2 | 1.0 |
| 7 | 2048-v0-very-easy | 1 | 57 | 1.0 |
| 8 | 2048-v0-very-hard | 1 | 7 | 1.0 |
| 9 | Alquerque-v0* | 2 | 4 | 1.0 |
| 10 | Bandit-v0* | 1 | 2 | 1.0 |
| 11 | Bandit-v0-hard | 1 | 1 | 1.0 |
| 12 | Battleship-v0 | 2 | 4 | 1.0 |
| 13 | Battleship-v0-extreme | 2 | 32 | 1.0 |
| 14 | Battleship-v0-large | 2 | 9 | 1.0 |
| 15 | Battleship-v0-standard | 2 | 6 | 1.0 |
| 16 | Blackjack-v0* | 1 | 2 | 1.0 |
| 17 | Blackjack-v0-long | 1 | 1 | 1.0 |
| 18 | Breakthrough-v0* | 2 | 2 | 1.0 |
| 19 | Breakthrough-v0-blind | 2 | 20 | 1.0 |
| 20 | Breakthrough-v0-large | 2 | 9 | 1.0 |
| 21 | Breakthrough-v0-long | 2 | 7 | 1.0 |
| 22 | Breakthrough-v0-small | 2 | 136 | 1.0 |
| 23 | Breakthrough-v0-tiny | 2 | 5 | 1.0 |
| 24 | Briscola-v0 | 2 | 2 | 1.0 |
| 25 | Checkers-v0* | 2 | 7 | 1.0 |
| 26 | Checkers-v0-long | 2 | 3 | 1.0 |
| 27 | Chess-v0* | 2 | 64 | 1.0 |
| 28 | Chess-v0-blind | 2 | 19 | 1.0 |
| 29 | Chess-v0-long | 2 | 16 | 1.0 |
| 30 | Chopsticks-v0* | 2 | 15 | 1.0 |
| 31 | Chopsticks-v0-long | 2 | 7 | 1.0 |
| 32 | Chopsticks-v0-medium | 2 | 15 | 1.0 |
| 33 | ColonelBlotto-v0 | 2 | 1 | 1.0 |
| 34 | ColonelBlotto-v0-extreme | 2 | 1 | 1.0 |
| 35 | ColonelBlotto-v0-large | 2 | 1 | 1.0 |
| 36 | ColonelBlotto-v0-small | 2 | 1 | 1.0 |
| 37 | ConnectFour-v0 | 2 | 10 | 1.0 |
| 38 | ConnectFour-v0-blind | 2 | 2 | 1.0 |
| 39 | ConnectFour-v0-large | 2 | 1 | 1.0 |
| 40 | Crusade-v0* | 2 | 4 | 1.0 |
| 41 | Cryptarithm-v0* | 1 | 45 | 1.0 |
| 42 | FifteenPuzzle-v0* | 1 | 3 | 1.0 |
| 43 | FrozenLake-v0* | 1 | 19 | 1.0 |
| 44 | FrozenLake-v0-hardcore | 1 | 4 | 1.0 |
| 45 | FrozenLake-v0-random | 1 | 22 | 1.0 |
| 46 | GameOfPureStrategy-v0 | 2 | 3 | 1.0 |
| 47 | GermanWhist-v0* | 2 | 43 | 1.0 |
| 48 | Golf-v0* | 2 | 8 | 1.0 |
| 49 | Golf-v0-medium | 2 | 9 | 1.0 |
| 50 | GuessTheNumber-v0* | 1 | 2 | 1.0 |
| 51 | GuessTheNumber-v0-hardcore | 1 | 2 | 1.0 |
| 52 | HighSociety-v0 | 2 | 3 | 1.0 |
| 53 | IndianPoker-v0 | 2 | 11 | 1.0 |
| 54 | IndianPoker-v0-extreme | 2 | 2 | 1.0 |
| 55 | IndianPoker-v0-long | 2 | 26 | 1.0 |
| 56 | IndianPoker-v0-medium | 2 | 7 | 1.0 |
| 57 | IndianPoker-v0-short | 2 | 2 | 1.0 |
| 58 | IteratedMatchingPennies-v0 | 2 | 1 | 1.0 |
| 59 | IteratedRockPaperScissors-v0 | 2 | 1 | 1.0 |
| 60 | IteratedTwoThirdsAverage-v0 | 2 | 1 | 1.0 |
| 61 | KuhnPoker-v0 | 2 | 5 | 1.0 |
| 62 | KuhnPoker-v0-extreme | 2 | 3 | 1.0 |
| 63 | KuhnPoker-v0-long | 2 | 2 | 1.0 |
| 64 | KuhnPoker-v0-medium | 2 | 2 | 1.0 |
| 65 | KuhnPoker-v0-short | 2 | 3 | 1.0 |
| 66 | LiarsDice-v0* | 2 | 4 | 1.0 |
| 67 | LiarsDice-v0-large | 2 | 6 | 1.0 |
| 68 | LiarsDice-v0-small | 2 | 5 | 1.0 |
| 69 | LightsOut-v0* | 1 | 1 | 1.0 |
| 70 | LinesOfAction-v0* | 2 | 23 | 1.0 |
| 71 | Mastermind-v0* | 1 | 2 | 1.0 |
| 72 | Mastermind-v0-extreme | 1 | 1 | 1.0 |
| 73 | Mastermind-v0-hard | 1 | 2 | 1.0 |
| 74 | MemoryGame-v0 | 2 | 3 | 1.0 |
| 75 | MemoryGame-v0-hard | 2 | 2 | 1.0 |
| 76 | MemoryGame-v0-medium | 2 | 2 | 1.0 |
| 77 | Minesweeper-v0* | 1 | 11 | 1.0 |
| 78 | Minesweeper-v0-hard | 1 | 6 | 1.0 |
| 79 | Minesweeper-v0-medium | 1 | 10 | 1.0 |
| 80 | Minesweeper-v0-small | 1 | 2 | 1.0 |
| 81 | NewRecruit-v0* | 2 | 2 | 1.0 |
| 82 | Nim-v0 | 2 | 1 | 1.0 |
| 83 | Nim-v0-large | 2 | 2 | 1.0 |
| 84 | Nim-v0-medium | 2 | 2 | 1.0 |
| 85 | Othello-v0* | 2 | 62 | 1.0 |
| 86 | Othello-v0-big | 2 | 2 | 1.0 |
| 87 | Othello-v0-hard | 2 | 30 | 1.0 |
| 88 | Othello-v0-huge | 2 | 12 | 1.0 |
| 89 | Othello-v0-small | 2 | 5 | 1.0 |
| 90 | Othello-v0-tiny | 2 | 13 | 1.0 |
| 91 | PegJump-v0* | 1 | 1 | 1.0 |
| 92 | PigDice-v0 | 2 | 1 | 1.0 |
| 93 | PigDice-v0-100 | 2 | 1 | 1.0 |
| 94 | PigDice-v0-150 | 2 | 1 | 1.0 |
| 95 | PigDice-v0-200 | 2 | 1 | 1.0 |
| 96 | PigDice-v0-250 | 2 | 1 | 1.0 |
| 97 | PigDice-v0-300 | 2 | 1 | 1.0 |
| 98 | PigDice-v0-350 | 2 | 1 | 1.0 |
| 99 | PigDice-v0-400 | 2 | 1 | 1.0 |
| 100 | PigDice-v0-450 | 2 | 1 | 1.0 |
| 101 | PigDice-v0-50 | 2 | 1 | 1.0 |
| 102 | PigDice-v0-500 | 2 | 1 | 1.0 |
| 103 | PigDice-v0-long | 2 | 1 | 1.0 |
| 104 | PigDice-v0-short | 2 | 1 | 1.0 |
| 105 | Poker-v0 | 2 | 17 | 1.0 |
| 106 | Poker-v0-extreme | 2 | 7 | 1.0 |
| 107 | Poker-v0-long | 2 | 5 | 1.0 |
| 108 | Poker-v0-small | 2 | 29 | 1.0 |
| 109 | QuantumTicTacToe-v0 | 2 | 12 | 1.0 |
| 110 | ReverseTicTacToe-v0 | 2 | 3 | 1.0 |
| 111 | RushHour-v0* | 1 | 3 | 1.0 |
| 112 | SantoriniBaseFixed-v0 | 2 | 30 | 1.0 |
| 113 | Secretary-v0* | 1 | 1 | 1.0 |
| 114 | Secretary-v0-long | 1 | 1 | 1.0 |
| 115 | SimpleTak-v0 | 2 | 4 | 1.0 |
| 116 | SimpleTak-v0-extreme | 2 | 8 | 1.0 |
| 117 | SimpleTak-v0-large | 2 | 12 | 1.0 |
| 118 | SimpleTak-v0-medium | 2 | 5 | 1.0 |
| 119 | Snake-v0 | 2 | 1 | 1.0 |
| 120 | Snake-v0-large | 2 | 1 | 1.0 |
| 121 | Snake-v0-standard | 2 | 1 | 1.0 |
| 122 | Sokoban-v0* | 1 | 5 | 1.0 |
| 123 | Sokoban-v0-medium | 1 | 1 | 1.0 |
| 124 | SpiteAndMalice-v0* | 2 | 33 | 1.0 |
| 125 | Stratego-v0* | 2 | 23 | 1.0 |
| 126 | Sudoku-v0* | 1 | 5 | 1.0 |
| 127 | Sudoku-v0-easy | 1 | 5 | 1.0 |
| 128 | Sudoku-v0-hard | 1 | 9 | 1.0 |
| 129 | Sudoku-v0-medium | 1 | 4 | 1.0 |
| 130 | Sudoku-v0-very-easy | 1 | 4 | 1.0 |
| 131 | Surround-v0 | 2 | 1 | 1.0 |
| 132 | Surround-v0-large | 2 | 1 | 1.0 |
| 133 | Surround-v0-standard | 2 | 1 | 1.0 |
| 134 | Tak-v0* | 2 | 21 | 1.0 |
| 135 | Tak-v0-hard | 2 | 53 | 1.0 |
| 136 | Tak-v0-medium | 2 | 6 | 1.0 |
| 137 | TicTacToe-v0 | 2 | 4 | 1.0 |
| 138 | TowerOfHanoi-v0* | 1 | 7 | 1.0 |
| 139 | TowerOfHanoi-v0-extreme | 1 | 44 | 1.0 |
| 140 | TowerOfHanoi-v0-hard | 1 | 7 | 1.0 |
| 141 | TowerOfHanoi-v0-hardcore | 1 | 2 | 1.0 |
| 142 | TowerOfHanoi-v0-medium | 1 | 7 | 1.0 |
| 143 | UltimateTicTacToe-v0* | 2 | 13 | 1.0 |
| 144 | WildTicTacToe-v0 | 2 | 10 | 1.0 |
| 已有对比 | 能支持什么 | 还不能归因于什么 |
|---|---|---|
| Flash vs Flash+Harness | 整套 harness 与重试机制改变了端到端表现。 | 不能单独分离 learned verifier、额外调用预算、反馈提示的贡献。 |
| Verifier vs Policy | 另一种职责分配可以提高部分任务回报并消除运行时 LLM。 | 目标函数、搜索预算和动作生成器一起变了,非单组件消融。 |
| Figure 2 收敛曲线 | 六个示例中代码合成后合法性逐渐提高。 | 不能证明 Thompson sampling 优于链式修复、随机搜索或只选当前最佳。 |
| 移除合法动作提示 | 本文的主设置不依赖直接抄部分游戏的合法动作列表。 | 没有完整有提示 / 无提示的定量对照表,不能估计全部增益来自哪一环节。 |
尤其缺少:首次生成不修复、去掉 Critic、纯文本反思、等预算反馈重试、oracle verifier、手工 verifier、不同采样权重,以及更换合成 LLM 的实验。文章展示了系统可行性,却尚未证明每一个设计选择都是必要的。
07 / PAPER VS. IMPLEMENTATION
本节基于 Appendix D 的真实代码片段进行静态阅读。作者明确表示不是完整 harness;本次没有确认完整官方训练、推理仓库,所以既不宣称已运行复现,也不把同名第三方仓库视作证据。
parse_board_to_grid 和 get_board_dimensions;这两个辅助函数不在该片段里完整展示。空棋盘或零维度抛异常。Our Interpretation:N 是数字线索,k 是已知邻域雷数,U 是仍未知邻域;这是代码中的约束传播关系。对子集 \(U_1\subset U_2\),若 \(m_2-m_1=0\),差集安全;若 \(m_2-m_1=|U_2\setminus U_1|\),差集全为雷。局部风险的算术平均不等于考虑所有重叠约束后的精确后验。
代码据“常见 8×8 扫雷配置”估计总雷数为 10,并将全局风险夹到 [0,1];推导迭代最多为行数×列数,以避免无限循环。这些是生成程序本身包含的启发式,不代表人类手工给模型写了整个策略,但会限制它向不同雷数、尺寸或观测格式的直接迁移。
片段实现 UCI 坐标与数组索引互换,棋盘固定为 8×8,用大写 / 小写识别阵营;枚举兵斜向攻击、马的八种偏移、王的邻格,以及车 / 后直线、象 / 后斜线的阻挡关系。对标准国际象棋而言,这些常量是规则编码,不是随意偏置。
但附录只展示辅助函数:没有给出完整 is_legal_action,也无法从中核实王车易位、吃过路兵、升变、历史状态、走后自将军等情况如何处理。因此“片段看起来合理”并不等于已经审计了一个完整国际象棋规则引擎。Appendix D.2,pp.19–21
| 可直接核查 | 证据 | 不能进一步假定 |
|---|---|---|
| 固定函数签名 | Appendix C 的 board 字符串输入与动作字符串 / bool 输出。 | 所有状态信息都已经编码到该字符串,或所有游戏使用同一解析器。 |
| 硬编码与停止条件 | 扫雷 10 枚雷;有限轮传播;Chess 8×8 与固定走法偏移。 | 不同变体之间共用相同程序;论文实际是每环境独立合成。 |
| 随机选择 | 扫雷安全格、最小风险格及兜底均可随机取样。 | 纯代码策略是完全确定性的。 |
| 运行安全 | Refiner prompt 要求安全代码、禁止 try-except。 | 存在沙箱、资源限制或防止外部副作用的完整实现。 |
| 完整实现 | 公开附录只提供两种游戏的部分函数。 | 已公开全部 145 个 harness、训练日志、seed 和执行包装器。 |
08 / REVIEWER COMMENTARY
动作合法性容易获得执行反馈,适合合成为代码;无需训练完整世界模型,能以较小改动改善多回合可靠性。
同一程序搜索视角覆盖验证器和完整策略,展示了语言模型能力可以在部署前沉淀成可执行程序。
提供 145 项列表、逐游戏奖励与合法率、两套提示、签名及长代码片段,比只报一个平均分更便于检查结论。
| 研究问题 | 建议实验 | 关键指标 |
|---|---|---|
| 到底是不是代码验证带来收益? | 裸模型、等预算文本重试、自动 verifier、人工 / oracle verifier,全部使用配对 seeds。 | 最终奖励、每成功任务 token、拒绝率、漏放率。 |
| 树搜索是否必要? | 固定总合成预算,对比链式修复、随机选父、贪心选父、Thompson;移除 Critic。 | 达到目标合法率所需调用、最好结果分布、回退次数。 |
| 规则知识是否能迁移? | 按游戏家族拆分,在未见棋盘尺寸、雷数、文本格式及规则变体上测试。 | OOD 合法率与任务成功率,而非随机 seed 内泛化。 |
| 系统是否可靠退出? | 注入不可解状态、空动作集合、解析失败与不完整 observation;设透明重试上限。 | 超时率、误拒率、可诊断失败率;不能仅看合法动作比例。 |
Research Extension · 未经本文验证 可以让模型为某一种材质图接口合成 is_valid_edit(graph, edit):先检查端口类型、参数域、环与节点支持情况,再允许 renderer 执行;把失败日志按编译、执行、视觉质量分开反馈。程序合法与材质像不像目标,应始终是两个独立评价维度。
更有研究价值的命题不是“加一个 checker 会不会好”,而是:在同等渲染预算下,自动生成的执行约束能否提高有效探索比例,又不误拒新颖图结构?设计时可使用不可改的编译器判定、独立测试集与多指标选择,防止候选代码通过放松检查器来“刷分”。材质图的拓扑、连续参数、视觉相似度和不可微执行链条均未在 AutoHarness 中实验;这里仅提出迁移方向。
AutoHarness 最值得保留的是“把执行反馈变成程序资产”的思想。它证明了这条路线在文本游戏上可行;还没有证明自动合成的验证器无遗漏、代码树搜索不可替代,或小模型在通用智能上超过大模型。可复用 harness 库、蒸馏回模型和多模态扩展,均属于作者的未来工作。
09 / REFERENCES & READING MAP
来源许可:论文 arXiv HTML 标明 CC BY 4.0。原论文 Figures 1–7 及 Table 1 保留编号、作者归属和来源链接;图像裁切、表格重排与中文解读属于本页整理。原始 prompt 的引用位于折叠区。其余数学形式化和 reviewer 意见已分别标注。
以下是本项目通用 MathJax 验收表达式,不代表 AutoHarness 使用图像 latent 或 Adam 超参数。
\(I^{\ast}\);\(z^{\ast}_{\mathrm{img}}\);\(z^{\mathrm{img}}_{1:I}\);\(z_{\lt t}\);\(P_{\theta}(\mathbf{z}\mid\mathbf{x})\);\(\beta_1=0.9,\ \beta_2=0.95\)。