阅读路线
三项困难需要三种控制机制
输入包含视频、首帧掩码和文本提示。系统需要把掩码传播到全部帧,在区域内部生成符合文本的新内容,同时精确保留区域外的原始像素语义,并支持补画、替换、重纹理等不同结构约束。
时间一致性
逐帧图像补绘会造成形状、颜色和纹理闪烁。AVID 在冻结图像生成能力的前提下训练 temporal self-attention motion modules。
结构强度
重纹理需要跟随原对象轮廓;对象替换需要放松轮廓;扩画不需要目标区域结构。单一结构条件强度难以覆盖三类需求。
可变长度
固定长度训练的时序注意力在更长序列上质量下降。整段处理的时空注意力成本也随帧数平方增长。
变量、条件与优化目标
输入
原视频 \(v_0=\{x_i^0\}_{i=1}^{N'}\),首帧二值掩码 \(m^0\),编辑文本 \(y\)。XMem 将 \(m^0\) 传播为 \(m=\{m_i\}_{i=1}^{N'}\);扩画任务直接在各帧使用同一待填区域。
输出
编辑视频 \(\hat v_0\)。掩码内部响应文本和可选 HED 结构条件,掩码外部保持源视频信息。论文用 BP 衡量区域外 L1 变化。
固定长度与任意长度
\(N=16\) 是正文训练片段长度;\(N'\) 是测试视频长度。窗口步幅为 \(o\),重叠窗口数量为 \(n\)。附录的 24 帧实验用于长度外推消融。
可学习部分
阶段一仅更新 motion modules;阶段二冻结主 UNet,更新由 UNet encoder 初始化的结构模块 \(s_\theta\)。推理期间不微调视频。
扩散过程
时间步 \(t\in\{1,\ldots,T\}\),\(\beta_t\) 控制逐步加噪。令 \(\alpha_t=1-\beta_t\),\(\bar\alpha_t=\prod_{j=1}^{t}\alpha_j\),论文以省略随机项的简化更新式说明从噪声预测恢复上一时间步;去噪器预测噪声后写成:
图像补绘条件为 \(c=(x_m,m,\tau_\theta(y))\),其中 \(x_m=x_0\odot(1-m)\),\(\tau_\theta\) 是文本编码器。基础噪声预测损失为:
训练两组适配器,保留图像补绘先验
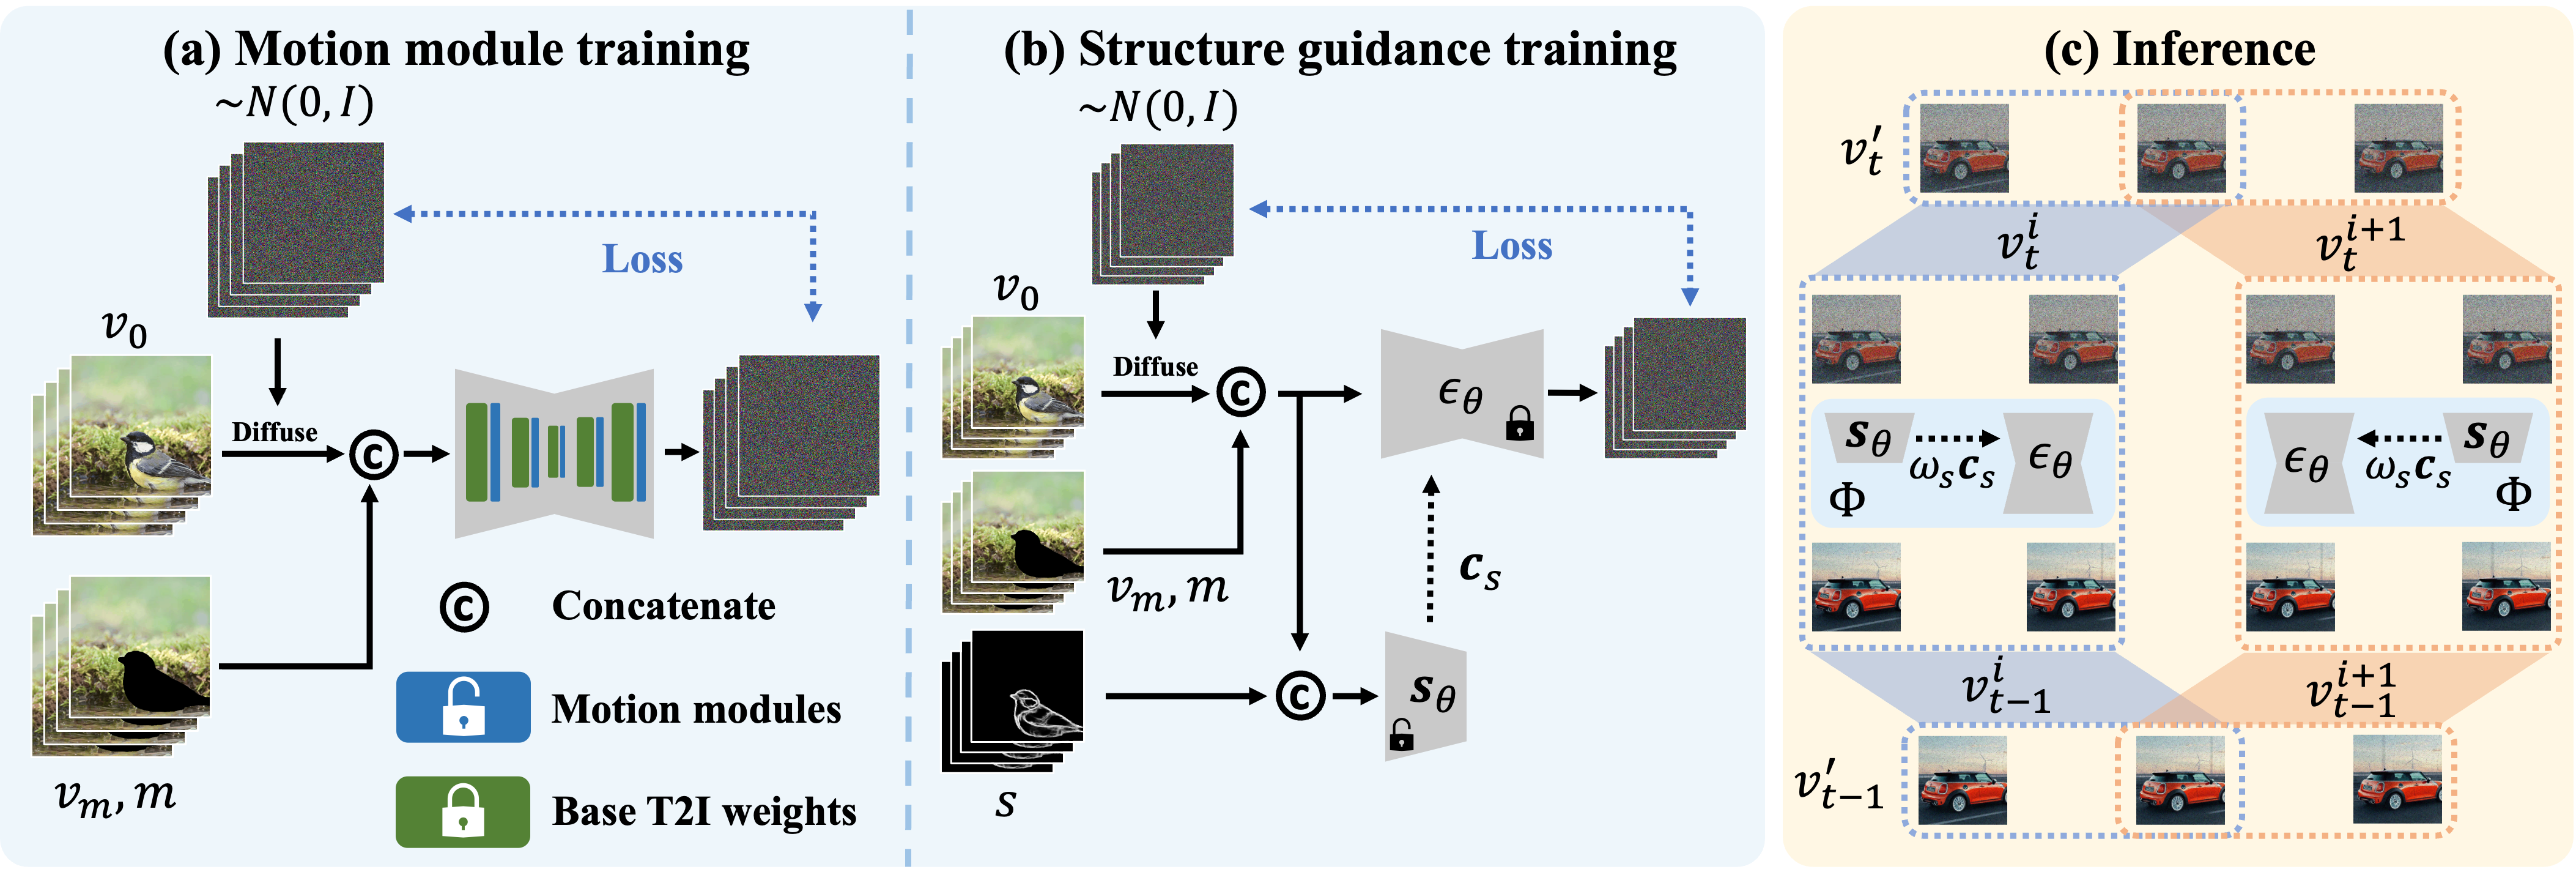
阶段一:视频噪声预测
每帧独立执行前向加噪,网络通过 temporal self-attention 交换时间信息。保留区域视频为 \(v_m=\{x_i^0\odot(1-m_i)\}_{i=1}^{N}\),条件为 \(c=(v_m,m,\tau_\theta(y))\)。
只训练 motion modules 的目的,是避免小规模视频数据破坏预训练图像 LDM 的文本与视觉生成能力。该策略把空间生成先验和时间适配分开。
阶段二:可调结构引导
逐帧结构 \(s^i=S(x_i^0)\) 由 HED 提取,训练时只保留合成掩码区域内的 HED。结构模块输出 13 张、跨 4 个分辨率的特征 \(\{h_j\}_{j=1}^{13}\),注入 UNet 各 skip connection 和 middle block。
推理时使用 \(\epsilon_\theta(v_t,t,c,\omega_s c_s)\)。\(\omega_s\) 越大,结果越贴近源视频结构。正文设置:对象替换和扩画取 \(\omega_s=0\),重纹理取 \(\omega_s=1\)。
每个去噪步骤都在重叠窗口之间求共识
Temporal MultiDiffusion 沿时间轴应用 MultiDiffusion。它在每一步去噪时让重叠窗口共同预测同一帧,再对这些预测求平均,从而避免已完成的独立短片产生突变接缝。
对 \(N'\) 帧视频,以长度 \(N\) 和步幅 \(o\) 建立窗口 \(v_t^i\)。论文给出的窗口数如下。当 \(N'-N\) 不能被 \(o\) 整除时,该式本身不会覆盖尾部;论文没有公开 tail window、padding 或末窗对齐策略:
令 \(S_k\) 为包含全局第 \(k\) 帧的窗口索引集合;窗口 \(i\) 中与其对应的局部帧记为 \(v_{t-1}^i[j]\)。融合规则为:
同一帧接受多个相邻上下文的预测,平均操作在整个反向扩散轨迹中反复执行。它直接缓解窗口接缝,但长距离身份仍可能缓慢漂移。
中间帧注意力引导
每个 spatial self-attention 层缓存全视频中间帧的 \(K^{N'/2}\) 与 \(V^{N'/2}\)。第 \(i\) 帧保留自己的常规注意力,同时加入对该参考帧的辅助注意力:
作者选择中间帧,因为它到其他帧的总体时间距离更小。正文长视频设置 \(\omega_a=0.3\)、\(o=4\)。过强引导会让参考帧键值支配生成,\(\omega_a=1\) 的汽车案例出现车轮伪影。
计算复杂度
整段直接推理
附录将基础模型复杂度写为 \(O((HW)^2N'^2)\):空间 attention 为 \(O((HW)^2)\),temporal attention 随 \(N'^2\) 增长。
滑动窗口
窗口阶段约为 \(O((HW)^2N^2n)\);加入中间帧 attention 后作者写为 \(O(2(HW)^2N^2n)\)。当 \(N'\gg N\) 且步幅固定时,对总长度近似线性。
论文公开了系统骨架,训练配方仍不完整
| 项目 | 论文披露 | 复现含义 |
|---|---|---|
| 基础模型 | 大规模预训练 inpainting Latent Diffusion Model,引用 Rombach et al. | 未给出精确 checkpoint 或版本 |
| 训练数据 | 去水印 Shutterstock 视频 | 私有来源;未报告视频数量、筛选与划分 |
| 片段 | 16 帧,512×512,6 FPS | 正文基础模型的训练分布 |
| 掩码 | synthetic random masks | 未公开采样分布、形状与面积范围 |
| 结构条件 | 掩码区域内 HED | UNet encoder 权重复制到控制模块,控制模块全部参数训练 |
| 评估数据 | 125 个训练未见视频 | Grounding-DINO + SAM 定位首帧对象,XMem 传播掩码,Llama 生成多种提示 |
| 长视频推理 | \(\omega_a=0.3\),\(o=4\) | 正文默认;结构比例按任务设为 0 或 1 |
| 未公开 | optimizer、learning rate、batch size、epoch/step、scheduler、warmup、weight decay、precision、GPU、训练时长 | 无法据论文精确重训 |
| 同样未公开 | 采样器最终选择、采样步数、CFG、negative prompt、随机种子、窗口尾部策略 | 无法精确复现推理质量与速度 |
主表验证 16 帧基础模型,不覆盖任意长度量化
所有方法在 16 帧视频上比较,作者有意关闭 Sec. 3.4 的长视频推理以控制条件。BP 是未编辑区域 L1 距离,表格以 \(10^{-3}\) 为单位,越低越好;例如 43.1 对应 0.0431;TA 是 CLIP text-video alignment,越高越好;TC 是相邻帧 CLIP-Image 特征余弦相似度,越高越好。
| 方法 | Uncropping | Object swap | Re-texturing | ||||||
|---|---|---|---|---|---|---|---|---|---|
| BP ↓ | TA ↑ | TC ↑ | BP ↓ | TA ↑ | TC ↑ | BP ↓ | TA ↑ | TC ↑ | |
| Per-frame LDM | 43.1 | 31.3 | 93.6 | 41.4 | 31.1 | 92.5 | 41.4 | 31.2 | 92.4 |
| Text2Video-Zero | 49.0 | 31.4 | 96.5 | 47.3 | 30.1 | 94.9 | 47.9 | 30.6 | 95.0 |
| VideoComposer | 55.7 | 31.2 | 96.4 | 71.0 | 31.5 | 96.5 | 64.5 | 32.1 | 95.5 |
| AVID | 42.3 | 31.3 | 97.2 | 41.1 | 31.5 | 96.5 | 40.7 | 32.0 | 96.3 |
AVID 在所有任务取得最低 BP,并在 uncropping 与 re-texturing 获得最高 TC;object swap 的 TA/TC 与 VideoComposer 持平。VideoComposer 的重纹理 TA 32.1 略高于 AVID 32.0。比较条件仍有差异:VideoComposer 重纹理同时接收 sketch、depth 与 motion vector,AVID 只接收 HED。
用户对比同时考虑时间一致、文本匹配和背景保持。Figure 6 给出四种方法的偏好比例,但正文没有披露参与者数量、每人样本数、随机化、置信区间或显著性检验,因此只能把百分比视为偏好证据,不能推导总体效应大小。
TokenFlow 附录比较
| 任务 | 方法 | BP ↓ | TA ↑ | TC ↑ |
|---|---|---|---|---|
| Object swap | TokenFlow | 93.3 | 31.5 | 97.5 |
| Object swap | AVID | 41.1 | 31.5 | 96.5 |
| Re-texturing | TokenFlow | 90.8 | 32.2 | 97.8 |
| Re-texturing | AVID | 40.7 | 32.0 | 96.3 |
TokenFlow 在 TC 与 TA 略高,却严重改变掩码外背景。作者将其归因于 TokenFlow 依靠文本决定编辑区域且使用 DDIM inversion;AVID 的显式 mask 对背景保护更强。TC 的高分也可能来自内容变化较小,无法单独证明运动真实。
消融定位了三种机制的作用边界
结构比例 \(\omega_s\)
重纹理从 0 增至 1 时,金色熊猫更好保持原运动与轮廓;对象替换中高比例会让浣熊继承熊猫形状并削弱文本匹配。该结果支持按任务调节结构强度。
重叠窗口
32 帧案例中,两个独立 16 帧片段在第 15/16 帧出现鹅颈纹理和浣熊姿态突变;Temporal MultiDiffusion 使边界过渡连续。该实验将 \(\omega_a\) 设为 0,以隔离窗口融合。
中间帧 \(\omega_a\)
\(\omega_a=0\) 时汽车颜色由红向暗红漂移;适度引导维持颜色与图案;\(\omega_a=1\) 引入后轮伪影。正文默认 0.3 来平衡锚定与帧内适应。
参考帧选择
附录比较 SC Attention、middle-frame SC Attention、first-frame guidance 与 middle-frame guidance。中间帧方案在示例中同时稳定颜色和图案;这些结果为定性样例,没有量化汇总。
24 帧直接推理
位置编码上限为 24 使模型可以接收 24 帧,但直接处理的浣熊耳朵错位,另一案例无法自然融合;窗口推理改善质量。它证明“可以执行”和“保持训练分布质量”存在差别。
掩码误差
扩大掩码仍可补绘,归因于随机合成掩码训练;腐蚀掩码没有覆盖全部旧对象时,区域外保护机制会保留残片,阻碍目标形状改变。
官方仓库没有发布可运行模型代码
仓库实际内容
assets/ · LICENSE · README.md
3 commits · MIT license
无训练代码、推理代码、config、checkpoint 或 release
README 声明仓库包含论文代码,但当前可见文件只有素材与说明。页面致谢 diffusers、AnimateDiff 与 Tune-A-Video,无法由此恢复 AVID 的具体实现。
可依据论文重建
两阶段冻结策略、16 帧输入、HED 控制、13 个多尺度特征、窗口均值融合、中间帧注意力公式、默认 \(o=4\)、\(\omega_a=0.3\) 与任务相关 \(\omega_s\)。
关键缺口
模型 checkpoint、optimizer 与学习率、噪声 schedule、采样器与步数、CFG、训练时长、显存、随机掩码生成器、测试 prompt pipeline 和视频预处理细节。
依赖风险
Shutterstock 训练集不可下载核查;Grounding-DINO、SAM、XMem、Llama 与 HED 构成外部工具链。每个版本变化都可能改变 mask、提示和最终分数。
系统组合具有实用价值,长程证据和复现透明度偏弱
Strengths
- 问题拆分与组件职责清楚:motion、structure、window consensus、identity anchor 分别处理不同失败模式。
- 冻结主图像 LDM,训练量集中在时序和结构适配器,合理保护预训练生成能力。
- 显式 mask 让背景保护可测且明显优于依靠文本编辑区域的方法。
- 附录诚实展示复杂动作、掩码遗漏和离开后返回画面的失败案例。
Weaknesses
- 长视频贡献缺乏量化表与长度扩展曲线,主表只覆盖 16 帧。
- TC 是相邻帧 CLIP 相似度,可能奖励静态或欠运动结果,缺少 optical flow、轨迹、重投影或动作真实性指标。
- 用户研究缺少人数、样本分配、置信区间与显著性统计。
- 训练集、代码、权重和大量超参数未公开,精确复现受阻。
Claim audit
“背景保持”由 BP 强力支持;“基础视频一致性”由 TC、用户偏好和定性样例支持;“任意长度”由算法可执行性和最长 256 帧网页样例支持;跨长程运动真实性和任意长度质量稳定性没有得到充分验证。
Limitations
马头左右转动会消失后再出现,狮腿发生穿插;对象离开画面后返回时容易失去一致性。作者将前两项归因于 motion foundation model 能力,将后者指向缺少更精细的 cross-clip attention injection。
一手资料与版本说明
- Zhang et al., arXiv:2312.03816v3,16 页合订本:正文 11 页,随后附录 5 页;方法、公式、主表与失败案例的主要来源。
- CVPR 2024 Open Access,正式会议信息与 pp. 7162–7172。
- CVPR Supplementary Material,6 页独立附录版本;额外任务、效率、TokenFlow、24 帧与 attention 消融、mask 鲁棒性及局限。
- 官方项目页,方法总览、定性视频、80/256 帧 text-to-video 延伸结果。
- 官方补充网页,对比、消融和失败视频的动态展示。
- 官方 GitHub,用于核查实际公开内容与可复现边界。