核心命题:速度、局部性与可重建性
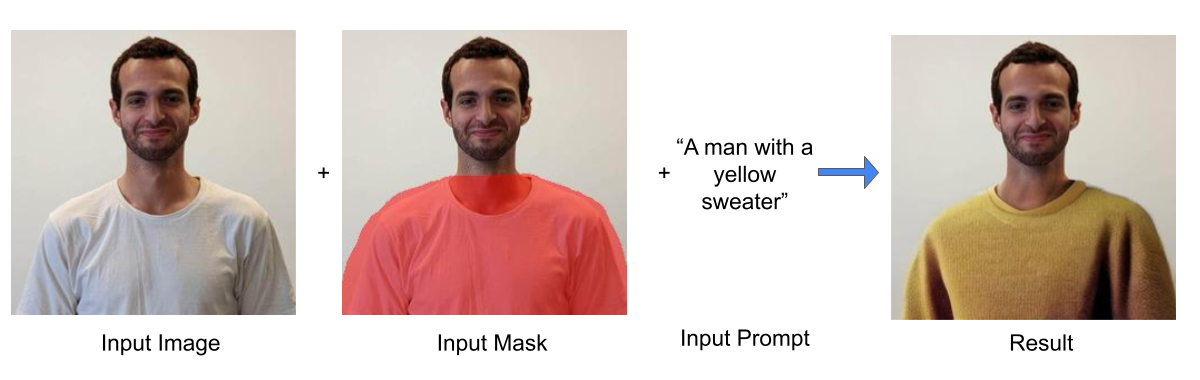
批量推理加速
论文 Table 2:24 个候选加背景优化为 72 秒;Blended Diffusion 24 个候选为 552 秒。比较基于同一 NVIDIA A10。
Batch precision
50 组随机图像、矩形掩码与 ImageNet 类别提示中,本文方法的 top-5 分类精度;Blended Diffusion 为 10.4%。
组合预训练模型
主体算法组合预训练 text-to-image LDM、VAE 与 CLIP 排序器。没有新增 diffusion 训练;每张选中结果可执行 75 步 decoder 权重优化。
作者验证了更高的评测 precision、更快的批量推理、较好的局部背景保持,以及细掩码与高频背景两类失败模式的定向修复。实验没有证明语义编辑始终正确,也没有覆盖开放词汇提示的系统性精度。
Research gap
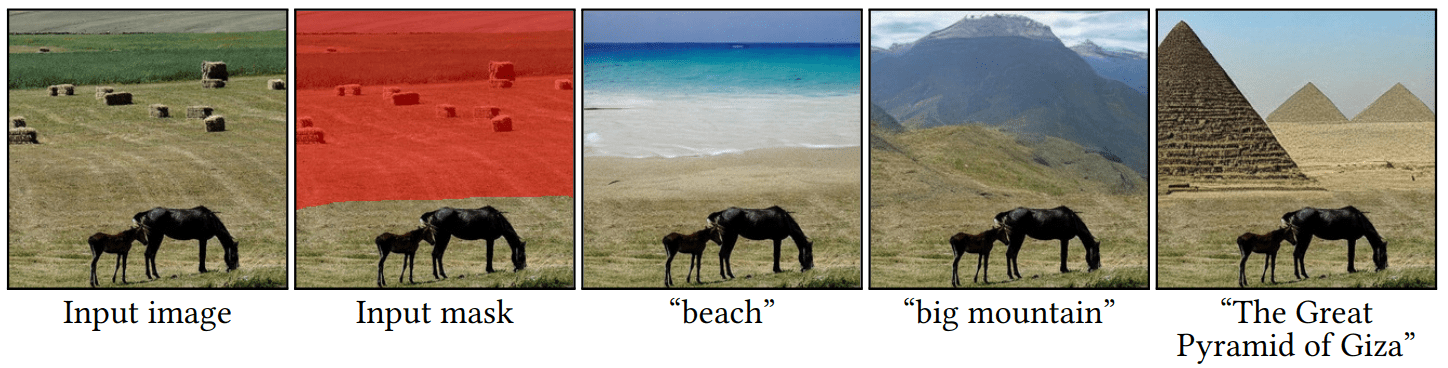
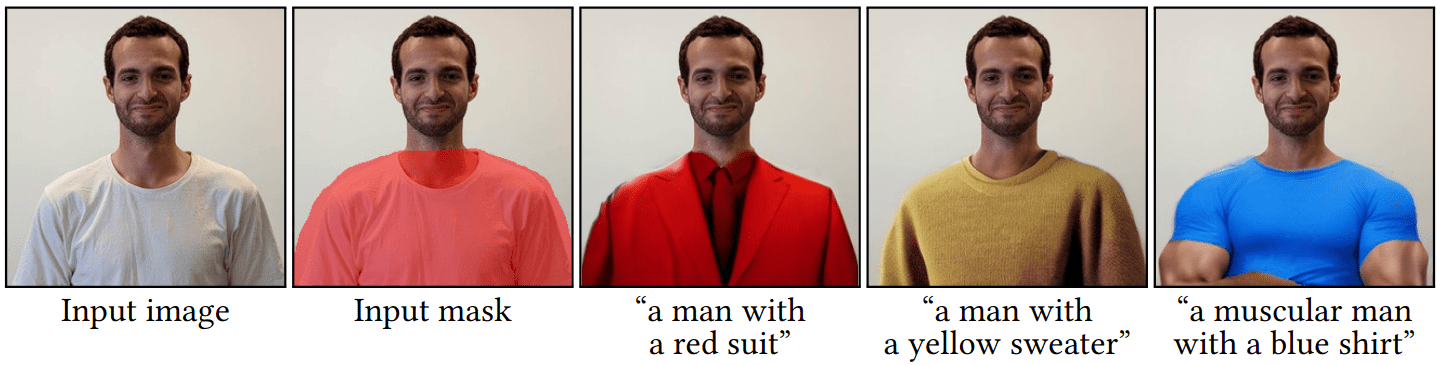
当时公开的 Blended Diffusion 能编辑真实通用图像,却在像素空间执行扩散,并在每一步计算 CLIP gradient,单批次约需 25 分钟且可能出现像素级噪声。text-to-image LDM 已显著缩短生成时间,但原模型从文本生成新图,没有局部编辑接口;其 VAE 压缩又会改变掩码外的脸、文字与规则纹理。论文将三个问题拆开处理:latent 层局部约束、lossy decoder 的背景恢复、低分辨率 latent 对细掩码的吞噬。
问题定义与符号
| 符号 | 含义 | 所在空间 |
|---|---|---|
| \(E,D\) | 预训练 VAE encoder / decoder | pixel ↔ latent |
| \(\mathbf{z}_{\mathrm{init}}\) | 源图编码;论文写作 \(\mathbf{z}_{\mathrm{init}}\sim E(\mathbf{x})\) | latent,宽高各缩小 8 倍 |
| \(\mathbf{m}_{\mathrm{latent}}\) | 下采样后的编辑掩码 | latent spatial grid |
| \(\mathbf{z}_{t,\mathrm{fg}}\) | 在提示 \(d\) 条件下,由当前状态去噪得到的候选前景 | latent |
| \(\mathbf{z}_{t,\mathrm{bg}}\) | 把源图 latent 加噪到当前噪声级别的背景锚点 | latent |
| \(k,t\) | 起始噪声步与当前反向扩散步 | diffusion schedule |
这个方法可以理解为“受约束的反向扩散”:文本模型每一步都能重写完整 latent,随后掩码外坐标立即由源图在同噪声层级的状态替换。下一次 denoising 再把边界附近不一致的 latent 拉回可生成图像区域。局部性来自反复投影,语义来自预训练条件扩散先验。
Algorithm 1:逐步 latent blending
文本 \(d\)
掩码 \(\mathbf{m}\)
下采样掩码
加噪到 \(k\)
源背景加噪 +
空间混合
候选排序
- 用 VAE 把 \(\mathbf{x}\) 编码为 \(\mathbf{z}_{\mathrm{init}}\),把 \(\mathbf{m}\) 以 nearest-neighbor 方式缩到 latent 尺寸。
- 从指定噪声等级 \(k\) 开始。噪声较多会给语义变化更多自由,代价是源内容约束减弱。
- 每一步先做 text-conditioned denoising,得到前景候选;独立地把 \(\mathbf{z}_{\mathrm{init}}\) 加噪到相应等级,得到背景锚点。
- 按 latent mask 混合。循环结束后仅解码一次,生成候选图像。
- 同一输入采样 24 个候选。把掩码内结果裁出并计算 CLIP image-text normalized cosine distance,排序后选择结果。
该设计取消了 Blended Diffusion 每步的像素空间 CLIP-loss gradient,也减少了空间尺寸。论文将速度与更少像素 clipping artifact 归因于此。论文还声称没有 pixel-level CLIP 对抗样本风险;证据是方法路径不含这类梯度,实验没有建立形式化保证。
背景重建:逐图优化 decoder
VAE 是有损压缩器。即使不运行扩散,\(D(E(\mathbf{x}))\) 也会改变脸部、字形与高频纹理。直接像素拼接会出现接缝;Poisson blending 会改变编辑区颜色;只优化 latent 的表达能力仍受固定 decoder 限制,论文观察到过度平滑。
前景项
要求微调后的 decoder 仍重现初始编辑 \(\hat{\mathbf{x}}\) 的掩码内内容。附录 B.4 显示删掉该项会让编辑区域颜色变淡。
背景项
以 \(\lambda=100\) 强调掩码外复原,修复人脸、文字和结构纹理。此阶段只对 top-ranked 候选执行,所以 24 张批量仅增加约 19 秒。
Figure 4–5 的案例支持 decoder 权重优化在这些输入上优于 pixel stitching、Poisson 与 latent optimization。论文没有给背景 PSNR、LPIPS 或边界误差的聚合消融,因此“最佳重建”主要由定性图支撑。
细掩码:先放宽空间,再逐步收紧
latent 宽高各缩小 8 倍,细线在下采样后可能只剩极少坐标。早期 denoising 负责粗形状与颜色,此时狭小 mask 让源背景迅速覆盖文本产生的信号;到后期再扩大区域又会破坏边界。
实现把 diffusion steps 平均分为四段,依次使用 7×7、5×5、3×3 ones kernel 膨胀后的掩码与原掩码。这样,粗尺度阶段有足够空间形成对象,最终阶段恢复用户指定边界。Figure 7 的 clouds / smoke / bracelet 显示前两类明显改善,绿色手环仍缺少精细结构。
progressive shrinking 的证据是一组过程可视化与三项定性对照。论文没有报告该组件的数值消融、最佳 kernel 顺序敏感性或对粗掩码的副作用。
实验:精度领先,评测覆盖仍然窄
Table 1 · Quantitative comparison
| 方法 | Batch precision ↑ | Batch diversity ↑ | Best-result precision ↑ | 人评:本文视觉质量胜出 | 人评:本文文本匹配胜出 |
|---|---|---|---|---|---|
| Blended Diffusion | 10.4% | 0.106 | 36% | 64% | 55% |
| Local CLIP-guided diffusion | 10.49% | 0.419 | 38% | 74% | 62% |
| PaintByWord++ | — | — | 0% | 94% | 68% |
| GLIDE-filtered | 1.87% | 0.114 | 4% | 26% | 86% |
| Ours | 28.66% | 0.115 | 54% | — | — |
评测集包含 50 张随机网络/私有图片。每张图生成边长位于对应维度五分之一至二分之一之间的随机矩形 mask,再随机抽取一个 ImageNet class label 作为 prompt。precision 先遮掉背景,再由 EfficientNet 判断目标 label 是否进入 top-5。diversity 只在分类正确的候选之间计算掩码内 pairwise LPIPS。Local CLIP-guided diffusion 的 diversity 很高,同时会改变整图,说明该指标并未单独惩罚背景漂移。
Table 2 · NVIDIA A10 推理时间
| 方法 | Batch size | 单张(秒) | 整批(秒) | 整批均摊(秒) |
|---|---|---|---|---|
| Blended Diffusion | 64 | 27 | 1472 | 23 |
| Blended Diffusion | 24* | 27 | 552 | 23 |
| Local CLIP-guided diffusion | 64 | 27 | 1472 | 23 |
| Local CLIP-guided diffusion | 24* | 27 | 552 | 23 |
| PaintByWord++ | — | 78 | — | — |
| GLIDE-filtered | 24 | 7 | 89 | 3.7 |
| Ours,无背景优化 | 24 | 6 | 53 | 2.2 |
| Ours,含背景优化 | 24 | 25 | 72 | 3 |
* 24 低于 Blended Diffusion 作者推荐 batch size,可能降低 batch precision。本文的 72 秒是先并行生成 24 张、CLIP 排序,再只优化第一名背景。按整批比较,72 / 552;按单次 top result 延迟,25 秒与 27 秒接近。
AMT user study
仍使用同一组 50 个随机任务,每个本文结果与一个公开 baseline 结果成对比较视觉质量和文本匹配。每个问题收集 5 个评分,总计每个任务维度 250 个评分;平局各分一半。本文相对 Blended Diffusion 的胜率为视觉 64%、文本 55%,对应二项检验 \(p\lt0.001\) 与 \(p=0.043\)。GLIDE-filtered 的视觉质量上本文只有 26% 胜率,作者解释为 GLIDE-filtered 常保持输入不变,因此看起来干净却不服从文字。
参数规模
附录 Table 3:本文 LDM 1.45B 加 CLIP 0.15B,共 1.60B;Blended Diffusion 为 0.70B;GLIDE 为 5.15B;GLIDE-filtered 为 0.45B。参数更少没有直接推出更快,核心速度来源仍是 latent spatial size、无逐步 CLIP gradient 和 batch execution。
Paper vs. Implementation:三个入口承担不同任务
| 文件 | 实际行为 | 与论文 Algorithm 1 的关系 |
|---|---|---|
ldm/image_editor.py | 原始 256×256 LDM 路径:50 DDIM steps、默认 CFG scale 5、latent 尺寸 \(H/8\times W/8\),调用定制 DDIM sampler 传入 source image、mask 与渐进掩码。 | 论文主方法的原始实现入口;随后用 CLIP ViT-B/16 对 mask 内候选排序。 |
ldm/image_reconstruction.py | 独立第二阶段:默认 weights optimization、75 steps;decoder Adam 学习率 \(10^{-4}\),latent 版本代码学习率 0.1;损失背景权重 100。 | 对应 Section 4.2。README 明确说明这一步可选,通常只处理选中的候选。 |
scripts/text_editing_SDXL.py | 后续 SDXL/Diffusers 实现,默认 1024×1024、50 steps、CFG 5;每步执行 latents * latent_mask + noise_source_latents * (1 - latent_mask)。 | 清楚实现 latent blending;使用更新的 SDXL backbone,不能把它的输出或默认值当作 2023 论文实验配置。 |
scripts/inpaint.py | 加载 LDM 的 inpainting_big checkpoint,把 masked image encoding 与 mask 拼成条件;解码后执行像素合成 (1-mask)*image + mask*predicted_image。该脚本没有文本 prompt。 | 通用 LDM inpainting 示例/辅助基线,未实现本文的 text-conditioned per-step latent blending。它的 pixel composite 不构成论文算法与代码冲突。 |
仓库 README 现在把 SDXL 与 SD 2.1 标为“New”,把论文 LDM 权重路径标为“Old”。论文数字来自 Rombach et al. 的 1.45B text-to-image LDM、256×256 输入和当时实现;使用 SDXL 脚本只能复现算法思想,不能直接复算 Table 1–2。
训练与推理配置
| 项目 | 论文公开信息 | 缺失信息 |
|---|---|---|
| 训练 | 本文不训练扩散模型;使用预训练 text-to-image LDM、CLIP ViT-B/16、公开 Blended Diffusion 与 GLIDE-filtered。 | LDM 自身训练细节应查原 LDM 论文;本文没有新的数据集训练 split。 |
| 主推理 | 256×256;latent 缩放 8 倍;50 DDIM steps;原仓库默认 batch 4、论文时间表 batch 24;CFG scale 5,DDIM eta 0。 | 论文正文没有完整列出随机种子、具体起始噪声强度的主实验取值及所有命令行参数。 |
| 背景优化 | Adam,decoder weights 学习率 0.0001,75 steps,\(\lambda=100\)。 | 没有报告显存峰值、收敛曲线或不同图像的提前停止规则。 |
| ranking | CLIP normalized cosine distance,仅使用 mask 内候选。 | 没有学习整体一致性、边界自然度或对象尺度的联合打分器。 |
Reviewer commentary
Strengths
- 对 LDM 的改造极简且无需训练,latent blending 的约束位置清楚。
- 准确识别 VAE reconstruction 与细 mask 两个 latent editing 特有故障,并分别给出可操作修复。
- 速度表同时报告 single image、full batch 与均摊,解释了 ranking 后仅优化一张的系统收益。
- 附录公开 metric 构造、AMT 问题、显著性与 optimizer 设置,复现信息优于正文。
Weaknesses
- 50 个随机 ImageNet label 任务规模较小,主要测可分类对象插入;材质、属性、关系、文字与背景替换覆盖不足。
- precision evaluator 只看遮罩后局部,无法衡量边界、光照、尺度与全图语义一致性。
- decoder 微调与 progressive shrinking 主要依赖定性消融,缺少汇总指标和成本分析。
- 比较混合了公开小模型、论文图片与在线 demo;可用性限制影响公平性。
- 随机敏感性、text bias 与整体不真实由论文承认,但 ranking 没有修复这些问题。
真正支持的结论
在论文构造的 50 个 ImageNet 类别局部编辑任务上,本文提高 classifier-based precision;在 A10 上批量生成候选显著快于两种逐步 CLIP-gradient 方法;五人多数投票偏好本文相对多数公开 baseline 的文本匹配。这些结果支持“在该协议下更快且目标命中率更高”。
证据仍有限的解释
“latent space 消除 adversarial example”依据计算路径推断;“decoder weights optimization 最佳”依赖有限案例;“细掩码问题来自粗到细生成动态”由过程可视化支持,缺少替代机制检验。论文没有以 segmentation boundary、background LPIPS 或局部 FID 分离这些因素。
可把每步硬 mask projection 改为 uncertainty-aware soft boundary:早期以高温度、大支持域形成语义,后期按照 decoder Jacobian 与边界重建误差收紧;ranking 同时使用文本命中、背景 identity、边界 gradient continuity 与全图 VLM coherence。decoder 微调还可替换成只更新少量 affine / LoRA 参数,降低逐图过拟合与 19 秒后处理成本。
程序化材质研究可迁移点
本文不生成 material graph。可迁移的是“每一步生成后投影回冻结区域”的控制原则:对材质图拓扑生成,可把未编辑子图、合法端口和执行结果当作 background constraint;候选生成后用 renderer feedback 只优化受影响节点参数。渐进 mask 的对应物是从较宽的子图 neighborhood 开始搜索,再逐层收缩到用户指定节点;这种延伸仍需新的图有效性、可执行性和材质外观实验。
来源与证据边界
- Avrahami, Fried, Lischinski. Blended Latent Diffusion. arXiv:2206.02779v2。本页完整阅读 27 页合订 PDF:正文 11 页,后续为 Appendix A–E、图表与参考文献。
- ACM TOG 42(4), Article 149, 2023。正式 DOI 与出版身份。
- 官方项目页。方法概览、应用图、视频与论文链接。
- 官方 GitHub repository。README、原始 LDM editor/reconstruction、后续 SDXL 与 inpainting 脚本均按完整文件核查。
- CompVis Latent Diffusion。预训练 LDM 与基础代码来源。
核查日期:2026-09-28。页面中的实验数字来自论文 v2。仓库的 SDXL 更新属于后续实现,已与论文实验配置分开说明。未运行 GPU 模型或重新生成论文实验。