贡献 1 · 可比较的任务载体
五类共 245 个手工任务,同时提供 Blender 文件、起点与目标脚本、图像和差异描述,覆盖参数修改和程序结构修改。
从“生成得像”
到“评测得可信”。
Benchmarking Foundational Model Systems for Graphics Editing
这篇论文最值得借鉴的,不只是把模型放进 Blender,而是把真实编辑工作流变成可执行、可比较、可诊断的实验。对 PMG 而言,下一步是让评测真正识别视觉、程序、材质行为与编辑能力之间的差异。
阅读基准:arXiv:2504.01786v1,2025-04-02,24 页含附录;出版身份经 CVF 核查。代码快照核查日 2026-09-18。论文历史结果不代表当前模型排行榜。本文未运行 BlenderGym 实验。
图形编辑不是一个统一的“写代码”问题。改变灯光颜色需要视觉判断;调整物体位置需要空间推理;修改材质或几何节点还需要把感知差异转成有效程序。过去各系统使用自建场景展示能力,难以判断性能差异究竟来自模型、任务难度、工具封装还是推理预算。
BlenderGym 用已知目标场景的重建式编辑建立统一协议:给起始代码与起点/目标渲染图,要求系统修改代码,再实际渲染、量化比较。任务不要求模型从空白生成任意场景,也不是用一句自由文本让评委判断艺术质量。[§3]
五类共 245 个手工任务,同时提供 Blender 文件、起点与目标脚本、图像和差异描述,覆盖参数修改和程序结构修改。
终端评测采用图像与几何距离。系统内部可以用 VLM 选候选,但最终 benchmark 分数不是这个 VLM 自己给出的评分。
把生成和验证拆开实验,发现增加验证计算也能改善选择;总预算不同时,较优的生成/验证分配比例发生变化。
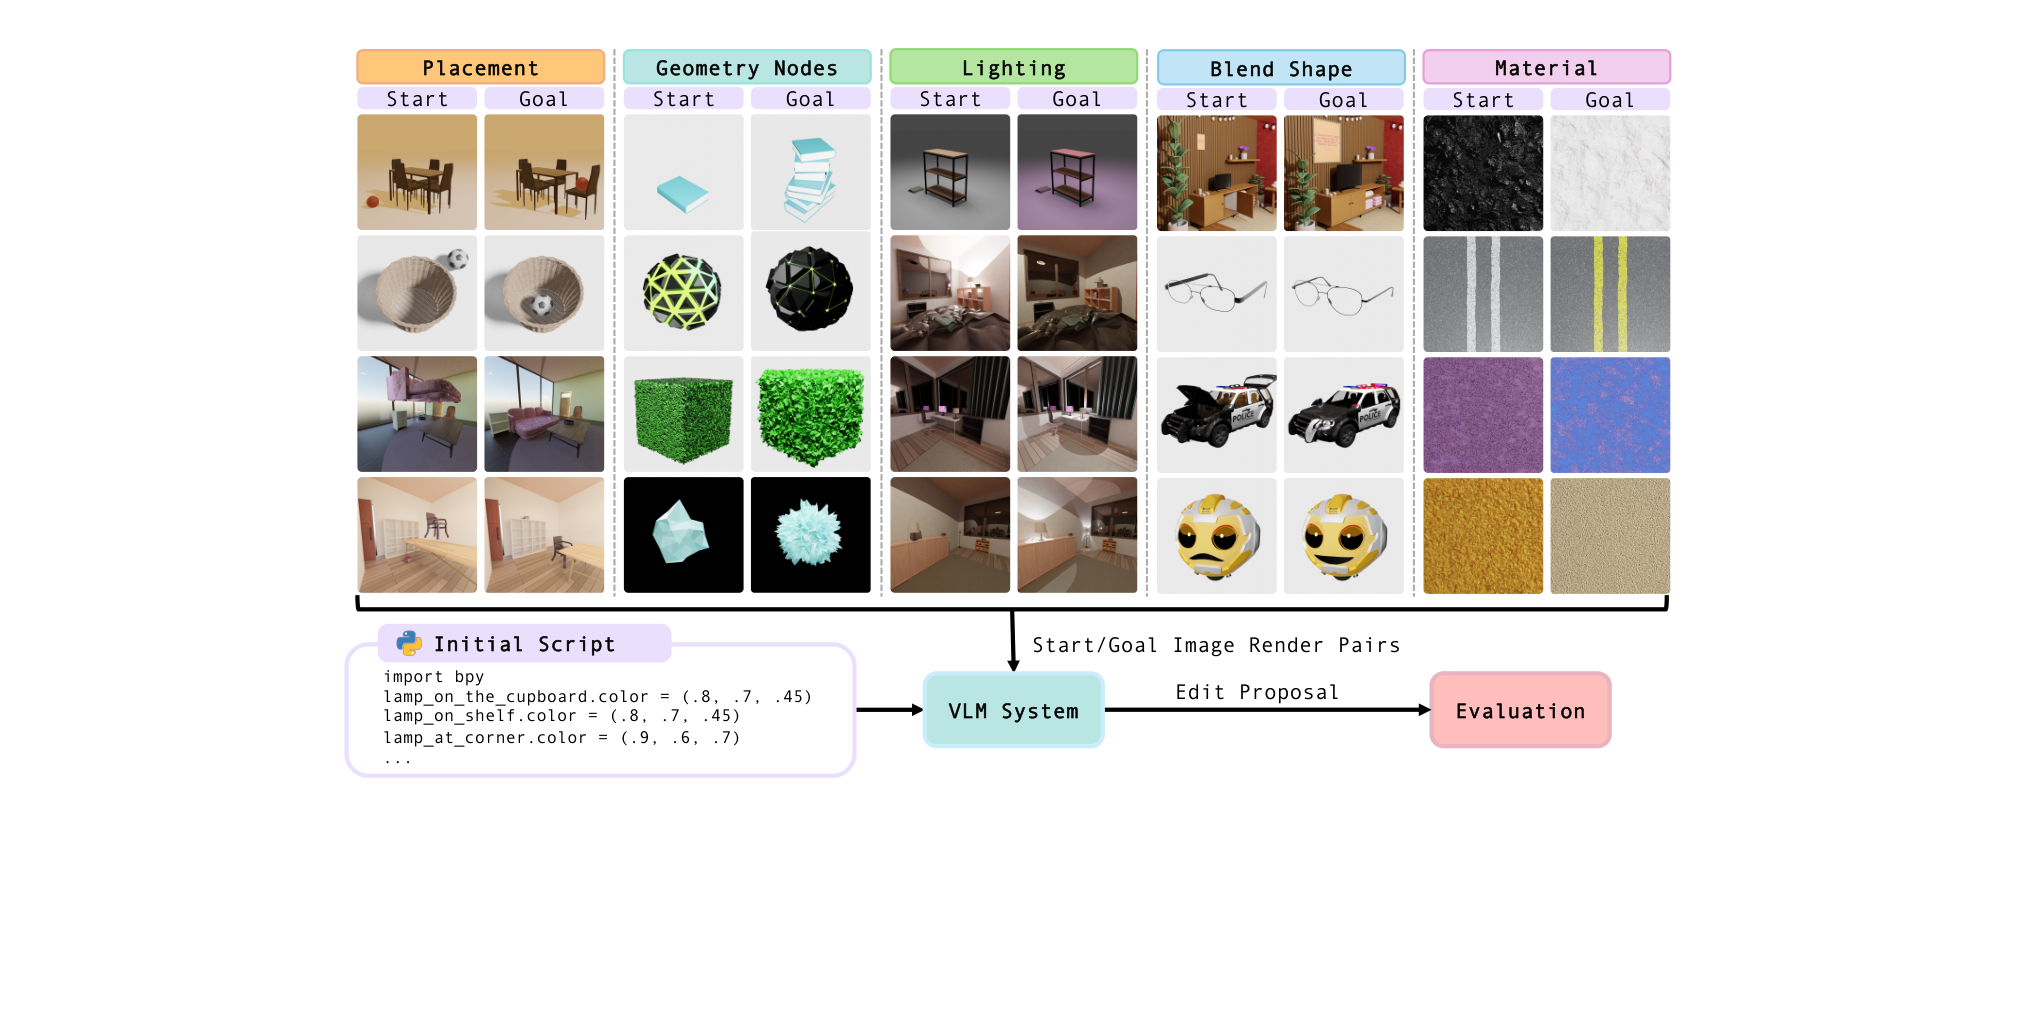
样本来自 BlenderAlchemy、Infinigen、BlenderKit 等原型,经人工构造起点—目标场景。245 是任务对数量,不能理解为 245 个完全独立的底层资产家族。原文未给出完整的训练/验证/隐藏测试划分;本文研究的是评测集上的推理能力,不是训练一个新模型。[§3.1]
| 任务 / 数量 | 系统要掌握什么 | 编辑对象 | 论文指标 ↓ |
|---|---|---|---|
| Geometry / 50 | 形状、尺度、空间分布 | BPY 与 Infinigen 程序、几何节点 | PL、N-CLIP、CD |
| Lighting / 40 | 从颜色、阴影反推光照 | 强度、颜色、位置、朝向及光源类型 | PL、N-CLIP |
| Material / 40 | 纹理、颜色、位移和图案 | BPY 与 Infinigen 材质代码/节点 | PL、N-CLIP |
| Blend Shape / 75 | 将语义参数对应到连续形变 | 带语言命名的形状控制量 | PL、N-CLIP、CD |
| Placement / 40 | 空间关系与坐标变化 | 直接坐标、位移向量、相对放置函数 | PL、N-CLIP、CD |
基础 .blend
起始 Python 脚本
起点/目标图像
修改后脚本
可执行候选
最终选定编辑
目标脚本/场景
评测专用视角
目标渲染与几何
多视角 PL、N-CLIP
适用任务的 CD
执行失败情况
数据包虽然包含目标脚本和语言差异描述,但论文标准系统描述的输入是起始脚本与起点/目标图像。不能因为目标代码在数据包里,就允许代理读取它。差异描述是否作为额外提示也必须单独声明,不能悄悄加入基础设置。
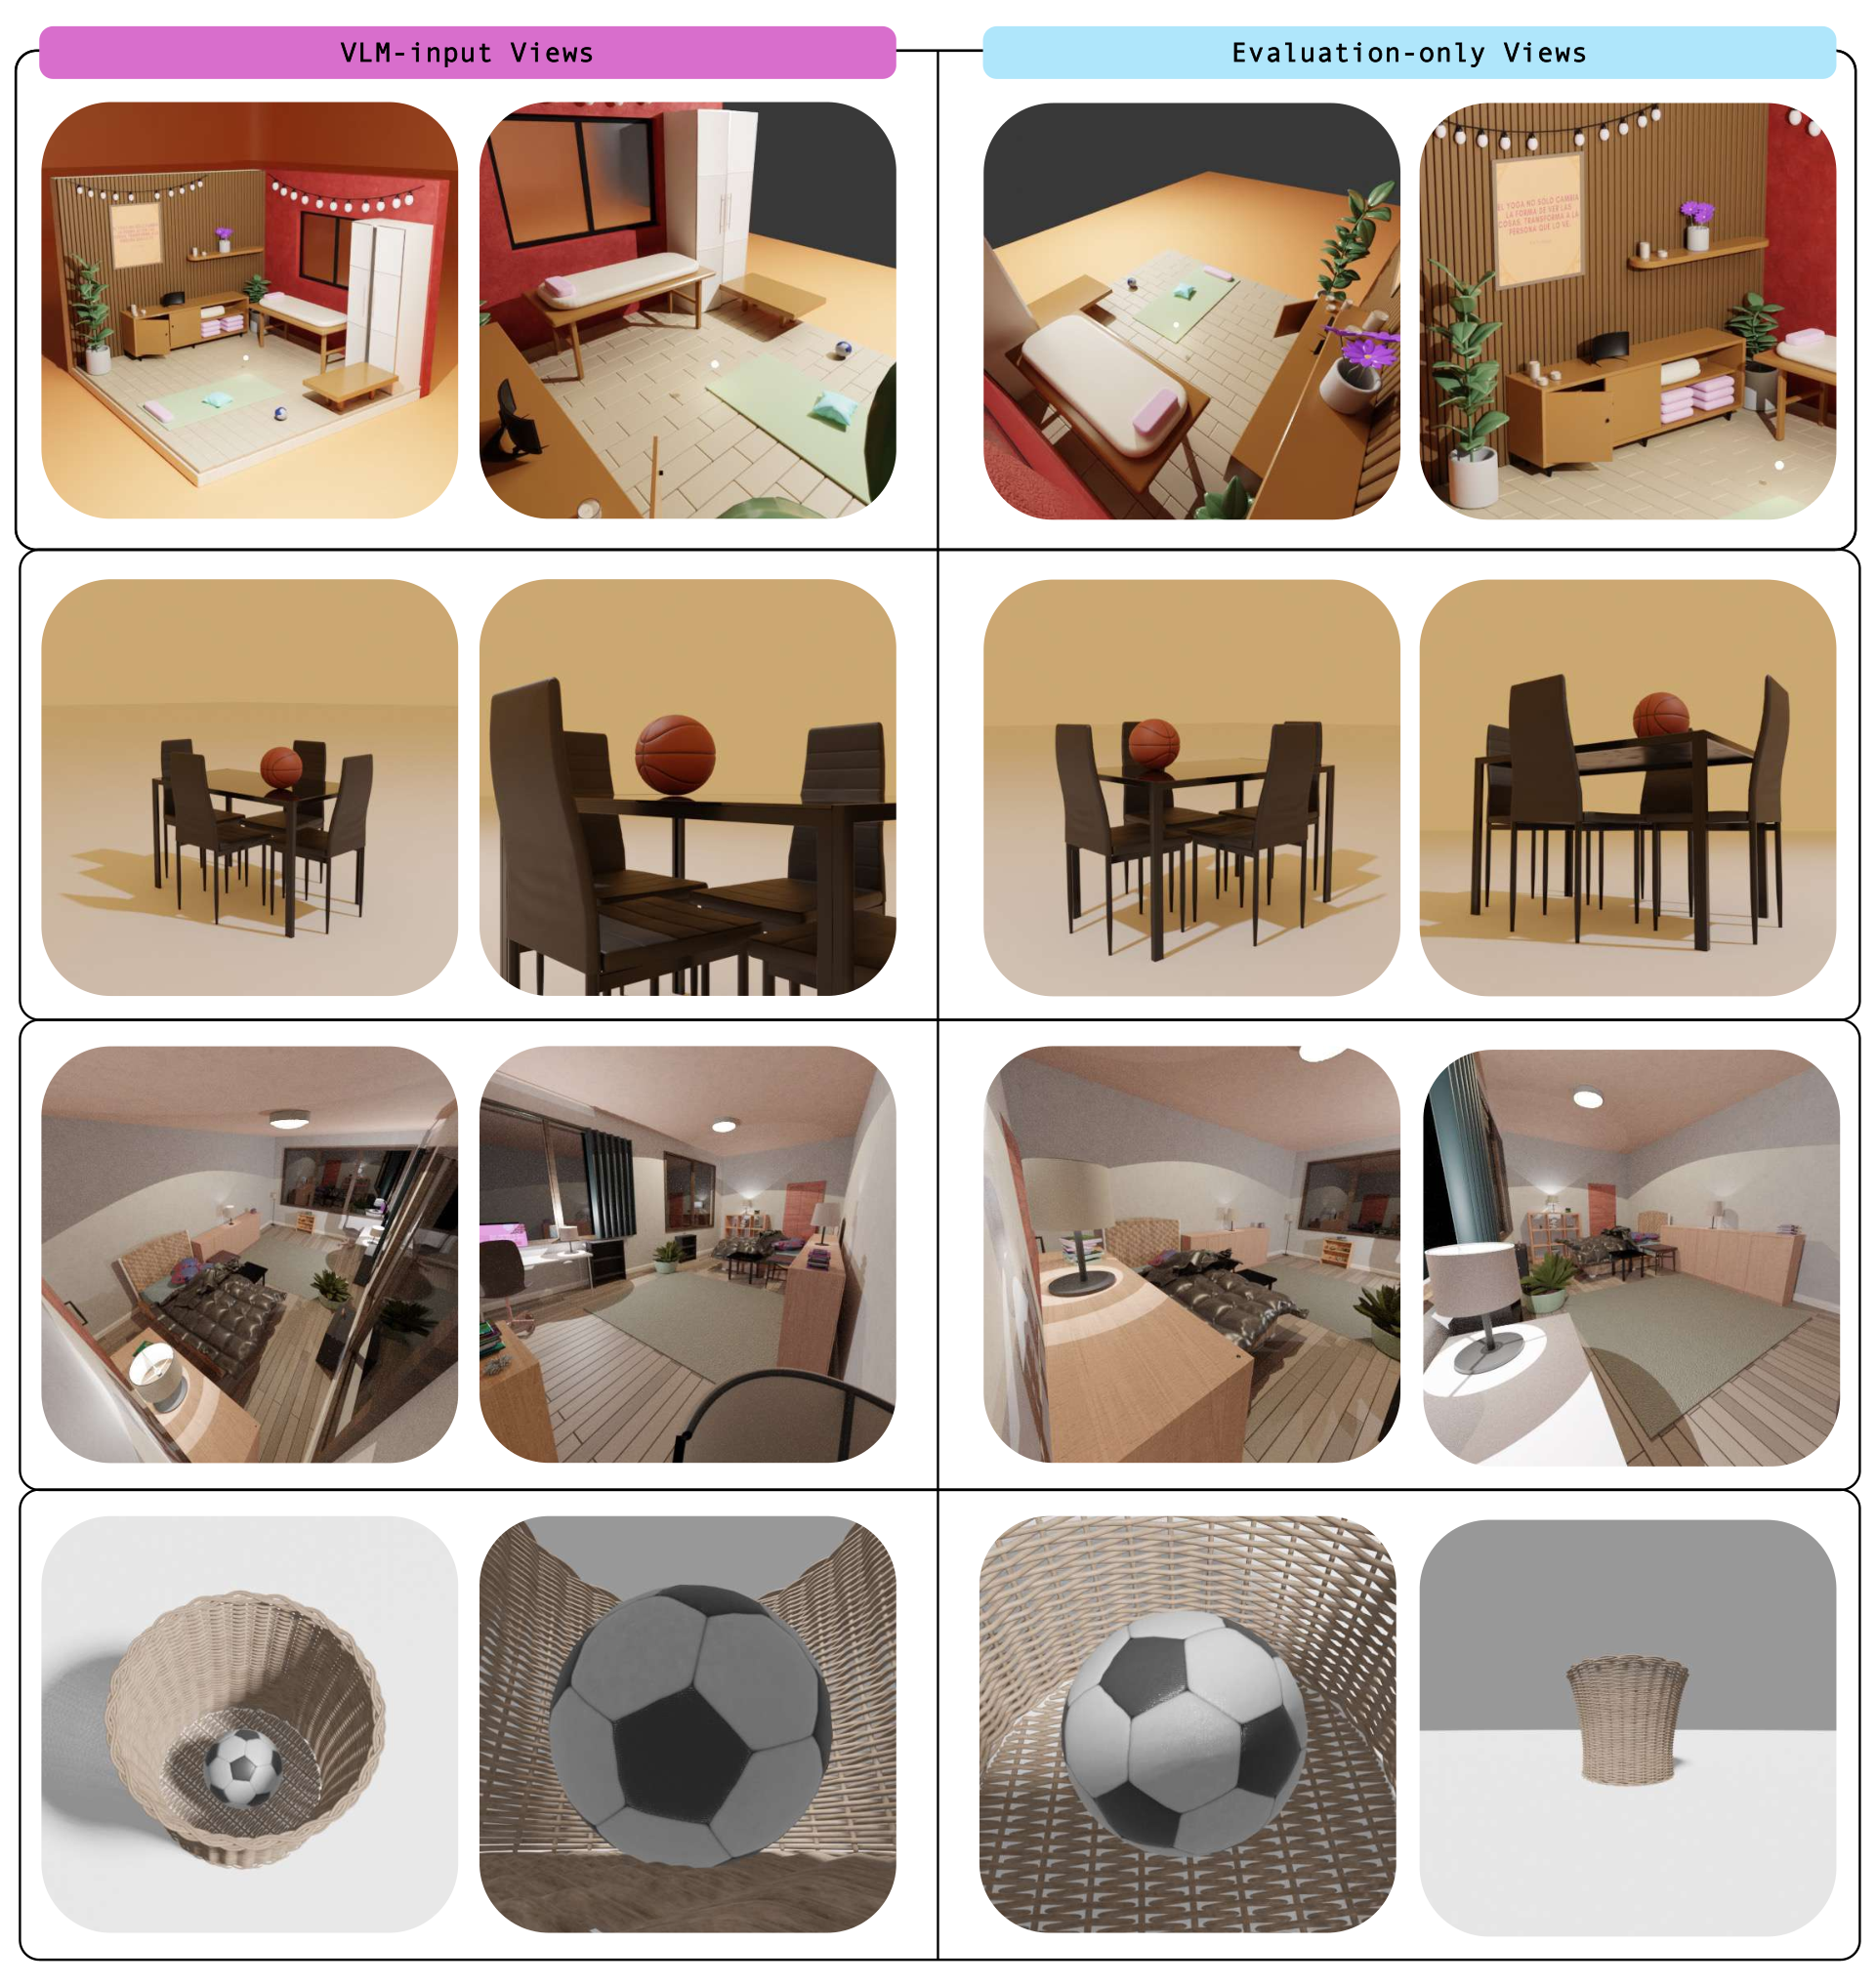
3D 相关任务至少固定三个视角。模型接收两个视角,至少一个是展示整体关系的 comprehensive view;最终评测使用全部视角。附录进一步要求所有关键对象至少在一个输入视角中出现,避免把“看不见的目标”变成不公平惩罚。额外评测视角用于检查三维一致性,而非单张图投机。[Appendix S5]
10 名普通 Blender 用户完成约 20% 的实例,每题最多 8 分钟,对齐论文模型系统的平均时间,并用相同指标测量。这里的“约 20%”不是全体任务的人类真值,也未完全消除熟练度、交互界面、样本选择和时间分布差异。稳健的新 benchmark 应公布确切样本 ID,在同一子集报告人和模型的配对比较。
Our Interpretation以下符号是为解释流程而统一引入的记号,不声称论文原文使用了同一套公式。
\(B\) 是基础 Blender 场景;\(S_0\) 是起始脚本;\(S_t\) 是第 \(t\) 轮保留的脚本;\(R\) 表示执行并渲染;\(c_v\) 是第 \(v\) 个相机及固定渲染条件;\(I^{\ast}\) 是目标渲染;\(\mathcal A\) 是整个编辑系统;\(C\) 是预算。生成对象是可执行脚本,不是扩散 latent 或直接输出的 RGB 图。
这是任务目标的概念表达:找一个有效脚本,使评测视角里的结果接近目标。实际 VLM 系统并不对这个目标反向传播,也不直接访问所有隐藏评测条件;它依赖看图、代码编辑和候选选择近似搜索。单张图的逆问题通常不唯一,因此恢复出另一份有效而视觉相符的程序也可能成功。
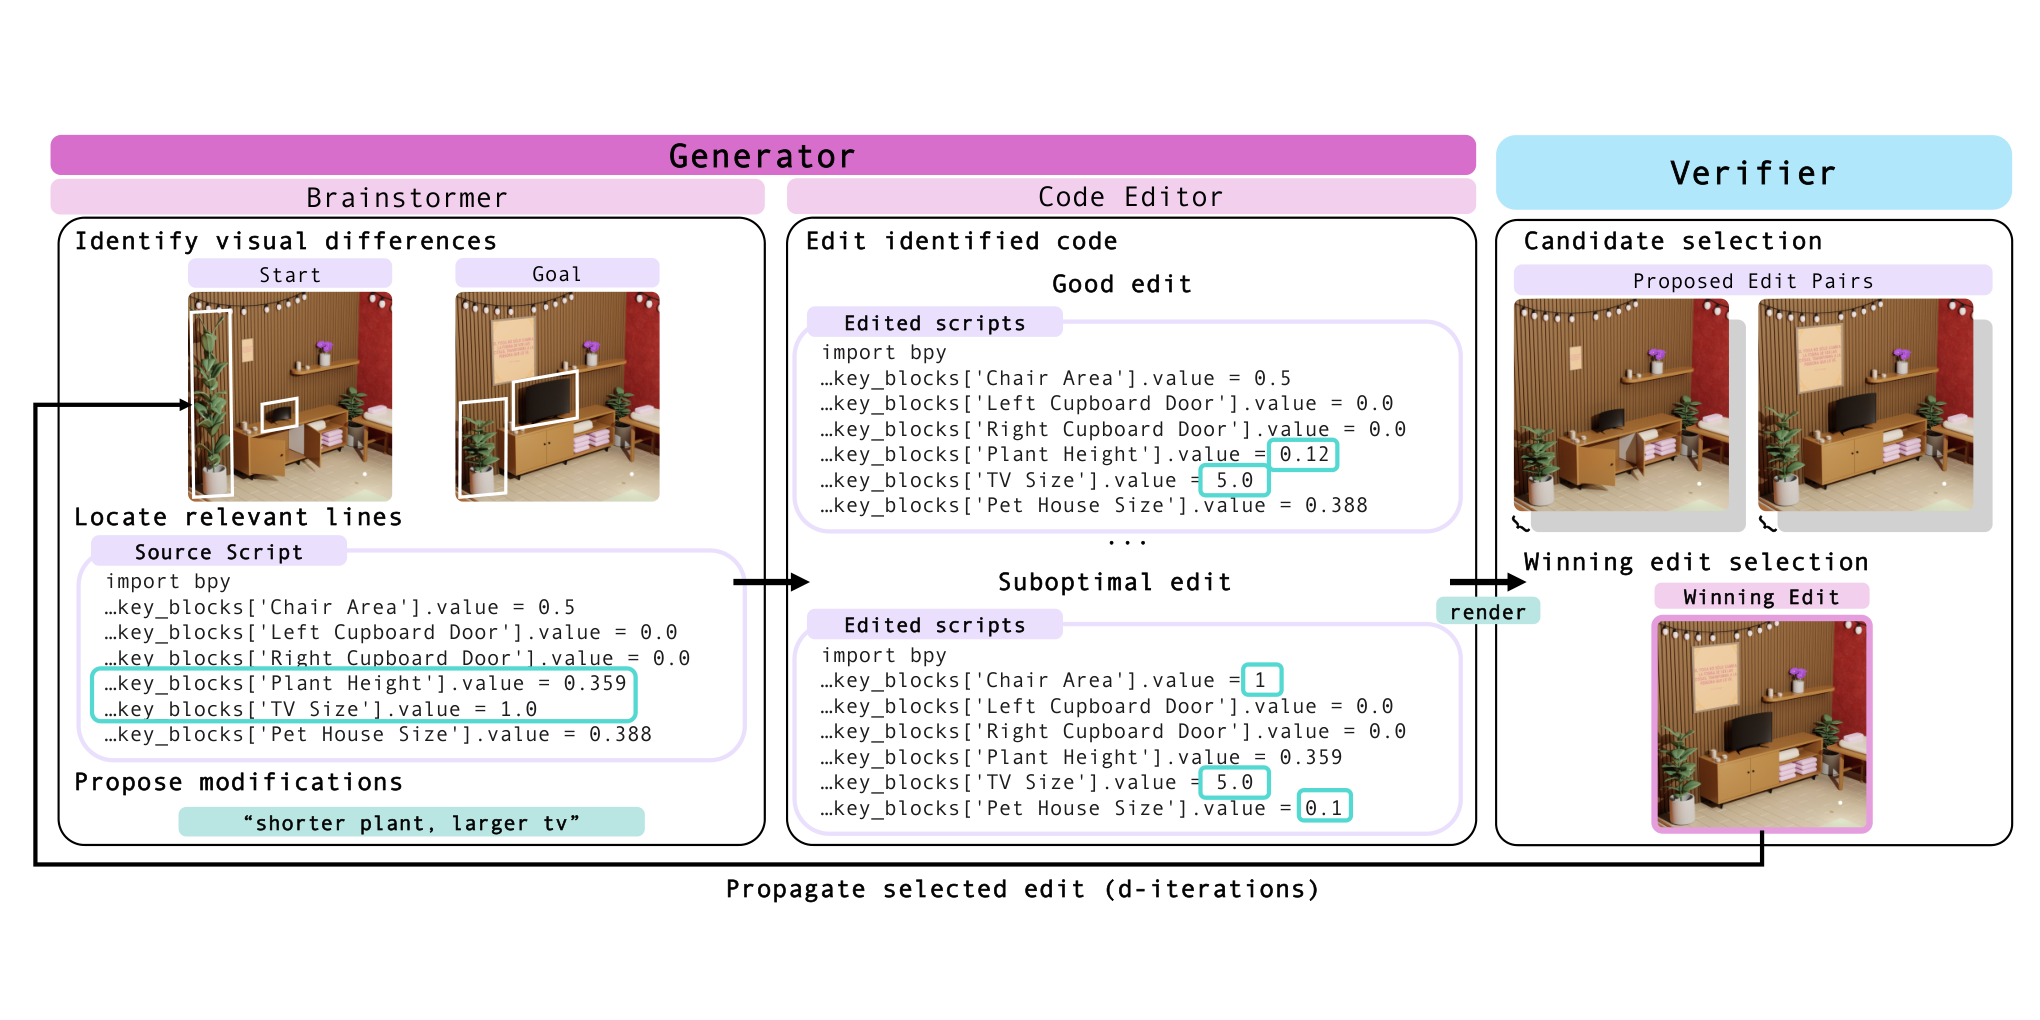
这是一棵每层只保留一个赢家的搜索过程,不是保留所有路径的完整 \(b^d\) 树。候选总数名义上为 \(db=12\),实际模型调用数还取决于 brainstorm、逐条 code edit、验证和失败处理。文中系统含多个角色,但这里是在解析论文,并未另外启动代理执行实验。[§4.1]
| 模板 | 输入与指令 | 输出约束 | 影响 |
|---|---|---|---|
| Figure 18 / leap | 起始代码+起点/目标拼图;指出主要差异和应修改的行 | 最多 5 条建议,每条关联少量代码 | 支持拓扑/结构修改,扩大搜索空间 |
| Figure 19 / tune | 先辨认唯一最明显差异,再寻找数值变量,再修改赋值 | 分步分析;最多 5 条建议 | 把视觉感知与参数映射分开 |
| Figure 20 / editor | 起始代码+一条修改建议 | 原片段/新片段,不重写整份代码 | 减少无关改动,但字符串替换依赖匹配 |
| Figure 21 / verifier | 目标图+左右候选拼图 | 代码块内选择 left 或 right | 容易产生位置偏置;选择不等于可靠评分 |
以上为中文释义,不是完整原始 prompt。原文完整模板见 PDF pp.20–22;不要把本页释义直接当成完全复现配置。论文并没有提供一套训练新模型的 system prompt/训练配方。
PL:当前官方实现取 RGB 前三通道并除以 255 后计算 MSE;\(H,W\) 为分辨率。它测像素误差,敏感于对齐、颜色和亮度;并非材质物理参数恢复准确率。实现尺寸不同时会调整第二张图的大小,因此 PMG 新协议应固定尺寸并显式拒绝尺寸不符,避免隐性预处理改变比较。[utils.py]
N-CLIP:\(f\) 为 CLIP 图像编码器。用于评测的公开 clip_similarity 加载 ViT-B/32,通过余弦相似度比较两张图;减一转换为越小越好。它是语义/整体视觉接近度,不能单独证明微观纹理、可平铺性和 PBR 行为正确。CLIP 在这里是冻结的度量模型,不是被训练的编辑器。
CD:上式给出常见对称平方 Chamfer 距离,说明如何比较两组几何采样点 \(P,Q\)。论文未充分说明点采样数、尺度归一化以及是否平方等实现细节,公开评测入口也尚未实现 CD;因此不能把此教学公式视为论文分数的已核实精确计算版本。
\(\mathcal C\) 是同一候选池;\(V\) 是两两选择器;\(k\) 为 reselection 次数。每次打乱顺序进行单淘汰,得到 \(k\) 个赢家,再对这份赢家列表单淘汰。它不是对字符串答案做多数投票,也没有训练新的 reward model。若每次比较消耗一次调用且不缓存,\(n\) 个候选的理论比较数为 \(k(n-1)+(k-1)=kn-1\)。重复赢家也可能增加调用;这个计数是算法分析而非对公开运行日志的测量。
固定 32 个候选,展示上述理想化调用计数;不是实验性能预测。
下表重建论文的全部 13 个系统配置及人类基线。粗体为各列最优模型,下划线为次优模型;人类单独作为参照,不参与模型排名。横向滚动查看全部任务。PL 与 N-CLIP:Blend Shape/Placement 列乘 \(10^{-3}\),其他任务列乘 \(10^{-2}\);CD 保留论文原尺度。不同任务的显示数值不能直接求平均。
| 系统 | Blend Shape | Placement | Geometry | Lighting | Material | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| PL ↓ | N-CLIP ↓ | CD ↓ | PL ↓ | N-CLIP ↓ | CD ↓ | PL ↓ | N-CLIP ↓ | CD ↓ | PL ↓ | N-CLIP ↓ | PL ↓ | N-CLIP ↓ | |
| GPT-4o | 9.140 | 20.47 | 0.904 | 11.89 | 30.38 | 11.22 | 6.747 | 8.561 | 1.192 | 2.410 | 2.398 | 3.653 | 8.942 |
| Claude-3.5-Sonnet | 12.79 | 27.96 | 1.962 | 13.19 | 51.76 | 11.29 | 10.81 | 13.04 | 1.452 | 2.897 | 4.049 | 5.769 | 11.44 |
| GPT-4-Turbo | 15.21 | 26.15 | 1.927 | 12.21 | 37.57 | 12.80 | 8.160 | 10.92 | 1.120 | 2.723 | 3.912 | 5.424 | 8.812 |
| Claude-3-Haiku | 13.62 | 29.72 | 2.563 | 14.78 | 44.10 | 12.13 | 10.15 | 12.51 | 1.362 | 3.712 | 4.824 | 5.960 | 11.61 |
| Gemini-1.5-flash | 23.18 | 30.47 | 2.412 | 10.94 | 45.34 | 8.324 | 9.443 | 10.49 | 1.323 | 3.514 | 5.688 | 6.364 | 10.42 |
| Qwen2-vl-7b | 16.78 | 29.22 | 2.123 | 15.31 | 41.12 | 14.21 | – | – | – | 2.985 | 2.225 | – | – |
| Qwen-Llama | 14.32 | 28.23 | 2.012 | 14.65 | 34.93 | 12.41 | 13.97 | 14.13 | 1.673 | 3.173 | 3.998 | – | – |
| Phi-3.5-vision | 12.51 | 24.14 | 2.012 | – | – | – | – | – | – | 3.127 | 6.012 | – | – |
| Phi-Llama | 12.13 | 24.77 | 1.826 | 14.61 | 35.61 | 12.61 | 9.818 | 11.92 | 1.471 | 3.621 | 6.895 | – | – |
| MiniCPM-V-2.6 | 13.86 | 29.92 | 1.997 | 11.99 | 31.69 | 12.62 | 7.127 | 8.542 | 1.229 | 3.829 | 6.124 | – | – |
| MiniCPM-Llama | 13.76 | 27.21 | 1.882 | 12.74 | 31.72 | 15.81 | 9.561 | 11.47 | 1.569 | 3.725 | 6.090 | 7.152 | 12.14 |
| InternVL2-8b | 12.69 | 29.09 | 1.920 | 14.71 | 35.92 | 17.22 | – | – | – | 3.920 | 6.825 | – | – |
| Intern-Llama | 11.80 | 23.83 | 1.861 | 16.15 | 37.23 | 18.22 | 13.70 | 14.44 | 1.578 | 3.825 | 6.152 | – | – |
| Human | 0.934 | 9.12 | 0.399 | 0.423 | 13.34 | 1.532 | 1.269 | 2.434 | 0.334 | 1.239 | 1.632 | 0.629 | 3.043 |
“—”沿用原文:该任务中超过 75% 实例无法生成任何可执行脚本,并不表示零误差。人类仅完成约 20% 的任务,表中差距不应当作全体样本配对统计的置信估计。来源:Table 1, p.5。
Material 的 PL:GPT-4o 为 3.653,人类为 0.629(均为表格缩放单位);模型误差约为人类的 5.81 倍。人类的数值低约 82.8%,但不是“成功率高 82.8%”。
Material 的 N-CLIP 最好模型是 GPT-4-Turbo:8.812,略低于 GPT-4o 的 8.942;PL 则 GPT-4o 更好。Lighting 中 Qwen2-VL 的 N-CLIP 为 2.225,低于 GPT-4o 的 2.398,但其 PL 更差。
把编辑器换成 Llama3.1-8B 后,一些开源组合能完成更多 Geometry 任务,但最终视觉距离不总是改善。可执行性与目标一致性是两条轴。
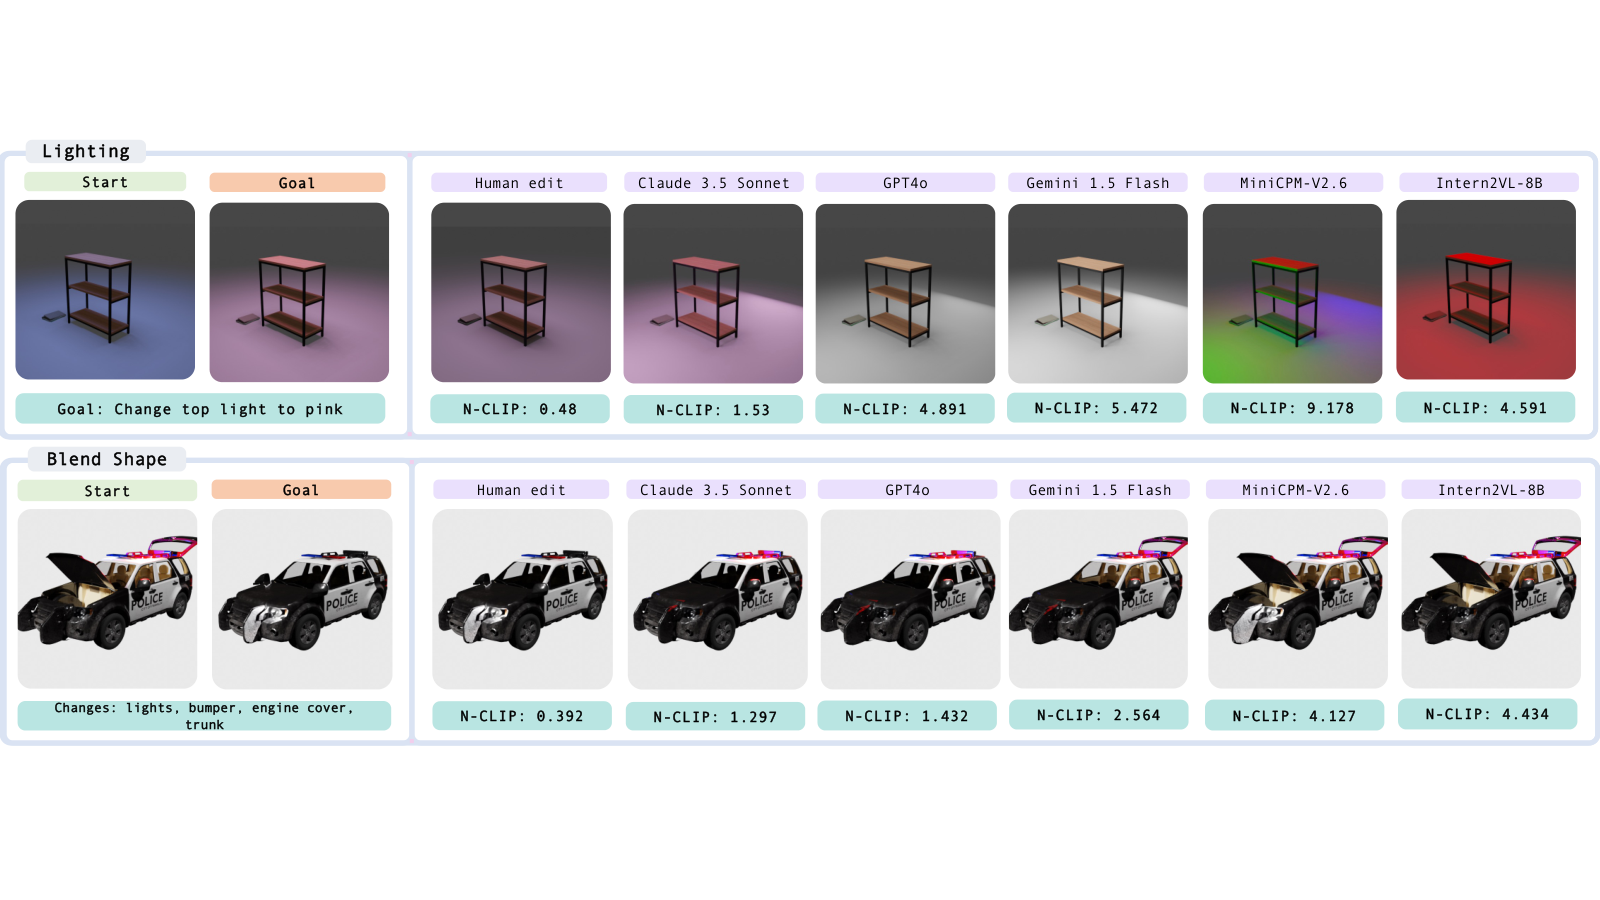
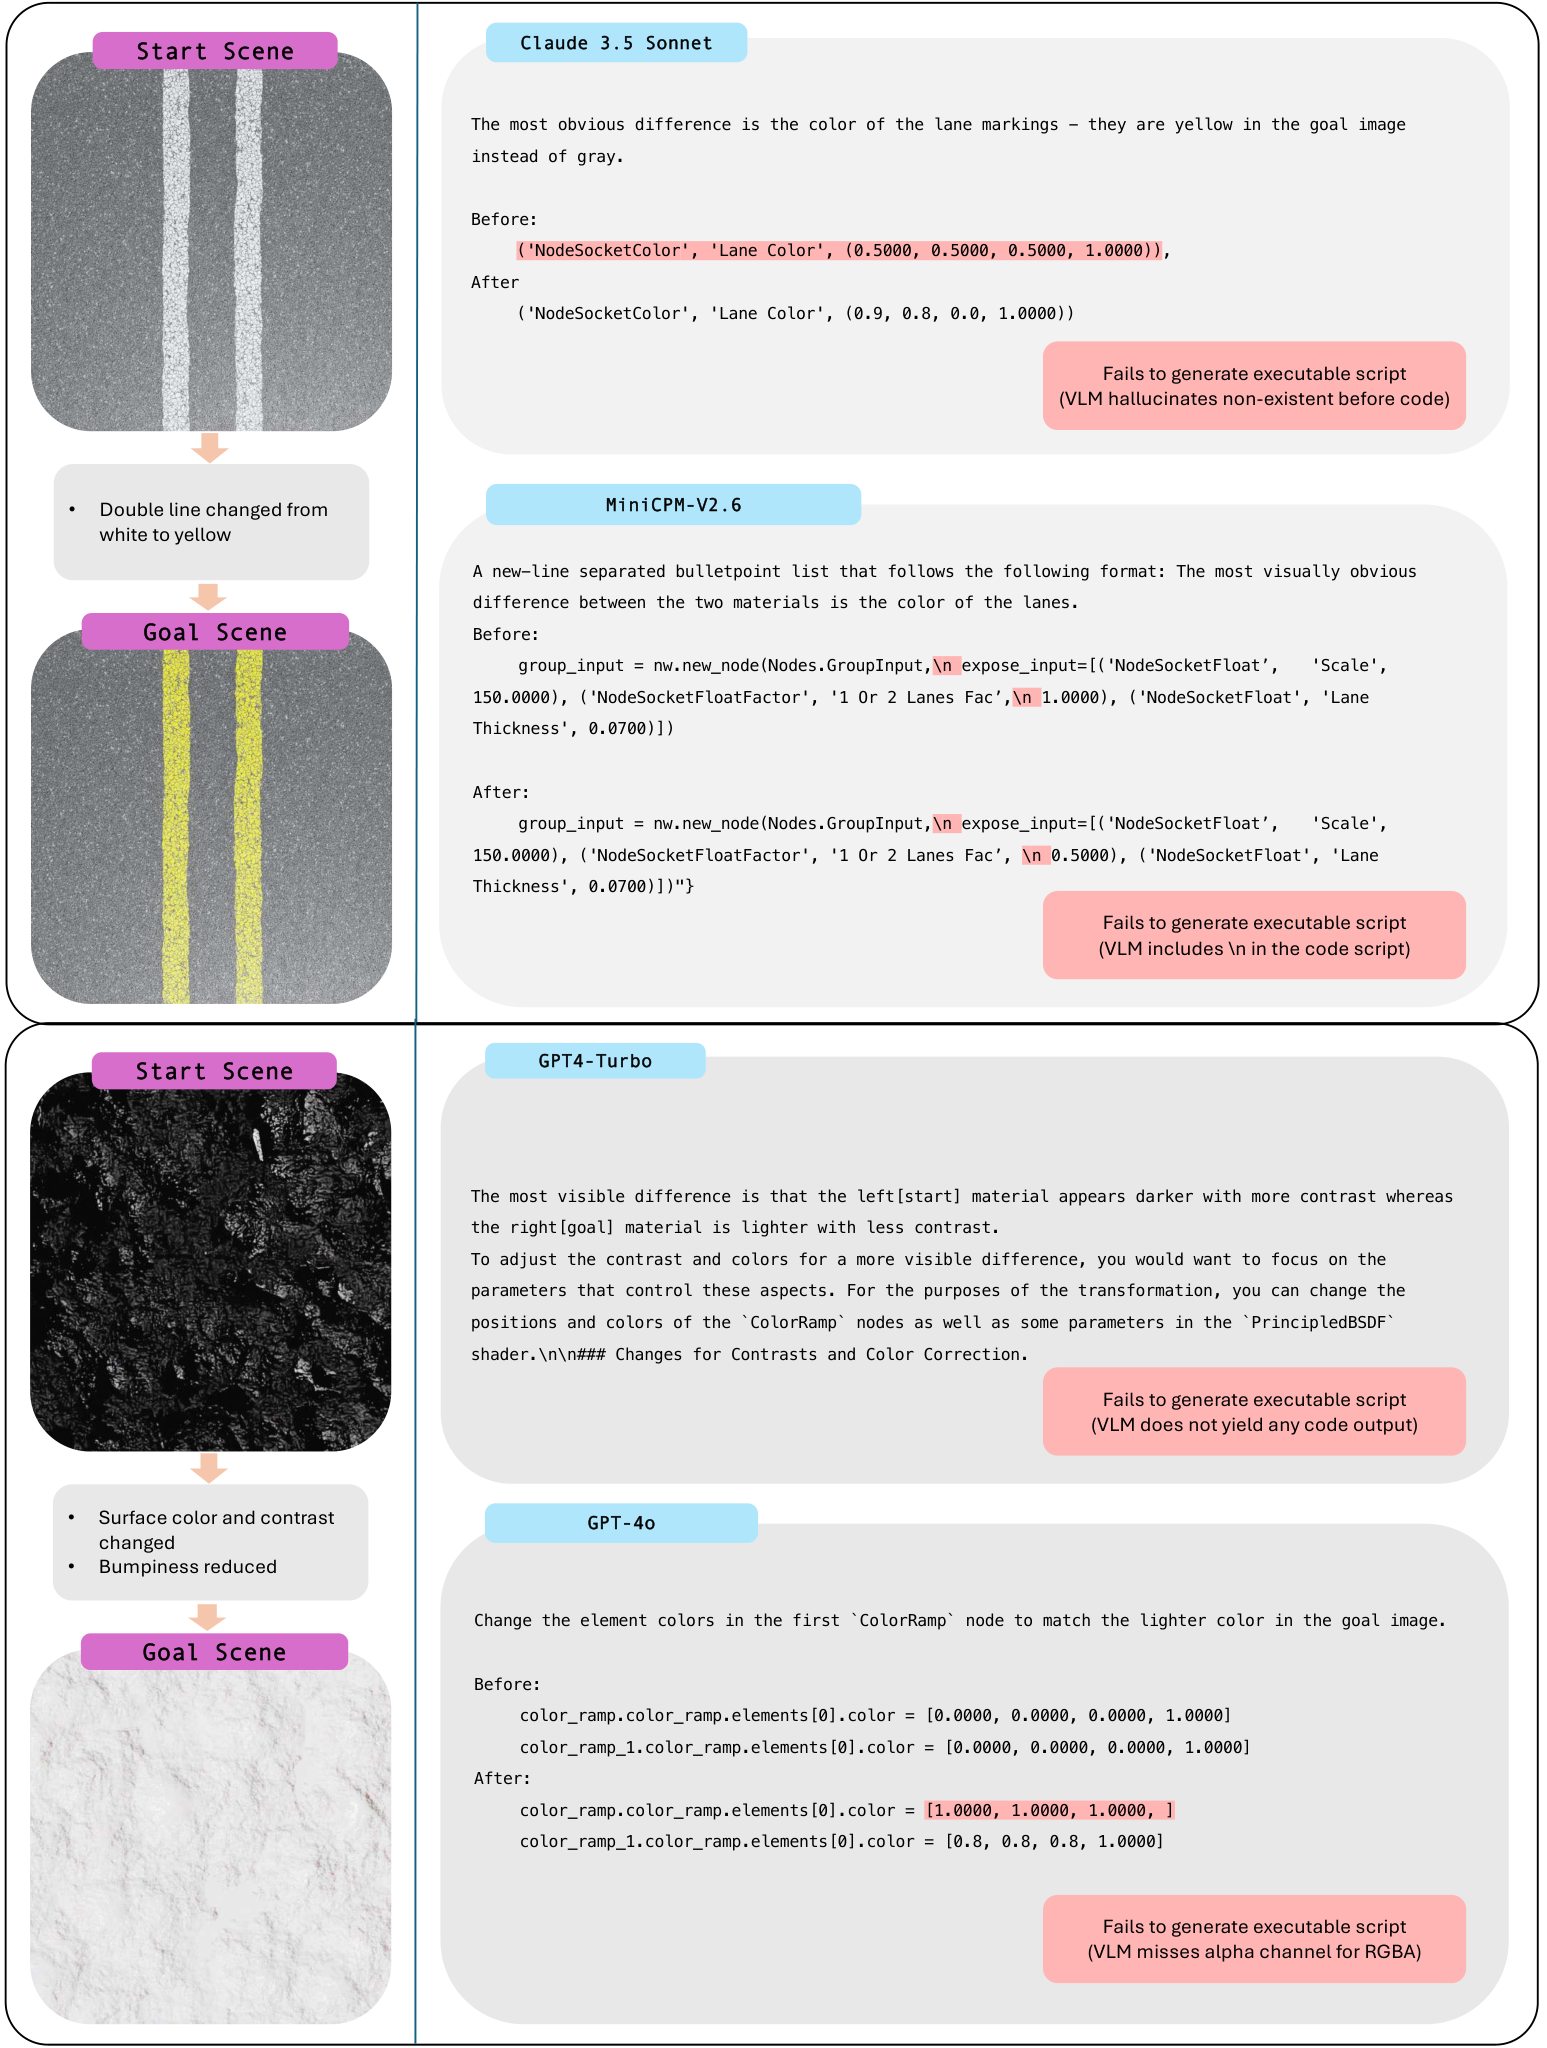
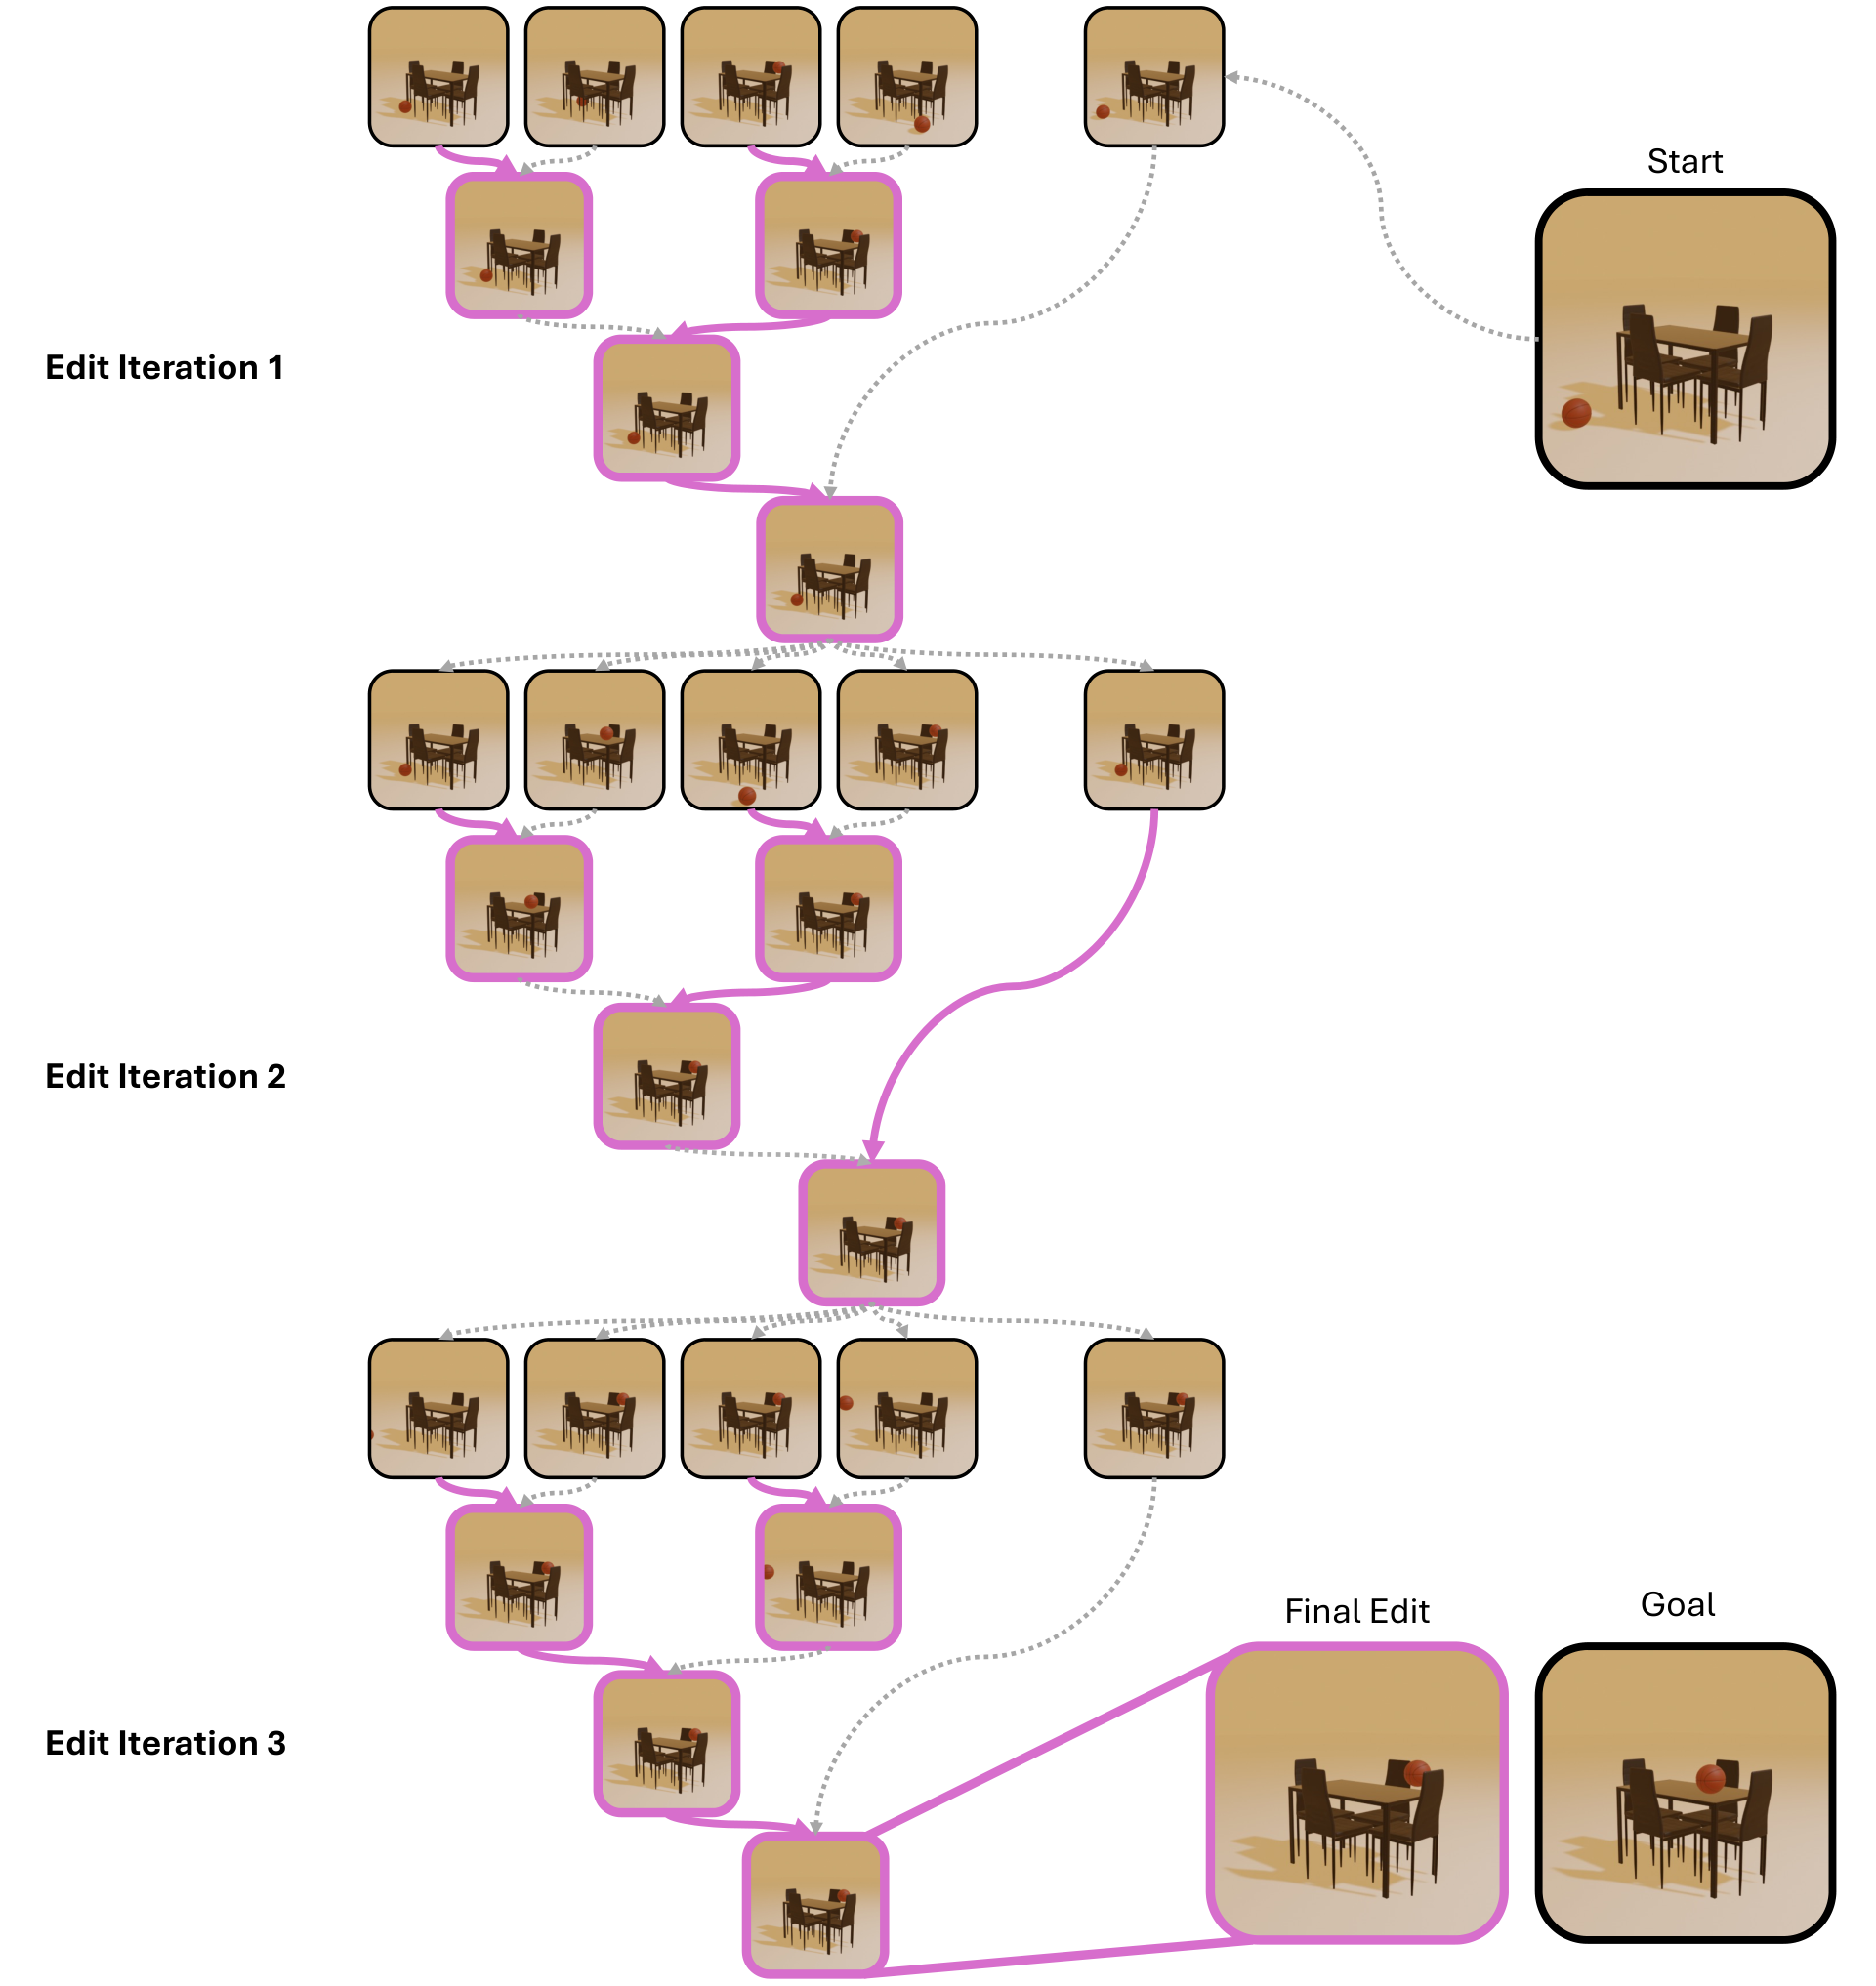
这些是定性案例,不是按四类错误完成的总体频率统计。一个 PMG benchmark 应当给每类失效预先定义标注准则,并报告分母。
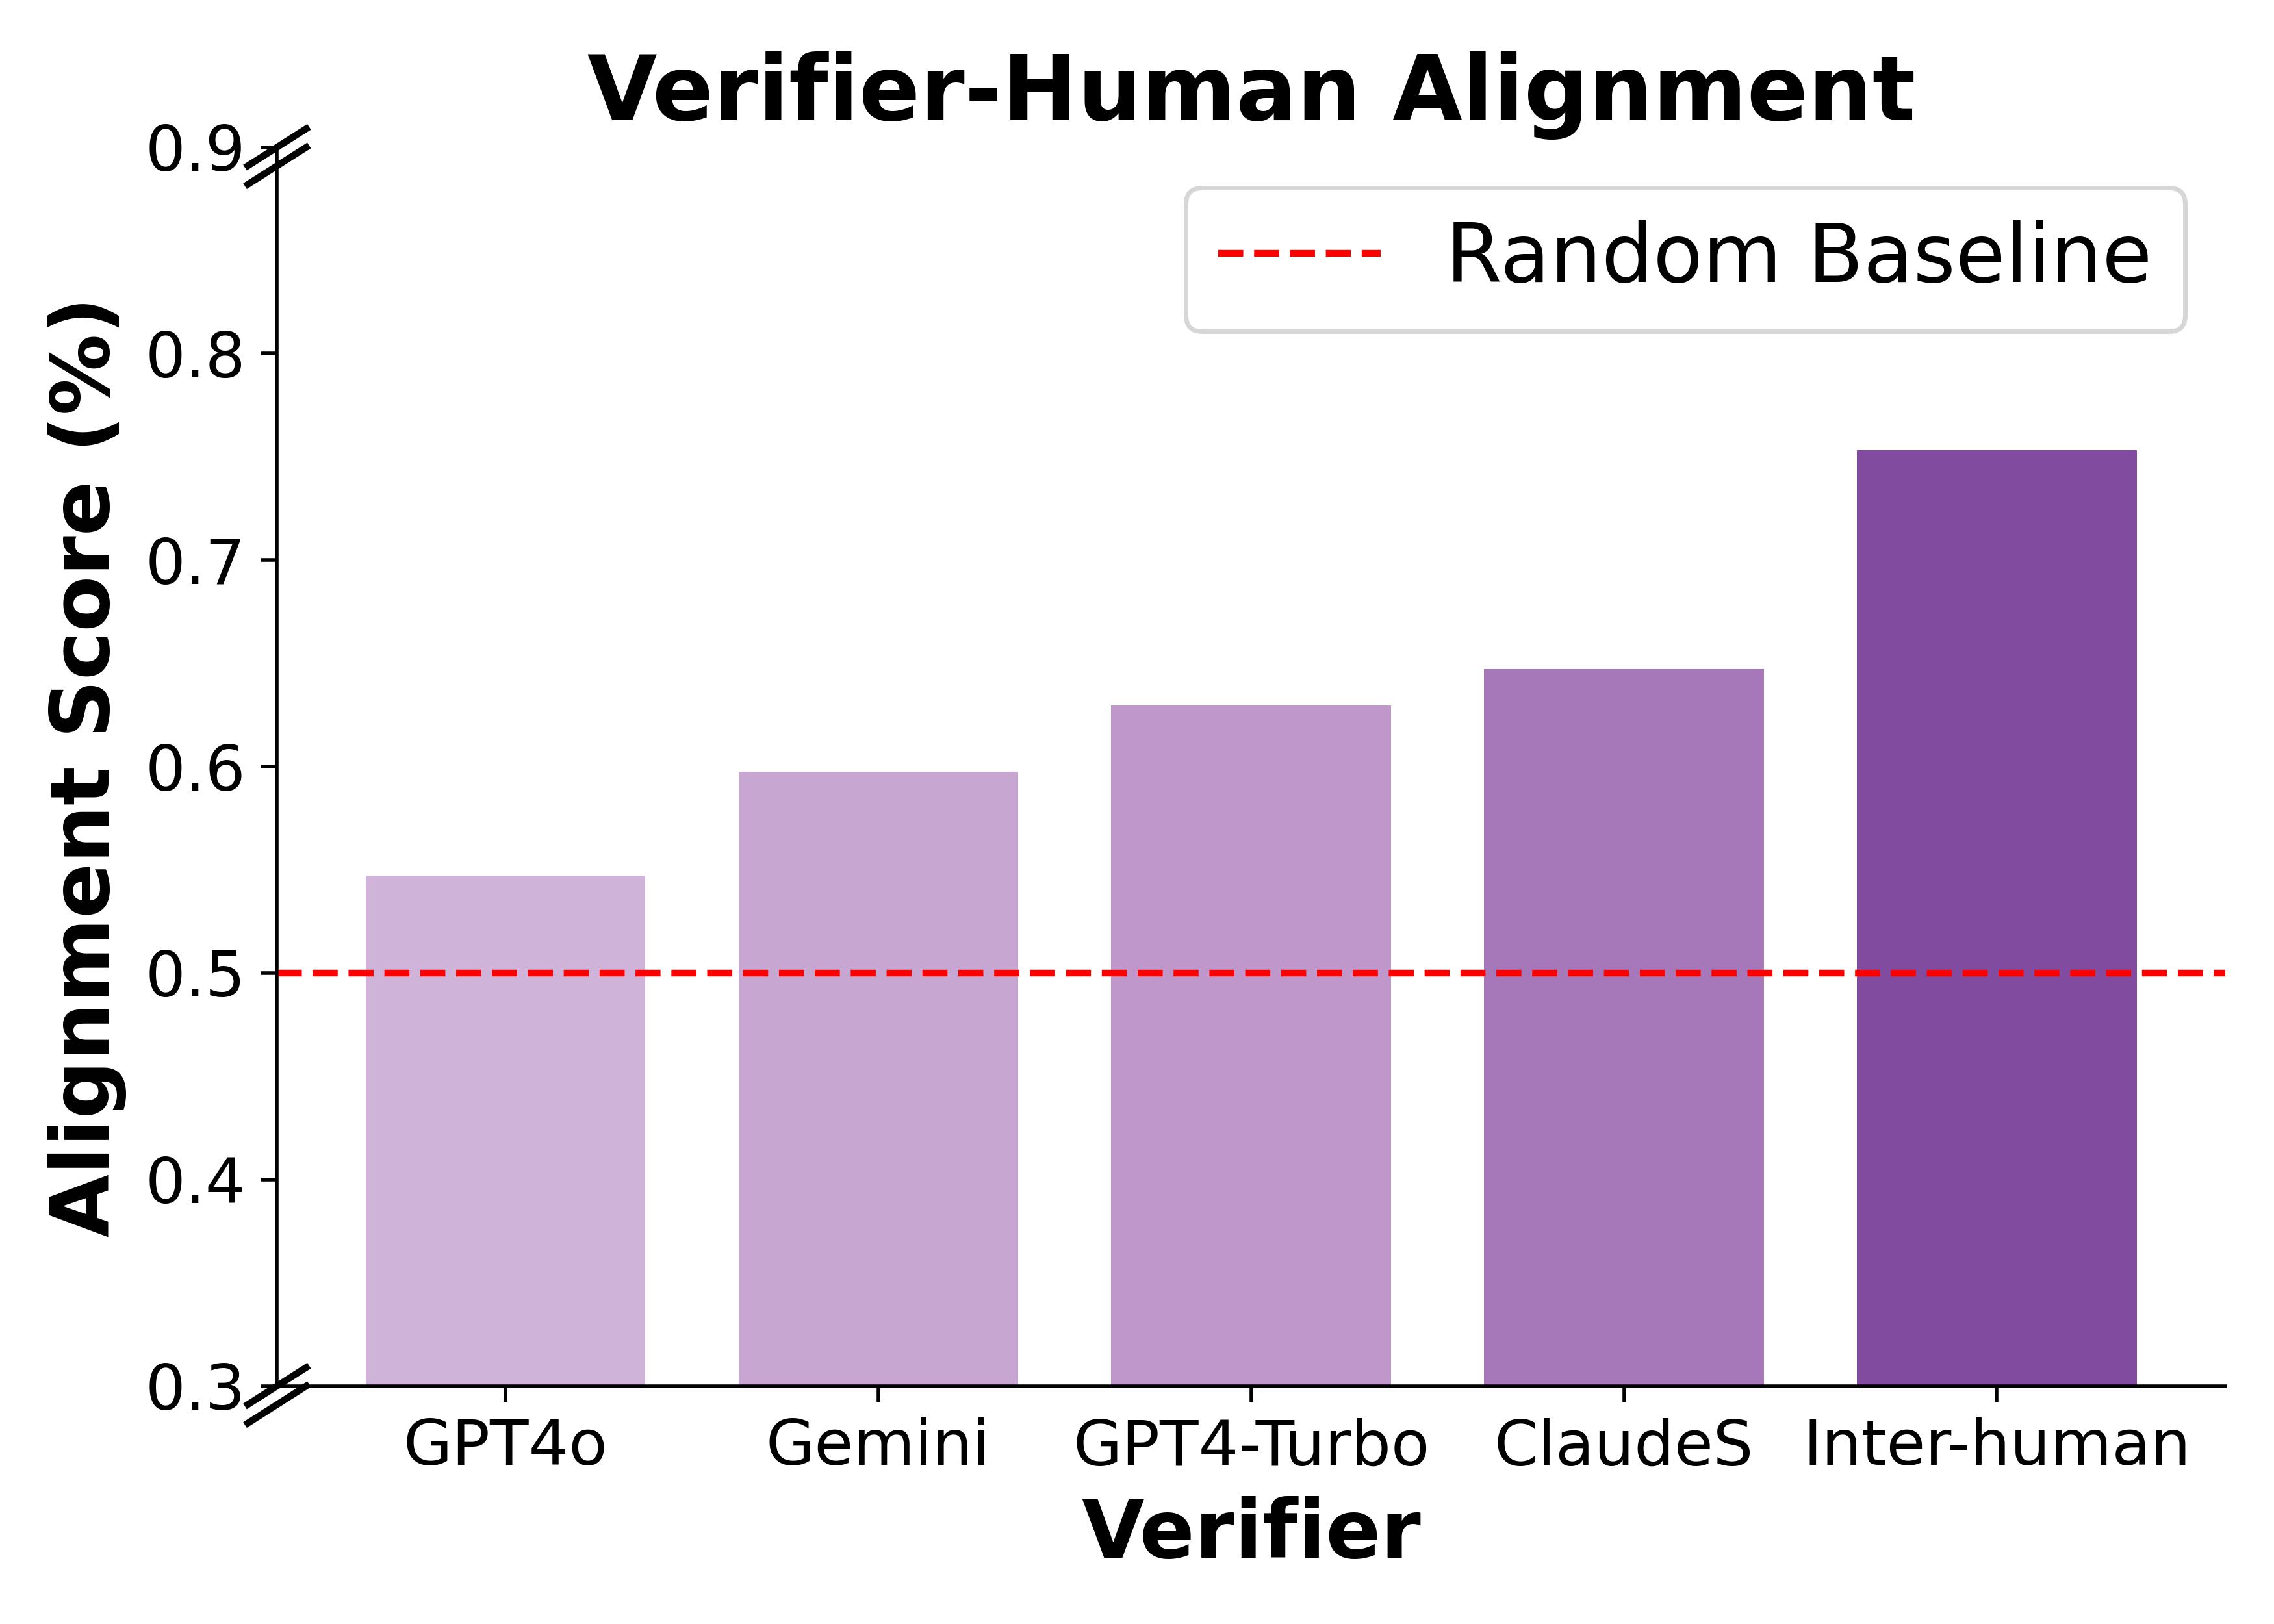
每类任务取一个实例,汇集模型推理中的成对选择;50 名参与者共提供 7,950 次判断。最一致的 Claude 3.5 Sonnet 与人类一致率约 0.66,低于人际一致率 0.79;各模型高于二选一随机基线 0.5。7,950 次判断不是 7,950 个独立场景,场景覆盖仍只有五个选定实例。[§4.2.2]
16 个 Blend Shape 实例,每题用 Claude 3.5 Sonnet 生成 4×8 树的 32 个候选,然后固定候选池;以 InternVL2-8B 做 verifier,令 \(k\in\{1,2,4,8,16,32,64\}\)。另报告较小规模 GPT-4o 和 Claude 扩展。这个设计有力之处在于:改进不是因为换了一批更好候选,而是因为选得更好。
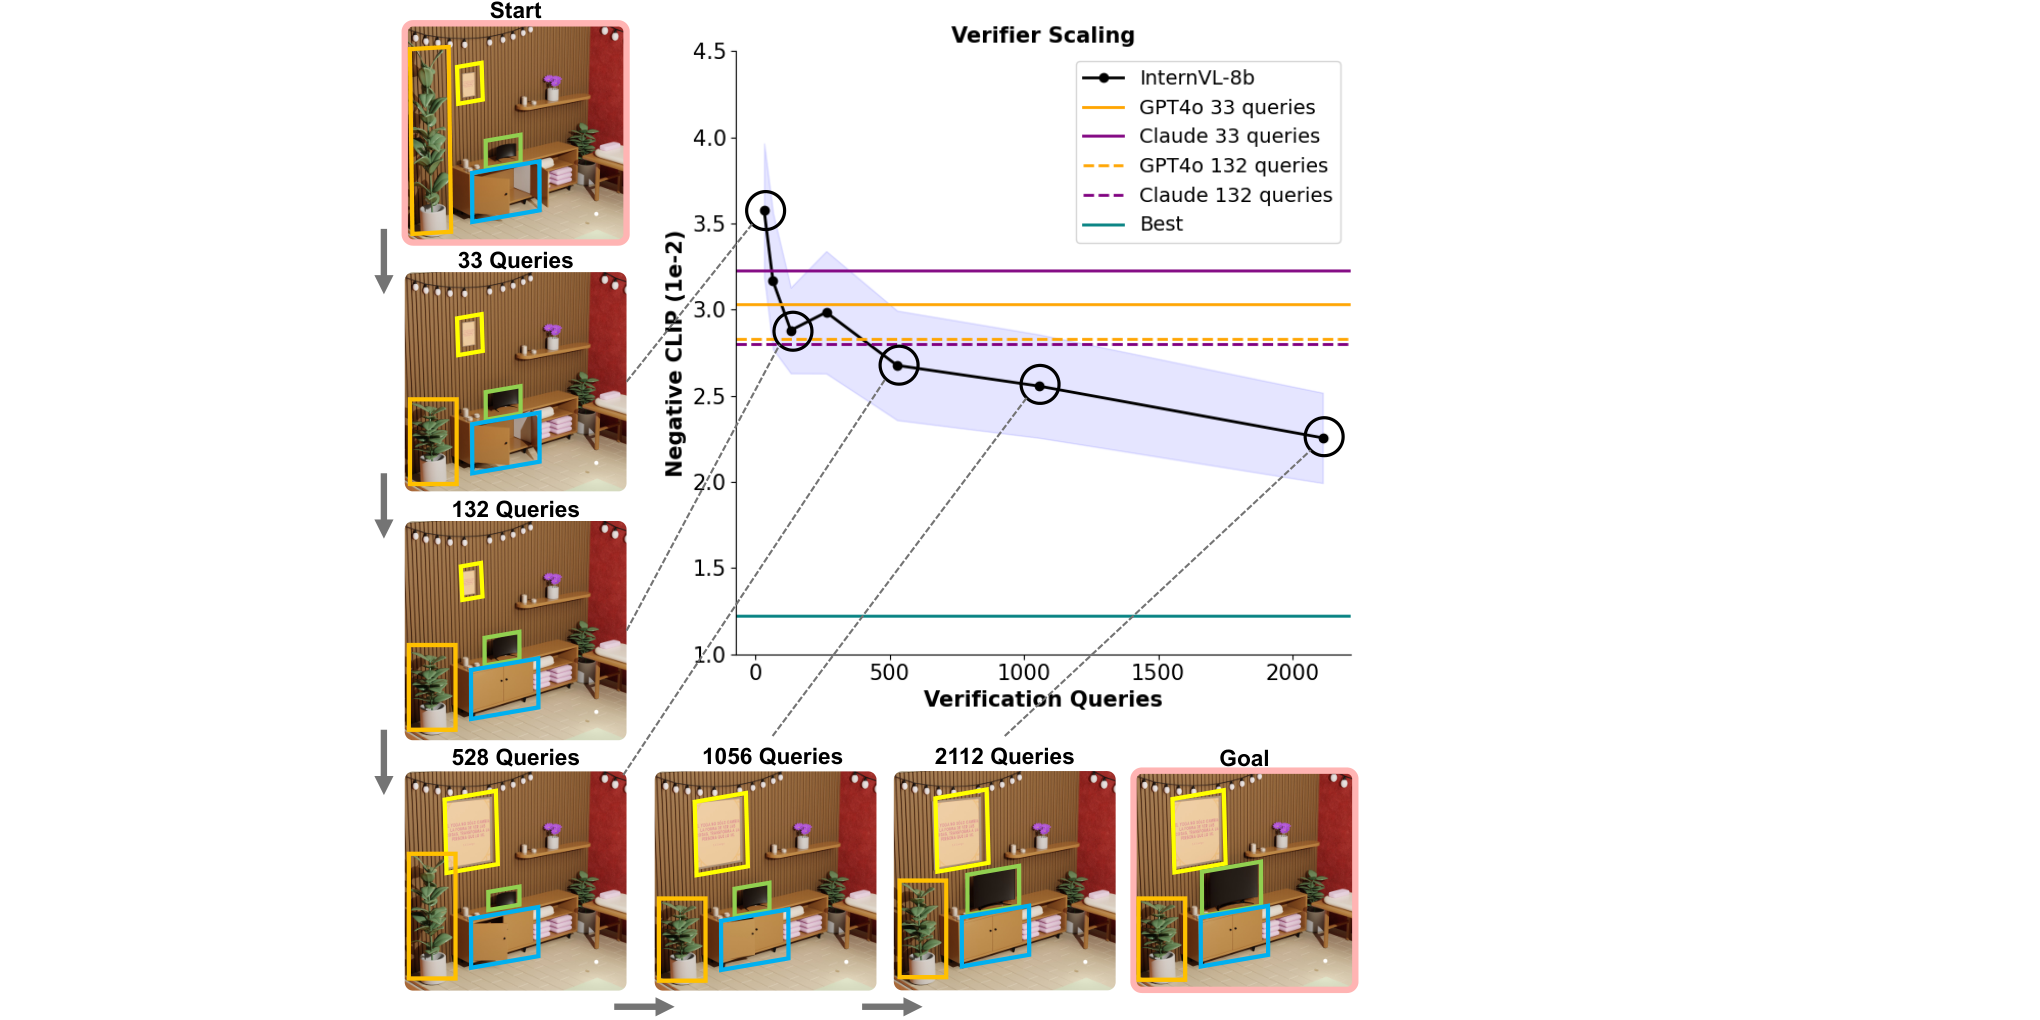
Paper Verified在这些实验里,扩大验证调用改善三种指标;扩展后的 InternVL2 可以超过未扩展或轻度扩展的闭源 verifier。Author Claim“验证扩展是普遍有效路径”则应视为待更广泛验证的推广,不能等同于开源完整编辑系统全面超过闭源系统。
使用 InternLlama,预算从 12 到 245 次查询;\(k=1,3,5\) 对应报告的 VeriRatio 约 0.33、0.62、0.73。与固定池实验不同,这里把重选放回每轮编辑闭环。测试 16 个 Blend Shape,附录扩展到 15 个 Lighting。
| VeriRatio | 少于 30 | 30–60 | 60–100 | 超过 100 |
|---|---|---|---|---|
| VeriRatio=0.33 | 1 | 2 | 3 | 3 |
| VeriRatio=0.62 | 2 | 1 | 1 | 2 |
| VeriRatio=0.73 | 3 | 3 | 2 | 1 |
Table 2,数值为性能名次,1 最好;列标题为总查询数。原论文的区间端点写法沿用为范围描述,不自行推断恰好 30/60/100 时的归属。
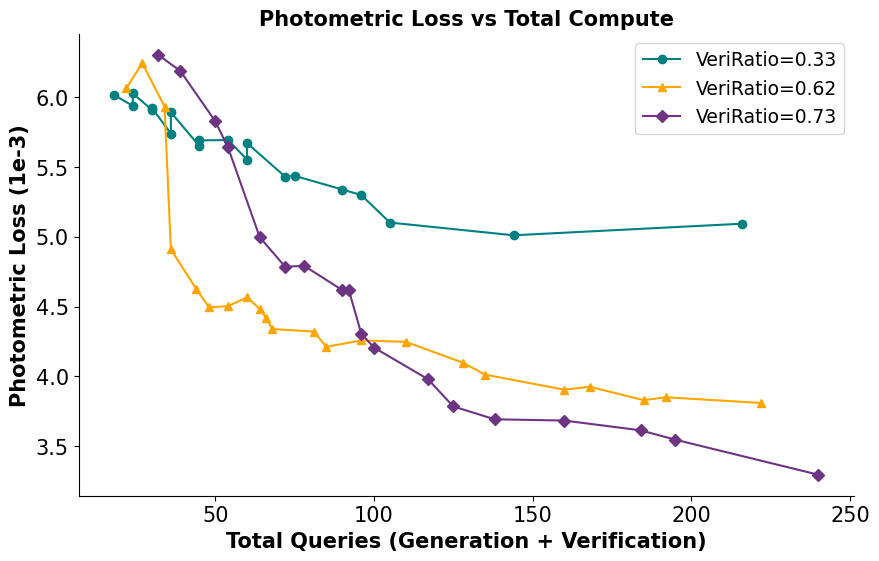
小于 30 次时 0.33 排第一;30–100 次区间 0.62 排第一;超过 100 次时 0.73 排第一。论文称实验中每 100 次生成/验证查询成本接近 0.45 美元,因而以查询数近似计算资源。这是论文当时特定系统下的成本假设,不是当前 API 价格,也不是所有模型的通用预算单位。
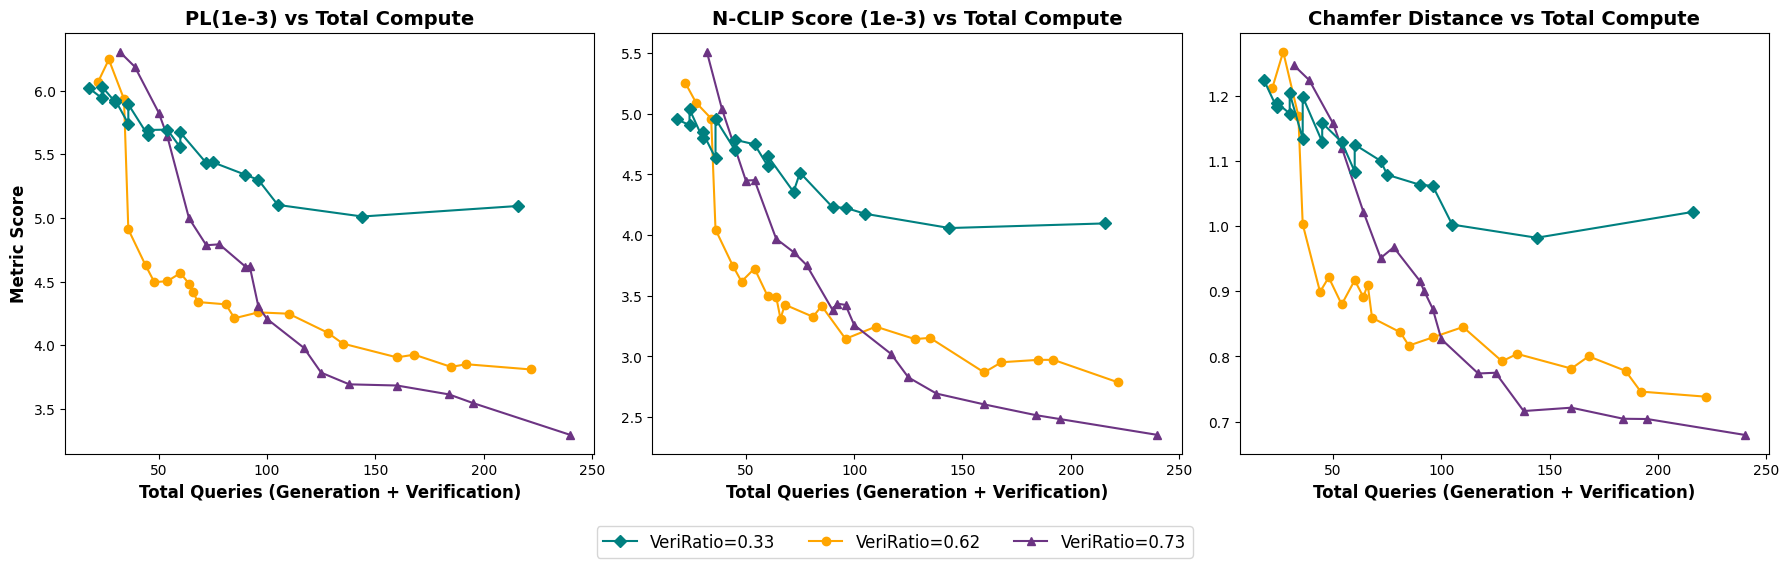
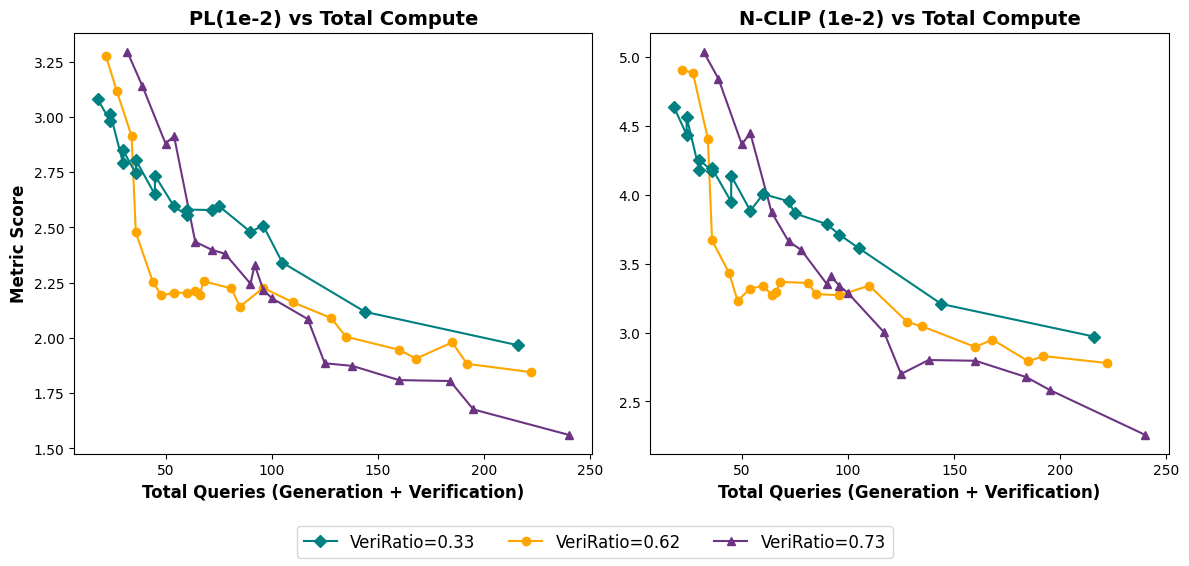
附录观察到 Lighting 上的分配差距较小,并解释为灯光差异更明显、验证较易。这是作者解释,未通过直接控制验证难度的干预实验建立因果关系。
本文具有 editor 替换、固定池的 \(k\) 扫描、同预算下的比例变化等系统分析,但没有完整隔离所有组件:例如并未给出覆盖全部任务的“去掉视觉/去掉执行反馈/只做参数优化/换候选顺序”的统一消融表。更换 Llama editor 同时改变模型组成;预算分配实验同时改变搜索配置。因此应准确写成受控比较和系统分析,不能夸大成所有设计选择的独立因果证明。
以下审计针对官方仓库快照 67c8b48bf8c548c701b6873db6fcc6527d756385。仅做静态阅读,不声称已经复现论文。[代码快照]
| 项目 | 已确认设置 | 复现边界 |
|---|---|---|
| 基础环境 | README 指定 Python 3.10;安装脚本下载数据并安装作者分支 Infinigen | 顶层安装脚本未冻结 torch 版本与 Infinigen commit;本次未审计所有递归依赖 |
| 系统结构 | 默认树为 3×4;generator/verifier 可指定;Llama 组合替换 code editor | 同一模型名的 API 别名可能漂移,模型日期需单独保存 |
| 训练 | 调用已有 VLM/LLM,没有论文提出的新训练过程 | 优化器、LR、epoch、训练 GPU 对本文方法不适用;不能虚构一套训练配置 |
| 推理采样 | 正文明确 depth、breadth 和重选 k | 正文/附录没有一张统一的 temperature、top-p、token 上限、重试、随机种子与精度表;API 封装须逐模型核对 |
| 评测 | 多视角平均 PL、N-CLIP;公开 CLIP 路径使用 ViT-B/32 | CD、失败分母和缓存行为需要额外审计 |
| 人类实验 | 10 人编辑约 20% 任务;50 人、7,950 次验证判断 | 人类一致率不是模型分数的校准函数,样本独立性与不确定性仍需报告 |
evaluation.py 的类别计数字典为 45,总和为 240。但该脚本实际遍历 metadata 中的实例,所以这个常量差异本身不足以证明真实只评了 240 项;必须核对数据压缩包和实际运行 manifest。--evaluator_type,但当前 inference.py 定义的是 --verifier_type;元数据默认目录是 info_saved,README 文段写作 infosaved。运行时应以快照参数解析器为准。直接证据:evaluation.py · inference.py · starter_setup.sh。这些是当前发布实现的发现,不是对作者未公开实验环境的推断。
先固定代码 commit、数据文件 hash、Blender/Infinigen 环境,再在一题上测试 API、渲染与指标;随后用明确任务清单运行推理,保存全部候选与选择;最后离线评测。以下命令根据当前 CLI 整理,本页未实际运行:
python inference.py --task placement --vlm_only \
  --generator_type [model_id] --verifier_type [model_id]
python evaluation.py --inference_metadata_saved_path [metadata.json]
正式复现仍需补足:精确数据版本、任务 ID、模型版本、温度/种子、实际 prompt、所有失败与重试、CD 实现、图像预处理、相机条件、渲染版本和运行成本。不要只复制榜单数字后宣称 reproduction。
Research Extension本节是面向我们的写作建议,不是 BlenderGym 作者给出的规范。一个强 benchmark 需要证明:测量对象重要 → 现有评价遗漏它 → 新协议确实测到它 → 比较公平且可复现 → 实验揭示有用结论。数据量和排行榜是证据的载体,不是全部贡献。
问题:现有 PMG 系统能否产出可执行、视觉匹配、能继续编辑的材质?交付任务集、运行器、输出协议、分维度排行榜和基线。
问题:现有自动指标/VLM judge 能否识别程序材质的实际好坏?交付候选材质池、受控缺陷、专家偏好、多条件测试和指标可靠性分析。
建议定位:以 A 为主任务,以 B 作为评测可信度的核心证据。若资源有限,先完成 B 的诊断 pilot,证明单张图指标确实遗漏可编辑性/材质行为,再决定正式 A 的规模。不要同时承诺“最大数据集、全引擎、全任务、新指标、新生成模型”而没有充分验证。
| 论文部分 | 必须回答的问题 | 需要的可检查证据 | 容易被拒的写法 |
|---|---|---|---|
| Introduction | 现有评测把哪些不同能力混为一谈?为什么妨碍研究? | 同图不同程序质量的反例;明确目标用户与任务 | 只说该领域重要、没有统一 benchmark |
| Related work | 已有数据集/系统评测覆盖哪些轴? | 逐篇核实的任务、表示、输入、编辑、执行与隐藏测试对比 | 仅按模型年份罗列;未经完整检索声称 first |
| Task formulation | 系统能看到什么、必须输出什么、能调用什么? | 输入输出 schema、预算、资源限制、失败定义 | 只写“根据图生成材质” |
| Dataset | 数据来自哪里?相似模板是否跨 split? | 来源许可、family 划分、去重、难度标签、人工 QA | 随机划分参数变体后宣称泛化 |
| Evaluation protocol | 分数是否测到承诺的能力? | 真实执行、隐藏条件、指标校准、失败分母 | 仅一张 CLIP/LPIPS 表;评测器自己证明自己 |
| Experimental setup | 是否在相同信息和成本下比较? | 版本、prompt、adapter、预算、缓存与种子清单 | 新方法多渲染几十次,baseline 仅一次 |
| Main results | 谁在哪种能力上好,代价是什么? | 分任务/分域结果、区间、质量—成本曲线 | 单一总分掩盖失败与 trade-off |
| Analysis | 这个 benchmark 带来了什么新认识? | 固定候选池、预算分配、失败分解、指标失效实验 | 展示几张精选图便宣布机制正确 |
| Limitations / release | 哪些结论不能推出?别人能否复测? | 数据卡、运行环境、隐藏评测治理与版本策略 | 承诺开源却缺评测依赖与样本清单 |
写作时可以围绕三项贡献,但必须等相应证据完成后再改为完成时态:
Figure 1:单视图看起来一样,但换光照/改参数后差异巨大,说明新测量对象必要。Figure 2:输入、程序、真实执行、隐藏测试和隔离边界。Table 1:已有评测覆盖矩阵。Table 2:数据规模/划分/难度。Table 3:主结果和失败率。Figure 3:质量—成本 Pareto 曲线。Figure 4:自动指标与专家一致性及受控反例。Table 4:消融和诊断。附录放完整配置、提示、逐类结果、置信区间和失败案例,而非把核心协议藏进附录。
如果换一个更强模型,这个 benchmark 是否仍有价值?如果只改颜色/检索最近邻就能高分,它真的测了程序生成吗?如果人类专家不认同分数,为什么这个排序可信?如果没有参考图拓扑,是否仍能评测?我们的协议需要逐一回答。
Research Extension这里将 PMG 解释为 Procedural Material Generation。以下是待实施的研究设计,不是已有实验结果,也没有修改当前 PMG 数据/训练流程。建议第一版聚焦 Substance 程序材质与固定节点库;Blender shader 或其他语言通过独立赛道接入,不能未经验证就声称等价转换。
\(V\) 为节点集合;\(E\) 是端口连接;\(\theta\) 是内部参数;\(\phi\) 是公开可编辑控制;\(s\) 是随机种子;\(r\) 是输出分辨率;\(M\) 是材质通道集合;\(c\) 包含几何、相机、光照和色彩管理。需要分别确认 Base Color、Roughness、Normal、Height、Metallic 等适用通道,不能把一张烘焙带光照的 RGB 图当作所有任务的合格 PBR 输出。
不以图拓扑完全一致作为主分数。同一种材质可以用不同图实现,原始 graph edit distance 或参数 L2 容易惩罚有效等价解。只有已知对应节点/参数的受控编辑子任务才适用结构恢复指标。主评测以执行结果、条件泛化和可操作行为为中心。
| 赛道 | 输入 → 输出 | 主问题 | 建议评测 |
|---|---|---|---|
| T1 图像 → 程序材质 | 参考图+约定渲染元信息 → 可编辑图与依赖 | 能否重建外观并真实执行? | 有效率、隐藏条件外观、成本 |
| T2 文本 → 程序材质 | 属性/关系描述 → 程序 | 是否满足语义约束而不靠图像真值? | 约束满足、盲评、可执行性;不对任意单一真值算像素误差 |
| T3 材质编辑 | 起始图+局部目标 → 修改后图 | 只改要求的属性,保留其余内容? | 目标变化成功、非目标保持、编辑后重执行 |
| T4 程序修复(扩展) | 损坏图+执行错误 → 可运行图 | 能否修复连接/参数/依赖且保留外观? | 修复率、变化副作用、调用数 |
| T5 评测器诊断 | 固定材质候选对+目标/编辑要求 → 排序或评分 | 指标/judge 能否识别真实缺陷? | 专家一致率、受控缺陷灵敏度、排序稳定性 |
优先级建议:首版把 T1+T3 做扎实,T5 为评测有效性证据;T2、T4 留为扩展。T1 与 T3 在“从空白生成”和“给定图修改”上信息量不同,必须分榜;不能让编辑任务的高分掩盖生成失败。
建立严格程序赛道和混合资源赛道。前者禁止目标图嵌入、未批准 Bitmap、外部纹理及模型自行下载资产;白名单库节点允许,但需要递归检查子图依赖。后者允许声明的纹理与检索库,另报资源来源、存储和依赖成本。Pixel Processor/FX-Map/子图是否允许应按研究问题预先固定;它们不是天然作弊,也不能在某个模型失败后临时改变规则。
每个输出都要能从干净环境独立编译、渲染和重建;检查图的可达依赖,防止把图像藏在子图、常量数组或缓存里。独立重建像素一致只能证明可复现,不代表与参考图相似。
对有真实程序真值的合成域,公开一种输入条件,隐藏其余几何/光照/尺度。例如平面、球体与曲面,柔和照明、侧光与环境光,以及固定空间尺度。所有方法用同一色彩管理、曝光、法线约定、位移约定和渲染器版本。隐藏条件要区分材质不确定性与模型失败:单张无标定输入不能唯一确定 roughness/height,因此需额外设置“带多光照或通道观测”的可识别子集;对单图赛道,只能解释为预测与合成真值的偏离,而非唯一正确材质的缺失。
进一步改变 seed 和输出分辨率,检查无缝平铺、频率保持和图的泛化;但本来不要求可平铺的真实表面不能因接缝得低分。隐含要求必须变成任务标签。
| 维度 | 可操作定义 | 主要限制/补救 |
|---|---|---|
| Execution | Parse → Compile → Render → 必需通道 → 依赖可移植;逐层成功率 | 每个分母均公布;基础设施故障和模型失败分开 |
| Visual fidelity | 同条件多视图 LPIPS、SSIM、RGB 误差;语义特征相似度作补充 | 固定实现版本与预处理;不能只用 CLIP 总分 |
| Material behavior | 隐藏光照/几何下的真值比较;适用时做通道误差与法线角误差 | 仅有真值与统一约定的域可用;真实照片单独处理 |
| Editability | 冻结图后接受预先定义的未见编辑请求,测目标属性变化与非目标保持 | 公开滑条数量不是可编辑性;不能只凭节点命名打分 |
| Procedural robustness | 新 seed、新分辨率、合法参数端点的成功率与变化一致性 | 按任务限定合理变化域,防止要求超出图的设计范围 |
| Complexity / portability | 可达展开节点数、依赖大小、编译/渲染时间、内存 | 只比较同库/同引擎;少节点不必然代表高质量 |
| Cost | 真实模型调用、输入/输出 token、渲染次数、墙钟时间、费用 | 硬件与缓存策略固定;失败重试也算成本 |
Our InterpretationLPIPS/SSIM 不是未经校准即可直接采用的标准答案。它们是候选视觉指标,需通过下节的专家和受控扰动实验确认是否符合我们的测量目标。项目若已有 SSIM 阈值,应当在独立 dev 校准后决定能否迁移,而不是机械沿用。
\(N\) 是冻结的全部任务数;\(v_i\) 表示该输出是否满足执行与资源规则;\(D_i\) 是固定条件下的视觉距离;\(\tau\) 只能从 dev 和专家可接受度校准,再冻结到 test。无效图使第二项为零,不应被删出分母。并列报告有效样本上的距离分布,避免以任意有限惩罚替代真实失败。
\(N_E\) 为所有编辑请求数;\(t_i\) 为目标属性达成程度;\(p_i\) 为非目标属性保持程度;具体估计器按属性单独设计。例如“砖缝变宽”可用目标 mask/边缘距离,“粗糙度增大”在可控光照下检测响应并用通道真值辅助;无法自动可靠验证的语义由盲评承担。不是每个属性都硬塞进同一个 CLIP 分数。
教学示例,非真实实验。系统 A 的有效率较低,但有效输出质量较高;试着改变有效率。
假定 A 的有效样本中 90% 达到视觉阈值,则全任务成功率为 45%。系统 B 固定为 90% 有效 × 70% 达标 = 63%。只报告成功样本的质量,会掩盖 A 的大量失败。
建议两种设置分开:Native control 只允许修改已暴露参数,检查图本身的控制能力;Assisted editing 用同一个冻结编辑器、同一预算编辑所有生成图,检查图在后续工作流中的可用性。后者仍受编辑器能力影响,需加入作者原图和直接生成的图对照。每个图从隐藏请求池抽取“仅改色调/粗糙度/元素密度/图案尺度”等请求,并验证不相关特征保持。
例如“扩大石砖但保持缝宽”同时测尺度控制与解耦程度;“改变种子但保持纹理类型”检查程序变化是否合理;“只提高粗糙度、不改变底色和结构”防止通过颜色变化伪造光照差异。所有请求要在冻结生成结果之后下发,防止系统只为已知编辑答案制作硬编码图。
构造固定候选池,包括真实模型输出、专家材质、强检索基线与受控缺陷,控制每类缺陷的严重度。比较 PL、SSIM、LPIPS、特征距离、单图 VLM judge、多视图 judge、执行感知 judge;最后一类可作为研究方法,但必须在独立 family 与未参与校准的模型输出上测试。
| 受控对照 | 期望测出的区别 | 为什么单图评价会漏掉 |
|---|---|---|
| 固定视图贴图伪装 vs. 程序材质 | 严格赛道依赖违规;换条件后行为差异 | 参考视图可完全相同 |
| 相似 Base Color、错误 Roughness/Normal | 多光照反射与表面细节差异 | 柔和正面光照下不明显 |
| 颜色正确、纹理尺度/方向错误 | 结构和频率敏感性 | 语义特征可能仍相似 |
| 单 tile 良好、边界不连续 | 平铺边界缺陷 | 单块显示掩盖接缝 |
| 漂亮但参数耦合 vs. 易于局部编辑 | 目标变化与非目标保持 | 静态图中不存在编辑行为信息 |
| 冗长但等价图 vs. 简洁图 | 效率、可维护性与视觉质量分离 | 视觉上应该平分,不应强行以外观罚复杂度 |
每个缺陷等级用相同基础资产生成成对对照,并检查“无关变化”的稳定性,例如候选左右翻转、等价图重排、仅更改名称。若指标在这些条件下大幅改变,应报告 judge 偏置。不要把嵌入评测器提示的自我声明当作质量证据。
给材质专家同时展示固定规范的多条件渲染和必要编辑演示,匿名随机排序、允许平局。分开问“目标相似”“材质行为”“可编辑性”,而不是单一“更好看”。建议 pilot 每对至少 3 名独立标注者,这是起步设计而非统计充分性的保证;通过人际一致率、分歧和预算估计正式样本量。
报告成对一致率(平局预先定义计分)、Spearman/Kendall 排序相关以及按 family 聚类 bootstrap 的 95% 区间。一个图的多视角、多个种子和多个用户判断不是独立材质样本。阈值、指标组合权重和 judge prompt 只能在 dev 调整;test 验证包括未参与校准的材质 family、生成模型和缺陷组合。比较主方法时采用同任务配对抽样,避免只比较两个均值。
| Baseline | 控制什么 | 公平性条件 |
|---|---|---|
| 起始图不修改/默认材质 | 任务是否被大面积不变背景稀释 | 同一目标、渲染与评测 mask |
| 合法库最近邻检索 | 相似模板是否已足以高分 | 公开检索库、禁止 test family 泄漏 |
| 检索+参数优化 | 是否真的需要拓扑生成 | 相同执行/渲染预算,固定优化器 |
| 仅参数优化(起始拓扑) | 编辑难度是否只来自数值拟合 | 只用于有起点的任务;不与空白生成混榜 |
| 单次 VLM 程序生成 | 没有执行反馈的基础能力 | 相同模型、节点文档和上下文 |
| VLM+执行错误反馈 | 修复语法/API 的收益 | 计入所有重试与失败成本 |
| VLM+渲染反馈+搜索 | 视觉闭环和候选选择的收益 | 固定预算梯度,区分 generator 与 verifier |
| 已有 PMG 专用系统 | 专业训练方法与通用代理的差异 | 只有表示/任务适配成功并通过真实执行的系统进入对应榜 |
| 专家/原始作者图 | 任务可解性与参考上界 | 同子集、明确时间与工具;原图不是可部署模型 |
| Oracle candidate selection | 生成池 vs. 选择器瓶颈 | 仅诊断,不作部署榜主结果 |
不要为了凑 baseline 数量给不兼容的方法做大幅私有改造,再将失败归咎于原论文。适配层本身需要验收;方法允许的输入、库与输出限制都要在表里公开。
若结果显示“单图排名与编辑/隐藏条件排名经常不一致”,它可能成为论文的主要发现;但在实际跑完并验证后才能写成结论。若没有出现预期差异,应报告负结果并调整贡献,不能反向挑选案例制造主张。
建议 pilot 配置(尚未实施):30 个独立 material family,15 个 dev、15 个封闭 pilot-test;每个 family 2 个 T1 目标和 2 个 T3 编辑请求,共 120 个任务。每类任务在 test 中只有 30 项,区间可能较宽,这个规模只用于验证协议和估计正式样本量,不应包装成覆盖完整行业的最终 benchmark。
先在小样本上完成三件事:所有真值可在干净环境编译渲染;检索+优化和至少两种生成系统可接入;专家确实能区分预设缺陷。随后用 family 间方差、配对效应大小和标注分歧决定正式扩展数量。正式测试应使用新封闭 family;已被反复查看的 pilot-test 需要降级为 dev,不能继续声称严格隐藏。
| 阶段 | 交付 | 进入下一阶段的条件 |
|---|---|---|
| 协议冻结 | 赛道、输入输出、节点库、资源规则、失败政策、数据卡 | 两名实现者按文档得到一致任务含义 |
| 运行器 pilot | 干净环境执行、完整通道、哈希、日志、超时管理 | 全部参考图可复跑;空输出/失败不会从分母消失 |
| 指标 pilot | 受控缺陷池、专家盲评、候选指标与区间 | 能解释指标有效范围;不能识别的维度另行报告 |
| 基线接入 | 统一适配器、预算阶梯、逐实例结果 | 至少检索、优化、单次生成、闭环生成可公平比较 |
| 正式冻结与运行 | 新 test family、预注册分析、全量分维度结果 | 所有主张都有对应实验;不看 test 调 prompt/阈值 |
| 发布与维护 | 公开 dev、可运行 evaluator、隐藏服务器/封闭脚本、版本说明 | 复现环境和许可检查完成;排行榜绑定版本 |
{
  "task_id": "immutable-id", "family_id": "source-lineage-id",
  "track": "image_to_graph | editing", "split": "dev | test",
  "inputs": {"reference_hash": "...", "start_graph_hash": "..."},
  "policy": {"node_library_version": "...", "external_assets": "forbidden"},
  "runtime": {"engine_version": "...", "renderer_config_hash": "..."},
  "evaluation": {"hidden_conditions_manifest_hash": "..."},
  "submission": {"graph_hash": "...", "dependency_manifest_hash": "..."},
  "result": {"parse": "pass", "compile": "pass", "render": "pass",
             "valid": true, "per_condition_metrics": [], "failure_reason": null},
  "budget": {"model_calls": 0, "render_calls": 0, "wall_seconds": 0}
}
这是 schema 示意,数值不是测量结果。test 的目标图/目标程序、隐藏相机和评测真值只在评测端保存,模型进程不可读取。另存完整 prompt、响应、工具调用、环境版本和逐次错误,避免只保存最终成功截图。
高单图相似度能否预测隐藏编辑成功?用同批输出的相关性和分歧对照检验;不要先假定必然负相关。
固定候选池的 oracle 与实际选择差距有多大?若很小,继续堆 verifier 的价值有限。
多条件/编辑指标相对单图指标,是否更符合独立专家判断?需要留出 family 与生成模型验证。
建议的主线:先证明“程序材质的可用性不能被单图相似度充分刻画”,再交付能测量这部分能力的任务和运行器;通过统一预算的基线揭示目前系统的瓶颈。这样的 benchmark 有明确研究问题,也能给后续 PMG 方法提供可优化的目标。
将执行成功、目标匹配、物理合理性和编辑能力分别报告;用家族级去重和隐藏条件测试泛化;扩大跨资产的人类验证;固定候选池比较多种 verifier;将真实耗时、模型费用与渲染资源纳入预算。若添加 learned reward,应将训练 reward 的偏好数据与最终评测隔离,避免把评测器学习的偏好当成独立证据。
对我们而言,BlenderGym 最有价值的迁移是从最终图像评分走向可执行的工作流诊断。但 PMG benchmark 的新意不应只是把 Blender 换成 Substance:需要证明新协议测到了旧评测遗漏的材质行为、结构约束和后续编辑能力。
以下为项目要求的渲染检查,不是 BlenderGym 的模型记号。
\(I^{\ast}\) \(z^{\ast}_{\mathrm{img}}\) \(z^{\mathrm{img}}_{1:I}\) \(z_{\lt t}\) \(P_{\theta}(\mathbf{z}\mid\mathbf{x})\) \(\beta_1=0.9,\ \beta_2=0.95\)
原论文图像用于学术精读,版权归原作者/权利人;所有图均标注原始 Figure 编号与来源。HTML 内嵌图像与 MathJax 3,可离线阅读;外链仅用于查阅来源。Table 1、Table 2 是原文数值的结构化转录,教学交互与 PMG 设计均明确标为本页解释或研究建议。此文件不是官方 benchmark 文档。
完成范围:论文/附录阅读、官方部分源码静态核查、单文件精读产物与浏览器验收。未执行论文模型评测、未验证全部数据许可和运行依赖、未开展 PMG 实验、未进行站点构建或部署。