单模型扩展失败
单个全局网络承担整座城市时,有限权重需要同时表示大量互不相关的局部细节;网络增大又使每条射线的查询成本上升。
Block-NeRF 的主要贡献来自系统分解:每个局部模型只承担一个空间块;外观嵌入、曝光条件与位姿修正吸收跨月采集差异;可见性网络负责筛选;外观匹配和二维反距离加权完成跨块合成。
Matthew Tancik · Vincent Casser · Xinchen Yan · Sabeek Pradhan · Ben Mildenhall · Pratul P. Srinivasan · Jonathan T. Barron · Henrik Kretzschmar
把单个 NeRF 直接加宽只能暂时增加容量,渲染代价仍会随模型增大,模型最终无法放入单个设备,局部道路变化也会迫使整个场景重新训练。城市数据还跨越数月,天气、时间、曝光、车辆轨迹误差和动态物体会共同破坏静态场景假设。
单个全局网络承担整座城市时,有限权重需要同时表示大量互不相关的局部细节;网络增大又使每条射线的查询成本上升。
同一地点在晴天、阴天、昼夜和不同曝光下呈现显著变化,若缺乏条件变量,网络容易把外观差异解释成错误密度。
道路施工等变化只发生在局部。独立块允许替换受影响区域,同时保留其他块的训练结果。
输入是带标定相机射线、车辆位姿、曝光值和可移动物体掩码的 RGB 图像。每个 Block-NeRF 输出体密度、视角相关颜色以及一个辅助可见性值。最终输出是目标相机的 RGB 图像。
| 符号 | 含义 | 所在环节 |
|---|---|---|
| \(\mathbf{r}(t)=\mathbf{o}+t\mathbf{d}\) | 相机原点 \(\mathbf{o}\) 沿单位方向 \(\mathbf{d}\) 发出的射线 | 训练与渲染 |
| \(\sigma_i,\mathbf{c}_i\) | 射线上第 \(i\) 个区间的密度与 RGB 颜色 | 局部 NeRF |
| \(T_i,w_i\) | 到采样点前的累积透射率,以及该样本对像素的体渲染权重 | 体渲染 |
| \(\mathbf{a}_j\) | 第 \(j\) 张训练图像的 32 维外观嵌入 | 颜色分支与块间外观匹配 |
| \(e_j\) | 快门时间与模拟增益组合得到的标量曝光条件 | 颜色分支 |
| \(f, f_c, f_v\) | 密度与特征网络、颜色网络、辅助可见性网络 | 每个 Block-NeRF |
| \(\mathbf{x}_k\) | 第 \(k\) 个块的中心或 origin | 候选选择与 IDW 合成 |
一个像素对应的是圆锥台体积,论文沿用 mip-NeRF,用高斯 \(\mathcal{N}(\boldsymbol{\mu},\boldsymbol{\Sigma})\) 近似该体积,再对位置编码取期望。它减少车辆相机以不同距离观察街景时产生的 aliasing。
每张训练图像拥有随机初始化并共同优化的 32 维向量。它吸收天气、时间与色彩平衡差异,并允许训练后在潜在空间插值。
证据边界:它没有提供物理可解释的光照分解,也没有保证不同块的同一向量对应相同外观。
相机曝光以 \(\operatorname{PE}(\text{shutter speed}\times\text{analog gain}/1000)\) 编码,使用 4 级正弦位置编码,只输入颜色分支。它既减少曝光差异造成的误差,也提供推理时可读的曝光控制。
每个 driving segment 学习平移偏移和 \(3\times3\) 残差旋转矩阵;残差加到单位矩阵后正交化。强正则在早期阻止网络用位姿偏移逃避几何学习。
预训练 Panoptic-DeepLab 识别车辆和行人,训练时忽略这些像素。阴影、漏检物体、树木和施工变化仍会留下伪影。
论文只明确说明 \(f_v\) 用 MSE 拟合 \(f\) 产生的透射率 \(T_i\),并将该损失缩放 \(10^{-6}\)。这里用 \(\operatorname{stopgrad}\) 明示辅助网络只读取监督目标,这是对实现关系的记号化解释;原文没有给出这一行完整公式。
典型放置策略在每个路口建立一个块,覆盖路口以及相连街道 75% 的长度,相邻块形成 50% 重叠。基本地图数据(例如 OpenStreetMap)足以自动安排块;训练图像按地理范围严格筛选。
论文未公开 Adam 的 \(\beta\) 值、weight decay、颜色损失的精确归一化、精度格式或完整训练代码。不得把 mip-NeRF 的默认值当作 Block-NeRF 已披露设置。
推理时的目标相机位置先通过半径筛选得到附近块;低分辨率运行独立可见性网络,均值低于阈值的块被移除。通常剩下一到三个块。
\(\mathbf{c}\) 是目标相机中心,\(\mathbf{x}_k\) 是块中心,\(\mathbf{I}_k\) 是第 \(k\) 个块完整渲染的二维图像。Alamo Square 使用 \(p=4\),Mission Bay 使用 \(p=1\)。权重在整幅图上相同,因此它牺牲部分锐度换取沿轨迹的时间稳定性。
外观码确定天气、昼夜和色彩基调,曝光标量控制亮度。论文没有生成式 decoding、temperature 或采样重排;这是逐场景优化后的确定性体渲染。候选筛选依赖固定半径和均值可见性阈值,但原文没有披露阈值数值。
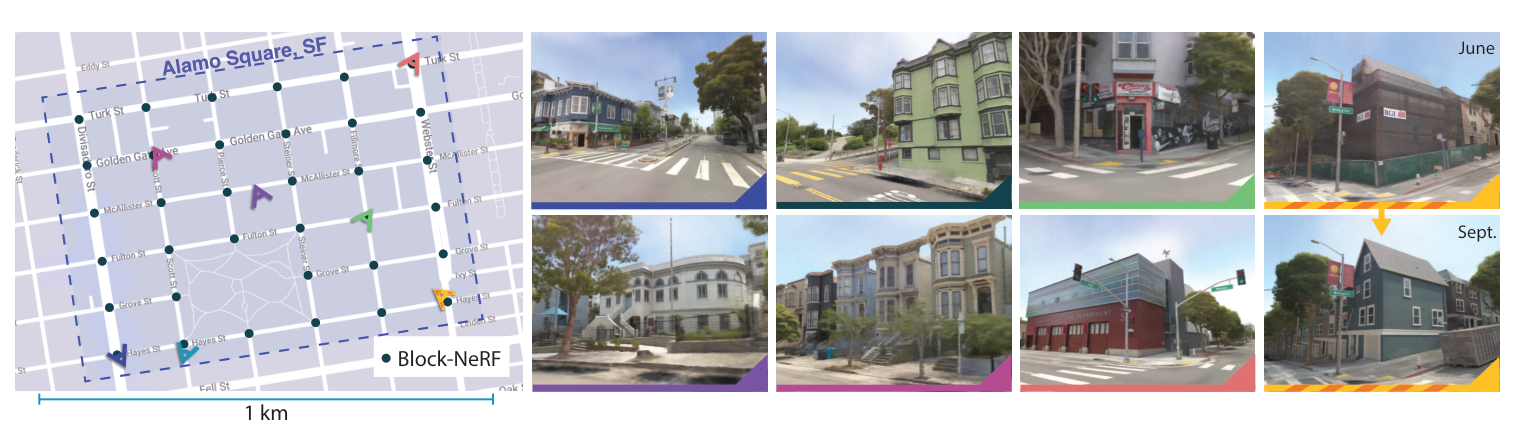
Alamo Square 用于跨月外观与规模展示;单次采集的 Mission Bay 用于比较块数、容量和插值方式,以减少环境变化带来的混杂因素。
| 方法 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | 实际支持的结论 |
|---|---|---|---|---|
| mip-NeRF | 17.86 | 0.563 | 0.509 | 没有跨图像条件时难以处理跨月变化 |
| Block-NeRF − Appearance | 20.13 | 0.611 | 0.458 | 外观嵌入贡献最大,减少云雾状伪几何 |
| Block-NeRF − Exposure | 23.55 | 0.649 | 0.418 | 定量影响很小,主要价值是推理时可控性 |
| Block-NeRF − Pose Opt. | 23.05 | 0.625 | 0.442 | 位姿修正提高锐度并减少重复物体 |
| Block-NeRF Full | 23.60 | 0.649 | 0.417 | 三项组合达到最佳总体表现 |
测试图像纵向分成两半:一半用于优化该测试图像的外观嵌入,另一半用于报告指标。这避免直接在被评测像素上拟合外观码,但评估仍是 test-time appearance fitting,不等同于完全无需适配的新视角预测。
| 比较条件 | 块数 | 每块 / 总权重 | 块大小 | 相对计算 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|---|---|---|---|
| 每块容量固定 | 1 | 0.25M / 0.25M | 544 m | 1× | 23.83 | 0.825 | 0.381 |
| 4 | 0.25M / 1.00M | 271 m | 2× | 25.55 | 0.868 | 0.318 | |
| 8 | 0.25M / 2.00M | 116 m | 2× | 26.59 | 0.890 | 0.278 | |
| 16 | 0.25M / 4.00M | 54 m | 2× | 27.40 | 0.907 | 0.242 | |
| 总容量固定约 1M | 1 | 1.00M / 1.00M | 544 m | 1× | 24.90 | 0.852 | 0.340 |
| 4 | 0.25M / 1.00M | 271 m | 0.5× | 25.55 | 0.868 | 0.318 | |
| 8 | 0.13M / 1.00M | 116 m | 0.25× | 25.92 | 0.875 | 0.306 | |
| 16 | 0.07M / 1.00M | 54 m | 0.125× | 25.98 | 0.877 | 0.305 |
| 插值 | 时间一致 | PSNR ↑ | SSIM ↑ | LPIPS ↓ | 判断 |
|---|---|---|---|---|---|
| Nearest | 否 | 26.40 | 0.887 | 0.280 | 开销最低,跨块突跳明显 |
| IDW 2D | 是 | 26.59 | 0.890 | 0.278 | 视频采用;指标与稳定性折中最佳 |
| IDW 3D | 否 | 26.57 | 0.890 | 0.278 | 深度噪声引入时间伪影 |
| Pixelwise Visibility | 否 | 27.39 | 0.906 | 0.242 | 静帧更锐利,视频闪烁 |
| Imagewise Visibility | 否 | 27.41 | 0.907 | 0.242 | 最佳静态指标,缺乏时间一致性 |
| 重叠 | 块大小 | PSNR ↑ | SSIM ↑ | LPIPS ↓ |
|---|---|---|---|---|
| 0% | 77 m | 26.77 | 0.895 | 0.262 |
| 25% | 97 m | 26.75 | 0.894 | 0.269 |
| 50%(主文设置) | 116 m | 26.59 | 0.890 | 0.278 |
| 75% | 136 m | 26.51 | 0.887 | 0.283 |
| 方法 | PSNR* train ↑ | PSNR* test ↑ | 协议限制 |
|---|---|---|---|
| COLMAP point rendering | 13.019 | 11.933 | 忽略不可见像素 |
| COLMAP surfel rendering | 13.291 | 12.343 | Lambertian + 单光源;忽略不可见像素 |
COLMAP 将 Mission Bay 切成 8 个半径 97 m、约 25% 重叠的块;给定相机内参与位姿先验,动态物体特征被掩蔽,再运行 SfM、MVS 与点云融合。反射表面和天空造成稀疏或错误几何。该结果说明传统管线在此数据上的困难,但评估掩蔽规则与表示能力不同,不能看作严格同预算的端到端 baseline。
可以把大型材质图或复杂 shader graph 按功能子图分块,让每个块独立训练或搜索,再用共享的接口变量与边界渲染约束组合。Block-NeRF 的外观匹配对应“局部程序的边界条件匹配”,可见性筛选对应“只执行影响当前输出的子程序”。这些属于跨领域研究设想,论文没有在材质图或程序生成上验证。
官方 Waymo 页面提供 Mission Bay 数据集说明、云存储入口、视频和论文链接;没有提供官方训练代码。社区实现不能作为论文实现事实。论文明确给出网络宽度、训练步数、采样数、学习率、硬件、时间、位姿正则与 IDW 指数,足以重建主要框架,仍不足以保证逐数值复现。
作者明确承认将高计算量 NeRF 推到街区规模可能增加能耗与碳排放,并把缓存与快速 NeRF 视为缓解方向。
数据采集限于公共道路,并模糊人脸与车牌;更频繁、更大范围的城市扫描仍会放大隐私风险。相机影像可能包含比 LiDAR 更敏感的细节。
本页逐页核查本地 2202.05263 PDF 的正文与附录,重建 Table 1–5 全部行列。Figure 2 与 Figure 3 使用结构重绘并明确标注;Figure 6、Figure 7、Figure 8–11 的结论以原始图注和正文解释呈现。未公开参数均保持未确认状态。