核心变量是“如何让两张图相互看见”
主流 diffusion VTON 常用 ReferenceNet 复制一套 UNet 提取服装特征,再经 attention 注入人物分支。CatVTON 的假设是:共享 VAE 和共享 UNet 已经提供共同特征空间,只需把人物与服装在空间维度拼成一幅联合画布,self-attention 就能承担远距离交互。
Research gap
ReferenceNet 与 CLIP、DINOv2 图像编码器增加参数、显存和推理时间;服装细节保存又未必受益于为分类或语义对齐训练的压缩表示。论文寻找一种保持像素级条件、又复用预训练扩散先验的路径。
证据边界
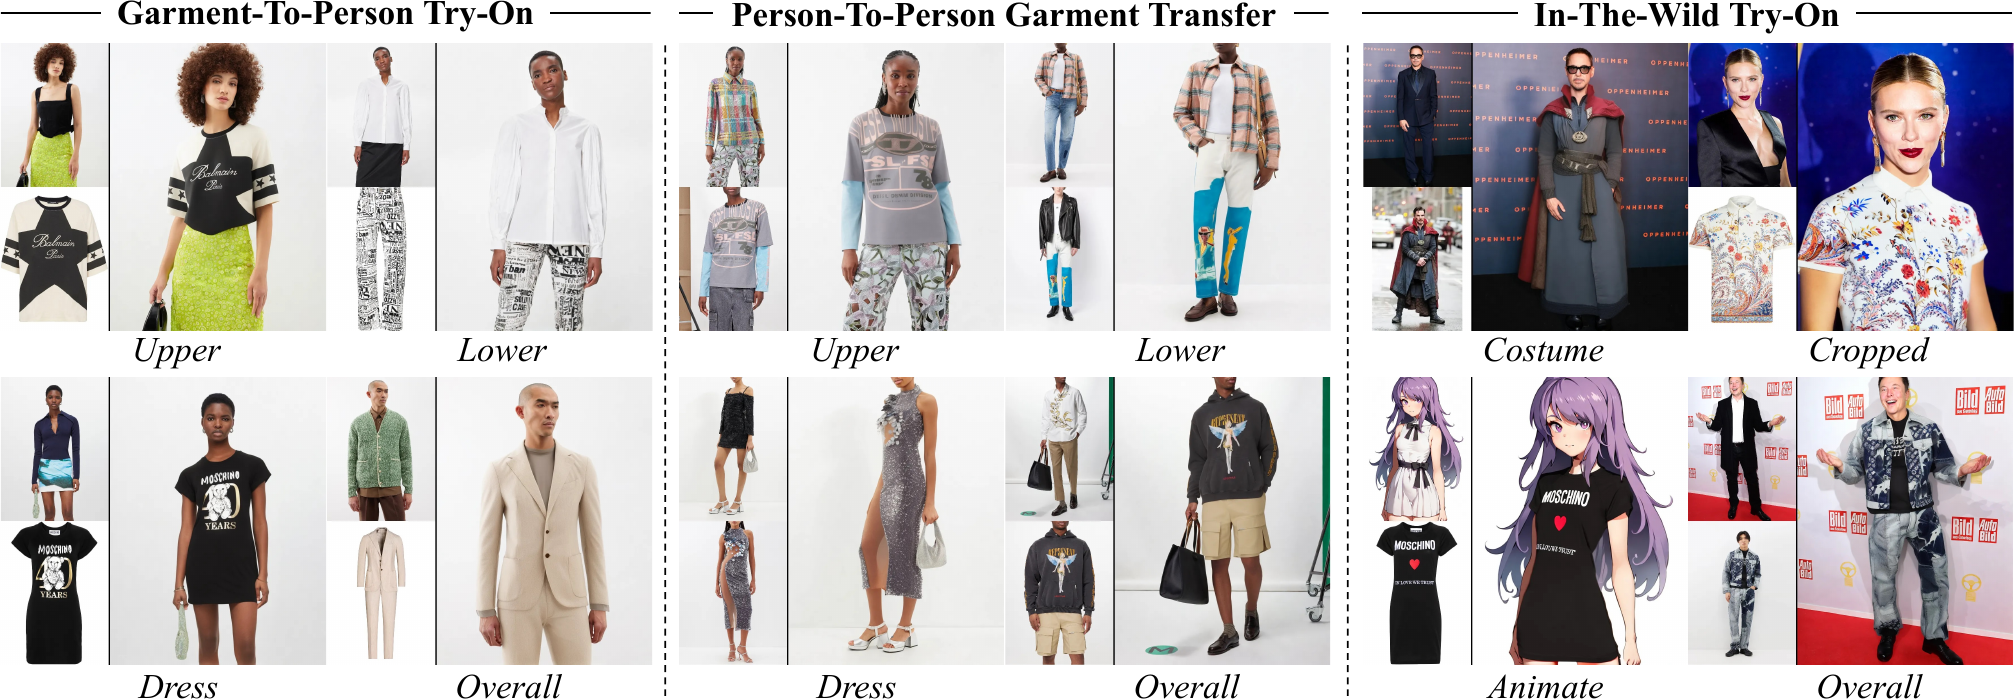
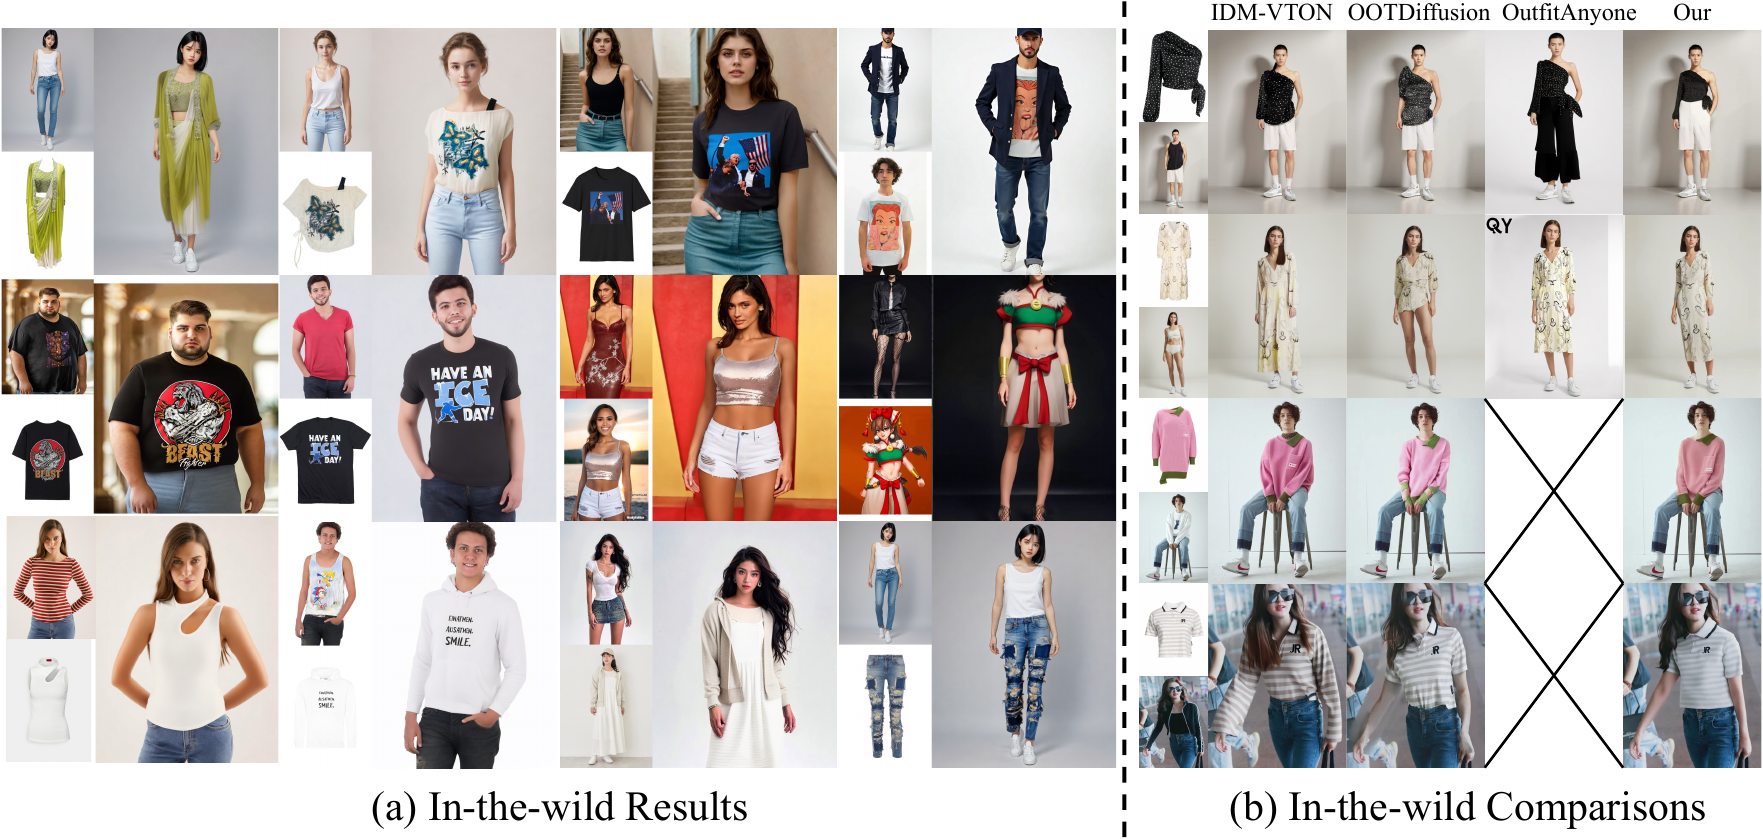
论文验证了 VITON-HD、DressCode、DeepFashion 衣服迁移和若干 in-the-wild 样例。它没有给出人体身份、服装 logo 字符级正确率、跨种族公平性或真实电商用户研究。
输入、mask 与联合潜变量
输入与输出
目标人物图像为 \(I_p\in\mathbb{R}^{3\times H\times W}\),服装参考为 \(I_g\in\mathbb{R}^{3\times H\times W}\)。mask-based 模型还接收衣服无关二值 mask \(M\in\mathbb{R}^{H\times W}\)。输出 \(\widetilde I_p\) 保留人物身份、姿态和背景,同时把参考服装映射到指定区域。
mask 语义
论文公式用 \(I_p\otimes M\) 表示输入人物图。官方代码的白色 mask 表示需要重绘的区域,并计算 masked_image = image * (mask < 0.5)。因此代码中的 mask 与论文公式里的保留掩码采用互补约定,阅读公式时必须先确认 \(M\) 的取值语义。
人物条件图
mask-free 路径保留原始人物图,让模型自行判断服装区域;mask-based 路径显式遮掉待替换区域。Hadamard 乘积 \(\otimes\) 逐像素应用 mask。
空间拼接
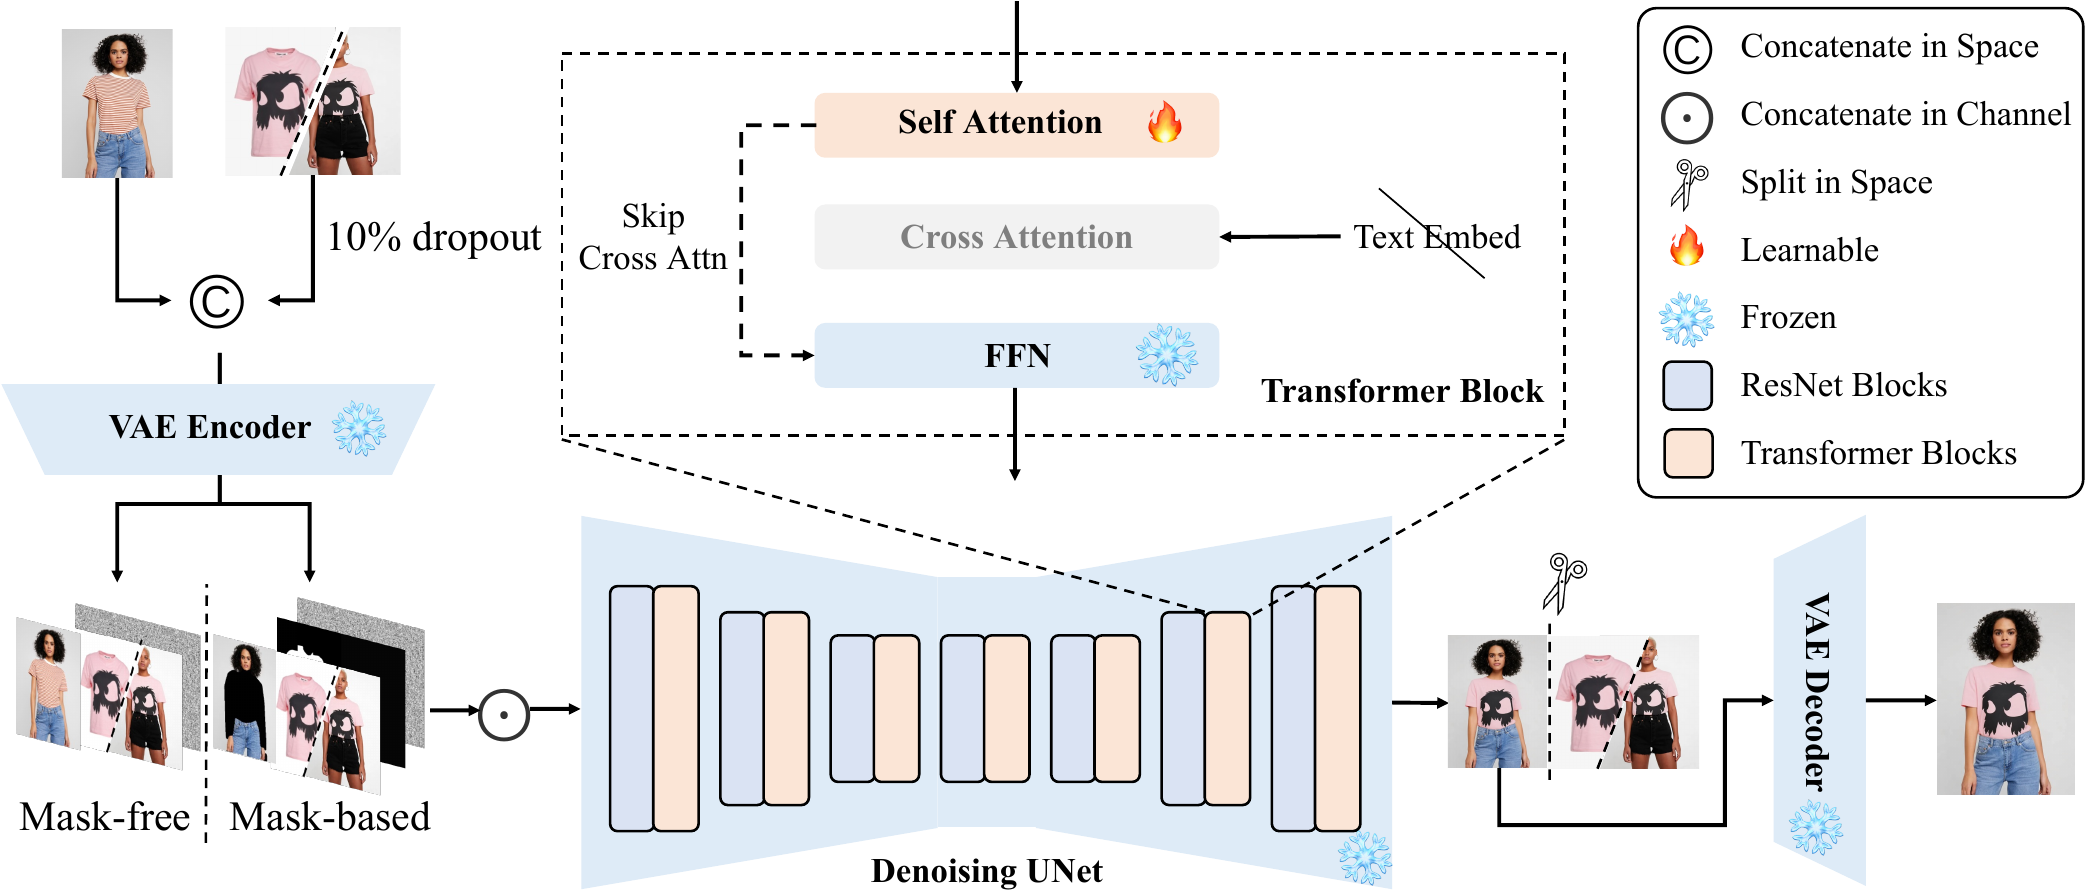
论文把 \(\Vert_s\) 定义为空间拼接,并在尺寸公式中采用宽度方向:两张 \(H\times W\) 图形成 \(H\times 2W\),VAE 下采样八倍后得到 \(4\times H/8\times W/4\)。共享 VAE 一次编码联合画布,使人物 token 与服装 token 进入同一潜空间。
concat_dim = -2,沿高度方向得到 \(4\times H/4\times W/8\)。mask-free pipeline 使用 concat_dim = -1。附录报告 x/y 轴训练都能正常生成,且 x 轴训练模型可在推理时改用 y 轴。九通道 inpainting 输入,跨半图 self-attention
mask-based 张量
以宽度拼接记号说明:噪声 \(z_t\in\mathbb{R}^{4\times H/8\times W/4}\),拼接 mask \(M_i\in\mathbb{R}^{1\times H/8\times W/4}\),条件 \(X_i\in\mathbb{R}^{4\times H/8\times W/4}\)。沿 channel 拼接得到 9 通道,匹配 Stable Diffusion v1.5 inpainting UNet。
mask-free 张量
InstructPix2Pix 版本将四通道噪声与四通道联合条件沿 channel 拼接,形成 8 通道输入。它不提供显式 mask;模型从原人物与服装的联合条件中学习重绘范围。
注意力为何可以“跨半图搬运”
UNet transformer block 把二维特征展平成 token 序列。联合画布中的人物 token 可以对服装半幅的 key 分配高权重,再从对应 value 聚合纹理、轮廓和颜色信息。卷积 ResNet 主要提供局部建模;self-attention 提供整张联合画布的长距离交互。论文据此只训练 attn1 self-attention。
删除的组件
文本编码器完全移除;原 UNet 的 attn2 cross-attention processor 被替换为直接返回 hidden states 的 SkipAttnProcessor。CLIP/DINO 图像编码器和 ReferenceNet 均不加入核心网络,合计减少 167.02M 文本相关参数,并避免复制 UNet。
冻结的组件
VAE、UNet ResNet block、FFN、归一化层和 cross-attention 路径保持冻结或被跳过。发布 checkpoint 只加载名为 attention 的模块集合;官方工具按模块名包含 attn1 选择 self-attention。
只优化 self-attention 的噪声预测
标准 latent diffusion 目标
\(z_t\) 是由干净 latent \(z_0\) 在时间步 \(t\) 加入 Gaussian noise 后的样本;\(\epsilon_{\theta}\) 预测已加入的噪声。CatVTON 对 mask-based 和 mask-free 模型都声明使用 MSE。论文没有明确说明 MSE 是否覆盖联合 latent 的两半,也没有发布训练代码,因此“只监督人物半幅”或“监督完整联合画布”都无法从一手材料确认。
DREAM 修正
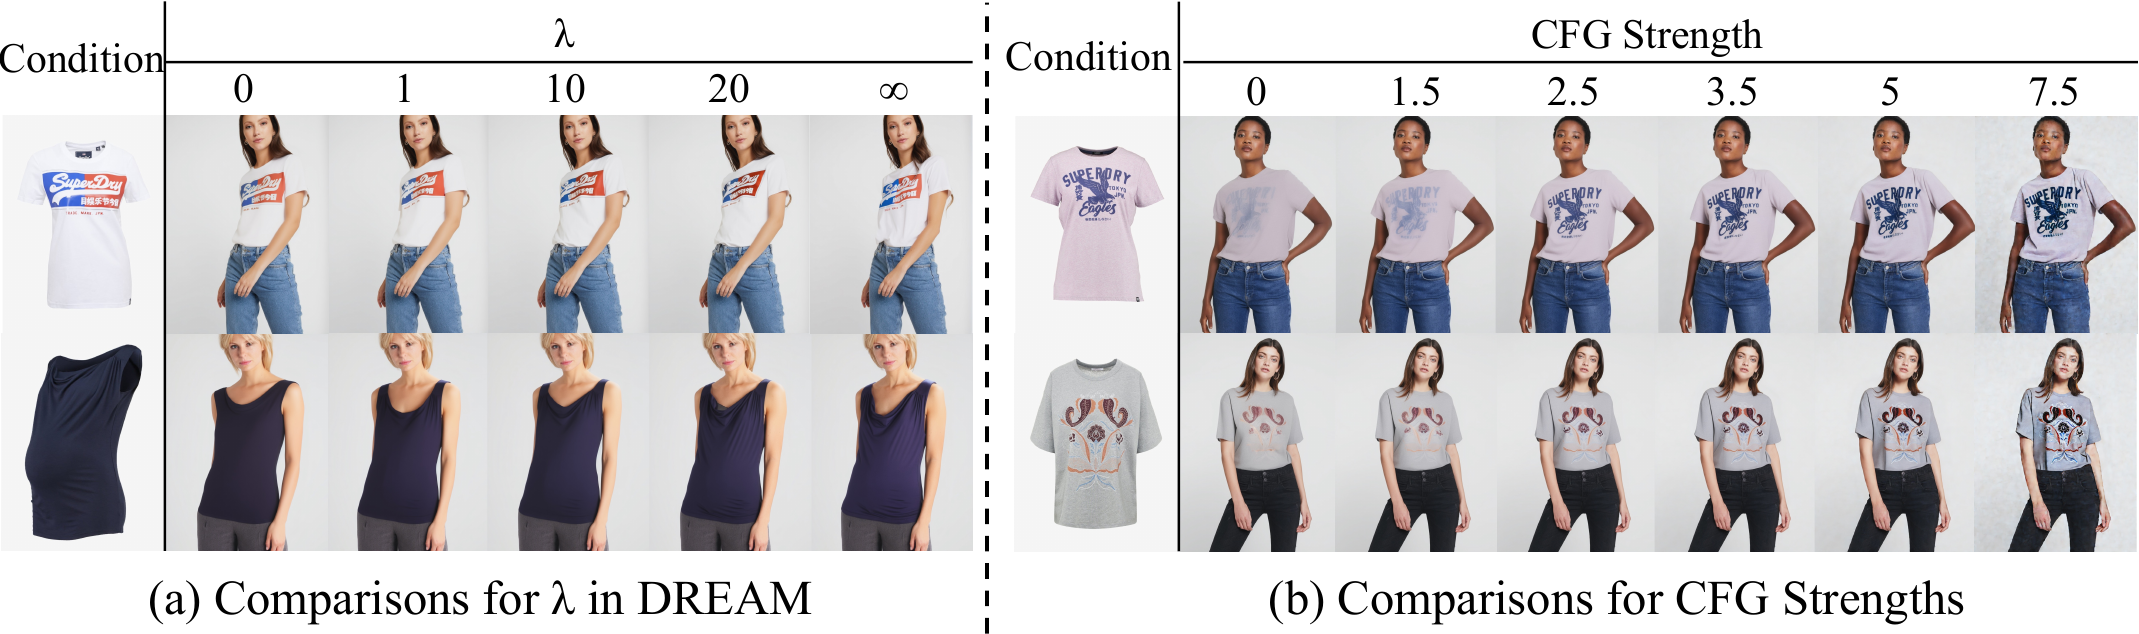
DREAM 先额外前向一次得到噪声估计,再把估计误差注入训练样本。论文用 \(\lambda=10\),目标是在较少训练步内补偿高频细节;额外前向会降低单步训练速度。
单数据集定量模型
- Base:Stable Diffusion v1.5 inpainting(mask-based)与 InstructPix2Pix(mask-free)
- 分辨率:\(512\times384\)
- 步数:16,000
- 全局 batch size:128
- 优化器:AdamW
- 学习率:常数 \(10^{-5}\)
- DREAM:\(\lambda=10\)
三数据集多任务模型
- 训练数据:约 73K image pairs
- 分辨率:\(1024\times768\)
- 步数:48,000
- 全局 batch size:32
- 其余设置与单数据集模型相同
- 硬件:8×NVIDIA A800 80GB
- 16K steps 约 10 小时;PyTorch 2.1.2 + Diffusers
公开信息缺口
论文未报告 AdamW 的 \(\beta_1,\beta_2\)、weight decay、warmup、gradient clipping、precision、gradient accumulation、数据增强、noise scheduler 训练配置与 checkpoint 选择准则。复现时需要自行决定这些项,并把它们与论文报告结果区分。
10% 条件 dropout
训练时有 10% 概率丢弃服装条件,建立无条件分支;推理时通过 CFG 组合无条件和有条件噪声预测。这里的“条件”是服装 latent,系统没有文本 prompt。
数据集划分与配对构造
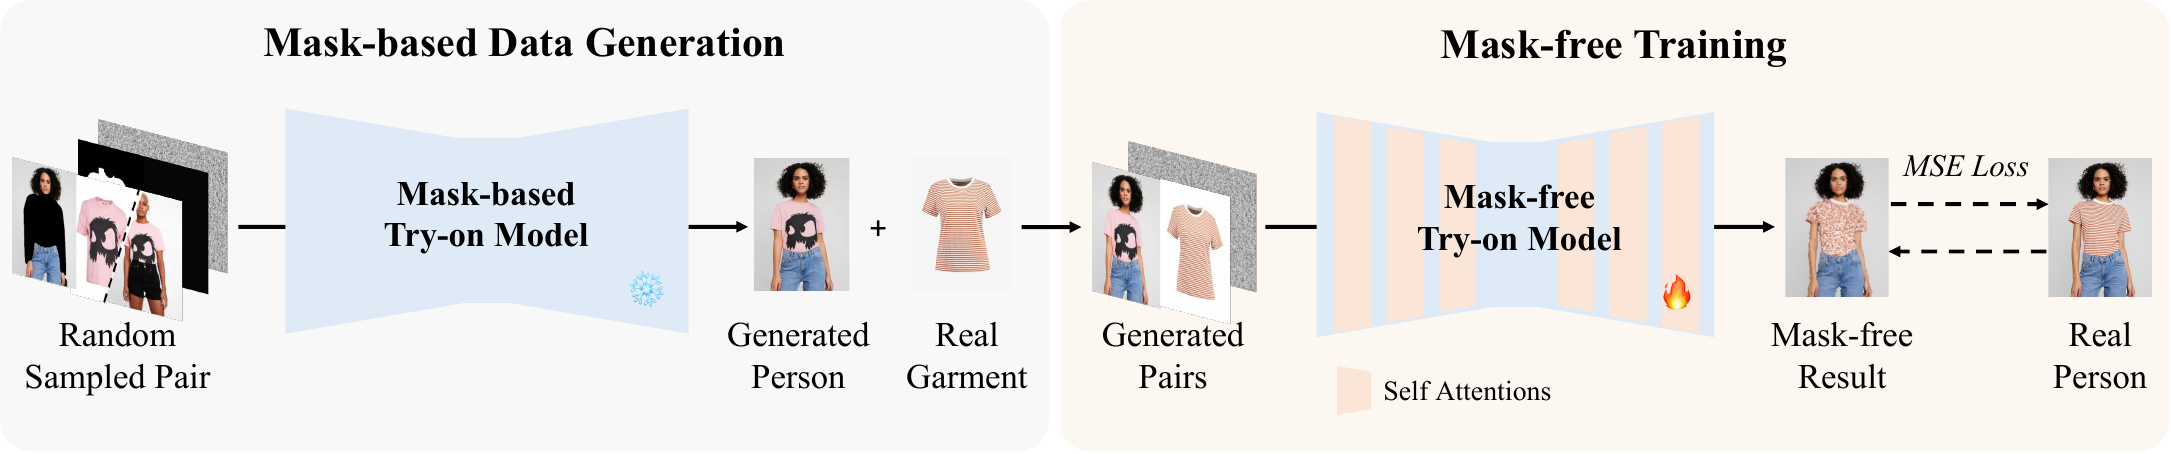
VITON-HD 包含 13,679 对上装人物与商品图,其中训练 11,647 对、测试 2,032 对。DressCode 训练 48,392 对、测试 5,400 对,覆盖上装、下装和连衣裙。DeepFashion in-shop retrieval 原始集合含 52,712 张高分辨率人物图;论文筛选其中 13,098 对用于训练、1,896 对用于测试衣服迁移。三集合训练对合计 73,137,对应论文约 73K 的描述。DressCode 与 DeepFashion 的衣服无关 mask 使用 DensePose,以及 LIP/ATR 两种 SCHP human parsing;mask-free 训练另通过 mask-based 模型生成伪配对。出处:正文 §4.1、附录 A.2。
条件在每个时间步重复注入
mask 与去噪递推
\(O\) 是与人物 mask 同尺寸的全零服装半幅 mask。随机噪声 \(z_T\sim\mathcal{N}(0,I)\) 与联合条件同形状;每个 DDIM 时间步都重新沿 channel 拼接 mask 与条件 latent。
CFG 与最终分割
论文的 CFG 消融选择 \(s=2.5\)。官方 UNet pipeline 默认 DDIM 50 steps、\(\eta=1.0\)、1024×768;评测脚本默认 512×384、seed 555。生成完联合 latent 后,仅保留人物半幅并通过 VAE decoder 解码。
mask-based 所需输入
核心模型需要人物、服装和二值 mask。论文把 mask 视为输入;官方 Gradio 为便利性额外运行 DensePose 与两套 SCHP 自动生成 mask。这项预处理属于应用封装,核心网络仍可直接使用用户 mask。
mask-free 所需输入
只需人物与服装;其代价是先用 mask-based 模型构造伪配对训练数据。结果表显示 mask-free 在 DressCode paired SSIM 与 LPIPS 更好,在多数分布指标上 mask-based 更好。
论文将整个去噪递推简写为 UNet 输出下一步 latent。实际发布代码由 UNet 预测噪声,再调用 DDIMScheduler.step 计算下一步 latent;时间步与 CFG 的作用应沿该调度器流程理解。
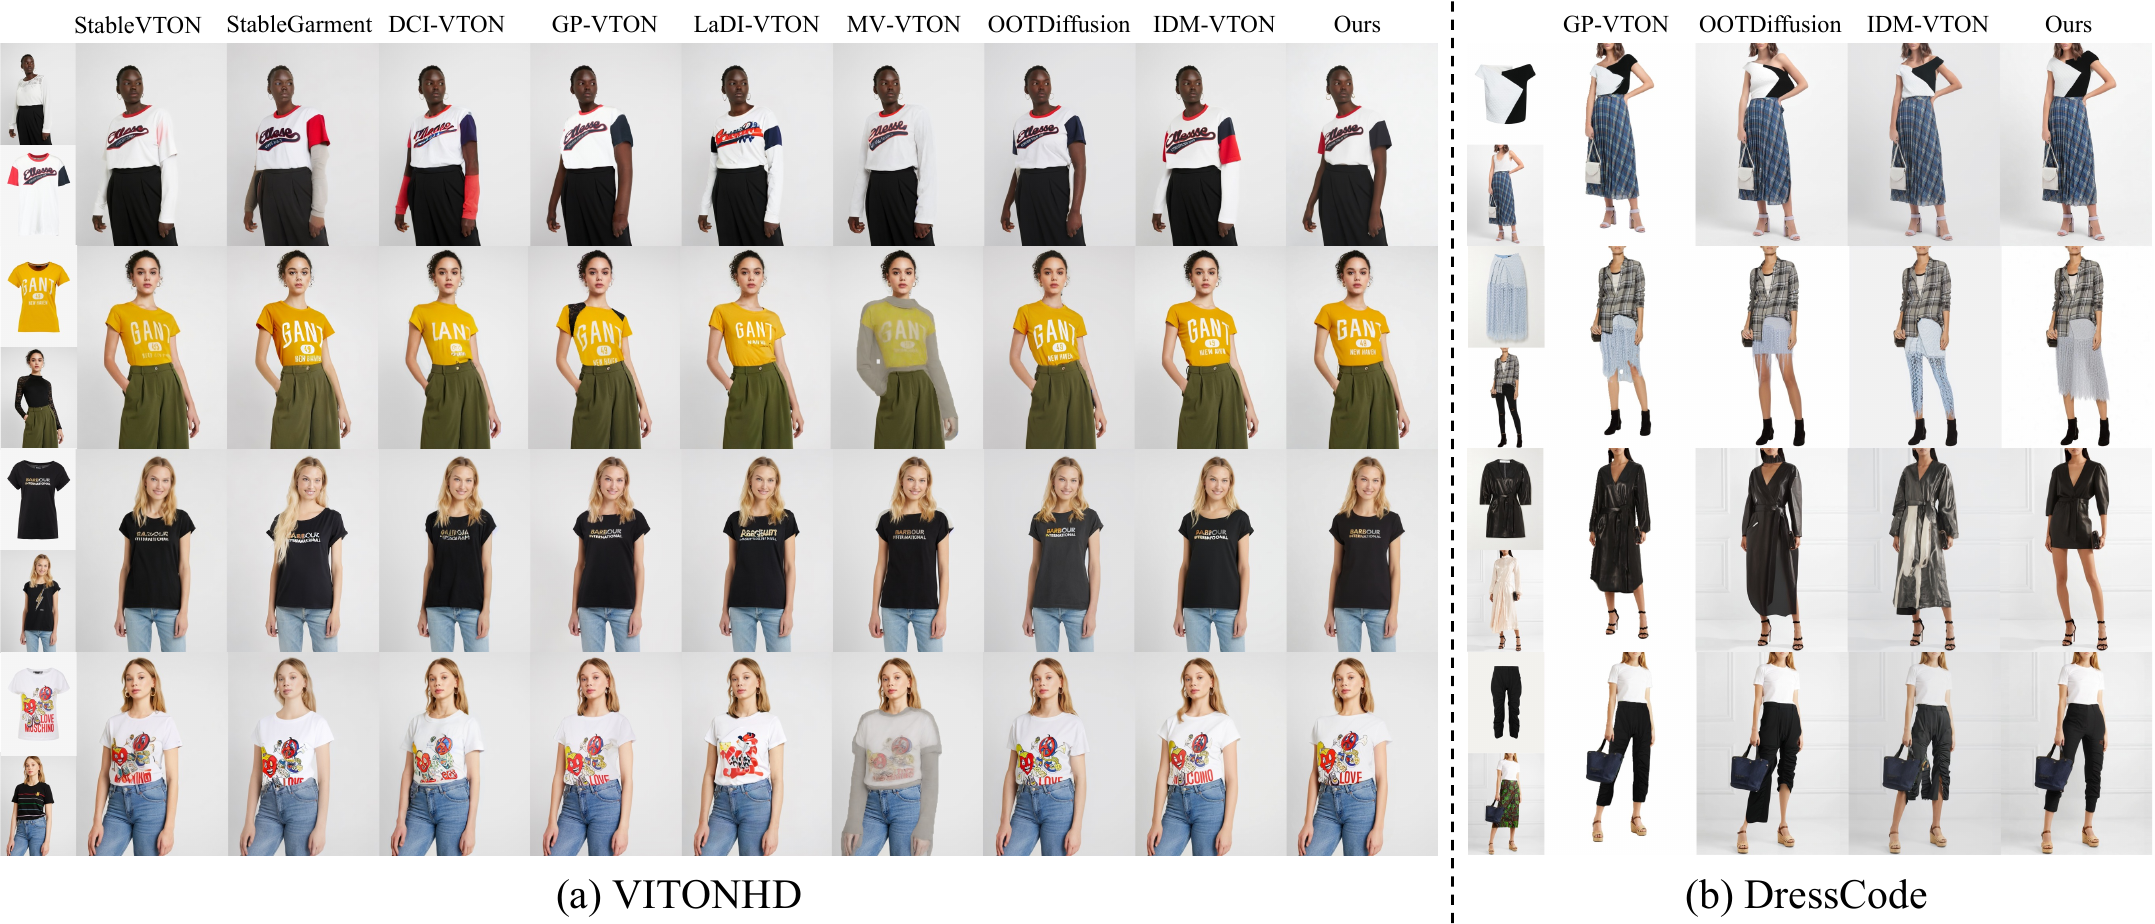
完整主表:两个数据集、成对与非成对设置
Paired 同时比较生成图与对应真值,使用 SSIM、FID、KID、LPIPS;Unpaired 没有逐图真值,只用 FID 与 KID 比较分布。SSIM 越高越好,其余指标越低越好。
| 方法 | VITON-HD | DressCode | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Paired | Unpaired | Paired | Unpaired | |||||||||
| SSIM ↑ | FID ↓ | KID ↓ | LPIPS ↓ | FID ↓ | KID ↓ | SSIM ↑ | FID ↓ | KID ↓ | LPIPS ↓ | FID ↓ | KID ↓ | |
| DCI-VTON | 0.8620 | 9.408 | 4.547 | 0.0606 | 12.531 | 5.251 | — | — | — | — | — | — |
| StableVTON | 0.8543 | 6.439 | 0.942 | 0.0905 | 11.054 | 3.914 | — | — | — | — | — | — |
| StableGarment | 0.8029 | 15.567 | 8.519 | 0.1042 | 17.115 | 8.851 | — | — | — | — | — | — |
| MV-VTON | 0.8083 | 15.442 | 7.501 | 0.1171 | 17.900 | 8.861 | — | — | — | — | — | — |
| GP-VTON | 0.8701 | 8.726 | 3.944 | 0.0585 | 11.844 | 4.310 | 0.7711 | 9.927 | 4.610 | 0.1801 | 12.791 | 6.627 |
| LaDI-VTON | 0.8603 | 11.386 | 7.248 | 0.0733 | 14.648 | 8.754 | 0.7656 | 9.555 | 4.683 | 0.2366 | 10.676 | 5.787 |
| IDM-VTON | 0.8499 | 5.762 | 0.732 | 0.0603 | 9.842 | 1.123 | 0.8797 | 6.821 | 2.924 | 0.0563 | 9.546 | 4.320 |
| OOTDiffusion | 0.8187 | 9.305 | 4.086 | 0.0876 | 12.408 | 4.689 | 0.8854 | 4.610 | 0.955 | 0.0533 | 12.567 | 6.627 |
| CatVTON (Mask-Free) | 0.8701 | 5.888 | 0.513 | 0.0613 | 9.287 | 1.168 | 0.9016 | 4.779 | 1.297 | 0.0452 | 7.400 | 2.619 |
| CatVTON (Inpainting) | 0.8704 | 5.425 | 0.411 | 0.0565 | 9.015 | 1.091 | 0.8922 | 3.992 | 0.818 | 0.0455 | 6.137 | 1.403 |
Table 1(原论文全部方法行与指标列;横向滚动查看完整 12 个指标)。粗体绿色为原表最优,下划线为原表第二名。
计算与显存
| 方法 | GFLOPs | 推理时间(秒) | 显存 | |||||
|---|---|---|---|---|---|---|---|---|
| \(E_{text}\) | \(E_{image}\) | ReferenceNet | UNet | 512×384 | 1024×768 | 512×384 | 1024×768 | |
| OOTDiffusion | 13.08 | 155.62 | 509.12 | 547.34 | 4.76 | 36.23 | 6854 M | 8892 M |
| IDM-VTON | 110.04 | 155.62 | 1340.15 | 1163.98 | 12.96 | 17.32 | 17112 M | 18916 M |
| StableVTON | — | 155.62 | 173.80 | 545.27 | 12.17 | 36.10 | 9828 M | 14176 M |
| CatVTON | — | — | — | 973.59 | 2.58 | 9.25 | 3276 M | 5940 M |
Table 2。单张 NVIDIA A100、batch size 1;推理时间取同一输入 10 次平均。GFLOPs 由 calflops 计算。
| 方法 | 参数(M) | 显存(G) | 额外条件 | |||||||
|---|---|---|---|---|---|---|---|---|---|---|
| VAE | UNet | \(UNet_{ref}\) | \(E_{text}\) | \(E_{image}\) | Total | Trainable | Pose | Text | ||
| OOTDiffusion | 83.61 | 859.53 | 859.52 | 85.06 | 303.70 | 2191.42 | 1719.05 | 10.20 | — | ✓ |
| IDM-VTON | 83.61 | 2567.39 | 2567.39 | 716.38 | 303.70 | 6238.47 | 2871.09 | 26.04 | ✓ | ✓ |
| StableVTON | 83.61 | 859.41 | 361.25 | — | 303.70 | 1607.97 | 500.73 | 7.87 | ✓ | — |
| StableGarment | 83.61 | 859.53 | 1220.77 | 85.06 | — | 2248.97 | 1253.49 | 11.60 | ✓ | ✓ |
| MV-VTON | 83.61 | 859.53 | 361.25 | — | 316.32 | 1620.71 | 884.66 | 7.92 | ✓ | — |
| CatVTON | 83.61 | 815.45 | — | — | — | 899.06 | 49.57 | 4.00 | — | — |
Table 3。论文据此得到总参数约减少 44%、可训练参数相对其他 diffusion baseline 减少 10 倍以上的结论。
关键消融:训练组件
| 训练模块 | Paired | Unpaired | 参数(M) | IPS ↑ | 训练显存(M) | ||||
|---|---|---|---|---|---|---|---|---|---|
| SSIM ↑ | FID ↓ | KID ↓ | LPIPS ↓ | FID ↓ | KID ↓ | ||||
| UNet | 0.8692 | 5.2496 | 0.4017 | 0.0550 | 8.8131 | 0.9559 | 815.45 | 3.21 | 14289 |
| Transformers | 0.8558 | 5.4496 | 0.4434 | 0.0558 | 8.8423 | 1.0082 | 267.24 | 4.10 | 9981 |
| Self Attention + Text | 0.8517 | 6.5744 | 1.0690 | 0.0772 | 9.6998 | 1.6683 | 49.57 | 4.50 | 8805 |
| Self Attention | 0.8704 | 5.4252 | 0.4112 | 0.0565 | 9.0151 | 1.0914 | 49.57 | 4.75 | 8451 |
全 UNet 在五个感知或分布指标略优;self-attention 在 SSIM、速度、训练显存和参数量占优。添加文本条件令全部六项质量指标下降。这个表支持“self-attention 是高效适配点”,尚不足以证明其他层与 VTON 无关。
DREAM \(\lambda\) 消融
| \(\lambda\) | Paired | Unpaired | ||||
|---|---|---|---|---|---|---|
| SSIM ↑ | FID ↓ | KID ↓ | LPIPS ↓ | FID ↓ | KID ↓ | |
| 0 | 0.8740 | 10.4534 | 3.8866 | 0.0692 | 14.1045 | 5.2824 |
| 1 | 0.8716 | 8.0983 | 2.1977 | 0.0646 | 11.7652 | 3.2942 |
| 10 | 0.8704 | 5.4252 | 0.4112 | 0.0565 | 9.0151 | 1.0914 |
| 20 | 0.8633 | 5.5861 | 0.4005 | 0.0620 | 9.0877 | 1.0416 |
| \(\infty\)(关闭 DREAM) | 0.8614 | 5.5561 | 0.3657 | 0.0631 | 8.9114 | 1.0049 |
\(\lambda=10\) 在 paired FID 与 LPIPS 最优;关闭 DREAM 在 KID 与 unpaired FID/KID 更好;\(\lambda=0\) 的 SSIM 最高。论文选择 10 是自然度与细节的经验折中,表格没有给出单一设置统治全部指标的证据。
DiT 可迁移性
| 方法 | SSIM ↑ | FID ↓ | KID ↓ | LPIPS ↓ | Unpaired FID ↓ | Unpaired KID ↓ |
|---|---|---|---|---|---|---|
| StableGarment | 0.8029 | 15.567 | 8.519 | 0.1042 | 17.115 | 8.851 |
| MV-VTON | 0.8083 | 15.442 | 7.501 | 0.1171 | 17.900 | 8.861 |
| LaDI-VTON | 0.8603 | 11.386 | 7.248 | 0.0733 | 14.648 | 8.754 |
| DCI-VTON | 0.8620 | 9.408 | 4.547 | 0.0606 | 12.531 | 5.251 |
| OOTDiffusion | 0.8187 | 9.305 | 4.086 | 0.0876 | 12.408 | 4.689 |
| GP-VTON | 0.8701 | 8.726 | 3.944 | 0.0585 | 11.844 | 4.310 |
| StableVITON | 0.8543 | 6.439 | 0.942 | 0.0905 | 11.054 | 3.914 |
| CatVTON (HunyuanDiT) | 0.9118 | 5.786 | 0.939 | 0.0393 | 10.019 | 1.864 |
附录 Table 6 在 VITON-HD 上验证空间拼接可以迁移到 HunyuanDiT。作者说明 DiT 收敛更慢且尚未充分拟合;表中也没有与 UNet CatVTON 的同设定直接对照,因此它属于可迁移性证据,不能据此断言 DiT 更优。
发布代码可以复现推理,训练过程仍有关键缺口
已核实的 UNet 路径
- DDIMScheduler 从 base checkpoint 读取
- VAE 使用
stabilityai/sd-vae-ft-mse - cross-attention processor 直接跳过
- self-attention processor 保持标准 PyTorch scaled dot-product attention
- 发布权重目录仅加载
attention - 联合 noise 每步生成完整两半,最终只解码人物半幅
应用层额外处理
Gradio 自动 mask 使用 DensePose 与 SCHP,随后对 mask 做 blur;评测脚本支持 repaint,把生成结果按高斯模糊 mask 与原人物重新混合。这些步骤会影响最终边界观感,论文表格是否使用 repaint 需要结合命令参数复现记录。
训练代码状态
官方仓库发布了推理、评测、自动 mask 与 checkpoint,没有发布论文 UNet 版本的训练代码。MSE 的空间监督范围、数据采样比例、DREAM 的具体实现、optimizer 其余参数都无法从仓库核实。
CatVTON-FLUX 的地位
仓库在 2024 年 12 月加入 FLUX.1-Fill-dev 的 37.4M LoRA 试验版。它移除 FLUX joint transformer 中的文本分支,使用图像 token 与单分支 attention;这套代码是论文之后的工程扩展,ICLR 主实验、表格和 49.57M 参数结论都对应 Stable Diffusion UNet 版本。
事实、作者解释与研究推断
简洁结构很强,证据链仍可继续加固
Strengths
- 用空间拼接统一人物与服装表示,结构清楚,移除了多套重复编码网络。
- 训练模块消融同时报告质量、参数、IPS 与显存,效率主张有直接证据。
- 主表覆盖两数据集、paired 与 unpaired 设置,baseline 范围较完整。
- 附录公开 mask-free 伪数据、硬件软件环境、x/y 拼接与 DiT 迁移。
Weaknesses
- 训练代码与若干关键 optimizer、监督范围未公开,完整复现受限。
- 自动 mask 与论文“无需预处理”的表达容易混淆;mask-based 核心模型仍依赖 mask 质量。
- 定量指标对 logo 字符、细密重复纹理与服装身份的测量不足。
- 野外对比含不同可用输入限制,公平性有限。
- 未报告多件服装组合、极端遮挡、手部交互和长期稳定性。
Potential improvements
下一步实验应公开完整训练脚本与 seed,明确联合 latent 的监督区域;在统一自动 mask、相同分辨率与相同 sampling steps 下重跑全部 baseline;加入 OCR accuracy、局部 patch LPIPS、DINO/CLIP garment retrieval、颜色差 \(\Delta E\) 与人工偏好;针对多件服装建立显式实例 token 和遮挡图,并用 attention 可视化验证跨半图对应是否真的承担纹理传递。
一手来源
- arXiv 2407.15886v2:论文 HTML、PDF 与 2025-02-16 版本信息。
- OpenReview · ICLR 2025 Poster:正式会议状态、作者顺序与通讯作者标记。
- 官方 GitHub 仓库:UNet 推理、评测、自动 mask、FLUX 扩展、checkpoint 说明与更新记录。
- 官方 Hugging Face checkpoints:mix、VITON-HD、DressCode attention 权重与 FLUX LoRA。
网页依据 ICLR 2025 / arXiv v2 的 9 位作者列表整理。官方仓库 README 底部旧 BibTeX 曾遗漏 Dongmei Jiang,身份信息以论文 PDF 与 OpenReview 为准。