干预
8
主要算术任务使用八个手写 CoT exemplars;AQuA 使用四个。
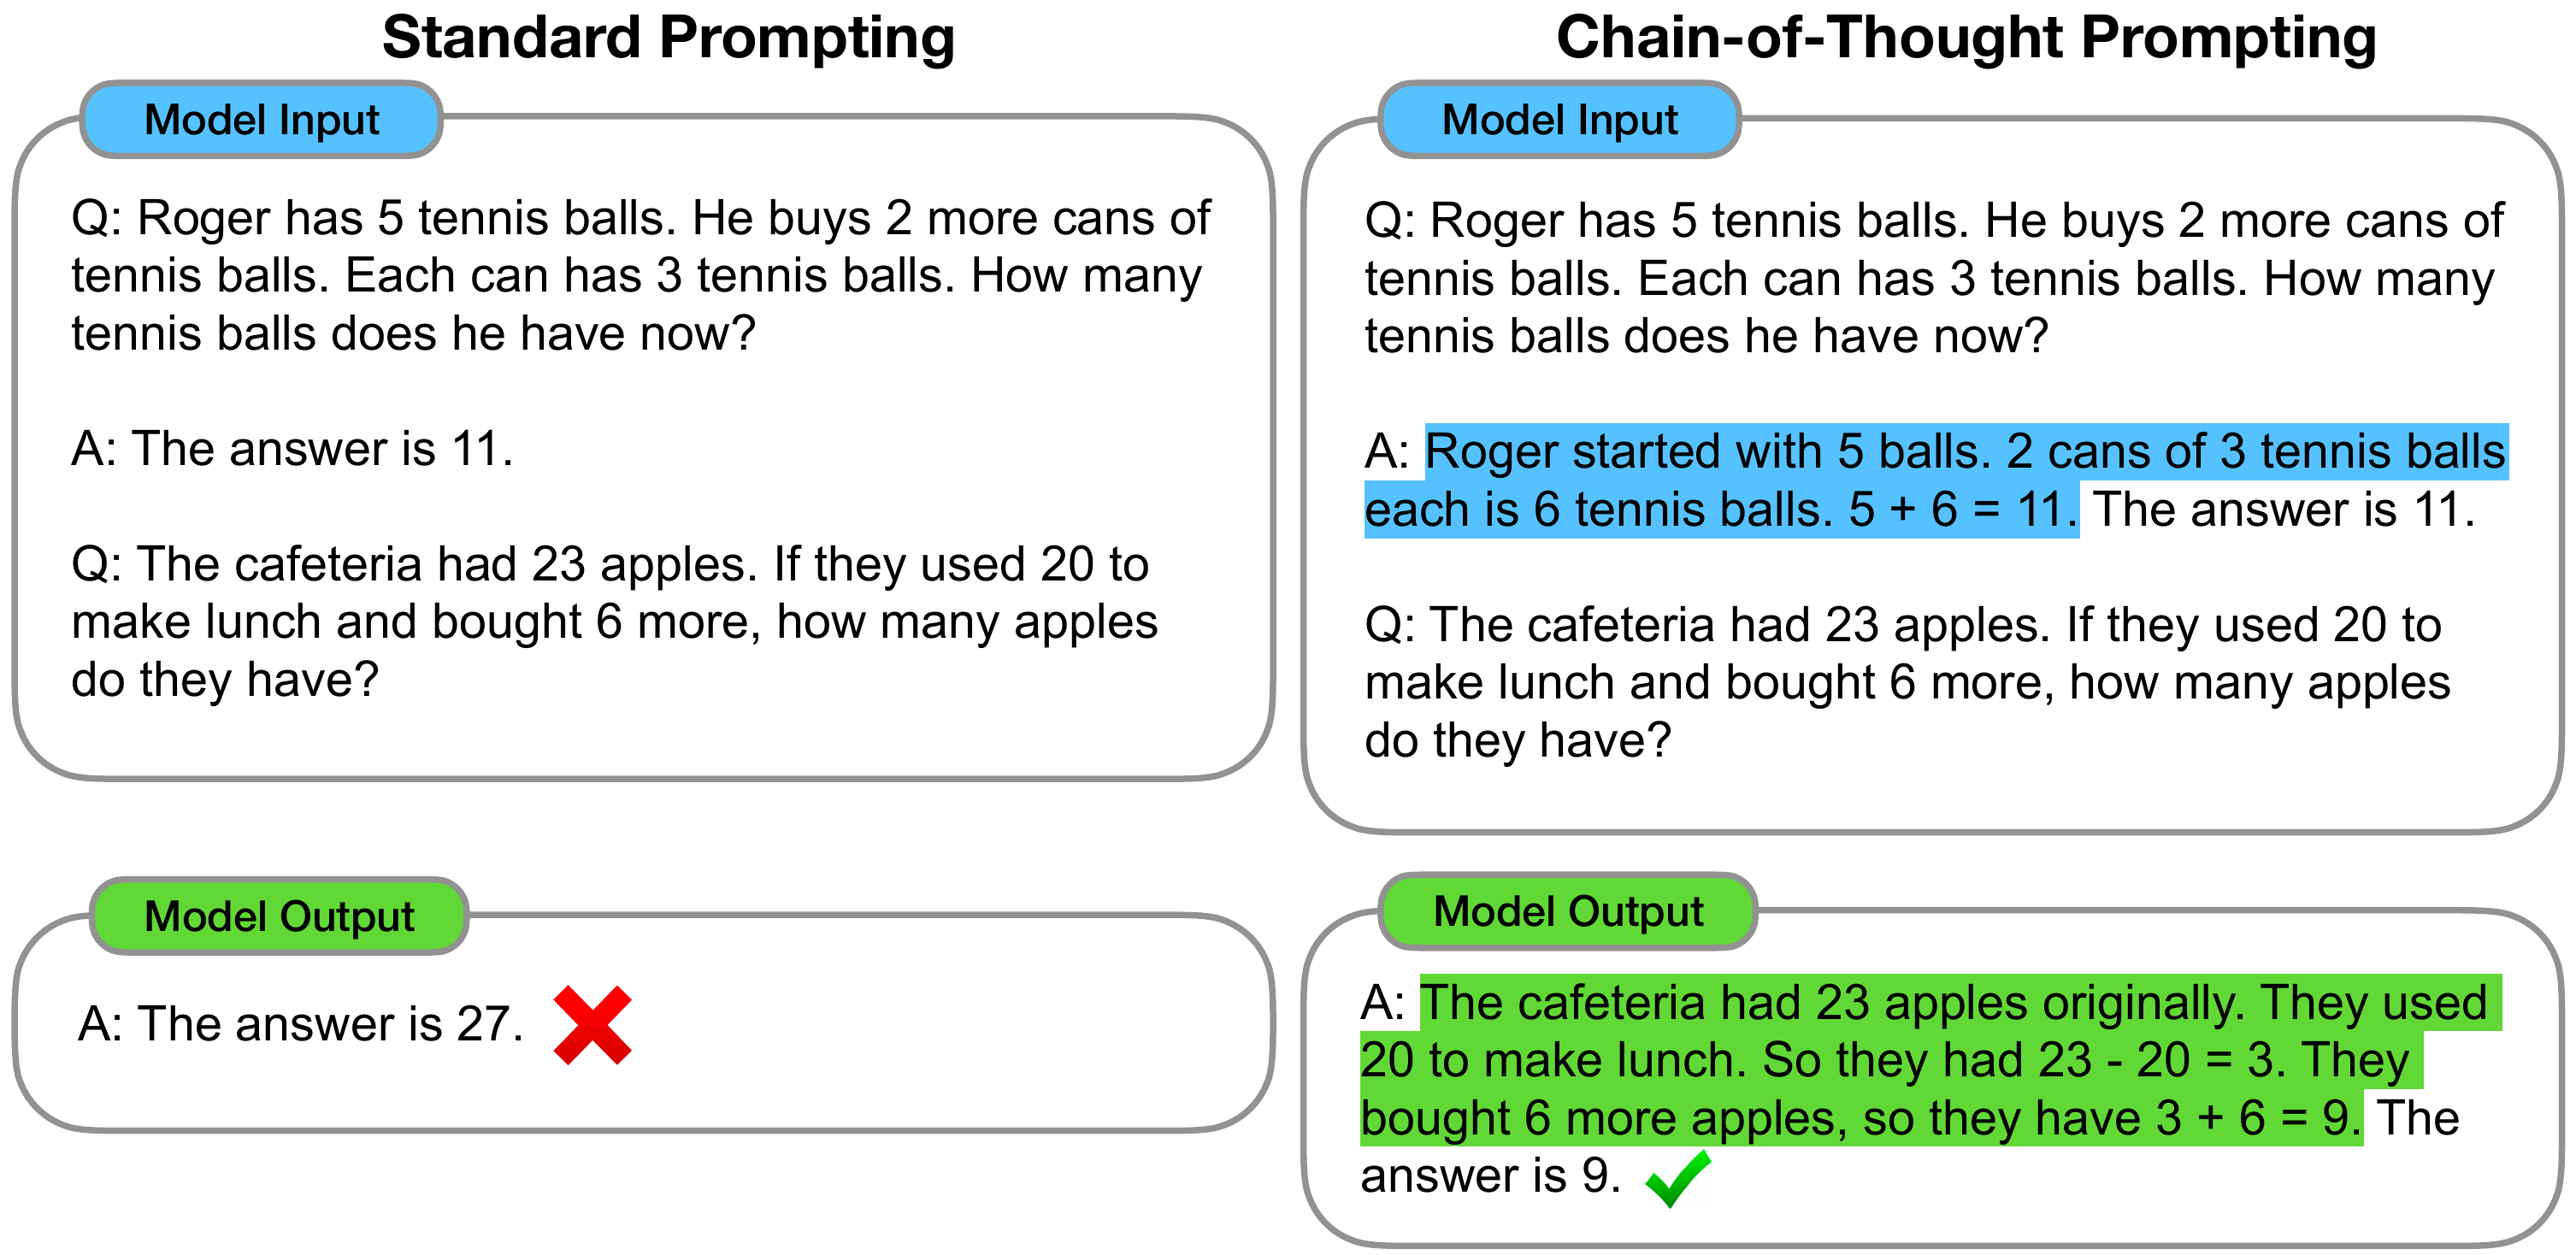
用少量“问题—中间推理—答案”示例,在不更新模型参数的条件下,让足够大的语言模型先生成自然语言中间步骤,再输出答案。论文的真正贡献是一组跨模型、跨任务、跨规模的受控实验证据。
此前的两条路线各有代价:带 rationale 的训练需要大规模高质量推理标注;普通 few-shot prompting 只展示输入与答案,在多步推理任务上常常随规模增长仍保持平坦。本文把两者结合为一种纯推理期方法。
主要算术任务使用八个手写 CoT exemplars;AQuA 使用四个。
PaLM 540B 上的提升最显著,尤其是 GSM8K 与长度外推。
整篇论文只做 prompting-based inference,没有 finetuning。
CoT prompting 在算术、常识与符号推理任务上广泛提高大模型准确率;小模型经常生成流畅但不合逻辑的链条,CoT 甚至降低准确率。
作者把随模型规模突然出现的有效 CoT 表现称为 emergent ability,并提出自然语言中间步骤可分配更多推理计算、提供可调试窗口。
实验直接证明的是“特定提示形式改变可观测输出和任务准确率”。它没有识别模型内部是否执行了与文字链条一致的计算,也没有证明生成的文字是忠实因果解释。
设测试问题为 \(x^{\ast}\),few-shot 示例集为 \(\mathcal D=\{(x_i,r_i,y_i)\}_{i=1}^{K}\)。其中 \(x_i\) 是问题,\(r_i\) 是人工写出的中间推理文本,\(y_i\) 是最终答案,主要设置中的 \(K=8\)。模型参数 \(\theta\) 在实验中保持冻结。
这条式子是对论文推理流程的形式化整理:实际生成序列 \(z\) 先包含 reasoning tokens \(r^{\ast}\),再包含答案 \(y^{\ast}\)。论文没有提出新的训练目标、loss 或模型结构;改变只发生在条件上下文 \(\mathcal D\) 与期望输出格式。
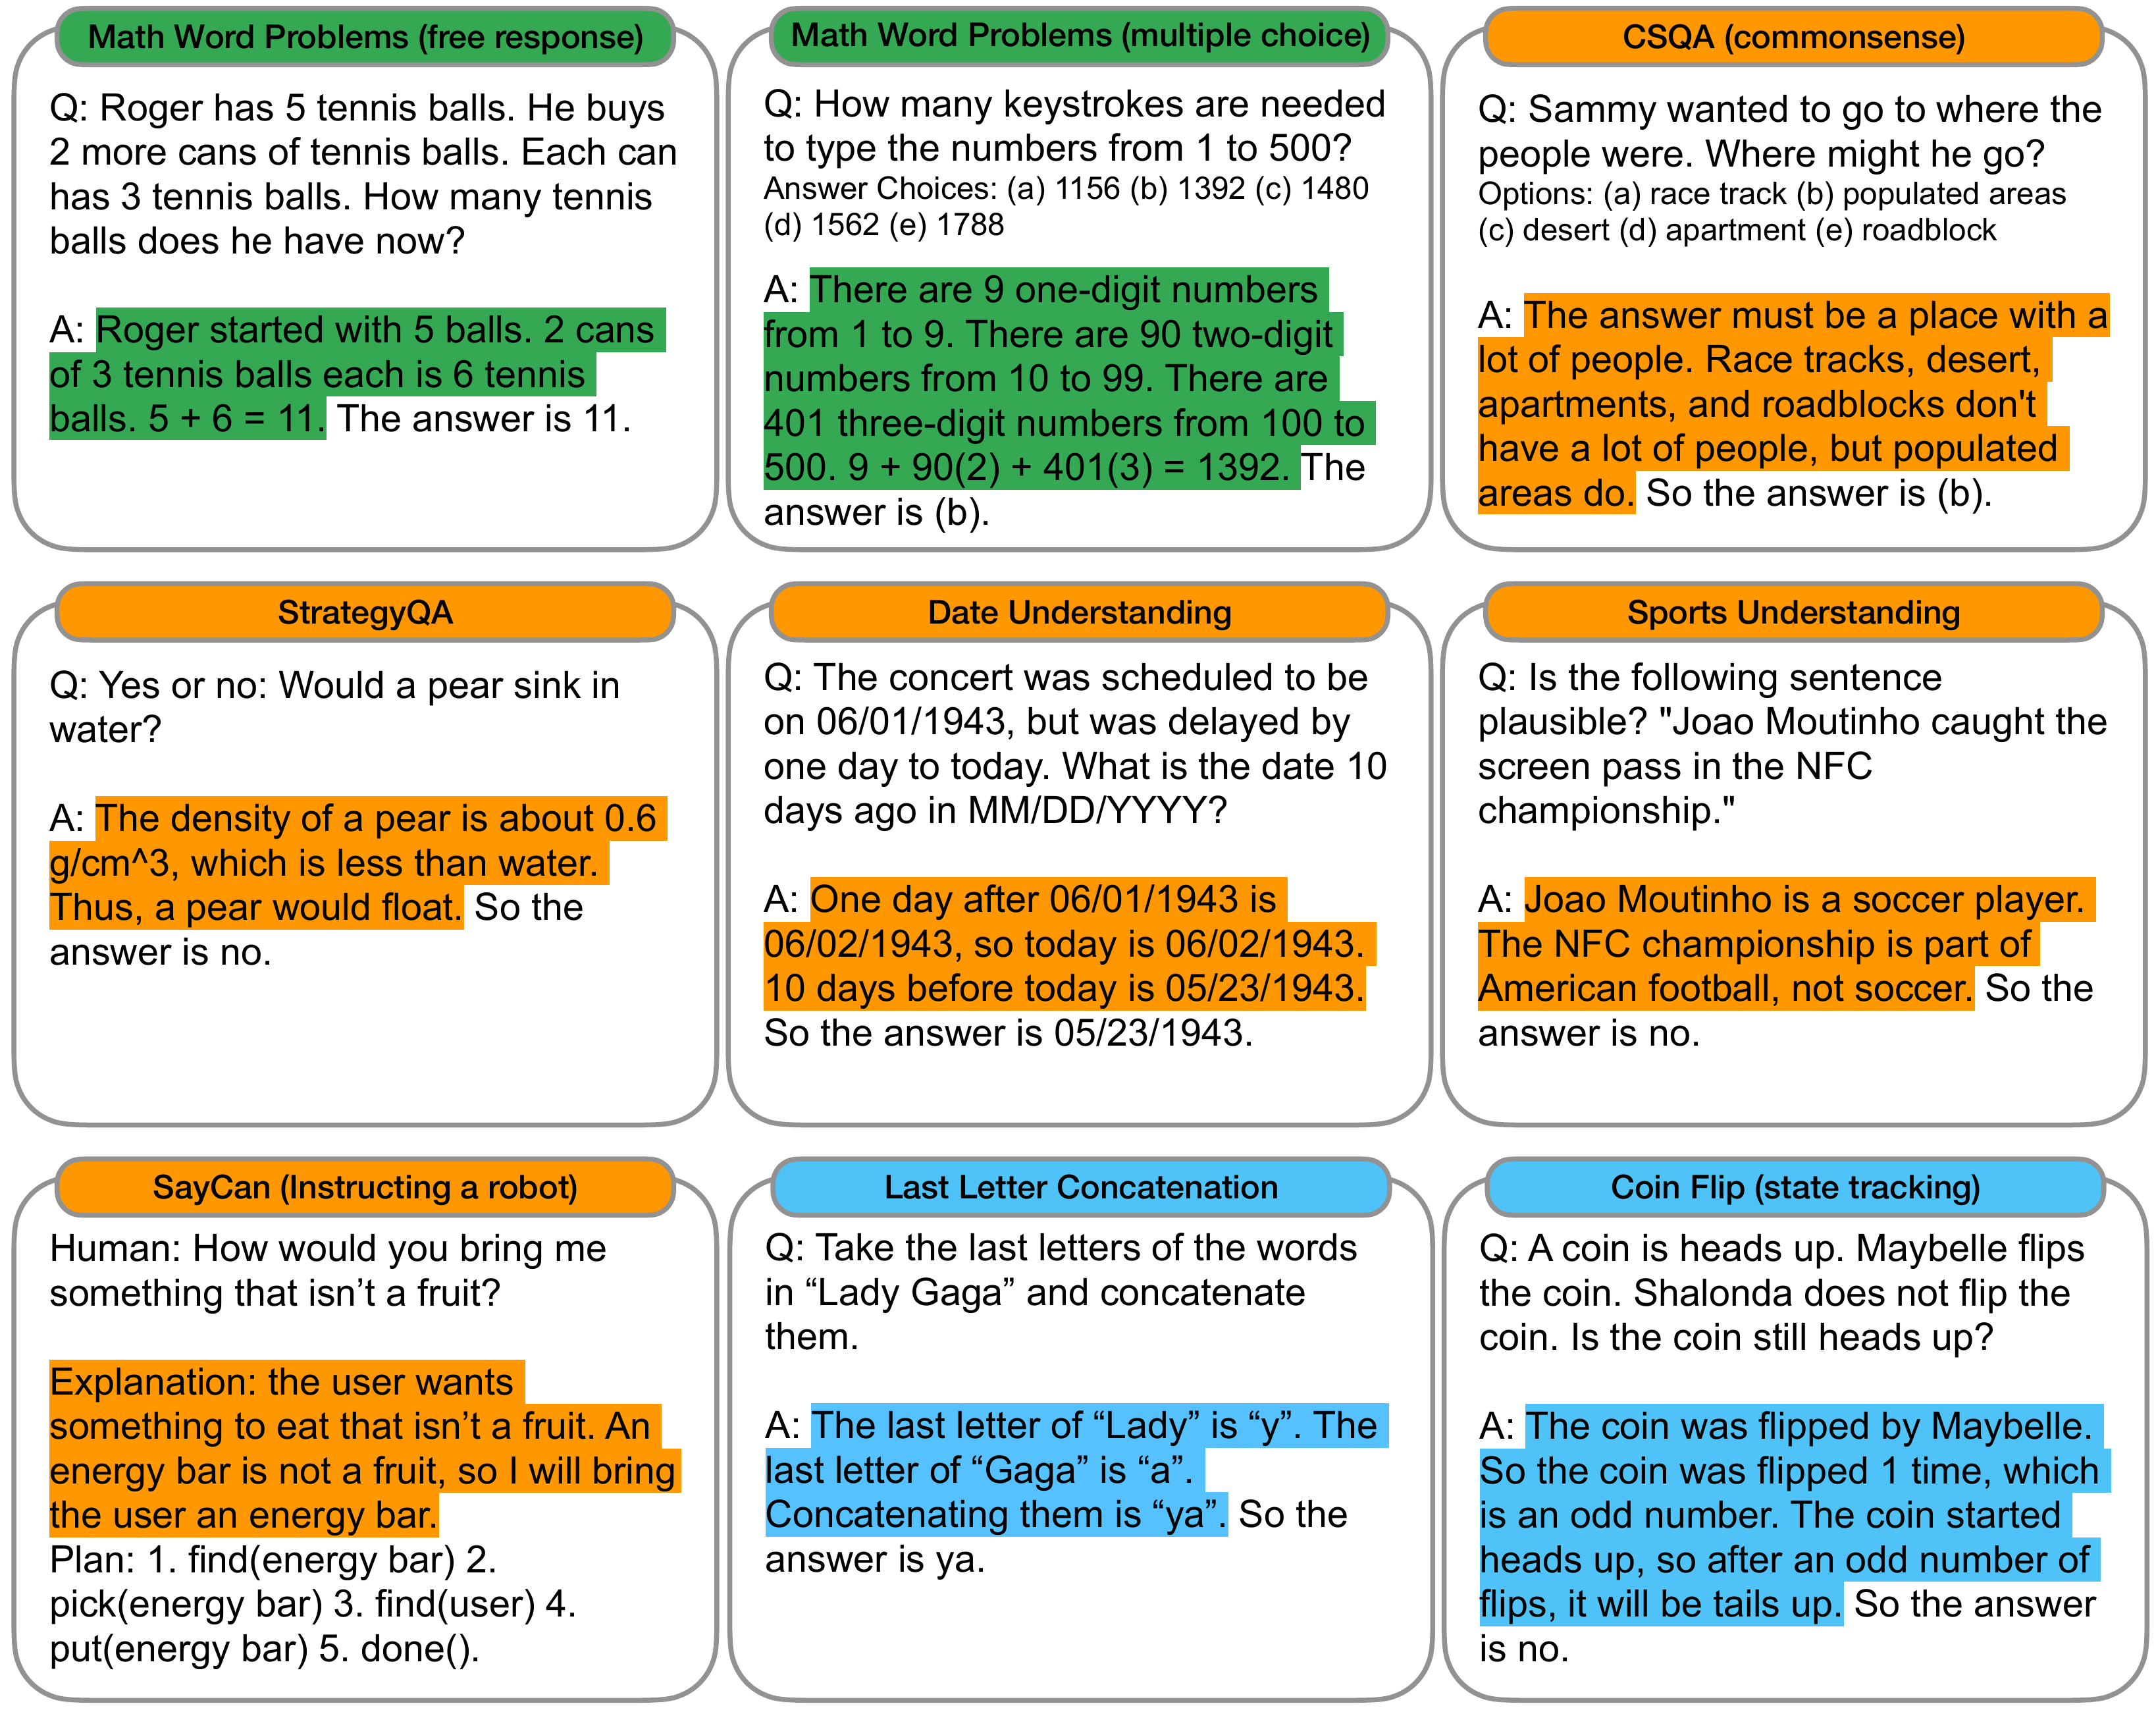
下面按 Appendix G 的八个主算术 exemplars 逐项给出中文释义与计算路径,供理解提示结构。论文实验使用英文原文;复现应从 Appendix G 取得原始上下文及对应 standard / CoT 版本。每个 CoT 示例先写问题,再写文字推理,最后以固定短语 The answer is 接答案;测试问题接在八个示例之后。
standard prompting 保留相同示例问题和最终答案,移除中间推理段。Equation-only 保留计算表达式;variable-compute-only 用点号控制额外输出长度;reasoning-after-answer 把最终答案提前。AQuA 的四个多选示例、各常识任务及符号任务的完整英文提示分别列在 Appendix G 后续表格,任务专用提示不能直接替换为这组算术示例。
论文没有 system prompt、tool description、retry instruction、beam search 或 reranker。推理采用 greedy decoding。LaMDA 的报告值对五种 exemplar 随机排列取平均,其余模型因计算费用只使用一个排列。
GPT 系列使用 text-ada-001、text-babbage-001、text-curie-001、text-davinci-002,论文推测其规模分别约为 350M、1.3B、6.7B、175B;Codex 使用 code-davinci-002。API 的训练细节由原模型决定。
LaMDA:422M、2B、8B、68B、137B;PaLM:8B、62B、540B。另评估 UL2 20B。本文没有训练这些模型,也没有冻结/可训练模块的划分问题。
GSM8K 1,319;SVAMP 1,000;ASDiv 2,096;AQuA 254;MAWPS 共四个子集:562 / 508 / 395 / 600。
CSQA、StrategyQA、BIG-bench Date Understanding、Sports Understanding 与 120 条 SayCan 评估集。
作者合成 Last Letter Concatenation 与 Coin Flip,并构造两步 in-domain、三步和四步 OOD 测试。
LaMDA 137B 推理使用 TPU v3 的 8×8 配置,即 64 chips / 128 cores;PaLM 540B 使用 TPU v4 的 4×4×12 配置,即 192 chips / 384 cores;GPT-3 通过公开 API。论文没有估算总计算量、延迟、token 成本或能耗。
Appendix E 明确写明全篇只进行 prompting-based inference。所谓“training details”在本文中不适用;模型预训练 recipe、optimizer、learning rate、batch size、scheduler、训练时长均不是本论文实验变量。
论文声称补充材料提供 LaMDA 137B 的 exact inputs、targets、predictions;当前 NeurIPS Supplemental PDF 只包含论文 Appendix A–H,没有可执行代码或该 zip 数据。PaLM 与 LaMDA 权重不可公开访问,公开 API 型号也已发生代际变化,因此无法在当前环境逐值重现。
主文的曲线图强调趋势,Appendix B 才给出所有模型规模与数据集数值。下面重建关键原表的全部方法行与指标列。
| 模型 | 提示 | GSM8K | SVAMP | ASDiv | AQuA | MAWPS |
|---|---|---|---|---|---|---|
| Prior best | finetuning | 55 | 57.4 | 75.3 | 37.9 | 88.4 |
| UL2 20B | Standard | 4.1 | 10.1 | 16.0 | 20.5 | 16.6 |
| UL2 20B | CoT | 4.4 (+0.3) | 12.5 (+2.4) | 16.9 (+0.9) | 23.6 (+3.1) | 19.1 (+2.5) |
| UL2 20B | CoT + ext. calc. | 6.9 | 28.3 | 34.3 | 23.6 | 42.7 |
| LaMDA 137B | Standard | 6.5 | 29.5 | 40.1 | 25.5 | 43.2 |
| LaMDA 137B | CoT | 14.3 (+7.8) | 37.5 (+8.0) | 46.6 (+6.5) | 20.6 (-4.9) | 57.9 (+14.7) |
| LaMDA 137B | CoT + ext. calc. | 17.8 | 42.1 | 53.4 | 20.6 | 69.3 |
| GPT-3 175B | Standard | 15.6 | 65.7 | 70.3 | 24.8 | 72.7 |
| GPT-3 175B | CoT | 46.9 (+31.3) | 68.9 (+3.2) | 71.3 (+1.0) | 35.8 (+11.0) | 87.1 (+14.4) |
| GPT-3 175B | CoT + ext. calc. | 49.6 | 70.3 | 71.1 | 35.8 | 87.5 |
| Codex | Standard | 19.7 | 69.9 | 74.0 | 29.5 | 78.7 |
| Codex | CoT | 63.1 (+43.4) | 76.4 (+6.5) | 80.4 (+6.4) | 45.3 (+15.8) | 92.6 (+13.9) |
| Codex | CoT + ext. calc. | 65.4 | 77.0 | 80.0 | 45.3 | 93.3 |
| PaLM 540B | Standard | 17.9 | 69.4 | 72.1 | 25.2 | 79.2 |
| PaLM 540B | CoT | 56.9 (+39.0) | 79.0 (+9.6) | 73.9 (+1.8) | 35.8 (+10.6) | 93.3 (+14.2) |
| PaLM 540B | CoT + ext. calc. | 58.6 | 79.8 | 72.6 | 35.8 | 93.5 |
| 模型 | 规模 | GSM S | GSM CoT | SVAMP S | SVAMP CoT | ASDiv S | ASDiv CoT | AQuA S | AQuA CoT | MAWPS S | MAWPS CoT |
|---|---|---|---|---|---|---|---|---|---|---|---|
| UL2 | 20B | 4.1 | 4.4 | 10.1 | 12.5 | 16.0 | 16.9 | 20.5 | 23.6 | 16.6 | 19.1 |
| LaMDA | 420M | 2.6 | 0.4 | 2.5 | 1.6 | 3.2 | 0.8 | 23.5 | 8.3 | 3.2 | 0.9 |
| LaMDA | 2B | 3.6 | 1.9 | 3.3 | 2.4 | 4.1 | 3.8 | 22.9 | 17.7 | 3.9 | 3.1 |
| LaMDA | 8B | 3.2 | 1.6 | 4.3 | 3.4 | 5.9 | 5.0 | 22.8 | 18.6 | 5.3 | 4.8 |
| LaMDA | 68B | 5.7 | 8.2 | 13.6 | 18.8 | 21.8 | 23.1 | 22.3 | 20.2 | 21.6 | 30.6 |
| LaMDA | 137B | 6.5 | 14.3 | 29.5 | 37.5 | 40.1 | 46.6 | 25.5 | 20.6 | 43.2 | 57.9 |
| GPT | 350M | 2.2 | 0.5 | 1.4 | 0.8 | 2.1 | 0.8 | 18.1 | 8.7 | 2.4 | 1.1 |
| GPT | 1.3B | 2.4 | 0.5 | 1.5 | 1.7 | 2.6 | 1.4 | 12.6 | 4.3 | 3.1 | 1.7 |
| GPT | 6.7B | 4.0 | 2.4 | 6.1 | 3.1 | 8.6 | 3.6 | 15.4 | 13.4 | 8.8 | 3.5 |
| GPT | 175B | 15.6 | 46.9 | 65.7 | 68.9 | 70.3 | 71.3 | 24.8 | 35.8 | 72.7 | 87.1 |
| Codex | code-davinci-002 | 19.7 | 63.1 | 69.9 | 76.4 | 74.0 | 80.4 | 29.5 | 45.3 | 78.7 | 92.6 |
| PaLM | 8B | 4.9 | 4.1 | 15.1 | 16.8 | 23.7 | 25.2 | 19.3 | 21.7 | 26.2 | 30.5 |
| PaLM | 62B | 9.6 | 29.9 | 48.2 | 46.7 | 58.7 | 61.9 | 25.6 | 22.4 | 61.8 | 80.3 |
| PaLM | 540B | 17.9 | 56.9 | 69.4 | 79.0 | 72.1 | 73.9 | 25.2 | 35.8 | 79.2 | 93.3 |
在 PaLM 上,GSM8K 从 standard 的 17.9 升至 CoT 的 56.9,绝对增加 39.0;加入外部 calculator 后为 58.6。LaMDA 420M–8B 上 CoT 普遍下降,68B 开始出现部分收益,137B 的 GSM8K 从 6.5 升至 14.3。这个非单调变化支撑“规模门槛”的描述,但规模同时混入预训练数据、训练计算、模型架构和指令调优差异,不能单独建立参数量的因果作用。
| 模型 | 规模 | SingleOp S | CoT | SingleEq S | CoT | AddSub S | CoT | MultiArith S | CoT |
|---|---|---|---|---|---|---|---|---|---|
| UL2 | 20B | 24.9 | 27.2 | 18.0 | 20.2 | 18.5 | 18.2 | 5.0 | 10.7 |
| LaMDA | 420M | 2.8 | 1.0 | 2.4 | 0.4 | 1.9 | 0.7 | 5.8 | 1.5 |
| LaMDA | 2B | 4.6 | 4.1 | 2.4 | 3.3 | 2.7 | 3.2 | 5.8 | 1.8 |
| LaMDA | 8B | 8.0 | 7.0 | 4.5 | 4.4 | 3.4 | 5.2 | 5.2 | 2.4 |
| LaMDA | 68B | 36.5 | 40.8 | 23.9 | 26.0 | 17.3 | 23.2 | 8.7 | 32.4 |
| LaMDA | 137B | 73.2 | 76.2 | 48.8 | 58.7 | 43.0 | 51.9 | 7.6 | 44.9 |
| GPT | 350M | 3.2 | 1.8 | 2.0 | 0.2 | 2.0 | 1.5 | 2.3 | 0.8 |
| GPT | 1.3B | 5.3 | 3.0 | 2.4 | 1.6 | 2.3 | 1.5 | 2.2 | 0.5 |
| GPT | 6.7B | 13.5 | 3.9 | 8.7 | 4.9 | 8.6 | 2.5 | 4.5 | 2.8 |
| GPT | 175B | 90.9 | 88.8 | 82.7 | 86.6 | 83.3 | 81.3 | 33.8 | 91.7 |
| Codex | code-davinci-002 | 93.1 | 91.8 | 86.8 | 93.1 | 90.9 | 89.1 | 44.0 | 96.2 |
| PaLM | 8B | 41.8 | 46.6 | 29.5 | 28.2 | 29.4 | 31.4 | 4.2 | 15.8 |
| PaLM | 62B | 87.9 | 85.6 | 77.2 | 83.5 | 74.7 | 78.2 | 7.3 | 73.7 |
| PaLM | 540B | 94.1 | 94.1 | 86.5 | 92.3 | 93.9 | 91.9 | 42.2 | 94.7 |
PaLM 540B 在 SingleOp 已有 94.1,CoT 保持 94.1;在 MultiArith 则从 42.2 跃升到 94.7。GPT 175B 与 Codex 在 SingleOp、AddSub 甚至略降,同时在 MultiArith 分别增加 57.9 与 52.2 个百分点。这个分层结果比总体 MAWPS 更直接地支持“多步问题获益更大”。
| 模型 | 规模 | CSQA S | CoT | StrategyQA S | CoT | Date S | CoT | Sports S | CoT | SayCan S | CoT |
|---|---|---|---|---|---|---|---|---|---|---|---|
| UL2 | 20B | 34.2 | 51.4 | 59.0 | 53.3 | 13.5 | 14.0 | 57.9 | 65.3 | 20.0 | 41.7 |
| LaMDA | 420M | 20.1 | 19.2 | 46.4 | 24.9 | 1.9 | 1.6 | 50.0 | 49.7 | 7.5 | 7.5 |
| LaMDA | 2B | 20.2 | 19.6 | 52.6 | 45.2 | 8.0 | 6.8 | 49.3 | 57.5 | 8.3 | 8.3 |
| LaMDA | 8B | 19.0 | 20.3 | 54.1 | 46.8 | 9.5 | 5.4 | 50.0 | 52.1 | 28.3 | 33.3 |
| LaMDA | 68B | 37.0 | 44.1 | 59.6 | 62.2 | 15.5 | 18.6 | 55.2 | 77.5 | 35.0 | 42.5 |
| LaMDA | 137B | 53.6 | 57.9 | 62.4 | 65.4 | 21.5 | 26.8 | 59.5 | 85.8 | 43.3 | 46.6 |
| GPT | 350M | 14.7 | 15.2 | 20.6 | 0.9 | 4.3 | 0.9 | 33.8 | 41.6 | 12.5 | 0.8 |
| GPT | 1.3B | 12.0 | 19.2 | 45.8 | 35.7 | 4.0 | 1.4 | 0.0 | 26.9 | 20.8 | 9.2 |
| GPT | 6.7B | 19.0 | 24.0 | 53.6 | 50.0 | 8.9 | 4.9 | 0.0 | 4.4 | 17.5 | 35.0 |
| GPT | 175B | 79.5 | 73.5 | 65.9 | 65.4 | 43.8 | 52.1 | 69.6 | 82.4 | 81.7 | 87.5 |
| Codex | code-davinci-002 | 82.3 | 77.9 | 67.1 | 73.2 | 49.0 | 64.8 | 71.7 | 98.5 | 85.8 | 88.3 |
| PaLM | 8B | 19.8 | 24.9 | 55.6 | 53.5 | 12.9 | 13.1 | 55.1 | 75.2 | 34.2 | 40.0 |
| PaLM | 62B | 65.4 | 68.1 | 58.4 | 63.4 | 29.8 | 44.7 | 72.1 | 93.6 | 65.8 | 70.0 |
| PaLM | 540B | 78.1 | 79.9 | 68.6 | 77.8 | 49.0 | 65.3 | 80.5 | 95.4 | 80.8 | 91.7 |
PaLM 540B 的 CoT 在 StrategyQA 从 68.6 升至 77.8,在 Sports 从 80.5 升至 95.4,在 SayCan 从 80.8 升至 91.7;CSQA 只有 1.8 点收益。GPT 175B 的 CSQA 和 StrategyQA 还分别下降 6.0 与 0.5 点,因此“跨任务普遍有效”需要限定到模型与任务组合。
| 模型 | 规模 | Concat 2 S | CoT | OOD 3 S | CoT | OOD 4 S | CoT | Coin 2 S | CoT | OOD 3 S | CoT | OOD 4 S | CoT |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| UL2 | 20B | 0.6 | 18.8 | 0.0 | 0.2 | 0.0 | 0.0 | 70.4 | 67.1 | 51.6 | 52.2 | 48.7 | 50.4 |
| LaMDA | 420M | 0.3 | 1.6 | 0.0 | 0.0 | 0.0 | 0.0 | 52.9 | 49.6 | 50.0 | 50.5 | 49.5 | 49.1 |
| LaMDA | 2B | 2.3 | 6.0 | 0.0 | 0.0 | 0.0 | 0.0 | 54.9 | 55.3 | 47.4 | 48.7 | 49.8 | 50.2 |
| LaMDA | 8B | 1.5 | 11.5 | 0.0 | 0.0 | 0.0 | 0.0 | 52.9 | 55.5 | 48.2 | 49.6 | 51.2 | 50.6 |
| LaMDA | 68B | 4.4 | 52.0 | 0.0 | 0.8 | 0.0 | 2.5 | 56.2 | 83.2 | 50.4 | 69.1 | 50.9 | 59.6 |
| LaMDA | 137B | 5.8 | 77.5 | 0.0 | 34.4 | 0.0 | 13.5 | 49.0 | 99.6 | 50.7 | 91.0 | 49.1 | 74.5 |
| PaLM | 8B | 2.6 | 18.8 | 0.0 | 0.0 | 0.0 | 0.2 | 60.0 | 74.4 | 47.3 | 57.1 | 50.9 | 51.8 |
| PaLM | 62B | 6.8 | 85.0 | 0.0 | 59.6 | 0.0 | 13.4 | 91.4 | 96.8 | 43.9 | 91.0 | 38.3 | 72.4 |
| PaLM | 540B | 7.6 | 99.4 | 0.2 | 94.8 | 0.0 | 63.0 | 98.1 | 100.0 | 49.3 | 98.6 | 54.8 | 90.2 |
PaLM 540B 在四词 last-letter OOD 上从 0.0 升至 63.0,在四步 coin flip OOD 上从 54.8 升至 90.2。标准提示在 last-letter OOD 几乎完全失败。这里的外推只覆盖同一合成规则下从两步到三、四步,不能直接推广到更长链条或开放域组合推理。
| 设置 | GSM8K | SVAMP | ASDiv | MAWPS |
|---|---|---|---|---|
| Standard | 6.5 ± 0.4 | 29.5 ± 0.6 | 40.1 ± 0.6 | 43.2 ± 0.9 |
| CoT | 14.3 ± 0.4 | 36.7 ± 0.4 | 46.6 ± 0.7 | 57.9 ± 1.5 |
| Equation only | 5.4 ± 0.2 | 35.1 ± 0.4 | 45.9 ± 0.6 | 50.1 ± 1.0 |
| Variable compute only | 6.4 ± 0.3 | 28.0 ± 0.6 | 39.4 ± 0.4 | 41.3 ± 1.1 |
| Reasoning after answer | 6.1 ± 0.4 | 30.7 ± 0.9 | 38.6 ± 0.6 | 43.6 ± 1.0 |
| Annotator B | 15.5 ± 0.6 | 35.2 ± 0.4 | 46.5 ± 0.4 | 58.2 ± 1.0 |
| Annotator C | 17.6 ± 1.0 | 37.5 ± 2.0 | 48.7 ± 0.7 | 60.1 ± 2.0 |
| Concise | 11.1 ± 0.3 | 38.7 ± 0.8 | 48.0 ± 0.3 | 59.6 ± 0.7 |
| GSM8K exemplars α | 12.6 ± 0.6 | 32.8 ± 1.1 | 44.1 ± 0.9 | 53.9 ± 1.1 |
| GSM8K exemplars β | 12.7 ± 0.5 | 34.8 ± 1.1 | 46.9 ± 0.6 | 60.9 ± 0.8 |
| GSM8K exemplars γ | 12.6 ± 0.7 | 35.6 ± 0.5 | 44.4 ± 2.6 | 54.2 ± 4.7 |
| 设置 | Date | Sports | SayCan | Concat | Coin |
|---|---|---|---|---|---|
| Standard | 21.5 ± 0.6 | 59.5 ± 3.0 | 80.8 ± 1.8 | 5.8 ± 0.6 | 49.0 ± 2.1 |
| CoT | 26.8 ± 2.1 | 85.8 ± 1.8 | 91.7 ± 1.4 | 77.5 ± 3.8 | 99.6 ± 0.3 |
| Variable compute only | 21.3 ± 0.7 | 61.6 ± 2.2 | 74.2 ± 2.3 | 7.2 ± 1.6 | 50.7 ± 0.7 |
| Reasoning after answer | 20.9 ± 1.0 | 63.0 ± 2.0 | 83.3 ± 0.6 | 0.0 ± 0.0 | 50.2 ± 0.5 |
| Annotator B | 27.4 ± 1.7 | 75.4 ± 2.7 | 88.3 ± 1.4 | 76.0 ± 1.9 | 77.5 ± 7.9 |
| Annotator C | 25.5 ± 2.5 | 81.1 ± 3.6 | 85.0 ± 1.8 | 68.1 ± 2.2 | 71.4 ± 11.1 |
只要求模型先写等式,在 GSM8K 上为 5.4,低于 standard 的 6.5 和 CoT 的 14.3;在 SVAMP、ASDiv、MAWPS 上处于 standard 与 CoT 之间。这说明自然语言语义分解对复杂 GSM8K 特别重要,同时也说明短算术任务的一部分收益可由显式等式承担。
用与等式字符数相同的点号扩展输出长度。GSM8K 为 6.4,接近 standard 6.5;Date、Coin 等也接近基线。实验排除了“只要多生成 token 就会提高准确率”这一简单解释,但它没有等价控制自然语言 token 的条件分布、结构或语义信息。
先给答案,再生成 reasoning。GSM8K 为 6.1,接近 standard;Concat 甚至为 0.0。它表明推理文本必须位于最终答案之前才能在自回归生成中影响答案 token,也反驳了单纯激活知识的解释。
三位共同作者写出的 CoT、精简版本以及三组 GSM8K crowd-worker exemplars,大多仍显著超过 standard。与此同时,Coin 的不同 annotator 可从 99.6 降到 71.4,且 Annotator C 的排列标准差达到 11.1;作者还报告两个共同作者写不出有效的五项 reverse-list prompt,第三位作者才成功。鲁棒性成立于所测条件内,提示工程仍然关键。
最有说服力的证据组合是:位置消融证明 reasoning 必须先于答案,点号控制证明额外 token 数量不够,MAWPS 分层证明收益随步骤复杂度增长,跨 annotator 实验说明结果不依赖唯一措辞。仍缺少随机生成但语法匹配的 rationale、错误 rationale、答案泄露控制和严格 token-budget 匹配。
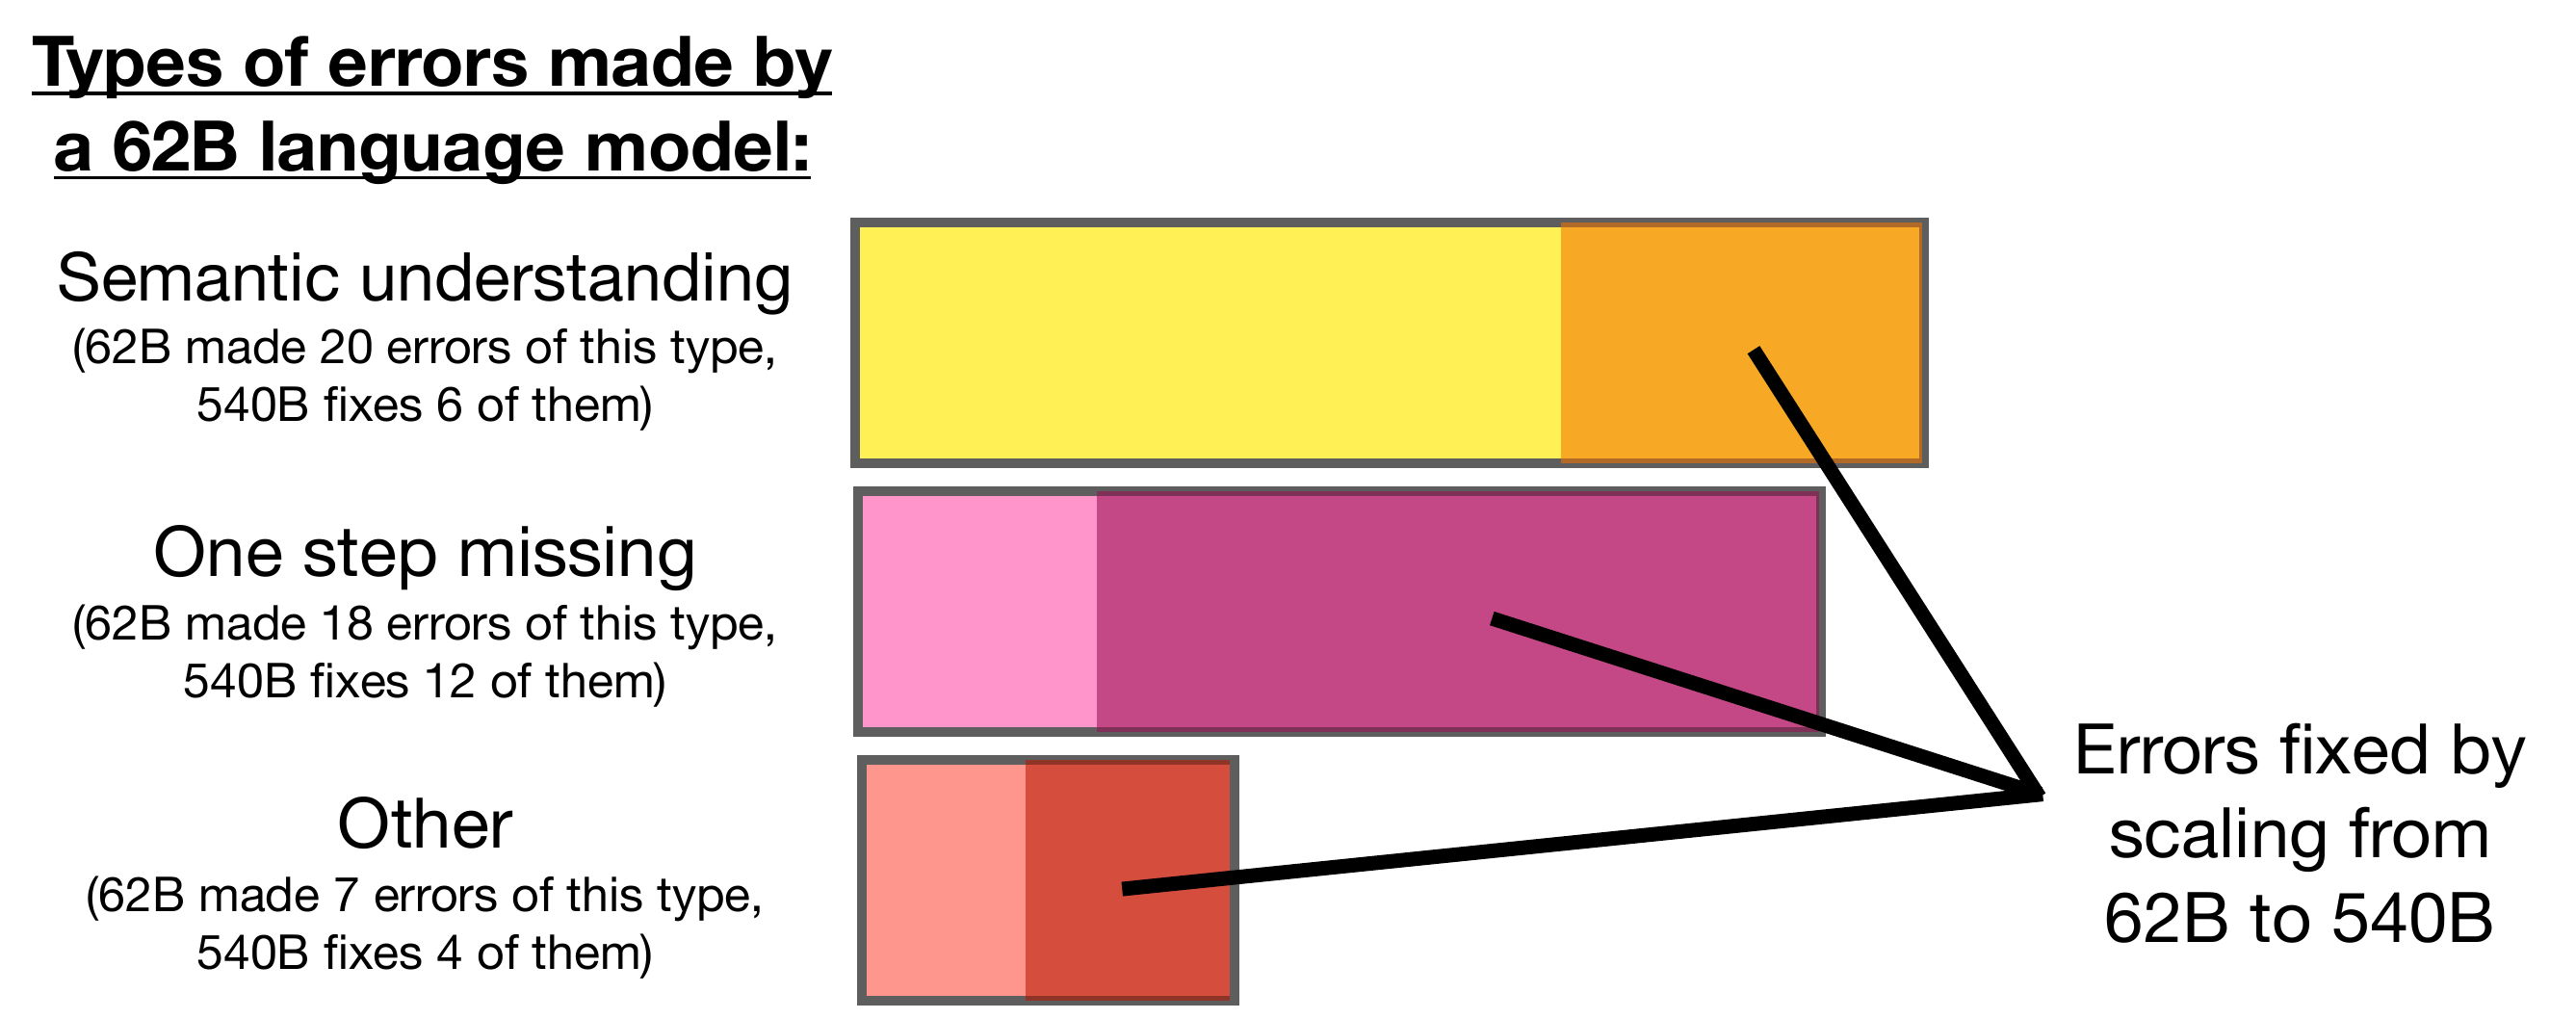
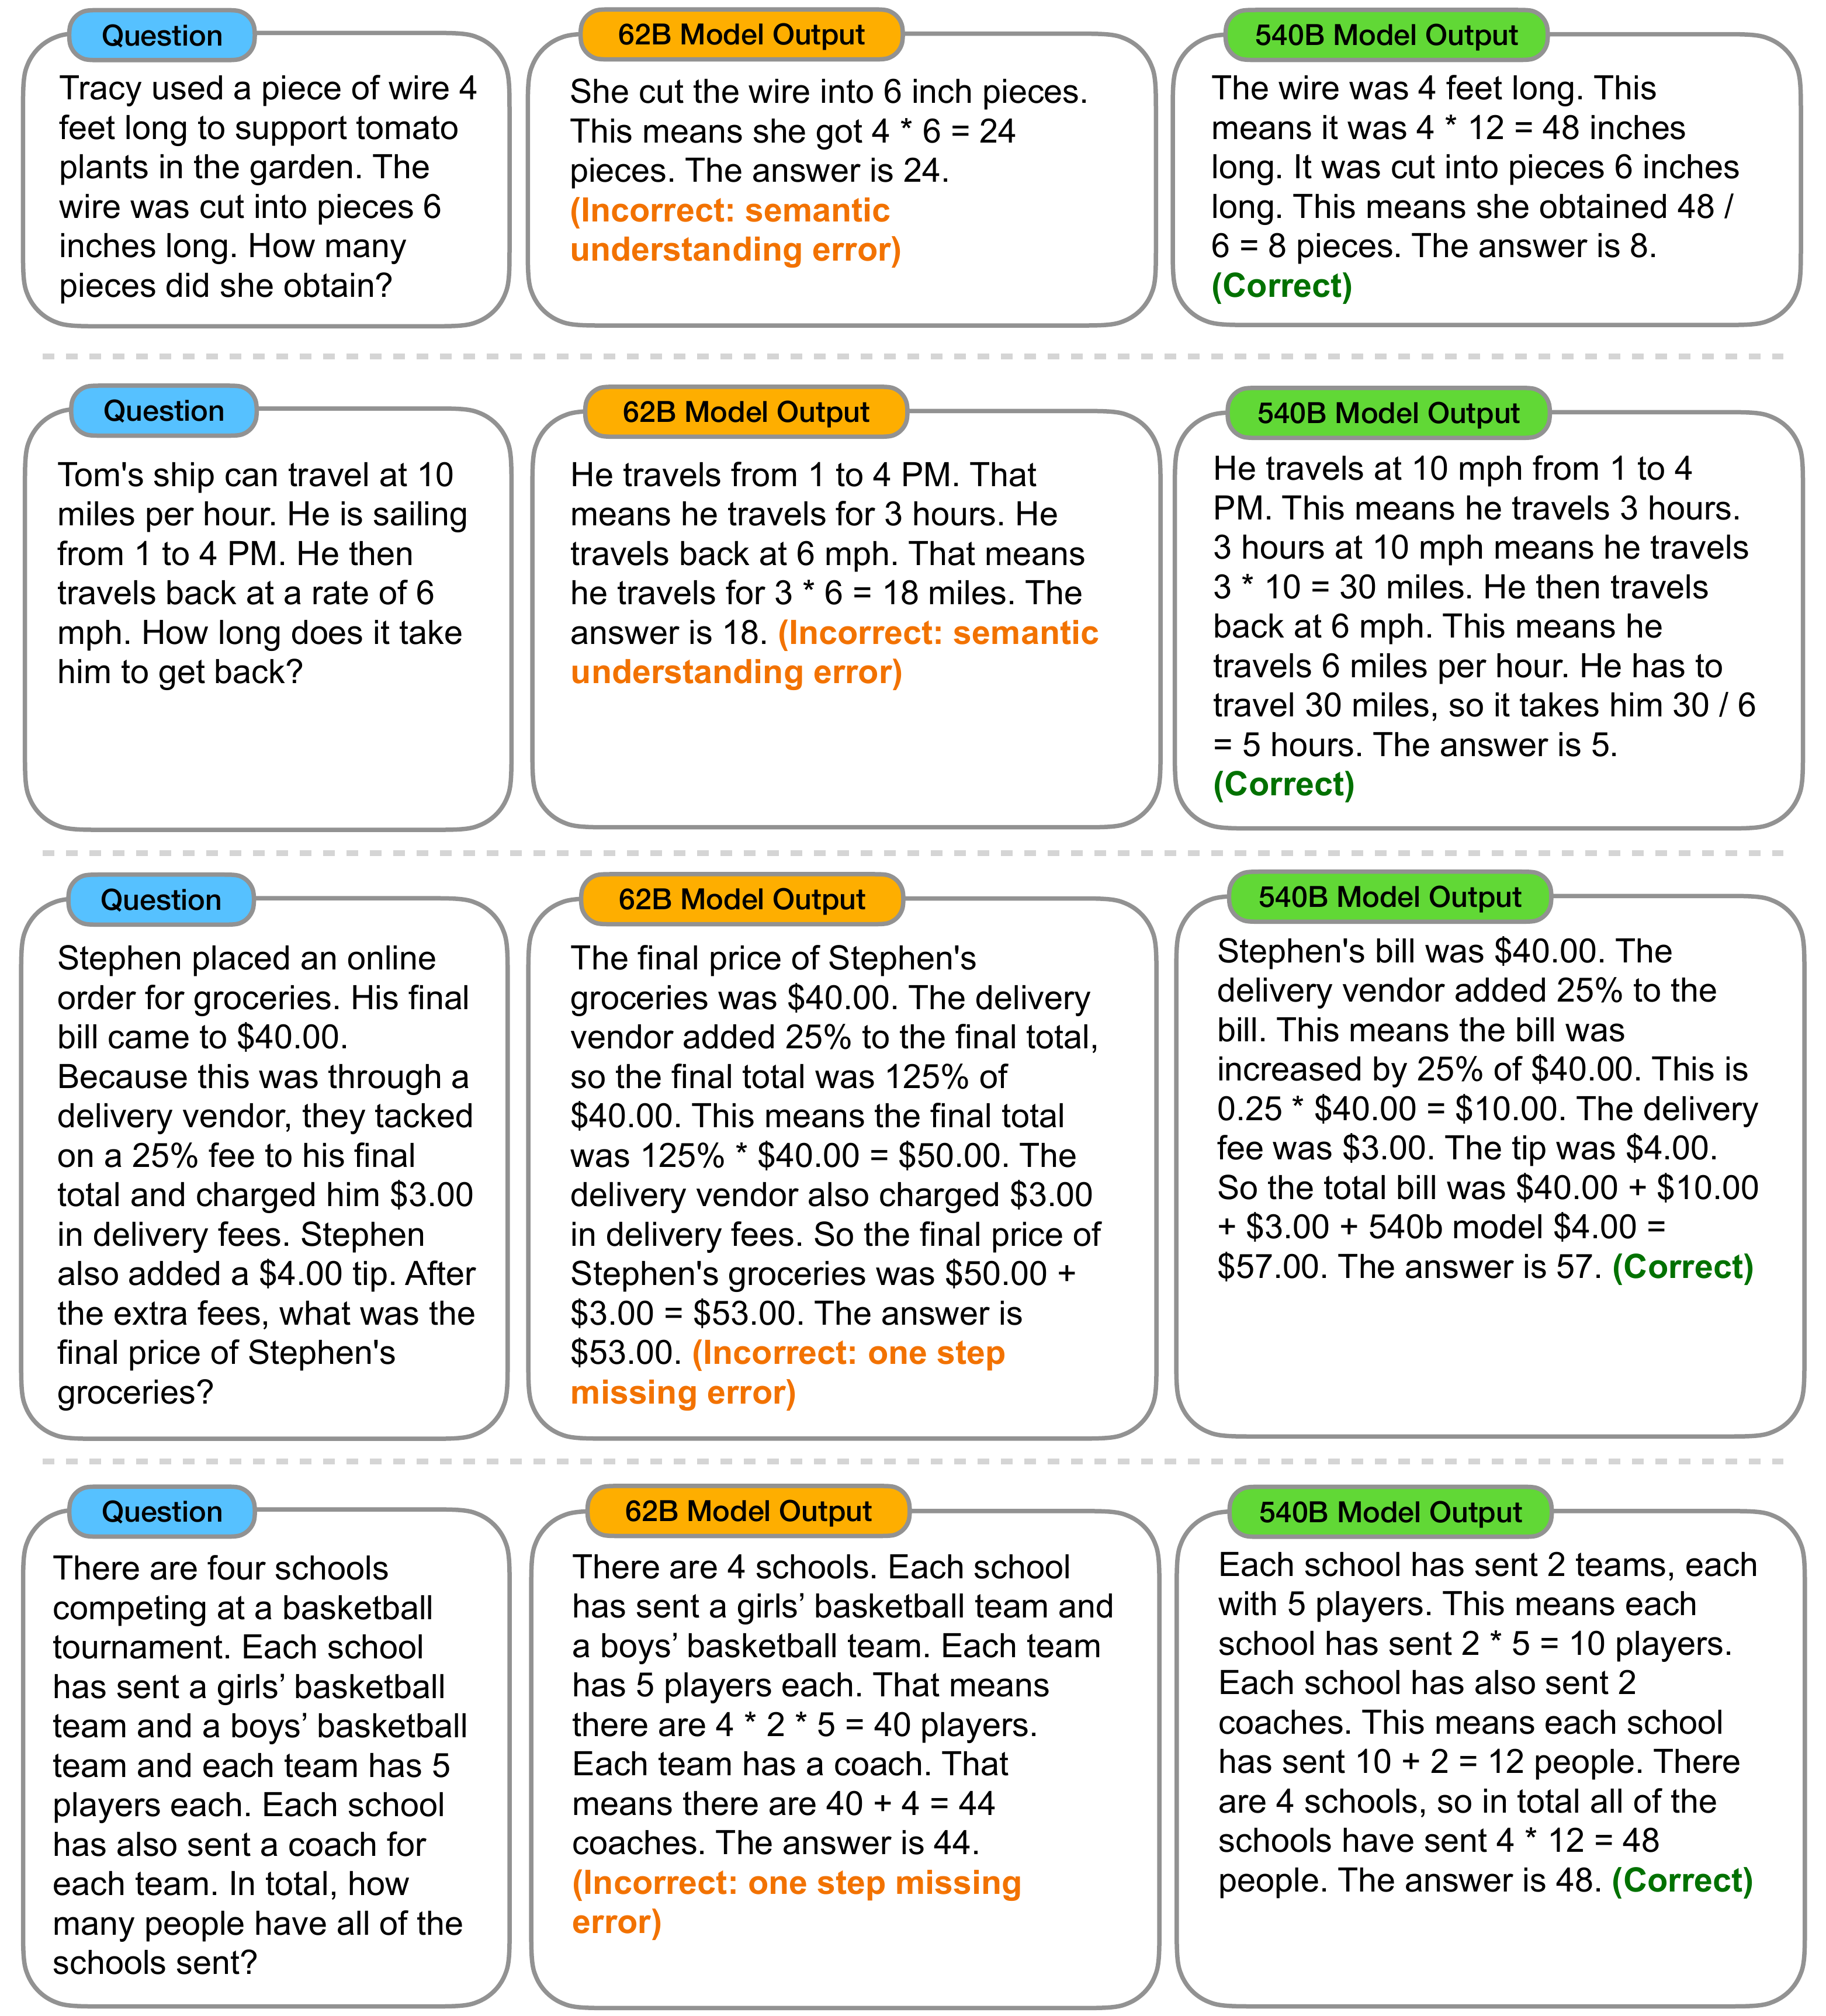
作者随机检查 50 个最终答案正确的样本:43 个被认为与人工 ground truth 等价,另有 7 个显著瑕疵,其中 1 个偶然得到正确答案,其他包括陈述不充分、无关陈述、等式漏写和语义倒置。这里对“正确链条”的判断来自作者人工分析,没有盲评或 inter-annotator agreement。
另检查 50 个最终答案错误的样本:8% 只含 calculator error,16% 只需修正 symbol mapping,22% 只漏一个步骤,剩余 54% 需要实质性修改;其中 8 个还含不连贯推理。34% 的错误样本包含算术错误与其他错误的组合。
这一复算与附录叙述的 23 个“轻微可修复”和 27 个“重大错误”一致。值得注意的是,Appendix D.2 写 LaMDA 137B 的 external calculator 将 GSM8K 从 14.3 提到 17.3,而 Table 1 给出 17.8;网页保留这项论文内部数值差异。
作者使用 Python eval 对生成链条里的算术表达式进行后处理,并通过字符串匹配把前一等式结果传给后续等式。它只校正算术执行,不能修正语义解析、变量对应、漏步骤或幻觉。其效果在 UL2 上很大,例如 MAWPS 从 19.1 到 42.7,说明 Table 1 的“CoT + calculator”同时包含语言推理与外部执行两个组件。
chain of thought 提供观察模型如何得到答案的窗口,并有助于定位错误。
论文自己明确承认,尚未完整刻画支撑答案的内部计算。生成理由具有可读性,不等同于 faithfulness;二分类和多选任务尤其容易出现错误理由碰巧命中答案。
eval 与字符串传播的解析细节没有完整算法或代码,且 17.3 / 17.8 存在内部不一致。对于 Agent 与程序生成,可把文字 CoT 替换为可执行中间状态:每一步生成 action,环境返回 observation,validator 检查约束,再决定继续、修复或回溯。这样能够把“可读 reasoning”升级为“可验证 trajectory”,并分别评价最终任务成功率与中间状态正确率。
对于 procedural material generation,可采用层级计划 \(r_{1:H}\) 指定材质结构与节点意图,再生成图程序 \(G=(V,E,\phi)\);每步执行渲染 \(I_t=R(G_t)\) 并基于视觉与图合法性反馈修复。这是从本文“先推理、后答案”原则推导出的研究设想,论文没有进行相关实验。
给定固定 prompts,若干大模型和任务上的 final-answer accuracy 显著提升;Table 1–7 与原图提供直接数据。
CoT 让模型分解问题、按难度分配额外计算,并可能拓展语言模型能够完成的任务集合。
MAWPS 分层与 token-count 消融共同支持“语义化中间步骤”解释;faithfulness 与真实内部推理机制仍未被检验。
把自然语言链条转成带执行反馈、验证器与回溯的可检查轨迹,是面向 Agent 和图程序生成的后续方向。
作者身份:PDF 首页列 Jason Wei、Xuezhi Wang、Dale Schuurmans、Maarten Bosma、Brian Ichter、Fei Xia、Ed H. Chi、Quoc V. Le、Denny Zhou;机构为 Google Research, Brain Team。首页只给 {jasonwei,dennyzhou}@google.com,没有星号或“corresponding author”标签,因此 Denny Zhou 继续作为末位通讯候选并标记 unverified。