研究缺口
依赖 2D diffusion prior 的 SDS 路线拥有丰富外观知识,却常见 Janus、多视图不一致、长时间优化和几何控制薄弱;直接在 3D 数据上训练的路线更理解形状,受限于数据质量、表示成本与模型规模。
A Controllable Large-scale Generative Model for Creating High-quality 3D Assets
一套把 3D 原生几何生成、跨模态控制与 2K PBR 材质合并到资产生产流程中的大型生成系统。
论文将几何与外观拆成两个连续阶段:先用 3D 原生 latent diffusion 生成完整几何,再用多视图扩散生成 diffuse、roughness 与 metallic 材质。核心研究假设是:经过统一化的大规模 3D 数据、可扩展的 latent set 表示和纯 Transformer 去噪器,能够把 3D 原生生成推进到足以支撑多种控制方式的基础模型水平。
依赖 2D diffusion prior 的 SDS 路线拥有丰富外观知识,却常见 Janus、多视图不一致、长时间优化和几何控制薄弱;直接在 3D 数据上训练的路线更理解形状,受限于数据质量、表示成本与模型规模。
几何生成完全在 3D latent space 中完成。外观由独立的 multi-view Material Diffusion 生成,再回投到 UV 空间。该分工让几何控制与 PBR 外观可以分别扩展。
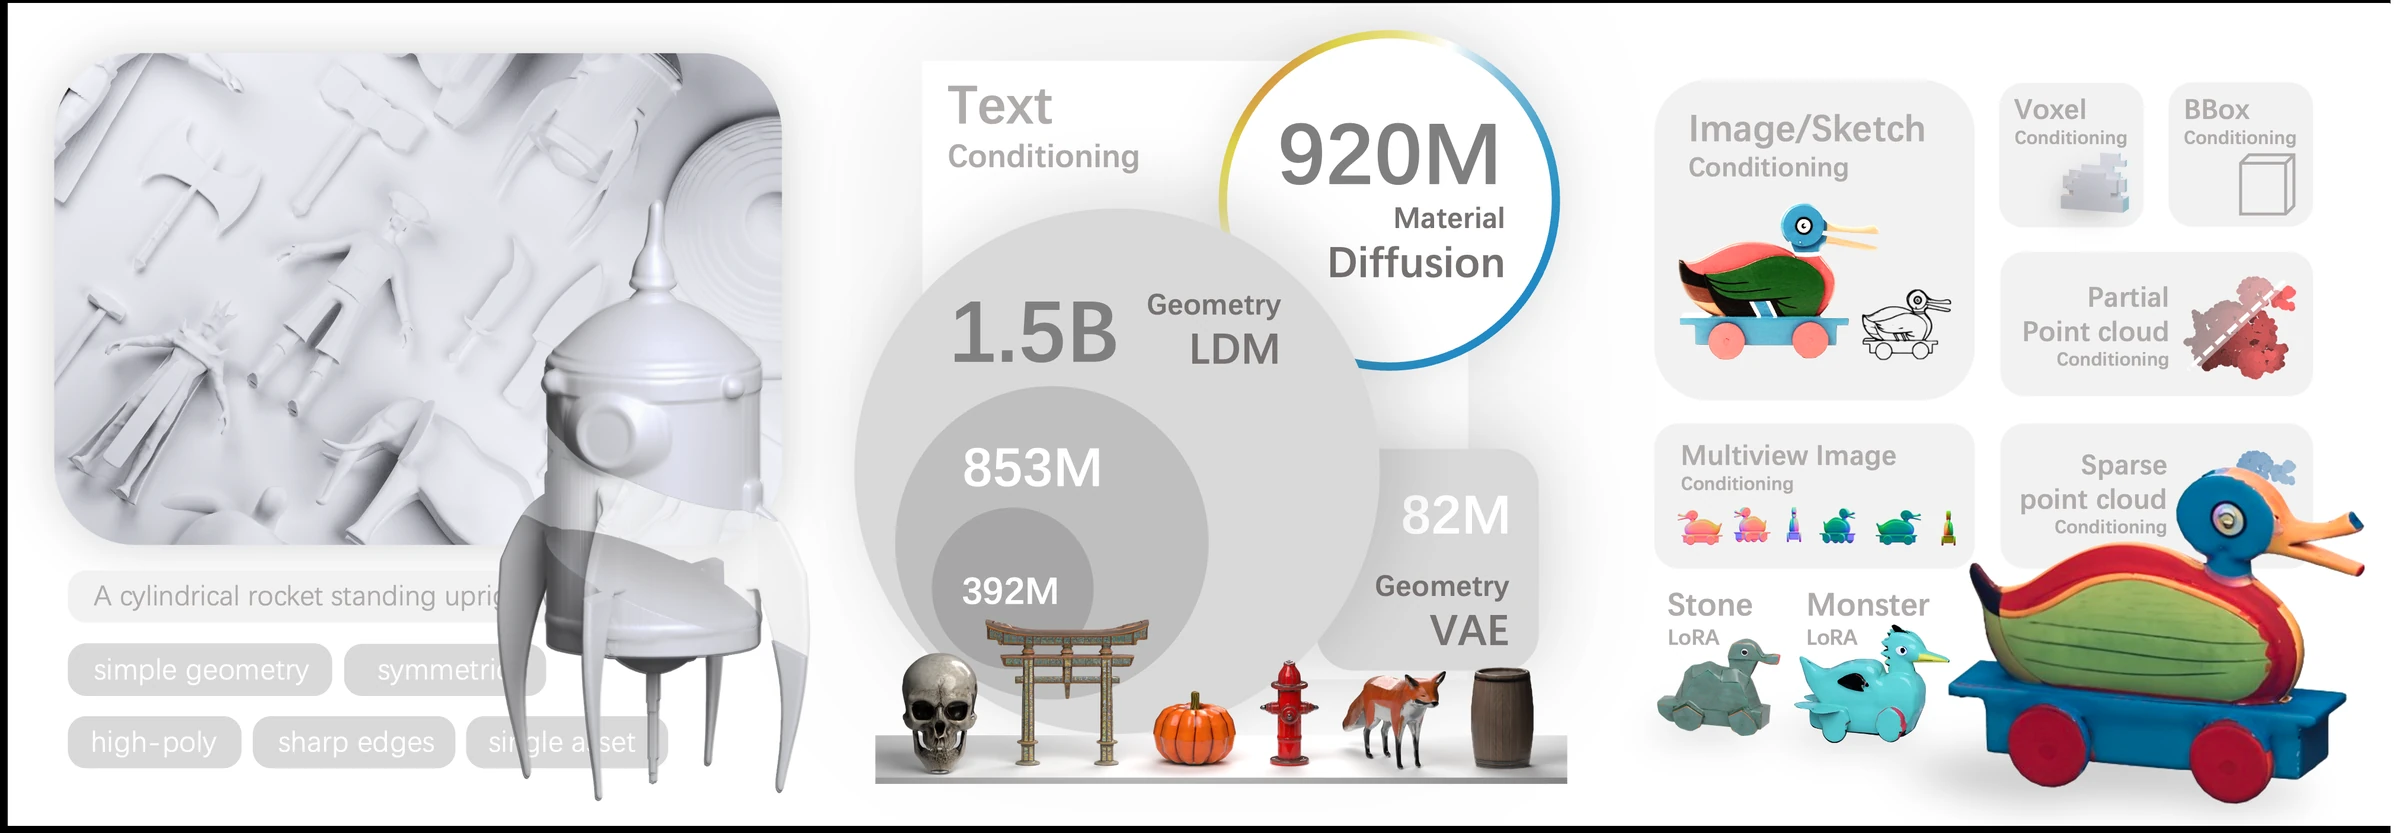
多分辨率 VAE、最高 1.5B 参数的 coarse-to-fine DiT、527K 统一化训练对象、多种 2D/3D 条件适配,以及输出 2K PBR 贴图的资产增强流程。
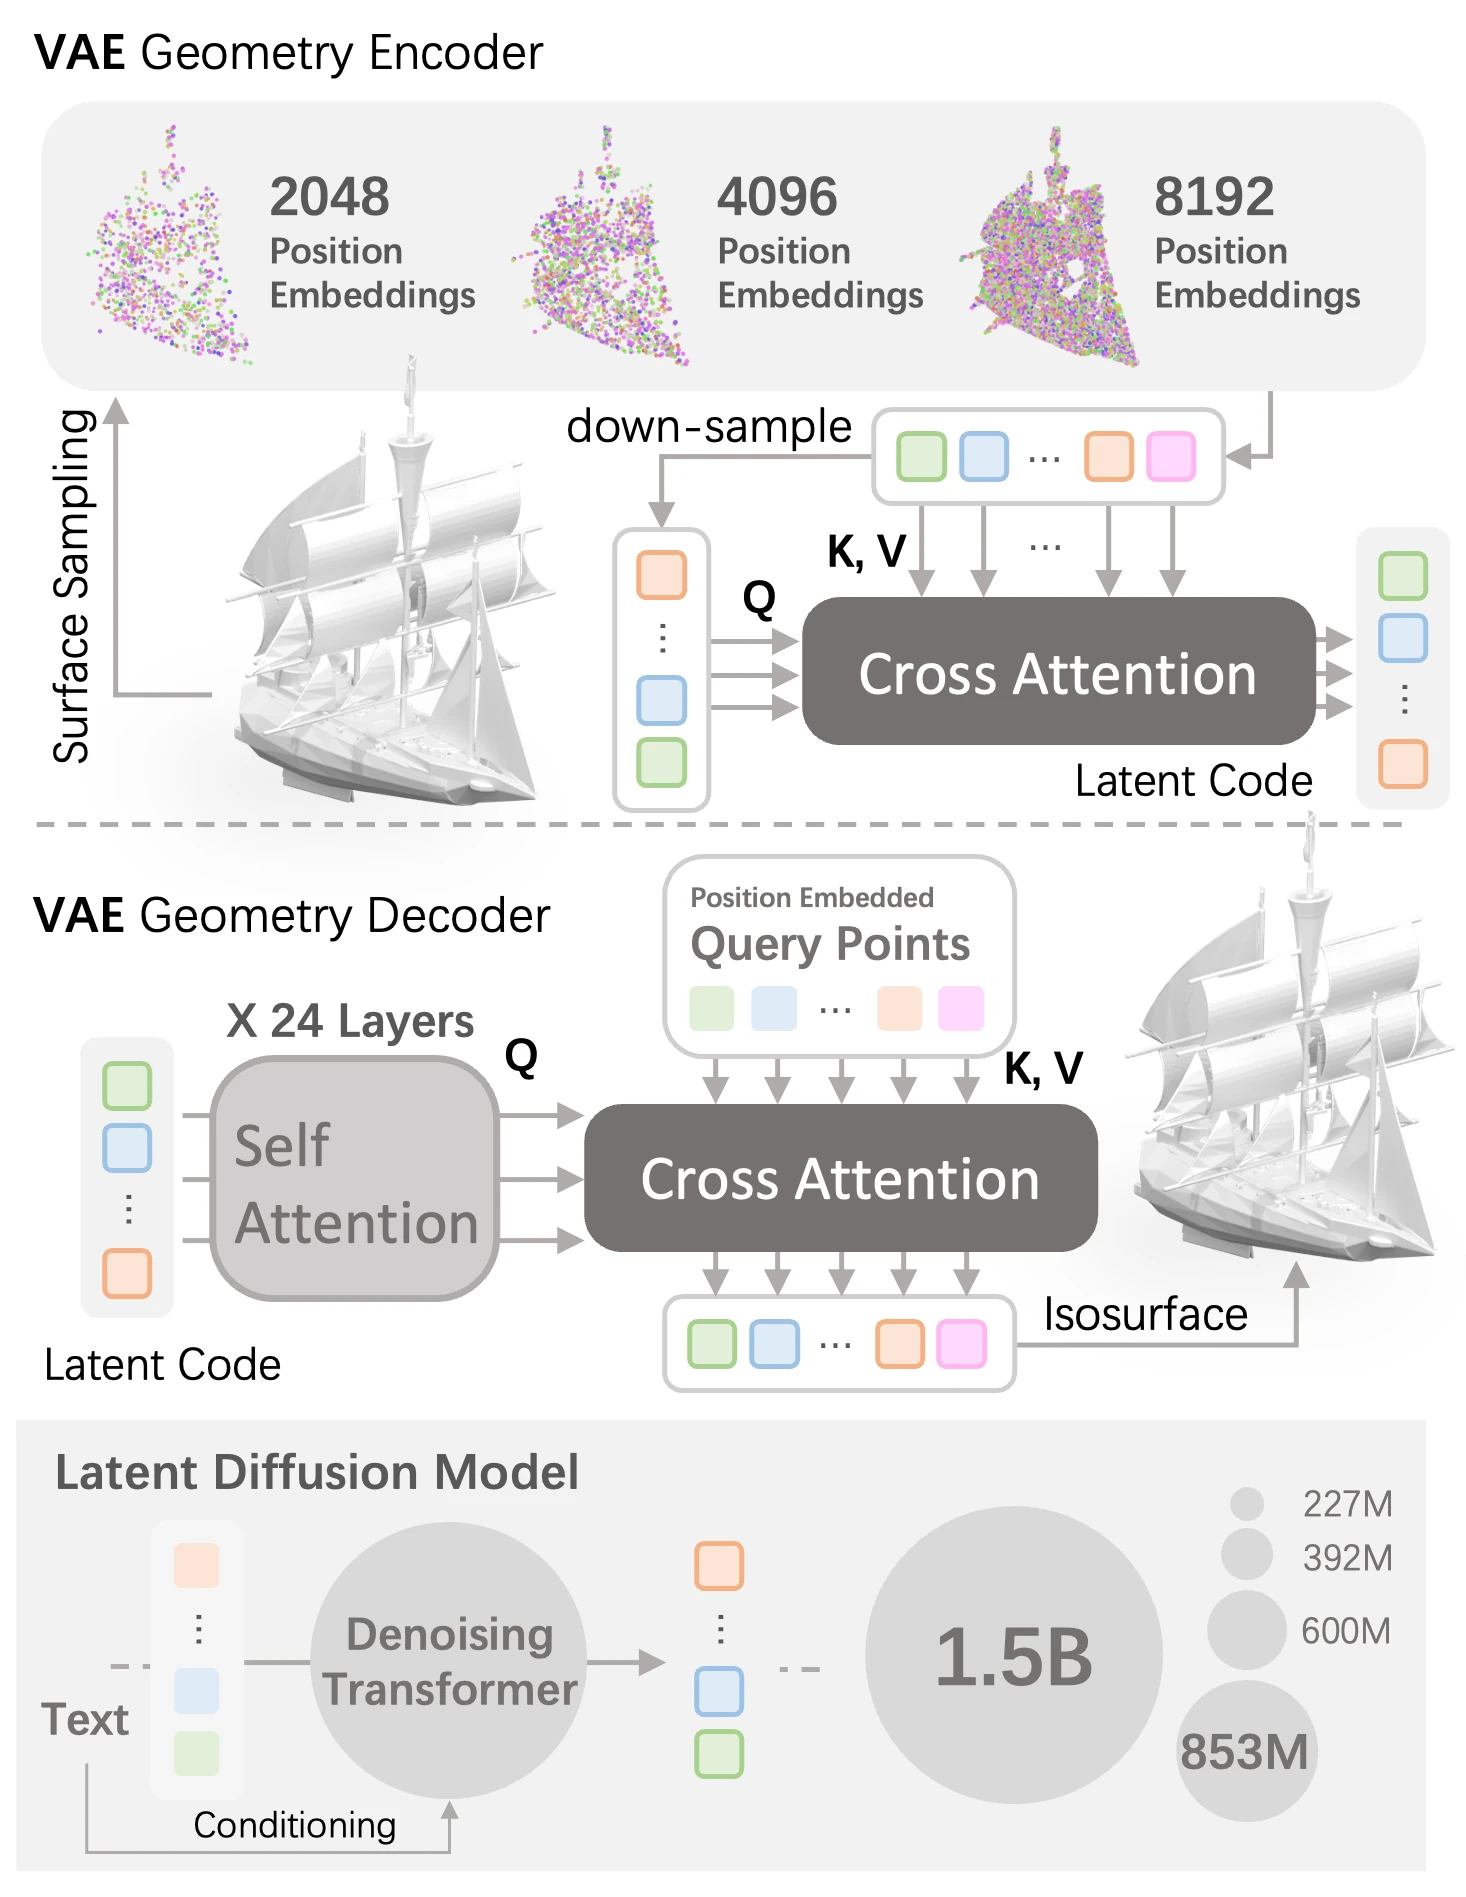
\(\widetilde{\mathbf{X}}\) 是输入点集的四分之一规模下采样。它充当 query;完整点集提供 key/value,因此 latent length 为 \(L=N/4\)。训练时随机选择 \(N\in\{2048,4096,8192\}\),使同一 VAE 覆盖三种几何分辨率。
24 层 self-attention 先传播全局形状信息,查询点再通过 cross-attention 读取 latent,得到 inside / outside logits。VAE 的 model dimension 为 512、8 个 attention heads,共 82M 参数。
时间嵌入 \(\mathbf{t}\) 与 noisy latent concatenation 后进入 24 个纯 Transformer blocks。公式省略了 projection 与 feed-forward layers。实现采用 pre-normalization、GeLU,feed-forward dimension 是 model dimension 的四倍。
训练先在 \(L=512\) 上学习粗结构,随后扩展到 1024,再扩展到 2048,并逐阶段降低学习率。Large 与 XL 还使用 head addition、head expansion 和 hidden-dimension expansion,把已经学习的权重扩展到更大模型。这里的“coarse-to-fine”同时涉及 latent length 与参数规模。
| Model | 参数 | 层数 | \(d_{\mathrm{model}}\) | heads | \(d_{\mathrm{head}}\) | latent length | batch size | learning rate |
|---|---|---|---|---|---|---|---|---|
| Tiny | 227M | 24 | 768 | 12 | 64 | 512 | 1024 | 1e-4 |
| Small | 392M | 24 | 1024 | 16 | 64 | 512 / 1024 | 16384 / 8192 | 1e-5 / 5e-6 |
| Medium | 600M | 24 | 1280 | 16 | 80 | 512 / 1024 | 16384 / 8192 | 1e-4 / 5e-5 |
| Large | 853M | 24 | 1536 | 16 | 96 | 512 / 1024 / 2048 | 8192 / 4096 / 2048 | 1e-4 / 1e-5 / 5e-6 |
| XL | 1.5B | 24 | 2048 | 16 | 128 | 512 / 1024 / 2048 | 4096 / 2048 / 1024 | 1e-4 / 1e-5 / 5e-6 |
过滤复杂场景与碎片化扫描后的完整几何训练集。论文没有给出两个源数据集各自保留数量和 train / validation / test 明细。
Large-P、XL-P、HD 阶段与所有条件适配使用的高质量子集。筛选阈值与逐类分布未公开。
从 Objaverse 选择、带高质量 PBR 材质的对象,用于 Material Diffusion。
输入网格可能非 watertight、方向不一致、面密度不均。CLAY 以 Unsigned Distance Field 作为中间表示,并在 isosurface extraction 前做 grid-based visibility computation:一个 grid point 若从所有方向都被遮挡,便标为 inside。这个规则倾向于最大化封闭体积,使 occupancy VAE 获得稳定训练目标,同时尽量保留 sharp edges、flat surfaces 和薄结构。
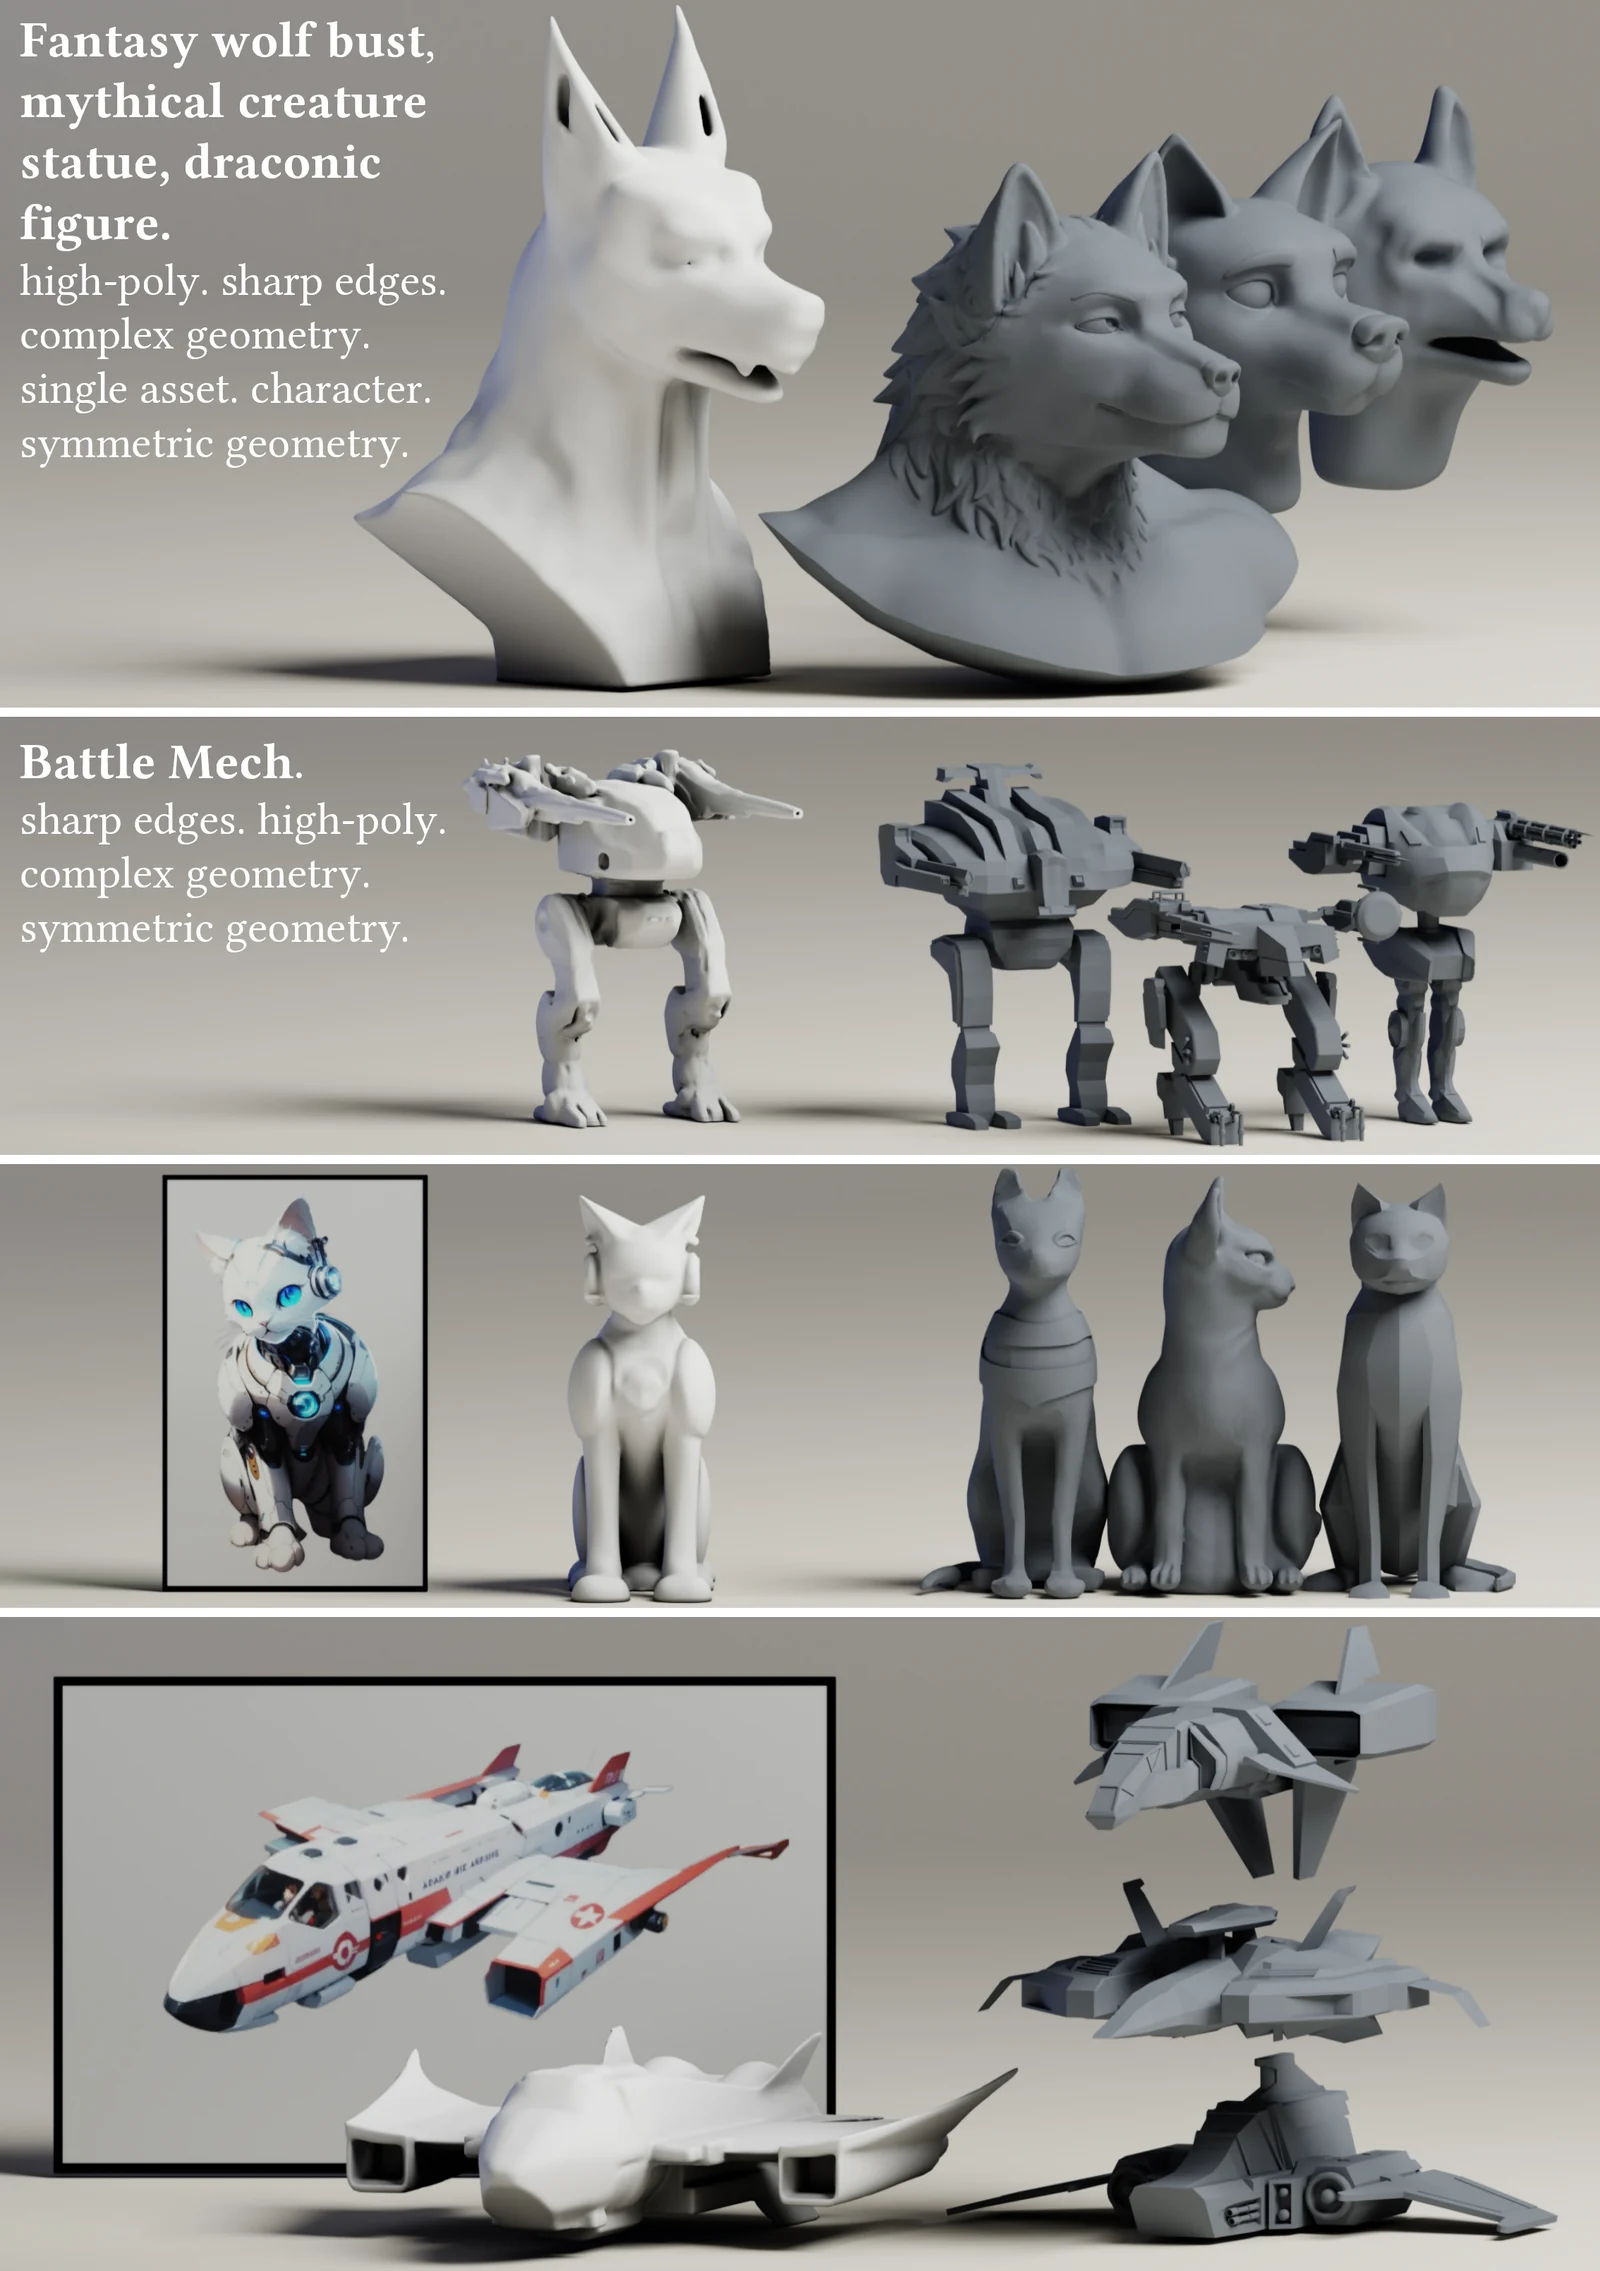
作者使用 GPT-4V 生成详细描述,并加入可控 prompt tags,例如 symmetric / asymmetric、sharp / smooth、low-poly / high-poly、simple / complex、character。Figure 10 显示这些标签能改变输出几何风格。论文没有公开完整 system prompt、图像视角数量、重试规则、人工复核比例和标注成本。
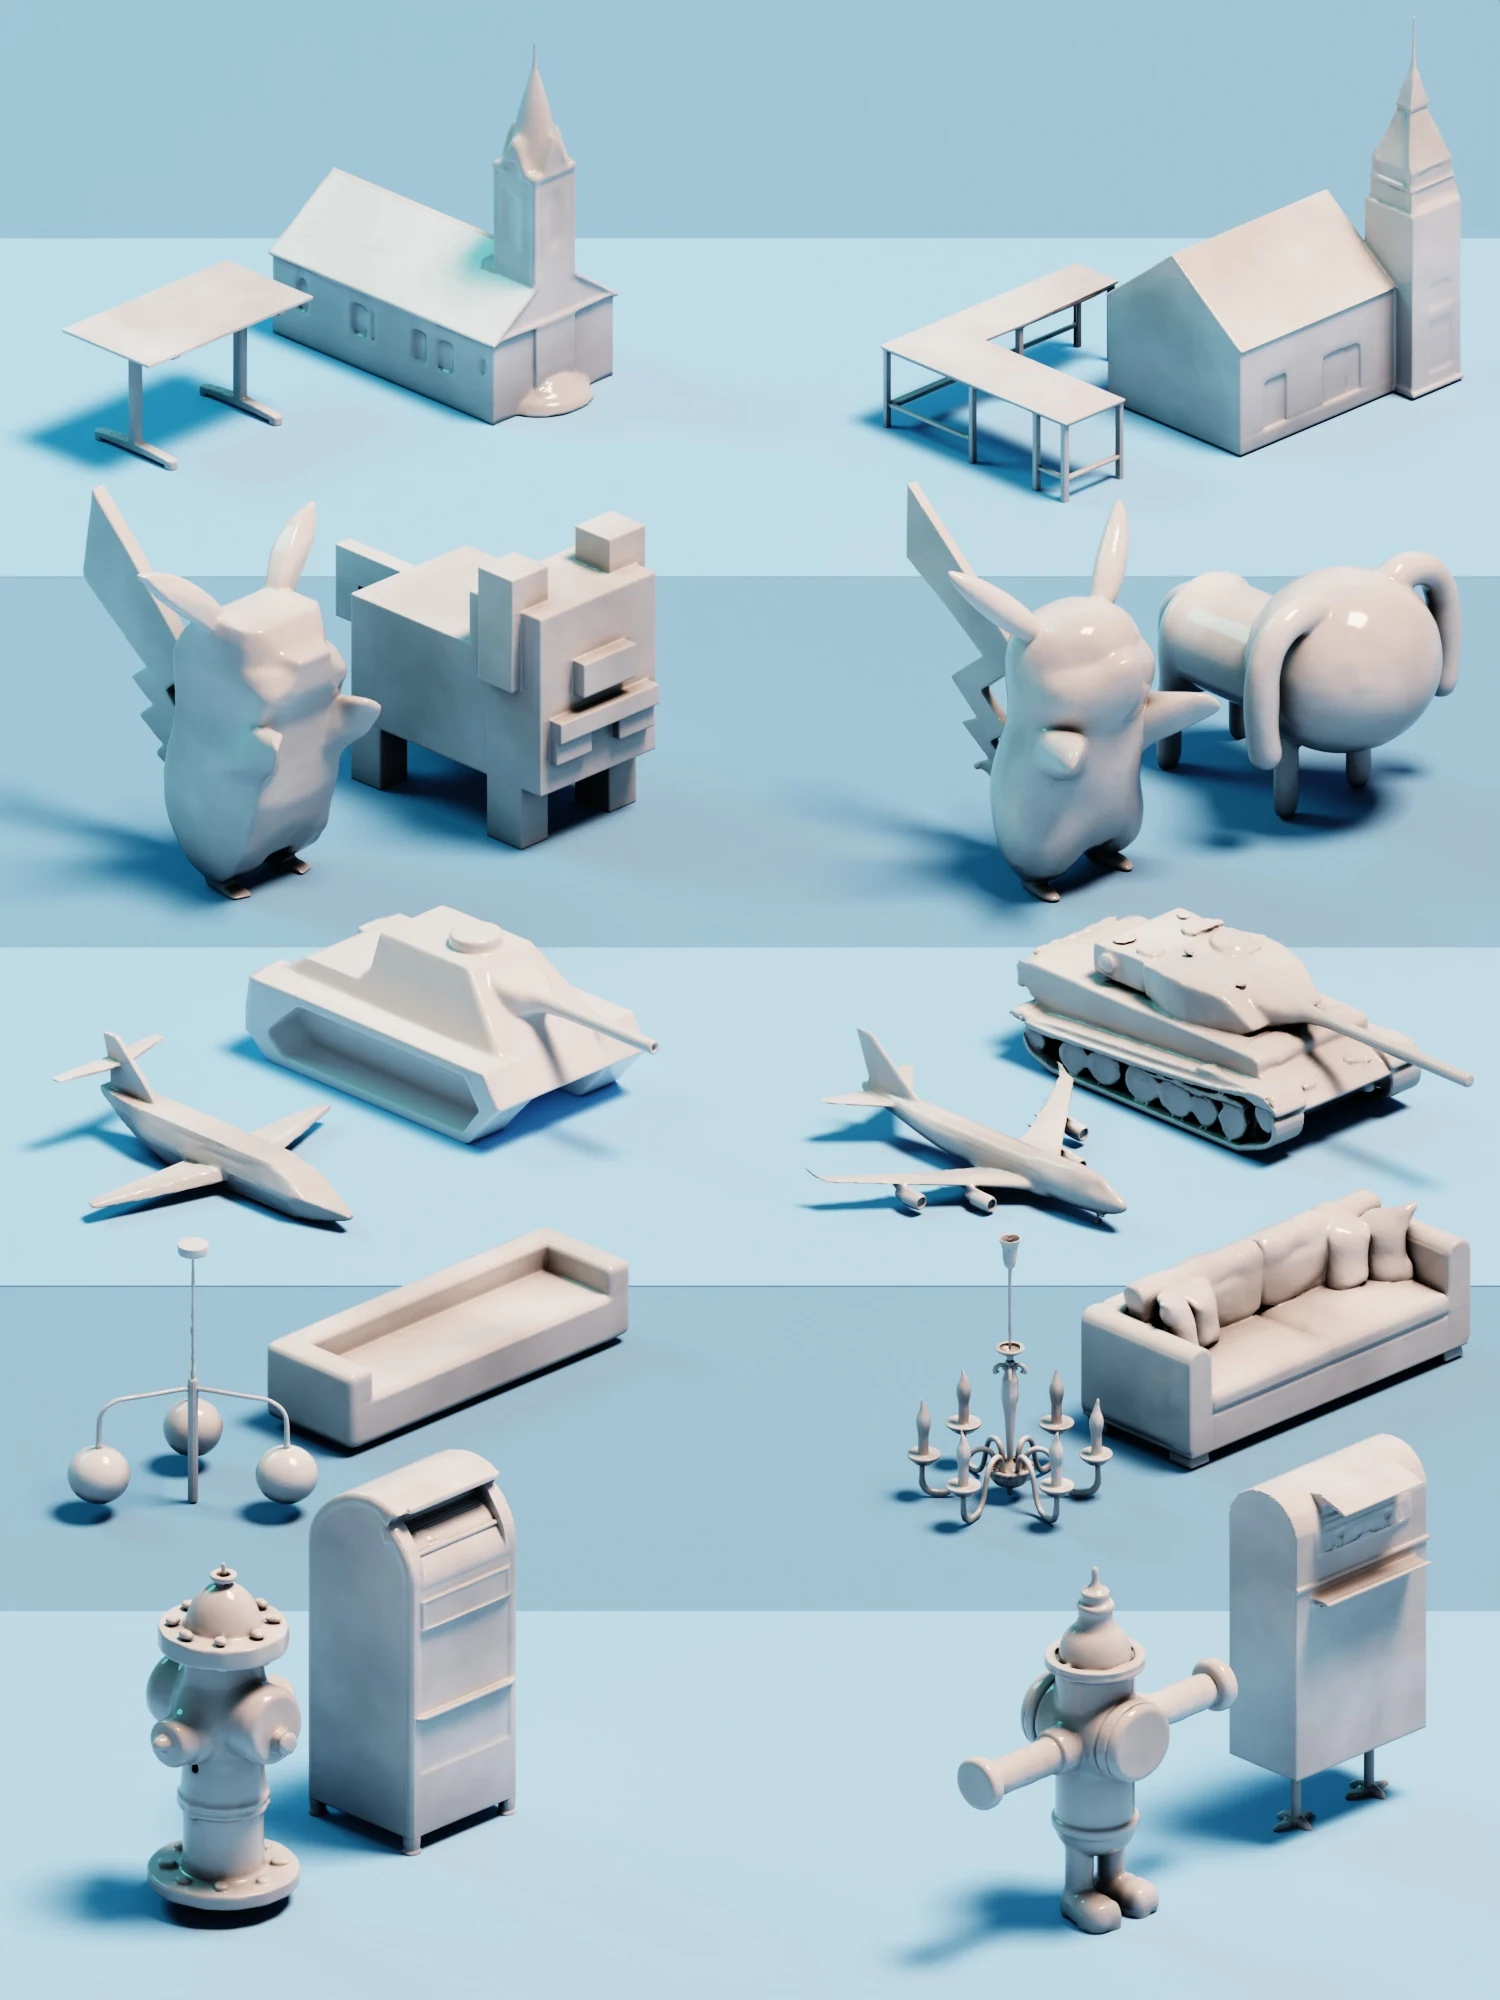
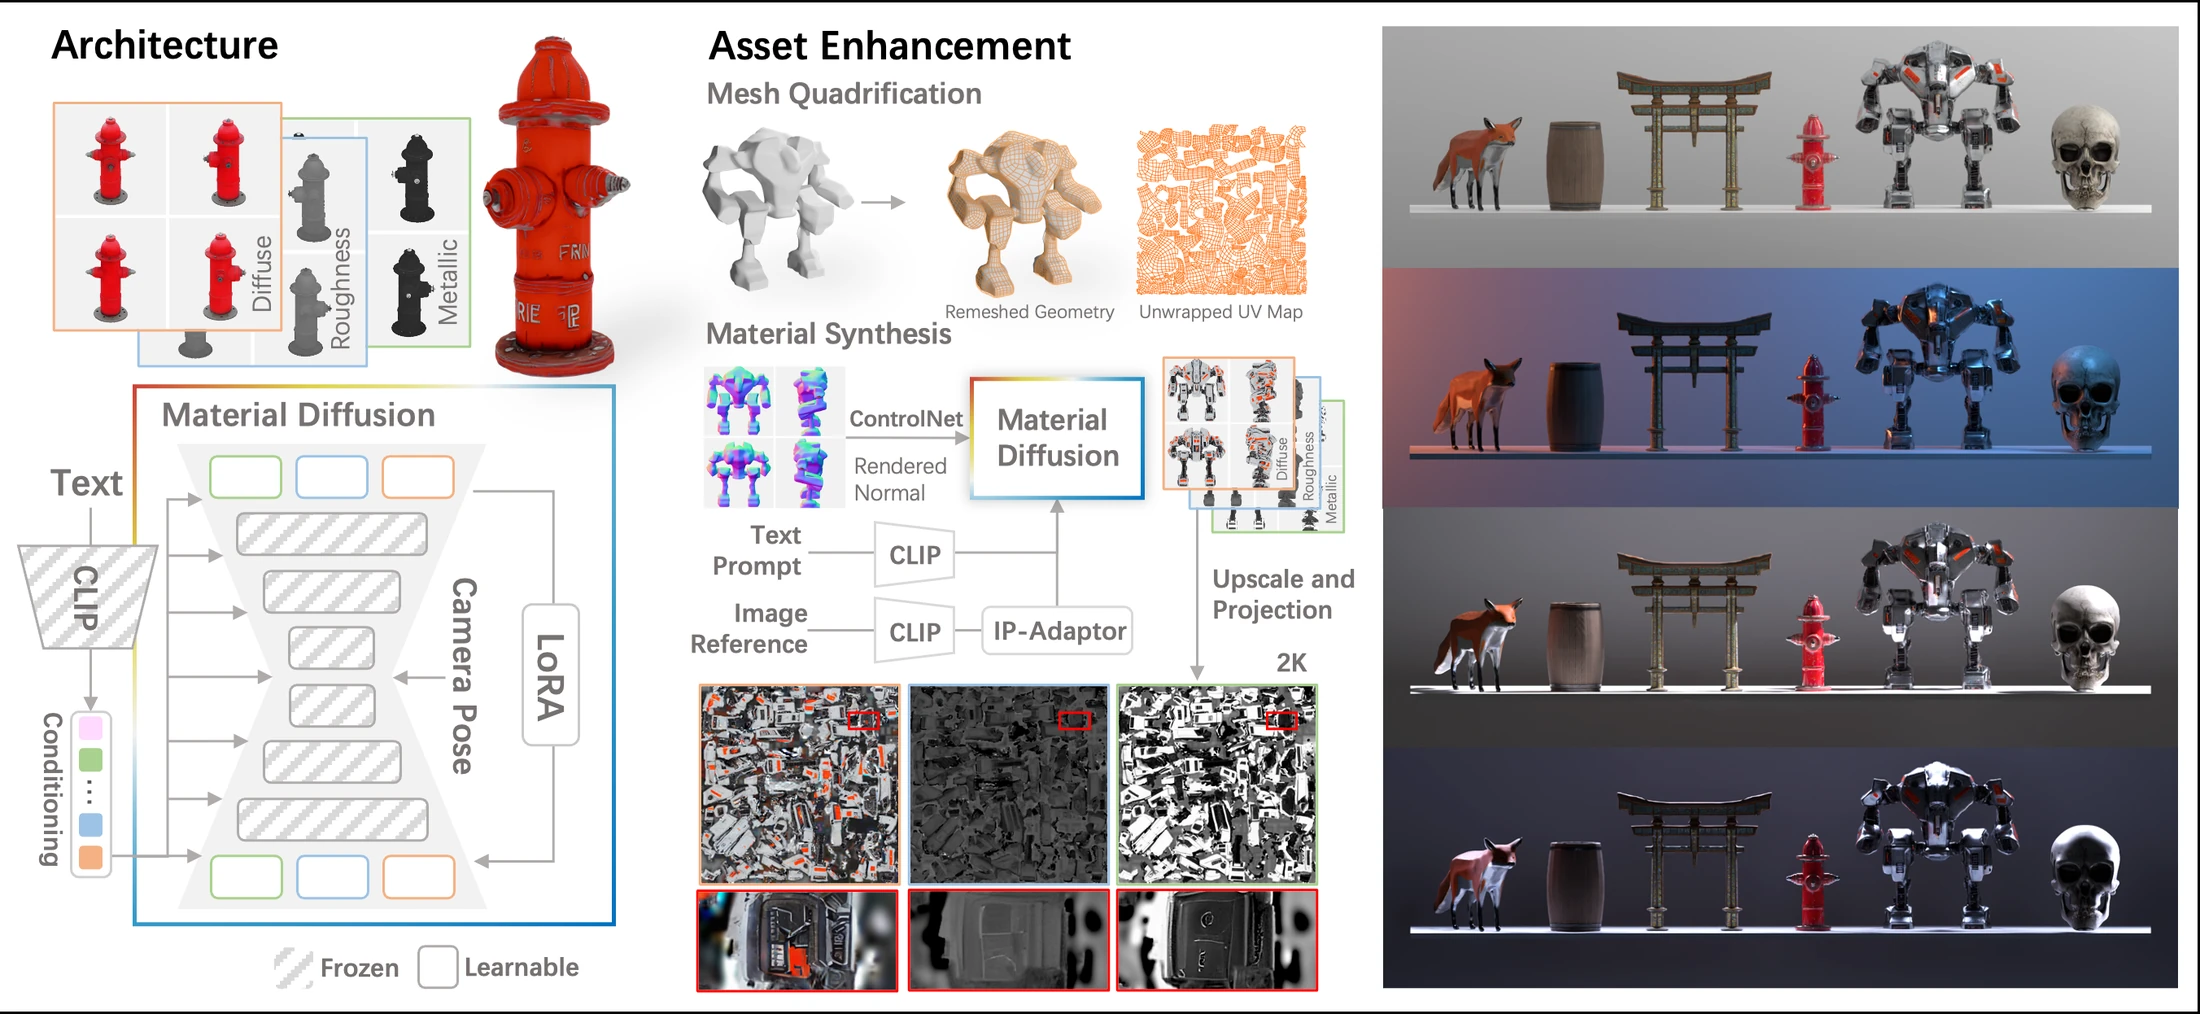
Material Diffusion 以 MVDream UNet 为基础,在最外层卷积加入三个带 skip connection 的分支,对多种材质属性并行去噪。新增层做 full-parameter fine-tuning,内部层使用 LoRA。ControlNet 用目标视角 normal maps 约束几何对应,IP-Adapter 提供图像外观条件。
原文本条件保留;第 \(i\) 个条件拥有独立的 trainable cross-attention module,其他参数冻结。标量 \(\alpha_i\) 直接调节对应条件的影响强度。
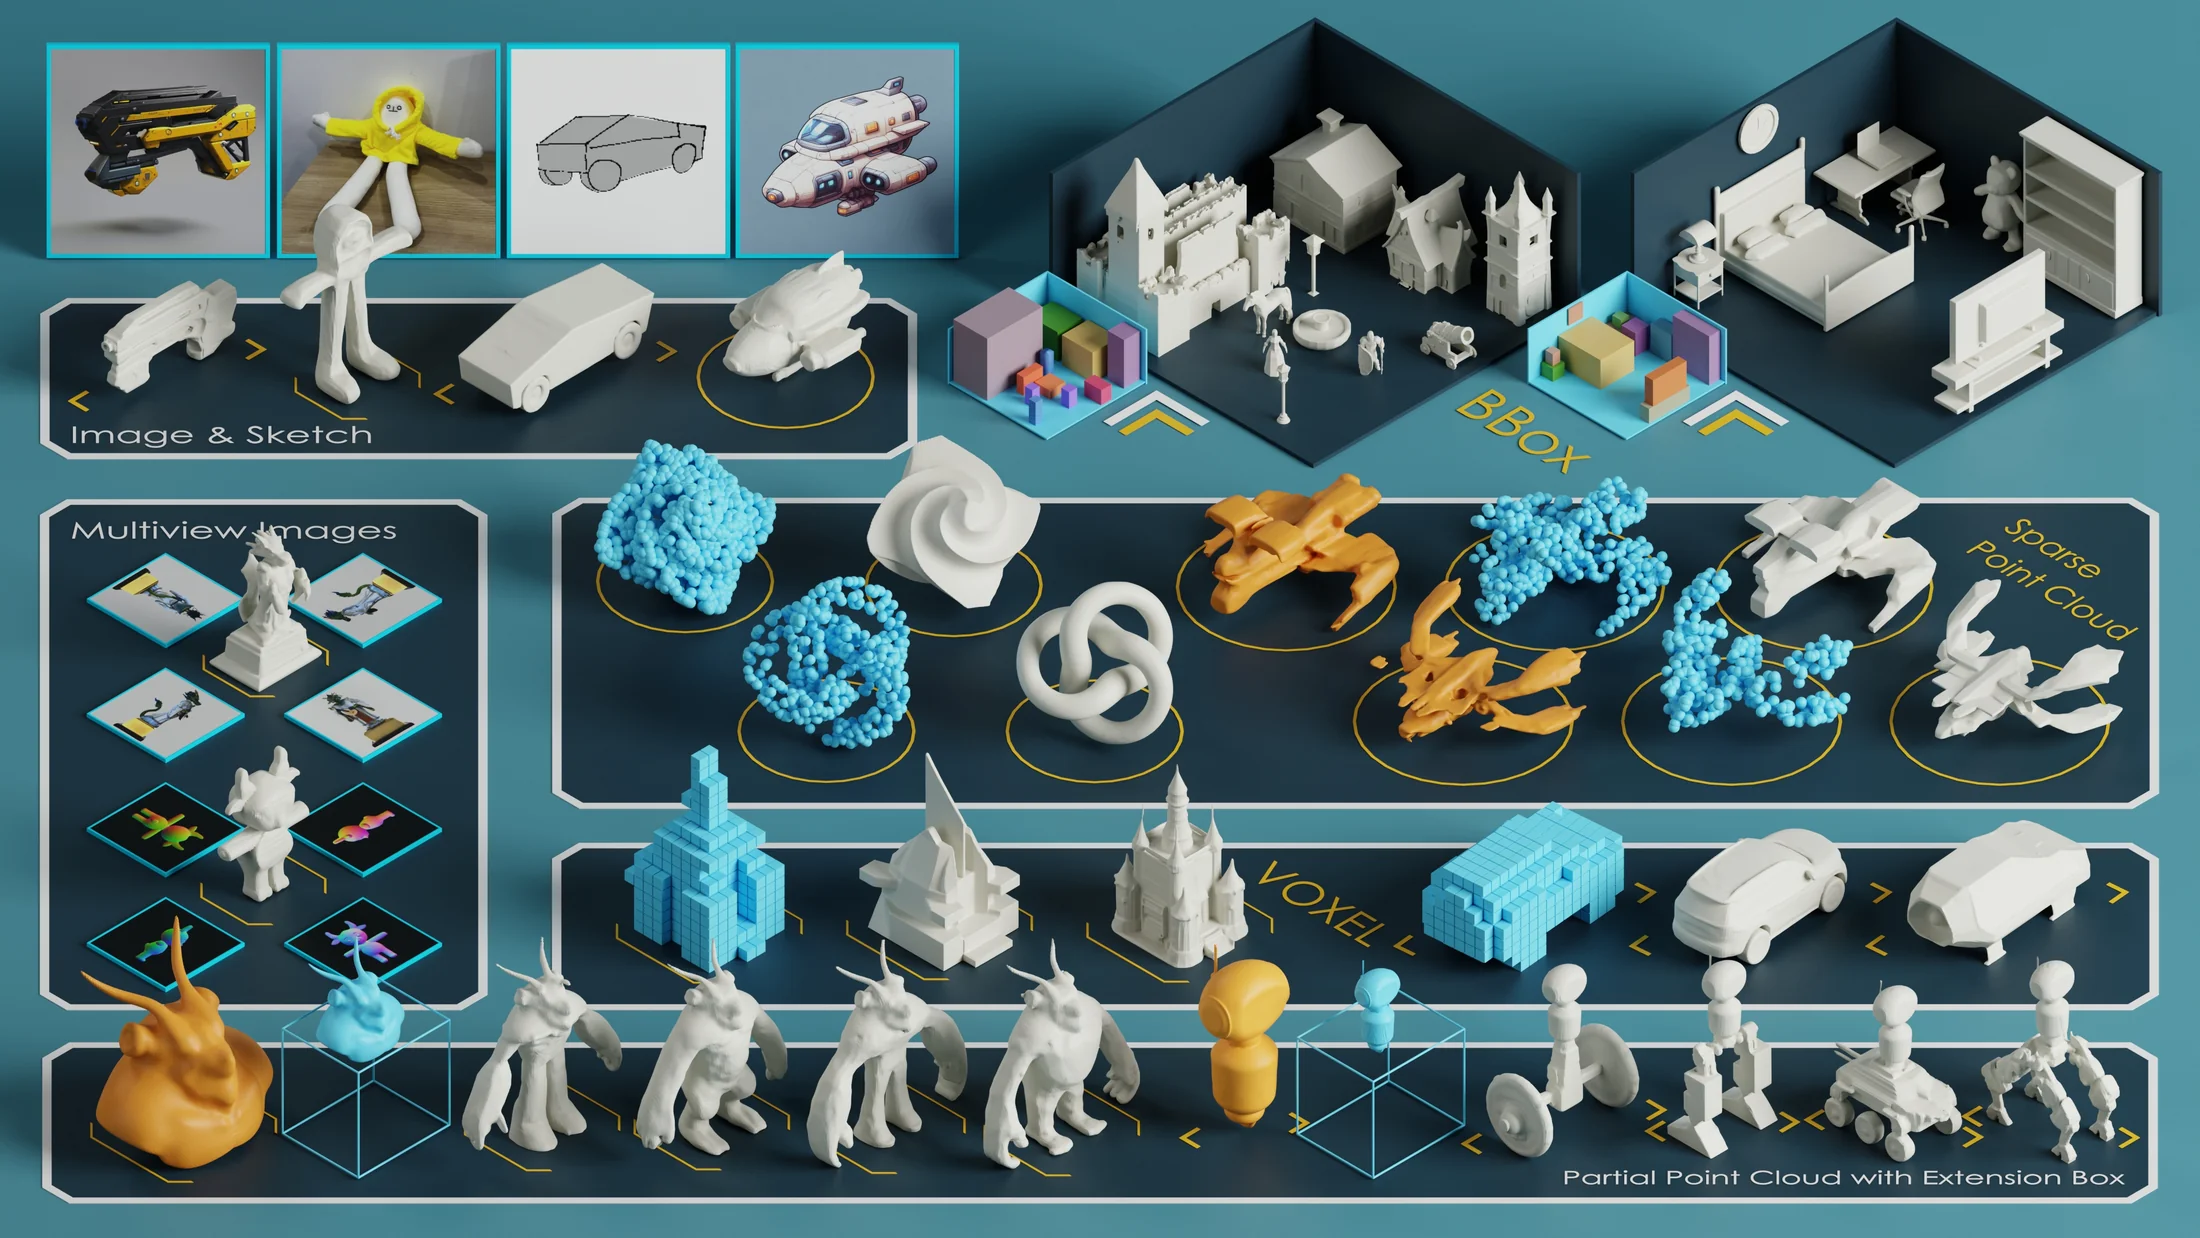
具有空间含义的条件由 feature \(\mathbf{f}\in\mathbb{R}^{M\times C}\) 与 sparse coordinates \(\mathbf{p}\in\mathbb{R}^{M\times3}\) 共同表示。point cloud 条件直接设 \(\mathbf{f}=\mathbf{0}\),仅让 positional embedding 编码点坐标。
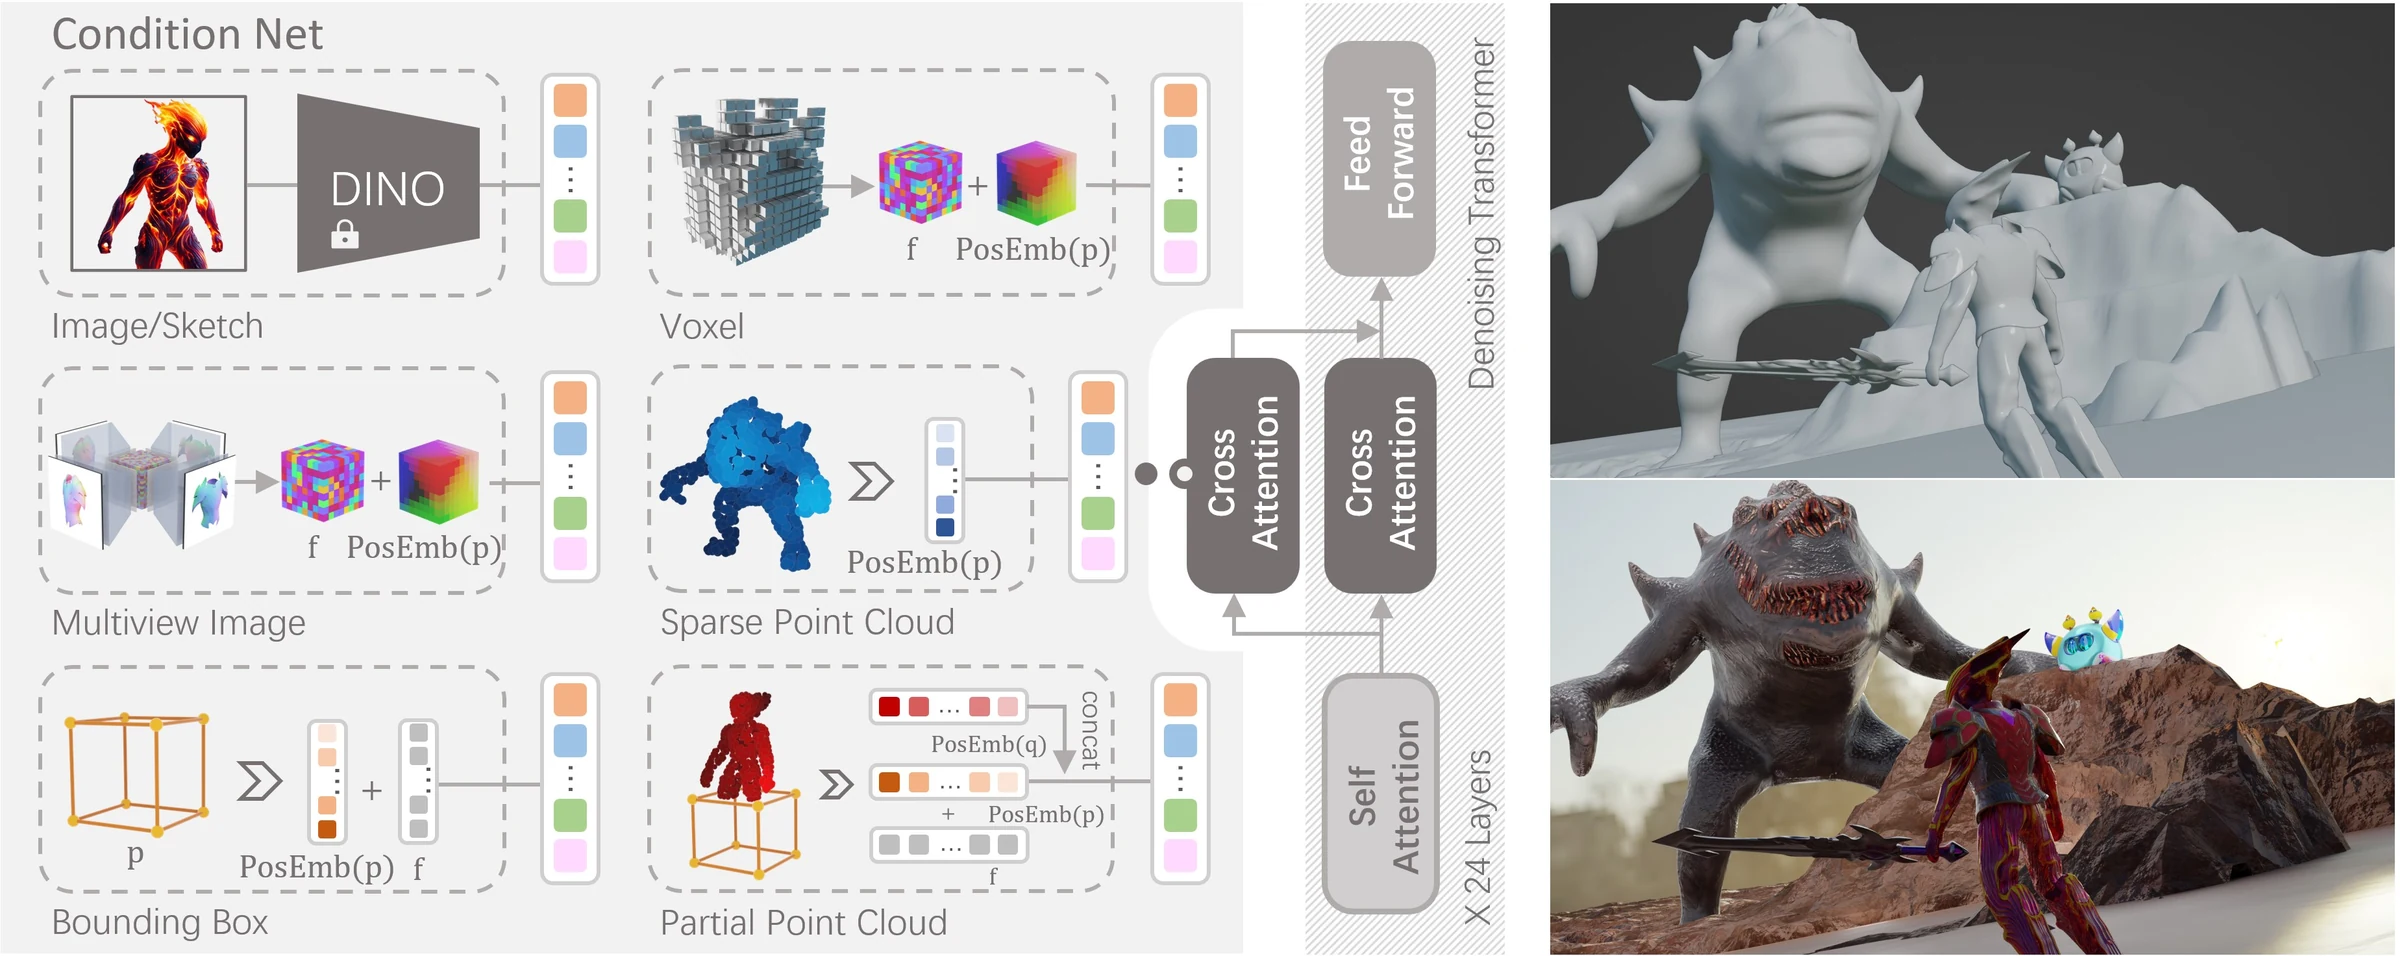
| Conditioning | 参数 | \(M\) | \(C\) | Backbone | 实现含义 |
|---|---|---|---|---|---|
| Image / Sketch | 352M | 257 | 1536 | DINOv2-Giant | DINO patch + global features |
| Voxel | 260M | \(8^3\) | 512 | 无 | \(16^3\) occupancy 经 3D convolution 下采样 |
| Multi-view images | 358M | \(8^3\) | 768 | DINOv2-Small | view features back-project 到 3D volume |
| Point cloud | 252M | 512 | 512 | 无 | 512 个 sparse surface points |
| Bounding box | 252M | 8 | 512 | 无 | 8 个 box corners |
| Partial point cloud | 252M | 2048 + 8 | 512 | 无 | partial points 与 extension box corners |
LoRA style adaptation 直接作用于 DiT attention layers。论文用 rock 与 pocket-monster 两个特定数据集展示风格迁移,但没有给出 LoRA rank、训练样本数量、学习率或定量评测。
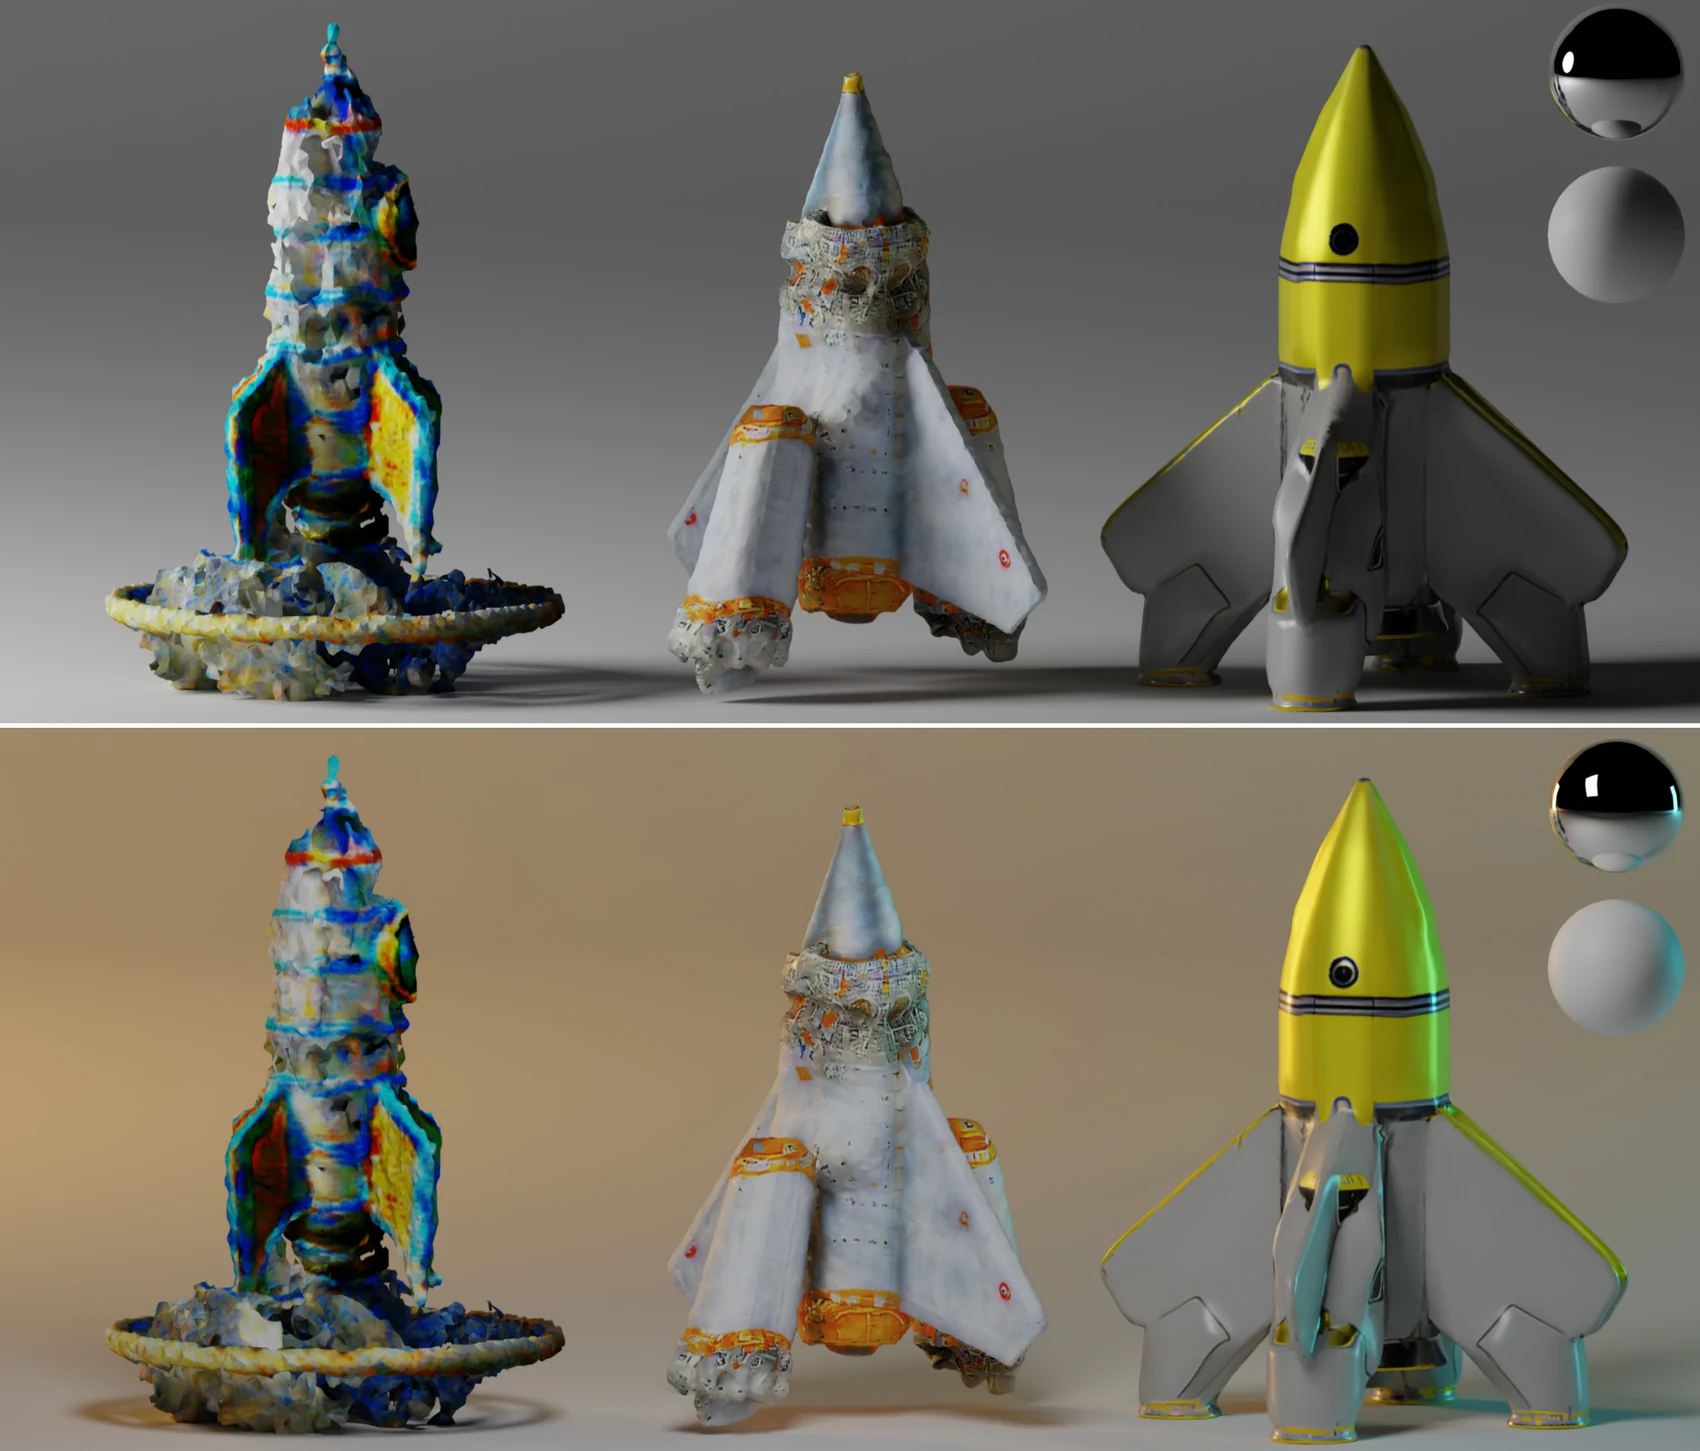
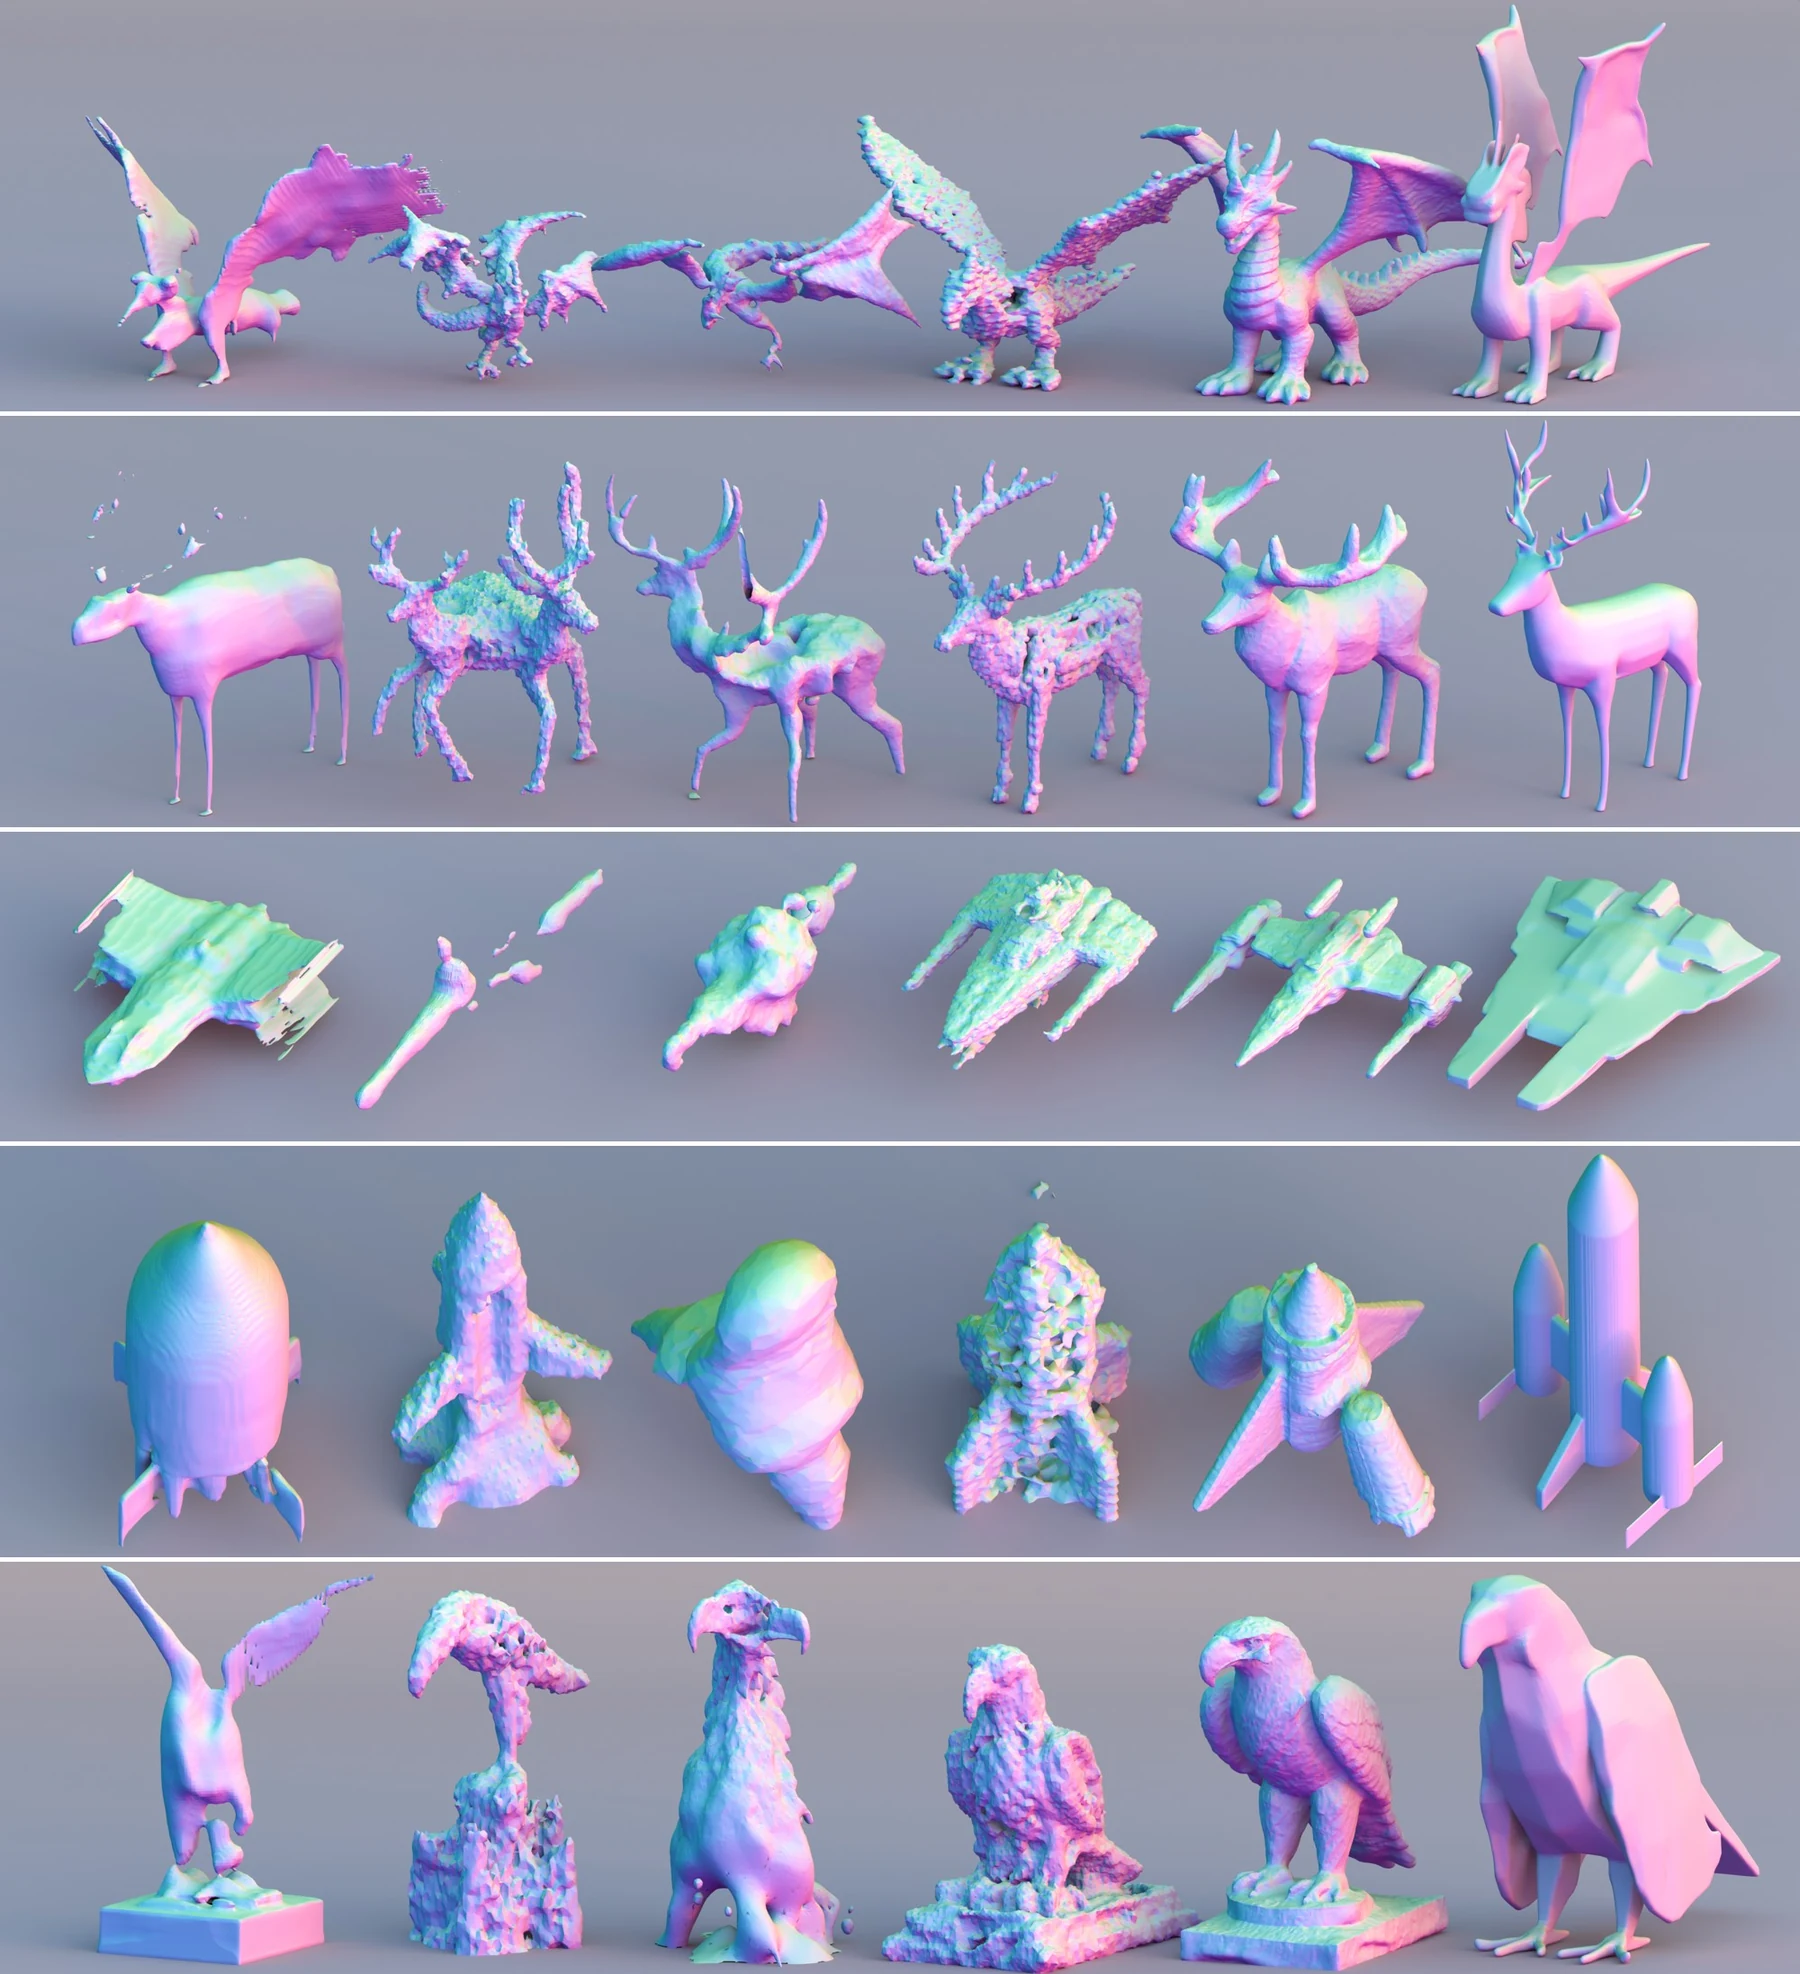
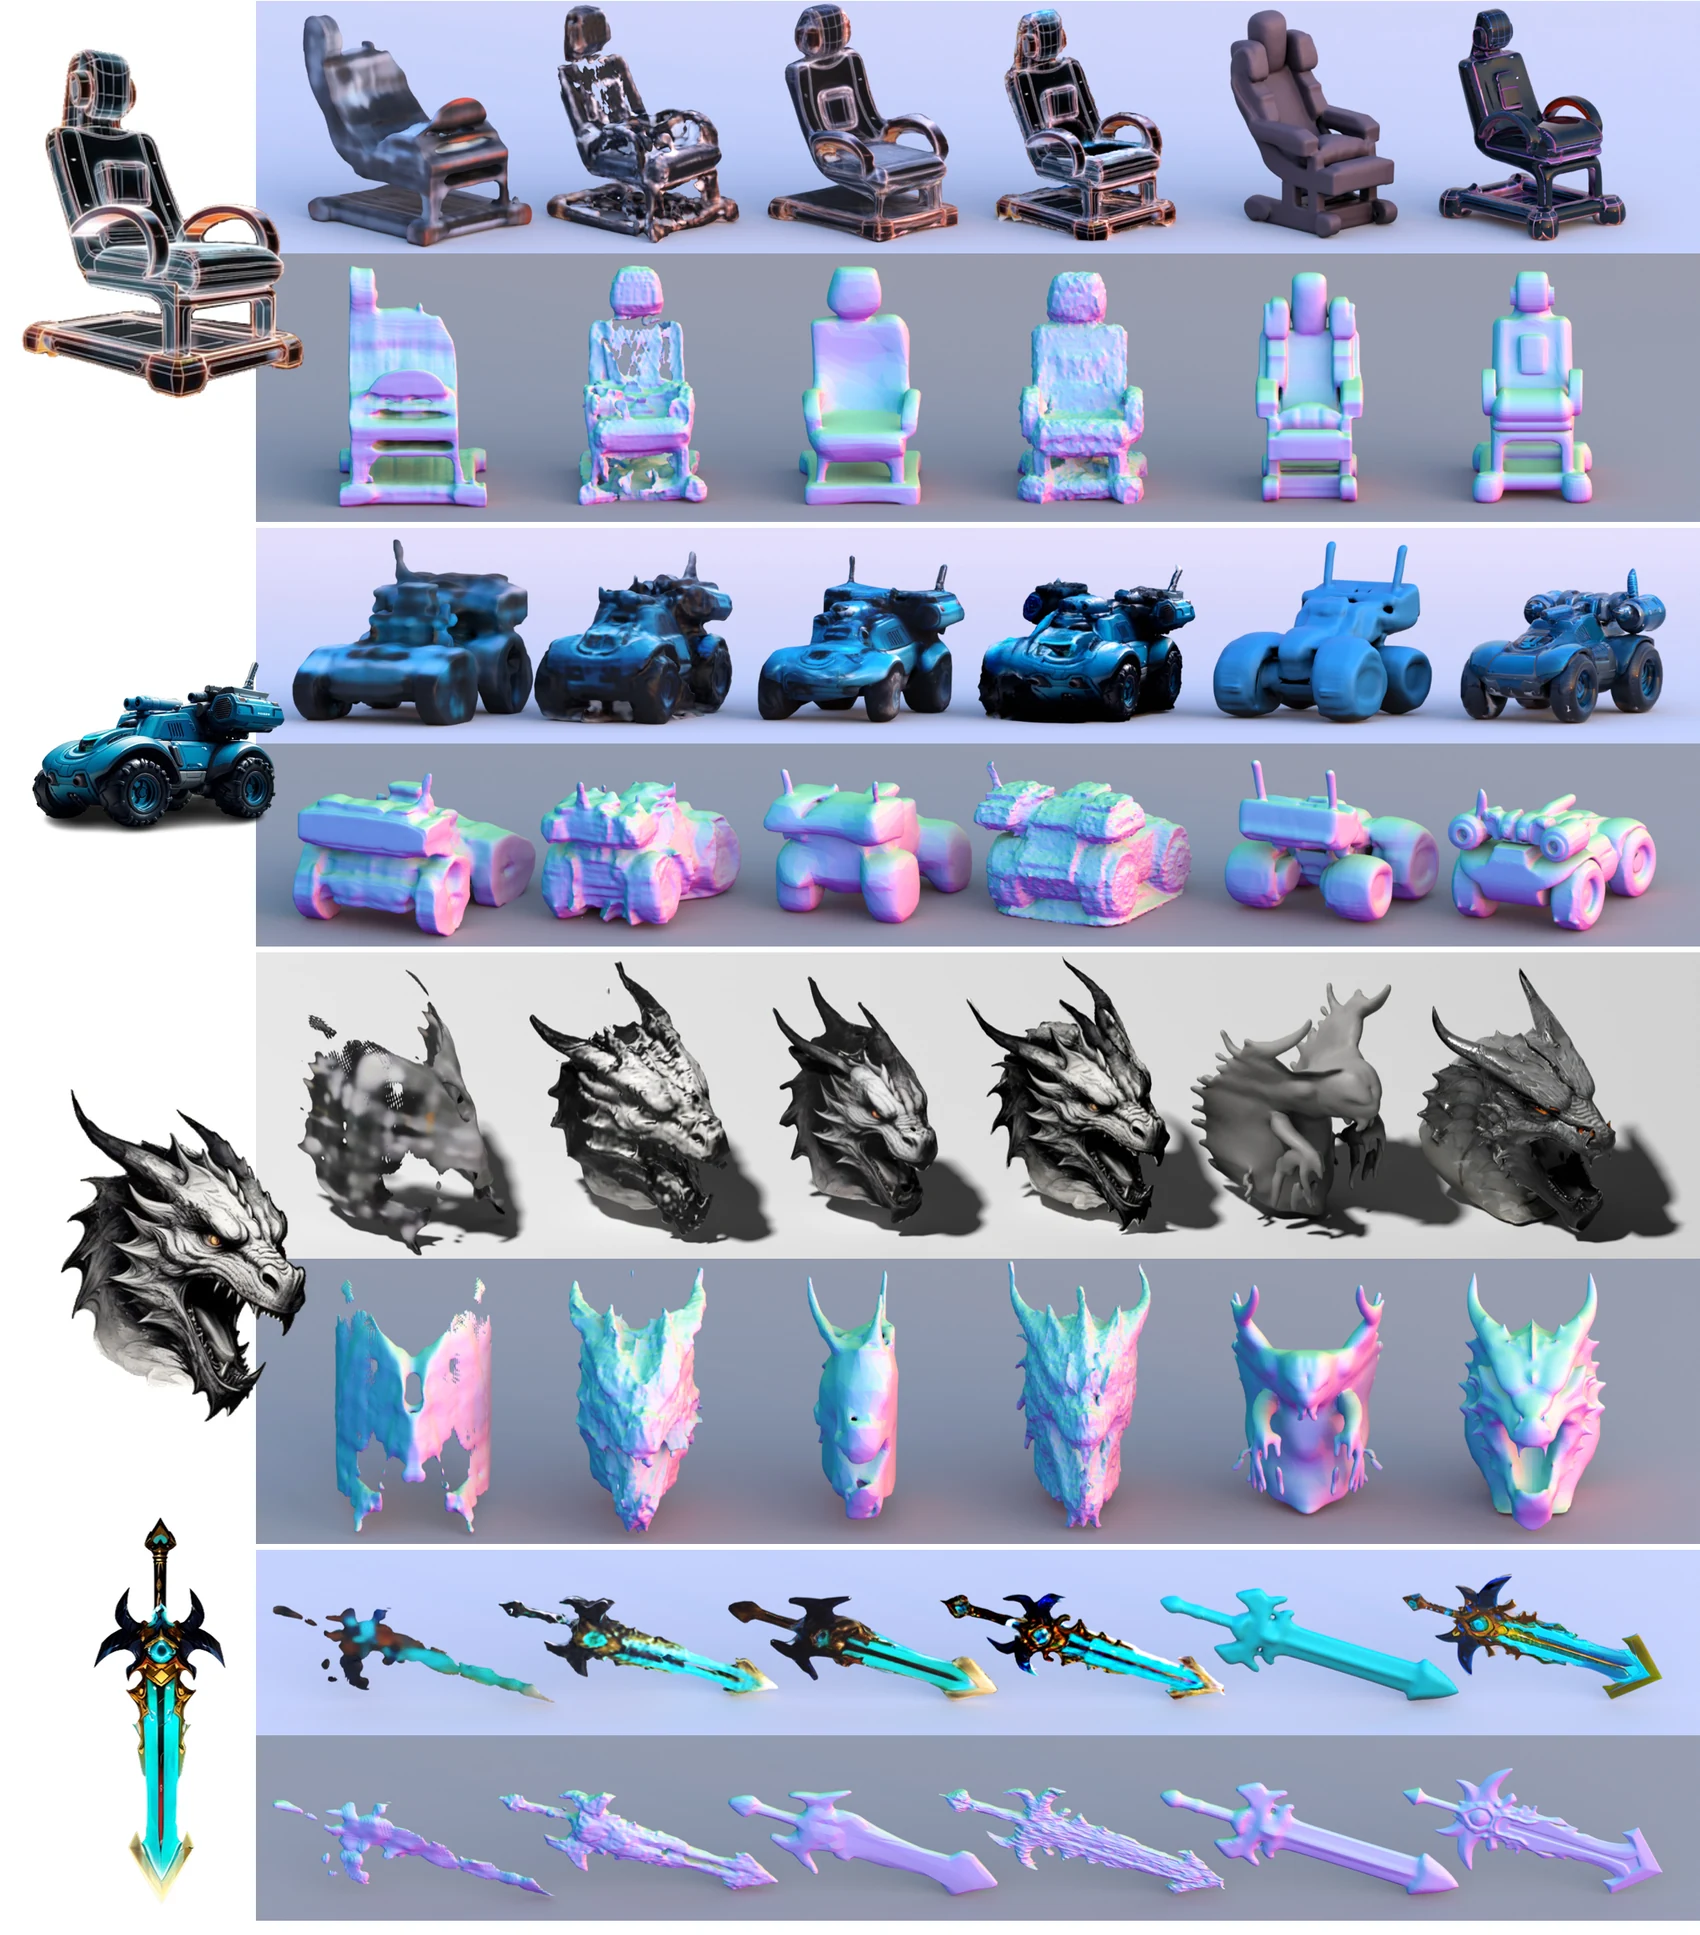
实验覆盖模型规模、多分辨率训练、多模态控制、SOTA 对比、材质定性对比和用户研究。最完整的定量证据集中在 Tables 3–5。
render-FID / KID 由每个 shape 的 8 个渲染视角计算;P-FID / KID 使用 PointNet++ 特征;CLIP(I-T) 使用 CLIP ViT-L/14;ULIP-T 使用 ULIP-2。下箭头越低越好,上箭头越高越好。
| Model | Latent | render-FID ↓ | render-KID ×10³ ↓ | P-FID ↓ | P-KID ×10³ ↓ | CLIP(I-T) ↑ | ULIP-T ↑ |
|---|---|---|---|---|---|---|---|
| Tiny-base | 1024 | 12.2241 | 3.4861 | 2.3905 | 4.1187 | 0.2242 | 0.1321 |
| Small-base | 1024 | 11.2982 | 4.2074 | 1.9332 | 4.1386 | 0.2319 | 0.1509 |
| Medium-base | 1024 | 13.0596 | 5.4561 | 1.4714 | 2.7708 | 0.2311 | 0.1511 |
| Large-base | 1024 | 6.5732 | 2.3617 | 0.8650 | 1.6377 | 0.2358 | 0.1559 |
| XL-base | 1024 | 5.2961 | 1.8640 | 0.7825 | 1.3805 | 0.2366 | 0.1554 |
| Large-P | 1024 | 5.7080 | 1.9997 | 0.7148 | 1.2202 | 0.2360 | 0.1565 |
| XL-P | 1024 | 4.0196 | 1.2773 | 0.6360 | 1.0761 | 0.2371 | 0.1564 |
| Large-P-HD | 2048 | 5.5634 | 1.8234 | 0.6394 | 0.9170 | 0.2374 | 0.1578 |
| XL-P-HD | 2048 | 4.4779 | 1.4486 | 0.5072 | 0.5180 | 0.2372 | 0.1569 |
| Condition | CD ×10³ ↓ | EMD ×10² ↓ | Voxel-IoU ↑ | F-Score ↑ | P-FID ↓ | P-KID ×10³ ↓ | ULIP-T ↑ | ULIP-I ↑ |
|---|---|---|---|---|---|---|---|---|
| Image | 12.4092 | 17.6155 | 0.4513 | 0.4070 | 0.9946 | 1.9889 | 0.1329 | 0.2066 |
| MVN | 0.9924 | 5.7283 | 0.7697 | 0.8218 | 0.3038 | 0.2420 | 0.1393 | 0.2220 |
| Voxel | 0.5676 | 8.4254 | 0.6273 | 0.6049 | 2.6963 | 5.0008 | 0.1186 | 0.1837 |
| Image-Bbox | 5.4733 | 14.0811 | 0.5122 | 0.4909 | 1.5884 | 3.2994 | 0.1275 | 0.2028 |
| Image-Voxel | 0.7491 | 8.1174 | 0.6514 | 0.6541 | 2.4866 | 6.8767 | 0.1262 | 0.2017 |
| Text-Image | 7.7198 | 14.5489 | 0.4980 | 0.4609 | 0.7996 | 1.4489 | 0.1407 | 0.2122 |
| Text-MVN | 0.7301 | 5.4034 | 0.7842 | 0.8358 | 0.2184 | 0.1233 | 0.1424 | 0.2240 |
| Text-Bbox | 5.6421 | 14.6170 | 0.4921 | 0.4659 | 2.0074 | 4.0355 | 0.1417 | 0.1838 |
| Text-Voxel | 0.6090 | 7.4981 | 0.6737 | 0.6689 | 1.0427 | 1.0903 | 0.1397 | 0.2036 |
MVN 与 Text-MVN 对结构重建最有效;voxel 获得最低 CD,却在 P-FID / KID 与 semantic alignment 上较弱,说明 coarse occupancy constraint 与分布真实感存在明显取舍。Image-Bbox 比纯 Image 改善几何距离,但 P-FID 与 ULIP-I 下降,额外空间约束没有在所有指标上带来提升。
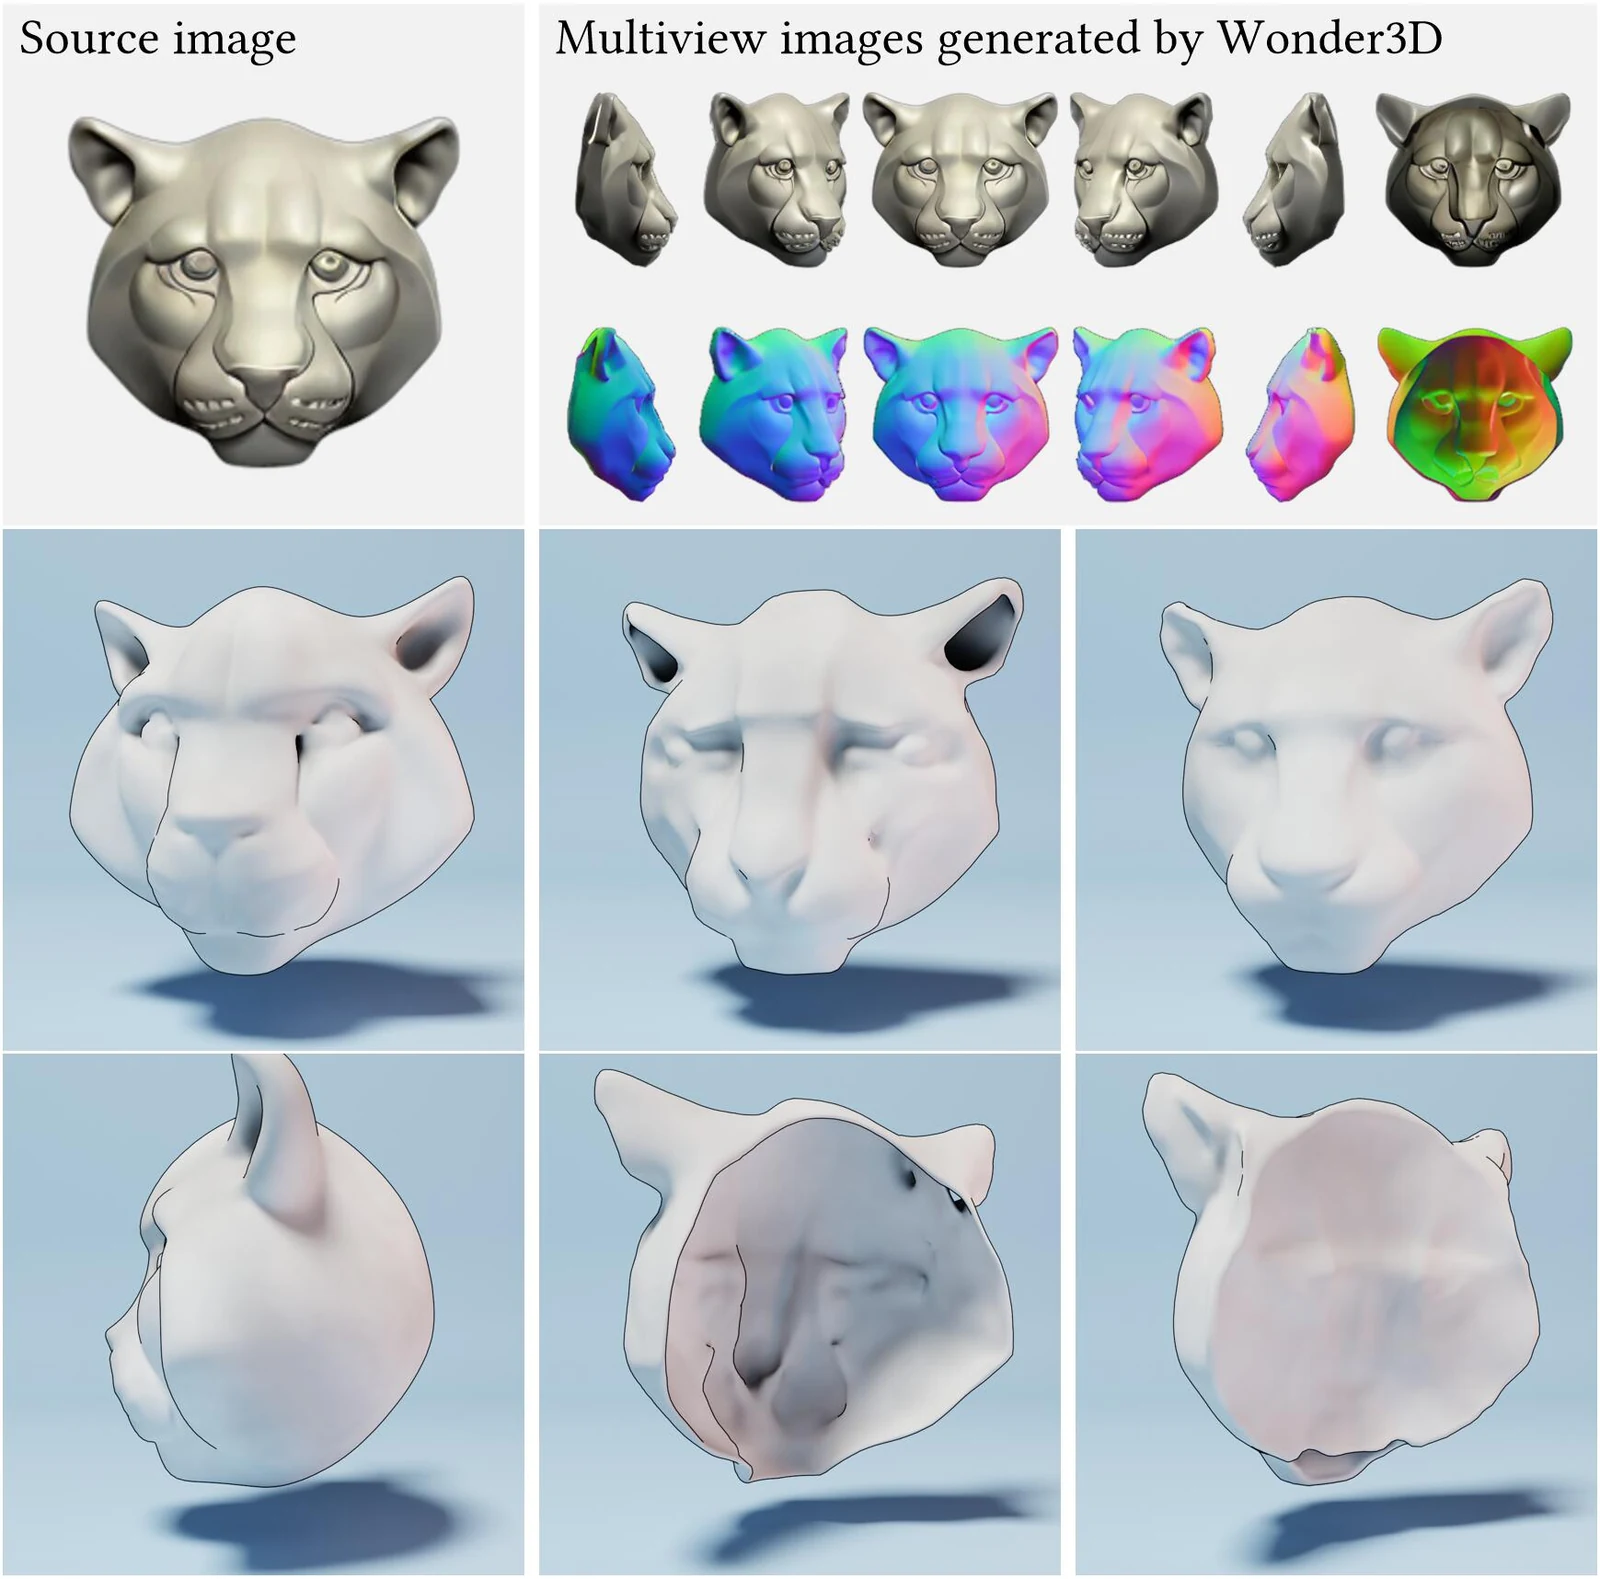
测试集由 GPT-4 生成 50 个文本 prompt,并使用 50 张图像分别评估 text-to-3D 与 image-to-3D。每个生成资产渲染 30 个 RGB views 与 30 个 normal views,再计算平均 CLIP 分数。
| Task / Method | CLIP geometry | CLIP appearance | ULIP-T | ULIP-I | Time |
|---|---|---|---|---|---|
| Text · Shap-E | 0.1761 (N-T) | 0.2081 (I-T) | 0.1160 | — | ≈10 s |
| Text · DreamFusion | 0.1549 | 0.1781 | 0.0566 | — | ≈1.5 h |
| Text · Magic3D | 0.1553 | 0.2034 | 0.0661 | — | ≈1.5 h |
| Text · MVDream | 0.1786 | 0.2237 | 0.1351 | — | ≈1.5 h |
| Text · RichDreamer | 0.1891 | 0.2281 | 0.1503 | — | ≈2 h |
| Text · CLAY | 0.1948 | 0.2324 | 0.1705 | — | ≈45 s |
| Image · Shap-E | 0.6315 (N-I) | 0.6971 (I-I) | — | 0.1307 | ≈10 s |
| Image · Wonder3D | 0.6489 | 0.7220 | — | 0.1520 | ≈4 min |
| Image · DreamCraft3D | 0.6641 | 0.7718 | — | 0.1706 | ≈4 h |
| Image · One-2-3-45++ | 0.6271 | 0.7574 | — | 0.1743 | ≈90 s |
| Image · Michelangelo | 0.6726 | — | — | 0.1899 | ≈10 s |
| Image · CLAY | 0.6848 | 0.7769 | — | 0.2140 | ≈45 s |
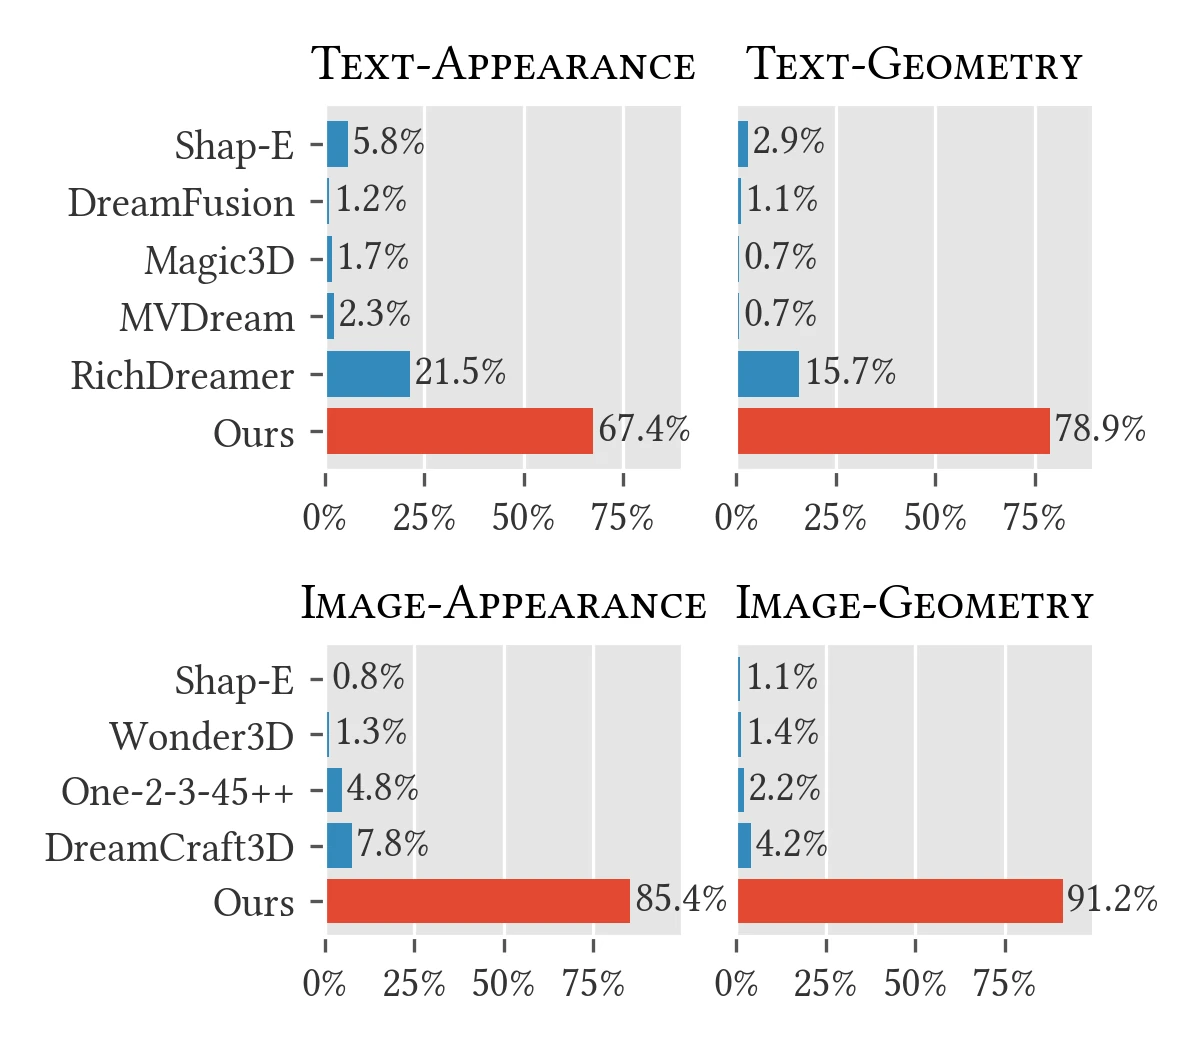
每人回答 15 个随机问题。测试材料来自 5 个 GPT-4 文本 prompt 与 15 张 Stable Diffusion 图像。
Text-to-3D 的 appearance / geometry 偏好票选择 CLAY。
Image-to-3D 的 appearance / geometry 偏好票选择 CLAY。
系统尚未端到端联合生成 geometry 与 material;仍需 remeshing、quadrification 和 UV unwrapping。Text-only 对 composed objects 较脆弱,例如 “a tiger riding a motorcycle”,作者归因于组合对象训练样本和细粒度描述不足。未来方向包括统一几何与 PBR、生成一致 topology,以及扩展到 dynamic objects。