把二维语义控制接入可生成的三维潜空间
NeRF 能保持新视角一致性,却把内容编码在大量网络参数中;当时的 EditNeRF 依赖用户涂鸦与逐例优化,形状编辑主要局限于局部增删。CLIP-NeRF 的核心假设是:类别级 conditional NeRF 若拥有结构化潜空间,CLIP 的跨模态方向可以学习成可复用的潜变量增量。
Research gap
文本或单张示例图提供的是二维、语义级约束;NeRF 编辑要求同一三维对象在所有相机视角保持一致。论文把这两个空间通过 feed-forward code mapper 连接,并以生成器与判别器提供类别先验。
关键设计
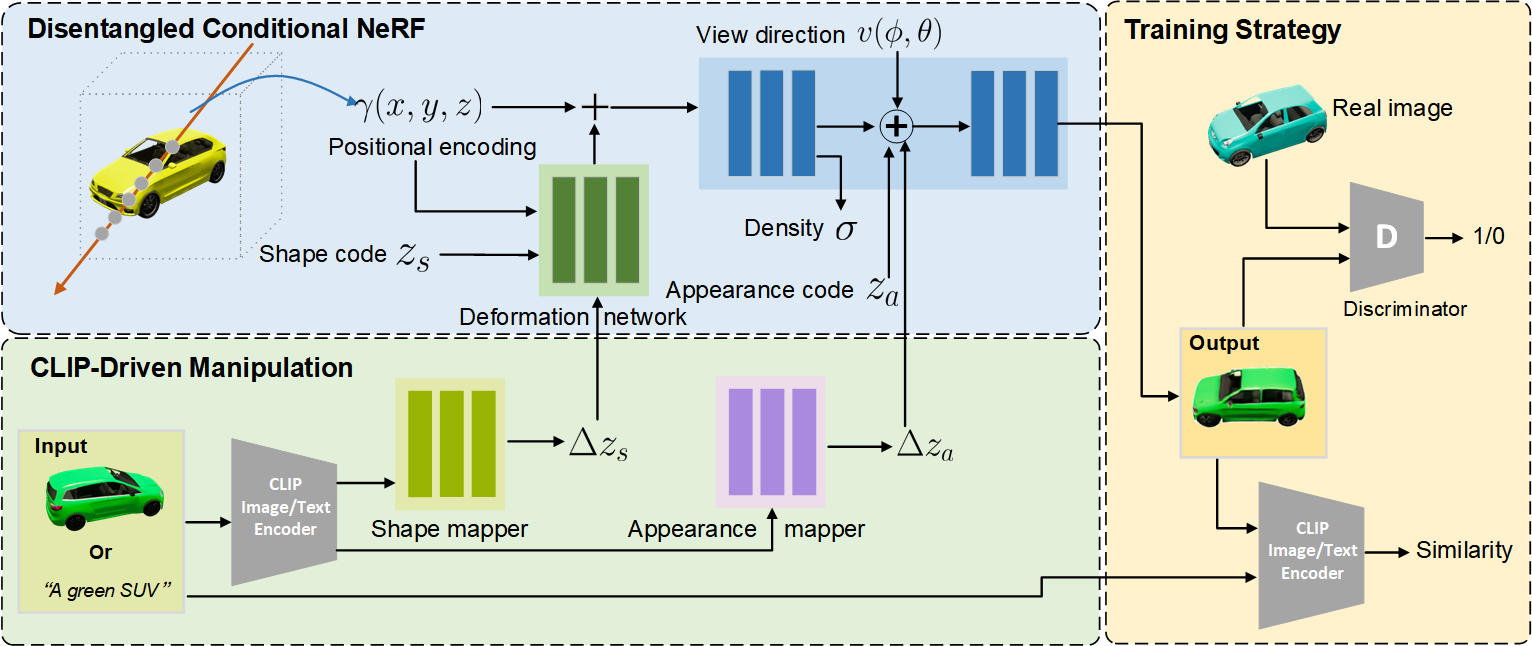
形状码只进入显式 deformation network,外观码延迟到颜色分支。这样的结构约束使形状编辑尽量少改变颜色,外观编辑不触及密度。
网页内容路径
输入、状态与输出
生成状态
空间点 \(\mathbf{x}=(x,y,z)\)、观察方向 \(\mathbf{v}=(\phi,\vartheta)\)、形状码 \(\mathbf{z}_s\in\mathbb{R}^{128}\) 与外观码 \(\mathbf{z}_a\in\mathbb{R}^{128}\) 共同决定体密度 \(\sigma\) 与视角相关颜色 \(\mathbf{c}=(r,g,b)\)。相机姿态 \(v\) 从上半球分布采样。
编辑条件
用户输入文本 \(t\) 或示例图 \(I_e\)。冻结的 CLIP 文本编码器 \(\hat{\mathcal{E}}_t\) 与图像编码器 \(\hat{\mathcal{E}}_i\) 把两者送入联合嵌入空间;两个 mapper 输出形状增量 \(\Delta\mathbf{z}_s\) 和外观增量 \(\Delta\mathbf{z}_a\)。
输出
编辑后的类别内 NeRF 实例,可从任意视角渲染。形状编辑更新 \(\mathbf{z}_s\) 并保持 \(\mathbf{z}_a\);外观编辑更新 \(\mathbf{z}_a\) 并保持 \(\mathbf{z}_s\)。
真实图像路径
单张真实图像 \(I_r\) 没有已知的相机、形状码和外观码。论文交替优化 \(v,\mathbf{z}_s,\mathbf{z}_a\),先把图像投影到生成流形,再应用同一 mapper。
这是论文 Eq. 1 的“直接拼接”基线。符号 \(\oplus\) 表示连接,\(\Gamma\) 表示逐坐标正弦位置编码。它缺少结构性隔离,改变形状码时可能连带改变颜色。
Eq. 2 中 \(m\) 控制频带数量。论文只给出这一编码定义,没有披露 \(m\) 的具体取值。
形状通过坐标变形,外观延迟到颜色分支
Conditional shape deformation
四层 deformation MLP \(T\) 接收位置与形状码,对每个位置编码频带输出位移。论文先以 \(\tanh\) 把每个分量限制在 \([-1,1]\),再把它加到原始正弦编码上。该设计把形状变化表达为基础体场的平滑变形。
Deferred appearance conditioning
外观码与视角方向编码一起进入 radiance 分支;密度先由变形位置预测。外观码因此无法直接改变密度,构成外观编辑保持几何的结构约束。
这是 Eq. 3 的浏览器安全表达。\(\Delta\mathbf{x}\) 在每条坐标轴上为 \(2m\) 维,位移作用于位置编码后的每个频带。它与 Nerfies 的局部、单场景 deformation 不同:这里用类别级形状码变形不同实例的全局体场。
Eq. 4 是完整生成器。渲染整张图时,论文简写为 \(\mathcal{F}_{\theta}(v,\mathbf{z}_s,\mathbf{z}_a)\),其中空间采样、体渲染积分和视口范围 \(R\) 被省略。
CLIP 嵌入产生可复用的潜变量位移
Eq. 5 输出的是局部编辑方向。示例图路径将 \(\hat{\mathcal{E}}_t(t)\) 换成 \(\hat{\mathcal{E}}_i(I_e)\),其余模块共享。
Eq. 6 使用 cosine distance。论文先做了一个小型多视角检查:两辆车各采样上半球 \(12\times12=144\) 个视角;同一对象跨视角的 CLIP 距离小于不同对象同视角的距离。该观察支持把 CLIP 当作视角相对稳定的语义约束。
原论文 Figure 2 报告上述 CLIP 多视角一致性检查。论文没有报告重复试验、置信区间或显著性检验,因此这项证据只支持所选对象上的观察。
阶段一:学习类别级生成器
公式按论文 Eq. 7–9 的符号保留。正文未分别展开生成器与判别器的完整交替更新方向;复现时需要明确各自的最小化或最大化约定。主系统代码未公开,因此无法据公开仓库核实其符号实现。CLIP 项权重 \(\lambda_c\) 的具体数值也未披露。
Eq. 7 使用 non-saturating GAN objective 与 real-image gradient regularization。训练图像只有随机单视角,且不提供相机姿态;\(v\) 从上半球先验采样。
阶段二:冻结生成器、判别器与 CLIP,只训练两个 mapper
Eq. 8–9 中帽号表示冻结权重。判别器项限制结果留在真实对象分布附近;CLIP 项使语义接近目标。文本 \(t\) 来自预定义 prompt library \(\mathcal{T}\),论文没有公开该库的完整内容。
从单张真实图像恢复相机与两个潜变量
真实图像的相机姿态和潜变量未知。作者借鉴 EM 式交替更新:依次优化相机 \(v\)、形状码 \(\mathbf{z}_s\)、外观码 \(\mathbf{z}_a\)。每个子问题同时使用像素重建误差和 CLIP 距离。
Eq. 10–12 中 \(\mathbf{z}_n\) 每步从标准 Gaussian 采样,\(\lambda_n\) 在整个 inversion 中从 1 线性衰减到 0,用噪声改善优化鲁棒性。论文给出 \(\lambda_v=0.1\)、\(\lambda_s=\lambda_a=0.2\),没有给出 inversion 总迭代数、每个子问题的更新步数或初始化策略。
论文公开了架构与优化器,训练日程仍有关键缺口
Datasets
- Photoshapes:150K 椅子,按引用工作协议渲染为 128×128;每个对象只使用一个随机视图。
- CARLA:10K 汽车,模拟器渲染为 256×256;每个对象一个随机视图。
- 训练图像不附相机姿态;模型从上半球相机先验采样。
Generator
- conditional NeRF:8 层 MLP,每层 256 hidden units,输入维度 64,ReLU。
- deformation network:4 层 MLP,每层 256 hidden units,ReLU。
- \(\mathbf{z}_s,\mathbf{z}_a\) 各 128 维,均从 normal distribution 采样。
Mappers and discriminator
论文所列 mapper 的 128→256→128 通道配置与 CLIP 原始嵌入之间如何连接,正文没有披露输入投影细节;该通道表不能直接确定主系统 CLIP embedding 的维度。
- shape / appearance mapper 均为 2 层 MLP,channel sizes 为 128、256、128,ReLU。
- discriminator 采用 PatchGAN。
- 论文没有说明 CLIP backbone、PatchGAN 层数与 patch 尺度。
Optimization
- Adam,初始 learning rate \(10^{-4}\)。
- 每 50K steps 将 learning rate 乘 0.5。
- inversion:Adam,从 \(10^{-3}\) 开始,每 100 steps 乘 0.75。
- \(\lambda_r=0.5,\lambda_v=0.1,\lambda_s=\lambda_a=0.2\)。
- 全部模型在 NVIDIA V100 上训练。
| 复现项目 | 论文状态 | 实际影响 |
|---|---|---|
| batch size、总 steps、训练时间 | 未公开 | 无法精确复现计算成本与收敛日程 |
| Adam betas、weight decay、precision | 未公开 | 优化动态存在自由度 |
| CLIP backbone 与预处理 | 主体论文未公开 | 文本图像相似度与显存需求不可确定 |
| 完整 prompt library | 未公开 | mapper 的支持概念范围不可复核 |
| 视角先验具体范围与采样密度 | 仅写 upper hemisphere | 生成器几何先验不可精确还原 |
| inversion 迭代次数与初始化 | 未公开 | 真实图像结果和时间不可精确复现 |
| 主系统完整代码与 checkpoint | 官方仓库未提供 | 论文主体无法端到端运行 |
速度优势清楚,质量证据以 FID 与用户匹配为主
Table 1 · 编辑耗时,20 张图平均秒数
| 方法 | Chairs 128×128 | Cars 256×256 | ||
|---|---|---|---|---|
| Shape | Appearance | Shape | Appearance | |
| EditNeRF | 30.0 | 15.9 | 33.2 | 16.8 |
| Ours | 0.58 | 0.51 | 2.12 | 1.98 |
CLIP-NeRF 的 mapper 是一次前向推理;EditNeRF 每次编辑都优化 latent code 与部分网络。按表中数字,chairs shape 约快 51.7 倍、appearance 约快 31.2 倍;cars shape 约快 15.7 倍、appearance 约快 8.5 倍。表格包含 inference/optimization 与单视图 rendering 时间。
Table 2 · 编辑前后 FID,越低越好
| 编辑 | 方法 | Chairs before | Chairs after | 变化 | Cars before | Cars after | 变化 |
|---|---|---|---|---|---|---|---|
| Color | EditNeRF | 36.8 | 40.2 | +3.4 | 102.8 | 118.7 | +15.9 |
| w/o disentanglement | 52.5 | 54.3 | +1.8 | 69.2 | 69.9 | +0.7 | |
| Ours | 47.8 | 49.0 | +1.2 | 66.7 | 67.2 | +0.5 | |
| Shape | w/o disentanglement | 52.5 | 53.2 | +0.7 | 69.2 | 71.1 | +1.9 |
| Ours | 47.8 | 48.4 | +0.6 | 66.7 | 67.8 | +1.1 |
FID 使用从潜空间随机抽取、不同视角渲染的 2K 图像,先计算重建图分布,再对这些图进行不同编辑并重算。EditNeRF 需要人为 scribble,论文因此没有报告其 shape-edit FID。结果支持“编辑后分布质量下降较小”;它没有直接测量提示词遵循度或同一对象的几何保持。
Table 3 · 用户匹配准确率
| 类别 | Text | Exemplar | 平均 |
|---|---|---|---|
| Chairs | 0.821 | 0.877 | 0.849 |
| Cars | 0.814 | 0.859 | 0.837 |
23 位参与者完成 20 个问题;每题包含 5 个由 5 个随机文本或示例图驱动的结果,参与者无限时完成五路匹配。随机猜测基线为 20%。论文没有报告参与者背景、置信区间、题目分配方式或显著性检验。
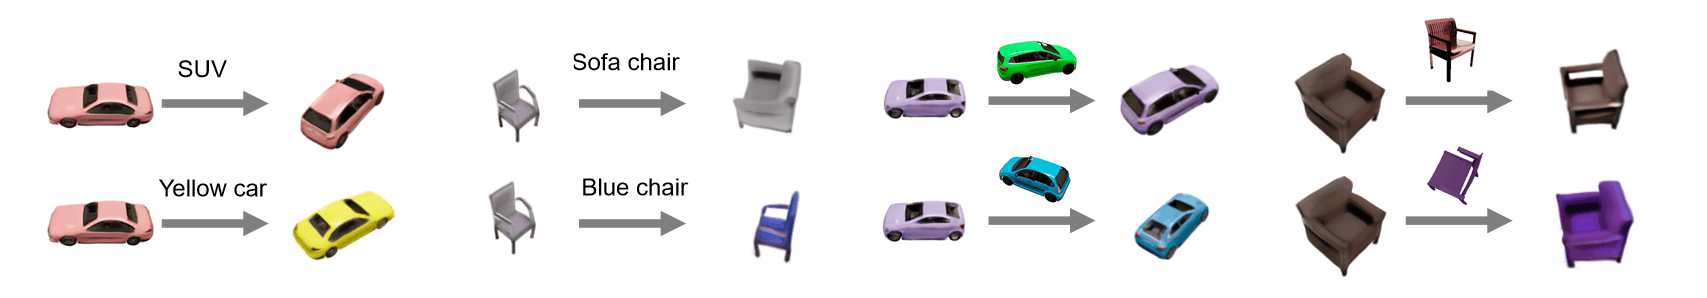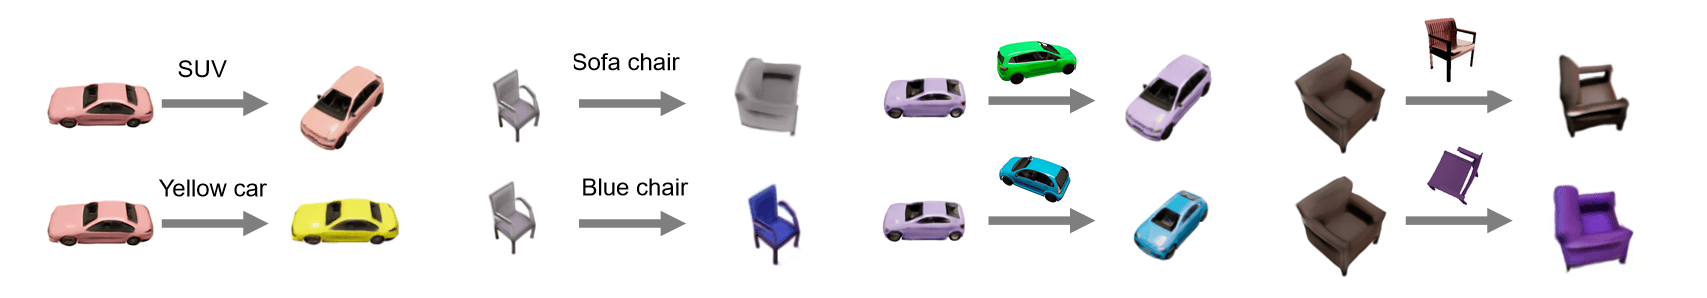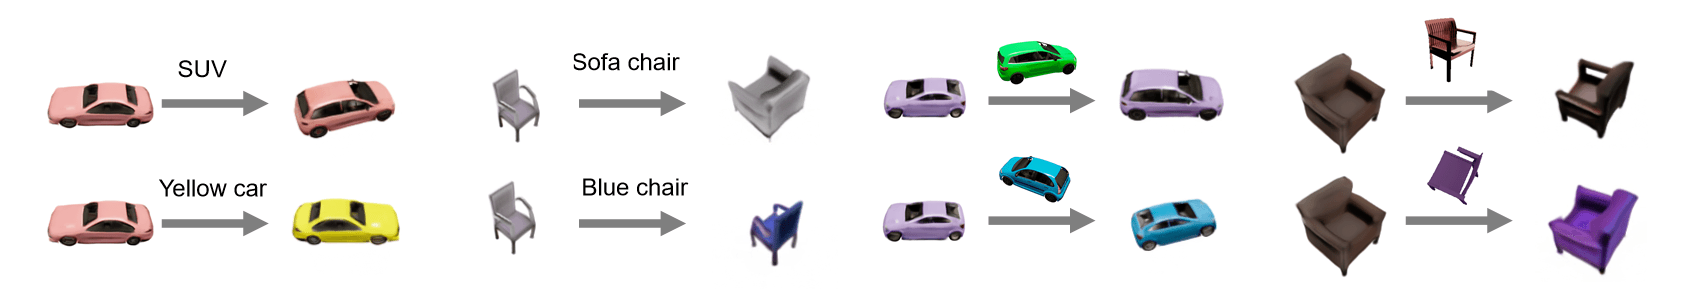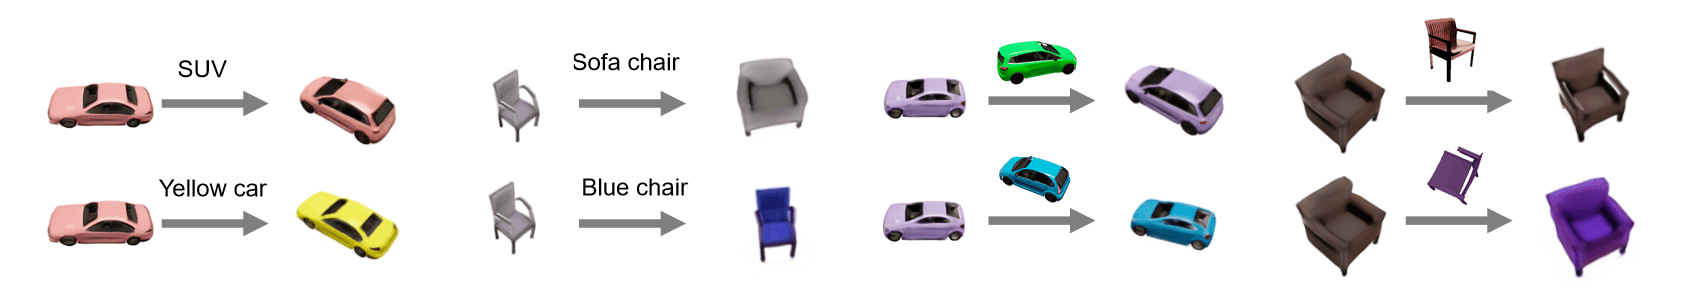
Figure 3 比较 EditNeRF 的局部 scribble 编辑与 CLIP-NeRF 的文本编辑;Figure 4 展示解耦结构减少形状编辑时的颜色串扰;Figure 5 比较 inversion 的 w/o CLIP、EditNeRF 与完整方法;Figure 6–7 分别展示文本与示例图编辑;Figure 8 展示真实单图 inversion 后的形状与外观编辑。
消融说明了两个组件的作用,也留下因果证据缺口
移除 disentanglement
Figure 4 显示直接条件化的模型在 shape edit 时改变颜色;Table 2 中完整模型的重建 FID 与编辑后 FID 整体更低。该消融同时改变了 deformation prior 与条件注入位置,因此无法分离两者各自贡献。
移除 inversion 的 CLIP 项
Figure 5 中,仅 photometric loss 的单视图 inversion 无法完整恢复三维对象;加入 CLIP 后定性结果更好。论文没有数值指标,也没有展示不同相机初始化下的鲁棒性。
CLIP view consistency probe
Figure 2 对两个对象与 144 个视角做 cosine distance 检查。它支持“所选案例中 CLIP 更关注对象语义”,尚不足以建立跨类别、跨遮挡条件下的普遍视角不变性。
Single-NeRF necessity test
Supplement Figure 5 表明冻结密度分支、用 patch-based CLIP loss 微调颜色分支可以改色;相同思路无法得到满意的 shape deformation。作者据此认为 conditional latent space 对形状编辑重要。
潜空间支持连续编辑、缩放与插值
论文 Eq. 13 与 Supplement Eq. 1 沿 mapper 方向缩放,Figure 12 以 0.2 为步长展示编辑强度。该操作也适用于 exemplar 方向。
Figure 13 / Supplement Figure 4 以 0.1 为步长线性插值形状与外观潜变量。连续输出说明局部路径平滑,但论文没有测量插值路径的几何合法性。
Continuous manipulation
同一文本或示例图可以先改形状再改外观,也可以交换顺序。Figure 9 与 Supplement Figure 1 给出 Blue Jeep → Orange SUV 等例子。
同色系细化
Supplement Figure 2 显示 blue、dark blue、light blue、dark cyan 等整对象外观编辑。它仍无法进行局部部件颜色控制。
明确失败模式
Figure 11 展示局部复杂指令与分布外指令失败,例如“前轮红、后轮绿”的局部多区域颜色要求,以及 formula racing car、带两只扶手和中空靠背的办公椅。作者把原因归于类别潜空间与预训练 CLIP 的表达能力。
官方仓库公开的是补充实验代码
| 组件 | 论文描述 | 官方仓库可核查内容 |
|---|---|---|
| Disentangled conditional NeRF | 8 层生成器 + 4 层 deformation MLP | 未公开 |
| Shape / appearance mapper | 两个 2 层 MLP | 未公开 |
| GAN category training | PatchGAN + non-saturating objective | 未公开 |
| Inverse manipulation | 交替优化相机、形状码、外观码 | 未公开 |
| Single-NeRF color editing | Supplement 的 latent-space necessity 实验 | 公开,基于 nerf-pytorch |
公开的 supplyment/ 目录加载 CLIP ViT-B/32,把生成 patch 双线性缩放到 224×224;默认只优化 coarse/fine NeRF 的 rgb_linear,可用开关加入 alpha、feature 和 view layers。Adam betas 为 \(\beta_1=0.9,\ \beta_2=0.999\),脚本默认 learning rate 为 \(5\times10^{-4}\)、总循环上限 210001,并保留原 NeRF 的 photometric loss。
README 的示例命令把 \(\lambda_{\mathrm{clip}}=1.0\),默认文本为 “A green excavator”,patch sample_scale 默认为 60。README 还明确说明:更换到 red 等颜色时可能需要手工打开 alpha、feature、view 分支,并调节 patch size。
贡献有效,实验范围与复现材料限制了结论强度
Strengths
- 将语义控制、类别生成式 NeRF 和跨视角渲染整合成清楚的两阶段系统。
- 形状变形与外观延迟条件化提供可解释的结构归纳偏置。
- 同一个 mapper 同时接受 CLIP 文本与图像嵌入,接口统一。
- 与逐例优化相比,feed-forward mapper 带来数量级的交互速度改善。
- 作者公开失败案例,并在 supplement 检查连续控制与 single-NeRF 边界。
Weaknesses
- 只覆盖椅子和汽车,均为单对象、受控背景的类别分布。
- 没有 geometry metric、multi-view consistency metric 或 prompt fidelity 自动指标。
- EditNeRF 比较的数据规模、视角数、相机监督与交互形式不同。
- 关键超参数、prompt library、训练步数与完整代码缺失。
- CLIP 的多视角 probe 规模很小,无法支持广泛的姿态不变性结论。
Potential improvements
- 用多视角 CLIP / DINO 特征、深度与法线一致性联合监督 mapper,直接测量编辑后的几何与视角一致性。
- 把全局 128D 潜变量扩展为部件级或空间场控制,以支持局部文本、区域 mask 和组合编辑。
- 在 test time 进行 renderer-in-the-loop search:mapper 给出初始方向,随后用多视角奖励与形状合法性约束修正。
- 用 3D-aware foundation model 或跨视角扩散先验替代单视图 CLIP,降低语义方向与相机、数据共现之间的纠缠。
- 公开 prompt library、checkpoints、随机种子和完整训练配置,并在同数据、同监督、同硬件上重做基线。
资料与版本
- arXiv 2112.05139v3,2022-03-02;本地归档 PDF SHA-256:
cec69267c2d521e642c90419ec39aeda4822c06df90a34be25db1ea1f014ec9e。 - CVPR 2022 proceedings page,页码 3835–3844。
- 官方 Supplement PDF,3 页,SHA-256:
4561d306dea737c99bb96a04deb4b322577ef0ce094ef037f5321d65ad194127。 - 官方项目页,作者、机构、通讯作者标记、演示与视频。
- 官方 GitHub repository,README、framework 图和 single-NeRF color editing 补充代码。