修补视频,
还要让运动成立
CoCoCo 把文本引导视频修补拆成三项工程问题:跨帧运动一致性、文本与区域的可控对应,以及个性化 Text-to-Image 模型与九通道修补 UNet 的兼容。
论文身份与证据状态
论文 PDF、arXiv 条目和项目主页一致给出九位作者。PDF 首页以星号明确标记 Xianbiao Qi 为通讯作者,第一作者是 Bojia Zi。
正式信息
标题:CoCoCo: Improving Text-Guided Video Inpainting for Better Consistency, Controllability and Compatibility
作者:Bojia Zi, Shihao Zhao, Xianbiao Qi, Jianan Wang, Yukai Shi, Qianyu Chen, Bin Liang, Kam-Fai Wong, Lei Zhang
机构:CUHK、HKU、Tsinghua、IDEA
版本:arXiv v1;没有在论文或 arXiv 页面声明正式会议。
来源冲突
项目主页 Citation 区把编号写成 2403.12305,并在标题中多出 “blue”;当前 GitHub README 的页面作者行还多出 Rong Xiao。论文 PDF、arXiv 元数据与仓库 BibTeX 均支持 2403.12035 及九位作者,因此本页以这三处一致证据为准。
PDF SHA-256:3D9D0311876FF058F620EF0E0B24FECDCD672F92DACD6F0FD02DC9A720F2280A
研究问题:修补区域必须同时服从三种约束
输入是一段视频、每帧掩码和文本描述;输出是在掩码内生成动态内容、在掩码外尽量保留原视频的完整视频。困难来自时间、语义和模型结构三个方向。
一致性
仅沿时间轴做 attention 时,同一空间位置能看见其他帧,却看不见其他空间位置。修补对象的运动容易脱离周围背景和相邻区域。
可控性
随机掩码可能没有覆盖 caption 中的对象,或者只覆盖对象的一部分。训练信号会把文本与无关区域配对。
兼容性
生成模型只接收四通道噪声 latent;修补模型接收四通道噪声 latent、四通道 masked latent 和一通道 mask,共九通道,参数形状无法直接替换。
形式化输入输出
- 视频 \(v^{1:f}\in\mathbb{R}^{f\times c\times w\times h}\),\(f\) 是帧数。
- 二值掩码 \(m^{1:f}\),论文写 \(v_m^{1:f}=v^{1:f}\odot m^{1:f}\)。掩码的前景取值方向在正文中没有额外定义,复现时应以实现预处理为准。
- 文本提示 \(y\),经 CLIP text encoder 得到 \(c_\theta(y)\)。
- 模型输出噪声预测 \(\epsilon_\theta\),DDIM 反向采样还原 latent,再由 VAE decoder 得到修补视频。
完整流程
与 caption
对象框与 phrase
概率采样
九通道条件
训练 motion modules
CFG 引导
修补视频
Motion Capture Module
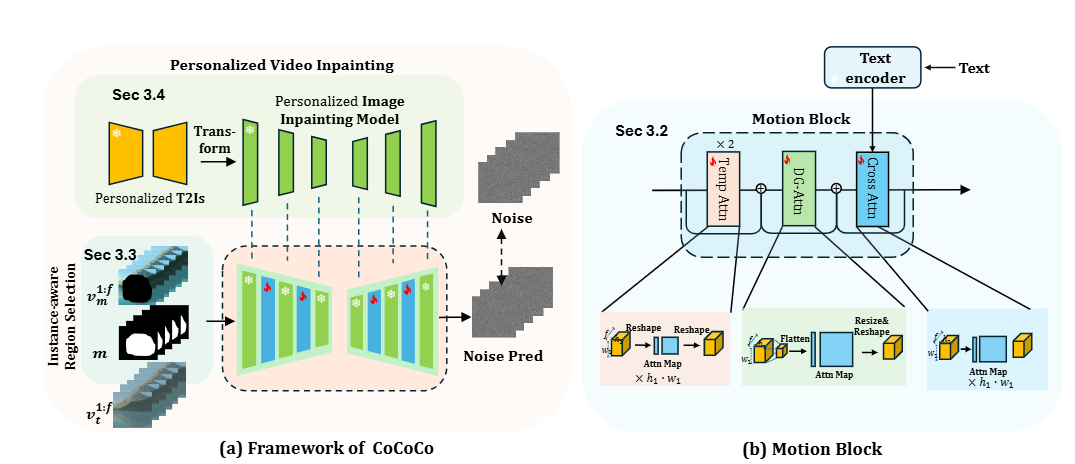
每个 motion block 顺序包含两层 Temporal Self-Attention、一层 Damped Global Attention(DGA)和一层 Textual Cross-Attention。前两层继承 AnimateDiff v2;DGA 与文本 cross-attention 使用 Kaiming 初始化,四层采用相同学习率训练。
Temporal attention 将每个空间坐标独立处理,只让长度为 \(f\) 的帧序列互相注意。DGA 先把空间分辨率从 \(w_1\times h_1\) 缩小到 \(w'_1\times h'_1\),再把帧和空间展平成长度 \(L=fw'_1h'_1\) 的序列进行 self-attention。这样能在降低注意力规模的同时传播跨空间、跨时间的信息。
原图用虚线表示可互相注意的位置:Temporal Attention 只连接相同空间坐标的多帧 token;DGA 连接缩小后所有帧、所有位置。PDF Figure 3 为关键结构示意,当前单文件使用文字与公式完整重建其含义。
文本 Cross-Attention
DGA 的缩小视觉 token 作为 query,文本 embedding 作为 key/value。论文声称这一做法把 attention map 从 \((fw_1h_1l_{\mathrm{text}})^2\) 降到 \((fl_{\mathrm{text}})^2\)。这里的复杂度描述写法不够严谨:标准 cross-attention 的权重矩阵一般为 query 数量乘 key 数量,并不整体平方;读者应把它理解为缩小空间 token 带来的内存下降方向,不能把该表达式当作严格复杂度推导。
Instance-aware Region Selection
- SceneDetect 阈值 20,只保留单场景视频,减少一个训练 clip 跨镜头的问题。
- 第一帧由 Grounding DINO 依据 caption 检测 phrase 和 bounding box。
- 后续帧固定第一帧识别出的 TokenSpan,以同一个 phrase 寻找对应区域,避免同一对象在不同帧返回不同短语。
- 用随机形状 mask 覆盖检测框,形成跨帧对象相关的 precise mask。
- 训练时以 0.7 / 0.2 / 0.1 采样 precise-mask clip、random-mask clip、null-prompt clip。null prompt 对应 classifier-free guidance 的无条件分支。
原论文 Figure 4 展示第一帧检测、TokenSpan 固定 phrase、逐帧 bounding box、随机形状遮罩,以及 precise / random / null 三类训练样本的概率分支。
个性化 T2I 转换
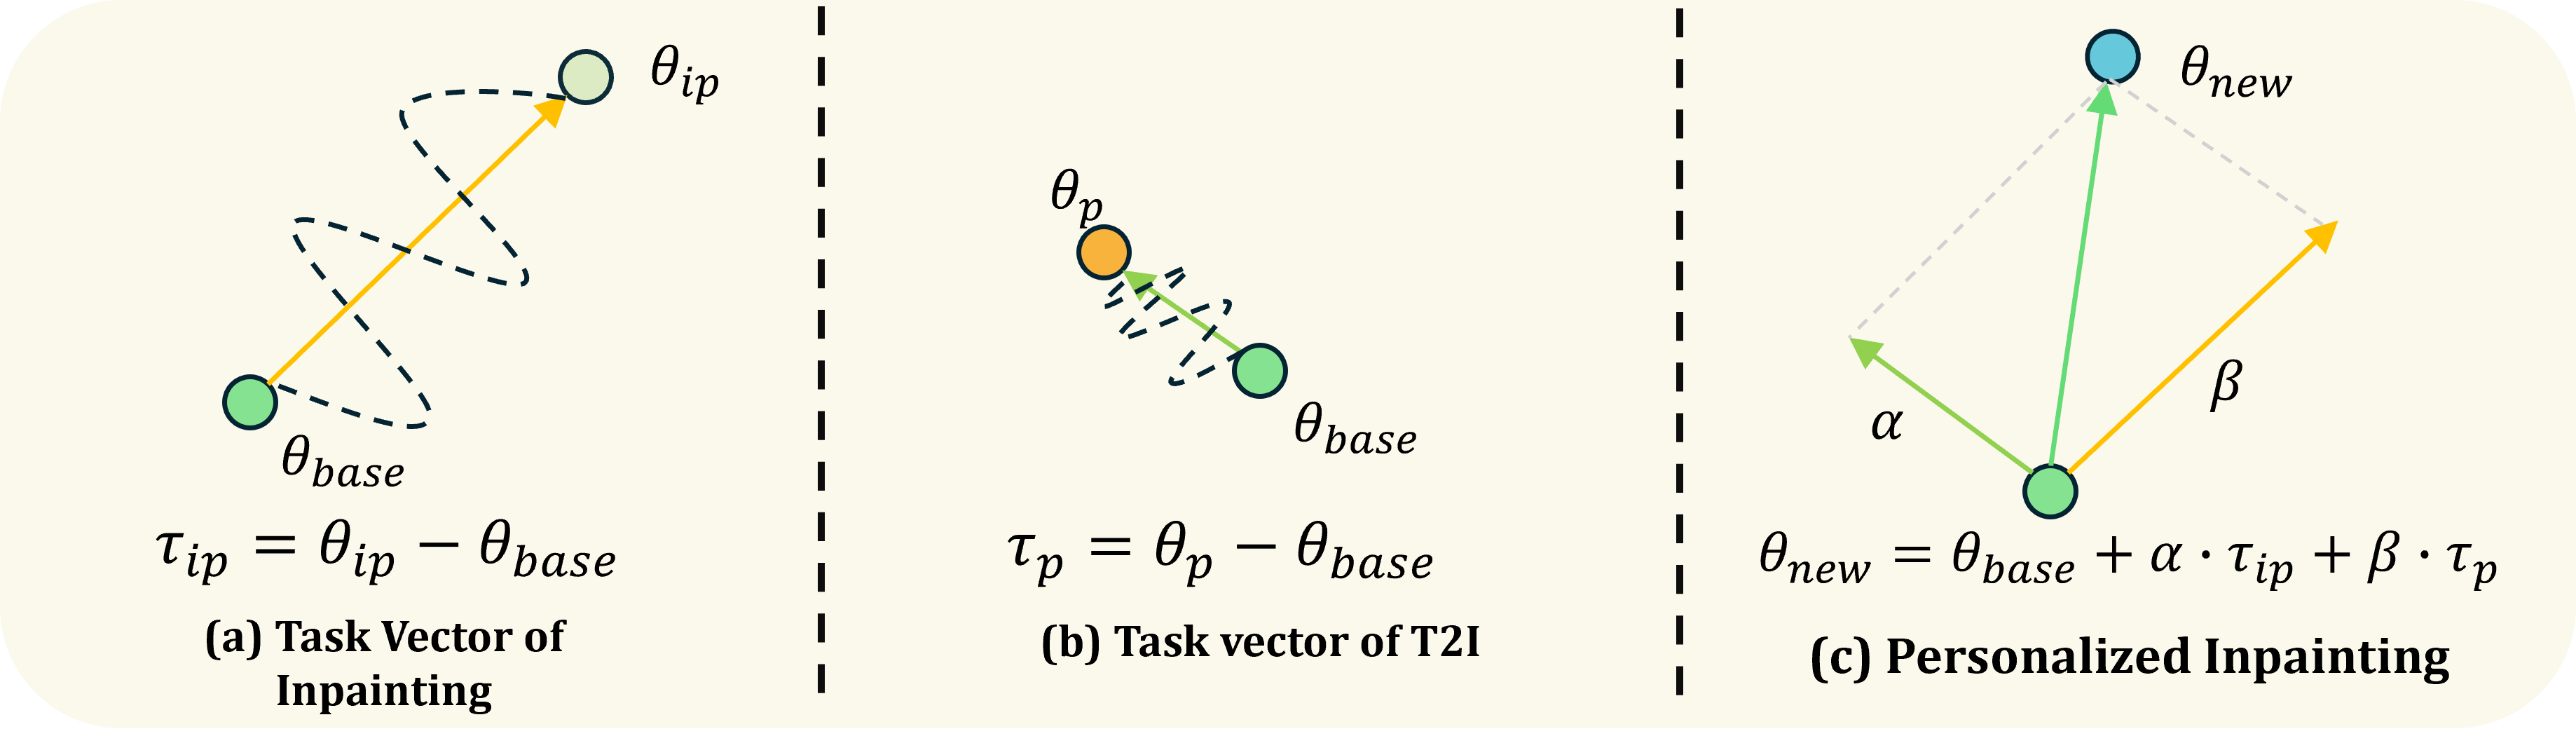
作者观察到 SD 生成模型与修补模型的大部分中深层参数余弦相似度超过 0.95,主要差异集中在浅层和输出层。该观察提供了参数算术可行的经验解释。转换过程不需要为每个个性化模型重新训练 CoCoCo。
数学表示逐式解释
1. 两个 task vector
\(\theta_{\mathrm{base}}\) 是输入层从四通道零填充至九通道的 SD 1.5 生成模型;\(\theta_{\mathrm{ip}}\) 是 SD Inpainting 1.5;\(\theta_p\) 是同一 base 上的个性化 T2I。两个差分分别编码“修补能力”和“个性化外观”。
2. 参数组合
\(\alpha\) 控制修补任务差分,\(\beta\) 控制个性化差分。论文建议 \(\alpha\in[0.5,1.5]\)、\(\beta\in[1,2]\),Appendix Figure 10 显示较大的两者会让模型失效;\(\alpha=0\) 会退化为生成模型,较小 \(\beta\) 则更像普通修补模型。此范围来自经验扫描,没有提供自动选择方法。
3. 前向扩散
VAE 对每帧编码得到 \(z_0^{1:f}\)。调度器在时间步 \(t\) 以 \(\bar{\alpha}_t\) 混合信号与高斯噪声,得到 UNet 需要去噪的 \(z_t^{1:f}\)。
4. 噪声预测目标
\(\bar{m}\) 是缩放到 latent 分辨率的掩码,\(z_{0,m}^{1:f}=\mathcal{E}(v_m^{1:f})\) 是 masked video latent。UNet 同时接收噪声 latent、mask、masked latent、时间步和文本条件,预测当初加入的 \(\epsilon^{1:f}\)。训练只更新 motion modules;图像修补空间模块保持冻结。
5. Attention 张量变换
这条式子把论文排版破碎的 DGA 公式重写为浏览器安全形式。它说明 resize 直接控制 self-attention 的 token 数;论文没有给出 \(w'_1,h'_1\) 的具体比例,官方配置以 Temporal_Light_down_resize 命名对应模块。
训练、数据与推理设置
| 阶段 | 项目 | 论文给出的设置 | 缺失或边界 |
|---|---|---|---|
| 数据 | 来源 | WebVid-10M,超过一千万组 Shutterstock 文本—视频对 | 过滤后实际数量、训练/验证切分版本未给出 |
| 清洗 | SceneDetect | threshold = 20;只保留单场景视频 | 没有报告误检率与剩余样本比例 |
| 检测 | Grounding DINO | 396×512;box 与 phrase threshold 均为 0.2 | 具体 checkpoint 未给出 |
| 采样 | clip | 16 帧;sample stride 4;分辨率 256×384 | 裁剪、缩放、帧率处理未说明 |
| 优化 | AdamW | 学习率 \(10^{-4}\),constant scheduler,一个 epoch,有效 batch size 256,gradient accumulation,mixed precision | GPU 数量、micro-batch、betas、weight decay、warmup、训练时长未给出 |
| 扩散 | DDPM | 1000 个训练时间步 | 代码配置给出 linear beta 0.00085→0.012;论文正文没有这一细节 |
| 初始化 | 空间 / 时间 | SD Inpainting 1.5 空间模块冻结;AnimateDiff v2 初始化两层 temporal attention;DGA 与 text cross-attention 使用 Kaiming | 参数量与 checkpoint 精确版本未给出 |
| 推理 | DDIM | 50 步,CFG 14;RTX 3090 上 1 分钟内完成 | 论文没有给出输入视频长度与耗时测量细节 |
| mask | 来源 | 用户绘制,或 Grounding DINO、CoTracker2、XMem、SAM 自动获得 | mask 传播组合方案没有统一协议 |
9ebe984cf1148470ec67b26e2781e05285f1512b 的验证脚本确实使用 DDIM 50 步;命令行参数默认 CFG 20,README 基础示例写 CFG 10,论文报告 CFG 14。官方仓库 README 仍写“training code is under preparation”,所以当前公开材料无法完整复现训练。公开推理结构核对
configs/code_release.yaml 列出四个 attention block:Temporal_Self、Temporal_Self、Temporal_Light_down_resize、Temporal_Text_Cross,与论文方法结构一致;motion modules 插入分辨率 1、2、4、8 以及 middle block。调度器为 1000 时间步、linear beta,推理脚本固定 50 步。
实验真正证明了什么
测试从 WebVid-10M validation 随机抽 1000 段视频,每段取前 16 帧、步幅 4;作者随机生成 mask 与 prompt。AnimateDiffV3 和 VideoCrafter2 通过 zero-shot inpainting 使用;VideoComposer 使用其文本引导修补模块。投稿时 AVID 未开源,因此主表没有 AVID 数字。
Table 1 · 主结果(完整重建)
| 方法 | 定量结果 | 用户研究选择率 | |||||
|---|---|---|---|---|---|---|---|
| CS ↑ | BP ↓ | TC ↑ | VQ ↑ | TA ↑ | TC ↑ | BP ↑ | |
| AnimateDiffV3* [20] | 25.3 | 7.2 | 96.7 | 14.6 | 20.8 | 12.5 | 25.0 |
| VideoCrafter2* [10] | 26.2 | 7.8 | 96.8 | 2.1 | 8.3 | 2.1 | 6.2 |
| VideoComposer [52] | 19.8 | 21.7 | 96.5 | 12.5 | 16.7 | 29.2 | 4.2 |
| CoCoCo | 24.9 | 6.2 | 97.2 | 72.9 | 54.2 | 56.2 | 64.6 |
* 表示 zero-shot inpainting。CS 是修补区域与文本的 CLIP score;BP 是掩码外像素的 L1 差异,范围 0–255,越低越好;定量 TC 是相邻帧 CLIP feature cosine similarity。用户研究四列是被选为最佳的比例。论文没有披露参与者数量、每位参与者比较的视频数、随机化流程、显著性检验与置信区间。 原稿 VQ 列四行数值合计为 102.1%,正文没有解释这一差异;此处保留原始数值,不据此反推参与人数或归一化概率。
CoCoCo 的 CLIP Score 为 24.9,比 AnimateDiffV3 低 0.4,比 VideoCrafter2 低 1.3;自动文本一致性指标没有取得最高值。
背景 L1 最低,相比 VideoComposer 的 21.7 降低 15.5,说明冻结空间修补先验与训练设计更能保护掩码外区域。
相邻帧 CLIP 相似度最高,但四种方法只差 0.4–0.7 个点,必须结合用户观察和动态样例判断实际意义。
论文展示黄色狗摇头、小女孩换装与黑车三个案例。VideoComposer 的背景变化明显;两种 zero-shot baseline 难以保持掩码内外一致;CoCoCo 的边界和整体运动更协调。动画信息无法由静态 PDF 完整保留。
Table 2 · 消融(完整重建)
| 设置 | CS ↑ | BP ↓ | TC ↑ |
|---|---|---|---|
| w/o MCB & IRS | 21.6 | 8.3 | 96.3 |
| w/o MCB | 23.6 | 8.6 | 96.8 |
| CoCoCo | 24.9 | 6.2 | 97.2 |
从第一行到第二行只加入 IRS:CS +2.0、TC +0.5,但 BP 变差 0.3。第二行到完整模型加入整个 MCB 改造:CS +1.3、BP 改善 2.4、TC +0.4。这个实验支持 IRS 有助于文本—区域对应,也支持完整 MCB 有助于背景与时间一致性。
Table 3 · CoCoCo 与 AVID 的结构差异(完整重建)
| 分组 | 子项 | AVID | CoCoCo |
|---|---|---|---|
| Data processing | Video clip | Random | Keep in one scene |
| Training mask | random | Instance-aware + random | |
| Motion capture module | Attn types | 2× Temp attn | 2× Temp attn 1× DG attn 1× Cross attn |
| Text encoder | None | CLIP text encoder | |
| Transformation strategy | — | ✕ | ✓ |
| Sparse control | — | ✓ | ✓ |
Appendix Table 3 主要是设计对照,没有给 AVID 同协议数值。项目主页后来展示了若干 CoCoCo 与 AVID 同样例结果,但页面仍没有定量表,因此主论文“优于 counterparts”的范围应限定在 Table 1 三个 baseline。
附录带来的额外信息
Figure 9 · 参数相似度
作者比较生成模型和修补模型六类层:conv、query、key、value、output projection、FFN。多数中间层 cosine similarity 超过 0.95,差异更集中于浅层和输出层。该观察解释 task-vector 组合为何有可能工作,但没有建立参数相似度与生成质量之间的因果关系。
Figure 10 · 参数敏感性
以 Counterfeit V3.0 和 SD Inpainting 1.5 扫描 \(\alpha,\beta\)。较低 \(\alpha\) 会略改背景;较大 \(\beta\) 增强 checkpoint 风格;两者过高会失效。论文只提供可视网格,没有自动指标曲线。
Figure 11 · 任务范围
额外案例覆盖 uncropping、retexturing 和 swapping。uncropping 使用 AnimateDiff V3 的 sparse control 引导细节,说明模型能组合外部控制模块。
动态图限制
PDF 使用可点击动画注释,静态提取只能看到代表帧。运动一致性主张需要在 Acrobat 或项目页观看完整 clip;单帧图无法验证抖动、速度与身份漂移。
Reviewer 视角
优点
- 三个痛点对应三个具体模块,方法动机清楚,且都能接入已有 latent diffusion UNet。
- IRS 直接修复 caption 与 mask 错配这一训练数据问题,成本低于重新标注完整分割数据。
- 冻结空间模块、只训练 motion module,保留 SD 修补能力并降低训练参数量。
- task-vector 转换把大量社区 T2I checkpoint 带入视频修补,不需要逐模型训练。
- 主表同时测文本、背景、时间和用户偏好,避免只用单一 CLIP score。
缺点
- 没有训练代码、训练硬件、过滤后数据量、参数量、训练时间和完整优化器设置,复现闭环不完整。
- 用户研究缺少样本量、协议和统计检验;选择率的可信区间无法判断。
- TC 指标可能奖励静止结果;缺少 optical flow、tracking consistency 或运动幅度控制。
- 消融把 DGA 与 text cross-attention 合并,无法识别单个组件贡献。
- 没有与 AVID 做同协议定量比较,Appendix 只比较设计。
- 1000 个测试视频来自 WebVid-10M validation,与训练数据同源;跨数据集、真实用户 mask 与长视频泛化没有验证。
- Grounding DINO phrase 与 box 误差会直接污染训练,论文没有分析检测失败案例。
可以形成后续工作的方向
- 执行感知 mask curriculum:记录 detector confidence、object visibility 和 mask coverage,在训练中对失败 frame 降权,避免错误 box 被当作精确监督。
- 可分解的时空模块:分别消融 DGA、text cross-attention、resize 比例和插入层级,以 motion-aware metric 分析每个模块。
- 长视频记忆:官方实现用 sliding window 支持任意长度,研究中可加入跨窗口 key/value memory 与重叠区一致性损失。
- 自动 task-vector 系数:根据背景保持、prompt 对齐和个性化身份三个目标,在测试时搜索 \(\alpha,\beta\),并用失败检测器拒绝参数组合。
- 三维引导:把深度、相机轨迹、3D track 或 scene flow 作为 sparse control,约束修补对象与镜头运动、遮挡关系和反射保持一致。
复现清单与已知不确定项
能够依据公开材料确定
- 模型基础:SD Inpainting 1.5 + AnimateDiff v2 motion 初始化。
- 四层 motion block 类型及插入分辨率。
- DDPM 1000 步训练、DDIM 50 步推理。
- 视频尺寸、帧数、步幅、三类样本概率。
- Grounding DINO 输入尺寸和阈值。
- AdamW、学习率、scheduler、epoch、有效 batch size。
- 公开推理脚本、checkpoint 入口、SAM2 demo 与个性化转换脚本。
公开材料仍然缺失
- 训练代码与最终训练配置。
- WebVid 过滤后的精确清单和样本数。
- GPU 数量、训练时长、随机种子与 micro-batch。
- AdamW betas、weight decay、gradient clipping。
- DGA resize 的论文级精确比例说明。
- 评测 prompt 与 mask 的生成代码。
- 用户研究的参与者与显著性统计。
- 各 personalized checkpoint 对应的 \(\alpha,\beta\) 完整记录。
实际推理顺序
- 准备 RGB frame 数组与同长度 mask;mask 可人工绘制或由 SAM2 等工具传播。
- 载入 SD Inpainting 1.5 的 tokenizer、text encoder、VAE、九通道 UNet。
- 载入 CoCoCo 的四组 motion module 权重。
- 可选:把 T2I checkpoint / LoRA 转为参数差分,并按系数写入 UNet、text encoder、VAE。
- 把 masked video latent、mask 和随机噪声 latent 拼接为九通道 UNet 条件。
- 执行 50 步 DDIM 与 classifier-free guidance。
- VAE 解码后组合输出视频;长视频由仓库 sliding-window 功能处理,论文正文没有给窗口边界协议。
References
- Zi et al. CoCoCo, arXiv:2403.12035v1 — 标题、作者、提交日期、版本与摘要。
- CoCoCo 官方项目页 — 动态案例、模块说明、作者与通讯标记;Citation 区含已注明的编号错误。
- CoCoCo 官方代码仓库 — 推理代码、配置、checkpoint 入口、SAM2 demo 与 task-vector 转换。
- AVID: Any-Length Video Inpainting with Diffusion Model — 论文主要视频修补参照。
- AnimateDiff — temporal motion module 初始化与个性化 T2I 兼容基础。
- Task Arithmetic — 参数差分组合思想来源。