重训 ControlNet 太贵,逐帧复用又缺少时间建模
SDv1.5 社区已经积累大量深度、边缘、法线、姿态等 ControlNet。新骨干的通道、空间层级、噪声尺度与时间维度各不相同,现成控制特征无法直接注入。论文将这个问题重写成“冻结两端、学习特征映射”。
核心假设
预训练 ControlNet 已把不同控制模态编码到可迁移的结构特征空间。小型适配器可以学习从 SDv1.5 ControlNet 特征到目标骨干特征的映射,同时用时间卷积与时间注意力补上视频一致性。
证据边界
论文在 DAVIS 2017、COCO val2017 以及若干定性样例上验证。开放域长视频、复杂镜头运动、人物身份保持、文本渲染、用户研究与安全公平性没有系统评测。
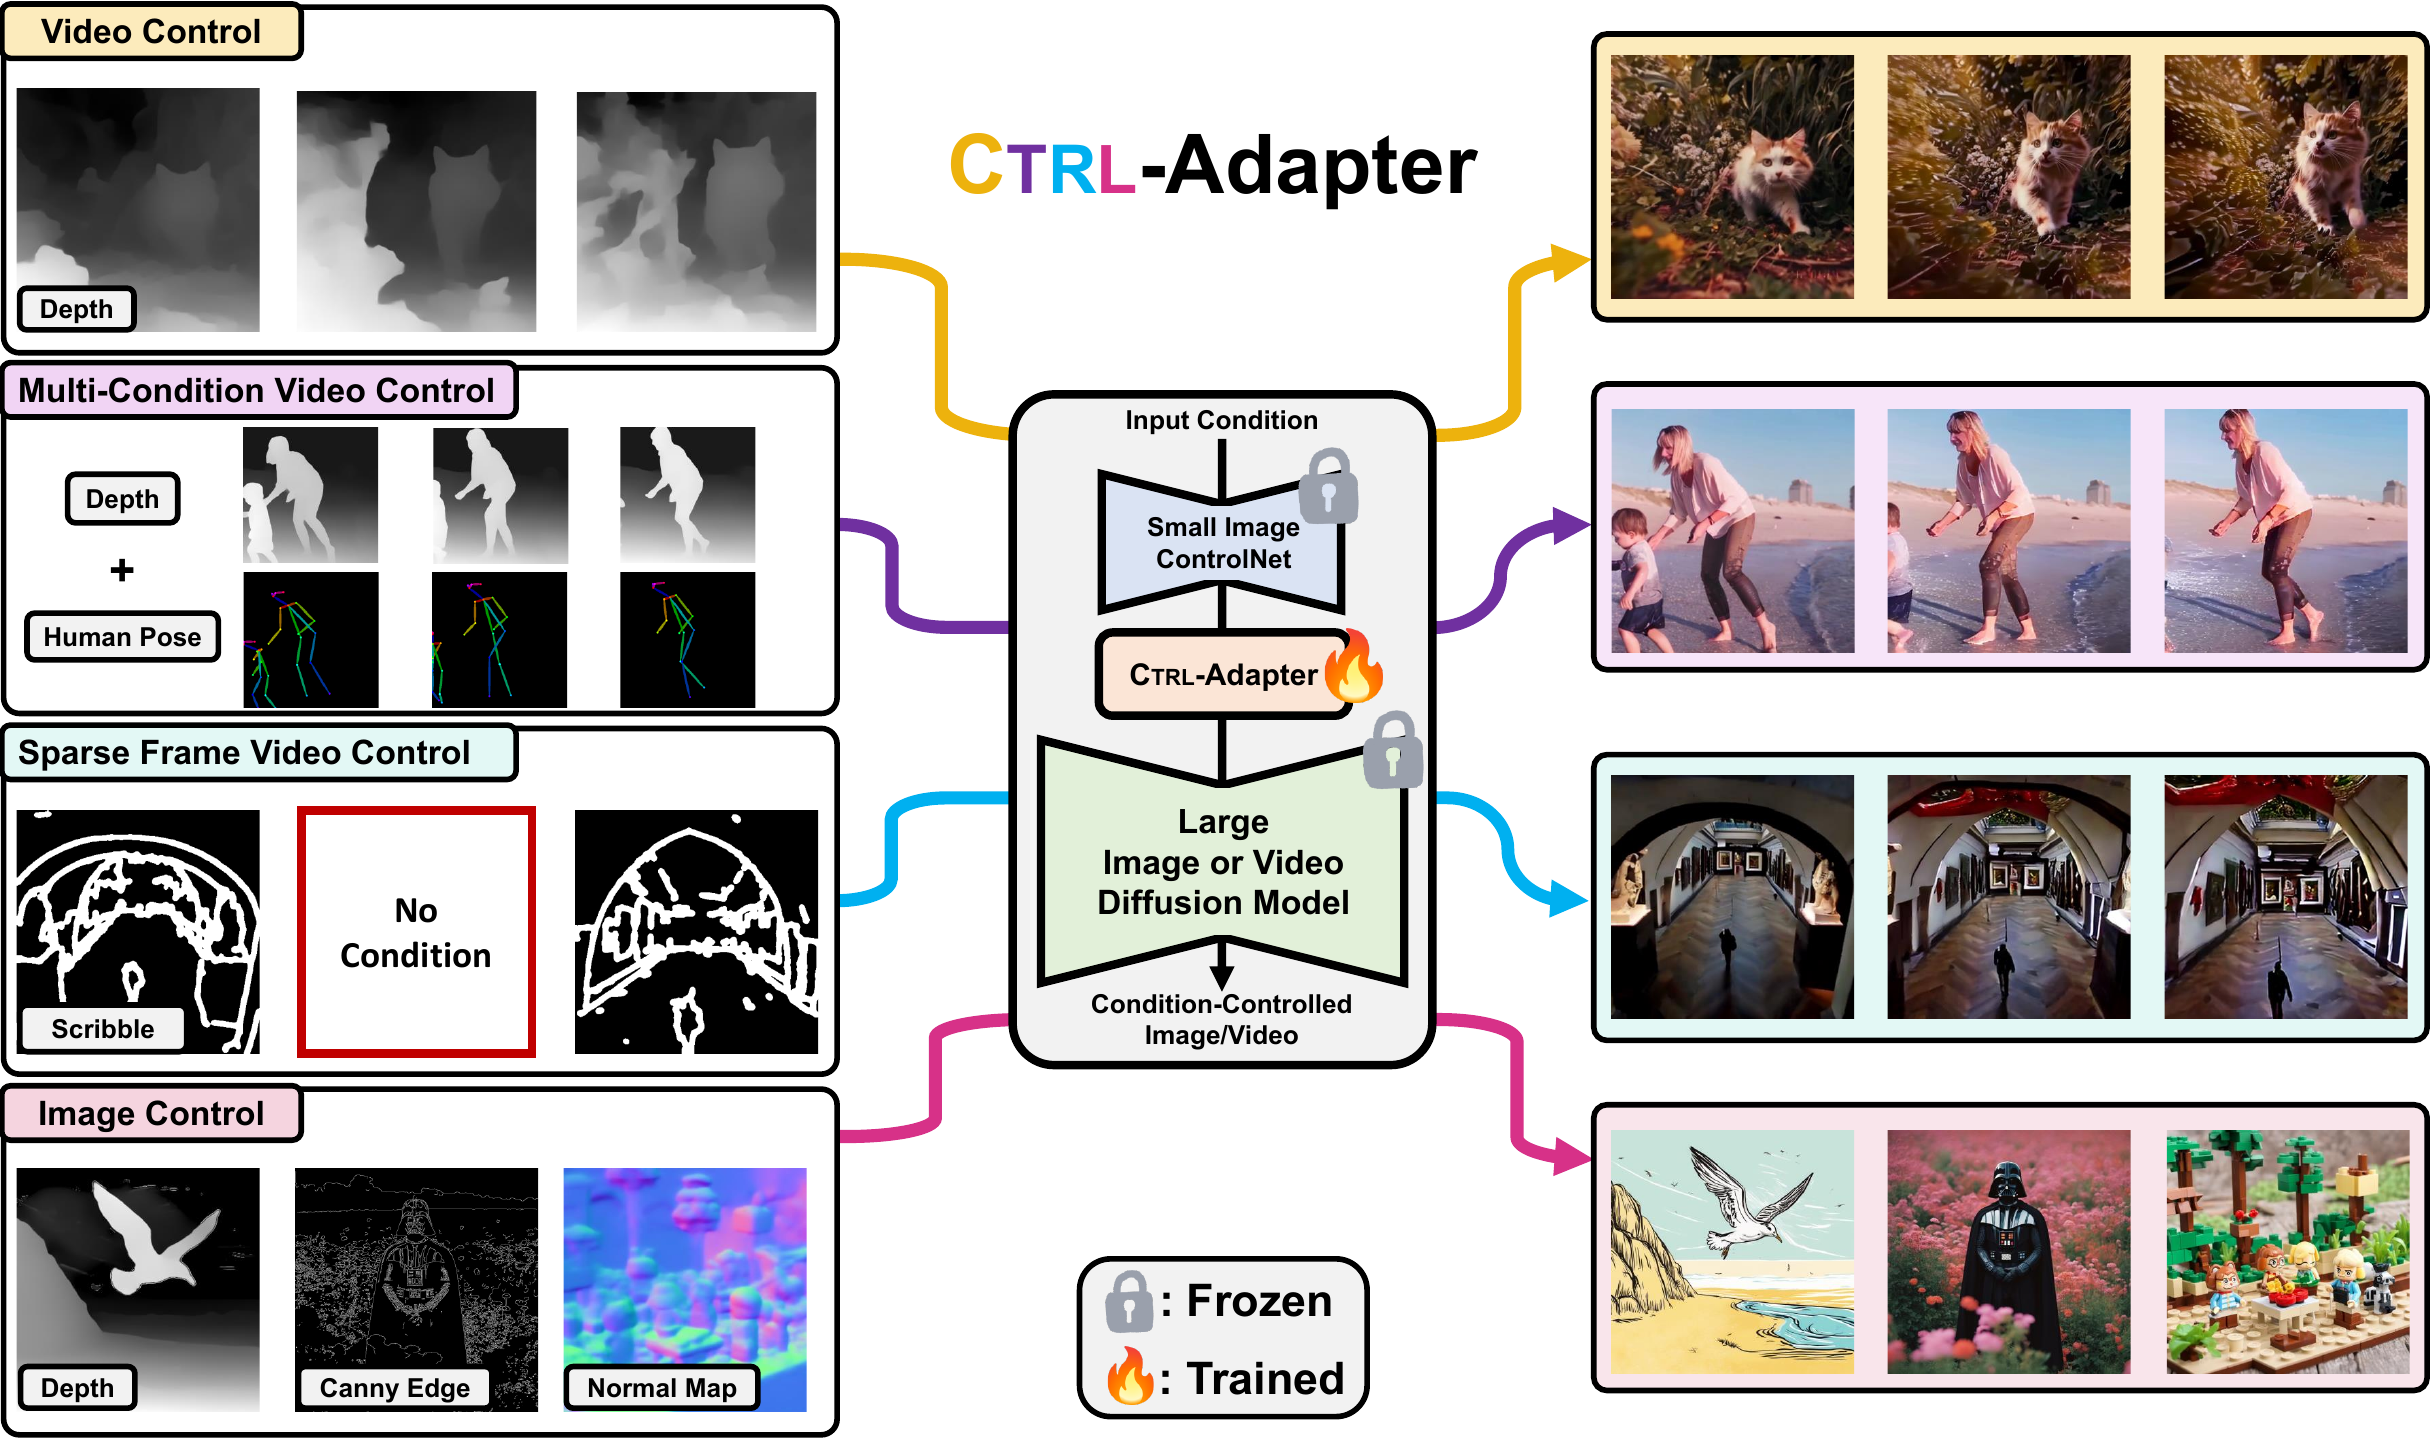
输入、输出与优化对象
输入
\(F\) 帧 RGB 视频 \(\mathbf{x}\in\mathbb{R}^{F\times 3\times H\times W}\),文本条件 \(\mathbf{c}_{\mathrm{text}}\)、可选首帧条件 \(\mathbf{c}_{\mathrm{img}}\)、逐帧或稀疏控制 \(\mathbf{c}_{f}\),以及扩散时间 \(t\)。图像被视为 \(F=1\) 的视频。
输出
目标骨干生成的受控图像或视频。CTRL-Adapter 输出与目标 U-Net/DiT 中间特征同形的残差,注入目标模型对应层。
冻结部分
SDv1.5 ControlNet 与目标扩散骨干参数全部冻结;训练时只更新适配器,以及多条件设置下的路由器。
目标函数
延续目标骨干的扩散训练目标。adapter 通过最终噪声/速度/去噪预测的误差获得梯度,没有额外的特征匹配损失。
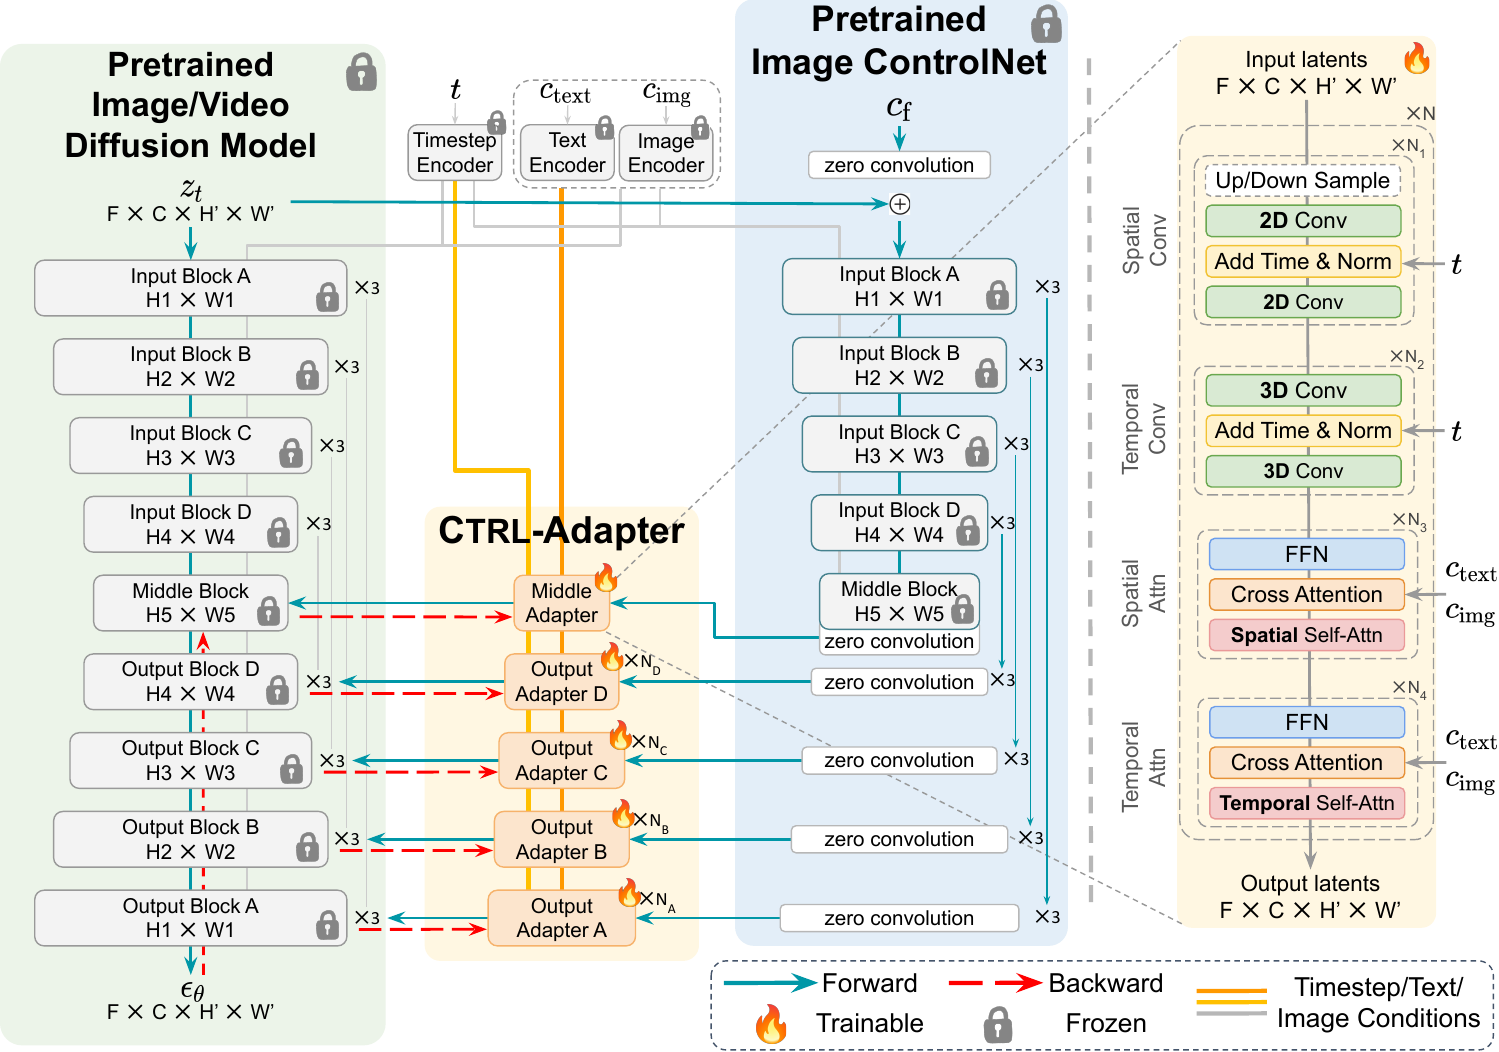
完整数据流
四模块如何工作
Spatial Conv
处理单帧局部结构,经时间嵌入调制与归一化;承担尺寸与通道映射的一部分。
Temporal Conv
沿帧维传播邻域信息,减少逐帧 ControlNet 特征造成的闪烁与漂移。
Spatial Attention
在单帧空间位置间建立全局关系,并接收文本或首帧条件的 cross-attention。
Temporal Attention
在同一空间位置跨帧交互,同时接收条件 embedding,增强长程时间一致性。
U-Net 映射
按最接近的 latent 高宽匹配目标层。默认视频配置覆盖 mid 与 output A/B/C/D,每个尺度位置放置三个 adapter。
DiT 映射
取 ControlNet 最大空间特征(block A),经 zero-conv 匹配通道;Latte 每隔一个 block 注入一次,即第 2、4、…、28 个 block。
跳过 latent:处理大噪声与稀疏控制
原始 ControlNet 通常读取 \(\mathbf{z}_{t}\) 与控制图。SVD 的噪声尺度满足 \(\sigma\sim\mathrm{LogNormal}(0.7,1.6)\),论文给出 \(\mathbb{E}[\sigma]=7.24\)。大尺度 noisy latent 可能淹没控制图;稀疏控制训练时,ControlNet 也可能依赖密集 latent,忽略少数有控制的帧。为此,SVD 与稀疏控制设置跳过 ControlNet 的输入卷积,从而不输入 \(\mathbf{z}_{t}\)。
Inverse timestep sampling
连续时间骨干与离散 1000 步 ControlNet 共享进度变量 \(u\)。这只匹配两个日程的分位进度,绝对噪声尺度仍然不同。正文先以 \(\sigma\sim\mathrm{LogNormal}(0.7,1.6)\) 描述 SVD 训练分布;附录 Algorithm 1 和公开代码实际采用有界 Karras 日程。
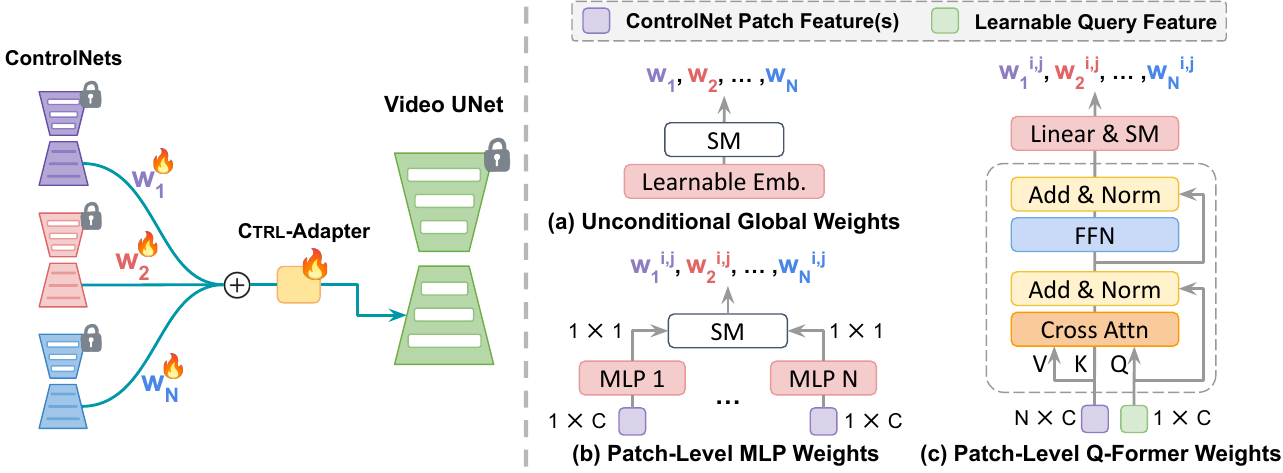
多条件 MoE
有 \(N\) 个 ControlNet 专家时,路由器产生归一化权重。全局路由器对整张特征图使用同一权重;patch-level MLP 独立处理每个专家的局部特征;patch-level Q-Former 同时读取同一位置的全部专家特征。
数据、训练与推理
视频训练集
从 Panda-70M 训练集随机下载约 150 万视频,以 2 FPS 计算 Gunnar Farneback 平均光流,归一化到 0–1;论文阈值 0.25,保留约 20 万视频。
图像训练集
LAION POP 随机抽取 30 万图像。该集合约 60 万张,最短边至少 768 px、aesthetic value 至少 0.5;使用 CogVLM 生成的 caption。
控制条件在线提取
深度:MiDaS dpt_swin2_large_384;分割:ADE20K 上的 SegFormer-B5;姿态:ViTPose Huge;Canny、法线、线稿、softedge、scribble:controlnet_aux。
评测集
DAVIS 2017 合并 TrainVal、Test-Dev、Test-Challenge 后切片:8 帧 1281 段、14 帧 697 段、16 帧 608 段。COCO val2017 共 5000 张,SDXL 评测中心裁剪到 1024×1024。
| 训练项 | 论文设置 | 复现含义 |
|---|---|---|
| 优化器 | AdamW | \(\beta_{1}=0.9\),\(\beta_{2}=0.999\),\(\epsilon=10^{-8}\),weight decay \(10^{-2}\) |
| 学习率 | \(5\times 10^{-5}\) | 公开代码默认 constant scheduler,warmup 500 步 |
| Batch | 每 GPU 1 | 4×A100 80GB;gradient accumulation 默认 1 |
| 精度 | bfloat16 | 论文明确未用 xFormers、gradient checkpointing、8-bit Adam、DeepSpeed |
| 梯度裁剪 | max norm 1 | 只更新 adapter/router 参数 |
| 训练步数 | 图像 80K;视频 40K | 两类训练均称可在 24 小时 wall-clock 内完成 |
| 推理硬件 | 单张 A6000 48GB | 骨干默认帧数、去噪步数与 CFG;发布脚本给出更具体值 |
发布脚本中的推理配置
| 骨干 | 分辨率/帧数 | 去噪步数 | control guidance end | 特殊设置 |
|---|---|---|---|---|
| SDXL | 1024² / 1 帧 | 50 | 0.6 | 深度 ControlNet,latent 输入保留 |
| I2VGen-XL | 512² / 16 帧 | 50 | 0.8 | 单条件或最多四个随机多条件参与单步训练 |
| SVD | 512² / 14 帧 | 25 | 0.8 | skip_conv_in=True |
稀疏帧控制
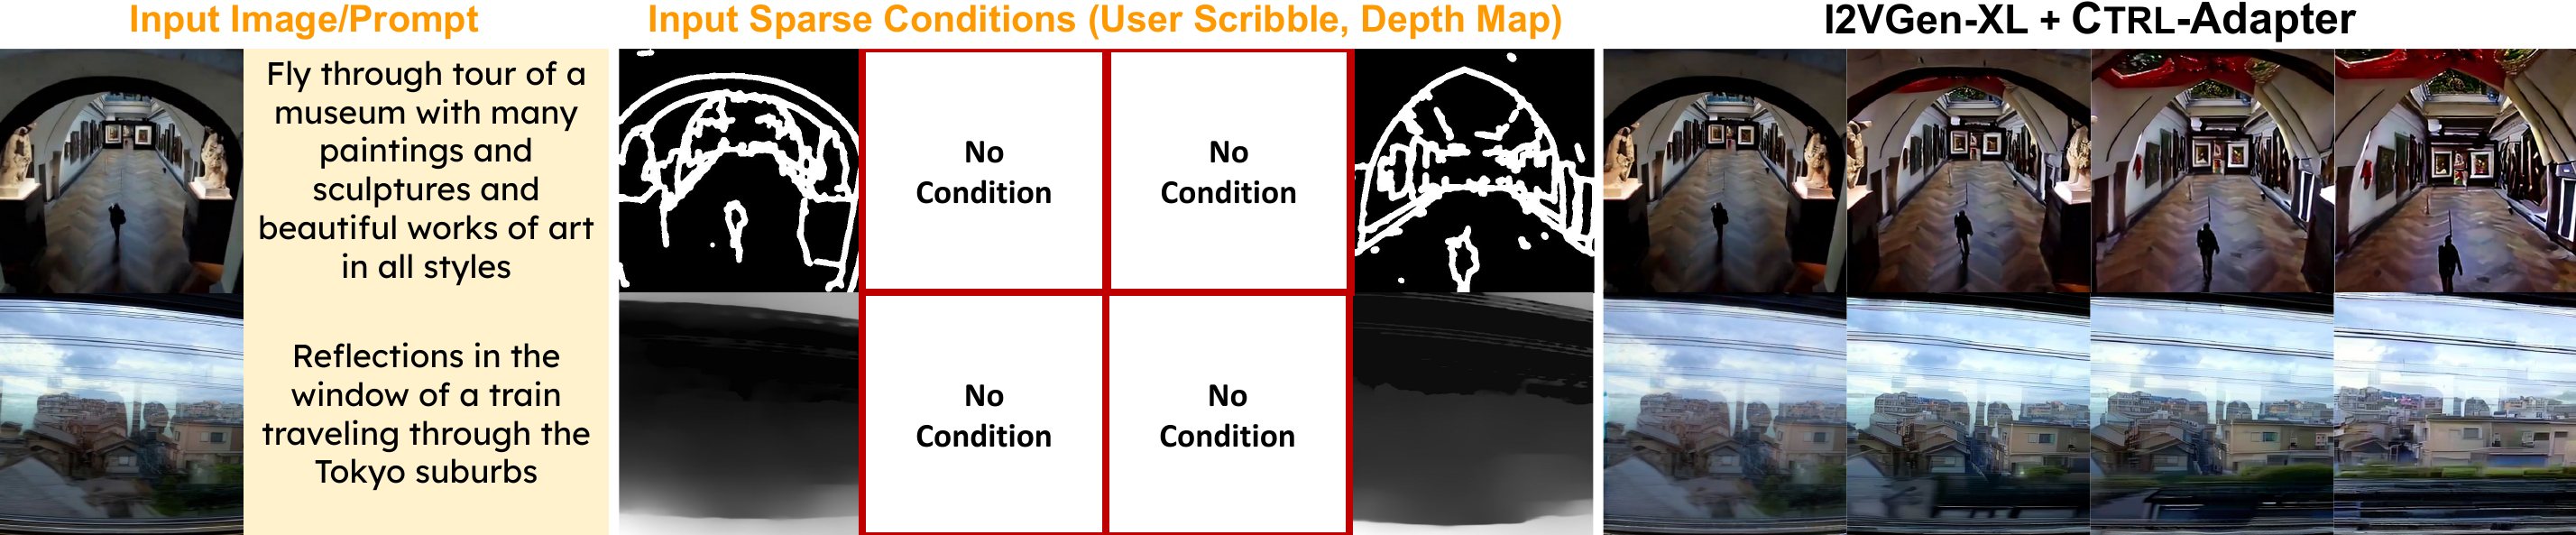
论文算法在每个训练步采样 \(k\in\{1,\ldots,N\}\),再从 \(N\) 个输出帧随机选择 \(k\) 个 keyframe,仅为这些帧提供深度或 scribble。公开实现 train.py:1279–1288 将范围固定为 1–4 帧;代码注释说明可把上限改成 args.n_sample_frames。因此论文覆盖任意稀疏度的表述大于默认发布配置。I2VGen-XL 示例在 16 帧中只给第 1、6、11、16 帧条件。
关键结果与公平性边界
指标方向:FID、MSE、Optical Flow Error 越低越好;SSIM 越高越好。主表把不同骨干、不同输出帧数与不同训练预算并列,能够证明框架兼容性与结果强度,无法单独分离“适配器设计”和“骨干能力”的贡献。
Table 1 · 可控图像/视频方法的能力比较
| 方法 | 图像控制 | 视频控制 | 稀疏帧视频控制 | 多条件控制 | 兼容不同骨干 |
|---|---|---|---|---|---|
| ControlNet | ✓ | — | — | — | — |
| Multi-ControlNet | ✓ | — | — | ✓ | — |
| T2I-Adapter | ✓ | — | — | ✓ | — |
| Uni-ControlNet | ✓ | — | — | ✓ | — |
| X-Adapter | ✓ | — | — | — | ✓ |
| ControlVideo | — | ✓ | — | — | — |
| VideoComposer | — | ✓ | — | ✓ | — |
| SparseCtrl | — | ✓ | ✓ | — | — |
| CTRL-Adapter | ✓ | ✓ | ✓ | ✓ | ✓ |
这张表验证的是功能覆盖范围。它没有提供视觉质量、控制精度、参数量或训练成本,因此不能单独支持性能优势。CTRL-Adapter 的预算卖点要结合 Figure 2:图像与视频设置在 A100 80GB 上训练不到 10 GPU 小时便超过所列强基线;正文同时说明 SDXL ControlNet 的训练预算约为 700 GPU 小时。
Table 2 · DAVIS 2017 单条件视频控制
| 方法 | Depth | Canny | ||
|---|---|---|---|---|
| FID ↓ | Flow Error ↓ | FID ↓ | Flow Error ↓ | |
| Text2Video-Zero | 19.46 | 4.09 | 17.80 | 3.77 |
| ControlVideo | 27.84 | 4.03 | 25.58 | 3.73 |
| Control-A-Video | 22.16 | 3.61 | 22.82 | 3.44 |
| VideoComposer | 22.09 | 4.55 | — | — |
| Hotshot-XL + SDXL ControlNet | 45.35 | 4.21 | 25.40 | 4.43 |
| Hotshot-XL + CTRL-Adapter | 14.63 | 3.94 | 20.83 | 4.15 |
| Latte + CTRL-Adapter | 16.92 | 3.98 | 17.87 | 2.73 |
| I2VGen-XL + CTRL-Adapter | 7.43 | 3.20 | 6.42 | 3.37 |
| SVD Temporal ControlNet | 4.91 | 4.84 | — | — |
| SVD + CTRL-Adapter | 3.82 | 2.96 | 3.96 | 2.39 |
Paper VerifiedSVD + CTRL-Adapter 在四列均为全表最佳。I2VGen-XL 的 FID 很强,Latte 的 Canny flow error 为 2.73。Hotshot-XL 结果提示适配器收益受骨干上限明显限制。
Table 3 · COCO val2017 单条件图像控制
| 方法 | Depth FID ↓ | Depth MSE ↓ | Depth SSIM ↑ | Canny FID ↓ | Canny SSIM ↑ | HED FID ↓ | HED SSIM ↑ |
|---|---|---|---|---|---|---|---|
| SDv1.5 ControlNet | 21.25 | 87.57 | — | 18.90 | 0.4828 | 26.59 | 0.4719 |
| T2I-Adapter | 21.35 | 89.82 | — | 18.98 | 0.4422 | — | — |
| GLIGEN | 21.46 | 88.22 | — | 24.74 | 0.4226 | 28.57 | 0.4015 |
| Uni-ControlNet | 21.20 | 91.05 | — | 17.79 | 0.4911 | 17.86 | 0.5197 |
| SDXL ControlNet | 17.91 | 86.95 | 0.8363 | 17.21 | 0.4458 | — | — |
| SDv1.5 ControlNet + X-Adapter | 20.71 | 90.08 | 0.7885 | 19.71 | 0.3002 | — | — |
| SDXL + CTRL-Adapter | 19.26 | 87.54 | 0.8534 | 21.04 | 0.5806 | 18.08 | 0.6454 |
| PixArt-δ ControlNet | — | — | — | — | — | 20.41 | 0.6938 |
| PixArt-α + CTRL-Adapter | 22.54 | 84.78 | 0.8496 | 18.75 | 0.6359 | 17.52 | 0.6812 |
Our InterpretationSDXL + CTRL-Adapter 的结构一致性指标强,FID 落后原生 SDXL ControlNet;这显示轻量适配器能够保留控制,却未在所有视觉分布指标上追平专门训练的目标骨干 ControlNet。PixArt-α 在 HED FID 上改善明显,HED SSIM 略低于 PixArt-δ ControlNet。
Table 4 · 多条件视频控制
| 路由方法 | D+C FID | D+C Flow | D+P FID | D+P Flow | 4 cond FID | 4 cond Flow | 7 cond FID | 7 cond Flow |
|---|---|---|---|---|---|---|---|---|
| Equal weights | 8.50 | 2.84 | 11.32 | 3.48 | 8.75 | 2.40 | 9.48 | 2.93 |
| Global learnable weights | 9.14 | 2.89 | 10.98 | 3.32 | 8.39 | 2.36 | 8.18 | 2.48 |
| Patch-level MLP | 8.40 | 2.34 | 9.37 | 3.17 | 7.87 | 2.11 | 8.26 | 2.00 |
| Patch-level Q-Former | 7.54 | 2.39 | 9.22 | 3.22 | 7.72 | 2.31 | 8.00 | 2.08 |
Q-Former 在四组 FID 均最佳,MLP 在四组 flow error 均最佳。论文的“patch-level 一致优于 global”得到支持;单一 patch-level 方案没有同时支配视觉质量与控制误差。
每项设计选择究竟证明了什么
模块组合
图像控制以 SC+SA 单层为默认;叠两层略降 FID、同时恶化 MSE,三层在相同步数下退化。视频控制以 SC+TC+SA+TA 取得较好的 FID/flow 平衡;包含 TC 与 TA 的组合有最低一组 flow error。
U-Net 注入位置
去掉 mid 与 output D 的变化很小;继续去掉 C 会显著提高 flow error。作者仍把 mid+A/B/C/D 作为公开 I2VGen-XL 默认配置,附录文字给出的效率建议是保留 mid+A/B/C。
同尺度 adapter 数量
每个 output 尺度默认三个 adapter。减少为一或两个几乎线性降低可训练参数与显存,同时增加 optical flow error。
DiT 插入策略
Latte 交错插入:FID 18.32、flow 2.98;前半:19.66/3.09;后半:23.18/3.31。结论支持在全部 DiT 深度中均匀分布注入点。
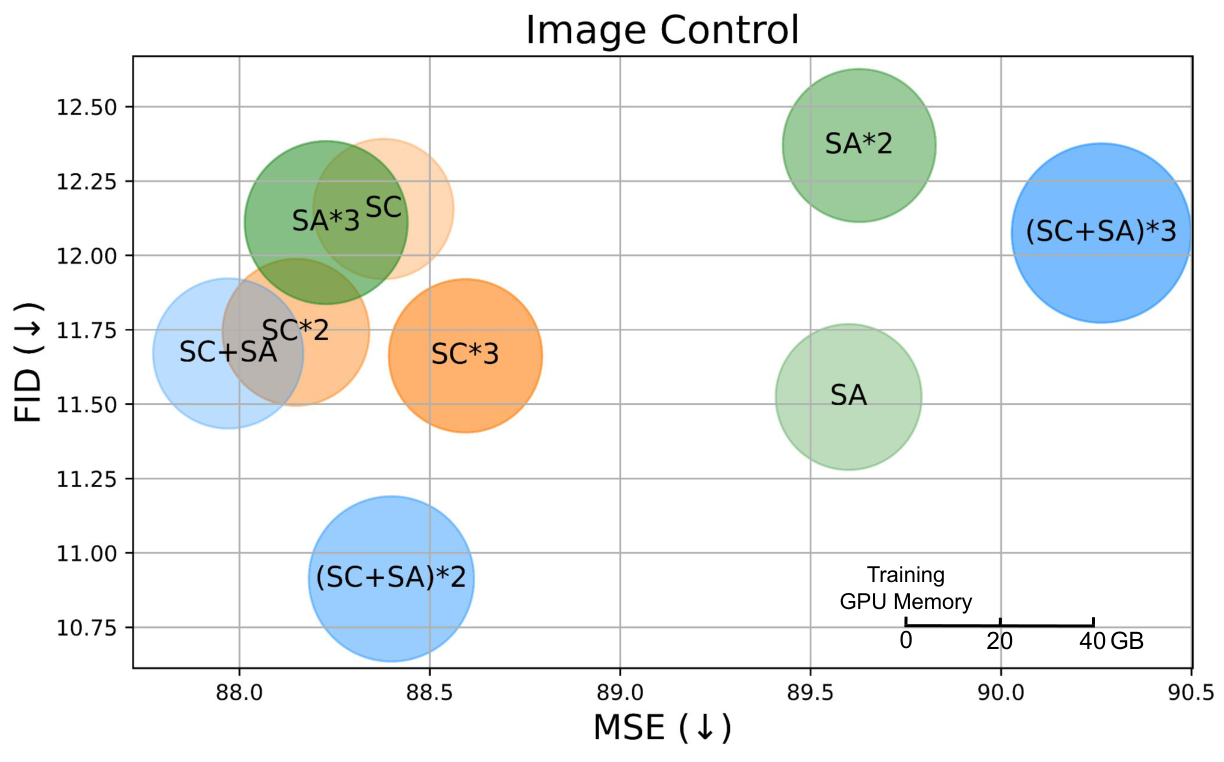
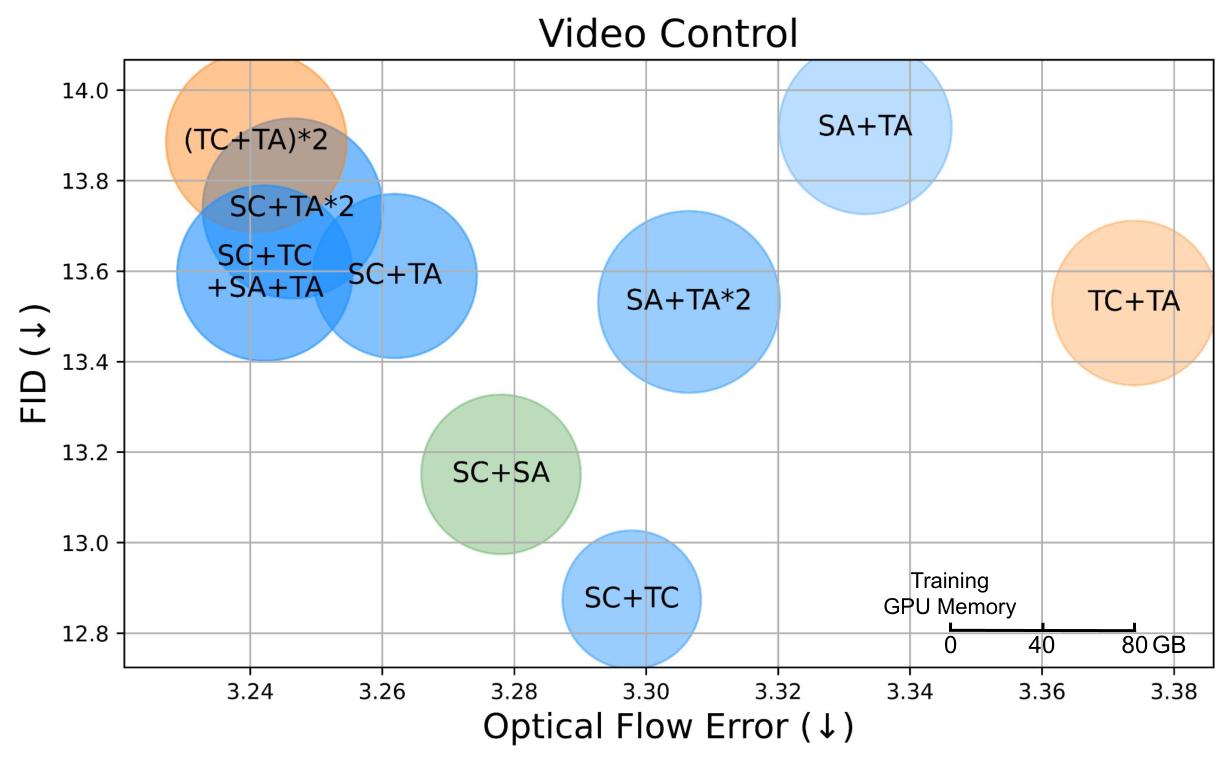
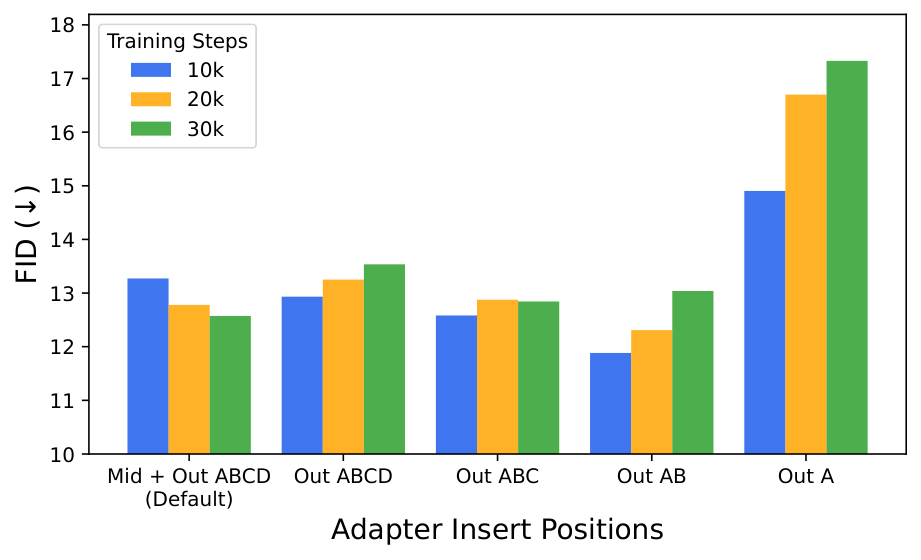
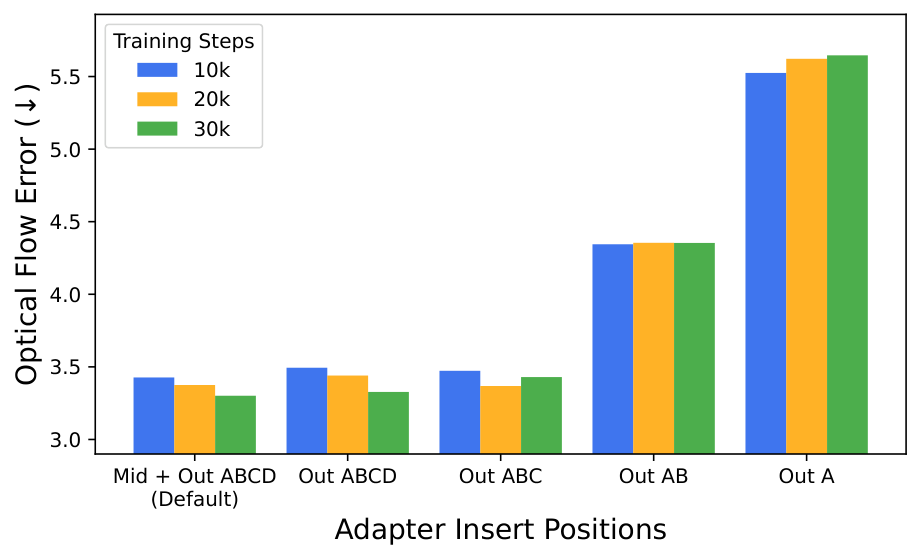
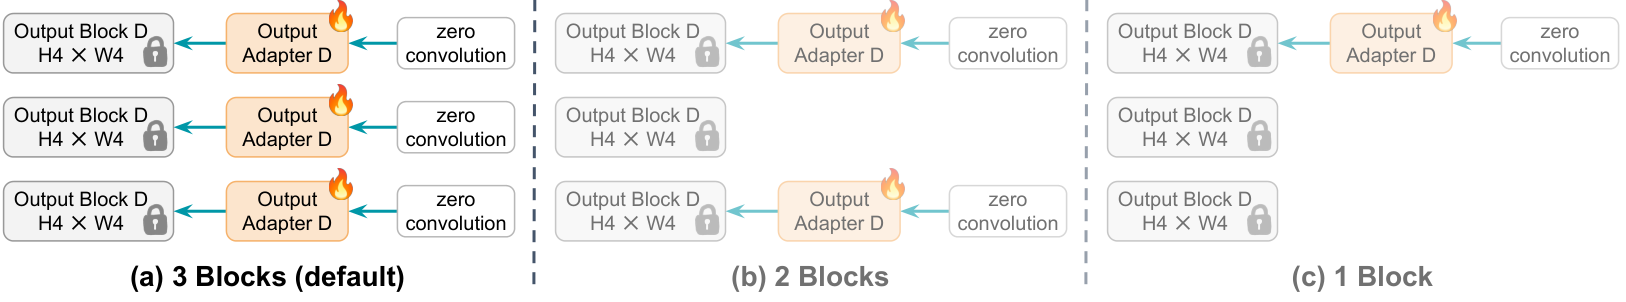
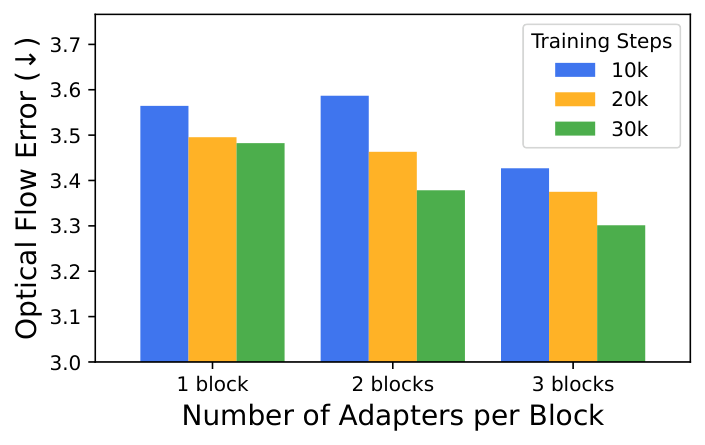
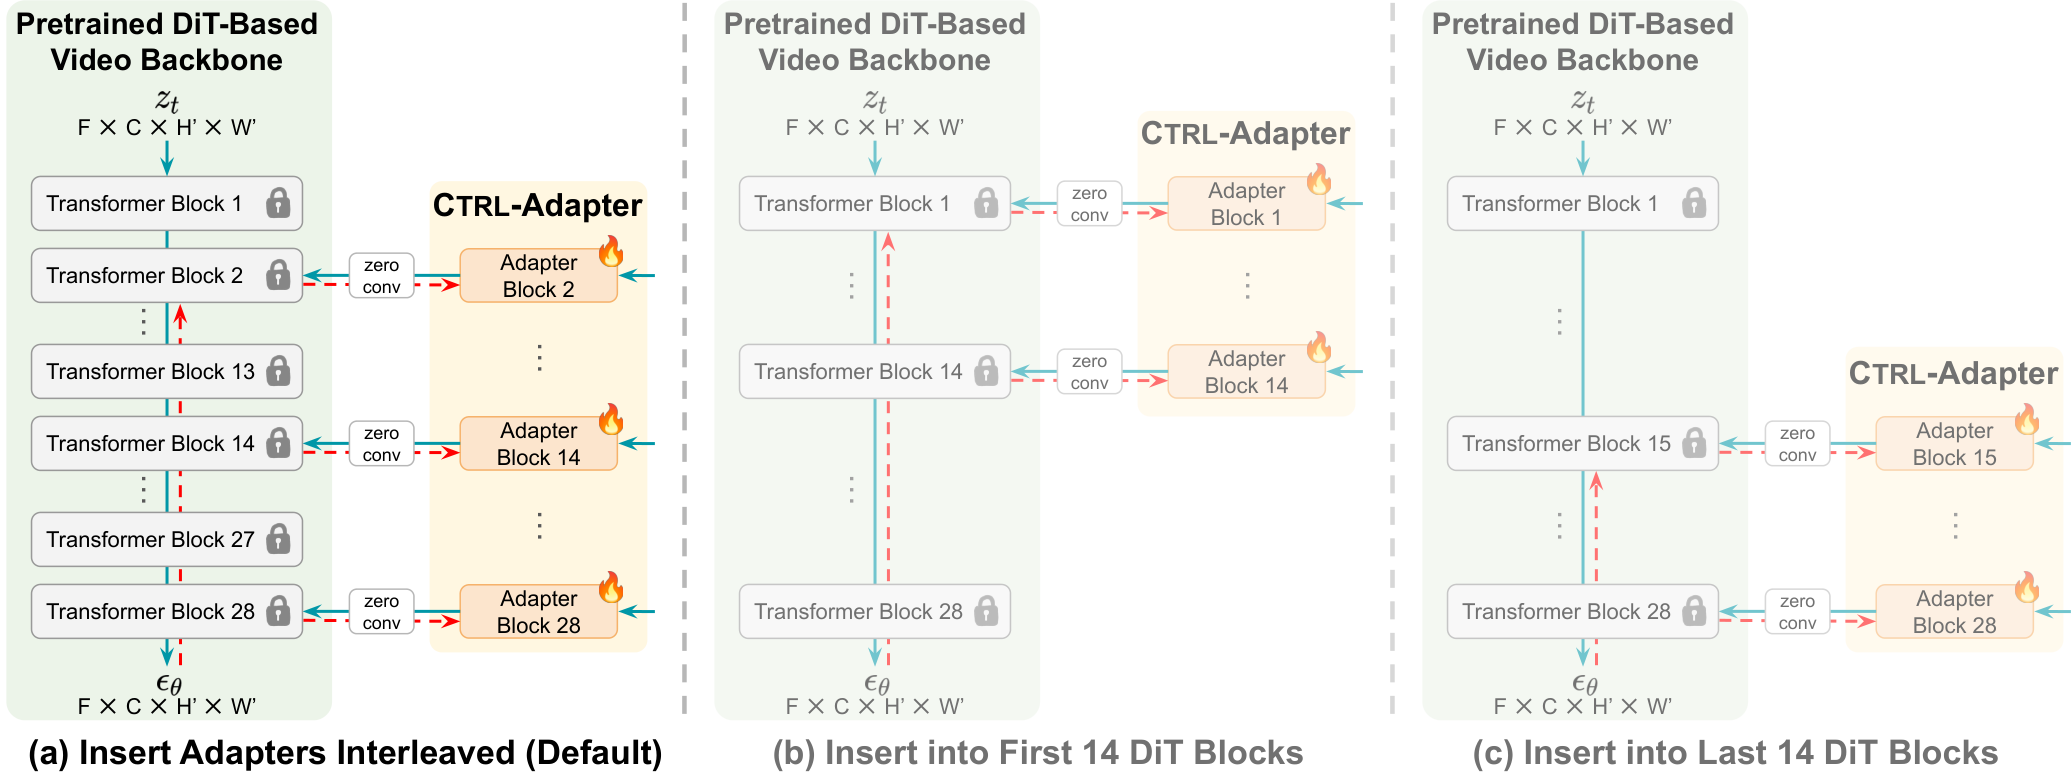
Table 5 · Latte 的 DiT block 插入策略
| 插入策略 | 位置与数量 | FID ↓ | Flow Error ↓ |
|---|---|---|---|
| Interleave(默认) | 第 2、4、…、28 block,共 14 个 | 18.32 | 2.98 |
| First Half | 前 14 个 block | 19.66 | 3.09 |
| Second Half | 后 14 个 block | 23.18 | 3.31 |
三个方案保持 adapter 数量相同,交错布局同时改善 FID 与 flow error,支持让控制残差贯穿 DiT 深度。这个实验控制了模块数量,不能推导增加 adapter 数量的独立收益。
Table 6 · PixArt-α 的 ControlNet 来源层
| 来源位置 | 1 block FID | 1 block SSIM | 2 blocks FID | 2 blocks SSIM | 3 blocks FID | 3 blocks SSIM |
|---|---|---|---|---|---|---|
| Output A(默认) | 17.90 | 0.6802 | 19.08 | 0.6971 | 19.28 | 0.6855 |
| Output B | 18.23 | 0.6712 | 18.61 | 0.6720 | 21.47 | 0.6549 |
| Output A+B | 17.52 | 0.6812 | — | — | — | — |
| Output C | 22.22 | 0.5273 | — | — | — | — |
| Output D | 34.16 | 0.3506 | — | — | — | — |
原论文表头把 SSIM 标成 ↓,与正文指标定义和数值解释冲突;SSIM 通常越高越好。这里原样保留数值,并把方向冲突标记为论文排版问题。
Table 7 · 跳过 latent
| 场景 | 给 ControlNet latent | FID ↓ | Flow Error ↓ |
|---|---|---|---|
| SVD,不同噪声尺度 | 是 | 4.48 | 2.77 |
| SVD,不同噪声尺度 | 否 | 3.82 | 2.96 |
| I2VGen-XL,稀疏帧 | 是 | 7.20 | 5.13 |
| I2VGen-XL,稀疏帧 | 否 | 5.98 | 4.88 |
对 SVD,跳过 latent 改善 FID、轻微损害 flow error;对稀疏帧,两项均改善。这个消融支持“稀疏条件避免 shortcut”的解释,也显示大噪声场景存在质量与控制精度交换。
Table 8 · 多条件视频的全局权重与 patch-level 权重
| 权重方法 | D+C FID | D+C Flow | D+P FID | D+P Flow | 4 cond FID | 4 cond Flow | 7 cond FID | 7 cond Flow |
|---|---|---|---|---|---|---|---|---|
| Equal Weights | 8.50 | 2.84 | 11.32 | 3.48 | 8.75 | 2.40 | 9.48 | 2.93 |
| (a.1) Unconditional Global | 9.14 | 2.89 | 10.98 | 3.32 | 8.39 | 2.36 | 8.18 | 2.48 |
| (a.2) Timestep Emb. | 9.41 | 3.51 | 11.13 | 3.35 | 9.51 | 2.78 | 8.17 | 2.45 |
| (a.3) Text/Image Emb. | 8.73 | 3.16 | 11.35 | 3.37 | 7.91 | 2.76 | 8.83 | 2.48 |
| (a.4) Timestep + Text/Image Emb. | 8.64 | 3.31 | 10.69 | 3.43 | 8.09 | 2.69 | 8.51 | 2.43 |
| (b) Patch-level MLP | 8.40 | 2.34 | 9.37 | 3.17 | 7.87 | 2.11 | 8.26 | 2.00 |
| (c) Patch-level Q-Former | 7.54 | 2.39 | 9.22 | 3.22 | 7.72 | 2.31 | 8.00 | 2.08 |
三种带条件 embedding 的全局 3 层 MLP 路由器没有稳定超过无条件全局权重;额外条件输入增加计算,却缺少一致收益。patch-level MLP 在四组 flow error 最优,Q-Former 在四组 FID 最优,显示局部路由把预算转化为更强控制,但两种局部方案分别偏向结构精度与视觉分布质量。
Table 9 · 统一 adapter 与单条件 adapter
| 训练策略 | Depth FID ↓ | Depth SSIM ↑ | Canny FID ↓ | Canny SSIM ↑ |
|---|---|---|---|---|
| Individual CTRL-Adapter(默认) | 19.26 | 0.8534 | 21.04 | 0.5806 |
| Unified CTRL-Adapter(八种条件) | 19.95 | 0.8437 | 22.31 | 0.5684 |
统一模型略有退化,说明跨条件共享可行,同时存在负迁移。统一方案减少每个条件分别保存 adapter 的部署成本;论文没有报告八个独立模型与统一模型的总参数、总训练 GPU 小时和总存储量,成本优势无法定量核算。
公开代码能复现的范围
| 项目 | 论文 | 公开仓库快照 4f495bd | 影响 |
|---|---|---|---|
| 基础骨干 | 六个 U-Net/DiT 骨干 | 提供 SDXL、I2VGen-XL、SVD 训练/推理;README 将 Latte、PixArt-α 标记为 WIP | DiT 主结果缺少对应公开训练实现 |
| 多条件路由 | global、patch MLP、patch Q-Former | ControlNetRouter 只构造 equal_weights 与 simple_weights;指南也只声明等权与线性权重 | Table 4 的 patch-level 最佳结果无法由当前路由代码直接复现 |
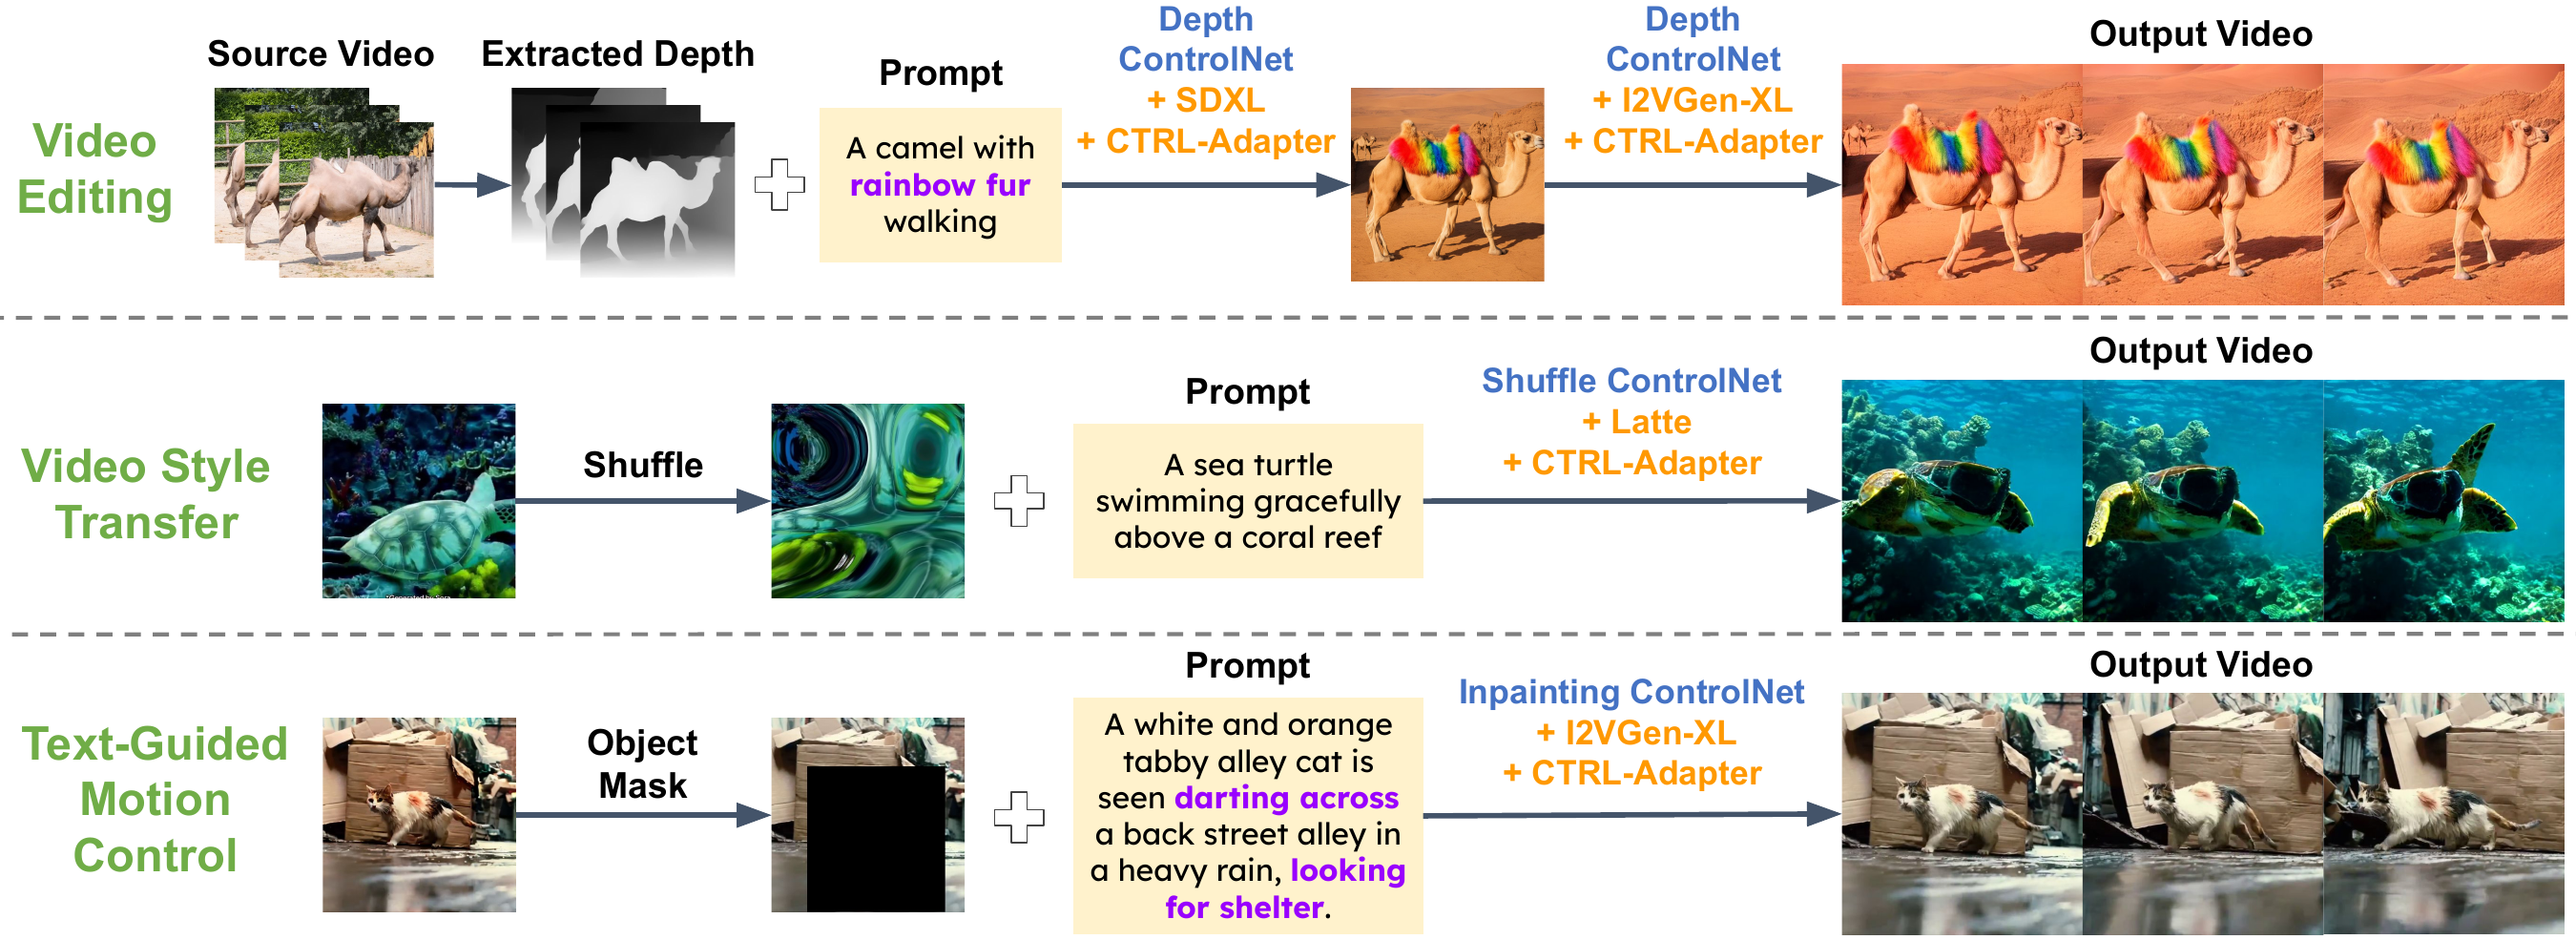
| 下游任务 | 视频编辑、风格迁移、文本引导运动控制 | README 将视频编辑与文本引导运动控制代码标记为 WIP | Figure 10 流程缺少完整脚本 |
| 评测 | DAVIS/COCO 主表 | README TODO 中 evaluation code 未发布 | 主表协议和样本配对需自行重建 |
| 视频筛选 | 光流阈值 0.25 | 训练指南写 0.3 | 过滤后训练集合可能不同 |
| 多条件训练脚本 | 正常训练调用 | 脚本最后一行在缺少续行反斜杠后单独执行 --extract_control_conditions True | 原脚本会把该参数当作新命令,需要手工修正 |
| 分辨率限制 | 框架面向任意骨干 | 训练代码断言 ControlNet 端使用 64×64 latent,对应 512×512 输入;配置注释写其他尺寸留待未来 | “任意骨干”仍需修改数据流与映射逻辑 |
证据分层与研究判断
Strengths
把控制迁移拆成两端冻结的特征映射,工程接口清晰;同一设计覆盖 U-Net 与 DiT、图像与视频、离散与连续噪声日程。DAVIS 与 COCO 主表、训练速度、架构消融、稀疏帧、零样本条件迁移和多条件路由共同形成较完整证据链。
Weaknesses
各骨干能力差异使跨方法比较难以归因;下游任务只有定性样例;部分重要结果对应代码缺失;公开训练指南与附录的光流阈值冲突;论文缺少参数量、吞吐、推理时延及 adapter 总存储成本的统一表。
Validity
Table 7 支持 latent skipping 的稀疏控制收益;SVD 结果同时显示 flow error 小幅恶化,因此“大噪声下全面更优”缺少数据支持。Table 4 支持 patch-level 路由,但 MLP 与 Q-Former 分别优化不同指标。
Generalization
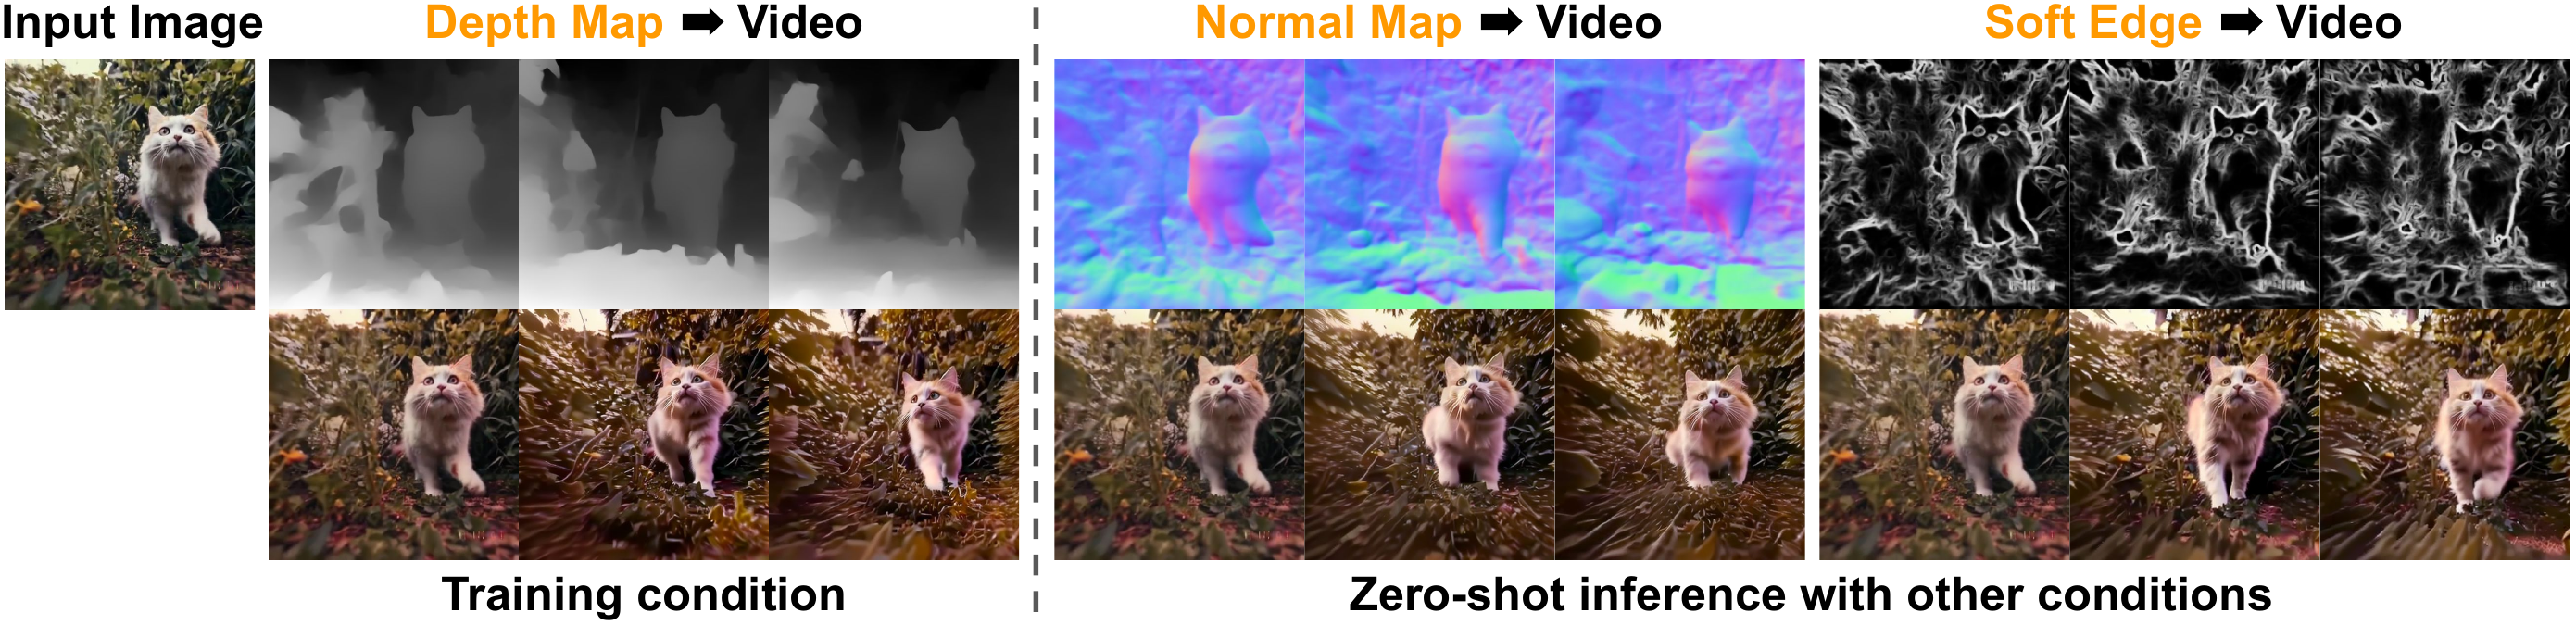
从 depth 到 normal/softedge 的 zero-shot 迁移以定性证据为主。对姿态、分割、线稿等条件的系统 zero-shot 表格、跨域训练集迁移与长视频扩展仍未建立。
四种陈述等级
Paper Verified冻结两端、训练 adapter 可在六种论文设置中实现控制迁移;SVD 在 DAVIS 主表四列最佳;SDXL adapter 的 depth SSIM 高于列出的 SDXL ControlNet。
Author Claim适配器学习了可跨控制模态迁移的通用 feature mapping。zero-shot 图支持该解释,量化覆盖不足。
Our InterpretationCTRL-Adapter 的主要价值来自接口复用与训练成本压缩。它把每次“重训控制网络”的问题缩减为学习目标骨干局部特征坐标系。
Research Extension可把 patch router 扩展为时间一致的稀疏专家路由,使同一控制在连续帧中保持平滑权重,并用 uncertainty 约束防止局部专家切换造成闪烁。
可形成后续论文的方向
Feature canonicalization
学习骨干无关的中间控制表示,再用小型 decoder 投影到各目标层,减少每个骨干单独训练 adapter 的成本。
Temporal router
为 patch-level MoE 加入跨帧状态、稀疏性和切换惩罚,直接优化控制精度与时间稳定性。
Test-time routing
按 prompt、噪声阶段与局部不确定性动态选择 ControlNet 专家,用少量 rollout 搜索 guidance schedule。
Long-video memory
把 adapter 输出压缩为可缓存的关键帧控制记忆,结合滑动窗口和跨窗口一致性约束。
Metric redesign
将 flow error、结构重建、感知质量、文本一致性和 temporal flicker 分离,避免单一 FID 掩盖控制失败。
Implementation completeness
发布 patch router、DiT、下游任务与确定性评测脚本,并给出 checkpoint、commit、数据过滤清单和每表命令。
一手资料与核查范围
- arXiv 2404.09967v2:40 页合订本,正文 9 页,附录与参考文献延续至第 40 页;本页全部论文数字均来自该 PDF/同版本 LaTeX 源。
- OpenReview / ICLR 2025:Published as a conference paper,Oral。
- 官方项目页:作者、共同第一作者标记、能力展示、paper/code/checkpoint 链接。
- 官方 GitHub:实现核查基于 commit 4f495bd2196e6ae3e44bd4a007f7391d99dbaf1e。
- ICLR 2025 Proceedings:正式会议收录身份。
SHA-256:c7dff3ba202d5fd683e8bca71a655f8a8c5745588451595488797c20ec844ecd
作者角色:Han Lin 与 Jaemin Cho 为项目页/论文首页明确标记的共同第一作者;论文、项目页与会议页面未发现通讯作者标记,按仓库规则将末位作者 Mohit Bansal 记为未核实候选。