输入
包含一个或多个排版文字区域的 RGB 栅格图像 \(x\)。文字可能覆盖未知背景,并含 fill、border、shadow。
把一张已经栅格化的文字图像拆回文字内容、字体、位置、颜色、边框、阴影与被遮挡背景,再交给标准 2D 图形引擎生成重新渲染的编辑结果。
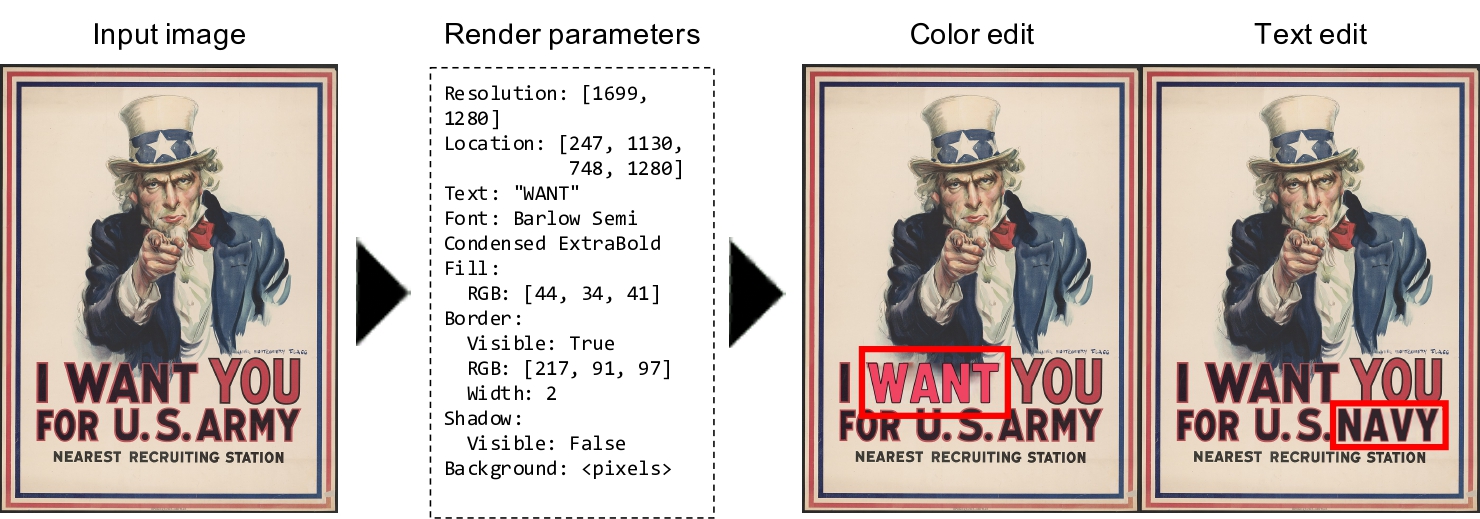
像素域风格迁移会产生模糊、折线和分辨率依赖。论文利用展示媒体中的文字通常由有限图形操作生成这一先验,把编辑转化为逆向恢复渲染过程。
包含一个或多个排版文字区域的 RGB 栅格图像 \(x\)。文字可能覆盖未知背景,并含 fill、border、shadow。
字符与文本框、字符串、字体类别、效果可见性和参数、各层颜色、字符仿射调整,以及隐藏背景 \(x_{\mathrm{bg}}\)。
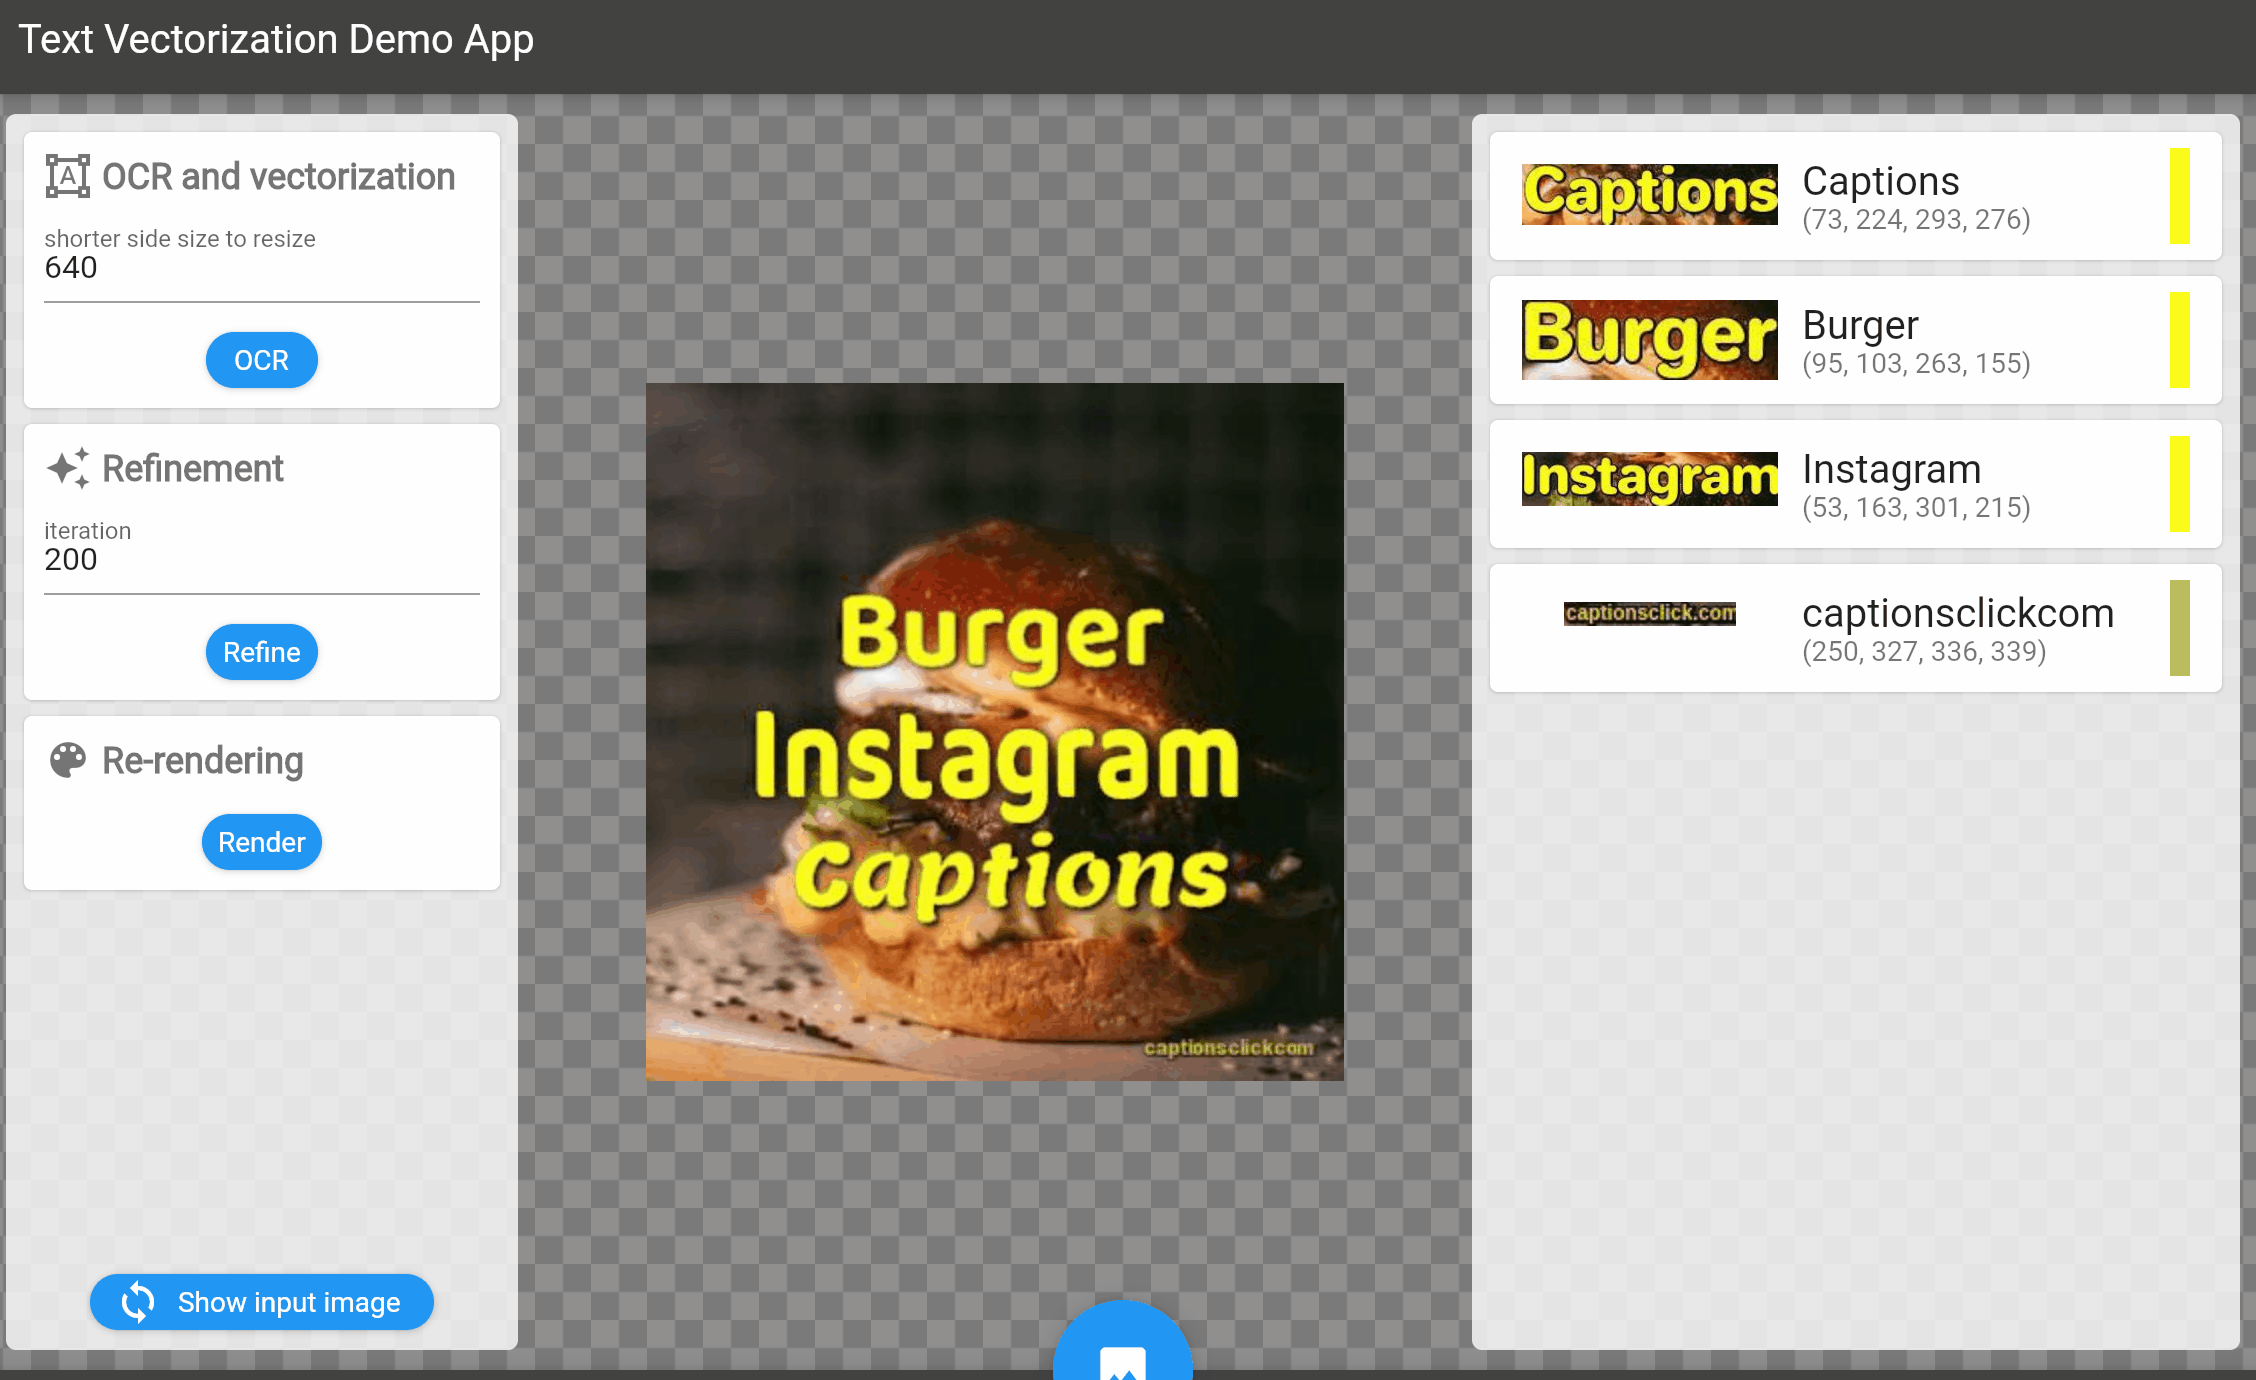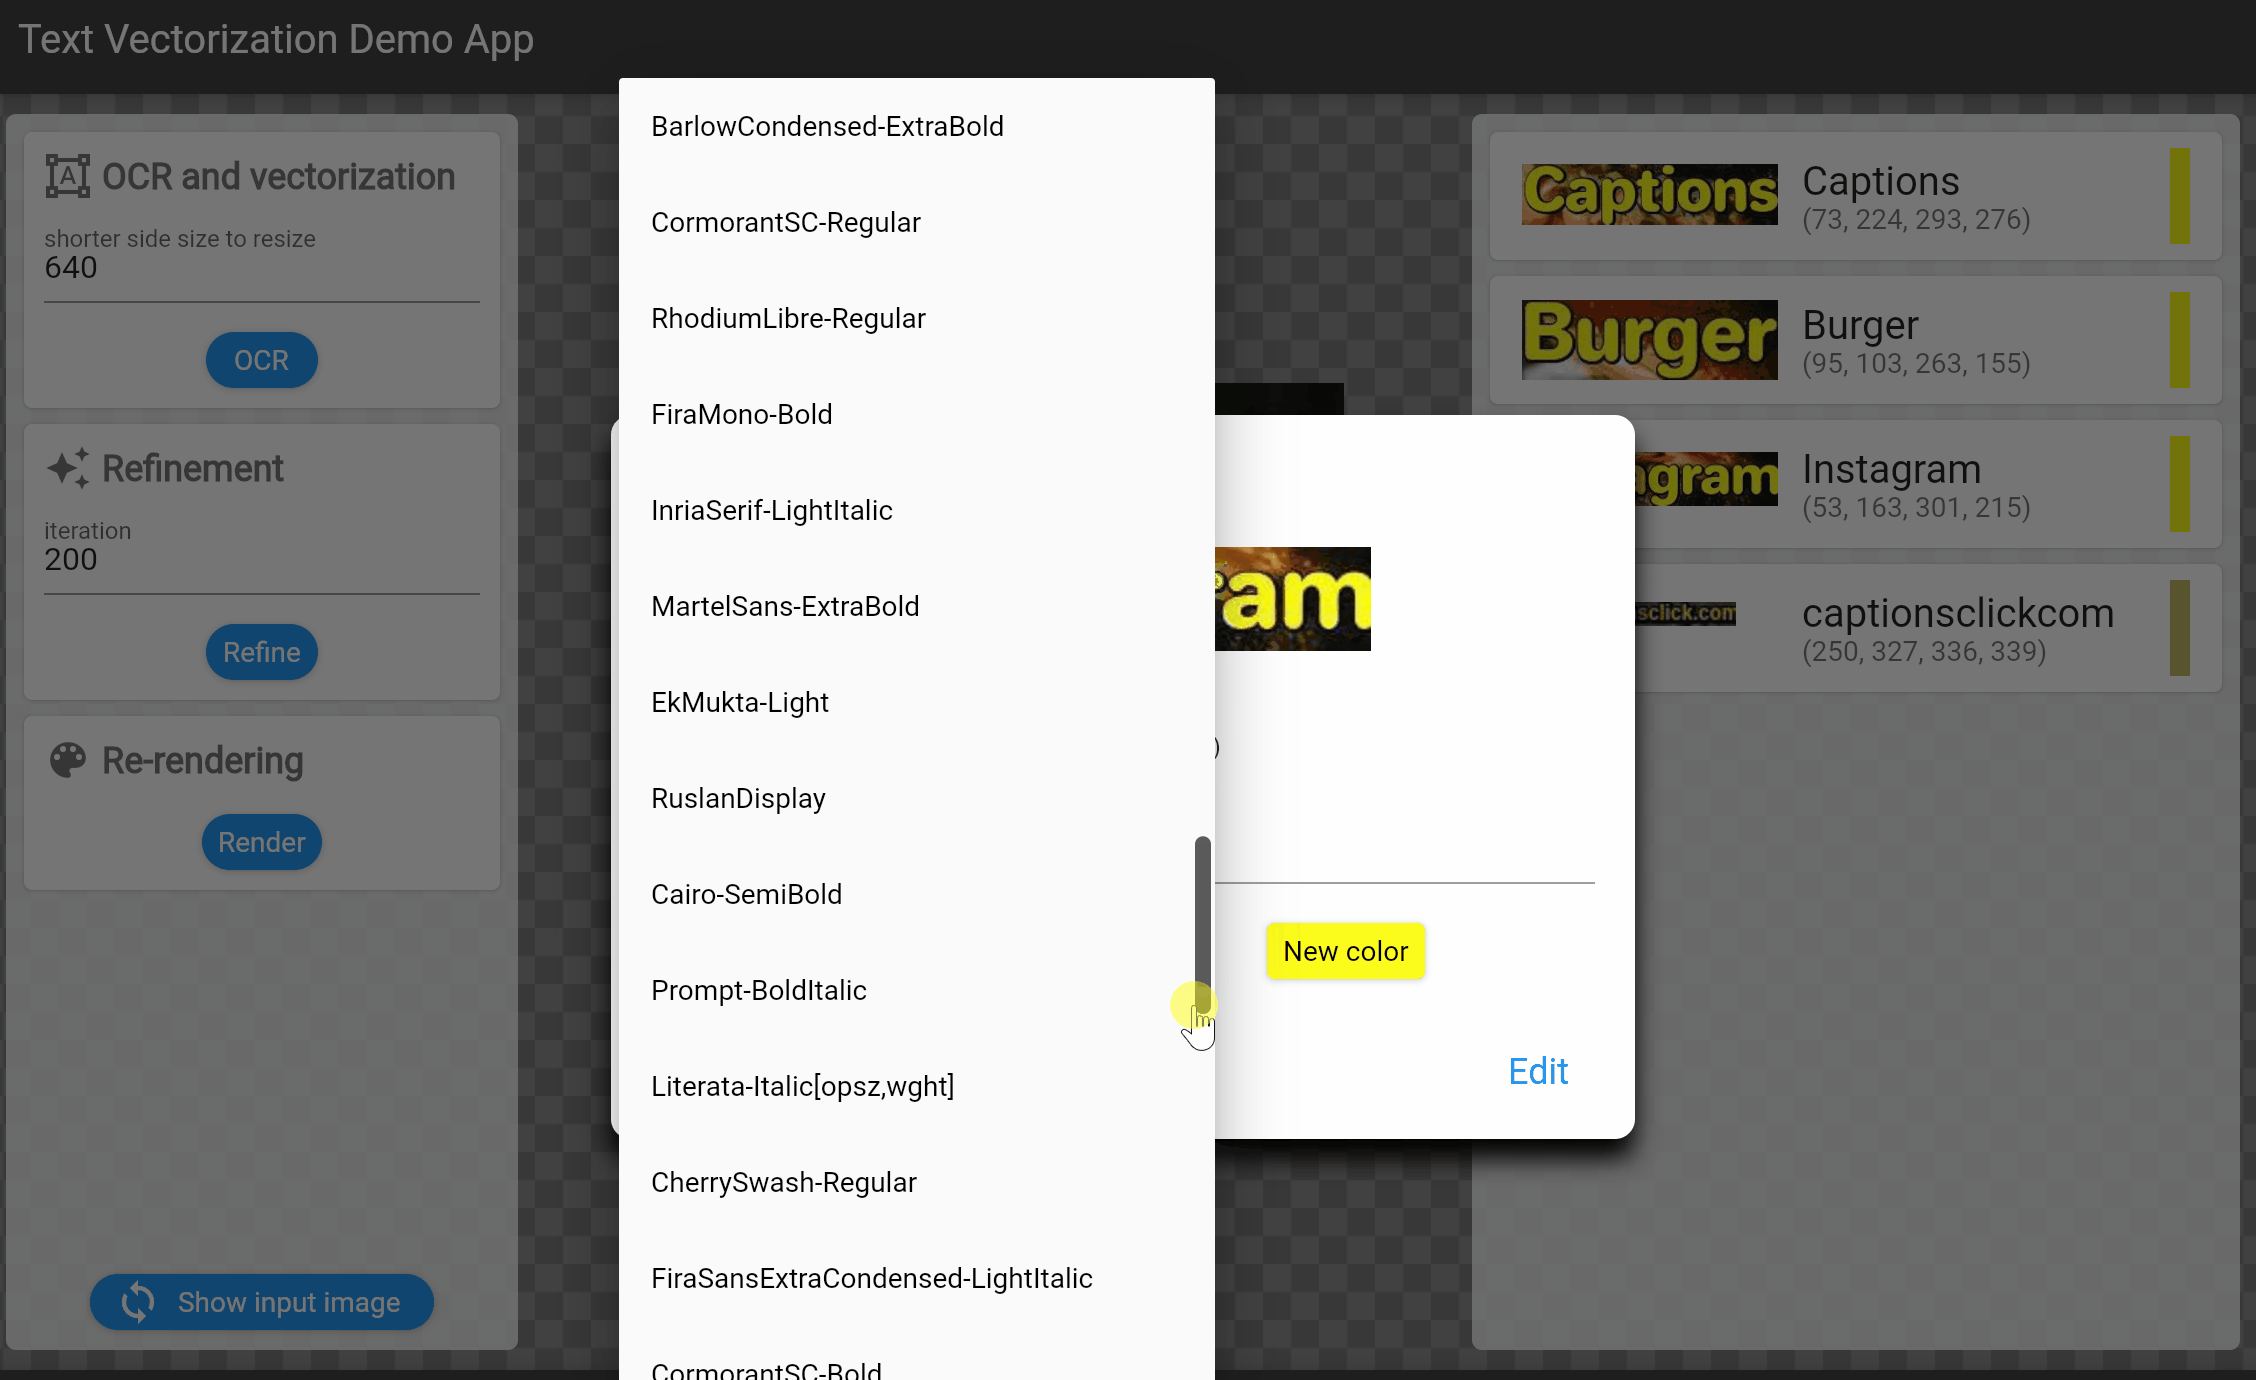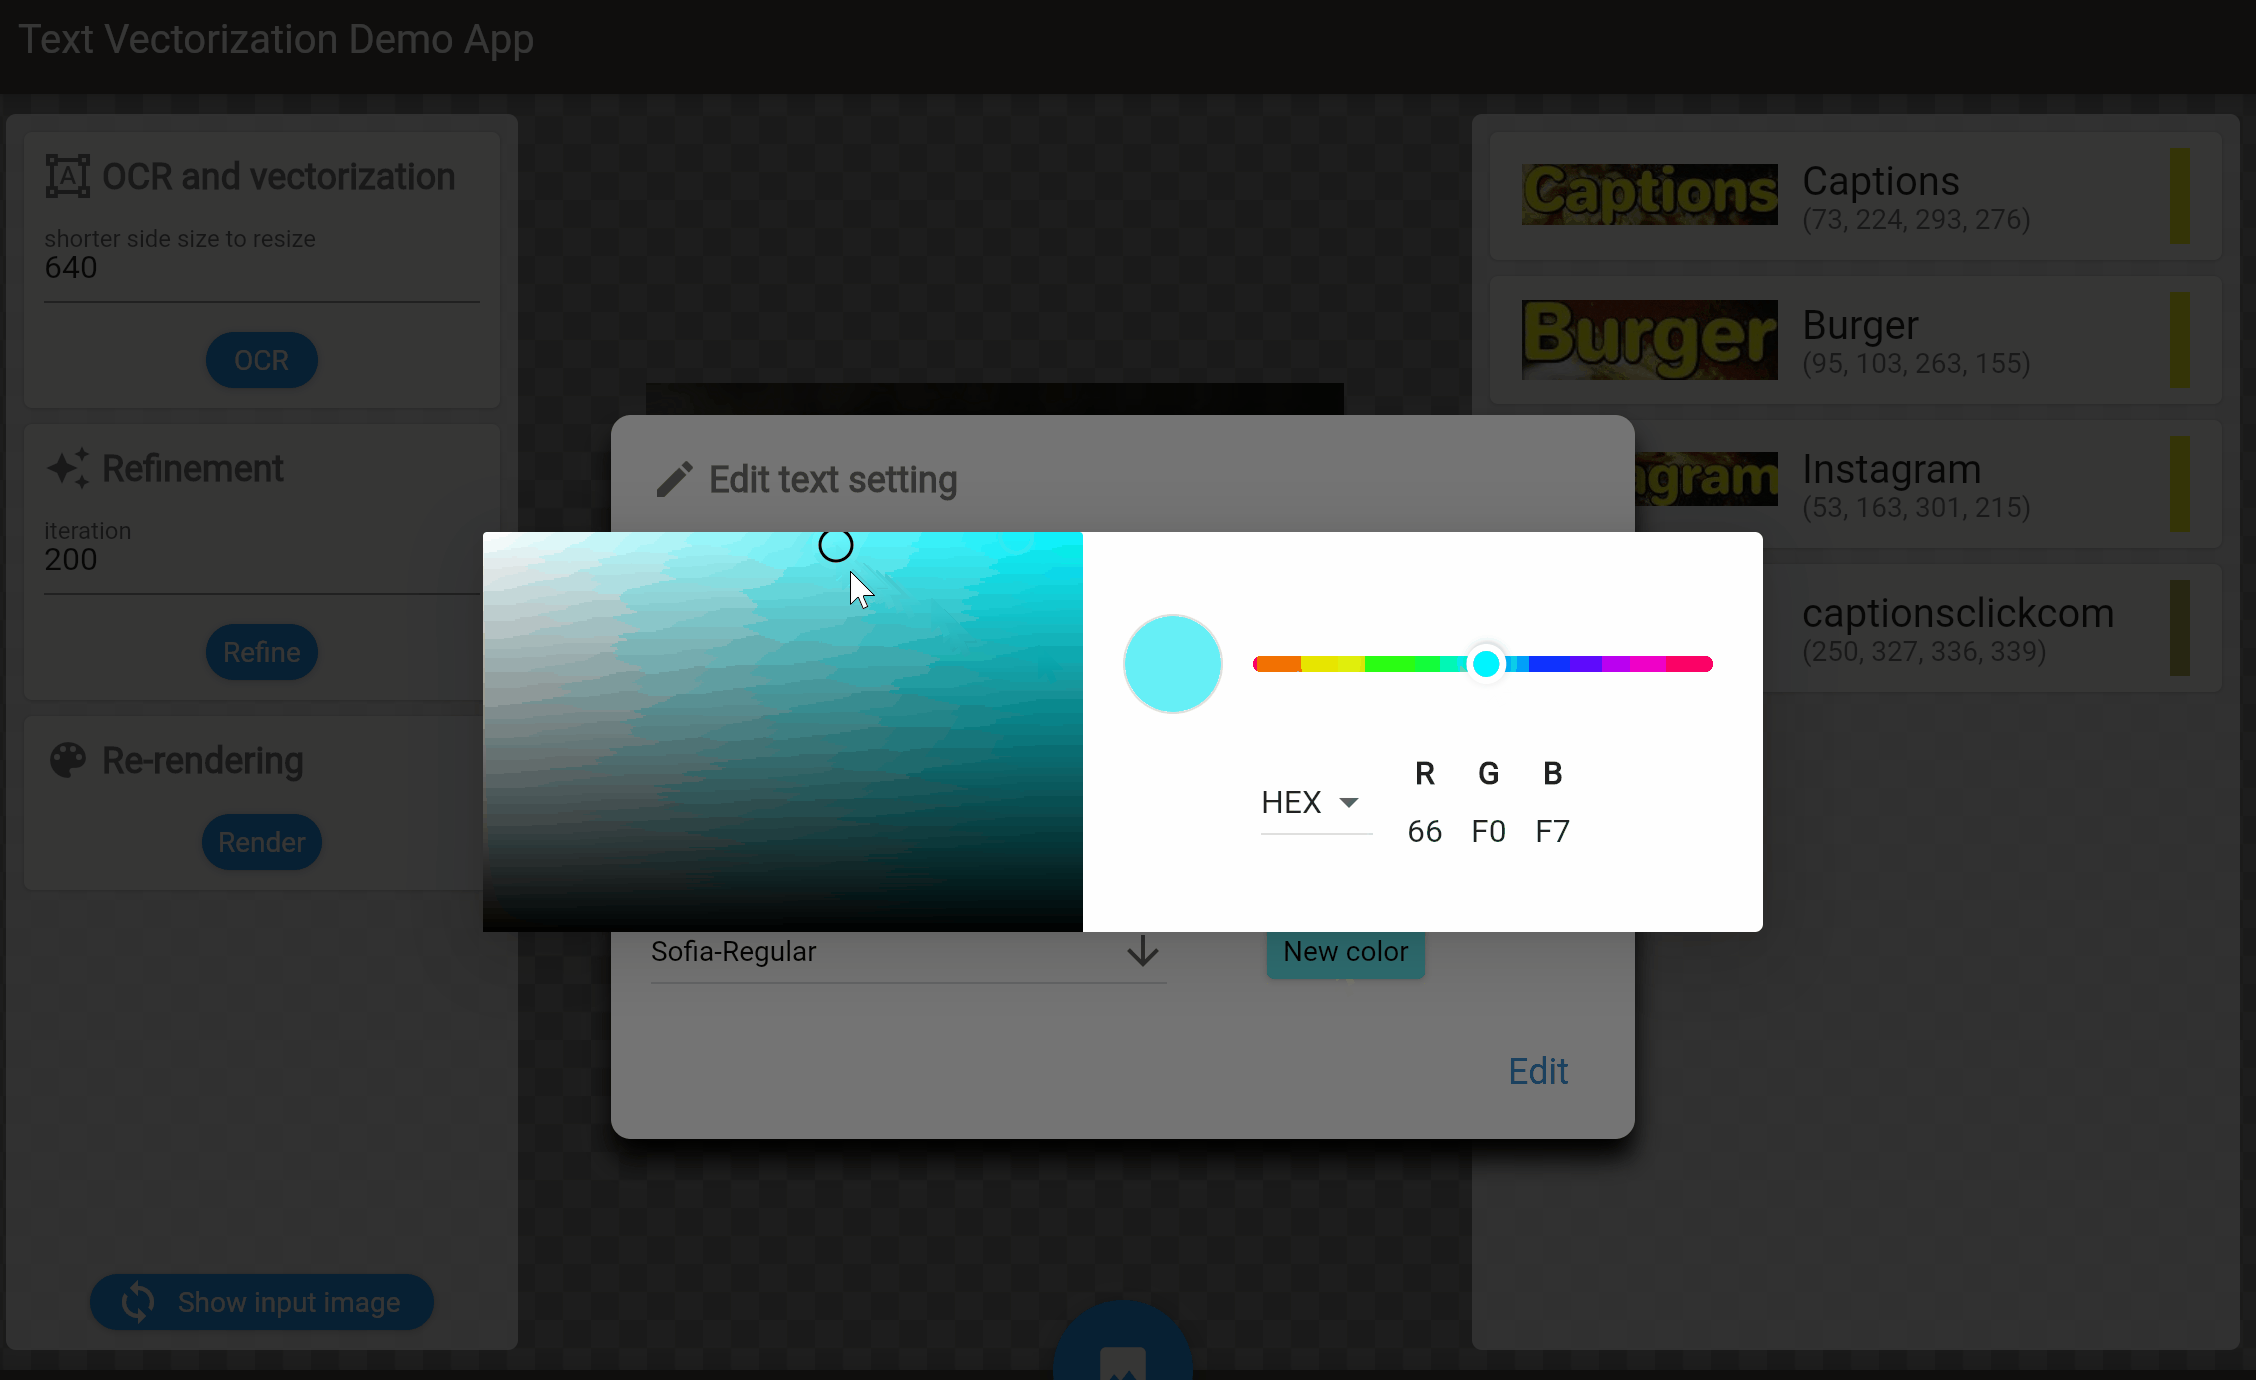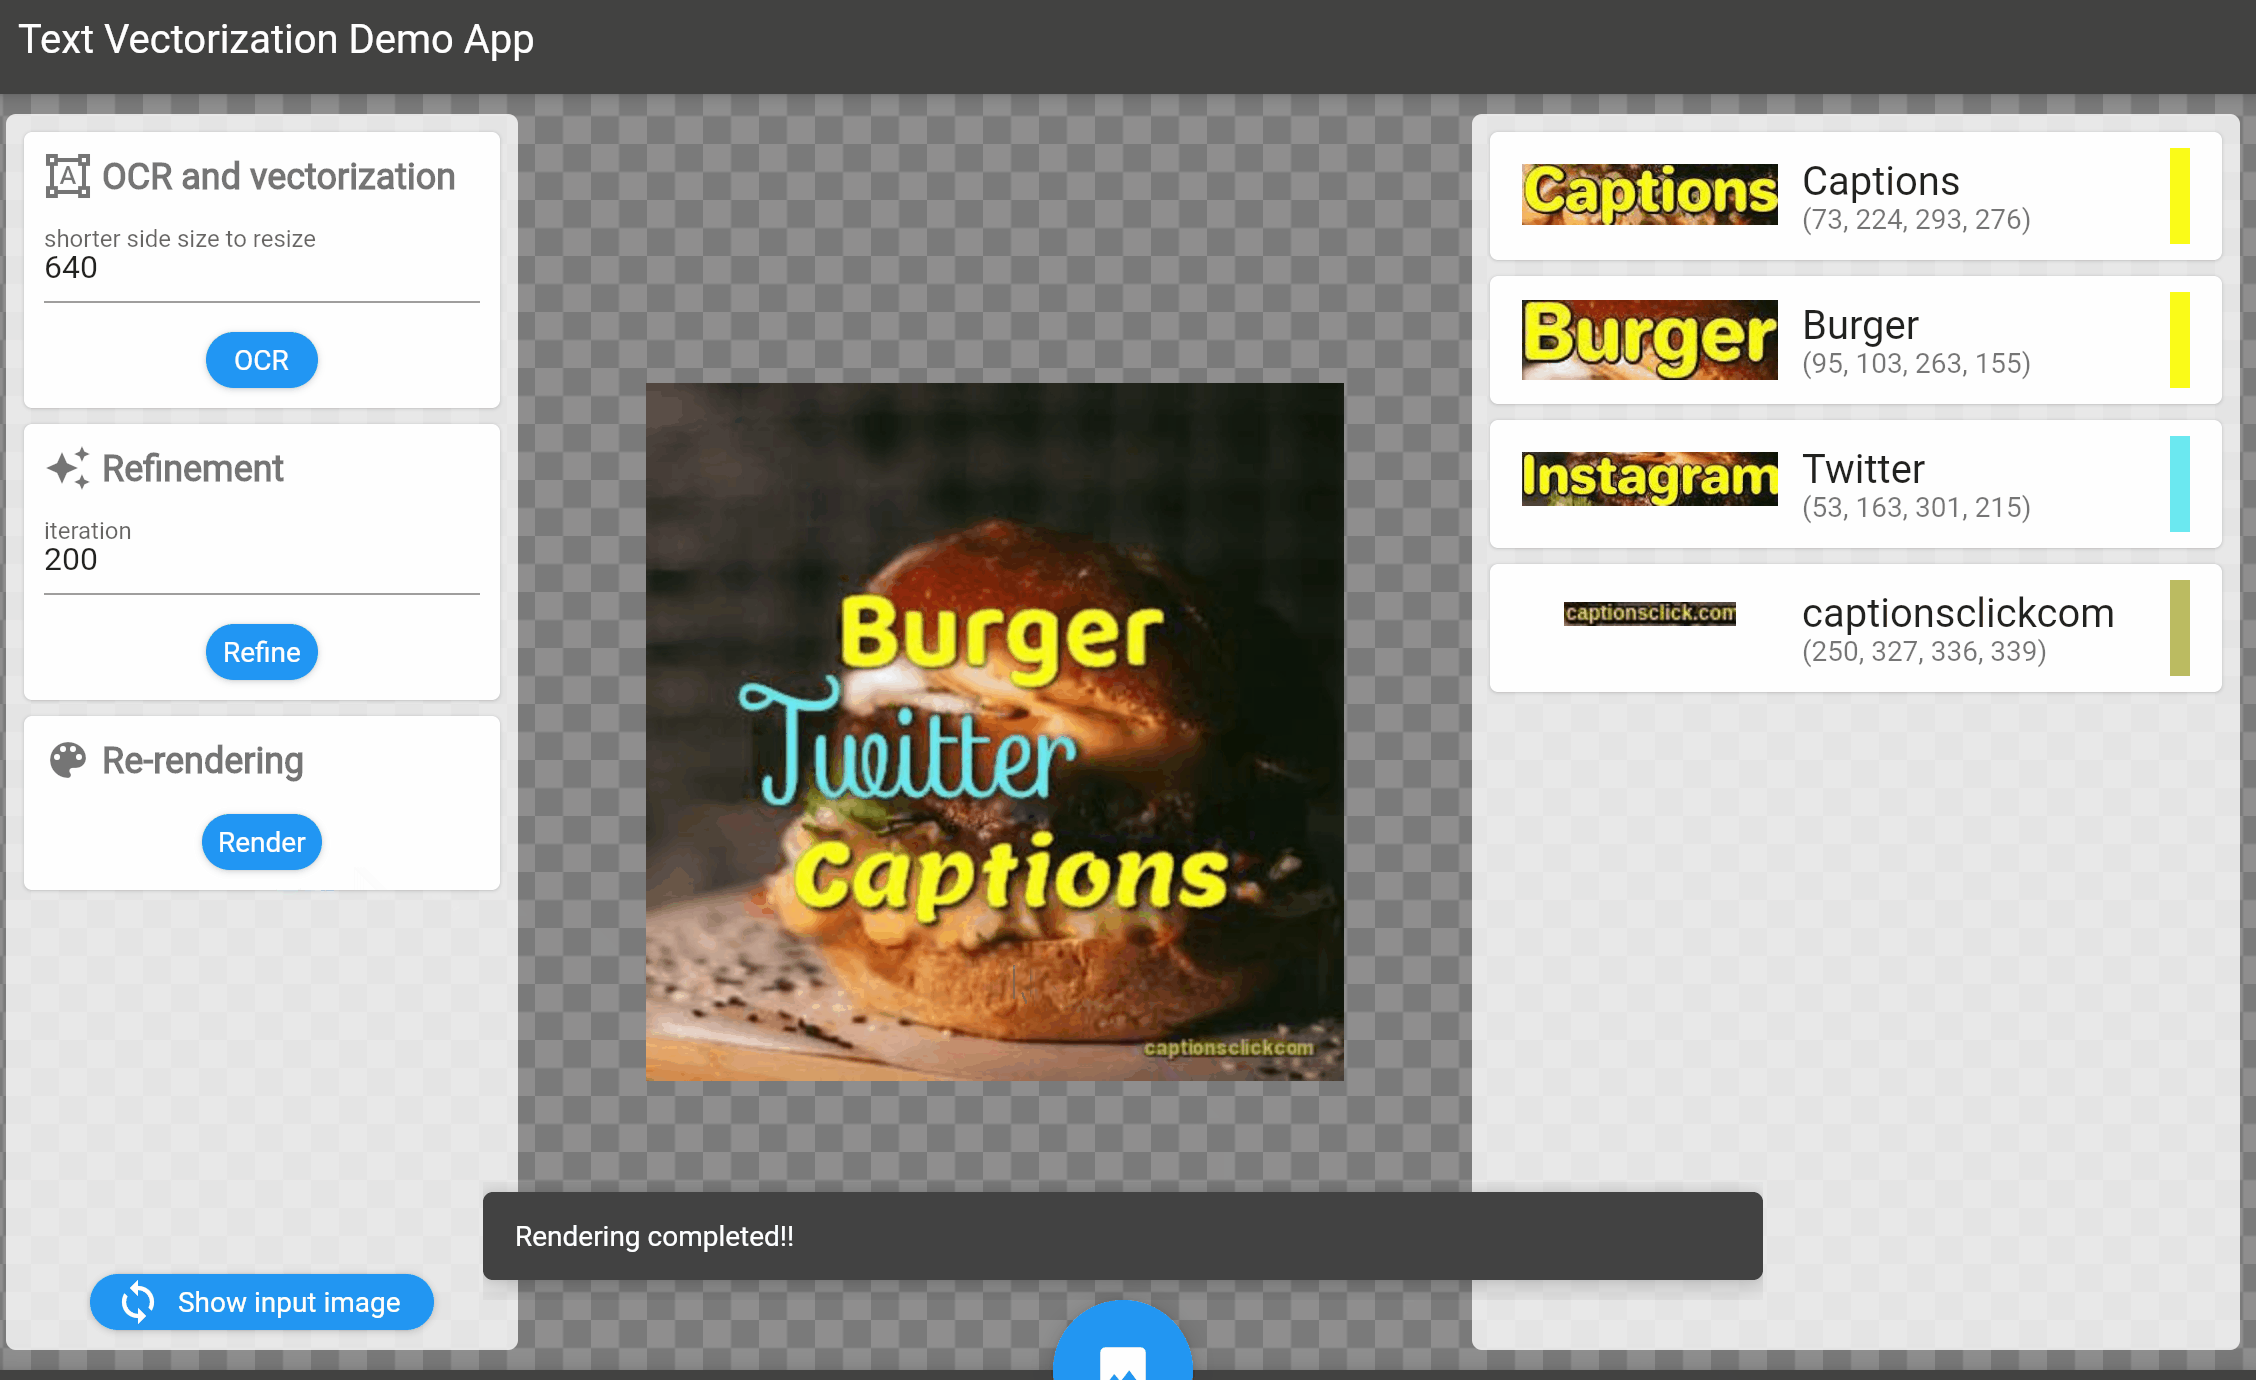
外部 Skia 引擎可消费的参数化表示。用户能改文字、字体、颜色、边框、阴影、位置和背景,并在任意分辨率重渲染。
表示的可编辑性来自语义分层。每个字段都有明确下游用途,渲染顺序固定为 shadow → fill → border。
文字与效果遮挡的像素由 inpainting 模块预测。Book Cover 评测使用 Telea,Advertisement 使用独立训练的 MEDFE。模型把 inpaint 输出恢复到原尺寸,再以预测 alpha 混合文字擦除区域,减轻 256×256 上采样伪影。
字体是封闭的 100 类分类;效果只包含 fill、border、shadow;图层顺序固定;每个效果使用纯色;复杂纹理、渐变、多重描边与自定义路径都超出表示范围。
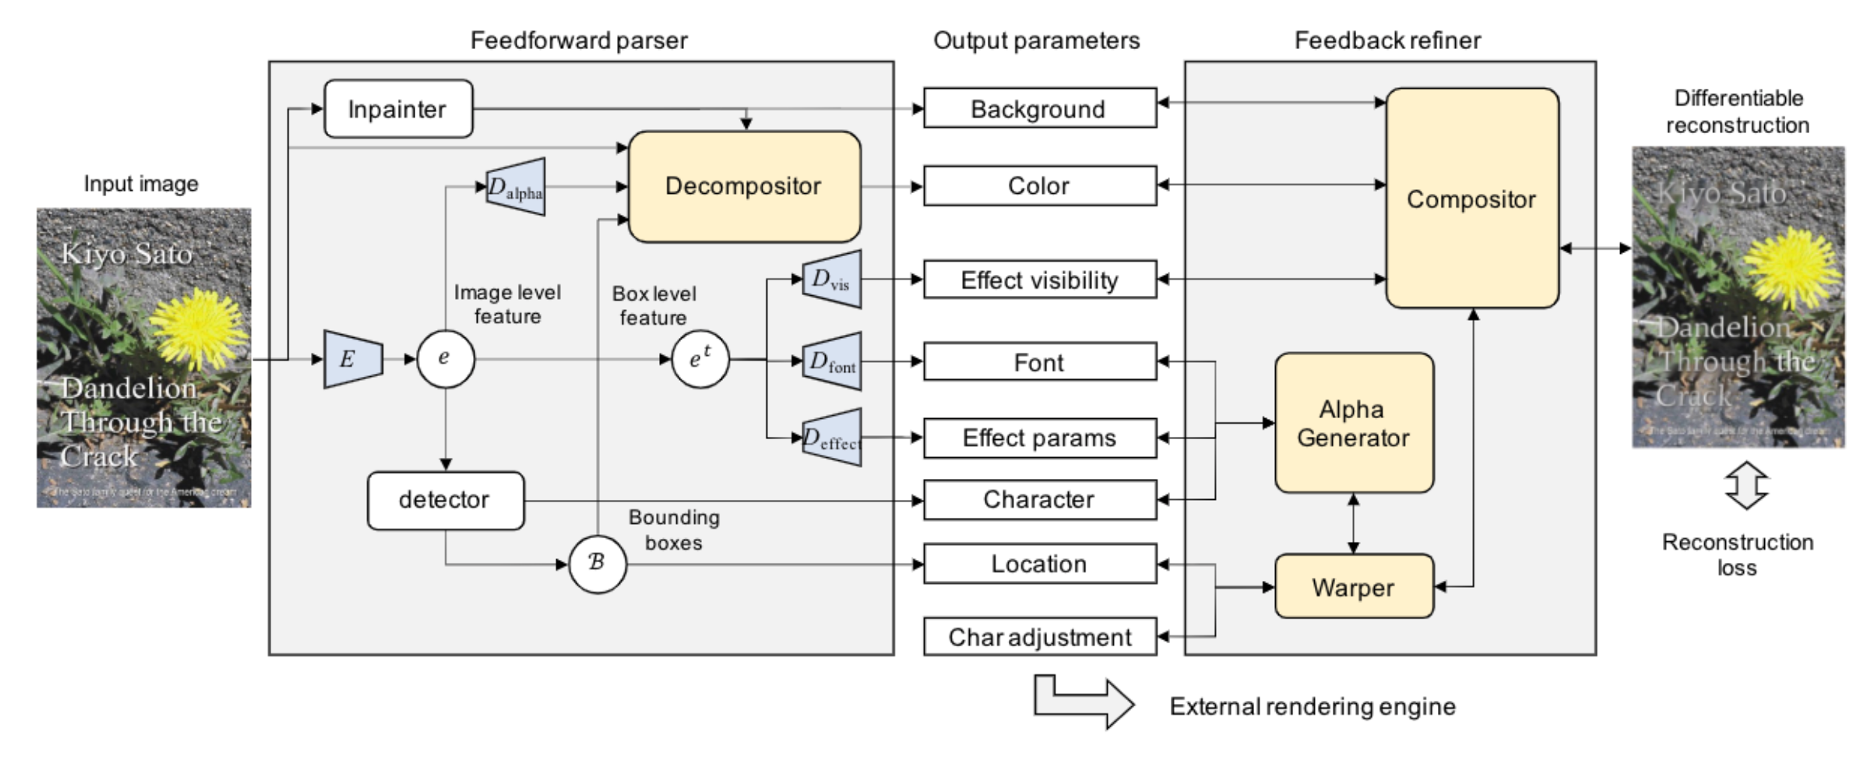
公开测试脚本把原图 resize 到 640,并同时保留归一化图像与原始像素张量。前者进入 Hourglass,后者参与 alpha 分解、背景修复和重建。
测试时保存外部 Skia 渲染图、可微重建图和一个 pickle 参数对象。参数对象包含背景像素、文本框参数、效果参数与可见性,编辑 notebook 直接修改这些字段。
字体选择和字符类别无法直接通过普通 rasterizer 求梯度。论文把所有候选形状提前画成 64×64 alpha,用类别概率的线性组合替代离散选择。
\(z\) 是字符形状,\(f_k\) 是第 \(k\) 个效果函数,\(\theta_k\) 是效果参数,\(\mathbf{c}_k\) 是该层 RGB。多层按 shadow、fill、border 依次把当前结果写回背景。
alpha 先由网络预测,候选颜色按逆合成公式逐像素恢复,再选择区域内概率最高的颜色。反分解顺序为 border、fill、shadow;不可见效果直接跳过。
\(A_{\Theta'}\) 是某个字符、字体等离散组合的预渲染 alpha;\(P(\Theta')\) 是组合概率。公开实现对 fill 保留 top-20 字体、单个字符候选;border 固定 top-1 字体与字符,同时混合 5 档描边宽度。
公开实现用 Adam、学习率 0.01、200 次迭代。可优化字体分布、边框和阴影可见性及参数、字符仿射、三层颜色;字符类别、背景与检测框保持固定。前 100 步对目标与重建同时施加逐步减弱的 Gaussian blur。
合成器扩展 SynthText 的背景与放置规则,并保存生成图像时的字符、字体、效果和 alpha 真值。
字体使用 softmax cross entropy;alpha 与连续效果参数使用 MSE;效果可见性使用 binary cross entropy。论文给出 \(\lambda_{\mathrm{font}}=0.1\)、\(\lambda_{\alpha}=10\)。OCR 与 inpainting 损失分别沿用 CharNet 与 MEDFE。
| 模块 | 层级 | 输入 | 输出 |
|---|---|---|---|
| Backbone | Hourglass → 3 次 stride-2 CONV → upsample → concat | 输入 3×H×W | e(x): 256×H/4×W/4 |
| Word detector | 3×3 CONV 两支 + 1×1 头 | e(x) | 前景图 2×H/4×W/4;geometry 32×H/4×W/4 |
| Character detector | 3×3 CONV 两支 + 1×1 头 | e(x) | 前景图与 geometry 各 32×H/4×W/4 |
| Character recognizer | 3×3 CONV 链 + 1×1 头 | e(x) | 94 类字符图 |
| Alpha | 特征上采样后与原图特征融合,Sigmoid 输出 | e(x) 与 x | fill / shadow / border 三张 H×W alpha |
| Font | 3×3 CONV + 1×1 分类头 | 文本框池化特征 256×1×1 | 100 类字体 |
| Effect visibility | 共享 V1 后两个 1×1 分类头 | 文本框池化特征 | shadow 2 类;border 2 类 |
| Effect parameters | 共享 P1 后 Tanh / Sigmoid / linear 头 | 文本框池化特征 | shadow offset 2;blur 1;border width 5 类 |
| Model | Layers | Kernel, Stride | Input | Input size | Output | Output size |
|---|---|---|---|---|---|---|
| Backbone | Hour Glass Net | - | x | 3×H×W | B1 | 256×H/4×W/4 |
| CONV + BN + RELU | (3 × 3), (2 × 2) | B1 | 256×H/4×W/4 | B2 | 128×H/8×W/8 | |
| CONV + BN + RELU | (3 × 3), (2 × 2) | B2 | 128×H/8×W/8 | B3 | 128×H/16×W/16 | |
| CONV + BN + RELU | (3 × 3), (2 × 2) | B3 | 128×H/16×W/16 | B4 | 128×H/32×W/32 | |
| Upsampling | - | B4 | 128×H/32×W/32 | B5 | 128×H/4×W/4 | |
| CONV + BN + RELU | (3 × 3), (1 × 1) | B1 and B5 | 384×H/4×W/4 | e(x) | 256×H/4×W/4 | |
| Word detector | CONV + BN + RELU | (3 × 3), (1 × 1) | e(x) | 256×H/4×W/4 | W1 | 128×H/4×W/4 |
| CONV + BN + RELU | (3 × 3), (1 × 1) | W1 | 128×H/4×W/4 | W2 | 32×H/4×W/4 | |
| CONV + BN + RELU | (3 × 3), (1 × 1) | W1 | 128×H/4×W/4 | W3 | 32×H/4×W/4 | |
| CONV | (1 × 1), (1 × 1) | W2 | 128×H/4×W/4 | Text foreground map | 2×H/4×W/4 | |
| CONV + RELU | (1 × 1), (1 × 1) | W3 | 128×H/4×W/4 | Text geometry map | 32×H/4×W/4 | |
| Char detector | CONV + BN + RELU | (3 × 3), (1 × 1) | e(x) | 256×H/4×W/4 | C1 | 128×H/4×W/4 |
| CONV + BN + RELU | (3 × 3), (1 × 1) | C1 | 128×H/4×W/4 | C2 | 32×H/4×W/4 | |
| CONV + BN + RELU | (3 × 3), (1 × 1) | C1 | 128×H/4×W/4 | C3 | 32×H/4×W/4 | |
| CONV | (1 × 1), (1 × 1) | C2 | 128×H/4×W/4 | Char foreground map | 32×H/4×W/4 | |
| CONV + RELU | (1 × 1), (1 × 1) | C3 | 128×H/4×W/4 | Char geometry map | 32×H/4×W/4 | |
| Char recognizer | CONV + BN + RELU | (3 × 3), (1 × 1) | e(x) | 256×H/4×W/4 | R1 | 128×H/4×W/4 |
| CONV + BN + RELU | (3 × 3), (1 × 1) | R1 | 128×H/4×W/4 | R2 | 32×H/4×W/4 | |
| CONV + BN + RELU | (3 × 3), (1 × 1) | R2 | 128×H/4×W/4 | R3 | 32×H/4×W/4 | |
| CONV | (1 × 1), (1 × 1) | R3 | 94×H/4×W/4 | Char recognition map | 32×H/4×W/4 | |
| Alpha | CONV + BN + RELU | (3 × 3), (1 × 1) | e(x) | 256×H/4×W/4 | A1 | 128×H/4×W/4 |
| CONV + BN + RELU | (3 × 3), (1 × 1) | A1 | 128×H/4×W/4 | A2 | 32×H/4×W/4 | |
| Upsampling | - | A2 | 32×H/4×W/4 | A3 | 32×H×W | |
| CONV + BN + RELU | (3 × 3), (1 × 1) | x | 3×H×W | A4 | 32×H×W | |
| CONV + BN + RELU | (3 × 3), (1 × 1) | A3 and A4 | 64×H×W | A5 | 32×H×W | |
| CONV + BN + RELU | (3 × 3), (1 × 1) | A5 | 32×H×W | A6 | 32×H×W | |
| CONV + Sigmoid | (3 × 3), (1 × 1) | A6 | 32×H×W | Alpha for decomposition | 3×H×W | |
| Font | CONV + BN + RELU | (3 × 3), (1 × 1) | e^{t}_{b}(x) | 256× 1× 1 | F1 | 128× 1× 1 |
| CONV | (1 × 1), (1 × 1) | F1 | 128× 1× 1 | Font categories | 100× 1× 1 | |
| Effects visiblity | CONV + BN + RELU | (3 × 3), (1 × 1) | e^{t}_{b}(x) | 256× 1× 1 | V1 | 128× 1× 1 |
| CONV | (1 × 1), (1 × 1) | V1 | 128× 1× 1 | Shadow visibility | 2× 1× 1 | |
| CONV | (1 × 1), (1 × 1) | V1 | 128× 1× 1 | Border visibility | 2× 1× 1 | |
| Effects params | CONV + BN + RELU | (3 × 3), (1 × 1) | e^{t}_{b}(x) | 256× 1× 1 | P1 | 128× 1× 1 |
| CONV + Tanh | (1 × 1), (1 × 1) | P1 | 128× 1× 1 | Shadow offset | 2× 1× 1 | |
| CONV + Sigmoid | (1 × 1), (1 × 1) | P1 | 128× 1× 1 | Shadow blur | 1× 1× 1 | |
| CONV | (1 × 1), (1 × 1) | P1 | 128× 1× 1 | Border weights | 5× 1× 1 |
模块概览后完整列出补充材料的 36 个数据行,连同表头共 37 行;逐层表保留原论文输入和输出尺度。Word / character 检测与识别在 \(H/4\times W/4\) 尺度工作,alpha 分支恢复到原图尺度。
src/models/layers/inner_ocr.py 默认中间通道为 128,文字与字符前景头各输出 2 通道,距离头各输出 4 通道,方向头各输出 1 通道,字符分类头输出 94 通道。实际实现还有单独的方向头,不能直接按原表的 32 通道几何头构建模型。该结论来自源码检查,本次没有训练或运行完整论文模型。一次前馈推理得到 OCR 框、字符、字体、alpha、效果参数和背景。检测不到文字时公开脚本直接结束。
每个词 200 步 Adam,论文报告约 1 分钟。优化发生在 640 像素工作空间;字符与字体 alpha 通过预渲染字典近似。
字符仿射结果更新 box;每个词选取“最佳字符”作为几何引导,搜索 font size 和 width scale,计算 baseline 与 offset。
公开脚本固定运行 200 次优化,没有 beam search、采样、reranking 或早停。最终 Skia 渲染图用于交付,可微重建图用于拟合诊断,pickle 保存参数以便继续编辑。
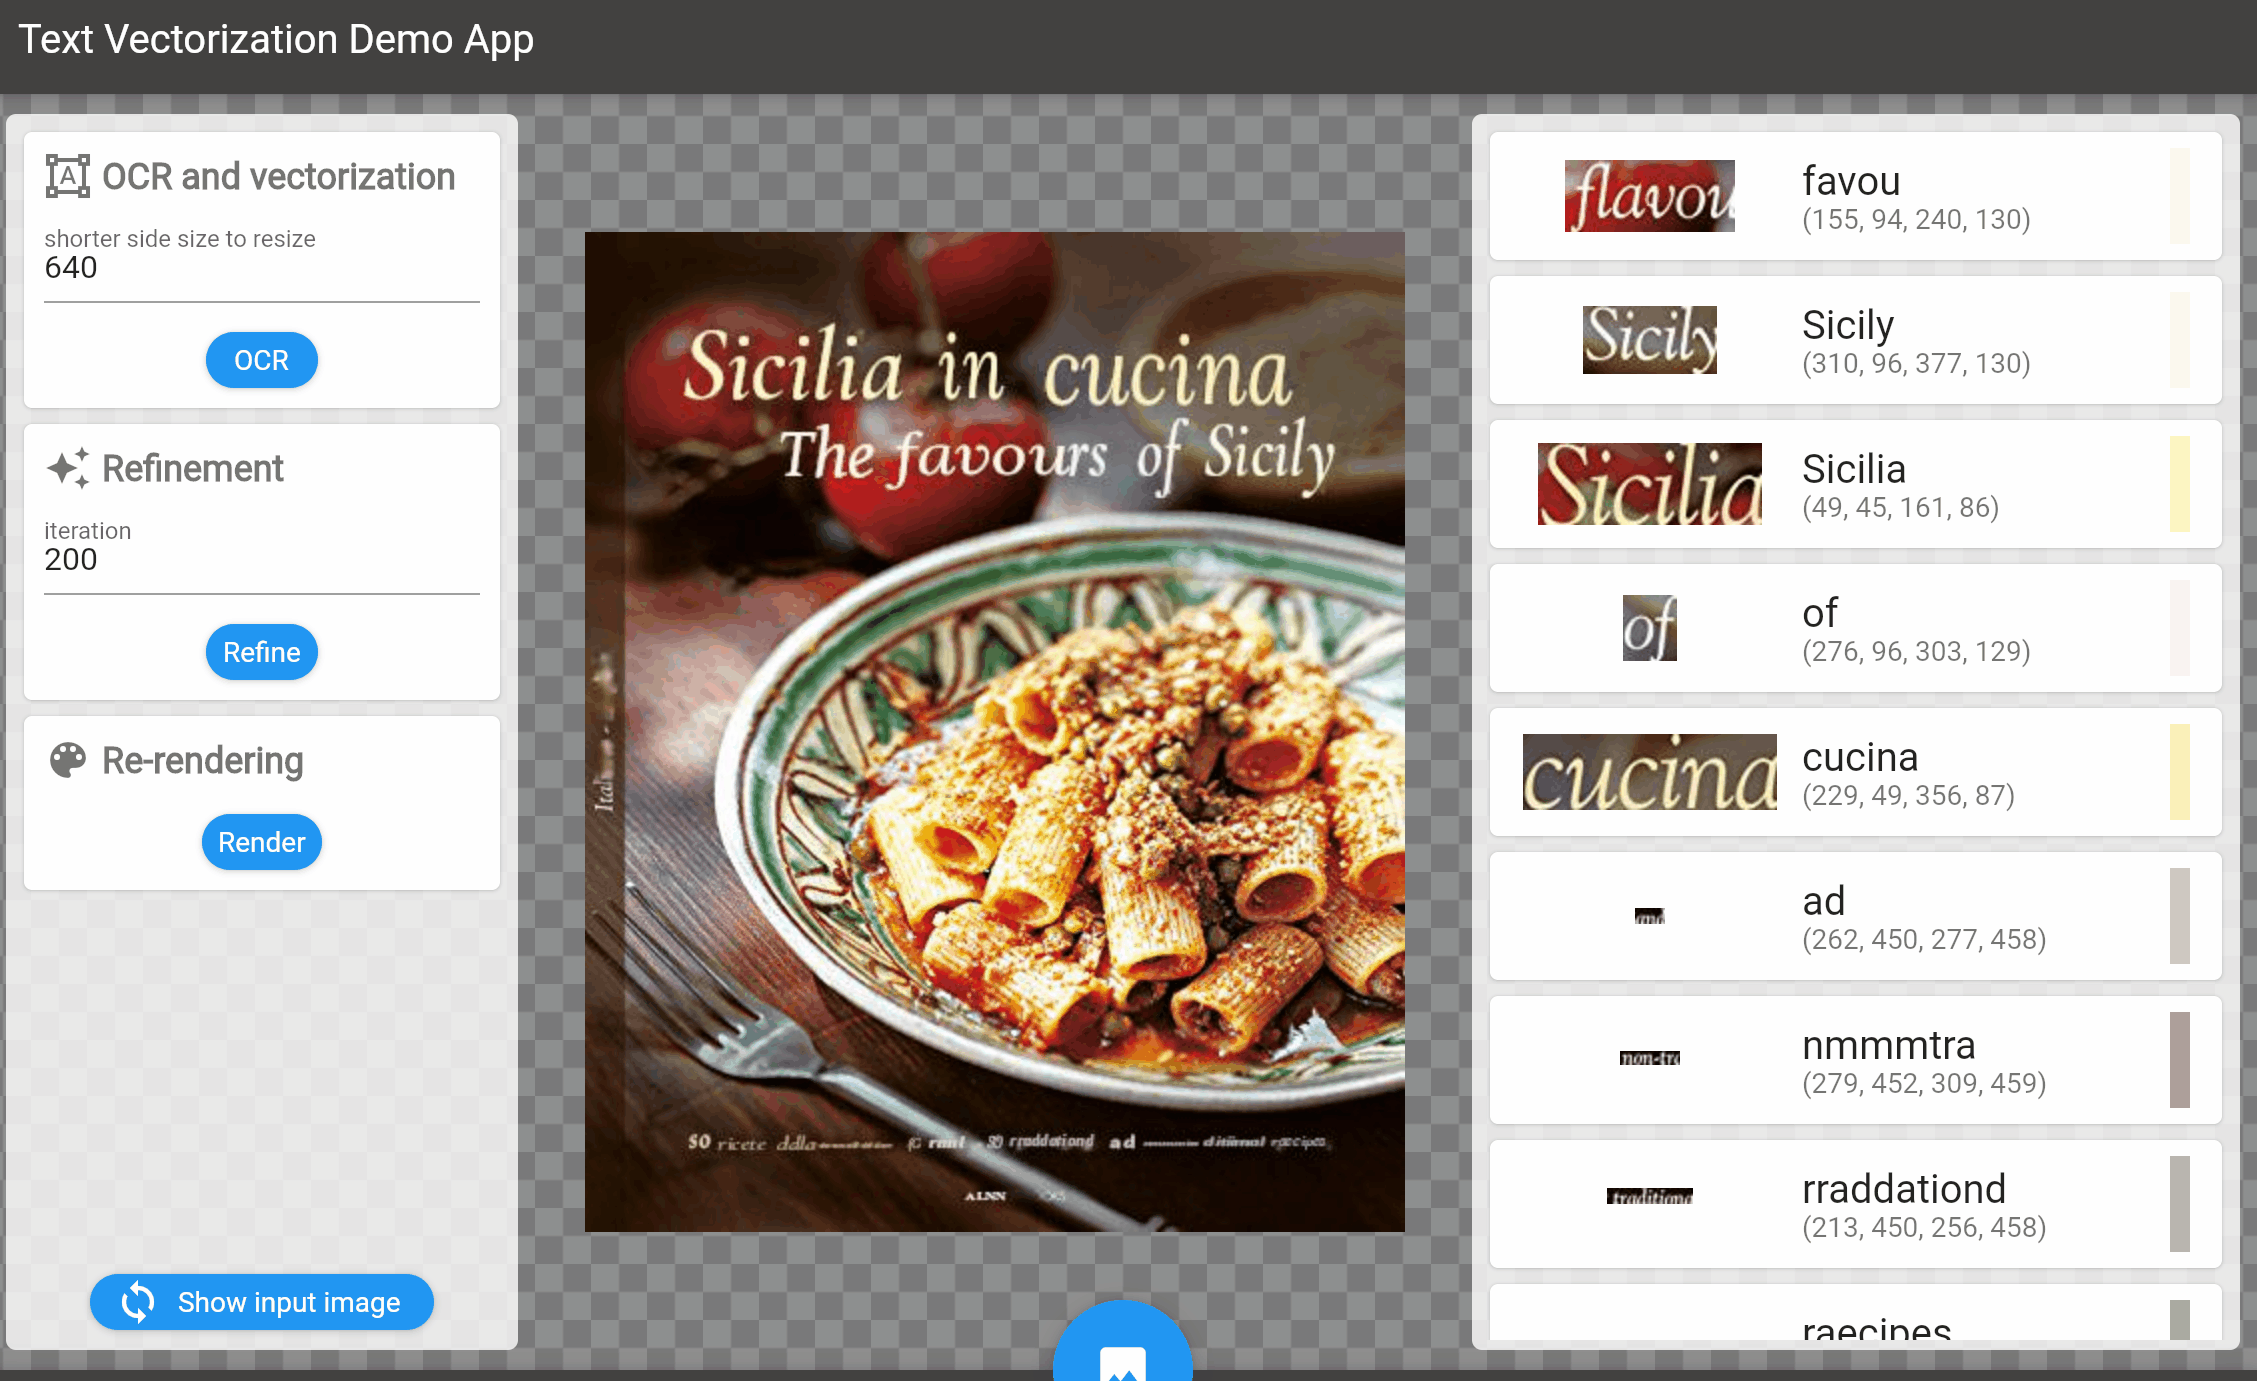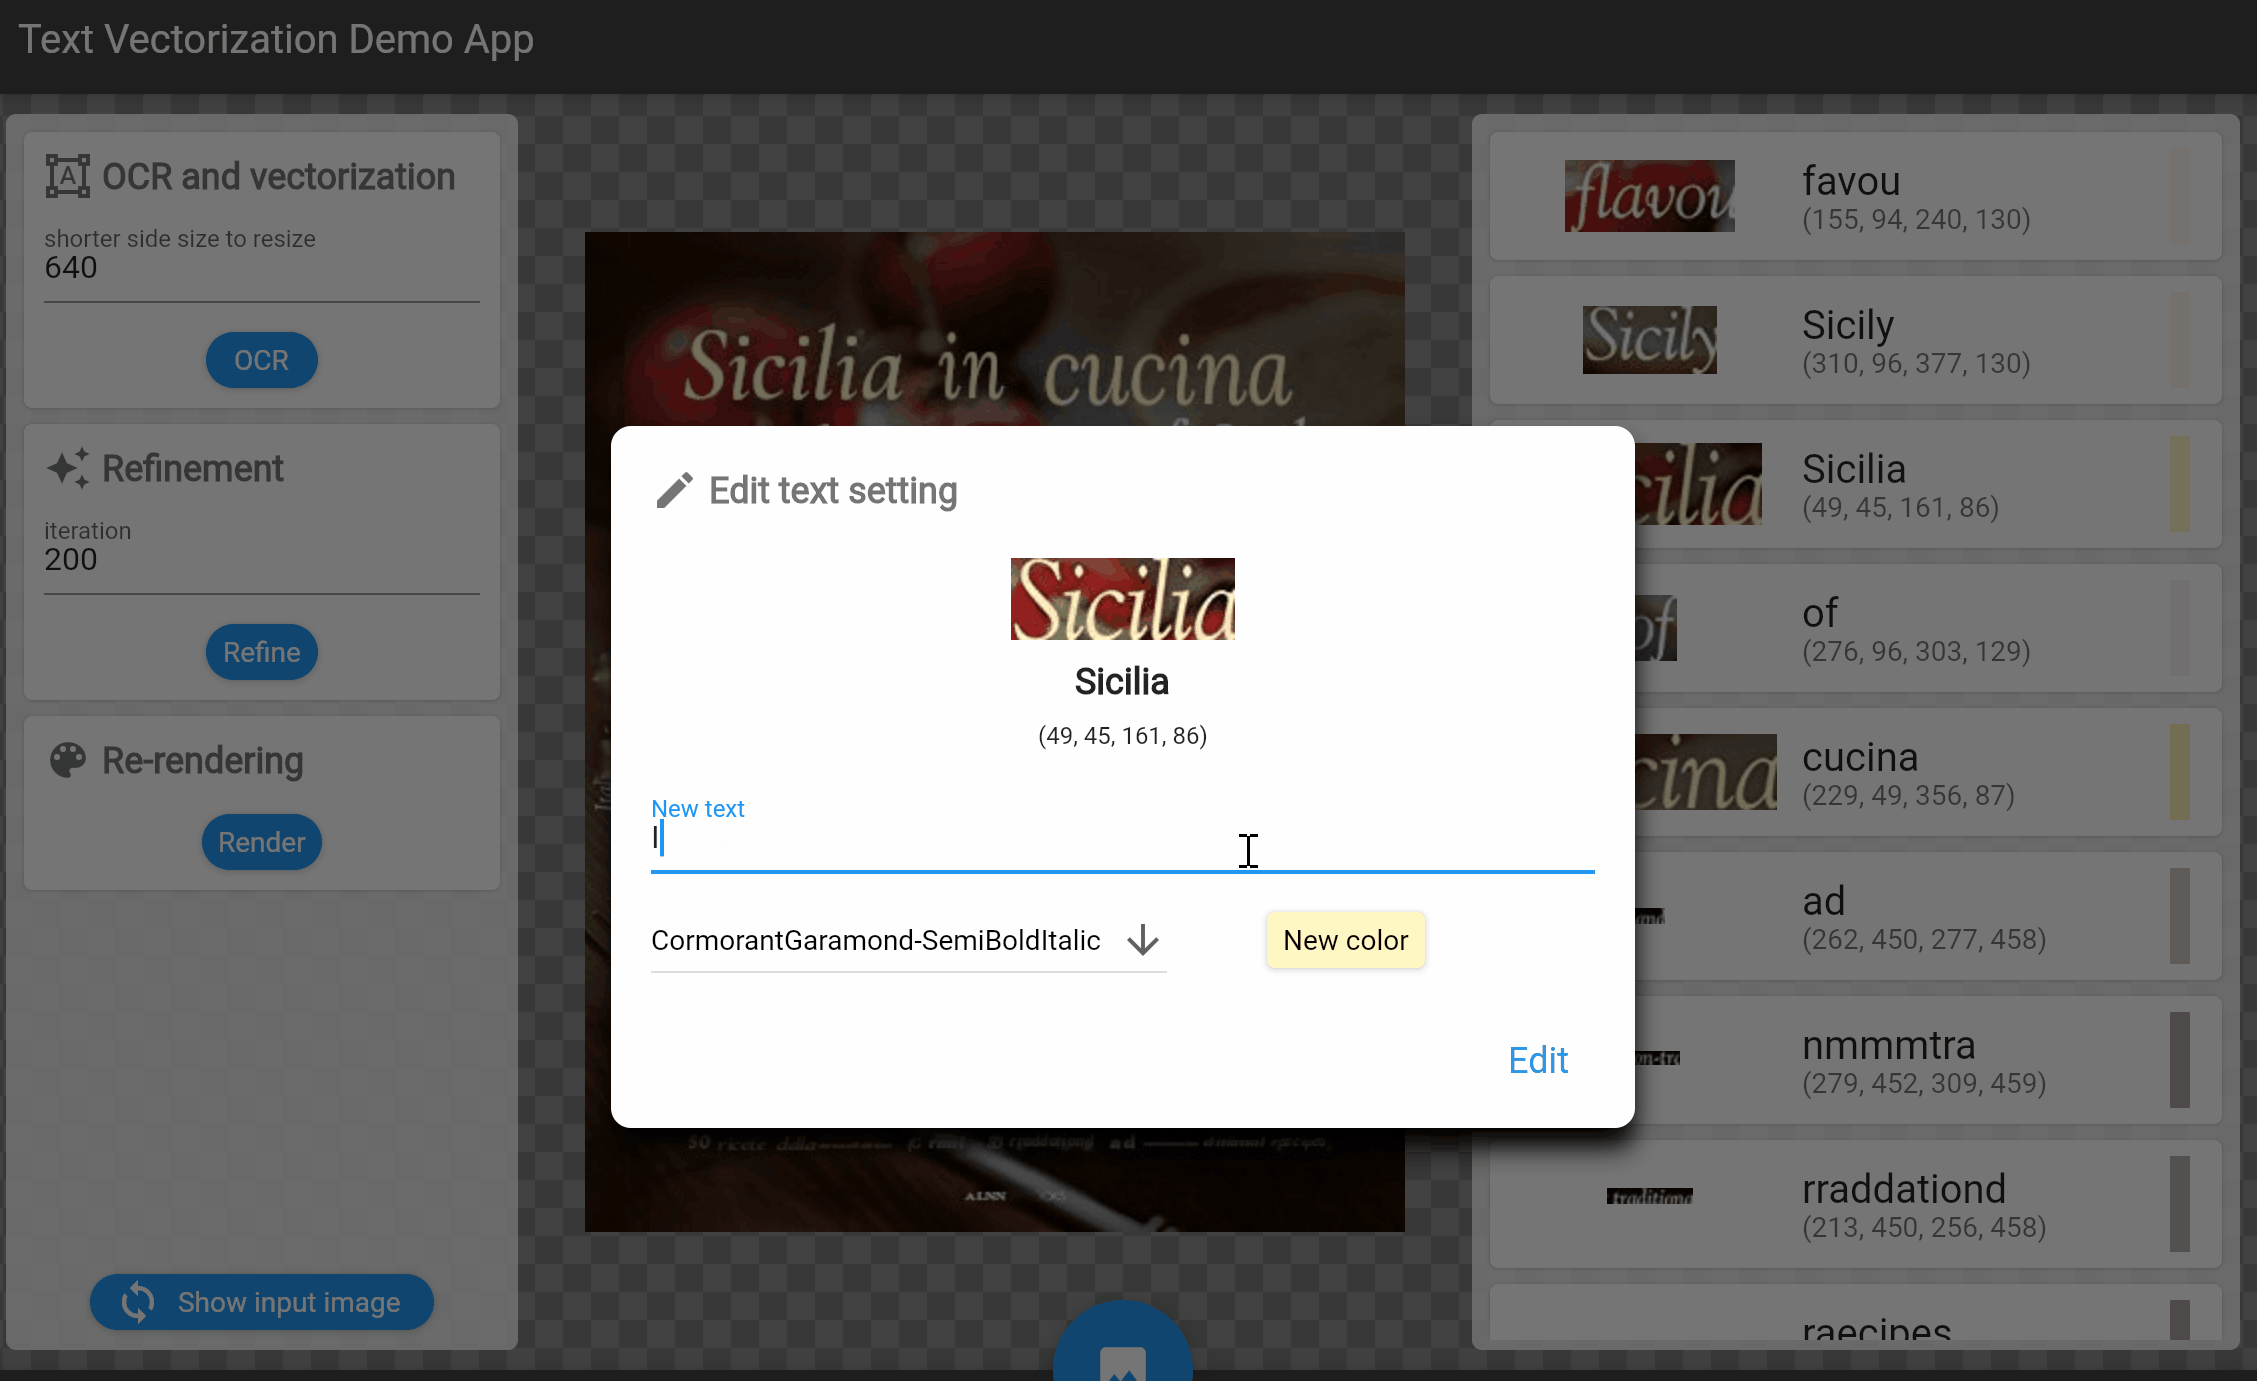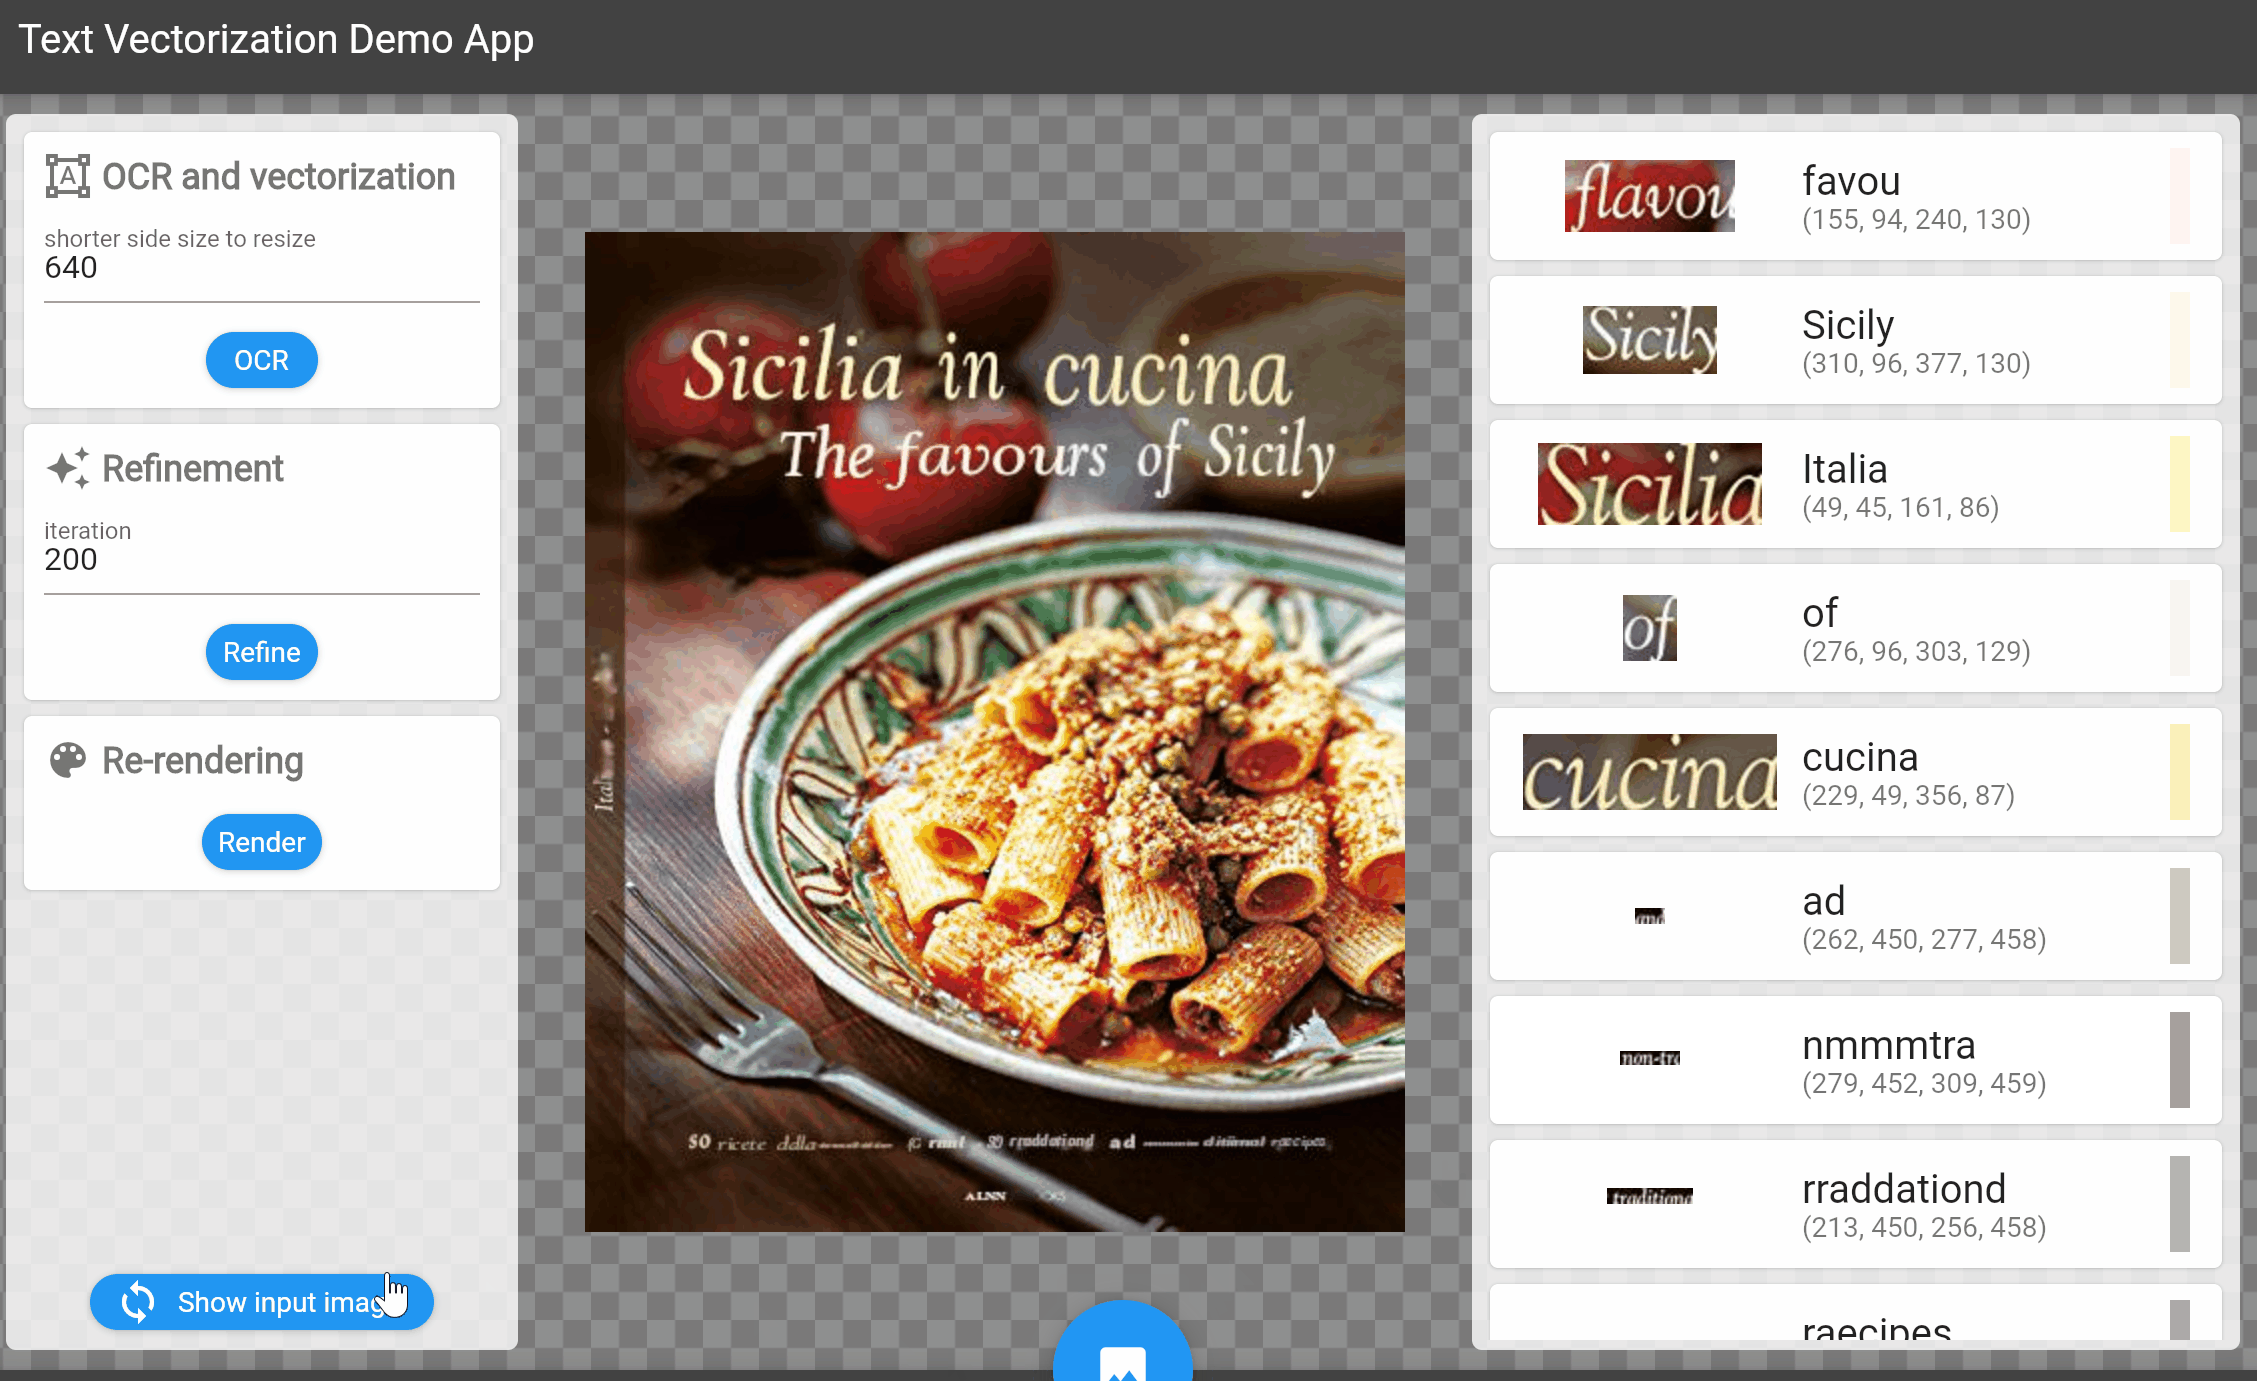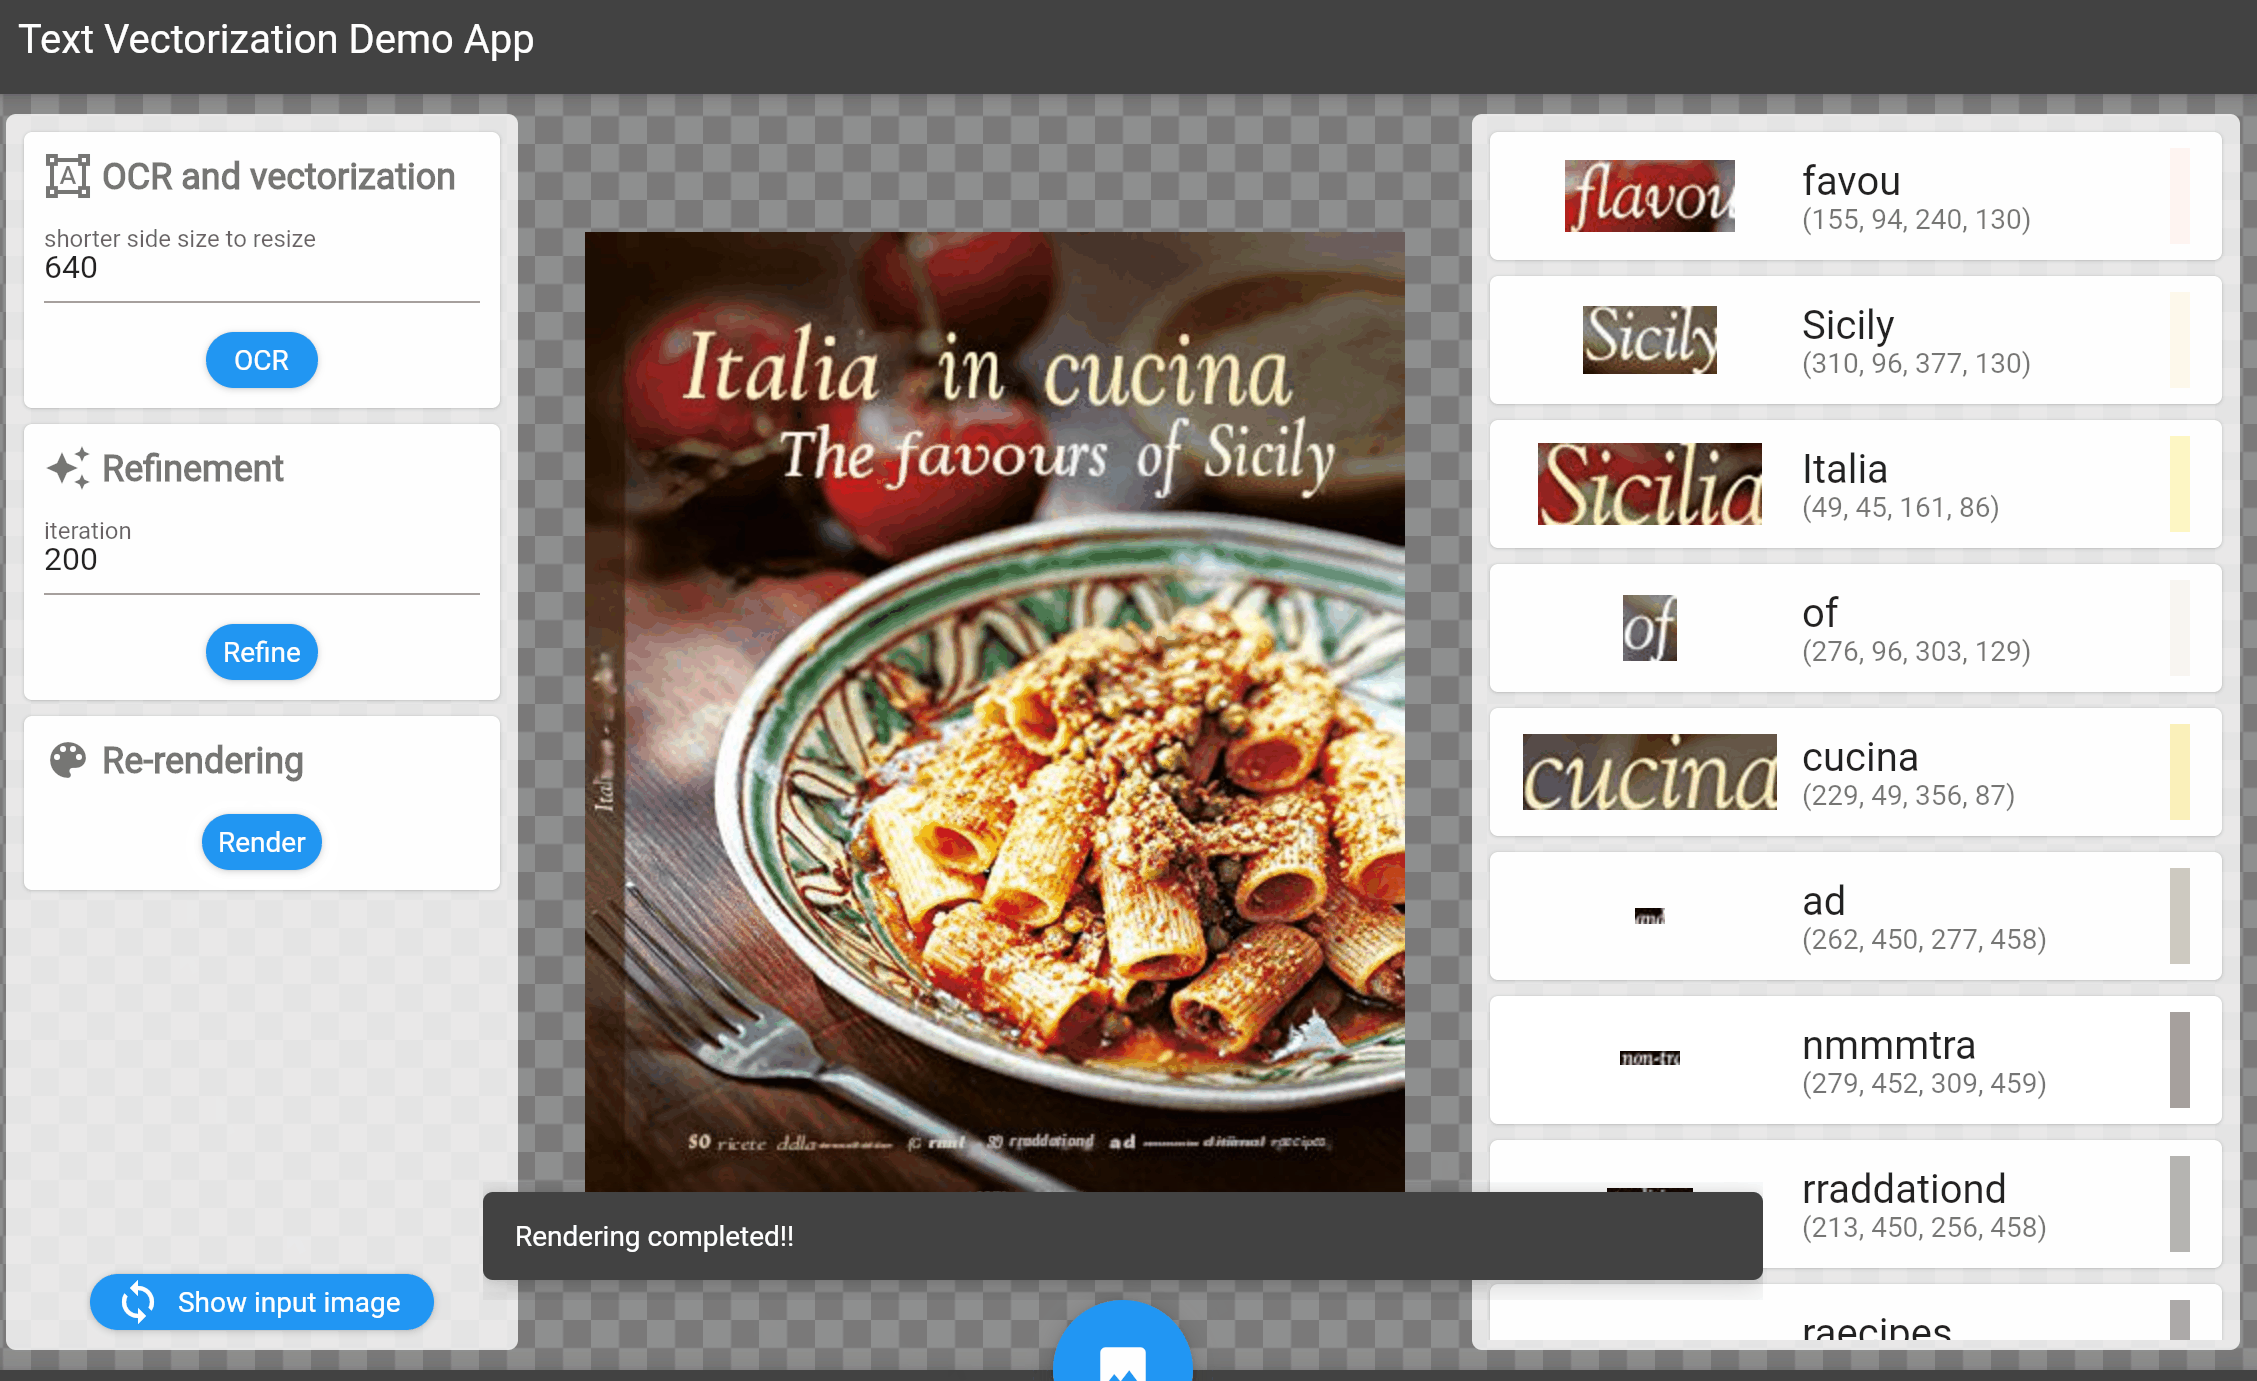
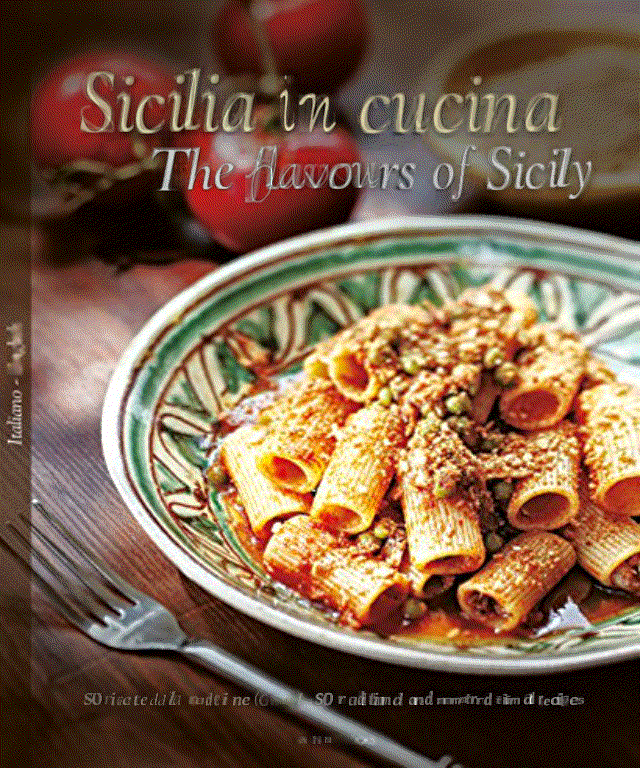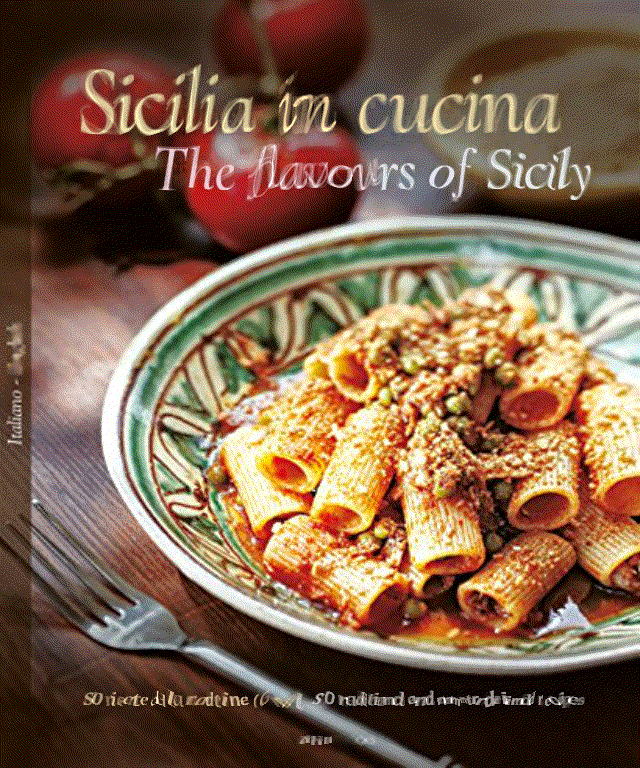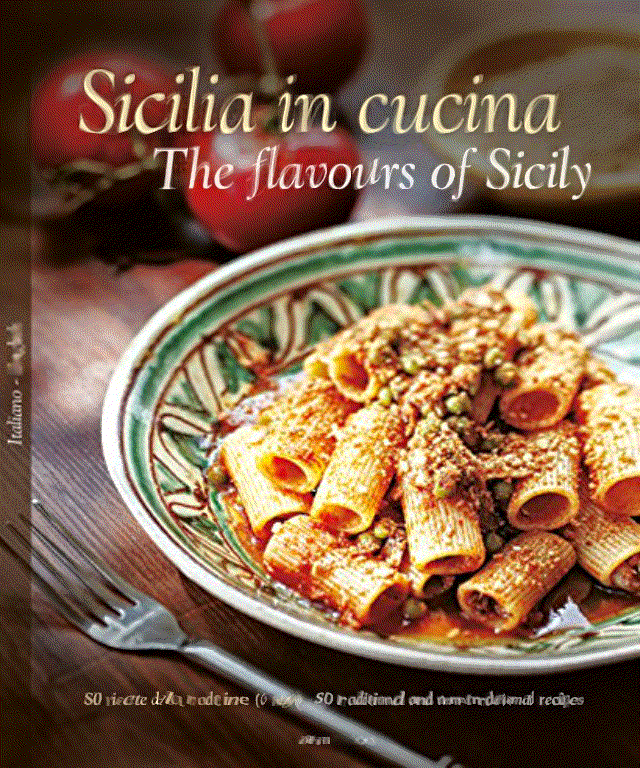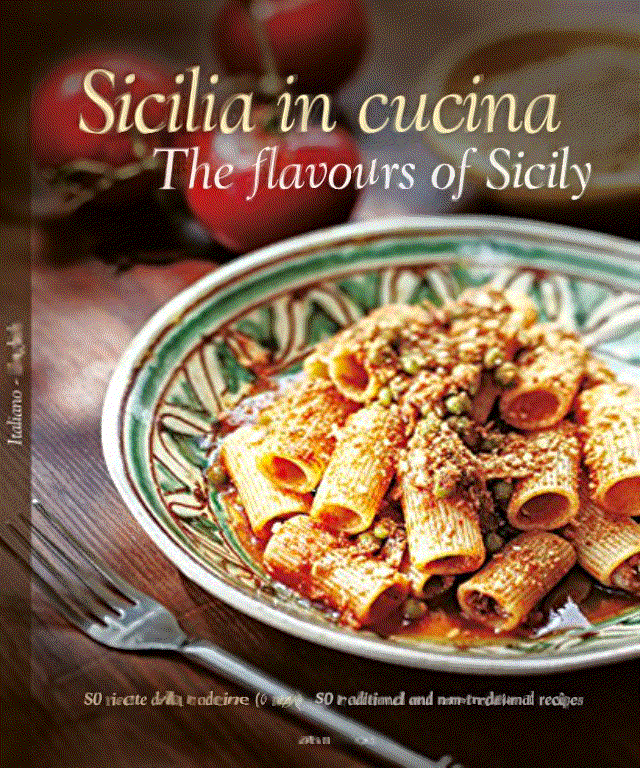
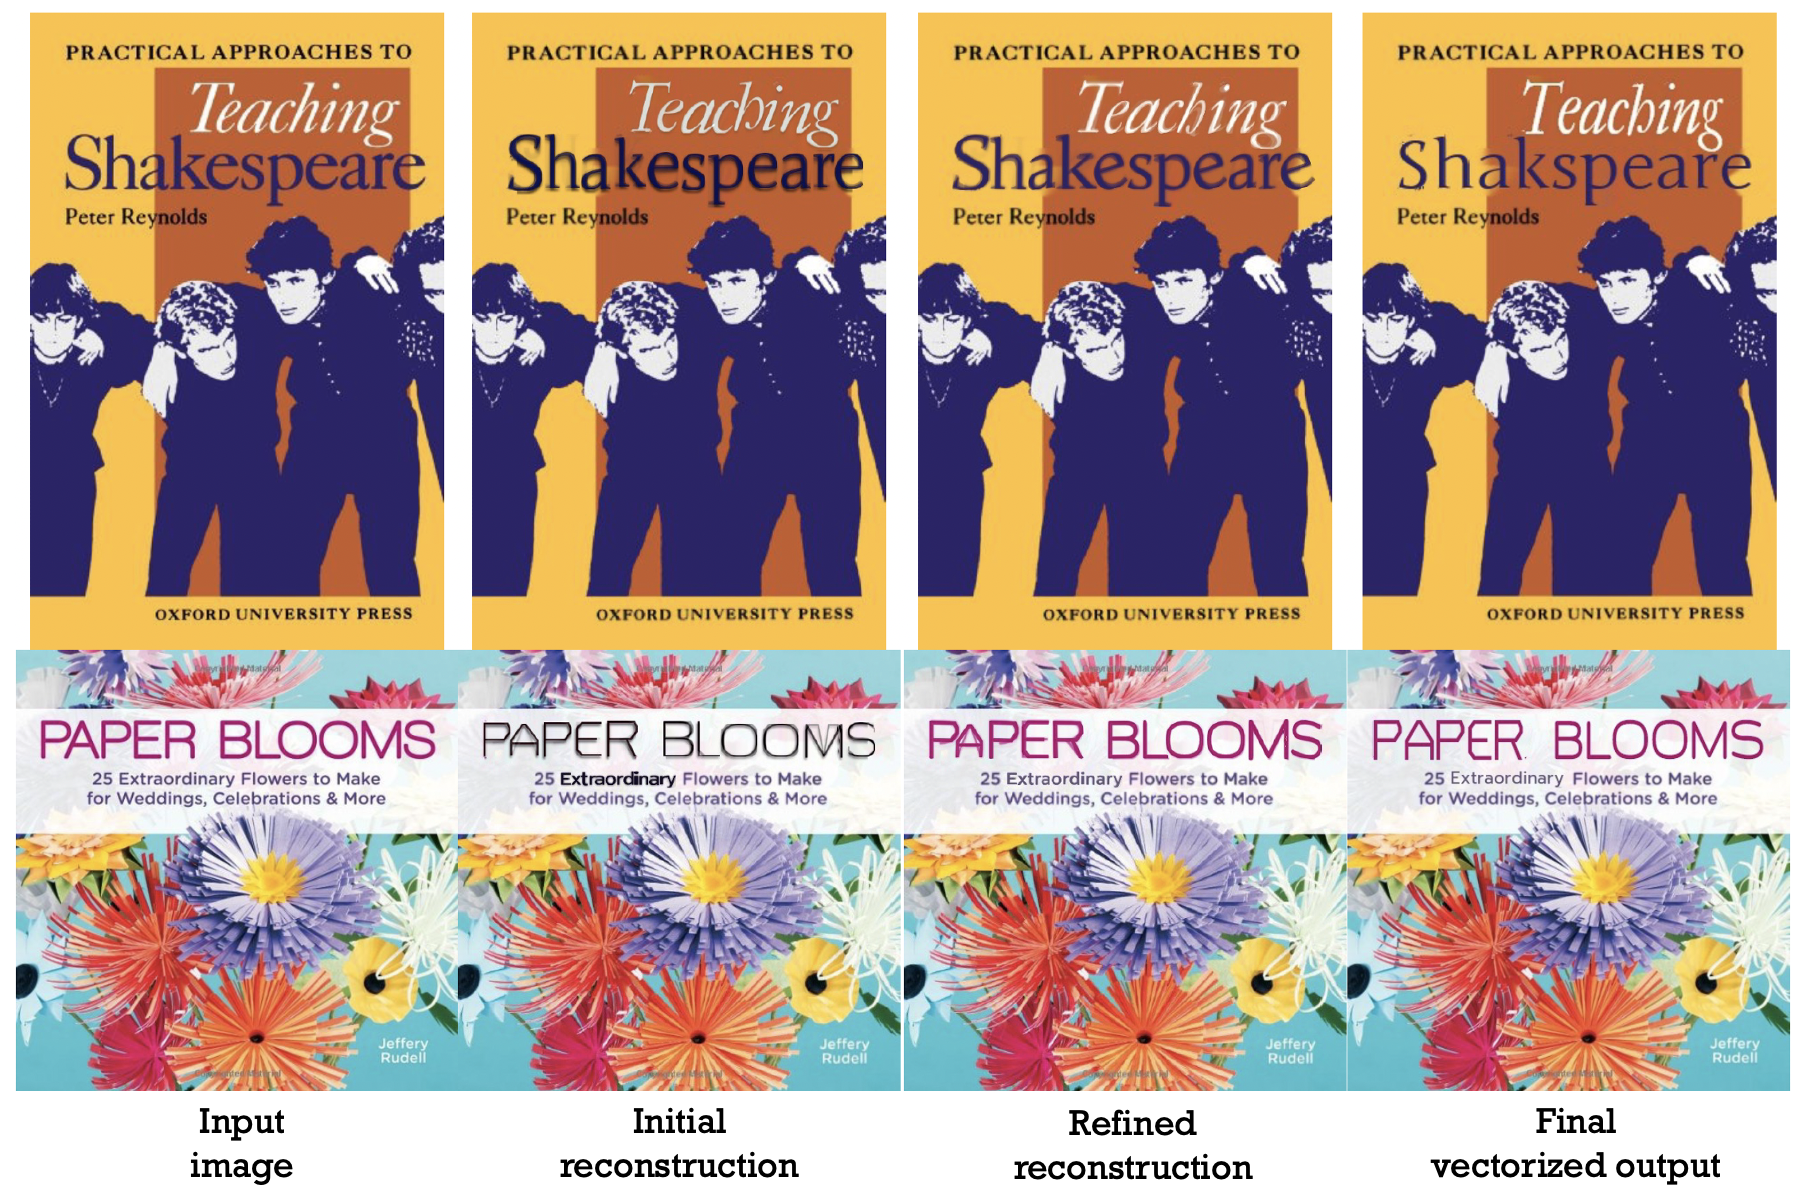
Book Cover 随机取 1,000 张图并用 CRAFT 提取标题区域;Advertisement 随机取 508 张图并评估所有文字区域。指标是平均 L1 与 PSNR。
| 数据集 | 方法 | L1 ↓ | PSNR ↑ | 含义 |
|---|---|---|---|---|
| Book cover 1,000 images | Feedforward | 0.15 | 29.22 | 前馈解析初值 |
| With refinement | 0.08 | 30.02 | 可微渲染内的最佳拟合 | |
| External rasterizer | 0.18 | 29.73 | 导出参数后 Skia 重渲染 | |
| Advertisement 508 images | Feedforward | 0.16 | 28.77 | 前馈解析初值 |
| With refinement | 0.09 | 29.37 | 可微渲染内的最佳拟合 | |
| External rasterizer | 0.19 | 29.16 | 导出参数后 Skia 重渲染 |
| Book Cover 设置 | PSNR ↑ | 相对 Full | 证据解释 |
|---|---|---|---|
| Full refinement | 30.02 | — | 完整优化 |
| Without color refinement | 29.53 | −0.49 | 覆盖面积大的颜色误差影响最大 |
| Without font refinement | 29.78 | −0.24 | 字体概率优化有可测贡献 |
| Without shadow refinement | 29.79 | −0.23 | 阴影区域较小,PSNR 敏感度有限 |
| Without border refinement | 29.99 | −0.03 | 细边框占像素少,PSNR 几乎不变 |
| No refinement | 29.22 | −0.80 | 完整反馈阶段的总体增益 |
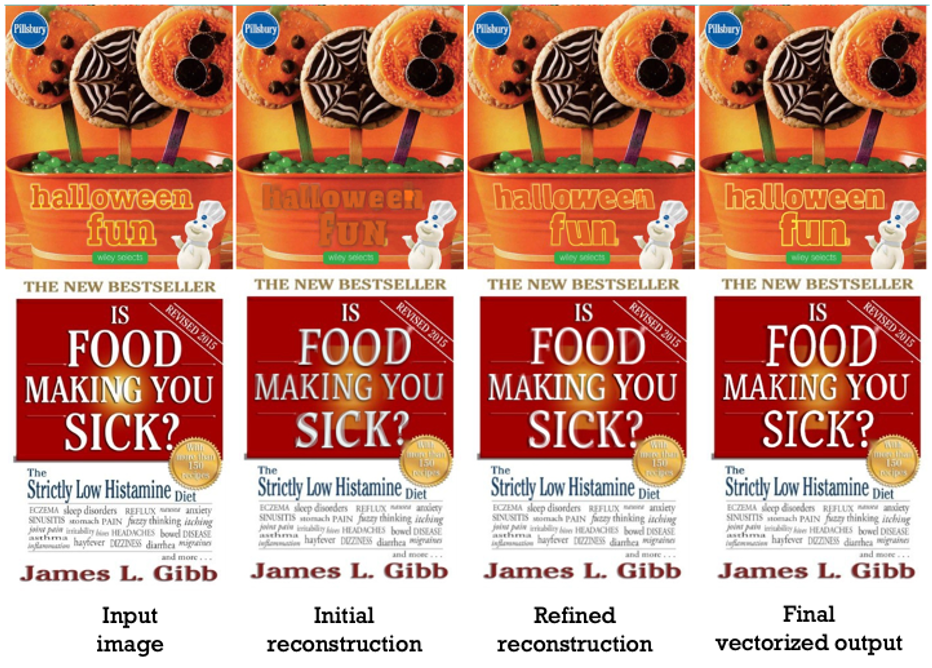
论文只给出 Figure 6 定性比较。SRNet 接收源风格图与目标文字 mask,在像素域生成新文字;本文用外部引擎生成目标 alpha,再以恢复参数重渲染。作者观察到 SRNet 的直线和字符边缘常出现小伪影。
没有量化指标、同预算训练说明或用户研究。两者的输出表示、训练目标和输入接口不同;这组结果支持“参数化渲染能保持锐利边缘”的示例性判断,无法建立全面的 state-of-the-art 优越性。
审计基于官方 GitHub commit 5661702f4c83233bc7a8c4558ee3fc6733838b5b。
train.py 默认只指向临时纯色数据;论文五类数据路径位于注释模板中。CLI 默认 batch size 8,论文为 4。trainer 把 backbone 设为 0.01、text parser / down 设为 0.1,均比论文报告的 0.001 / 0.01 大 10 倍。
公开实现前 100 次迭代同时模糊目标和重建,sigma 从接近 10 逐步降到 0;论文正文只说明 Adam 与 200 iterations。该 coarse-to-fine 技巧会显著影响收敛。
fill alpha 对字体保留 top-20,对字符固定 top-1;border 对字体与字符均固定 top-1,只混合 5 档宽度。文字内容因此完全由 OCR 决定,反馈阶段不能纠正字符误识别。
代码对每个词选取重建误差更可靠的字符框,分别向上与向下最多搜索 1,000 个 font size 候选,再求 width scale。论文只概述为 grid search,公开实现揭示了边界和最佳字符启发式。
仓库提供预训练权重链接、100 字体包链接、预渲染 alpha 生成脚本、测试脚本、数据生成器、训练代码和编辑 notebook。Google Fonts 目录后来变化,README 已要求下载固定字体归档。
真实五类训练数据目录、准确版本锁定、预训练 CharNet 权重来源、训练硬件和时长均未在仓库配置中封闭。默认训练路径用于 quick start,不能直接复现论文表格。
5661702f4c83233bc7a8c4558ee3fc6733838b5b。通讯作者:PDF、CVF 页面、项目页与仓库均未显示明确 correspondence 标记;Kota Yamaguchi 只按末位作者规则保留为未核实候选。