ICML 2015 · Foundational Diffusion Model

Deep Unsupervised Learning using Nonequilibrium Thermodynamics

把任意数据分布沿已知 Markov 扩散过程缓慢推向简单平衡分布,再学习每个微小步骤的时间反演。它给出可采样的深层生成链、路径重要性估计、可训练的变分下界,以及通过逐步乘入约束完成去噪与缺失数据恢复的方法。

Jascha Sohl-Dickstein · Eric A. Weiss · Niru Maheswaranathan · Surya GanguliICML 2015 · PMLR 37:2256–2265arXiv:1503.03585v8 · 18 页合订本正文与参考文献 11 页 + Appendix 7 页Gaussian + binomial diffusion
01 · Research gap

用许多容易估计的小反演,代替一个难以归一化的全局密度

灵活的能量模型可以表达复杂数据,却常有难解的配分函数;Gaussian 等可归一化分布容易训练和求值,却缺少表达能力。论文的核心假设是:先用已知扩散核逐步抹去结构,每步足够小时,逆向条件分布仍属于简单核族,因此只需学习局部均值、协方差或 Bernoulli 概率。

输入与输出

训练输入是数据样本 \(x^{(0)}\sim q(x^{(0)})\)。前向链生成噪声状态 \(x^{(1)},\ldots,x^{(T)}\)。学习结果是一组逆向转移 \(p(x^{(t-1)}\mid x^{(t)})\),从简单先验 \(\pi(x^{(T)})\) 精确采样整条离散 Markov 链并得到 \(x^{(0)}\)。

四项能力

论文强调灵活表达、沿已定义链精确采样、与额外分布相乘形成 posterior,以及通过路径权重估计数据概率。这里的“精确采样”指严格执行有限步已学习 Markov 模型;它没有表示有限步反演等于真实数据分布。

40
Swiss roll 的 Gaussian 步数
1000
多数图像实验的 Gaussian 步数
2000
binary heartbeat 的 binomial 步数
历史语境。 这篇论文直接学习均值和协方差函数,并保留 Gaussian 与 binomial 两类核、路径分布、熵边界和 posterior 乘法。后来的 DDPM 常采用固定噪声日程与噪声预测参数化;用现代 DDPM 术语替换全文会丢失论文的原始目标和离散数据分支。
02 · Forward and reverse Markov paths

前向过程已知,逆向过程可学习

平衡分布 \(\pi\) 对扩散核 \(T_{\pi}\) 保持不变。数据分布用 \(q\) 表示;模型用 \(p\) 表示;上标 \((t)\) 是扩散时间,并非网络层索引。
\[ \pi(y)=\int T_{\pi}(y\mid y';\beta)\pi(y')\,dy',\qquad q(x^{(t)}\mid x^{(t-1)})=T_{\pi}(x^{(t)}\mid x^{(t-1)};\beta_t). \]
\(\beta_t\) 控制第 \(t\) 步破坏信号的强度;核保持 \(\pi\) 不变,反复应用后边缘分布趋向 \(\pi\)。
\[ q(x^{(0:T)})=q(x^{(0)})\prod_{t=1}^{T}q(x^{(t)}\mid x^{(t-1)}), \qquad p(x^{(0:T)})=\pi(x^{(T)})\prod_{t=1}^{T}p(x^{(t-1)}\mid x^{(t)}). \]
第一式是训练时可直接采样的 inference path;第二式定义生成模型。训练使两条路径接近,从而让逆向链把平衡噪声恢复成数据。
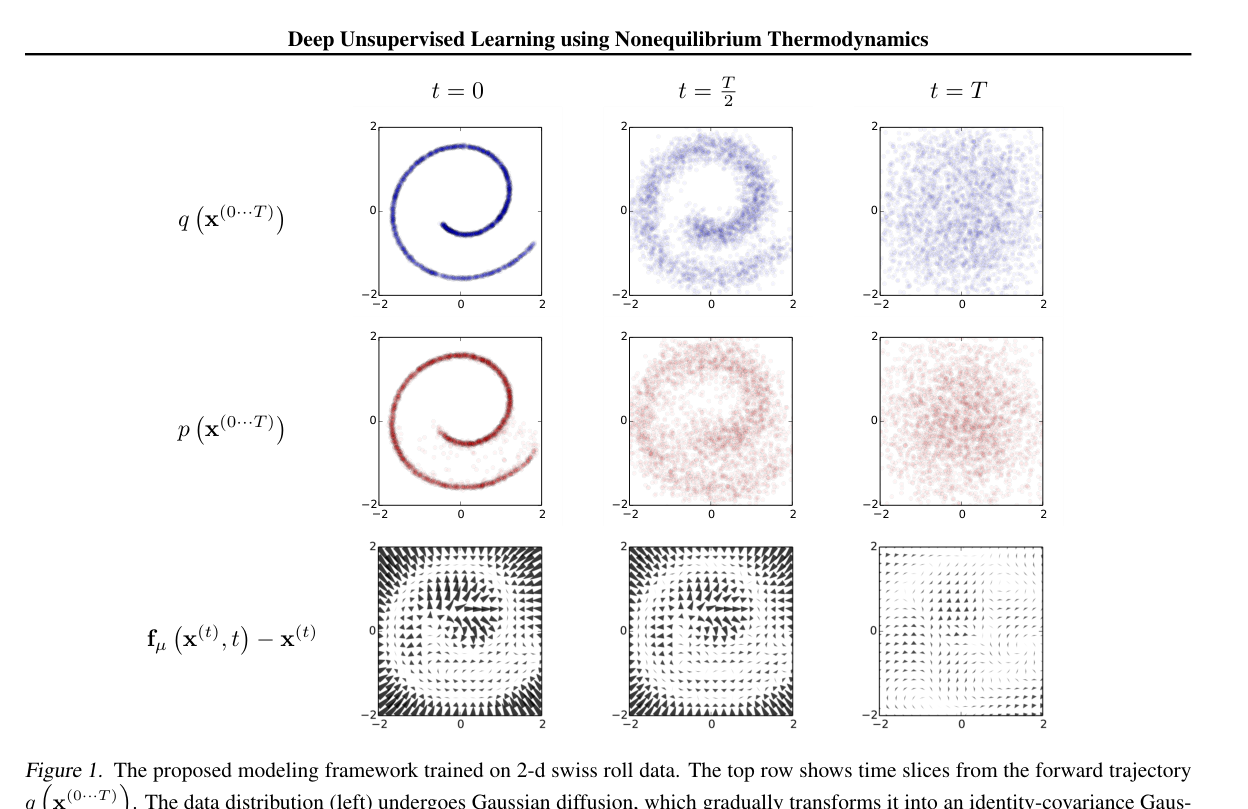
原论文 Figure 1,二维 swiss roll 的前向与反向扩散轨迹
Figure 1(原论文) 上排从 swiss roll 走向单位 Gaussian;中排从单位 Gaussian 走回数据;下排显示逆向 drift \(f_{\mu}(x^{(t)},t)-x^{(t)}\)。

两类核

项目GaussianBinomial / Bernoulli
平衡分布\(\pi(x^{(T)})=\mathcal N(x^{(T)};0,I)\)通用表:\(\pi(x^{(T)})=\mathcal B(x^{(T)};0.5)\);Heartbeat 实验:独立 \(\mathcal B(0.2)\) prior
前向核\(\mathcal N(x^{(t)};\sqrt{1-\beta_t}x^{(t-1)},\beta_t I)\)通用表:\(\mathcal B(x^{(t)};(1-\beta_t)x^{(t-1)}+0.5\beta_t)\)
逆向核\(\mathcal N(x^{(t-1)};f_{\mu}(x^{(t)},t),f_{\Sigma}(x^{(t)},t))\)\(\mathcal B(x^{(t-1)};f_b(x^{(t)},t))\)
学习对象均值、协方差及 Gaussian 实验中的 \(\beta_{2:T}\)每个 bit 的 Bernoulli rate;日程固定

Gaussian 核把信号乘以 \(\sqrt{1-\beta_t}\),并添加方差 \(\beta_t\) 的噪声,因此单位协方差 Gaussian 保持不变。通用 Binomial 表把 bit probability 向 0.5 拉近:\(\beta_t=0\) 保留 bit,\(\beta_t=1\) 完全随机化。
Heartbeat 的实验特例。 Appendix D.1.2 明确写出 reverse trajectory 从与数据平均活动率相同的独立 prior 初始化,即 \(p(x_i^{(T)}=1)=0.2\)。这与 Table App.1 的通用 \(0.5\) 平衡分布及前向核存在差别。若保持同类 stationary kernel,通用写法应把 \(0.5\) 换成 \(\rho=0.2\):\(q(x_i^{(t)}=1\mid x_i^{(t-1)})=(1-\beta_t)x_i^{(t-1)}+\rho\beta_t\)。论文没有明确写出 Heartbeat 是否采用该替换,因此已验证事实是实验 prior 为 0.2,实验专用 forward kernel 细节保持未公开。
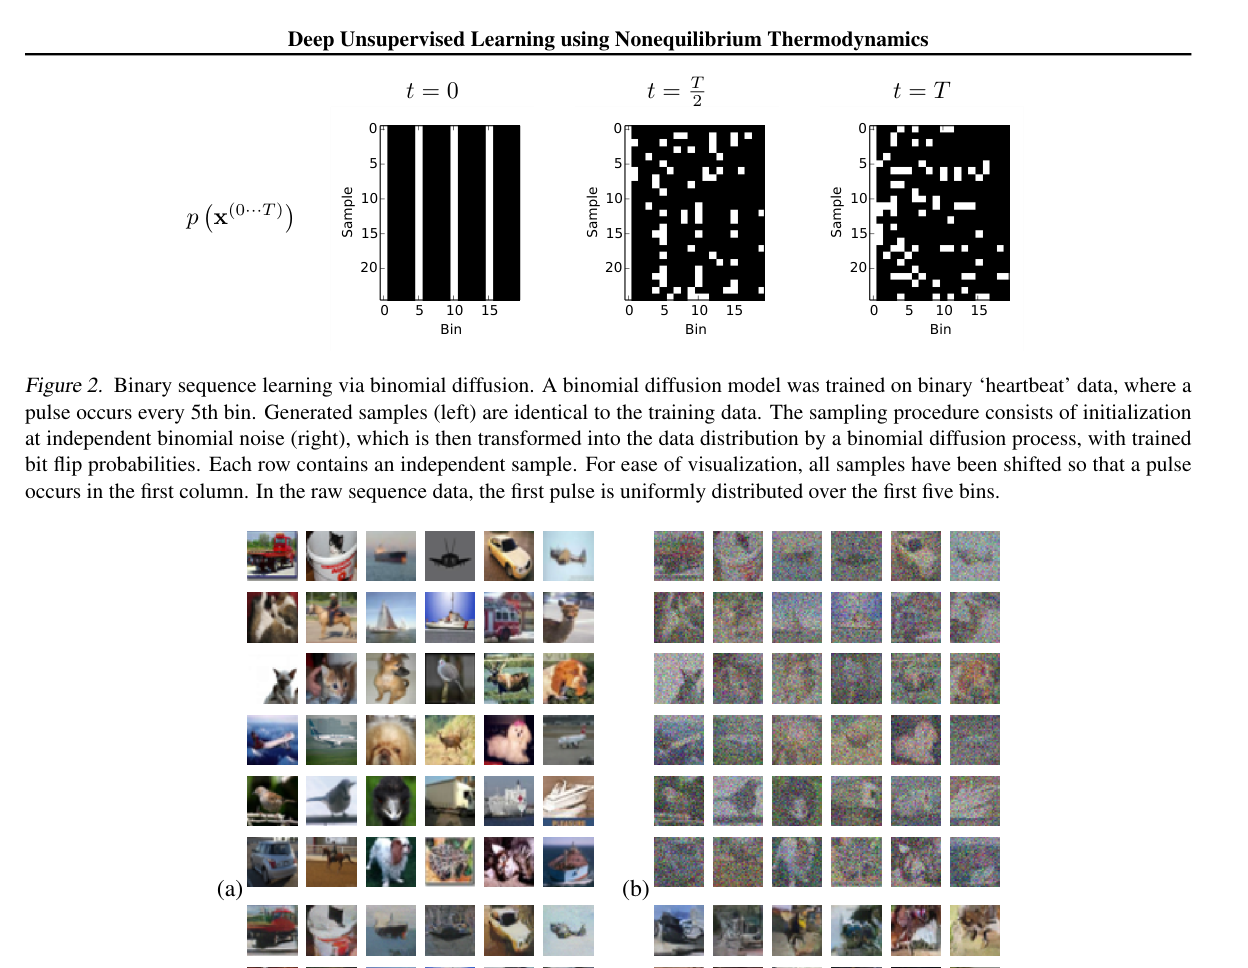
原论文 Figures 2 和 3,binary heartbeat 与 CIFAR-10
Figures 2–3(原论文) Figure 2 展示 heartbeat 从独立噪声恢复五格周期;Figure 3 展示 CIFAR-10 holdout、SNR=1 的加噪图、posterior 去噪结果与无条件样本。
为何小步骤重要。 连续扩散极限下,Gaussian 或 binomial 前向核的时间反演仍具有相同函数形式。有限步越小,复杂多峰的单步逆条件越接近简单核;成本按 \(T\) 次网络求值线性增长。
03 · Probability and variational bound

路径重要性恒等式给出概率,Jensen 不等式给出训练目标

\[ p(x^{(0)})=\int q(x^{(1:T)}\mid x^{(0)}) \frac{p(x^{(0:T)})}{q(x^{(1:T)}\mid x^{(0)})}\,dx^{(1:T)} =\mathbb E_q\!\left[ p(x^{(T)})\prod_{t=1}^{T} \frac{p(x^{(t-1)}\mid x^{(t)})}{q(x^{(t)}\mid x^{(t-1)})} \right]. \]
分子乘入再除去同一个 forward conditional,积分值没有变化。括号内是整条 reverse path 与 forward conditional path 的密度比;可以用前向轨迹 Monte Carlo 估计。路径完全一致的准静态极限下,单个样本即可精确求值。
\[ L=\mathbb E_{q(x^{(0)})}[\log p(x^{(0)})] \ge K=\mathbb E_{q(x^{(0:T)})}\!\left[ \log p(x^{(T)})+ \sum_{t=1}^{T}\log\frac{p(x^{(t-1)}\mid x^{(t)})}{q(x^{(t)}\mid x^{(t-1)})} \right]. \]
对路径权重的期望取对数后应用 Jensen:\(\log\mathbb E[w]\ge\mathbb E[\log w]\)。最大化 \(K\) 是最大化数据对数似然的下界。

附录 B 的逐式化简

1 · 分离终点\(p(x^{(T)})=\pi(x^{(T)})\),其 cross entropy 在核设计下为常数。
2 · 移除边界令第一个 reverse step 等于相应平衡反演核,消去 \(t=1\) 的 edge effect。
3 · Bayes 改写把前向 transition 改写为 \(q(x^{(t-1)}\mid x^{(t)},x^{(0)})\) 和两个边缘比。
4 · 望远镜求和边缘比变成条件熵差,并在 \(t=2\ldots T\) 抵消中间项。
5 · KL 识别每一步的 log ratio 变成 posterior 与 learned reverse kernel 的负 KL。
\[ K=-\sum_{t=2}^{T}\mathbb E_{q(x^{(0)},x^{(t)})} \left[D_{\mathrm{KL}}\!\left( q(x^{(t-1)}\mid x^{(t)},x^{(0)})\,\middle\|\, p(x^{(t-1)}\mid x^{(t)})\right)\right] +H_q(X^{(T)}\mid X^{(0)})-H_q(X^{(1)}\mid X^{(0)})-H_p(X^{(T)}). \]
固定 forward kernel 与 \(\beta_{1:T}\) 时,后三个熵项是可解析计算的常数,reverse-network 参数只进入逐步 KL,因此网络训练等价于拟合“知道干净样本 \(x^{(0)}\)”时的解析后验。Gaussian 实验还通过对 \(K\) 求梯度学习 \(\beta_{2:T}\);此时 posterior、逐步 KL 与 \(H_q(X^{(T)}\mid X^{(0)})\) 随学习的 schedule 变化;\(H_q(X^{(1)}\mid X^{(0)})\) 只依赖固定的 \(\beta_1\),仍保持常数,frozen-noise 重参数化负责传递这些梯度。Gaussian KL 退化成均值与方差回归;binomial 使用 Bernoulli KL。

Gaussian forward marginal 与 posterior

\[ \alpha_t=1-\beta_t,\qquad \bar\alpha_t=\prod_{s=1}^{t}\alpha_s, \qquad q(x^{(t)}\mid x^{(0)})= \mathcal N\!\left(x^{(t)};\sqrt{\bar\alpha_t}x^{(0)},(1-\bar\alpha_t)I\right). \]
这是反复代入线性 Gaussian 核得到的闭式边缘,允许训练时直接抽取任意时间 \(t\),无需真的执行前面所有步骤。
\[ q(x^{(t-1)}\mid x^{(t)},x^{(0)}) =\mathcal N(x^{(t-1)};\widetilde\mu_t,\widetilde\beta_t I), \quad \widetilde\beta_t=\frac{1-\bar\alpha_{t-1}}{1-\bar\alpha_t}\beta_t, \] \[ \widetilde\mu_t= \frac{\sqrt{\bar\alpha_{t-1}}\beta_t}{1-\bar\alpha_t}x^{(0)} +\frac{\sqrt{\alpha_t}(1-\bar\alpha_{t-1})}{1-\bar\alpha_t}x^{(t)}. \]
由两个 Gaussian 因子 \(q(x^{(t)}\mid x^{(t-1)})q(x^{(t-1)}\mid x^{(0)})\) 完成平方得到。论文代码用等价 precision 加权形式实现 posterior 均值与标准差。

Bernoulli forward marginal 与 posterior

令 \(\rho\in(0,1)\) 表示 stationary Bernoulli probability。Table App.1 的通用核对应 \(\rho=0.5\)。定义 \(\bar\alpha_t=\prod_{s=1}^{t}(1-\beta_s)\),则第 \(i\) 个 bit 的 forward marginal parameter 为

\[ m_{t,i}=q(x_i^{(t)}=1\mid x_i^{(0)}) =\rho+\bar\alpha_t(x_i^{(0)}-\rho). \]

给定观测 \(x_i^{(t)}\in\{0,1\}\),Bayes rule 给出完整 posterior。令

\[ a_t(x)=\bigl(1-\beta_t+\beta_t\rho\bigr)^x \bigl(\beta_t(1-\rho)\bigr)^{1-x}, \qquad b_t(x)=\bigl(\beta_t\rho\bigr)^x \bigl(1-\beta_t\rho\bigr)^{1-x}, \] \[ q(x_i^{(t-1)}=1\mid x_i^{(t)},x_i^{(0)}) =\frac{m_{t-1,i}a_t(x_i^{(t)})} {m_{t-1,i}a_t(x_i^{(t)})+(1-m_{t-1,i})b_t(x_i^{(t)})}. \]
\(a_t\) 是在上一步 bit 为 1 时产生当前观测的概率,\(b_t\) 是在上一步 bit 为 0 时产生当前观测的概率。分母对两种上一步状态求和,保证结果落在 \([0,1]\)。把 \(\rho\) 设为 0.5 得到 Table App.1 的通用 binomial posterior;Heartbeat 的实验 prior 为 0.2,但论文未写明是否把 forward kernel 的 \(\rho\) 同步设为 0.2。

扩散日程

Gaussian 实验固定较小的 \(\beta_1\),通过对 \(K\) 的梯度上升学习 \(\beta_{2:T}\),用 frozen noise 重参数化保持噪声样本固定后求偏导。脚注说明后续实验发现 binomial 的固定日程同样有效。离散 bit 无法用这种 frozen-noise 梯度,因此令每步抹去剩余原信号的固定比例:

\[ \beta_t=(T-t+1)^{-1}. \]
该日程使剩余 signal 系数逐步均匀下降,到终点完全成为独立噪声。
04 · Entropy bounds

仅用 forward process 夹住每步 reverse conditional entropy

\[ H_q(X^{(t-1)}\mid X^{(t)}) =H_q(X^{(t)}\mid X^{(t-1)})+H_q(X^{(t-1)})-H_q(X^{(t)}). \]
来自联合熵对称性。后两项的边缘熵通常未知,附录 A 进一步给出可计算边界。
\[ H_q(X^{(t)}\mid X^{(t-1)}) \ge H_q(X^{(t-1)}\mid X^{(t)}) \ge H_q(X^{(t)}\mid X^{(t-1)}) +H_q(X^{(t-1)}\mid X^{(0)})-H_q(X^{(t)}\mid X^{(0)}). \]
上界利用扩散使边缘熵单调增加;Gaussian 情况要求训练数据缩放到方差 1,binomial 情况无需额外条件。下界利用 Markov 链的数据处理性质:随着 \(t\) 增加,终点携带的初态信息只会减少。所有右侧条件熵由已知前向核解析得到。
边界含义。 这些熵界用于检查逆向步骤可能达到的随机性,并可转化为似然约束。论文没有把它们作为现代 score-matching 目标,也没有提供基于该界的独立 ablation。
05 · Multiplying distributions

把条件约束逐步乘入 reverse kernel

目标 posterior 写成 \(\widetilde p(x^{(0)})\propto p(x^{(0)})r(x^{(0)})\)。论文在每个时间边缘引入同类约束 \(r(x^{(t)})\),并规范化每一步。

\[ \widetilde p(x^{(t)})=\frac{p(x^{(t)})r(x^{(t)})}{\widetilde Z_t}, \qquad \widetilde p(x^{(t)}\mid x^{(t+1)}) =\frac{p(x^{(t)}\mid x^{(t+1)})r(x^{(t)})}{\widetilde Z_t(x^{(t+1)})}. \]
\(r\) 可以是 likelihood、平滑 positive function,或已知坐标上的 delta constraint。\(\widetilde Z_t(x^{(t+1)})\) 是单步条件归一化常数。

受约束 Bernoulli reverse kernel

以下逐 bit 公式要求基础 kernel 按 bit 独立,约束也能分解成 \(r(y)=\prod_i r_i(y_i)\);耦合多个 bit 的约束通常使后验产生依赖,不能直接套用独立 Bernoulli 更新。对单个 bit \(i\),令基础逆向核给出 \(c_i=\Pr_p(x_i^{(t-1)}=1\mid x^{(t)})=[f_b(x^{(t)},t)]_i\),并令约束权重 \(d_{i,1}=r(x_i^{(t-1)}=1)\)、\(d_{i,0}=r(x_i^{(t-1)}=0)\)。把 \(r\) 与 Bernoulli PMF 相乘并规范化后,论文 Table App.1 的受约束 binomial kernel 可写成

\[ \widetilde p(x_i^{(t-1)}=1\mid x^{(t)}) =\frac{c_i d_{i,1}}{c_i d_{i,1}+(1-c_i)d_{i,0}}, \] \[ \widetilde p(x_i^{(t-1)}\mid x^{(t)}) =\mathcal B\!\left(x_i^{(t-1)}; \frac{c_i d_{i,1}}{c_i d_{i,1}+(1-c_i)d_{i,0}} \right). \]
若 \(r\) 本身按 Bernoulli probability 表示,论文记 \(d_i=r(x_i=1)\),于是 \(d_{i,1}=d_i\)、\(d_{i,0}=1-d_i\)。合法条件是 \(0\le c_i,d_i\le1\) 且分母严格大于 0;结果自然位于 \([0,1]\)。硬约束 1 对应 \((d_{i,1},d_{i,0})=(1,0)\),硬约束 0 对应 \((0,1)\),未知 bit 使用等权 \((1,1)\) 并保持原 kernel。

Gaussian 小扰动

\[ p(y\mid x^{(t)})=\mathcal N(y;\mu,\Sigma),\quad \widetilde p(y\mid x^{(t)})\propto \mathcal N(y;\mu,\Sigma)r(y), \] \[ E_r(y)=-\log r(y)\approx E_r(\mu)+(y-\mu)^{\mathsf T}g, \qquad g=\left.\nabla_yE_r(y)\right|_{y=\mu}, \] \[ \widetilde p(y\mid x^{(t)})\approx \mathcal N\!\left(y;\mu+\Sigma\left.\nabla_y\log r(y)\right|_{y=\mu},\Sigma\right). \]
对 \(-\log r\) 在 \(\mu\) 处一阶展开并完成平方。约束梯度按协方差缩放后移动均值,协方差保持原值;成立条件是约束能量 Hessian 相对 \(\Sigma^{-1}\) 足够小。

Missing data 与去噪

缺失区域恢复

已知坐标上取 delta function,使每个 reverse step 的已知像素严格满足观测;缺失坐标上令 \(r\) 为常数,让模型自由采样。Figure 5 将 bark 中央 \(100\times100\) 区域初始化为单位 Gaussian 噪声,周围像素形成条件。

Gaussian 去噪

将观测 likelihood 作为 \(r\) 与每步 Gaussian 核相乘。Figure 3 使用方差 1、SNR=1 的噪声图作为观测,并从模型 posterior 采样干净图。恢复结果是一份后验样本,没有表示 posterior mean 或唯一逆解。
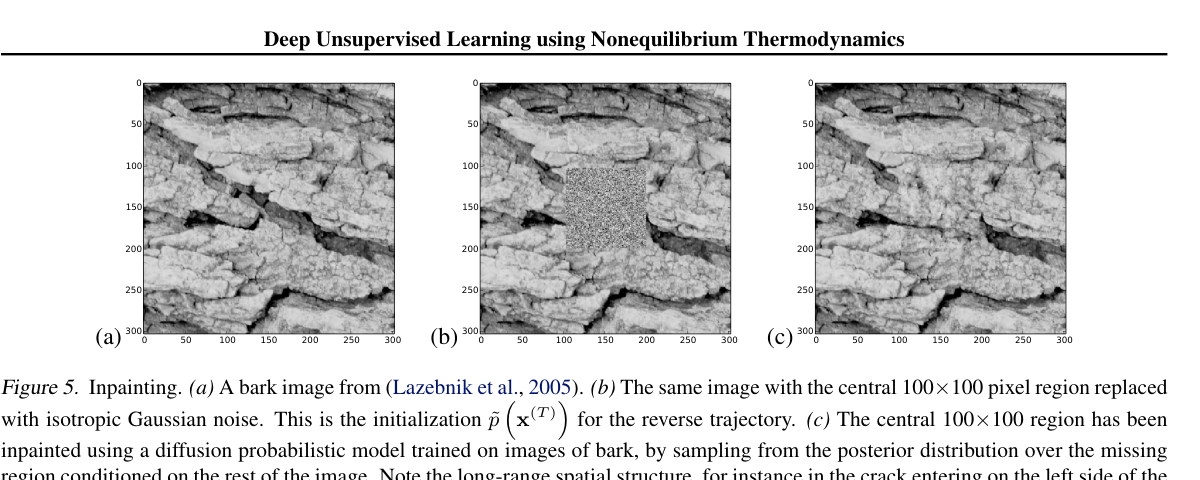
原论文 Figure 5,bark 缺失区域恢复
Figure 5(原论文) 左为 bark 原图,中为中央区域替换成 Gaussian 噪声,右为受周边已知像素约束的 posterior sample。长裂纹跨越边界延续,展示模型利用远程结构。
约束采样的近似边界。 delta constraint 可与 Gaussian 或 binomial 单步核闭式相乘;一般平滑 \(r\) 依赖局部一阶近似。论文没有报告 conditional likelihood、多个 posterior samples 的覆盖率或缺失率曲线。
06 · Experiments

完整结果、数据设置与比较口径

Table 1 · Holdout lower bound

Dataset\(K\)\(K-L_{\mathrm{null}}\)说明
Swiss Roll2.35 bits6.45 bits二维连续分布
Binary Heartbeat−2.414 bits/sequence12.024 bits/sequence真实过程为 −2.322 bits/sequence
Bark−0.55 bits/pixel1.5 bits/pixelT01–T04 bark texture
Dead Leaves1.489 bits/pixel3.536 bits/pixel同 Theis et al. 的 train/test data
CIFAR-105.4 ± 0.2 bits/pixel11.5 ± 0.2 bits/pixel加 uniform noise 去除 8-bit quantization
MNIST见 Table 2 的 Parzen estimate与下界口径不同

\(L_{\mathrm{null}}\) 是单位 Gaussian 或独立 binomial 基线的 log likelihood。除 heartbeat 外,各数据先整体缩放到方差 1。CIFAR-10 的 ± 数值来自论文表格;论文没有说明重复次数与误差统计方式。

Table 2 · 与其他模型比较

DatasetModelLog likelihood评测口径
Dead LeavesMCGSM1.244 bits/pixel相同训练和测试数据
Diffusion1.489 bits/pixel
MNISTStacked CAE174 ± 2.3 bitsGoodfellow et al. 的 Parzen-window code
DBN199 ± 2.9 bits
Deep GSN309 ± 1.6 bits
Diffusion317 ± 2.7 bits
Adversarial net325 ± 2.9 bits
Perfect model349 ± 3.3 bits

“Perfect model”把训练数据样本送入同一个 Parzen estimator,说明该估计器自身存在上限和偏差。MNIST 的 317 bits 低于 adversarial net 的 325 bits,论文表述为 comparable。Dead Leaves 上 Diffusion 提高 0.245 bits/pixel。
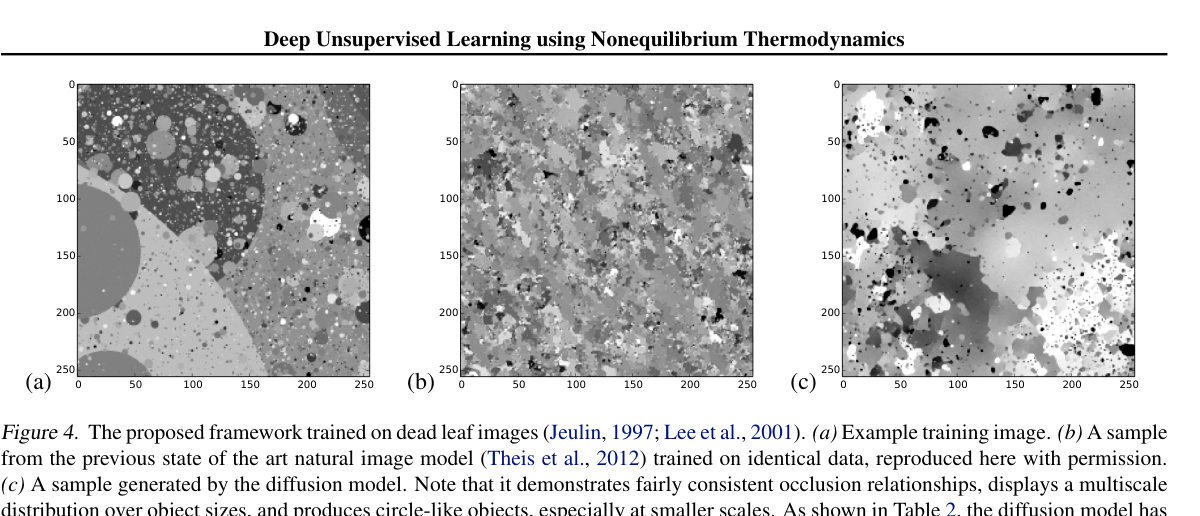
原论文 Figure 4,dead leaves 样本比较
Figure 4(原论文) 训练图、此前 MCGSM 样本与 diffusion 样本。diffusion 样本呈现遮挡关系、跨尺度圆形结构;定量证据来自 Table 2。

数据集与模型配置

数据核 / 步数网络与设置公开缺失项
Swiss rollGaussian / 40归一化 RBF,一层 16 hidden units;各时刻独立 top readout;其余权重在时间与 \(f_{\mu},f_{\Sigma}\) 间共享;diagonal covariance样本量、split、训练步数、学习率
HeartbeatBinomial / 2000长度 20;每 5 格一个 1,初相位均匀;3 层各 50 sigmoid units;每时刻独立 readout;先验均值 0.2样本量、训练时长
MNISTGaussian / 1000Figure D.1 的 dense pathway;Parzen-window 评测已发表实验完整层宽、训练 epoch、bandwidth 选择细节
CIFAR-10Gaussian / 1000multi-scale convolution 与 dense pathway 并行;RMSprop;加入 uniform dequantization noise正文层宽、正式训练 epoch、硬件、耗时
Dead LeavesGaussian / 1000multi-scale convolution;与 MCGSM 使用相同数据生成参数、样本量、层宽、优化超参数
Bark T01–T04Gaussian / 500multi-scale convolution;中央 100×100 inpaintingcrop 数、split、层宽、优化超参数

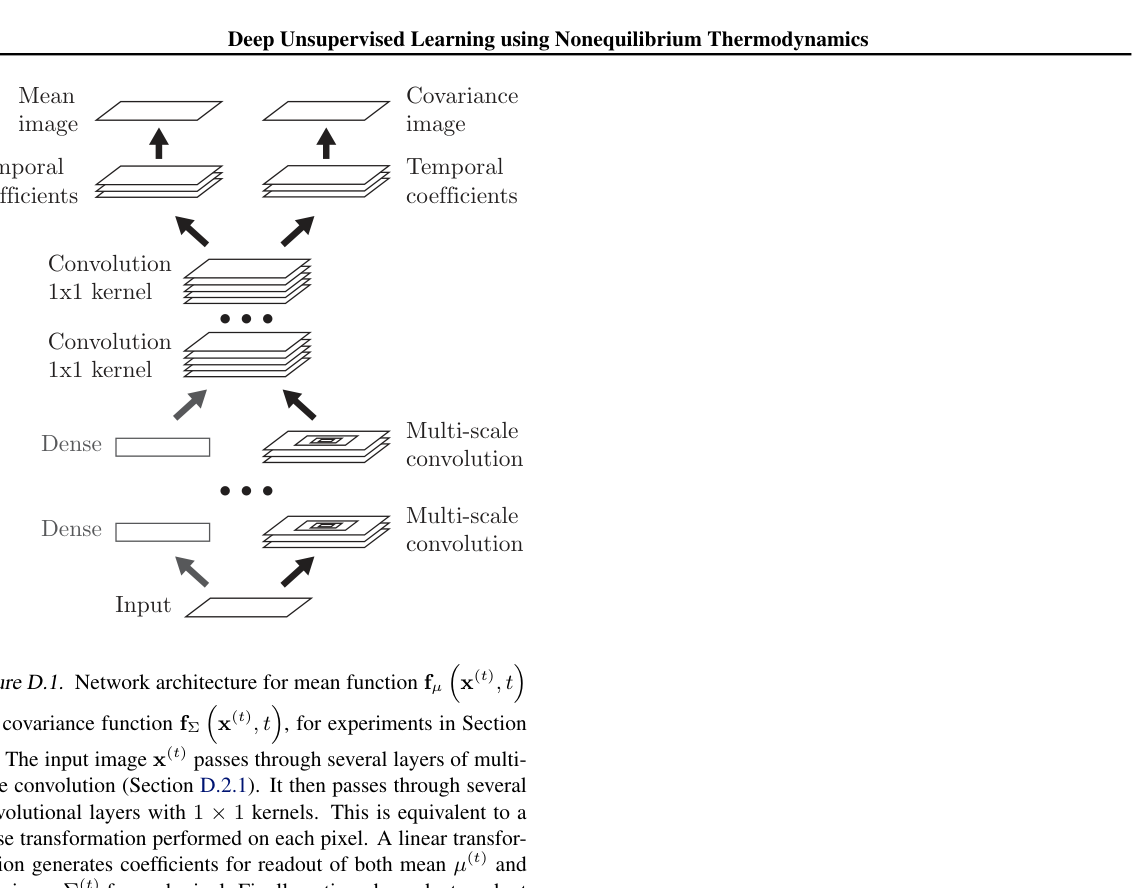
图像网络

\[ z_i^{\mu}=\sum_{j=1}^{J}y_{ij}^{\mu}g_j(t),\qquad g_j(t)=\frac{\exp\!\left(-\frac{(t-\tau_j)^2}{2w^2}\right)} {\sum_{k=1}^{J}\exp\!\left(-\frac{(t-\tau_k)^2}{2w^2}\right)}, \] \[ \Sigma_{ii}=\sigma\!\left(z_i^{\Sigma}+\sigma^{-1}(\beta_t)\right), \qquad \mu_i=(x_i-z_i^{\mu})(1-\Sigma_{ii})+z_i^{\mu}. \]
卷积网络为每个像素输出 \(2J\) 个系数,time bump basis 把系数转换为时刻相关的均值与方差参数。variance 通过 sigmoid 限制;\(\Sigma\) 是对角矩阵。multi-scale layer 对多个 2 的幂次尺度做 mean pooling、卷积、上采样求和,再做 softplus;dense 与 1×1 convolution 使用 tanh。
原论文 Figure D.1,图像实验的网络架构
Figure D.1(原论文补充材料) 输入经过 dense 或 multi-scale convolution,再经 1×1 卷积形成 temporal coefficients,最终读出 mean image 与 covariance image。
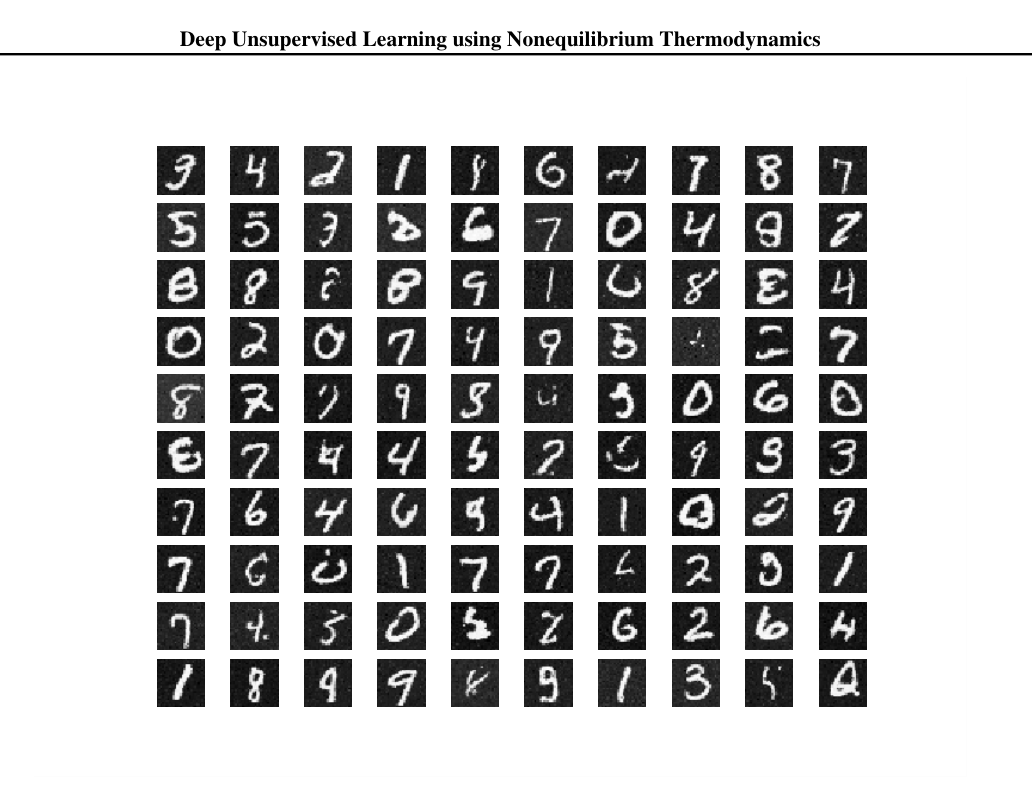
原论文 Figure App.1,MNIST 真实采样
Figure App.1(原论文补充材料) MNIST 样本来自分布抽样,图注特别说明它们不是 Gaussian 或 binomial mean。
没有组件消融表。 论文提供多数据集、baseline 与 qualitative posterior demonstrations,没有逐项移除 learned variance、learned schedule、multi-scale path 或时间基函数的 ablation。实验只能证明完整系统在这些任务上的表现。
07 · Paper versus implementation

官方仓库提供参考实现,无法逐数值复现发表结果

参考代码默认值

  • trajectory length 1000,temporal basis 10,step-1 variance 0.001。
  • batch size 512,初始学习率 \(10^{-3}\),RMSprop,500 batches/epoch。
  • 学习率函数衰减至 \(10^{-5}\);上限 100001 epochs;每 25 epochs 评测、保存和出图。
  • 输入用一个 minibatch 估计均值与方差后标准化,并加入 \(1/255\) 对应的 uniform dequantization noise。

README 的已展示训练

  • MNIST 示例在 825 epochs 后展示。
  • CIFAR-10 示例在 1700 epochs 后展示,batch 200;dense lower 1000、输出每像素 5;conv hidden 100、6 层;dense lower 6 层;dense upper 4 层、hidden 100。
  • README 没有声明这些 checkpoint 对应论文 Table 1 的最终数值。
方面论文实验官方公开仓库
代码身份原始研究代码作者明确称为 refactoring;原始代码按邮件请求提供
优化器多数实验 SFO;CIFAR-10 为 RMSprop统一 RMSprop
激活函数convolution softplus,dense tanhleaky ReLU,负半轴斜率 0.05
逆均值参数化附录式 (65) 描述 equilibrium-mean 形式围绕 forward mean 的 perturbation 参数化
依赖Theano;正文未锁定版本旧版 Blocks、Fuel、Theano;README 要求 2015 年 bleeding-edge Blocks/Fuel
硬件与耗时未公开未公开
复现结论。 仓库源码与 README 足以核查算法结构、配置入口及作者展示的 MNIST/CIFAR-10 训练命令。本次没有安装旧版 Blocks、Fuel、Theano,也没有执行训练,因此不声称当前环境能够运行该仓库。发表论文全部六个数据集的原始训练配置、硬件、随机种子、正式 checkpoint 和原始实验代码没有完整公开。
08 · Reviewer commentary

证据支持什么,仍缺少什么

Paper verified论文推导了有限 Markov path 的似然下界,并在 Gaussian 与 Bernoulli 核上给出解析训练目标;Dead Leaves 的 holdout likelihood 超过 MCGSM;heartbeat 接近真实生成分布;图像上演示无条件采样、去噪与缺失区域恢复。
Author claim作者称框架能够拟合任意数据分布,并且概率可以廉价求值。该说法依赖足够小的步骤、足够强的逆向回归器与 path estimator 方差;有限网络和有限 \(T\) 下没有普适逼近定理或规模实验。
Our interpretation最持久的贡献是把 density learning 分解成一系列 tractable denoising posterior matching 问题,并把全路径 likelihood 连接到负 KL 的望远镜分解。Gaussian 与 binomial 并列说明思想作用于连续和离散状态。
Research extension可以学习更低方差的路径估计器、把约束 posterior 写成系统化 guidance、用自适应步长分配计算预算、加入执行结果反馈修复离散结构,并为 missing-data posterior 评测 calibration 与 mode coverage。

Strengths

  • 模型定义、采样链、概率下界与条件推理属于同一数学体系。
  • 完整推导覆盖 path ratio、KL、entropy 与 perturbed kernel。
  • Gaussian 与 binomial 核展示表示范围。
  • Table 1 同时报告绝对 bound 与对简单基线的增益。

Weaknesses

  • 生成需要 500–2000 次网络求值,成本随步数线性增加。
  • CIFAR-10 likelihood 较早版本受 8-bit quantization 影响,v8 才加入 dequantization 修正。
  • MNIST 采用 Parzen estimate,无法与训练 bound 直接比较。
  • 训练配置、硬件与耗时缺失,官方仓库又是不同参数化的重构实现。
  • posterior demonstrations 缺少定量评测与多样性分析。

进一步可检验问题

09 · Sources

一手资料与身份核查

  1. PMLR 正式记录:ICML 2015,PMLR 37:2256–2265,会议日期 2015 年 7 月 7–9 日。
  2. PMLR 正文 PDF:正式会议版本共 10 页,含正文与参考文献。
  3. PMLR Supplement:7 页附录 A–D。
  4. arXiv:1503.03585v8:2015-11-18 的 18 页合订版本,作者顺序与 PMLR 一致。
  5. 作者官方参考实现:核查 commit de92b574f9daa730e7db242c4db3137e4a65489a 的 README、train.py、model.py 与 regression.py。
作者与机构。 PDF 首页列出 Jascha Sohl-Dickstein 的第一项机构为 Stanford University;Eric A. Weiss 为 University of California, Berkeley;Niru Maheswaranathan 与 Surya Ganguli 为 Stanford University。正文、PMLR 页面与 arXiv 均未显示通讯作者标记,因此 Surya Ganguli 仅按末位作者规则记录为通讯候选,状态为 unverified。
页数与排版。 本地 arXiv v8 合订 PDF 共 18 页:正文与参考文献位于第 1–11 页,其中参考文献从第 9 页下半部开始并延续至第 11 页;Appendix A–D 位于第 12–18 页。PMLR 独立版本把正文与参考文献排成 10 页,并另附 7 页 supplement,因此页码和公式编号无法与 arXiv 合订版逐页映射。本页公式编号以本地 v8 为核查依据。