研究问题:三维表示如何同时保留细节、拓扑与紧凑性
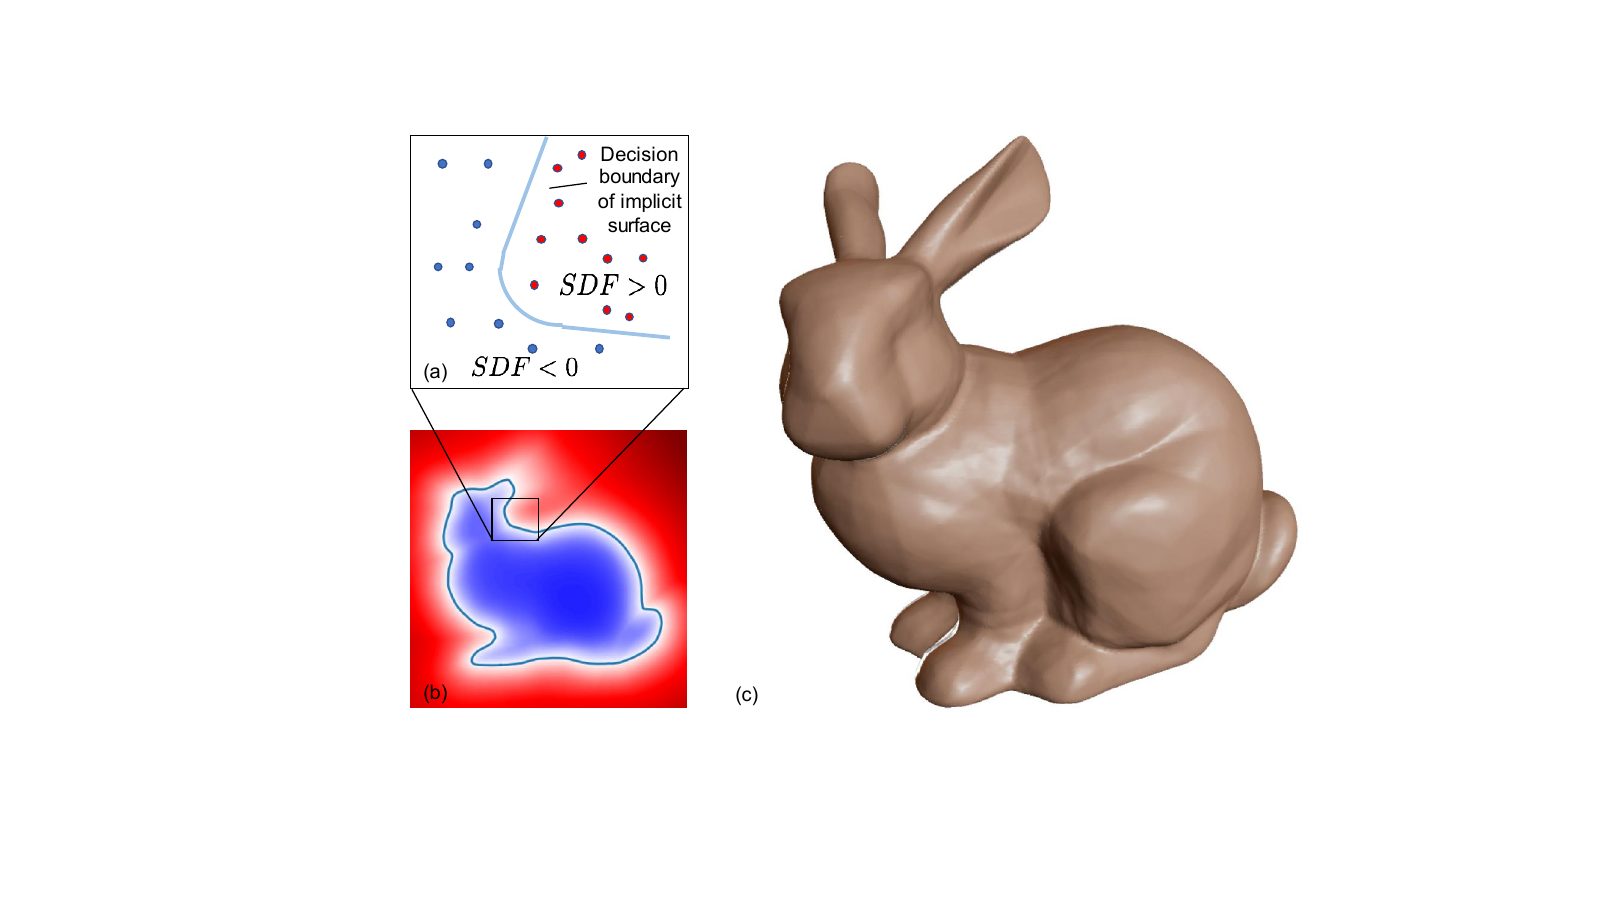
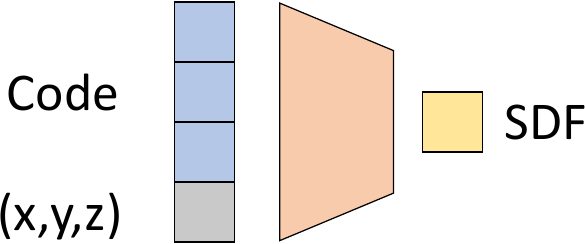
规则体素网格的储存与计算量随分辨率立方增长;点云缺少闭合曲面;固定模板网格难以处理孔洞数量不同的形状。DeepSDF 选择连续 signed distance field,将曲面定义为神经网络输出的零等值面,一个 decoder 通过 latent code 表示同一类别中的许多形状。
查询点 \(\mathbf{x}\in\mathbb{R}^3\) 与形状 latent code \(\mathbf{z}\)。训练数据还包含真实 SDF 值 \(s\)。
\(\tilde{s}=f_{\theta}(\mathbf{z},\mathbf{x})\)。符号区分内外,绝对值近似到表面的距离。
满足 \(f_{\theta}(\mathbf{z},\mathbf{x})=0\) 的点构成形状边界,可用 raycasting 或 Marching Cubes 显式化。
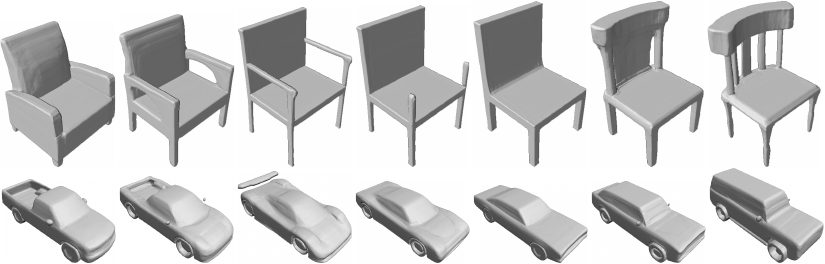
论文在 known-shape representation、unknown-shape reconstruction、partial shape completion 和 latent interpolation 四方面进行实验。Jeong Joon Park 与 Peter Florence 姓名后的 † 只对应“在 Facebook Reality Labs 实习期间完成工作”的脚注,没有共同第一作者或通讯作者含义。
连续 SDF:网络学习空间中的距离场
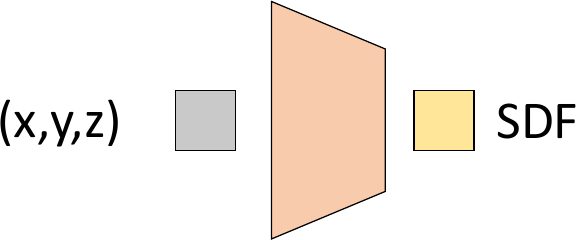
SDF 比 occupancy 多保留距离信息,可用于 sphere tracing 的步长估计,空间导数 \(\partial f_{\theta}/\partial\mathbf{x}\) 可提供法向。论文没有显式 Eikonal 约束,预测场通过监督 samples 逼近 metric SDF。
Auto-decoder:训练时直接学习每个形状的 code
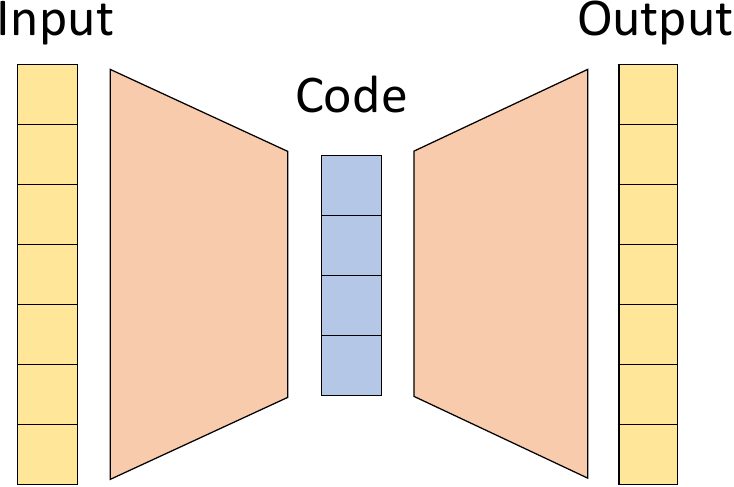
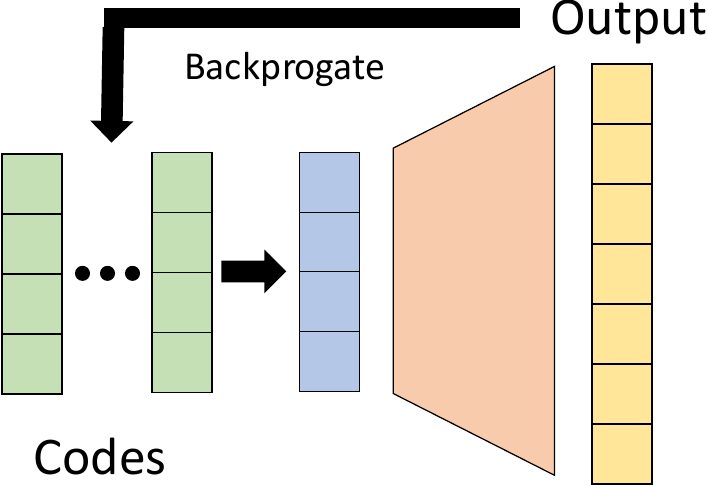
Auto-decoder 把编码变成优化问题,允许测试观测采用任意数量和任意空间分布的 samples;代价是每个新形状都要执行许多次梯度更新,并受初始化与局部最优影响。
数据、网络与训练:复现所需的完整链路
归一化
提取定向表面点
构建 SDF pairs
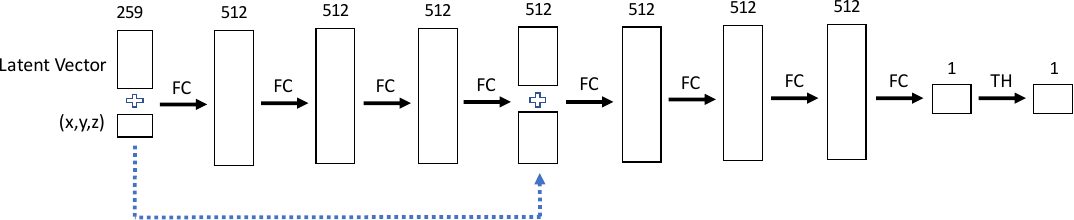
decoder 与 codes
- 每个 mesh 缩放到半径 \(1/1.03\) 的球内;若超过 2% 三角形呈双面可见,论文丢弃该 mesh。
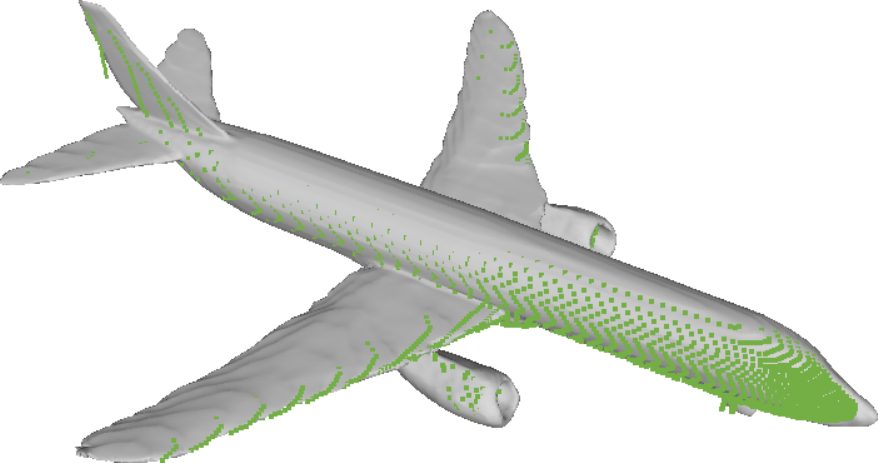
- 按面积采约 250,000 个表面点;每点加入方差 0.0025 与 0.00025 的两种 Gaussian 扰动,生成约 500,000 个近表面 samples;另在单位球内均匀采约 25,000 点。
- KD-tree 给出最近定向表面点;距离给绝对值,法向与位移点积给符号。每个 batch 强制 positive / negative 各占一半。
| 项目 | 论文设置 | 说明 |
|---|---|---|
| Optimizer | Adam | 同时更新 decoder 与训练 shape codes。 |
| Decoder learning rate | \(10^{-5}B\) | \(B\) 为每批 shape 数。 |
| Latent learning rate | \(10^{-3}\) | 直接优化 embedding。 |
| Samples / shape / batch | 16,384 | 正负各半。 |
| Regularization | \(\sigma=10^{-2}\) | 控制 Gaussian code prior。 |
| 训练资源 | 1000 epochs;8 张 Nvidia GPU;约 8 小时 | GPU 型号、精度、随机种子、完整 scheduler 未披露。 |
| 数据版本 | representation 用 ShapeNet v2;completion 用 ShapeNet v1 | completion 跟随 3D-EPN 基准。 |
补充材料训练细节写 \(\mathcal{N}(0,0.01^2)\),完整概率推导段落写 \(\mathcal{N}(0,0.001^2)\)。官方代码默认 0.01,复现时必须记录实际初始化。
测试时推理:固定网络,寻找最合适的形状码
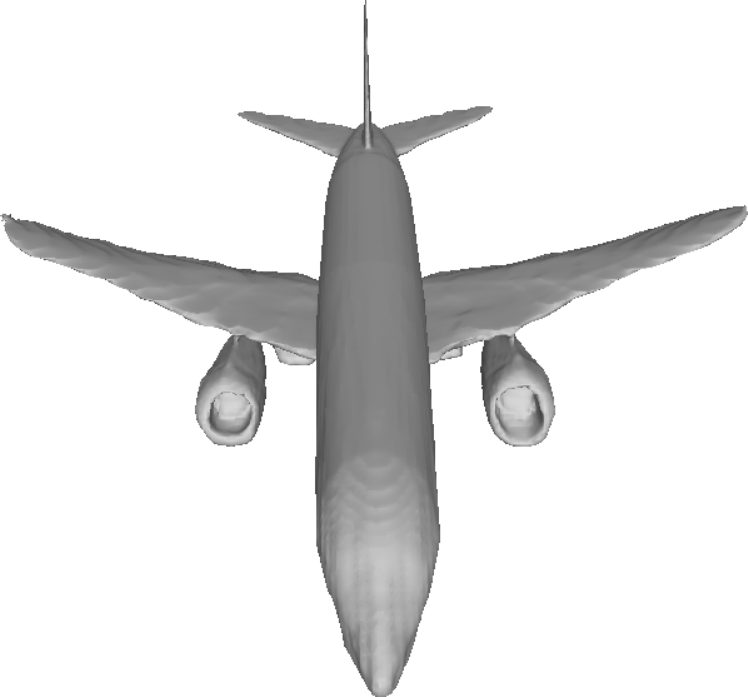
Unknown-shape reconstruction 从 held-out SDF samples 随机初始化 code,以 Adam 优化,再查询空间网格并用 Marching Cubes 提取零等值面。论文定量 mesh 使用 \(512^3\) 网格,Chamfer 使用 30,000 points,EMD 使用 500 points。
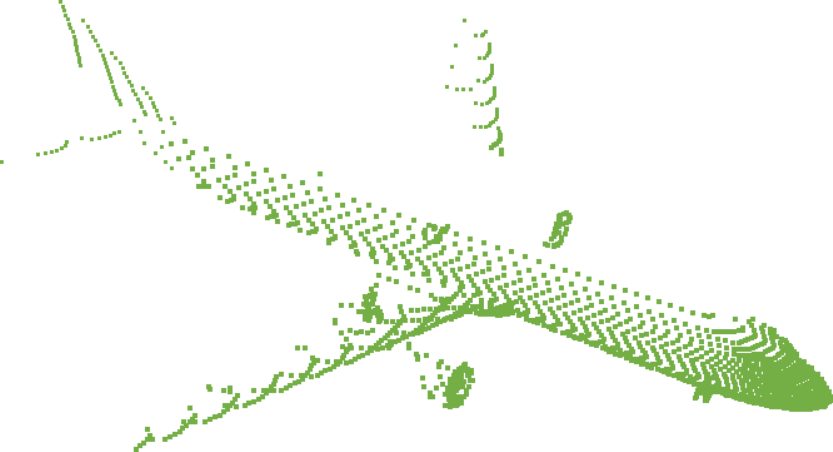
Shape completion 对每个深度点沿估计法向前后取距离 \(\eta\) 的 samples,赋值 \(+\eta\) 与 \(-\eta\)。相机到可见表面之间沿 ray 采 free-space points;若 \(f_{\theta}(\mathbf{z},\mathbf{x}_j)\lt0\),增加 \(\left|f_{\theta}(\mathbf{z},\mathbf{x}_j)\right|\) 损失。论文没有给出 \(\eta\)、每条 ray 的 free-space sample 数、采样间隔、completion 的 optimizer iterations 或 learning rate,因此完整 forward / backward sampling 细节无法从正文与补充材料恢复。
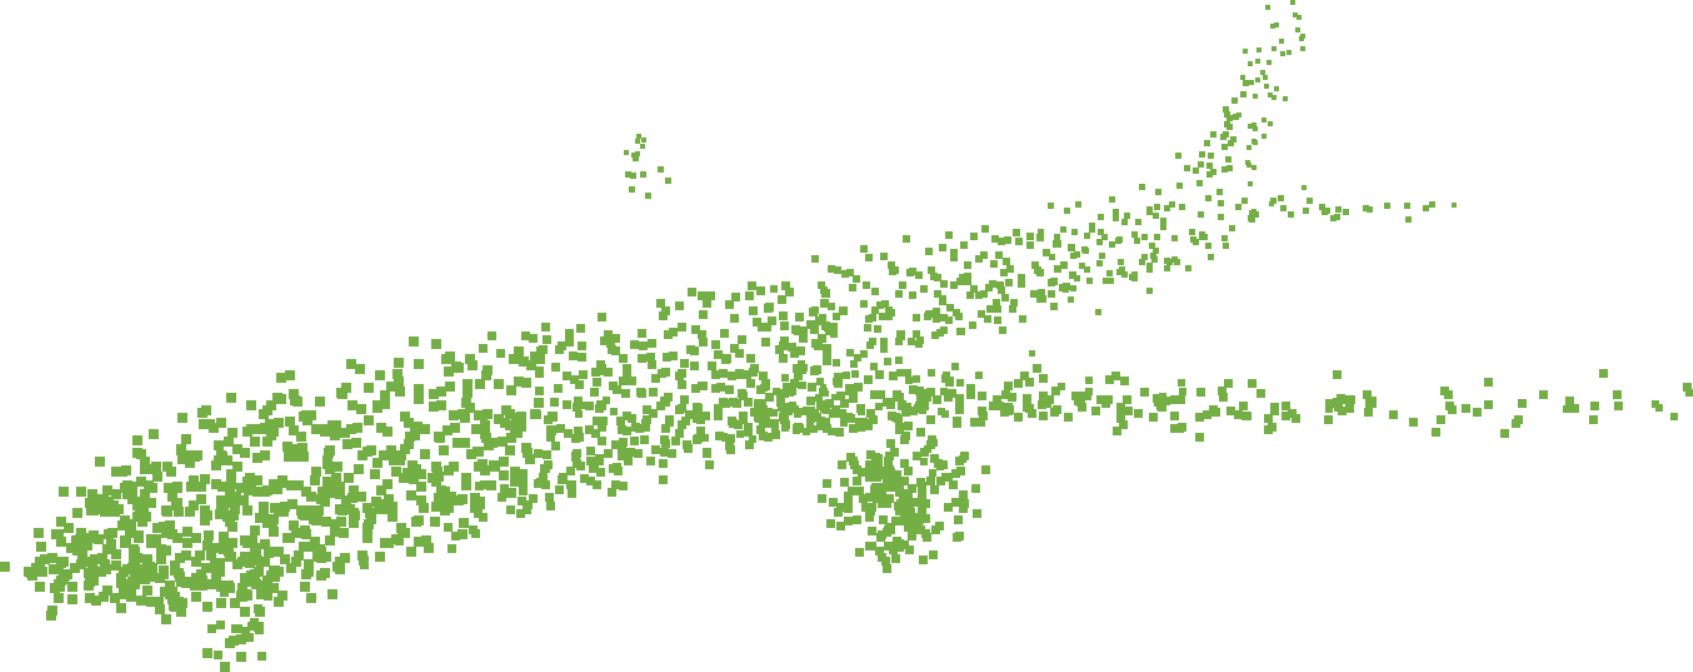
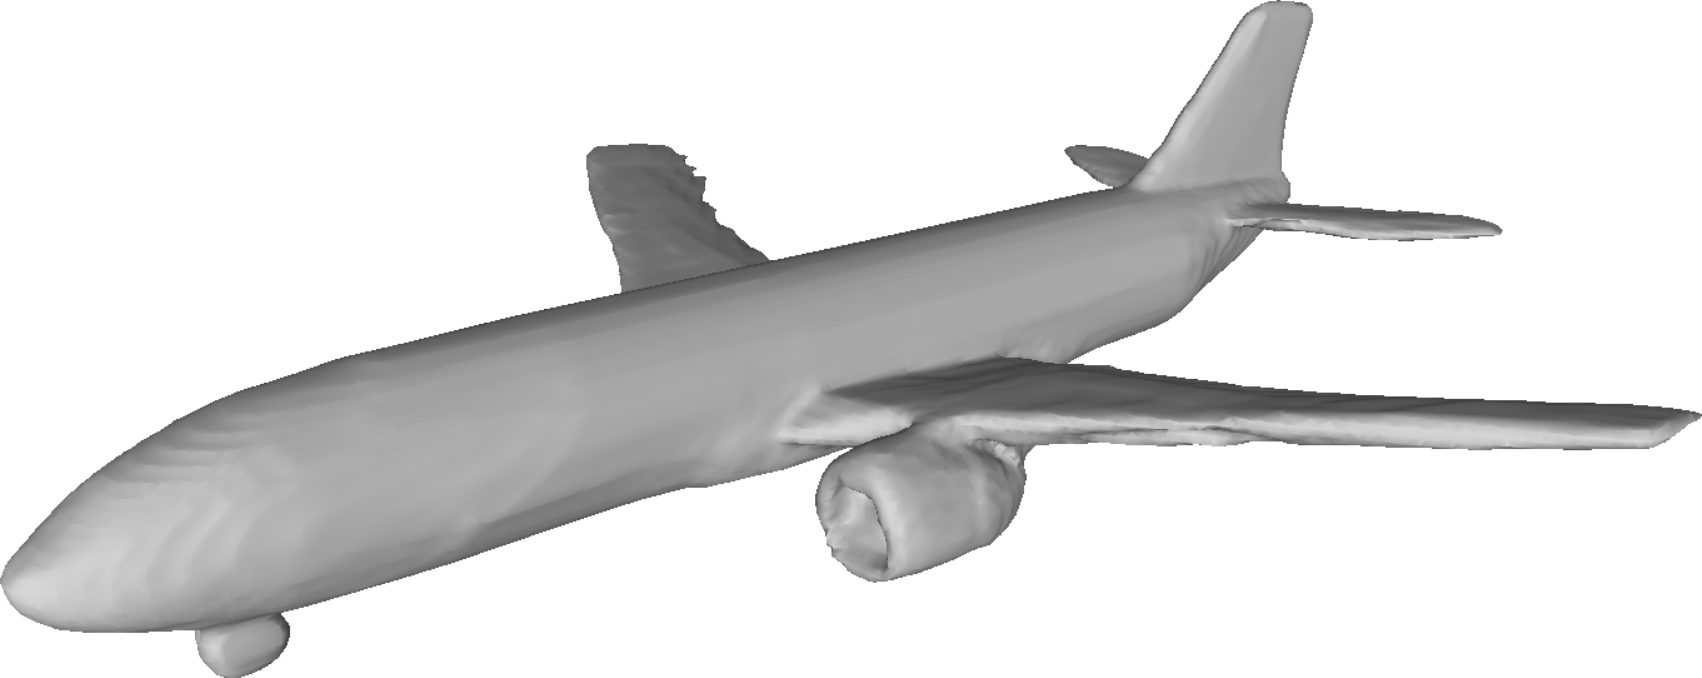
实验结果:五张原表逐项重建
指标定义与单位
Normal cosine similarity 从 ground-truth 表面采 2500 个带法向点,匹配生成 mesh 最近 face。为兼容没有 oriented normals 的 AtlasNet,评测对生成法向及其反向取较高 cosine,即等价于绝对 cosine;范围为 0 到 1。
Table 1 · 表示能力、模型大小与推理
| 方法 | 类型 | 离散化 | 复杂拓扑 | 闭合表面 | 法向 | GB | 秒 | 任务 |
|---|---|---|---|---|---|---|---|---|
| 3D-EPN | Voxel SDF | \(32^3\) | ✓ | ✓ | ✓ | 0.42 | — | C |
| OGN | Octree | \(256^3\) | ✓ | ✓ | 0.54 | 0.32 | K | |
| AtlasNet-Sphere | Parametric mesh | 1 patch | ✓ | 0.015 | 0.01 | K,U | ||
| AtlasNet-25 | Parametric mesh | 25 patches | ✓ | 0.172 | 0.32 | K,U | ||
| DeepSDF | Continuous SDF | none | ✓ | ✓ | ✓ | 0.0074 | 9.72 | K,U,C |
Table 2 · Known cars
| 方法 | CD mean ↓ | CD median ↓ | EMD mean ↓ | EMD median ↓ |
|---|---|---|---|---|
| OGN | 0.167 | 0.127 | 0.043 | 0.042 |
| AtlasNet-Sphere | 0.210 | 0.185 | 0.046 | 0.045 |
| AtlasNet-25 | 0.157 | 0.140 | 0.060 | 0.060 |
| DeepSDF | 0.084 | 0.058 | 0.043 | 0.042 |
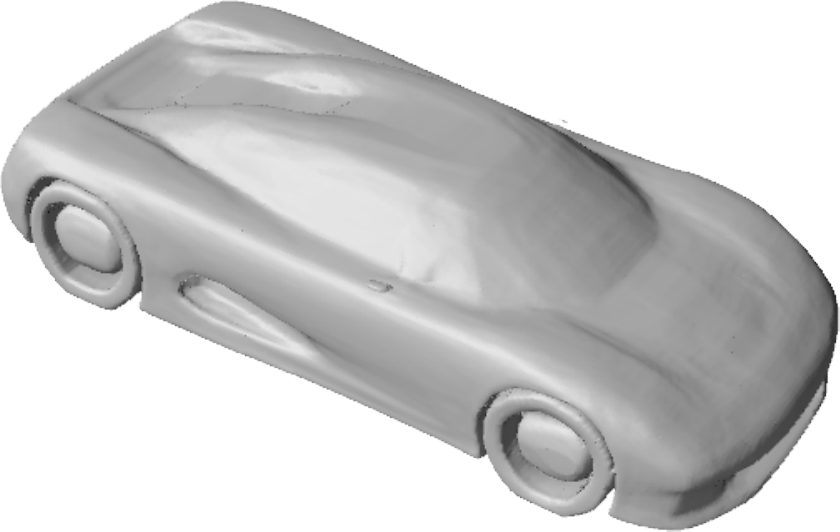
Table 3 · Unknown ShapeNet shapes
| 指标 / 方法 | chair | plane | table | lamp | sofa |
|---|---|---|---|---|---|
| CD mean ↓ | |||||
| AtlasNet-Sph. | 0.752 | 0.188 | 0.725 | 2.381 | 0.445 |
| AtlasNet-25 | 0.368 | 0.216 | 0.328 | 1.182 | 0.411 |
| DeepSDF | 0.204 | 0.143 | 0.553 | 0.832 | 0.132 |
| CD median ↓ | |||||
| AtlasNet-Sph. | 0.511 | 0.079 | 0.389 | 2.180 | 0.330 |
| AtlasNet-25 | 0.276 | 0.065 | 0.195 | 0.993 | 0.311 |
| DeepSDF | 0.072 | 0.036 | 0.068 | 0.219 | 0.088 |
| EMD mean ↓ | |||||
| AtlasNet-Sph. | 0.071 | 0.038 | 0.060 | 0.085 | 0.050 |
| AtlasNet-25 | 0.064 | 0.041 | 0.073 | 0.062 | 0.063 |
| DeepSDF | 0.049 | 0.033 | 0.050 | 0.059 | 0.047 |
| Mesh accuracy mean ↓ | |||||
| AtlasNet-Sph. | 0.033 | 0.013 | 0.032 | 0.054 | 0.017 |
| AtlasNet-25 | 0.018 | 0.013 | 0.014 | 0.042 | 0.017 |
| DeepSDF | 0.009 | 0.004 | 0.012 | 0.013 | 0.004 |
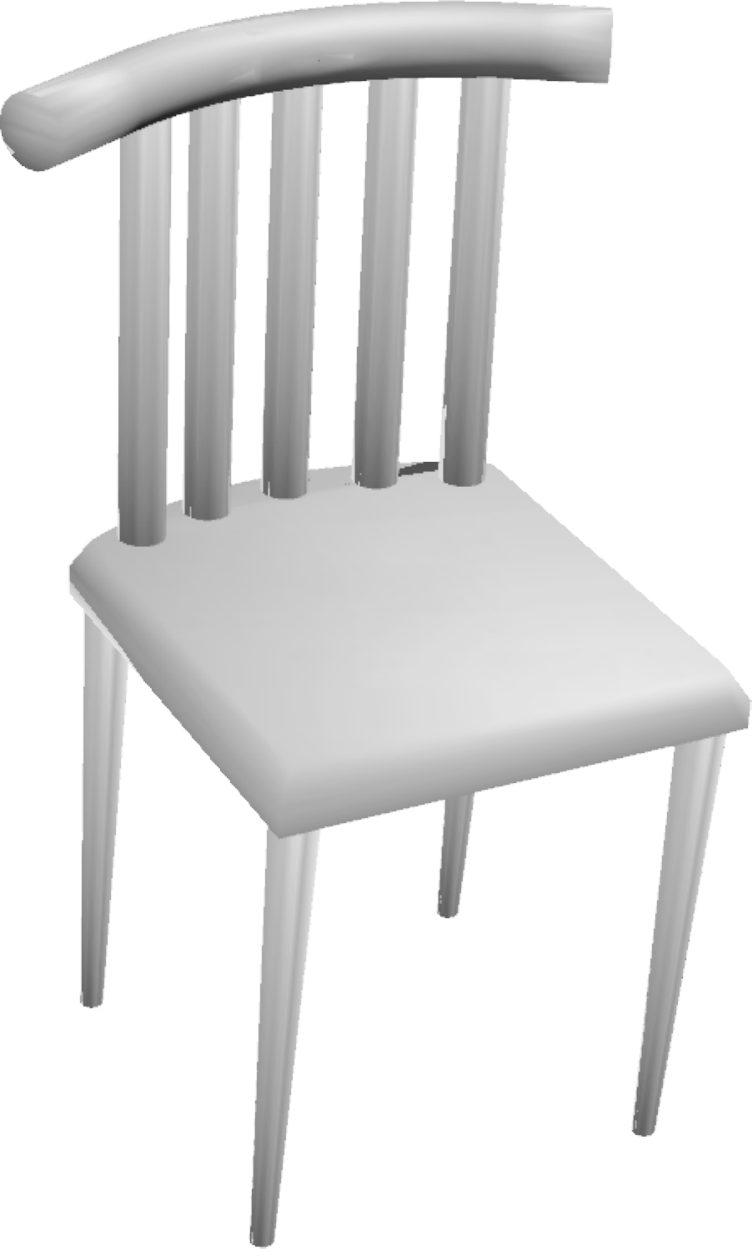
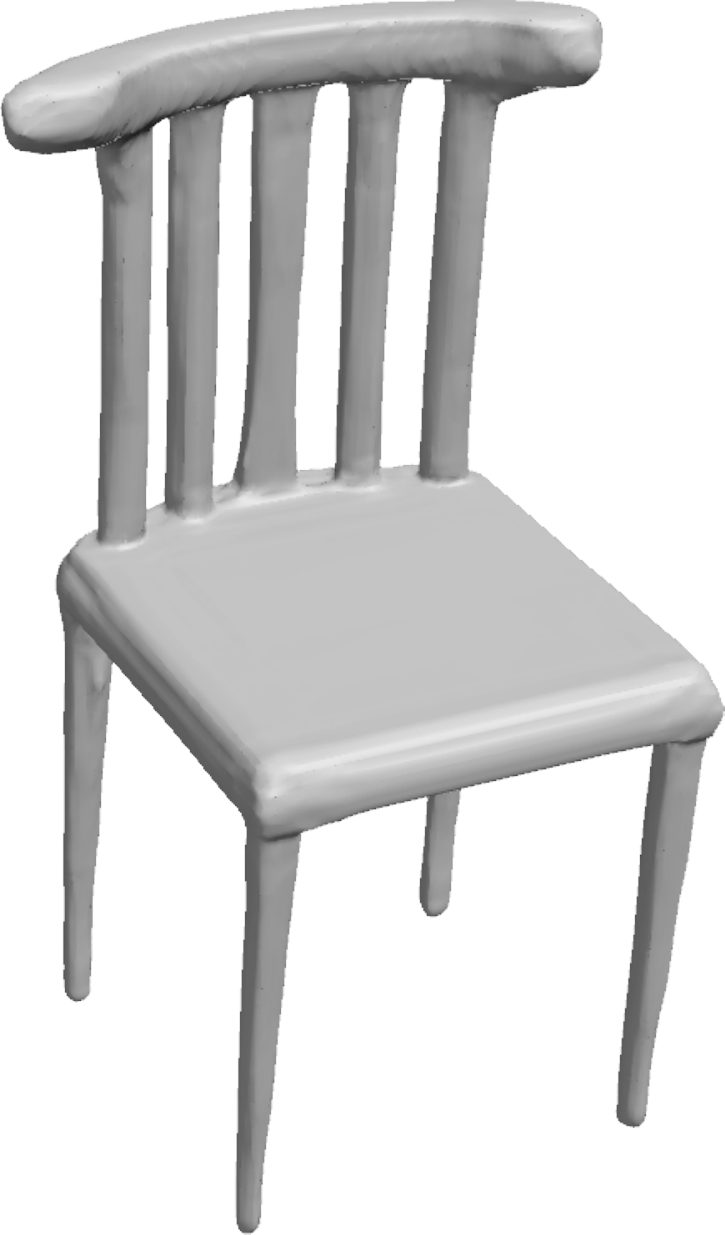
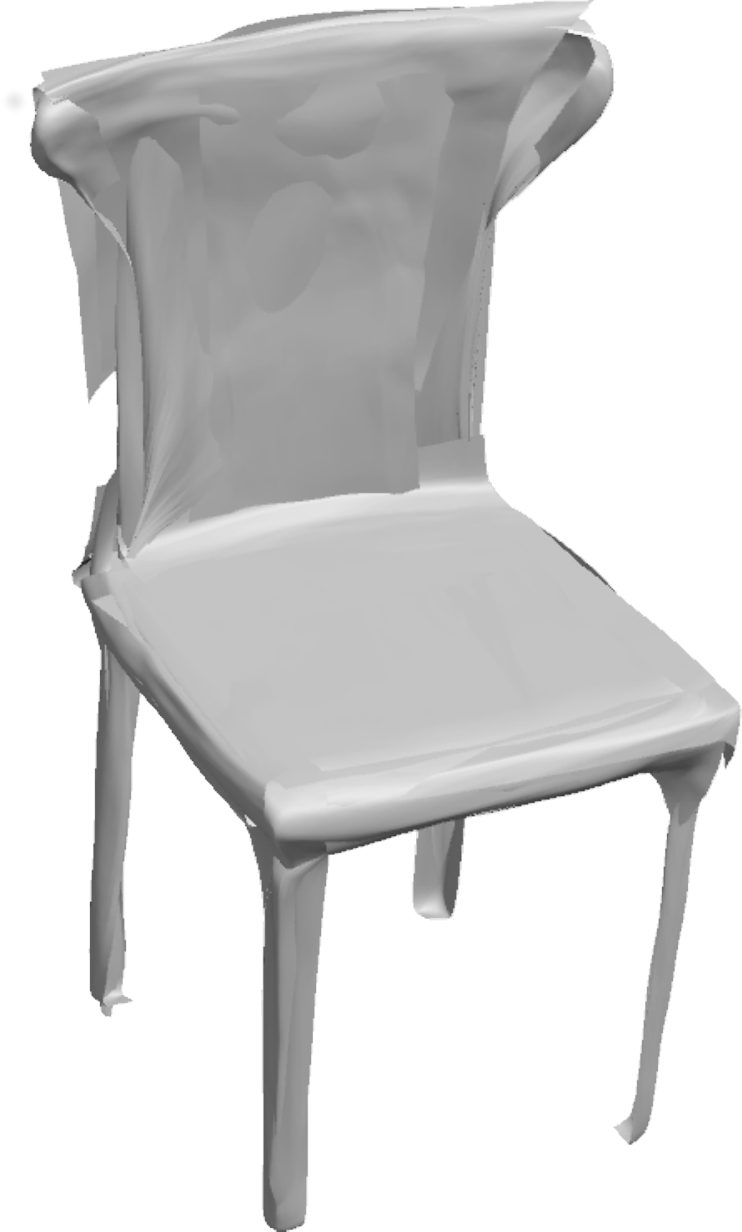
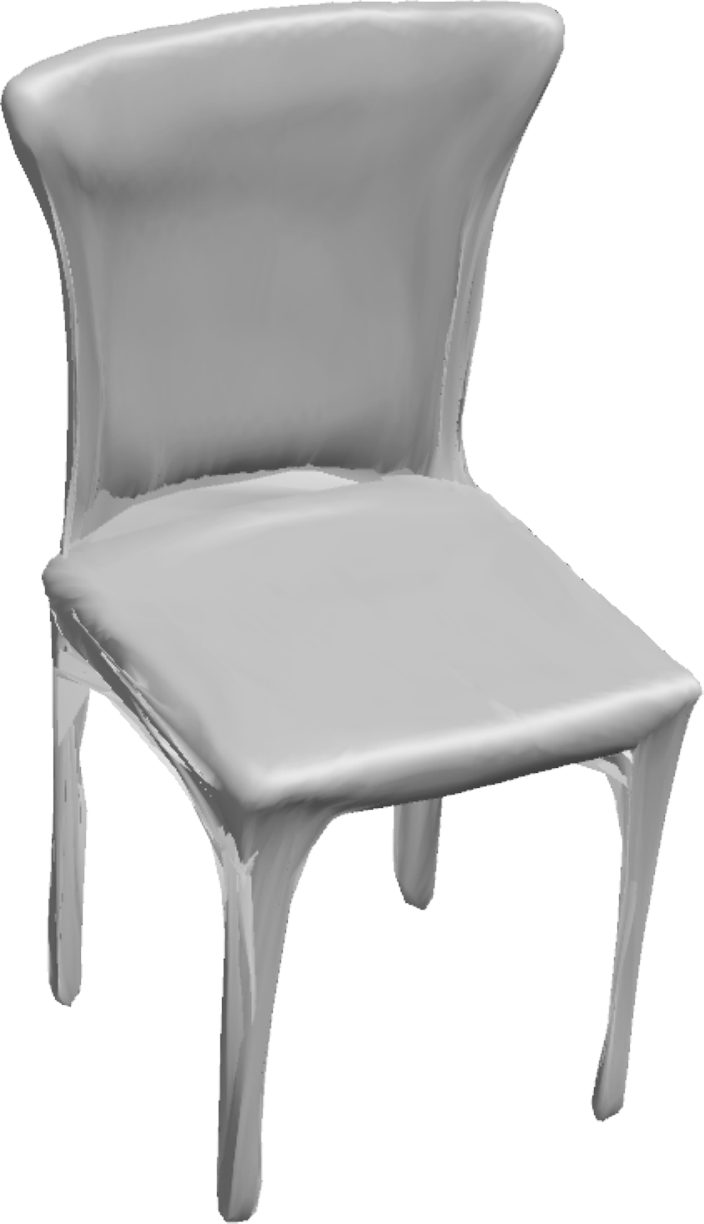
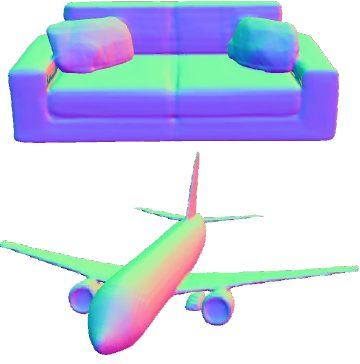
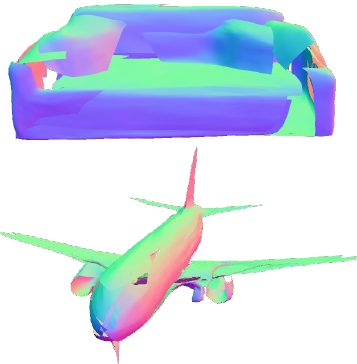
Table 4 · Single-view completion
| 类别 | 方法 | CD med. ↓ | CD mean ↓ | EMD ↓ | Mesh acc. ↓ | Mesh comp. ↑ | Cos sim. ↑ |
|---|---|---|---|---|---|---|---|
| chair | 3D-EPN | 2.25 | 2.83 | 0.084 | 0.059 | 0.209 | 0.752 |
| DeepSDF | 1.28 | 2.11 | 0.071 | 0.049 | 0.500 | 0.766 | |
| plane | 3D-EPN | 1.63 | 2.19 | 0.063 | 0.040 | 0.165 | 0.710 |
| DeepSDF | 0.37 | 1.16 | 0.049 | 0.032 | 0.722 | 0.823 | |
| sofa | 3D-EPN | 2.03 | 2.18 | 0.071 | 0.049 | 0.254 | 0.742 |
| DeepSDF | 0.82 | 1.59 | 0.059 | 0.041 | 0.541 | 0.810 |
Table 5 · Unknown shapes 的完整度与法向
| 指标 / 方法 | chair | plane | table | lamp | sofa |
|---|---|---|---|---|---|
| Mesh completion mean ↑ | |||||
| AtlasNet-Sph. | 0.668 | 0.862 | 0.755 | 0.281 | 0.641 |
| AtlasNet-25 | 0.723 | 0.887 | 0.785 | 0.528 | 0.681 |
| DeepSDF | 0.947 | 0.943 | 0.959 | 0.877 | 0.931 |
| Mesh completion median ↑ | |||||
| AtlasNet-Sph. | 0.686 | 0.930 | 0.795 | 0.257 | 0.666 |
| AtlasNet-25 | 0.736 | 0.944 | 0.825 | 0.533 | 0.702 |
| DeepSDF | 0.970 | 0.970 | 0.982 | 0.930 | 0.941 |
| Cosine similarity mean ↑ | |||||
| AtlasNet-Sph. | 0.790 | 0.840 | 0.826 | 0.719 | 0.847 |
| AtlasNet-25 | 0.797 | 0.858 | 0.835 | 0.725 | 0.826 |
| DeepSDF | 0.896 | 0.907 | 0.916 | 0.862 | 0.917 |
DeepSDF 在 Table 3 的 20 个 lower-is-better 单元中获得 19 个最优,仅 table 类 CD mean 由 AtlasNet-25 更低。Table 5 的 15 个 higher-is-better 单元全部最优。
附录实验:哪些设计选择得到支持
Depth 与 skip input
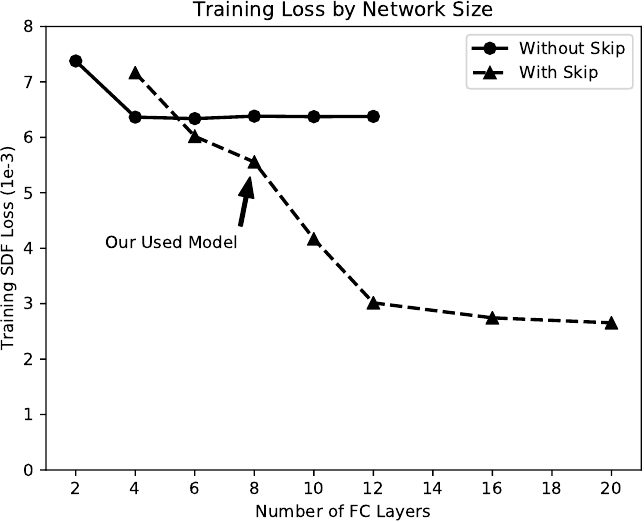
500 个 chair 的 memorization 实验显示,无 skip 时约 4 层后训练误差饱和;每隔 4 层重新拼接输入后,误差随深度继续下降。测试误差从 4 层约 9.7 降到 8 层约 5.7,随后趋于平缓。
Truncation distance
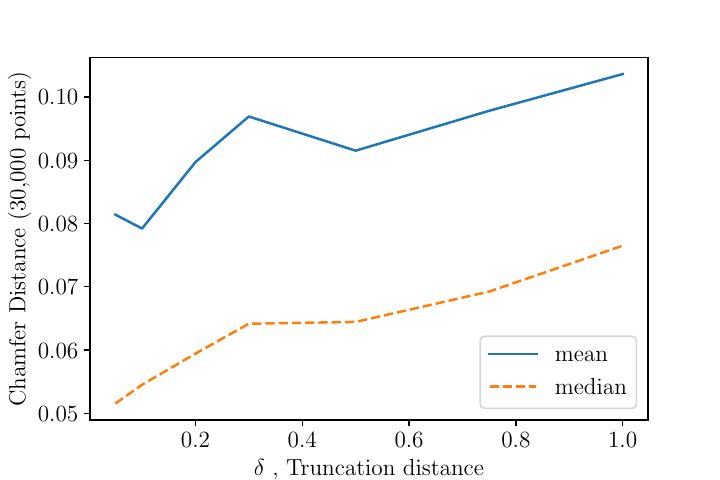
100 个 known cars 上,\(\delta\) 从 0.05 增到 1.0 时 Chamfer 适度升高。较小值把容量集中于零等值面,较大值覆盖更宽 SDF 域。
MNIST 对照让 AE、VAE、AD 的 decoder 结构一致,并比较 2、5、15 维 latent spaces。AE 的随机 samples 常出现伪影,decoder-only optimization 会发散;AD 在全部维度均可通过优化找到测试 code。15 维 VAE decode 的数值 test error 略低,作者报告 AD 的重建视觉更接近目标数字。
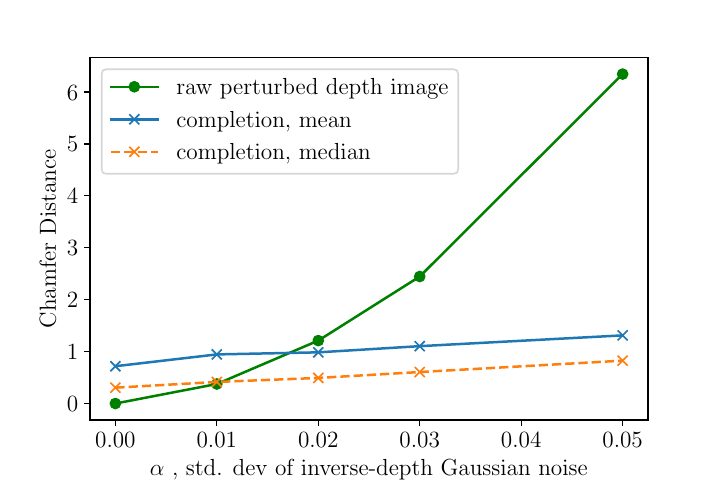
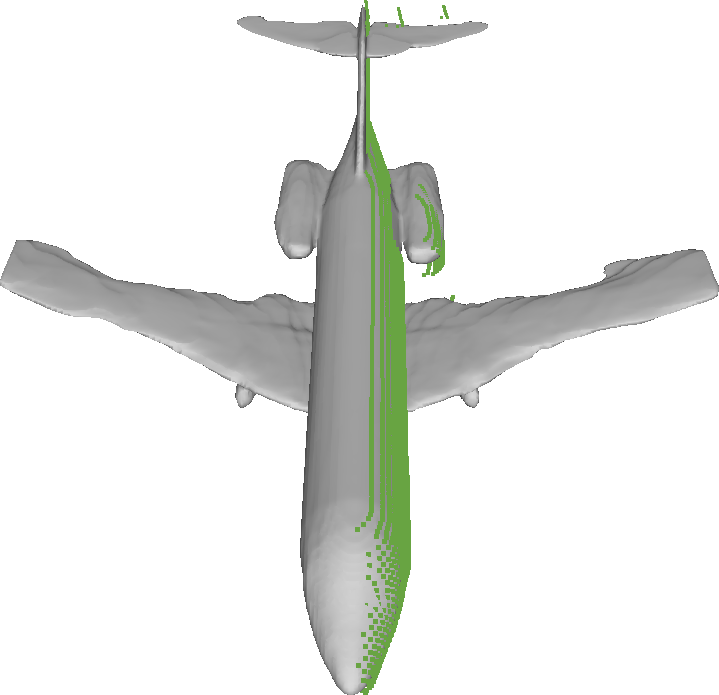
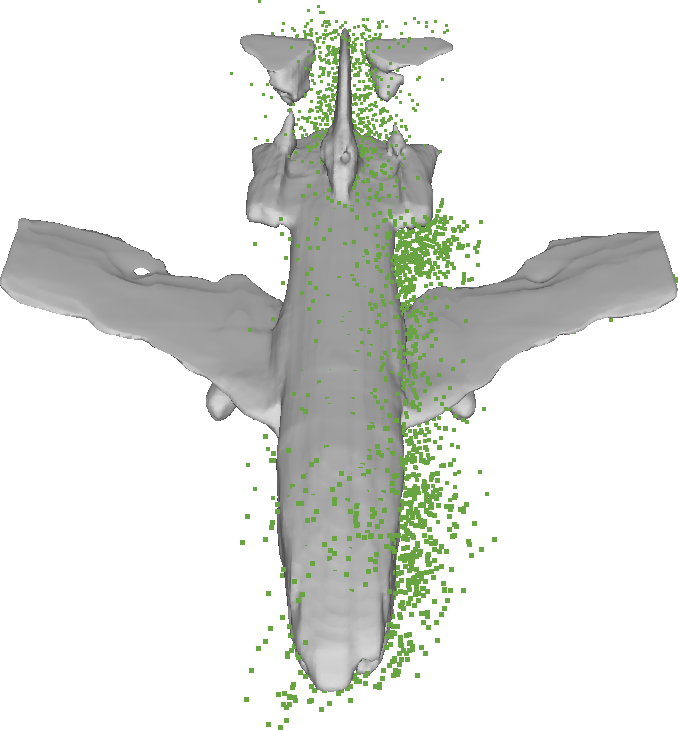
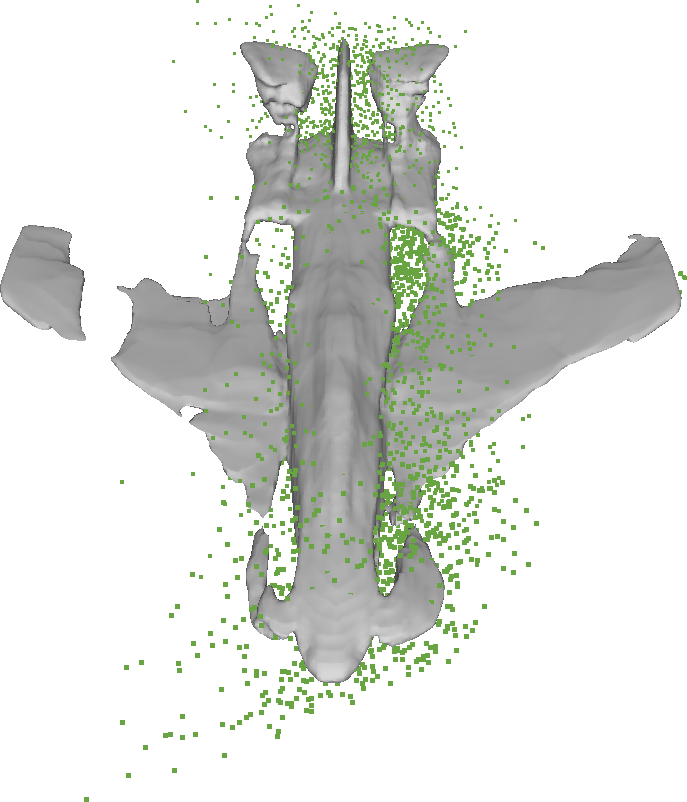
Figure 1 的平滑插值与 MNIST 对照被用来支持 latent space 平滑、完整。三维 latent distribution 的覆盖率没有独立测量,因此该结论的证据仍有限。
Paper vs. Implementation:官方仓库复现审计
核查对象为 Meta Research 官方归档仓库 commit 48c19b8d49ed5293da4edd7da8c3941444bc5cd7。仓库于 2023 年 10 月归档为只读。
| 项目 | 论文 | 官方代码 | 复现影响 |
|---|---|---|---|
| 训练 epochs | 1000 | 示例 specs 为 2001 | 发布配置属于后续复现配置。 |
| Decoder LR | \(10^{-5}B\) | batch 64,初始 0.0005,每 500 epochs 乘 0.5 | 论文公式对应 0.00064。 |
| 输出激活 | 末层 tanh | 最终始终执行 tanh;specs 的 use_tanh 为 false | 最终行为符合论文,配置名容易误导。 |
| Code regularization | \(\lVert\mathbf{z}\rVert_2^2/\sigma^2\) | 求 sample-expanded code 的 \(\lVert\mathbf{z}\rVert_2\),乘 1e-4,前 100 epochs warm up | 实现形式与论文 squared norm 有差异。 |
| Test reconstruction | MAP;定量 mesh \(512^3\) | 800 iterations、每步 8000 samples、LR 5e-3 半程降 10 倍、mesh \(256^3\) | 复现表格需提高 resolution。 |
| Table 3 selection | chair / plane 各重建两次,保留 Chamfer 较低者 | README 明确发布流程未实现 | 该选择使用 ground truth metric。 |
| Shape completion | 正文核心实验 | README 明确当前 release 没有 completion code | Table 4 与 Figure 8–11 无法完整重跑。 |
| 公开 splits | ShapeNet 五类 | chair 3281/832;plane 1780/456;table 4859/1216;lamp 897/213;sofa 1628/411 | completion 的 v1 / 3D-EPN 流程缺失。 |
latent ~ N(0, 0.01²)
repeat 800 iterations:
    sample 8000 balanced positive / negative SDF points
    clamp prediction and target to [-0.1, 0.1]
    loss = L1 + 1e-4 * mean(latent²)
    Adam updates latent only; LR 5e-3 becomes 5e-4 halfway
query a 256³ grid and extract level 0 with Marching Cubes
本页面核对论文、补充材料、arXiv 源文件与官方代码,没有下载 ShapeNet 或重跑训练。训练 GPU 型号、随机种子、混合精度、完整 completion 脚本和论文 checkpoint 均未公开。
Reviewer commentary
Strengths
- 连续 implicit representation 避免固定 voxel resolution,能表达孔洞、薄结构与闭合表面。
- Auto-decoder 把稀疏、部分观测统一进 latent MAP objective。
- 实验覆盖 representation、completion、interpolation、noise、network depth、truncation、AE/VAE 对照与多种几何指标。
- Table 3 与 Table 5 显示跨五类 ShapeNet 的广泛优势。
Weaknesses
- 每个测试形状都需迭代优化 code,9.72 秒显著慢于 AtlasNet。
- canonical pose 是强假设,真实场景还需估计 SE(3)。
- Table 3 的 oracle-of-two 选择依赖 ground truth。
- 公开仓库缺失 completion,核心结果无法完整重跑。
- 单个全局 code 面对多物体场景和局部高频细节时扩展能力有限。
- Paper Verified
- 标准化 ShapeNet mesh 或 canonical-view partial depth 下,DeepSDF 在指定评测获得强 reconstruction / completion 数值。
- Author Claim
- 插值与 MNIST 对照支持 latent space 平滑、完整;三维 coverage 没有独立测量。
- Our Interpretation
- 长期影响来自“坐标输入的连续神经场 + test-time latent optimization”的组合。
- Unresolved
- regularization、epochs、learning rate、mesh resolution 与评测选择需要复现者明确固定版本。
面向 procedural material 或结构化资产,可把全局 code 拆成可组合局部 codes,并让 renderer feedback 参与 test-time optimization;同时预测 validity 与 uncertainty,使结果兼顾可执行、可编辑和多视角一致。这属于研究设想,论文没有验证。
一手来源
- CVPR 2019 Open Access 正式页面,pp. 165–174,DOI 10.1109/CVPR.2019.00025,含 PDF、supplement 与视频。
- arXiv:1901.05103v1,19 页正文与补充材料合订本;本页面还核对原始 TeX 与 Figure 文件。
- Meta Research 官方 DeepSDF 仓库,commit 48c19b8d49ed5293da4edd7da8c3941444bc5cd7。
- ShapeNet,主要数据来源。
- 3D-EPN,completion baseline 与 split 来源。