纯 RL 的关键实验
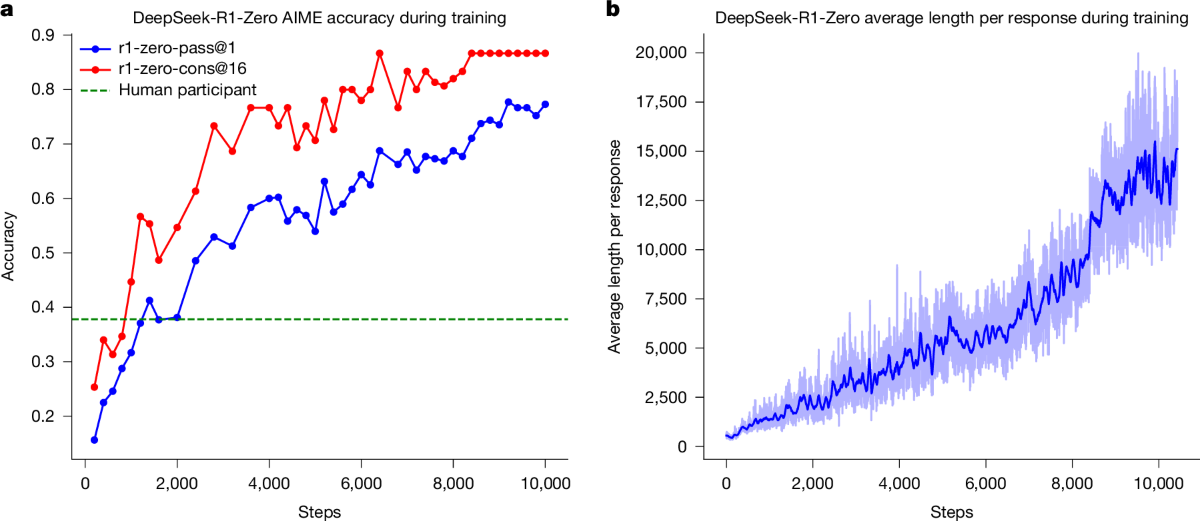
DeepSeek-R1-Zero 从 DeepSeek-V3-Base 直接开始 GRPO,没有预先使用推理轨迹 SFT。规则奖励只检查最终答案正确性与输出格式。AIME 2024 pass@1 从 15.6% 增至 77.9%,cons@16 达到 86.7%。
一份覆盖 Nature 正式文、Methods、Extended Data、83 页 Supplementary Information、同行评议、arXiv v2 与官方仓库的技术精读。核心问题是:只根据最终结果给奖励,671B MoE 模型能否自己发展出长链推理、检查与改写策略?
DeepSeek-R1-Zero 从 DeepSeek-V3-Base 直接开始 GRPO,没有预先使用推理轨迹 SFT。规则奖励只检查最终答案正确性与输出格式。AIME 2024 pass@1 从 15.6% 增至 77.9%,cons@16 达到 86.7%。
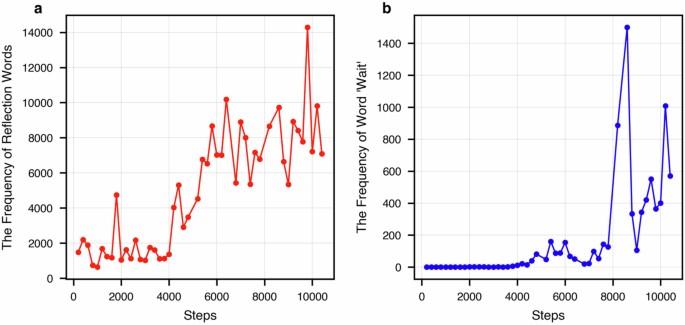
作者把回答长度增长、反思词频增加与策略切换解释为推理行为的自我演化。Extended Data Fig. 1 证明词频随训练变化,仍不能单独证明内部认知机制。
训练信号奖励可验证结果;策略梯度扩大同题组内高奖励轨迹的概率。长回答、复核与重试是优化后的行为模式,证据支持“有效策略形成”,对意识或类人思维没有证明力。
把材质图编译成功、拓扑合法、渲染相似度和可编辑性组合成可验证奖励,再以同一条件下多个候选图的组内相对优势训练生成器。关键研究点包括 verifier 校准、长图结构的 token credit assignment、执行成本和 reward hacking。
正式标题:DeepSeek-R1 incentivizes reasoning in LLMs through reinforcement learning。2025-09-17 在线发表,Nature 645,633–638,DOI 10.1038/s41586-025-09422-z。主文 PDF 11 页,补充信息 83 页,另有 64 页同行评议文件。
主文使用 Table 1–2、Fig. 1–2、Extended Data Fig. 1–2 与 Extended Data Table 1;补充信息使用 Supplementary Tables 1–29 与 Figs. 1–16。正式 Methods 已完整披露 R1-Zero 的 32,768→65,536 token 长度课程、10,400 步和约 1.6 epochs。
2026-01-04 更新,标题为 DeepSeek-R1: Incentivizing Reasoning Capability in LLMs via Reinforcement Learning,本地 PDF 为 86 页。作者署名采用 DeepSeek-AI 集体名称,正文和扩展材料合并为单一文件,并重新编号表格与图片。
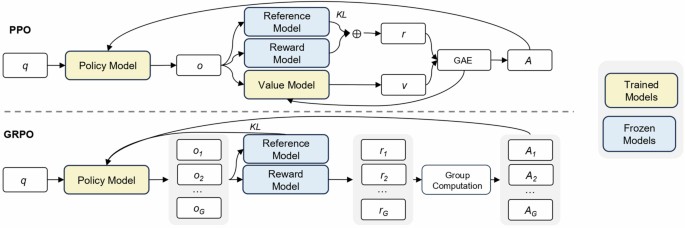
每个问题 \(q\) 从旧策略抽样 \(G\) 个完整回答。奖励在整条回答结束后得到,随后按同题组均值和标准差标准化。
回答高于同题组平均奖励时为正,低于平均时为负。GRPO 省去 PPO 的独立 critic/value model,降低大模型训练的显存和计算负担。
\(\rho_i\) 衡量新旧策略对该回答的概率比。正式版只为 R1 第一阶段 RL 报告 \(\varepsilon=10\),并说明较小值会截断大量 token 的梯度、较大值会造成不稳定。R1-Zero 没有单独披露 clip 参数。
上式右侧是基于采样回答的非负 KL 估计量。令 \(r=\pi_{\mathrm{ref}}(o\mid q)/\pi_{\theta}(o\mid q)\),在策略 \(\pi_{\theta}\) 下对 \(r-\log r-1\) 取期望才得到完整 KL divergence;单个回答的值包含采样误差。它限制策略远离 reference 的程度。
\(\beta=0.001\),参考策略每 400 步更新为最新策略。该配置由正式 Methods 的 R1-Zero 跨页段落直接披露。
系统把任务组织成用户提问与助手回答;助手先在指定思考标签内写推理,再在答案标签内给出结论。模板只规定结构,没有提供解题内容或 few-shot 示例。数学题的最终答案需要可由规则提取,代码题通过编译和测试用例执行。
此处给出结构与要求的中文释义,没有逐字复制原始英文模板。
这里把 Methods 的规则写成指示函数:verifier 检查数学、选择、逻辑最终答案或代码测试;格式项检查规定标签。两个分量等权。
learning rate \(3\times10^{-6}\)、temperature 1、每题 \(G=16\);32 个独立问题形成 512 回答批次。每次 rollout 有 8,192 个回答,随机分成 16 个 minibatch,执行一个 inner epoch;参考策略每 400 步刷新。前 8,200 步最大 32,768 token,随后为 65,536;共 10,400 步、约 1.6 epochs。Methods 没有给出 Zero 的独立 clip、optimizer、weight decay 或 warmup。
learning rate \(3\times10^{-6}\)、最大 32,768 token、每题 16 回答、32 个问题组成 512 回答批次;该阶段单独报告 clip \(\varepsilon=10\)。
消融显示它维持输出语言一致性,数学表现大致相当,代码表现略降。这里存在可读性与任务分数之间的取舍。
这是 Methods Eq. 8 的总奖励记法。每个 query 按任务启用 reasoning 或 general 分支,非所属任务的分量不参与该样本;语言一致性项按论文设置直接加入最终奖励。
helpfulness 数据只评最终摘要;safety 数据评完整回答,包括推理和摘要。每个 query 依据所属数据域选择一个奖励模型,因此不会把 helpfulness 与 safety 机械相加。第二阶段总训练 1,700 步、temperature 0.7,最后 400 步加入通用指令数据;长期使用模型奖励会出现 reward hacking。
Methods 将奖励模型架构描述为与 DeepSeek-R1 一致,并增加预测 scalar preference score 的 reward head;初始化 checkpoint 与 reward head 使用的具体 token 位置未披露。Helpfulness RM 使用 66K preference pairs:V3 生成成对回答,V3 以随机 A/B 顺序独立判断四次并取平均,仅保留偏好差超过 1 的 pair,同时控制长度偏差;采用 pairwise loss。Safety RM 使用 106K prompts 和 pointwise 标注。两者训练 batch 256、learning rate \(6\times10^{-6}\)、1 epoch、最大 8,192 token;推理时没有长度限制。这里的 106K 是 safety RM 的训练规模,第二阶段 RL 的 safety query 为 12K。
原图比较 DeepSeek-Coder-V2-Lite(16B MoE、2.4B activated)在 MATH 上的 PPO 与 GRPO。PPO 的 GAE 参数 \(\lambda=0.95\) 时明显较差,调至 \(\lambda=1.0\) 后接近 GRPO;作者据此主张 GRPO 可减少 value model 开销及额外调参。该对照没有证明 GRPO 对所有任务都优于充分调参的 PPO。
其他补充原图索引:Figure 1:PPO 与 GRPO 结构;Figure 3:四模块 RL infrastructure;Figure 4:reward hacking 的奖励上升与任务表现下降;Figure 5:language consistency 实验;Figure 6:MATH 难度分层;Figure 7:训练中推理行为演化;Figure 8:人类推理任务比较;Figures 9–10:ChatBotArena 风格控制及多维排名;Figure 11:安全分类体系;Figure 12:多语言安全;Figures 13–14:MMLU / MMLU-Pro 分类结果;Figure 15:2024 竞赛定量推理类别分解;Figure 16:难度与 test-time compute。未嵌入原图可按以上编号在正式补充 PDF 中定位,不能把不同图号的实验混用。
| RL 数据 | 规模 | 问题 / 输出 | 验证方式 |
|---|---|---|---|
| Math | 26K | 定量推理 → 数字、表达式或方程 | 答案匹配;排除数学证明 |
| Code | 17K 算法 + 8K 修复 | 竞赛程序、GitHub issue 修复 | 隐藏测试、单元测试 |
| STEM | 22K | 4–8 选项;物理15.5%、生物30.7%、化学46.5%、其他7.3% | 选项匹配 |
| Logic | 15K | 真实与合成逻辑题 | 选择题或确定性规则 |
| General | 66K helpfulness + 12K safety | 写作、编辑、事实问答、角色扮演 | 按 query 域选择 helpful RM 或 safety RM |
| 领域 | 样本数 | 平均轮数 | 平均 token |
|---|---|---|---|
| Math | 395,285 | 1.0 | 6,094.2 |
| Code | 211,129 | 1.1 | 7,435.7 |
| STEM | 10,124 | 1.0 | 4,928.8 |
| Logic | 10,395 | 1.0 | 2,739.0 |
| General | 177,812 | 1.1 | 1,419.8 |
| Total | 804,745 | 1.0 | 5,355.3 |
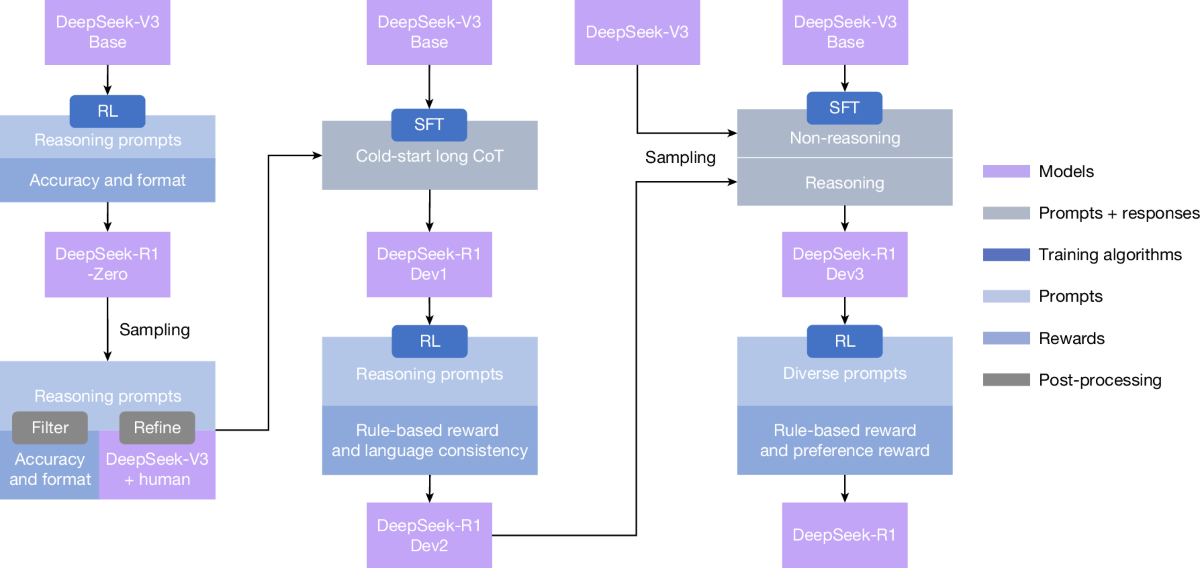
保留可产生确定最终答案的定量题,排除证明题。规则先抽取答案,规范化 LaTeX 与数值形式,再用 SymPy 解析并比较表达式;无法解析的样本交给 V3 判断。构造冷启动数据时,以 R1-Zero、temperature 1.0 生成候选,保留答案正确、格式可读的轨迹,过滤重复、异常长段落、语言混合和大段代码,再由 V3 改写推理与摘要并进行人工核验。
算法源包括 5,151 个 Codeforces 和 2,504 个 AtCoder 问题。DeepSeek-V2.5 生成候选测试输入;作者用题目已有正确提交确认测试应当通过,再用错误提交筛选能够揭示错误的测试,删除无效、重复或判别力不足的用例。代码修复样本来自 GitHub issue,并以仓库单元测试作为执行信号。
从第一阶段 RL checkpoint 进行 rejection sampling。规则可验证任务直接检查结果;部分非规则任务由 V3 比较 ground truth 与预测。随后过滤语言混合、超长段落和代码块。
复用 V3 的部分 SFT 数据,加入写作、事实问答、翻译、自我认知、软件工程、前端开发与安全数据。多轮数据很少,补充材料把多轮能力列为限制。
DeepSeek-V3 MoE 总参数;每 token 激活约 37B。R1 与 R1-Zero 均基于 V3-Base。
64 个节点,每节点 8 张 H800。R1-Zero 约 198 小时;R1 约 80 小时。
按 H800 每 GPU 小时 2 美元估算,详见下表。
冷启动 SFT 与第二阶段 SFT 均训练 2–3 epochs;cosine learning-rate schedule 从 \(5\times10^{-5}\) 降至 \(5\times10^{-6}\);最大上下文 32,768,batch size 128。
learning rate \(3\times10^{-6}\),temperature 1;第 8,200 步前最大 32,768 token,随后 65,536 token;总 10,400 步、约 1.6 epochs。
四个模块分别负责 rollout、参考或奖励模型推理、规则奖励和训练。vLLM workers 执行采样;MoE 使用跨节点 expert parallelism 与热点专家冗余;MTP 用于 self-speculative decoding;规则检查器异步覆盖其他模块延迟;按长度排序后 Best-Fit packing 降低 padding;阶段间把模型卸载到内存或磁盘;训练模块支持 GRPO、PPO 与 DPO。分布式训练依赖内部 HAI-LLM,完整训练框架没有公开。
| 阶段 | H800 GPU hours | 按每 GPU 小时 2 美元估算 |
|---|---|---|
| R1-Zero | 101K | $202K |
| SFT data creation | 5K | $10K |
| R1 | 41K | $82K |
| Total | 147K | $294K |
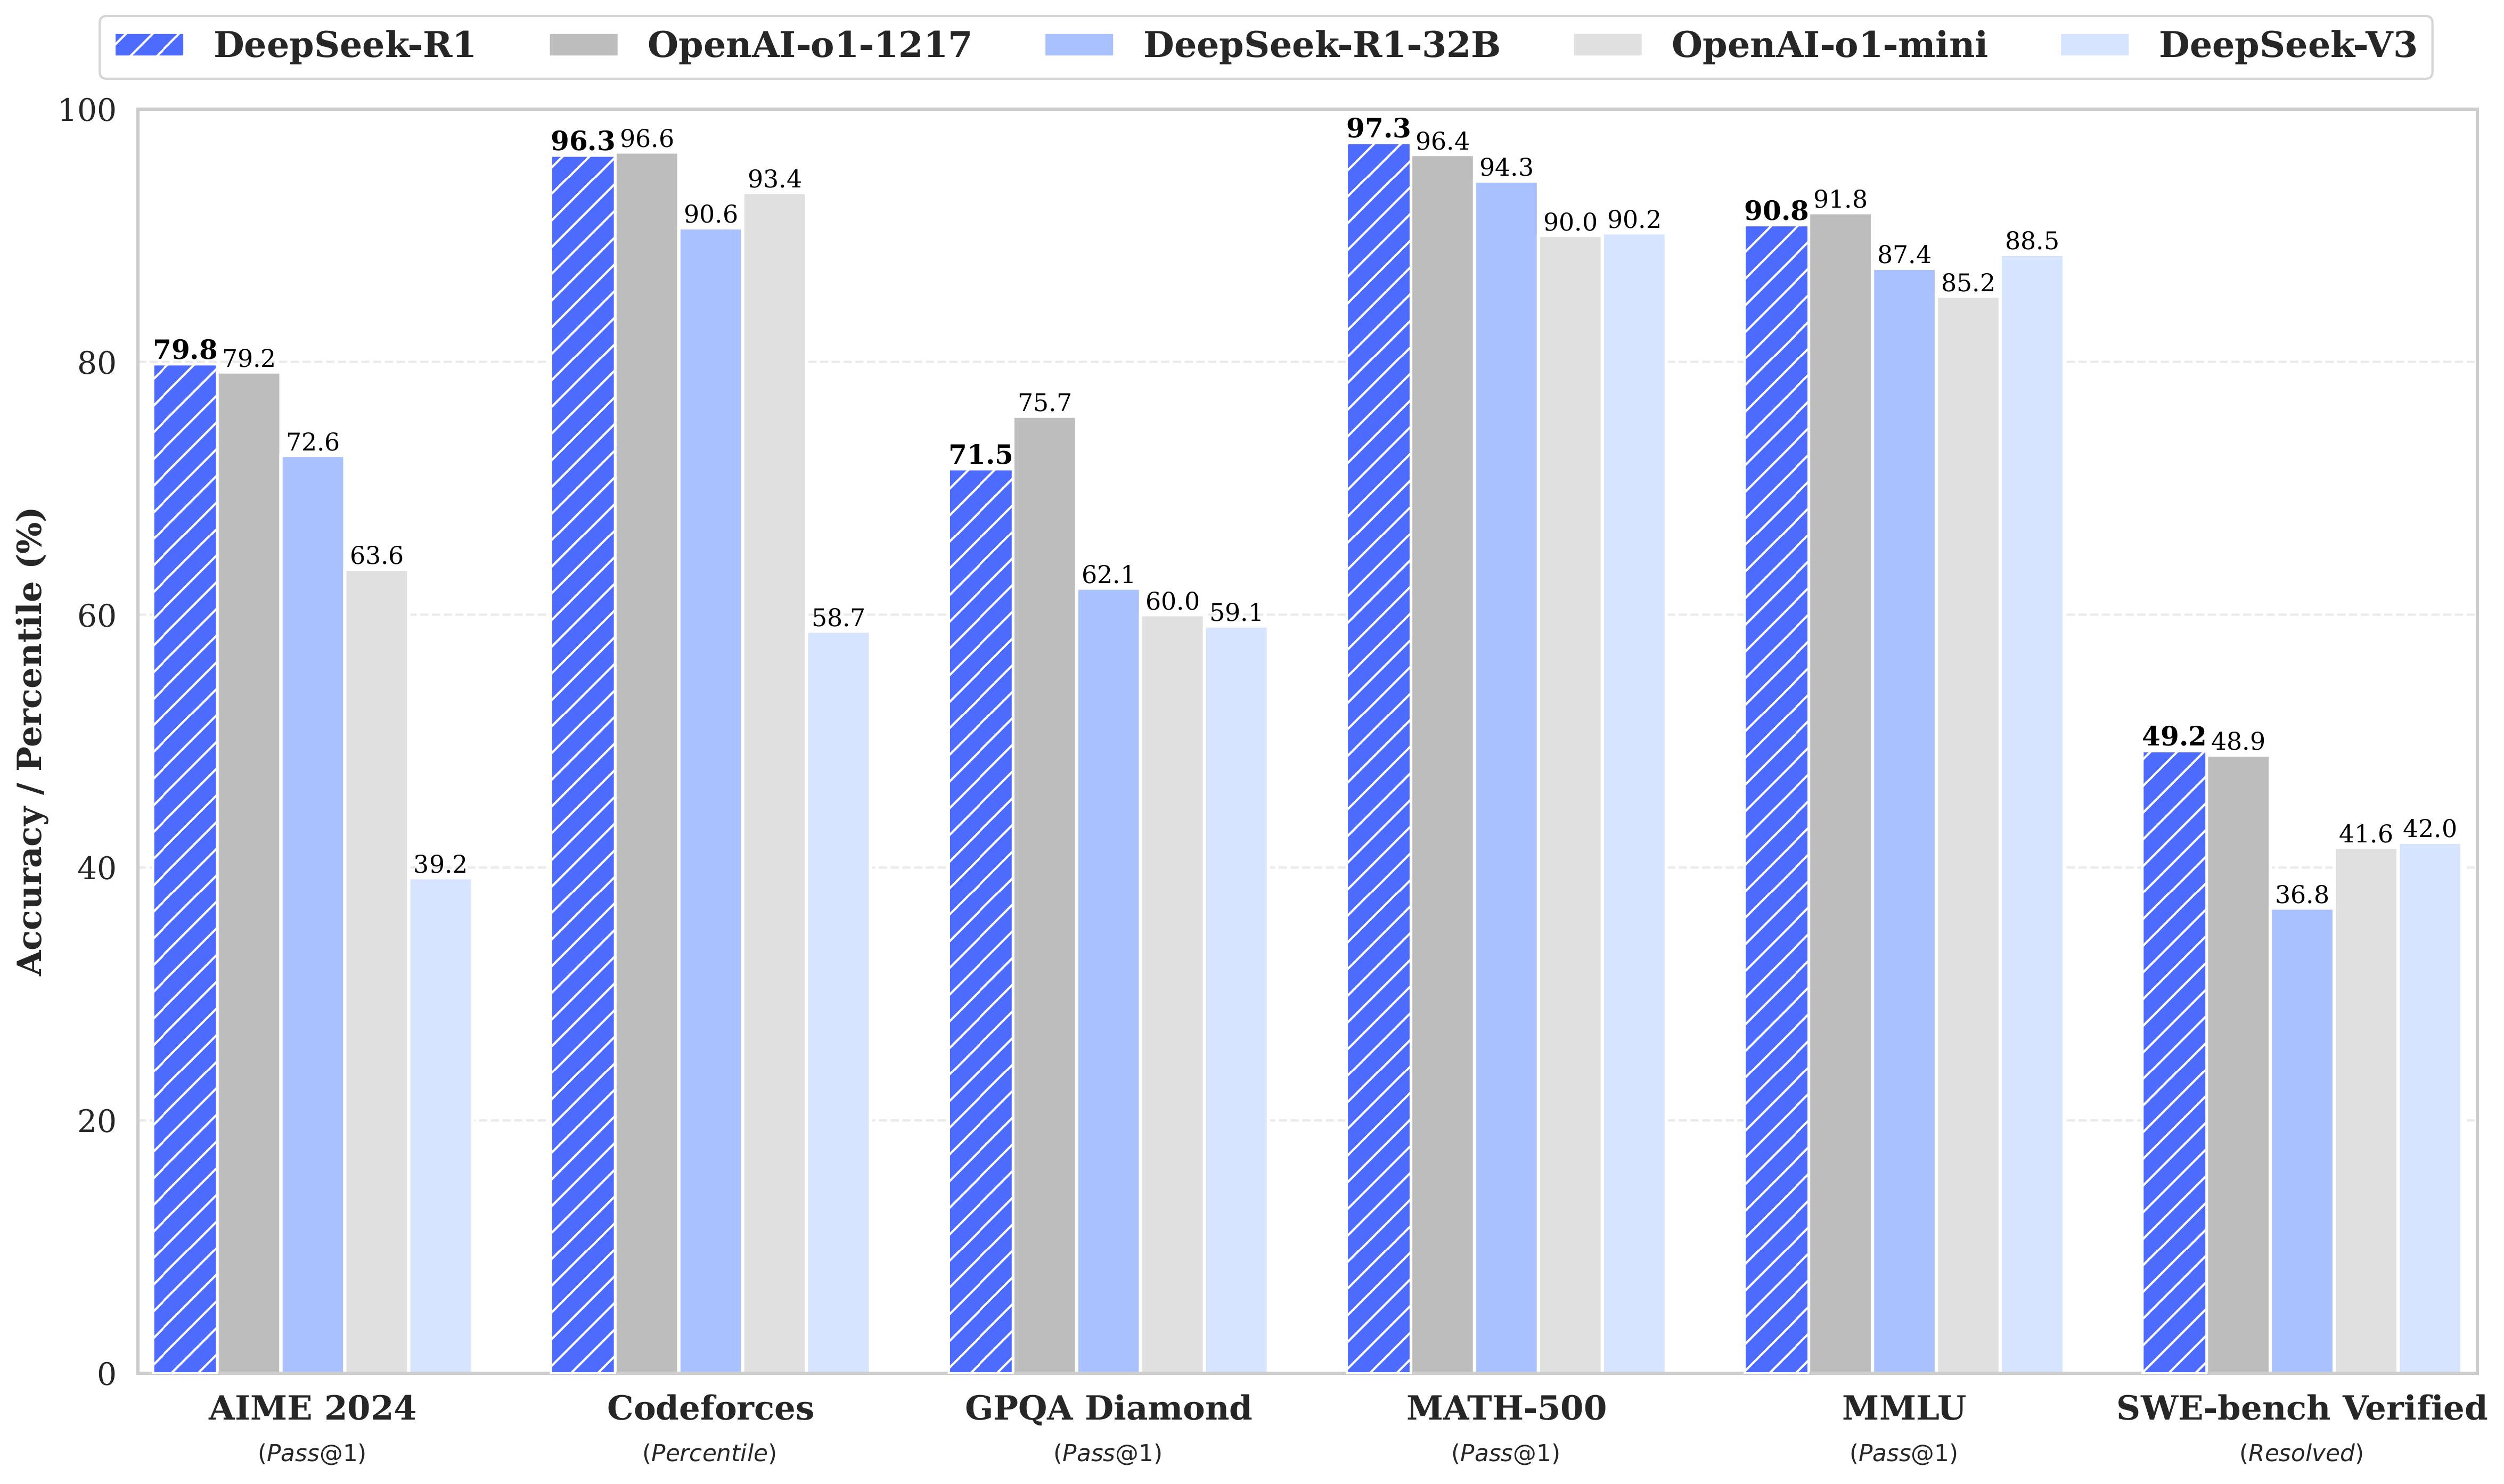
Nature Table 2 全部方法列与指标行。数值依原表;显著性粗体没有在文本抽取中稳定保留,本页不重新推断显著性。
| Benchmark | R1-Zero | R1 Dev1 | R1 Dev2 | R1 Dev3 | R1 |
|---|---|---|---|---|---|
| MMLU | 88.8 | 89.1 | 91.2 | 91.0 | 90.8 |
| MMLU-Redux | 85.6 | 90.0 | 93.0 | 93.1 | 92.9 |
| MMLU-Pro | 68.9 | 74.1 | 83.8 | 83.1 | 84.0 |
| DROP | 89.1 | 89.8 | 91.1 | 88.7 | 92.2 |
| IF-Eval | 46.6 | 71.7 | 72.0 | 78.1 | 83.3 |
| GPQA Diamond | 75.8 | 66.1 | 70.7 | 71.2 | 71.5 |
| SimpleQA | 30.3 | 17.8 | 28.2 | 24.9 | 30.1 |
| FRAMES | 82.3 | 78.5 | 81.8 | 81.9 | 82.5 |
| AlpacaEval 2.0 | 24.7 | 50.1 | 55.8 | 62.1 | 87.6 |
| Arena-Hard | 53.6 | 77.0 | 73.2 | 75.6 | 92.3 |
| LiveCodeBench | 50.0 | 57.5 | 63.5 | 64.6 | 65.9 |
| Codeforces percentile | 80.4 | 84.5 | 90.5 | 92.1 | 96.3 |
| Codeforces rating | 1,444 | 1,534 | 1,687 | 1,746 | 2,029 |
| SWE-bench Verified | 43.2 | 39.6 | 44.6 | 45.6 | 49.2 |
| Aider-Polyglot | 12.2 | 6.7 | 25.6 | 44.8 | 53.3 |
| AIME 2024 | 77.9 | 59.0 | 74.0 | 78.1 | 79.8 |
| MATH-500 | 95.9 | 94.2 | 95.9 | 95.4 | 97.3 |
| CNMO 2024 | 88.1 | 58.0 | 73.9 | 77.3 | 78.8 |
| CLUEWSC | 93.1 | 92.8 | 92.6 | 91.6 | 92.8 |
| C-Eval | 92.8 | 85.7 | 91.9 | 86.4 | 91.8 |
| C-SimpleQA | 66.4 | 58.8 | 64.2 | 66.9 | 63.7 |
IF-Eval 46.6→71.7,Arena-Hard 53.6→77.0;AIME 77.9→59.0,显示小规模冷启动数据改善交互形式,同时削弱部分推理成绩。
AIME 59.0→74.0,LiveCodeBench 57.5→63.5,Codeforces 1,534→1,687;通用偏好指标提升有限。
第二次 SFT 带来 Aider 25.6→44.8;最终 RL 后 AlpacaEval 62.1→87.6、Arena-Hard 75.6→92.3,同时 AIME 达 79.8。
| Benchmark | Claude 3.5 | GPT-4o | DeepSeek-V3 | o1-mini | o1-1217 | R1 |
|---|---|---|---|---|---|---|
| MMLU | 88.3 | 87.2 | 88.5 | 85.2 | 91.8 | 90.8 |
| MMLU-Redux | 88.9 | 88.0 | 89.1 | 86.7 | — | 92.9 |
| MMLU-Pro | 78.0 | 72.6 | 75.9 | 80.3 | — | 84.0 |
| DROP | 88.3 | 83.7 | 91.6 | 83.9 | 90.2 | 92.2 |
| IF-Eval | 86.5 | 84.3 | 86.1 | 84.8 | — | 83.3 |
| GPQA Diamond | 65.0 | 49.9 | 59.1 | 60.0 | 75.7 | 71.5 |
| SimpleQA | 28.4 | 38.2 | 24.9 | 7.0 | 47.0 | 30.1 |
| FRAMES | 72.5 | 80.5 | 73.3 | 76.9 | — | 82.5 |
| AlpacaEval 2.0 | 52.0 | 51.1 | 70.0 | 57.8 | — | 87.6 |
| Arena-Hard | 85.2 | 80.4 | 85.5 | 92.0 | — | 92.3 |
| LiveCodeBench | 38.9 | 32.9 | 36.2 | 53.8 | 63.4 | 65.9 |
| Codeforces percentile | 20.3 | 23.6 | 58.7 | 93.4 | 96.6 | 96.3 |
| Codeforces rating | 717 | 759 | 1,134 | 1,820 | 2,061 | 2,029 |
| SWE-bench Verified | 50.8 | 38.8 | 42.0 | 41.6 | 48.9 | 49.2 |
| Aider-Polyglot | 45.3 | 16.0 | 49.6 | 32.9 | 61.7 | 53.3 |
| AIME 2024 | 16.0 | 9.3 | 39.2 | 63.6 | 79.2 | 79.8 |
| MATH-500 | 78.3 | 74.6 | 90.2 | 90.0 | 96.4 | 97.3 |
| CNMO 2024 | 13.1 | 10.8 | 43.2 | 67.6 | — | 78.8 |
| CLUEWSC | 85.4 | 87.9 | 90.9 | 89.9 | — | 92.8 |
| C-Eval | 76.7 | 76.0 | 86.5 | 68.9 | — | 91.8 |
| C-SimpleQA | 55.4 | 58.7 | 68.0 | 40.3 | — | 63.7 |
括号内是移除 risk control system 后的原始模型分数;表格明确给出 HarmBench 与总体平均的变化。DNA、HarmBench 由作者复现,其余 benchmark 数值取自独立 HELM 评测。
| 模型 | SST | BBQ | ART | XSTest | DNA | HarmBench | Average |
|---|---|---|---|---|---|---|---|
| Claude-3.7-Sonnet | 100.0 | 92.1 | 99.7 | 96.4 | 95.9 | 83.3 | 94.6 |
| o1 (2024-12-17) | 99.0 | 97.3 | 98.3 | 97.0 | 86.2 | 84.0 | 93.6 |
| GPT-4o (2024-05-13) | 98.5 | 95.1 | 99.1 | 97.3 | 90.6 | 72.7 | 92.2 |
| Qwen2.5-Instruct-72B | 100.0 | 95.4 | 99.6 | 97.9 | 95.9 | 83.0 | 95.3 |
| DeepSeek-V3 + risk control | 95.3 | 96.7 | 97.1 | 97.1 | 95.6 | 96.0 (67.0) | 96.3 (91.5) |
| DeepSeek-R1 + risk control, hidden CoT | 98.0 | 96.6 | 97.2 | 94.4 | 93.7 | 96.3 (58.0) | 96.0 (89.7) |
| DeepSeek-R1 + risk control | 97.5 | 96.6 | 96.2 | 95.3 | 94.8 | 89.3 (35.0) | 95.0 (85.9) |
测试集覆盖 28 个子类;每类 20 个中文 prompt,再构造英文版本,共 1,120 条。GPT-4o 作为 judge,与人工标签一致率超过 95%。
| 模型 | Discrimination | Illegal | Harmful | Ethical | Overall |
|---|---|---|---|---|---|
| Claude-3.7-Sonnet | 8.4 / 2.5 | 14.1 / 4.5 | 9.5 / 5.5 | 7.5 / 0.6 | 10.7 / 3.6 |
| o1 | 7.2 / 37.8 | 12.3 / 54.8 | 5.0 / 73.5 | 8.8 / 34.4 | 9.0 / 50.4 |
| GPT-4o | 19.1 / 6.2 | 22.5 / 28.4 | 28.0 / 19.5 | 18.8 / 4.4 | 22.0 / 17.1 |
| Qwen2.5-Instruct-72B | 12.8 / 2.5 | 14.5 / 9.5 | 15.5 / 5.0 | 11.9 / 0.0 | 13.8 / 5.4 |
| DeepSeek-V3 | 20.3 / 2.5 | 17.3 / 13.9 | 17.5 / 9.5 | 13.1 / 1.9 | 17.6 / 8.1 |
| DeepSeek-V3 + risk control | 8.1 / 16.9 | 3.2 / 35.5 | 7.0 / 22.5 | 3.1 / 18.1 | 5.3 / 25.4 |
| DeepSeek-R1 | 19.7 / 3.8 | 28.9 / 8.6 | 32.5 / 6.0 | 16.9 / 0.6 | 25.2 / 5.6 |
| DeepSeek-R1 + risk control | 9.1 / 17.2 | 6.6 / 39.1 | 13.0 / 29.0 | 6.9 / 13.1 | 8.5 / 27.3 |
作者把 2,232 个越狱指令模板随机拼接到原始安全问题,再使用关注操纵陷阱的 LLM judge 分类 safe、unsafe 或 rejected。
| 模型 | Unsafe 原始 | Unsafe 越狱 | 差值 | Rejected 原始 | Rejected 越狱 | 差值 |
|---|---|---|---|---|---|---|
| Claude-3.7-Sonnet | 10.7 | 26.2 | +15.5 | 3.6 | 21.9 | +18.3 |
| o1 | 9.0 | 12.1 | +3.1 | 50.4 | 79.8 | +29.4 |
| GPT-4o | 22.0 | 30.4 | +8.4 | 17.1 | 57.3 | +40.2 |
| Qwen2.5-Instruct-72B | 13.8 | 29.7 | +15.9 | 5.4 | 25.2 | +19.8 |
| DeepSeek-V3 | 17.6 | 36.4 | +18.8 | 8.1 | 8.9 | +0.8 |
| DeepSeek-V3 + risk control | 5.3 | 2.3 | −3.0 | 25.4 | 46.5 | +21.1 |
| DeepSeek-R1 | 25.2 | 85.9 | +60.7 | 5.6 | 1.9 | −3.7 |
| DeepSeek-R1 + risk control | 8.5 | 4.3 | −4.2 | 27.3 | 87.3 | +60.0 |
| Benchmark | V3-Base | V3 | R1-Zero | R1 |
|---|---|---|---|---|
| MMLU | 87.1 | 88.5 | 88.8 | 90.8 |
| MMLU-Redux | 86.2 | 89.1 | 85.6 | 92.9 |
| MMLU-Pro | 64.4 | 75.9 | 68.9 | 84.0 |
| DROP | 89.0 | 91.6 | 89.1 | 92.2 |
| IF-Eval | 58.6 | 86.1 | 46.6 | 83.3 |
| GPQA Diamond | — | 59.1 | 75.8 | 71.5 |
| SimpleQA | 20.1 | 24.9 | 30.3 | 30.1 |
| FRAMES | — | 73.3 | 82.3 | 82.5 |
| AlpacaEval 2.0 | — | 70.0 | 24.7 | 87.6 |
| Arena-Hard | — | 85.5 | 53.6 | 92.3 |
| LiveCodeBench | — | 36.2 | 50.0 | 65.9 |
| Codeforces percentile | — | 58.7 | 80.4 | 96.3 |
| Codeforces rating | — | 1,134 | 1,444 | 2,029 |
| SWE-bench Verified | — | 42.0 | 43.2 | 49.2 |
| Aider-Polyglot | — | 49.6 | 12.2 | 53.3 |
| AIME 2024 | — | 39.2 | 77.9 | 79.8 |
| MATH-500 | — | 90.2 | 95.9 | 97.3 |
| CNMO 2024 | — | 43.2 | 88.1 | 78.8 |
| CLUEWSC | 82.7 | 90.9 | 93.1 | 92.8 |
| C-Eval | 90.1 | 86.5 | 92.8 | 91.8 |
| C-SimpleQA | — | 68.0 | 66.4 | 63.7 |
| 参与者或模型 | AMC 12 2024 | AIME 2025 | USAMO Index |
|---|---|---|---|
| Human participants | 61.7 | 6.2 / 15 | 123.7 |
| GPT-4o-0513 | 84.0 | 2.0 / 15 | 104.0 |
| DeepSeek-V3 | 98.3 | 3.3 / 15 | 131.3 |
| OpenAI o1-1217 | 141.0 | 12.0 / 15 | 261.0 |
| DeepSeek-R1 | 143.7 | 11.3 / 15 | 256.7 |
AIME 2025 的 pass@1 另报 R1 为 75%、o1 为 80%。这些题目晚于主要训练语料截止时间,为污染争议提供更近时点的证据,但仍无法完成全训练数据审计。
| 难度 | R1-Zero | Dev1 | Dev2 | Dev3 | R1 |
|---|---|---|---|---|---|
| Easy | 98.07 | 99.52 | 100.00 | 100.00 | 100.00 |
| Medium | 58.78 | 73.31 | 81.76 | 81.42 | 83.45 |
| Hard | 17.09 | 23.21 | 30.36 | 33.16 | 34.44 |
六个学生模型只做 SFT:2–3 epochs、batch 64、context 32,768,cosine 将 learning rate 降到初始值的十分之一。
| 学生模型 | Base model | 初始 LR |
|---|---|---|
| R1-Distill-Qwen-1.5B | Qwen2.5-Math-1.5B | \(1\times10^{-4}\) |
| R1-Distill-Qwen-7B | Qwen2.5-Math-7B | \(8\times10^{-5}\) |
| R1-Distill-Qwen-14B | Qwen2.5-14B | \(7\times10^{-5}\) |
| R1-Distill-Qwen-32B | Qwen2.5-32B | \(6\times10^{-5}\) |
| R1-Distill-Llama-8B | Llama-3.1-8B | \(5\times10^{-5}\) |
| R1-Distill-Llama-70B | Llama-3.3-70B-Instruct | \(2\times10^{-5}\) |
| 模型 | AIME pass@1 | AIME cons@64 | MATH-500 | GPQA | LiveCodeBench | Codeforces rating |
|---|---|---|---|---|---|---|
| GPT-4o-0513 | 9.3 | 13.4 | 74.6 | 49.9 | 32.9 | 759 |
| Claude-3.5-Sonnet-1022 | 16.0 | 26.7 | 78.3 | 65.0 | 38.9 | 717 |
| R1-Distill-Qwen-1.5B | 28.9 | 52.7 | 83.9 | 33.8 | 16.9 | 954 |
| R1-Distill-Qwen-7B | 55.5 | 83.3 | 92.8 | 49.1 | 37.6 | 1,189 |
| R1-Distill-Qwen-14B | 69.7 | 80.0 | 93.9 | 59.1 | 53.1 | 1,481 |
| R1-Distill-Qwen-32B | 72.6 | 83.3 | 94.3 | 62.1 | 57.2 | 1,691 |
| R1-Distill-Llama-8B | 50.4 | 80.0 | 89.1 | 49.0 | 39.6 | 1,205 |
| R1-Distill-Llama-70B | 70.0 | 86.7 | 94.5 | 65.2 | 57.5 | 1,633 |
| 模型 | AIME pass@1 | AIME cons@64 | MATH-500 | GPQA | LiveCodeBench |
|---|---|---|---|---|---|
| QwQ-32B-Preview | 50.0 | 60.0 | 90.6 | 54.5 | 41.9 |
| Qwen2.5-32B-Zero | 47.0 | 60.0 | 91.6 | 55.0 | 40.2 |
| R1-Distill-Qwen-32B | 72.6 | 83.3 | 94.3 | 62.1 | 57.2 |
| 模型 | AIME 2024 | AIME 2025 |
|---|---|---|
| GPT-4o-0513 | 9.3 | — |
| Qwen2-Math-7B-Instruct | 7.9 | 4.6 |
| Qwen2-Math-7B-Zero | 22.3 | 18.1 |
Supplementary Section 2.4.1 披露该 32B 纯 RL 对照使用 learning rate \(2\times10^{-6}\)、KL coefficient 0.001、temperature 1、每题 16 个回答、最大 32,768 token;每步 32 问题/512 回答,每 rollout 8,192 回答分成 16 minibatches,单 inner epoch,reference 每 400 步刷新。Qwen2.5-32B-Zero 训练超过 10K RL 步,仍低于 R1-Distill-Qwen-32B。Table 13 同时列出 QwQ-32B-Preview,显示比较并不限于一个纯 RL checkpoint。
Table 14 的 Qwen2-Math-7B-Zero 在约 10K policy-gradient steps 后,AIME 2024 达 22.3%、AIME 2025 达 18.1%,高于 7B Instruct 的 7.9% 与 4.6%。因此证据支持蒸馏在作者 32B 配置下更高效,同时也记录小模型纯 RL 能够改善成绩。
temperature 0.6(建议范围 0.5–0.7),top-p 0.95;数学提示要求逐步推理并把最终答案放入 box;不使用 system prompt;必要时强制以思考标签开头。
最大生成长度 32,768。AIME 与 GPQA 每题 \(k=64\),MATH 与 Codeforces \(k=16\),LiveCodeBench \(k=8\)。
其中 \(p_i\in\{0,1\}\) 表示第 \(i\) 次采样回答是否通过任务 verifier;此均值估计单次回答的成功概率。AIME 另报告 64 样本多数投票 cons@64。
补充材料使用 10-gram overlap 做数据去污染。同行评议质疑该阈值偏宽松,并要求更详细的数据来源与生成 prompt;因此 benchmark 结果仍存在污染不确定性。
DeepSeek-R1 仓库提供模型说明、权重链接、MIT 许可、推理建议、少量数据样例和一份论文 PDF。核心推理脚本指向 DeepSeek-V3 仓库。Nature Code availability 说明训练网络基于 PyTorch,分布式训练依赖内部 HAI-LLM,推理使用 vLLM。仓库没有公开完整 GRPO 训练控制器、全量训练数据、完整 reward verifier、数据过滤程序或复现实验配置。
R1-Zero 与 R1:671B total / 37B activated / 128K context;另发布 1.5B、7B、8B、14B、32B、70B 六个蒸馏 checkpoint。公开权重和官方路径可以用于后续推理验证;本次精读没有实际运行模型。
| 表格 | 任务 | 输入或输出格式 | 评分规则 |
|---|---|---|---|
| 15 | MMLU | 57 类学科选择题;末尾给出 Answer 字母 | 抽取选项并精确匹配 |
| 16 | MMLU-Redux | 5,700 道重标注选择题;JSON reasoning 与 answer | 精确匹配答案字母 |
| 17 | LiveCodeBench | LeetCode、AtCoder、Codeforces 新题;代码围栏内 Python | 执行官方测试 |
| 18 | MMLU-Pro | 更难的多选题;逐步推理后输出 Answer | 抽取大写选项字母 |
| 19 | DROP | 段落阅读后的数字或抽取式答案 | 按数据集标准规范化匹配 |
| 20 | IF-Eval | 包含可验证约束的指令 | 官方约束检查函数 |
| 21 | FRAMES | 给出 gold Wikipedia 文章的长上下文 | 与 ground truth 内容比较后判 TRUE/FALSE |
| 22 | Arena-Hard | 开放问题与两个匿名回答 | LLM judge 选择 A、B 或 tie |
| 23 | AlpacaEval 2.0 | 开放指令和两个候选回答 | LLM judge 选择模型标识 |
| 24 | CLUEWSC | 中文 Winograd 指代消歧 | 抽取末行并精确匹配 |
| 25 | C-Eval | 52 个中文学科选择题 | 抽取最终选项 |
| 26 | GPQA | 研究生级 STEM 选择题 | 抽取 ANSWER 后的字母 |
| 27 | SimpleQA | 英文短事实问答 | grader 判 correct、incorrect 或 not attempted |
| 28 | C-SimpleQA | 中文短事实问答 | 同类三分 grader |
| 29 | AIME、MATH、CNMO | 逐步推理,最终答案置于 box | 规则抽取、数值规范化与 SymPy 等价判断 |
SWE-bench Verified、Aider-Polyglot 与 Codeforces 也出现在主结果表,但 Supplementary Tables 15–29 没有为它们逐项给出同样的 prompt 示例。
R1-Zero 的设置干净地展示了大规模 base checkpoint、可验证任务、结果奖励与足够 RL 预算的组合可以显著提高推理 benchmark。模型无需人工标注每一步推理。
在 R1-Distill-Qwen-7B 上,加入 LC reward 维持语言一致性;数学大致相当,编码略有下降。它证明该奖励控制语言行为,同时没有证明可读性奖励对所有能力无害。
训练后回答更长且分数更高。第 8.2K 步同时提高长度上限到 65,536,性能与长度也发生跳变。论文没有彻底拆分更多 token、训练课程和策略质量各自的贡献。
全量数据、内部训练框架、奖励检查器和完整训练代码缺失;训练成本是按租用价格估算;硬件总量与 wall-clock 给出,能耗、失败实验总预算和工程成本没有完整计入。
通用推理的“步骤”难定义,中间步骤正确性难标注,模型化 PRM 会产生 reward hacking;在作者实验里,它更适合 top-N reranking 或 guided search,收益不足以抵消大规模 RL 的额外成本。
token 搜索空间指数增长;每个节点的扩展上限会造成局部最优;value model 的误差直接影响每步搜索,迭代改进困难。作者只得出本实验设置下的失败经验。
需要长度匹配的控制组、固定 context 上限的训练曲线、相同 base model 的 SFT/GRPO/PPO 比较、不同 verifier 噪声水平的敏感性分析、公开的 prompt-level evaluation outputs,以及按训练样本来源分层的污染审计。对程序化材质任务,还应报告图执行失败率、渲染器调用数、每题候选分布与 reward–human preference 校准。