把重建误差交给可学习的渲染器
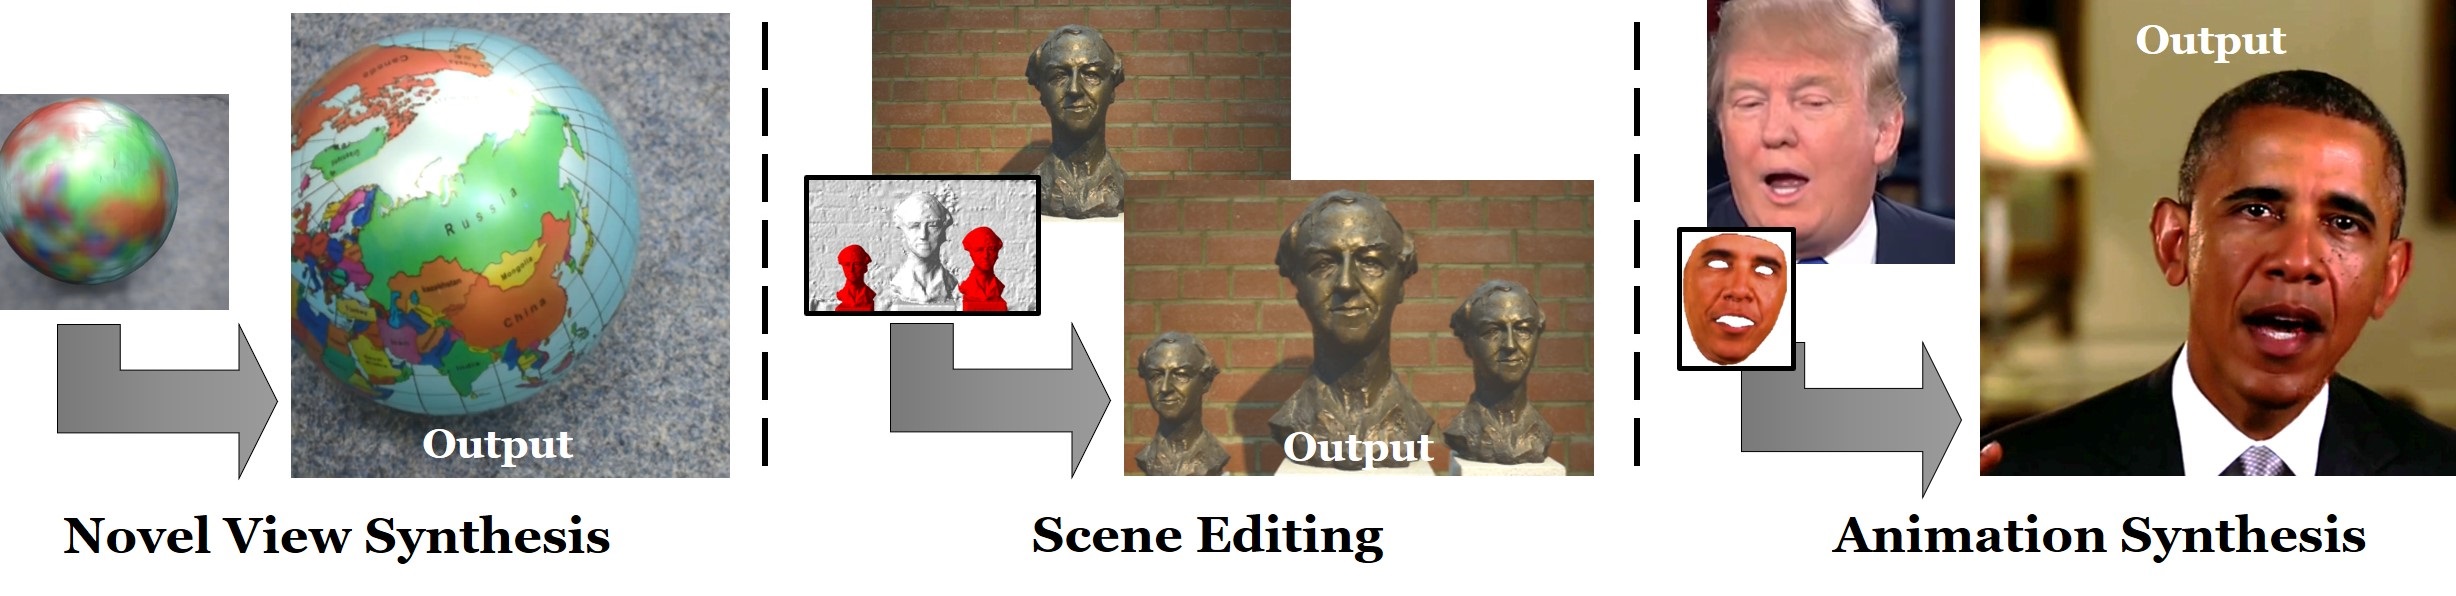
经典渲染要求精确几何、材质与光照。手持视频经 SfM/MVS 得到的网格常有孔洞、过度平滑、位姿漂移与遮挡边界误差。论文保留这个不完美的 3D proxy,用它提供视角、遮挡、表面对应与编辑控制,再让学习到的纹理和屏幕空间网络重建丢失的外观。
Research gap
IBR 需要保留大量训练图像并依赖准确深度;纯 2D image-to-image 网络缺少显式 3D 控制和长期一致的表面记忆;surface light field 又容易受几何错位影响。作者要验证:可学习的表面特征加局部卷积 renderer 是否能兼顾 3D 控制、照片真实感与实时推理。
核心假设
几何 proxy 无需承载完整细节,只要 UV 对应足够稳定,就能把同一表面位置的训练信号汇聚到统一 texture space。U-Net 的邻域感受野再对屏幕空间的小幅错位、缺口和过度平滑进行补偿。
训练对象是场景参数与渲染器参数
固定输入
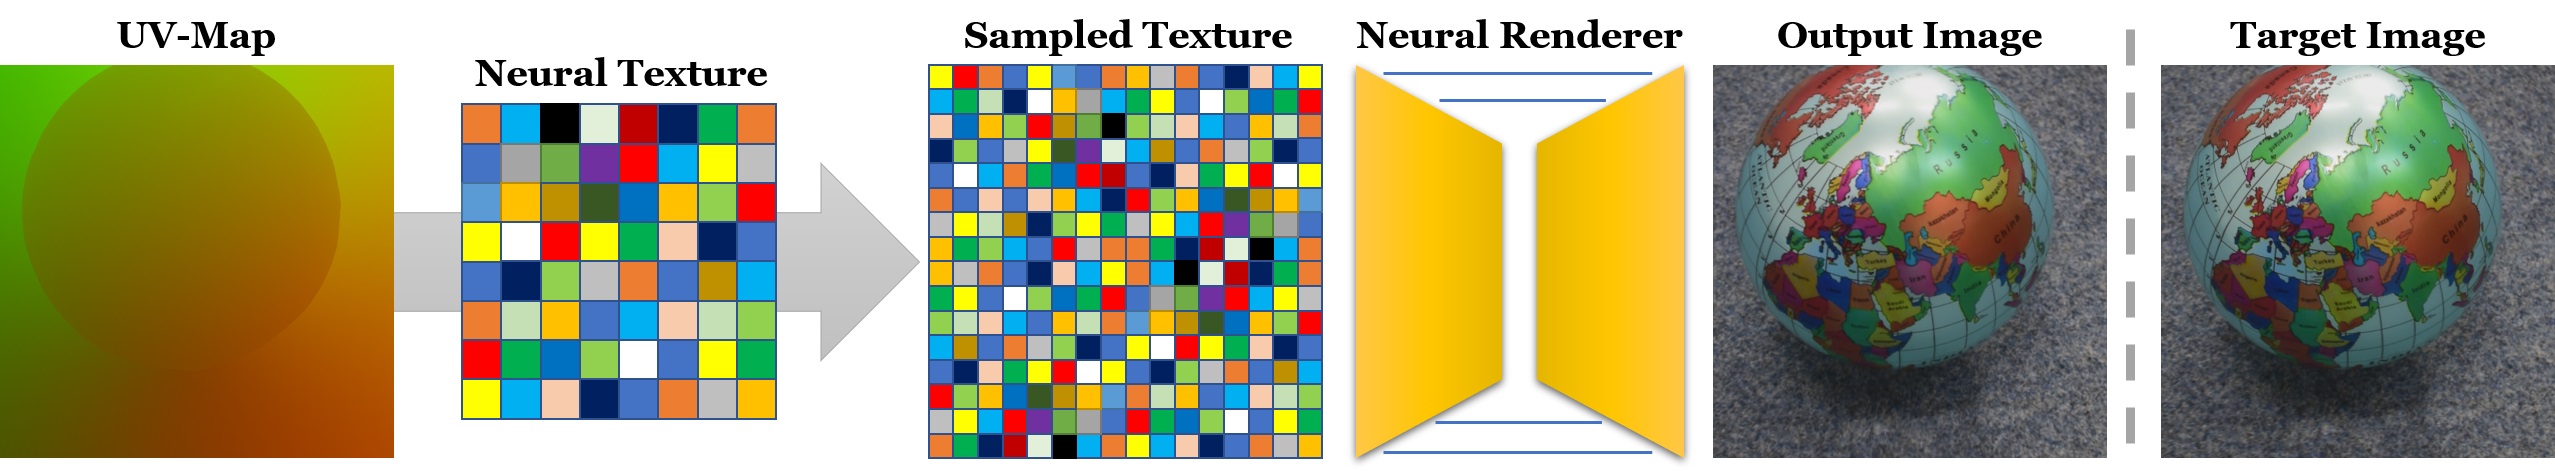
带 UV parameterization 的粗网格 \(G\);训练图像与相机参数 \(\{(\mathbf I_k,\mathbf p_k)\}_{k=1}^{N}\)。\(\mathbf p_k\) 包含 intrinsic 与 extrinsic。训练前为每个视角预计算 texel-to-pixel 对应,即论文所称 UV map。
学习变量
\(\mathbf T\) 是对象专属的多通道 Neural Texture hierarchy;\(\mathcal R\) 是对象或人物专属的屏幕空间 U-Net。论文所有主要实拍实验按对象单独训练。
监督信号
每个样本由 UV map 与对应 RGB ground truth 组成。UV map 经过可微双线性采样得到屏幕空间特征;预测 RGB 与真实随机裁剪之间计算 \(\ell_1\) photometric loss。
推理条件
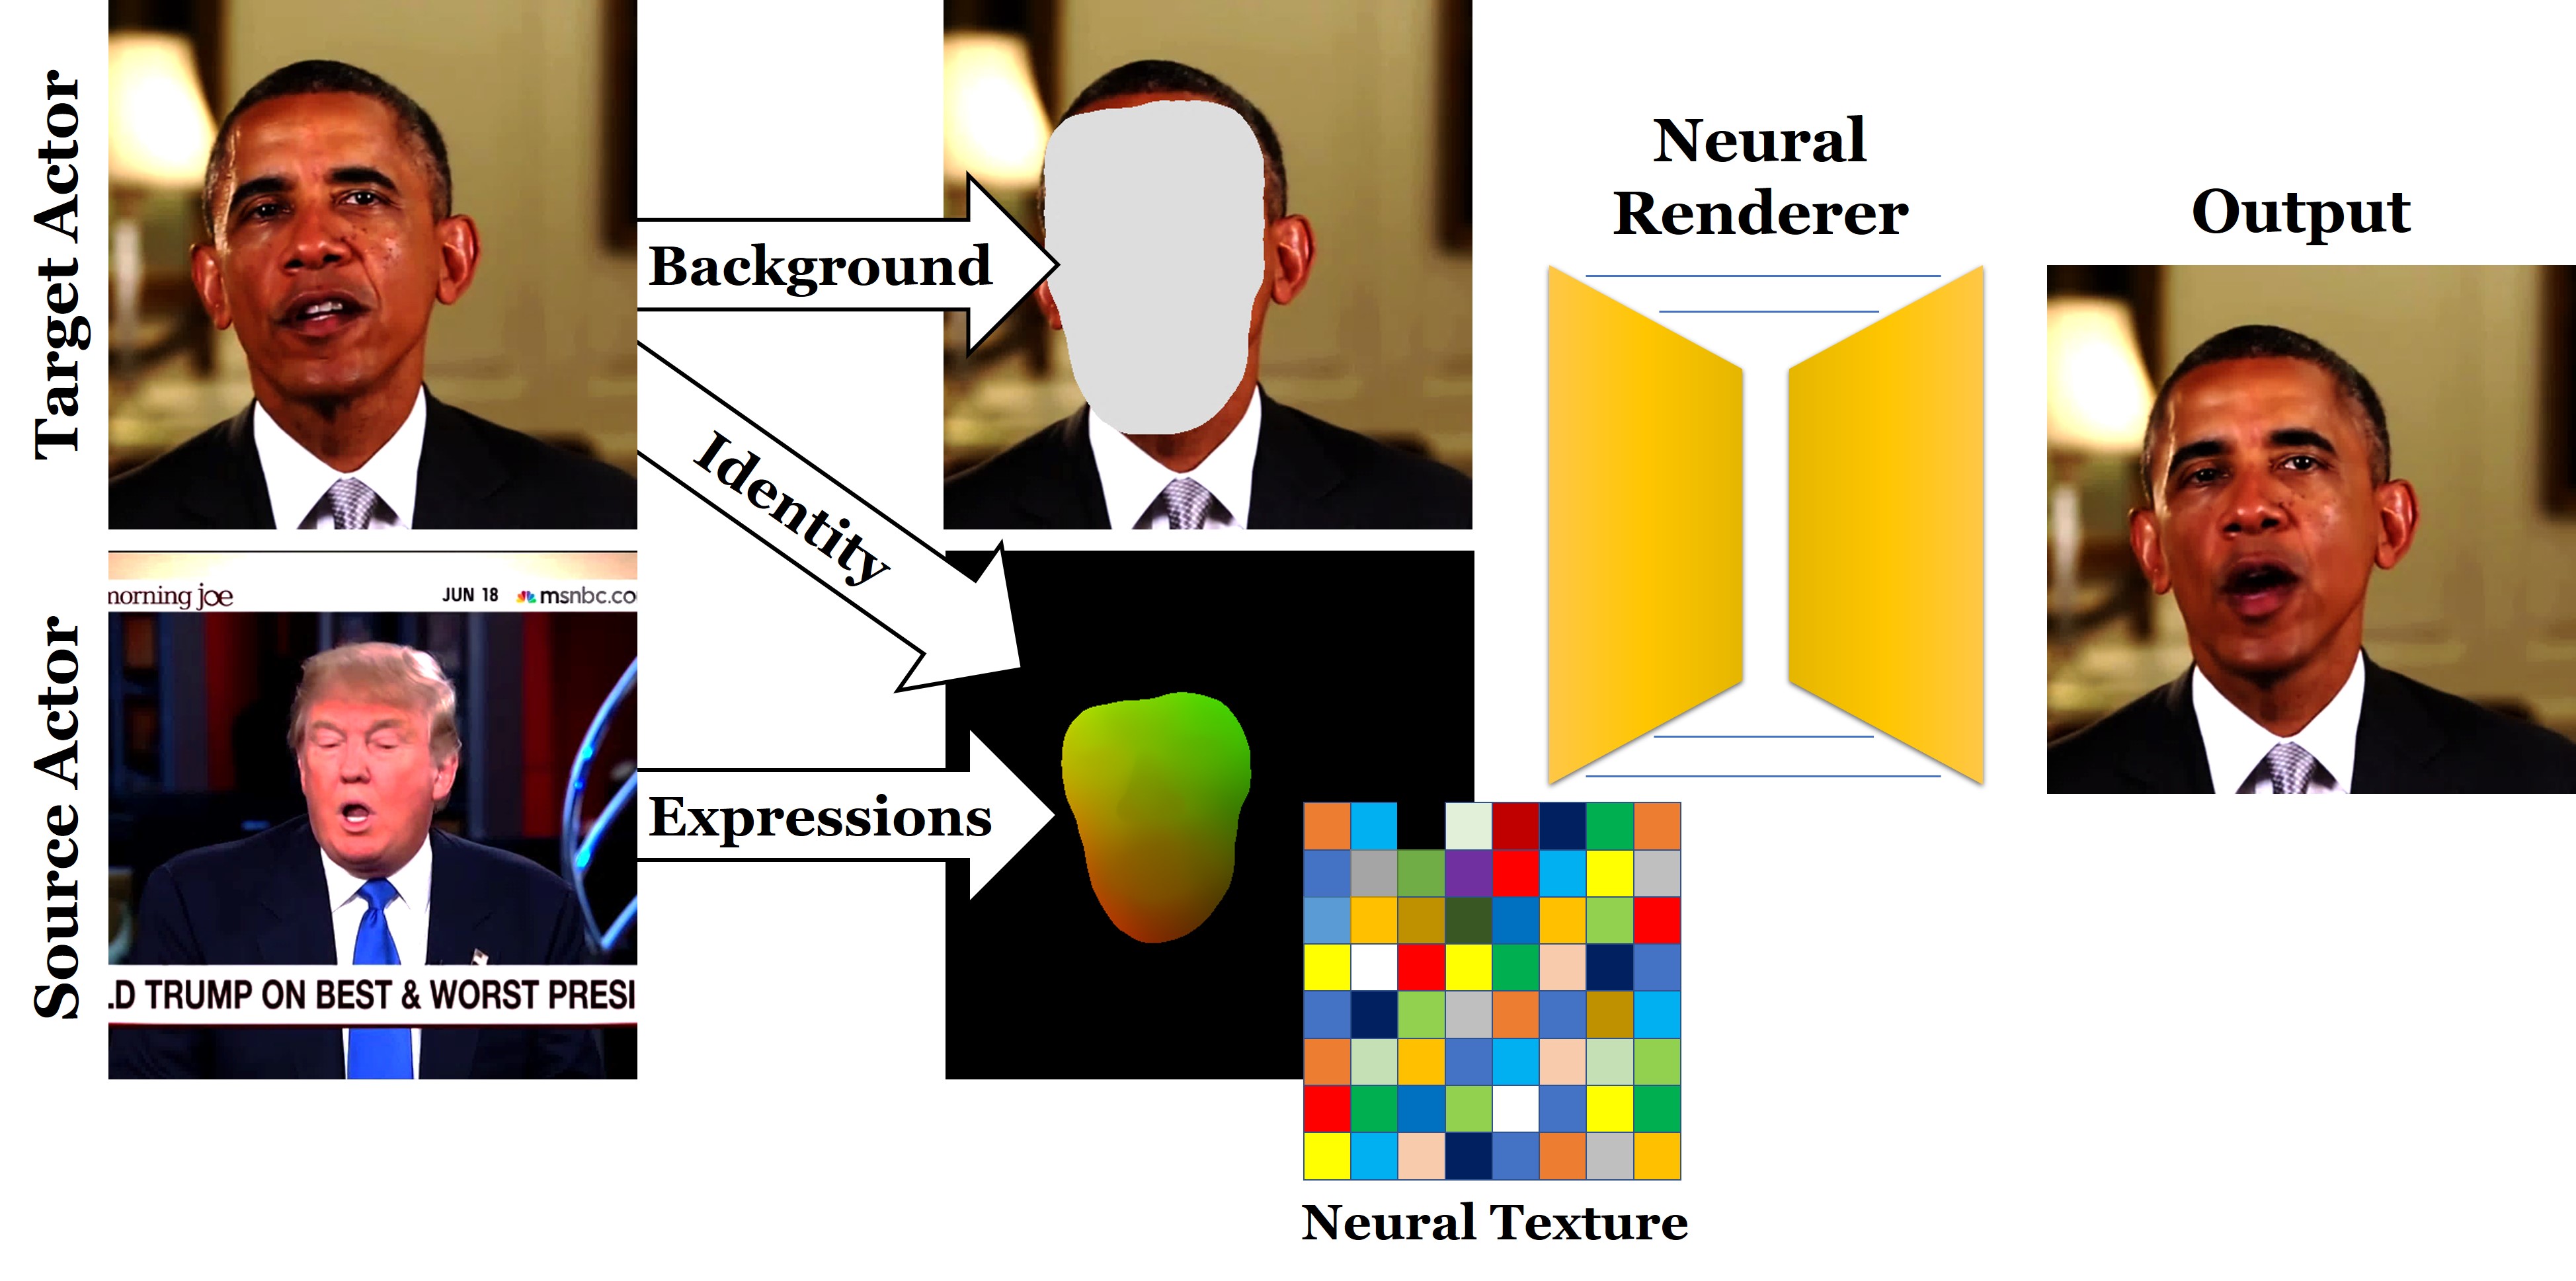
新相机先光栅化 proxy 并产生 UV lookup;场景编辑直接修改几何并保留顶点 UV;人脸重演使用 Face2Face 的 expression transfer 生成目标演员的新 UV map,并另给背景图。
这条式子把场景表征和成像函数放进同一优化。论文进一步将 \(\mathcal L\) 实例化为随机位置、随机尺度裁剪上的 \(\ell_1\) 重建误差;它没有使用 GAN、perceptual loss 或显式 temporal loss。
这是本页依据算法过程写出的等价展开:\(U\) 表示 proxy 在相机 \(\mathbf p_k\) 下的 UV lookup,\(S\) 表示多层纹理的双线性采样与求和,\(\gamma(\mathbf d_k)\) 表示视线方向的 spherical harmonics 特征。第二条不是论文编号公式。
Texture space 记忆,screen space 修复
为什么称为 deferred
传统 deferred rendering 先把几何属性写入屏幕空间 G-buffer,再统一 shading。本文先生成学习到的 screen-space feature buffer,然后用 U-Net 延后解释这些特征。网络工作在图像空间,因此能利用邻域。
训练与推理一致性
训练阶段预计算 UV map,推理阶段由 rasterizer 实时生成 UV map。论文强调两者模拟同一 graphics pipeline 操作,使前向与反向训练所见的采样过程匹配测试时的 lookup。
16 个通道没有预设物理语义
传统纹理的 RGB、normal、roughness 由人定义;Neural Texture 的通道由重建任务自动形成。论文允许给前 3 个通道增加中间重建约束,使其接近平均颜色,其他通道继续作为 renderer 可解释的 latent surface features。
Hierarchy
默认使用 \(K=4\) 个分辨率层。对相同归一化 UV 坐标,在每层执行双线性采样,然后将所有层的采样结果相加,形成 Laplacian-pyramid 风格特征。
频率分配
粗层不施加正则,越细层施加越强的 \(\ell_2\) regularization。软约束促使低频外观进入粗层、高频细节进入细层;网络同时学习如何组合这些层并抑制 aliasing。
Minification
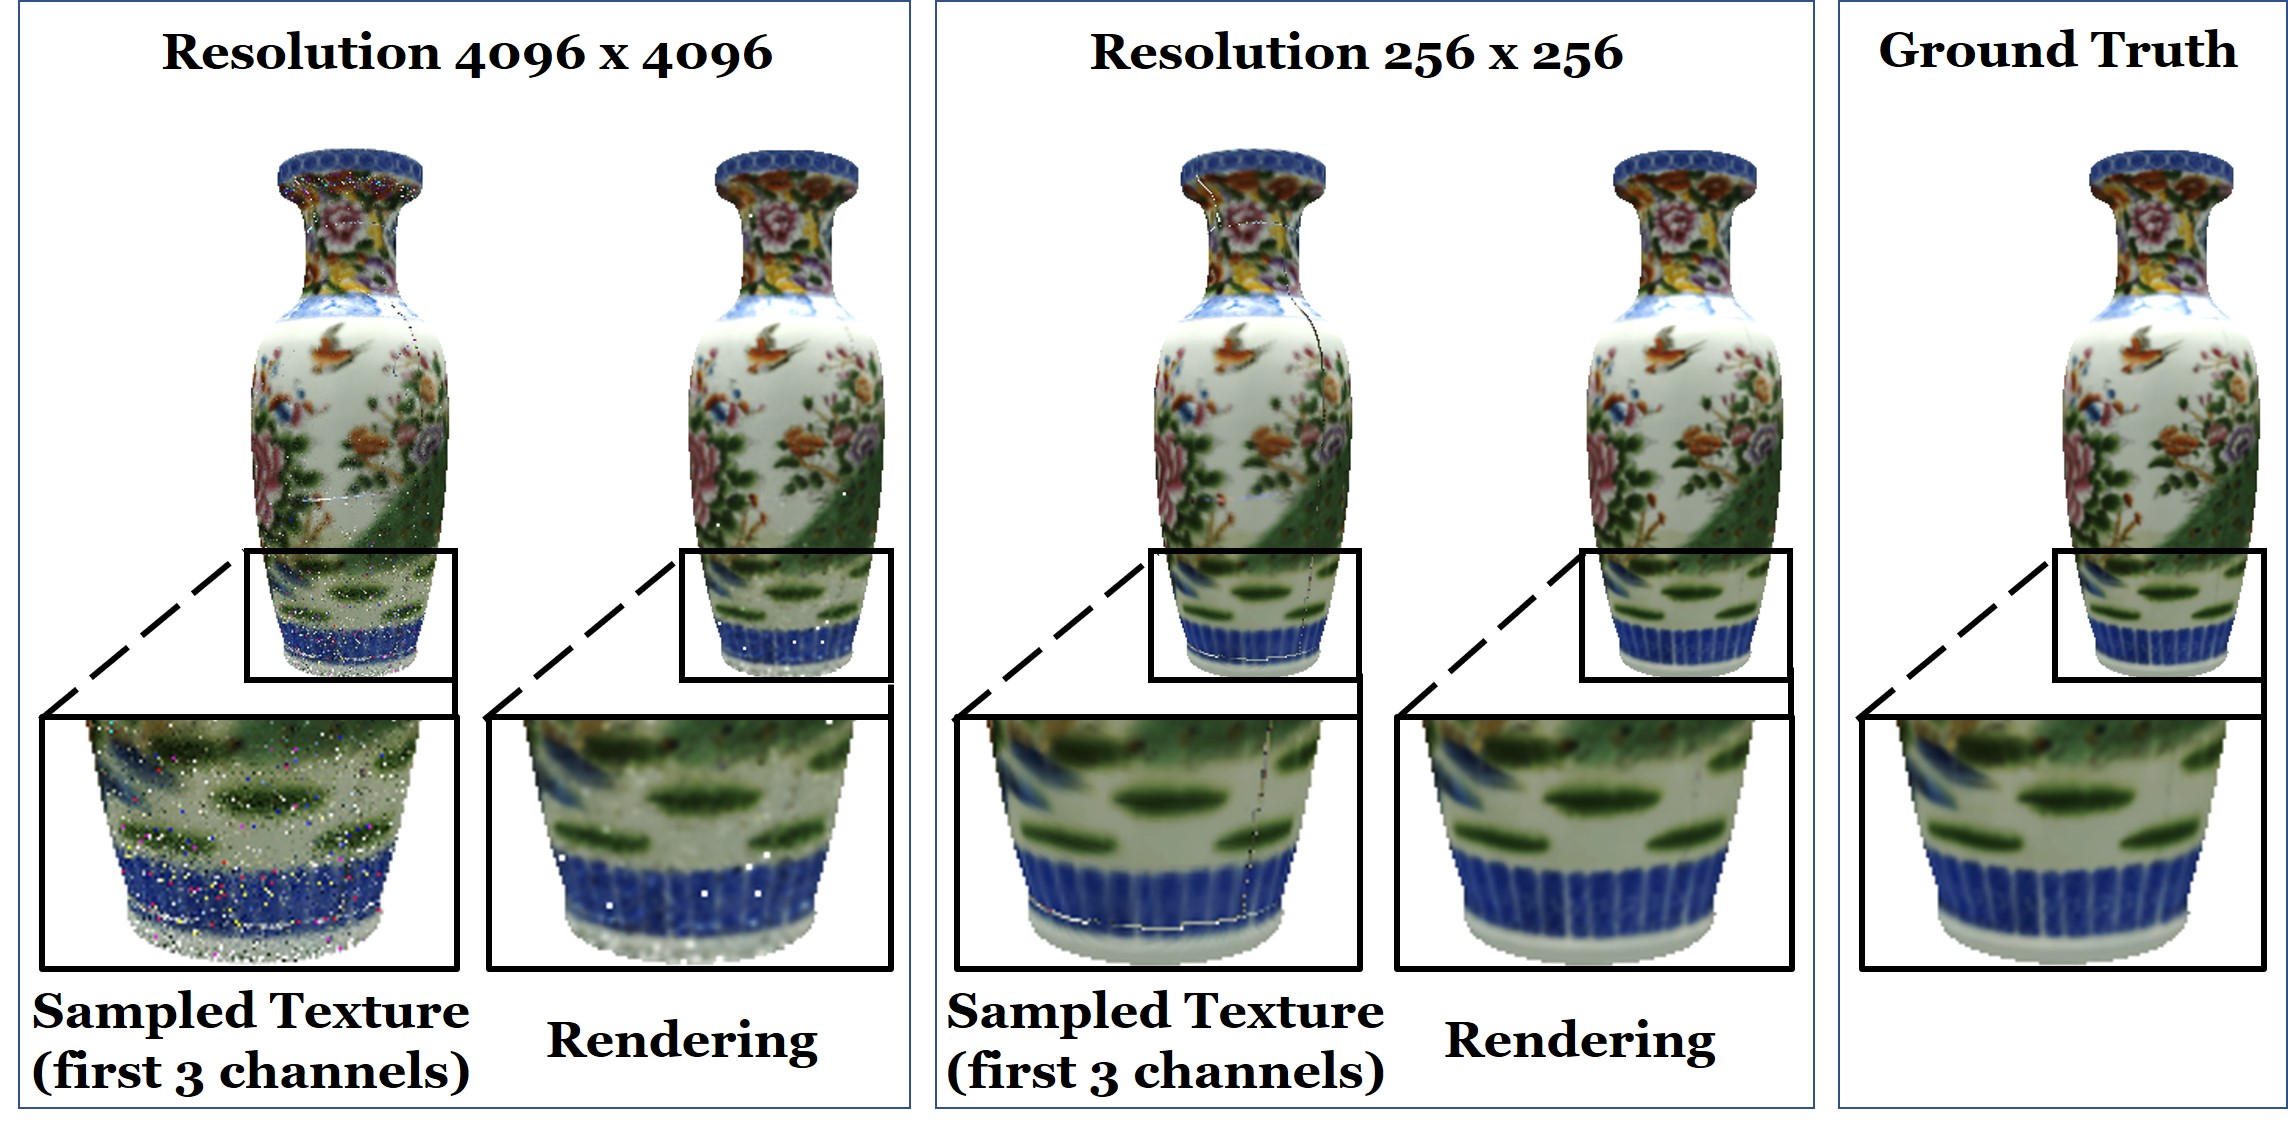
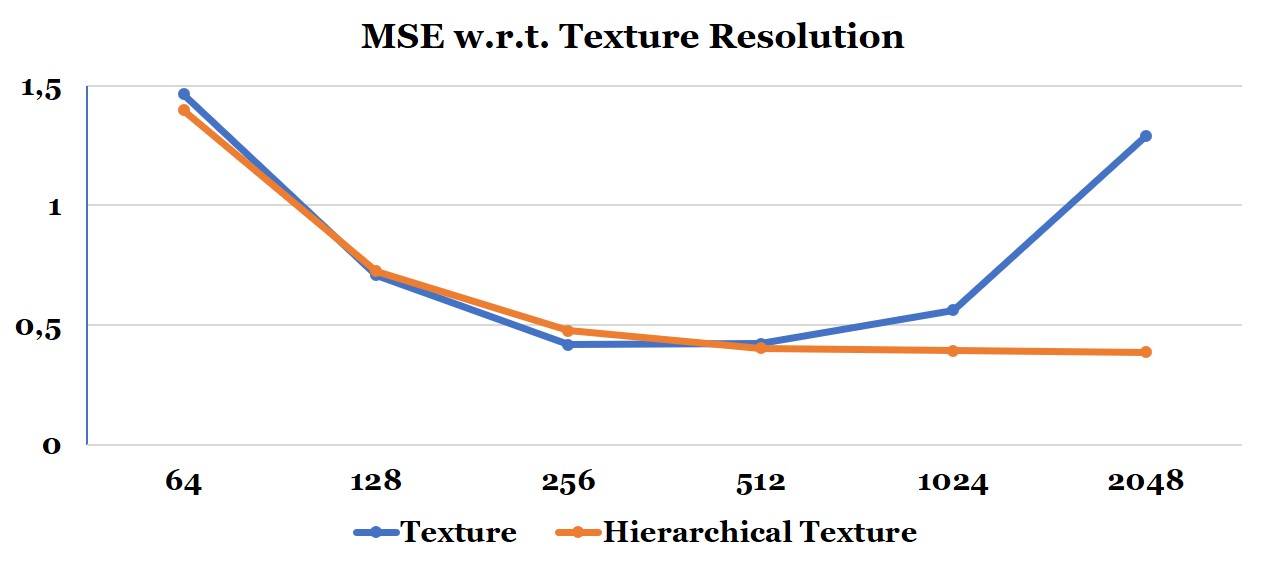
高分辨率 texture 在远处被欠采样。单层提高分辨率虽增加容量,也会让近处 magnification 时采到训练中未充分更新的 texels,形成过拟合与采样伪影。
可微采样
对 texel 邻域使用双线性权重,梯度从像素损失回传到四个邻近 texels。proxy 的 topology 与 UV 在本文中固定,论文没有联合优化网格或 UV seam。
这是对 Section 4.2–4.3 的显式化。论文用文字定义逐层采样与求和,没有给它单独的编号公式。
U-Net 用局部上下文补偿几何误差
| 阶段 | 输入 → 输出通道 | Kernel / stride | Normalization | Activation |
|---|---|---|---|---|
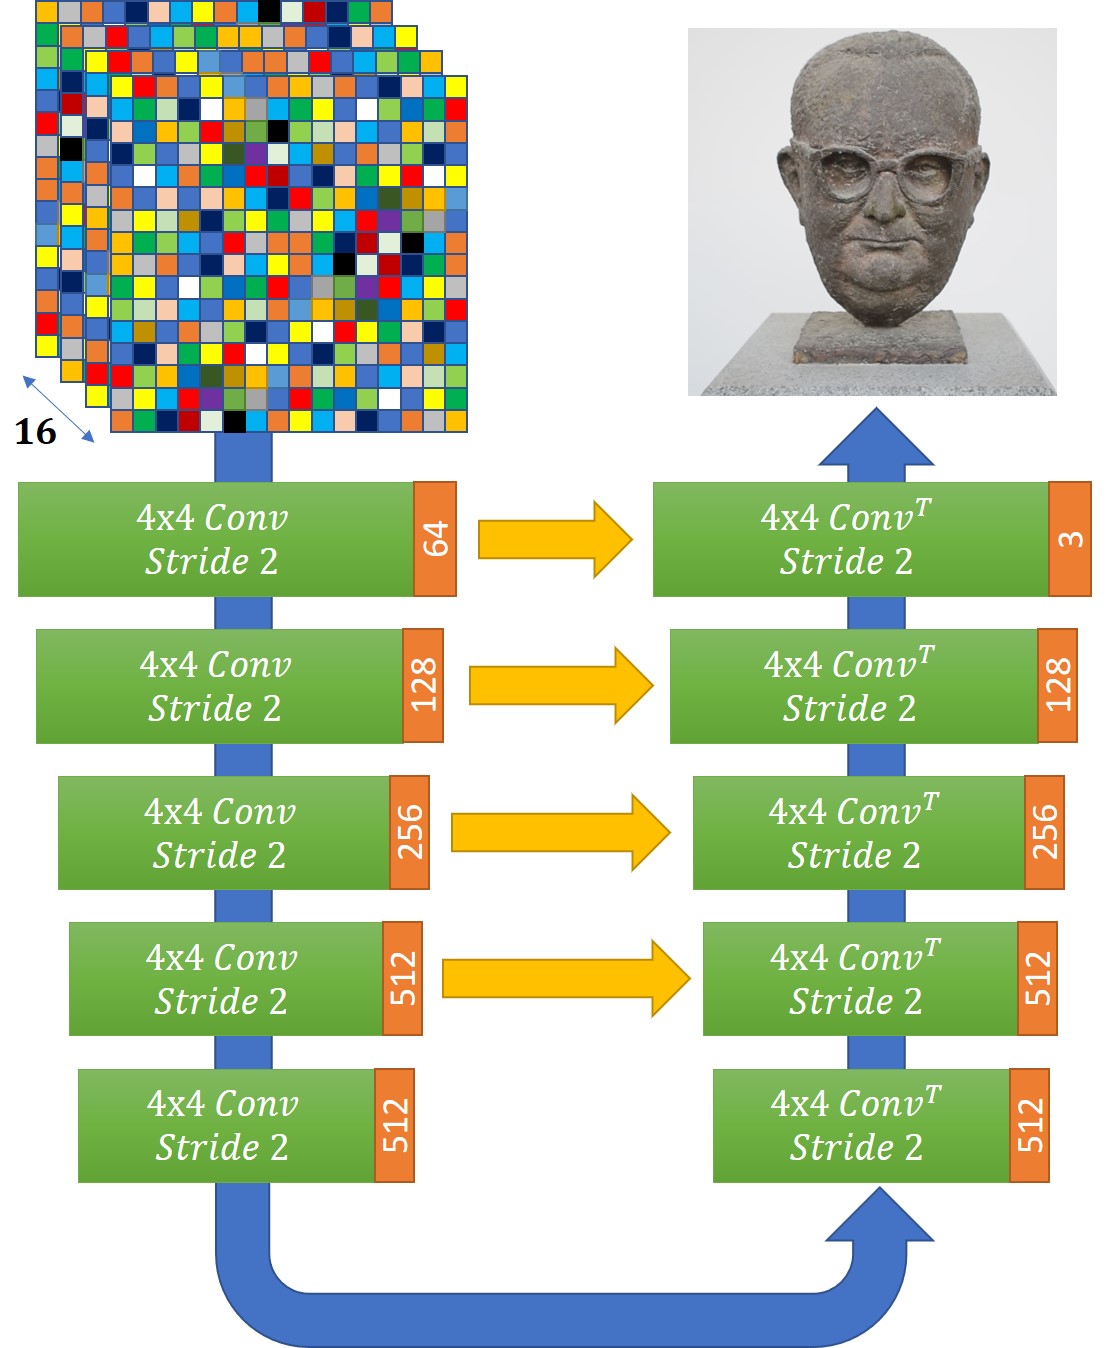
| Encoder 1 | 16 → 64 | \(4\times4\) / 2 | InstanceNorm | LeakyReLU 0.2 |
| Encoder 2 | 64 → 128 | \(4\times4\) / 2 | InstanceNorm | LeakyReLU 0.2 |
| Encoder 3 | 128 → 256 | \(4\times4\) / 2 | InstanceNorm | LeakyReLU 0.2 |
| Encoder 4 | 256 → 512 | \(4\times4\) / 2 | InstanceNorm | LeakyReLU 0.2 |
| Encoder 5 | 512 → 512 | \(4\times4\) / 2 | InstanceNorm | LeakyReLU 0.2 |
| Decoder | 镜像 encoder,带 skip connections | \(4\times4\) / 2 | 论文未逐层另述 | 最终 Tanh |
视角相关通道
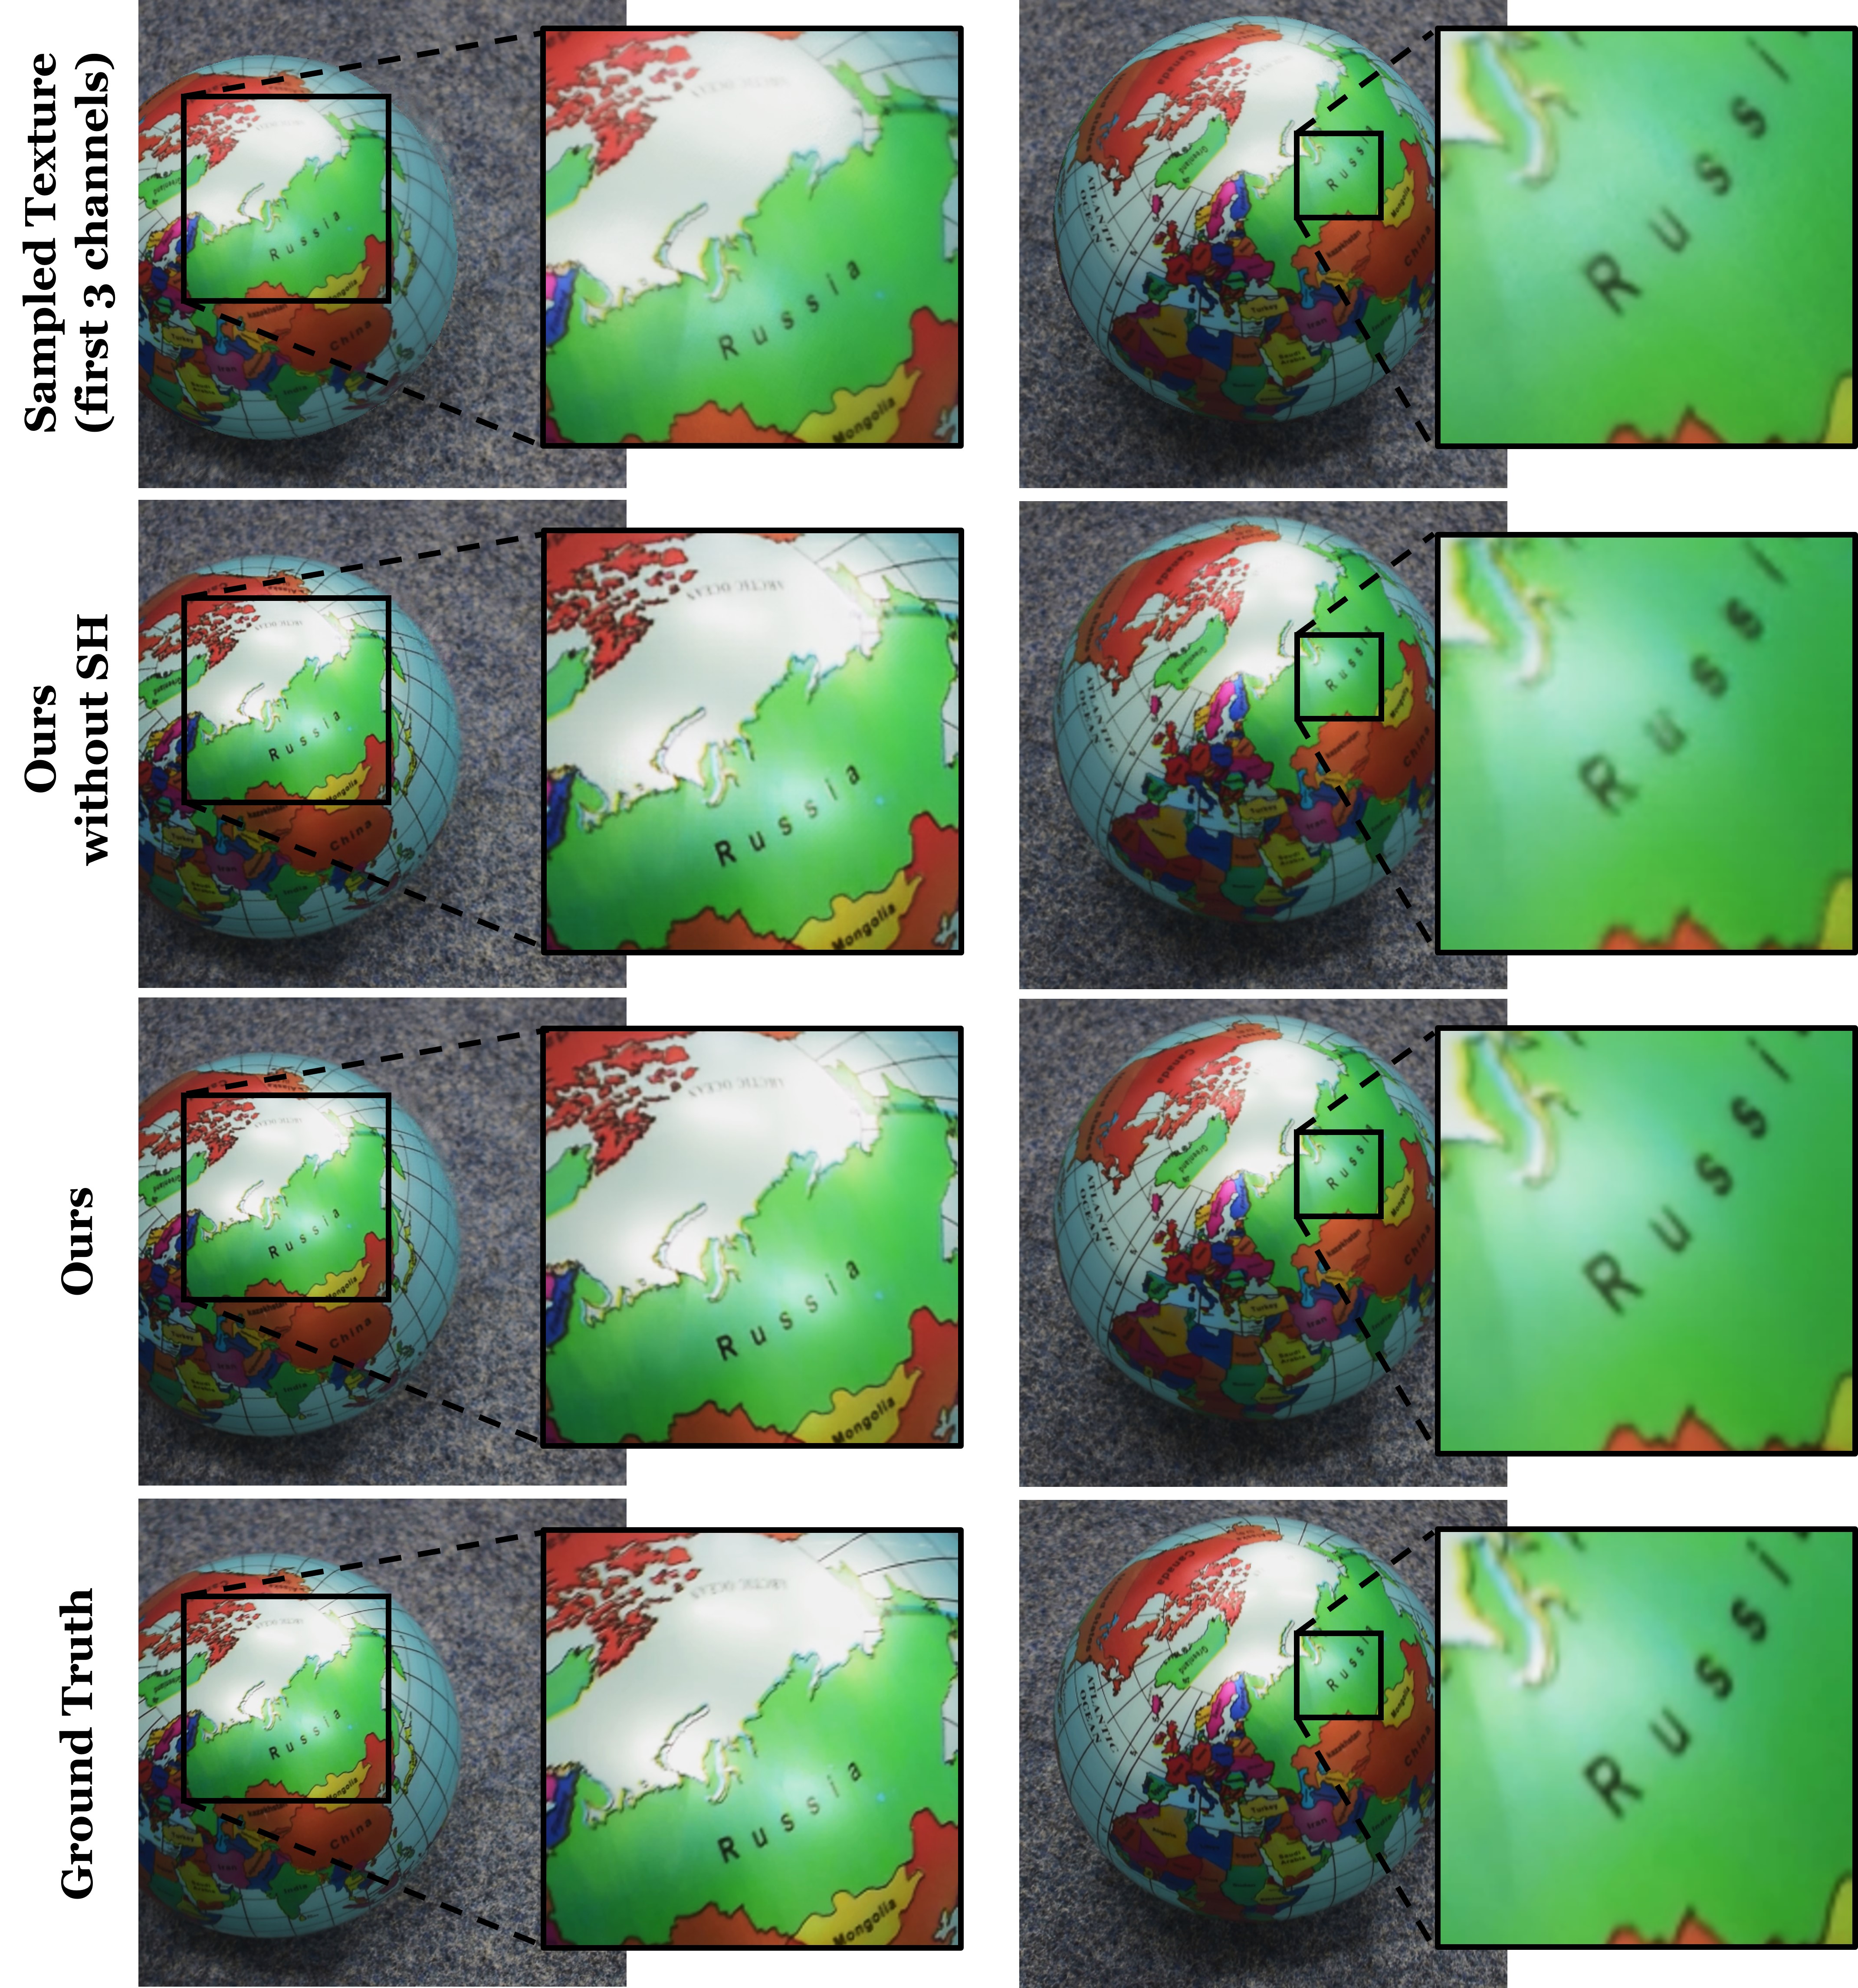
作者用前三阶 spherical harmonics basis,得到 9 个方向特征图;网络前先把采样特征与这些 basis 相乘,以表达 specular highlight 随视角变化。正文写“feature channels 4–13”,按通常包含端点的计数会得到 10 个通道,和 9 个 basis 不一致。论文没有进一步消除这个编号歧义。
监督来自同一段视频的 RGB 帧
实拍采集
DSLR 以 \(1920\times1080\)、30 Hz 采集。COLMAP 估计相机与 coarse geometry;每第 25 帧参与 dense reconstruction,其余帧注册到该重建。UV 使用 Microsoft UVAtlas。
合成数据
Artec3D objects:1000 个半球随机训练视角与 1000 帧平滑测试轨迹。完整训练集到最近训练视角的平均角差 \(2.13^\circ\),范围 \(0.04^\circ\)–\(6.60^\circ\)。
真实序列
依任务使用 800–1700 帧。论文举例:800 帧序列平均最近角差 \(0.92^\circ\),1700 帧序列为 \(0.85^\circ\)。这些角差忽略相机位置变化。
人脸序列
Macron 650 帧,Obama 2400 帧,Figure 17 序列 2400 帧。作者指出表情覆盖不足会降低可重演的表情丰富度。
| 项目 | 论文设置 | 复现含义 |
|---|---|---|
| Texture | \(512\times512\),4 hierarchy levels,16 features / texel | 对象专属可训练参数 |
| Renderer | 5-layer U-Net,约 16M 参数 | 对象或人物专属网络 |
| Loss | 随机位置与随机尺度 crop 上的 \(\ell_1\) | 裁剪与缩放同时承担 augmentation |
| Optimizer | Adam,learning rate \(0.001\) | texture 与 renderer 联合更新 |
| Adam | \(\beta_1=0.9,\ \beta_2=0.999,\ \epsilon=10^{-8}\) | 论文称 default parameters |
| Steps | 约 50k SGD steps | 未给 batch size 与 wall-clock |
| Test | rasterize new UV → sample texture → U-Net RGB | 无需保存训练图像 |
论文的定量证据集中在新视角
Figure 6 · 同一实拍序列的 IBR 比较
| 方法 | 测试时保存内容 | 使用视角 | MSE ↓ | 说明 |
|---|---|---|---|---|
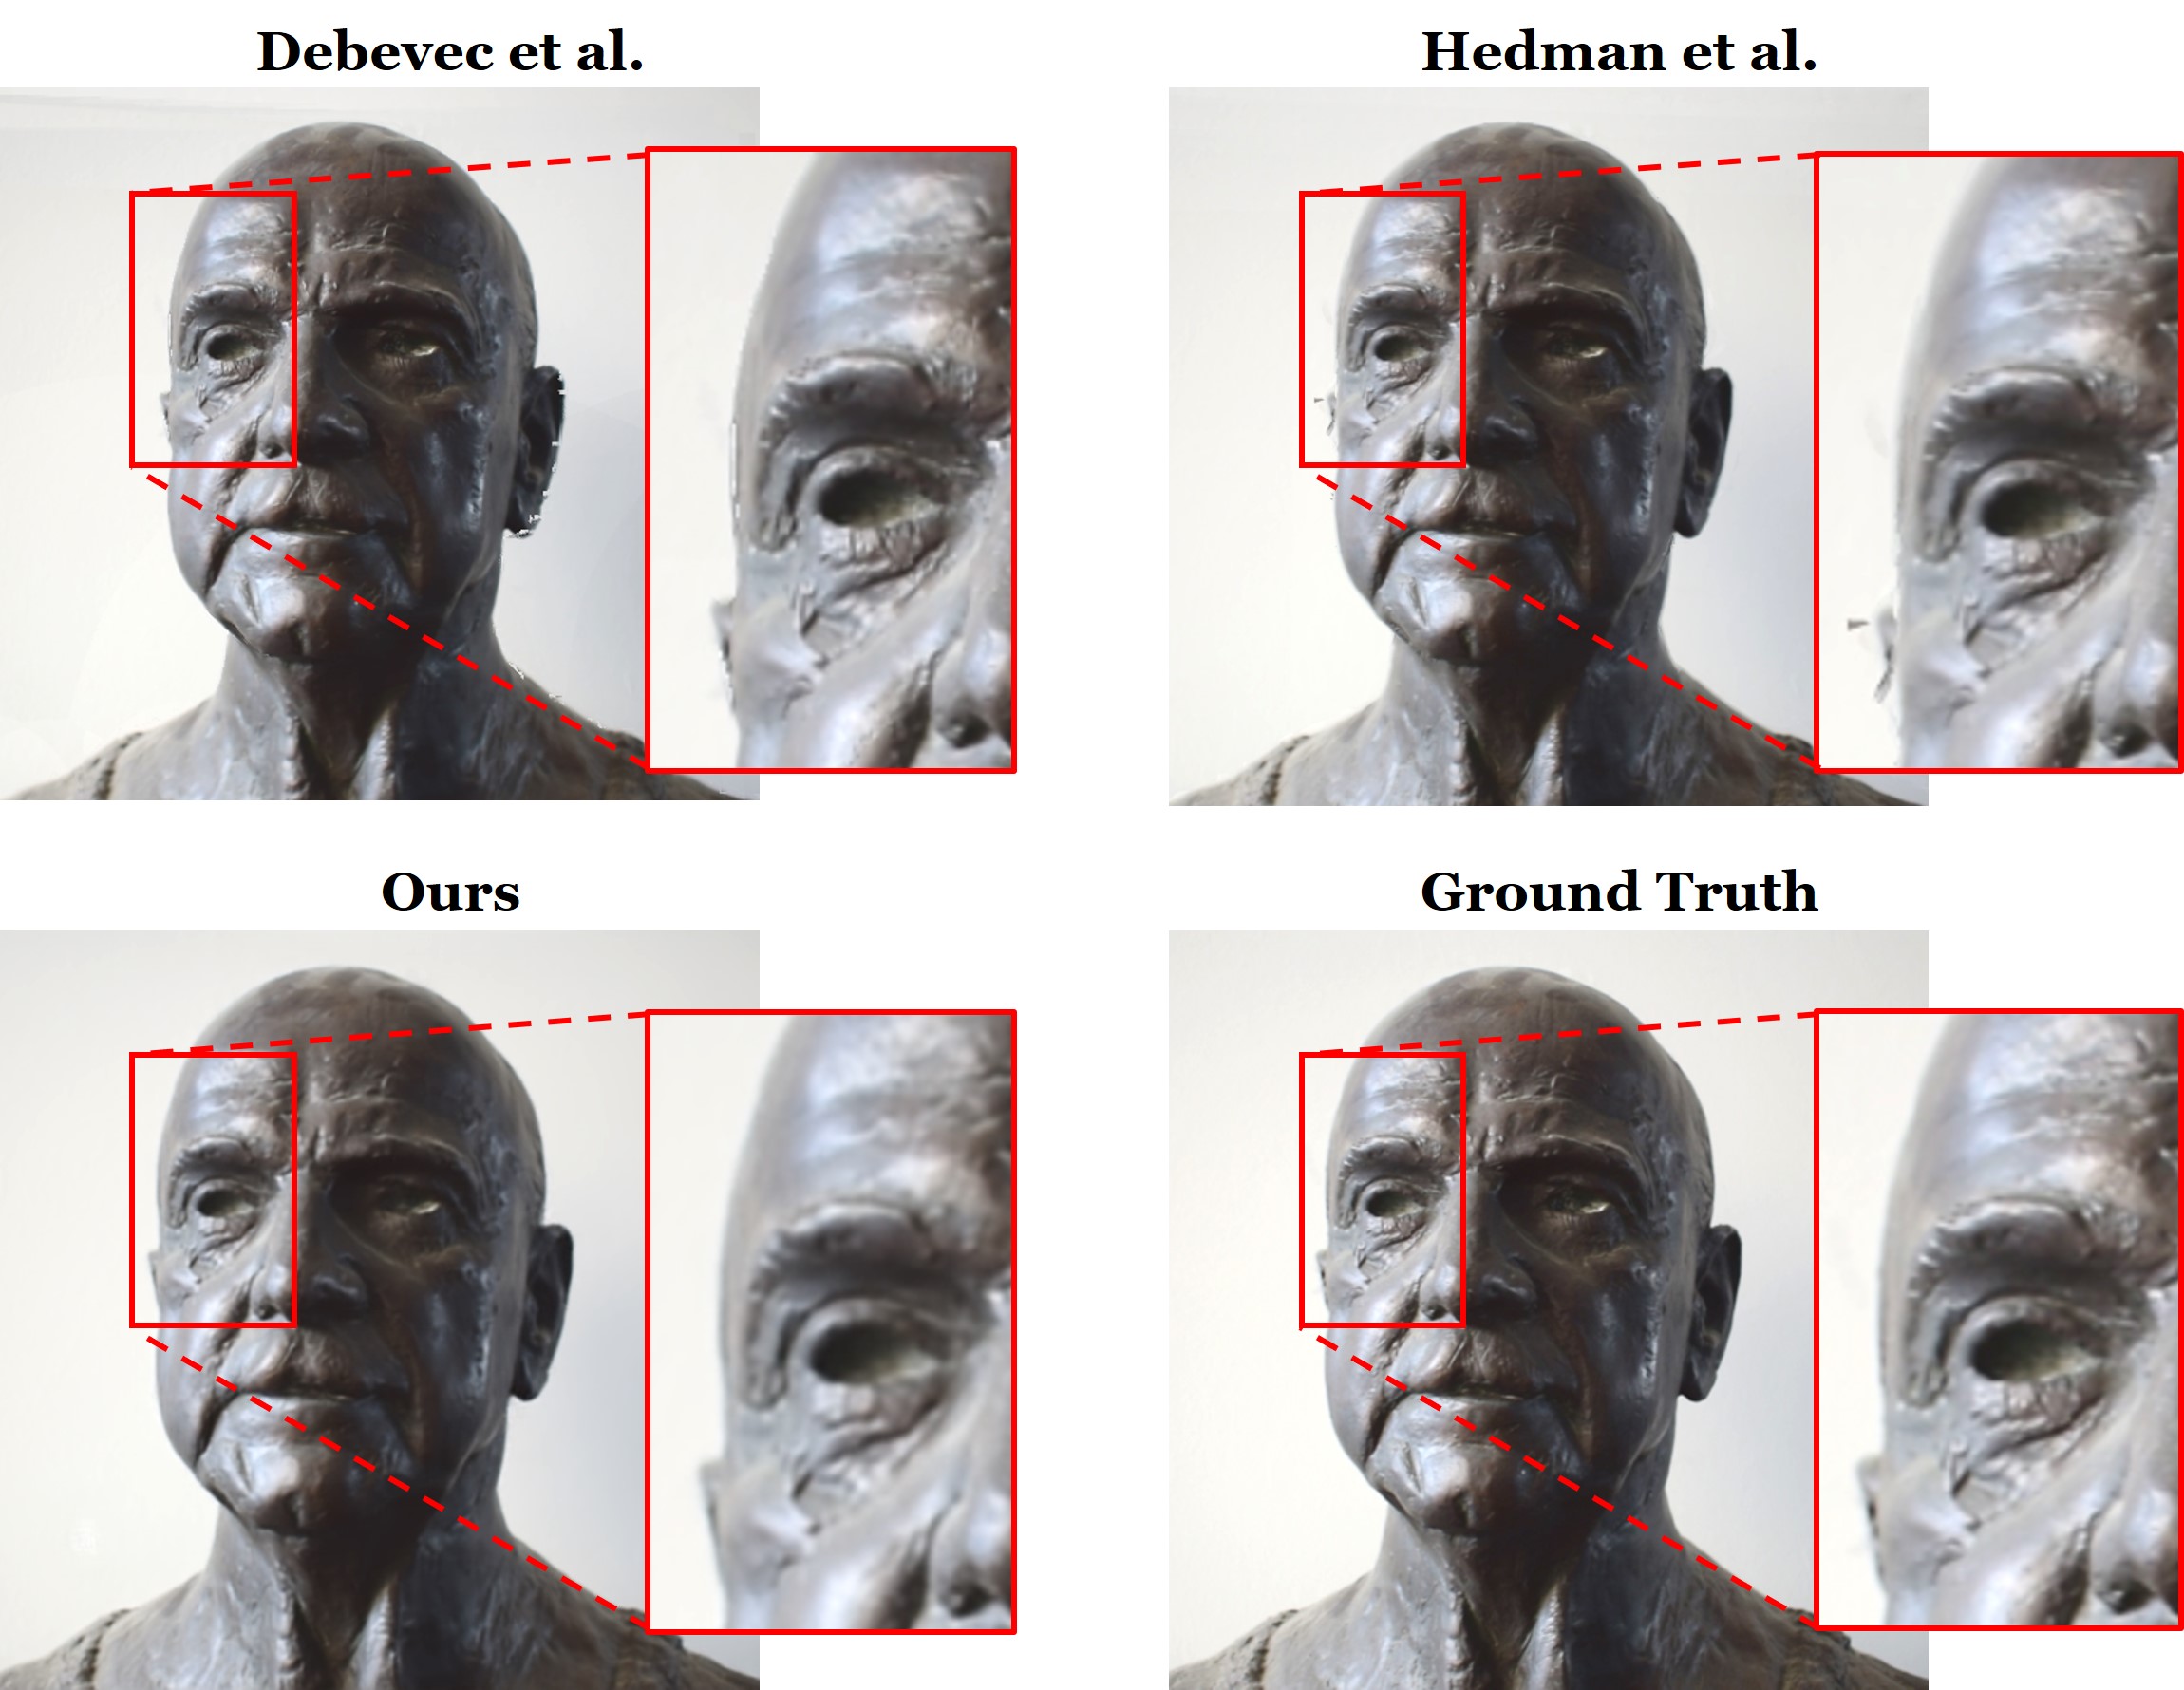
| Debevec et al. IBR | 训练图像 + proxy | 1686 | 37.58 | 作者改为逐像素 nearest-view selection,速度远低于实时 |
| InsideOut / Hedman et al. | 99 帧 RGB + 每帧 depth + proxy | 99 | 28.05 | 仅能使用参与 MVS 的每第 25 帧 |
| Deferred Neural Rendering | \(512\times512\times16\) texture + 16M renderer | 训练 1686 | 20.65 | 测试阶段无需训练图像;每个序列需训练 |
Pix2Pix
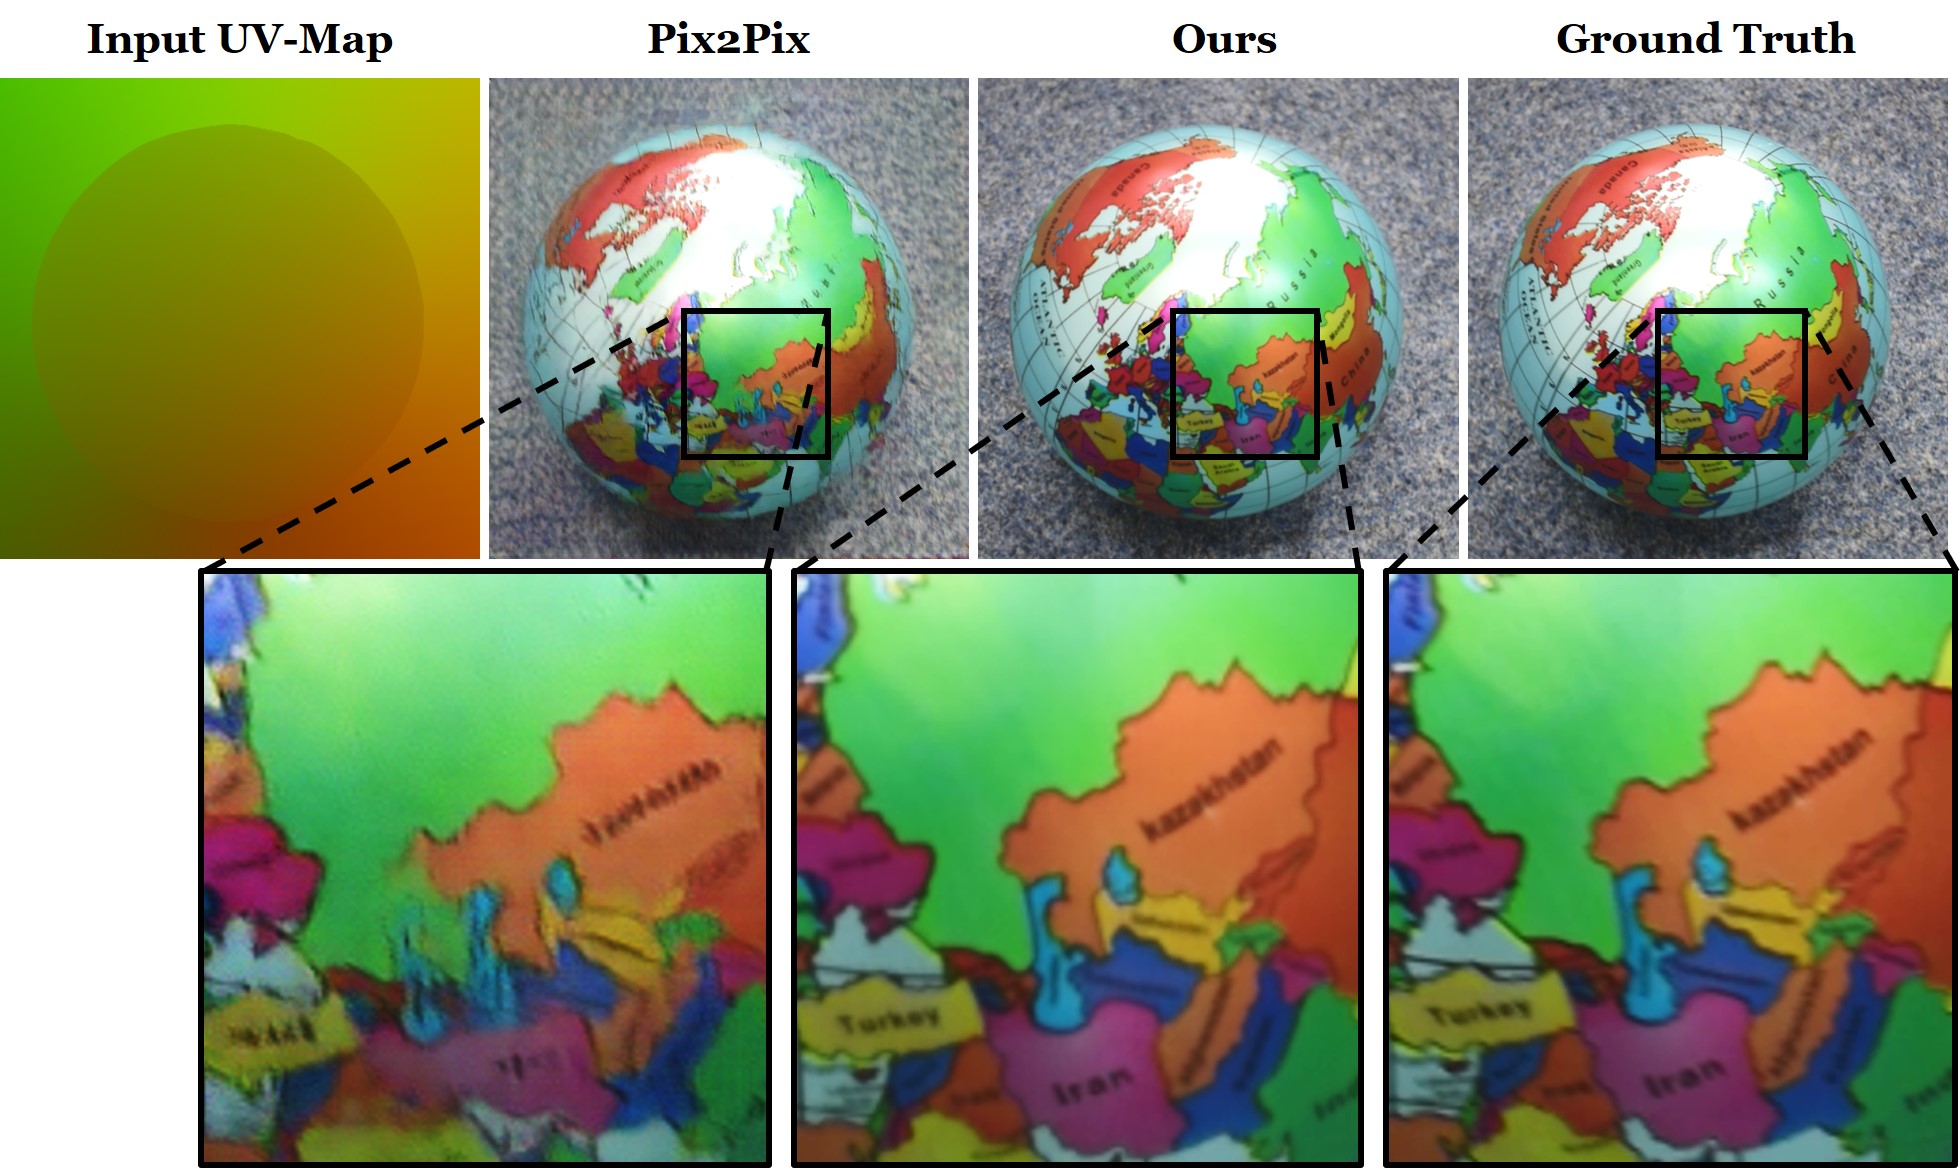
输入同样是 UV map,直接在屏幕空间预测 RGB。Figure 4 显示 Pix2Pix 更模糊;Figure 15 显示几何编辑后泛化较差。论文没有给这两组的数字或 temporal metric。
IGNOR
Figure 5 显示本文更好地重建高频 specular highlights,并称视频更稳定。本文只保存一个 Neural Texture,IGNOR 需要原始参考图像。此比较同样主要为定性。
Scene editing
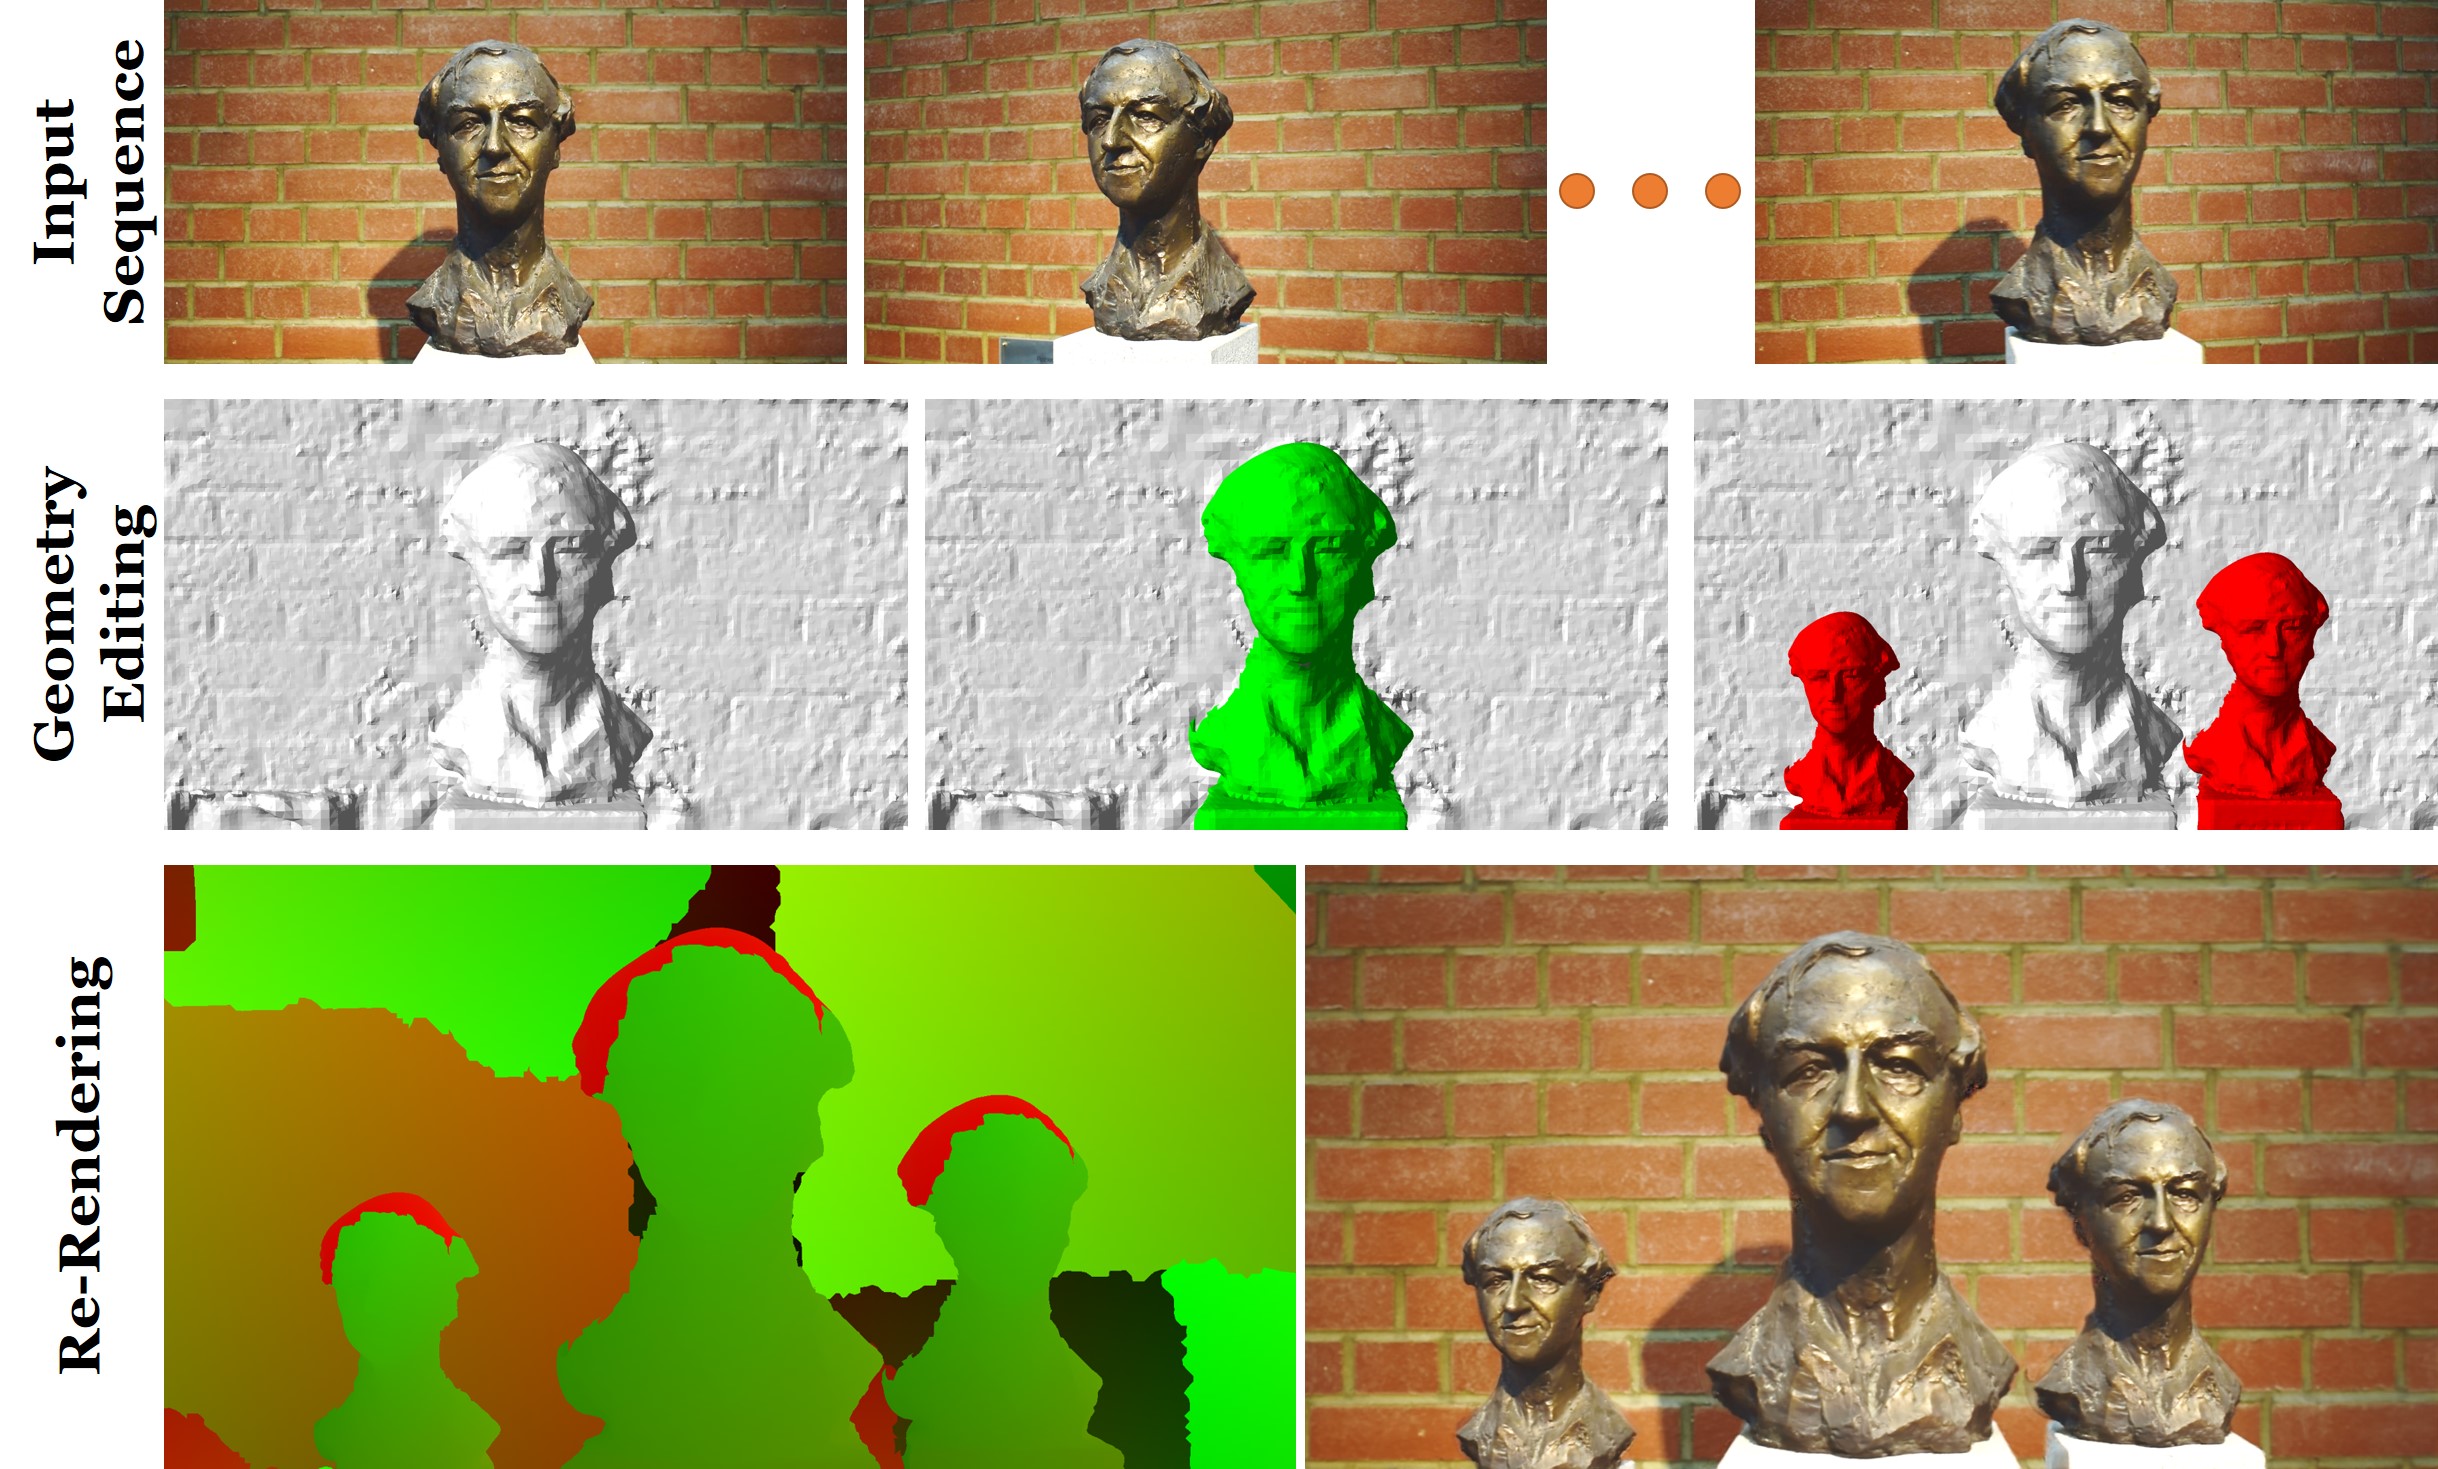
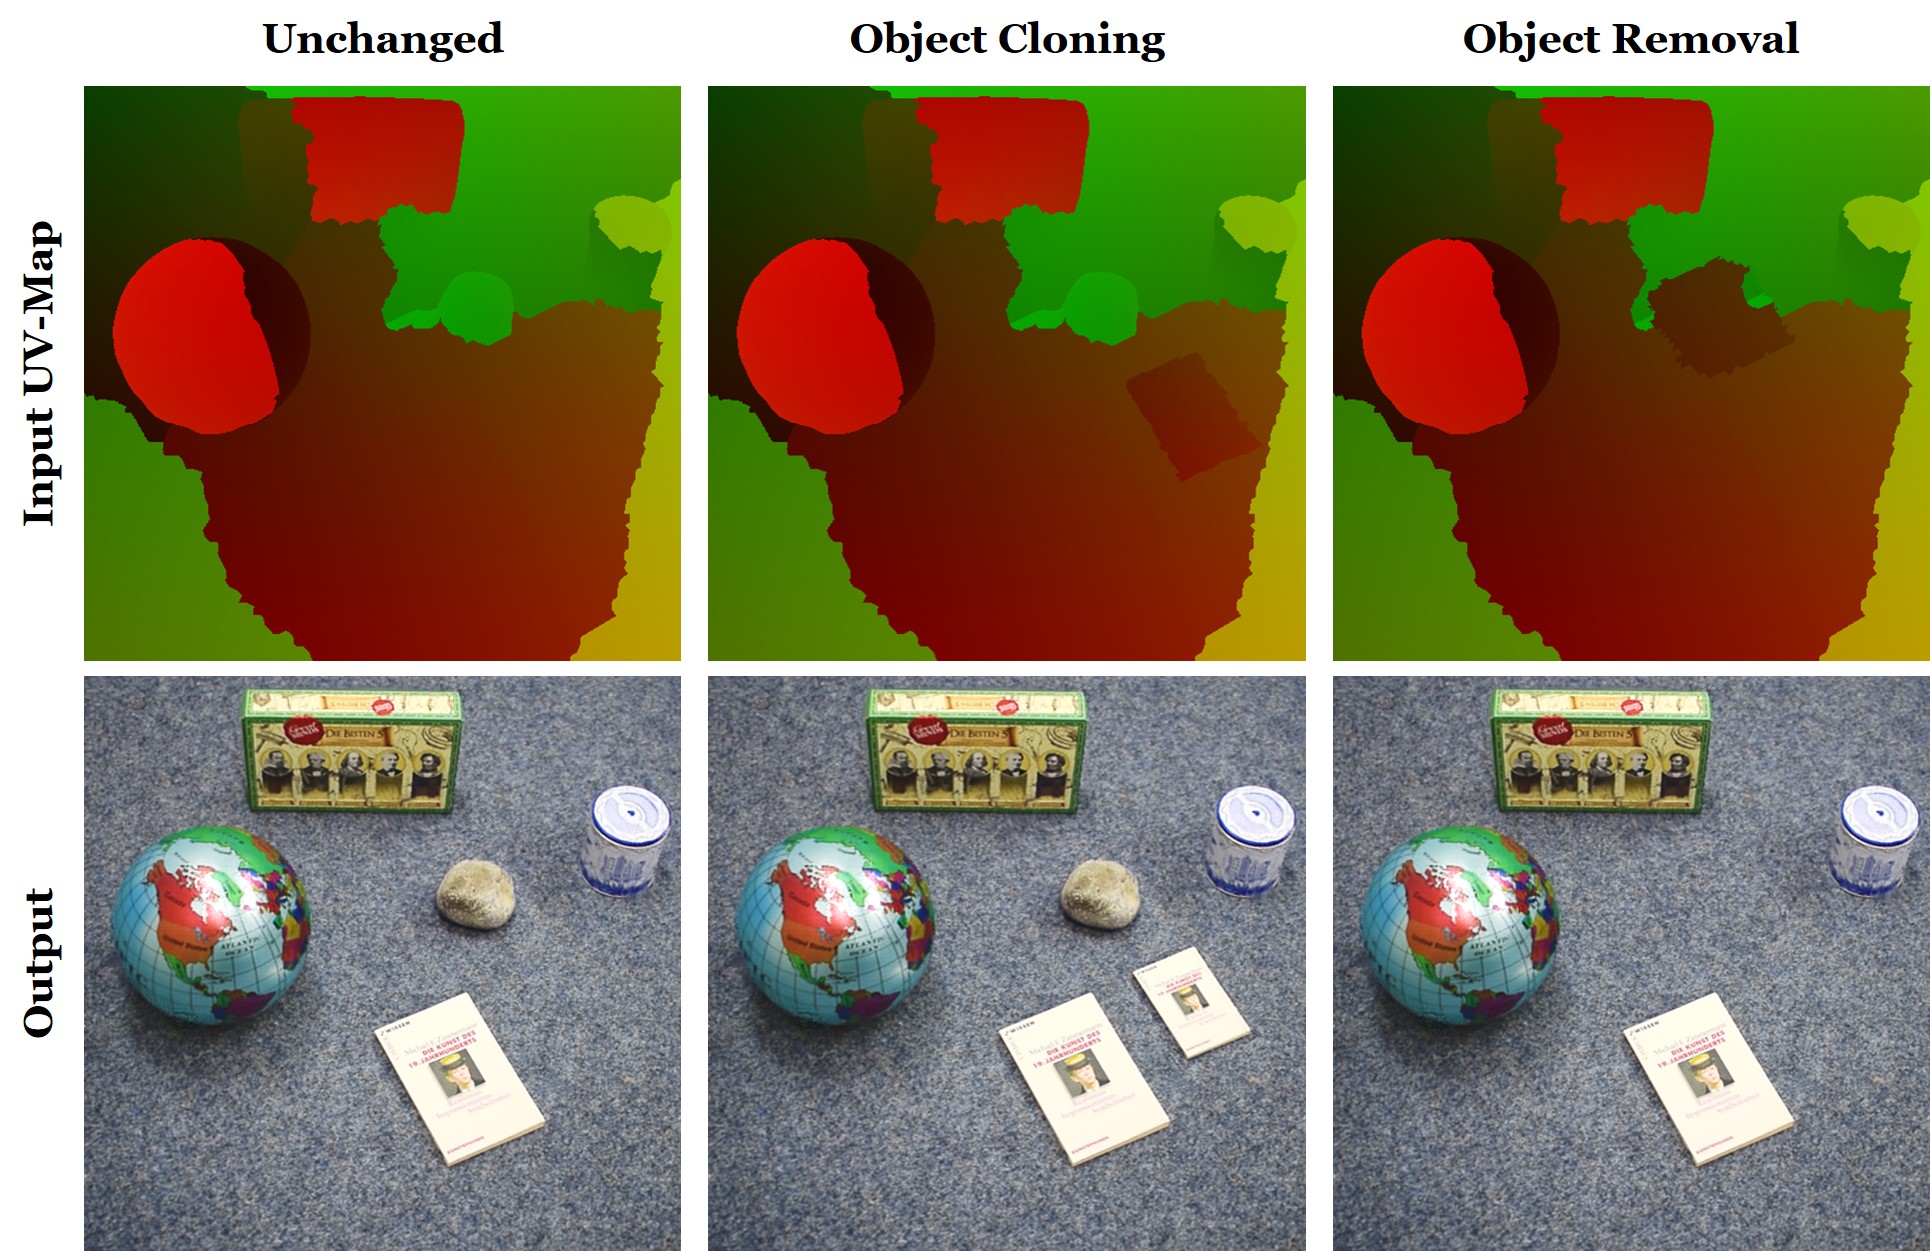
Figure 14–16 展示移动、复制与移除。编辑后的 UV 进入同一个训练 renderer,没有用编辑样本重新训练。论文没有评估大位移、强遮挡变化或新接触阴影。
Facial reenactment
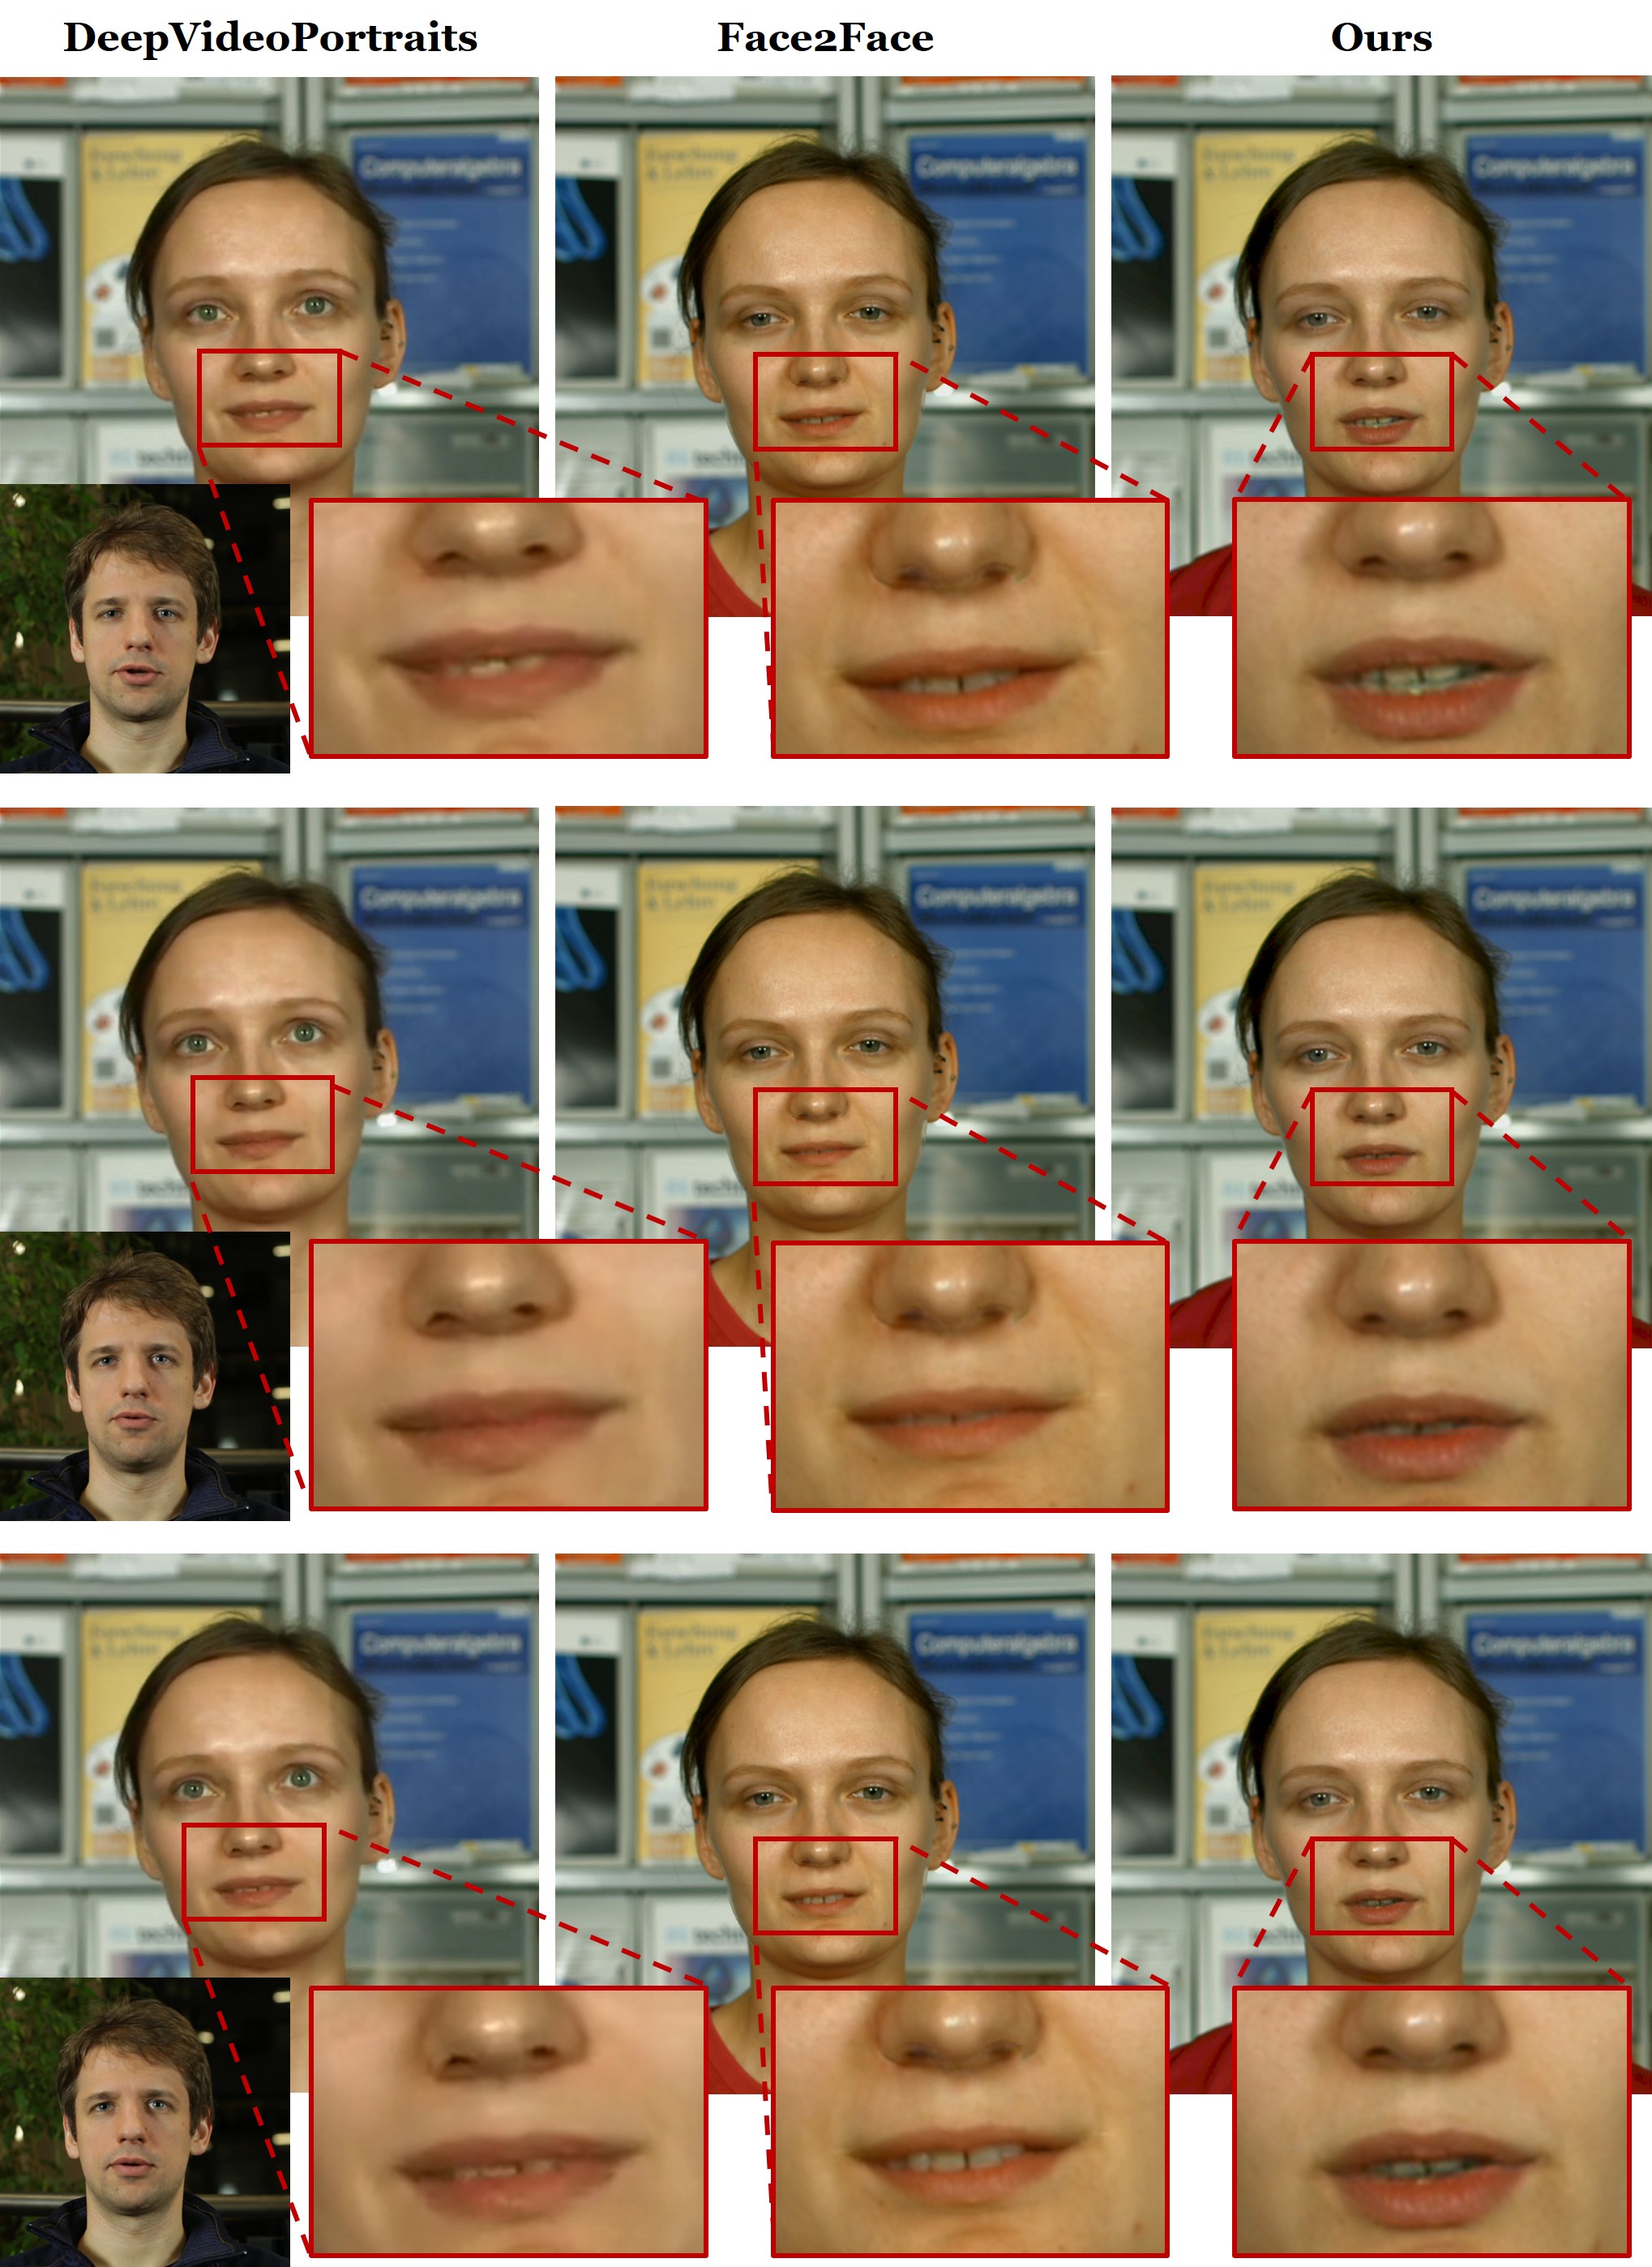
Figure 17 对比 Face2Face 与 DeepVideoPortraits,口腔更锐利、个体特征更丰富。只报告定性图与约 4 ms renderer 时间,没有身份、表情或 temporal 指标。
分辨率、数据、几何、邻域与视角
Texture resolution and hierarchy
| 设置 | Texture resolution | MSE ↓ | 论文结论 |
|---|---|---|---|
| Single texture | \(256\times256\) | 0.418 | 单层 sweet spot |
| Single texture | \(4096\times4096\) | 8.46 | magnification 下未优化 texels 与过拟合 |
| 4-level hierarchy | \(2048\times2048\) | 0.38 | 高分辨率下仍继续改善 |
Number of training images
| 训练图像数 | 最近视角平均角差 | Min / max | MSE ↓ |
|---|---|---|---|
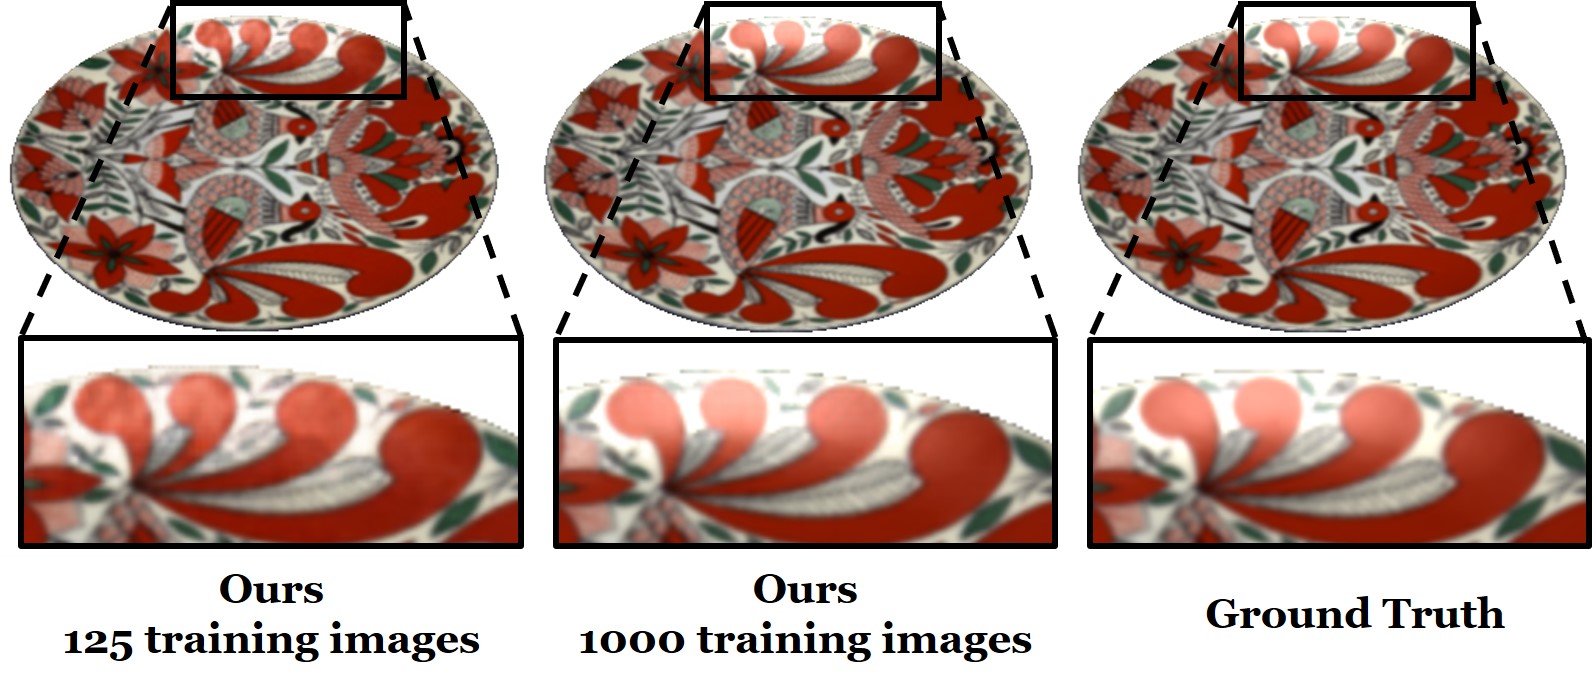
| 1000 | \(2.13^\circ\) | \(0.04^\circ/6.60^\circ\) | 2.2 |
| 500 | \(3.30^\circ\) | \(0.11^\circ/9.76^\circ\) | 2.2 |
| 250 | \(4.4^\circ\) | \(0.11^\circ/12.67^\circ\) | 6.5 |
| 125 | \(6.27^\circ\) | \(0.23^\circ/18.79^\circ\) | 16.9 |
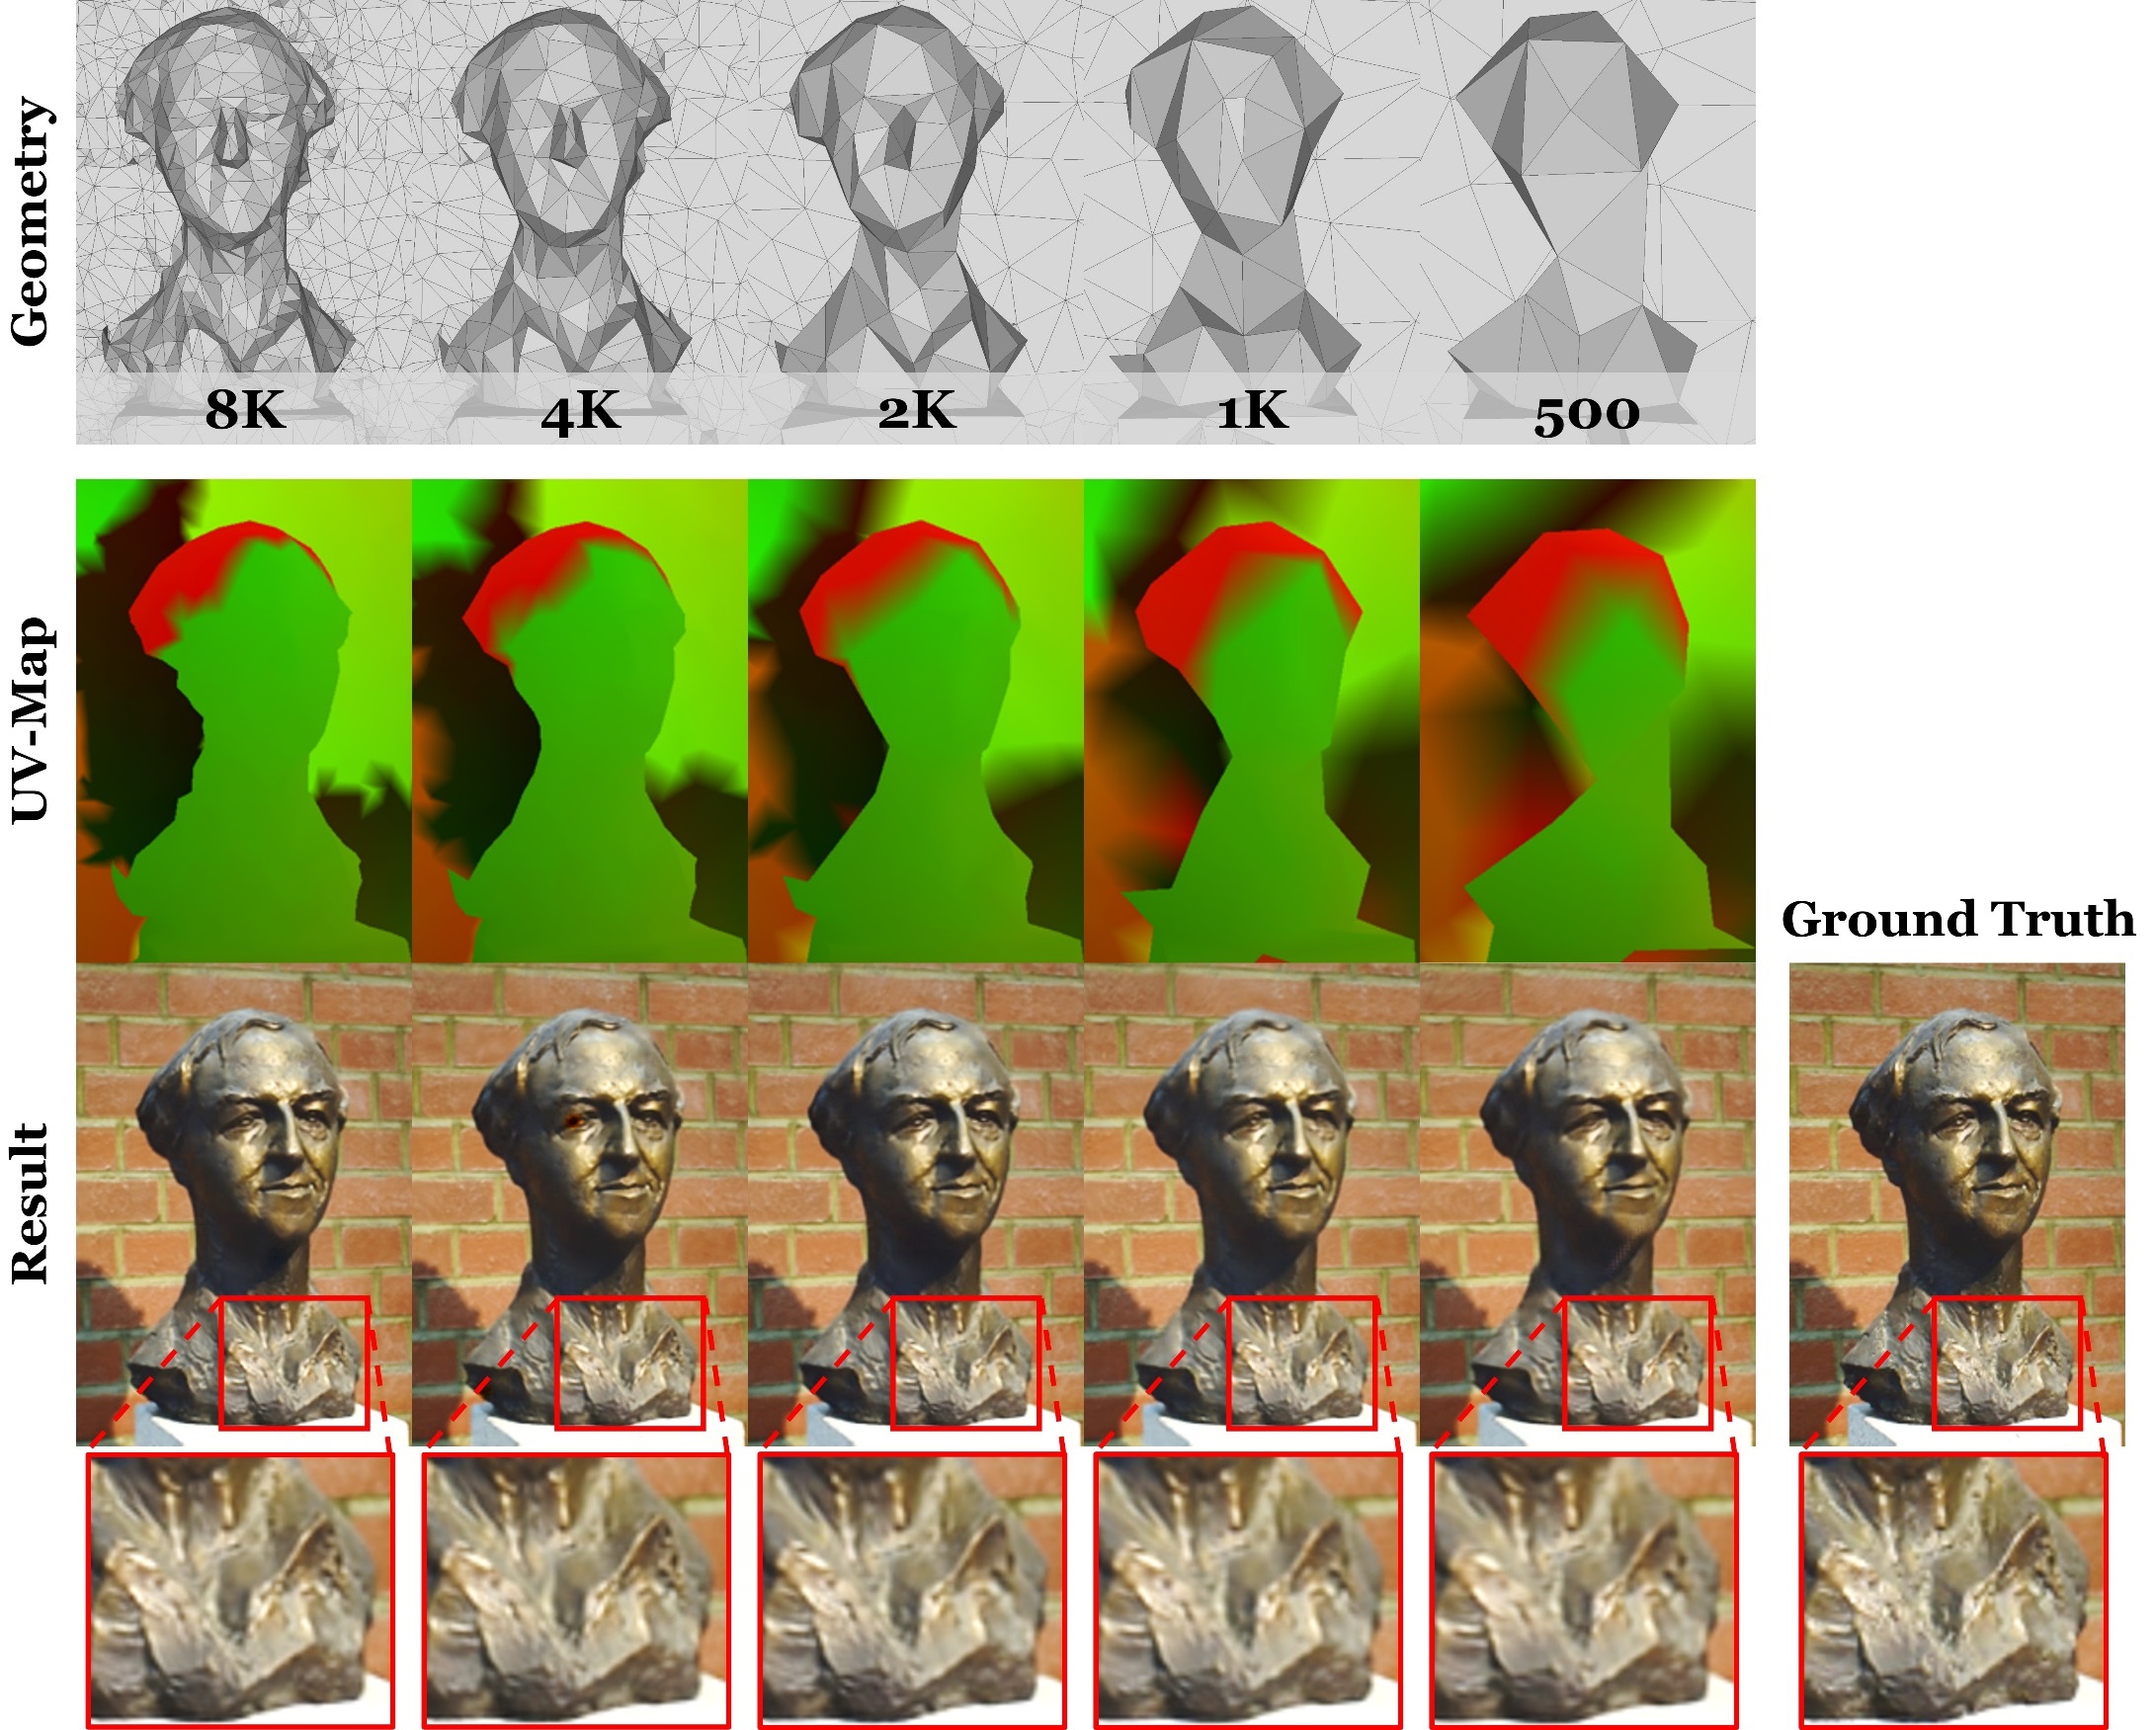
Proxy geometry
| 三角形数量 | 8K | 4K | 2K | 1K | 500 |
|---|---|---|---|---|---|
| MSE ↓ | 11.068 | 11.742 | 12.515 | 18.297 | 18.395 |
Renderer neighborhood and view direction
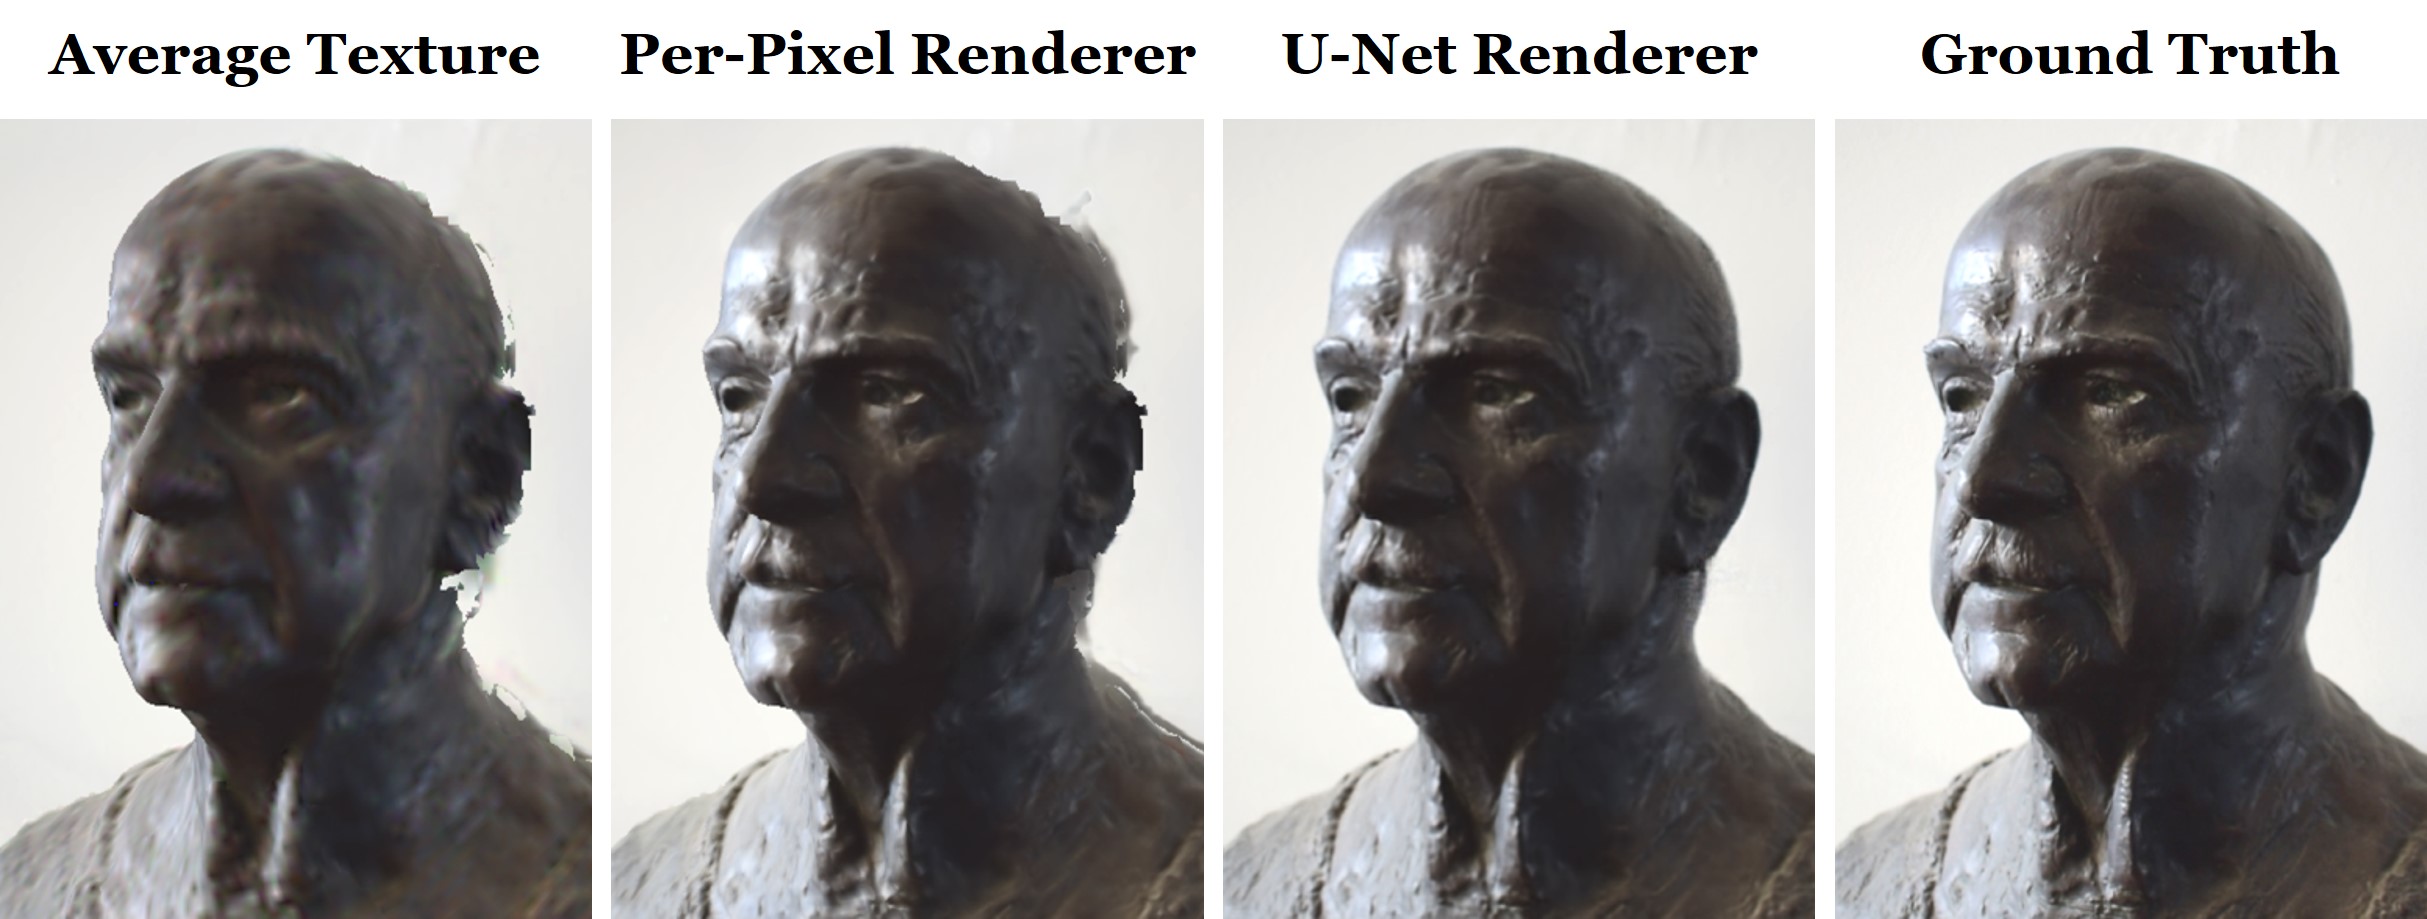
U-Net vs. per-pixel
把所有卷积换成 stride 1 的 \(1\times1\) convolution,保持相近结构。输出更模糊,支持“屏幕空间邻域能修正小几何误差”的机制解释。论文没有给这一消融的 MSE。
Spherical harmonics
250 图像测试序列中,完整方法 MSE 为 48.2,移除 SH layer 为 58.1;完整方法的高光更清晰。这项结果支持显式方向条件,对通道编号歧义没有给出解释。
控制来自几何,外观来自学习表征
可组合性
表面上的特征随网格移动,复制对象也复制其 UV 与 texture lookup。这个接口比直接编辑无语义 latent vector 更可预测,且同一表面跨帧访问同一份纹理参数。
未建模因素
照明在捕获过程中假设静态;克隆和移动对象不会重新求解全局光照、投影阴影或反射。网络可能局部补全已见分布内的外观,无法保证物理一致的 relighting。
动态表面前提
人脸任务依赖 Face2Face 的可跟踪 template、表达参数和 UV parameterization。方法没有解决任意非刚体拓扑变化、头发或衣物的完整 4D correspondence。
伦理
作者明确讨论人脸重演可能被用于伪造影像,并引用当时的 deepfake detection 工作;也指出检测器依赖大型训练集,跨生成方法迁移有限。
官方没有发布训练代码
官方可核查源码
arXiv TeX source 完整包含主文、Appendix A 与 Figures 1–18 的原始 JPEG。它确认网络、训练超参数、图注数字和 Figure 编号,也是本页图片与表格的直接来源。
第三方 PyTorch 复现
SSRSGJYD/NeuralTexture 明确自称 unofficial。固定核查提交 d23f5e5;它实现 UV grid sampling、4 层 Laplacian sum、16-channel texture、5-level U-Net 和 SH basis。
| 项目 | 论文 | 第三方复现 d23f5e5 | 影响 |
|---|---|---|---|
| 默认 texture | \(512\times512\) | \(1024\times1024\) | 容量与采样行为不同 |
| 训练长度 | 约 50k steps | 50 epochs,默认 899 图、batch 12 | step 数取决于数据与 epoch |
| 随机缩放 | 随机 crop 的位置与尺度变化 | 先 256 crop,再按 \(2^{-1},2^0,2^1\) resize | 属于一种具体解释,论文未给离散尺度 |
| RGB constraint | “可以”给前 3 通道 intermediate loss | 总 loss 恒为 texture RGB \(\ell_1\) + output \(\ell_1\) | 第三方默认固定采用该可选项 |
| 学习率 | texture 与 renderer 均写 \(10^{-3}\) | U-Net 参数组使用 \(0.1\times\) texture LR | 不等于论文文字设置 |
| Hierarchy 正则 | 粗层无正则,细层正则递增 | 默认 weight decay 为 0.01, 0.001, 0.0001, 0 | 代码参数顺序对应高分辨率到低分辨率,符合“越细越强” |
| SH channels | 9 maps;文字称 channels 4–13 | x[:,3:12] 乘 9 basis | 第三方选择 1-based channels 4–12 |
| Direction | view direction;未给文件格式 | 每帧读取 shape (3) 的 extrinsics | README 名称容易把相机参数与单位方向混淆 |
| 复现实验 | 多组真实与合成序列 | 不含论文数据、checkpoint 或数值复现报告 | 只能审计结构,不能验证原表结果 |
nn.Parameter(torch.FloatTensor(...)) 后没有显式初始化;默认 argparse type=bool 也会让字符串参数难以按常见直觉关闭。它可以作为结构参考,不能作为论文 50k-step 实验的权威执行记录。复现时需要补齐的变量
论文已公开
- 数据分辨率、实拍重建抽帧频率
- texture resolution、levels、channels
- U-Net encoder 结构与最终 Tanh
- \(\ell_1\) loss、Adam 参数、50k steps
- 合成视角数量与主要序列帧数
- 主要 MSE 与部分运行时间
论文未公开
- batch size、精确 crop size 与尺度分布
- 参数初始化、padding、decoder 全部细节
- hierarchy 每层 \(\ell_2\) 系数
- 前 3 通道 loss 权重与是否用于每项实验
- 训练硬件、训练时长、随机种子
- 全部数据、camera/UV 格式和 checkpoint
严格复现协议
应先固定一条合成序列,公开 mesh、UV、相机、1000/1000 train-test split 与颜色范围;实现 rasterizer 和训练 lookup 的一致性单元检查;逐项复现单层分辨率、4 层 hierarchy、1×1 renderer、移除 SH 与 triangle decimation;每项用多个种子报告 MSE、PSNR、LPIPS、temporal warping error、显存与训练时间。实拍任务需要另外记录 COLMAP revision、UVAtlas 参数、帧注册失败率和 mask 处理。
贡献清楚,证据仍偏展示型
Strengths
- 把 texture-space persistence 与 screen-space correction 分工得很清楚。
- 使用现有 graphics pipeline,显式支持相机控制与网格编辑。
- 关键机制都有对应消融:层级、邻域、视角、数据量、几何量。
- Appendix 给出足够精确的 encoder 结构,实时推理数据有硬件说明。
- 提前识别人脸合成的滥用风险。
Weaknesses
- 实拍对象少于 10 个,每个对象独立训练,泛化证据有限。
- 很多 baseline、编辑和重演比较只提供定性图片。
- MSE 跨不同序列与颜色分布,无法直接横向比较。
- 无误差条、随机种子、多次运行或 temporal metric。
- 静态光照限制了材质、照明与几何的可解释分离。
- 官方未公开实现与数据,关键训练细节缺失。
Potential improvements
训练跨对象的 generalized renderer,并以少量图像估计新的 texture;把 illumination、BRDF 与 residual appearance 拆成可控表示;联合修正 camera pose、proxy geometry 与 UV;使用 differentiable rasterization 或 path tracing 提供更精确梯度;在 test time 通过 visibility-aware optimization 修复新暴露表面;把不确定性显式预测到遮挡边界与 extrapolation 区域;用 perceptual、temporal 与 geometry-aware 指标补全 MSE。
事实、主张、解释与延伸
一手资料与实现审计
- arXiv record · 1904.12356v1:作者、版本、日期、摘要、12 页 PDF 与 TeX source。
- Official preprint PDF:主文、Appendix A、Figures 1–18、公式与实验数字。
- Niessner Lab official project page:论文身份、ACM TOG 2019、teaser、视频与官方 extras。
- ACM DOI · 10.1145/3306346.3323035:ACM TOG 38(4), Article 66 的正式记录。
- TUM research portal:卷期、Article 66、DOI 与 2019 年正式出版信息。
- Official supplemental video:新视角、编辑与人脸重演的时间序列结果。
- Unofficial PyTorch reproduction · d23f5e5:结构与代码差异审计;仓库明确自称 unofficial。
本页以 arXiv v1 的 12 页合订文档为主。Appendix A 位于同一 PDF 第 11 页;没有单独的 supplementary PDF。官方视频用于时间序列观感,页面中的数值只采用论文正文和图注明确报告的结果。