Paper Reading · NeurIPS 2024 · arXiv:2406.01781v5

DEFT

冻结大型无条件扩散模型,只学习条件分布相对先验增加的广义 \(h\)-transform。
10 位作者 · 前 5 位 equal contributionAdvances in Neural Information Processing Systems 37DOI 10.52202/079017-062047 页 arXiv v5官方代码提交 2495d46

页面覆盖正式会议论文、47 页版本全文与附录、原始 TeX、公开结果 CSV 和官方代码固定提交。数值表逐项重建;缺少的超参数与实现范围直接标记。

00 · Paper identity

五位共同第一作者,星号只表示 equal contributions

正式 NeurIPS 2024 主会记录列出十位作者。论文首页给 Alexander Denker、Francisco Vargas、Shreyas Padhy、Kieran Didi、Simon Mathis 加星号,脚注明确写作 “equal contributions”。首页没有通讯作者标记。

作者顺序

Alexander Denker* · Francisco Vargas* · Shreyas Padhy* · Kieran Didi* · Simon Mathis* · Vincent Dutordoir · Riccardo Barbano · Emile Mathieu · Urszula Julia Komorowska · Pietro Lio

第一位作者首个机构:University College London;其余多位作者来自 University of Cambridge,Riccardo Barbano 来自 Atinary Technologies。

出版记录

venue:NeurIPS 2024 Main Conference Track
proceedings:Advances in Neural Information Processing Systems 37
DOI:10.52202/079017-0620
arXiv:2406.01781v5

归档规则在缺少通讯标记时把末位 Pietro Lio 记为未核实候选,这项记录不代表论文确认其通讯身份。

4–17%图像任务 \(h\)-network 相对基础模型的参数比例范围
100DEFT 图像推理 DDIM 步数
1kImageNet 微调样本与独立评测样本规模
10 / 12DEFT 9% 在连续 motif 任务中解出的任务数
Paper Verified

论文验证的范围包括自然图像线性与非线性逆问题、两个 CT 数据集、Genie 基础模型上的连续 motif scaffolding,以及小规模 MNIST stochastic-control 实验。

01 · Research motivation

条件采样方法共享同一目标,却常以不同启发式公式出现

预训练无条件扩散模型已经昂贵地学到 \(p_t(\mathbf{x})\)。逆问题要求后验 \(p_t(\mathbf{x}\mid \mathbf{y})\)。现有 reconstruction guidance 常用 Tweedie 估计和 Gaussian 近似构造条件梯度,性能依赖 guidance scale、反向传播和算子性质;全量条件训练又需要大量配对数据与训练开销。

研究缺口

Bayes 分解指出条件 score 等于无条件 score 加 likelihood score,但中间时刻的 \(p_t(\mathbf{y}\mid\mathbf{x}_t)\) 通常不可得。论文用 Doob 的 \(h\)-transform 统一解释这一额外漂移。

核心假设

固定预训练 score,只用小网络逼近 \(\nabla_{\mathbf{x}_t}\log p_t(\mathbf{y}\mid\mathbf{x}_t)\),可保留大型模型的 prior,并以更少推理步数得到高质量条件样本。

实际代价

主方法需要少量配对样本。论文另给只用单次观测的 stochastic-control 表达,但高维轨迹反向传播成本仍高,正文实验以 score-matching DEFT 为主。

Our Interpretation

参数效率来自问题分解:基础模型负责数据流形,\(h^\phi\) 负责条件带来的残差 score。理论给出目标函数,有限网络、近似 likelihood 特征和离散采样共同决定实际误差。

02 · Generalised h-transform

从无条件 reverse SDE 到后验 reverse SDE,只增加一个条件漂移

符号含义作用
\(\mathbf{X}_t\)无条件扩散过程在时刻 \(t\) 的状态基础模型拟合其边缘 score
\(\mathbf{H}_t\)施加观测条件后的过程状态目标后验采样轨迹
\(f_t,\sigma_t\)前向 SDE 的 drift 与 diffusion定义噪声过程
\(p_t(\mathbf{x})\)无条件边缘密度由冻结 score 网络近似
\(\mathbf{Y}=\mathbf{y}\)观测;可由算子 \(\mathcal{A}\) 与噪声产生条件信息
\(h_t^{\ast}\)\(\nabla_{\mathbf{x}_t}\log p_t(\mathbf{y}\mid\mathbf{x}_t)\)广义 \(h\)-transform 的 score 形式
\(\epsilon_t^{\theta^{\ast}}\)冻结的无条件噪声预测器提供 prior score 与 Tweedie 估计
\(h_t^\phi\)小型可训练网络近似条件残差噪声
\(\bar{\alpha}_t\)DDPM 累积保真系数控制加噪和去噪

无条件过程

\[ \mathrm{d}\mathbf{X}_t=f_t(\mathbf{X}_t)\,\mathrm{d}t+\sigma_t\,\mathrm{d}\mathbf{W}_t, \qquad \mathbf{X}_0\sim p_{\mathrm{data}}. \] \[ \mathrm{d}\mathbf{X}_t= \left[f_t(\mathbf{X}_t)-\sigma_t^2\nabla_{\mathbf{X}_t}\log p_t(\mathbf{X}_t)\right]\mathrm{d}t+ \sigma_t\,\mathrm{d}\bar{\mathbf{W}}_t. \]
第一式把数据加噪;第二式按反向时间生成。冻结模型近似第二式中的无条件 score。

硬约束与噪声观测

\[ \mathrm{d}\mathbf{H}_t= \left[\bar b_t(\mathbf{H}_t)-\sigma_t^2\nabla_{\mathbf{H}_t} \log \mathbb{P}(\mathbf{X}_0\in B\mid\mathbf{H}_t)\right]\mathrm{d}t+ \sigma_t\,\mathrm{d}\bar{\mathbf{W}}_t. \]
经典 Doob 变换条件化终点事件 \(B\)。新增项使轨迹在有限时间命中该事件。
\[ p_{y\mid t}(\mathbf{y}\mid\mathbf{x}_t) =\int p(\mathbf{y}\mid\mathbf{x}_0)\,p_{0\mid t}(\mathbf{x}_0\mid\mathbf{x}_t)\,\mathrm{d}\mathbf{x}_0, \] \[ \mathrm{d}\mathbf{H}_t= \left[\bar b_t(\mathbf{H}_t)-\sigma_t^2\nabla_{\mathbf{H}_t} \log p_{y\mid t}(\mathbf{y}\mid\mathbf{H}_t)\right]\mathrm{d}t+ \sigma_t\,\mathrm{d}\bar{\mathbf{W}}_t. \]
广义形式把硬事件替换为 likelihood 积分。只要额外 score 准确,时间零边缘就是 \(p(\mathbf{x}_0\mid\mathbf{y})\)。反向 SDE 的精确初始分布是 \(Q_T^{f_t}[p(\mathbf{x}_0\mid\mathbf{y})]\);仅在 VP-SDE 充分混合、\(T\) 足够大时,才用无条件终端分布或标准 Gaussian 近似。
Notation Audit

Proposition 2.2 与附录证明按物理扩散时间书写:forward 过程从 clean posterior \(p(\mathbf{x}_0\mid\mathbf{y})\) 出发,在 \(T\) 到达 \(Q_T^{f_t}[p(\mathbf{x}_0\mid\mathbf{y})]\);reverse sampler 则从该 noisy posterior terminal law 开始并回到 clean posterior。Theorem 3.1 第 4 项把桥的边界写成 \(\mathbb{Q}_0=Q_T^{f_t}[p(\mathbf{x}_0\mid\mathbf{y})]\)、\(\mathbb{Q}_T=p(\mathbf{x}_0\mid\mathbf{y})\),它使用反向采样路径的参数方向,和该定理其余位置的 \(\mathbf{H}_T\rightarrow\mathbf{H}_0\) 下标方向冲突。这里按过程端点含义解释,不把这组下标当成新的物理时间定义。

四种等价视角

Path-measure reweighting

条件路径测度由无条件路径测度乘以时间零后验对先验的 Radon–Nikodym 导数。

Denoising score matching

用配对 \((\mathbf{x}_0,\mathbf{y})\) 和一次随机加噪直接监督 \(h_t\),无需模拟完整反向轨迹。

Stochastic control

最小化控制能量与负 log-likelihood,可只依赖一条观测,但要处理整条随机轨迹的梯度。

Schrödinger bridge

条件路径是以无条件过程为参考、满足边界分布约束的最小 KL 路径测度。

\[ \frac{\mathrm{d}\mathbb{Q}}{\mathrm{d}\mathbb{P}}(\mathbf{X}_{0:T}) =\frac{p(\mathbf{X}_0\mid\mathbf{y})}{p_{\mathrm{data}}(\mathbf{X}_0)} =\frac{p(\mathbf{y}\mid\mathbf{X}_0)}{p(\mathbf{y})}. \]
\(\mathbb{P}\) 是无条件路径分布,\(\mathbb{Q}\) 是准确后验路径分布。权重仅取决于 clean 端点,Bayes 归一化常数 \(p(\mathbf{y})\) 使路径权重积分为一;该关系要求后验相对先验绝对连续。它说明 conditioning 如何重加权整个轨迹。
\[ \mathcal{L}^{\mathbf{y}}_{\mathrm{SM}}(h) =\mathbb{E}_{\mathbf{X}_0\sim p(\mathbf{x}_0\mid\mathbf{y}),\,t,\,\mathbf{H}_t\sim p_{t\mid0}} \left[\left\|h_t(\mathbf{H}_t)+\nabla_{\mathbf{H}_t}\log p_t(\mathbf{H}_t) -\nabla_{\mathbf{H}_t}\log p_{t\mid0}(\mathbf{H}_t\mid\mathbf{X}_0)\right\|_2^2\right]. \]
这里的 \(h\) 是 score residual。训练用已知前向 Gaussian 的 score 监督“基础 score + 条件 residual”,对观测与算子摊销后得到下节的 epsilon residual 目标。理论式中条件样本来自后验;实际数据先采样 \(\mathbf{x}_0\),再按观测模型生成 \(\mathbf{y}\),以联合配对样本训练所有条件。
\[ \mathcal{L}^{\mathbf{y}}_{\mathrm{SC}}(h) =\mathbb{E}_{\mathbb{Q}^{h}}\left[\frac{1}{2}\int_0^T \sigma_t^2\|h_t(\mathbf{H}_t)\|_2^2\,\mathrm{d}t\right] -\mathbb{E}_{\mathbb{Q}^{h}}\left[\log p(\mathbf{y}\mid\mathbf{H}_0)\right]. \]
\(\mathbb{Q}^{h}\) 是当前控制 \(h\) 诱导的反向轨迹分布,随训练参数改变。第一项惩罚偏离基础过程的控制能量,第二项鼓励 clean 终点解释观测;在共同终端分布等条件下,Girsanov 路径 KL 把它连接到后验拟合。与一次加噪的 SM 不同,SC 需要模拟受控轨迹,朴素梯度还要穿过多步采样。VarGrad 与 Trajectory Balance 是附录用于降低轨迹梯度成本的估计方法,不能从能量公式推定免费或无梯度优化。
Author Claim

统一框架涵盖 DPS、\(\Pi\)GDM、conditional score matching 和 classifier guidance。严格结果描述连续 SDE 与函数空间中的最优 \(h\);实验网络属于离散、有限容量近似。

03 · Training and inference

训练只需一次冻结模型前向传播,推理每步相加两份噪声预测

\[ \mathbf{H}_t=\sqrt{\bar{\alpha}_t}\mathbf{X}_0+\sqrt{1-\bar{\alpha}_t}\mathbf{\epsilon}, \qquad \mathbf{\epsilon}\sim\mathcal{N}(\mathbf{0},\mathbf{I}), \] \[ \min_{\phi}\; \mathbb{E}\left[ \left\| h_t^\phi(\mathbf{H}_t,\mathbf{Y}) +\epsilon_t^{\theta^{\ast}}(\mathbf{H}_t) -\mathbf{\epsilon} \right\|_2^2 \right]. \]
总噪声预测由冻结基础模型和小型 \(h\)-network 相加。梯度只更新 \(\phi\),无需穿过 \(\theta^{\ast}\)。论文复用符号 \(h\):理论部分的 \(h_t^{\mathrm{score}}=\nabla_{\mathbf{x}_t}\log p_t(\mathbf{y}\mid\mathbf{x}_t)\) 是 score 增量;式 11 中网络输出是 epsilon residual。由 \(s_t=-\epsilon_t/\sqrt{1-\bar\alpha_t}\) 可得 \(h_t^{\epsilon}=-\sqrt{1-\bar\alpha_t}\,h_t^{\mathrm{score}}\)。加号来自残差已经吸收负号与尺度,二者不能直接逐值比较。
\[ \hat{\mathbf{x}}_0(\mathbf{x}_t) = \frac{\mathbf{x}_t-\sqrt{1-\bar{\alpha}_t}\, \epsilon_t^{\theta^{\ast}}(\mathbf{x}_t)} {\sqrt{\bar{\alpha}_t}}, \] \[ \hat{\mathbf{x}}_0(\mathbf{x}_t,\mathbf{y}) = \hat{\mathbf{x}}_0(\mathbf{x}_t) - \frac{\sqrt{1-\bar{\alpha}_t}}{\sqrt{\bar{\alpha}_t}}\, h_t^{\phi^{\ast}}(\mathbf{x}_t,\mathbf{y}). \]
\(h\)-network 也可解释为对无条件 Tweedie 去噪估计的条件修正。

Likelihood-informed architecture

\[ h_t^\phi(\mathbf{x}_t,\mathbf{y})= \mathrm{NN}_1^\phi\!\left( \mathbf{x}_t,\hat{\mathbf{x}}_0, \nabla_{\hat{\mathbf{x}}_0}\log p(\mathbf{y}\mid\hat{\mathbf{x}}_0),t \right) + \mathrm{NN}_2^\phi(t)\, \nabla_{\hat{\mathbf{x}}_0}\log p(\mathbf{y}\mid\hat{\mathbf{x}}_0). \]
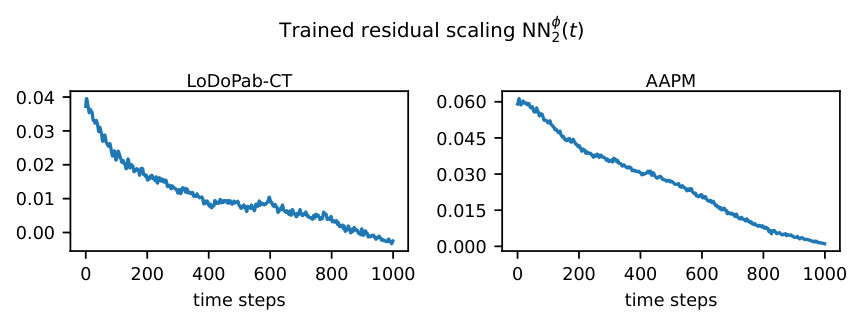
\(\mathrm{NN}_1\) 学习高容量修正;\(\mathrm{NN}_2\) 学习随时间变化的标量残差权重。cheap guidance 不计算冻结 U-Net 的 Jacobian。
1 · 配对样本\(\mathbf{x}_0,\mathbf{y}\)
2 · 随机时刻\(t\sim U\{1,\ldots,T\}\)
3 · 一次加噪得到 \(\mathbf{x}_t\)
4 · 冻结前向得到 \(\epsilon^\theta,\hat{\mathbf{x}}_0\)
5 · 条件残差得到 \(h^\phi\)
6 · MSE 更新只更新 \(\phi\)
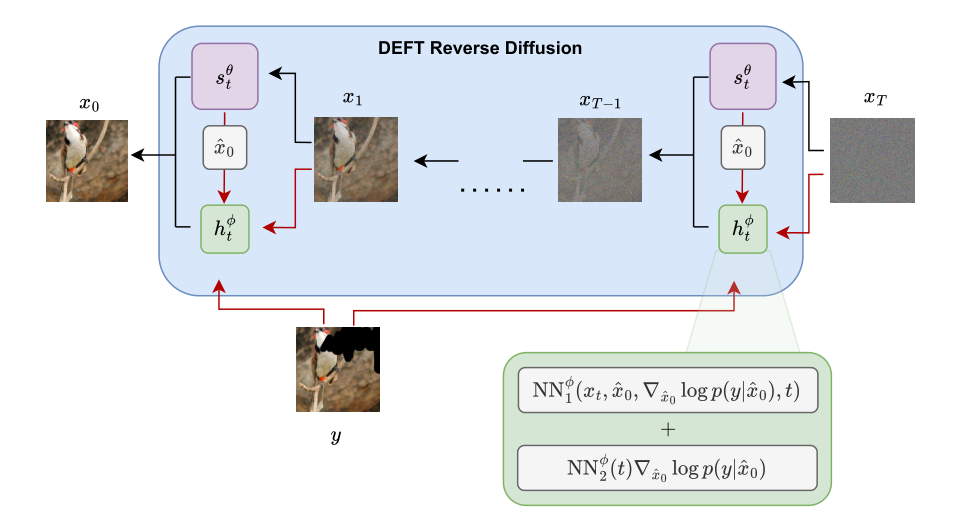
Figure 1 DEFT reverse diffusion pipeline
Figure 1(原论文):每个反向步都运行冻结无条件模型与 \(h\)-network,再相加噪声预测。训练期只有小网络接收梯度;采样期两者都只做前向传播。

推理

  1. 理论上从 \(\mathbf{x}_T\sim Q_T^{f_t}[p(\mathbf{x}_0\mid\mathbf{y})]\) 开始;VP-SDE 大 \(T\) 实现使用 \(\mathcal{N}(\mathbf{0},\mathbf{I})\) 近似。
  2. 冻结模型预测 \(\epsilon_t^{\theta^{\ast}}(\mathbf{x}_t)\),并计算 \(\hat{\mathbf{x}}_0\)。
  3. 构造观测、mask、backprojection、近似 likelihood gradient 等任务特征。
  4. \(h_t^\phi\) 预测条件残差,组合 \(\hat{\epsilon}_t=\epsilon_t^{\theta^{\ast}}+h_t^\phi\)。
  5. 按 DDIM 更新到下一时刻。图像实验使用 100 步;DPS 与 RED-diff 使用 1000 步。
Evidence Boundary

方法论文公式写 \(\mathrm{NN}_2^\phi\) 初始化输出 1;图像附录写最后一层 bias 初始化 0.01;固定提交默认配置写 0.001,并在 epsilon 参数化分支反转标量符号。三个版本不能视为同一初值。

附录统一图像加噪配置为 \(T=1000\),linear beta 从 \(10^{-4}\) 到 \(2\times10^{-2}\)。\(\mathrm{NN}_1\) 使用 attention U-Net,末层零初始化;\(\mathrm{NN}_2\) 是三层全连接网络,使用 SiLU,输出单个时间标量。蛋白使用 \(T=1000\) 和 cosine beta schedule,Genie 在 \(C_\alpha\) Euclidean 坐标上扩散,内部使用 Frenet–Serret frames、SE(3)-invariant encoder 与 equivariant decoder;conditional pair features 把 motif 和 Tweedie 信息加入小模型。附录没有给出 DEFT 蛋白网络的完整 optimizer、学习率、batch、GPU、训练时长和随机种子,800 epochs 无法独立确定全部训练预算。

04 · Natural-image inverse problems

线性任务突出感知质量,非线性任务突出稳定重建

ImageNet 评测使用 \(256\times256\) 图像、约 550M 参数无条件模型。DEFT 以独立 1k validation 子集训练约 23M 参数网络,再在另一组 1k validation 图像评测。线性任务使用 DPS、\(\Pi\)GDM、DDRM、RED-diff 和 I²SB;非线性任务只比较 DPS 与 RED-diff。

线性:inpainting 与 4× super-resolution

指标Inpainting4× Super-resolution
DPS\(\Pi\)GDMDDRMRED-diffDEFTI²SBDPS\(\Pi\)GDMDDRMRED-diffDEFTI²SB
PSNR ↑21.2720.3020.7223.2922.1823.2624.8325.2525.3225.9524.9223.95
SSIM ↑0.670.820.830.870.850.860.710.730.720.750.710.64
KID ↓15.284.502.500.860.290.23810.0110.914.010.01.780.004
LPIPS ↓0.260.120.140.100.090.0680.160.150.230.250.120.11
Top-1 ↑58.267.868.672.071.774.571.571.0263.966.771.971.6
Total time, 1k (h) ↓30.722.830.337.865.2N/A30.722.830.337.865.2N/A
Time / sample (s) ↓100.610.21.2228.34.36N/A100.610.21.2228.34.36N/A

Inpainting

mask 遮挡 20–30% 像素。输入含 \(\mathbf{x}_t\)、Tweedie 估计、带零填充观测、mask 与 cheap guidance,共 13 通道。训练 200 epochs、batch 16、Adam、初始学习率 \(5\times10^{-4}\) 并退火。3.9 小时训练加 1.2 小时评测。

Super-resolution

算子为 4× bicubic downsampling。附录写模型输入 9 通道,却同时列出四组 RGB 特征,按文字应为 12 通道。固定提交实际拼接 \(\mathbf{x}_t\)、Tweedie 估计和 cheap guidance 三组 RGB,配置也设为 9 通道;上采样观测通过 guidance 进入,并未单独拼接。训练设置同上。DEFT 的 PSNR 与 SSIM 低于 RED-diff,却在 KID、LPIPS 与 top-1 三项感知指标领先可比 zero-shot 方法。

自然图像表的 Total time 以 1k 图像为口径,DEFT 包含 3.9 小时训练和约 1.2 小时评测;Time / sample 在单张 A100 上用各方法可容纳的最大 batch 摊销。它与后文 CT 的单张 RTX 3090 逐图时间属于不同硬件和测量协议。

Inpainting target
Target + mask
DPS result
DPS
PiGDM result
PiGDM
DDRM result
DDRM
RED-diff result
RED-diff
DEFT result
DEFT
Figure 2(原论文):ImageNet inpainting 的同一样例对比。数值结论以上表 1k 图像评测为准。

非线性:HDR、phase retrieval 与 learned deblurring

指标HDRPhase retrievalNon-linear deblurring
DPSRED-diffDEFTDPSRED-diffDEFTDPSRED-diffDEFT
PSNR ↑7.9425.2328.519.9910.5313.0317.5721.2125.16
SSIM ↑0.210.790.890.120.170.320.390.530.79
KID ↓272.51.20.1093.2114.080.8912.8966.80.34
LPIPS ↓0.720.100.040.660.600.520.420.420.09
Top-1 ↑4.068.574.01.57.213.130.223.569.9
Total time, 1k (h) ↓30.77.95.230.77.95.230.98.15.2
Time / sample (s) ↓100.428.34.4100.628.44.4101.230.44.6

HDR

\(\mathcal{A}(\mathbf{x})=\mathrm{clip}(2\mathbf{x};-1,1)\)。饱和区梯度为零,使 DPS guidance 缺少信息。DEFT 用近似残差特征 \(0.5(\mathcal{A}(\hat{\mathbf{x}}_0)-\mathbf{y})\) 学习跨越零梯度区。

Phase retrieval

\(\mathcal{A}(\mathbf{x})=|\mathcal{F}\mathbf{x}|\),2× oversampling。输入加入用 Tweedie phase 与观测 magnitude 合成的粗重建、350 步 ER 算法重建和 autograd guidance。13.03 dB 仍显示任务远未解决。

Non-linear deblurring

算子为训练神经网络。真实梯度增加成本且收益有限,作者改用 \(\mathcal{A}^{\dagger}(\mathcal{A}(\hat{\mathbf{x}}_0)-\mathbf{y})\) 类似的廉价近似。论文发现 RED-diff 原仓库的权重加载使任务近乎平凡,并在修正时更换 forward operator。主表支持修正任务内部比较,旧表与新表之间的差值同时混入算子变化。

Deblur ground truth
Ground truth
Deblur measurement
Measurement
DPS deblur
DPS
RED-diff deblur
RED-diff
DEFT deblur
DEFT
Figure 3(原论文):修正权重加载后的 non-linear deblurring。任务定义变化使该表不能与旧实现产生的高 PSNR 直接比较。
05 · Medical reconstruction

CT 实验把相同 23M 条件网络接到两种规模的医学扩散模型

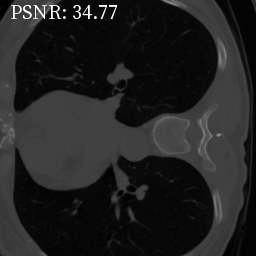
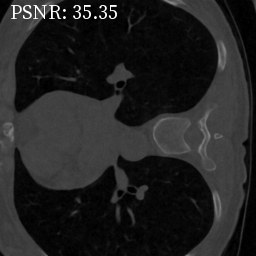
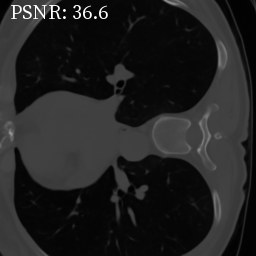
算子是 60 角 parallel-beam Radon transform,观测加入 \(\sigma_y=1.0\) 的 Gaussian 噪声,约为 3.5% relative noise。标准 Gaussian likelihood 为 \(\log p(\mathbf{y}\mid\mathbf{x})=-\|\mathbf{y}-\mathcal{A}\mathbf{x}\|_2^2/(2\sigma_y^2)+C\),其精确梯度是 \(-\sigma_y^{-2}\mathcal{A}^{\ast}(\mathcal{A}\mathbf{x}-\mathbf{y})\),平方求导抵消了 \(1/2\)。原附录的特征公式额外保留 \(1/2\),并实际以 filtered backprojection 替代 adjoint;该特征属于输入工程近似,不能当成精确 likelihood score。DEFT、DPS、RED-diff 的样本步数分别为 100、1000、1000。

指标AAPMLoDoPab-CT
DPSRED-diffDEFTDPSRED-diffDEFT
PSNR ↑33.1134.8534.7334.1634.9535.81
SSIM ↑0.8850.8650.8870.8460.8490.876
Time / image (s) ↓208.983.416.3156.870.113.8

CT 时间在单张 RTX 3090 上按单幅图像测量。AAPM 的 PSNR 由 RED-diff 34.85 dB 领先 DEFT 34.73 dB,DEFT 在该数据集的 SSIM 与速度领先;LoDoPab-CT 才是 PSNR、SSIM、速度三项同时领先。

AAPM

10 位患者的 abdomen scans;9 位用于基础模型和 \(h\)-transform 训练,L035 的 87 slices 专用于测试。无条件 attention U-Net 约 374M 参数、Adam 训练 300 epochs、EMA 0.999;\(h\)-network 23M,约 6%。

LoDoPab-CT

35,820 train 图像训练 133M 无条件模型;3,522 validation 图像训练 \(h\)-network并搜索 DPS/RED-diff 超参数;test 每 20 张取一张,共 178 张。基础模型 Adam 训练 75 epochs,即 671,625 steps,EMA 0.999;\(h\)-network 约 17%。

CT ground truth
Ground truth
DPS CT
DPS
RED-diff CT
RED-diff
DEFT CT
DEFT
Figure 4(原论文):LoDoPab-CT reconstruction。医学任务以 distortion 指标为主,论文没有提供病灶级诊断评测。
Missing Setup

附录没有给两种 CT \(h\)-network 的 optimizer、learning rate、batch size、epoch 或 stopping rule;固定代码含可配置默认值,但无法证明这些默认值生成表中结果。

06 · Protein motif scaffolding

把 motif 当作坐标子集条件,联合去噪 motif 与 scaffold

状态是蛋白 \(C_\alpha\) 坐标,motif 由 mask 选择。冻结基础模型为 4.087M 参数 Genie;DEFT 使用 downsized Genie 作为 \(h\)-network,9% 版本约 200k 参数,并加入 motif 坐标与无条件 Tweedie 估计的 conditional pair features。

\[ \mathbf{y}=\mathcal{A}\mathbf{x},\qquad \mathcal{A}\in\{0,1\}^{n\times d}. \]
mask 从完整骨架选择 motif 坐标。DEFT 对 motif 与 scaffold 一起加噪和去噪;RFDiffusion 的条件训练在采样时固定 motif 坐标。
平均指标DPSDEFT 9%Amortised Genie
Success % ↑1.39.224.5
scRMSD \(\lt 2\) Å % ↑44.328.942.0
motifRMSD \(\lt 1\) Å % ↑4.124.045.8

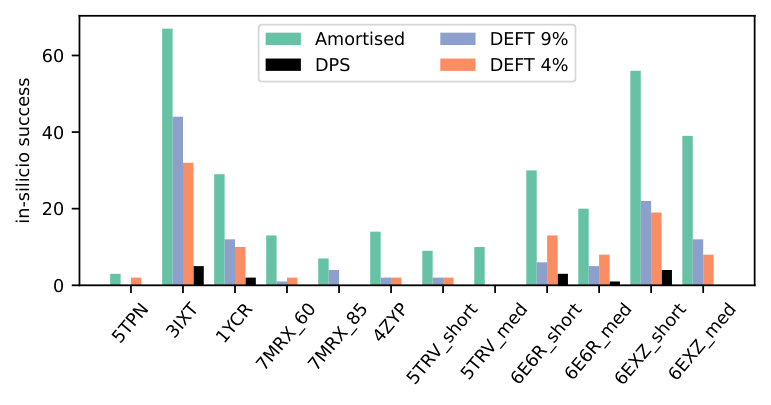
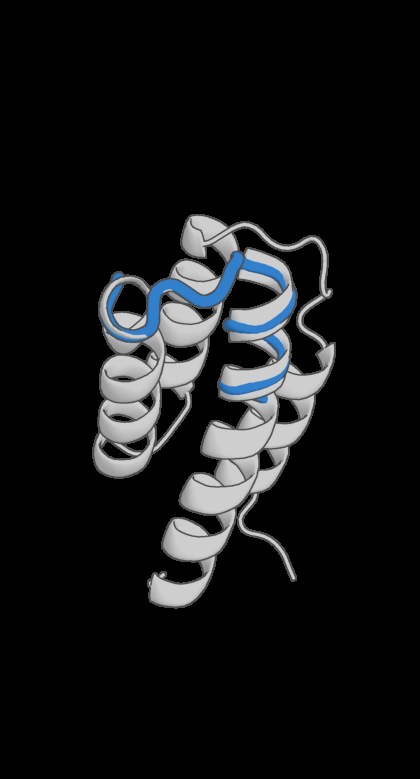
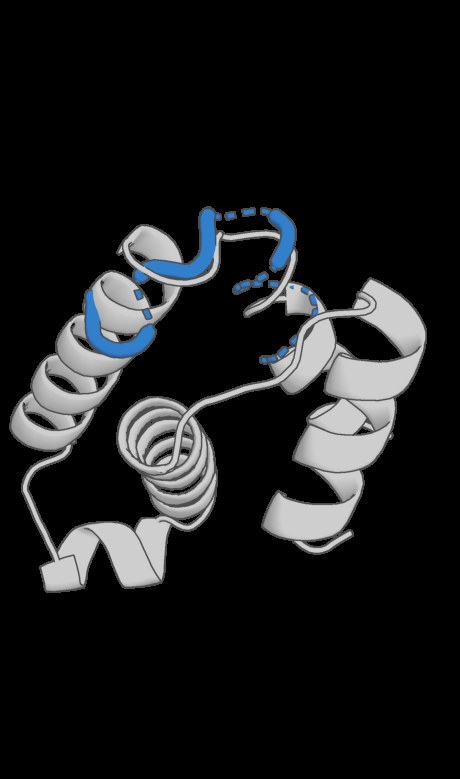
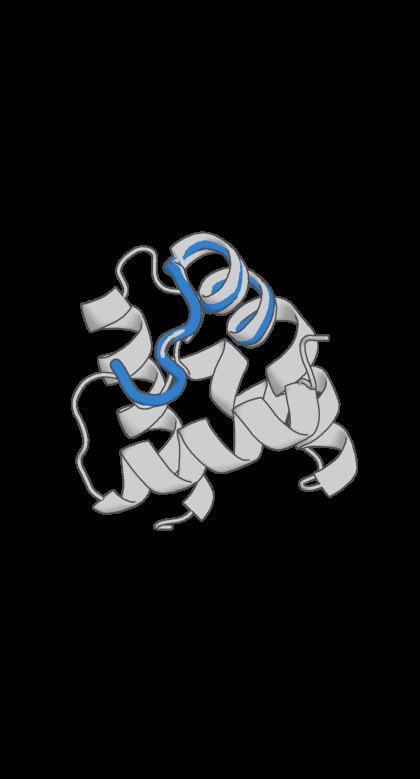
成功样本同时满足 scRMSD \(\lt 2\) Å 与 motifRMSD \(\lt 1\) Å;每项任务生成 100 个样本,只要一个成功就算该任务 solved。DEFT 9% 解出 10/12,DPS 解出 5/12。Amortised Genie 为 4.162M 参数,2100 epochs;DEFT 为 800 epochs。

Figure 5 protein motif benchmark
Figure 5(原论文):12 个连续 motif 任务的 in-silico success。论文图注与表注分别出现 12 和 11 targets;公开 CSV 含 12 个任务。
Amortised protein sample
Amortised
DPS protein sample
DPS
DEFT protein sample
DEFT 9%
附录 Figure(原论文):6EXZ medium motif。作者观察到 DPS 在低 guidance 下骨架真实但 motif 偏离,在高 guidance 下 motif 贴合但骨架失真。
公开源 CSV 的 12 项任务复算

下表按每个方法、每项任务 100 个样本,直接应用论文阈值复算。它用于核对 Figure 5;DPS 逐任务原始 CSV 未包含在 arXiv source 中。

方法任务nSuccess %scRMSD \(\lt 2\) %motifRMSD \(\lt 1\) %Solved
DEFT 9%1YCR10012.028.028.0是
DEFT 9%3IXT10044.045.088.0是
DEFT 9%4ZYP1002.04.05.0是
DEFT 9%5TPN1000.03.00.0否
DEFT 9%5TRV_med1000.04.00.0否
DEFT 9%5TRV_short1002.09.02.0是
DEFT 9%6E6R_med1005.017.024.0是
DEFT 9%6E6R_short1006.018.028.0是
DEFT 9%6EXZ_med10012.021.025.0是
DEFT 9%6EXZ_short10022.028.038.0是
DEFT 9%7MRX_601001.05.03.0是
DEFT 9%7MRX_851004.012.05.0是
DEFT 4%1YCR10010.034.019.0是
DEFT 4%3IXT10032.032.083.0是
DEFT 4%4ZYP1002.05.08.0是
DEFT 4%5TPN1002.014.03.0是
DEFT 4%5TRV_med1000.06.01.0否
DEFT 4%5TRV_short1002.07.02.0是
DEFT 4%6E6R_med1008.022.024.0是
DEFT 4%6E6R_short10013.024.020.0是
DEFT 4%6EXZ_med1008.019.028.0是
DEFT 4%6EXZ_short10019.034.040.0是
DEFT 4%7MRX_601002.011.03.0是
DEFT 4%7MRX_851000.02.02.0否
Amortised1YCR10029.041.057.0是
Amortised3IXT10067.067.098.0是
Amortised4ZYP10014.025.024.0是
Amortised5TPN1003.020.08.0是
Amortised5TRV_med10010.016.018.0是
Amortised5TRV_short1009.016.010.0是
Amortised6E6R_med10020.022.059.0是
Amortised6E6R_short10030.033.067.0是
Amortised6EXZ_med10039.047.072.0是
Amortised6EXZ_short10056.059.074.0是
Amortised7MRX_6010013.020.017.0是
Amortised7MRX_851007.011.011.0是
Evidence Boundary

结果属于 in-silico pipeline:ProteinMPNN inverse folding、ESMFold refolding、scRMSD 与 motifRMSD。论文没有湿实验验证。平均表写“11 targets”,数值按 12 个任务复算可得到 9.2%、28.9%、24.0% 等主表结果,因此 11 更可能是图注错误。“DEFT 9%”与约 200k 条件网络、4.087M Genie 的直接参数比约 4.9% 也不吻合,论文没有充分说明该百分比的分母口径。

07 · Ablations and appendix experiments

样本量、网络输入与训练预算分别检验

ImageNet inpainting:微调样本数量

训练图像数PSNR ↑SSIM ↑KID ↓LPIPS ↓Top-1 ↑
1020.870.831.850.12368.8
10020.990.840.9780.11269.6
20022.110.8470.4010.09670.6
100022.180.850.290.0971.7

200 张时 KID 0.401 已优于 RED-diff 的 0.86;10 张仍可工作,但五项指标随样本量整体改善。该消融只覆盖 inpainting,没有检验 operator shift 或跨数据集泛化。

LoDoPab-CT:\(h\)-network 参数化

输入与残差结构PSNR ↑SSIM ↑
完整结构:\(\mathbf{x}_t,\hat{\mathbf{x}}_0,\nabla\log p\) + time-scaled residual35.810.876
移除 \(\hat{\mathbf{x}}_0\),保留 likelihood gradient 与 residual35.740.875
\(\mathbf{x}_t,\hat{\mathbf{x}}_0,\mathcal{A}^{\ast}\mathbf{y}\),无 residual34.040.851
\(\mathbf{x}_t,\mathcal{A}^{\ast}\mathbf{y}\)26.620.724

完整结构相对最朴素输入提升 9.19 dB。完整结构与移除 Tweedie 输入的差距只有 0.07 dB,说明主要增益来自 likelihood gradient 与 residual pathway 的组合;论文正文将“约 8 dB”同时归因于 Tweedie 与 log-likelihood 信息,消融无法单独量化每一项的因果贡献。

Time scaling network curves
Appendix Figure(原论文):AAPM 与 LoDoPab-CT 的 \(\mathrm{NN}_2^\phi(t)\)。采样初期权重较小,接近数据端时增强。

Flowers:同预算 DEFT 与 amortised conditional model

方法InpaintingOutpaintingBlur
PSNRSSIMKIDPSNRSSIMKIDPSNRSSIMKID
Amortised 20×, full data27.810.9360.00005712.140.2210.02823.020.7340.0196
Amortised 2×25.220.9120.001610.840.1920.082122.660.7160.0289
Amortised 1×16.280.8060.0069.9850.1730.121.750.7050.0374
DPS26.290.8970.003611.880.2150.038922.510.6830.0624
DEFT26.180.9160.001911.180.1600.1123.160.7090.0529

数据划分 6149 / 1020 / 1020。24M unconditional 与 amortised 模型训练约 50 小时;Amortised 2× 为 4.5 小时;DEFT 与 Amortised 1× 约 2.5 小时。同预算比较呈逐指标取舍:DEFT 在 inpainting 的三项指标领先 Amortised 1×,在 blur 的 PSNR 更高;outpainting 的 SSIM 0.160 低于 0.173、KID 0.11 高于 0.1,blur 的 KID 0.0529 也高于 0.0374。完整数据 20× 模型整体领先。

Stochastic control proof of concept

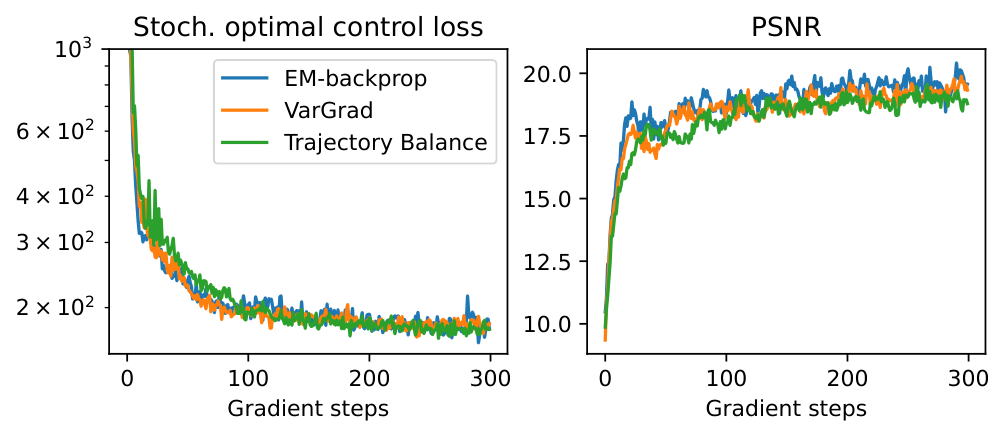
MNIST parallel-beam Radon transform 使用 5 个角度与 10% Gaussian noise。3M 无条件模型配 70k \(h\)-network。EM-backprop 使用 batch 16、60–80 steps;VarGrad 与 Trajectory Balance 使用 batch 26、80–140 steps;单张 RTX 3090 训练约 1 小时。轨迹只对随机 20% 时刻反向传播仍给出相近性能。

Stochastic control loss
Appendix Figure:三种估计器的 control loss 与 mean PSNR。
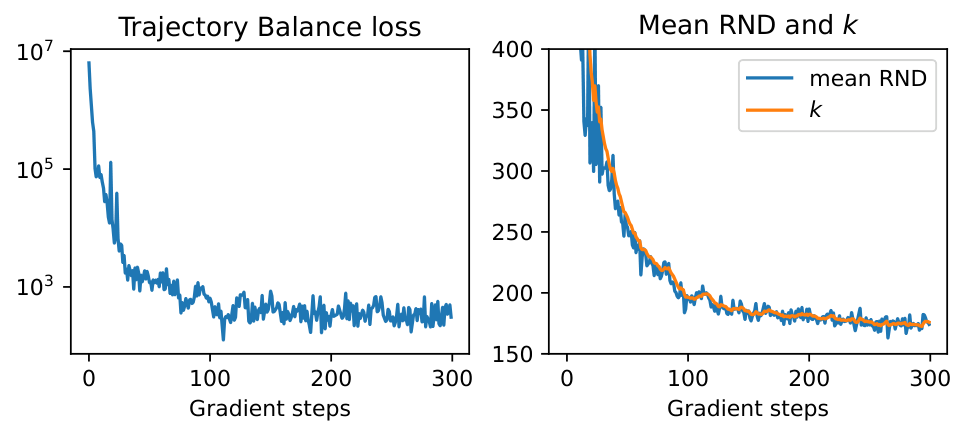
Trajectory balance loss
Appendix Figure:Trajectory Balance 中标量 \(k\) 追踪 mean RND,方差更小。

RED-diff 原 non-linear blur 实现

方法PSNR ↑SSIM ↑LPIPS ↓Total time (h) ↓
RED-diff45.000.98\(1.2\times10^{-3}\)7.9
DEFT64.640.99\(1.0\times10^{-5}\)5.2

作者确认旧代码没有正确加载 blur 网络权重,forward operator 接近 identity,因此异常高分只说明任务退化。主表使用修正实现。

08 · Baselines and fairness

时间优势真实存在,比较条件仍需逐项阅读

Sampling steps

DEFT 100 DDIM steps;DPS 与 RED-diff 1000 steps;DDRM 20 steps;\(\Pi\)GDM 100 steps。单样本速度主要反映算法步数、是否需要梯度与可用 batch size。

Training accounting

ImageNet total time 把 DEFT 的 3.9 小时训练计入 1k 图像总成本。处理更多观测时训练成本可摊薄;只处理少量观测时结论会变化。

Hyperparameter search

ImageNet baselines沿用 RED-diff 配置且未额外调参;CT 对 DPS 与 RED-diff 在 validation subset 搜索 PSNR。DEFT 同样通过任务训练学习条件,双方可用信息不完全相同。

I²SB upper bound

I²SB 用完整 ImageNet 训练条件模型,数据与算力远多于 1k 样本 DEFT,且表中没有时间。它适合显示 fully conditional training 的上限,不适合作为同预算 baseline。

Operator coverage

\(\Pi\)GDM 与 DDRM 没有进入非线性任务,因为方法前提不支持这些算子。非线性结论只建立在 DPS 和 RED-diff 两个 baseline 上。

Protein upper bound

Amortised Genie 参数量和训练 epochs 都高于 DEFT;DPS guidance scale 经过 5 次实验调节。论文没有与 RFDiffusion 完整模型做同预算数值比较。

09 · Paper vs implementation

固定提交覆盖图像路径,蛋白与附录 control 实验没有公开实现

核查对象:官方仓库 alexdenker/DEFT,提交 2495d46593cb48253e8f879131cdd82fcc17be7f,提交日期 2024-12-04。

损失函数
htransform/losses.py 按论文生成 \(\mathbf{x}_t\),冻结基础模型得到 \(\epsilon^\theta\) 和 \(\hat{\mathbf{x}}_0\),训练 \(\|\epsilon-(\epsilon^\theta+h^\phi)\|^2\)。
梯度边界
基础模型与条件特征构造包在 torch.no_grad(),符合“只训练 \(h\)-network”。phase retrieval 的近似 guidance 单独启用 autograd。
任务输入
inpainting 拼接 13 通道;super-resolution/HDR/CT/deblur 通常拼接 \(\mathbf{x}_t,\hat{\mathbf{x}}_0\) 与 cheap guidance;phase retrieval 加入两种粗反演。
数据选择
ImageNet 代码从 10k 列表每 10 张取一张形成 1k finetune set,每 100 张偏移一张形成约 100 张 validation set。论文的最终 1k evaluation 由单独 loader 列表提供。
公开范围
仓库没有 protein、Genie、motif、MNIST stochastic-control、VarGrad 或 Trajectory Balance 文件,也没有论文结果 checkpoint。
运行入口
README 的 super-resolution 命令对应重构后 main.py;inpainting 示例仍引用已不存在的 run_supervised_finetuning.py 与 configs/default_config.py。
默认配置
_configs/imagenet256_deft.yaml 引用缺失的 wandb_config/alexanderdenker.yaml;默认 finetune dataset root 是作者本机路径,使用者必须补齐。
噪声参数
论文 ImageNet task 描述为 noiseless,并为 inductive feature 使用 \(\sigma_y=1.0\) Gaussian approximation;代码 YAML 的 HDR/inpainting 默认 noise_std: 0.1,示例运行需要显式覆盖。
Residual 初值
论文方法、附录、代码默认分别写 1、0.01、0.001;当前 epsilon 分支还对 time scaling 取负。
训练配置
公开 command 复现 SR4 的 batch 16、200 epochs、学习率 0.0005、100-step validation,并保留 “TODO: sample and eval with EMA model”。
Reproducibility

仓库可审计算法核心,却不能直接复现论文全部表格。缺少任务 checkpoint、完整命令、医学训练参数、蛋白代码、control objective 代码与若干配置文件。页面没有声称独立复现实验。

10 · Reviewer commentary

理论组织清晰,经验覆盖广;复现证据和公平预算仍有空缺

Strengths
  • 广义 \(h\)-transform 把 reconstruction guidance、conditional training 与 stochastic control 放进同一数学语言。
  • score-matching 目标只需配对样本的一次加噪,避免通过 550M 基础模型反向传播。
  • 线性、非线性、医学与蛋白坐标任务共同验证条件残差建模的适用范围。
  • 主表同时报告 distortion、perceptual、分类与时间指标,明确任务偏好的差异。
  • 作者主动发现并公开 RED-diff blur 权重加载问题。
Weaknesses
  • 任务专用 \(h\)-network 仍需配对数据与训练,模型跨算子和跨噪声强度的迁移没有验证。
  • ImageNet baseline 没有逐任务重新调参,CT baseline 又进行了验证集搜索,调参协议不统一。
  • 蛋白结果只有 in-silico 评估,基础 Genie 能力限制结论,公开仓库也缺少对应代码。
  • 关键训练设置缺失,架构初值在正文、附录与代码之间不一致。
  • LoDoPab 的 3,522 张 validation 图像用于 \(h\)-network 训练,同一 validation 数据池还用于 baseline search,仍需要更清楚的数据隔离说明。
  • 理论最优 \(h\) 与有限网络近似之间没有误差界,100-step DDIM 的离散误差也未单独分析。

可以直接形成后续研究的问题

Operator-conditioned DEFT

把算子、噪声强度与采样预算编码为条件,在一套 \(h\)-network 中覆盖多个逆问题,并以未见算子测试迁移。

Test-time control refinement

用 stochastic-control objective 在单次观测上继续优化预训练 \(h\)-network,以少量轨迹更新修正 domain shift。

Uncertainty-calibrated residual

让 \(\mathrm{NN}_2(t)\) 预测空间相关或频率相关置信度,并校准 posterior coverage,减少单标量 guidance 对局部病灶的限制。

Protein equivariant residual

在更强蛋白基础模型上构建严格 SE(3)-equivariant \(h\)-transform,并加入 clash、energy 和 wet-lab 约束。

Budget-matched benchmark

统一训练数据、GPU 时间、sampling NFE、baseline 调参次数与 checkpoint 选择,绘制质量—总成本 Pareto curve。

Procedural graph extension

将冻结的无条件 material graph prior 与条件 \(h\)-network 组合,输入文本、渲染图、节点有效性和 renderer residual,在生成中修正 topology 与参数。

Research Extension

程序化材质方向可以把 renderer feedback 视为 likelihood signal:预训练图生成器或图程序生成器提供 prior,\(h\)-network 学习满足目标外观、可执行性和可编辑性的条件残差。需要真实图执行和多视角渲染验证,单一 CLIP 相似度不足以支撑可复现 claim。

11 · Sources

一手资料与证据范围

  1. NeurIPS 2024 正式论文记录:作者、主会轨道、卷次与 DOI。
  2. arXiv:2406.01781v5:47 页正文、附录、算法、实验设置与原始图表。
  3. 官方代码固定提交 2495d46:图像训练、采样、likelihood 与配置审计。
  4. OpenAI guided-diffusion:ImageNet 无条件 checkpoint 来源。
  5. 页面没有把作者解释、页面推断和研究延伸混写为论文实验事实;复算蛋白逐任务表使用 arXiv source 内公开 CSV。