出版身份与证据范围
作者与机构
Xingzi Xu*†(Amazon、Duke University)、Qi Li*(Amazon)、Shuwen Qiu†(UCLA)、Julien Han(Amazon)、Karim Bouyarmane(Amazon)。论文脚注把星号定义为 Equal contribution,十字符号定义为实习期间完成。
论文、正式出版页与项目页都没有通讯作者标记。末位作者 Karim Bouyarmane 记录为未核实通讯候选人。
版本关系
CVF 正式论文为 10 页,补充材料为 3 页;本地 arXiv v1 PDF 将两者合并为 13 页。CVF 元数据记录页码 3333–3342,PDF 页脚印有 3308–3317,存在出版元数据与 PDF 页脚差异。
项目页公开于 deft-vton.github.io。截至核查时,官方 GitHub 仓库只含项目网页、GIF 与视频,没有模型训练、推理代码或权重。
条件能力与大模型训练成本之间的缺口
高质量 VTO 通常要改动大型 diffusion 模型,或在每个采样步骤额外计算昂贵 guidance。DEFT-VTON 的核心假设是:预训练生成器已经掌握通用图像先验,VTO 所缺的主要成分可以表示为条件 score 的增量,并由一个小型辅助网络学习。
研究缺口
PEFT baseline 仍训练 U-Net 的 self-attention,约占骨干 5.51%;DEFT 路线把骨干完全冻结,把条件修正移到独立辅助网络。这样可以降低可训练参数量,并为后续替换更大的基础模型保留接口。
速度问题
单纯 DSM 训练得到的条件引导仍依赖多步采样。论文再用 consistency loss 约束不同噪声时刻的 clean prediction,使同一轨迹上的输出接近,从而支持更少步骤的 DDIM-like 采样。
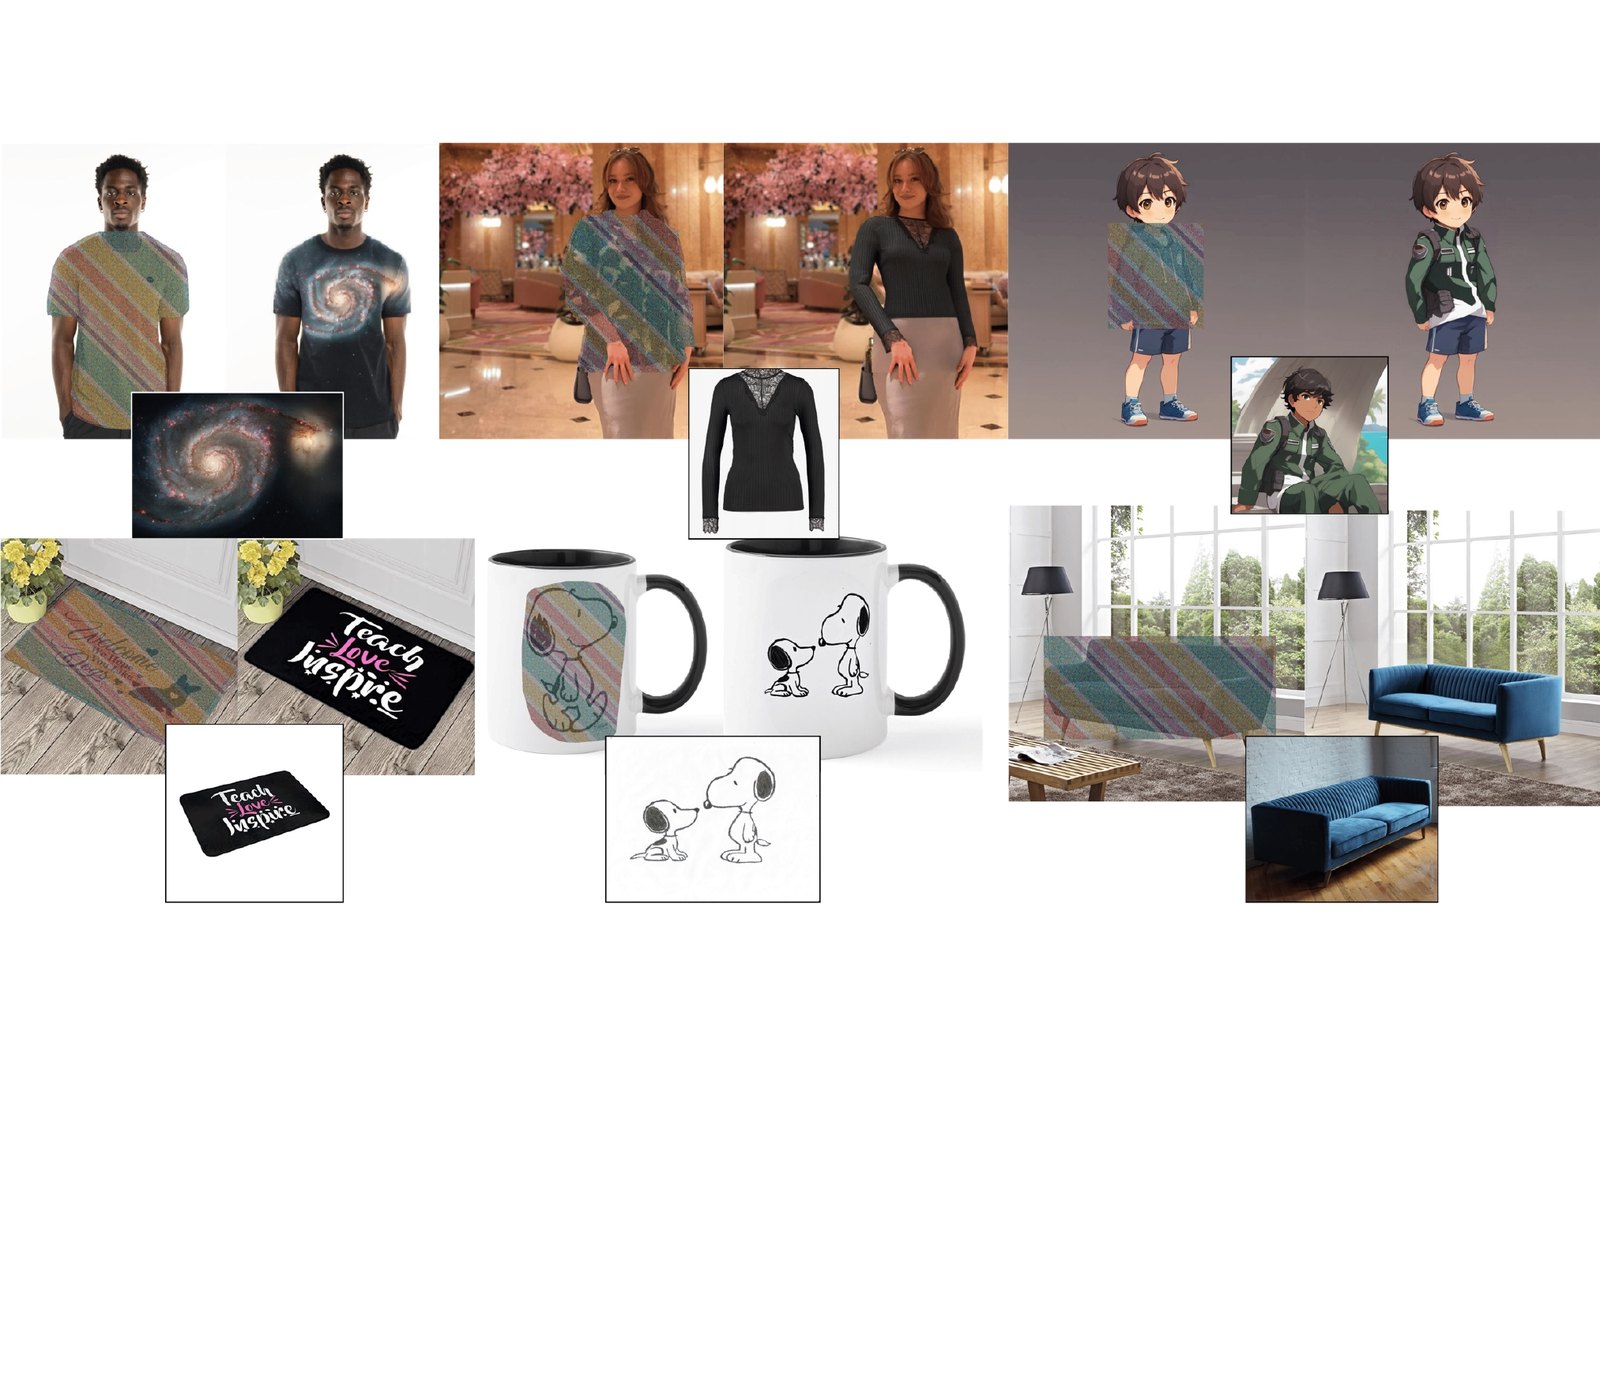
把 VTO 条件写成 score 的可学习增量
给定目标人物图、服装参考图和二值掩码,模型在 latent space 中生成换装结果。预训练 score 网络提供无条件或基础生成方向,辅助网络 \(h_t(\mathbf{x},\mathbf{y})\) 逼近条件事件带来的 score 修正。
| 符号 | 含义 | 形状或分布 |
|---|---|---|
| \(\mathbf{I}_p\) | 目标人物/目标输出图,也是训练监督 | \(\mathbb{R}^{3\times H\times W}\) |
| \(\mathbf{I}_g\) | 服装或产品参考图,可来自商品图或场景图 | \(\mathbb{R}^{3\times H\times W}\) |
| \(\mathbf{I}_M\) | 二值掩码;由 \(\mathbf{I}_a=\mathbf{I}_p\circ\mathbf{I}_M\) 可知值 1 对应保留像素 | \(\mathbb{R}^{H\times W}\) |
| \(\mathbf{I}_a\) | garment-agnostic 图,\(\mathbf{I}_p\circ\mathbf{I}_M\) | 图像空间 |
| \(\varepsilon,\mathbb{D}\) | 冻结的 VAE encoder 与 decoder | 预训练 |
| \(\mathbf{Z}_a,\mathbf{Z}_g\) | 人物与服装 latent | \(\mathbb{R}^{C_Z\times H_Z\times W_Z}\) |
| \(\mathbf{y}\) | 条件:拼接 latent 与 latent mask | \(\mathbf{Z}_c\otimes\mathbf{I}_{mc}\) |
| \(\mathbf{s}^{\theta^{\ast}}\) | 冻结的基础网络;连续时间中是 score,离散实现中按 epsilon prediction 写 | 项目页称约 2.4B 参数 |
| \(\mathbf{h}\) | 唯一训练的条件网络;理论中是 score guidance,算法中与 epsilon prediction 直接相加 | 项目页称 35.3M 参数 |
| \(\mathbf{H}_t\) | 条件反向过程的噪声 latent | VP-SDE / DDPM path |
Doob h-transform 的连续时间表达
Generalised h-transform 的 DSM 目标
冻结主干,辅助网络接收相同条件
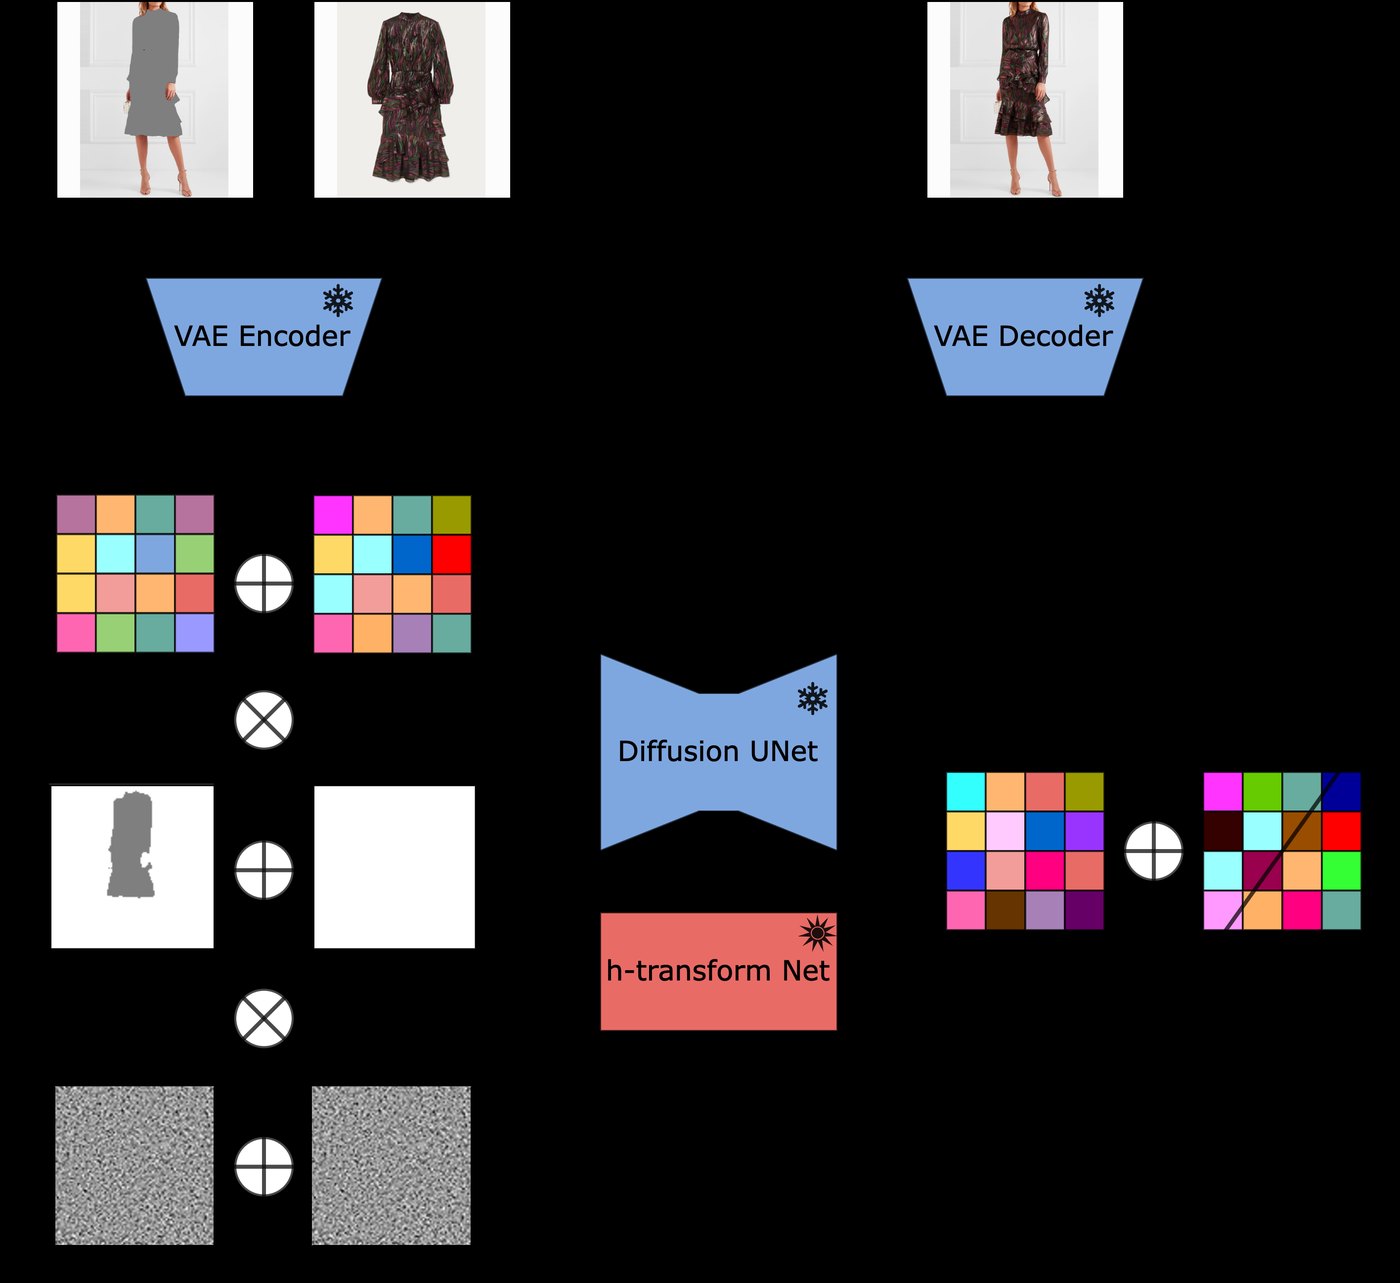
PEFT baseline
冻结 VAE,训练 diffusion U-Net 的一部分,论文称约占骨干 5.51%。正文摘要另写 5.52%,属于同一数量级的舍入差异。
DEFT-VTON
冻结 encoder 与 score 网络,训练辅助 h-transform。项目页给出 score 网络 2.4B、autoencoder 83.7M、h-transform 35.3M;论文未公开 h-transform 的层数、通道、block 类型或初始化。
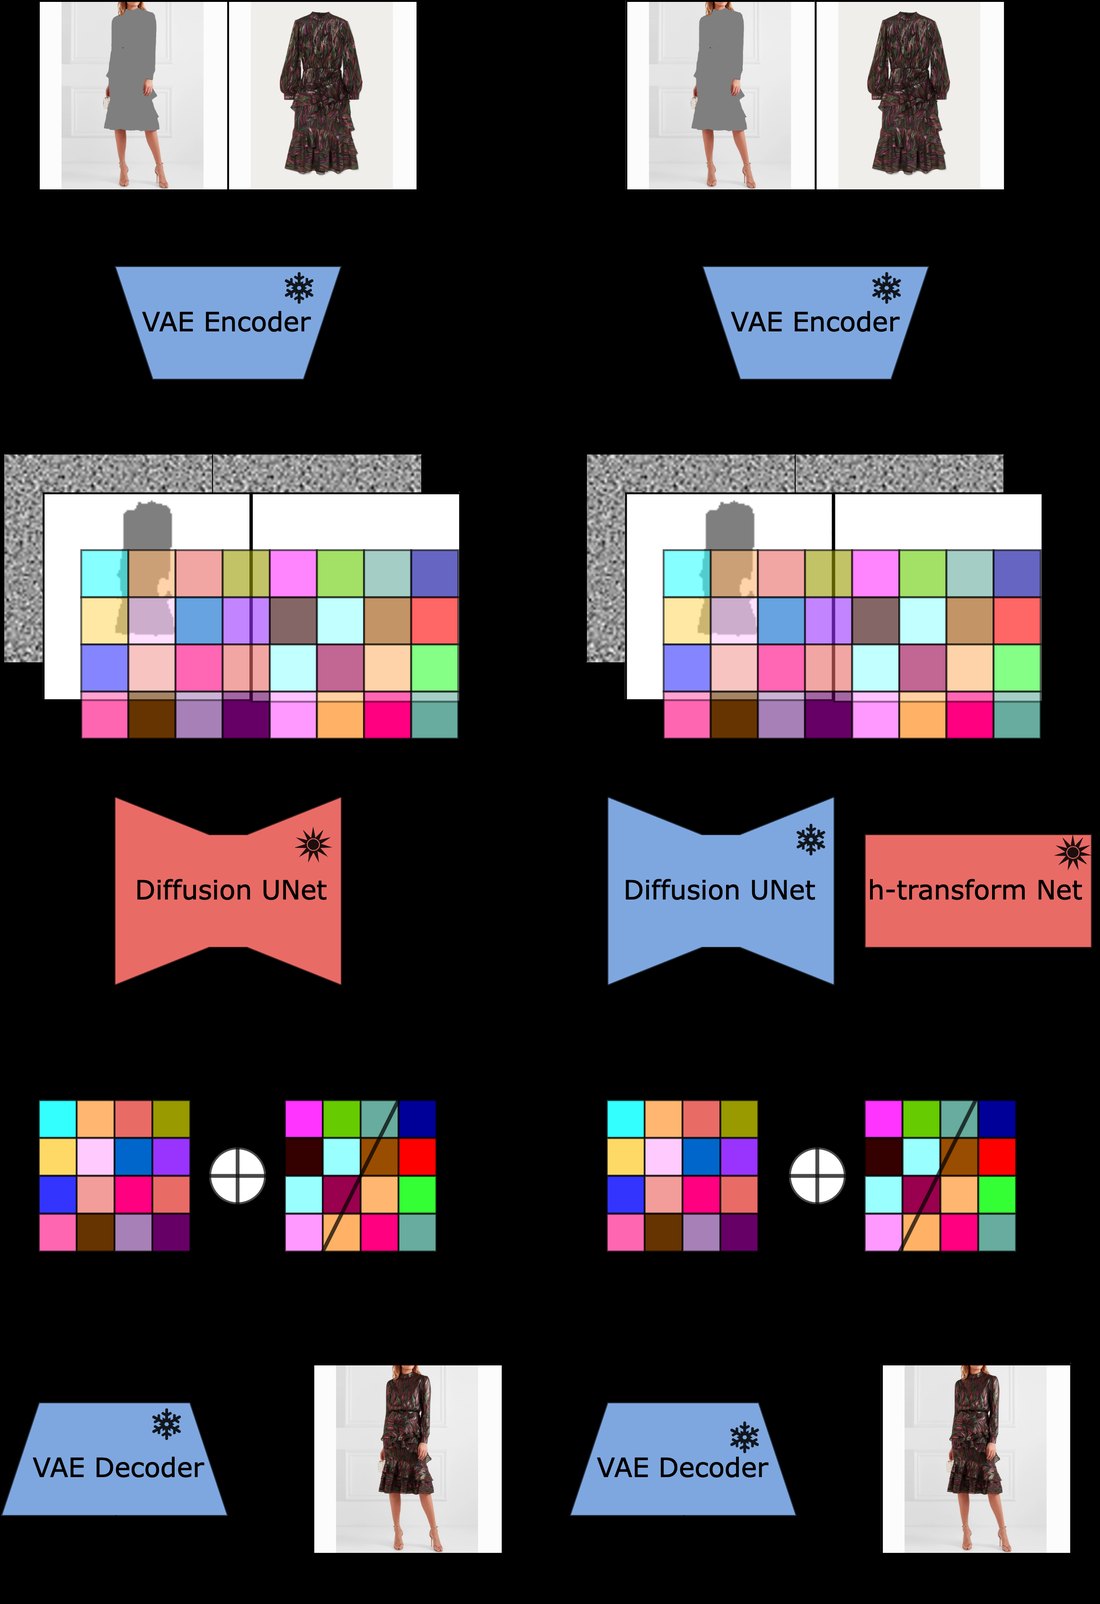
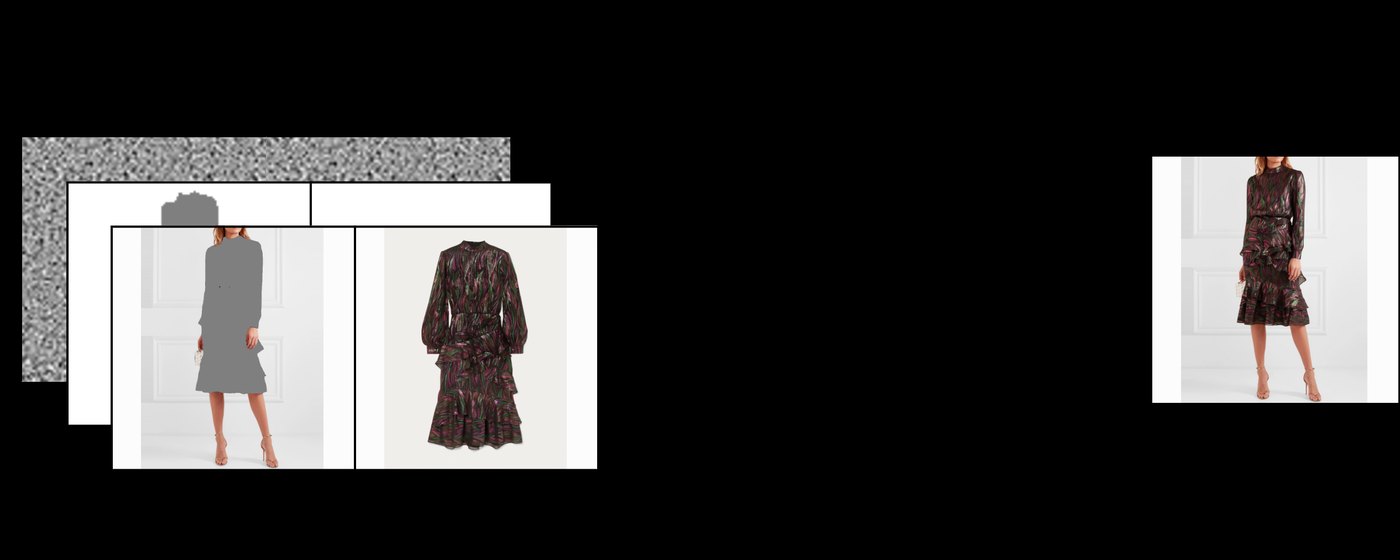
同一个 h-transform 的两阶段训练
训练先用 DSM 获得可靠 VTO 条件能力,再继续微调该网络,使相邻噪声时刻的 clean predictions 保持一致。基础 score 网络全程冻结。
阶段 A · DEFT
采样真实目标 latent、条件和噪声时刻,令 \(\mathbf{s}^{\theta^{\ast}}+\mathbf{h}\) 预测 noise/clean target,优化 DSM 或算法中采用的 pseudo-Huber 版本。
阶段 B · adaptive consistency
从阶段 A 的 h-transform 初始化,继续计算多个噪声时刻的预测。相邻预测用 pseudo-Huber 距离形成 \(\mathcal{L}_{\mathrm{CM}}\),并由 DSM 大小自适应保持 VTO 能力。
论文先介绍传统 teacher-EMA 蒸馏
DEFT-VTON 实际使用的 self-consistency
Adaptive objective
- 冻结预训练 encoder \(\varepsilon\) 和 score network \(\mathbf{s}\)。
- 将目标图、参考图和 mask 编码并拼接;算法文字把 \(\varepsilon(\mathbf{I}_p)\) 也并入 \(\mathbf{x}_0\)。
- 采样 \(N_t\) 个 \(t_j\sim\mathrm{Unif}(0,1)\) 与共享高斯噪声 \(\mathbf{W}\)。
- 构造 \(\mathbf{x}_{t_j}=\sqrt{\bar\alpha_{t_j}}\mathbf{x}_0+\sqrt{1-\bar\alpha_{t_j}}\mathbf{W}\)。
- 预测 \(\hat{\mathbf{x}}_0^{(i,j)}=\mathbf{s}(t_j,\mathbf{x}_{t_j}^{(i)})+\mathbf{h}(t_j,\mathbf{x}_{t_j}^{(i)})\)。
- DSM 对齐真实 \(\mathbf{x}_0\),CM 对齐相邻时刻预测,返回 adaptive loss 更新 \(\mathbf{h}\)。
公开测试集与未公开 VTA 训练集合
VITON-HD
测试 split 含 2,032 对正面上半身服装样本。paired 设置以人物原图作为 GT,计算 SSIM 与 LPIPS;unpaired 设置更换参考服装,计算生成图与源图分布之间的 FID 与 KID。测试直接复用数据集提供的预处理 mask。
Virtual Try-All
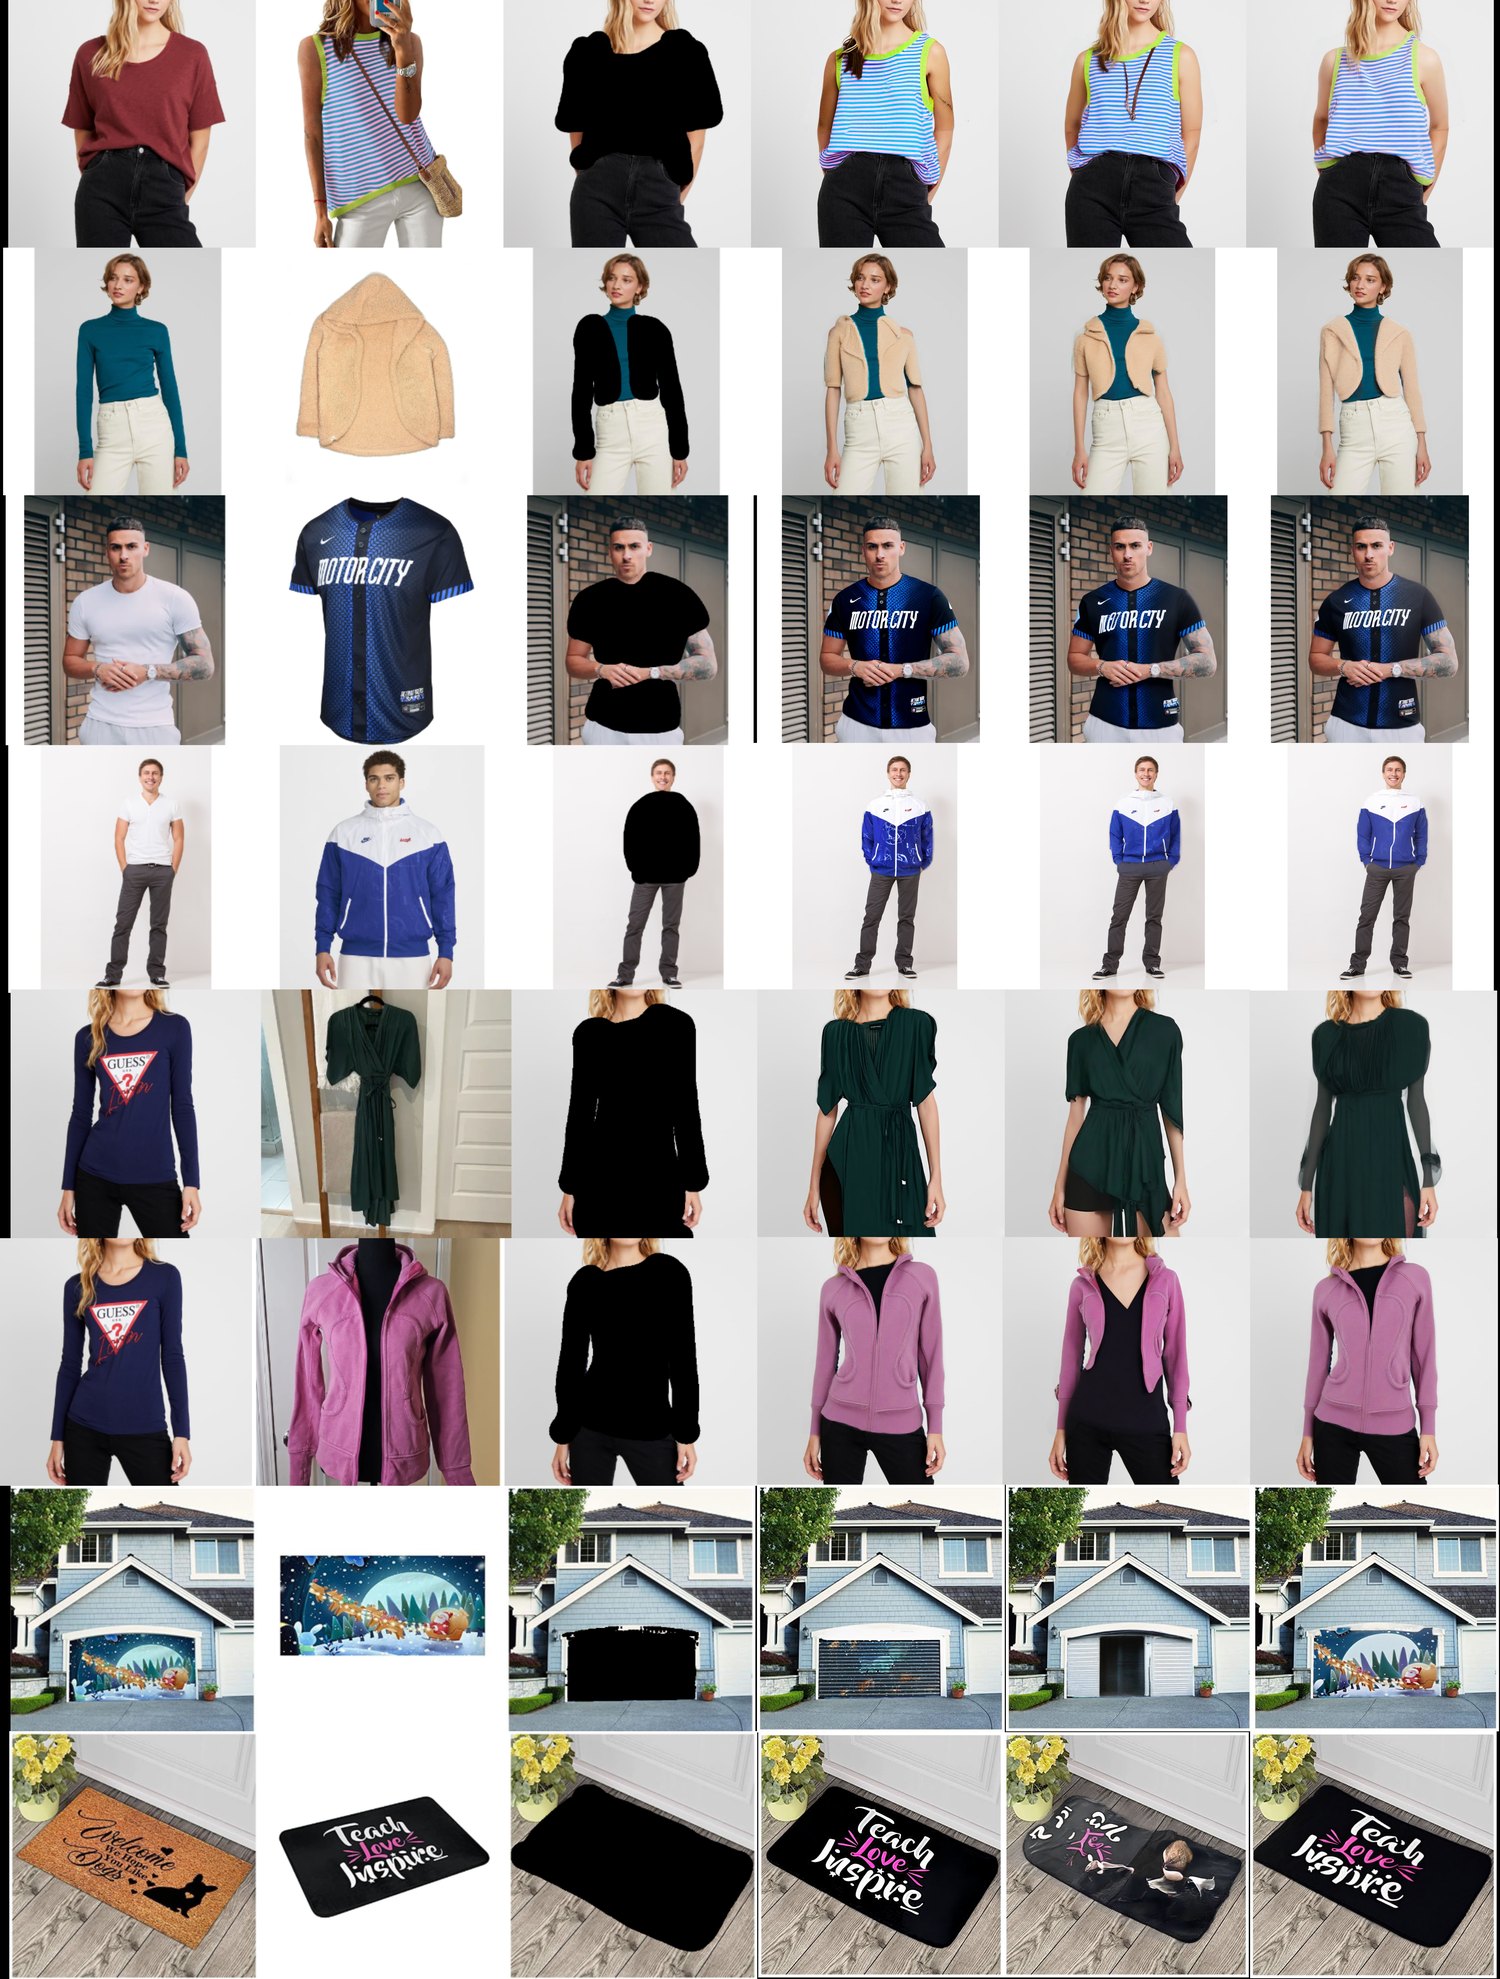
私有或未发布的 VTA 数据覆盖 jackets、pajamas、bags、hats、shoes、jewelry、toys 等,参考图包含 lay-flat、ghost-mannequin、on-figure 与 off-figure。论文没有给出样本数量、train/validation/test split、来源许可、类别分布或去重策略。
配对清洗
先用 classifier 判断 source image 是否展示 reference image 中的产品。论文没有给出分类器名称、阈值、错误率与人工审核比例。
Mask 生成
先用 object detector 在 source image 上生成产品 bounding box,再把 box 作为 prompt 交给 segmentation model 得到 inpainting mask。detector 与 segmenter 的具体模型、版本和 mask 后处理未公开。
完整 VITON-HD 主表与补充消融
主文 Table 1 与补充材料 Table 1 采用不同的 consistency 行。下面分别完整重建两张有效表,保留全部方法行和指标列。
主文 Table 1 · 9 行
| 方法 | 采样步数 | SSIM ↑ | LPIPS ↓ | FID ↓ | KID ↓ |
|---|---|---|---|---|---|
| StableVTON | — | 0.8543 | 0.0905 | 11.054 | 3.914 |
| LaDI-VTON | — | 0.8603 | 0.0733 | 14.648 | 8.754 |
| IDM-VTON | 30 | 0.8499 | 0.0603 | 9.842 | 1.123 |
| OOTDiffusion | 20 | 0.8187 | 0.0876 | 12.408 | 4.680 |
| CatVTON | 50 | 0.8704 | 0.0565 | 9.015 | 1.091 |
| DEFT · DSM | 25 | 0.9118 | 0.0533 | 8.3351 | 0.5212 |
| DEFT · DSM | 15 | 0.9098 | 0.0521 | 8.6339 | 0.7916 |
| DEFT · DSM + CM | 25 | 0.9105 | 0.0564 | 8.6310 | 0.7243 |
| DEFT · DSM + CM | 15 | 0.9130 | 0.0542 | 8.8567 | 1.016 |
Supplementary Table 1 · 25 行
| 方法 | 采样步数 | SSIM ↑ | LPIPS ↓ | FID ↓ | KID ↓ |
|---|---|---|---|---|---|
| StableVTON | — | 0.8543 | 0.0905 | 11.054 | 3.914 |
| LaDI-VTON | — | 0.8603 | 0.0733 | 14.648 | 8.754 |
| IDM-VTON | 30 | 0.8499 | 0.0603 | 9.842 | 1.123 |
| OOTDiffusion | 20 | 0.8187 | 0.0876 | 12.408 | 4.680 |
| CatVTON | 50 | 0.8704 | 0.0565 | 9.015 | 1.091 |
| DEFT · DSM | 25 | 0.9118 | 0.0533 | 8.3351 | 0.5212 |
| DEFT · DSM | 15 | 0.9098 | 0.0521 | 8.6339 | 0.7916 |
| DEFT · 0.2 DSM + CM | 12 | 0.9063 | 0.0782 | 25.7948 | 15.52 |
| DEFT · 0.2 DSM + CM | 15 | 0.9064 | 0.0798 | 27.8843 | 18.92 |
| DEFT · 0.2 DSM + CM | 25 | 0.9034 | 0.0853 | 33.2223 | 24.53 |
| DEFT · 0.4 DSM + CM | 12 | 0.9135 | 0.0553 | 9.1671 | 1.2612 |
| DEFT · 0.4 DSM + CM | 15 | 0.9136 | 0.0552 | 8.7922 | 0.9970 |
| DEFT · 0.4 DSM + CM | 25 | 0.9098 | 0.0581 | 8.4704 | 0.6649 |
| DEFT · 0.6 DSM + CM | 12 | 0.9122 | 0.0560 | 9.0136 | 1.1998 |
| DEFT · 0.6 DSM + CM | 15 | 0.9132 | 0.0553 | 8.6611 | 0.9104 |
| DEFT · 0.6 DSM + CM | 25 | 0.9100 | 0.0579 | 8.5988 | 0.6713 |
| DEFT · 0.8 DSM + CM | 12 | 0.9112 | 0.0571 | 9.0765 | 1.2336 |
| DEFT · 0.8 DSM + CM | 15 | 0.9126 | 0.0561 | 8.7394 | 0.9378 |
| DEFT · 0.8 DSM + CM | 25 | 0.9101 | 0.0592 | 8.4160 | 0.5474 |
| DEFT · 1.0 DSM + CM | 10 | 0.8935 | 0.0862 | 12.7324 | 3.5322 |
| DEFT · 1.0 DSM + CM | 11 | 0.9111 | 0.0573 | 9.2023 | 1.3684 |
| DEFT · 1.0 DSM + CM | 12 | 0.9114 | 0.0571 | 8.9859 | 1.1134 |
| DEFT · 1.0 DSM + CM | 15 | 0.9125 | 0.0561 | 8.7113 | 0.8937 |
| DEFT · 1.0 DSM + CM | 20 | 0.9081 | 0.0617 | 8.8301 | 0.8030 |
| DEFT · 1.0 DSM + CM | 25 | 0.9091 | 0.0599 | 8.5058 | 0.5952 |
纯 DSM 的最强分布指标
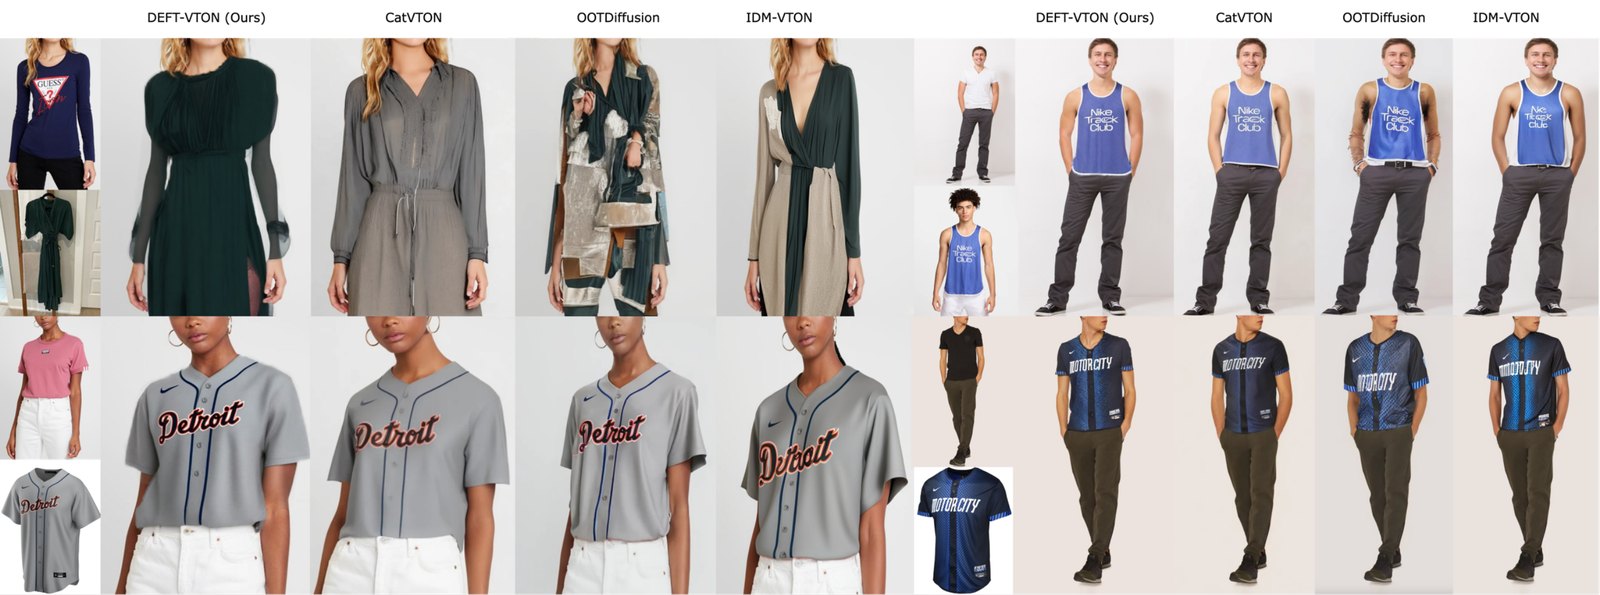
25 步 DSM 得到 FID 8.3351、KID 0.5212,均为完整表最佳;15 步 DSM 得到最佳 LPIPS 0.0521。减少 10 步后这些指标仍高于全部所列 baseline,说明基础 DEFT 已具备较强低步数能力。
Consistency 的准确取舍
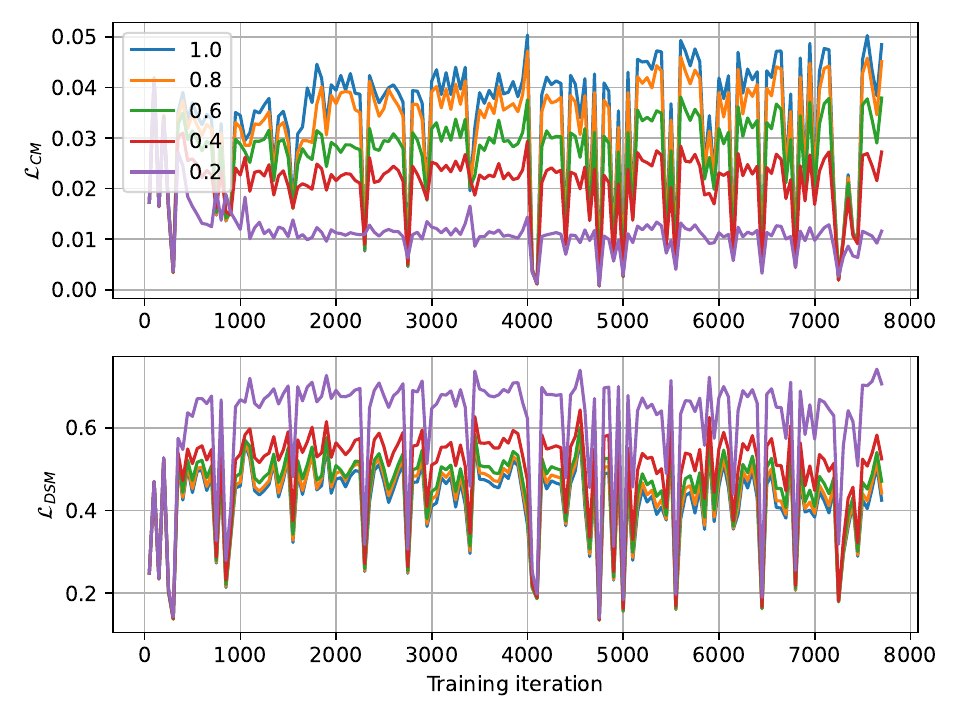
主文同为 25 步时,加入 CM 后 SSIM 从 0.9118 降至 0.9105、LPIPS 从 0.0533 升至 0.0564、FID 从 8.3351 升至 8.6310、KID 从 0.5212 升至 0.7243,四项均变差。同为 15 步时,SSIM 从 0.9098 升至 0.9130,LPIPS、FID、KID 分别从 0.0521 / 8.6339 / 0.7916 变为 0.0542 / 8.8567 / 1.016,后三项变差。CM 的主要证据是 15 步 SSIM 与困难样例定性表现。
系数与步数交互
0.4 DSM + CM、15 步取得完整补充表最佳 SSIM 0.9136,但 FID/KID 仍弱于纯 DSM 25 步。0.2 系数造成 FID/KID 大幅恶化,支持作者关于 DSM 权重过低会丢失 VTO 能力的判断。
指标与单位
补充材料表头只写 KID,没有 \(\times 10^3\) 或其他缩放单位,页面保持原数值与原单位标注。论文没有报告置信区间或重复运行方差。
步数并非单调更优
补充材料指出 SSIM/LPIPS 约在 15 步附近达到较好值,FID/KID 随步数增加整体改善;作者同时观察到更多步数会增加部分 hallucination。各指标覆盖的质量侧面不同。
基线公平性
主文给出 IDM-VTON 30 步、OOTDiffusion 20 步、CatVTON 50 步;StableVTON 与 LaDI-VTON 步数、分辨率、模型大小和硬件成本没有统一列出。
可以核实的配置,以及公开材料留下的空白
| 项目 | 核实值 | 证据与说明 |
|---|---|---|
| 基础模型 | Latent Diffusion;预训练 autoencoder + score diffusion U-Net | 正式论文 4.2;结论的 “diffusion transformer” 与此不一致 |
| 冻结组件 | encoder / autoencoder 与 score network 全部冻结 | Algorithm 1、Figure 2–4 |
| 训练组件 | 35.3M h-transform | 官方项目页;约为冻结 2.4B score + 83.7M VAE 的 1.42% |
| PEFT baseline | 约 5.51% 可训练 | Figure 3;摘要写 5.52% |
| 输入尺寸 | 1024 × 1024 | arXiv TeX 源码中被注释的实现段落;未出现在渲染论文 |
| 优化器 | AdamW | 同上,需视为未进入正式稿的作者源码信息 |
| 学习率 | \(10^{-5}\) | 同上 |
| 批量大小 | 8 | 同上;未说明全局批量或每张 GPU |
| 训练硬件 | 8 × NVIDIA H100 | 正式论文 4.2 |
| 采样器 | DDIM adapted to consistency models | 正式论文;参考 Consistency Models Algorithm 1 |
| 常用推理步数 | 15;消融覆盖 10、11、12、15、20、25 | 主文与补充材料 |
| loss metric | pseudo-Huber | 3.3 与 Algorithm 1 |
| 代码与权重 | 未发布 | 官方项目仓库只有展示站点与媒体文件 |
未公开的训练信息
h-transform 内部结构、初始化、训练 epoch/iteration 总数、warmup、scheduler、weight decay、precision、gradient accumulation、随机种子、训练时长、显存、\(N_t\)、pseudo-Huber 参数、\(b_1,b_2\) 和最终 \(\lambda\) 均缺失。
未公开的推理信息
DDIM 时间表、eta、consistency sampler 的精确修改、CFG 或其他 guidance scale、输入预处理、mask 膨胀、随机种子、每张图延迟、吞吐量、显存与后处理均缺失。
论文源码提供的额外线索
arXiv v1 TeX 中保留一段被注释的 implementation text,写有 Diffusers、2.4B / 83.7M / 35.3M、1024、AdamW、学习率 \(10^{-5}\)、batch 8。项目页独立确认三个参数规模;其余值没有进入正式论文。
表格与附录一致性
主文表注声称 appendix 提供 DressCode 结果;TeX 源码中 DressCode 表被整体注释,正式补充材料只渲染 VITON-HD。因此页面不把这些隐藏行当作正式实验结论。
论文验证、作者解释与可延伸方向
贡献明确,复现与因果证据仍然薄弱
Strengths
- 把 Doob h-transform 从一般 diffusion adaptation 明确落到 VTO 条件生成。
- 完全冻结大型骨干,训练参数比例从约 5.51% 降至 1.42%。
- 区分 DSM 条件能力与 trajectory consistency,并用完整系数/步数消融展示失败区间。
- 补充材料保留全部 25 行 VITON-HD 数值,便于检查指标取舍。
Weaknesses
- 未公开代码、权重、h-transform 结构和关键超参数,核心方法无法独立复现。
- VTA 数据规模、来源与 split 缺失,跨域结论缺少受控实验。
- 没有统一 wall-clock、显存、训练小时数与能耗对比,效率证据主要来自参数比例和 NFE。
- 指标没有方差、置信区间或显著性检验;unpaired FID/KID 对单个服装保真度的解释有限。
- adaptive loss 的 threshold 机制缺少具体值和对照,论文宣称的“data-adaptive”行为难以复核。
Potential improvements
- 公开 adapter 结构、完整训练配置和 sampler 实现,并提供固定 seed 的复现实验。
- 增加 teacher-free consistency、EMA teacher、纯 DSM、固定加权与 adaptive threshold 的等预算对照。
- 加入服装 logo OCR、纹理对应、身份保持、mask 边界与局部编辑泄漏指标。
- 对 VTA 按类别、参考形态与稀有度分层报告结果,配合数据量消融。
可形成后续论文的问题
把 consistency residual 作为推理时的可信度信号,针对每个样本动态选择时间步;将 h-transform 拆成 garment identity、pose/geometry、background preservation 三个可组合 guidance;用小型 reward model 对多候选进行低成本 reranking,并检测文字与图形破坏。
一手资料
- CVF Open Access 正式出版页:作者、venue、正式 PDF、补充材料与 BibTeX。
- CVPR 2025 eLVM Workshop 正文 PDF:10 页。
- 正式 Supplementary Material:3 页,含完整系数与采样步数表。
- arXiv:2509.13506v1:13 页合订版本与 TeX source。
- 官方项目页:演示、作者身份、参数规模;页面中的 arXiv 按钮误链到另一篇论文,本文以 CVF 与 arXiv 正式记录为准。
- 官方项目页仓库:核查 commit
f671a00,只有展示网页和媒体资源。 - Denker et al., DEFT: Efficient Fine-tuning of Diffusion Models by Learning the Generalised h-transform:理论来源。
- Song et al., Consistency Models;Song & Dhariwal, Improved Techniques for Training Consistency Models:consistency 训练与采样背景。