公开推理结构
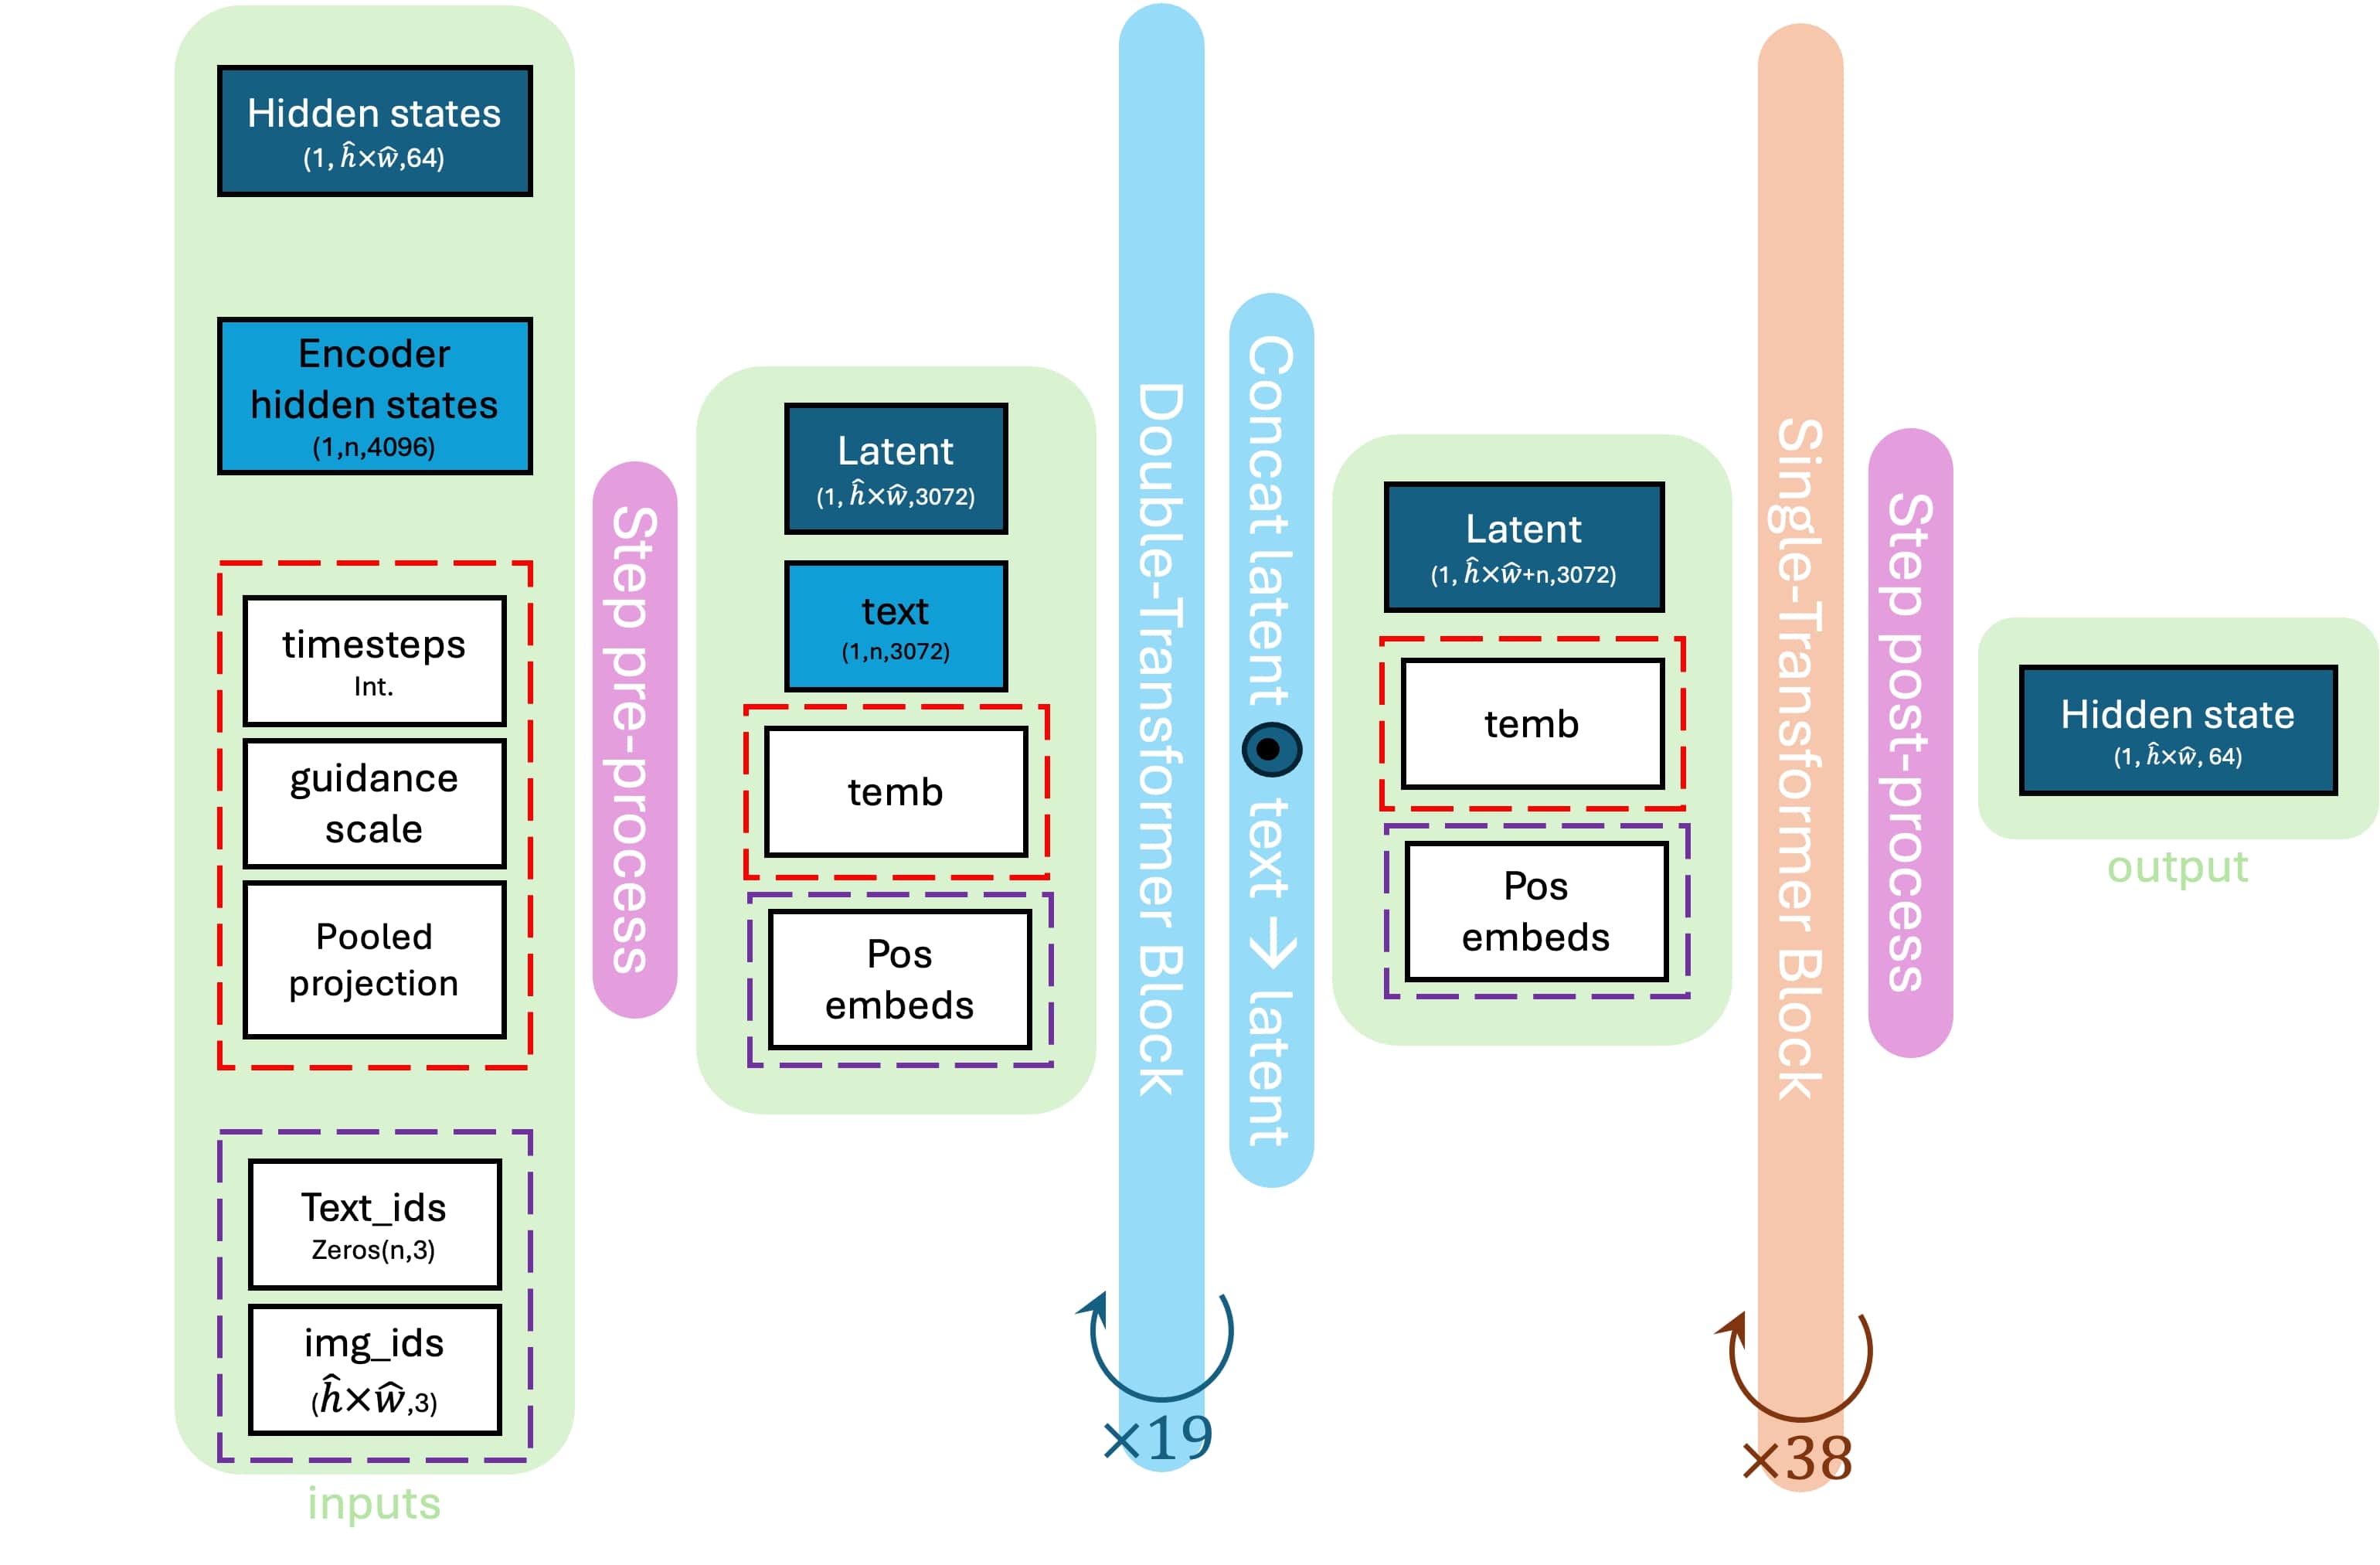
19 个 DoubleStreamBlock、38 个 SingleStreamBlock、hidden size 3072、24 个 attention heads、head dimension 128、MLP ratio 4。固定代码提交早于论文提交日 12 天。
从 16 通道 latent 到 64 维 packed image token,再经过 19 个双流块与 38 个单流块:这份精读把 FLUX.1 的公开推理路径拆成可核查的张量、公式与代码语义。
论文的价值集中在架构讲解与源码导读。它没有提供 FLUX.1 的原始训练记录,也没有完成可复核的定量 benchmark。
19 个 DoubleStreamBlock、38 个 SingleStreamBlock、hidden size 3072、24 个 attention heads、head dimension 128、MLP ratio 4。固定代码提交早于论文提交日 12 天。
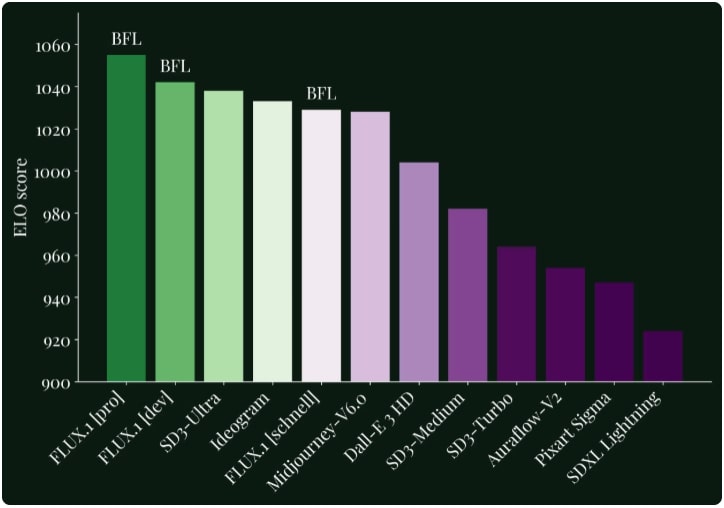
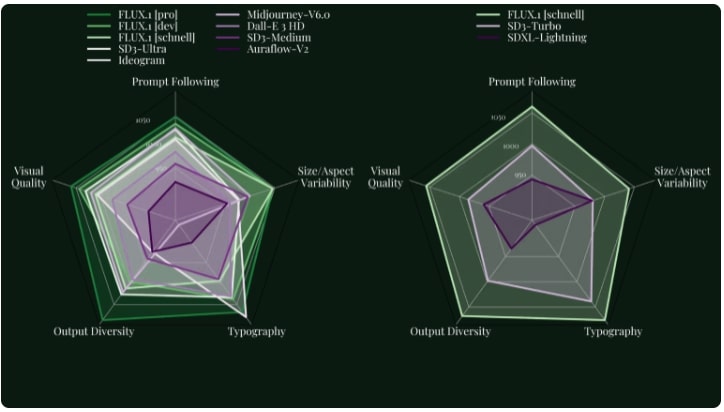
BFL 官方公告称公开 FLUX.1 模型基于 flow matching、混合 multimodal 与 parallel DiT blocks,并达到 12B 参数规模。性能排名来自厂商发布的偏好评测图。
训练数据组成、清洗、采样比例、优化器、学习率、batch size、训练步数、GPU 数量、总算力、完整 loss 权重、distillation 配方均没有在本报告或基础推理仓库中公开。
这份报告把分散在推理代码中的信息组织成可读图示,尤其解释两阶段 Transformer、AdaLN modulation、三轴 RoPE 与双文本编码器。它适合作为源码入口和架构地图;复现 FLUX.1 训练仍缺少关键条件。
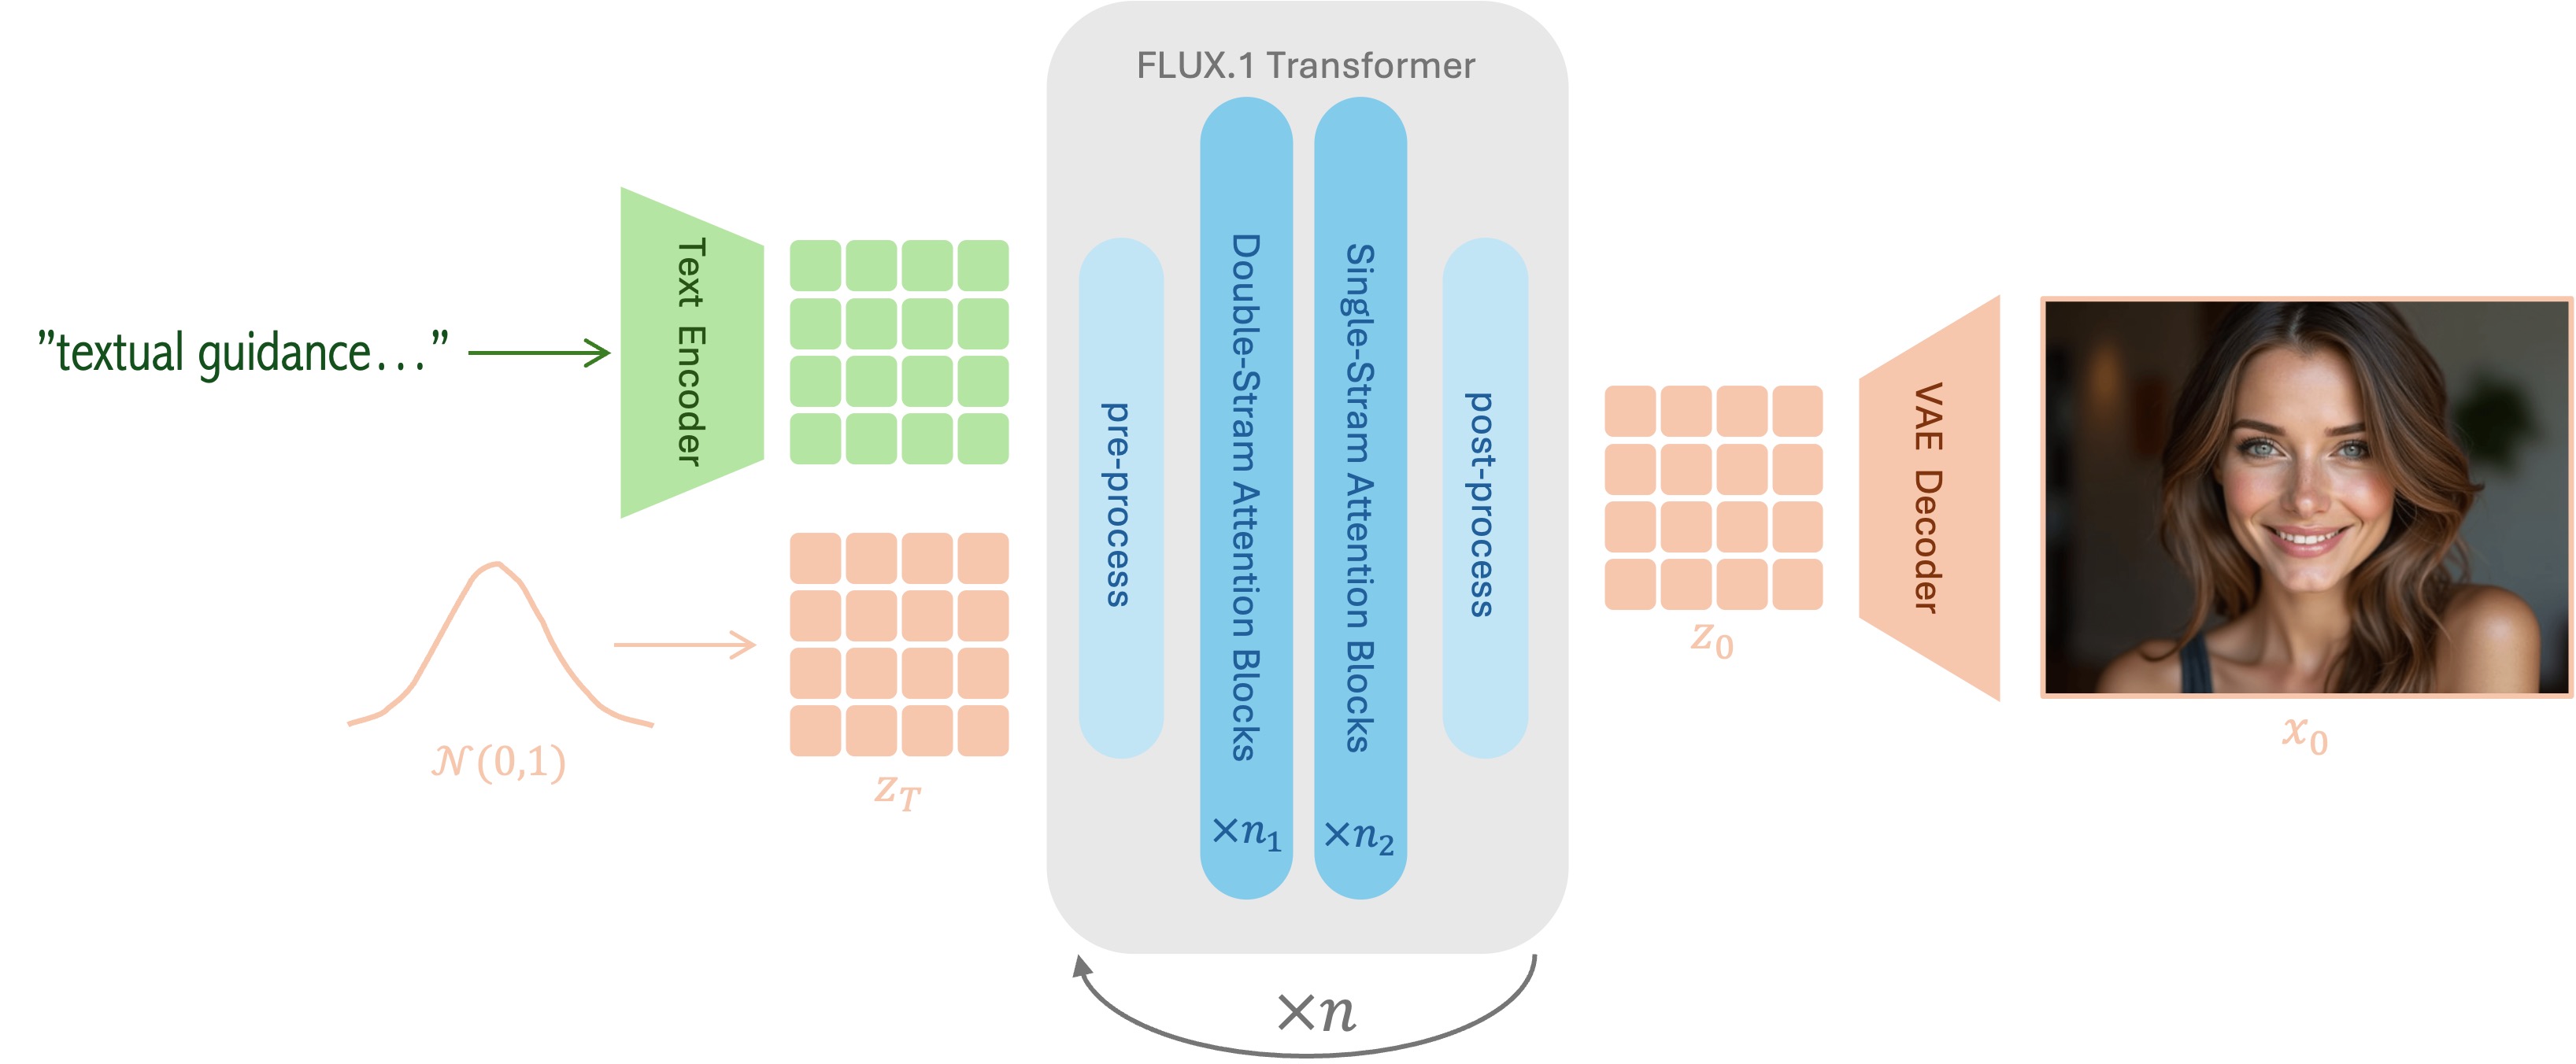
文本先进入两个冻结编码器;图像生成过程在 VAE latent 中运行;Transformer 输出每个 packed image token 的 velocity;最后由 VAE decoder 返回 RGB。
T5-v1_1-XXL 产生逐 token 的 dense representation,官方基础代码中 dev 最大长度为 512,schnell 为 256,特征维度为 4096。CLIP ViT-L/14 产生整句 pooled vector,维度为 768。
目标像素尺寸 \(H\times W\) 经 VAE scale 8 映射到 16 通道 latent。官方代码为便于 \(2\times2\) packing,噪声尺寸使用 [B,16,2⌈H/16⌉,2⌈W/16⌉]。
每个 \(2\times2\) latent 邻域按通道展平,得到 64 维 token。空间 token 数为 \(L_I=\lceil H/16\rceil\lceil W/16\rceil\)。这一步属于重新排列,没有可训练参数。
每个 sampling step 都把当前 image tokens、T5 tokens、CLIP pooled vector、timestep、guidance 和三轴 token IDs 送入同一 Transformer。网络输出与 packed image tokens 同形状的 velocity。
官方代码在递减时间表上执行 \(x\leftarrow x+(t_{\mathrm{prev}}-t_{\mathrm{curr}})v_{\theta}(x,t,c)\)。完成后 unpack 回 16 通道 latent,再经 VAE decoder 生成 RGB。
第一式是官方 AutoEncoder.encode 在 encoder 与 diagonal Gaussian regularizer 后的处理;第二式是 decode 在 decoder 前执行的逆变换。数值方向会影响外部 latent 与 VAE 原始 latent 的转换,不能只记录两个常数。
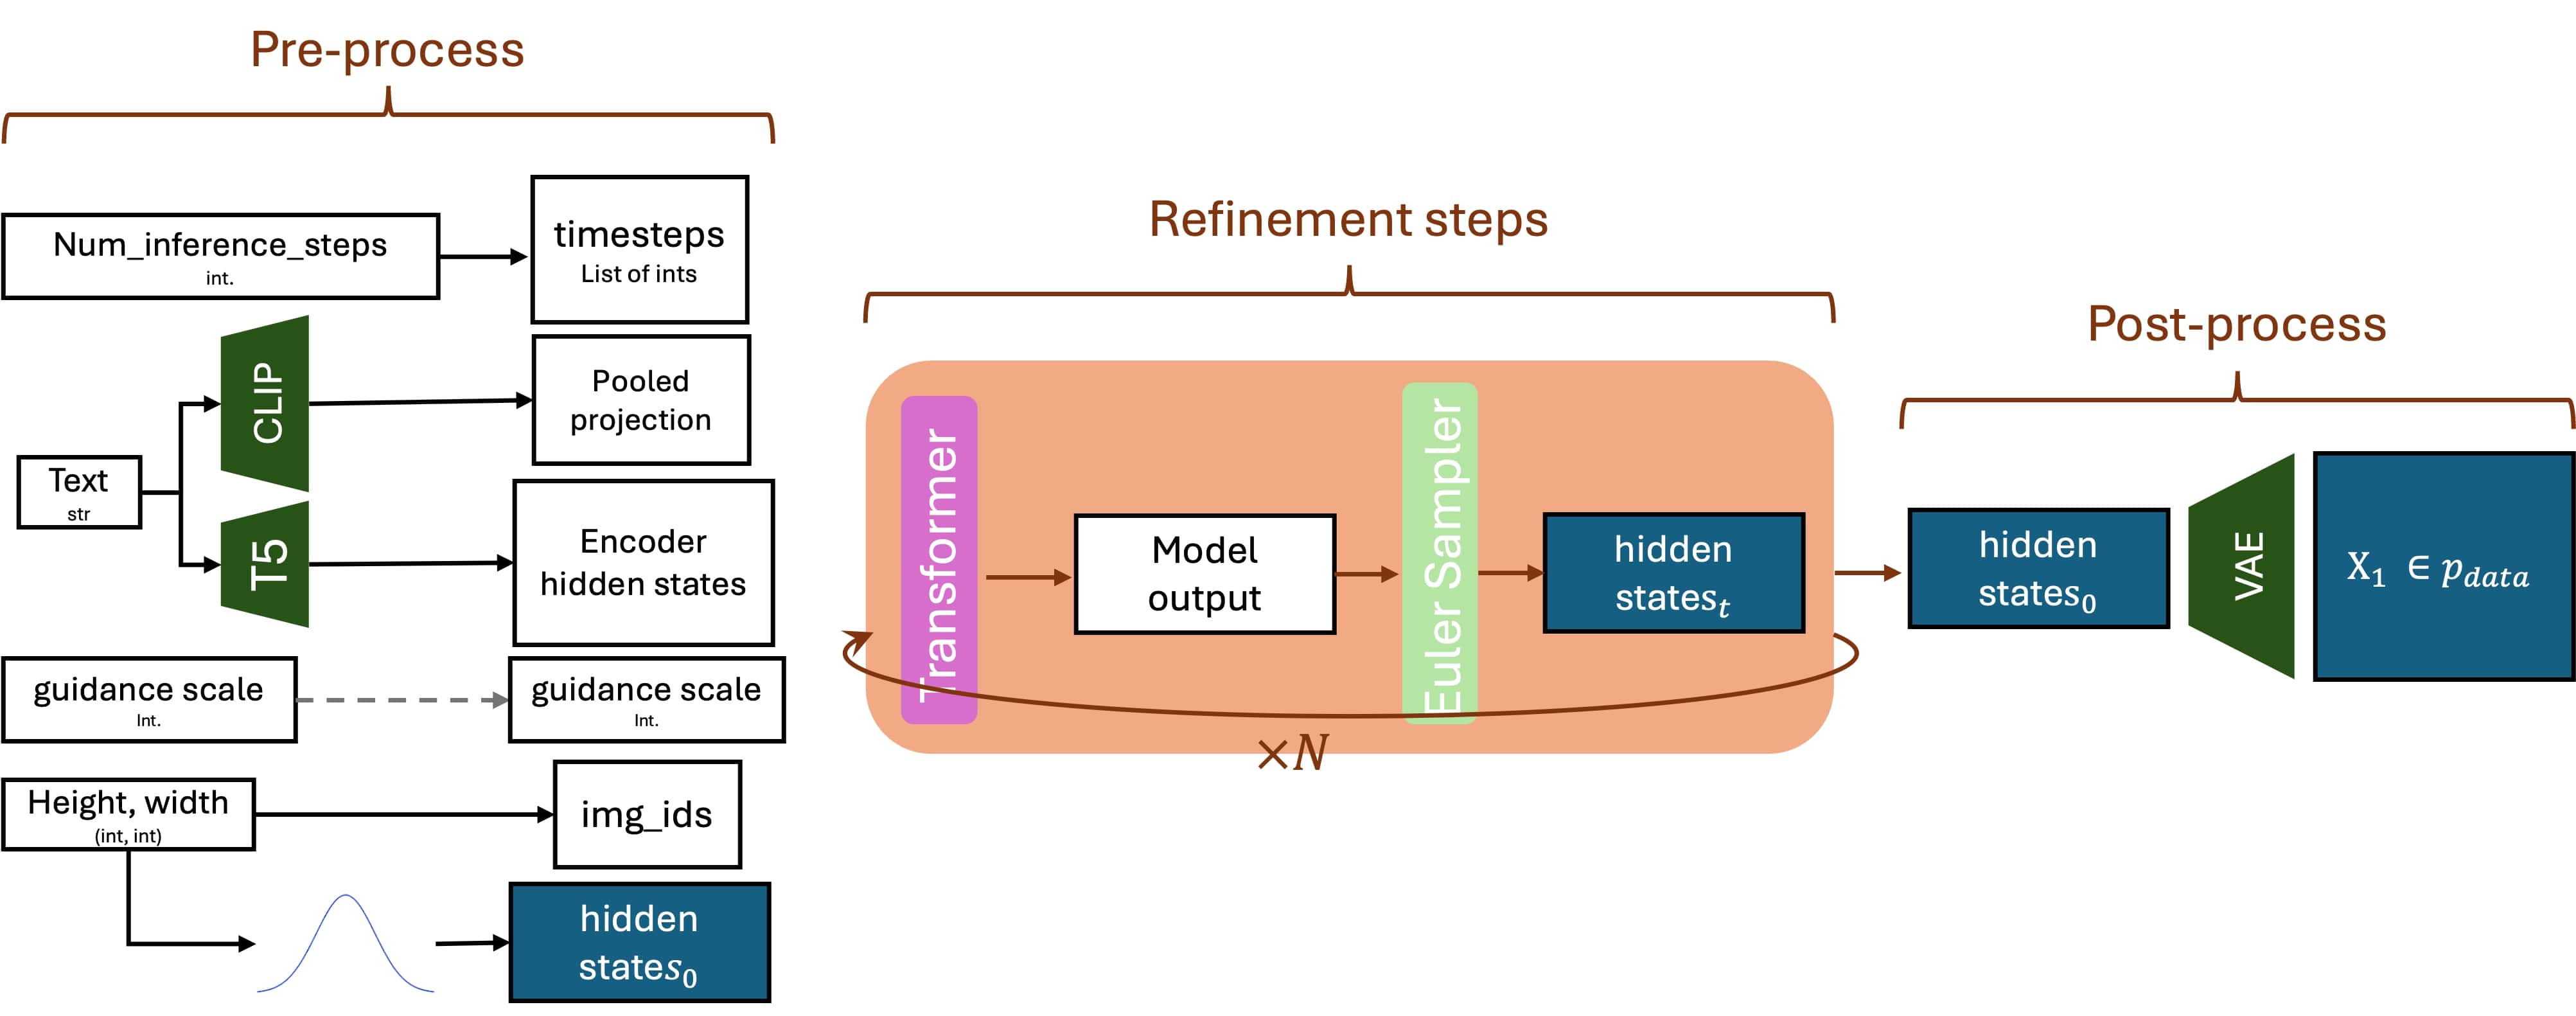
下表依据 BFL 官方提交的 sampling.py、model.py 与 util.py 重建。\(B\) 表示 batch size。
| 对象 | 进入 Transformer 前 | 线性投影后 | 作用 |
|---|---|---|---|
| 噪声 latent | [B,16,128,128] | 先 packing | 1024 像素除以 VAE scale 8 |
| packed image tokens | [B,4096,64] | [B,4096,3072] | 每个 token 汇集 \(16\times2\times2=64\) 个 latent 标量 |
| T5 tokens · dev | [B,512,4096] | [B,512,3072] | token-level prompt condition |
| T5 tokens · schnell | [B,256,4096] | [B,256,3072] | 官方 demo 使用较短最大长度 |
| CLIP pooled vector | [B,768] | [B,3072] | 整句语义进入全局 modulation vector |
| timestep embedding | [B,256] | [B,3072] | 正弦 embedding 经两层 MLP |
| guidance embedding · dev | [B,256] | [B,3072] | guidance-distilled 模型的条件;schnell 配置关闭 |
| token IDs | [B,512+4096,3] | RoPE matrix | 文本 ID 全零;图像 ID 为 \((0,h,w)\) |
| velocity output | — | [B,4096,64] | 只保留 image token 部分,再执行 Euler 更新 |
官方实现的 einops 语义为 b c (h ph) (w pw) → b (h w) (c ph pw),其中 \(p_h=p_w=2\)。因此每个 token 保留一个 \(2\times2\) latent patch 的完整 16 通道内容。像素空间里,这个 token 对应约 \(16\times16\) 像素区域。
报告用 Rectified Flow 的直线路径解释 FLUX.1。这个公式提供方法背景;BFL 基础仓库仅公开推理实现,因此无法从代码确认完整训练采样分布和 loss 细节。
语义:网络回归注入的噪声 \(\epsilon\)。报告用它建立传统 diffusion 与 velocity prediction 的差别。
在报告第 1.4 节的记号里,\(x_0\sim\mathcal{N}(0,I)\) 是噪声,\(x_1\sim p_{\mathrm{data}}\) 是数据,目标 velocity \(x_1-x_0\) 沿直线从噪声指向数据。\(v_{\theta}\) 接收中间状态与时间,学习条件向量场。
条件集合 \(c\) 包含 T5 token embeddings、CLIP pooled embedding、guidance、image IDs 与 text IDs。官方推理代码使用 \(t_{\mathrm{curr}}\) 到 \(t_{\mathrm{prev}}\) 的显式 Euler 步进。
这给出两套约定的显式转换:报告的正向参数 \(t:0\rightarrow1\) 从噪声走向数据;代码参数 \(\tau:1\rightarrow0\) 也从噪声走向数据。代码预测的是关于 \(\tau\) 的导数,且 Euler 的 \(\Delta\tau\lt0\),所以更新方向仍然指向 clean latent。实际推理依然需要多次网络求值与 Euler 积分;报告背景中“消除 iterative reverse denoising”的措辞只能理解为采用确定性 ODE velocity formulation,不能理解成单次前向生成。
dev 对基础线性时间表应用此 shift,image sequence 越长,时间点越偏向高噪声区间。schnell 的官方入口把 shift 关闭。报告只写“Flow-Matching Euler Discrete sampler”,没有给出这段分辨率相关公式。
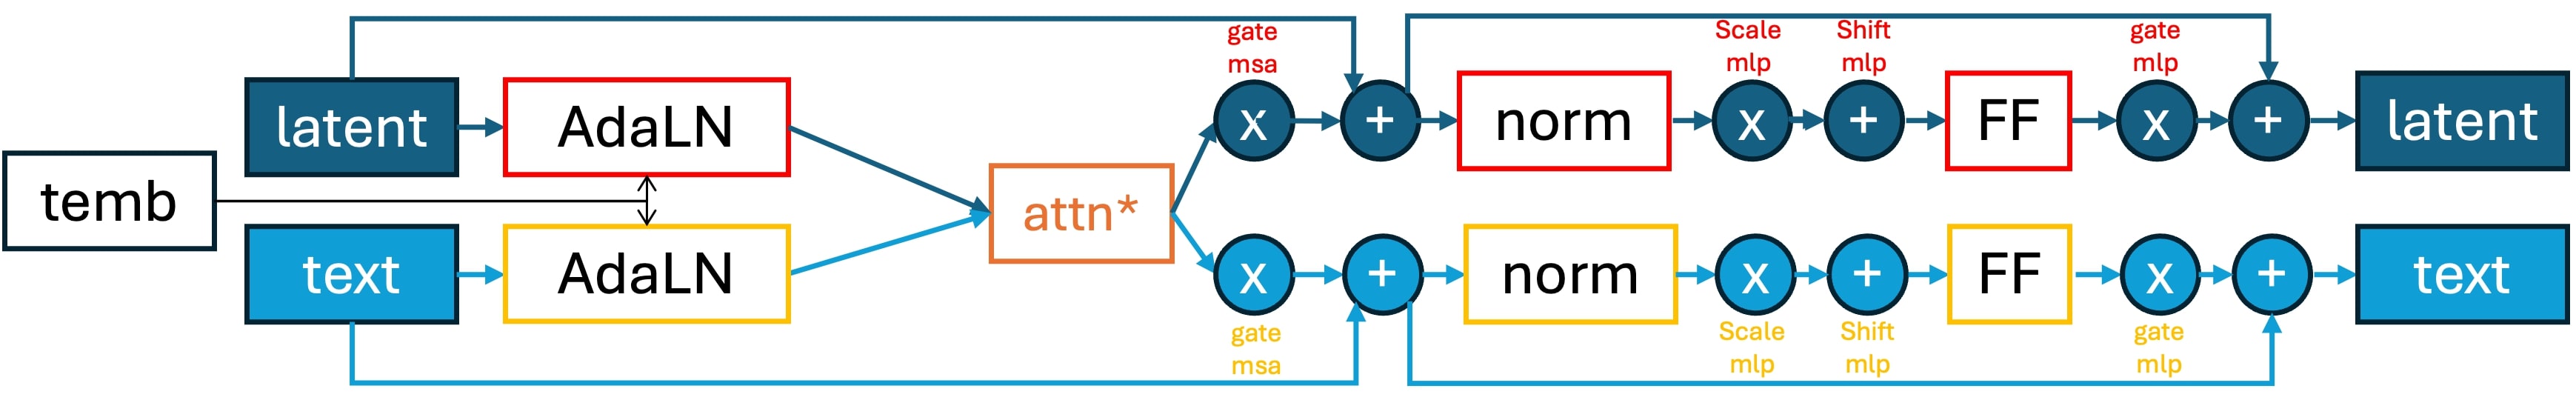
两类 block 都允许文本与图像双向交互。差异集中在参数共享方式、attention 与 MLP 的组合方式,以及 modulation 的数量。
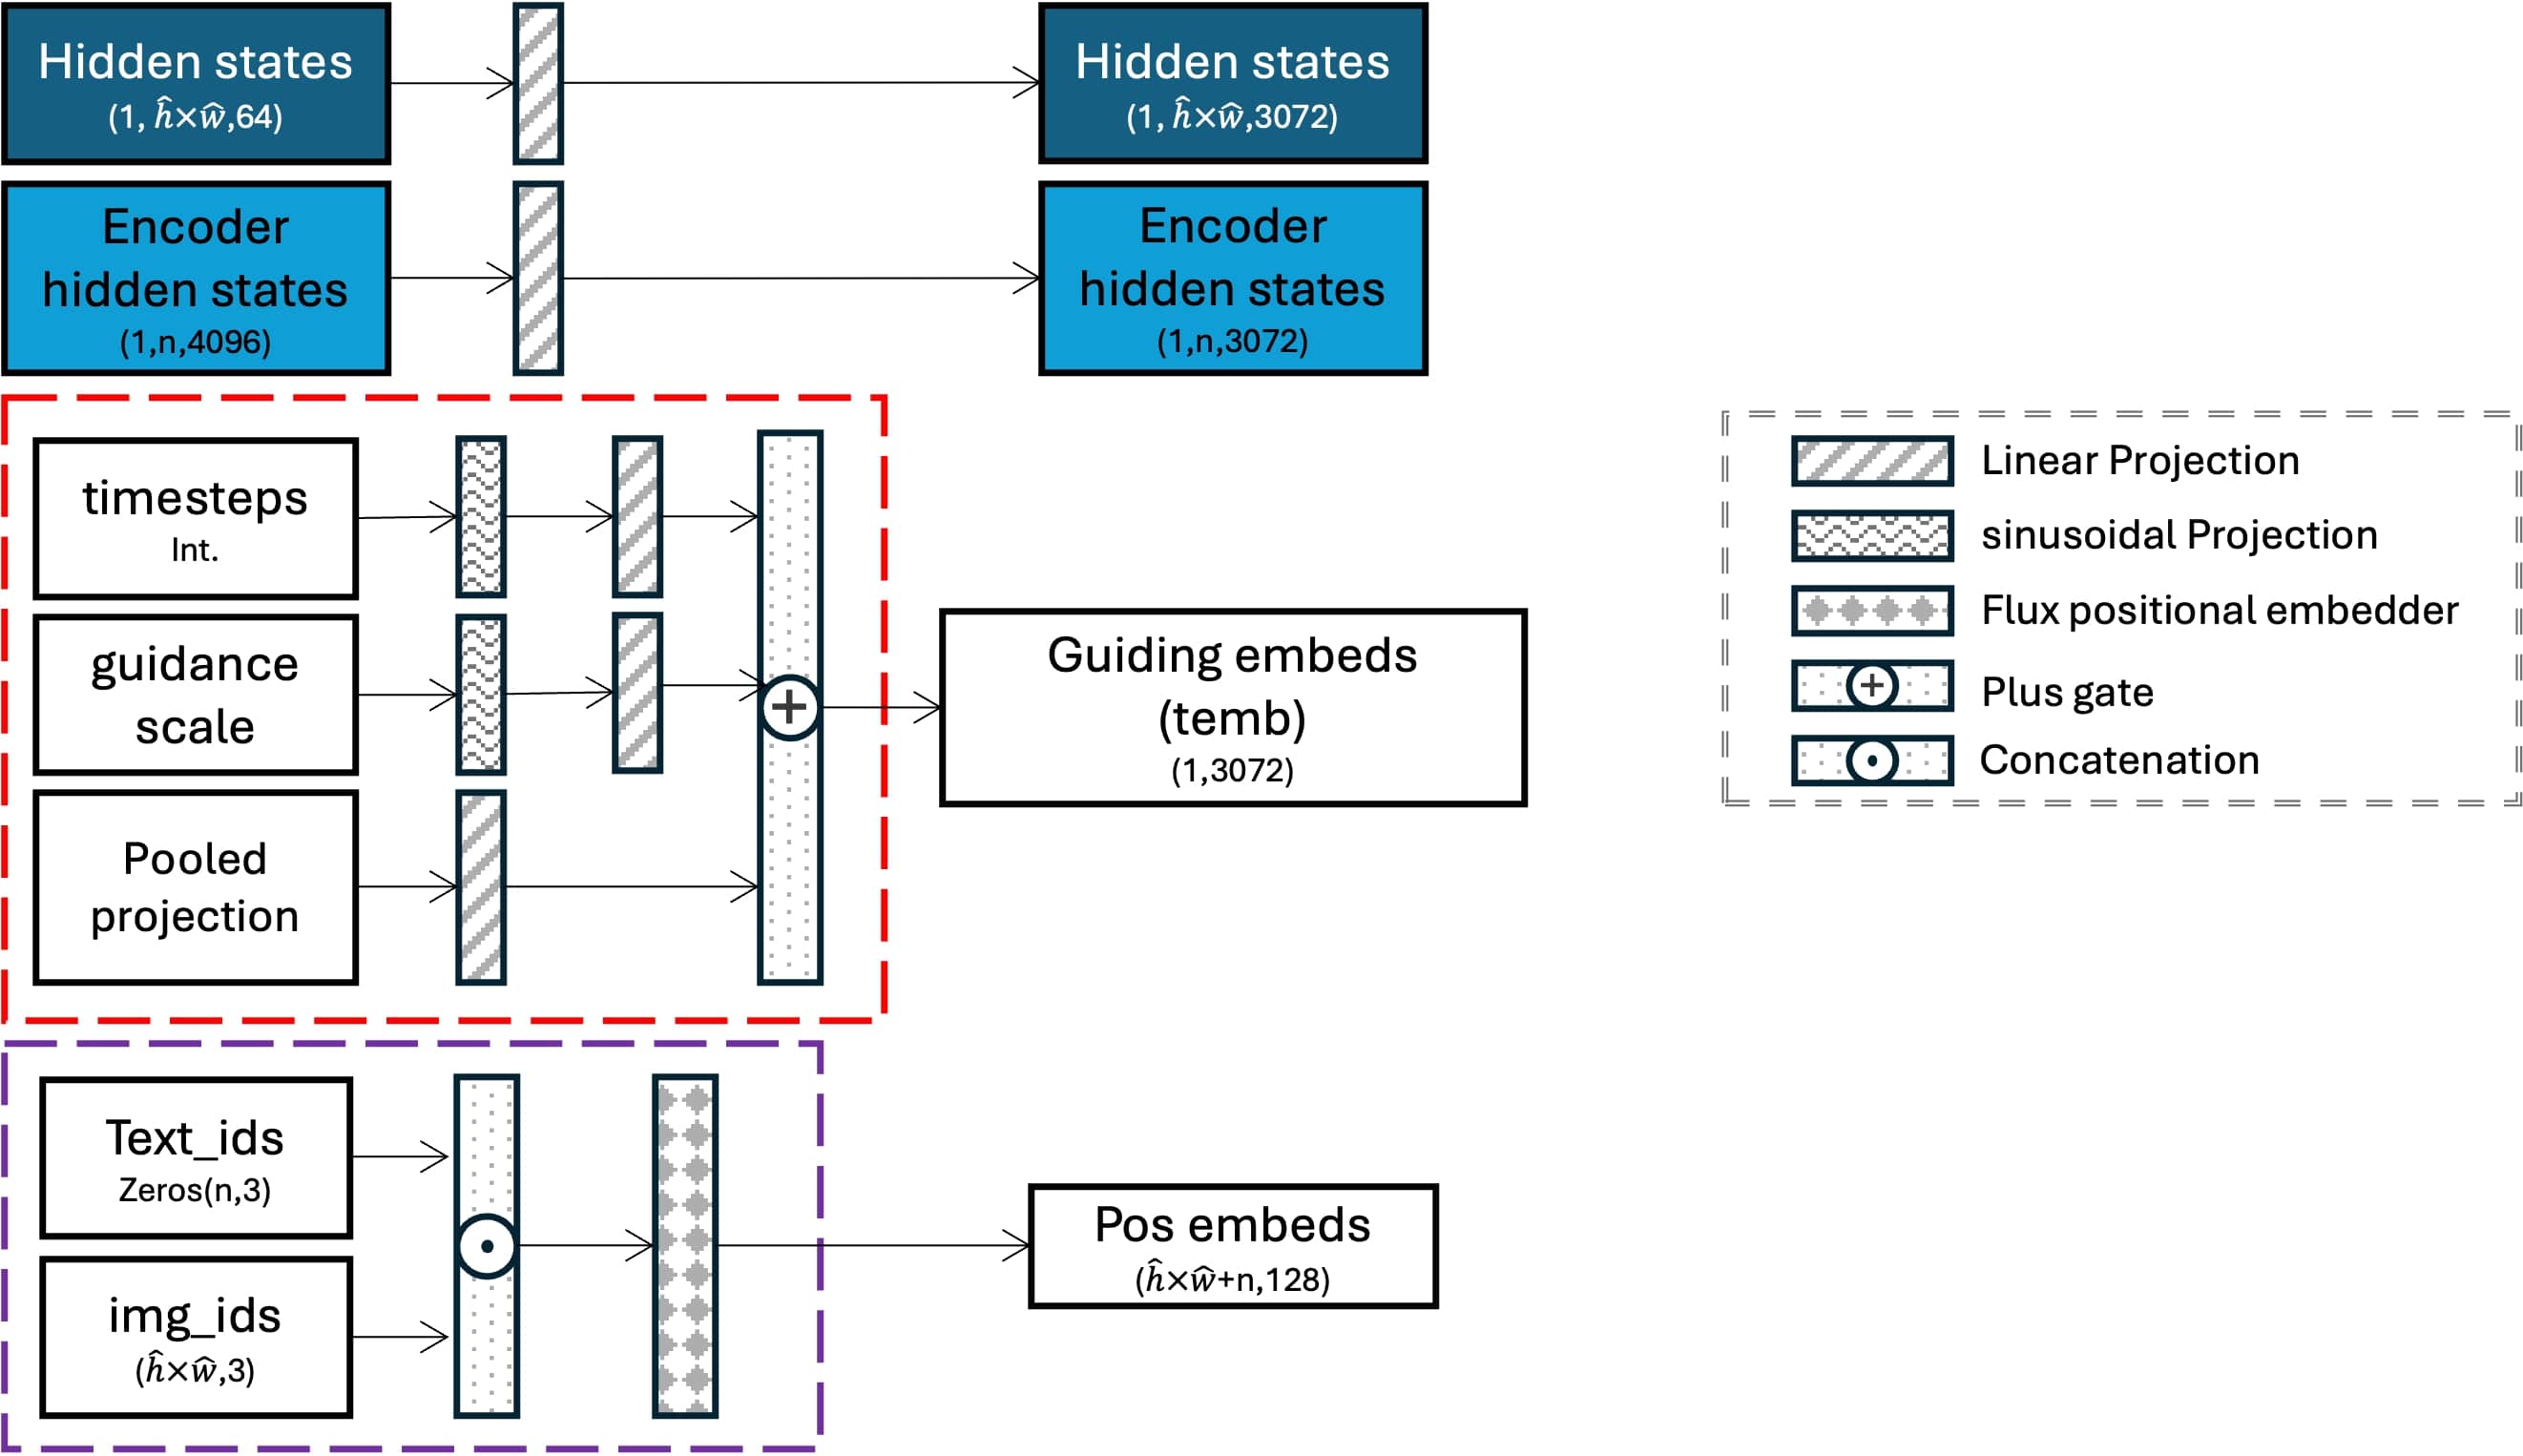
\(\gamma(\cdot)\) 是 256 维正弦 embedding,\(f_t,f_y,f_g\) 都是 Linear–SiLU–Linear MLP。\(y\in\mathbb{R}^{B\times768}\) 来自 CLIP pooled output。这个向量不会作为序列 token 参加 attention;每个 block 用它产生 shift、scale 与 gate。
固定代码的 timestep_embedding 对 timestep 与 guidance 都先乘 1000,再生成 128 个 cosine 与 128 个 sine 分量,总维度为 256。两者随后分别经过自己的 256→3072→3072 MLP。
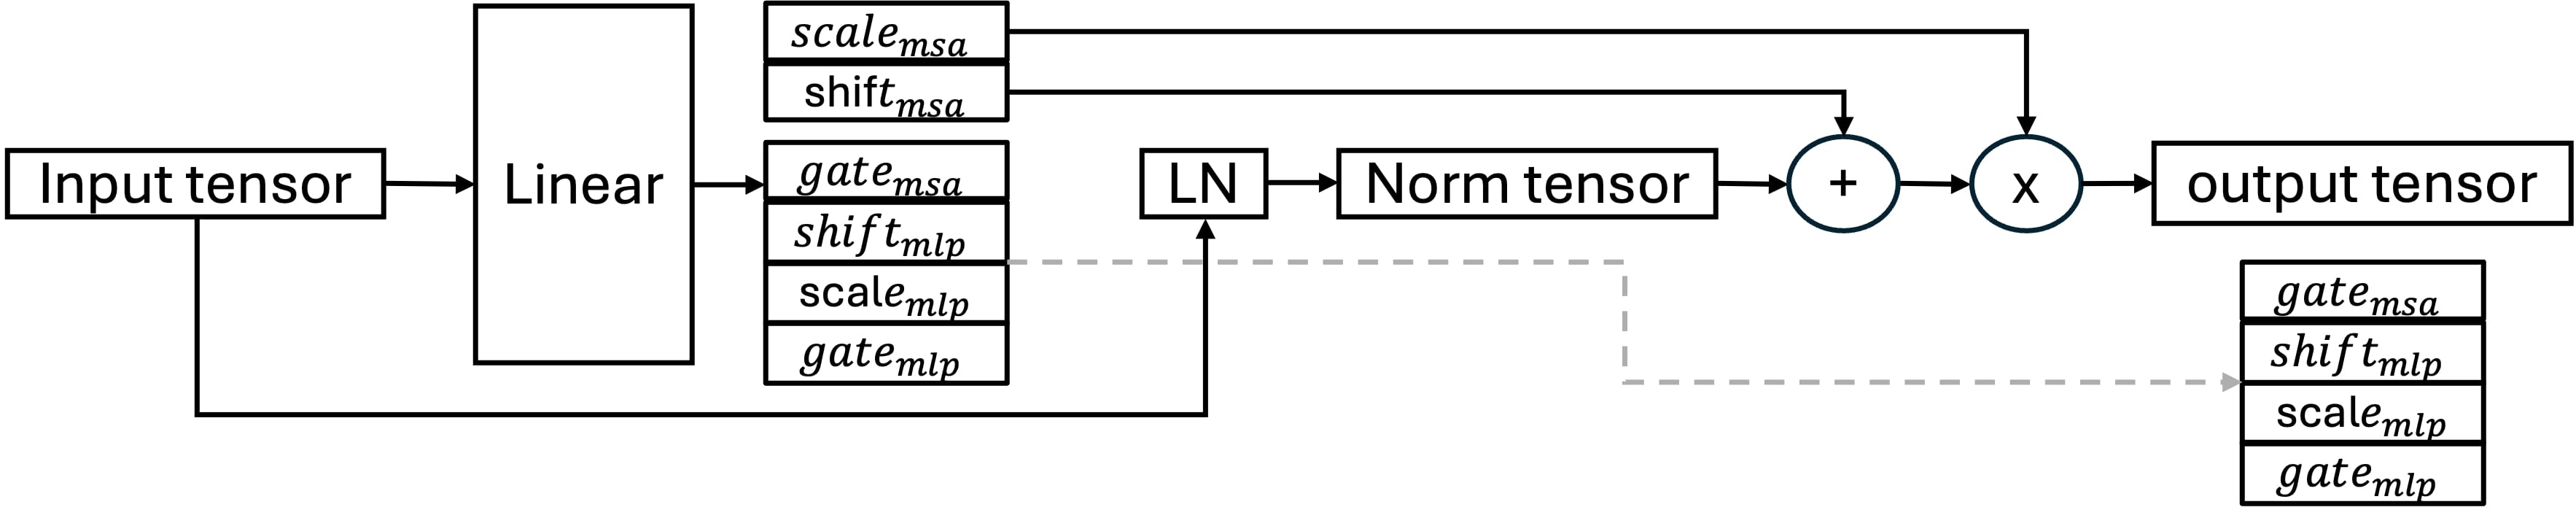
image 与 text 使用各自的 modulation、LayerNorm、QKV、attention output projection 与 MLP。每个模态的 modulation 一次产生六组 3072 维向量:attention 的 shift / scale / gate,以及 MLP 的 shift / scale / gate。
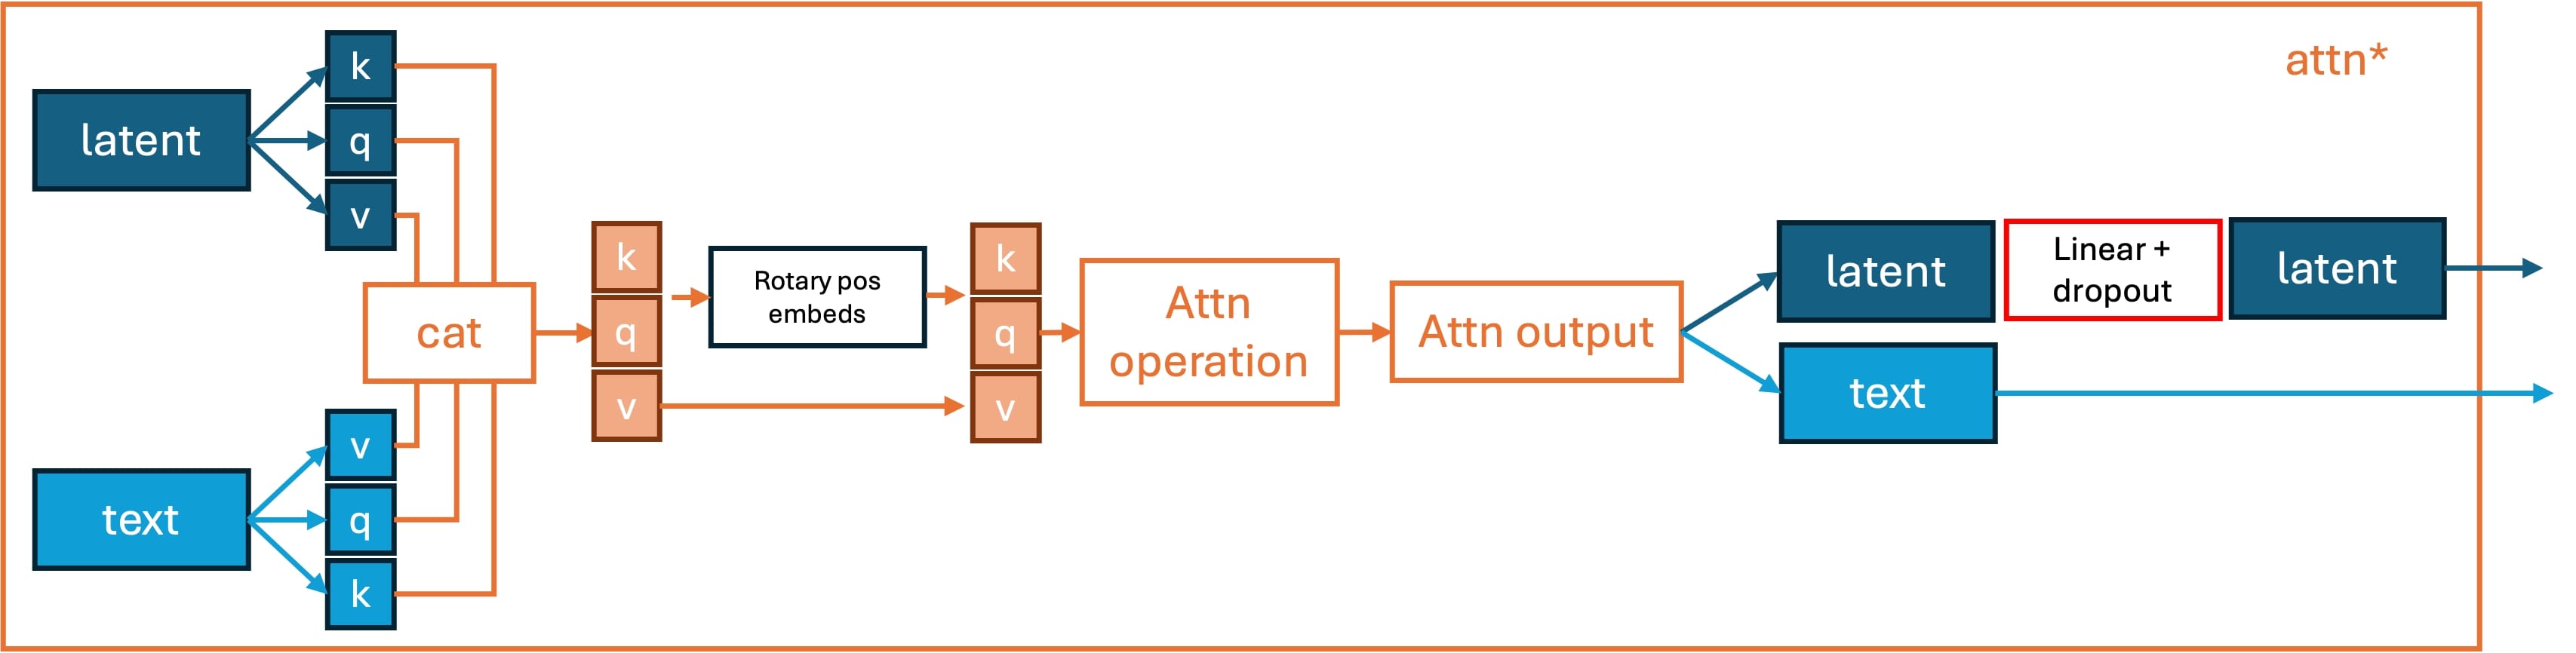
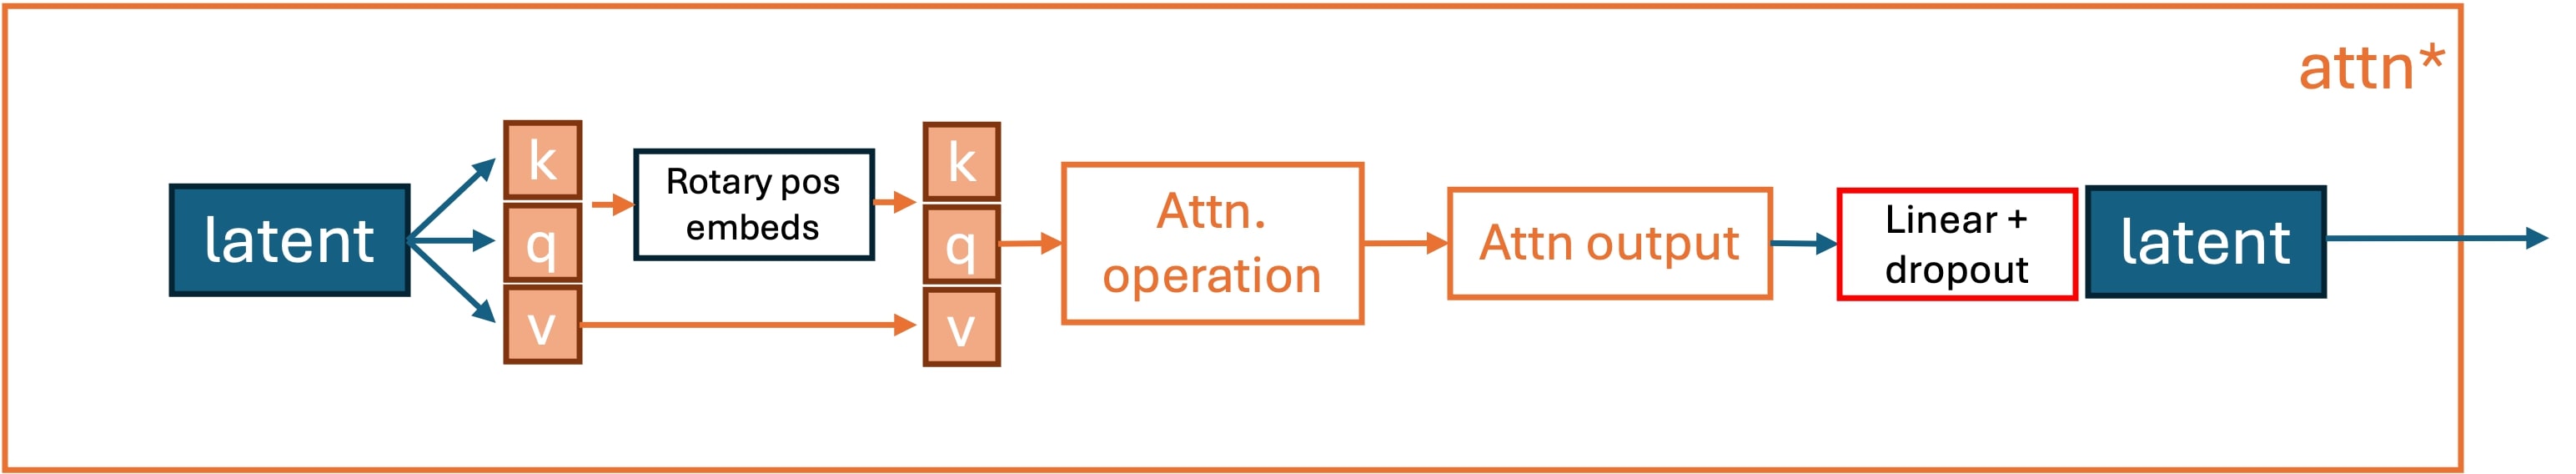
QKV 投影分别完成,随后沿 token 轴拼接,一次 scaled dot-product attention 同时包含 text↔text、image↔image、text→image 与 image→text 四类关系。attention 输出再按序列边界拆回两个流。
完成 19 个双流块后,代码按 [txt; img] 拼成单一序列。所有 token 共享同一组权重。一次 fused linear1 同时生成 QKV 与 MLP hidden,attention 和 GELU 分支并行计算,连接后经 linear2 返回 3072 维。
Single-Stream modulation 只产生一组 shift、scale、gate。它没有第二次 LayerNorm,也没有独立的 MLP residual gate。报告把它描述成 parallel attention + MLP,这与固定代码吻合。
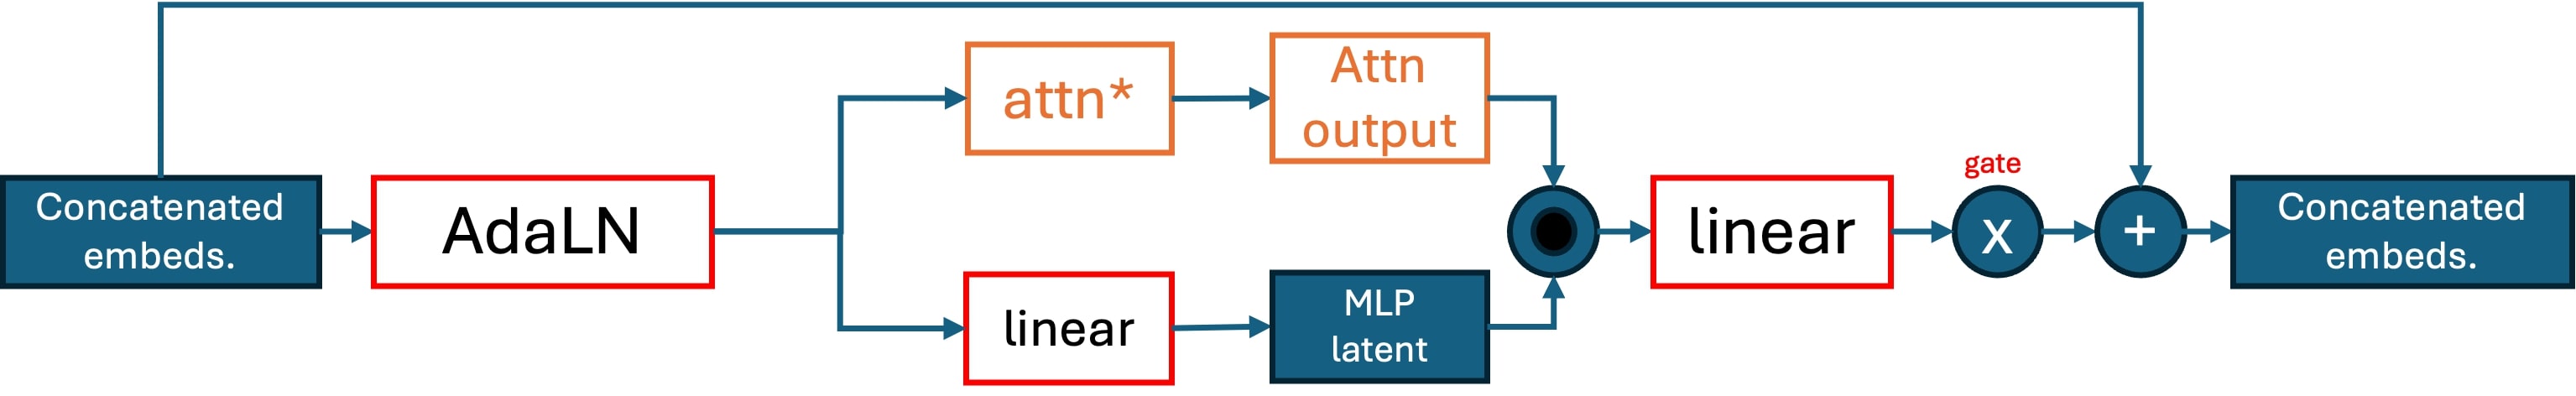
| 属性 | Double-Stream | Single-Stream |
|---|---|---|
| 层数 | 19 | 38 |
| 模态参数 | image / text 各自独立 | 拼接序列共享 |
| attention | 独立 QKV 后联合 attention | 单一 fused QKV |
| MLP 位置 | attention residual 后顺序执行 | 与 attention 从同一输入并行执行 |
| modulation | 每个模态 6 组向量 | 全序列 3 组向量 |
| 固定提交参数量 | 约 6.457B | 约 5.381B |
hidden size 3072 除以 24 heads,得到每头 128 维。Q 和 K 在每个 head 内先做带可训练 scale 的 RMSNorm;V 保持原值。随后对 Q/K 施加 RoPE,最后调用 scaled dot-product attention。
三轴 RoPE 的维度分配为 \([16,56,56]\),总和正好等于 128。基础 text-to-image 的 image IDs 为 \((0,h,w)\),text IDs 全为 \((0,0,0)\)。第一轴在基础模型中保持零;在后续 Kontext 代码里可区分条件图像序列,这也说明三轴设计为扩展保留了位置。
38 个单流块完成后,代码裁掉前面的 text token 部分。LastLayer 使用 \(c_{\mathrm{vec}}\) 产生最终 shift 与 scale,对 image states 做 AdaLN,再线性映射到 64 维 velocity。基础配置的 patch size 参数为 1,因为 \(2\times2\) packing 已在模型外完成。
报告主体常以“FLUX.1”统称模型。固定提交能直接核实 open-weight 的 dev 与 schnell;pro 权重和内部训练实现没有公开。
| 项目 | FLUX.1 [dev] | FLUX.1 [schnell] | 证据性质 |
|---|---|---|---|
| Transformer 主干 | 19 双流 + 38 单流,3072 hidden,24 heads | 相同 | 官方代码 |
| guidance embedding | 开启,guidance 数值进入 256→3072 MLP | 关闭,传入 guidance 被 Identity 忽略 | 官方代码 |
| T5 最大长度 | 512 | 256 | 官方 demo |
| 默认步数 | 50 | 4 | 官方 CLI |
| schedule shift | 开启,依赖 image sequence length | 关闭 | 官方 CLI |
| 来源描述 | 由 pro guidance-distilled | 面向少步推理的 distilled variant | BFL 公告与报告 |
| 权重许可 | FLUX.1-dev Non-Commercial License | Apache 2.0 | 官方仓库 |
| 训练数据与优化器 | 未公开 | 未公开 | 证据缺口 |
参数量依据固定提交中的层定义与 dev 配置逐项计算,包含 embedding projections、QK RMSNorm scale 与 final layer,不包含 T5、CLIP 和 VAE。
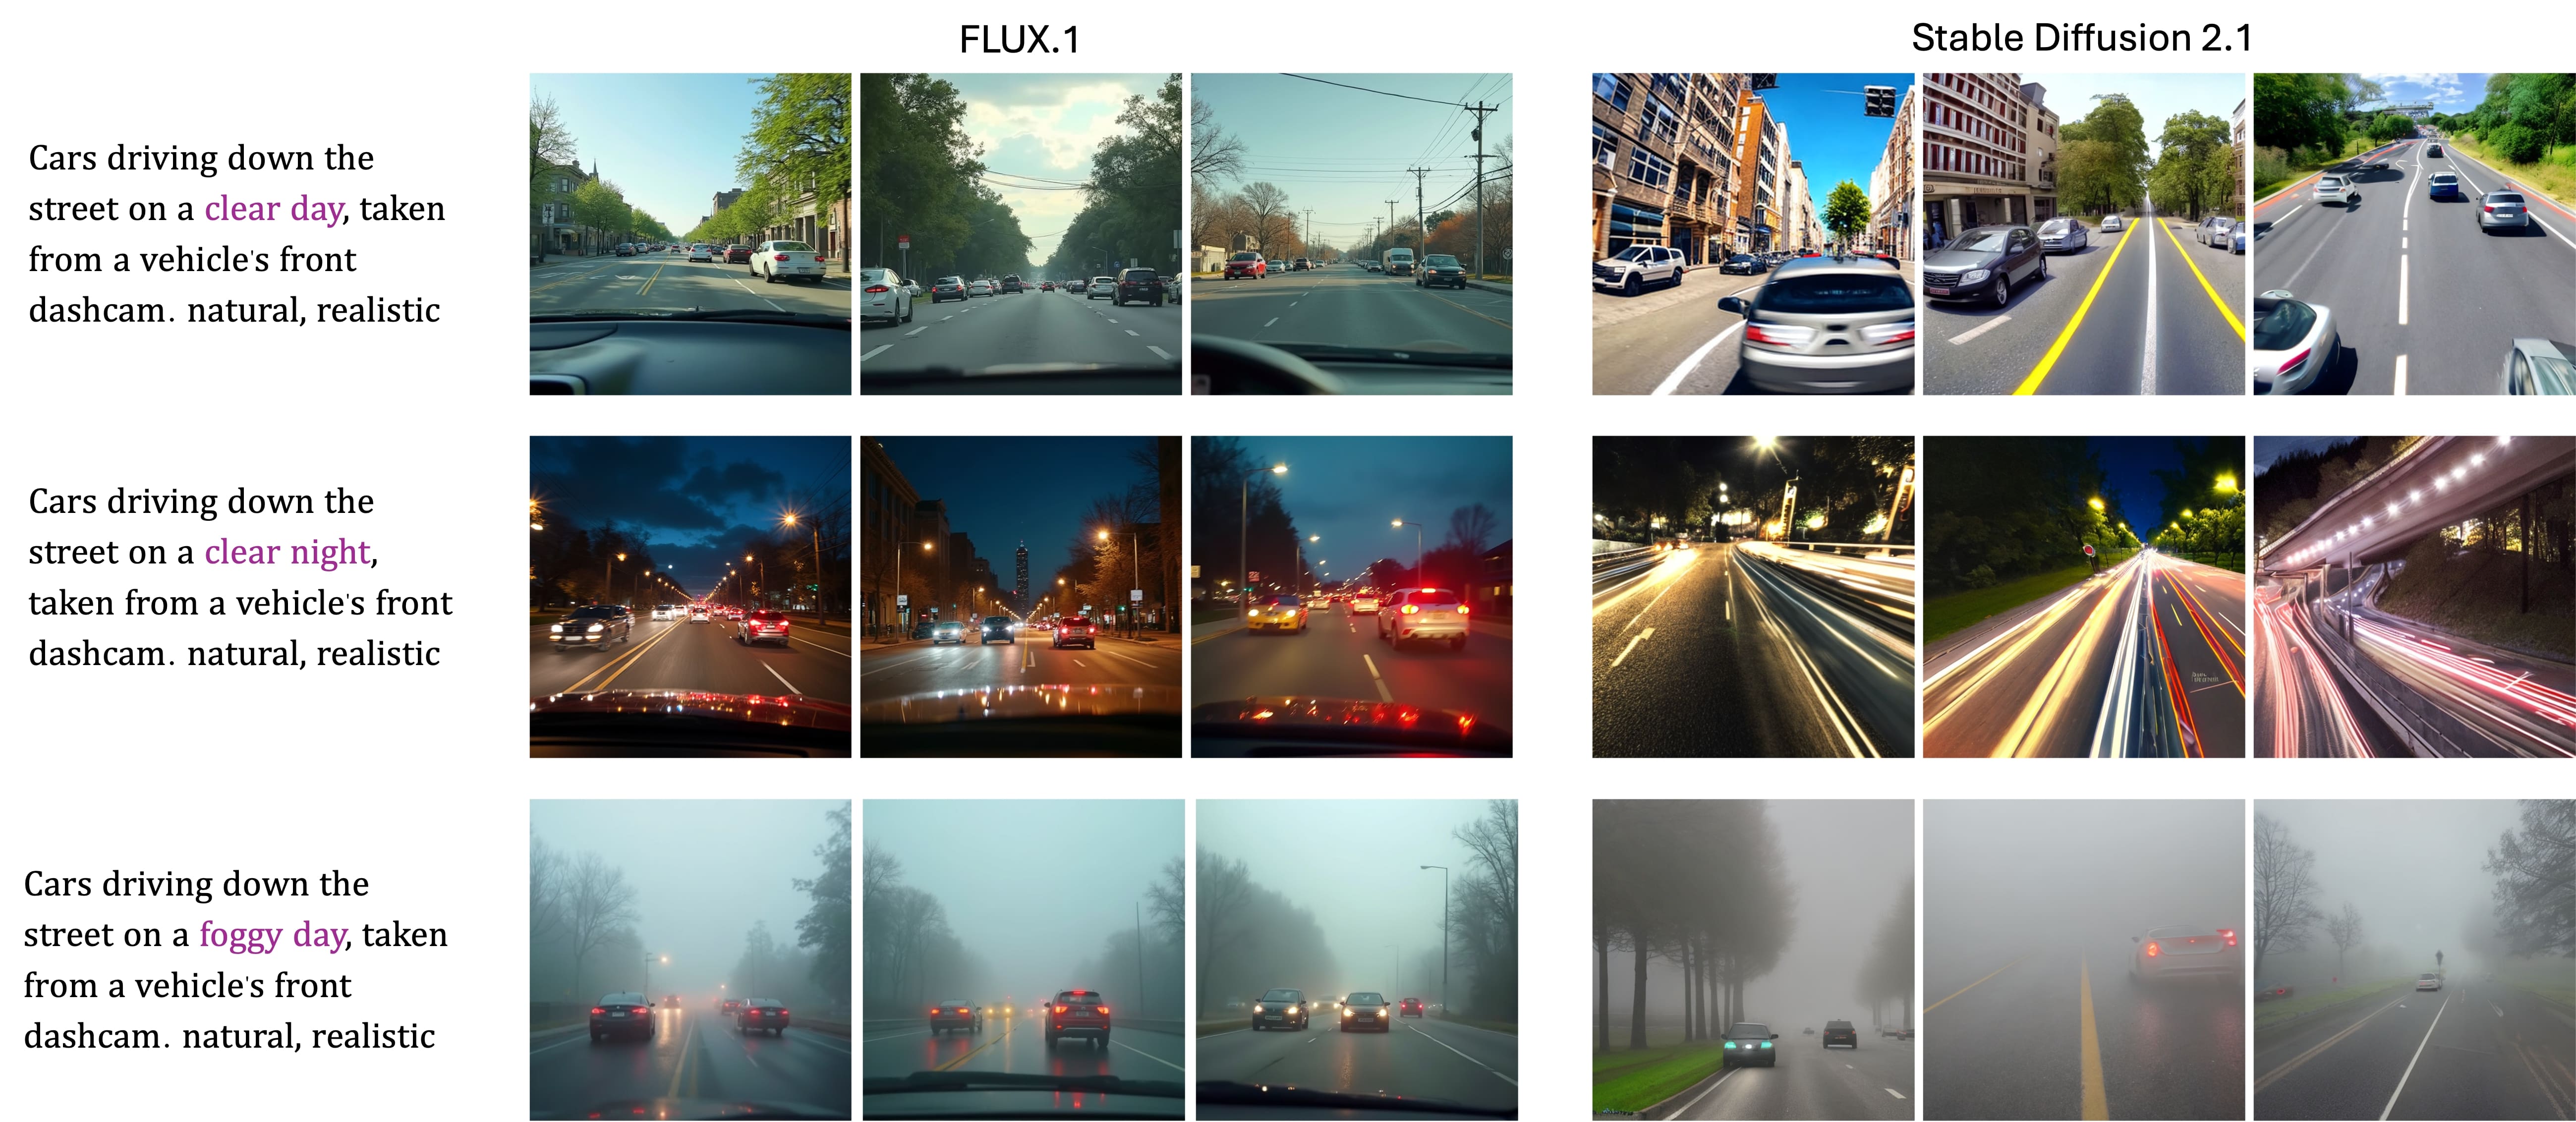
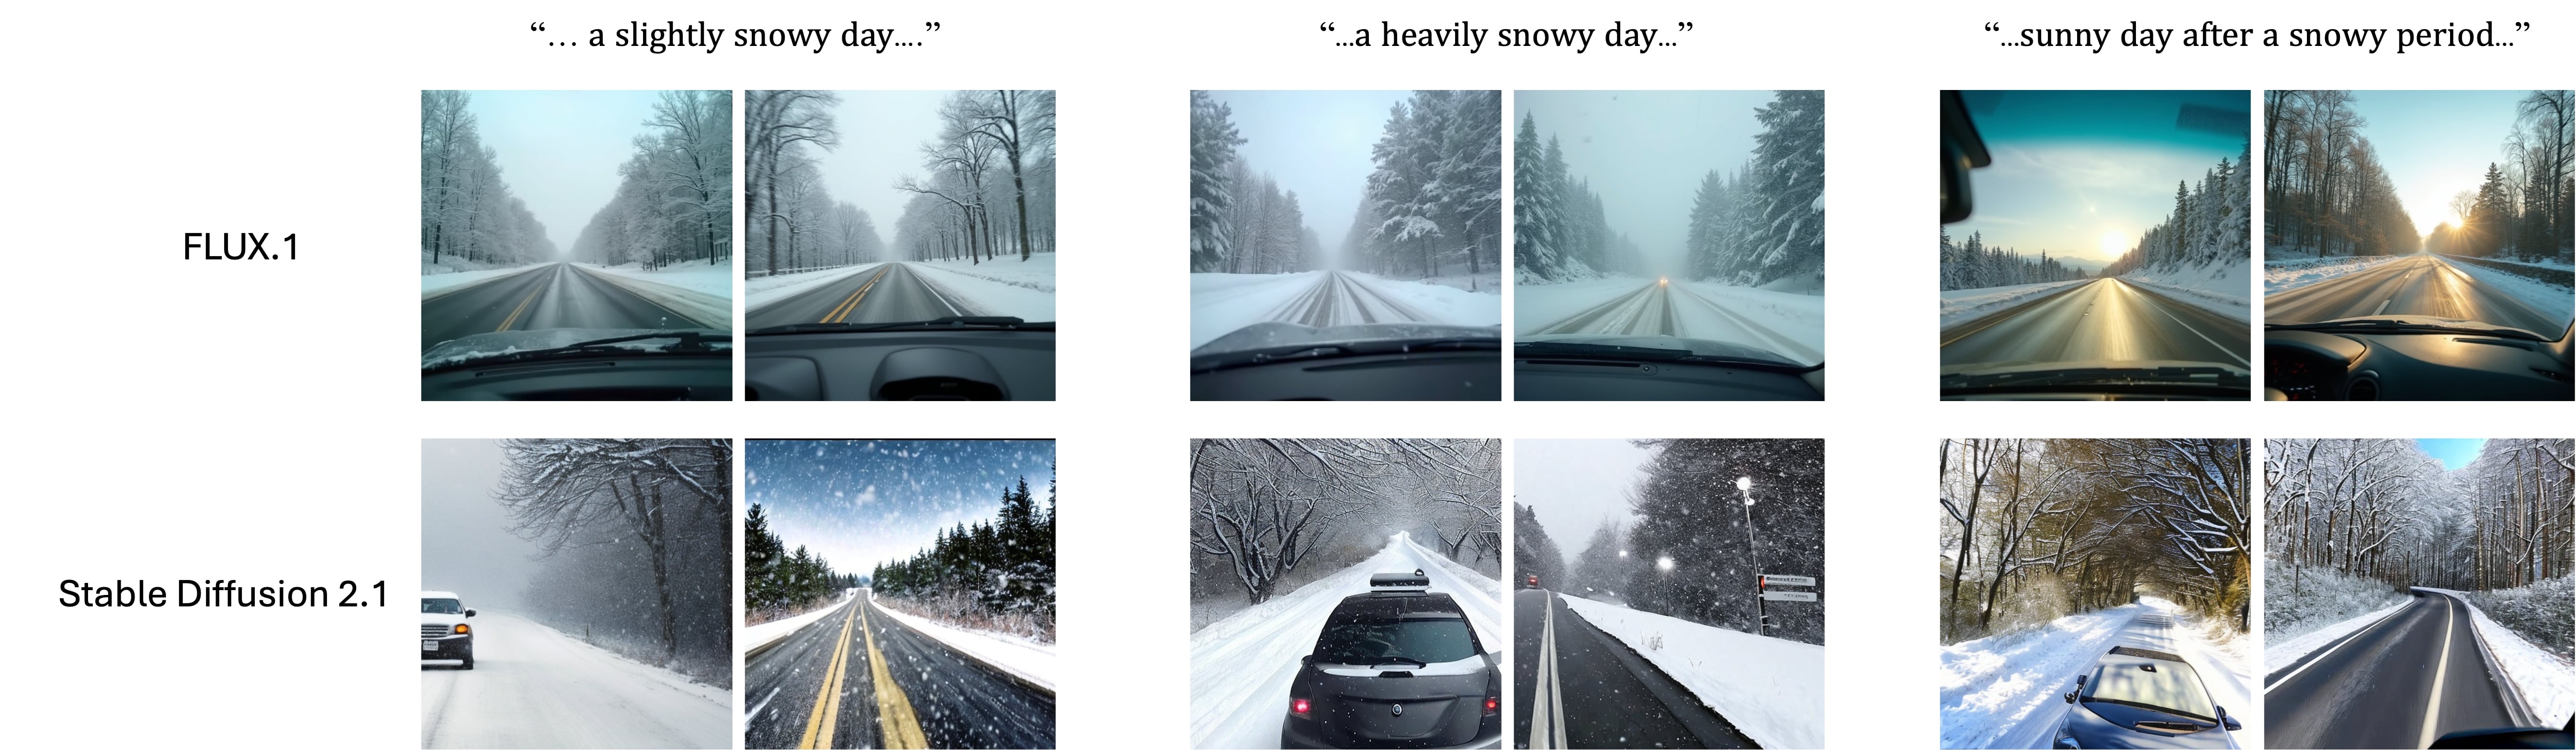
正文 Figure 2–3 转载 BFL 官方发布材料。附录由报告作者展示 FLUX.1[dev] 与 SD 2.1 的汽车场景定性比较,参数有说明,评测协议不足以支撑广泛排名。
| 设置 | FLUX.1[dev] | SD 2.1 |
|---|---|---|
| 采样步数 | 50 | 50 |
| guidance scale | 2.5 | 7.5 |
| 分辨率 | 512×512 | 512×512 |
| 微调 | 没有额外微调 | 没有额外微调 |
| 场景 | 汽车前向 dashcam 视角;天气、稀疏 prompt、罕见概念、复杂 prompt | |
原图比较“adverse weather”“difficult viewing conditions”“blurry”等宽泛或简短条件,作用是展示模型对抽象描述与直接视觉属性的响应。页面保留编号说明,原 PDF 第 19 页可查。
原图包含 boat-trailer 与 upside-down crashed car,作用是支持作者关于长尾汽车概念词汇覆盖的定性观察。没有量化稀有度或成功率。
原图考察同一 prompt 内多个描述元素的遵循情况。作者把表现归因于 T5 dense embeddings;报告没有通过移除 T5 或替换 encoder 验证因果。
原图展示多种尺寸与 aspect ratio 的生成结果,作用是说明 FLUX.1 的可变 token grid 推理能力。它没有给出各尺寸的质量指标、速度或显存消耗。
| 项目 | 公开状态 | 可获得内容 |
|---|---|---|
| Transformer 结构 | 公开 | 完整 inference module、层数、维度、RoPE、modulation、QK normalization |
| sampling loop | 公开 | noise shape、packing、schedule shift、Euler update、unpack |
| 文本编码器 | 公开 | T5-v1_1-XXL 与 CLIP ViT-L/14 型号和最大长度 |
| VAE 配置与权重 | 公开 | 16 latent channels、scale factor 0.3611、shift factor 0.1159、公开权重 |
| 基础模型训练代码 | 未公开 | 官方仓库自述为 minimal inference code |
| 训练数据 | 未公开 | 数据来源、规模、去重、过滤、caption 生成、许可分布均未知 |
| 优化器与预算 | 未公开 | optimizer、LR、scheduler、batch、steps、hardware、训练时长均未知 |
| distillation | 部分声明 | dev 为 guidance-distilled、schnell 为快速蒸馏版本;具体目标与 teacher sampling 未公开 |
| 原始 benchmark | 报告未复现 | 只转载厂商图与加入作者定性对照 |
报告认为双流与单流组合在专门化、融合、效率之间取得平衡,并把 FLUX.1 的高表现与 rich vocabulary、heavy pre-training、T5 dense embeddings 联系起来。这些解释具有合理性,缺少组件消融和训练记录支持。
双流阶段让两种模态在进入共享表示前保留不同变换;单流阶段把计算预算集中到统一序列内的深层融合。数量上 19+38 也表明共享阶段承担更多深度。这个结构解释来自代码形态,无法单独证明性能因果。