研究缺口
已有 diffusion model 的生成质量可与 GAN 接近,采样却需要数百到数千次网络评估。作者寻找一套可直接复用 DDPM checkpoint 的短轨迹生成过程。
Paper Reading / Diffusion Sampling
训练同一个噪声预测器,重写前向 joint,换出一族从随机 DDPM 到确定性 DDIM 的生成过程。
DDIM 的核心贡献位于采样过程:固定 \(q(\mathbf{x}_t\mid\mathbf{x}_0)\) 的每个单时刻边际,允许改变 \(q(\mathbf{x}_{1:T}\mid\mathbf{x}_0)\) 的联合结构,再用较短时间子序列执行逆向生成。论文报告 20–100 步可接近 1000 步模型的质量,并将 50k 图像采样墙钟时间缩短约 \(10\times\) 到 \(50\times\)。
身份说明:论文首次提交于 2020-10-06,正式发表于 ICLR 2021;本页以 2022-10-05 的 arXiv v4 为正文与附录依据。v4 在第 6 页更新 ODE 关联并修正证明。核查日期:2026-09-28。
01 / RESEARCH MOTIVATION
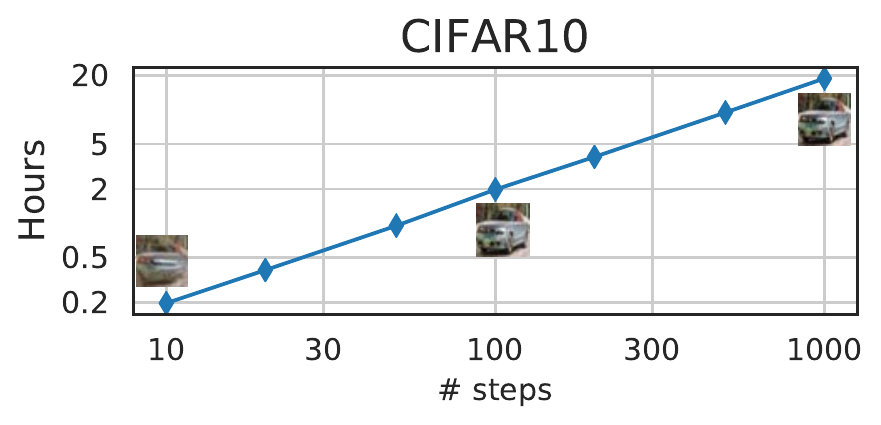
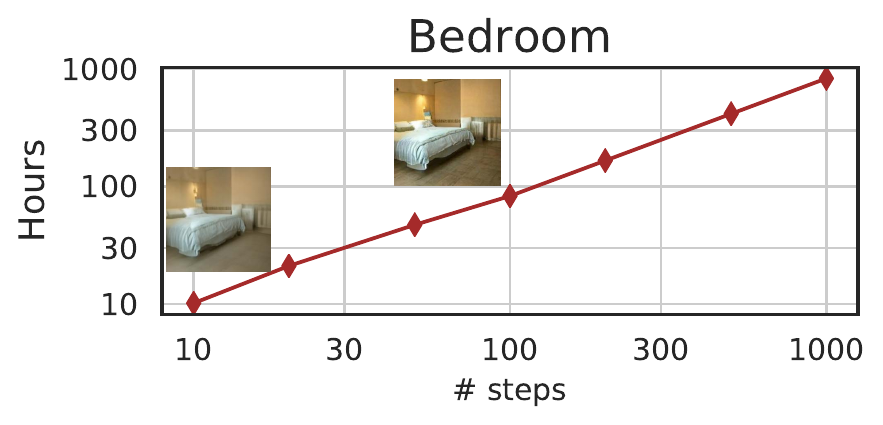
DDPM 用长达 \(T=1000\) 的逆向 Markov 链逐步去噪。每一步都调用一次网络,步骤之间存在严格依赖,无法并行完成单个样本。论文给出的直观成本是:Nvidia 2080 Ti 上生成 50k 张 \(32\times32\) 图像约需 20 小时,生成 50k 张 \(256\times256\) 图像可接近 1000 小时。
已有 diffusion model 的生成质量可与 GAN 接近,采样却需要数百到数千次网络评估。作者寻找一套可直接复用 DDPM checkpoint 的短轨迹生成过程。
常用噪声预测目标只读取 \(q(\mathbf{x}_t\mid\mathbf{x}_0)\)。保持这些边际分布相同,联合前向过程仍有大量自由度;新的 joint 对应新的逆向生成过程。
训练样本构造、噪声预测网络和损失保持原有形式;推理时选择时间子序列与方差参数。速度改善来自网络调用次数减少。
“更快”指采样与生成。论文没有证明训练更快;它直接复用 CIFAR-10、LSUN Bedroom、LSUN Church 的 DDPM checkpoint,并自行训练 CelebA 模型。确定性 DDIM 的逆向映射在给定 \(\mathbf{x}_T\) 后固定,初始 \(\mathbf{x}_T\sim\mathcal{N}(\mathbf{0},\mathbf{I})\) 仍然随机。
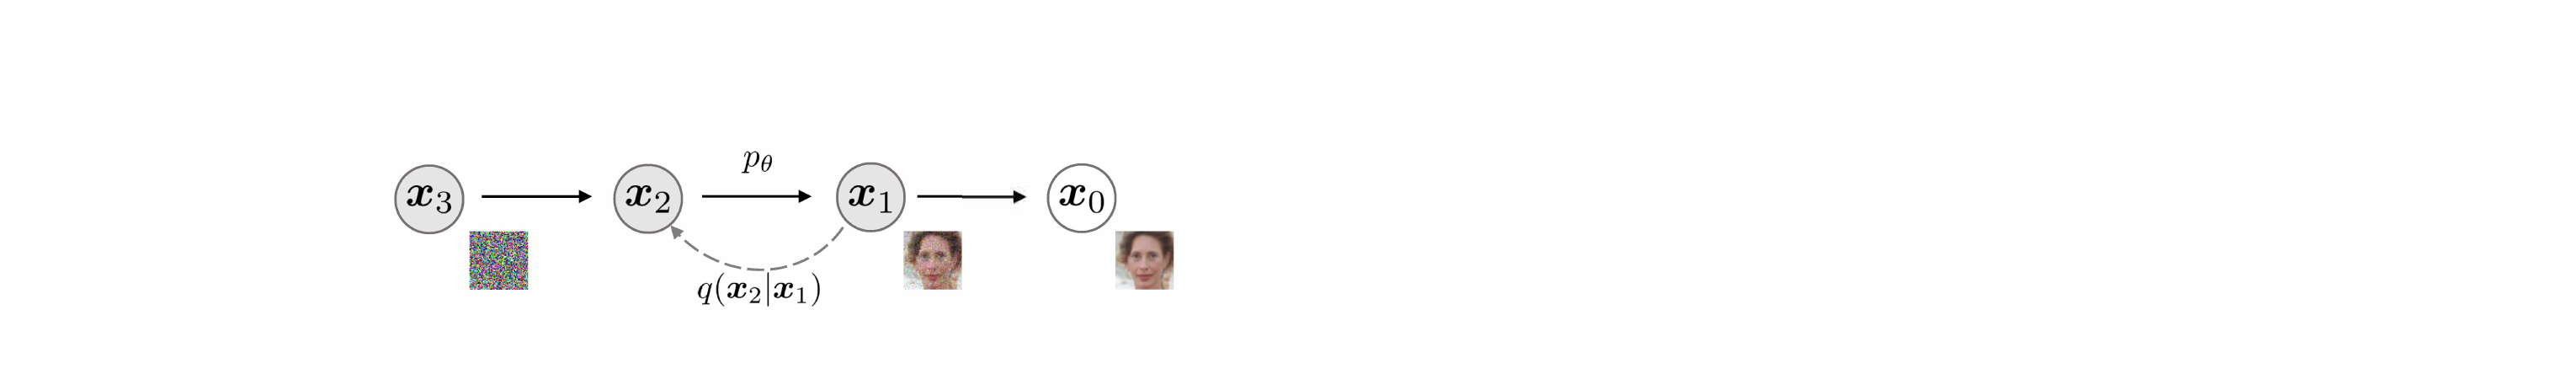
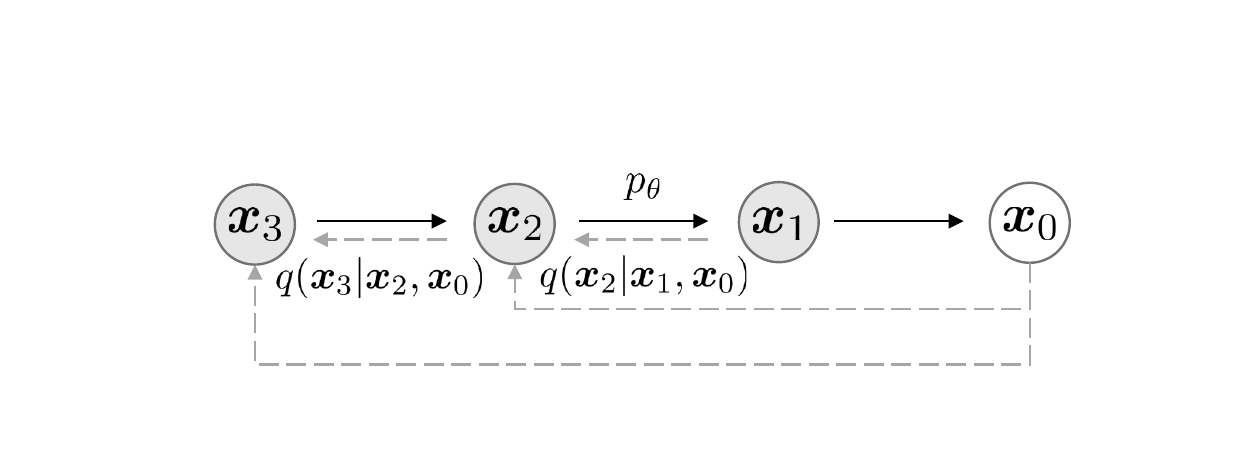
02 / PROBLEM FORMULATION
论文使用 \(\alpha_t\) 表示 DDPM 文献常写的累计乘积 \(\bar{\alpha}_t\)。因此 \(\alpha_t\) 随 \(t\) 递减,\(\alpha_0=1\),而一步 beta 可由 \(1-\alpha_t/\alpha_{t-1}\) 恢复。代码中的 compute_alpha 对 beta 做累乘,正好返回论文语义中的 \(\alpha_t\)。
| 符号 | 定义 | 作用 |
|---|---|---|
| \(\mathbf{x}_0\) | 数据样本 | 训练时来自 \(q(\mathbf{x}_0)\);生成终点 |
| \(\mathbf{x}_t\) | 第 \(t\) 个噪声层级的 latent | 与图像同维;作为噪声预测器输入 |
| \(\alpha_t\) | 累计信号保留量,\(\alpha_0=1\) | 决定 \(\mathbf{x}_0\) 与噪声的混合比例 |
| \(\mathbf{\epsilon}\) | 标准 Gaussian 噪声 | 训练目标与随机采样项 |
| \(\epsilon_{\theta}^{(t)}\) | 时间条件噪声预测网络 | 从 \(\mathbf{x}_t\) 估计加入的噪声 |
| \(\mathbf{\sigma}\) | 每一步条件标准差向量 | 索引 non-Markov joint 与生成随机性 |
| \(\tau=(\tau_1,\ldots,\tau_S)\) | \([1,\ldots,T]\) 的递增子序列 | 定义实际访问的 \(S\) 个噪声层级 |
| \(\eta\) | 实验中的单一方差缩放参数 | \(\eta=0\) 为 DDIM;\(\eta=1\) 对应一种 DDPM 方差 |
03 / NON-MARKOVIAN FAMILY
假设 \(\mathbf{x}_t\mid\mathbf{x}_0\) 已有目标 Gaussian 边际。把上式写成线性 Gaussian:条件均值对 \(\mathbf{x}_t\) 的随机部分贡献方差 \(1-\alpha_{t-1}-\sigma_t^2\),条件自身再贡献 \(\sigma_t^2\)。两项相加恰好得到 \(1-\alpha_{t-1}\),均值中的噪声期望为零,因此:
从 \(t=T\) 反向归纳到 1,即得到每个目标边际。这个结论说明 joint 的时间相关结构可以变化,训练看到的单时刻带噪样本分布保持一致。
定理要求每个 \(\sigma_t\gt0\),因为证明中的权重包含 \(1/\sigma_t^2\)。DDIM 采用 \(\sigma_t=0\) 的边界情形,论文用 \(\sigma_t\) 任意接近零来说明其极限关系。把定理直接写成覆盖零方差会遗漏这一限制。
04 / OBJECTIVE EQUIVALENCE
模型从 \(\mathbf{x}_t\) 预测噪声,再恢复干净样本估计:
non-Markov joint 对应的 variational objective 为:
附录的目标是把每个 Gaussian KL 化为 \(\mathbf{x}_0-f_\theta^{(t)}(\mathbf{x}_t)\) 的加权平方误差,从而证明存在正权重向量 \(\mathbf{\gamma}\),使 \(J_{\mathbf{\sigma}}=L_{\mathbf{\gamma}}+C\)。这个“存在正权重”的结论成立,但 v4 附录直接写出的 \(\gamma_t=1/(2d\sigma_t^2\alpha_t)\) 省略了条件均值差的系数以及 \(1-\alpha_t\),不能视为一般时间表下的完整标准 Gaussian 系数。
论文随后说明:若各个 \(t\) 的 \(\epsilon_{\theta}^{(t)}\) 参数互不共享,并且每一项都能达到全局最优,正权重只会缩放彼此独立的子问题,所以 \(L_{\mathbf{\gamma}}\) 与 \(L_{\mathbf{1}}\) 共享最优解。官方实现使用同一个时间条件 U-Net,参数跨 \(t\) 共享;有限容量、有限数据和实际优化下,不同权重可以改变折中。实验显示已有 DDPM checkpoint 能有效支持 DDIM 采样,这属于经验支持。
给定合法 \(\mathbf{\sigma}\),构造保证每个 \(q_{\mathbf{\sigma}}(\mathbf{x}_t\mid\mathbf{x}_0)\) 与 DDPM 一致。
对全部正 \(\sigma_t\),\(J_{\mathbf{\sigma}}\) 等于某个 \(L_{\mathbf{\gamma}}\) 加常数。
从 \(L_{\mathbf{\gamma}}\) 推到 \(L_{\mathbf{1}}\) 的最优解一致,需要时间步参数互不共享和全局最优。
\(\sigma_t=0\) 未被定理直接覆盖,论文用正方差趋近零连接 DDIM。
05 / SAMPLING EQUATION
| 设置 | 每步随机性 | 与论文术语的关系 | 给定 \(\mathbf{x}_T\) 后 |
|---|---|---|---|
| \(\eta=0\) | \(\sigma_{\tau_i}=0\) | DDIM | 轨迹固定时输出确定 |
| \(0\lt\eta\lt1\) | 部分随机 | generalized process | 仍依赖每步新噪声 |
| \(\eta=1\) | posterior variance | 一种 DDPM 生成过程 | 随机 |
| \(\hat{\sigma}_{\tau_i}=\sqrt{1-\alpha_{\tau_i}/\alpha_{\tau_{i-1}}}\) | 更大方差 | Ho et al. CIFAR-10 实现使用的 DDPM 变体 | 随机,短轨迹噪声扰动更强 |
DDIM 中“implicit”表示 \(p_\theta(\mathbf{x}_0)\) 由先验 latent 经确定映射隐式定义。它不要求初始状态固定为常数;每次生成仍先抽取 \(\mathbf{x}_T\)。
06 / SUBSEQUENCE SAMPLING
令 \(\tau=(\tau_1,\ldots,\tau_S)\) 是 \([1,\ldots,T]\) 的递增子序列,附录取 \(\tau_S=T\)。生成时按照 \(\tau_S,\tau_{S-1},\ldots,\tau_1,0\) 执行前一节更新。网络仍接收原始时间索引,因此一个 \(T=1000\) 的 checkpoint 可以只访问 \(S\) 个层级。
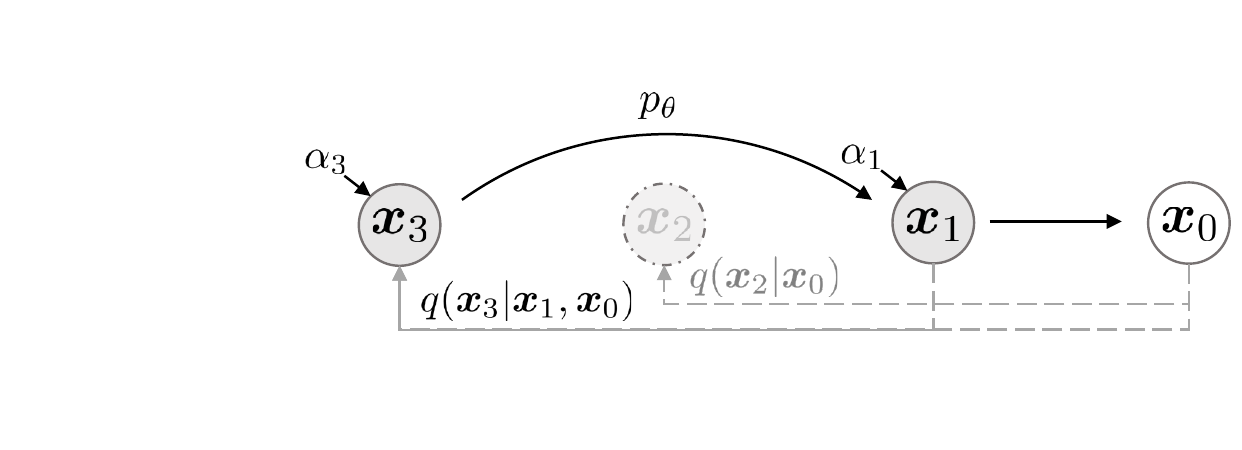
Linear:\(\tau_i=\lfloor ci\rfloor\),用于 CelebA、LSUN Bedroom、LSUN Church。
Quadratic:\(\tau_i=\lfloor ci^2\rfloor\),用于 CIFAR-10。常数 \(c\) 使末端接近 \(T\)。作者称这些选择在各自数据集上略优于另一种。
uniform 以整数 skip=T//S 构造 range(0,T,skip);quad 使用 \(\lfloor \mathrm{linspace}(0,\sqrt{0.8T},S)^2\rfloor\)。后者最大索引接近 \(0.8T\),与论文“末端接近 \(T\)”的文字存在实现差异。
每个采样步调用一次 U-Net,墙钟时间随 \(S\) 近似线性增长。短轨迹减少 network function evaluations;训练 checkpoint 的原始 \(T\) 不随采样 \(S\) 改变。
07 / ODE CONNECTION
对 \(\eta=0\) 的确定性更新,引入 \(\bar{\mathbf{x}}=\mathbf{x}/\sqrt{\alpha}\) 与噪声尺度 \(\rho=\sqrt{(1-\alpha)/\alpha}\)。这里用 \(\rho\) 区分前文离散条件标准差 \(\sigma_t\)。更新可写成:
v4 的 Proposition 1 证明:当噪声预测器达到最优时,这个 ODE 与 Variance-Exploding SDE 的 probability flow ODE 经变量重参数后等价。连续 ODE 等价不意味着有限步离散完全相同。DDIM 对 \(\mathrm{d}\rho\) 取 Euler 步,论文对比的 probability-flow 实现对 \(\mathrm{d}t\) 取 Euler 步;粗时间网格下两者会产生不同结果。
最优模型下,经 \(\bar{\mathbf{x}},\rho\) 变换,DDIM ODE 与 VE-SDE probability flow ODE 相同。
足够细离散时可从数据积分到 latent,再沿生成方向返回;实验用重建误差提供支持。
表 2 的误差随步数下降符合 Euler 离散误差预期,也混合了 U-Net 预测误差;论文没有单独分解两者。
08 / EXPERIMENTS
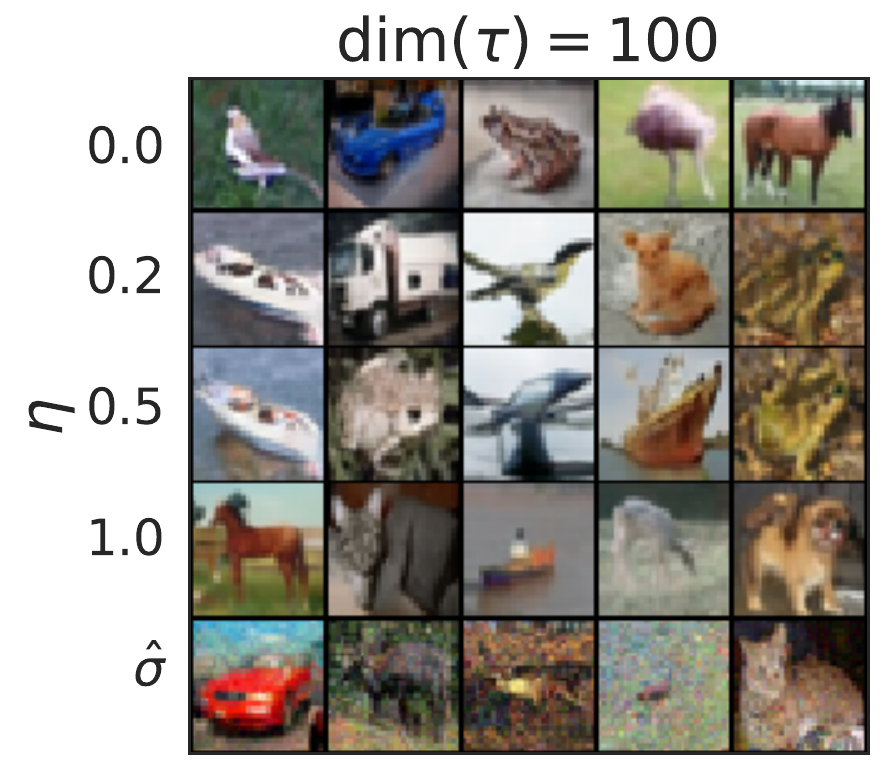
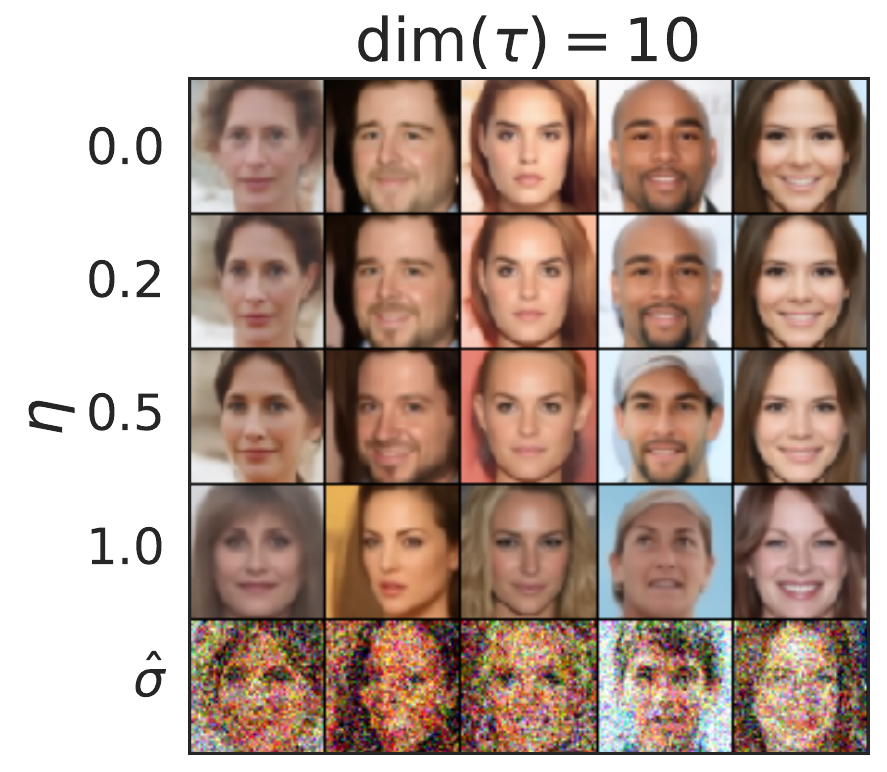
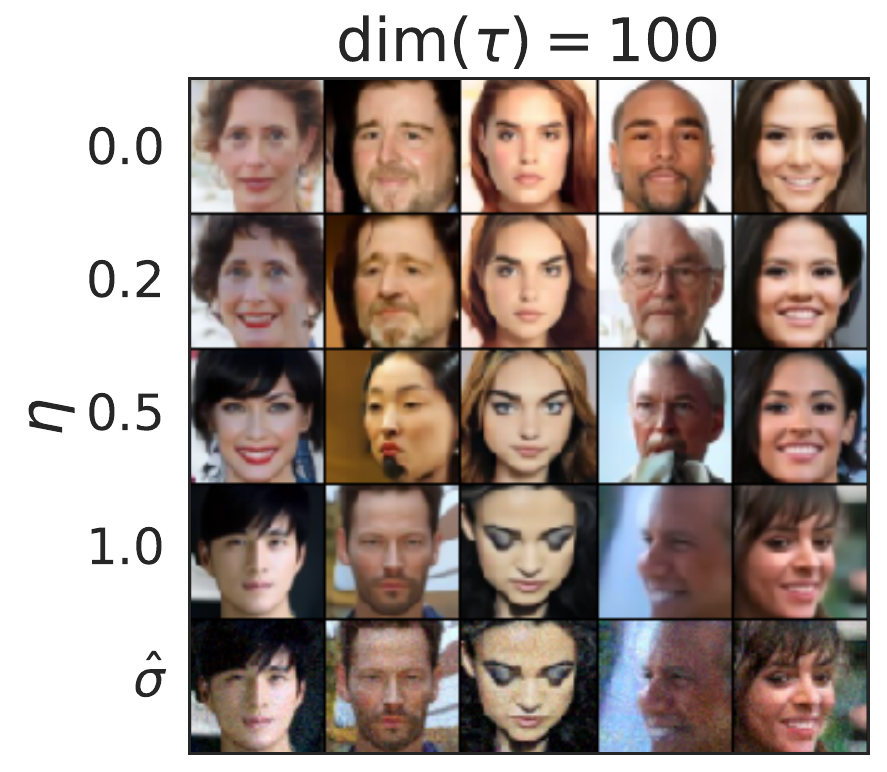
四个数据集均使用 \(T=1000\) 的噪声层级与 \(L_{\mathbf{1}}\) 目标。CIFAR-10、LSUN Bedroom、LSUN Church 复用 Ho et al. 的预训练 DDPM;CelebA 64×64 由作者训练。主要指标是 50k 样本的 FID,速度图在单张 Nvidia 2080 Ti 上测量。
| 方差设置 | CIFAR-10 32×32:采样步数 \(S\) | CelebA 64×64:采样步数 \(S\) | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| 10 | 20 | 50 | 100 | 1000 | 10 | 20 | 50 | 100 | 1000 | |
| DDIM \(\eta=0.0\) | 13.36 | 6.84 | 4.67 | 4.16 | 4.04 | 17.33 | 13.73 | 9.17 | 6.53 | 3.51 |
| \(\eta=0.2\) | 14.04 | 7.11 | 4.77 | 4.25 | 4.09 | 17.66 | 14.11 | 9.51 | 6.79 | 3.64 |
| \(\eta=0.5\) | 16.66 | 8.35 | 5.25 | 4.46 | 4.29 | 19.86 | 16.06 | 11.01 | 8.09 | 4.28 |
| DDPM \(\eta=1.0\) | 41.07 | 18.36 | 8.01 | 5.78 | 4.73 | 33.12 | 26.03 | 18.48 | 13.93 | 5.98 |
| DDPM \(\hat{\sigma}\) | 367.43 | 133.37 | 32.72 | 9.99 | 3.17 | 299.71 | 183.83 | 71.71 | 45.20 | 3.26 |
短轨迹中 \(\eta=0\) 的 FID 最低;1000 步时 \(\hat{\sigma}\) 变体略优。以 CelebA 为例,20 步 DDIM 的 FID 13.73 接近 100 步 \(\eta=1\) 的 13.93。表中没有置信区间、随机种子重复或标准差。
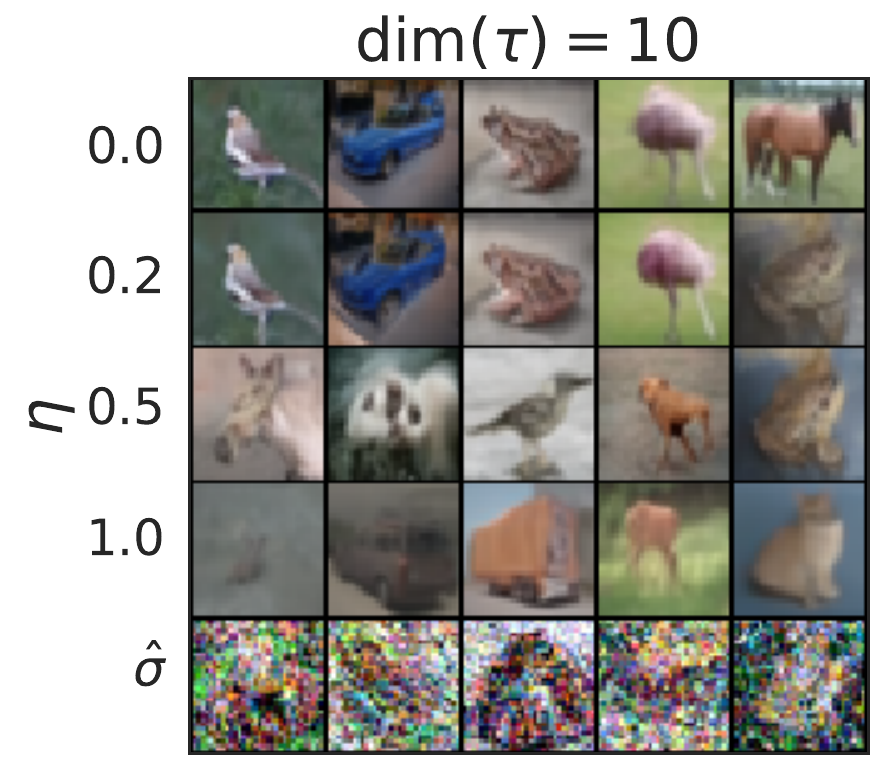
| 方法 | Bedroom 256×256 | Church 256×256 | ||||||
|---|---|---|---|---|---|---|---|---|
| 10 | 20 | 50 | 100 | 10 | 20 | 50 | 100 | |
| DDIM \(\eta=0.0\) | 16.95 | 8.89 | 6.75 | 6.62 | 19.45 | 12.47 | 10.84 | 10.58 |
| DDPM \(\eta=1.0\) | 42.78 | 22.77 | 10.81 | 6.81 | 51.56 | 23.37 | 11.16 | 8.27 |
附录另外报告 1000 步 DDPM:Bedroom FID 6.36,Church FID 7.89。Church 的 100 步 DDPM 为 8.27,优于 100 步 DDIM 的 10.58,说明“DDIM 在少步数总是更优”不受该表支持。
| 编码与解码步数 \(S\) | 10 | 20 | 50 | 100 | 200 | 500 | 1000 |
|---|---|---|---|---|---|---|---|
| 每维 MSE,图像缩放到 [0,1] | 0.014 | 0.0065 | 0.0023 | 0.0009 | 0.0004 | 0.0001 | 0.0001 |
数值四舍五入到 \(10^{-4}\)。\(\mathbf{x}_T\) 与 \(\mathbf{x}_0\) 同维,作者明确不研究压缩率;这里验证的是确定性路径的近似可逆性。
09 / CONSISTENCY, INTERPOLATION, RECONSTRUCTION
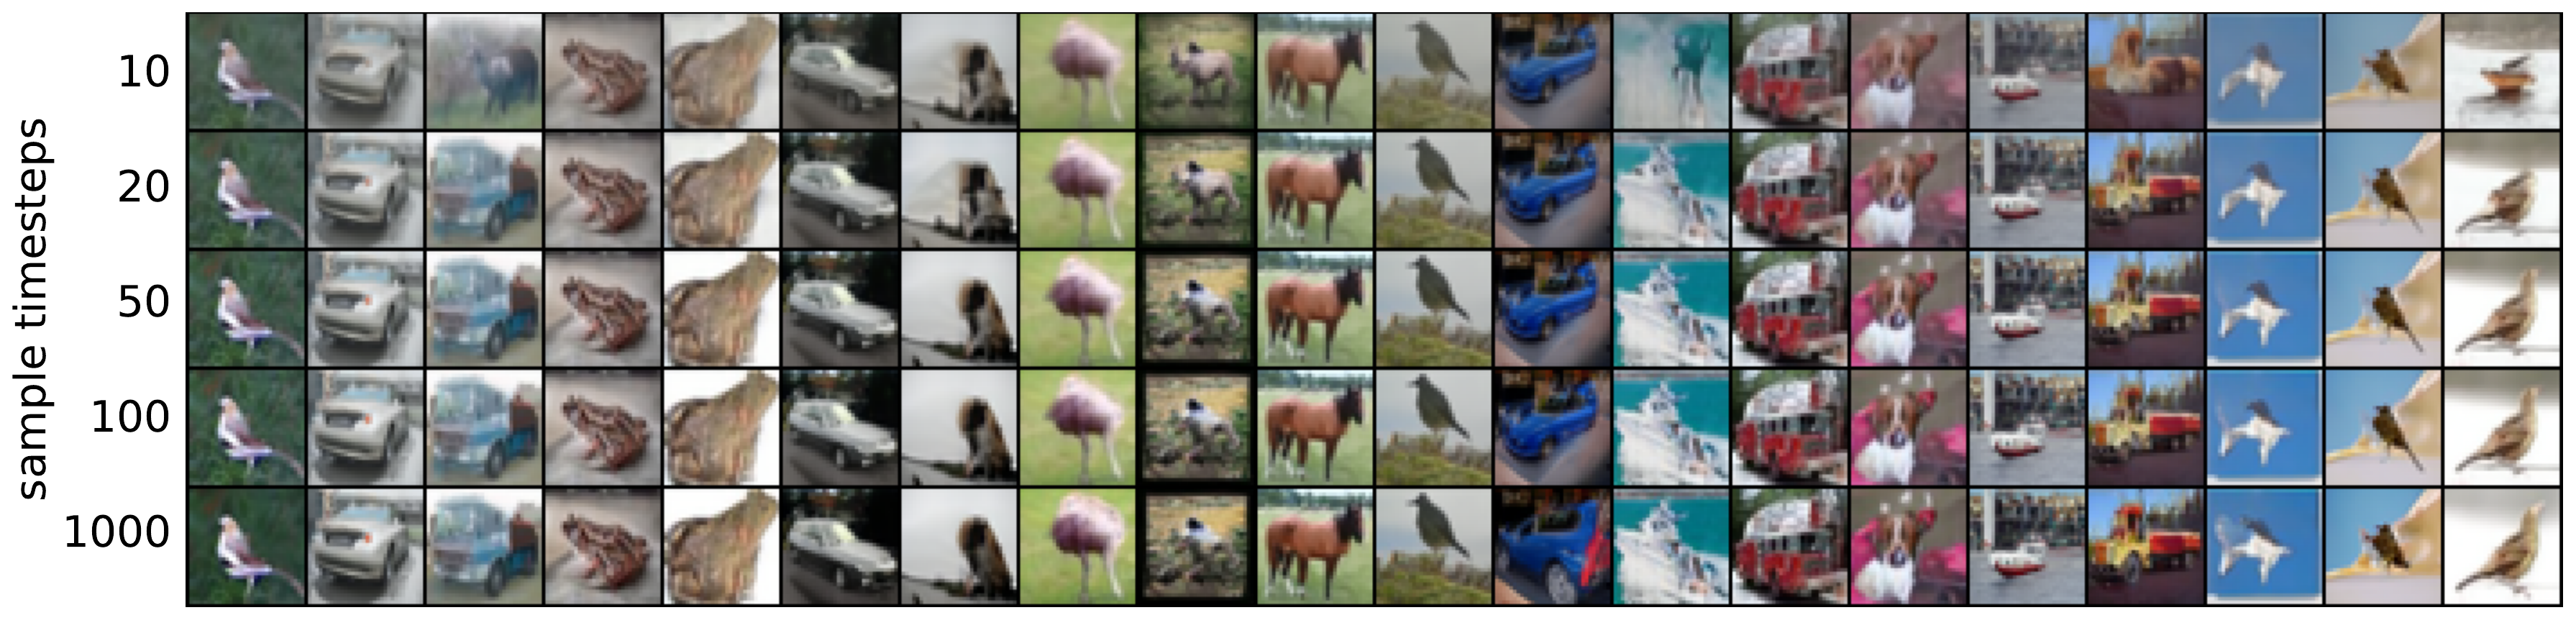
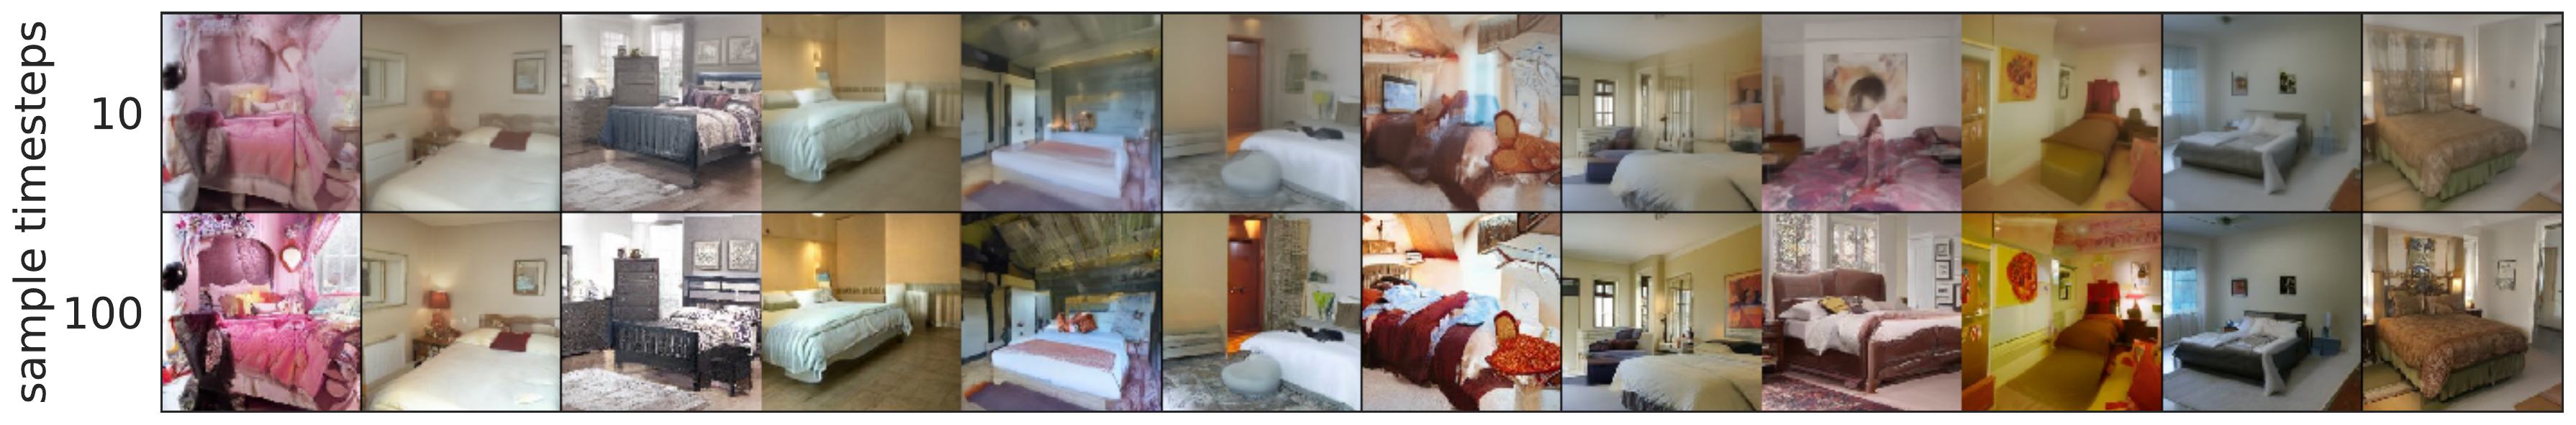
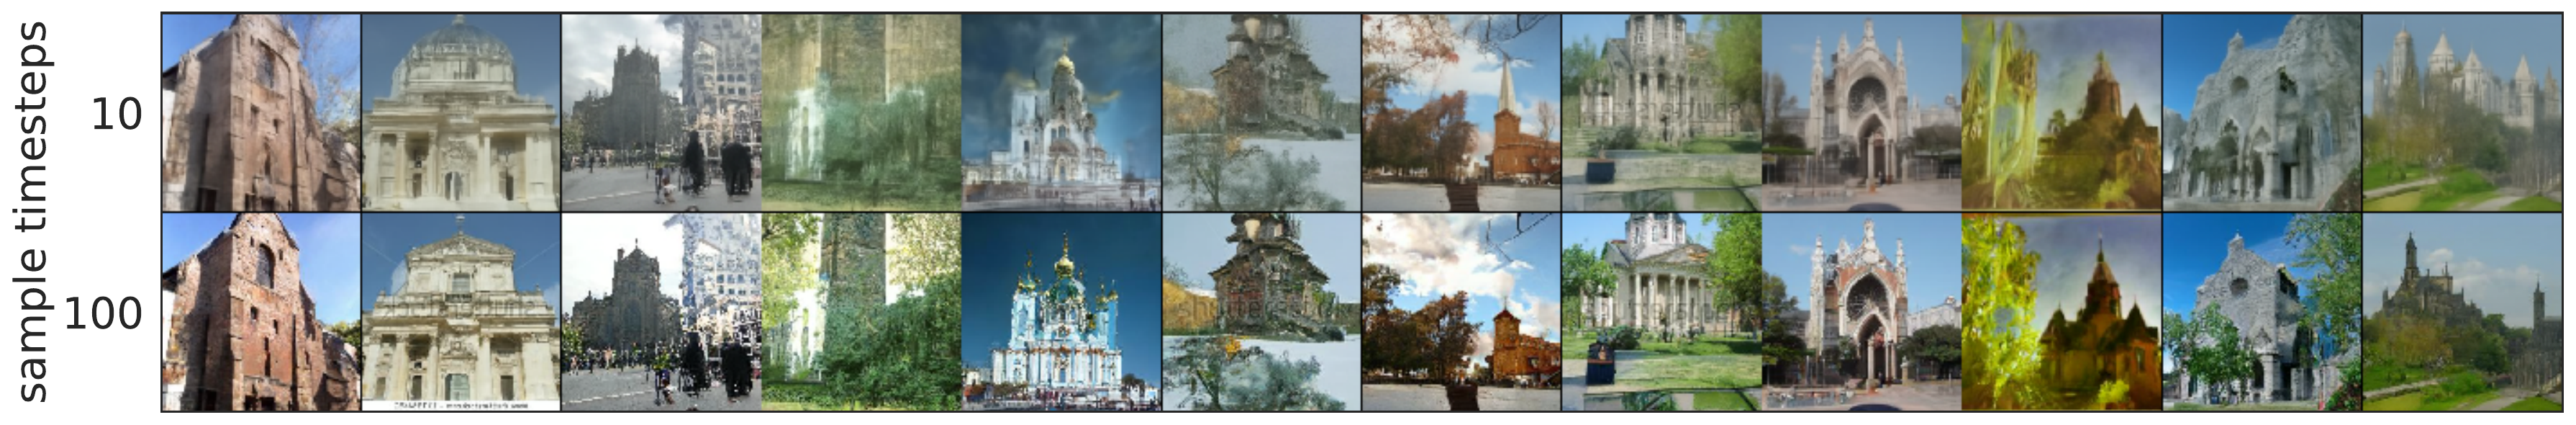
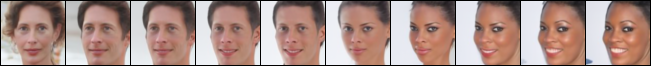
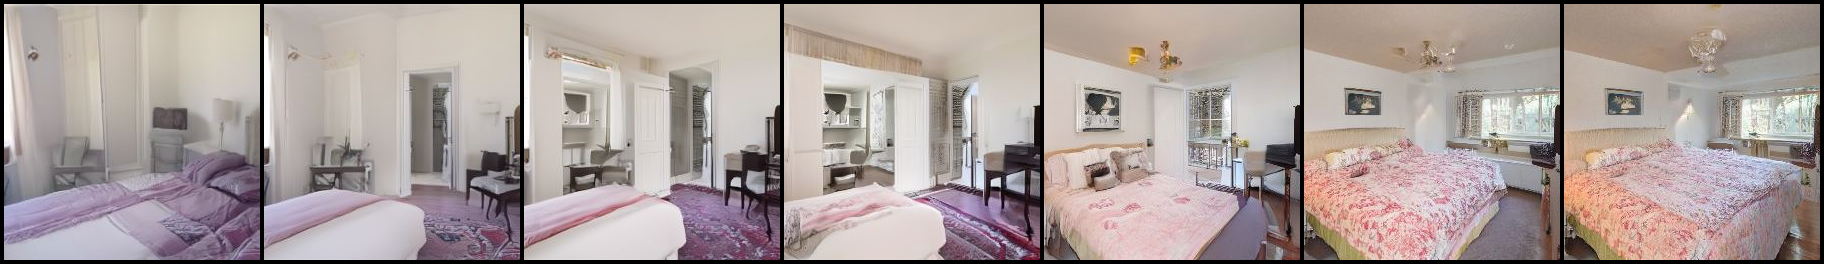
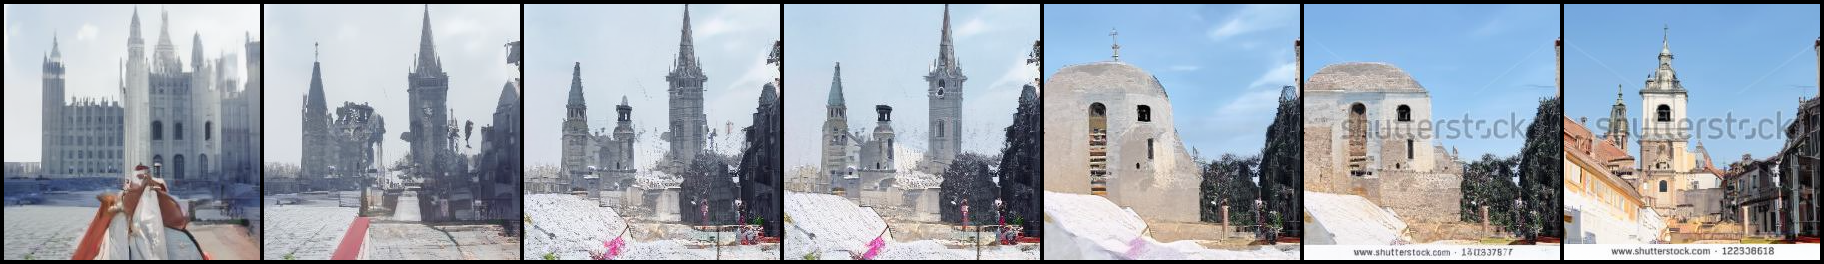
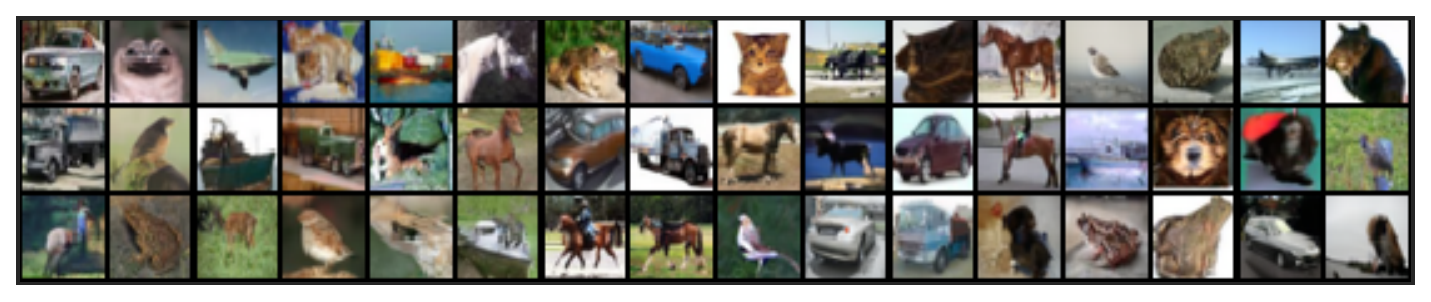
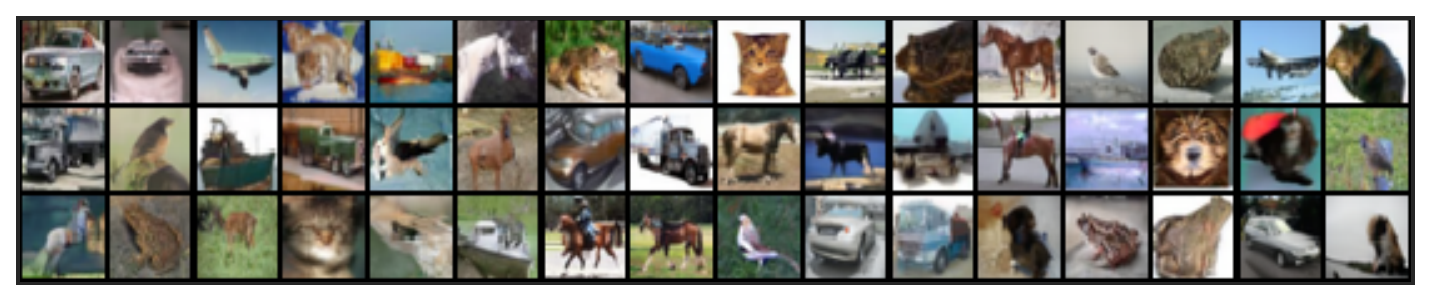
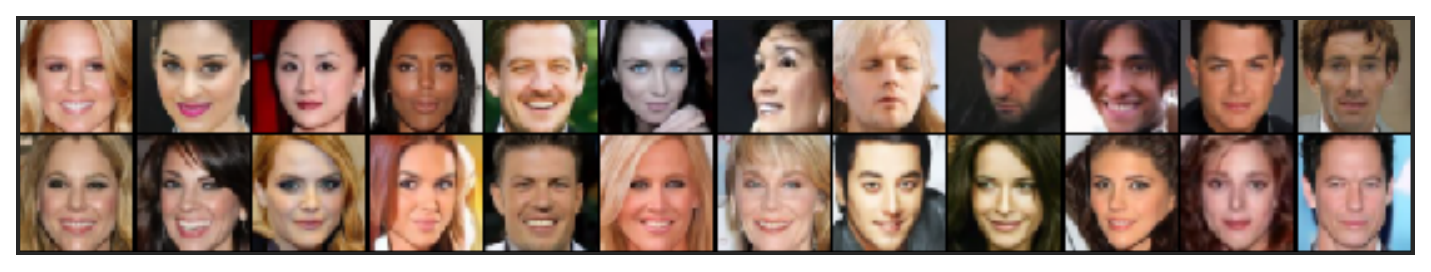
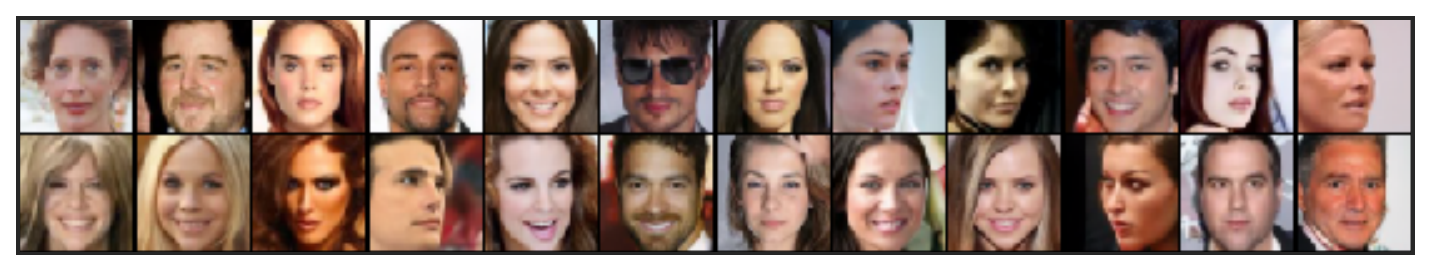
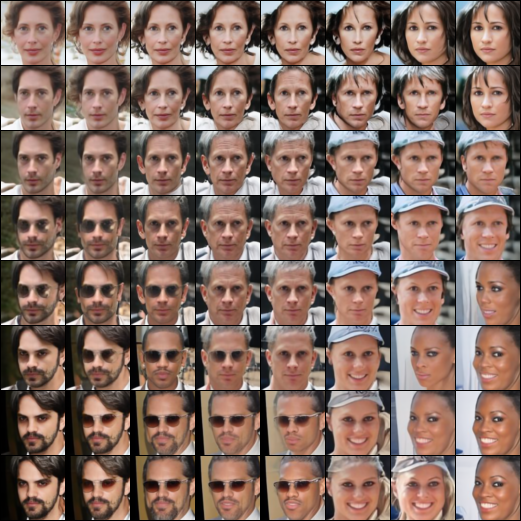
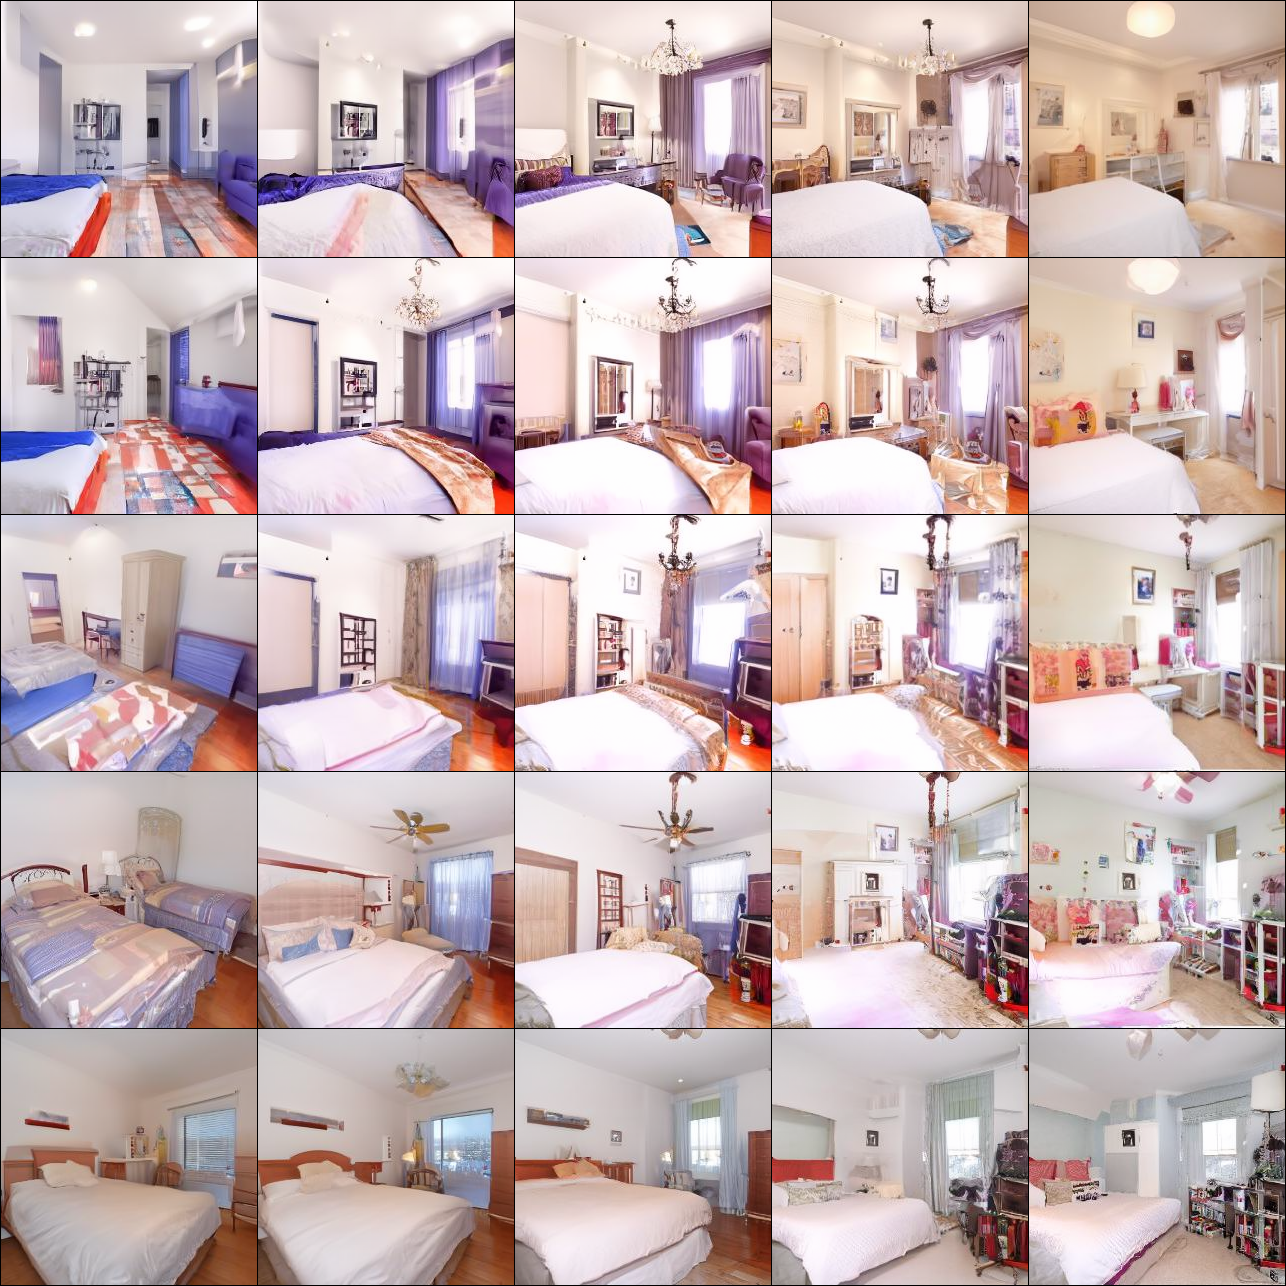
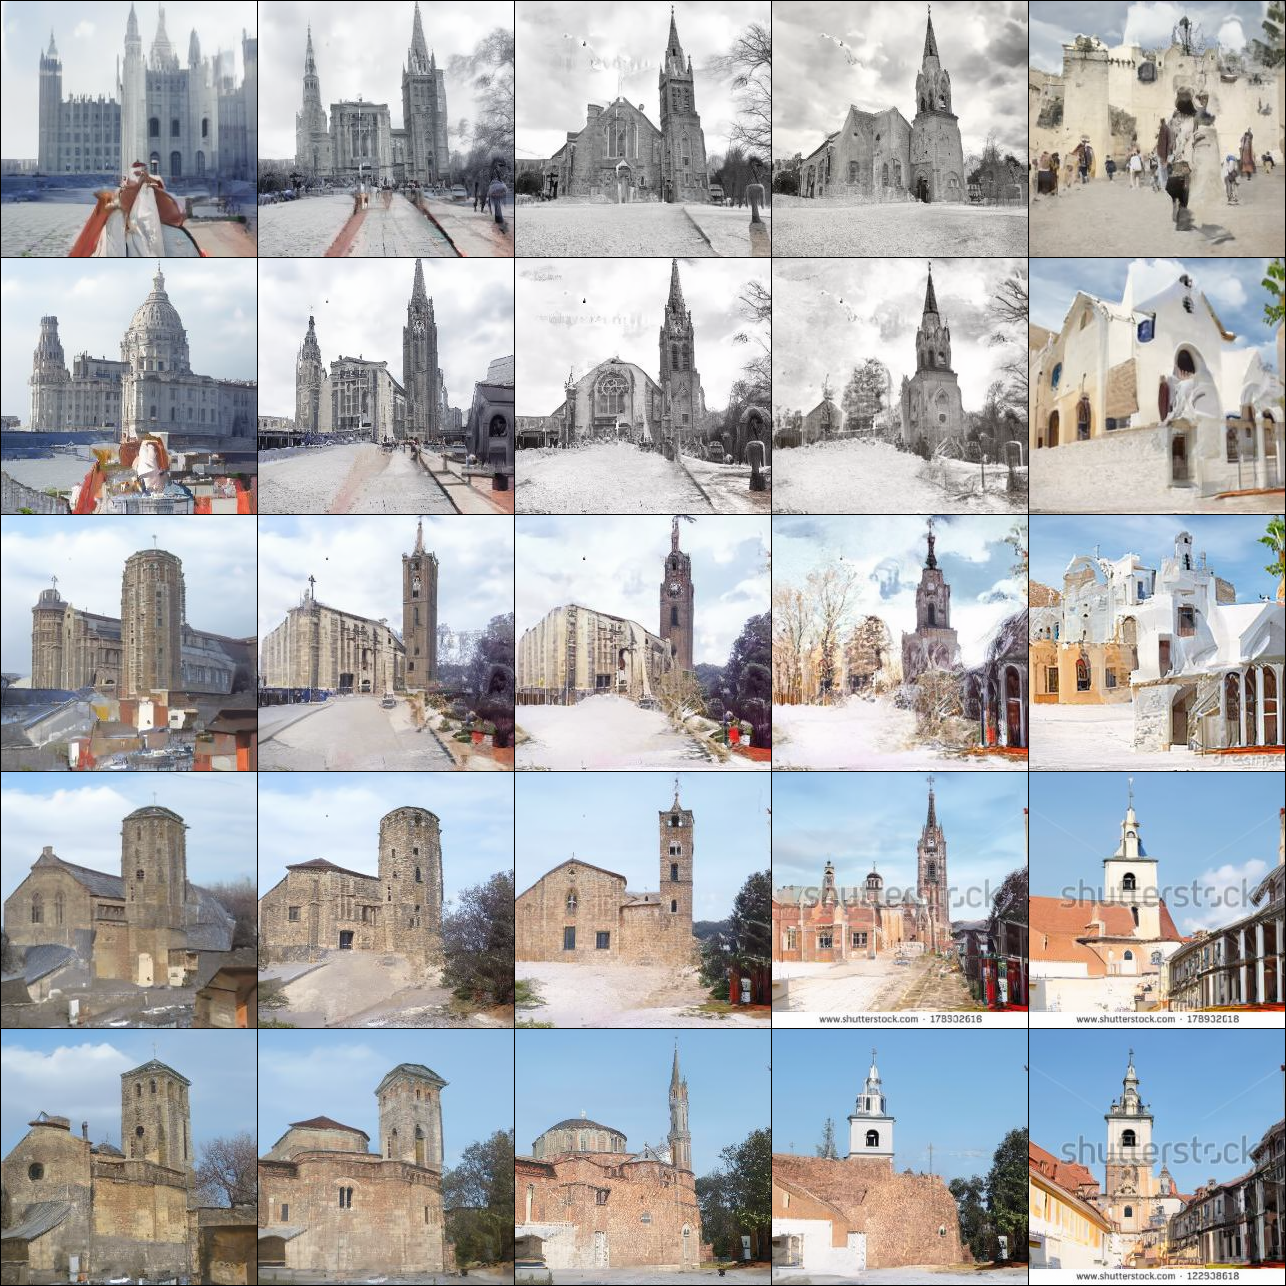
作者据此把 \(\mathbf{x}_T\) 视为信息丰富的 latent。对于两份初始 latent,附录使用 spherical linear interpolation:
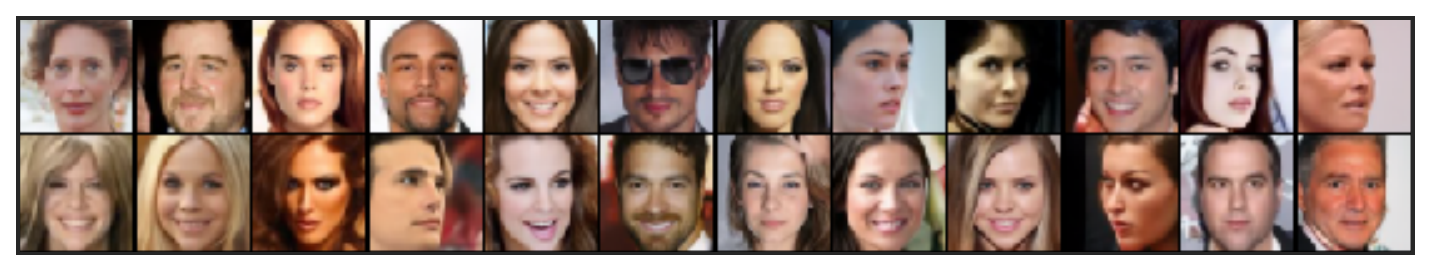
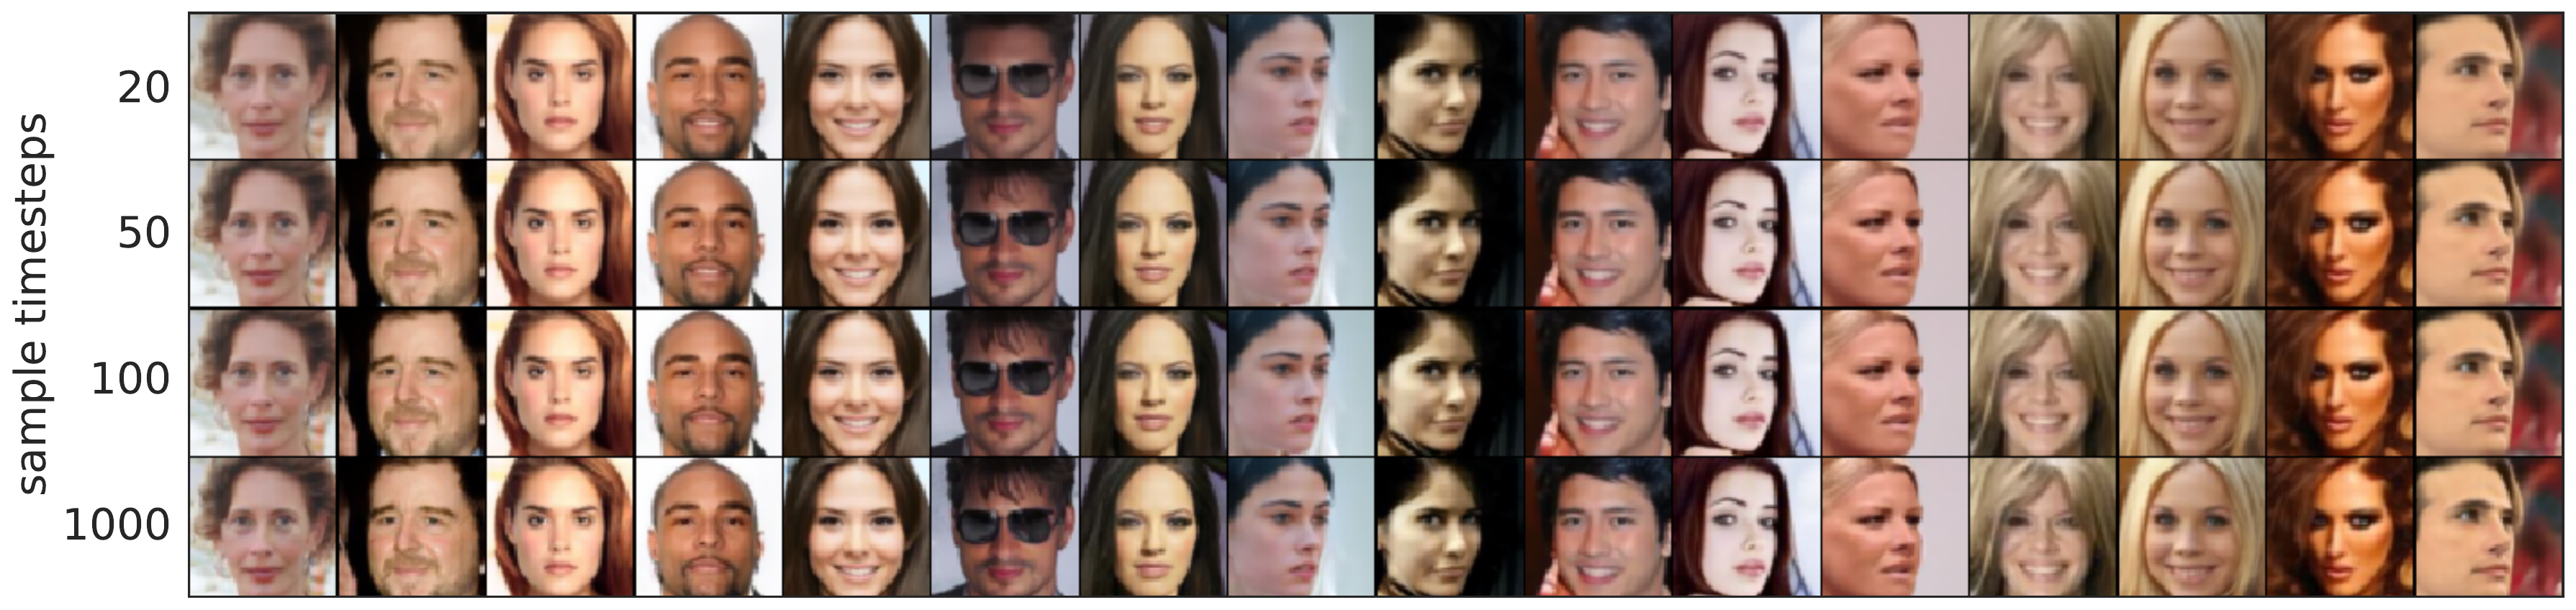
10 / REPRODUCTION DETAILS
| 项目 | CIFAR-10 | CelebA | LSUN Bedroom / Church |
|---|---|---|---|
| 分辨率 | 32×32 | 64×64,原始 CelebA,经 StyleGAN 工具预处理 | 256×256 |
| checkpoint | Ho et al. DDPM pretrained | 作者自行训练 | Ho et al. DDPM pretrained |
| 网络 | U-Net / Wide ResNet;channels 128;multiplier [1,2,2,2];2 residual blocks;16×16 attention;dropout 0.1 | channels 128;[1,2,2,2,4];2 blocks;16×16 attention;dropout 0.1 | channels 128;[1,1,2,2,4,4];2 blocks;16×16 attention;dropout 0 |
| diffusion | 1000 steps;linear beta 0.0001 到 0.02;随机水平翻转;数据缩放到 [-1,1] | ||
| 优化器 | Adam;lr 0.0002;\(\beta_1=0.9\);eps \(10^{-8}\);weight decay 0;gradient clip 1 | 同 CIFAR-10 | Adam;lr 0.00002;\(\beta_1=0.9\);eps \(10^{-8}\);weight decay 0;配置未列 gradient clip |
| batch / EMA | 128 / 0.9999 | 128 / 0.9999 | 64 / 0.999 |
| 配置上限 | n_epochs: 10000、n_iters: 5000000;训练循环按 epoch 运行,代码没有使用 n_iters 作为终止条件 | ||
| 采样 batch | 64 | 32 | 32 |
| 轨迹 | 论文 quadratic;代码 quad | linear / uniform | linear / uniform |
正文与附录没有给 CelebA 实际训练步数、训练耗时、GPU 数量、随机种子、完整数据 split 数量、数据下载版本、FID 实现版本、统计重复次数、scheduler、warmup、\(\beta_2\)、训练 precision 或 checkpoint 选择规则。代码依赖 PyTorch 1.6,并保存 50k PNG 供外部 FID 评估;仓库没有包含 FID 计算脚本。
11 / PAPER VS IMPLEMENTATION
代码核查固定在官方仓库提交 34d640e5180cc5ab378f84af6ed596cb0c810e6c(2020-10-20)。当前仓库 HEAD 的核心 configs/functions/models/runners/main.py 与该提交一致;后续代码差异仅涉及 CelebA 下载兼容,README 另增加 Diffusers 示例。
| 核查点 | 论文 | 固定提交 | 影响 |
|---|---|---|---|
| \(\eta\) 方差 | 式 (16) 与附录 closed form | c1 = eta * sqrt((1-at/at_next)*(1-at_next)/(1-at)) | 与论文对应,c2=sqrt(1-at_next-c1²) |
| 初始噪声 | \(\mathbf{x}_T\sim\mathcal{N}(0,I)\) | 每个 FID batch 用 torch.randn | \(\eta=0\) 仍生成不同随机样本 |
| 时间子序列 | linear 末端接近 \(T\);quadratic 同理 | uniform 为整数 range;quad 的最大时间约 \(0.8T\) | quadratic 实现与文字定义存在可复现差异 |
| \(\hat{\sigma}\) | 较大方差 DDPM 变体 | sample_type=ddpm_noisy 另走 ddpm_steps | 实现会 clamp \(\hat{x}_0\) 到 [-1,1] |
| 模型参数 | 等价最优解讨论假设各 \(t\) 参数不共享 | 一个 U-Net 通过 timestep embedding 服务所有 \(t\) | 理论 surrogate 论证的附加假设在实现中不满足 |
| 训练终止 | 未给 CelebA 精确步数 | 配置有 5,000,000 iterations,循环只检查 epoch | 仅凭配置不能恢复作者实际 checkpoint 训练预算 |
| 异常处理 | 未讨论 | 训练入口捕获全部异常;gradient clipping 也捕获全部异常 | 可能把错误写入日志后以正常返回结束,降低 fast-fail 可诊断性 |
| 插值命令 | slerp latent interpolation | README 把 --interpolation 描述为 inpainting;代码实际执行 slerp | README 名称错误,代码与论文插值实验一致 |
| 硬编码 | 实验给出 50k FID 与插值设置 | FID 样本数硬编码 50,000;插值 batch 分块与 11 个系数硬编码 | 更改评估规模需要编辑代码 |
12 / EVIDENCE AND FAIRNESS
每个数据集内部用同一个训练模型改变 \(S\) 与 \(\eta\),将大部分质量差异归因于采样过程。
CIFAR-10 32×32、CelebA 64×64 与两个 LSUN 256×256 类别共同验证短轨迹趋势。
论文把 \(S\lt T\) 的 DDPM 视作模拟一个用 \(S\) 步训练的 DDPM;它没有实际重新训练最优的 \(S\)-step baseline。
CIFAR-10 与 LSUN 使用外部 DDPM checkpoint,CelebA 使用作者 checkpoint。跨数据集绝对 FID 不构成方法公平比较。
FID 只有单点数值,未报告重复抽样、标准差或显著性。速度只给单 GPU 图表。
论文主要比较同一模型的 DDPM / DDIM 方差族,未覆盖后续高阶 ODE solver、distillation 或现代 scheduler。
论文还给出离散 categorical non-Markov forward process 的附录构造:固定 \(q(\mathbf{x}_t\mid\mathbf{x}_0)=\mathrm{Cat}(\alpha_t\mathbf{x}_0+(1-\alpha_t)\mathbf{1}_K)\)。这里 \(\mathbf{1}_K=(1/K,\ldots,1/K)\) 是归一化的均匀类别概率向量,每个元素都等于 \(1/K\)。前一步条件分布混合 \(\mathrm{Cat}(\mathbf{x}_t)\)、\(\mathrm{Cat}(\mathbf{x}_0)\) 与 \(\mathrm{Cat}(\mathbf{1}_K)\),三项权重依次为 \(\sigma_t\)、\(\alpha_{t-1}-\sigma_t\alpha_t\) 与 \((1-\alpha_{t-1})-(1-\alpha_t)\sigma_t\)。附录再用 KL 凸性得到加权多类别分类损失上界。该部分没有实验,只展示 Gaussian 之外的可扩展方向。
13 / REVIEWER COMMENTARY
通过 joint 的自由度解释 sampling schedule,使已有 DDPM checkpoint 获得 10–100 步推理能力,工程价值直接。
\(\eta\) 连续连接确定性 DDIM 与随机 DDPM,允许在样本质量、随机性与计算预算之间做受控实验。
确定性路径自然支持固定 latent 的跨轨迹一致性、slerp 与 ODE 反向编码,扩展了 diffusion model 的用途。
从任意加权目标推到无权重目标的最优解一致依赖不共享参数,实际时间条件 U-Net 共享全部主干参数。
比较没有重新训练或重新调优针对少步数设计的 DDPM;因此能证明同 checkpoint 下 DDIM 更适合少步采样。
CelebA 的实际训练预算、FID 工具链、种子和统计误差缺失;官方仓库也没有重建论文全部表格的一键脚本。
在 procedural material latent diffusion 中,把 renderer residual 作为局部误差估计,动态分配 \(\tau\) 与 ODE 步长。
对 graph topology 使用离散 non-Markov 构造,对连续材质参数使用 DDIM ODE,并设计执行有效性的联合约束。
固定同一初始 latent,比较不同 \(\eta\)、时间表与 renderer score;用有限预算选择可执行且视觉误差最低的轨迹。
以上研究延伸来自本文方法与 procedural material generation 的结合,原论文没有在 material graph、shader program 或 renderer-in-the-loop 任务上验证。
14 / PRIMARY SOURCES
PDF 列出三位作者及 Stanford 邮箱,没有共同第一作者标记,也没有星号或文字明确通信作者。Obsidian 现有记录把最后作者 Stefano Ermon 作为通信作者候选,状态应保持 unverified。