初始化
采样 \(\mathbf{x}_T\sim\mathcal{N}(\mathbf{0},\mathbf{I})\)。
把图像生成写成一个可训练的有限时长逆扩散链:预测噪声、直接训练采样器,并揭示变分推断、score matching、Langevin dynamics 与渐进压缩之间的共同结构。
Sohl-Dickstein 等人在 2015 年给出了 diffusion probabilistic model,但当时图像样本仍落后于 GAN、autoregressive model 与 VAE。本文寻找一组相互配合的设计:固定小步长高斯前向链、噪声预测参数化、简化的训练加权,以及适合图像的 U-Net。
原始变分上界虽然可计算,各时间步权重跨度很大;直接预测逆向均值也缺少清晰的归纳偏置。采样器还需要在训练完成后真正沿 1,000 步逆链运行,因此任何训练与采样的不一致都会累积。
如果让网络预测产生当前噪声图像的标准高斯噪声 \(\boldsymbol{\epsilon}\),每个时间步就成为统一尺度的去噪问题;去掉变分项的解析权重,会把优化重心移向更难的大噪声任务,从而改善视觉样本。
论文没有提出扩散概率模型本身。核心新增内容是明确的 \(\boldsymbol{\epsilon}\)-prediction 参数化、与 denoising score matching 的等价关系、显著的图像生成结果,以及渐进有损压缩解释。
把连续高斯转移展开后,独立高斯噪声的线性组合仍为高斯。定义 \(\alpha_t=1-\beta_t\) 与 \(\bar{\alpha}_t=\prod_{s=1}^{t}\alpha_s\),可直接从干净图像采样任意时间步:
因此训练时无需真的运行前向链 1,000 次。每个 minibatch 只需均匀采样一个 \(t\) 和一个噪声张量 \(\boldsymbol{\epsilon}\sim\mathcal{N}(\mathbf{0},\mathbf{I})\)。
后验均值是 \(\mathbf{x}_0\) 与 \(\mathbf{x}_t\) 的解析加权组合;方差只由 schedule 决定。这让每个 KL 项成为两个高斯之间的闭式距离。
Appendix A 的关键变换使用 Bayes 恒等式 \(q(\mathbf{x}_t\mid\mathbf{x}_{t-1})=q(\mathbf{x}_{t-1}\mid\mathbf{x}_t,\mathbf{x}_0)q(\mathbf{x}_t\mid\mathbf{x}_0)/q(\mathbf{x}_{t-1}\mid\mathbf{x}_0)\)。代入原始轨迹比值后,相邻时间步的边际项望远镜消去,留下末态 prior KL、中间后验 KL 与最后的 decoder NLL。这样既降低 Monte Carlo 方差,也让每个中间项能用高斯 KL 闭式计算。附录另把边际条件 \(q(\mathbf{x}_{t-1}\mid\mathbf{x}_t)\) 写入同一目标,得到“prior mismatch + 各步条件 KL + 数据熵”的压缩解释;这一个形式无法直接估计,只用于分析。
前向末态与标准正态先验的 KL。由于 \(\beta_t\) 固定,它对 \(\theta\) 是常数;实验中约为 \(10^{-5}\) bits/dim。
训练学习的逆向高斯转移,使其逼近已知 \(\mathbf{x}_0\) 时的精确前向后验。
最后一步的离散图像 decoder,对每个缩放后的 8-bit 像素值积分一个高斯 bin。
原始像素是 \(\{0,\ldots,255\}\) 的整数,线性缩放到 \([-1,1]\) 后,相邻量化值间距为 \(2/255\)。decoder 把每个离散值对应到以该值为中心、左右各 \(1/255\) 的连续区间,并对所有 \(D\) 个颜色坐标独立相乘:
边界像素使用无穷端点,确保最暗与最亮 bin 收下高斯尾部。精确变分训练中的 \(L_0=-\log p_{\theta}(\mathbf{x}_0\mid\mathbf{x}_1)\) 优化上面的离散似然。\(L_{\mathrm{simple}}\) 把 \(t=1\) 与其余时间步统一成连续噪声 MSE;论文将它解释为以“高斯密度乘 bin 宽度 \(2/255\)”近似积分,并忽略 \(\sigma_1^2\) 的解析权重与边界效应。两种目标在 \(t=1\) 上并不完全相同。
网络输出的 \(\boldsymbol{\epsilon}_{\theta}\) 被解析系数转换成逆向分布均值。代入 KL 后,第 \(t\) 步变为带解析权重的噪声均方误差:
它删除了上一式的时间权重,等价于重新加权变分上界。本文 schedule 下,这会降低小 \(t\)、低噪声项的相对权重,让网络更多处理大噪声去噪。实验显示 FID 明显改善,NLL 略微变差。
\(\mathbf{x}_0\sim q(\mathbf{x}_0)\)
\(t\sim\mathrm{Uniform}(\{1,\ldots,T\})\)
构造 \(\mathbf{x}_t\),保存真实 \(\boldsymbol{\epsilon}\)。
输入噪声图与时间 embedding。
最小化逐像素噪声 MSE。
采样 \(\mathbf{x}_T\sim\mathcal{N}(\mathbf{0},\mathbf{I})\)。
当 \(t\gt1\) 时 \(\mathbf{z}\sim\mathcal{N}(\mathbf{0},\mathbf{I})\);当 \(t=1\) 时令 \(\mathbf{z}=\mathbf{0}\),最后一步不再加噪。
论文显示 \(\boldsymbol{\mu}_{\theta}(\mathbf{x}_1,1)\);代码还会把由噪声反推的 \(\hat{\mathbf{x}}_0\) 裁剪到 \([-1,1]\)。
论文比较 \(\sigma_t^2=\beta_t\) 与 \(\sigma_t^2=\tilde{\beta}_t\),结果相近。主样本质量模型使用固定 large variance;学习对角方差在消融中训练不稳定。
训练样本只访问一个随机时间步,采样必须顺序执行 1,000 次网络计算。CIFAR10 一批 256 张需 17 秒;256² 一批 128 张需 300 秒。
| 项目 | CIFAR10 32² | CelebA-HQ / LSUN 256² |
|---|---|---|
| 网络 | U-Net / Wide ResNet;4 个分辨率;通道倍率 (1,2,2,2) | 6 个分辨率;通道倍率 (1,1,2,2,4,4) |
| 公共结构 | 每层 2 个 convolutional residual blocks;16×16 self-attention;GroupNorm;每个残差块注入 sinusoidal time embedding | |
| 参数量 | 35.7M | 114M;LSUN Bedroom large 约 256M |
| 优化器 | Adam 标准超参数;代码固定梯度全局范数阈值 1;EMA decay 0.9999;warmup 5,000 steps | |
| 学习率 / batch | \(2\times10^{-4}\) / 128 | \(2\times10^{-5}\) / 64 |
| 正则与增强 | dropout 0.1;random horizontal flip | dropout 0;LSUN Bedroom 不翻转,其余数据集翻转 |
| 训练步数 | 800k(10.6 小时,21 steps/s) | CelebA-HQ 0.5M;Bedroom 2.4M;Cat 1.8M;Church 1.2M;Bedroom large 1.15M |
| 硬件 | TPU v3-8,论文描述其计算规模近似 8 张 V100 | |
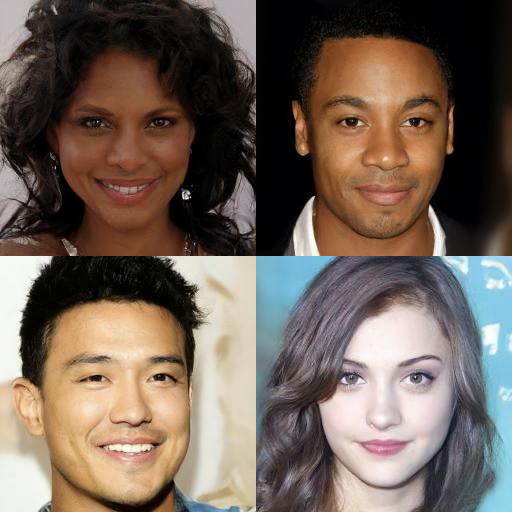
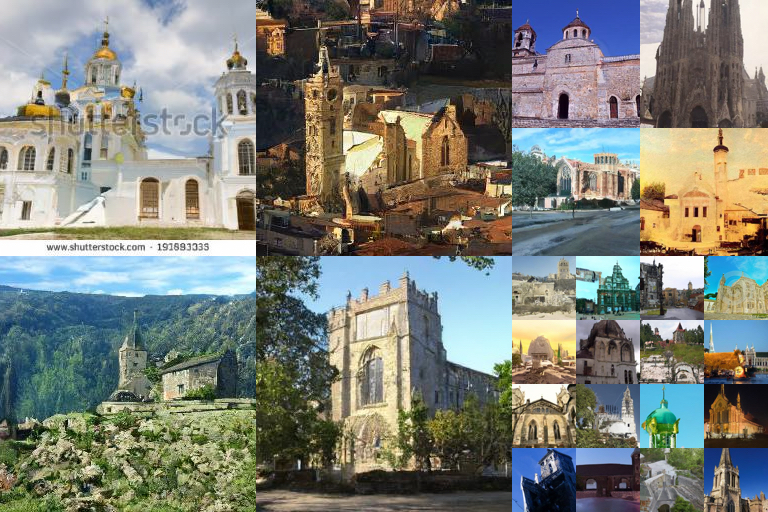
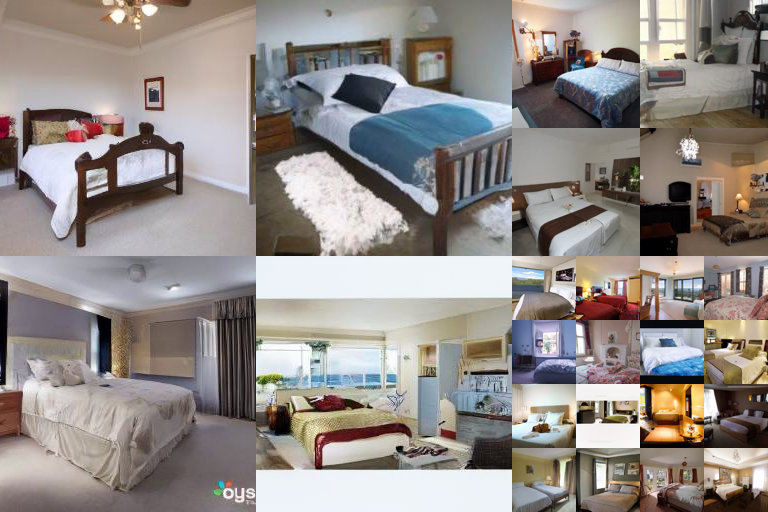
CIFAR10 与 CelebA-HQ 使用 TensorFlow Datasets;LSUN 用 StyleGAN 工具准备。8-bit RGB 像素缩放到 \([-1,1]\)。论文沿用各生成建模工作的标准数据划分,未给出新筛选或标注流程。
CIFAR10 的 IS 与 FID 使用 50,000 个样本,分别采用 OpenAI Inception 与 TTUR FID 代码。LSUN 用 StyleGAN2 代码计算 50,000 样本 FID。最终数字取训练过程中最低 FID checkpoint 对应的指标。
DDPM 使用带 self-attention 的 U-Net,并把 sinusoidal \(t\) embedding 注入全部残差块;NCSN 使用含 dilated convolution 的 RefineNet,时间条件只进入 normalization 或输出端。
DDPM 每次前向加噪前乘 \(\sqrt{1-\beta_t}\),避免信号与噪声相加后方差持续增长;NCSN 的 corruption 没有这一缩放。
DDPM 把信号破坏到 \(q(\mathbf{x}_T\mid\mathbf{x}_0)\) 与标准正态近似一致,并使用很小的 \(\beta_t\),让单步逆向条件高斯近似合理,减少训练与采样的分布偏移。
DDPM 的步长与噪声系数由 forward schedule 推导,变分目标直接训练有限步采样链;NCSN 在 score 网络训练完成后手工选择 annealed Langevin sampler 系数。
1e0dceb3b3495bbe19116a5e1b3596cd0706c543。CIFAR10 默认项明确为 model_mean_type='eps'、model_var_type='fixedlarge'、loss_type='mse';代码补充了正文未逐项列出的 warmup、梯度裁剪与通道倍率。运行环境是 TensorFlow 1.15、Python 3.5 与 Google Cloud TPU/GCS,现代环境复现需要兼容性维护。| 类别 | 模型 | IS ↑ | FID ↓ | NLL Test (Train) ↓ bits/dim |
|---|---|---|---|---|
| Conditional | EBM | 8.30 | 37.9 | — |
| Conditional | JEM | 8.76 | 38.4 | — |
| Conditional | BigGAN | 9.22 | 14.73 | — |
| Conditional | StyleGAN2 + ADA (v1) | 10.06 | 2.67 | — |
| Unconditional | Diffusion (original) | — | — | ≤ 5.40 |
| Unconditional | Gated PixelCNN | 4.60 | 65.93 | 3.03 (2.90) |
| Unconditional | Sparse Transformer | — | — | 2.80 |
| Unconditional | PixelIQN | 5.29 | 49.46 | — |
| Unconditional | EBM | 6.78 | 38.2 | — |
| Unconditional | NCSNv2 | — | 31.75 | — |
| Unconditional | NCSN | 8.87±0.12 | 25.32 | — |
| Unconditional | SNGAN | 8.22±0.05 | 21.7 | — |
| Unconditional | SNGAN-DDLS | 9.09±0.10 | 15.42 | — |
| Unconditional | StyleGAN2 + ADA (v1) | 9.74±0.05 | 3.26 | — |
| Unconditional | Ours (\(L\), fixed isotropic \(\boldsymbol{\Sigma}\)) | 7.67±0.13 | 13.51 | ≤ 3.70 (3.69) |
| Unconditional | Ours (\(L_{\mathrm{simple}}\)) | 9.46±0.11 | 3.17 | ≤ 3.75 (3.72) |
| 预测对象 | 目标 / 方差 | IS ↑ | FID ↓ |
|---|---|---|---|
| \(\tilde{\boldsymbol{\mu}}\) | \(L\),learned diagonal \(\boldsymbol{\Sigma}\) | 7.28±0.10 | 23.69 |
| \(\tilde{\boldsymbol{\mu}}\) | \(L\),fixed isotropic \(\boldsymbol{\Sigma}\) | 8.06±0.09 | 13.22 |
| \(\tilde{\boldsymbol{\mu}}\) | unweighted \(\lVert\tilde{\boldsymbol{\mu}}-\tilde{\boldsymbol{\mu}}_{\theta}\rVert^2\) | 不稳定 | 不稳定 |
| \(\boldsymbol{\epsilon}\) | \(L\),learned diagonal \(\boldsymbol{\Sigma}\) | 不稳定 | 不稳定 |
| \(\boldsymbol{\epsilon}\) | \(L\),fixed isotropic \(\boldsymbol{\Sigma}\) | 7.67±0.13 | 13.51 |
| \(\boldsymbol{\epsilon}\) | \(L_{\mathrm{simple}}\) | 9.46±0.11 | 3.17 |
消融支持三项具体结论:固定方差比学习对角方差稳定;在真实 ELBO 下预测 \(\tilde{\boldsymbol{\mu}}\) 与预测 \(\boldsymbol{\epsilon}\) 相近;噪声预测与无权重 MSE 的组合带来主要 FID 改善。它没有把网络结构、schedule 和目标逐项完全析因。
| 模型 | Bedroom | Church | Cat |
|---|---|---|---|
| ProgressiveGAN | 8.34 | 6.42 | 37.52 |
| StyleGAN | 2.65 | 4.21* | 8.53* |
| StyleGAN2 | — | 3.86 | 6.93 |
| Ours (\(L_{\mathrm{simple}}\)) | 6.36 | 7.89 | 19.75 |
| Ours (large) | 4.90 | — | — |
* StyleGAN2 论文代为报告的 baseline。本文在 LSUN 上达到与 ProgressiveGAN 相近的量级,但没有击败 StyleGAN 系列。
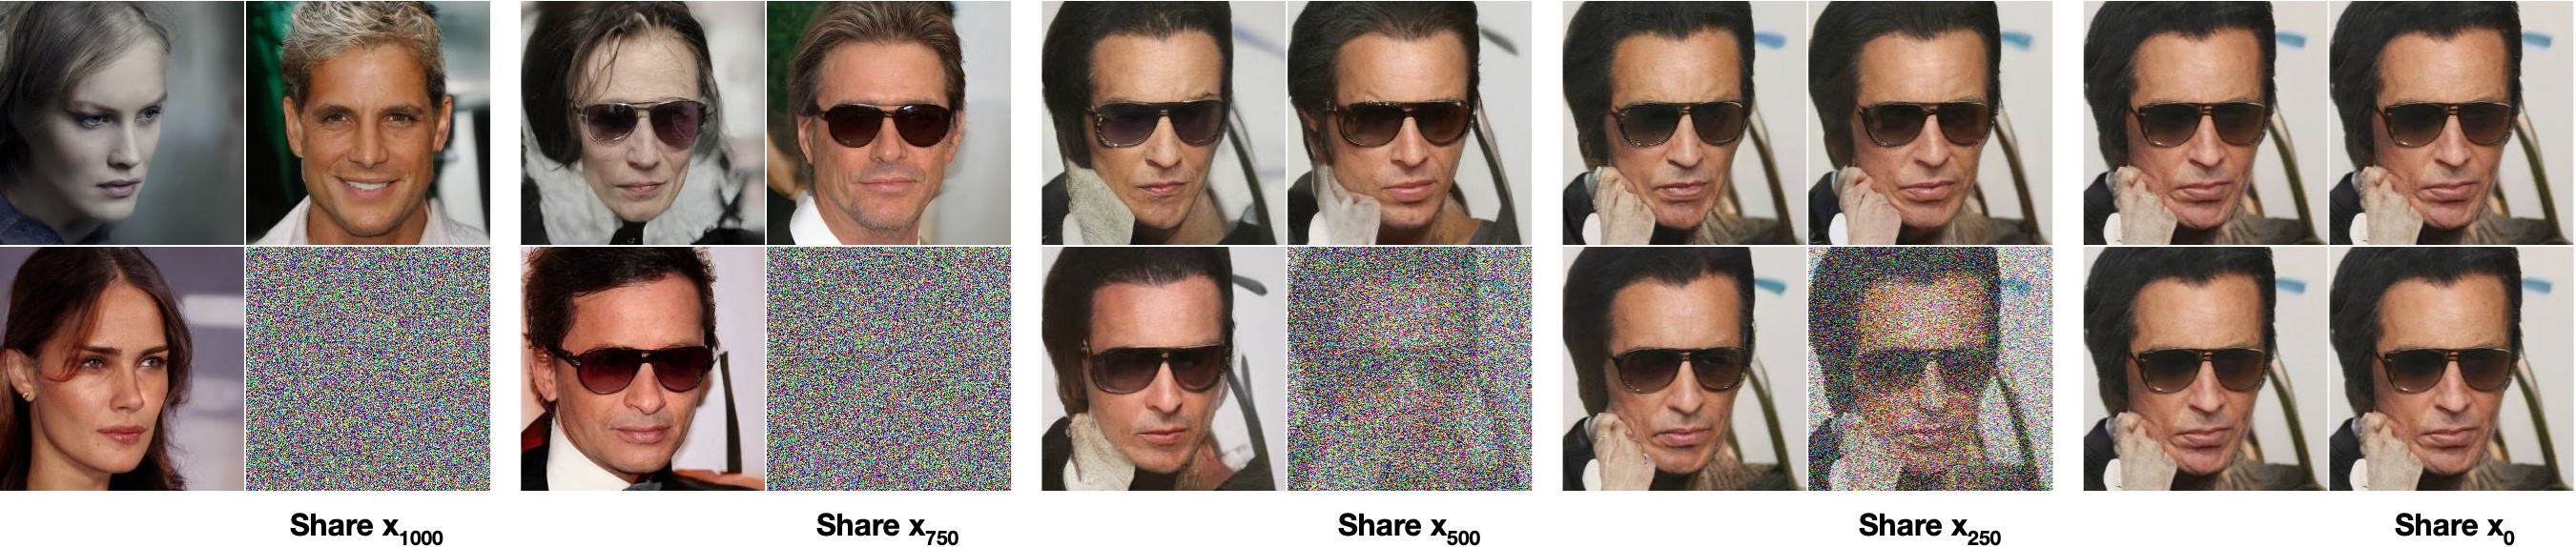
最高样本质量模型的总 NLL 为 3.75 bits/dim,其中 rate 为 1.78,distortion 为 1.97;重建 RMSE 只有 0.95(0–255 尺度)。超过一半无损码长用于人眼几乎无法察觉的细节。
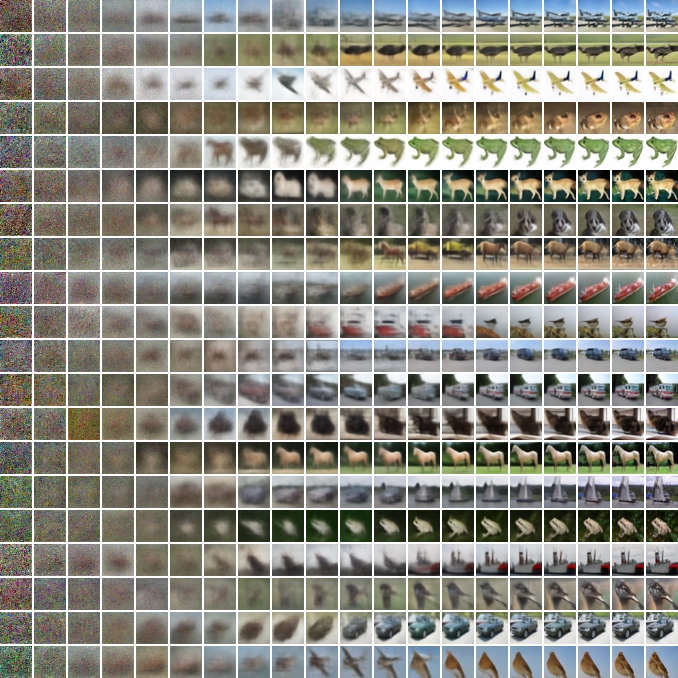
接收端每获得一个更早的隐变量,就能用上式更新当前重建。低码率阶段迅速恢复语义与大尺度结构,后续大量比特只改善细节。
| 逆向时间 \(T-t+1\) | Rate (bits/dim) | Distortion RMSE [0,255] |
|---|---|---|
| 1000 | 1.77581 | 0.95136 |
| 900 | 0.11994 | 12.02277 |
| 800 | 0.05415 | 18.47482 |
| 700 | 0.02866 | 24.43656 |
| 600 | 0.01507 | 30.80948 |
| 500 | 0.00716 | 38.03236 |
| 400 | 0.00282 | 46.12765 |
| 300 | 0.00081 | 54.18826 |
| 200 | 0.00013 | 60.97170 |
| 100 | 0.00000 | 67.60125 |
如果存在能以约 \(D_{\mathrm{KL}}(q\mathbin\Vert p)\) 平均比特发送样本的 minimal random coding 程序,逐步码长相加恰好对应 ELBO 的 \(L_T\)、\(L_{T-1},\ldots,L_1\) 与 \(L_0\)。这一对应解释了 rate-distortion 表的“rate”如何累计。
如果前向过程改成每步遮掉一个坐标,逆向模型就逐坐标恢复数据,退化为 autoregressive model。高斯扩散则像一种无法用像素重排表达的“软位序”:各频率、尺度与空间位置的信息在噪声过程中连续消失,再按粗到细的次序恢复。这是作者解释图像归纳偏置的推测,论文没有用频谱或语义探针直接证明。
研究学习方差、非均匀时间网格、确定性轨迹与少步蒸馏。目标是在固定计算预算下控制每一步对语义结构和高频细节的贡献。
将 perceptual quality、likelihood 与不同噪声区间的权重写成可解释的多目标问题;用 gradient SNR 或在线难度估计分配时间步。
对 material graph、shader graph 或程序 token,前向 corruption 可以作用于拓扑、节点参数和渲染结果;逆向过程需要有效性约束与 renderer-in-the-loop 修复。
把每个逆向状态看成可检查的中间方案,加入外部执行、感知指标、回溯和重采样。论文的固定马尔可夫链提供基线,新的研究问题是怎样让反馈改变后续去噪轨迹。