DiffMat 精读
Visual Informatics · 2024 · Research article

把材质生成移入 StyleGAN latent

DiffMat 用冻结的 CLIP ViT-H/14 读取任意照明下的参考照片,以八层 cross-attention MLP 在 512 维 PhotoMat latent 中执行条件扩散,再解码出可直接进入 PBR 流程的十通道 SVBRDF。

Liang Yuan · 第一及通讯作者Dingkun YanSuguru SaitoIssei FujishiroDOI 10.1016/j.visinf.2023.12.0019 页
参考照片平面材质,光照未知或复杂
CLIP tokens224² → 257 × 1024,全部 token
Latent diffusion512 维向量,20 步 DPM-Solver++
PhotoMat 解码32 通道隐式材质 → 10 通道贴图
PBR 输出albedo / normal / roughness / specular
01 · RESEARCH GAP

论文真正解决了什么

目标是从一张日常照片生成“外观相似、可重新渲染、允许多样采样”的材质。系统不恢复照片中唯一真实的 SVBRDF;它从 PhotoMat 已学到的材质流形中采样条件匹配的候选。

Paper Verified

输入与输出

输入 \(c\) 是平面材质参考照片,可包含阳光、室内环境光、阴影或相机闪光。输出 \(x\in\mathbb{R}^{10\times H\times W}\) 包含 3 通道 albedo、3 通道 normal、1 通道 roughness 与 3 通道 specular。

Paper Verified

两个数据瓶颈

像素空间扩散需要高计算量;真实高分辨率 SVBRDF 数据又稀缺。论文借用预训练 PhotoMat generator 作为材质先验与 decoder,仅训练 latent denoiser。

Our Interpretation

先验约束的条件生成

CLIP 约束 latent 的视觉语义,PhotoMat 决定可输出材质的支持集。结果的物理参数来自生成器先验,输入照片提供外观条件,二者没有逐像素反演约束。
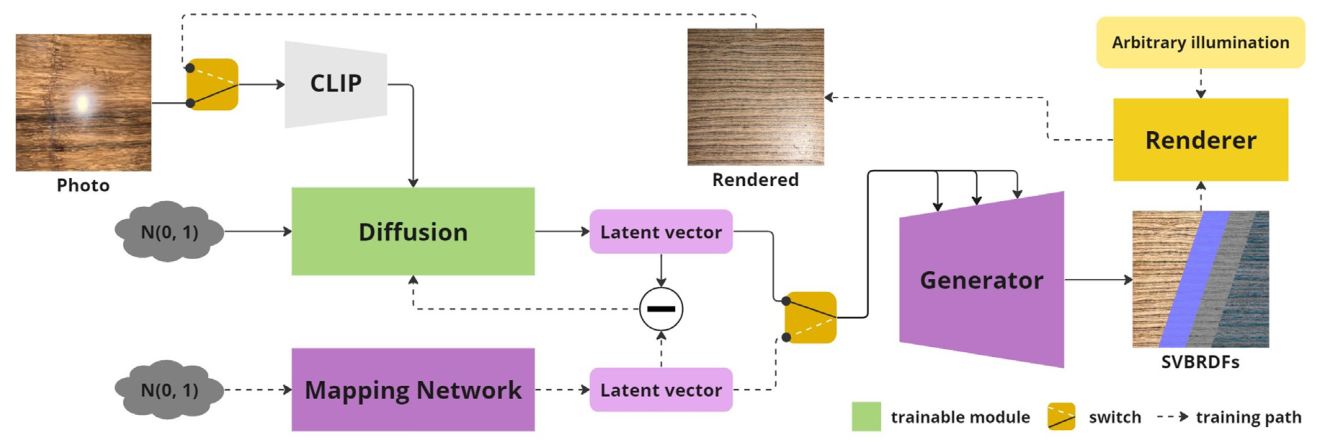
论文 Figure 1:DiffMat 完整流程
Figure 1 · 总体流程。 CLIP 将参考图编码为条件;扩散模型生成材质 latent;PhotoMat generator 将 latent 解码为 SVBRDF。这里的 DiffMat 与同名可微 Substance 材质图 renderer 没有实现关系。
任务边界这篇论文没有生成 material graph、SBS/SBSAR、shader program 或节点拓扑;推理时没有 renderer-in-the-loop 参数优化。它输出固定语义的十通道像素贴图。
02 · PIPELINE

训练数据在运行时产生

训练配对来自同一 latent 的“材质参数”与“随机光照渲染图”,保证条件图 \(c\) 和目标 \(z\) 对应同一材质,同时强迫条件编码器面对光照变化。

STEP 01

采样 StyleGAN

从高斯噪声 \(\epsilon_0\) 经 PhotoMat mapping network \(\xi\) 获得 512 维 \(z\)。

STEP 02

解码材质

\(\psi\) 产生 \(32\times H\times W\) 隐式材质;\(\delta\) 输出十通道 SVBRDF。

STEP 03

随机照明渲染

实时 GGX renderer 随机改变方向光、点光和环境光的强度、位置与方向。

STEP 04

条件去噪

冻结 CLIP 提取全部 257 tokens,cross-attention MLP 预测加入 latent 的噪声。
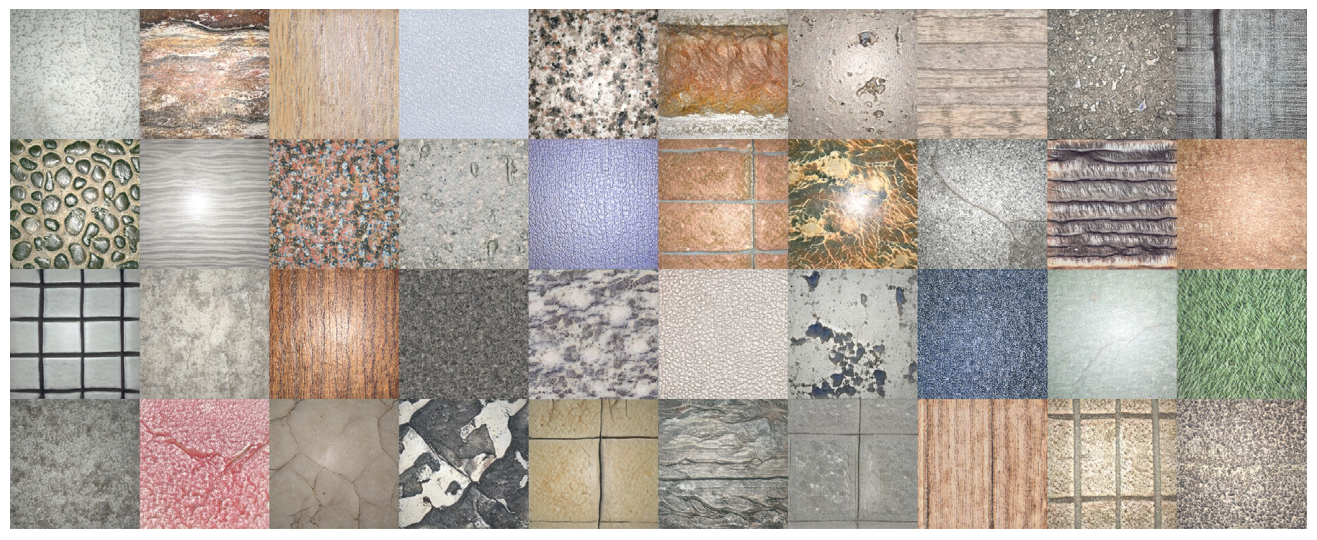
论文 Figure 2:任意照明条件的训练图像
Figure 2 · 在线训练条件。 同一生成材质在模拟太阳的方向光、模拟闪光灯的点光与环境光下渲染;每种光源参数随机变化。该过程产生合成配对,不代表论文收集了真实照片与真实 SVBRDF 的成对数据。
Author Claim

降低光照敏感性

作者认为多光照渲染让模型把材质外观与具体照明解耦。实验展示不同真实照明下的定性结果,但没有 illumination-specific quantitative split,也没有光照估计或真实 BRDF 的直接误差。

Paper Verified

PhotoMat 的角色

PhotoMat generator 已从真实 flash photographs 学习材质分布。DiffMat 冻结并复用它的 mapping、projection 与 material map decoder;训练目标处于 generator 的 latent domain。

03 · FORMULATION

公式 1–8:从扩散到注意力

原文沿用 \(\alpha_t,\beta_t\) 表示在任意时刻直接混合信号与噪声的幅值。这里的 \(\beta_t\) 不应自动解释为经典 DDPM 中逐步转移方差。

Equation 1 · 前向加噪
\[x_t=\alpha_t x+\beta_t\epsilon,\qquad \epsilon\sim\mathcal{N}(0,1),\quad t\sim\mathcal{U}\{1,\ldots,T\}.\]

\(x\) 为干净样本;\(x_t\) 为时刻 \(t\) 的带噪样本;\(\alpha_t\) 与 \(\beta_t\) 是噪声日程给定的信号和噪声幅值;\(T\) 未报告。

Equation 2 · 无条件噪声预测
\[\mathcal{L}_{\mathrm{DM}}=\mathbb{E}_{x,\epsilon,t}\!\left[\left\lVert\epsilon-\epsilon_{\theta}(x_t,t)\right\rVert_2^2\right].\]

\(\epsilon_{\theta}\) 预测被加入的噪声。原文将其描述为从 \(x_t\) 预测 \(x_{t-1}\),目标式仍写成噪声预测。

Equation 3 · 条件扩散
\[\mathcal{L}_{\mathrm{DM}}=\mathbb{E}_{x,c,\epsilon,t}\!\left[\left\lVert\epsilon-\epsilon_{\theta}\!\left(x_t,t,\tau_{\theta}(c)\right)\right\rVert_2^2\right].\]

\(c\) 是参考图;\(\tau_{\theta}\) 是冻结的 CLIP ViT-H/14,输出 257 个 1024 维 token。

Equation 4 · PhotoMat latent 目标
\[\mathcal{L}_{\mathrm{DM}}=\mathbb{E}_{z,c,\epsilon,t}\!\left[\left\lVert\epsilon-\epsilon_{\theta}\!\left(z_t,t,\tau_{\theta}(c)\right)\right\rVert_2^2\right].\]

\(z\in\mathbb{R}^{512}\) 是 StyleGAN latent,\(z_t\) 是加噪 latent。去噪对象由十通道纹理变成固定长度向量。

Equations 5–6 · 先验与解码器
\[z=\xi\!\left(\epsilon_0\right),\qquad \epsilon_0\sim\mathcal{N}(0,1),\tag{5}\]\[x=\delta\!\left(\psi(z)\right).\tag{6}\]

\(\xi\) 是 StyleGAN mapping network;\(\psi(z)\in\mathbb{R}^{32\times H\times W}\) 是 projection network 的隐式材质;\(\delta\) 输出 \(x\in\mathbb{R}^{10\times H\times W}\)。512 维、32 通道与 10 通道是三种不同表示。

Equation 7 · 在线配对
\[c=R(x,l).\]

\(R\) 是 GGX microfacet 2D renderer;\(l\) 是随机照明配置。该式把同一 \(z\) 解码的 \(x\) 渲染为条件图 \(c\)。

Equation 8 · 每层 cross-attention
\[Q=W_Q^{i}\,\phi(z_t),\qquad K=W_K^{i}\,\tau_{\theta}(c),\qquad V=W_V^{i}\,\tau_{\theta}(c).\]

\(i\) 是 denoiser 层编号;\(\phi(z_t)\) 是注入 time embedding 的中间 latent;query 来自 latent 支路,key/value 来自全部 CLIP tokens;三个 \(W\) 是可训练投影。

Classifier-free guidance

\[\widehat{\epsilon}_{\theta}=\epsilon_{\theta}(z_t,t,\varnothing)+s\left[\epsilon_{\theta}\!\left(z_t,t,\tau_{\theta}(c)\right)-\epsilon_{\theta}(z_t,t,\varnothing)\right].\]

训练以 0.15 概率丢弃条件;推理使用 \(s=2.5\)。这个式子解释 CFG 语义,论文没有单独编号写出。

DPM-Solver++

采用 Stability AI 实现的 second-order multistep DPM-Solver++,默认 20 个 sampling steps。论文没有给出 solver 准确子变体、noise schedule、总 \(T\)、动态阈值、随机种子或 tolerance。
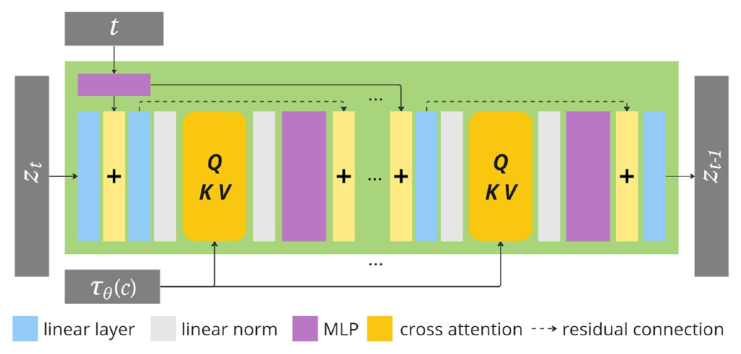
论文 Figure 3:多层 cross-attention denoising network
Figure 3 · Denoiser 完整公开配置。 512 维带噪 latent 与 time embedding 进入 linear layer;主体包括 linear normalization、MLP、cross-attention 与 residual connection,共八个 cross-attention 层;输出与 latent 同维度的噪声预测。每层 Q 来自 latent 支路,K/V 来自 \(\tau_{\theta}(c)\)。正文与图中没有报告 MLP hidden widths、attention heads、dropout 或参数量。
04 · REPRODUCTION

已公开的训练配置

论文足以重建总体训练逻辑与主要超参数,仍不足以精确复现权重。官方项目页只提供论文说明与 DOI;核查时没有模型代码链接。

512 × 512PhotoMat synthesis network;另可换 tileable 256 × 256 variant
ViT-H/14冻结 OpenCLIP;224 × 224 输入;257 × 1024 输出
8 layerscross-attention backbone;目标 latent 为 512 维
AdamWlearning rate \(10^{-5}\),betas \(0.9,0.999\),weight decay 0.1
Batch 64PyTorch DDP;4 × NVIDIA A100-SXM 40GB
Drop 0.15classifier-free guidance 条件丢弃概率
每 1M steps3,200 张选定条件图与 renderer 输出检查 FID
26M stepsFID 稳定后停止;论文称约 2 天
20 stepsDPM-Solver++ second-order multistep;guidance 2.5
26M steps 的口径存在复现疑问在 batch 64、四张 A100、约 48 小时的同一段描述中,“26M steps”会对应异常巨大的样本吞吐。原文没有解释它表示 optimizer updates、训练样本、DDP 子步还是其他计数单位,因此保留原始口径,不换算成 epochs 或样本数。
已报告

模型与硬件

PyTorch、DistributedDataParallel、DGX Station A100、四张 A100-SXM 40GB;冻结 CLIP;复用 PhotoMat generator;实时 GGX renderer。

缺失

精确复现障碍

训练 latent 数量与 split、光照参数分布、noise schedule、总 diffusion steps、MLP width、attention heads、激活函数、scheduler、warmup、precision、gradient clipping、checkpoint 与随机种子均未公开。

05 · EVIDENCE

实验到底证明了什么

评价集有 50 个材料:20 个 Poly Haven 合成材质通过 Unity GPU path tracer 在随机方向光、spotlight、environment map 下渲染,另有 30 张 iPhone 14 实拍照片,覆盖室外、明亮室内与昏暗环境。
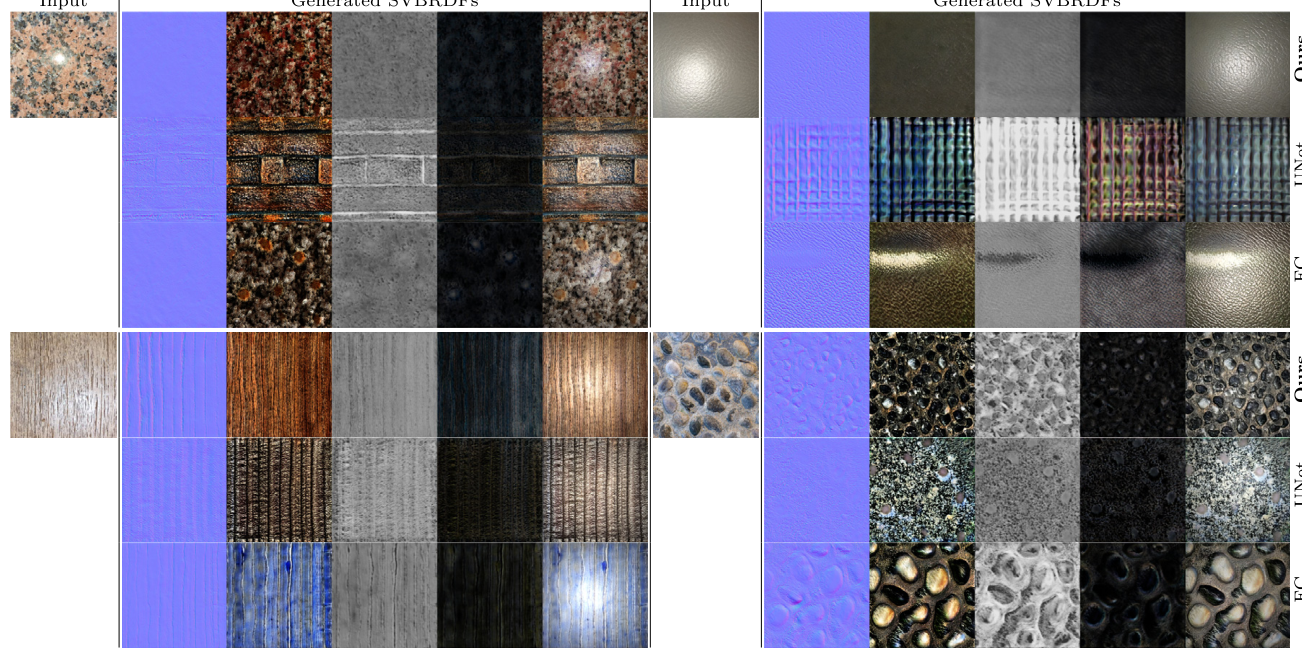
论文 Figure 4:网络架构消融
Figure 4 · 架构消融。 相同 guidance scale 2.5 下,UNet、纯 FC 与八层 cross-attention 的 SVBRDF 及渲染结果。本文网络更接近参考图的图案与颜色。
denoiser结构Albedo FID ↓Rendered FID ↓
UNettime-conditional UNet182.3196.1
FC仅 fully connected layers90.383.1
Oursmulti-layer cross-attention27.633.2

Table 1 的全部 3 × 2 数值。FID 只在评价集的 20 个合成材质上计算;论文没有报告每个材质生成多少样本、置信区间或重复运行方差。这个 20 材质结果与训练期间每 1M steps 使用的 3,200 张检查图像属于不同集合。

Paper Verified

消融支持 cross-attention

相同训练参数下,Ours 相对 FC 的 Albedo FID 从 90.3 降至 27.6,Rendered FID 从 83.1 降至 33.2;相对 UNet 差距更大。

证据边界

没有拆开八层与全 token

实验把完整结构与两个粗粒度 baseline 比较,没有分别改变 attention 层数、global/local token、time embedding 或 residual path,无法将收益归因到单个组件。
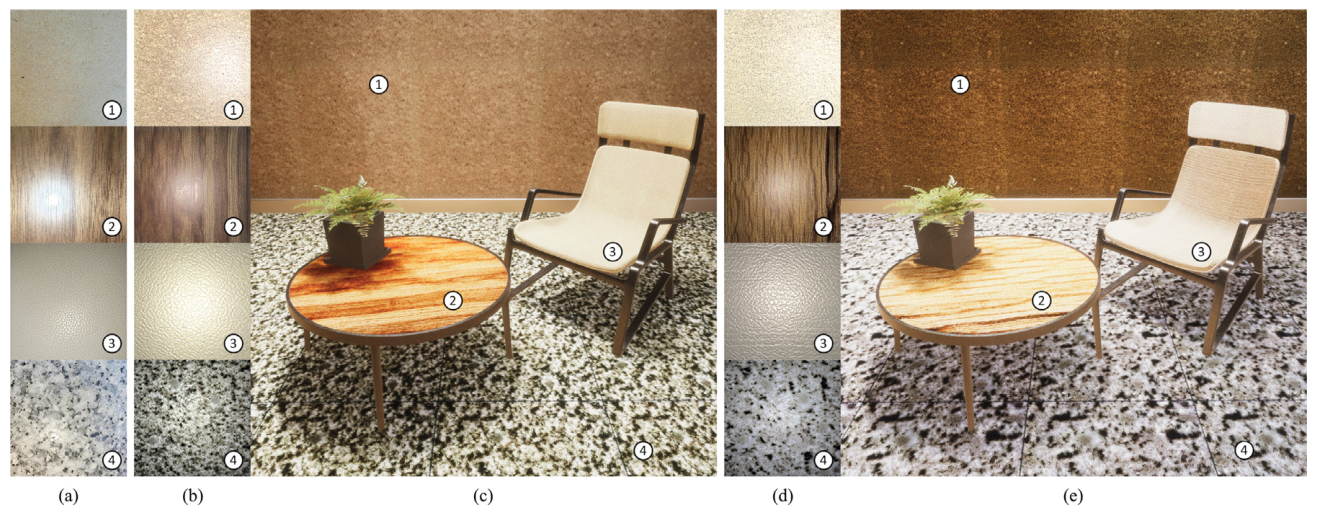
论文 Figure 5:数字场景材质生成应用
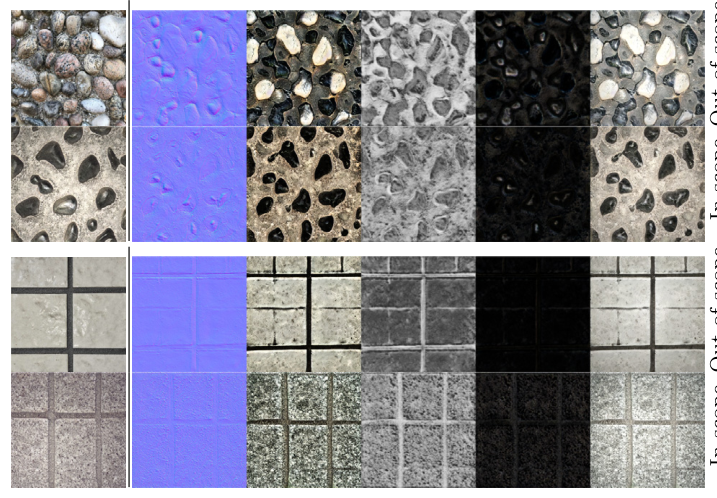
Figure 5 · 数字场景应用。 作者拍摄墙面、桌面、椅面和地面四张参考图,生成两组材料,再应用到对应 3D 物体。该图展示 PBR 可用性与多样采样,没有物理参数 ground truth。
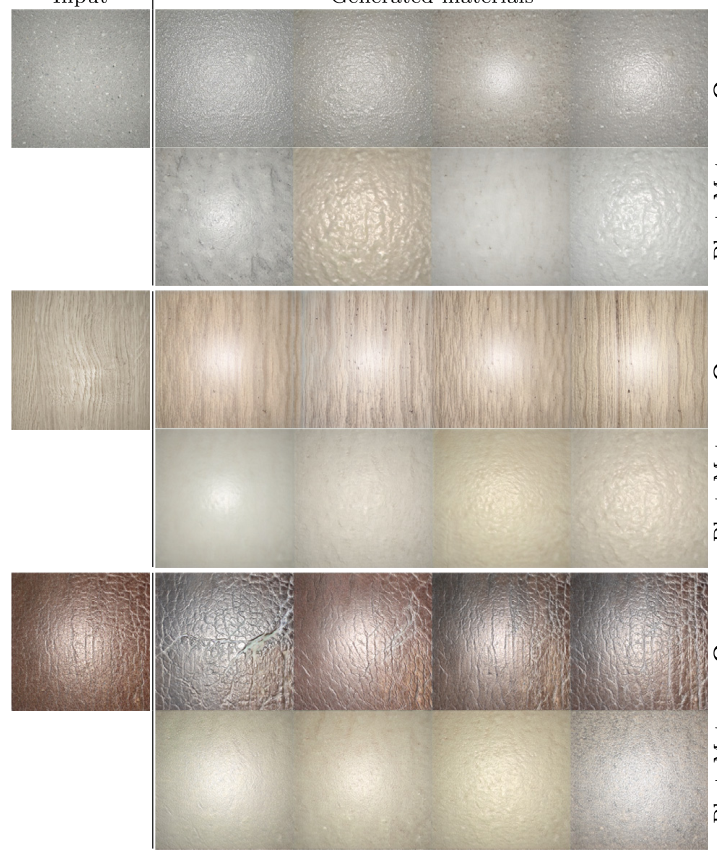
论文 Figure 6:DiffMat 与 conditional PhotoMat
Figure 6 · Conditional PhotoMat。 作者改造 StyleGAN mapping network 以接收 CLIP tokens,并与 DiffMat 在相同参考图上各生成四个种子。这个 baseline 是本文训练的条件版本,并非 PhotoMat 原论文发布的条件模型。
论文 Figure 7:DiffMat 与 TileGen
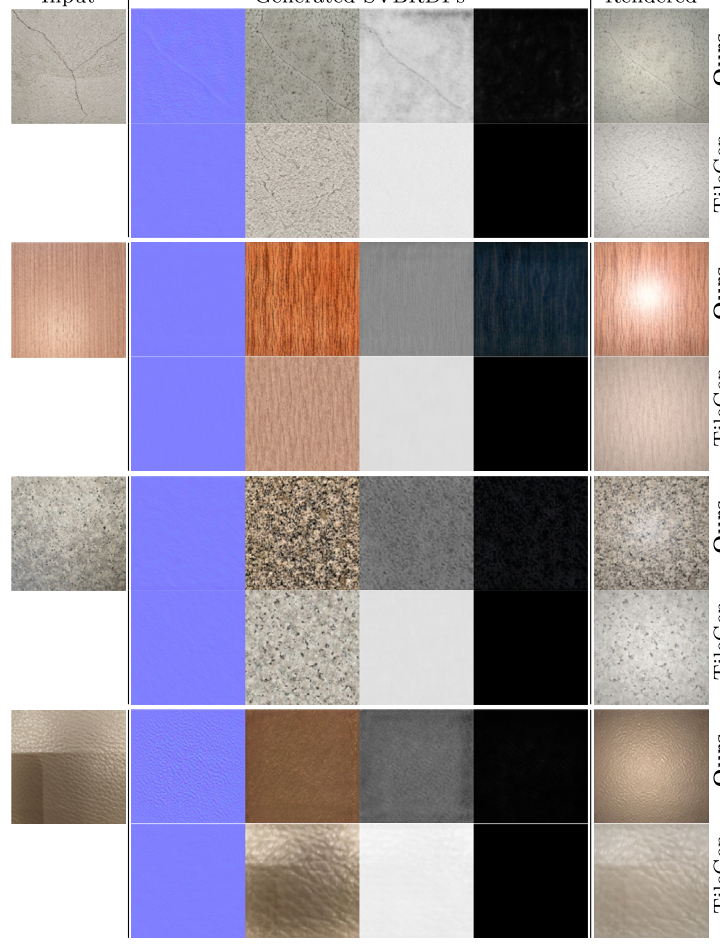
Figure 7 · TileGen。 相同真实照片与 RTX 2080 Ti 上,DiffMat 使用 20 个 DPM steps,TileGen 使用 500 个优化 steps。图中比较石材、木材与皮革的 SVBRDF 及渲染结果。
0.87 s
DiffMat · 20-step DPM-Solver++ · RTX 2080 Ti
137.7 s
TileGen · 500 optimization steps · RTX 2080 Ti
速度数字的边界同一 GPU 与作者指定迭代数下,计时比约为 \(137.7/0.87\approx158.3\)。两种方法的目标、训练成本、输出分布与质量没有被控制为严格等价,这个比值只描述该实验设置的推理时延。
论文 Figure 8:StyleGAN 支持集之外的失败案例
Figure 8 · OOD 失败。 当参考照片超出 StyleGAN generator 的支持范围时,结果出现伪影;换成与 generator 分布相近的参考图后改善。用于对照的生成图明确未进入训练集。
06 · REVIEWER

审稿视角与研究延伸

论文提出清晰有效的系统组合,但证据规模和复现信息限制了结论强度。以下将论文验证、作者解释与研究设想分开。

Strengths

表示选择经济

512 维 latent 将十通道高分辨率扩散压缩为向量去噪;PhotoMat 提供真实感先验;CLIP tokens 提供跨光照视觉语义。

Strengths

训练配对闭环清楚

从同一 \(z\) 解码 \(x\),再随机照明渲染 \(c\),生成一致配对,免除真实 SVBRDF 标注需求。

Strengths

失败边界被展示

Figure 8 暴露 generator support 限制;正文承认 GAN mode collapse、无文本条件与 planar input 范围。

Weakness

FID 样本有限

Table 1 只基于 20 个合成材质,缺少生成样本数、重复次数与方差。小样本 FID 偏差使统计可靠性不足。

Weakness

Baseline 公平性有限

Conditional PhotoMat 只有定性图;TileGen 没有质量匹配、超参数扫描、训练成本或统一 metric。30 张真实照片也没有量化结果。

Weakness

无代码与配置缺口

官方项目页没有模型代码。noise schedule、网络宽度、光照采样分布和训练集规模缺失;26M steps 口径不清。

Research Extension

材质专用 autoencoder

学习保持 tileability、频谱与 BRDF 语义的十通道空间 latent,扩大生成支持集并保留局部结构。

Research Extension

多条件与非平面输入

引入法线、深度、mask、多视图或几何 proxy,在随机 3D 表面上渲染训练条件。

Research Extension

执行感知 test-time search

对少量 latent 候选进行多光照、多视角真实渲染,以 perceptual 与物理一致性重排,并增加 latent OOD detector。

论文结论的有效范围论文验证了在作者的 50 材料评价集与给定 baseline 设置中,cross-attention latent diffusion 能生成视觉匹配的 SVBRDF,并在相同 GPU 计时中明显快于 500 步 TileGen。论文没有验证物理参数恢复准确性、跨数据集泛化、文本控制、非平面输入或公开代码复现。
07 · SOURCES

身份与证据来源

页面事实以正式期刊 PDF 为主,并用 Keio 官方项目页核对标题与 DOI。期刊卷期为 2024 年 3 月,文章于 2024 年 1 月 4 日 online available。

  1. Liang Yuan, Dingkun Yan, Suguru Saito, Issei Fujishiro. “DiffMat: Latent diffusion models for image-guided material generation.” Visual Informatics 8(1), 6–14, 2024. DOI.
  2. Keio University Fujishiro Lab. DiffMat official project page. 核查时未发现模型代码链接。
  3. Zhou et al. “PhotoMat: A Material Generator Learned from Single Flash Photos.” SIGGRAPH 2023. DiffMat 使用其 generator 作为 latent prior 与 SVBRDF decoder。
  4. Lu et al. “DPM-Solver++: Fast Solver for Guided Sampling of Diffusion Probabilistic Models.” 2023.