一个模型覆盖多种时间缺失模式
视频的未来具有多解性,确定性预测容易把不同未来平均成模糊画面;GAN 与 VAE 能表达随机性,却往往针对固定任务训练。RaMViD 的研究问题是:能否把图像扩散模型扩展到视频,并以一种不增加额外条件分支的训练方式,让同一网络处理预测、插补和补全?
现有条件方式的负担
常见条件扩散把条件帧经额外网络处理,或在通道维度拼接。无条件模型配合 RePaint 式反复去噪与再加噪也能强制协调,但视频维度使多次重采样代价很高,条件帧稀少时尤为明显。
论文的核心直觉
把干净条件帧直接放回视频原位置,网络可以从“干净/有噪”的差异识别条件。随机采样条件位置后,训练分布覆盖不同缺失模式;推理时只需固定任意条件集合 \(\mathcal C\)。
已知帧保持干净,未知帧承担扩散过程
视频与索引集合
视频 \(\mathbf x_0\in\mathbb R^{L\times W\times H\times C}\)。条件帧索引为 \(\mathcal C\),未知帧索引为 \(\mathcal U\),两者互斥且并集为 \(\{0,\ldots,L-1\}\)。条件帧数 \(k=|\mathcal C|\)。
模型输入与输出
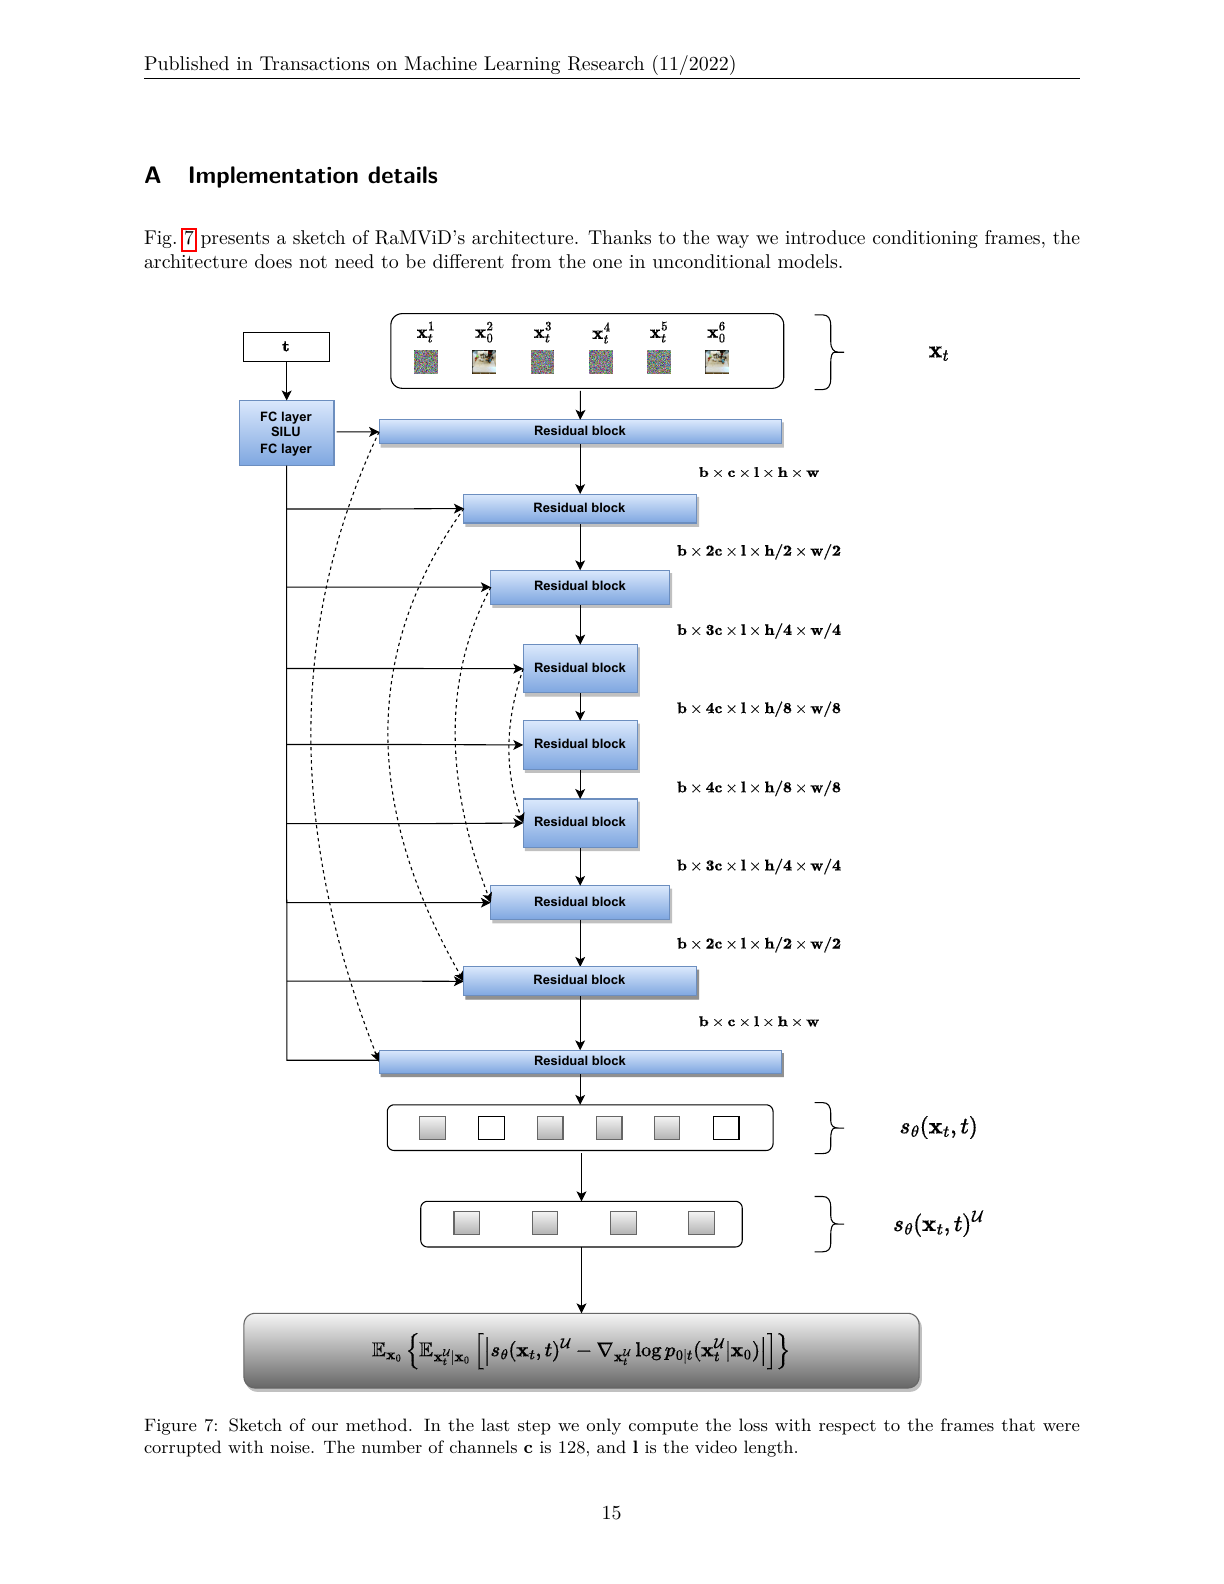
输入 \(\mathbf x_t\) 在 \(\mathcal C\) 位置保留原始帧 \(\mathbf x_0^{\mathcal C}\),在 \(\mathcal U\) 位置放入加噪帧 \(\mathbf x_t^{\mathcal U}\)。网络输出与整段视频同形的噪声或 score 预测,损失只读取 \(\mathcal U\) 位置。
训练条件
以概率 \(p_U\) 设置 \(\mathcal C=\varnothing\),形成无条件样本;其他时候先从 \(\{1,\ldots,K\}\) 均匀采样 \(k\),再均匀抽取 \(k\) 个帧索引。
推理条件
用户指定任意 \(\mathcal C\):前缀条件得到 prediction,首尾条件得到 infilling,均匀稀疏条件得到 completion/时间上采样,空集得到 unconditional generation。
运算 \(\oplus\) 按索引把两组帧放回原时间位置。它不是通道拼接,视频长度和网络输入通道数均保持不变。


随机掩码改变 score matching 的作用域
论文先用连续时间 SDE 解释 score-based diffusion,再在实现中采用离散的 1000 步 DDPM。方法的关键差异集中在噪声支持集与损失支持集:条件帧既不加噪,也不进入误差平均。
前向过程把数据逐步变为简单噪声分布。\(f\) 是 drift,\(g\) 是 diffusion coefficient,\(w\) 是 Brownian motion。上式的高斯条件分布对应论文举例的 variance-exploding 过程:\(f=0\),\(g(t)=\sqrt{\mathrm{d}\sigma^2(t)/\mathrm{d}t}\);一般 drift 下不能直接使用这个均值不变的表达式。本文的推导随后只对未知子张量 \(\mathbf x_t^{\mathcal U}\) 应用该过程。
标准 denoising score matching 让 \(s_\theta\) 学习加噪样本的条件 score。RaMViD 把网络输入替换为干净与加噪帧的交织序列,并把预测与 target 都限制到未知位置。
这条目标函数计算未知帧上的误差。条件帧仍进入 3D U-Net 的卷积和 attention,因此能影响未知帧预测;它们没有直接的 denoising target。
逆过程的 score 条件于干净帧 \(\mathbf x_0^{\mathcal C}\)。实现层面,每个 reverse step 开始前都把条件位置覆盖为原始干净帧,再计算一次去噪更新。


Improved DDPM U-Net 改为 3D 卷积
空间与时间
所有卷积使用 \(3\times3\times3\) kernel。encoder 经过三次下采样把空间分辨率 \(64\to32\to16\to8\),论文明确不压缩时间维度。官方代码在 scale_time_dim=0 时使用 stride \((1,2,2)\)。
通道与 attention
首层 128 channels,64 分辨率的 channel multiplier 为 \((1,2,3,4)\),因此各级为 128、256、384、512。16 与 8 分辨率插入 4-head self-attention。
ResNet blocks
BAIR 每个分辨率 2 个 block,约 235M 参数;Kinetics-600 与 UCF-101 每级 3 个 block,约 308M 参数。模型保留 diffusion timestep embedding,论文所说“不编码时间维度”指视频帧轴不做 positional encoding/压缩。
输出与方差
论文采用 score-based “simple” objective。固定提交的默认 learn_sigma=False,输出 3 channels 并使用 FIXED_LARGE variance;README 命令没有覆盖该选项。
三套数据,共享同一训练机制
| 数据集 | 训练视频 | 序列/任务 | Batch / micro-batch | 迭代与算力 | 采样步数 |
|---|---|---|---|---|---|
| BAIR robot pushing | 64 × 64;随机长度 20 子序列 | 给 1 帧预测 15;首尾插补 14 | 32 / 16 | 250k;8 × A100 40GB;约 3 天 | 750;附录另测 250/500 |
| Kinetics-600 | 约 500k 个 10 秒片段;resize + center crop 64 × 64;长度 16 | 5→11 prediction;\(\{0,1,14,15\}\) 与 \(\{0,5,10,15\}\) completion | 64 / 16 | 500k;8 × A100 40GB;附录约 10 天 | 500 |
| UCF-101 | 13,320 视频;160 × 120 resize + center crop 64 × 64;长度 16 | unconditional generation | 64 / 16 | 450k;8 × A100 40GB;约 9 天 | 500 |
统一超参数
learning rate \(2\times10^{-5}\),线性 noise schedule,\(T=1000\),uniform timestep sampler,EMA rate \(0.9999\)。论文没有报告 optimizer 名称、weight decay、warmup 或 scheduler;官方代码默认 AdamW、weight decay 0、无 LR annealing。
随机掩码分布
\(b\sim\mathrm{Bernoulli}(p_U)\)。若 \(b=1\),\(\mathcal C=\varnothing\);其余样本均匀选择 \(k\in\{1,\ldots,K\}\),再不放回抽取帧索引。BAIR 扫描 \(p_U\in\{0,0.25,0.5,0.75\}\) 与 \(K\in\{2,4,8\}\)。
条件采样
未知位置从 Gaussian noise 开始。每个 DDPM reverse step 前,把 \(\mathcal C\) 位置覆盖为 \(\mathbf x_0^{\mathcal C}\);默认 resample_steps=1,因此主实验没有额外 forward-backward harmonization loop。
EMA 与 respacing
从 EMA checkpoint 采样。代码通过 timestep_respacing 从 1000 个训练步选择较少的采样时刻;附录显示少于 500 步会显著损害 FVD。
全部五张主表
Table 1 · BAIR prediction:给定一帧预测十五帧
| Method | FVD ↓ | Parameters |
|---|---|---|
| Latent Video Transformer | 125.8 | — |
| SAVP | 116.4 | — |
| DVD-GAN-FP | 109.8 | — |
| TrIVD-GAN-FP | 103.3 | — |
| VideoGPT | 103.3 | 40M |
| Video Transformer | 94.0 | 373M |
| FitVid | 93.6 | 302M |
| MCVD | 89.5 | 251.2M |
| NÜWA | 86.9 | — |
| RaMViD \(p_U=0,K=4\) | 86.41 | 235M |
| RaMViD \(p_U=0.25,K=4\) | 85.3 ± 1.8 | 235M |
| RaMViD \(p_U=0.5,K=4\) | 85.03 | 235M |
| RaMViD \(p_U=0.75,K=4\) | 86.05 | 235M |
| RaMViD \(p_U=0.25,K=2\) | 87.39 | 235M |
| RaMViD \(p_U=0.25,K=8\) | 82.64 | 235M |
| RaMViD \(p_U=0.25\), fixed | 89.01 | 235M |
baseline 数字来自 FitVid 作者提供的统一评估流程;表内只有 \(p_U=0.25,K=4\) 报告多次运行误差条。其余 RaMViD 行为单次结果,差值不应被解释为稳定显著性。
Table 2 · BAIR infilling:条件帧 \(\mathcal C=\{0,15\}\)
| Method | FVD ↓ |
|---|---|
| RaMViD \(p_U=0,K=4\) | 85.68 |
| RaMViD \(p_U=0.25,K=4\) | 85.02 |
| RaMViD \(p_U=0.5,K=4\) | 87.04 |
| RaMViD \(p_U=0.75,K=4\) | 87.85 |
| RaMViD \(p_U=0.25,K=2\) | 83.83 |
| RaMViD \(p_U=0.25,K=8\) | 87.11 |
| RaMViD \(p_U=0.25\), fixed | 119.76 |
固定 prediction mask 的任务专用模型在 infilling 上明显失效;随机位置训练带来的跨任务泛化是这张表最直接的证据。


Table 3 · Kinetics-600 prediction:给定五帧预测十一帧
| Method | FVD ↓ | Parameters |
|---|---|---|
| Video Transformer | 170 ± 5 | 373M |
| DVD-GAN-FP | 69 ± 1 | — |
| CCVS | 55 ± 1 | 366M |
| TrIVD-GAN-FP | 26 ± 1 | — |
| RaMViD \(p_U=0\) | 18.69 | 308M |
| RaMViD \(p_U=0.25\) | 17.53 ± 1.07 | 308M |
| RaMViD \(p_U=0.5\) | 17.61 | 308M |
| RaMViD \(p_U=0.75\) | 27.64 | 308M |
\(p_U=0.25\) 将 FVD 从最佳外部 baseline 的 26 降至 17.53;当 \(p_U\) 提升到 0.75 时,conditional prediction 下降到 27.64。作者把这个 tipping point 归因于复杂数据上 conditional 与 unconditional distribution 差异更大,这属于解释性推测。
Table 4 · Kinetics-600 两种 completion mask
| Method | \(\mathcal C=\{0,1,14,15\}\) FVD ↓ | \(\mathcal C=\{0,5,10,15\}\) FVD ↓ |
|---|---|---|
| RaMViD \(p_U=0\) | 10.68 | 6.28 |
| RaMViD \(p_U=0.25\) | 10.85 | 4.91 |
| RaMViD \(p_U=0.5\) | 10.86 | 5.90 |
| RaMViD \(p_U=0.75\) | 17.33 | 7.29 |
均匀条件帧的 FVD 明显更低,因为每段缺口更短。这个任务可以解释为 temporal upsampling,但论文没有训练高 FPS 专用模型或报告真实 FPS 上采样指标。


Table 5 · UCF-101 unconditional generation
| Method | IS ↑ | Parameters | Resolution |
|---|---|---|---|
| VGAN | 8.31 ± 0.09 | — | 64 × 64 |
| MoCoGAN | 12.42 ± 0.03 | 3.3M | 64 × 64 |
| TGAN-F | 13.62 ± 0.06 | 17.5M | 64 × 64 |
| progressive VGAN | 14.56 ± 0.05 | — | 64 × 64 |
| TGAN-F | 22.91 ± 0.19 | 70M | 128 × 128 |
| VideoGPT | 24.69 ± 0.3 | 200M | 128 × 128 |
| TGANv2 | 26.60 ± 0.47 | 200M | 64 × 64 |
| DVD-GAN | 32.97 ± 1.7 | — | 128 × 128 |
| RaMViD \(p_U=0.5\) | 20.84 ± 0.08 | 308M | 64 × 64 |
| RaMViD \(p_U=0.75\) | 21.71 ± 0.21 | 308M | 64 × 64 |
RaMViD 在无条件生成上属于 competitive result,并未达到最佳。TGAN-F、VideoGPT 与 DVD-GAN 的 128 × 128 训练分辨率对用 112 × 112 输入计算的 IS 有一定优势;TGANv2 同为 64 × 64,仍高于 RaMViD。


掩码分布同时控制通用性与任务精度
\(p_U\) 消融
BAIR 上 \(p_U\) 从 0 到 0.75 的 prediction FVD 差异较小;Kinetics 上 0.25/0.5 最佳,0.75 明显下降。更高无条件比例帮助无条件生成,也减少模型看到带条件样本的频率。
\(K\) 消融
BAIR prediction 的最佳行是 \(K=8\),infilling 的最佳行是 \(K=2\)。单个 \(K\) 没有在所有任务占优,支持作者关于 task-dependent mask schedule 的后续方向。
随机位置与 fixed mask
fixed prediction model 的 BAIR prediction FVD 89.01,略差于随机 mask 多数设置;infilling FVD 119.76,显著差于随机 mask。证据表明随机位置扩大任务覆盖范围。
缺少的消融
论文没有独立比较 2D 与 3D convolution、是否使用 attention、cosine 与 linear schedule 的完整数值,也没有把“只对未知帧计算 loss”与“全帧 loss”量化比较。
| 数据集 | 评价样本 | 重复 | 指标实现 |
|---|---|---|---|
| BAIR | 256 个 test videos;每个视频预测一条序列 | 整个流程 100 次,FVD 取平均 | I3D Kinetics-400 latent statistics |
| Kinetics-600 | test set 取 50,000 视频,每个预测一条序列 | 仅 \(p_U=0.25\) 行报告误差条 | 预测与 ground truth 的 FVD |
| UCF-101 | 无条件采样 10,000 视频 | 重复 3 次 | TGANv2 public video IS implementation |
速度、长视频与失败案例
采样步数与计算成本
| 数据/模型 | 250 steps | 500 steps | 750 steps | 10,000 videos 时间 |
|---|---|---|---|---|
| BAIR \(p_U=0.25\) | FVD 101.54 | FVD 85.07 | FVD 84.20 | 500 steps 约 7 小时 |
| Kinetics-600 | FVD 49 | FVD 16 | FVD 14 | 500 steps 约 9 小时 |
| UCF-101 | 未报告 | 主实验使用 | 未报告 | 500 steps 约 9 小时 |
附录因此建议 DDPM sampler 至少使用 500 steps。论文没有报告 DDIM、DPM-Solver 或蒸馏采样的结果。


快速物体运动
背景能保持,快速运动主体会拉伸、融化或变形。3D convolution 与全序列去噪仍未显式建模 optical flow 或刚体/人体结构。
快速相机运动
首尾构图差异过大时,模型可能让主体在开头消失、末尾重新出现,形成外观插值,无法恢复合理 camera trajectory。
UCF 过拟合
每类动作约 25 个不同 setting,生成视频常与训练样本很相近。论文没有报告 nearest-neighbor distance 或 memorization audit。
分辨率限制
所有实验均为 64 × 64。作者明确把 super-resolution module 列为未来方向,本文没有实现空间超分模块。


官方代码固定提交审计
官方仓库 Tobi-r9/RaMViD 固定核查提交 d04802577e0afe4964a86029791a700f22881892(2023-11-11)。仓库基于 OpenAI Improved Diffusion,并公开训练、采样和长视频脚本。
| 项目 | 论文描述 | 固定提交行为 | 判断 |
|---|---|---|---|
| Mask sampling | \(p_U\) 选空集;否则 \(k\sim U\{1,\ldots,K\}\) | 每个 batch item 调用 Bernoulli、randint(1,K) 与 random.sample | 一致 |
| 干净条件帧 | 条件帧不加噪 | noise 乘 mask;\(\mathbf x_t\) 在 mask=0 位置替换为 \(\mathbf x_0\) | 一致 |
| Masked loss | 只在 \(\mathcal U\) 上计算 | MSE 乘 mask,再按有效元素归一 | 一致 |
| Sampling condition | reverse diffusion 条件于 clean frames | 每个 reverse step 前执行 img[:,:,cond_frames] = cond_img | 一致 |
| Video convolution | \(3\times3\times3\),仅空间降采样 | Conv3d;scale_time_dim=0 产生 stride \((1,2,2)\) | 一致 |
| Variance | 正文没有说明是否 learned variance | 默认 learn_sigma=False,使用 FIXED_LARGE | 需要复现者明确记录 |
| Optimizer | 正文未报告 | 训练循环使用 AdamW;默认 weight decay 0 | 代码补充信息 |
| README batch | 全局 batch 32/64 | README 分布式示例为每 rank 4/8,并要求按 rank 数手动除 | 8 GPU 时一致 |
| Micro-batch | 正文 Section 4.1 写 size 2;Appendix D 写 16 | README 每 rank microbatch=2;全局表述可对应 16 | 两个文档口径可由 per-rank/global 解释 |
| 短视频填充 | 训练随机子序列 | MP4 loader 对不足 \(L\) 的视频补零;GIF loader 没有同样补零 | 未在论文说明的格式差异 |
| 随机种子 | 未报告 | 训练脚本的 seed 设置被注释;采样 seed=0 时不会进入 seed 分支 | 复现随机性未固定 |
复现需要固定的执行协议
数据
- BAIR 原始 64 × 64 数据与 256 test videos
- Kinetics public downloader 的具体 snapshot 与失效视频清单
- UCF-101 全量 13,320 视频
- 随机连续子序列选择和 center crop
模型
- 128 base channels,multiplier 1/2/3/4
- BAIR 2 blocks,其余 3 blocks
- attention resolutions 16/8,4 heads
- 3D convolution,时间 stride 固定为 1
优化
- linear beta schedule,1000 training steps
- LR \(2\times10^{-5}\),EMA 0.9999
- global batch 与 per-rank micro-batch 分开记录
- 明确 learn_sigma=False 与 AdamW 默认值
评估
- 至少 500 DDPM sampling steps
- BAIR 100 次 FVD 重复
- Kinetics 50,000 test predictions
- UCF 10,000 samples × 3 次 IS
论文没有公开的关键值
精确 beta 起止值可从 Improved Diffusion linear schedule 与代码得到;论文正文没有逐项写出。正文也没有报告训练 random seed、数据 loader worker nondeterminism、checkpoint selection rule、gradient clipping 是否触发、mixed precision、optimizer 名称、weight decay、所有模型的完整命令、baseline checkpoint 与统一评估代码。严格复现报告应把这些作为实现选择单列。
条件机制简洁,实验结论有清楚边界
Strengths
- 条件帧直接占据原时间位置,架构改动很少。
- 随机 mask 给 prediction、infilling、completion 提供统一训练目标。
- BAIR 与 Kinetics 的主表包含强 baseline 和参数量。
- 附录公开算力、数据协议、采样速度与失败案例。
- 官方代码直接实现了论文最关键的 noise mask 与 loss mask。
Weaknesses
- 全部实验停留在 64 × 64,细节质量的上限很低。
- 500–750 步 DDPM 采样成本高,10,000 视频需要 7–9 小时。
- 快速运动、快速镜头与长时自回归误差仍明显。
- 多数消融只有单次结果,误差条与统计显著性不足。
- 掩码训练的贡献没有和 2D/3D、schedule、attention 分别量化。
- UCF 有 memorization 迹象,缺少正式最近邻审计。
Potential improvements
使用 latent video diffusion 降低空间计算量;加入 motion-aware representation、optical flow 或 trajectory token 处理快速运动;训练分层 temporal model 解决 30 帧后的误差积累;用 consistency model 或现代 solver 减少采样步数;学习 task-conditioned mask curriculum;让条件帧带显式 binary mask channel,消除“靠噪声强度猜条件”的歧义;报告 perceptual、motion、identity 与 memorization 指标。
一手资料
- arXiv record · 2206.07696v3:作者、版本历史、TMLR 发表说明、摘要与 PDF。
- arXiv HTML full text:主文公式、Algorithm 1、Tables 1–5、Appendix A–G 与 Figures 1–15 图注;与本地 22 页 PDF 逐项交叉核对。
- OpenReview · TMLR review forum:正式评审入口。自动页面访问受验证页限制,本页没有引用未读取的评审正文。
- Official project page:三项任务设置、训练时长说明与高分辨率动态示例。
- Official code · fixed commit d048025:README、3D U-Net、随机 mask loss、sampling condition 与数据 loader 的实现审计。
- OpenAI Improved Diffusion:RaMViD 官方代码声明的基础实现。
- Official FVD implementation reference:论文采用的 FVD 实现入口。
- TGANv2 repository:论文用于 video Inception Score 的公开实现入口。
论文身份:Tobias Höppe 为唯一第一作者,第一机构为 KTH Stockholm。作者列表中的星号脚注表示 Equal advising,没有标记共同第一作者或通讯作者。Andrea Dittadi 仅按 vault 规则保留为未核实的末位通讯候选。页面中的 Figure 1–6、8–15 使用本地 PDF 原始嵌入图像;Figure 7 使用原论文附录整页。