正式书目
IEEE TPAMI
2023 年第 45 卷第 9 期,10850–10869 页。正式标题是 Diffusion Models in Vision: A Survey。
一份面向推导、实现与证据边界的深度精读:把 DDPM、NCSN 与连续时间 SDE 放进同一坐标系,重建综述收录的全部方法分类,并解释这篇 2023 年历史综述能够证明什么。
本页完整精读本地归档的 25 页 arXiv v5。arXiv 当前版本为 v6;逐行比较 v5 与 v6 的 25 页文本和 TeX 后,变化集中在排版、符号间距及少量语句修订,分类表和讨论范围没有扩充到 2025 年方法。
2023 年第 45 卷第 9 期,10850–10869 页。正式标题是 Diffusion Models in Vision: A Survey。
PDF 脚注明确 Florinel-Alin Croitoru 与 Vlad Hondru 贡献相同;Radu Tudor Ionescu 由星号及邮箱明确标记为通讯作者。
综述主体覆盖到 2022 年左右的工作。Stable Diffusion 等样例反映当时前沿,不能代替今天的扩散模型全景。
扩散模型在图像生成上同时展现高质量与高多样性,但理论入口分散在离散概率模型、score matching 和随机微分方程三套术语里;视觉应用也已从无条件生成扩展到编辑、反问题、医学和视频。
DDPM 预测噪声,NCSN 估计对数密度梯度,SDE 用连续时间随机过程统一前两者。若只记网络结构或采样公式,很难理解它们为何相通。
作者以任务、denoising condition、architecture、dataset 四列整理文献,帮助读者辨认“扩散模型”这个大类中实际解决的问题和所依赖的信息。
离散前向 Markov 过程:
\[p(x_t\mid x_{t-1})=\mathcal{N}\!\left(x_t;\sqrt{1-\beta_t}\,x_{t-1},\beta_t\mathbf{I}\right).\]从 \(x_0\) 一步采样任意时刻:
\[x_t=\sqrt{\widehat{\beta}_t}\,x_0+\sqrt{1-\widehat{\beta}_t}\,z_t,\qquad z_t\sim\mathcal{N}(0,\mathbf{I}).\]输入是干净训练图像与随机时间步;训练目标通常是恢复该步噪声或 score。推理输入是高斯噪声与可选条件,输出通过多步逆过程成为图像。条件可以是类别、文本、图像、mask、测量值、帧或 latent representation。
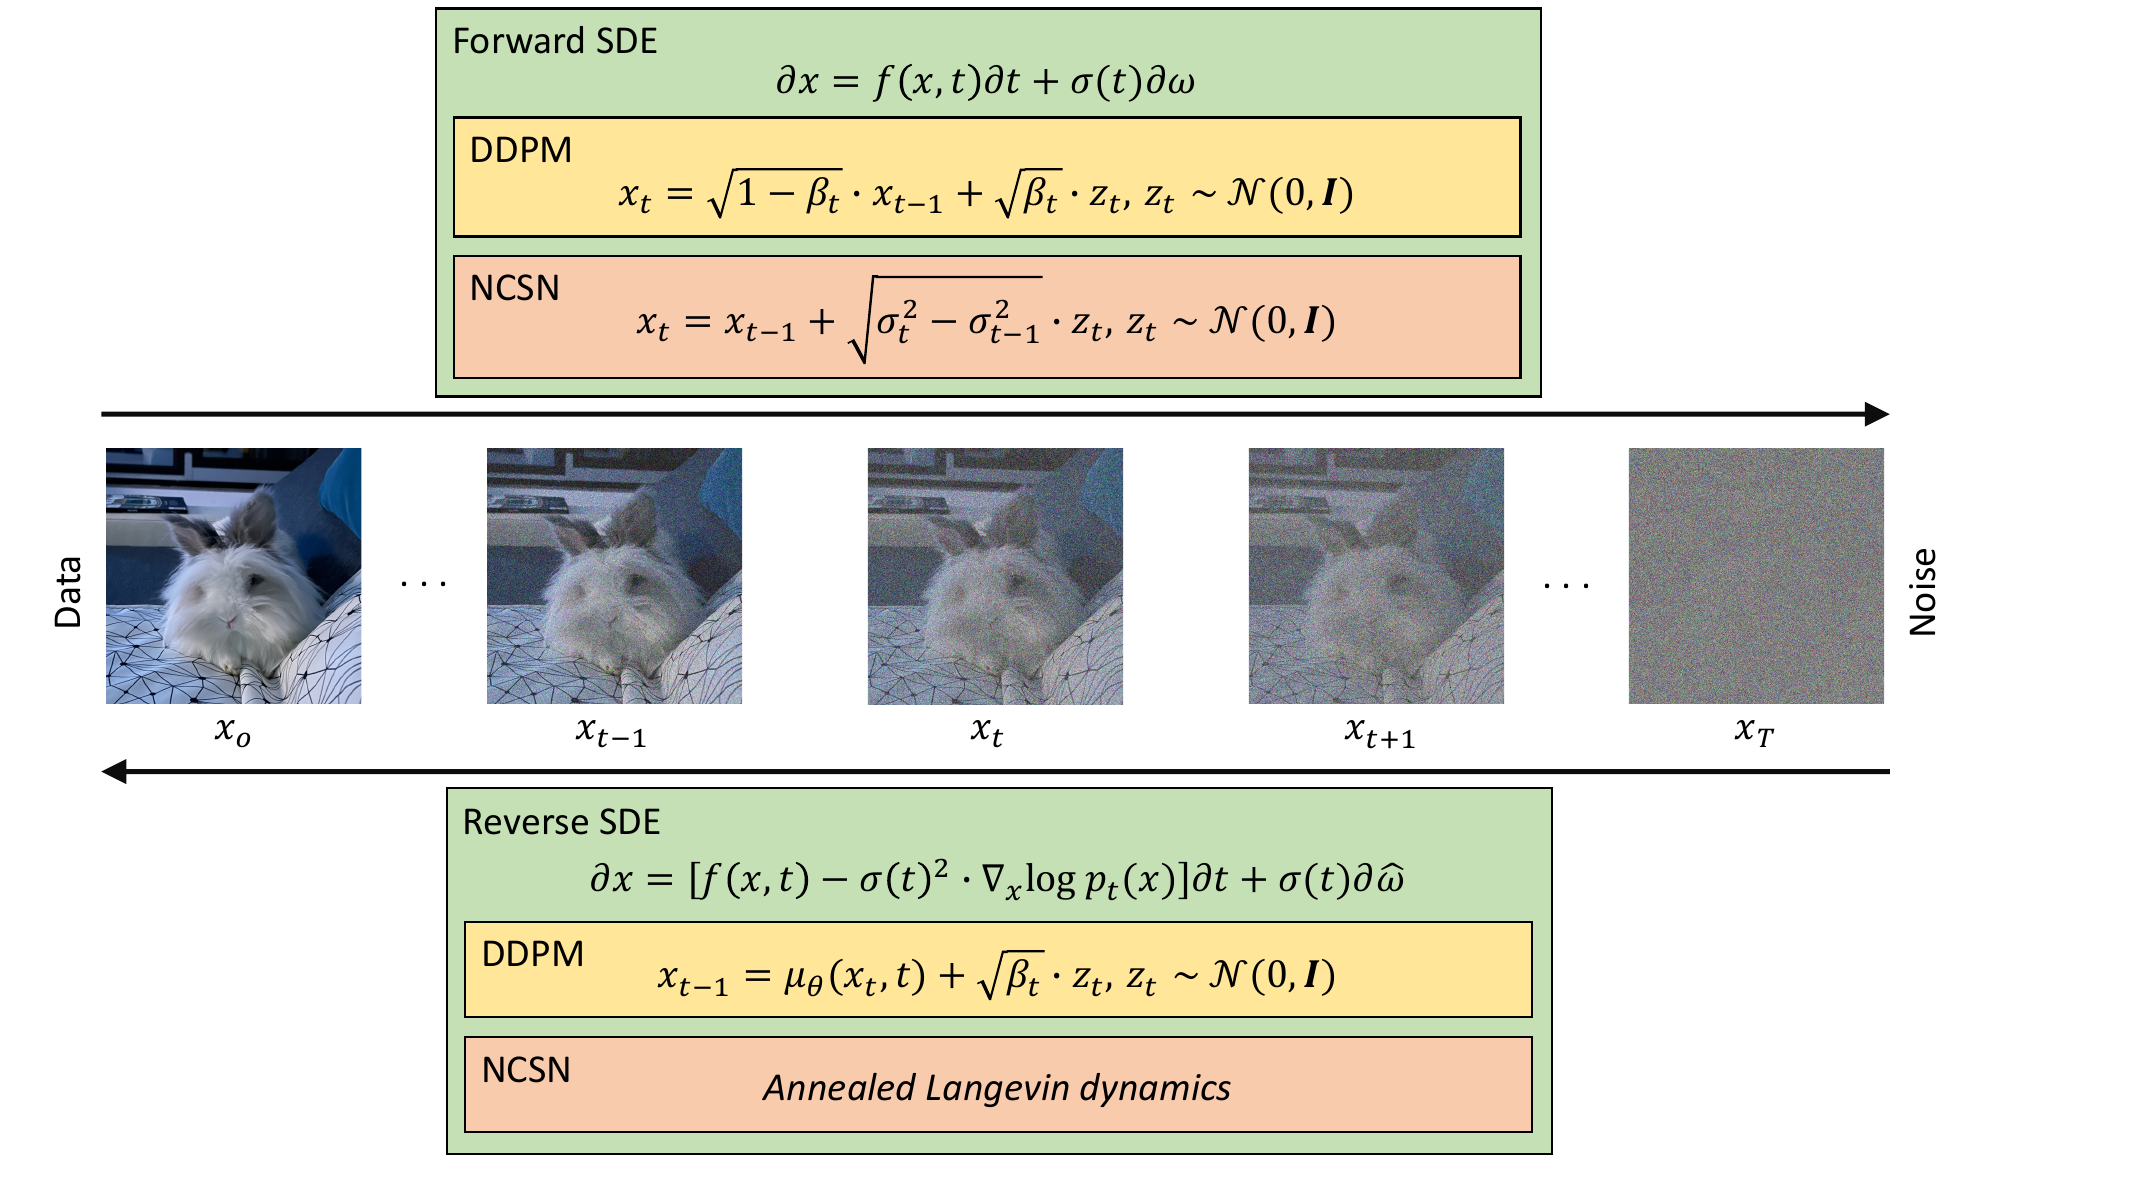
当每个 \(\beta_t\) 很小且 \(\widehat{\beta}_T\rightarrow0\) 时,末态接近高斯,逆转移也可用高斯建模。网络接收 \(x_t\) 和时间嵌入,原始形式预测均值与协方差;Ho 等固定协方差并改为预测噪声。
上式的 ELBO 分解省略了外层记号;严格训练目标还要对 \(x_0\sim p_{\mathrm{data}}(x_0)\) 以及完整前向轨迹 \(x_{1:T}\sim q(x_{1:T}\mid x_0)\) 取期望。第一项是该期望下的重建负对数似然,末态 KL 让前向终点匹配先验,中间 KL 让学习到的逆转移接近已知前向 posterior。简化损失舍弃时间相关权重,使每个采样到的时间步直接做噪声回归。
score \(\nabla_x\log p(x)\) 指向高密度方向。原始 score matching 需要未知真 score;denoising score matching 先用已知高斯扰动构造条件 score,再训练单个网络覆盖一组噪声尺度。
推理采用 annealed Langevin dynamics:从最大噪声尺度开始,在每一尺度执行 \(N\) 次带随机扰动的 score 更新,再把结果传给下一尺度。噪声项帮助离开局部区域,逐级退火让采样从平滑密度走向数据流形。
前向过程由 drift 逐渐消除信号,diffusion term 注入布朗噪声;逆时间 SDE 的额外项由 score 决定。因此,只要学到所有时间的 score,就能用数值 SDE solver 从噪声积分回数据。
Algorithm 3 从 \(t=T\) 走向 \(0\),所以离散时间增量 \(\Delta t\lt0\)。Euler–Maruyama 的 reverse update 必须对布朗增量使用 \(\sqrt{\lvert\Delta t\rvert}\,z\),不能把负时间步直接放进平方根:
离散 DDPM 可对应 variance-preserving SDE,NCSN 的噪声扰动可对应 variance-exploding SDE。论文还指出 reverse SDE 有对应的 probability flow ODE:
ODE 与 SDE 共享相同的边缘分布,提供确定性采样、可逆映射和通过瞬时变量替换计算 likelihood 的入口。该公式是统一视角的重要延伸;数值误差和网络 score 误差仍决定实际结果。
附录把 DDPM 训练的关键化简完整串联起来。理解这段推导可以避免把 “预测噪声” 当作经验技巧。
| 模型族 | 共同点 | 关键差异与联系 |
|---|---|---|
| VAE | 都有 latent variables,并通过变分下界处理不可解的边缘似然。 | DDPM 的 latent 是一整条固定前向噪声轨迹;encoder 不需要学习。逆过程可视为层数很深且参数共享的 hierarchical VAE。 |
| GAN | 都能从简单先验生成高维图像。 | GAN 以 adversarial game 训练并一次前向生成;扩散训练更稳定、mode coverage 通常更好,推理需要多步。综述引用当时结果说明扩散已在部分图像生成指标超越 GAN,未进行统一重测。 |
| Energy-based model | score 是能量梯度的相反数:若 \(p(x)\propto e^{-E(x)}\),则 \(\nabla_x\log p(x)=-\nabla_xE(x)\)。 | NCSN 直接学习不同噪声尺度的 score,绕开归一化常数;Langevin dynamics 用该向量场采样。 |
| Autoregressive | 都可建模复杂分布,并可给出 likelihood 相关目标。 | autoregressive 依照固定变量顺序生成,带来单向偏置;扩散同时更新整幅样本。离散扩散与 autoregressive transition 也可以组合。 |
| Normalizing flow | 都连接简单先验与数据,并存在可逆连续动力学视角。 | flow 要求可逆变换与 Jacobian;probability flow ODE 提供确定性连续映射,但需要 score 和 ODE 积分。 |
综述正文把 Ho 等的网络概括为 PixelCNN++,但原始 DDPM 明确采用 U-Net 形状的 backbone,并以 Wide ResNet blocks、group normalization、self-attention 与 sinusoidal time embedding 构成。后续方法也采用 Transformer、VAE、GAN generator、NCSN++ 等架构,不能统一写成一种 U-Net。
引用 Ho 等的设置:\(T=1000\),\(\beta_t\) 从 \(10^{-4}\) 线性增加到 \(2\times10^{-2}\)。这属于原始 DDPM 示例,不能外推到表中所有方法。
DDPM 逐步祖先采样,NCSN 每一噪声尺度执行多次 Langevin 更新,SDE 依赖 Euler-Maruyama 或 predictor-corrector 等数值 solver。
类别、文本、图像、mask、测量或 frame 可进入 denoiser。classifier guidance 使用外部分类器梯度;classifier-free guidance 在同一模型中混合有条件和无条件 score。
综述覆盖 learned variance、DDIM、PNDM、知识蒸馏、bilateral schedule、latent diffusion 等方向。每种方法的步数和质量衡量协议不同。
论文没有统一 optimizer、learning rate、batch size、epoch、GPU 或训练时长,也没有公开统一代码。复现具体方法必须回到 Table 1 对应原论文。
综述将采样成本视为主线问题。下面把正文提到的主要方案放在同一参照系中:它们分别改变方差、轨迹、数值积分、训练目标或表示空间。
Improved DDPM 让网络同时预测噪声和插值系数 \(v\),在前向 posterior variance \(\widetilde{\beta}_t\) 与 \(\beta_t\) 之间插值:
均值继续依赖噪声预测,变分项为方差提供学习信号。论文综述转述其可将采样降到约 50 步;该数字属于 Nichol 与 Dhariwal 的具体模型和协议。
DDIM 构造与 DDPM 具有相同训练边缘分布的非 Markov 过程,沿子序列采样。先由 \(x_t\) 估计干净样本:
当 \(\sigma_t=0\) 时,给定初始噪声后的轨迹是确定性的;增加 \(\sigma_t\) 恢复随机性。它复用已训练的噪声网络,速度来自跳过时间点。
PNDM 不重新训练 denoiser,先用 pseudo Runge–Kutta 建立高阶历史,再用 pseudo linear multi-step / Adams–Bashforth 组合最近的噪声预测。抽象地,更新可写为:
与 DDIM 主要改变概率轨迹不同,PNDM 主要改进离散数值方法,用历史斜率提高少步积分精度;SDE 工作还覆盖 Euler–Maruyama、predictor-corrector 和 ODE solver。
Progressive distillation 生成教师两步轨迹的终点,训练学生用一次去噪到达同一点,然后反复把步数减半。若教师映射为 \(F_{\theta}\),一轮目标可概括为:
速度来自把计算迁移到训练阶段;学生误差会随多轮蒸馏累积,需要质量与步数之间的重新校准。
autoencoder 先将图像编码为 \(z_0=\mathcal{E}(x)\),扩散模型在低维 \(z_t\) 上学习噪声,再由 \(\mathcal{D}(z_0)\) 解码。条件 \(c\) 通过 cross-attention 或拼接进入 denoiser:
它减少每一步的空间计算量,同时引入 autoencoder 重建误差与 latent bottleneck。综述还收录 discrete VAE / VQ 表示、D2C 与 latent score model,不能把所有 latent 方法视为同一个架构。
当分类器 \(p_{\phi}(y\mid x_t,t)\) 精确且校准良好时,Bayes rule 给出 \(s=1\) 的理想条件 score 恒等式:
实际 classifier guidance 引入 guidance scale \(s\),把学习到的 unconditional score \(s_{\theta}(x_t,t)\) 改成:
当 \(s\ne1\) 时,该向量场对应按 \(p_t(x_t)p_{\phi}(y\mid x_t,t)^s\) 重新加权的 tempered density,不能与真实条件 score 直接等同。更大的 \(s\) 通常提高条件一致性,同时可能降低多样性;外部分类器带来额外训练和推理成本。
同一网络在训练时随机丢弃条件,学到有条件与无条件预测;推理时对两者作线性外推:
\(c\) 可以是类别或文本,\(\varnothing\) 表示空条件,\(w\) 是 guidance scale。它省去单独分类器,但每一步通常需要两次网络预测。
| 方法 | 条件机制 | 结果与控制量 |
|---|---|---|
| Posterior / inverse guidance | 给定测量 \(y=\mathcal{A}(x)+n\),把 prior score 与 likelihood gradient 组合:\(\nabla_x\log p(x\mid y)=\nabla_x\log p(x)+\nabla_x\log p(y\mid x)\)。 | 算子 \(\mathcal{A}\)、噪声模型和梯度近似决定 data consistency;用于 MRI、deblurring、super-resolution 等。 |
| SDEdit | 把输入图像先扩散到中间时刻 \(t_0\),再从该状态执行 reverse SDE。 | \(t_0\) 控制保留输入结构与服从生成 prior 的强弱;条件通过起点进入。 |
| ILVR | 每一步用参考图像的当前噪声版本替换生成样本的低频分量。 | 低通算子决定保留的布局尺度,无需重新训练基础扩散模型。 |
| RePaint / masked editing | 已知区域从原图对应的前向噪声分布取样,未知区域由逆过程生成,并通过 forward/backward resampling 改善边界语义。 | mask 确定硬约束区域;重采样次数增加协调能力与计算量。 |
| Text / CLIP guidance | 文本编码通过 cross-attention、classifier-free prediction 或 CLIP 相似度梯度影响 denoising。 | 文本一致性、图像保真与多样性之间存在 guidance trade-off。 |
无条件图像生成、类别条件生成、text-to-image、few-shot generation,以及多条件控制。
image-to-image translation、super-resolution、editing、inpainting、restoration、registration 与 counterfactual explanation。
segmentation、classification、adversarial purification、MRI reconstruction、compressive sensing 等。
generation、translation、segmentation 与 anomaly detection;条件常来自图像或测量。
video generation / infilling、point cloud generation、shape generation 与 completion。
同一扩散体系覆盖生成、修复、转换或 latent editing,表明 denoising prior 可被不同观测约束复用。
下表重建原文连续三页的全部方法行与五列信息。它是一张文献分类表,颜色只服务于原论文的任务分组;本页用实时筛选替代颜色编码。
| 论文 | 任务 | 去噪条件 | 架构 | 数据集 |
|---|---|---|---|---|
| Austin [78] | image generation | unconditional | D3PM | CIFAR-10 |
| Bao [20] | image generation | unconditional | DDIM, Improved DDPM | CelebA, ImageNet, LSUN Bedroom, CIFAR-10 |
| Benny [79] | image generation | unconditional | DDPM, DDIM | CIFAR-10, ImageNet, CelebA |
| Bond-Taylor [80] | image generation | unconditional | DDPM | LSUN Bedroom, LSUN Church, FFHQ |
| Choi [81] | image generation | unconditional | DDPM | FFHQ, AFHQ-Dog, CUB, MetFaces |
| De [82] | image generation | unconditional | DSB | MNIST, CelebA |
| Deasy [83] | image generation | unconditional | NCSN | MNIST, Fashion-MNIST, CIFAR-10, CelebA |
| Deja [84] | image generation | unconditional | Improved DDPM | Fashion-MNIST, CIFAR-10, CelebA |
| Dockhorn [21] | image generation | unconditional | NCSN++, DDPM++ | CIFAR-10 |
| Ho [2] | image generation | unconditional | DDPM | CIFAR-10, CelebA-HQ, LSUN |
| Huang [59] | image generation | unconditional | DDPM | CIFAR-10, MNIST |
| Jing [30] | image generation | unconditional | NCSN++, DDPM++ | CIFAR-10, CelebA-256-HQ, LSUN Church |
| Jolicoeur [85] | image generation | unconditional | NCSN | CIFAR-10, LSUN Church, Stacked-MNIST |
| Jolicoeur [86] | image generation | unconditional | DDPM++, NCSN++ | CIFAR-10, LSUN Church, FFHQ |
| Kim [87] | image generation | unconditional | NCSN++, DDPM++ | CIFAR-10, CelebA, MNIST |
| Kingma [88] | image generation | unconditional | DDPM | CIFAR-10, ImageNet |
| Kong [89] | image generation | unconditional | DDIM, DDPM | LSUN Bedroom, CelebA, CIFAR-10 |
| Lam [90] | image generation | unconditional | BDDM | CIFAR-10, CelebA |
| Liu [91] | image generation | unconditional | PNDM | CIFAR-10, CelebA |
| Ma [92] | image generation | unconditional | NCSN, NCSN++ | CIFAR-10, CelebA, LSUN Bedroom, LSUN Church, FFHQ |
| Nachmani [93] | image generation | unconditional | DDIM, DDPM | CelebA, LSUN Church |
| Nichol [6] | image generation | unconditional | DDPM | CIFAR-10, ImageNet |
| Pandey [19] | image generation | unconditional | DDPM | CelebA-HQ, CIFAR-10 |
| San [94] | image generation | unconditional | DDPM | CelebA, LSUN Bedroom, LSUN Church |
| Sehwag [95] | image generation | unconditional | ADM | CIFAR-10, ImageNet |
| Sohl-Dickstein [1] | image generation | unconditional | DDPM | MNIST, CIFAR-10, Dead Leaf Images |
| Song [13] | image generation | unconditional | NCSN | FFHQ, CelebA, LSUN Bedroom, LSUN Tower, LSUN Church Outdoor |
| Song [15] | image generation | unconditional | DDPM++ | CIFAR-10, ImageNet 32\(\times\)32 |
| Song [7] | image generation | unconditional | DDIM | CIFAR-10, CelebA, LSUN |
| Vahdat [17] | image generation | unconditional | NCSN++ | CIFAR-10, CelebA-HQ, MNIST |
| Wang [96] | image generation | unconditional | DDIM | CIFAR-10, CelebA |
| Wang [97] | image generation | unconditional | StyleGAN2, ProjectedGAN | CIFAR-10, STL-10, LSUN Bedroom, LSUN Church, AFHQ, FFHQ |
| Watson [98] | image generation | unconditional | DDPM | CIFAR-10, ImageNet |
| Watson [8] | image generation | unconditional | Improved DDPM | CIFAR-10, ImageNet 64\(\times\)64 |
| Xiao [99] | image generation | unconditional | NCSN++ | CIFAR-10 |
| Zhang [71] | image generation | unconditional | DDPM | CIFAR-10, MNIST |
| Zheng [100] | image generation | unconditional | DDPM | CIFAR-10, CelebA, CelebA-HQ, LSUN Bedroom, LSUN Church |
| Bordes [101] | conditional image generation | conditioned on latent representations | Improved DDPM | ImageNet |
| Campbell [102] | conditional image generation | unconditional, conditioned on sound | DDPM | CIFAR-10, Lakh Pianoroll |
| Chao [103] | conditional image generation | conditioned on class | Score SDE, Improved DDPM | CIFAR-10, CIFAR-100 |
| Dhariwal [5] | conditional image generation | unconditional, classifier guidance | ADM | LSUN Bedroom, LSUN Horse, LSUN Cat |
| 论文 | 任务 | 去噪条件 | 架构 | 数据集 |
|---|---|---|---|---|
| Ho [104] | conditional image generation | conditioned on label | DDPM | LSUN, ImageNet |
| Ho [77] | conditional image generation | unconditional, classifier-free guidance | ADM | ImageNet 64\(\times\)64, ImageNet 128\(\times\)128 |
| Karras [105] | conditional image generation | unconditional, conditioned on class | DDPM++, NCSN++, DDPM, DDIM | CIFAR-10, ImageNet 64\(\times\)64 |
| Liu [106] | conditional image generation | conditioned on text, image, style guidance | DDPM | FFHQ, LSUN Cat, LSUN Horse, LSUN Bedroom |
| Liu [22] | conditional image generation | conditioned on text, 2D positions, relational descriptions between items, human facial attributes | Improved DDPM | CLEVR, Relational CLEVR, FFHQ |
| Lu [107] | conditional image generation | unconditional, conditioned on class | DDIM | CIFAR-10, CelebA, ImageNet, LSUN Bedroom |
| Salimans [108] | conditional image generation | unconditional, conditioned on class | DDIM | CIFAR-10, ImageNet, LSUN |
| Singh [109] | conditional image generation | conditioned on noise | DDIM | ImageNet |
| Sinha [16] | conditional image generation | unconditional, conditioned on label | D2C | CIFAR-10, CIFAR-100, fMoW, CelebA-64, CelebA-HQ-256, FFHQ-256 |
| Ho [34] | image-to-image translation | conditioned on image | Improved DDPM | ctest10k, places10k |
| Li [37] | image-to-image translation | conditioned on image | DDPM | Face2Comic, Edges2Shoes, Edges2Handbags |
| Sasaki [110] | image-to-image translation | conditioned on image | DDPM | CMP Facades, KAIST Multispectral Pedestrian |
| Wang [36] | image-to-image translation | conditioned on image | DDIM | ADE20K, COCO-Stuff, DIODE |
| Wolleb [38] | image-to-image translation | conditioned on image | Improved DDPM | BRATS |
| Zhao [35] | image-to-image translation | conditioned on image | DDPM | CelebaA-HQ, AFHQ |
| Gu [111] | text-to-image generation | conditioned on text | VQ-Diffusion | CUB-200, Oxford 102 Flowers, MS-COCO |
| Jiang [23] | text-to-image generation | conditioned on text | Transformer-based encoder-decoder | DeepFashion-MultiModal |
| Ramesh [112] | text-to-image generation | conditioned on text | ADM | MS-COCO, AVA |
| Rombach [11] | text-to-image generation | conditioned on text | LDM | OpenImages, WikiArt, LAION-2B-en, ArtBench |
| Saharia [12] | text-to-image generation | conditioned on text | Imagen | MS-COCO, DrawBench |
| Shi [9] | text-to-image generation | unconditional, conditioned on text | Improved DDPM | Conceptual Captions, MS-COCO |
| Zhang [113] | text-to-image generation | unconditional, conditioned on text | DDIM | CIFAR-10, CelebA, ImageNet |
| Daniels [25] | super-resolution | conditioned on image | NCSN | CIFAR-10, CelebA |
| Saharia [18] | super-resolution | conditioned on image | DDPM++ | FFHQ, CelebA-HQ, ImageNet-1K |
| Avrahami [114] | image editing | conditioned on image and mask | DDPM, ADM | ImageNet, CUB, LSUN Bedroom, MS-COCO |
| Avrahami [31] | region image editing | text guidance | DDPM | PaintByWord |
| Meng [33] | image editing | conditioned on image | Score SDE, DDPM, Improved DDPM | LSUN, CelebA-HQ |
| Lugmayr [29] | inpainting | unconditional | DDPM | CelebA-HQ, ImageNet |
| Nichol [14] | inpainting | conditioned on image, text guidance | ADM | MS-COCO |
| Amit [42] | image segmentation | conditioned on image | Improved DDPM | Cityscapes, Vaihingen, MoNuSeg |
| Baranchuk [39] | image segmentation | conditioned on image | Improved DDPM | LSUN, FFHQ-256, ADE-Bedroom-30, CelebA-19 |
| Batzolis [24] | multi-task (inpainting, super-resolution, edge-to-image) | conditioned on image | DDPM | CelebA, Edges2Shoes |
| Batzolis [115] | multi-task (image generation, super-resolution, inpainting, image-to-image translation) | unconditional | DDIM | ImageNet, CelebA-HQ, CelebA, Edges2Shoes |
| Blattmann [116] | multi-task (image generation) | unconditional, conditioned on text, class | LDM | ImageNet |
| Choi [32] | multi-task (image generation, image-to-image translation, image editing) | conditioned on image | DDPM | FFHQ, MetFaces |
| Chung [26] | multi-task (inpainting, super-resolution, MRI reconstruction) | conditioned on image | CCDF | FFHQ, AFHQ, fastMRI knee |
| Esser [28] | multi-task (image generation, inpainting) | unconditional, conditioned on class, image and text | ImageBART | ImageNet, Conceptual Captions, FFHQ, LSUN |
| Gao [117] | multi-task (image generation, inpainting) | unconditional, conditioned on image | DDPM | CIFAR-10, LSUN, CelebA |
| Graikos [40] | multi-task (image generation, image segmentation) | conditioned on class | DDIM | FFHQ-256, CelebA |
| 论文 | 任务 | 去噪条件 | 架构 | 数据集 |
|---|---|---|---|---|
| Hu [118] | multi-task (image generation, inpainting) | unconditional, conditioned on image | VQ-DDM | CelebA-HQ, LSUN Church |
| Khrulkov [119] | multi-task (image generation, image-to-image translation) | conditioned on class | Improved DDPM | AFHQ, FFHQ, MetFaces, ImageNet |
| Kim [120] | multi-task (image translation, multi-attribute transfer) | conditioned on image, portrait, stroke | DDIM | ImageNet, CelebA-HQ, AFHQ-Dog, LSUN Bedroom, Church |
| Luo [121] | multi-task (point cloud generation, auto-encoding, unsupervised representation learning) | conditioned on shape latent | DDPM | ShapeNet |
| Lyu [122] | multi-task (image generation, image editing) | unconditional, conditioned on class | DDPM | CIFAR-10, CelebA, ImageNet, LSUN Bedroom, LSUN Cat |
| Preechakul [123] | multi-task (latent interpolation, attribute manipulation) | conditioned on latent representation | DDIM | CelebA-HQ |
| Rombach [10] | multi-task (super-resolution, image generation, inpainting) | unconditional, conditioned on image | VQ-DDM | ImageNet, CelebA-HQ, FFHQ, LSUN |
| Shi [124] | multi-task (super-resolution, inpainting) | conditioned on image | Improved DDPM | MNIST, CelebA |
| Song [3] | multi-task (image generation, inpainting) | unconditional, conditioned on image | NCSN | MNIST, CIFAR-10, CelebA |
| Kadkhodaie [125] | multi-task (Spatial super-resolution, Deblurring, Compressive sensing, Inpainting, Random missing pixels) | conditioned on linear measurements | BF-CNN | MNIST, Set5, Set68, Set14 |
| Song [4] | multi-task (image generation, inpainting, colorization) | unconditional, conditioned on image, class | NCSN++, DDPM++ | CelebA-HQ, CIFAR-10, LSUN |
| Hu [126] | medical image-to-image translation | conditioned on image | DDPM | ONH |
| Chung [127] | medical image generation | conditioned on measurements | NCSN++ | fastMRI knee |
| Özbey [128] | medical image generation | conditioned on image | Improved DDPM | IXI, Gold Atlas - Male Pelvis |
| Song [129] | medical image generation | conditioned on measurements | NCSN++ | LIDC, LDCT Image and Projection, BRATS |
| Wolleb [41] | medical image segmentation | conditioned on image | Improved DDPM | BRATS |
| Sanchez [130] | medical image segmentation and anomaly detection | conditioned on image and binary variable | ADM | BRATS |
| Pinaya [44] | medical image segmentation and anomaly detection | conditioned on image | DDPM | MedNIST, UK Biobank Images, WMH, BRATS, MSLUB |
| Wolleb [45] | medical image anomaly detection | conditioned on image | DDIM | CheXpert, BRATS |
| Wyatt [46] | medical image anomaly detection | conditioned on image | ADM | NFBS, 22 MRI scans |
| Harvey [131] | video generation | conditioned on frames | FDM | GQN-Mazes, MineRL Navigate, CARLA Town01 |
| Ho [132] | video generation | unconditional, conditioned on text | DDPM | 101 Human Actions |
| Yang [133] | video generation | conditioned on video representation | RVD | BAIR, KTH Actions, Simulation, Cityscapes |
| Höppe [134] | video generation and infilling | conditioned on frames | RaMViD | BAIR, Kinetics-600, UCF-101 |
| Giannone [135] | few-shot image generation | conditioned on image | Improved DDPM | CIFAR-FS, mini-ImageNet, CelebA |
| Jeanneret [136] | counterfactual explanations | unconditional | DDPM | CelebA |
| Sanchez [137] | counterfactual estimates | conditional | ADM | MNIST, ImageNet |
| Kawar [27] | image restoration | conditioned on image | DDIM | FFHQ, ImageNet |
| Özdenizci [138] | image restoration | conditioned on image | DDPM | Snow100K, Outdoor-Rain, RainDrop |
| Kim [139] | image registration | conditioned on image | DDPM | Radboud Faces, OASIS-3 |
| Nie [140] | adversarial purification | conditioned on image | Score SDE, Improved DDPM, DDIM | CIFAR-10, ImageNet, CelebA-HQ |
| Wang [141] | semantic image generation | conditioned on semantic map | DDPM | Cityscapes, ADE20K, CelebAMask-HQ |
| Zhou [142] | shape generation and completion | unconditional, conditional shape completion | DDPM | ShapeNet, PartNet |
| Zimmermann [43] | classification | conditioned on label | DDPM++ | CIFAR-10 |
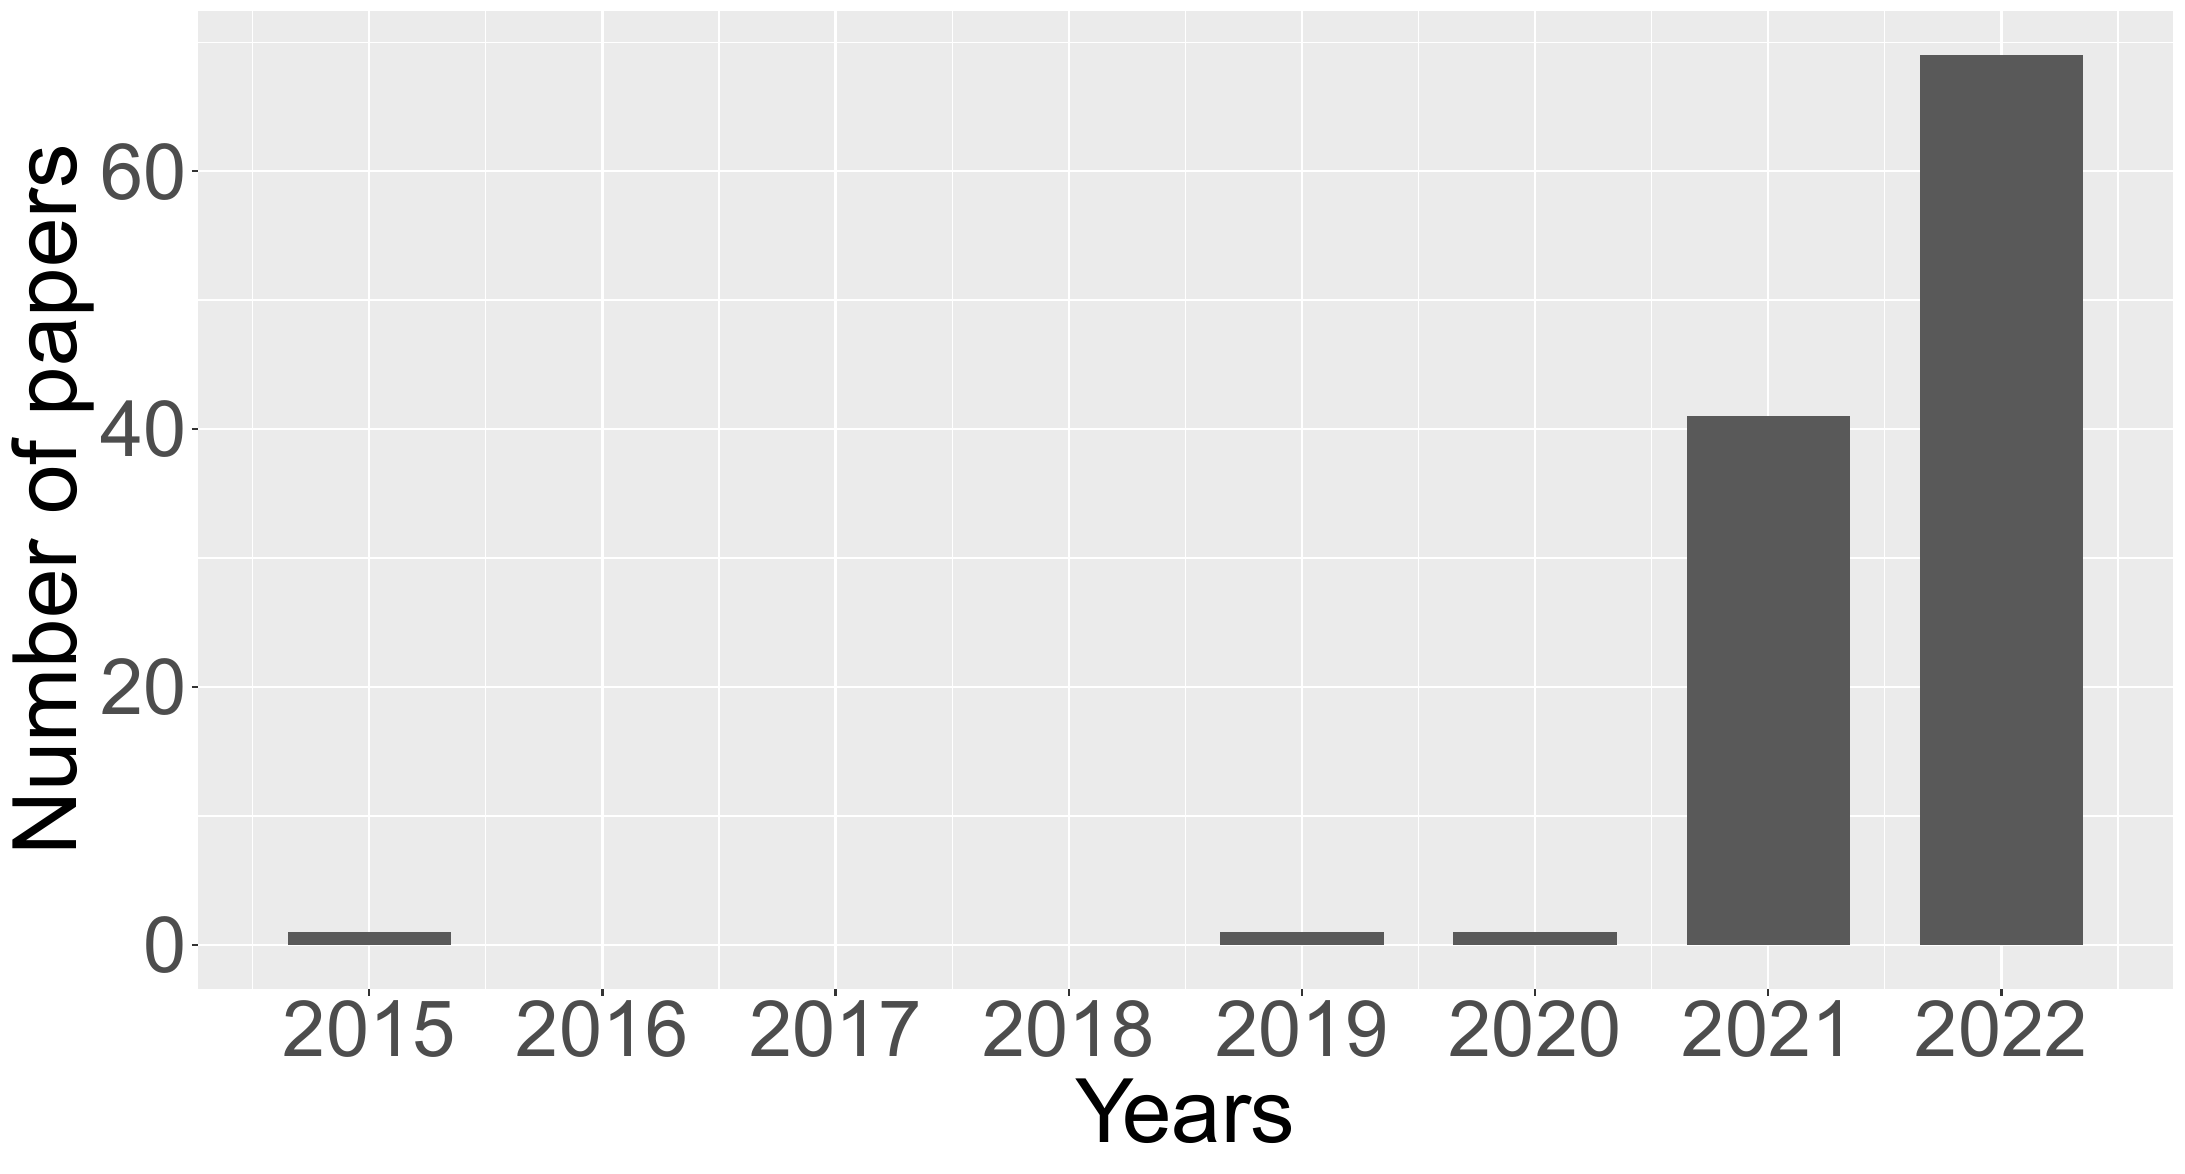
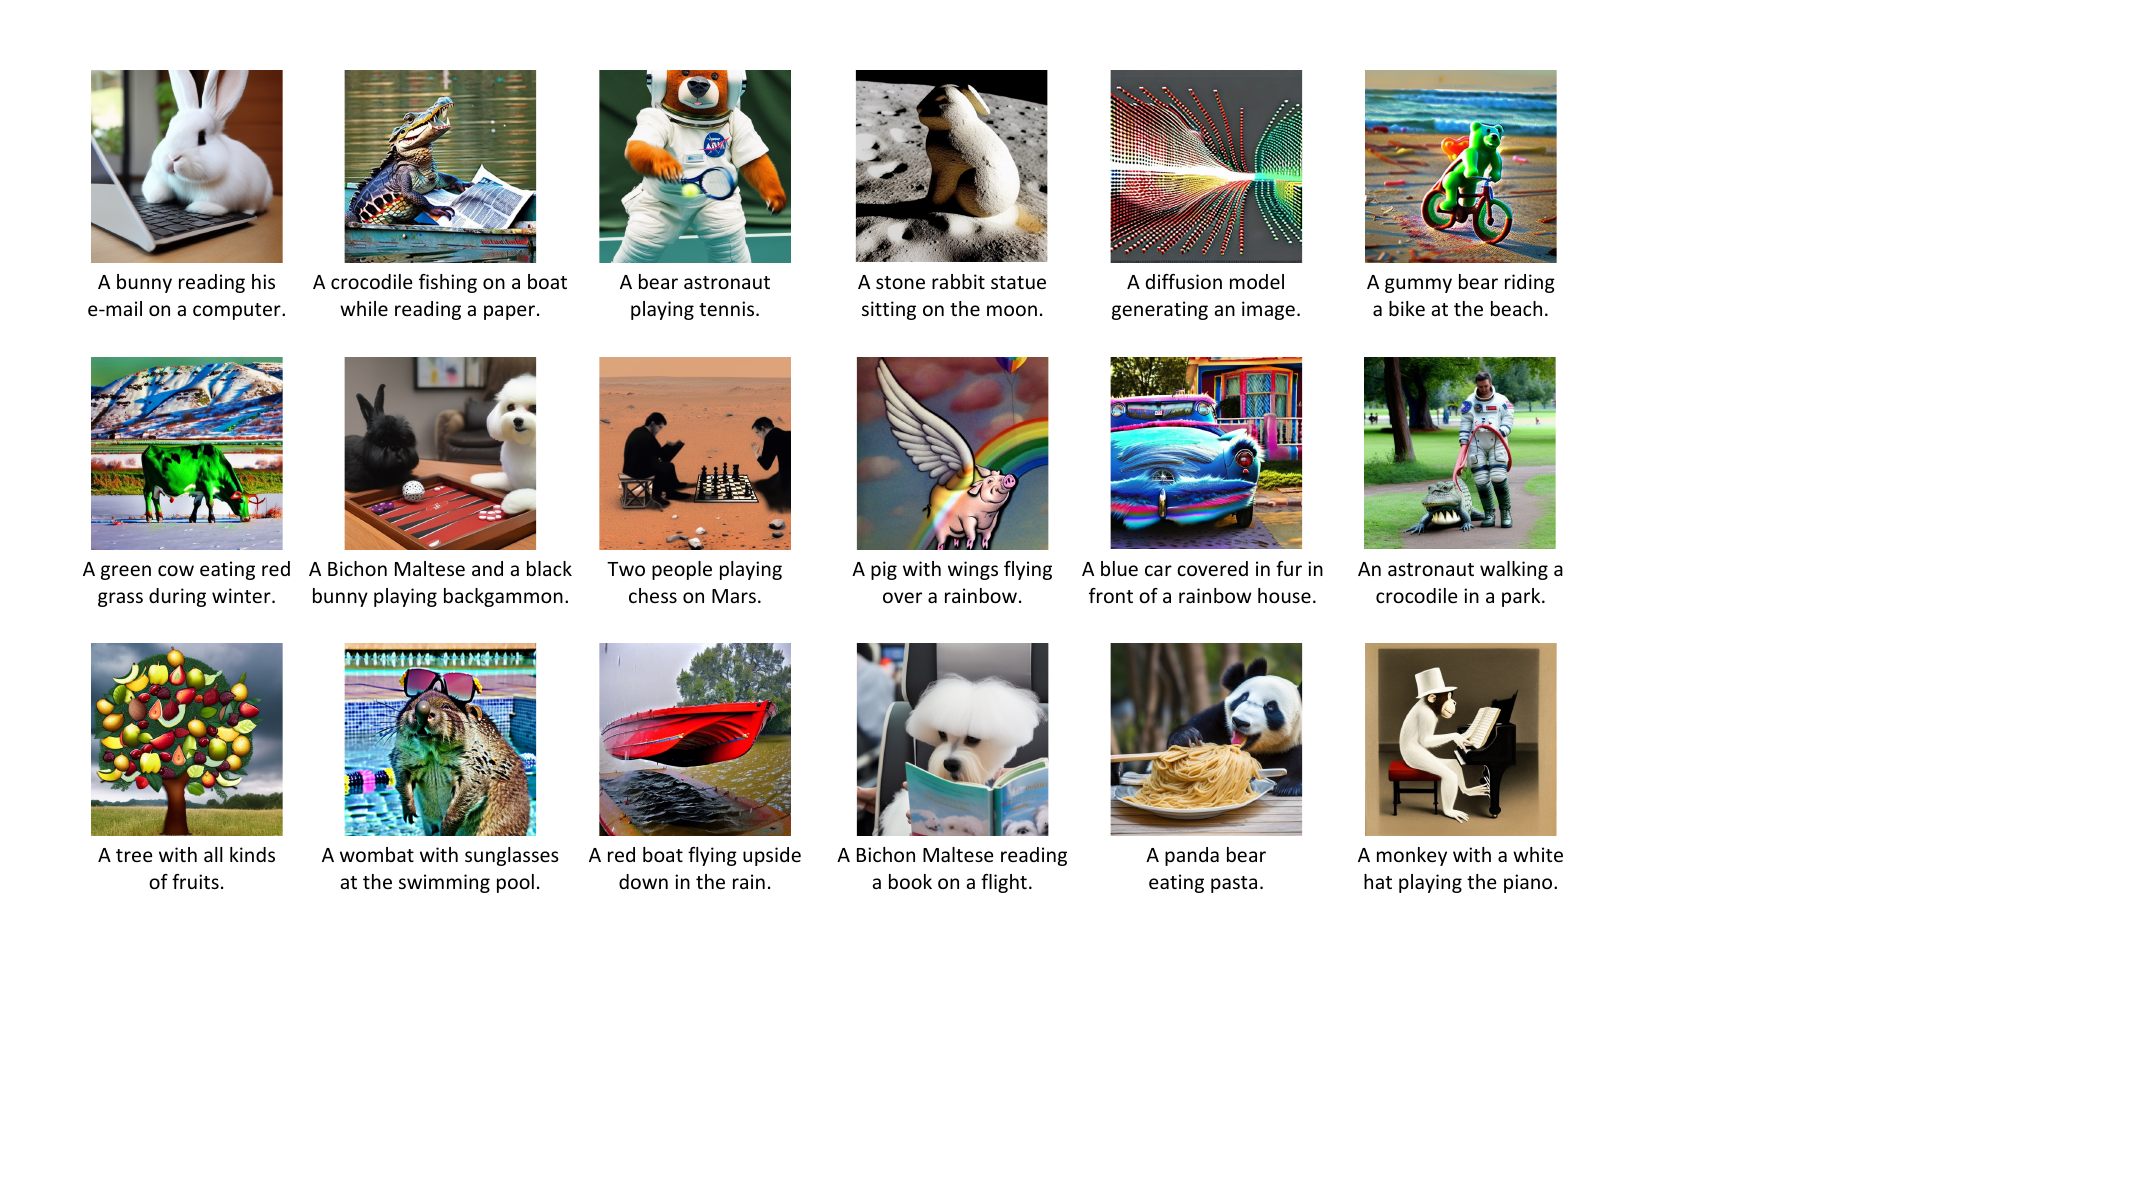
作者没有重新训练表中模型,没有公开复现实验、统计显著性或统一 sample budget。Figure 2 是作者通过 DreamStudio 生成的定性样例;Figure 1 是粗略文献数量统计。
正文综述 FID、IS、NLL、precision / recall 等已有结果,也讨论采样步数,但不同论文在数据预处理、分辨率、sample count、classifier 和 checkpoint 上存在差异。
| 指标 | 测量内容 | 综述阅读时的限制 |
|---|---|---|
| FID | 生成与真实特征分布的均值、协方差距离,较低更好。 | 对 sample count、特征提取器和数据预处理敏感;不同论文报告值缺少统一复算。 |
| Inception Score | 偏好单样本类别明确且整体类别分布多样。 | 不直接比较真实分布,依赖 ImageNet classifier。 |
| NLL / bits-per-dim | 概率模型对数据的 likelihood。 | 高 likelihood 不必然对应更佳感知质量;估计方法也可能不同。 |
| Precision / Recall | 分别近似衡量 fidelity 与 coverage。 | 特征空间与邻域定义影响结果;有助于揭示 FID 隐藏的 trade-off。 |
| Network evaluations | 采样时调用 denoiser 的次数。 | 单次网络大小与硬件速度仍不同,不能等同于真实延迟。 |
三框架统一顺序合理:先定义前向扰动,再说明学习对象和逆向采样。附录从边缘似然推导到噪声回归,能够支撑读者理解 DDPM 的训练目标。
Table 1 同时保留任务、条件、架构与数据集,信息密度高,避免仅按论文年代罗列。
检索协议、纳入排除标准、搜索数据库和质量评估没有形成系统综述式流程,因此“comprehensive”难以严格复核。
正文跨论文转述性能时,sample count、评估实现与训练预算缺少统一标准;分类表也没有 venue、年份、代码状态或核心数值列。
核心公式和三套算法足以重建基础 sampler 的逻辑。具体论文的 optimizer、网络细节、数据 split、采样超参数与评价代码仍需回到引用文献。
Figure 1 的统计不能复算;Figure 2 的 DreamStudio 生成没有公开 seed 与完整生成记录。
后续综述可预注册检索式,公开结构化文献数据库,为每个结果记录数据版本、分辨率、样本数、NFE、硬件延迟和代码提交,并把理论 taxonomy 与可复现实验分开维护。
对基础理论可增加 \(v\)-prediction、EDM parameterization、flow matching 与现代 solver 的符号转换图。
Table 1 每一行的方括号编号都可跳转到下列完整引用;编号与论文参考文献顺序一致。
原论文 Figures 1–3 与完整 Table 1 均来自 arXiv v6 TeX source;阅读正文以本地 v5 PDF 为准,并逐行检查 v5/v6 差异。核查日期:2026-09-28。