现有笔刷
重复 stamping 带来明显周期结构;不同材质交界需要艺术家手工修补。复杂图像作为笔刷时尤其容易显露复制痕迹。
把一张任意纹理图变成可交互的三维笔刷:每个 stamp 在局部渲染空间完成条件扩散修补,再投影回 UV atlas,并借助多尺度图像条件与 texture guidance 抑制连续绘制中的身份漂移。
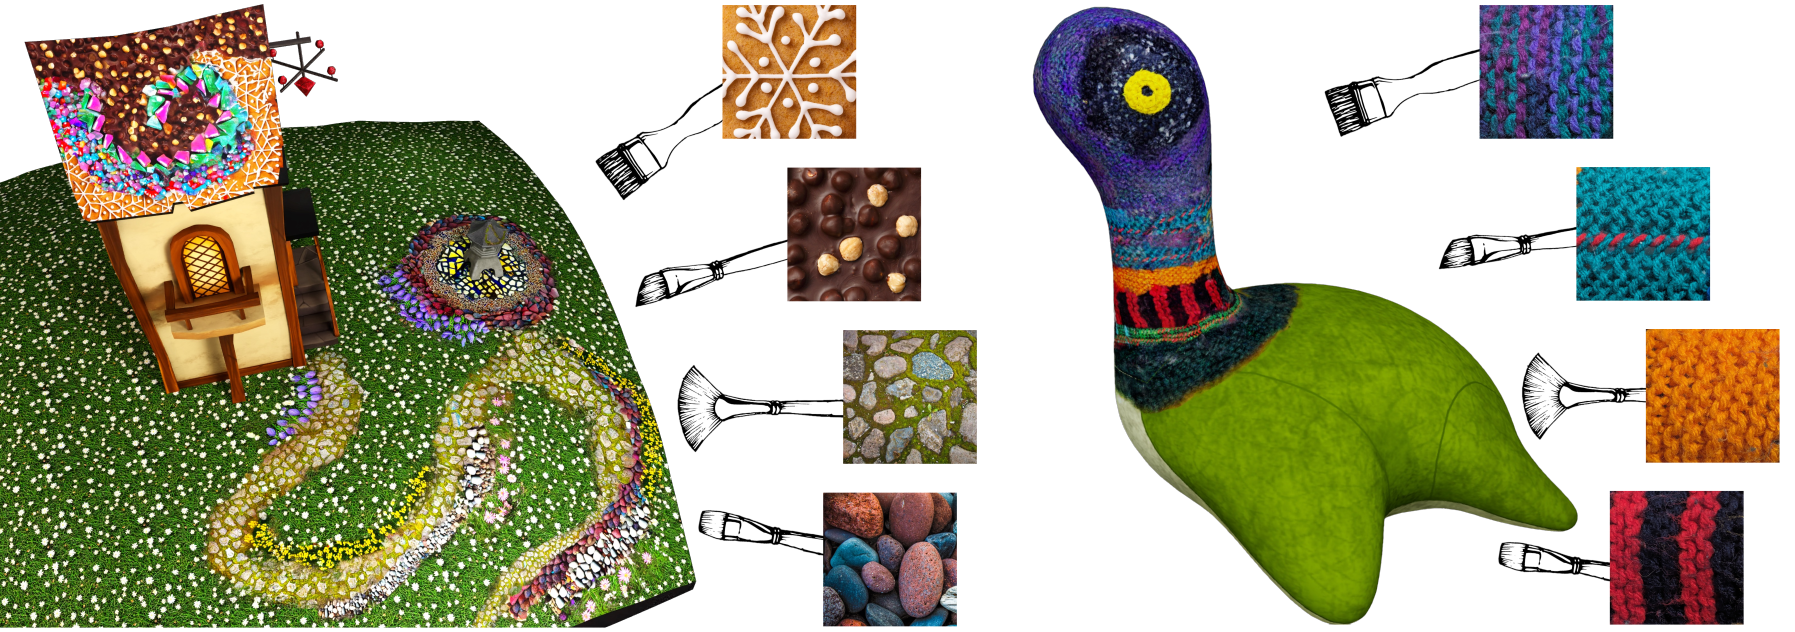
传统三维纹理绘制软件可以把自定义图像作为 stamp,却会重复复制同一块像素;经典 exemplar synthesis 能拼接样本,但依赖较大、较干净的源纹理,并且很难在任意两种纹理之间实时生成自然边界。全自动 text-to-texture 方法又削弱了艺术家对位置、尺寸与方向的直接控制。论文把预训练开放域扩散模型压进笔刷循环,让生成过程服从鼠标轨迹。
重复 stamping 带来明显周期结构;不同材质交界需要艺术家手工修补。复杂图像作为笔刷时尤其容易显露复制痕迹。
PatchMatch、TextureMixer 与 TextureAE 可以扩展纹理,开放域泛化、任意纹理过渡与实时三维交互无法同时满足。
条件 inpainting DM 已经学习自然图像先验。连续 stamp 共享重叠上下文,再用强图像条件固定 brush identity,就能把“想象力”限制在艺术家选定的纹理范围内。
论文明确提出三项要求:生成器必须支持 conditional inpainting(R1)、条件必须充分控制 brush identity(R2)、单次生成必须达到交互速度(R3)。贡献重点是交互系统与生成模型结合,作者主动说明其贡献并非新的通用纹理合成算法。
“任意开放域纹理”由 Pexels 跨类别样本、定性案例和小规模专家试用支持。实验没有覆盖所有纹理分布、所有网格条件或生产级资产,因此该表述应理解为开放域能力展示。
UV-mapped 三维网格 \(M=(V,F,F_U,U)\),其中 \(V,F\) 分别是三维顶点与面索引,\(U,F_U\) 分别是 UV 坐标与 UV 面索引、RGBA texture atlas \(T\)、用户视角相机 \(C\)、光标轨迹、brush size \(\beta\)、stamp size \(w\)、stamp 间距 \(\delta\),以及参考纹理图 \(S\)。
更新后的 RGB/RGBA texture atlas \(T^{\ast}\)。公开系统创建和保存 albedo/diffuse map;论文的 PBR 多通道结果只属于初步实验。
闭盒条件修补器 \(G(I,b)\) 接收局部 RGBA 上下文 \(I\) 与 brush condition \(b=E(S)\),输出完整 RGB stamp。随机性允许同一纹理产生多个变化。
每个 stamp 与已绘区域无缝衔接、保持参考纹理身份、提供非重复变化,并在固定 256×256 patch 上满足近实时延迟。
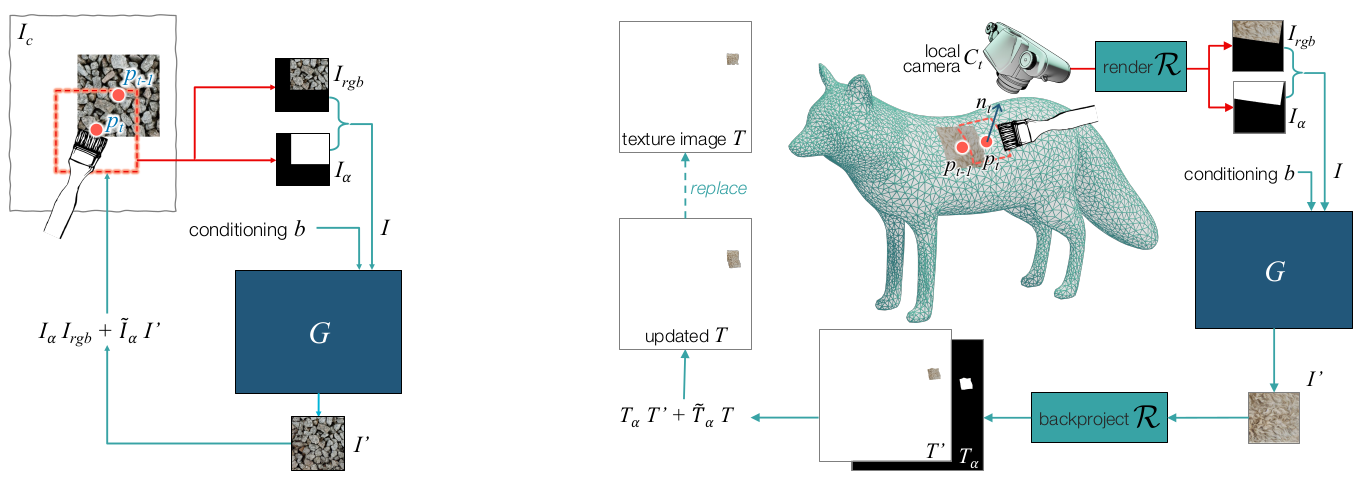
对任意尺寸画布 \(D\),光标移动距离超过 \(\delta\) 时裁出 \(w\times w\) 局部 RGBA patch。输入的 alpha 表示已知区域;新 stamp 与前一 stamp 重叠,扩散修补器必须延续已知像素附近的结构。生成结果通过 brush falloff 与目标画布合成。
直接在 UV atlas 上生成会把网格参数化拉伸带进模型输入。论文改用每个 stamp 的局部相机 \(C_t\):其 look-at point 为 \(p_t\),eye 位于 \(p_t+n_t\),up vector 跟随笔画方向。模型看到的纹理尺度和方向由相机统一,生成后再回投影到 UV。
up vector 随 \(p_t-p_{t-1}\) 旋转,因此纤维、砖块等有方向纹理沿笔画展开。首个点只记录位置,从第二个点开始获得稳定方向。
\(\beta\) 改变局部正交相机 FOV;FOV 变大时固定 256×256 输出覆盖更大表面范围。分辨率固定换取速度,细节密度随笔刷尺寸变化。
局部渲染仅记录 front-facing、被命中且已有不透明纹理的像素;回投影限制为可见面。已有 UV seam 仍可能导致纹理采样伪影。
falloff mask 清空 stamp 中央区域,再让模型依据外围上下文修补。公开 app 同时提供 inpaint、overpaint 与 erase 三种模式。
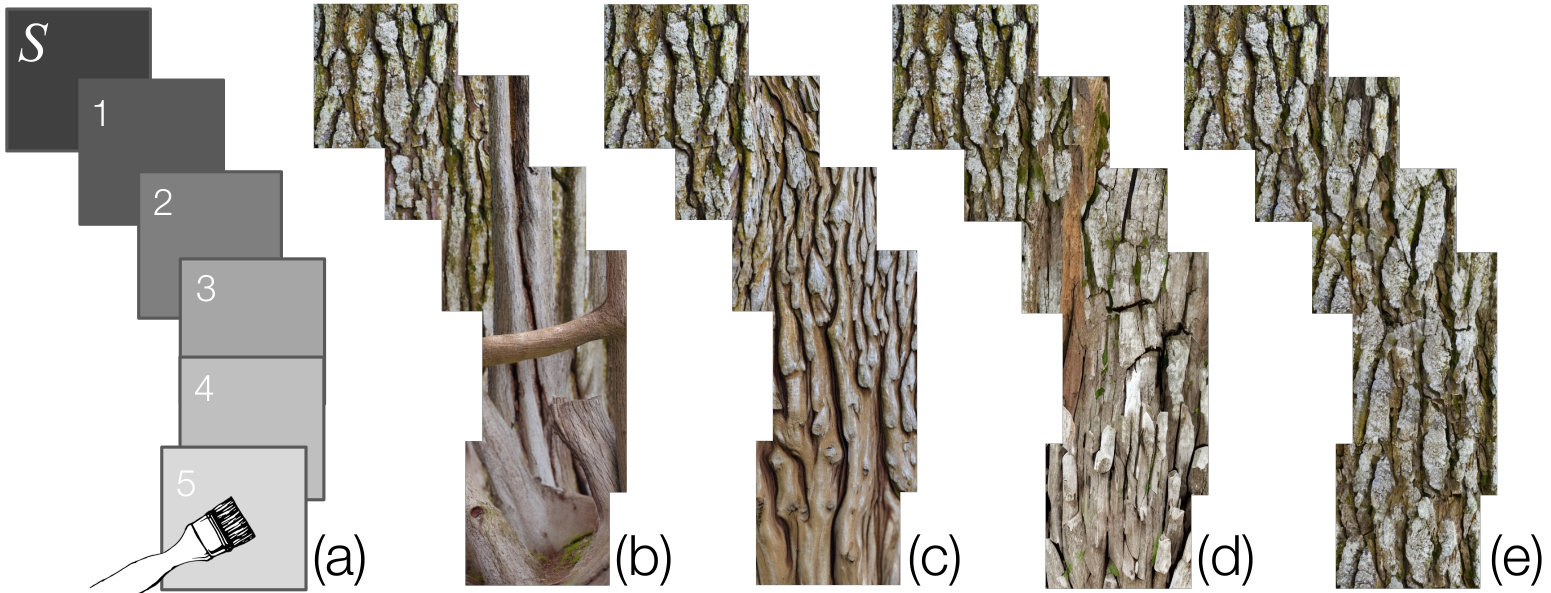
参考纹理 \(S\) 被分成 \(1+4+9=14\) 个 patch,每个 patch 调整为 224×224 并送入冻结的 OpenAI CLIP ViT-B/32。每个尺度内加入二维位置编码,通过各自四层 transformer;14 个 768 维 token 拼接、LayerNorm、线性投影后作为 Stable Diffusion UNet cross-attention 的 \(b\)。
作者观察到 inpainting context 对输出的影响强于 cross-attention 图像条件。系统先把参考纹理内容贴进未知区,保留经过 dilation 的空白边界,形成伪上下文 \(\widehat I\)。每步多跑一个有条件 UNet 分支,用“伪上下文预测减去真实上下文预测”的方向把采样拉回目标纹理。
拖动滑块查看论文 Table 1 的四个纹理引导设置。SW 越低表示生成 stamp 与目标纹理更一致;FID 越低表示生成 patch 分布更接近真实纹理 patch 分布。
下表中图像编码器层数、LoRA rank、优化器及示例命令来自固定官方代码提交;补充材料尚未取得,暂时无法确认这些默认值与论文实际训练运行完全一致。
| 环节 | 论文/官方配置 | 可复现细节 |
|---|---|---|
| 基础模型 | Stable Diffusion inpainting | 论文 §5.5 写 Stable Diffusion 1.2;公开代码 `version="1.5"` 且指向已下架的 `runwayml/stable-diffusion-inpainting` |
| 训练数据 | DTD,5,640 张 | 随机旋转 0–90°、随机缩放裁剪、水平/垂直翻转;目标与 mask 为 256×256 |
| 参考条件 | 1、2×2、3×3 patch | 共 14 个 patch,各自调整到 224×224;CLIP ViT-B/32 冻结 |
| 可训练部分 | 图像编码器 + UNet LoRA | LoRA rank 4;UNet 原权重冻结;image encoder 四层 transformer/尺度 |
| 公开代码默认优化器 | AdamW | \(\mathrm{lr}=10^{-4}\),\(\beta_1=0.9,\ \beta_2=0.999\),weight decay \(10^{-2}\),\(\epsilon=10^{-8}\) |
| 公开代码示例训练命令 | batch 32,100 epochs | constant scheduler,0 warmup,condition dropout 0.2,seed 42,checkpoint 每 5,000 steps |
| 推理 | 256×256,20 steps | DDIM scheduler;论文实验 CFG 4;TensorRT;单张 NVIDIA RTX 6000 Ada 约 0.15 s/stamp |
| 系统通信 | WebSocket 二进制协议 | 前端发送 steps、context padding、TG steps、CFG/TG scale 与 RGBA patch;服务返回 RGB stamp |
论文与仓库没有报告实际训练 GPU 数量、训练时长、最终 update steps、混合精度配置、完整 validation protocol 或随机种子重复次数。上述缺失项不能从脚本默认值推断为论文实际设置。
论文正文称 Stable Diffusion 1.2;固定官方仓库提交 dee8f9bda3a5ee4ced783f4a3039c1c76fb347f9 的 TensorRT 配置使用 version 1.5,README 也要求以 Stable Diffusion v1.5 inpainting 镜像替换已下架模型。复现时应记录所用 checkpoint 哈希,避免把历史模型名称差异隐藏起来。
896 张训练纹理、98 张测试纹理。TextureMixer 与 TextureAE 在该闭域数据上训练,因此 Earth 更有利于它们。
作者收集并裁剪 100 张免版税照片,覆盖建筑、食物、布料、工艺、动物和植物,用于开放域测试。公开仓库要求通过 issue 申请该集合。
每个纹理只给方法一个 256×256 crop。SW 对连续笔画中的 5 个 stamp 求平均;FID 比较 100 个真实 patch 与 20 条笔画生成的 100 个 patch。
| 方法 | Earth test | Pexels out-of-domain | ||
|---|---|---|---|---|
| FID ↓ | SW ↓ | FID ↓ | SW ↓ | |
| PatchMatch / Photoshop | 6.09 ± 6.3895% CI 4.844–7.344 | 1.25 ± 1.280.999–1.501 | 8.22 ± 7.346.780–9.657 | 2.32 ± 1.861.951–2.681 |
| TextureMixer | 1.74 ± 1.3495% CI 1.475–1.998 | 0.141 ± 0.1220.117–0.165 | 4.02 ± 3.813.273–4.766 | 0.472 ± 0.4310.387–0.556 |
| TextureAE | 20.2 ± 10.618.08–22.24 | 2.11 ± 1.501.819–2.407 | 12.9 ± 8.2411.25–14.48 | 2.65 ± 2.272.200–3.090 |
| Ours · \(\lambda=0\) | 9.24 ± 4.618.335–10.14 | 1.81 ± 1.341.552–2.076 | 10.1 ± 8.098.542–11.71 | 2.29 ± 1.861.925–2.653 |
| Ours · \(\lambda=0.5\) | 3.42 ± 1.583.118–3.738 | 0.812 ± 0.5460.705–0.919 | 3.10 ± 2.592.591–3.606 | 0.957 ± 0.7220.816–1.099 |
| Ours · \(\lambda=0.75\) | 1.69 ± 0.8021.535–1.849 | 0.347 ± 0.2410.299–0.394 | 1.68 ± 1.361.415–1.950 | 0.392 ± 0.2380.345–0.438 |
| Ours · \(\lambda=1\) | 1.12 ± 0.6510.992–1.247 | 0.199 ± 0.1260.174–0.224 | 1.18 ± 0.9210.997–1.358 | 0.311 ± 0.2380.264–0.357 |
在 Earth 上,闭域 TextureMixer 的 SW 最低;在 Pexels 上,\(\lambda=1\) 的本文方法同时取得最低 FID 与 SW。随着 \(\lambda\) 从 0 增至 1,本文方法四项指标单调下降,支持 texture guidance 抑制漂移并改善生成 patch 与参考分布的接近程度。FID 没有直接测量样本多样性,这些数值不能单独证明多样性保持。
FID 与 SW 都在二维 patch 上计算,没有直接衡量 UV seam、跨视角一致性、表面几何顺应性、艺术家控制感或完整资产质量。表中的方法训练数据规模差异很大;作者承认开放域预训练让比较缺乏完全对等的训练条件。
Original paper Figure 7. Earth 与 Pexels 上展示完整笔画及纹理过渡。GCorr 单个 256×256 patch 超过 40 秒,只参与定性比较;论文指出 DM 在自然共现纹理之间会生成可解释边界,遇到不合理组合时可能只画出锐利分界线。
Original paper Figure 8. 案例包括修补 photogrammetry texture、从实体玩具迁移观感、服装印花、姜饼屋概念探索与初步 PBR 通道实验。PBR 示例仍缺少高质量输出和跨 stamp 一致性。
两名 3D texturing/surfacing 专家试用系统。两人均认为真实纹理混合效果难以用现有工具实现,工具容易学习,并强烈同意其可加速 concept design。
样本量只有两人,正文没有量表、任务时长、对照条件、作品盲评或原始访谈记录。该研究适合形成设计假设,无法估计总体用户效应。
审计基于官方 repository commit dee8f9bda3a5ee4ced783f4a3039c1c76fb347f9(2026-01-15)。公开代码由训练、TensorRT 推理服务器与 Omniverse Kit app 三部分组成。
tg_steps 步使用 \(\lambda\),后续步把其置零。只支持单个 0–1 UV square,不支持 UDIM;要求 UV islands 无重叠并尽量减少 seam;跨多个 mesh 绘制需要预合并;vertex-varying normals 会触发 `NotImplementedError`;撤销只保留最近 10 条笔画且没有 redo。
公开 app 的 paintable material 只创建 albedo/diffuse map,其他 PBR maps 需要手工处理。它不会生成 SBS/SBSAR、shader graph、material graph 或十通道 SVBRDF。
原 `runwayml/stable-diffusion-inpainting` 已下架;README 提供 Hugging Face/ModelScope 镜像位置并要求修改模型名。公开预训练权重单独从 NVIDIA S3 下载。
本页完成源码与配置审计,没有下载巨型权重、构建 Omniverse、编译 TensorRT engine 或重跑论文实验。官方依赖需要 Linux Ubuntu 20.04、NVIDIA GPU、nvidia-docker 与 Omniverse Kit。
生成器只看局部 albedo context,没有显式深度、曲率、语义或照明条件。纹理可能跨越几何边界,局部高曲率和自遮挡会破坏回投影。
质量依赖良好的 UV layout 与 texel density。算法能跨 seam 绘制,但 atlas sampling 和有限分辨率仍可能产生接缝与拉伸。
增大 \(\lambda\) 固定 brush identity,也会压低模型自由度。论文缺少明确可预测的局部编辑约束和候选选择机制。
所有 stamp 固定 256×256;FOV 控制表面覆盖范围,因此放大笔刷时单位表面细节下降,缩小时推理次数增加。
多通道生成仅为早期结果,没有验证 albedo、normal、roughness、metallic 等通道之间的物理一致性。
缺少 seam 指标、跨视角一致性、操作吞吐量、延迟分布、显存占用、资产级盲评与大规模用户实验。
论文最有价值的思想是把生成模型改造成“局部、连续、带状态的交互操作符”。texture guidance 的三个分支可以看作 test-time control:基础分支保证可采样性,参考条件分支保持语义,伪上下文分支把已有像素的强约束扩展到未知区域。
可继续研究 geometry-conditioned brush tokens、显式 seam/occlusion mask、跨视角同步扩散、候选 stamp 搜索与用户选择、跨 PBR 通道的物理约束、分层 coarse-to-fine atlas、执行感知的 graph repair,以及以 artist corrections 学习局部 reward。对于 procedural material,合理扩展是把 brush 输出连接到可编辑材质图的局部结构与参数;该方向没有被本文验证。
ACM supplementary-materials 页面在本次核查环境返回 Cloudflare 403,官方项目页也只链接该 ACM 页面。正文明确引用 supplementary material 的附加消融、详细局限与两人试用细节;本页没有臆造这些未取得内容,相关缺口已在训练配置、用户研究和局限部分标明。