一条屏幕轨迹,无法单独说明对象在动,还是相机在动
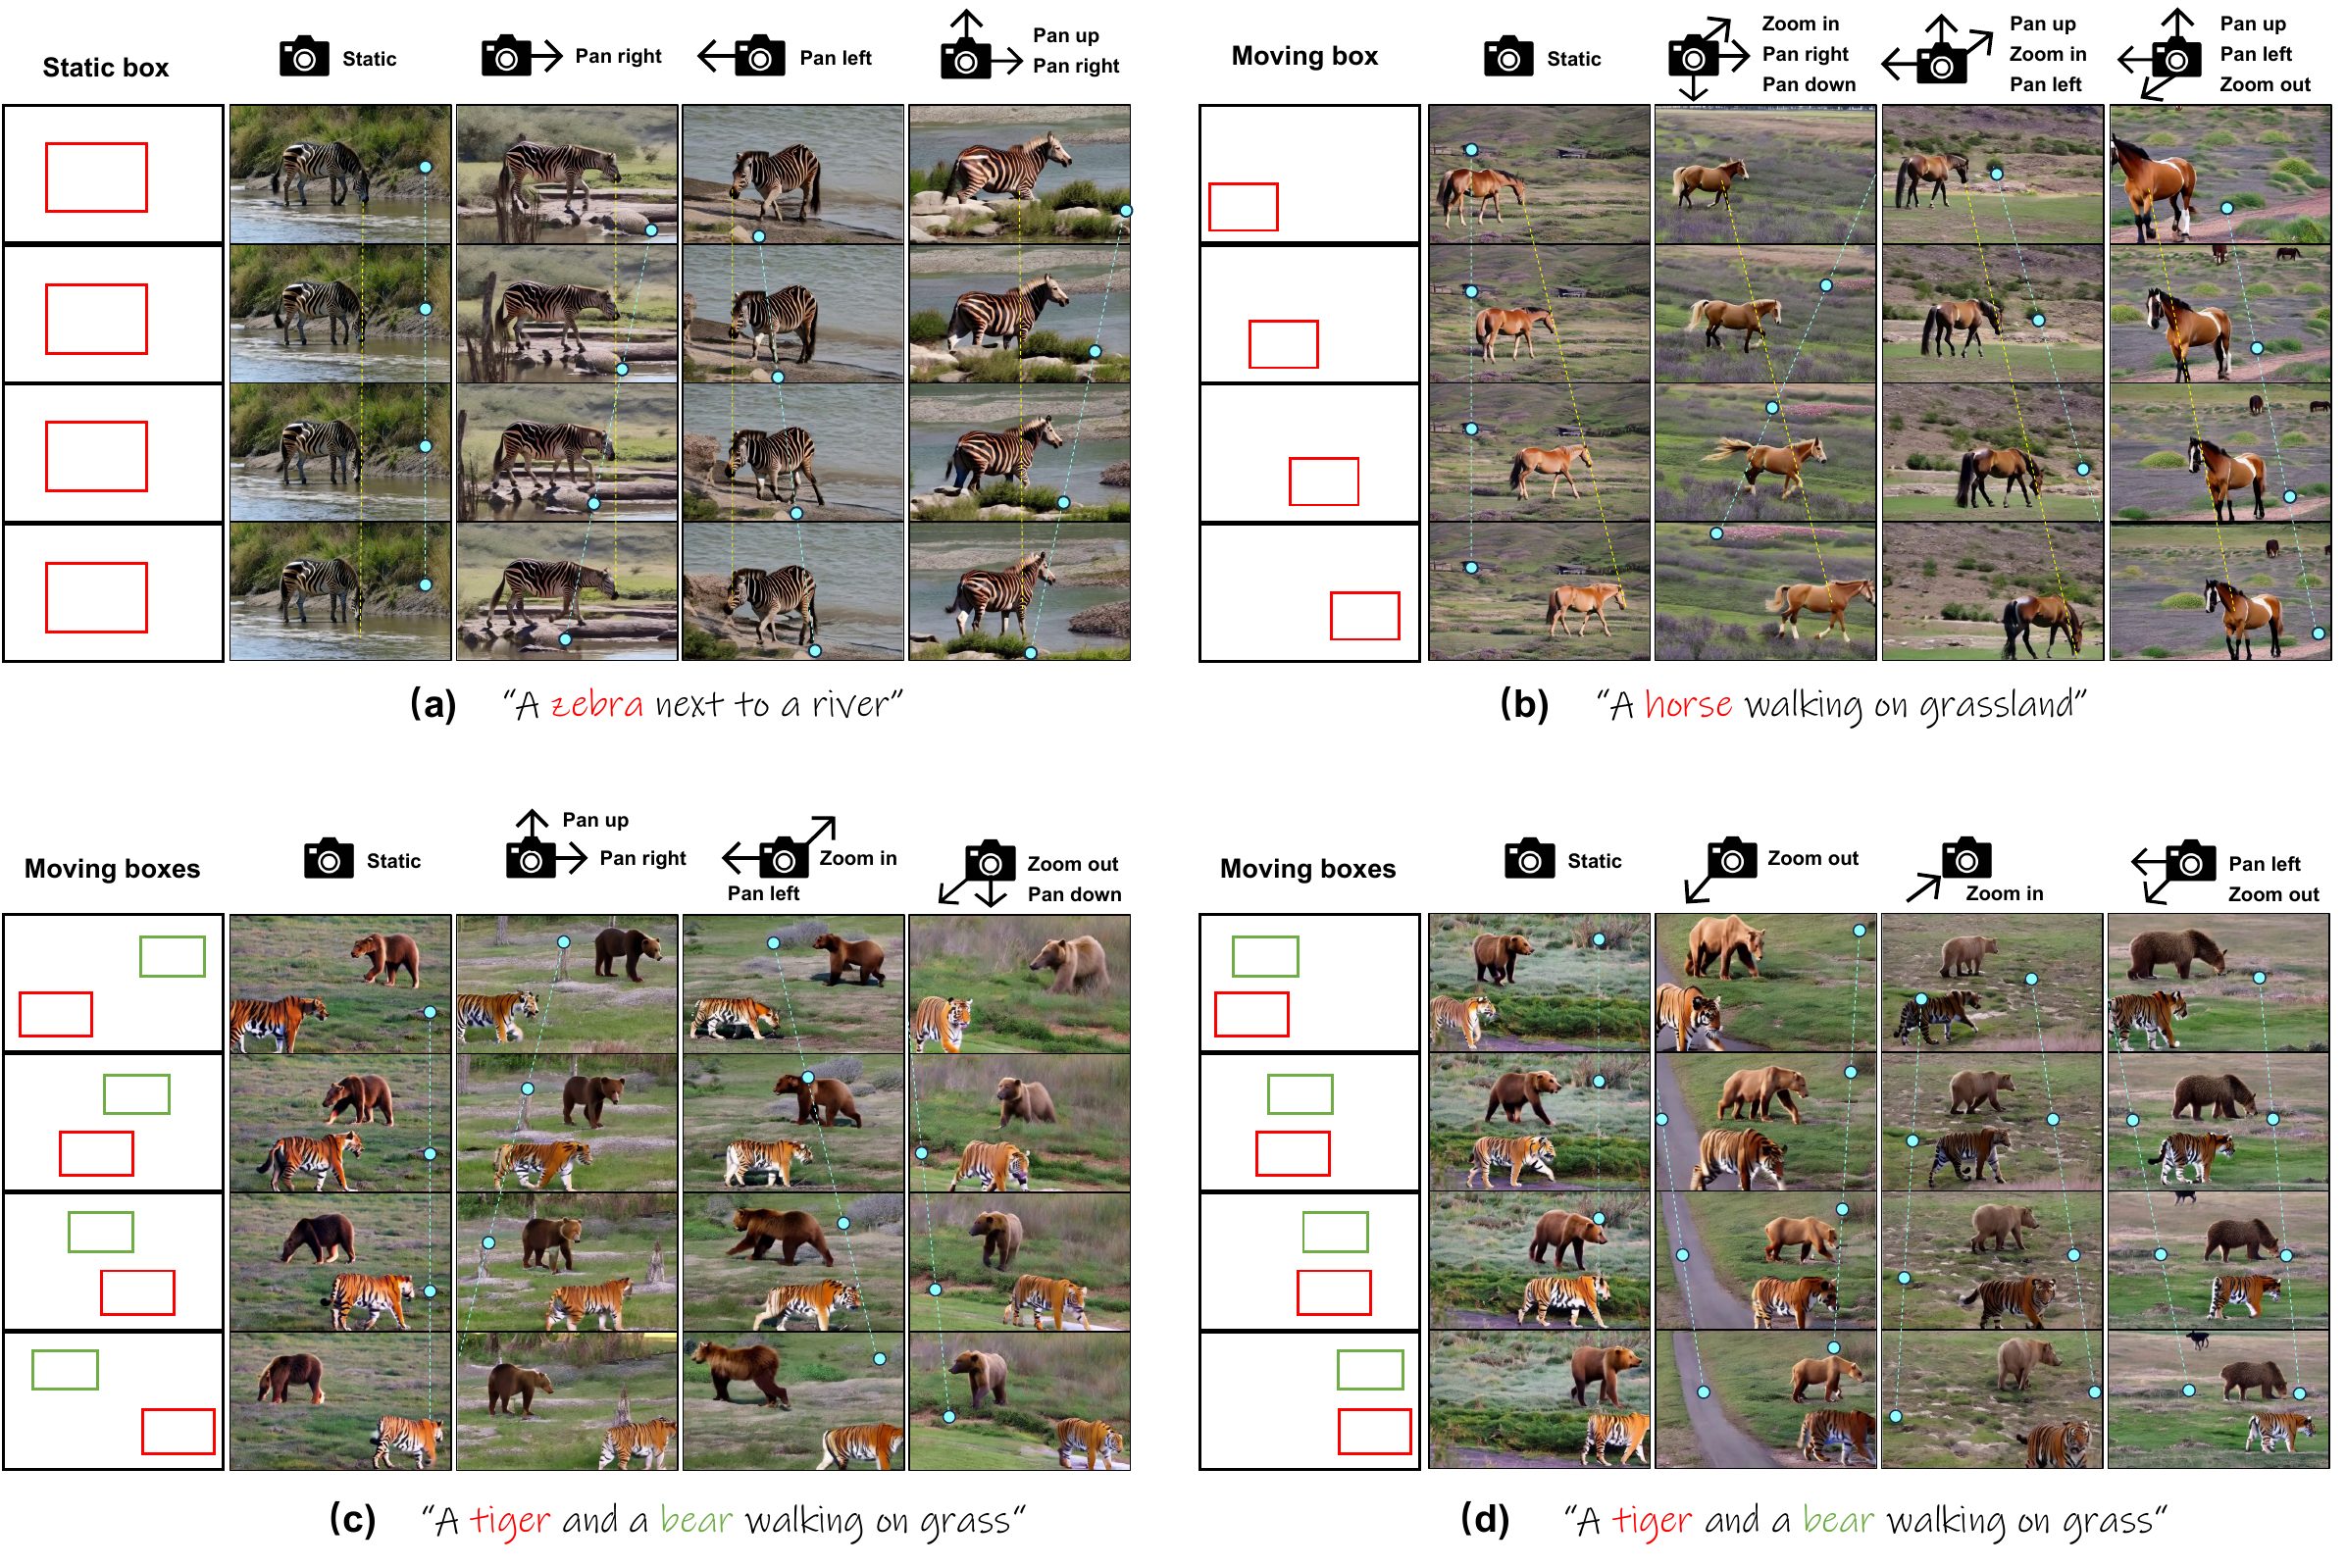
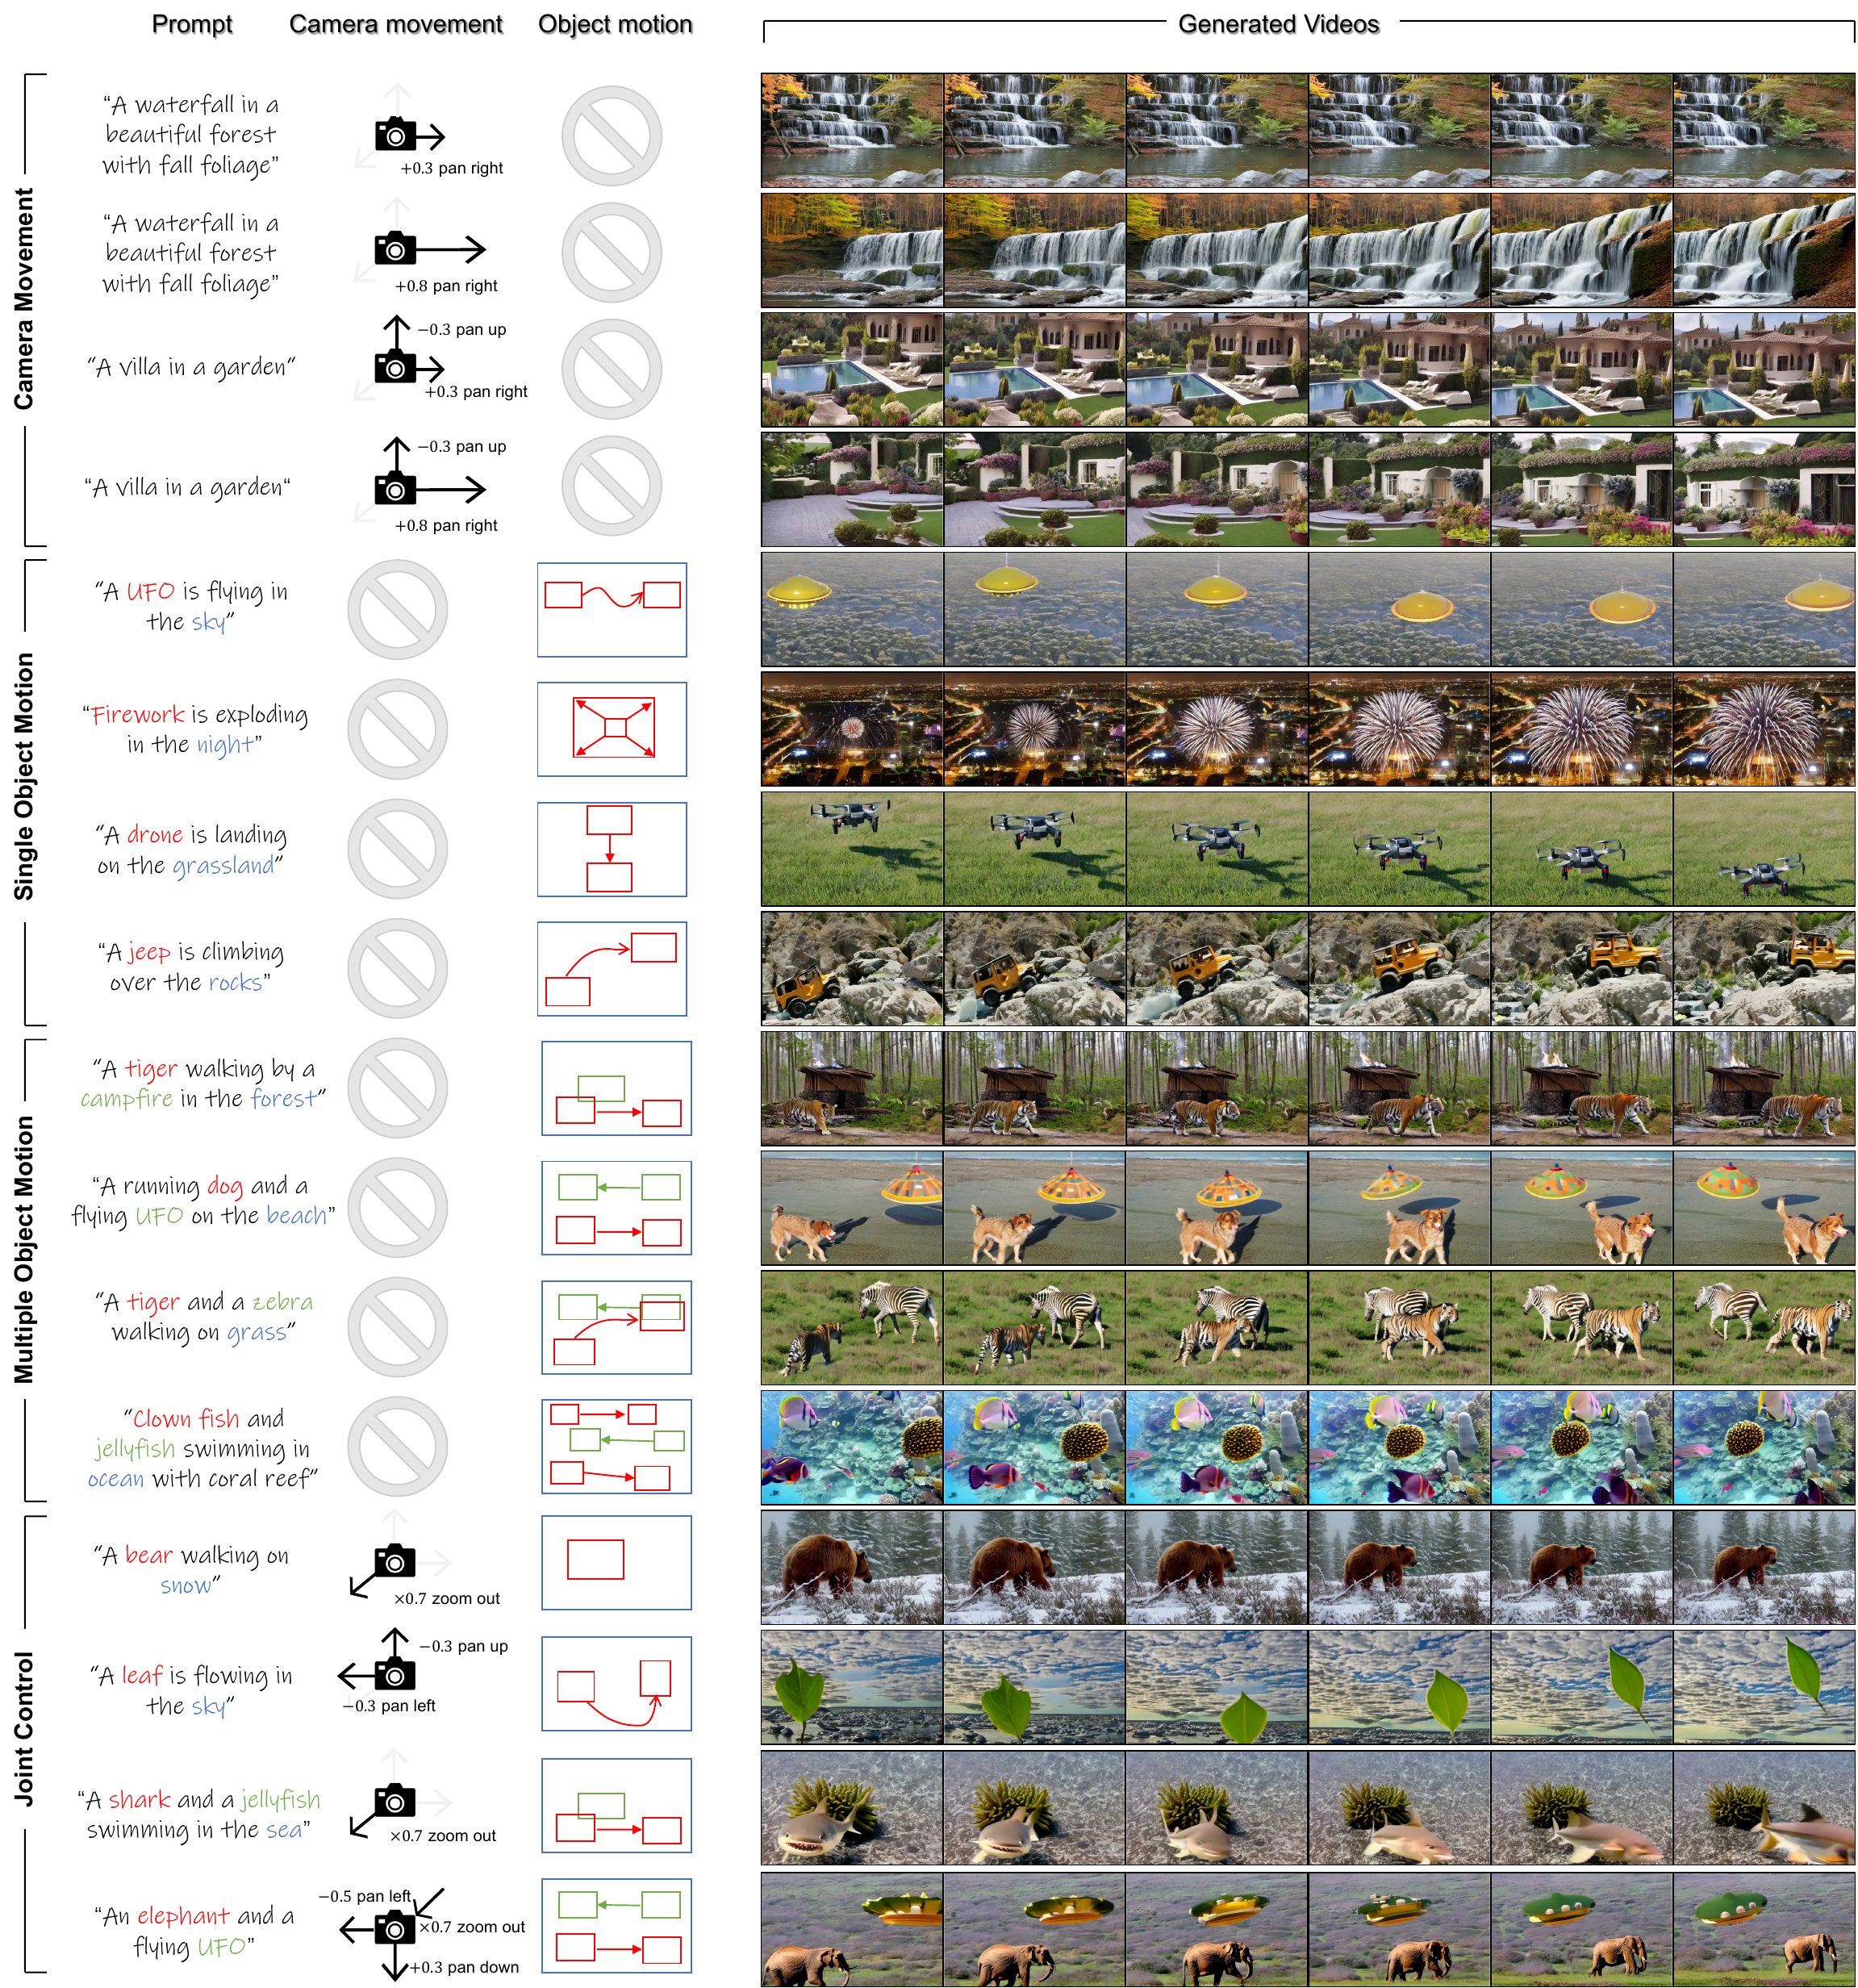
生成视频中的表观运动由前景对象运动与相机运动共同组成。只规定“对象从左向右”仍存在多种解释:对象右移、相机左移,或两者同时移动。论文将两个控制源分开建模,使用户可以独立或联合指定。
相机自由度
水平平移 \(c_x\)、垂直平移 \(c_y\)、缩放 \(c_z\)。它们描述二维裁剪窗口的变化,没有表达完整三维相机位姿。
多个对象
每个对象词 \(O_n\) 绑定首帧方框、末帧方框和中间路径,通过插值得到逐帧方框序列。
正交控制机制
相机分支训练新增 temporal cross-attention;对象分支在推理时修改 spatial cross-attention。
输入、输出与完整生成路径
用户输入:
\[\mathcal{I}=\left(c_{\mathrm{txt}},\mathbf{c}_{\mathrm{cam}},\{O_n,\mathbf{B}^{1}_{n},\mathbf{B}^{L}_{n},\zeta_n\}_{n=1}^{N}\right),\qquad \mathbf{c}_{\mathrm{cam}}=[c_x,c_y,c_z].\]其中 \(c_{\mathrm{txt}}\) 是文本提示;\(O_n\) 是第 \(n\) 个对象词;路径 \(\zeta_n\) 连接首末方框,经插值得到 \([\mathbf{B}^{1}_{n},\ldots,\mathbf{B}^{L}_{n}]\)。输出是长度为 \(L\) 的视频。
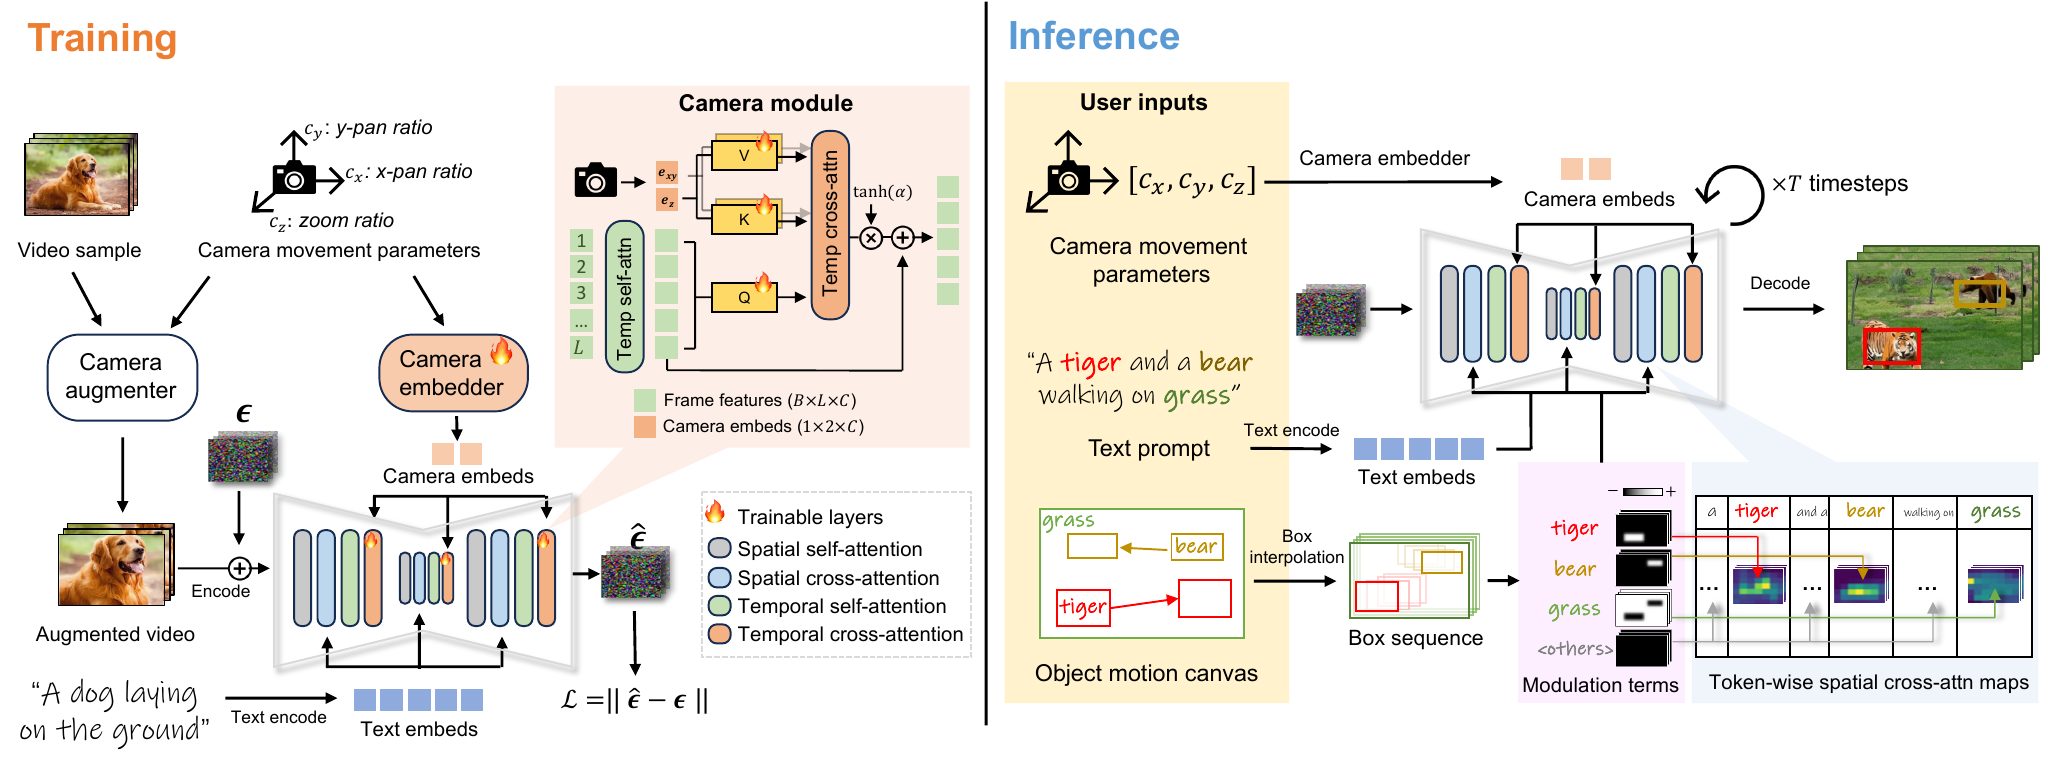
Camera branch
先在静态镜头视频上制造可知的 pan / zoom,再冻结原 Zeroscope 权重,只训练 camera embedder 与 camera module。此分支需要训练。
Object branch
在 DDIM 采样中按对象词和方框修改空间 cross-attention logits。此分支直接使用预训练模型内部先验,无需另建 grounding 数据集。
相机控制从“裁剪窗口语言”进入时间注意力
参数含义与范围
| 参数 | 定义 | 正方向 | 训练范围 |
|---|---|---|---|
| \(c_x\) | 首末帧中心横向位移 / 帧宽 | 向右 pan | \([-1,1]\) |
| \(c_y\) | 首末帧中心纵向位移 / 帧高 | 向下 pan | \([-1,1]\) |
| \(c_z\) | 末帧相对首帧的缩放比例 | \(c_z\gt 1\) 为 zoom-in | \([0.5,2]\) |
增强过程从 \([0,0,1,1]\) 出发,按帧线性改变裁剪框,再归一化、裁剪并缩放到训练分辨率。这一构造给每个增强视频提供精确的 \(\mathbf{c}_{\mathrm{cam}}\),无需对真实视频估计相机运动。
两个 token 分别编码 pan 与 zoom
\(\mathcal{F}\) 是 Fourier embedder。两个 embedding 维度相同,沿序列维拼成长度为 2 的 camera tokens。分开投影使 pan 和 zoom 拥有独立 key / value。
新增 temporal cross-attention
\(\mathbf{F}\) 是帧特征,\(\mathbf{Q}\) 来自视觉帧,\(\mathbf{K}_{xy},\mathbf{V}_{xy}\) 来自 pan token,\(\mathbf{K}_{z},\mathbf{V}_{z}\) 来自 zoom token。可学习标量 \(\alpha\) 初始化为 0,因此新增残差从零影响开始。
用对象词—方框配对直接改写空间 cross-attention
空间 cross-attention 中,query 来自视觉 token,key 与 value 来自文本 token。每个 attention logit 对应一个图像位置与一个文本 token 的匹配强度。
\(\lambda\) 是调制强度;\(\mathbf{S}\) 与 \(\mathbf{Q}\mathbf{K}^{\mathsf{T}}\) 同形。默认 \(\lambda=25\)。
放大、放松与持续抑制
\(\mathbf{T}_n\) 是对象词对应的 token 索引。方框越小,放大项越大。放大只在早期去噪阶段生效,以先确定粗略布局;默认 \(\tau=0.95T\)。抑制在全部采样步骤生效,并保留 start / end token,避免明显损害画面质量。
背景 token
如果提示中标记背景词,其空间区域定义为全部对象方框并集的补集,采用同类 attention 调制。
多个对象
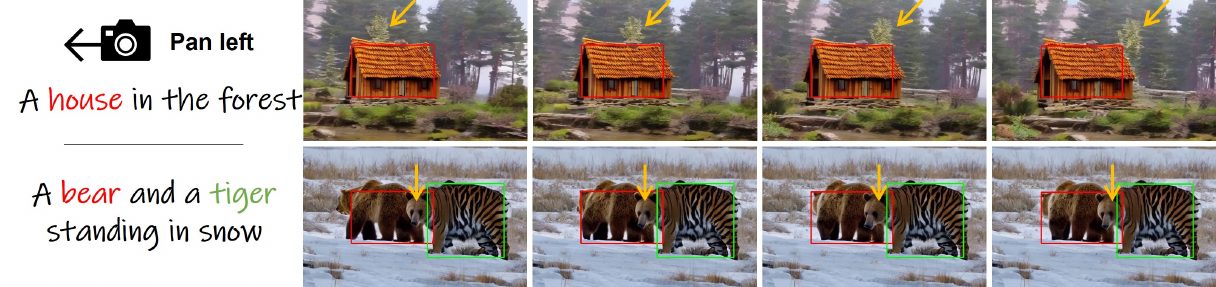
每个对象逐帧构造自己的 mask;对象词与轨迹显式绑定。方框重叠时多个语义约束会冲突,论文 Figure 7 展示了 tiger / bear 混合失败。
复现所需的训练、采样与数据细节
训练目标
训练样本 \(\mathbf{x}_0\) 是经过 camera augmentation 的视频。原 Zeroscope 权重冻结,仅 camera embedder 与 camera module 更新。
数据
MovieShot 的 22k static-shot movie trailers 子集;使用 BLIP-2 生成 caption。静态镜头保证增强前相机固定,主体仍可运动。
三阶段分辨率
\(256\times256\times8\):100k iterations;\(320\times512\times16\):50k;\(320\times512\times24\):50k。
优化
DDPM noise scheduler,训练 timestep 均匀采样 \([400,1000]\);AdamW,learning rate \(5\times10^{-5}\),batch size 8,8 张 NVIDIA Tesla V100。
camera 参数采样
三项独立采样,因此训练中包含静止、单轴和组合运动。
推理配置与 camera CFG
无条件相机状态为 \(\varnothing_{\mathrm{cam}}=[0,0,1]\)。论文使用 DDIM 50 steps、guidance scale \(s=9\)、\(320\times512\times24\) 输出。camera module 仅在早期步骤启用:采样从高噪声时间向低噪声时间推进,当 \(t\) 降至约 \(0.85T\) 时关闭,相当于前约 15% 的采样步骤使用相机模块;文本条件持续参与采样。对象放大截止值为 \(0.95T\),两项截止时刻分别控制不同分支。
| 项目 | 论文设置 | 公开代码固定提交 |
|---|---|---|
| 基础模型 | pretrained Zeroscope T2V | cerspense/zeroscope_v2_576w |
| 可训练部分 | camera embedder + camera module | 筛选参数名含 fuser 与 cam |
| 对象控制 | 采样期 attention modulation | SpatialCrossAttnProcessor 修改 logits |
| 默认采样 | DDIM 50 steps,CFG 9 | pipeline 默认值 50 与 9.0 |
| 对象控制参数 | \(\lambda=25,\tau=0.95T\) | pipeline 默认 25 与 0.95 |
| camera cut-off | \(0.85T\) | cam_off_t=0.85 |
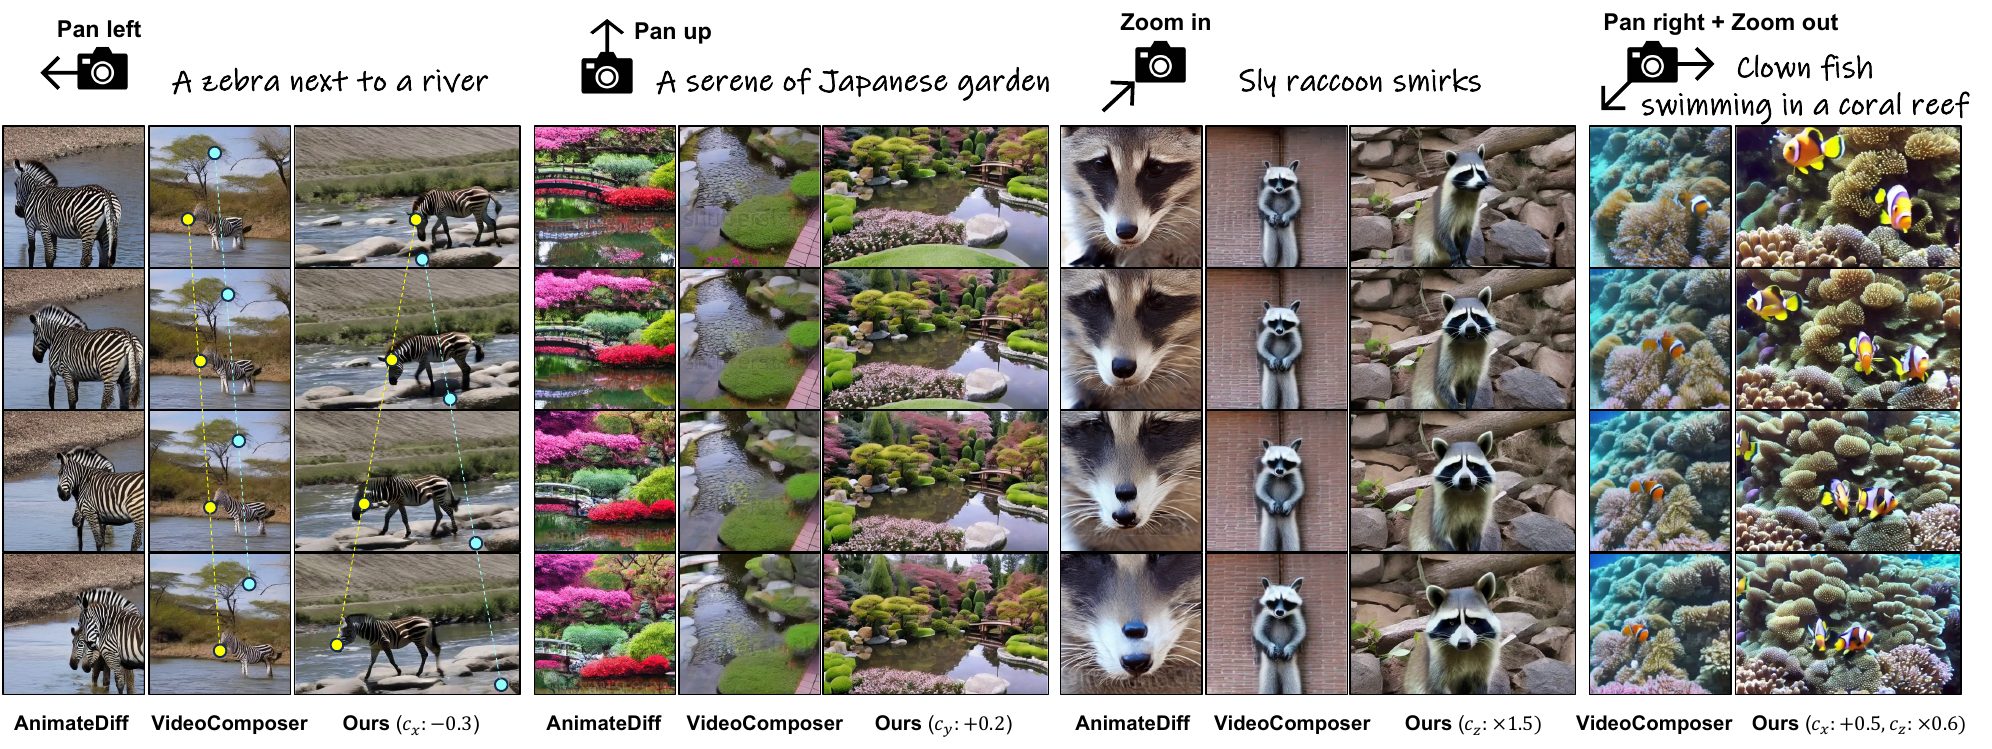
实验分别检验画面质量、相机运动误差与对象 grounding
Camera benchmark
200 个场景 prompt,来自 Chivileva 等人的 prompt set。参考质量集为 MSR-VTT 的 2,048 段视频。光流由 VideoFlow 估计,再与参数生成的目标光流比较。
Object benchmark
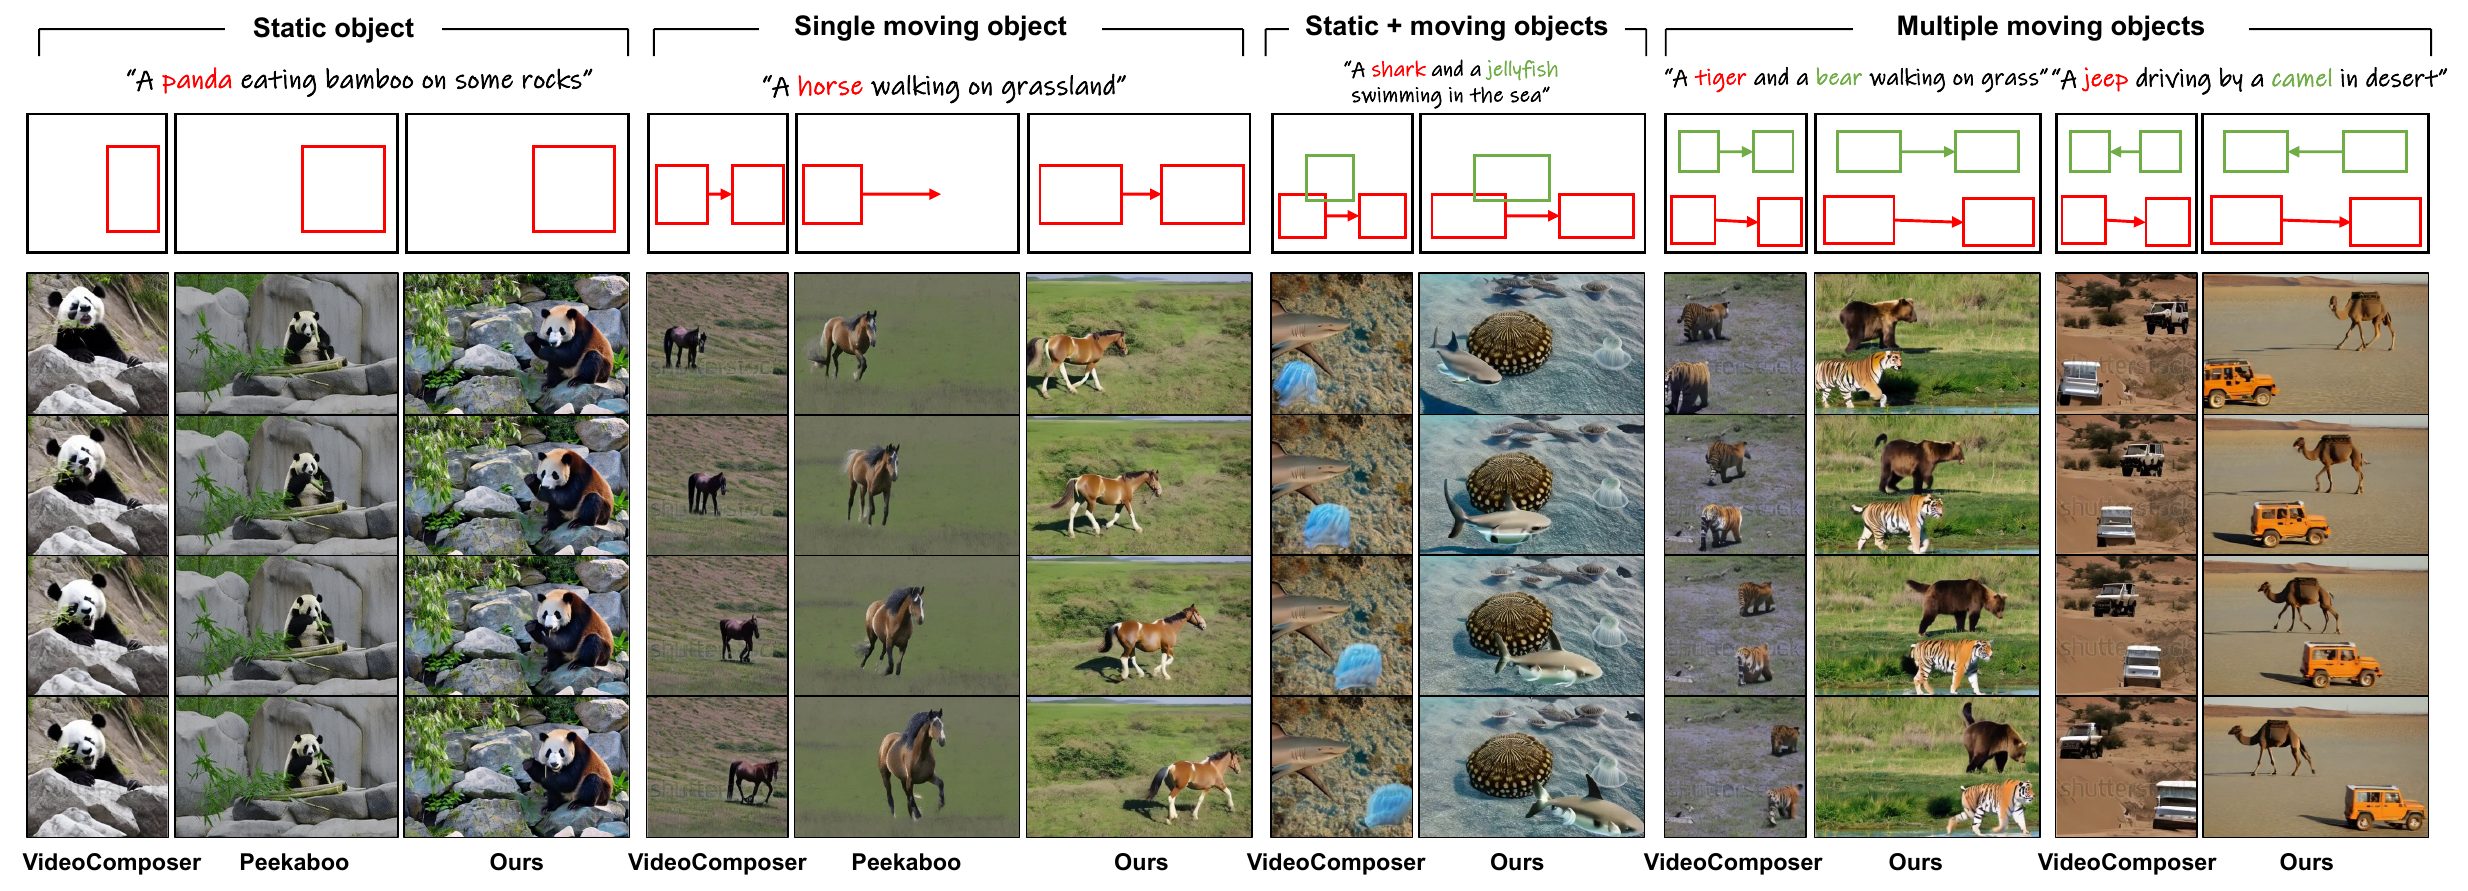
作者整理 200 个 box-prompt pairs,包含不同大小、位置和轨迹,主要为自然动物与物体。质量参考集为 Animal Kingdom 的 800 段视频。
Table 1 · 相机控制
| 方法 | FVD ↓ | FID-vid ↓ | Flow error ↓ |
|---|---|---|---|
| AnimateDiff | 1685.40 | 82.57 | — |
| VideoComposer | 1230.57 | 82.14 | 0.74 |
| Direct-a-Video | 888.91 | 48.96 | 0.46 |
AnimateDiff 没有定量相机参数,因此论文未计算其 flow error。VideoComposer 使用按相机参数手工构造的 motion vector maps,输入密度和接口与本文不同;质量差异也混入了不同基础模型的影响。
Table 2 · 对象控制
| 方法 | FVD ↓ | FID-vid ↓ | CLIP-sim ↑ | mIoU (%) ↑ | AP50 (%) ↑ |
|---|---|---|---|---|---|
| VideoComposer | 1620.83 | 90.57 | 27.35 | 45.24 | 31.01 |
| Peekaboo | 1384.62 | 44.49 | 27.03 | 36.55 | 18.77 |
| Direct-a-Video | 1300.86 | 43.55 | 27.63 | 47.83 | 31.33 |
CLIP-sim 在每个视频均匀抽取 8 帧,并在方框区域内使用模板 “a photo of <obj>”。Grounding DINO 检测生成对象,再与输入方框计算 mIoU 与 AP50。Direct-a-Video 对 VideoComposer 的 AP50 仅高 0.32 个百分点,远小于它对 Peekaboo 的提升。
Table 6 · 加入控制后的质量
| 指标 | Base | Cam | Obj | Cam+Obj |
|---|---|---|---|---|
| FID-vid ↓ | 41.12 | 44.95 | 43.55 | 41.20 |
| FVD ↓ | 1104.36 | 1204.55 | 1300.86 | 1280.88 |
放大负责位置响应,抑制负责多对象语义隔离
Table 3 · 两个 attention 操作
| 放大 | 抑制 | CLIP-sim ↑ | mIoU (%) ↑ | AP50 (%) ↑ |
|---|---|---|---|---|
| 关 | 开 | 25.82 | 15.35 | 3.46 |
| 开 | 关 | 27.49 | 38.87 | 10.25 |
| 开 | 开 | 27.63 | 47.83 | 31.33 |
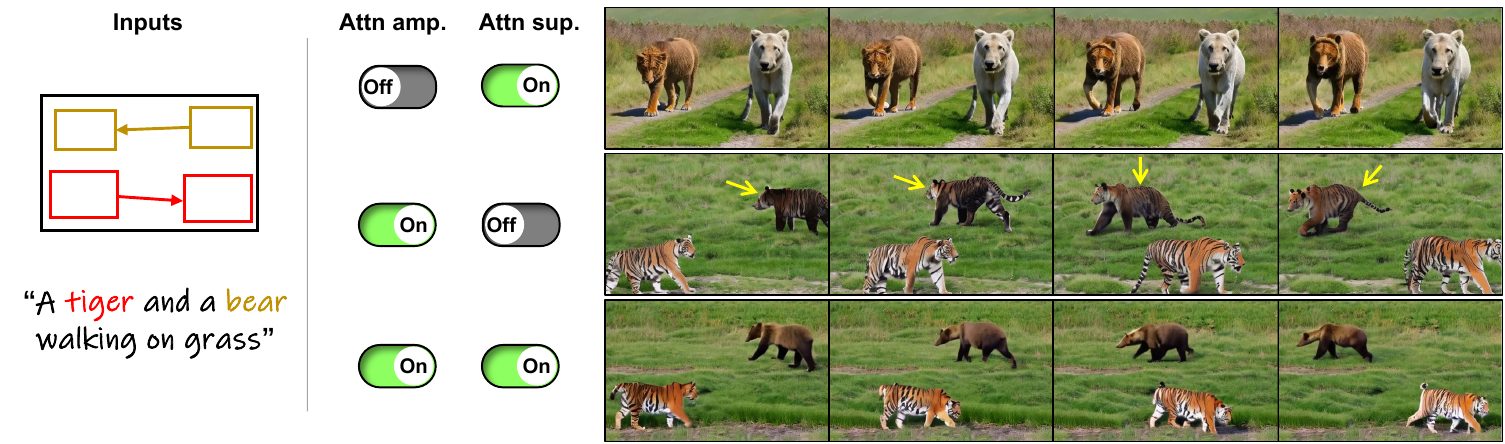
Table 4 · 在 U-Net 哪些部分放大
| 指标 | E | M | D | E+M | M+D | E+D | E+M+D |
|---|---|---|---|---|---|---|---|
| CLIP-sim ↑ | 26.20 | 25.93 | 26.75 | 26.35 | 26.74 | 27.62 | 27.63 |
| mIoU (%) ↑ | 30.90 | 14.28 | 29.25 | 31.71 | 28.98 | 49.06 | 47.83 |
| AP50 (%) ↑ | 5.50 | 0.27 | 5.75 | 6.61 | 6.13 | 30.04 | 31.33 |
E+D 的 mIoU 高于 E+M+D;作者选择全部层,因为 CLIP-sim 与 AP50 略高。Middle 单独使用效果很弱,加入 E+D 后带来的收益也有限。
Table 5 · \(\lambda\) 与 \(\tau\) 的完整网格
| \(\tau\) | \(\lambda=5\) | \(\lambda=10\) | \(\lambda=25\) | \(\lambda=50\) | ||||
|---|---|---|---|---|---|---|---|---|
| CLIP | mIoU | CLIP | mIoU | CLIP | mIoU | CLIP | mIoU | |
| \(0.80T\) | 26.81 | 27.99 | 24.91 | 47.71 | 24.65 | 49.76 | 24.83 | 47.83 |
| \(0.85T\) | 26.85 | 25.72 | 25.31 | 42.52 | 25.03 | 47.69 | 25.29 | 47.75 |
| \(0.90T\) | 26.78 | 26.74 | 26.15 | 40.83 | 26.60 | 45.50 | 26.18 | 44.08 |
| \(0.95T\) | 26.48 | 21.82 | 27.49 | 41.61 | 27.63 | 47.83 | 27.32 | 43.92 |
低 \(\tau\) 让放大持续更久,mIoU 往往上升,CLIP 语义质量会降低并出现方框形状过度响应。作者建议 \(\tau\in[0.9T,0.95T]\)、\(\lambda\in[10,25]\)。
固定代码提交揭示了论文公式背后的实际执行位置
相机模块确实参与训练
UNet3DConditionModel 以 attention_type="cross_temp" 新建 camera fuser;训练脚本冻结原参数,只选择名称包含 fuser 与 cam 的参数。代码还从已有 temporal self-attention 初始化新层权重。
对象控制确实发生在推理
SpatialCrossAttnProcessor 在 conditional branch 的 logits 上加入 attn_lambda * size_reg,再对负 mask 位置填入 -inf,随后执行 softmax。
camera 分为两个 key/value token
TempCrossAttnProcessor 对 cam_hidden_states[:,0:1] 与 [:,1:2] 使用独立的 K/V 投影,分别对应 pan 与 zoom。
公开 UI 具有额外交互约束
用户用星号标记对象词;多词对象使用圆括号;若标记背景词,它必须是最后一个标记词。UI 从起始方框、结束方框和可调整路径生成逐帧轨迹。
reg_sizes 实际使用每层空间位置数 \(h'w'\):对每个 query 位置计算 \(1-|R(i)|/(h'w')\),其中 \(|R(i)|\) 是该位置所属布局区域的空间面积。因此,代码实现对应“区域面积 / 空间 token 数”,没有除以完整 cross-attention 矩阵的 \(h'w'\times77\) 个元素。页面公式保留论文写法,此处记录实现语义。beautiful place。抑制 mask 将 BOS 与 EOS 通道保持为零,使这两个 token 不被填成负无穷。Commit: fa3ff99076015a293bd026111c06e5544be1cc7f
Key files: src/dataset.py · src/attention.py · src/attention_processor.py · src/t2v_pipeline.py · train_cam.py · inference.ipynb
方法的价值来自小接口和两种控制机制的清晰分工
Strengths
- 三个连续参数与方框轨迹具有很低的用户输入成本。
- camera augmentation 避开真实相机运动标注,冻结基础模型后训练成本集中在新增模块。
- 对象词与多条轨迹显式绑定,attention suppression 针对多对象语义泄漏给出直接处理。
- 主表覆盖质量、camera flow、文本语义和 box grounding,附录提供较完整超参数网格。
Weaknesses
- camera control 只覆盖二维 pan 与 zoom,不能产生绕物体旋转等三维轨迹。
- “解耦”缺少真实相机位姿或三维场景层面的验证,光流可以被对象运动与生成内容共同影响。
- 不同 baseline 使用不同基础模型和控制输入,FVD / FID-vid 的比较混入生成器能力差异。
- 200 个 prompt 与 200 个 box-prompt benchmark 没有公开详细构造与统计不确定性。
- 论文没有给出训练时间、推理时间和额外参数量。
一手资料与证据边界
- Yang et al., Direct-a-Video, arXiv:2402.03162v2,15 页,含 Appendix A–C;最后修订 2024-05-06。
- ACM DOI 10.1145/3641519.3657481;SIGGRAPH Conference Papers 2024,Denver,2024-07-27 至 2024-08-01。
- 官方项目页;作者、机构、通讯作者、方法说明和动态示例。
- 官方代码固定提交 fa3ff99;训练、attention processor、pipeline 与 UI。