实验实际展示
在 Lasso、三个数学任务、四个 GPU kernel 任务上,部分设置获得更好的质量与调用次数权衡;固定底层 agent 与 evaluator,调整探索控制代码。
PAPER READING / AGENT · META-EXPLORATION
让探索历史成为世界,
让搜索策略在回放中进化。
Recursive Self-Improvement through Evolving Worlds
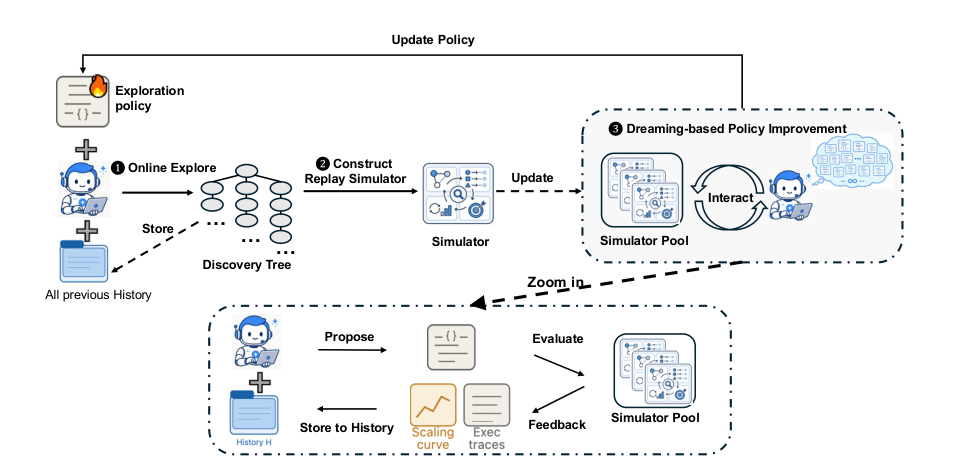
它把昂贵的发现过程保存为可重复回放的树,让另一个固定的 LLM 修改搜索控制代码;胜出的控制器再回到真实环境,产生下一批历史。真正被递归改进的是算力分配与探索策略。
前两项为论文对应实验的特定比较,不代表所有任务。核查日期:2026-09-18;当前确认是预印本,未据此宣称会议或期刊录用。
01 / THE QUESTION
长程发现不是一次生成:提出程序、运行、测量、修改,可能重复数千次。一次优质代码生成固然重要,但把后续预算交给哪条分支、何时重开方向、多少请求同时执行、什么时候停止,决定了大量成本是否产生价值。固定策略不会从自己积累的失败中更新;直接在线优化策略,则每试一个坏控制器,都可能支付一次完整发现流程的代价。
本文填补的缺口是元层反馈的复用:把原先只用于下一次提示的历史,变成可以评估其他控制器的环境。核心假设是:从已发生轨迹中学到的调度规律,能迁移到下一轮随机生成过程。回放让筛选便宜,但这种迁移仍需要真实上线验证。§1–2,pp.2–4
在 Lasso、三个数学任务、四个 GPU kernel 任务上,部分设置获得更好的质量与调用次数权衡;固定底层 agent 与 evaluator,调整探索控制代码。
历史回放可为元探索提供即时、廉价的离线反馈;逐轮扩大的世界池促进进一步自改进。它是经验性系统主张,没有给出对任意新环境的收敛保证。
这更接近“在已记录结果上做控制程序搜索”,而非训练一个能想象任意未来的神经世界模型;也没有更新基础 LLM 的参数。
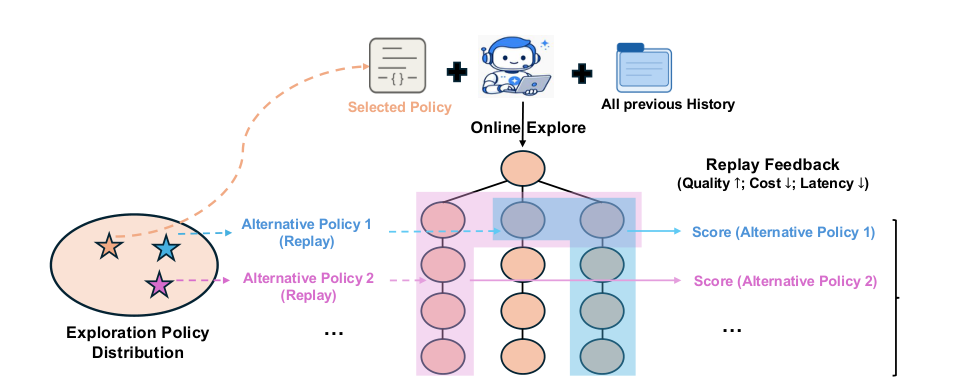
World 是已探索空间的一份记录;Dreaming 是在记录上运行候选策略;Recursive 是策略上线后改变未来收集到的历史,再用扩大后的历史改策略。回放不生成新科学解,也不能回答未记录动作会产生什么。
Tong Zheng、Xidong Wu、Zheng Zhang、Zhankui He、Chaoyi Zhang、Benjamin Coleman、Ruoqiao Wei、Di Bai、Haolin Liu、Rui Liu、Xue Wang、Yue Zhuan、Wang-Cheng Kang、Renkai Xiang、Heng Huang、Xinwu Cheng、Yunsong Guo。
机构:Google、University of Maryland, College Park、Google DeepMind、University of Virginia。通讯作者:Xidong Wu、Zheng Zhang。官方项目页和仓库部分发布状态仍有占位信息,本页以 arXiv v1 PDF 为论文身份与内容依据。
02 / REPRESENTATION & PIPELINE
输入是任务说明、初始工作目录、固定的代码生成 agent、固定的评测器,以及已完成轮次的历史。输出包含两层:对象层的候选程序或数学构造,以及元层的可执行探索策略。这里没有编码器—潜变量—解码器架构,也没有图 token 生成模型;“图”主要表示发现过程的依赖关系。
| 符号 / 对象 | 定义与作用 |
|---|---|
| \(r\) | 根节点,初始 workspace 状态;可用于打开新方向。 |
| \(v,s_v\) | 一次生成—评测尝试,以及其任务分数。节点保存文件系统快照、生成产物、诊断与继承的历史。 |
| \(\mathcal{T}_t\) | 第 \(t\) 轮真实发现树。每个非根节点只有一个主父节点。 |
| \(\mathcal{H}_t\) | 前 \(t\) 轮完整树的集合;每棵树是一个独立回放世界。 |
| \(\pi_t,\pi_t^{m}\) | 当前上线策略,以及本轮离线开发的第 \(m\) 个代码版本。 |
| \(W,C,K_1,K_2,M\) | 并行 worker 上限、动作批次、在线/离线决策轮上限、离线候选版本数。 |
| \(\mathcal{T}_i^{m,k}\) | 策略版本 \(m\) 在历史世界 \(i\) 中经过 \(k\) 轮后已揭示的子树,不是完整历史树。 |
策略选的是“从哪些已知状态继续”,而不是直接写下一段科学程序。批次大小决定并行量;空批次表示停止。非根节点被扩展后不再是当前叶子,因此正文中的非根分支实际沿链推进,根可以不断开新链。这不是允许任意内部节点重新分叉的通用树搜索接口。上式用 \(\mathcal{A}\) 区分批次集合,原文也将它记为 \(A(\mathcal{T};W)\)。
每轮从新树 \(\mathcal{T}_t^{0}=\{r\}\) 出发,旧历史 \(\mathcal{H}_{t-1}\) 提供上下文,但不等于新树本身。一个 worker 恢复父节点工作目录、调用固定 discovery agent 并评测,得到一个新子节点。相同起点再次生成可能不同。轮内策略代码固定,选空批次或到达 \(K_1\) 则停止。
非根节点只返回它已记录的唯一后继;根返回尚未揭示的、创建时间最早的根子节点;不存在记录就返回空集合。策略只读取已揭示观察,不能查看未来分数。空批次、达到 \(K_2\) 或整棵树已揭示都会结束回放。选了非空批次却没有可揭示后继仍消耗一次决策轮,因此实现必须处理边界。
这条转移公式保留父子顺序,只改变选哪些链、走多深、并行如何分组、何时停。它评估的是同一份已实现结果的不同访问方式;不包含新提示、新程序、新采样随机数会造成的反事实结果。§3,pp.5–6
| 功能 | 本文中的对应机制 |
|---|---|
| Reasoning / Action | 发现 agent 对科学任务提出方案并实现;探索控制器的 action 则是选择一个节点批次,两者不能混为同一动作。 |
| Observation / Feedback | 节点的测量分数、编译与正确性诊断、成功/失败类别、相对父节点收益。 |
| Memory | 完整历史树与 workspace / proposal / score 文件;既用于上下文,也作为回放结果源。 |
| Reflection / Retry | 提示词要求区分方向失效与可修复实现错误;重试应基于具体错误诊断。离线 agent 根据回放轨迹修订调度代码。 |
| Environment / Tool | 在线调用代码生成与任务评测;离线调用只揭示记录的 replay API。本文没有材质 renderer。 |
03 / THE OBJECTIVE
设回放终止于 \(k_i^{m,\ast}\) 轮,揭示的非根节点数为 \(N_i^{m}=|\mathcal{T}_i^{m,k_i^{m,\ast}}|-1\)。每个非根节点对应一次真实发现尝试,因此它是回放所代表的工作量,而不是本次回放实际又执行了这么多调用。
第一项鼓励到达好解;第二项惩罚大量尝试;第三项鼓励把值得做的尝试放到同一轮。分母至少为 1,避免空回放除零。并行奖励使用每轮平均尝试数,不是对异构任务真实墙钟时长的精确模型。系数决定质量与成本的交换比例;正文未报告具体数值,不应凭经验替作者补上。
策略开发 agent 可利用当前和此前修订的反馈,逐步提出新代码;候选并不要求每一步都变好。选择阶段保留当前上线版本 \(\pi_t^{0}=\pi_t\),所以:
它来自“候选集合包含旧版本”这一选择规则。换到新的随机 rollout、换任务、换数据分布,或者历史池扩大后,评分都可能变化;也不能据此推出真实发现分数逐轮单调上升。对同一批历史反复开发策略,仍然存在元层过拟合。原文 §3 / Eq.(1)
Our Interpretation · 教学数值,不是论文实验。两条策略已达到相同的最好分数 1.5。A 揭示 12 个节点、用 3 轮;B 揭示 8 个节点、用 4 轮。调整系数观察为什么“更少调用”和“更并行”可能冲突。
附录 B.2 让 evaluator 扫描一个单独的 \(\beta\) 控制旋钮,比较 attainment(达到的质量)—总 probes 的曲线;并行惩罚是各扫描点“有效顺序轮数 / 总 probes”的平均。一个含 \(b\) 个请求的批次,有效顺序轮数按 \(\lceil b/W\rceil\) 计。串行惩罚近 1,充分并行近 \(1/W\)。
这里的 \(\beta\) 是控制探索宽度、耐心和剪枝阈值的策略参数,不是正文 Eq.(1) 的 \(\beta_1,\beta_2\)。论文没有充分说明这两种评价的对应关系、AUC 精确归一化、扫描网格与 \(\lambda\) 数值。复现时必须记录选择了哪套定义,不能把附录的实现提示当成正文线性目标的直接代码展开。Appendix B.2,pp.19–23
04 / REPRODUCTION NOTEBOOK
| 项目 | 论文明确给出 | 复现边界 |
|---|---|---|
| Discovery backbone | Gemini-3.1 Pro、Gemini-3.7-Flash,经 Gemini CLI 调用;数学与 kernel 使用 Pro。 | 名称按论文原文记录;参数量、精确 API 版本与服务快照未给出。 |
| 可变 / 固定组件 | 探索策略代码可变;底层模型、evaluator、执行接口固定。 | 策略开发 agent 被描述为固定 LLM;其精确独立配置未充分报告。 |
| Pro 初始策略与预算 | 每轮 10 个并行 workspace,每个最多 11 次尝试,共 110 calls。 | 正文称 refinement steps;附录 grid 的 R 则表示根尝试之后的 refinement 数,不能直接混用。 |
| Flash 初始策略与预算 | 32 × 20,共 640 calls/轮。 | Dream-RSI 上限与固定探索相同,允许自适应提前停止;第一轮采用同一策略。 |
| 外循环次数 | Lasso 5 轮;数学 10 轮;ConvDiv 行为图显示 E0–E8 共 9 轮。 | 不应将这张图推断为全部 kernel 的统一轮数。 |
| 优化器 / LR / batch / epoch | 没有神经网络参数训练,未使用本文新增的梯度优化。 | 这些传统训练超参不适用于策略代码搜索;不要编造 Adam、学习率或训练 GPU。 |
| 推理采样 | 在线生成具有随机性;控制器提示要求确定性调度。 | temperature、top-p、top-k、token 上限、底层 beam 配置未充分报告。 |
| 离线搜索 | 在历史池上评价多个代码版本,保留旧策略并择优。 | M、K₁/K₂ 的完整实验配置、开发 token 成本、墙钟时长未完整报告。 |
| 硬件与总成本 | 主要横轴为 discovery-agent calls / generations。 | 未形成充分可复现的 GPU 型号、驱动、计时重复与全链路美元成本说明。 |
Lasso 在与 SimpleTES 相同的 17 个合成实例上搜索,覆盖维度、稀疏度、相关性与 active set 的变化;再测六个 held-out 数据集:Gisette、RCV1、DNA、Leukemia、Colon、Duke Breast。这是搜索任务与下游泛化测试划分,不是 LLM 的训练/验证/测试语料划分。数学任务以候选构造及其目标函数评测;kernel 从 KernelBench 选出四项,并非完整套件普测。本文没有构建图像—图程序配对数据集。
附录 B.1 已公开提示词,本页采用语义整理而非伪造原始 prompt。运行时填入 node/history/baseline 路径、评测程序和 problem 文件,另预留 direction_guidance 插槽。
“不加 Guidance”的对照仍然有上述读历史要求;因此 Figure 5 比较的是额外的方向性总结,不是“完全不用历史”与“使用历史”。
只修改指定 method 文件,实现 OptimalPolicy.solve(self, question, budget=None),不能代替 discovery agent 解决科学任务。API 提供 reset、observed、legal_actions、legal_roots、opened_branches、meta、probe_batch、baseline_score、max_parallelism。Observation 包含 score、evaluated、valid、fail_class、error、父节点/基线收益和有效测试数量。
重建每条链的成功锚点、趋势、退步、失败—修复序列和剩余深度。一次可修复失败不能抹去此前的成功,也不能永久饿死这条分支。
组合 exploitation、exploration、最多一个 recovery;候选必须在调用前已合法且不重复,不能同时放入父子节点,也不能固定先全展开再全加深。
运行中只能使用已揭示信息和允许的结构元数据;禁止未来分数、真实最优值、固定赢家 ID、绝对目标阈值和内部 trace。
停止前考虑整个组合的剩余机会。evaluated 且 error 为空、fail_class 为 ok 即成功;不能仅因 valid 为 false 判成可修复失败。
一个 rollout 内 \(\beta\) 固定;高值带来更宽探索、更深耐心、更弱剪枝。离线用固定网格扫描它;跨真实轮次才更改默认值。提示建议检查最近 2–3 个 live manifests 与相应 sweep:仍在进步时大体保留,平台且高 β 提供合理收益时小幅增加,反之小幅下降;典型步长 0.1–0.2,约束到 [0,1],证据不足用约 0.6。这些是手工规定的元启发式,不是无先验涌现。
每个策略还必须实现 plan_grid(context):在新在线 grid 建立前选择 branch_count 与 refine_count,返回理由。若每链允许 R 次 refinement,加上根尝试共 R+1 个单元。可选宽深受 hard caps 限制;回放计划超出已有树的宽深支持,不能获得回放 reward。history 用于判断“多方向早获益”还是“少数方向晚获益”,但不能读取当前轮未来结果。Appendix B.2,pp.21–23
05 / EXPERIMENTS
输入 \(X\in\mathbb{R}^{n\times p}\)、响应 \(y\in\mathbb{R}^{n}\)、递减正则系数序列,输出每个系数下的权重。方法寻找能够快速计算整条 regularization path 的程序。
候选近似解须对每个 k 满足 \(F_k(\widetilde w_k)\le F_k(w_{k,\mathrm{sklearn}})+10^{-6}\)。正确性检查用不同于计时实例的新实例;任一要求失败,搜索分数为 0。否则令计时实例集为 \(\mathcal I\),搜索奖励为:
这是整条路径耗时的几何均值的倒数;下表的 held-out Avg. 则是六个数据集运行时间的算术平均,二者不要混用。Appendix A,p.17
所有数值按原图转录;粗体为各耗时列全表最佳,下划线为第二(不计并列规则歧义);calls 不是运行该求解器的推理次数,而是发现它的生成预算。
| 方法 | Model | Calls | Gisette | RCV1 | DNA | Leukemia | Colon | Duke Breast | Avg. |
|---|---|---|---|---|---|---|---|---|---|
| sklearn | — | — | 11275.2 | 252881.7 | 93.8 | 227.2 | 229.8 | 374.0 | 44180.3 |
| glmnet | — | — | 9063.6 | 73072.8 | 351.9 | 45.0 | 24.2 | 47.7 | 13767.5 |
| SimpleTES | GPT-OSS-120B | 51,200 | 3141.9 | 19625.6 | 15.9 | 15.5 | 11.6 | 18.1 | 3804.8 |
| SimpleTES † | GPT-OSS-120B | 51,200 | 8651.0 | 41143.1 | 37.6 | 28.2 | 19.5 | 31.1 | 8318.4 |
| Fixed exploration | Gemini-3.1-Pro | 550 | 1861.8 | 19550.1 | 41.5 | 26.1 | 14.5 | 28.4 | 3587.1 |
| Fixed exploration | Gemini-3.7-Flash | 3,200 | 1133.1 | 13873.0 | 29.8 | 24.1 | 15.7 | 24.4 | 2516.7 |
| Dream-RSI | Gemini-3.1-Pro | 317 | 2841.0 | 14616.0 | 49.9 | 30.2 | 16.4 | 32.5 | 2931.0 |
| Dream-RSI | Gemini-3.7-Flash | 1,879 | 1091.9 | 12923.4 | 31.4 | 21.0 | 12.2 | 23.6 | 2350.6 |
原图 SimpleTES † 保留了匕首标识,但图注未解释其含义;本页不猜测它是重跑、修正还是硬件变化。
平均 3587.1 → 2931.0 ms,降低 18.3%;550 → 317 calls,减少 42.4%,即约 1.74× 少。51,200 / 317 ≈ 161.5 对应宣传中的“最多 162×”。
2516.7 → 2350.6 ms,降低 6.6%;3200 → 1879 calls,减少 41.3%。预算节省较稳定,但质量收益随 backbone 与数据集变化。
Pro 相比固定探索只有 RCV1 更快,另外五项都更慢;RCV1 的大绝对耗时主导了均值。Flash 在 DNA 上 29.8 → 31.4 ms 退化。SimpleTES 在 DNA、Leukemia、Colon、Duke Breast 四项仍快于 Dream-RSI 两种配置。因此不能写成“全面击败所有 baseline”。这些百分比由表中数值计算。
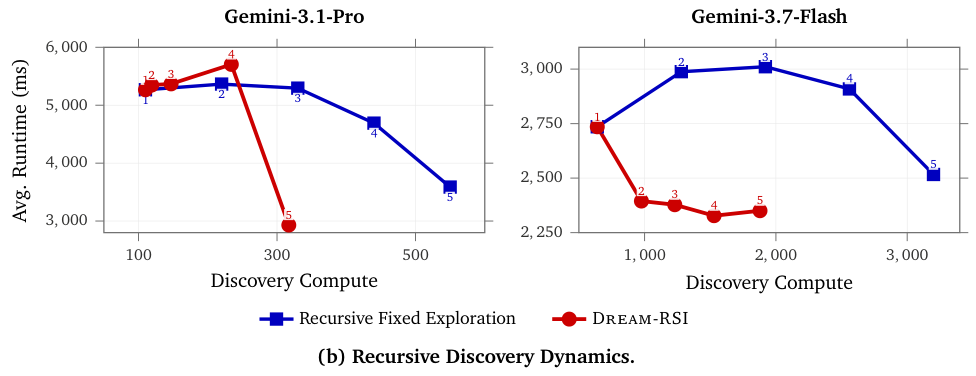
Our Interpretation Figure 3(b) 的 Pro 曲线在最后一轮前并非始终优于固定探索,最终跃升才形成优势;Flash 曲线较早体现收益。没有重复种子和置信区间,不能判断最后一次跃升的方差。跨 SimpleTES 比较同时改变模型与编排方式;更强的因果证据来自同 backbone 的 Recursive Fixed Exploration 对照。
Sum–Difference:找有限整数集合 \(A\),让和集相对差集更大;和集与差集分别含所有两元素之和、之差,目标最大化:
Circle Packing:在单位正方形内选圆心与非负半径,最大化半径之和 \(\sum_i r_i\)。每个圆须满足 \(r_i\le x_i,y_i\le1-r_i\),任意两圆满足:
附录列出 \(n\in\{26,32\}\),但 Table 1 只有一个 Circle Packing 列,未逐项对应这两个规模;不应声称表中一个值同时证明两种规模都最优。
Autocorrelation Inequalities:尽管任务名使用 autocorrelation,附录实际定义的是自卷积:
支撑区间为 \([-1/4,1/4]\),积分为 1。第一任务要求非负 f,最小化自卷积在 \([-1/2,1/2]\) 的最大值;第二任务同样要求非负,最大化 \(\|f\ast f\|_2^2/(\|f\ast f\|_1\|f\ast f\|_{\infty})\);第三任务允许带符号 f,最小化自卷积绝对值的最大值。Table 1 仅有一个越低越好的列,不能将其外推为附录三种目标全部成功。Appendix A,p.18
| 方法 | LLM | Sum Diff ↑ | Auto Correlation ↓ | Circle Packing ↑ |
|---|---|---|---|---|
| AlphaEvolve | Gemini-2.0 Pro + Flash | — | 1.455700 | 2.635862 |
| AlphaEvolveV2 | Gemini-2.0 Pro + Flash | 1.121936 | — | 2.635983 |
| OpenEvolve | — | — | 1.460000 | — |
| CodeEvolve | — | — | — | 2.635980 |
| ShinkaEvolve | Mixed | — | 1.457800 | 2.635982 |
| TTS-Discovery | Qwen3-8B | — | — | 2.635983 |
| ThetaEvolve | Distilled-Qwen3-8B | — | 1.493000 | 2.635983 |
| EvoX | Gemini-3.0-Pro | — | 1.458900 | 2.635900 |
| SimpleTES | GPT-OSS-120B | 1.143975 | 1.453675 | 2.635983 |
| Recursive Fixed Exploration | Gemini-3.1-Pro | 1.144047 | 1.456001 | 2.635983 |
| Dream-RSI | Gemini-3.1-Pro | 1.145427 | 1.456375 | 2.635983 |
在与固定探索对照时,Sum–Difference 从 1.144047 → 1.145427,绝对增加 0.001380(约 0.121%);Circle Packing 在显示精度上持平;Autocorrelation 从 1.456001 → 1.456375,反而稍差。相比 SimpleTES,后者自相关结果 1.453675 仍更优。文中声称本方法数学实验少于 1,000 generations,而 SimpleTES 为 51,200;这支持预算差异,但不是所有数学任务质量都更高,也不是总美元成本精确少 50 倍。§4.2,Table 1
选取 KernelBench 的 VGG16、LayerNorm、ConvDiv、ConvMax。生成实现需通过参考实现的正确性检查,性能分数是逆运行时间,单位 \(1/\mathrm{ms}\)。比较双方使用同一 Pro agent、初始化与评测协议。
| 任务 | Figure 4 报告的比较 | 准确解释 |
|---|---|---|
| VGG16 | 2.43× fewer generations | 达到可比性能时约少 58.8% 次生成,不是 kernel 快 2.43×。 |
| LayerNorm | 1.79× fewer generations | 达到可比性能时约少 44.1% 次生成。 |
| ConvDiv | 2.09× higher score | 相近发现预算下逆耗时分数 2.09 倍,对应候选执行耗时约为对照的 47.8%。 |
| ConvMax | 1.44× higher score | 相近预算下候选执行耗时约为对照的 69.4%。 |
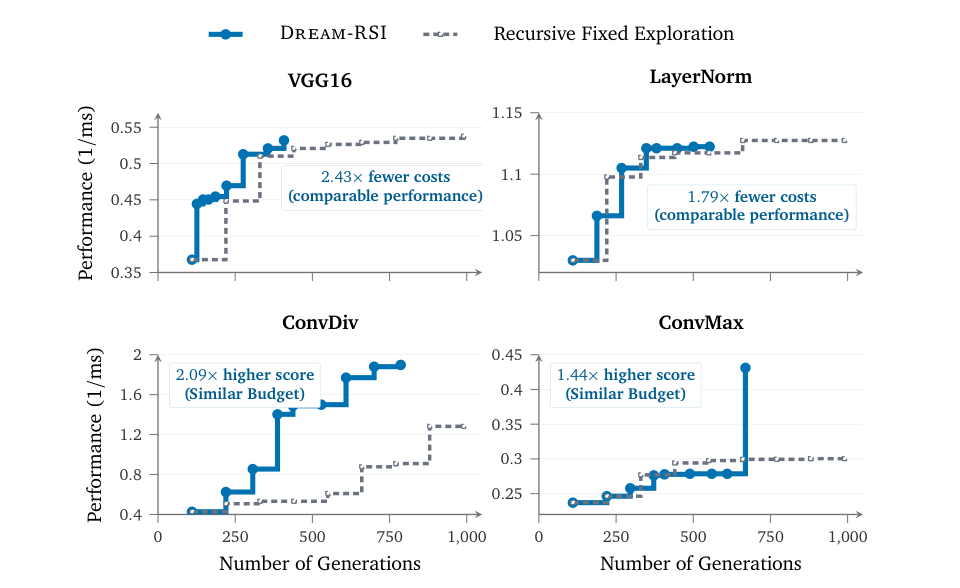
换算百分比是本页依据论文倍率的计算;原图未提供每个点的完整数值表,本页不伪造采样点。四项结果不能外推为 KernelBench 全集表现,论文也没有 user study。
06 / ABLATION & BEHAVIOR
在 ConvDiv 上,作者为固定探索和 Dream-RSI 各加一个版本:将历史总结为高层方向建议,注入后续提示。最终在相近预算下,两个加 Guidance 的版本都弱于各自不加 Guidance 的版本;但原曲线中局部预算段存在交叉,因此“任何预算点都更差”过强。
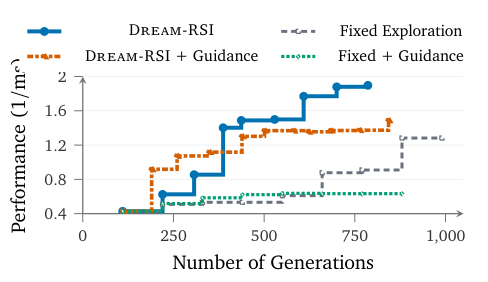
这一具体任务和提示设置中,额外指导没有改善最终质量—预算结果。Dream-RSI 的未加指导版本最终最高。
强方向先验压缩搜索空间、抑制并行多样性。这是对观察到曲线的解释,文中没有直接量化多样性或进行因果干预证明它。
不能由此推出“文本记忆无效”“历史总结普遍有害”或“回放替代所有上下文”。B.1 本来就要求发现 agent 阅读历史,guidance 对照只是多加了一层方向摘要。也没有单独消融“移除并行奖励”“固定 β”“禁用 failure recovery”“只回放一棵树”来拆分各部件贡献。
| 轮次 | E0 | E1 | E2 | E3 | E4 | E5 | E6 | E7 | E8 |
|---|---|---|---|---|---|---|---|---|---|
| 最好性能 / 1/ms | 0.427 | 0.625 | 0.855 | 1.403 | 1.488 | 1.499 | 1.770 | 1.880 | 1.898 |
| 评测尝试数 | 110 | 110 | 87 | 80 | 50 | 92 | 80 | 91 | 86 |
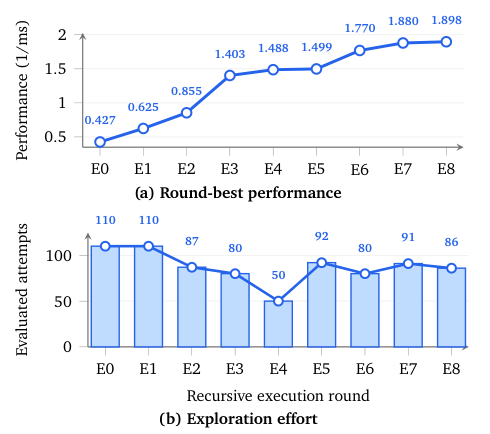
调用数由 110 减少到 E4 的 50,E5 又增加到 92,而较大性能跃升发生在 E6(1.499 → 1.770)。这与“平台后增加探索”的叙述相容,但不是每一次加大预算都立刻换来大收益;附录本身也规定了平台后调整 β 的启发式。仅这一轨迹不能证明某个 β 改动造成某次性能跃升。
07 / PAPER VS. IMPLEMENTATION
截至核查日,官方仓库目录主要为 README、CITATION、展示资产和 PDF,未见完整控制器、回放引擎与 reproduction scripts。README 将它们标记为准备中;因此本页可检查公开提示与附录求解器,无法声称已运行或审计完整 Dream-RSI 系统。仓库 arXiv badge 仍写 coming soon,而论文已发布,是元数据滞后。官方仓库 ↗
| 核查点 | 正文 | 公开附录 / 实现材料 | 影响 |
|---|---|---|---|
| 策略目标 | 最高分 − 节点成本 + 并行量。 | 扫描 β 的 Pareto AUC − parallel penalty。 | 未给等价性;需明确实际实验选择规则。 |
| 新根动作 | 选择公共根,回放揭示最早未见分支。 | legal_roots 提供多个 root cell,可在批次中选择多个。 | 正文抽象接口与提示接口有粒度差异,影响第一批并行与重放语义。 |
| 控制空间 | 选择 leaf / root 批次、停止。 | 额外有 plan_grid、默认 β 的跨轮规则、固定 recovery 组合要求。 | 系统是有强先验的程序优化;不能将全部收益归因于无约束自发策略发现。 |
| 失败判断 | 节点保存诊断。 | 显式规定成功语义,某些 correctness / resource / shape 错误优先视为可修复。 | 固定分类与 helper 可能影响很大,未有独立消融。 |
| 成本 | discovery-agent calls。 | 策略开发也调用 LLM,历史读取与 replay 也消耗计算。 | “零执行成本”限于不重跑发现与评测,非全流程零成本。 |
给出的 Lasso solver 用 C++ / Eigen / OpenMP,外层为沿正则路径 warm-start 的 active-set 优化。先筛去不太可能激活的特征,再在活跃集做 coordinate descent;相关性缓存与 lazy Gram 矩阵减少重复计算,最后通过 KKT 检查确认被排除的特征是否需要纳入。它不是 SimpleTES 所述按规模切换 LARS 与 coordinate descent 的方式。
Cauchy–Schwarz pruning 的作用是“便宜证明暂时无需精确算梯度”:基于一个旧 residual 及梯度锚点,估计 residual 变化能带来的最大梯度变化;若上界仍未超出 KKT 阈值,就跳过精确内积。不能认证时才重算,剪枝失效则刷新锚点。下式是对代码机制的解释性整理,非正文编号公式:
这里 r 是残差而非发现树根;若右侧不超过相应 KKT 阈值,就可避免某次精确梯度计算。这说明发现收益不仅来自数学算法,还来自工程层面的数据布局与缓存。
-fopenmp 与 -ffast-math。这些是公开可见的 discovered solver 工程选择,并非未公开的控制器 bug。它们可能依赖规模与硬件;快速浮点优化与容差检查需要一起复测。不同 CPU、线程数或 BLAS/Eigen 配置下的收益不能直接照搬。Appendix C,pp.23–36
08 / REVIEWER COMMENTARY
表示抓住瓶颈:调度策略与代码生成解耦,已有日志直接成为元层评价素材,避免为每个候选控制器再做整轮真实发现。
可执行而非口头反思:策略写成代码,能在相同记录上重复比较,具有相对清晰的行动与预算接口。
有同模型对照:固定探索共享初始化、agent 与 evaluator;Lasso 另有 held-out 数据,避免仅展示搜索分数。
支持集受限:未走过的后继没有反馈;学会跳过历史坏支不等于能预测新的坏支。
元层验证不足:反复看同一历史池,缺少独立 replay test worlds、跨任务迁移和 replay—online 排名相关性测量。
成本与统计不全:没有充分的重复种子误差、开发开销和硬件协议;跨模型 generation 数不能直接当公平总算力。
Our Interpretation B.1 要求发现 agent 阅读跨分支历史。如果真实运行的调度顺序变了,某次生成时可见的其他分支结果也会变化,进而改变输出。而 replay 固定返回原节点的结果。因此“确定性读取旧记录”是精确的,“这些就是新策略真实在线将产生的结果”并不精确。可靠外推需要假设相关上下文不变,或者明确把回放仅视作经验代理。
这不让回放失去价值:廉价且有偏的代理仍可能筛掉差策略。关键是量化偏差,而不是把有限历史世界等同于完整环境模型。可以针对同一 prefix 重新生成多次,并改变跨分支上下文,测策略排序是否稳定。
以下是研究设想,本文没有在材质生成上验证。可以把每次材料图修改保存为节点:图程序或 SBS/Python、父节点、renderer 配置、渲染图、有效性、图复杂度、感知误差和耗时。控制器选择重开 topology、继续参数优化、修复无效节点或停止;实际动作仍由固定图生成器与优化器执行。
这里 \(R_v\) 是节点材质的渲染图,\(I^{\ast}\) 是目标图。可把 q 替换进回放质量项,但需要另加执行有效性、复杂度或多视角约束,避免低 LPIPS 的 bitmap 捷径。目标图、光照、相机或 renderer 版本一旦改变,旧记录分数未必继续成立。
最小有说服力的实验是:同一目标材质、相同生成器、相同渲染预算,对比固定 beam / 随机 restart / 手工 early-stop / 回放策略;用未参与策略开发的材质与随机种子测试。记录 graph validity、LPIPS、多视角一致性、拓扑多样性与真实渲染成本。若控制器也改变生成 prompt,必须重新评估该动作的结果,不能从旧树凭空补出新图。
09 / SOURCES & READING CHECKLIST
| 要确认的问题 | 原文位置 |
|---|---|
| 系统到底改变什么? | §3,pp.4–6;Figure 1–2。 |
| 不退化保证在哪个范围? | §3,p.6:固定历史池平均 replay score。 |
| Lasso 的优势是否均匀? | Figure 3(a),p.8:必须逐列阅读。 |
| 数学任务有没有输给基线? | Table 1,p.9:Autocorrelation 越低越好。 |
| 控制器靠哪些手工先验? | Appendix B.2,pp.19–23。 |
| 公开代码能复现整套系统吗? | 仓库 release plan;附录 C 仅为发现出的 Lasso solver。 |
本页为中文分析性整理;Paper Verified 表示论文报告的实验观察,不表示本地独立复现;Author Claim、Our Interpretation 与 Research Extension 分别标识作者解释、本页推理和未来设想。原图版权归原作者;本页仅嵌入与论文讨论直接相关的图表。
\(I^{\ast}\) · \(z^{\ast}_{\mathrm{img}}\) · \(z^{\mathrm{img}}_{1:I}\) · \(z_{\lt t}\) · \(P_{\theta}(\mathbf{z}\mid\mathbf{x})\) · \(\beta_1=0.9,\ \beta_2=0.95\)