输入
同一主体的 3–5 张图像、粗粒度 class noun,例如 dog、clock,以及模型 tokenizer 中选出的罕见 identifier。
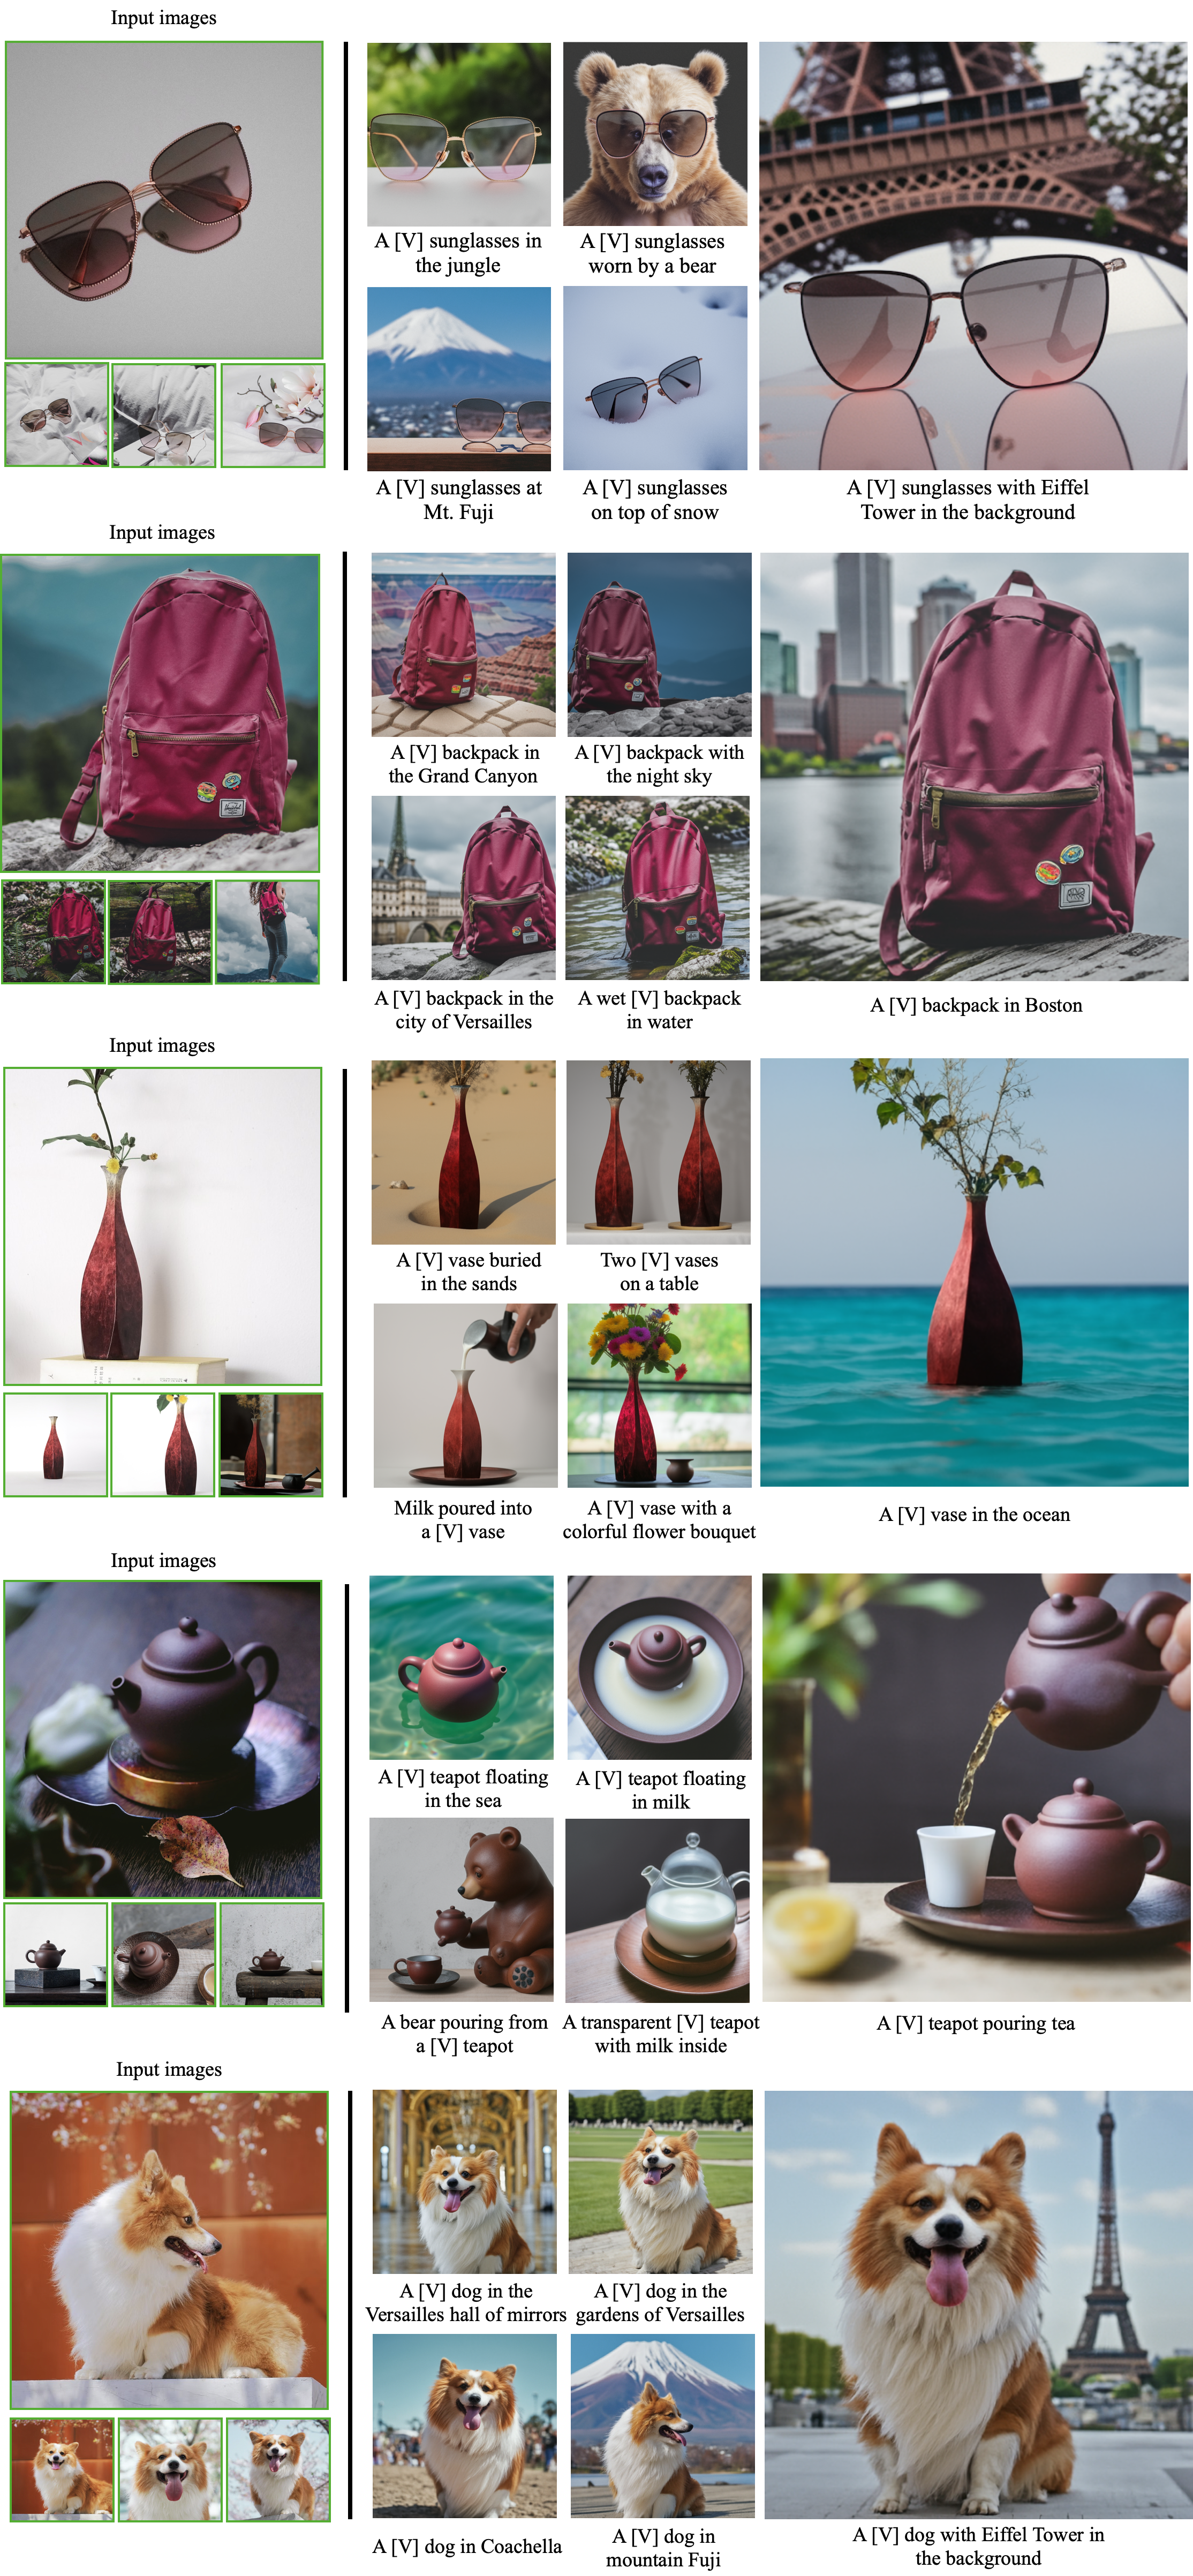
输入同一主体的 3–5 张随手拍照片,DreamBooth 微调整个文本到图像扩散模型,把一个罕见标识符与该主体绑定,再借用模型已有的类别先验生成新场景、新姿态、新视角和艺术表达。
大型文本到图像模型知道“狗”“背包”“闹钟”是什么,却无法仅凭长文本稳定复现某一只狗的脸部纹理、某个背包的形状或某只闹钟右下方独特的数字 3。论文把这个缺口定义为 subject-driven generation。
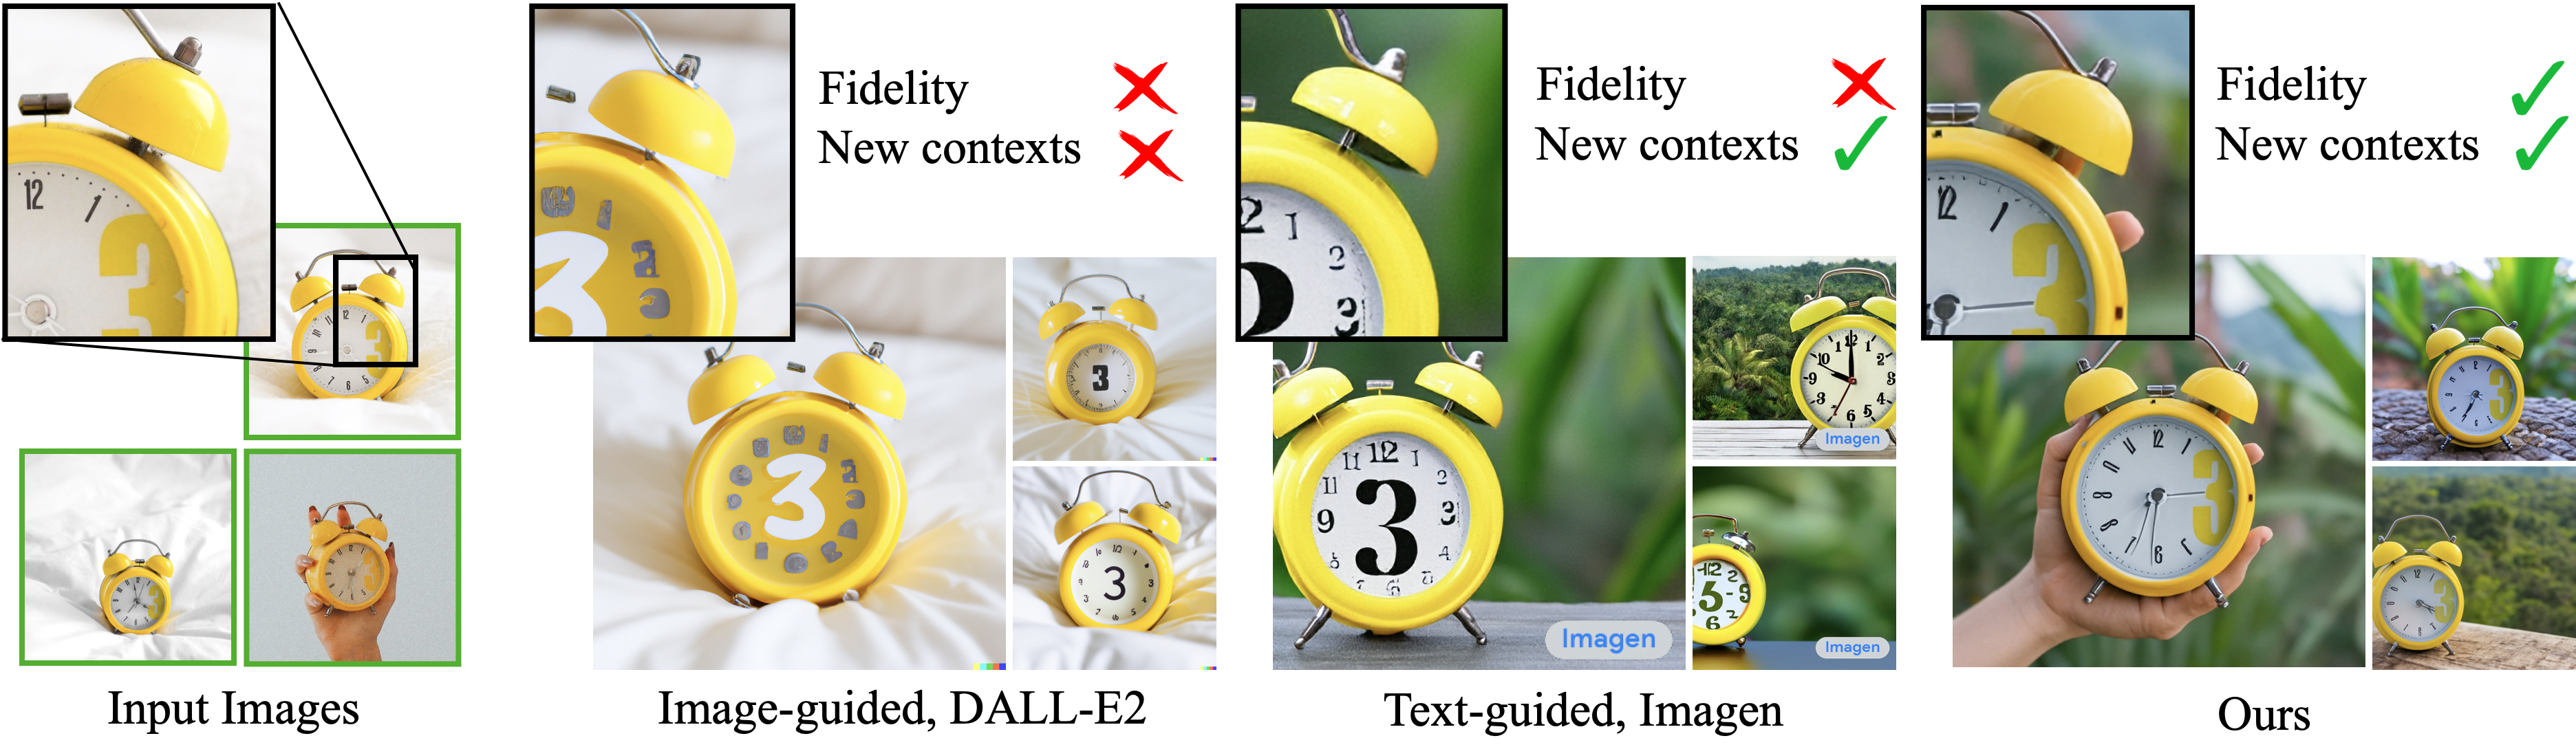
同一主体的 3–5 张图像、粗粒度 class noun,例如 dog、clock,以及模型 tokenizer 中选出的罕见 identifier。
一份主体专用的微调模型。推理提示词把 identifier 与 class noun 放入自然语言句子,模型从随机噪声生成该主体的新图像。
主体重建要求记住实例细节;可编辑性要求保留类别的姿态、视角和场景先验。过度微调会造成语言漂移、训练背景复制与输出多样性下降。
identifier 指定实例,class noun 接入模型已有的类别知识,prior preservation 用冻结原模型自动生成的类别样本约束微调过程。三者共同决定模型记住什么、还能变化多少。
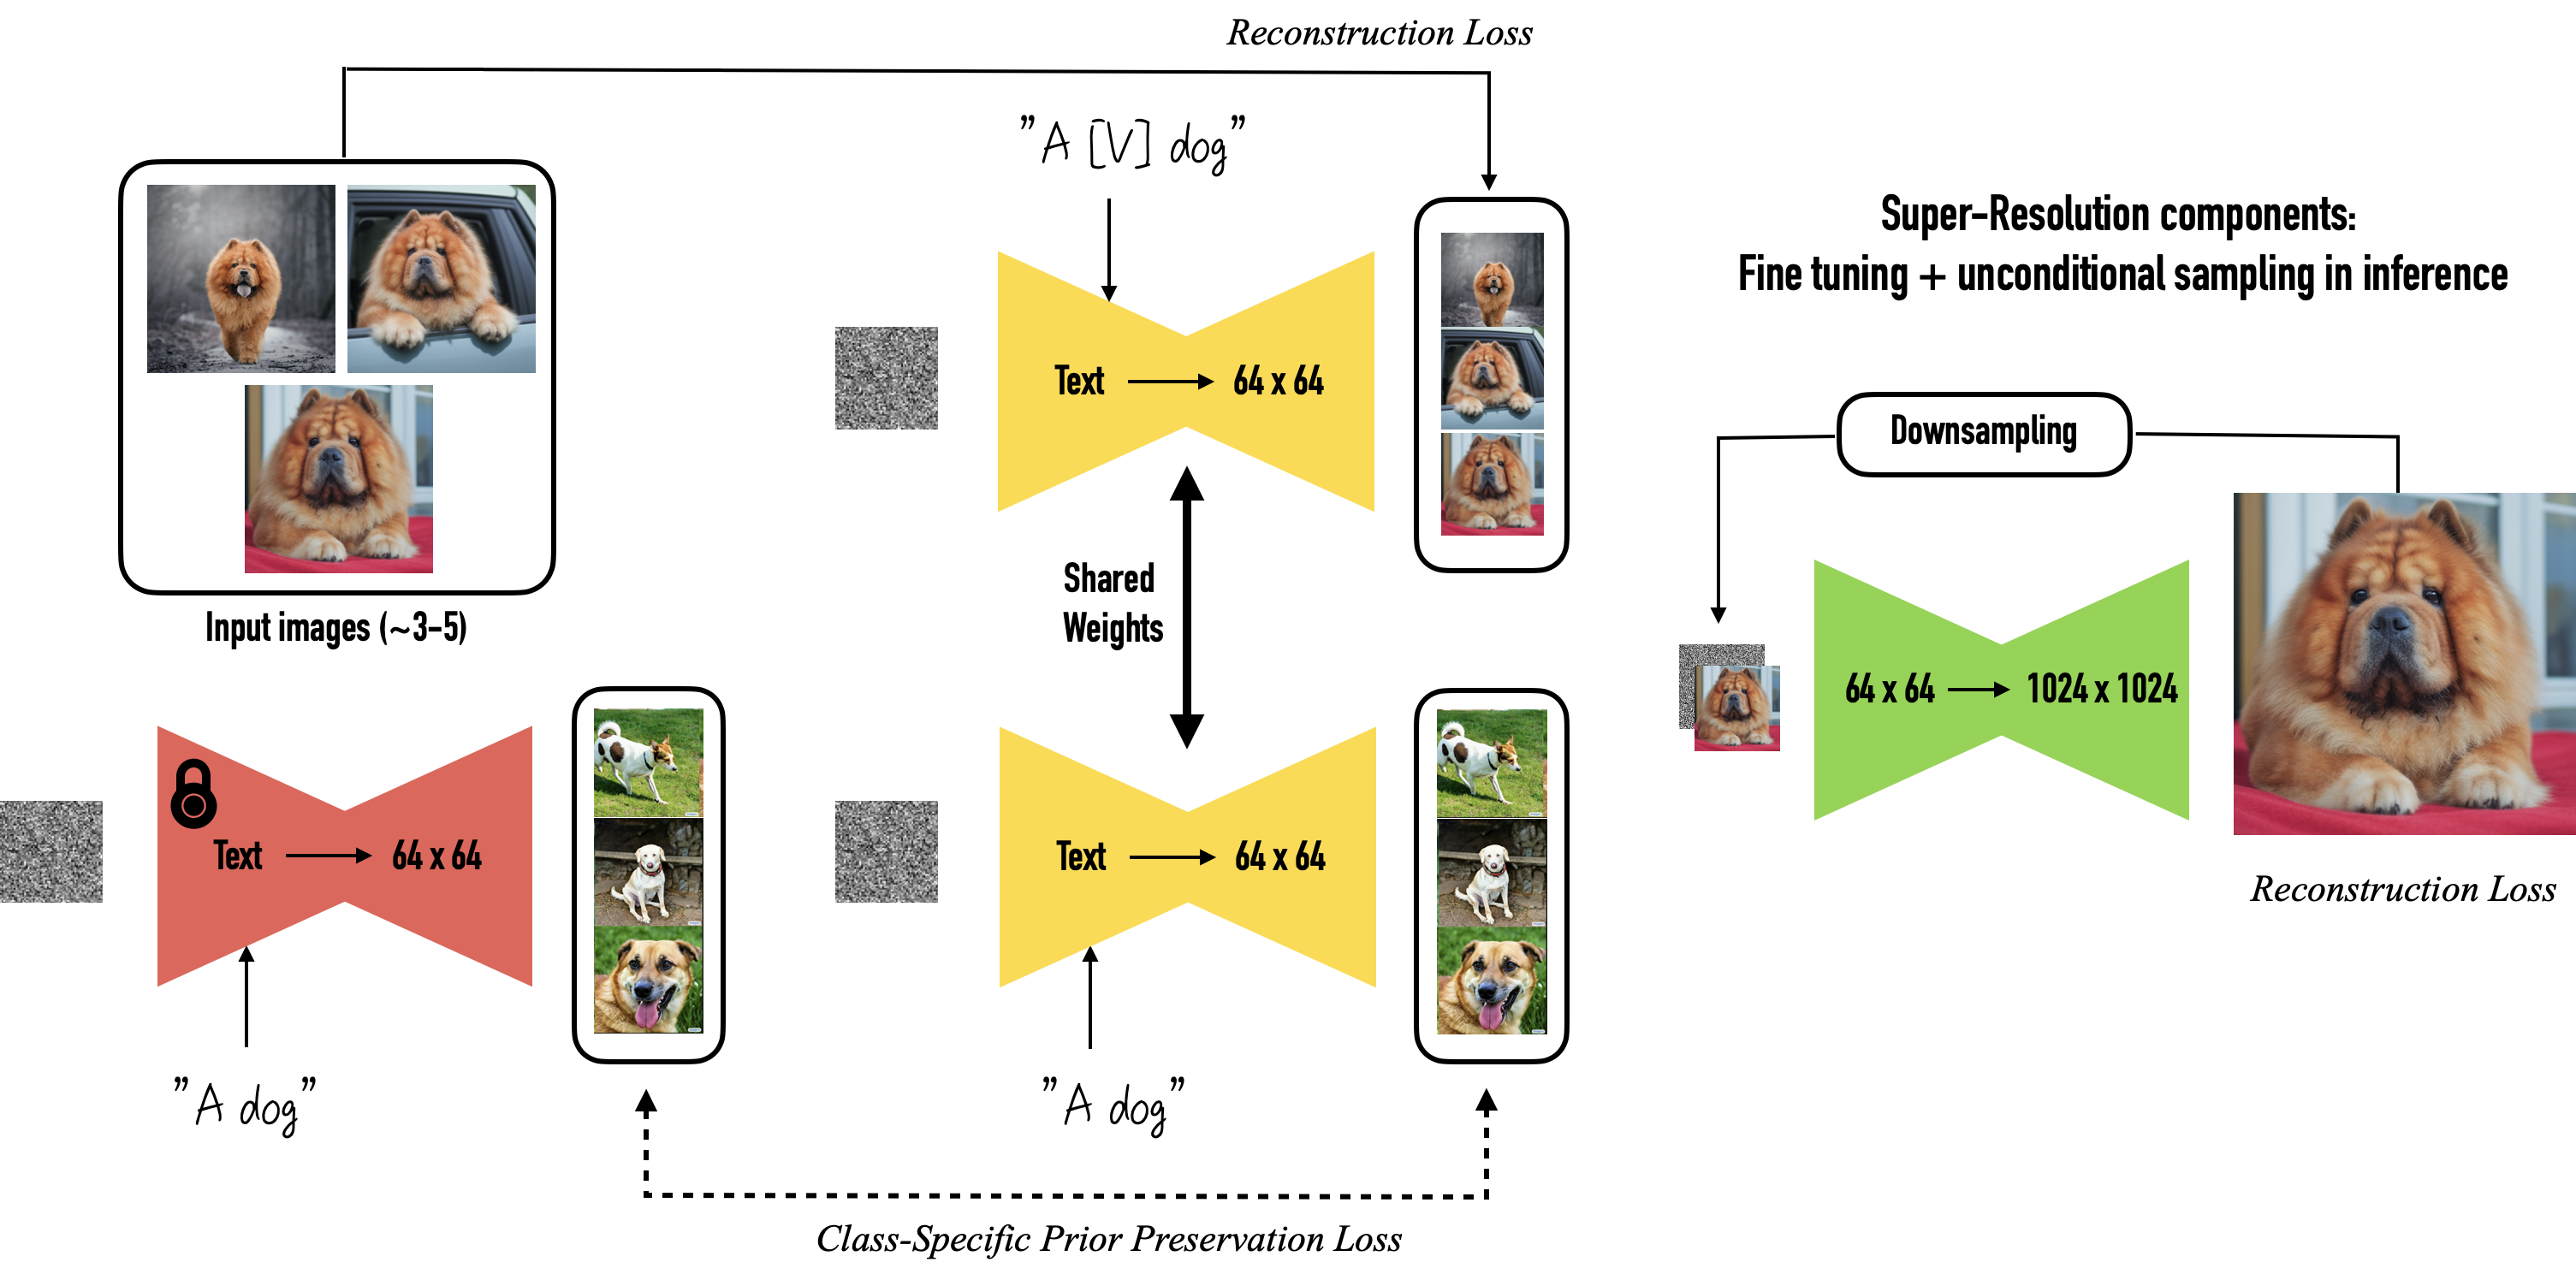
\(\mathbf{x}\) 是干净图像,\(\boldsymbol{\epsilon}\sim\mathcal{N}(\mathbf{0},\mathbf{I})\) 是噪声,\(t\sim\mathcal{U}([0,1])\) 是扩散时间,\(\alpha_t,\sigma_t\) 控制信号与噪声比例,\(w_t\) 是随时间变化的权重,\(\mathbf{c}=\Gamma(f(P))\) 来自提示词 \(P\) 的 tokenizer \(f\) 与文本编码器 \(\Gamma\)。目标训练 \(\widehat{\mathbf{x}}_{\theta}\) 从任意噪声等级预测干净图像。
第一项把真实主体图像 \(\mathbf{x}\) 与 “a [V] [class noun]” 绑定。第二项使用冻结原模型从 “a [class noun]” 采样的 \(\mathbf{x}_{\mathrm{pr}}\),其中 \(\mathbf{c}_{\mathrm{pr}}=\Gamma(f(\text{``a [class noun]''}))\)。\(\lambda=1\) 平衡两项。先生成 prior 样本,再冻结这些目标并微调新模型;“autogenous” 指监督数据来自原模型自身。
a [identifier] [class noun]。常见的 DreamBooth LoRA 实现属于后续工程变体。论文主方法以全层微调获得最高主体保真度,并分别报告 Imagen 与 Stable Diffusion 的实验。
论文没有说明 Stable Diffusion 具体版本、训练分辨率、optimizer、batch size、gradient accumulation、precision、weight decay、scheduler、采样步数、guidance scale 或随机种子。
supplement 允许 deterministic DDIM 或 stochastic ancestral sampler 逐步降低噪声。论文没有锁定最终实验统一使用的 sampler 与步数,也没有 beam search、reranking、外部验证器或 retry。
评测集包含 30 个主体:21 个物体、9 个宠物,共 15 个类别。公开仓库每个主体有 4–6 张图像;方法正文通常使用 3–5 张。物体和宠物各有 25 条评测提示词。
物体:20 条 recontextualization + 5 条 property modification。宠物:10 条 recontextualization + 10 条 accessorization + 5 条 property modification。每个主体、每条提示词生成 4 张,共 \(30\times25\times4=3000\) 张。
DINO:生成图与全部真实图的 ViT-S/16 DINO embedding 平均余弦相似度,强调实例细节。CLIP-I:CLIP image embedding 的同类相似度。CLIP-T:生成图与提示词的 CLIP 相似度。
| 方法 | DINO ↑ | CLIP-I ↑ | CLIP-T ↑ |
|---|---|---|---|
| Real Images | 0.774 | 0.885 | N/A |
| DreamBooth (Imagen) | 0.696 | 0.812 | 0.306 |
| DreamBooth (Stable Diffusion) | 0.668 | 0.803 | 0.305 |
| Textual Inversion (Stable Diffusion) | 0.569 | 0.780 | 0.255 |
Real Images 是同一主体不同真实照片之间的参考分数,反映经验性 ceiling;它并非严格理论上界,生成图可能因构图等因素出现不同相似度。Imagen 与 Stable Diffusion 的参数量、训练语料和生成质量不同,因此两行差距不能独立归因于 DreamBooth 训练细节。与 Textual Inversion 的同底模比较使用 Stable Diffusion,公平性更强。
| 选择 | 主体保真 | 提示词保真 |
|---|---|---|
| DreamBooth (Stable Diffusion) | 68% | 81% |
| Textual Inversion (Stable Diffusion) | 22% | 12% |
| 无法判断 / 同等 | 10% | 7% |
| Imagen 配置 | PRES ↓ | DIV ↑ | DINO ↑ | CLIP-I ↑ | CLIP-T ↑ |
|---|---|---|---|---|---|
| DreamBooth w/ PPL | 0.493 | 0.391 | 0.684 | 0.815 | 0.308 |
| DreamBooth w/o PPL | 0.664 | 0.371 | 0.712 | 0.828 | 0.306 |
PRES 衡量“用纯 class prompt 生成的随机同类”与目标主体的 DINO 相似度,数值越高表示类别分布越坍缩到该主体。正文把 DIV 描述为相同提示词生成图之间的“average LPIPS cosine similarity”,同时表头把更高值视为更多样;该术语与常见 LPIPS distance 口径存在歧义,论文没有给出实现细节,本页保留原方向。PPL 使 PRES 从 0.664 降至 0.493、DIV 从 0.371 升至 0.391,同时 DINO 从 0.712 降至 0.684、CLIP-I 从 0.828 降至 0.815,直接呈现类别多样性与实例相似度的取舍。
| 训练提示词中的类别 | DINO ↑ | CLIP-I ↑ | 现象 |
|---|---|---|---|
| Correct Class | 0.744 | 0.853 | 接入正确类别先验,收敛与主体保持最佳 |
| No Class | 0.303 | 0.607 | 难以学习主体,容易生成错误样本 |
| Wrong Class | 0.454 | 0.728 | 类别形状与实例冲突,例如背包向圆柱罐形状偏移 |
| 主体 | 1 张 | 2 张 | 3 张 | 4 张 | 5 张 |
|---|---|---|---|---|---|
| Backpack | 0.494 | 0.515 | 0.596 | 0.604 | 0.597 |
| Dog | 0.798 | 0.851 | 0.871 | 0.876 | 0.864 |
| 主体 | 1 张 | 2 张 | 3 张 | 4 张 | 5 张 |
|---|---|---|---|---|---|
| Backpack | 0.798 | 0.851 | 0.871 | 0.876 | 0.864 |
| Dog | 0.646 | 0.683 | 0.734 | 0.740 | 0.730 |
两张 supplement 表逐字重建正式 PDF 数值。作者对两个主体各训练 1–5 张图的五个模型,每个模型用 10 条 recontextualization 提示词、每条生成 4 张。原始 prompt-fidelity 表的 Backpack 行 0.798 / 0.851 / 0.871 / 0.876 / 0.864 与上一张 DINO 表的 Dog 行完全重复,且相对主表 CLIP-T 数量级异常偏高;作者没有提供原始结果文件用于复核,本页保留正式 PDF 数字,不据此推断精确效应大小。两表报告的峰值都在 4 张。
不微调 SR 会幻觉式添加高频纹理;沿用 Imagen 原训练噪声 \(10^{-3}\) 会模糊高频细节;把 256 SR 微调噪声降到 \(10^{-5}\) 可减少两类问题。64→256 SR 对多数主体关键,256→1024 SR 对高细节主体有帮助。
正文比较了常见词、随机字符和 tokenizer 罕见 token 的失效机理,给出 Imagen token 范围与字符长度规则。正式论文没有 identifier 的数值消融,也没有公开每个主体实际使用的 token。
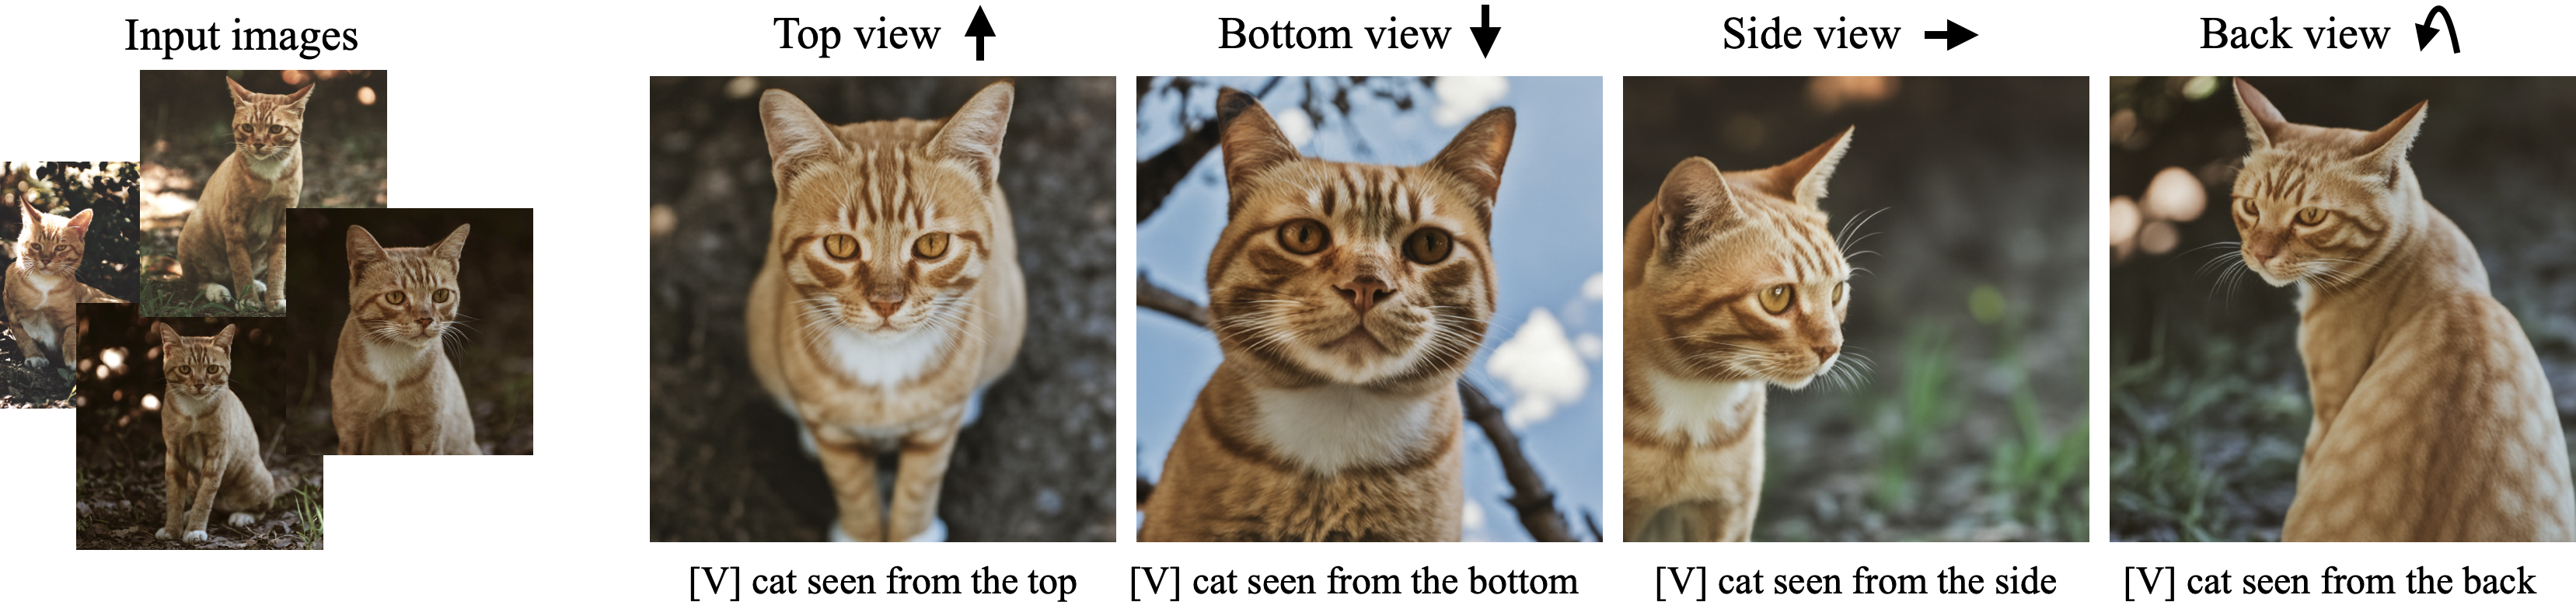
个性化生成可以减少通用模型对主体属性的偏置,也能制造误导性图片。论文只做定性风险声明,没有水印、身份授权、训练图删除、滥用检测或隐私实验。
本页完整核查 CVPR 正式主文、正式 supplement、本地 arXiv v2 合订 PDF、官方项目页与官方数据仓库。所有主表和 supplement 的图像数量表均重建为 HTML。Figure 2、3、6、7 直接嵌入官方项目资源并离线保存。论文未披露的训练和采样设置保持未确认。