CVPR 2023 · SUBJECT-DRIVEN GENERATION

给扩散模型
教会一个具体的“谁”

输入同一主体的 3–5 张随手拍照片,DreamBooth 微调整个文本到图像扩散模型,把一个罕见标识符与该主体绑定,再借用模型已有的类别先验生成新场景、新姿态、新视角和艺术表达。

Nataniel Ruiz 等Google Research · Boston UniversityCVPR 2023 · 22500–22510arXiv:2208.12242v2
3–5典型主体输入图像数量
1,000论文建议微调迭代与 class prior 样本数量
30评测主体,覆盖 15 个类别
3,000评测生成图像总量
01 · RESEARCH GAP

文本会描述类别,却很难精确指向用户手中的那个实例

大型文本到图像模型知道“狗”“背包”“闹钟”是什么,却无法仅凭长文本稳定复现某一只狗的脸部纹理、某个背包的形状或某只闹钟右下方独特的数字 3。论文把这个缺口定义为 subject-driven generation。
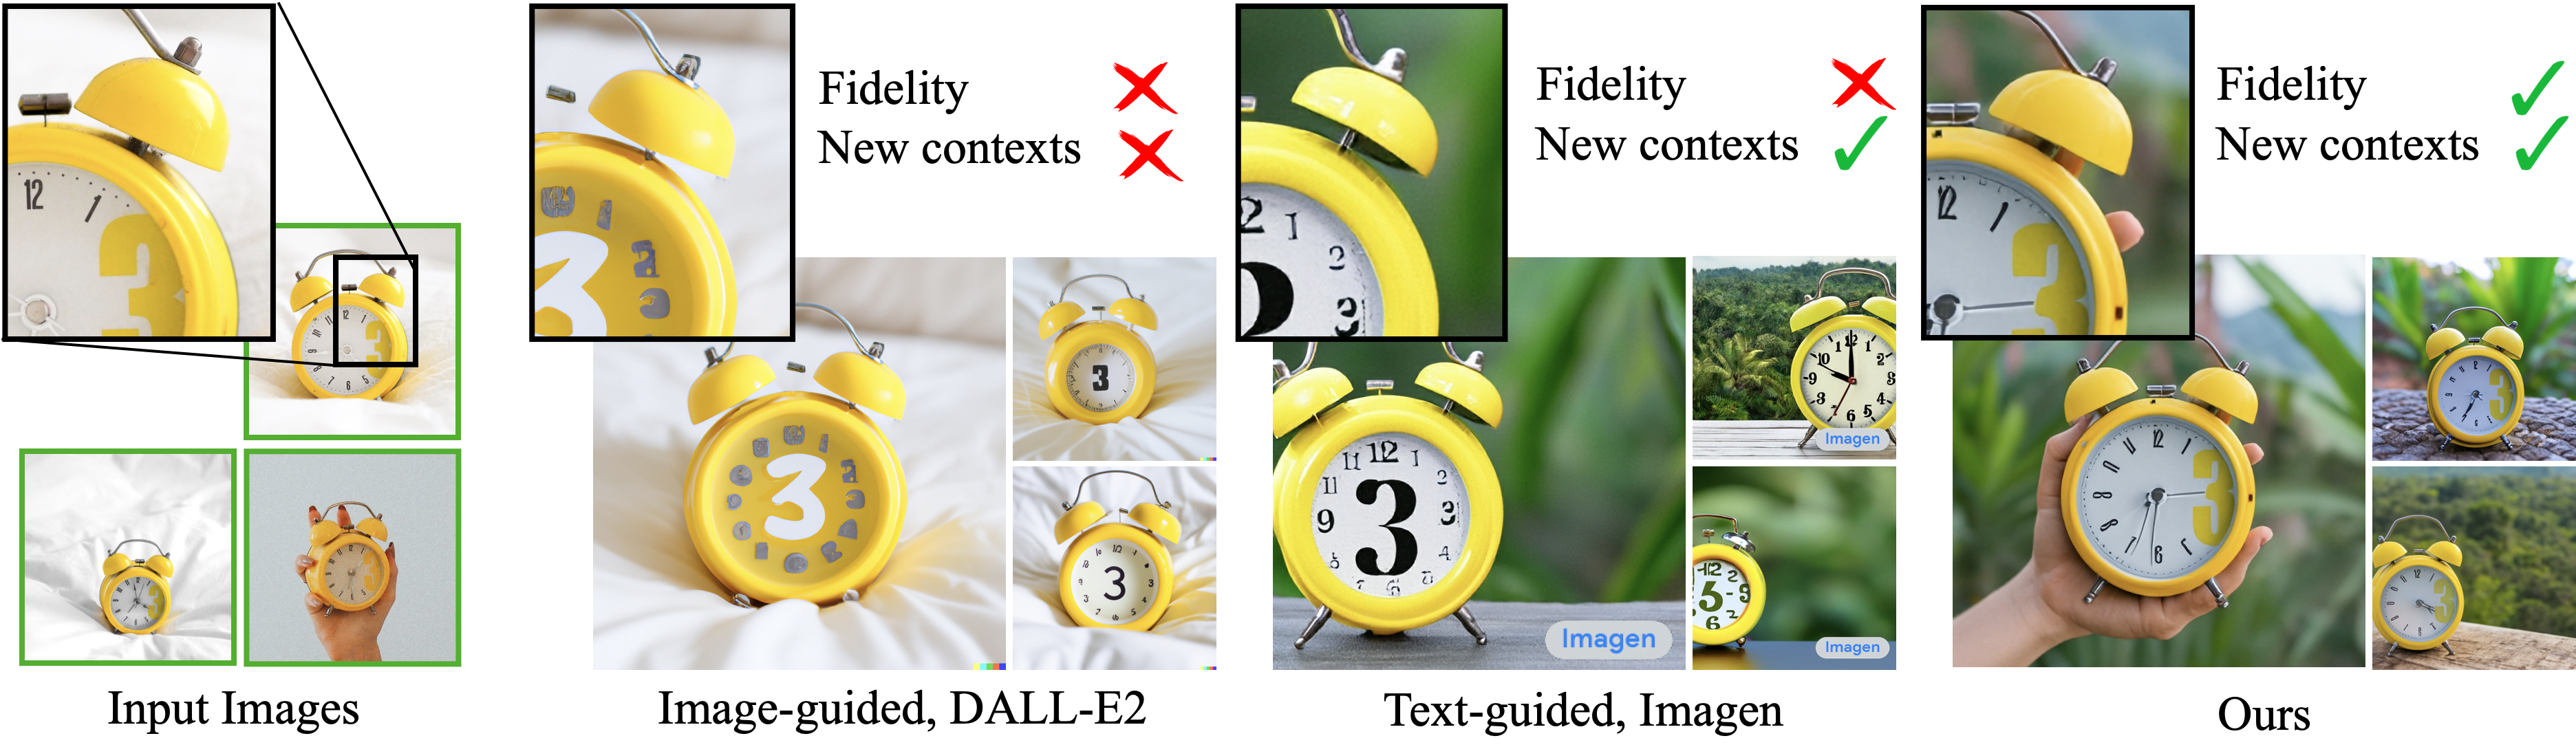
DreamBooth 官方项目页展示 DALL-E 2、Imagen 与 DreamBooth 的主体保持比较
Figure 2(官方原图)。共享视觉语义空间的 DALL-E 2 图像变体与经过详尽提示词工程的 Imagen,都没有同时保留黄色闹钟的精细身份特征和新环境;DreamBooth 用 “a [V] clock in the jungle” 指向该实例。

输入

同一主体的 3–5 张图像、粗粒度 class noun,例如 dog、clock,以及模型 tokenizer 中选出的罕见 identifier。

输出

一份主体专用的微调模型。推理提示词把 identifier 与 class noun 放入自然语言句子,模型从随机噪声生成该主体的新图像。

核心张力

主体重建要求记住实例细节;可编辑性要求保留类别的姿态、视角和场景先验。过度微调会造成语言漂移、训练背景复制与输出多样性下降。

Paper Verified论文证明了图像级身份相似度、提示词相似度和人类偏好上的优势,并展示多种新上下文。它没有恢复显式三维几何,因此“text-guided view synthesis”属于视角条件图像生成;跨视角几何一致性没有被测量。
02 · METHOD

identifier、class noun 与 prior preservation 构成一套互相制约的记忆机制

identifier 指定实例,class noun 接入模型已有的类别知识,prior preservation 用冻结原模型自动生成的类别样本约束微调过程。三者共同决定模型记住什么、还能变化多少。
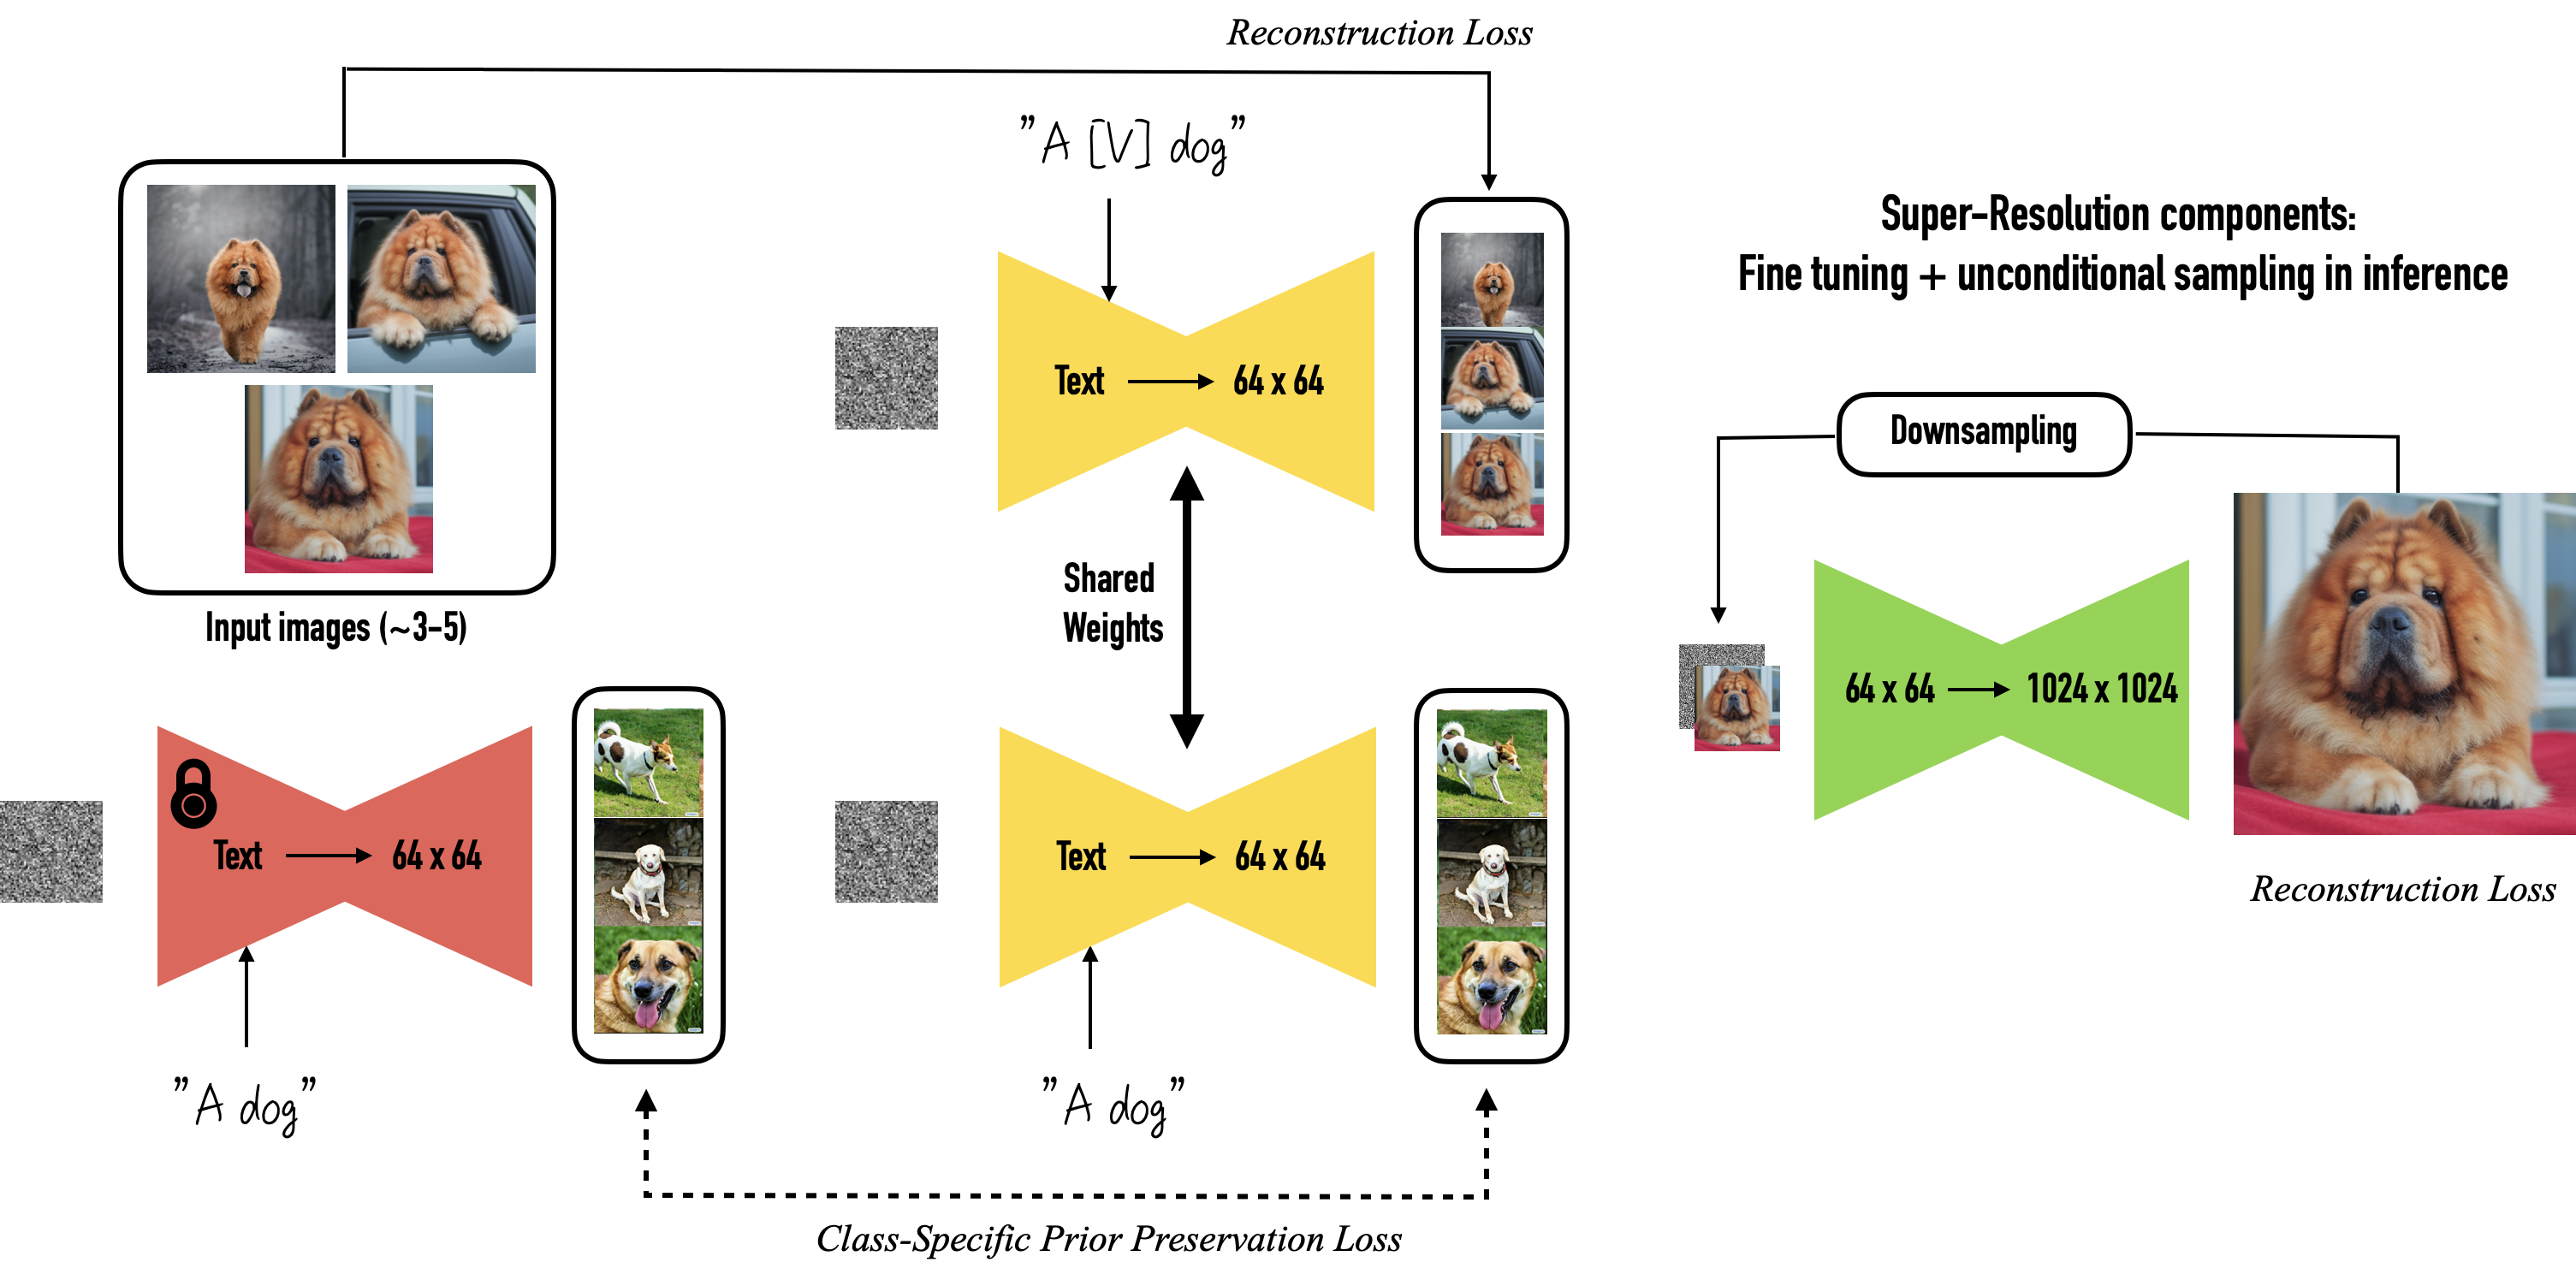
DreamBooth 官方方法流程原图
Figure 3(官方原图)。主体重建分支使用 “a [V] dog” 与用户图像;类别先验分支使用 “a dog” 与冻结原模型生成的同类图像。两项损失同时更新个性化模型。

扩散模型基础目标

\[ \mathcal{L}_{\mathrm{diff}}(\theta)= \mathbb{E}_{\mathbf{x},\mathbf{c},\boldsymbol{\epsilon},t} \left[w_t\left\|\widehat{\mathbf{x}}_{\theta} (\alpha_t\mathbf{x}+\sigma_t\boldsymbol{\epsilon},\mathbf{c})-\mathbf{x}\right\|_2^2\right] \]

\(\mathbf{x}\) 是干净图像,\(\boldsymbol{\epsilon}\sim\mathcal{N}(\mathbf{0},\mathbf{I})\) 是噪声,\(t\sim\mathcal{U}([0,1])\) 是扩散时间,\(\alpha_t,\sigma_t\) 控制信号与噪声比例,\(w_t\) 是随时间变化的权重,\(\mathbf{c}=\Gamma(f(P))\) 来自提示词 \(P\) 的 tokenizer \(f\) 与文本编码器 \(\Gamma\)。目标训练 \(\widehat{\mathbf{x}}_{\theta}\) 从任意噪声等级预测干净图像。

DreamBooth 双目标

\[ \begin{aligned} \mathcal{L}_{\mathrm{DB}}(\theta)=\mathbb{E}_{\mathbf{x},\mathbf{c},\boldsymbol{\epsilon},\boldsymbol{\epsilon}^{\prime},t,t^{\prime}}\Big[& w_t\left\|\widehat{\mathbf{x}}_{\theta}(\alpha_t\mathbf{x}+\sigma_t\boldsymbol{\epsilon},\mathbf{c})-\mathbf{x}\right\|_2^2\\ &+\lambda w_{t^{\prime}}\left\|\widehat{\mathbf{x}}_{\theta}(\alpha_{t^{\prime}}\mathbf{x}_{\mathrm{pr}}+\sigma_{t^{\prime}}\boldsymbol{\epsilon}^{\prime},\mathbf{c}_{\mathrm{pr}})-\mathbf{x}_{\mathrm{pr}}\right\|_2^2\Big] \end{aligned} \]

第一项把真实主体图像 \(\mathbf{x}\) 与 “a [V] [class noun]” 绑定。第二项使用冻结原模型从 “a [class noun]” 采样的 \(\mathbf{x}_{\mathrm{pr}}\),其中 \(\mathbf{c}_{\mathrm{pr}}=\Gamma(f(\text{``a [class noun]''}))\)。\(\lambda=1\) 平衡两项。先生成 prior 样本,再冻结这些目标并微调新模型;“autogenous” 指监督数据来自原模型自身。

罕见 identifier 如何选择

  • 常见英文词带有原语义,微调需要先解开旧含义。
  • 随机字符也可能被 SentencePiece 拆成常见字母 token,仍带强先验。
  • Imagen 从 T5-XXL tokenizer 的 token 编号 5000–10000 均匀采样,限制为不含空格、解码后至多 3 个 Unicode 字符。
  • 短 token 序列长度 \(k\in\{1,2,3\}\) 可用;detokenize 得到可写入提示词的字符序列 \(\widehat{V}\)。

class noun 的作用

  • 提示词模板为 a [identifier] [class noun]。
  • 类别词把主体实例连接到预训练模型中的姿态、结构和场景分布。
  • 错误类别会与实例形状冲突;缺少类别会增加学习难度和语言漂移。
  • 类别可由用户提供或分类器产生,论文实验直接使用已知类别。
Evidence Boundary论文详细说明 identifier 的 tokenizer 设计动机,却没有给出常见词、随机字符与罕见 token 的独立定量表。该设计的效果主要来自作者经验陈述;class noun 与 prior preservation 另有直接消融。
03 · TRAINING & INFERENCE

原始方法微调整个 Imagen 级联;Stable Diffusion 是单阶段潜空间附录验证

常见的 DreamBooth LoRA 实现属于后续工程变体。论文主方法以全层微调获得最高主体保真度,并分别报告 Imagen 与 Stable Diffusion 的实验。

01 · PREPARE收集 3–5 张主体图像,选择 class noun 与罕见 identifier
02 · SAMPLE PRIOR冻结原模型,用 “a [class noun]” 生成约 1,000 张类别图像
03 · PERSONALIZE主体重建损失与 prior preservation 同时微调约 1,000 步
04 · SUPER-RESOLVEImagen 继续微调 SR 组件,降低噪声增强以保留细节
05 · GENERATE把 [V] 与类别词插入新提示词,从随机噪声迭代去噪

Imagen:主实验配置

文本编码冻结 T5-XXL + SentencePiece
生成级联64×64 base;64→256 SR;256→1024 SR
微调范围论文称最高保真度来自所有层
学习率\(10^{-5}\)
迭代 / \(\lambda\)约 1,000 / 1
prior 样本约 1,000,可少于该数
硬件 / 时间单个 TPU v4,约 5 分钟
SR 噪声增强256 SR 微调从 \(10^{-3}\) 降到 \(10^{-5}\)

Stable Diffusion:论文补充配置

生成空间单个 latent diffusion U-Net + 固定 decoder
可训练部分U-Net;supplement 表示文本编码器也可训练
学习率\(5\times10^{-6}\)
迭代 / \(\lambda\)约 1,000 / 1
硬件 / 时间单个 NVIDIA A100,约 5 分钟
额外 SR 阶段没有 Imagen 式级联 SR 微调

论文没有说明 Stable Diffusion 具体版本、训练分辨率、optimizer、batch size、gradient accumulation、precision、weight decay、scheduler、采样步数、guidance scale 或随机种子。

\[ \mathbf{z}_{t_1}\sim\mathcal{N}(\mathbf{0},\mathbf{I}),\qquad 1=t_1\gt\cdots\gt t_T=0,\qquad \widehat{\mathbf{x}}_{t_i}=\widehat{\mathbf{x}}_{\theta}(\mathbf{z}_{t_i},\mathbf{c}) \]

supplement 允许 deterministic DDIM 或 stochastic ancestral sampler 逐步降低噪声。论文没有锁定最终实验统一使用的 sampler 与步数,也没有 beam search、reranking、外部验证器或 retry。

Paper vs. Common Implementations论文所称 DreamBooth 是模型权重的全层 fine-tuning,并使用原模型生成的 class prior 样本。LoRA、低秩 adapter、8-bit optimizer、xFormers、社区默认 prompt 和 WebUI 训练参数均未构成论文方法事实;官方 GitHub 仓库只发布数据集与 prompts。
04 · DATA & RESULTS

身份保真与提示词服从被分开测量,DreamBooth 在两者上同时领先 Textual Inversion

评测集包含 30 个主体:21 个物体、9 个宠物,共 15 个类别。公开仓库每个主体有 4–6 张图像;方法正文通常使用 3–5 张。物体和宠物各有 25 条评测提示词。

评测提示词

物体:20 条 recontextualization + 5 条 property modification。宠物:10 条 recontextualization + 10 条 accessorization + 5 条 property modification。每个主体、每条提示词生成 4 张,共 \(30\times25\times4=3000\) 张。

三项自动指标

DINO:生成图与全部真实图的 ViT-S/16 DINO embedding 平均余弦相似度,强调实例细节。CLIP-I:CLIP image embedding 的同类相似度。CLIP-T:生成图与提示词的 CLIP 相似度。

Table 1 · 主体与提示词保真度

方法DINO ↑CLIP-I ↑CLIP-T ↑
Real Images0.7740.885N/A
DreamBooth (Imagen)0.6960.8120.306
DreamBooth (Stable Diffusion)0.6680.8030.305
Textual Inversion (Stable Diffusion)0.5690.7800.255

Real Images 是同一主体不同真实照片之间的参考分数,反映经验性 ceiling;它并非严格理论上界,生成图可能因构图等因素出现不同相似度。Imagen 与 Stable Diffusion 的参数量、训练语料和生成质量不同,因此两行差距不能独立归因于 DreamBooth 训练细节。与 Textual Inversion 的同底模比较使用 Stable Diffusion,公平性更强。

Table 2 · 用户偏好

选择主体保真提示词保真
DreamBooth (Stable Diffusion)68%81%
Textual Inversion (Stable Diffusion)22%12%
无法判断 / 同等10%7%
User Study Protocol主体保真与提示词保真各招募 72 位用户;每份问卷 25 个成对问题,每对由 3 人评价,总计 1,800 个回答、600 个图像对,以多数票聚合。DINO 与归一化人类主体偏好的 Pearson 相关系数为 0.32,CLIP-I 为 0.27;DINO 的 \(p=9.44\times10^{-30}\)。
DreamBooth 官方项目页重场景化结果
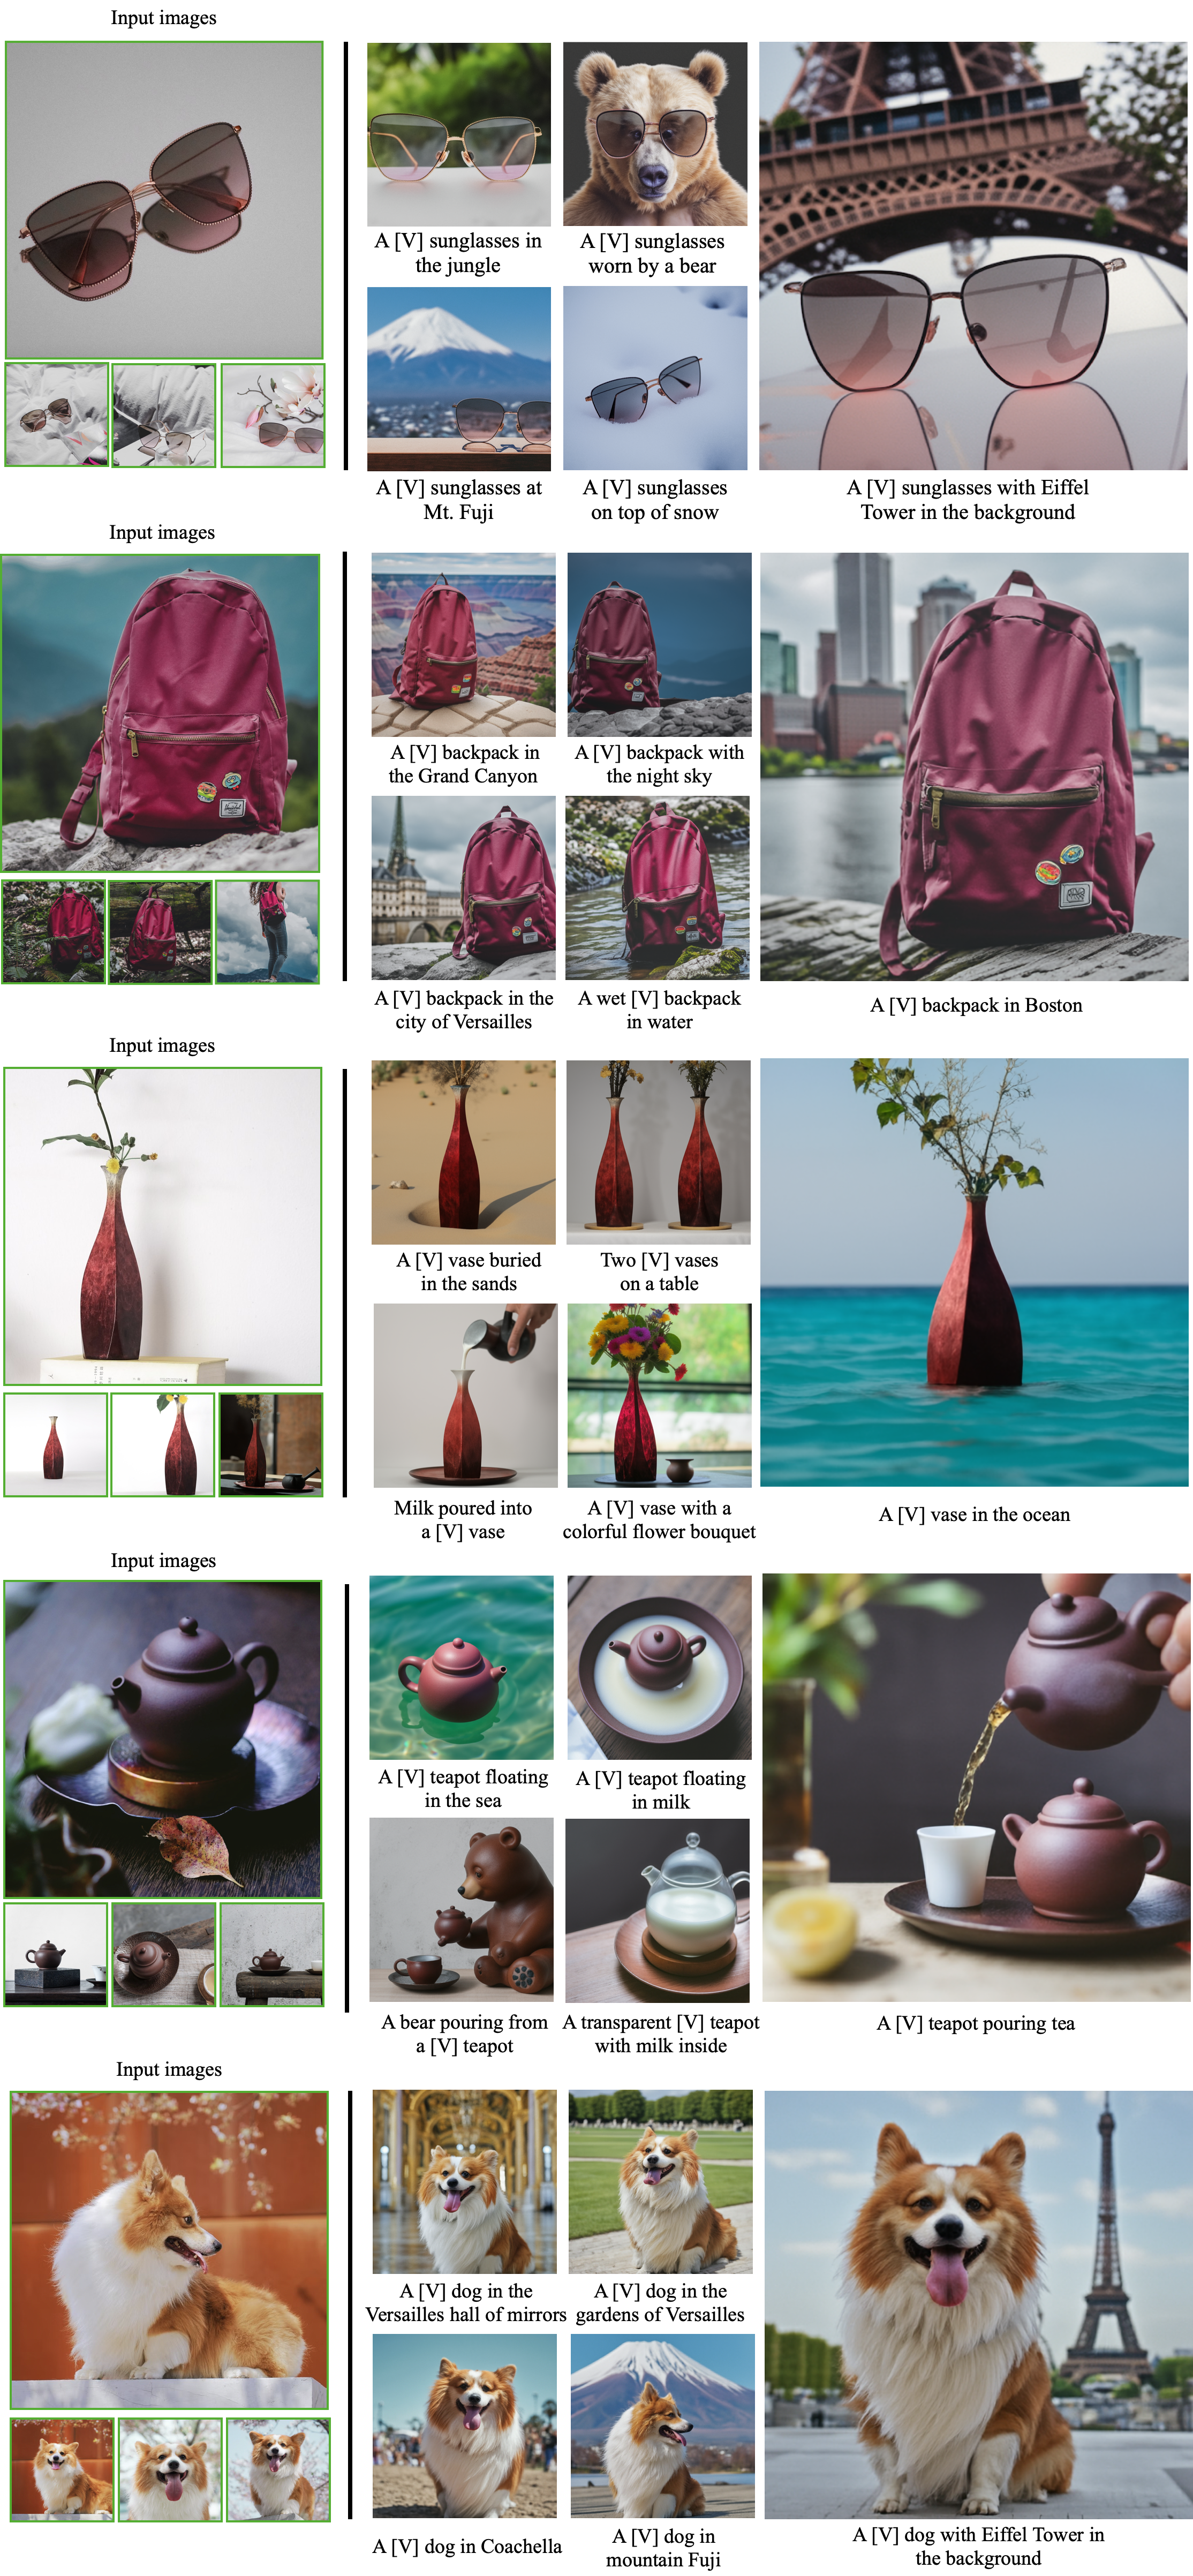
Figure 6(官方原图)。背包和花瓶在不同环境中的 recontextualization。该图说明主体细节与场景交互可以同时出现;单张定性结果不能验证跨样本稳定性。
05 · ABLATIONS

PPL 牺牲少量实例相似度换取类别先验与多样性,正确 class noun 是主体学习的关键支点

Table 3 · Prior preservation loss

Imagen 配置PRES ↓DIV ↑DINO ↑CLIP-I ↑CLIP-T ↑
DreamBooth w/ PPL0.4930.3910.6840.8150.308
DreamBooth w/o PPL0.6640.3710.7120.8280.306

PRES 衡量“用纯 class prompt 生成的随机同类”与目标主体的 DINO 相似度,数值越高表示类别分布越坍缩到该主体。正文把 DIV 描述为相同提示词生成图之间的“average LPIPS cosine similarity”,同时表头把更高值视为更多样;该术语与常见 LPIPS distance 口径存在歧义,论文没有给出实现细节,本页保留原方向。PPL 使 PRES 从 0.664 降至 0.493、DIV 从 0.371 升至 0.391,同时 DINO 从 0.712 降至 0.684、CLIP-I 从 0.828 降至 0.815,直接呈现类别多样性与实例相似度的取舍。

Table 4 · Class noun

训练提示词中的类别DINO ↑CLIP-I ↑现象
Correct Class0.7440.853接入正确类别先验,收敛与主体保持最佳
No Class0.3030.607难以学习主体,容易生成错误样本
Wrong Class0.4540.728类别形状与实例冲突,例如背包向圆柱罐形状偏移

Supplement Table 1 · 输入图像数量对 DINO 的影响

主体1 张2 张3 张4 张5 张
Backpack0.4940.5150.5960.6040.597
Dog0.7980.8510.8710.8760.864

Supplement Table 2 · 输入图像数量对 prompt fidelity 的影响

主体1 张2 张3 张4 张5 张
Backpack0.7980.8510.8710.8760.864
Dog0.6460.6830.7340.7400.730

两张 supplement 表逐字重建正式 PDF 数值。作者对两个主体各训练 1–5 张图的五个模型,每个模型用 10 条 recontextualization 提示词、每条生成 4 张。原始 prompt-fidelity 表的 Backpack 行 0.798 / 0.851 / 0.871 / 0.876 / 0.864 与上一张 DINO 表的 Dog 行完全重复,且相对主表 CLIP-T 数量级异常偏高;作者没有提供原始结果文件用于复核,本页保留正式 PDF 数字,不据此推断精确效应大小。两表报告的峰值都在 4 张。

Imagen SR 消融

不微调 SR 会幻觉式添加高频纹理;沿用 Imagen 原训练噪声 \(10^{-3}\) 会模糊高频细节;把 256 SR 微调噪声降到 \(10^{-5}\) 可减少两类问题。64→256 SR 对多数主体关键,256→1024 SR 对高细节主体有帮助。

Identifier 证据强度

正文比较了常见词、随机字符和 tokenizer 罕见 token 的失效机理,给出 Imagen token 范围与字符长度规则。正式论文没有 identifier 的数值消融,也没有公开每个主体实际使用的 token。
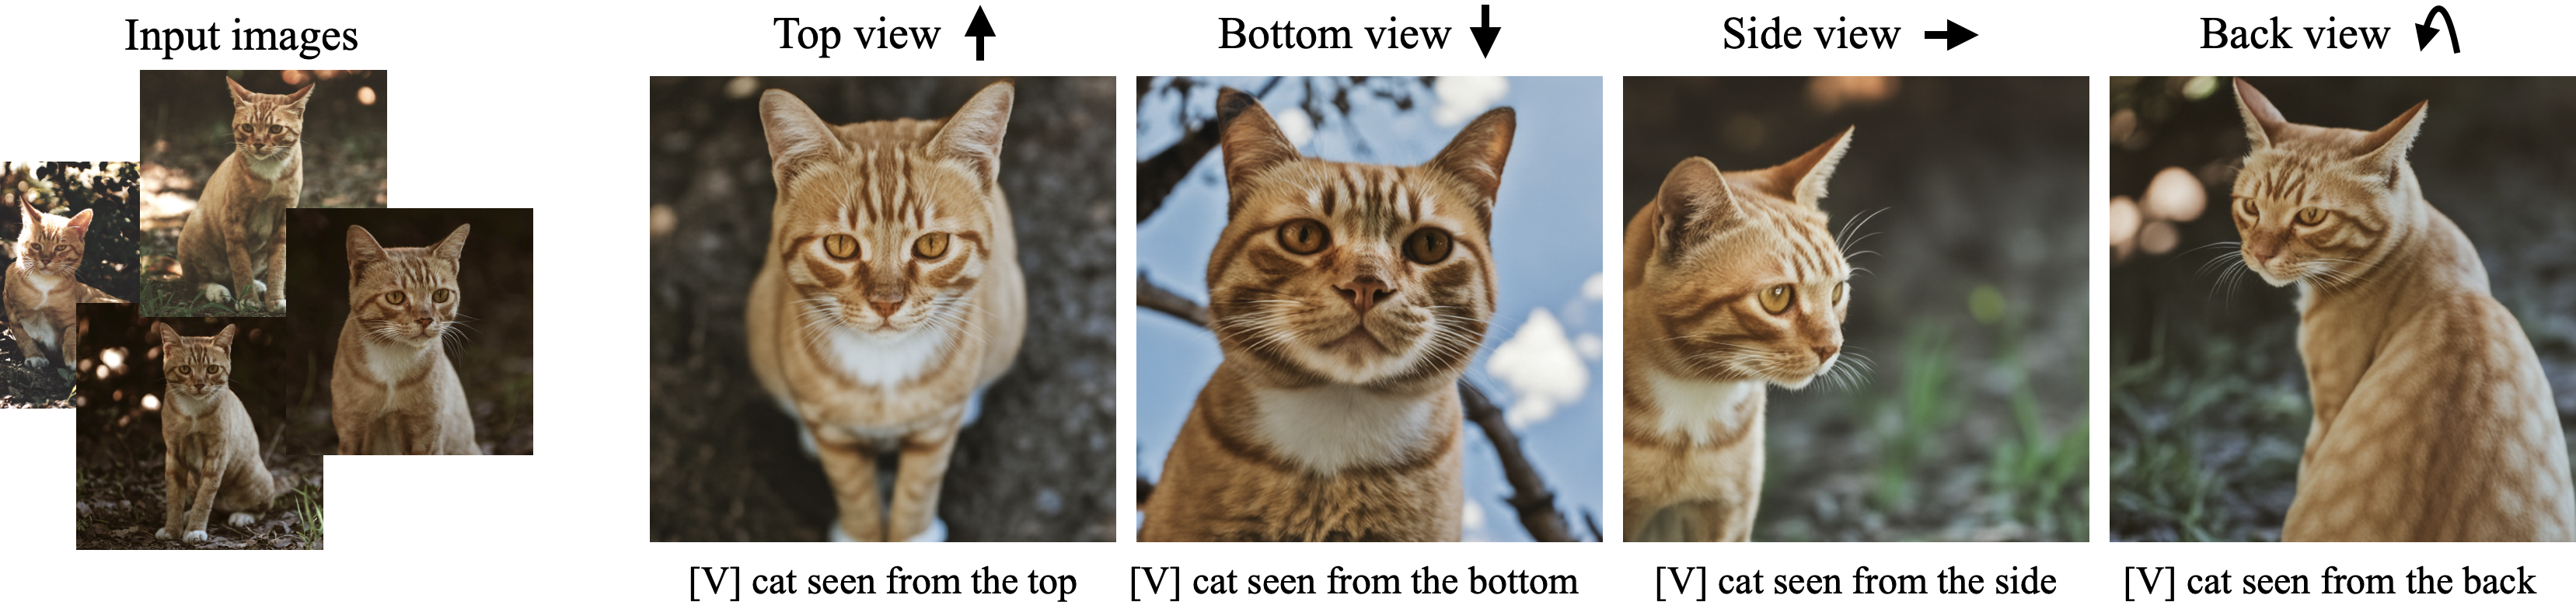
DreamBooth 官方项目页 novel view synthesis 结果
Figure 7(官方原图)。提示词要求 top、bottom、side、back view。论文指出训练只包含 4 张正面猫图;图像保持额头毛纹并生成新姿态。该展示支持外观连续性,未建立相机姿态误差或三维重投影指标。
06 · REVIEWER

DreamBooth 建立了个性化扩散的任务范式,复现边界主要来自闭源 Imagen 与缺失训练细节

Strengths

  • 把实例记忆与类别先验的冲突压缩成清晰的双损失设计。
  • 同底模 Stable Diffusion 比较、自动指标与两项用户研究共同支撑结论。
  • 公开 30 主体数据集、完整评测 prompts 与许可证记录。
  • class noun、PPL、输入图数量和 Imagen SR 都有针对性消融。
  • 从单一主体扩展到新场景、艺术、配饰、属性和视角,应用覆盖充分。

Weaknesses

  • Imagen 权重与训练代码未公开,主结果无法逐数值复现。
  • optimizer、batch、precision、scheduler、采样步数和 guidance 等关键设置缺失。
  • 每个主体维护一整份微调模型,存储和多主体组合成本高。
  • DINO 相关系数只有 0.32,自动指标仍无法充分代表身份判断。
  • 视角实验没有多视图一致性或三维几何评测。
  • 用户研究披露问卷规模,却没有人口统计、质量控制或置信区间。

Potential Improvements

  • 把实例表征拆成紧凑 adapter,同时约束生成器中的身份通道。
  • 用分层 prior:类别、姿态、材质、背景分别保持,减少 context leakage。
  • 加入多视图或特征追踪一致性,验证“novel view”中的几何稳定性。
  • 在推理期以身份奖励与提示词奖励进行候选搜索和可解释重排。
  • 建立训练图近邻与成员推断审计,量化记忆和隐私风险。

失败模式与结论边界

论文明确展示

  • 罕见上下文可能生成错误环境。
  • 上下文颜色会渗入主体外观。
  • 与训练环境相近的提示词会触发背景与构图复现。
  • 罕见主体支持的变化更少,细节偶尔会被幻觉修改。

社会影响

个性化生成可以减少通用模型对主体属性的偏置,也能制造误导性图片。论文只做定性风险声明,没有水印、身份授权、训练图删除、滥用检测或隐私实验。

Our InterpretationPPL 的价值可以理解为一种局部持续学习约束:新实例梯度改变“[V] dog”,原模型生成的类别数据同时保护“dog”的输出分布。它依赖原模型自身样本,因此会把原类别偏差一并保留下来。
Research Extension在程序化材质生成中,可以把 identifier 绑定到具体材质实例,把 class noun 绑定到“wood / stone / fabric”等可执行程序族,再用冻结生成器产生的类别图或 graph 作为 prior preservation。进一步加入 renderer-in-the-loop 的外观误差与 graph validity 约束,分别保护实例观感、可编辑参数和程序合法性。这是研究设想,DreamBooth 论文没有在材质图、shader graph 或可执行程序上验证。
07 · SOURCES

一手来源与复现状态

  1. Ruiz et al. CVPR 2023 Open Access:正式书目信息、11 页主文与 14 页 supplement。
  2. Ruiz et al. arXiv:2208.12242v2:25 页主文与补充材料合订版本,2023-03-15。
  3. DreamBooth 官方项目页:方法概览、原始结果图、应用描述和社会影响。
  4. Google Research. 官方 DreamBooth Dataset 仓库:30 主体、15 类、每主体 4–6 张图像、完整 prompts 与图片来源许可证;仓库不含 Imagen 训练代码。
  5. Saharia et al. Imagen;Rombach et al. Latent Diffusion / Stable Diffusion;Gal et al. Textual Inversion:架构与比较基线。

本页完整核查 CVPR 正式主文、正式 supplement、本地 arXiv v2 合订 PDF、官方项目页与官方数据仓库。所有主表和 supplement 的图像数量表均重建为 HTML。Figure 2、3、6、7 直接嵌入官方项目资源并离线保存。论文未披露的训练和采样设置保持未确认。