ICLR 2023 · Text-to-3D · Score Distillation Sampling

DreamFusion:
Text-to-3D using 2D Diffusion

把冻结的二维文本到图像扩散模型变成一个可微三维生成器的优化先验:每个文本提示从随机初始化的 NeRF 开始,以随机相机渲染,经由 Score Distillation Sampling 更新场景参数。

Ben Poole · 第一作者Google Research · 第一机构arXiv v1 · 2022-09-29ICLR 2023通讯作者未显式标记
0训练所需三维数据
15,000 steps每个提示独立优化,约 1.5 小时
64 × 64冻结 Imagen base 模型监督分辨率
4 × TPU v4每个芯片渲染一个视角
01 · MOTIVATION

二维图像先验很强,三维配对数据很少

论文把任务定义成“在可微渲染器参数空间中采样”。文本到图像模型提供每个视角应当长什么样的分布,随机相机和共享 NeRF 参数迫使这些二维约束汇聚为一个三维一致对象。

输入与输出

输入是文本提示 \(y\)。优化变量 \(\theta\) 是单个 NeRF 场景的全部参数。随机相机 \(c\) 和光照 \(\ell\) 经过渲染器得到 \(x=g(\theta;c,\ell)\)。输出是可从任意视角渲染、可改变点光源、可由 marching cubes 导出网格的场景。

真正填补的缺口

此前 Dream Fields 用 CLIP 相似度优化 NeRF,容易得到缺乏细节和真实感的对象。DreamFusion 把扩散模型在多个噪声尺度上的 score 变成优化方向,避免训练三维生成模型,也无需三维标注数据。

Paper Verified原方法使用冻结的 Imagen 64×64 base 模型及其 T5-XXL 文本编码器。扩散模型权重不微调,也没有调用 Imagen 的超分辨率级联。每个提示都会重新优化一个随机初始化的 NeRF。
Evidence Boundary官方没有公开 Imagen 权重或完整 DreamFusion 训练代码。MultiNeRF 是 NeRF 基础代码来源,不能当作完整实现。使用 Stable Diffusion 的社区复现改变了图像先验、潜空间、分辨率和 guidance 语义,无法充当原方法的等价实现。
02 · SCORE DISTILLATION

SDS 的核心是冻结 score,经由渲染器 Jacobian 更新三维参数

它看起来像噪声预测残差,数学来源是生成器前向噪声分布与扩散先验边缘分布之间的加权 KL。实现时使用 stop-gradient surrogate,只需要 U-Net 前向预测。

扩散前向过程与训练目标

\[q(z_t\mid x)=\mathcal N(\alpha_t x,\sigma_t^2\mathbf I),\qquad z_t=\alpha_t x+\sigma_t\epsilon,\qquad \alpha_t^2+\sigma_t^2=1\]\[\mathcal L_{\mathrm{Diff}}(\phi,x)=\mathbb E_{t,\epsilon}\left[w(t)\left\|\epsilon_\phi(z_t;t)-\epsilon\right\|_2^2\right]\]

\(x\) 是干净图像,\(z_t\) 是噪声图像,\(\epsilon\sim\mathcal N(0,\mathbf I)\),\(\phi\) 是已训练且冻结的扩散模型参数。DreamFusion 不再优化 \(\phi\)。

Classifier-Free Guidance 的精确定义

\[\widehat\epsilon_\phi(z_t;y,t)=(1+\omega)\epsilon_\phi(z_t;y,t)-\omega\epsilon_\phi(z_t;t)\]

论文使用 \(\omega=100\)。按常见写法 \(\epsilon_{\mathrm{uncond}}+s(\epsilon_{\mathrm{cond}}-\epsilon_{\mathrm{uncond}})\),这相当于 \(s=101\)。高 guidance 提高条件一致性,也强化 mode-seeking 和饱和倾向。

概率密度蒸馏目标

\[\mathcal L_{\mathrm{SDS}}(\theta)=\mathbb E_{t,c,\ell}\left[\frac{\sigma_t}{\alpha_t}w(t)\,D_{\mathrm{KL}}\!\left(q(z_t\mid g(\theta;c,\ell))\,\|\,\widehat p_\phi(z_t\mid y)\right)\right]\]

前向分布 \(q\) 的均值由当前渲染结果决定,方差固定;\(p_\phi\) 的 score 由冻结 Imagen 估计。系数 \(\sigma_t/\alpha_t\) 使 KL 的链式系数最终化简为下式。

从 score 到图像梯度

\[ \widehat s_\phi(z_t;y,t)=-\frac{\widehat\epsilon_\phi(z_t;y,t)}{\sigma_t},\qquad \nabla_x D_{\mathrm{KL}}=\frac{\alpha_t}{\sigma_t}\mathbb E_\epsilon[\widehat\epsilon_\phi(z_t;y,t)] \]

固定方差的高斯平移不改变其熵,因此关于生成图像的熵梯度为零。先验对数密度的梯度是 score,乘上噪声图像关于干净图像的 Jacobian \(\alpha_t\),再乘目标中的 \(\sigma_t/\alpha_t\),便得到加权噪声预测。加入均值为零的 \(-\epsilon\) 后获得下式控制变量估计。帽号 \(\widehat p_\phi\) 表示 CFG 修改后的先验,原论文始终使用 guided score;score 网络仅近似该密度的梯度。来源:§2、Appendix A.4。

实际使用的 SDS 梯度

\[\nabla_\theta\mathcal L_{\mathrm{SDS}}=\mathbb E_{t,c,\ell,\epsilon}\left[w(t)\left(\widehat\epsilon_\phi(z_t;y,t)-\epsilon\right)\frac{\partial g(\theta;c,\ell)}{\partial\theta}\right]\]

U-Net 输出被停止梯度,反向传播只穿过渲染器 \(g\)。\(-\epsilon\) 的期望为零,是与预测残差相关的 control variate,可降低方差。论文采用 \(t\sim\mathcal U(0.02,0.98)\) 和 \(w(t)=\sigma_t^2\)。

关键区分SDS 并非直接最小化可回传 U-Net 的 noise-MSE。若对训练损失关于输入求导,会出现昂贵且条件较差的 U-Net Jacobian。代码常写作 \(\langle\operatorname{stopgrad}[w(t)(\widehat\epsilon-\epsilon)],x\rangle\) 以产生指定梯度;这个 surrogate 的数值与上面的 KL 数值含义不同。
公式审查附录 Eq. 11–16 的意图由 score identity、固定方差高斯的路径导数和 control variate 共同确定。原 Eq. 14 的排版容易让 \(\alpha_t\) 链式系数看起来重复,Figure 8 的显式 VJP 行也含有容易误读的负号。本文按最终 Eq. 16 与可验证的 stop-gradient 伪代码给出梯度,并重新整理有歧义的中间排版。
03 · 3D REPRESENTATION

NeRF 同时预测密度与漫反射 albedo,随机光照把外观与几何耦合起来

文本提示
T5-XXL
→
冻结 Imagen
score
→
SDS 梯度
随机相机
随机点光源
→
NeRF + 体渲染
→
64×64 图像
RGB / textureless
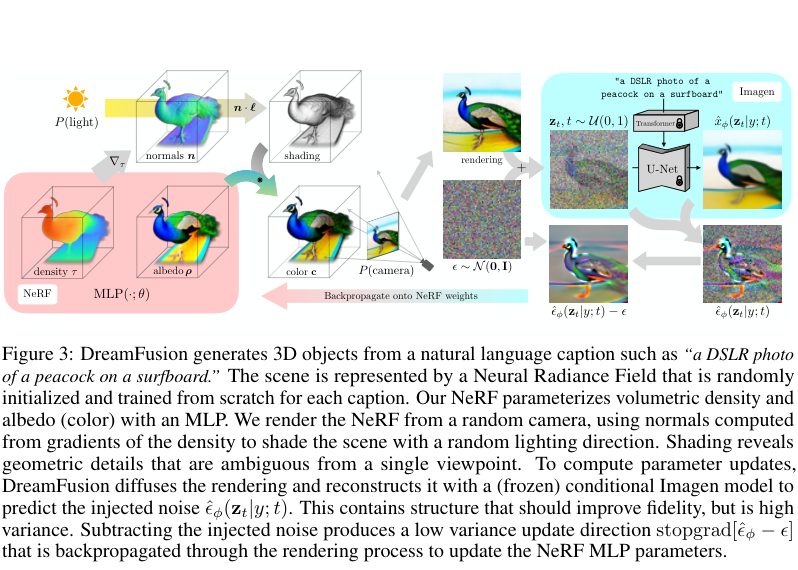
Figure 3(结构重绘)。论文完整优化回路:共享的 NeRF 参数接收来自随机视角的 SDS 梯度;Imagen 始终冻结。

体渲染

\[C(\mathbf r)=\sum_i w_i\,\mathbf c_i,\qquad w_i=\alpha_i\prod_{j\lt i}(1-\alpha_j),\qquad \alpha_i=1-\exp(-\tau_i\delta_i)\]

\(\mathbf r\) 是相机射线,\(\tau_i\) 是第 \(i\) 个区间密度,\(\delta_i\) 是区间长度。权重 \(w_i\) 表示光线首次在该处终止的近似概率。

密度、albedo、法线与 Lambertian shading

\[(\tau(\boldsymbol\mu),\boldsymbol\rho(\boldsymbol\mu))=\operatorname{MLP}(\operatorname{IPE}(\boldsymbol\mu,\boldsymbol\Sigma)),\qquad \mathbf n=-\frac{\nabla_{\boldsymbol\mu}\tau}{\|\nabla_{\boldsymbol\mu}\tau\|}\]\[\mathbf c(\boldsymbol\mu)=\boldsymbol\rho(\boldsymbol\mu)\odot\left(\mathbf a+\mathbf d\,\max(0,\mathbf n\cdot\frac{\mathbf l-\boldsymbol\mu}{\|\mathbf l-\boldsymbol\mu\|})\right)\]

这里 \(\mathbf l\) 是点光源的三维位置,\(\mathbf a\) 与 \(\mathbf d\) 分别是环境光和漫反射光的 RGB 颜色;每个空间点都计算朝向光源的单位方向。网络输出密度与 RGB 漫反射 albedo,法线来自负密度梯度。它没有预测 roughness、metalness、specular 或完整 SVBRDF,也没有生成程序化材质图。

网络与场景边界

仅在固定球形边界内部查询密度场;第二个 MLP 根据位置编码后的射线方向生成背景。若射线累计不透明度为 \(A=\sum_iw_i\),最终颜色为 \(C_{\mathrm{final}}=C+(1-A)C_{\mathrm{bg}}\)。固定边界与背景支路减少相机附近的密度堆积。用于初始化的中心密度偏置为 \(\tau_{\mathrm{init}}(\boldsymbol\mu)=\lambda_\tau\exp[-\|\boldsymbol\mu\|^2/(2\sigma_\tau^2)]\),直接加到密度输出以帮助形成中心物体。来源:§3.1、Appendix A.2 Eq. 9。

主干5 个 ResNet blocks
隐藏宽度128
激活与归一化SiLU + LayerNorm
密度 / albedoexp / sigmoid
背景方向 MLP

几何正则

\[ \mathcal L_{\mathrm{orient}}=\sum_i\operatorname{stopgrad}(w_i)\max(0,\mathbf n_i\cdot\mathbf v)^2,\qquad \mathcal L_{\mathrm{opacity}}=\sqrt{\left(\sum_iw_i\right)^2+0.01} \]

\(\mathbf v\) 是从相机沿射线进入场景的方向,面向相机的法线应与它形成负点积;第一项因此惩罚正点积,并以可见性权重累计。固定 \(w_i\) 的梯度可避免优化器靠缩小或消除物体来逃避法线约束。第二项惩罚每条射线的累计不透明度,鼓励保留空背景;它没有直接监督真实表面位置。两项与 SDS 在同一步优化中共同更新场景参数。来源:Appendix A.2 Eq. 10 及其后段落。

orientation loss 以停止梯度的体渲染权重惩罚朝向背离相机的可见法线;权重通常为 \(10^{-2}\),前 5,000 步从 \(10^{-4}\) 增长。opacity loss 约束累计 alpha,权重范围 \(10^{-3}\) 至 \(5\times10^{-3}\),促进前景和背景分离。

04 · TRAINING

每一步重采样相机、光照、噪声尺度和噪声

训练过程没有三维数据集,也没有多视图真值。三维一致性来自共享场参数和跨视角反复优化。

01采样相机与视角文本
02渲染 RGB 或 textureless
03采样 \(t\) 与 \(\epsilon\)
04Imagen 预测 guided noise
05SDS + 正则更新 NeRF
06重复至 15k steps

相机分布

  • elevation:主文 \(-10^\circ\) 至 \(90^\circ\);附录以 50% 角度均匀和 50% 半球面积均匀混合。
  • azimuth:\(0^\circ\) 至 \(360^\circ\)。
  • 距离:\(1.0\) 至 \(1.5\),对象球半径约 1.4。
  • 焦距:\(0.7\) 至 \(1.35\) 倍 64 像素。
  • 相机位置加 \(\mathcal U(-0.1,0.1)^3\);look-at 为 \(\mathcal N(0,0.2\mathbf I)\),up 扰动为 \(\mathcal N(0,0.02\mathbf I)\)。

光照与 shading

  • 光方向从 \(\mathcal N(\mathbf p_{\mathrm{cam}},\mathbf I)\) 采样,长度为 0.8 至 1.5。
  • 前 1,000 步使用纯 albedo。
  • 之后 75% 步骤开启 ambient 0.1、diffuse 0.9;其余 25% 为纯 albedo。
  • 开启光照时,50% 使用 textureless shading,即 albedo 固定为白色。

Integrated Positional Encoding

  • 频率层级 \(L=8\)。
  • 使用各向同性 \(\boldsymbol\Sigma=\lambda_\Sigma^2\mathbf I\)。
  • \(\lambda_\Sigma\) 在前 5,000 步从 0.05 线性下降至 0.002。
  • 中心密度偏置为 Gaussian,代表性 \(\lambda_\tau=5\)、\(\sigma_\tau=0.2\)。

优化与计算

  • Distributed Shampoo:\(\beta_1=0.9,\ \beta_2=0.9\),exponent override 2,block size 128,SQRT_N graft,\(\epsilon=10^{-6}\)。
  • 前 3,000 步学习率由 \(10^{-9}\) 线性升至 \(10^{-4}\),之后 cosine 降至 \(10^{-6}\)。
  • 4 个 TPU v4 chips,每个芯片一个视角;15,000 步约 1.5 小时。
  • 约一半计算用于 NeRF 渲染,一半用于 Imagen。
View-dependent prompting主文描述按方位对 front / side / back 文本 embedding 加权;附录报告多种插值实验后,直接选取距离当前方位最近的 embedding 已经有效。这个差异属于描述粒度变化,复现时应优先记录附录的实际选择。
05 · EXPERIMENTS

检索指标支持文本一致性,无法直接证明真实几何

评估使用 153 个 object-centric COCO validation captions。Color 为完整着色渲染,Geo 为 textureless render;两者都以 CLIP R-Precision 衡量文本检索。

Table 1 · R-Precision(全部原始方法行)

方法CLIP B/32CLIP B/16CLIP L/14
Color ↑Geo ↑Color ↑Geo ↑Color ↑Geo ↑
Ground Truth images77.1—79.1———
Dream Fields68.3—74.2———
Dream Fields reimplementation78.61.399.90.882.91.4
CLIP-Mesh67.8—75.8—74.5*—
DreamFusion75.142.577.546.679.758.5

* CLIP-Mesh L/14 Color 为单个 seed。DreamFusion 对每个 caption 使用 2 个 generation seeds,在 elevation 30° 的多个 azimuth 上取平均。Dream Fields 与 CLIP-Mesh 使用 45° held-out view,协议并不完全相同。括号说明:重实现 Dream Fields 的 B/16 同类模型参与训练与评估,存在指标过拟合风险。

如何读表

DreamFusion 的 Geo 指标远高于其他可报告 baseline,支持其 textureless 渲染仍能与文本语义匹配。Color 列中,Dream Fields 重实现分别得到 78.6、99.9、82.9,三项都高于 DreamFusion 的 75.1、77.5、79.7。因此“颜色结果超过全部 baseline”的宽泛说法不受这张表支持。

几何指标的边界

论文没有对应对象的三维 ground truth,未计算 Chamfer Distance、normal error 或 surface accuracy。Geo R-Precision 只是将无纹理渲染送入 CLIP 的代理指标,能反映可辨识轮廓与粗略结构,无法验证真实尺寸、拓扑或背面几何。

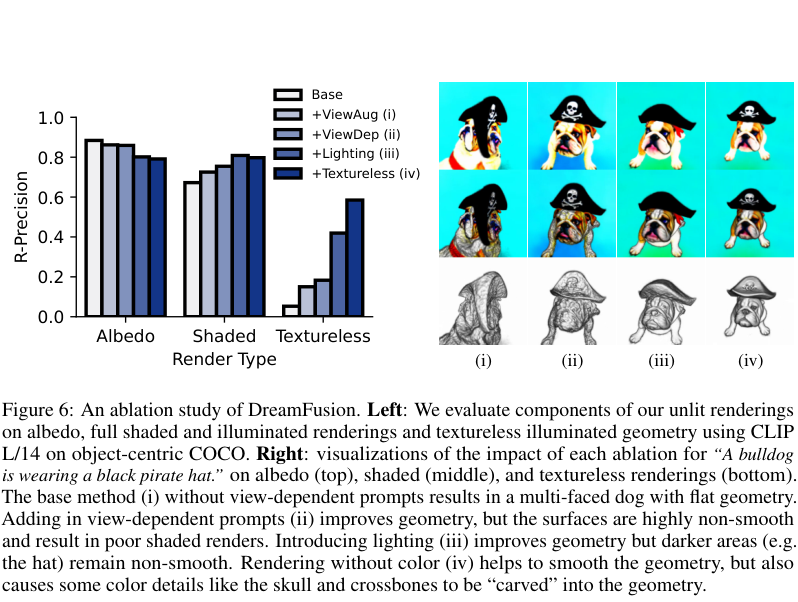
Ablation · Figure 6

设置移除内容论文可支持的结论
Full无完整系统达到最佳综合图像与几何质量
− View Augmentation相机位置、look-at、up 与焦距扰动随机成像条件帮助跨视角鲁棒性
− View-dependent Promptingfront / side / back 方位文本减少视角语义歧义和多面结构
− Lighting随机 Lambertian illumination降低颜色写入阴影和几何的倾向
− Textureless白色 albedo 的 shading 训练削弱显式几何监督信号

正文只明确给出完整渲染 R-Precision 相对最弱设置提高 12.5 个百分点。Figure 6 柱形没有逐项数字标签,本文不从柱高估算伪精确数值。正文“Appendix Table 9”实际对应附录 Figure 9。
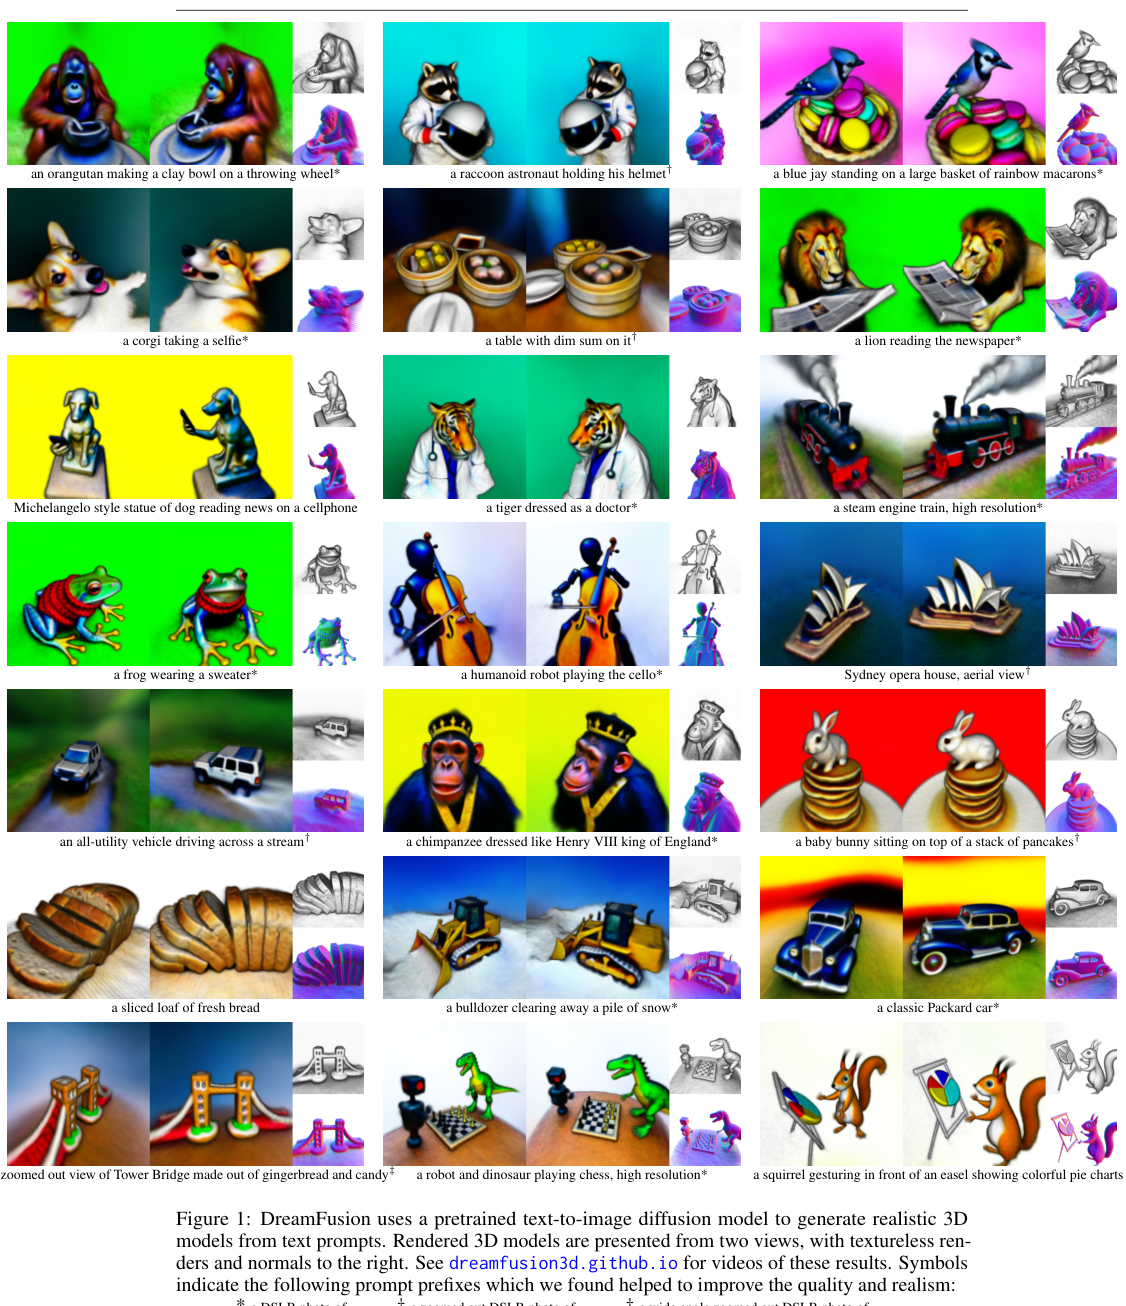
原论文 Figure 1
Figure 1(原论文第 2 页)。两视角颜色、无纹理和法线渲染,用于判断外观与几何的区别。图像依据 PDF 图像对象和 caption 文字坐标提取,保留原始图注。
原论文 Figure 3
Figure 3(原论文第 5 页)。完整的相机、渲染、扩散噪声与 SDS 更新回路。图像依据 PDF 图像对象和 caption 文字坐标提取,保留原始图注。
原论文 Figure 6
Figure 6(原论文第 9 页)。各组件消融的原始柱形和定性结果;不将未标注柱高转写为精确数值。图像依据 PDF 图像对象和 caption 文字坐标提取,保留原始图注。
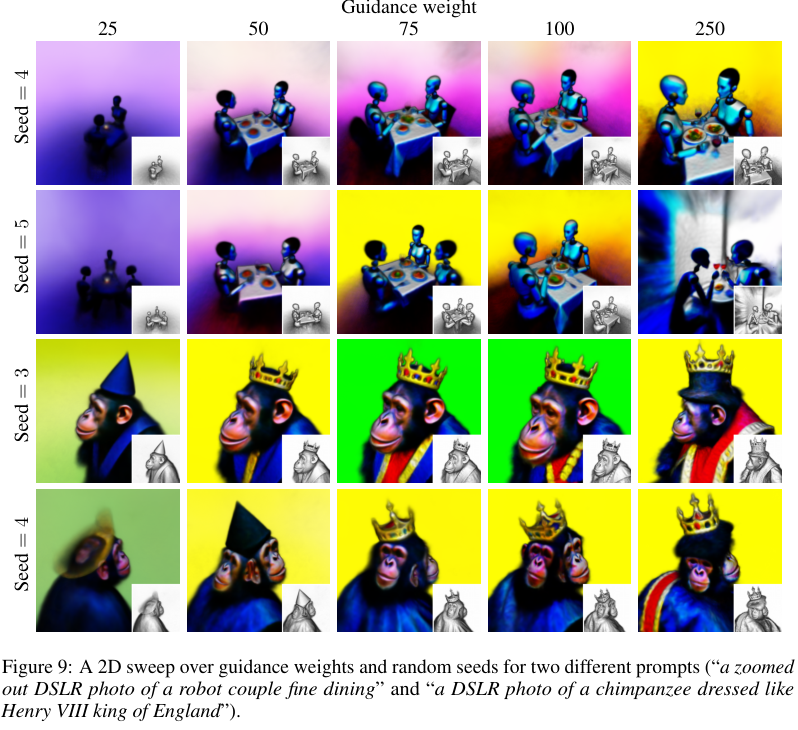
原论文 Figure 9
Figure 9(原论文第 18 页)。两个提示词的 guidance 与 seed 扫描;低多样性仍属于方法局限。图像依据 PDF 图像对象和 caption 文字坐标提取,保留原始图注。

Figure 1

两视角 RGB、textureless 与 normal 结果总览,展示提示前缀符号。

Figure 2

祖先采样与参数空间 SDS 的二维对照。

Figure 3

随机相机、NeRF 渲染、加噪与冻结 Imagen 的训练回路。

Figure 4

逐步改变文本分别重新生成场景;没有证明对同一资产进行保真编辑。

Figure 5

与 Dream Fields、CLIP-Mesh 的定性对照。

Figure 6

视角增强、视角文本、光照和 textureless 的消融。

Figure 7

DDPM 祖先采样伪代码。

Figure 8

SDS stop-gradient 伪代码;VJP 行符号需结合 Eq. 16 审查。

Figure 9

guidance 25–250 与多 seed 扫描,展示高 guidance 和低多样性。

06 · REVIEWER

开创性的接口设计,证据和复现条件仍有明显边界

Strengths

  • 把任意可微图像参数化与大型二维扩散先验连接起来,SDS 具有广泛迁移价值。
  • 无需三维训练数据或扩散模型微调,研究假设清晰。
  • 随机视角、光照、textureless rendering 与 orientation regularization 形成完整三维优化系统。
  • 正文和附录提供了相机、网络、优化器与正则的大量关键参数。

Weaknesses

  • 依赖未公开 Imagen,核心结果无法按原模型完全复现。
  • 64×64 监督限制细节,容易产生过平滑、高饱和和 Janus 几何。
  • 每个提示约 1.5 小时和 4 个 TPU v4 chips,成本较高。
  • R-Precision 不能替代真实几何评估;baseline 的评估相机协议也不统一。
  • SDS 倾向寻找模式,不同随机 seed 的多样性有限。
Author Claim

作者解释

高 guidance 在受限的 NeRF 参数空间中可以比二维采样承受更大数值,且多噪声尺度共同寻找一致模式。论文将低多样性归因于 mode-seeking 与高噪声平滑分布中模式数量有限;这是合理解释,缺少系统因果实验。

Research Extension

程序化材质方向

可以把 SDS 替换为对可执行材质图渲染结果的多视角、多光照 score guidance,并让优化变量成为图拓扑和节点参数;执行有效性、可编辑性与物理通道一致性需要额外约束。这是研究设想,原论文没有生成 SBS、shader graph 或 SVBRDF。

07 · SOURCES

一手资料与身份核对

  1. Poole et al. arXiv:2209.14988v1:2022-09-29 提交记录、作者列表、18 页论文与附录。
  2. Poole et al. OpenReview ICLR 2023 论坛:正式会议版本与 ICLR 2023 书目信息。
  3. Poole et al. DreamFusion 官方项目页:作者机构、视频、gallery、mesh export 与方法说明。
  4. Saharia et al. Imagen:冻结文本到图像扩散先验及 T5 文本编码基础。
  5. Barron et al. mip-NeRF 360 与 MultiNeRF:DreamFusion 的 NeRF 基础实现来源。

本页完整核查本地 2209.14988v1.pdf 共 18 页,包括正文、参考文献和 Appendix A.1–A.5;重建 Table 1 全部行列,并逐项整理 Figure 1–9 的用途。论文与官方页面未发现通讯作者标记,末位作者仅按仓库规范作为候选。