时间步差异
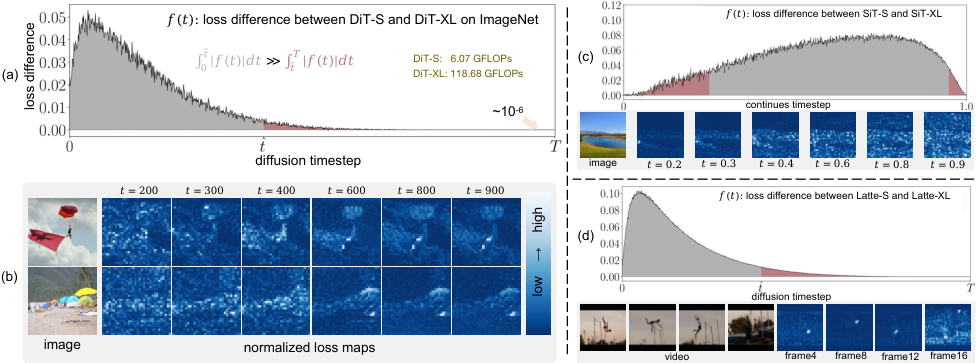
DiT-S 与 DiT-XL 的损失差在靠近纯噪声的较大 \(t\) 区间显著缩小,说明这些时间步可以由较窄子网络处理。接近图像的较小 \(t\) 更依赖模型容量。
DyDiT++ 把 DiT 的固定宽度改造成时间步路由,把每个 MLP 的全量 token 处理改造成空间路由;期刊扩展稿再把同一思想迁移到 SiT flow matching、Latte 视频、FLUX 文本生成,并以 TD-LoRA 降低动态化训练的参数与显存成本。
页面正文和全部数值以本地 47 页 v1 为唯一基准。当前 arXiv 身份与原会议论文只用于书目信息和贡献谱系。
DiT 在 1000 个训练时间步上复用同一套宽度,并让每个 patch 穿过相同的 MLP。作者以大小模型损失差与逐 patch 损失图说明,任务难度并不均匀。
DiT-S 与 DiT-XL 的损失差在靠近纯噪声的较大 \(t\) 区间显著缩小,说明这些时间步可以由较窄子网络处理。接近图像的较小 \(t\) 更依赖模型容量。
主体、细节丰富和彩色区域具有较高损失;连续背景的损失较低。SDT 因此把 MLP 预算优先留给困难 patch。
缩步采样减少时间步数量,静态剪枝固定削减每一步的网络。DyDiT 学习随时间步和 token 改变的计算图,目标是与这些方法组合。
输入是潜空间噪声 token \(\mathbf{X}\)、时间步嵌入 \(\mathbf{E}_t\) 与类别条件;输出仍是 DiT 的噪声与方差预测。路由器只改变中间计算分配。
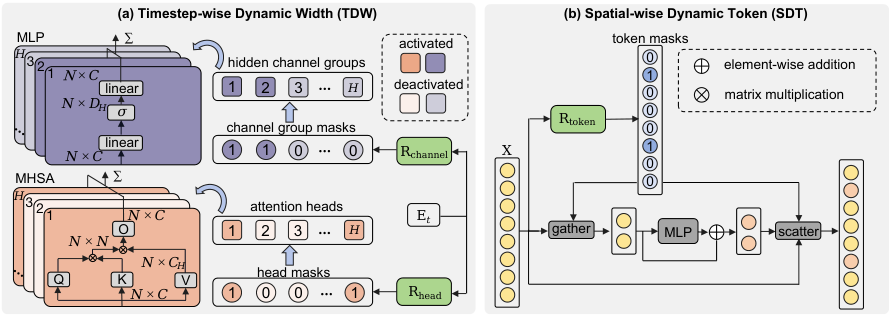
若激活 head 数为 \(\widetilde H_{\mathrm{head}}\),TDW 让 attention 复杂度按 \(\widetilde H_{\mathrm{head}}/H\) 缩减;MLP 同理按 \(\widetilde H_{\mathrm{channel}}/H\) 缩减。每层强制保留按 magnitude 排名最重要的一组,避免全部关闭。
\(C_H=C/H\) 是每个 attention head 的特征宽度;若 MLP 完整中间宽度为 \(D\),则每个 channel group 的宽度为 \(D_H=D/H\)。SDT 再将第二式中的 \(N\) 替换为实际进入 MLP 的 \(\widetilde N\)。第一式覆盖 Q/K/V、attention 乘法和输出投影;第二式覆盖 MLP 的两次线性变换。TDW 的 head 与 channel router 都是“单个线性层 + Sigmoid”,输入为时间步嵌入 \(\mathbf{E}_t\),输出维度均为 \(H\)。SDT 的公开 DiT 实现使用两层小型 MLP 产生逐 token 概率;论文正文只把它抽象为 \(R_{\mathrm{token}}\)。
实际推理应 gather \(\widetilde N\) 个 token 进入 MLP,再 scatter 回 \(N\) 个位置。MHSA 对全部 token 运行。训练时用 Gumbel-Sigmoid 与 straight-through estimator 让二值选择可以反向传播。
\(\lambda\) 约束 batch 内均匀采样时间步的平均 FLOPs 比例。它没有为每个样本设置硬上限,因此实际 FLOPs 会围绕目标波动。论文的 warm-up 阶段另保留完整 DiT 分支监督,随后移除;DiT-XL λ=.5 使用 30k warm-up 和总计 200k 追加迭代。
\(\lambda=.5\) 指路由成本模型下 attention 与 MLP 的平均比例。DiT-XL 实际从 118.69G 到 57.88G,比例约 0.488;路由、VAE、采样调度与内存访问没有完整计入,因此 FLOPs 减少 2.04×只转化为端到端 1.73×。
SiT 学习连续插值路径 \(\mathbf{x}_t=\alpha_t\mathbf{x}_0+\sigma_t\mathbf{x}_1\) 的速度场:
\(\mathcal{L}_{\mathrm{velocity}}=\mathbb{E}\lVert\mathbf{v}_{\theta}(\mathbf{x}_t,t)-\mathrm{d}\mathbf{x}_t/\mathrm{d}t\rVert_2^2\)。
结构与 DiT 相同,TDW、SDT 和 FLOPs 约束直接复用,只把生成损失替换为 velocity loss。
\(\mathbf{X}\in\mathbb{R}^{L\times N\times C}\);空间层与时间层交替。两类层都拥有 head、channel 和 token router,从时间步、空间位置和帧间位置三个方向分配计算。
v1:Latte-XL 官方 checkpoint,四个数据集,各 150k 迭代,2048 个 16 帧 256² clip,FVD;其余 optimizer、batch、采样步数没有披露。
DoubleBlock 为图像与文本保留并行 MLP;SDT 只跳过图像 MLP。SingleBlock 将 attention 和 MLP 中间特征拼接,\(\operatorname{FC}_2\) 的有效输入宽度同时受 head 与 channel router 控制。token router 在图像 token、池化文本 token 与时间步 AdaLN 融合后作判断。
第一阶段每隔四个 block 蒸馏静态 FLUX-Lite 的中间表示与输出,并使用 \(w=5.0\) 的预算损失;第二阶段进行 CFG distillation,把 conditional 与 unconditional 两次前向蒸馏到带 guidance embedding 的单次前向。v1 使用 λ=.7、内部数据集、500k 迭代、1024² 图像;数据规模、batch、optimizer、硬件和训练时长未公开。
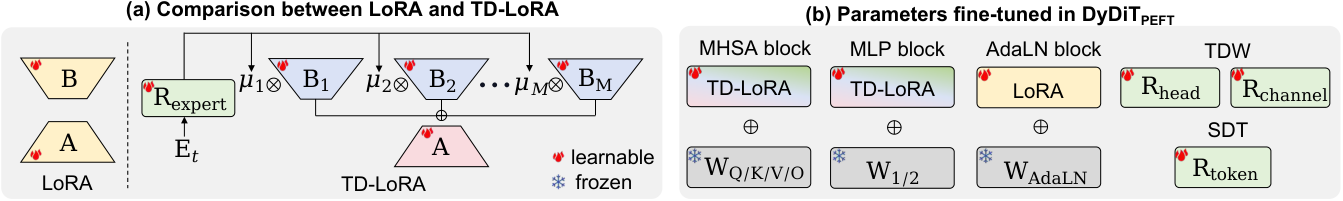
默认 \(M=3\)、TD-LoRA rank \(=4\),AdaLN 普通 LoRA rank \(=8\)。推理时先按时间步融合专家,再合并到原权重;论文报告额外融合延迟相对批处理前向可以忽略。训练显存从 34GB 降到 25GB,FID 从 full fine-tune 的 2.07 变为 2.23。
| 分支 | 基础模型 | 数据与输出 | 训练 | 推理与评测 | v1 缺失项 |
|---|---|---|---|---|---|
| DyDiT | DiT-S/B/XL | ImageNet 256² / 512²;四个 224² 细粒度集 | AdamW 1e-4,batch 256,8×A800 80GB;50k/100k/150–200k | 250 DDPM;CFG 1.5 指标、4.0 展示;50k samples | precision、训练时长、完整 scheduler |
| DySiT | SiT-XL | ImageNet 256² | 称复用 DyDiT 预算训练 | Heun ODE / Euler-Maruyama SDE | 步数、迭代、batch、硬件、优化器 |
| DyLatte | Latte-XL | UCF101、Taichi-HD、FaceForensics、SkyTimelapse;16×256² | 官方 checkpoint + 150k | 2048 clips,FVD;V100 speed | batch、LR、optimizer、采样器/步数、训练硬件 |
| DyFLUX | FLUX-Lite 8B | 内部数据,1024² | 500k;表示蒸馏 + CFG 蒸馏;λ=.7 | GenEval 与 12 人用户研究 | 数据量、过滤、batch、LR、硬件、训练时长、速度硬件 |
| TD-LoRA | DiT-XL | ImageNet 256² | expert 3、rank 4;AdaLN rank 8;λ=.5 | 250 DDPM,50k FID | PEFT optimizer 与完整训练 schedule |
下面完整重建 v1 的 Tables 1–11 全部方法行。粗体分组行保留静态、动态和分辨率边界。
| 模型 | 参数量 M ↓ | FLOPs G ↓ | FID ↓ | sFID ↓ | IS ↑ | Precision ↑ | Recall ↑ |
|---|---|---|---|---|---|---|---|
| 256×256 · Static | |||||||
| ADM | 608 | 1120 | 4.59 | 5.25 | 186.87 | 0.82 | 0.52 |
| LDM-4 | 400 | 104 | 3.95 | — | 178.22 | 0.81 | 0.55 |
| U-ViT-L/2 | 287 | 77 | 3.52 | — | — | — | — |
| U-ViT-H/2 | 501 | 113 | 2.29 | — | 247.67 | 0.87 | 0.48 |
| DiffuSSM-XL | 673 | 280 | 2.28 | 4.49 | 269.13 | 0.86 | 0.57 |
| DiM-L | 380 | 94 | 2.64 | — | — | — | — |
| DiM-H | 860 | 210 | 2.21 | — | — | — | — |
| DiffiT | 561 | 114 | 1.73 | — | 276.49 | 0.8 | 0.62 |
| DiMR-XL | 505 | 160 | 1.7 | — | 289.0 | 0.79 | 0.63 |
| DiT-L | 468 | 81 | 5.02 | — | 167.2 | 0.75 | 0.57 |
| DiT-XL | 675 | 118 | 2.27 | 4.6 | 277.0 | 0.83 | 0.57 |
| 256×256 · Dynamic | |||||||
| DyDiT-XL λ=0.7 | 678 | 84.33 (1.40×少) | 2.12 | 4.61 | 284.31 | 0.81 | 0.6 |
| DyDiT-XL λ=0.5 | 678 | 57.88 (2.04×少) | 2.07 | 4.56 | 248.03 | 0.8 | 0.61 |
| 512×512 · Static | |||||||
| ADM-G | 731 | 2813 | 3.85 | 5.86 | 221.72 | 0.84 | 0.53 |
| DiffuSSM-XL | 673 | 1066 | 3.41 | — | 255.0 | 0.85 | 0.49 |
| DiM-Huge | 860 | 708 | 3.78 | — | — | — | — |
| DiT-XL | 675 | 514 | 3.04 | 5.02 | 240.8 | 0.84 | 0.54 |
| 512×512 · Dynamic | |||||||
| DyDiT-XL λ=0.7 | 678 | 375.05 (1.37×少) | 2.88 | 5.14 | 228.93 | 0.83 | 0.56 |
| 模型 | s/image ↓ | FLOPs G ↓ | Food FID | Artbench FID | Cars FID | Birds FID | 平均 FID |
|---|---|---|---|---|---|---|---|
| DiT-S | 0.65 | 6.07 | 14.56 | 17.54 | 9.3 | 7.69 | 12.27 |
| pruned random | 0.38 | 3.05 | 45.66 | 76.75 | 60.26 | 48.6 | 57.81 |
| pruned magnitude | 0.38 | 3.05 | 41.93 | 42.04 | 31.49 | 26.45 | 35.44 |
| pruned Taylor | 0.38 | 3.05 | 47.26 | 74.21 | 27.19 | 22.33 | 42.74 |
| pruned Diff | 0.38 | 3.05 | 36.93 | 68.18 | 26.23 | 23.05 | 38.59 |
| pruned ToMe 20% | 0.61 | 4.82 | 43.87 | 62.96 | 32.16 | 15.2 | 38.54 |
| DyDiT-S λ=0.5 | 0.41 | 3.16 (1.92×少) | 16.74 | 21.35 | 10.01 | 7.85 | 13.98 |
| DyDiT-S λ=0.5 † | 0.41 | 3.17 (1.91×少) | 13.03 | 19.47 | 12.15 | 8.01 | 13.16 |
| 模型 | TDW | SDT | ImageNet | Food | Artbench | Cars | Birds | 平均 |
|---|---|---|---|---|---|---|---|---|
| I | ✓ | 31.89 | 15.71 | 28.19 | 19.67 | 9.23 | 20.93 | |
| II | ✓ | 70.06 | 23.79 | 52.78 | 16.9 | 12.05 | 35.12 | |
| III | ✓ | ✓ | 28.75 | 16.74 | 21.35 | 10.01 | 7.85 | 16.94 |
| I random | 随机 | 124.38 | 111.88 | 151.99 | 127.53 | 164.29 | 136.01 | |
| I manual | 手工 | 34.08 | 23.89 | 40.02 | 22.34 | 20.17 | 28.1 | |
| III layer-skip | ✓ | 层级跳过 | 30.95 | 17.75 | 23.15 | 10.53 | 9.01 | 18.29 |
| 模型 | 250-DDPM s/FID | 50-DDIM s/FID | 20-DPM++ s/FID | 10-DPM++ s/FID |
|---|---|---|---|---|
| DiT-XL | 10.22 / 2.27 | 2.00 / 2.26 | 0.84 / 4.62 | 0.42 / 11.66 |
| DyDiT-XL λ=0.7 | 7.76 / 2.12 | 1.56 / 2.16 | 0.62 / 4.28 | 0.31 / 11.10 |
| DyDiT-XL λ=0.5 | 5.91 / 2.07 | 1.17 / 2.36 | 0.46 / 4.22 | 0.23 / 11.31 |
| 模型 | DeepCache interval | s/image ↓ | FID ↓ |
|---|---|---|---|
| DiT-XL | 0 | 10.22 | 2.27 |
| DyDiT-XL λ=0.5 | 0 | 5.91 | 2.07 |
| DiT-XL | 2 | 5.02 | 2.47 |
| DyDiT-XL λ=0.5 | 2 | 2.99 | 2.43 |
| DiT-XL | 5 | 2.03 | 6.73 |
| DyDiT-XL λ=0.5 | 3 | 2.01 | 3.37 |
| 模型 | 参数量 M | FLOPs G | FID | sFID | IS | Precision | Recall |
|---|---|---|---|---|---|---|---|
| SiT-XL ODE | 675 | 118 | 2.11 | 4.62 | 255.87 | 0.8 | 0.61 |
| DySiT-XL λ=0.7 ODE | 678 | 85.1 | 1.95 | 4.59 | 268.61 | 0.82 | 0.61 |
| DySiT-XL λ=0.5 ODE | 678 | 58.38 | 2.11 | 4.75 | 268.19 | 0.82 | 0.59 |
| SiT-XL SDE | 675 | 118 | 2.04 | 4.5 | 269.55 | 0.82 | 0.59 |
| DySiT-XL λ=0.7 SDE | 678 | 85.31 | 2.08 | 4.55 | 281.84 | 0.83 | 0.59 |
| DySiT-XL λ=0.5 SDE | 678 | 58.27 | 2.27 | 4.68 | 284.17 | 0.84 | 0.58 |
| 模型 | FLOPs G ↓ | s/video ↓ | FVD ↓ |
|---|---|---|---|
| Latte | 1895 | 157 | 186.7 |
| DyLatte λ=0.4 | 761 | 77 | 189.72 |
| DyLatte λ=0.5 | 952 | 97 | 181.9 |
| DyLatte λ=0.6 | 1134 | 115 | 147.03 |
| DyLatte λ=0.7 | 1329 | 127 | 164.2 |
| 模型 | s/image | FLOPs T | Overall | Single | Two | Count | Color | Position | Binding |
|---|---|---|---|---|---|---|---|---|---|
| FLUX 12B | 18.85 | 40.8 | 66.48 | 98.75 | 84.85 | 74.69 | 76.6 | 21.75 | 42.25 |
| FLUX-Lite 8B | 15.23 | 30.0 | 62.06 | 98.44 | 74.24 | 64.38 | 75.53 | 17.0 | 42.75 |
| DyFLUX-Lite 8B | 11.84 | 21.2 | 67.64 | 99.06 | 86.36 | 67.19 | 78.99 | 22.25 | 52.0 |
| 表 | 设计 | 可学习参数 M | 速度 s/image | FID |
|---|---|---|---|---|
| 9 | DyDiT-XL full | 678 | 5.91 | 2.07 |
| 9 | DyDiT-XL LoRA | 9.29 | 5.91 | 2.41 |
| 9 | DyDiT-XL TD-LoRA PEFT | 9.94 | 5.96 | 2.23 |
| 10 | TD-LoRA | 9.94 | — | 2.23 |
| 10 | Inverse TD-LoRA | 9.42 | — | 2.39 |
| 10 | Symmetry TD-LoRA | 10.22 | — | 2.66 |
| 10 | TD-LoRA w/o timestep | 9.91 | — | 3.16 |
| 11 | DyDiT-XL full · baseline | 678 | — | 2.07 |
| 11 | TD-LoRA rank 1 | 5.3 | — | 2.94 |
| 11 | TD-LoRA rank 2 | 6.84 | — | 3.09 |
| 11 | TD-LoRA rank 4 | 9.94 | — | 2.23 |
| 11 | TD-LoRA rank 8 | 16.13 | — | 2.48 |
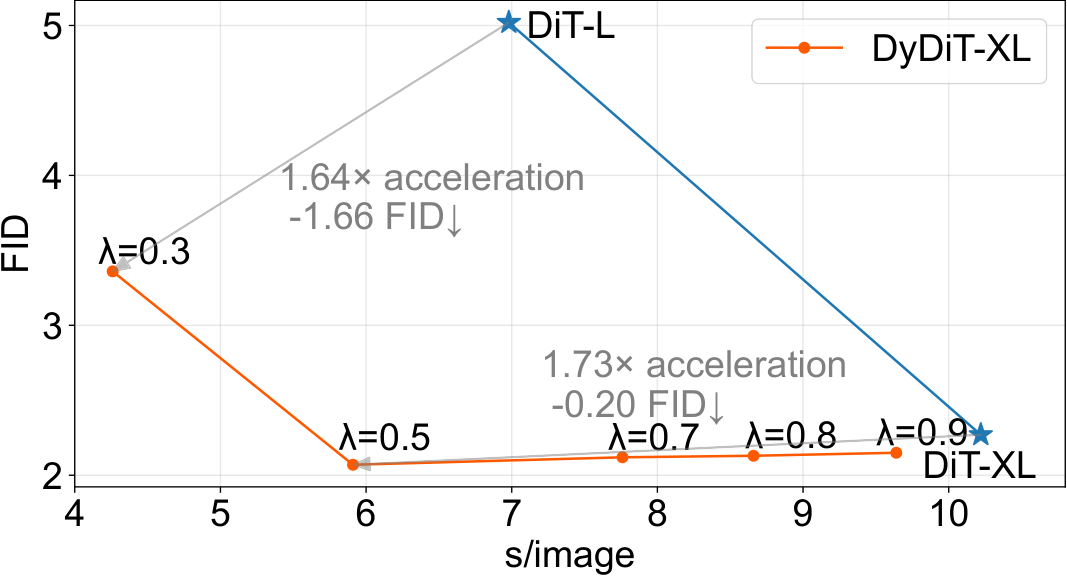
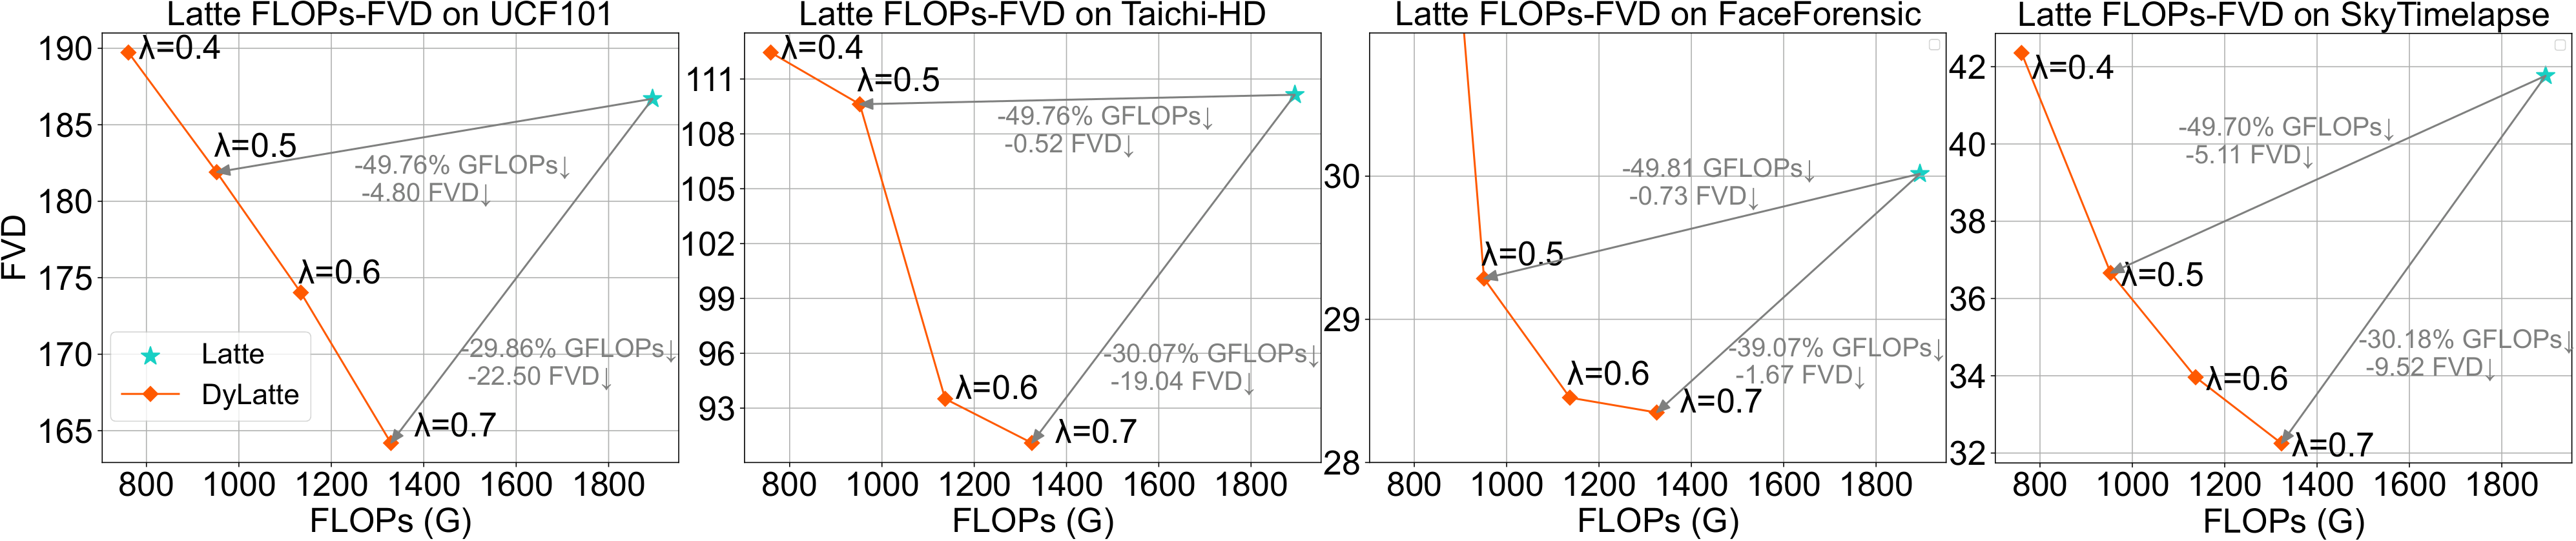
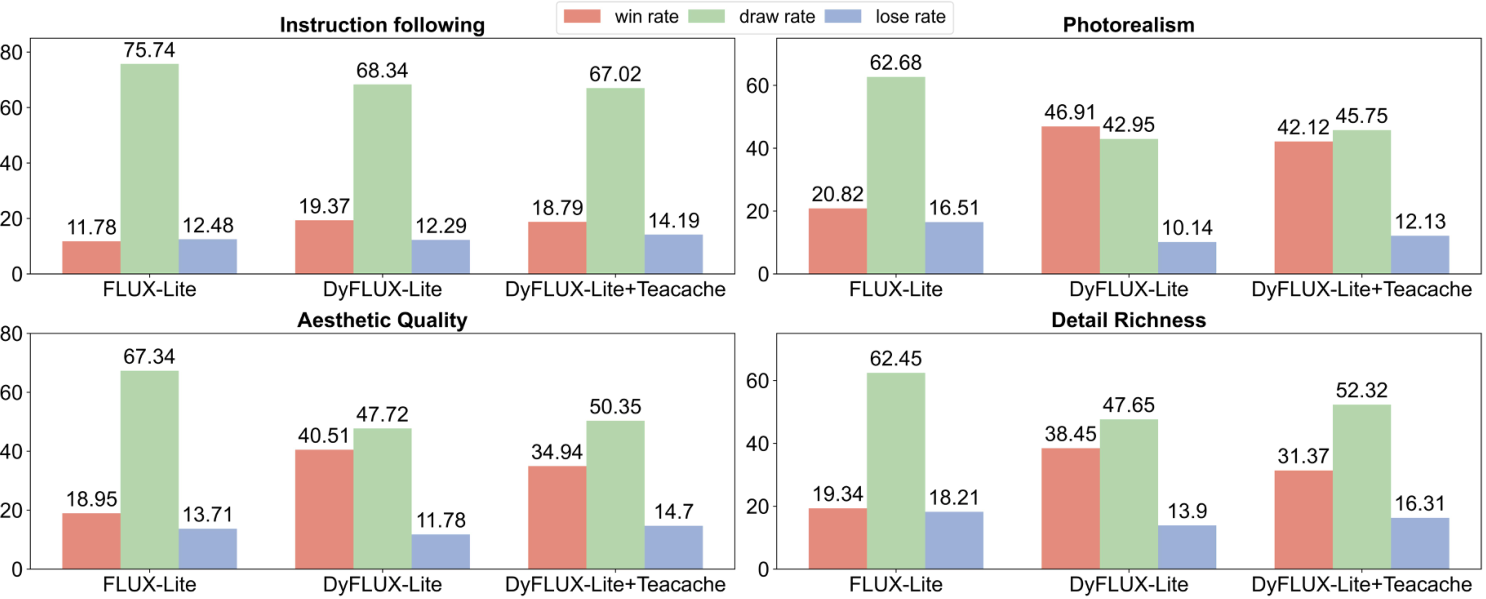
Table 19 控制相同追加训练和相同 router 参数后,DyDiT λ=.7 仍以 84.33G / FID 2.12 优于静态 118.69G / FID 2.15,削弱了“只是多训练”这一解释。
λ=.5 对 DiT-S 造成 FID +7.29,对 DiT-B 造成 +3.85,对 DiT-XL 改善 0.20。大模型冗余更多是合理解释,但论文只测试三个规模,仍缺少相同训练算力下的系统缩放定律。
DyLatte λ=.6 的 FVD 147.03 优于 λ=.7 的 164.20;TD-LoRA rank 4 优于 rank 8;50k fine-tune 与 150k 同为 2.12。单次 FID/FVD 的方差和重复实验没有报告。
v1 正文的可见编号从 Table 11 跳到 Table 13;逐页核查 47 页 PDF、paper.tex、sec/4_experiment.tex 与 sec/appendix.tex 后,没有找到 Table 12 的标题、标签或表体。以下重建 Tables 13–25。
| 模型 | 优化器与 LR | batch | λ | 迭代 | warmup | 增强 | crop |
|---|---|---|---|---|---|---|---|
| DiT-S | AdamW 1e-4 | 256 | 0.9/0.8/0.7/0.5/0.4/0.3 | 50k | 0 | random flip | 224² |
| DiT-B | AdamW 1e-4 | 256 | 0.9/0.8/0.7/0.5/0.4/0.3 | 100k | 0 | random flip | 224² |
| DiT-XL | AdamW 1e-4 | 256 | 0.7/0.6/0.5/0.3 | 150k for 0.7; 200k others | 30k | random flip | 224² |
| 模型 | 参数 M | 层数 | heads | channel | 预训练来源 |
|---|---|---|---|---|---|
| DiT-S | 33 | 12 | 6 | 384 | T-Stitch · 5M iter |
| DiT-B | 130 | 12 | 12 | 768 | T-Stitch · 1.6M iter |
| DiT-XL | 675 | 28 | 16 | 1152 | 官方 DiT · 7M iter |
| DyDiT-S | 33 | 12 | 6 动态 | 384 动态 | fine-tune |
| DyDiT-B | 131 | 12 | 12 动态 | 768 动态 | fine-tune |
| DyDiT-XL | 678 | 28 | 16 动态 | 1152 动态 | fine-tune |
| 模型 | 训练迭代 | s/image | FLOPs G | FID | ΔFID |
|---|---|---|---|---|---|
| DiT-XL | 7M | 10.22 | 118.69 | 2.27 | 0.0 |
| DyDiT λ=0.7 scratch | 7M | 7.75 | 84.31 | 2.37 | +0.10 |
| DyDiT λ=0.7 scratch | 11M | 7.76 | 84.32 | 2.25 | -0.02 |
| DyDiT λ=0.7 fine-tune | 150k | 7.76 | 84.33 | 2.12 | -0.15 |
| 模型 | s/image | 加速 | FLOPs G | FID | ΔFID |
|---|---|---|---|---|---|
| DiT-S | 0.65 | 1.00× | 6.07 | 21.46 | 0 |
| S λ=.9 | 0.63 | 1.03× | 5.72 | 21.06 | -0.4 |
| S λ=.8 | 0.56 | 1.16× | 4.94 | 21.95 | +.49 |
| S λ=.7 | 0.51 | 1.27× | 4.34 | 23.01 | +1.55 |
| S λ=.5 | 0.42 | 1.54× | 3.16 | 28.75 | +7.29 |
| S λ=.4 | 0.38 | 1.71× | 2.63 | 36.21 | +14.75 |
| S λ=.3 | 0.32 | 2.03× | 1.96 | 59.28 | +37.83 |
| DiT-B | 2.09 | 1.00× | 23.02 | 9.07 | 0 |
| B λ=.9 | 1.97 | 1.05× | 21.28 | 8.78 | -.29 |
| B λ=.8 | 1.76 | 1.18× | 18.53 | 8.79 | -.28 |
| B λ=.7 | 1.57 | 1.32× | 16.28 | 9.4 | +.33 |
| B λ=.5 | 1.22 | 1.70× | 11.9 | 12.92 | +3.85 |
| B λ=.4 | 1.06 | 1.95× | 9.71 | 15.54 | +6.47 |
| B λ=.3 | 0.89 | 2.33× | 7.51 | 23.34 | +14.27 |
| DiT-XL | 10.22 | 1.00× | 118.69 | 2.27 | 0 |
| XL λ=.9 | 9.64 | 1.06× | 110.73 | 2.15 | -.12 |
| XL λ=.8 | 8.66 | 1.18× | 96.04 | 2.13 | -.14 |
| XL λ=.7 | 7.76 | 1.32× | 84.33 | 2.12 | -.15 |
| XL λ=.5 | 5.91 | 1.73× | 57.88 | 2.07 | -.20 |
| XL λ=.3 | 4.26 | 2.40× | 38.85 | 3.36 | +1.09 |
| 表 | 模型 | 速度 | FLOPs G | FID | ΔFID |
|---|---|---|---|---|---|
| 17 CIFAR-10 | U-ViT-S/2 | 2.19 s | 11.34 | 3.12 | 0 |
| 17 | DyU-ViT-S/2 λ=.4 | 1.04 s / 2.10× | 4.73 | 3.18 | +.06 |
| 17 | Diff pruning | — | 5.32 | 12.63 | +9.51 |
| 17 | ASP | — | 5.76 | 319.87 | +316.75 |
| 17 | SparseDM | — | 5.67 | 4.23 | +1.11 |
| 18 ImageNet | U-ViT-H/2 | 2.22 s | 113.0 | 2.29 | 0 |
| 18 | DyU-ViT-H/2 λ=.5 | 1.35 s / 1.57× | 67.09 | 2.42 | +.13 |
| 模型 | 预训练 | 追加训练 | FLOPs G | FID | ΔFID |
|---|---|---|---|---|---|
| DiT-XL | 7M | — | 118.69 | 2.27 | 0 |
| DiT-XL | 7M | 150k / 2.14% | 118.69 | 2.16 | -.11 |
| DiT-XL | 7M | 350k / 5% | 118.69 | 2.15 | -.12 |
| DiT-XL + routers | 7M | 150k / 2.14% | 118.69 | 2.15 | -.12 |
| DyDiT λ=.7 | 7M | 150k / 2.14% | 84.33 | 2.12 | -.15 |
| 表 | 模型 | steps | s/image | 加速 | FLOPs G | FID |
|---|---|---|---|---|---|---|
| 20 | DiT-XL 512 | 100 | 18.36 | 1× | 514.8 | 3.75 |
| 20 | DyDiT-XL 512 λ=.7 | 100 | 14.0 | 1.31× | 375.35 | 3.61 |
| 20 | DiT-XL 512 | 250 | 45.9 | 1× | 514.8 | 3.04 |
| 20 | DyDiT-XL 512 λ=.7 | 250 | 35.01 | 1.31× | 375.05 | 2.88 |
| 21 | PixArt-α | 20 | 0.91 | 1× | 141.09 | 19.88 |
| 21 | DyPixArt-α λ=.7 | 20 | 0.69 | 1.32× | 112.44 | 19.75 |
| 表 | 模型 | 速度 | FLOPs G | FID | ΔFID |
|---|---|---|---|---|---|
| 22 | DiT-XL + 250 DDPM | 10.22 | 118.69 | 2.27 | 0 |
| 22 | DiT-XL + 4-step LCM | 0.082 | 118.69 | 6.53 | +4.26 |
| 22 | DyDiT λ=.9 + LCM | 0.076 | 104.43 | 6.52 | +4.25 |
| 23 · 5k samples | DiT-XL | 1× | — | 9.08 | 0 |
| 23 | DyDiT λ=.5 | 1.73× | — | 8.95 | -.13 |
| 23 | ASE-D4 | 1.34× | — | 9.09 | +.01 |
| 23 | ASE-D7 | 1.39× | — | 9.39 | +.31 |
| 表 | 设置 | FLOPs G | FID | ΔFID |
|---|---|---|---|---|
| 24 | DiT baseline | 118.69 | 2.27 | 0 |
| 24 | 10k / 0.14% | 103.08 | 45.95 | +43.65 |
| 24 | 25k / 0.35% | 91.97 | 2.97 | +.70 |
| 24 | 50k / 0.71% | 85.07 | 2.12 | -.15 |
| 24 | 100k / 1.43% | 84.3 | 2.17 | -.10 |
| 24 | 150k / 2.14% | 84.33 | 2.12 | -.15 |
| 25 | DiT-XL baseline | 118.69 | 2.27 | 0 |
| 25 | 100% data | 84.33 | 2.12 | -.15 |
| 25 | 10% data | 84.43 | 2.13 | -.14 |
| 25 | 1% data | 84.37 | 2.31 | +.06 |
核查官方仓库提交 0ddc5097d2bc38c9b68b6c32ac6b53adadc1f865(2025-04-10)。仓库只有 DyDiT/ 与 DyFLUX/ 两个顶层实现目录。
| 已公开 | DiT 的 router、Gumbel-Sigmoid、FLOPs loss、两阶段 λ=.5 shell、λ=.7 shell、DDPM sampling 与 FID 文件生成;DyFLUX-Lite 的 28-step、1024² inference、token gather/scatter 和 TeaCache 入口。 |
|---|---|
| 未见公开路径 | SiT / DySiT、Latte / DyLatte、TD-LoRA、DyFLUX 训练、蒸馏训练、GenEval 脚本、用户研究数据和论文使用的高效 DyDiT 推理 kernel。 |
| DyDiT 训练路径 | DyDiT/models.py:120–140 先完成 full-shape attention,再乘 head mask;models.py:179–190 先执行完整 MLP 线性层,再乘 channel mask。SDT 的完整输出 mask 位于 DiT block 路径。models.py:43–53 虽可按 width_mult 切权重,但固定提交仅在构造器设置该值,仓库没有后续赋值,也没有 DyDiT token gather/scatter。这条路径用于路由训练与 FLOPs surrogate,不能据此断言论文全部速度实验都以 full-shape mask 运行;公开快照缺少论文所需的 DyDiT 高效推理路径。 |
| DyFLUX 公开边界 | DyFLUX/flux_models/dy_utils.py:100–105, 155–160 明确写着只发布 token-dynamic mode,收到 width mask 时抛出 NotImplementedError。transformer_flux_dyn.py:155–174 的 SingleBlock 与 transformer_flux_dyn.py:298–312 的 DoubleBlock 使用 nonzero、索引和写回,确实减少所选图像 token 的 MLP 计算。 |
| 损失系数 | 论文 Equation 8 写 \(w=1.0\);DyDiT/loss.py:31–35, 56–59 把 DynamicLoss.token_loss_ratio 默认设为 2.0 并乘到预算损失。loss.py:63–83 依据 mask 激活率计算 FLOPs surrogate;代码变量 token_ratio 同时用作目标 FLOPs 参数名。 |
| 优化步骤 | 实际调用路径为 DyDiT/train.py:274–279 组装 diffusion、complete-model 与 dynamic loss,train.py:281–282 清空梯度并反向传播,随后 train.py:284 第一次调用 opt.step();train.py:285 才裁剪并读取 norm,norm 低于阈值时在 train.py:286–287 第二次调用 opt.step()。因此同一 batch 可以更新两次,大梯度检查发生在第一次更新之后。 |
| warm-up | DyDiT/train0.5.sh:8–26 运行含完整模型损失的 stage 1,train0.5.sh:29–49 从 30k checkpoint 切换到 train_without_completemodel.py 并训练到 200k。train0.7.sh:9–26 始终调用 train.py;其采样 checkpoint 是 150k。 |
| 可运行性 | 数据、VAE 与 checkpoint 使用 /path/... 占位符,README 引用的 sample_0.7.sh 在固定提交中缺失。需要人工补路径和脚本参数。 |
| DyFLUX 数值快照 | 论文 Table 8 报 Overall 67.64,各子项 99.06/86.36/67.19/78.99/22.25/52.00;固定提交 README 报 67.51 与 99.38/83.59/60.00/81.65/24.50/56.00。README 称 checkpoint 为 work-in-progress 且基于公开数据,不能用其数值替代 v1 内部数据实验。 |
| 用户研究 | 论文写 12 人分成 6 组、每组评估 3,108 个 prompt-image pairs;README 只称 500+ images。论文句子没有说明 3,108 是每组独立样本、总样本或组间分配,统计独立性和置信区间均未提供。 |
1e0724e5553f42bbc8271086d68a3e395455dde9599a8f549b377d15dfe0e95a。原论文 Figures 2、3、5、7、11、13 使用 v1 TeX source 中的官方 PDF 素材转为内嵌 PNG。页面未加载外部字体、脚本或图片;MathJax 3.2.2 完整 bundle 内嵌。