视觉注意力有成本
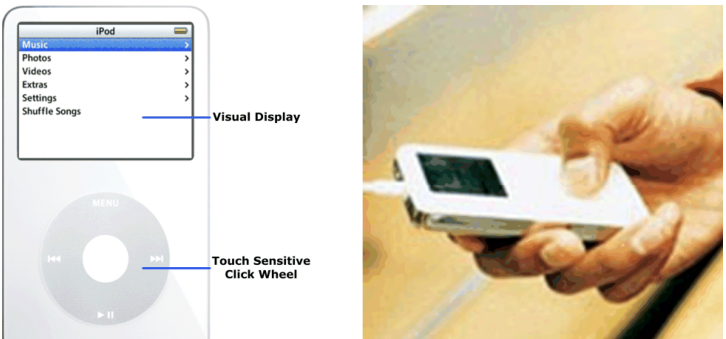
行走、跑步或驾驶会与屏幕争夺视觉注意力;无屏设备、视觉障碍、从口袋取出设备的不便和屏幕耗电也会限制视觉菜单。
用圆形触摸盘把串行语音菜单变成可探索、可中断、可直接访问的空间界面。论文的关键贡献来自交互时序与学习路径设计,并通过 12 人、11,520 次选择的受控实验检验。
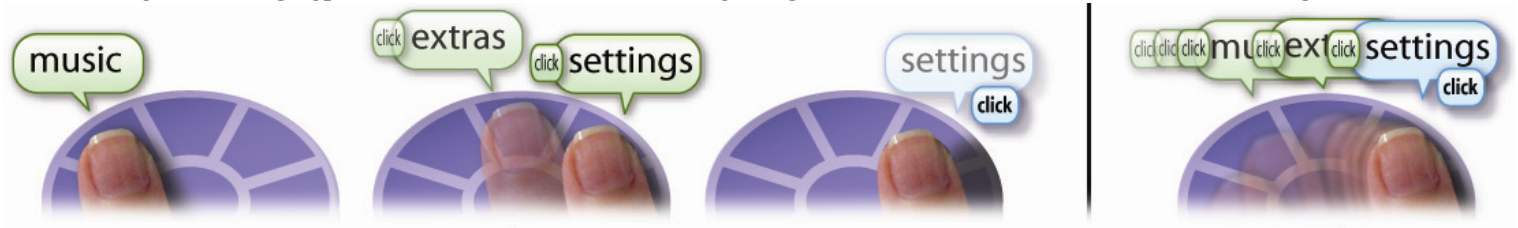
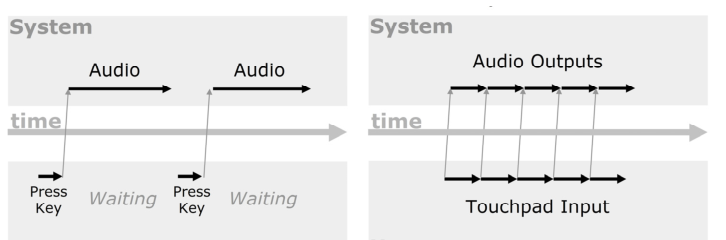
传统 IVR 先播放选项、再等待按键,用户受系统节奏支配。earPod 把语音片段绑定到手指所在扇区:触碰即播报,越界立即截断并切换,抬手确认,中心区域取消。用户可以按自己的速度浏览,也可以在记住位置后直接点击。
行走、跑步或驾驶会与屏幕争夺视觉注意力;无屏设备、视觉障碍、从口袋取出设备的不便和屏幕耗电也会限制视觉菜单。
音频无法像视觉列表那样持续并行呈现。传统 IVR 设定固定播放顺序与速度,用户需要等待并依赖短期记忆,错误恢复成本也较高。
静态且规模适中的菜单如果改用反应式触摸、可中断语音和空间映射,纯听觉反馈也可能获得可接受的新手表现,并支持从探索到直接点击的学习过程。
| 系统类别 | 已有能力 | 论文指出的缺口 | earPod 的处理 |
|---|---|---|---|
| 传统 IVR | 语音提示与数字键快捷访问 | 播放与输入构成顺序对话;中间熟练度用户仍会等待完整列表 | 手指动作主动驱动播放,越界立即切换 |
| Auditory icons / earcons | 非语音提示可辅助导航 | 没有给出完整层级菜单的触摸交互模型 | 语音命名负责语义,click 与 shutter 负责边界和确认 |
| 移动音频手势 | 控制音乐等少量命令 | 命令规模很小 | 评估一层 8 项与两层 8×8 层级 |
| Liao 等的纸笔菜单 | 圆形布局与可中断语音 | 同时依赖视觉、LED 和触觉,且笔输入难以代表移动免视线场景 | 普通触摸盘与立体声耳机,正式实验聚焦纯音频反馈 |
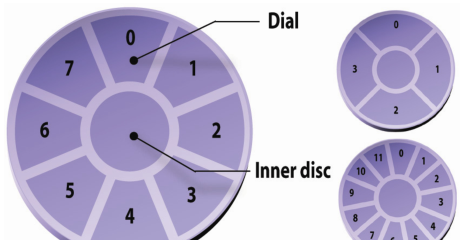
Our Interpretation 论文没有给出数学模型。下列形式化用于明确实现关系。设触摸盘中心为 \(c=(c_x,c_y)\),触点为 \(p_t=(x_t,y_t)\),则半径与极角可写为:
对于 \(N\) 个等宽扇区和方向偏移 \(\theta_0\),扇区索引可实现为:
当 \(r_t\) 位于外圈且 \(k_t\ne k_{t-1}\) 时,系统终止旧音频、播放 click,再开始新语音。抬手事件在外圈触发选择,在中心触发取消。空间迟滞会把刚越过的边界向反方向移动,使返回原扇区需要更大的位移,从而抑制边界附近抖动。论文未公开迟滞距离、压力阈值和具体回退手势。
沿外圈长距离滑动,听取多个完整或部分菜单名。
记住近似位置,先落在附近,再做短距离修正。
记住绝对位置后直接点击;两层菜单以两次点击完成。
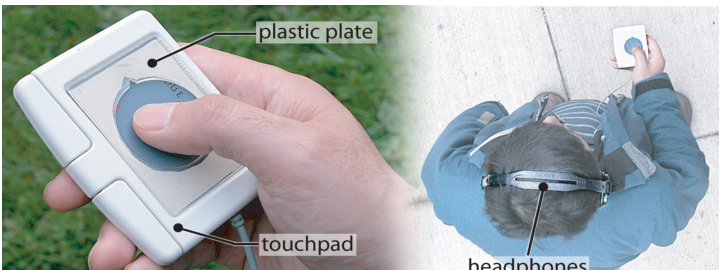
塑料覆盖层开出半径 19 mm 的圆孔,覆盖层厚 2 mm;顶部 3 mm 缺口提供触觉方向。Java 1.5 程序通过 JNI 和 Cirque 专用驱动读取绝对 \(x,y\) 与 pressure。
抬手瞬间的非自主移动会被过滤;扇区边界使用空间迟滞。音频与视觉实验条件使用相同过滤。
真人语音以 16 bit、44 kHz 录制。加载后移除 leading silence,并归一化音量。由于 Java 原生音频库存在可感知延迟,作者扩展了实时声音物理模拟库以降低播放延迟。
单声道人声通过 interaural time difference(ITD)与 interaural intensity difference(IID)编码左右轴。系统没有实现完整三维 HRTF,也没有进行个体校准。作者观察到“声音围绕头部成圆”的主观错觉,并明确将跨模态整合解释留作后续验证。
基线是研究者在 Dell Inspiron 8000、Windows XP 和 19 英寸 LCD 上实现的 iPod-like 视觉菜单。两种条件都使用同一圆形触摸盘;视觉条件沿圆周滑动使屏幕菜单项高亮,抬手完成选择。真实 iPod Nano 使用中心按钮确认,因此这个基线属于模拟接口。实验目标始终以视觉文字显示在屏幕中央,audio 条件只是在菜单反馈阶段免看菜单。
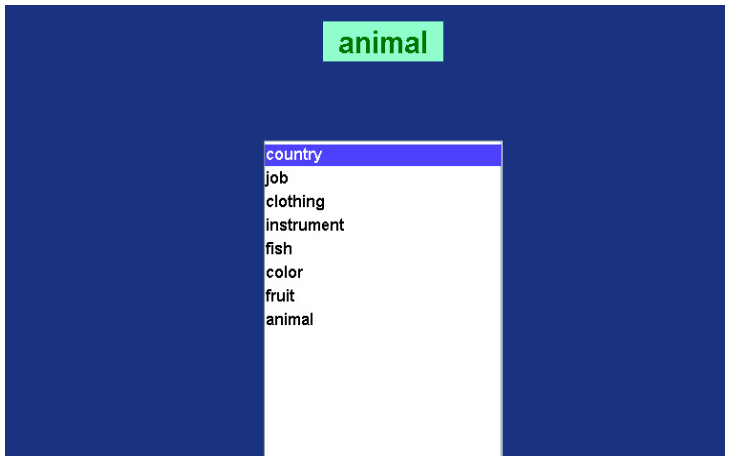
菜单含 8 个上层类别,每类 8 个词,共 64 个叶子。每个词 1–3 个音节,录音约 1 秒。正式实验的两层条件只抽取每类 2 个目标,共 16 个反复练习的叶子;参与者仍需在完整 8×8 结构中查找。论文因而验证了对 16 个固定目标的位置学习,没有验证所有 64 个叶子的熟练掌握。
| 类别 | 完整八项 |
|---|---|
| Clothing | Apron, Brief, Cloak, Coat, Dress, Hat, Jacket(正文只列出 7 项) |
| Fish | Carp, Cod, Eel, Haddock, Pollock, Redfish, Salmon, Sardine |
| Instrument | Bassoon, Cello, Clarinet, Drums, Flute, Guitar, Organ, Piano |
| Job | Actor, Cook, Doctor, Driver, Farmer, Hunter, Lawyer, Soldier |
| Animal | Ants, Apes, Bats, Bears, Eagles, Zebras, Elephants, Horses |
| Color | Black, Blue, Grey, Green, Lime, Navy, Olive, Purple |
| Country | Brazil, China, Denmark, Egypt, England, Finland, France, Greece |
| Fruit | Apple, Banana, Cherry, Grape, Guava, Kiwi, Lemon, Mango |
原 PDF 的 Clothing 行只列出 7 个词,而方法部分声明每类有 8 项、合计 64 项。正文实际枚举共 63 个词,缺少的 Clothing 刺激没有披露。本页保留这项来源内部不一致,复现时需要向作者索取原始实验材料。
| 因素 | 设置 | 控制与限制 |
|---|---|---|
| Technique | audio earPod / visual iPod-like | within-participant;两组六人,技术顺序 6/6 counterbalance |
| Depth | 8 项一层 / 8×8 两层 | 固定先易后难,没有 counterbalance |
| Practice | 每个接口 5 分钟 | 使用正式实验以外的刺激 |
| Trials | \(12\times2\times(8+16)\times20=11{,}520\) | 目标呈现随机;菜单内容与顺序预先固定且所有人相同 |
| Error | 任意层选中项与 stimulus 不匹配 | 显示视觉 “mismatch”;成功 trial 无额外反馈 |
| Time | 目标出现到最终抬手 | 先求每名参与者、每个 cell 的 median,再对参与者取 mean |
Our Interpretation 若 \(C_i\) 表示第 \(i\) 次选择正确与否,准确率可写为 \(A=\frac{1}{n}\sum_{i=1}^{n}C_i\)。对正偏的时间数据,论文先在参与者与设计 cell 内取中位数,再跨参与者求均值;这能降低极端慢 trial 对汇总结果的影响。
| 指标 | earPod / audio | visual | 统计证据与解释 |
|---|---|---|---|
| 总体准确率 | 92.1% | 93.9% | \(p\gt .05\),差异未达显著;该结果无法证明两者等效 |
| 菜单层级准确率 | 一层 94.2%;两层 91.8% | \(F_{1,11}=21.16,\ p\lt .001\) | |
| 总体选择时间 | 技术主效应 \(F\lt1,\ p\gt .05\) | 全部练习阶段合并后没有显著总体差异 | |
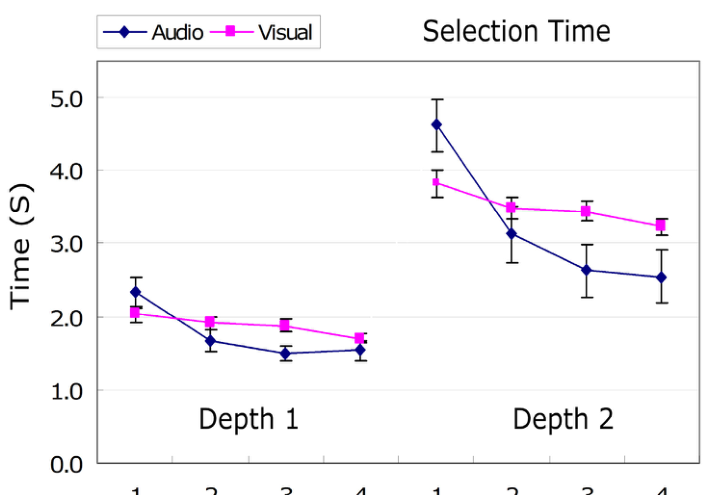
| 菜单层级时间 | 一层 1.9 s;两层 3.4 s | \(F_{1,10}=82.84,\ p\lt .001\) | |
| 三因素交互 | time period × technique × depth | \(F_{3,30}=7.75,\ p\lt .01\),两种深度都出现曲线交叉 | |
| 最后五个 block | 2.1 s | 2.5 s | \(F_{1,10}=6.03,\ p\lt .05\),earPod 快约 16% |
| 达到专家点击 | 一层 9/12;两层 8/12 | 只教授滑动,直接点击由参与者自行发现;其余参与者也在部分 trial 使用点击 | |
| 主观偏好 | audio 4;visual 4;无偏好 4 | 11/12 同意或强烈同意组合两种模式 | |
新手会落在错误扇区后沿外圈逐项滑动。熟练后路径缩短,并逐渐变成一次点击;两层任务的专家行为是两次点击。性能变化与直接访问的采用同时发生。
参与者共有 12 人,但若干时间检验报告 \(df=10\)。正文没有说明排除、缺失数据或自由度处理,因此应保留原报告,不能推断有人退出。
| 结论 | 证据状态 | 理由 |
|---|---|---|
| 固定、规模适中的菜单可用 earPod 准确选择 | Paper Verified | 受控实验准确率 92.1%,与视觉条件差异未显著 |
| 约 30 分钟练习后 earPod 更快 | Paper Verified | 最后五个 block 为 2.1 s 对 2.5 s;限制在反复出现的 16 个目标与固定映射 |
| 空间化音频直接造成学习提升 | Author Claim | 实验没有单独移除空间化,也没有 factorial ablation |
| earPod 适合跑步、驾驶与盲人用户 | Unverified Extension | 正式实验是坐姿桌面环境;移动状态只有未量化的 informal 尝试,驾驶比较当时仍在进行 |
| audio 本身优于 visual | Confounded | audio 同时使用直接空间访问,visual 使用线性访问;作者也承认视觉若支持直接访问,专家表现可能接近 |
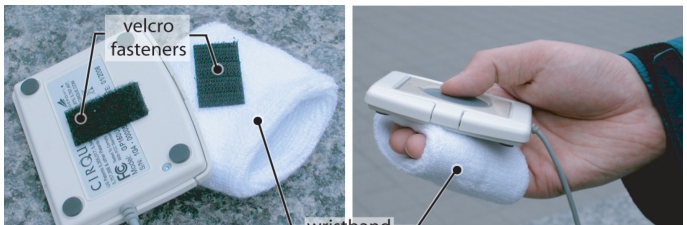
作者让“若干人”在站立、行走和慢跑时做少量选择。站立与行走中的滑动和点击没有明显问题;慢跑时触摸盘晃动使点击困难。把触摸盘用 Velcro 固定到 hand wrap 后,参与者感觉点击更容易。论文没有报告人数、trial 数、准确率、速度或统计检验。
动态长列表会破坏“一项对应一个空间位置”的前提,歌曲列表等内容无法自然获得稳定映射。作者提出 audio 与 visual 并存,让用户按情境选择通道;两种视觉草案分别保留线性标签布局,或直接把视觉菜单排成圆形以强化相同空间模型。
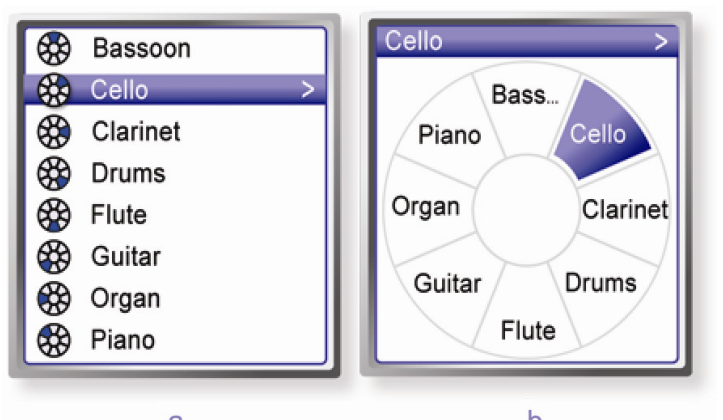
交互模型把音频串行性的弱点转化为用户可控制的扫描过程;click、shutter、可中断语音、取消区与迟滞共同形成完整系统。实验保留了长期练习曲线与运动日志,能解释性能变化来自何种操作策略。
audio/visual 与 direct/linear 两个因素被绑定,无法辨认反馈模态与访问结构的独立贡献。depth 固定先一层后两层,可能混入练习或疲劳。样本小,参与者均未用过 iPod,且正式任务没有移动或并行视觉任务。
硬件、软件版本、音频格式、菜单材料、trial 计数和聚合方式披露较充分。缺少迟滞距离、压力阈值、音频空间化参数、完整 raw logs、菜单缺失刺激项及代码,精确复现仍需补足。
交叉 audio / visual feedback 与 direct / linear access,统一确认动作与训练量。这样可以估计反馈模态、访问结构及两者交互,减少当前核心混淆。
在行走、跑步、驾驶模拟、视觉双任务和设备入袋条件下测量选择时间、错误、主任务干扰和 workload,并预注册安全停止条件。
分别移除 spatialization、boundary click、interruptibility 和 hysteresis,测量学习速度、修正路径与边界错误,检验每个设计机制的独立作用。
研究稳定的类别锚点、分层搜索、频率自适应位置与可撤销回退,评估映射变化对空间记忆的损害,覆盖歌曲列表等长尾内容。