瓶颈 01
token 开销
注意力计算与序列长度呈二次关系。论文引言将其写成“参数数量随 token 数平方增长”,这个表述不准确:固定 Transformer 的权重参数数量不随输入长度改变,变化的是注意力计算量与激活内存。
DiT 把文本、噪声图像与视觉条件表示成 token。直接拼接条件会增加注意力开销;通用 LoRA 又可能改动文本与噪声分支,影响社区定制模型的风格。多条件在只见过单条件训练时还会产生未经训练的条件间交互。
注意力计算与序列长度呈二次关系。论文引言将其写成“参数数量随 token 数平方增长”,这个表述不准确:固定 Transformer 的权重参数数量不随输入长度改变,变化的是注意力计算量与激活内存。
各个控制模块独立训练后直接组合,条件 token 之间会发生训练中未出现的交叉注意力,可能造成身份、姿态、空间结构互相干扰。
EasyControl 只让低秩增量作用于条件 token,保留基础模型的文本与噪声投影。这个结构意在降低控制模块对 Style LoRA 或定制 FLUX 的影响。
条件图像先缩放到固定分辨率,经 FLUX VAE 与 patch packing 得到条件 token;条件专用 LoRA 更新 Q/K/V;结构化注意力隔离各条件分支;位置坐标保持空间对应;推理时缓存条件 K/V。
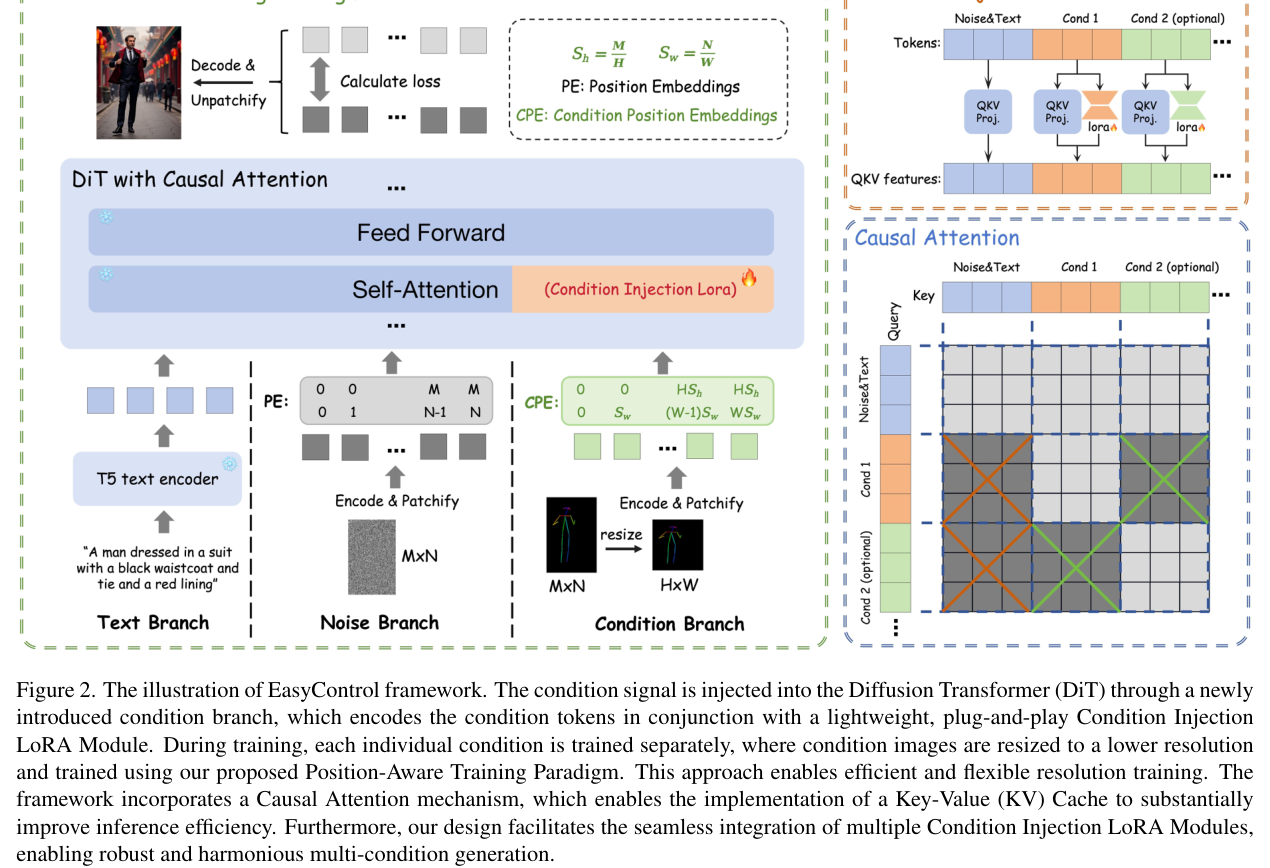
输入:文本提示词、当前噪声 latent \(z_t\)、一个或多个条件图像 \(c_i\)。空间条件包括 Canny、Depth、OpenPose;主体条件提供身份参考。
输出:FLUX flow-matching 速度场预测,经 25 步官方推理示例或论文指定步数迭代为图像 latent,再由 VAE 解码。
训练参数:57 个注意力层中的条件 Q/K/V LoRA;双流块还含输出 projection LoRA。VAE、两套文本编码器与 FLUX 主干冻结。
\(t,n,c\) 分别表示文本、噪声与条件分支。共享矩阵 \(W_Q,W_K,W_V\) 来自预训练 FLUX。
正式论文 Eq. 2/3 的维度标注把 \(A_i,B_i\) 都写成 \(d\times r\),此时 \(B_iA_i\) 无法相乘。与 LoRA 及代码一致的方向应为 \(A_Q\in\mathbb{R}^{r\times d_{\mathrm{in}}}\)、\(B_Q\in\mathbb{R}^{d_{\mathrm{out}}\times r}\),K/V 同理;先降到 \(r\),再升回输出维度。
代码中的 LoRA 层先构造与完整序列同形的 mask,只保留某个条件块,再应用 down/up 投影。每个条件模块因此只改变自己的 token;基础投影仍由冻结的 FLUX 计算。
Eq. 5 定义文本、噪声与条件 Q/K/V 沿 token 维的拼接;Eq. 6 在该联合序列上施加掩码并计算注意力。多条件组合的序列与掩码由 Eq. 9/10 进一步定义。\(d_k\) 是每个 attention head 的 key/query 宽度,\(1/\sqrt{d_k}\) 控制点积尺度。掩码 \(M\) 在 softmax 之前把禁止的 query–key 配对加为 \(-\infty\),允许项加 0;softmax 随后在每个 query 行的 key 维归一化,最终用得到的权重对 \(V\) 加权求和。
RoPE 先接收每个 token 的二维坐标,再旋转 Q/K;PATP 修改的是 RoPE 的坐标输入。主体条件的 64 偏移也加在坐标通道上,不能解释为对旋转后的 feature 直接加 64。
这里的“因果”描述的是分支间信息方向。单条件公式建立了缓存所需的隔离;正式论文多条件公式的文字定义放宽了反向读取,会让条件 K/V 依赖每一步变化的去噪 token。固定提交中的实现维持单向隔离。
\(D\) 表示文本与噪声 token,\(C\) 表示条件 token。行索引 \(i\) 是 query,列索引 \(j\) 是 key。条件 query 不能读取去噪/文本 key;去噪/文本 query 可以读取条件 key。
该条件允许 \(i\in C_k,j\in D\),即条件 query 读取当前去噪状态。此时条件表示随扩散步改变,跨步复用第一步条件 K/V 缺少数学依据。论文同时宣称条件分支与 timestep 无关,二者在这个公式下无法同时成立。
| query / key | 去噪/文本 \(D\) | 条件 \(C_1\) | 条件 \(C_2\) |
|---|---|---|---|
| 去噪/文本 \(D\) | 允许 | 允许 | 允许 |
| 条件 \(C_1\) | 阻断 | 允许 | 阻断 |
| 条件 \(C_2\) | 阻断 | 阻断 | 允许 |
实现先将全部 query 行设为阻断,再把前 \(n_D\) 行全部清零,随后只清零每个条件块自己的对角子矩阵。这个 combined mask 与 Eq. 8 一致,并扩展为“各条件互不读取”。对应 src/layers_cache.py:143–152, 301–311。
条件分支 embedding \(e_c\) 在代码中以 cond_temb 表示,并使用零 timestep 构造,所以不随 denoising step 改变;它仍使用同一张图生成期间固定的 pooled text projection 与 guidance。条件图像、提示词、guidance、LoRA 权重或条件数量发生变化时,缓存都需要失效。
管线在每次调用开始时遍历全部 attention processor 并执行 bank_kv.clear();随后用 32 个 warm-up latent token 触发一次条件缓存。后续步只重新计算去噪/文本 Q/K/V,拼接缓存的条件 K/V,并复用第一轮保存的条件 attention 输出。官方示例结束后再次显式清空。
实现按“缓存是否为空”判断复用,没有缓存键来校验 prompt、guidance、条件图像、分辨率与 LoRA。只要绕过管线或在同一 processor 上直接调用 Transformer,就需要调用者主动清空。
空间条件统一缩放为 512×512。其 RoPE 坐标覆盖输出图像对应的 packed latent token 网格;主体条件使用固定坐标偏移分离主体区域。
令输出 packed token 网格为 \((h_o,w_o)\),条件 packed token 网格为 \((h_c,w_c)\)。位置缩放比例与像素尺寸比例相同,但坐标单位始终是 packed token。
这些坐标先输入 RoPE,用来旋转 Q/K。实现没有对旋转后的 feature 直接增加坐标数值。
512×512 条件对应 \(32\times32=1024\) 个 packed token;1024×1024 输出对应 \(64\times64=4096\) 个 packed token,因此 \(s_h=s_w=2\)。
条件坐标末端是 62,输出网格坐标范围是 0 至 63。这个半开区间解释了论文 Eq. 13/14 把端点写作输出尺寸时容易产生的歧义,也避免把像素高度 512 与 packed 网格高度 32 混为同一个 \(H\)。
补充材料 Eq. 16 在主体条件坐标的高度通道加入固定偏移:
代码修改传给 RoPE 的 packed token 坐标。64 属于该坐标单位,含义是把主体条件放入独立位置区间;它没有加到已经旋转的 Q/K feature 上。
PATP 依赖条件缩放后仍保留足够结构。极高输出分辨率会让固定 1024 个条件 token 覆盖更大跨度,局部控制变粗。补充材料 Figure 7 与 Limitations 明确报告极高分辨率下控制能力下降。
论文公开了主干、设备、批量、学习率与步数;代码补足 LoRA rank、混合精度、优化器与位置实现。没有公开完整训练数据清洗、学习率调度细节对应的实验日志、随机种子和训练时间。
Eq. 15 中的 \(\epsilon\) 是由 torch.randn_like 采样的 Gaussian noise;训练目标是速度 \(\epsilon-x_0\)。论文原文把 \(\epsilon\) 解释为 predicted noise,和公式及代码不一致。
正式 Table 1 caption 说明 1024×1024、25 denoising steps;§4.1 同样写 25 sampling steps。§4.3.2 正文却写单张 A100、20 sampling steps。代码的正式推理示例为 25,训练期 validation 为 20。
这些文字来自同一正式论文版本,缺少公开计时脚本与实验日志,无法判断 Table 1 的时间究竟对应 20 还是 25 步。网页保留冲突,不选择其中一个数值替代另一个。
正式补充材料补足了 Face 数据来源和 Table 2–4 的评测方式。指标包含控制一致性、文本一致性、图像质量、主体身份与人体关键点误差,必须分别阅读。
Face 条件模型使用经过整理的 LAION-Face 子集,以及作者收集的私有 multi-view human dataset。所有人物图像先由 InsightFace 执行人脸裁剪与归一化配准。私有数据规模、许可、筛选阈值与划分没有公开,因此该分支无法仅依靠公开资料完整复现。
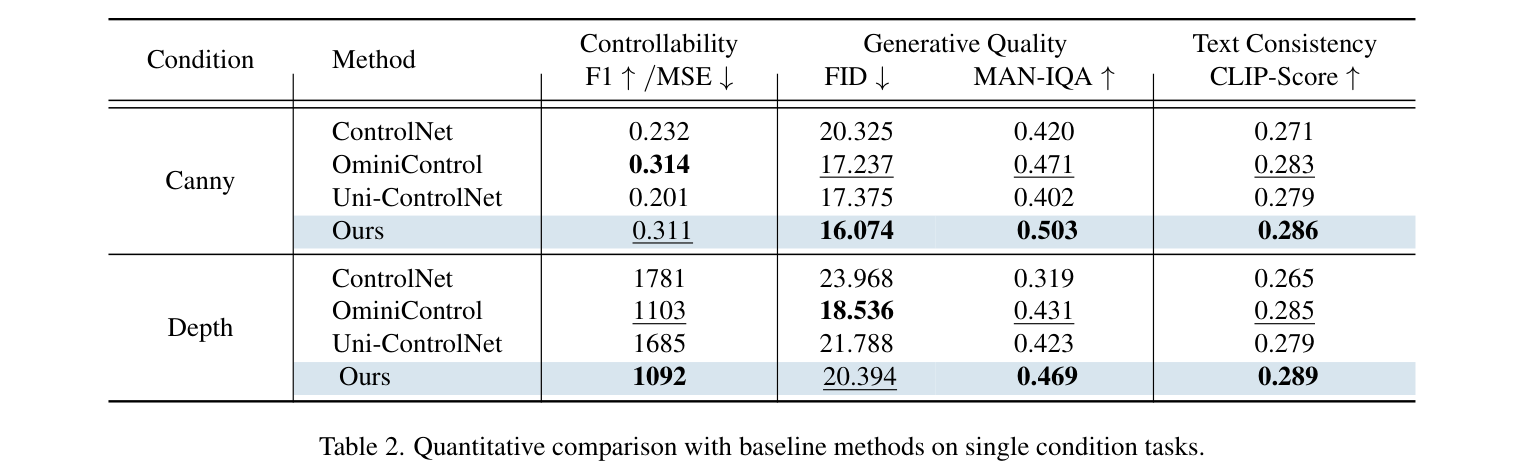
Table 2 使用 COCO 2017 validation 的全部 5,000 张图像,保留原始分辨率与长宽比例,并以 ground-truth caption 作为文本提示。对生成图像再次提取 Canny 或 Depth:Canny F1 比较提取边缘与输入边缘,Depth MSE 比较提取深度图与输入深度图。
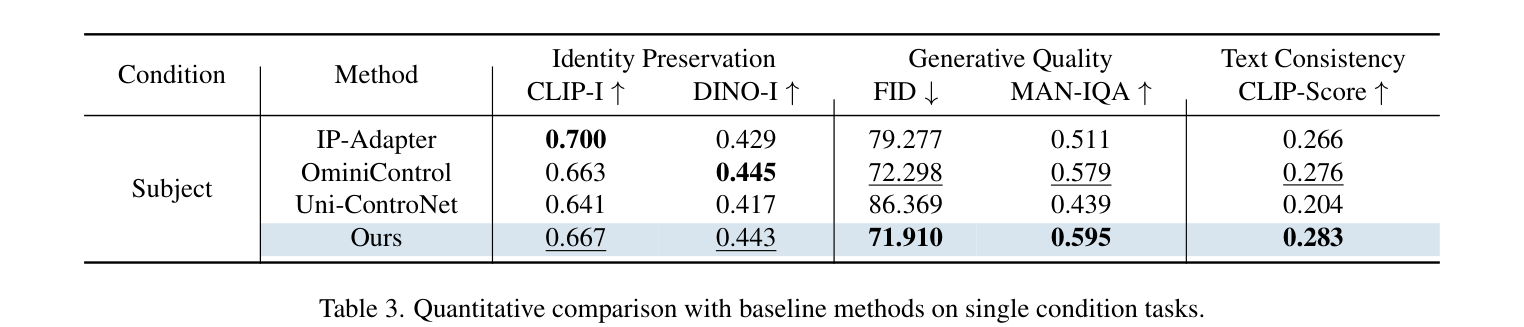
Table 3 使用 Concept101。每张参考图配合与主体语义一致的文本生成图像。CLIP-I 和 DINO-I 分别用 CLIP 与 DINO 图像编码器计算生成图和参考图特征的 cosine similarity,用于衡量身份保持。
CLIP-Score 衡量生成图与文本提示的一致性;FID 衡量生成分布与参考真实图像分布的距离;MAN-IQA 衡量无参考图像质量。不同指标方向不同:F1、CLIP-Score、MAN-IQA、CLIP-I 与 DINO-I 越高越好,MSE 与 FID 越低越好。
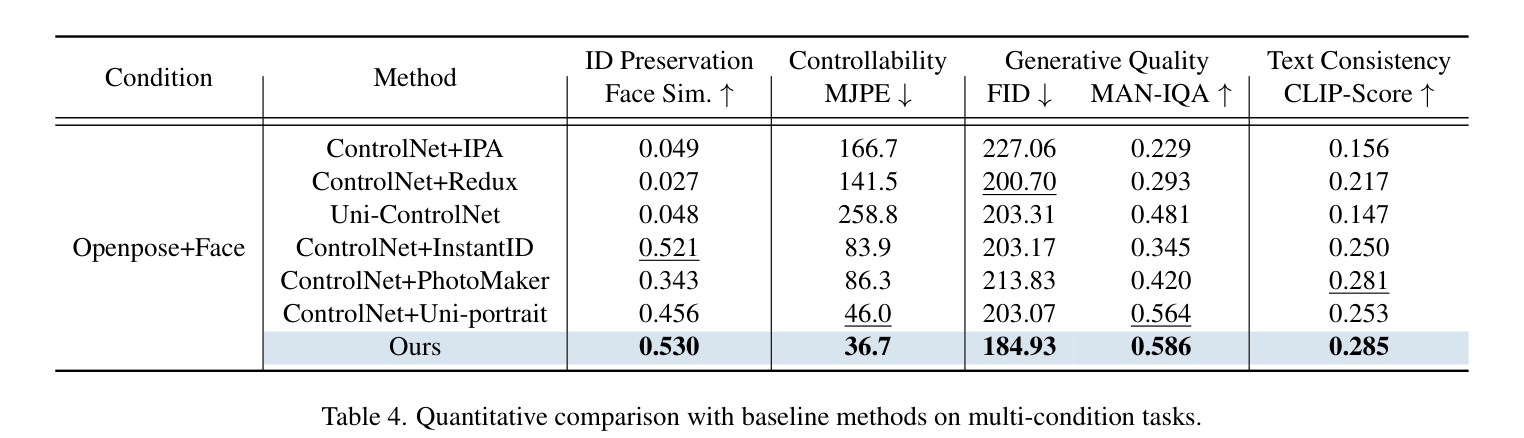
Table 4 的 Face Similarity 衡量生成脸与参考脸的相似度。MJPE 由 OpenPose 提取输入与生成图的人体关键点,计算对应关节的 Euclidean distance,先在每张图内求平均,再在数据集上求平均;数值越低越好。
EasyControl 没有包揽全部指标:Depth 的 FID 为 20.394,OminiControl 为 18.536;Canny F1 为 0.311,OminiControl 为 0.314。Subject 的 CLIP-I 与 DINO-I 两项也都没有达到最高值。其结果更接近控制、文本一致性、质量和效率之间的综合取舍。
补充材料 F.1 说明部分 baseline 无法迁移条件,或无法检测生成图中的 face/pose,因此对应指标不能准确计算。论文没有公开失败样本占比,也没有说明这些样本在汇总时被记为最差值、被排除,或采用其他规则。该缺口会改变 Face Similarity 与 MJPE 的分母和均值,限制 Table 4 的独立复现与公平比较。
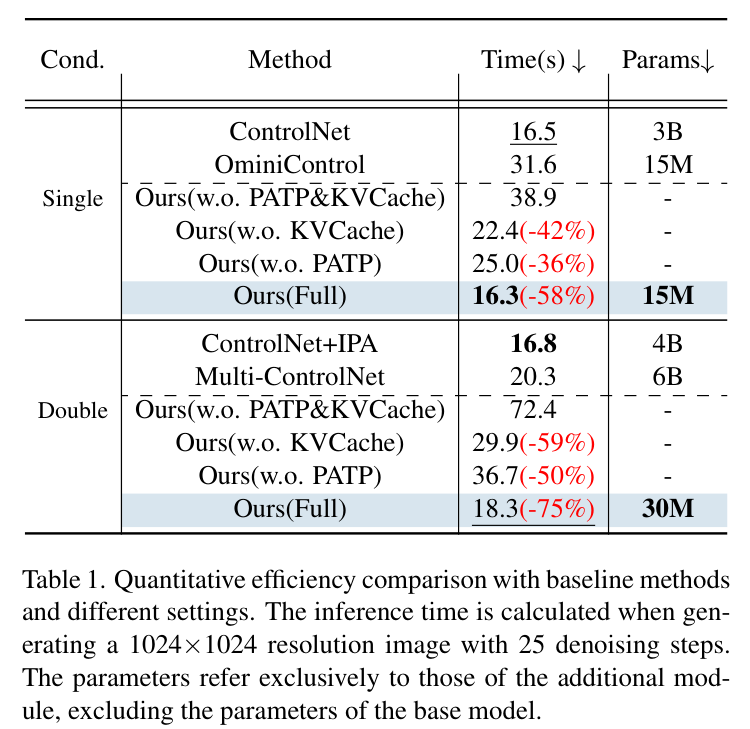
15M/30M 只表示新增 Condition Injection LoRA 参数,不包含约 12B 的 FLUX.1-dev 主干。所有百分比来自相对自身 “w.o. PATP & KVCache” 的 ablation;双条件完整模型比 ControlNet+IPA 慢 1.5 秒。
完整模型,15M 新增参数。相对 38.9s ablation 延迟降低约 58%。ControlNet 为 16.5s。
完整模型,30M 新增参数。相对 72.4s ablation 延迟降低约 74.7%,等价于约 3.96 倍吞吐。
双条件 Ours 18.3s,ControlNet+IPA 16.8s。EasyControl 的优势在新增参数量与自身 ablation 加速;数据不支持“所有条件设置都最快”。
| 条件数 | 方法 | 时间 | 新增模块参数 | 解读 |
|---|---|---|---|---|
| 单条件 | ControlNet | 16.5s | 3B | 时间略慢于 Ours Full |
| OminiControl | 31.6s | 15M | 参数量相同,延迟更高 | |
| Ours w.o. PATP & KVCache | 38.9s | — | 内部基准 | |
| Ours w.o. KVCache | 22.4s (−42%) | — | PATP 单独保留 | |
| Ours w.o. PATP | 25.0s (−36%) | — | KV Cache 单独保留 | |
| Ours Full | 16.3s (−58%) | 15M | 本组最低延迟 | |
| 双条件 | ControlNet + IPA | 16.8s | 4B | 本组最低延迟 |
| Multi-ControlNet | 20.3s | 6B | 新增模块最大 | |
| Ours w.o. PATP & KVCache | 72.4s | — | 内部基准 | |
| Ours w.o. KVCache | 29.9s (−59%) | — | PATP 单独保留 | |
| Ours w.o. PATP | 36.7s (−50%) | — | KV Cache 单独保留 | |
| Ours Full | 18.3s (−75%) | 30M | 比 ControlNet+IPA 慢 1.5s |
| 条件 | 方法 | F1↑ / MSE↓ | FID↓ | MAN-IQA↑ | CLIP-Score↑ |
|---|---|---|---|---|---|
| Canny | ControlNet | 0.232 | 20.325 | 0.420 | 0.271 |
| OminiControl | 0.314 | 17.237 | 0.471 | 0.283 | |
| Uni-ControlNet | 0.201 | 17.375 | 0.402 | 0.279 | |
| Ours | 0.311 | 16.074 | 0.503 | 0.286 | |
| Depth | ControlNet | 1781 | 23.968 | 0.319 | 0.265 |
| OminiControl | 1103 | 18.536 | 0.431 | 0.285 | |
| Uni-ControlNet | 1685 | 21.788 | 0.423 | 0.279 | |
| Ours | 1092 | 20.394 | 0.469 | 0.289 |
| 方法 | CLIP-I↑ | DINO-I↑ | FID↓ | MAN-IQA↑ | CLIP-Score↑ |
|---|---|---|---|---|---|
| IP-Adapter | 0.700 | 0.429 | 79.277 | 0.511 | 0.266 |
| OminiControl | 0.663 | 0.445 | 72.298 | 0.579 | 0.276 |
| Uni-ControlNet | 0.641 | 0.417 | 86.369 | 0.439 | 0.204 |
| Ours | 0.667 | 0.443 | 71.910 | 0.595 | 0.283 |
| 方法 | Face Sim.↑ | MJPE↓ | FID↓ | MAN-IQA↑ | CLIP-Score↑ |
|---|---|---|---|---|---|
| ControlNet + IPA | 0.049 | 166.7 | 227.06 | 0.229 | 0.156 |
| ControlNet + Redux | 0.027 | 141.5 | 200.70 | 0.293 | 0.217 |
| Uni-ControlNet | 0.048 | 258.8 | 203.31 | 0.481 | 0.147 |
| ControlNet + InstantID | 0.521 | 83.9 | 203.17 | 0.345 | 0.250 |
| ControlNet + PhotoMaker | 0.343 | 86.3 | 213.83 | 0.420 | 0.281 |
| ControlNet + Uni-portrait | 0.456 | 46.0 | 203.07 | 0.564 | 0.253 |
| Ours | 0.530 | 36.7 | 184.93 | 0.586 | 0.285 |
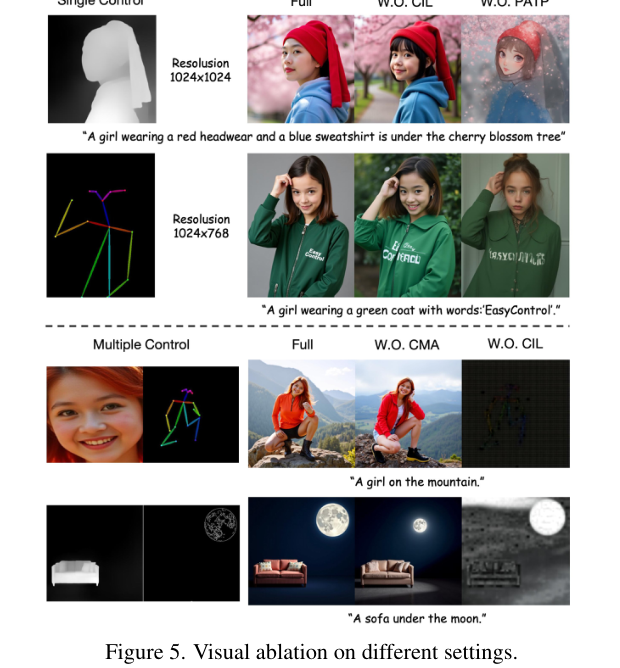
定量消融集中在 PATP 与 KV Cache 的延迟;CIL、CMA 与分辨率适应主要由 Figure 5 的视觉对比支持,缺少独立数值表。
用标准 LoRA 替代条件专用 LoRA,单条件仍可控制,多条件零样本组合失败。证据是 Figure 5 视觉结果;论文没有报告可重复的数值或冲突强度统计。
控制信号与噪声都固定为 512×512。1024×1024 或 1024×768 推理出现 artifact 与质量下降;效率表显示 single 25.0s、double 36.7s。
仍能生成图像,但多条件控制发生姿态与物体位置偏移。该结果支持条件间隔离具有作用;现有证据无法区分掩码结构中各条边的独立贡献。
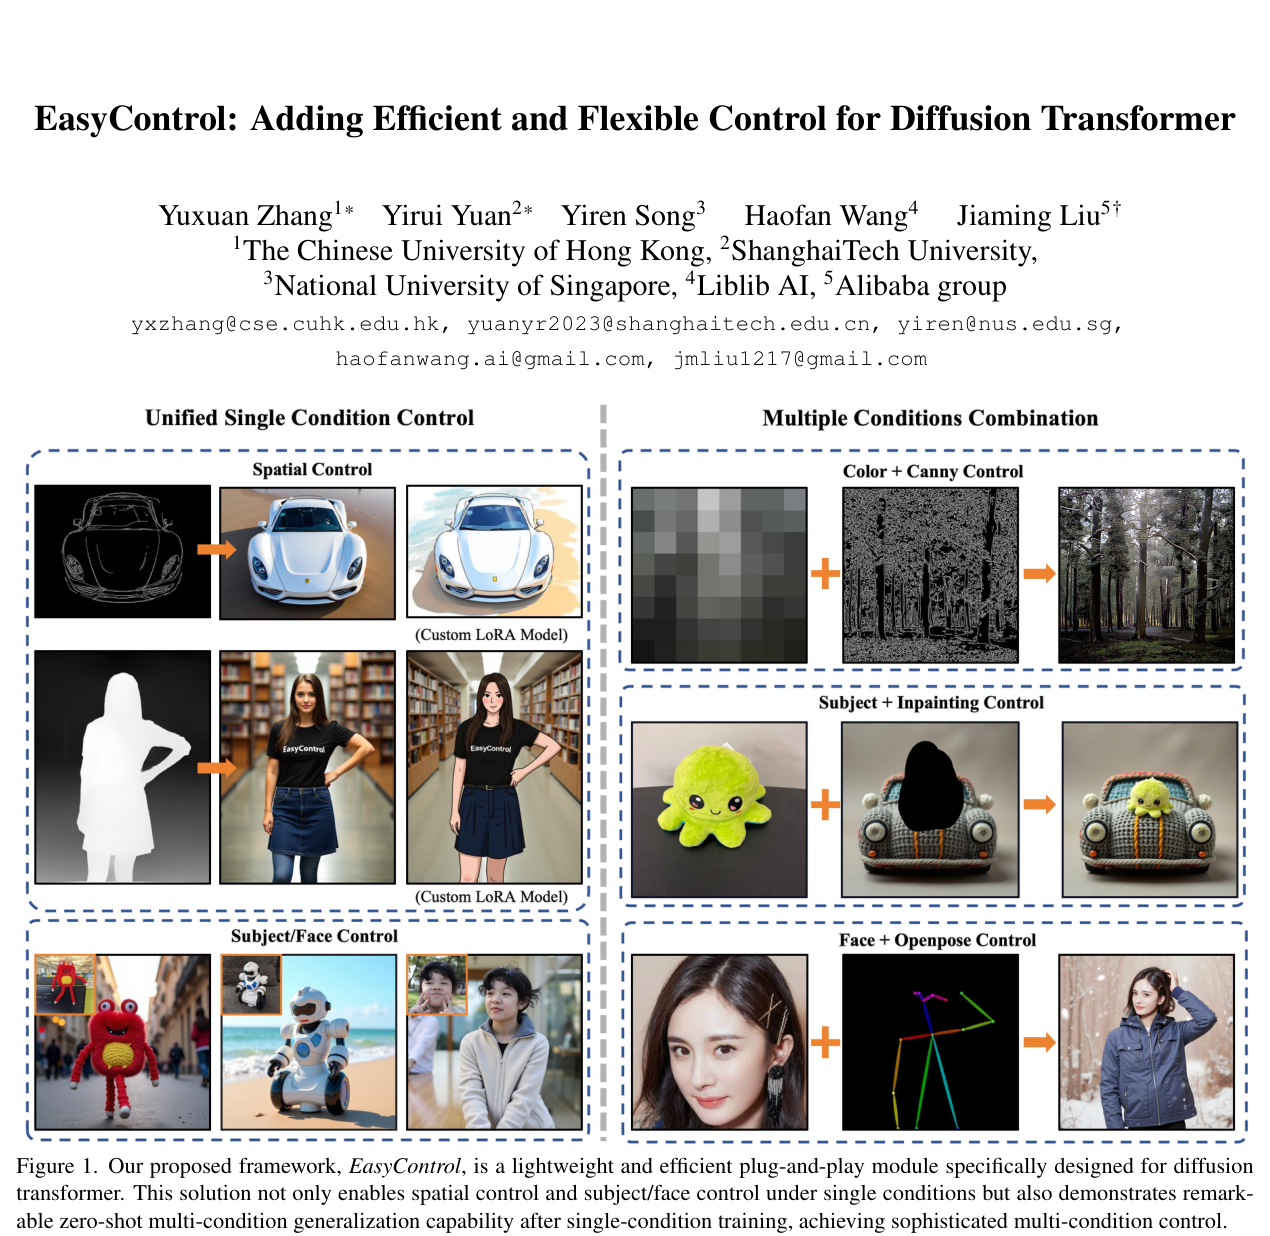
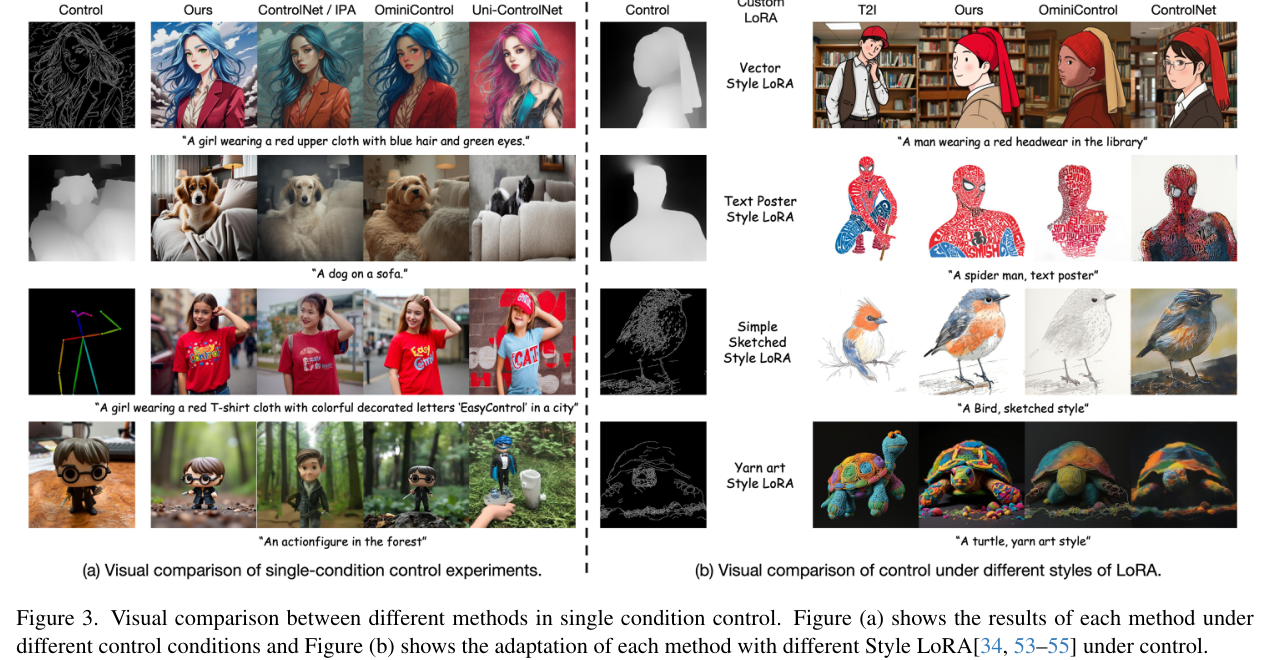
以下图像均从 CVF 正式论文及补充材料直接裁取。定量表已经在上文逐行重建。
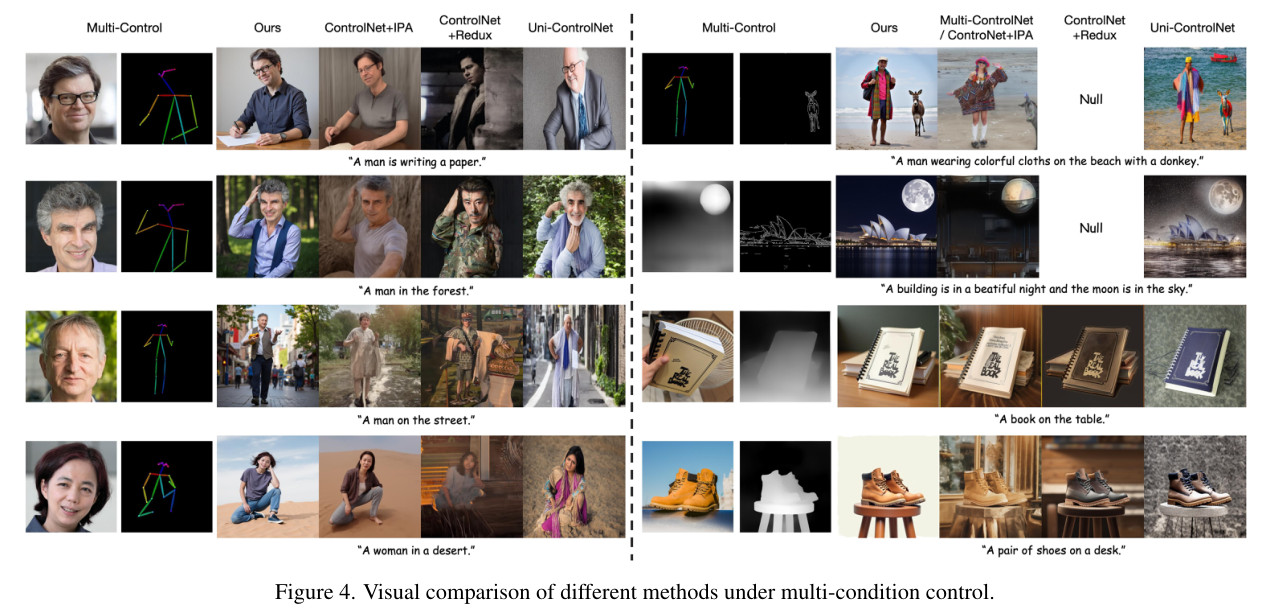
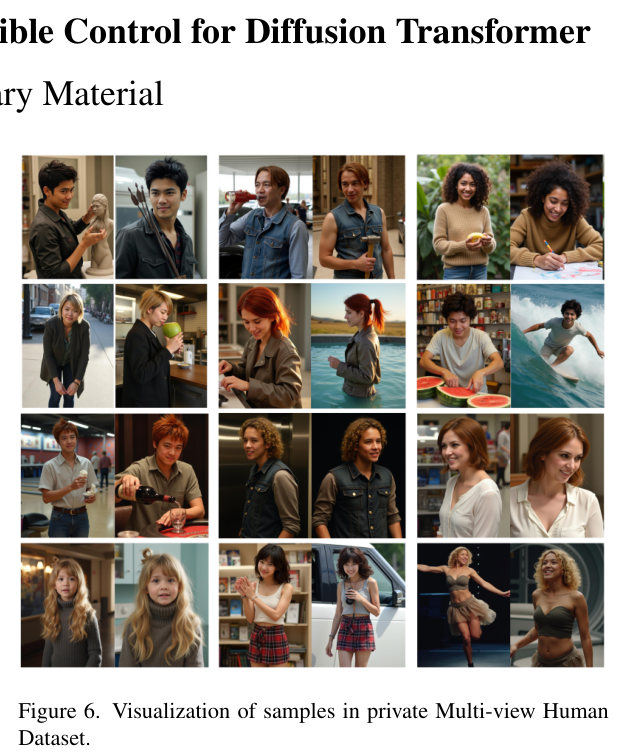
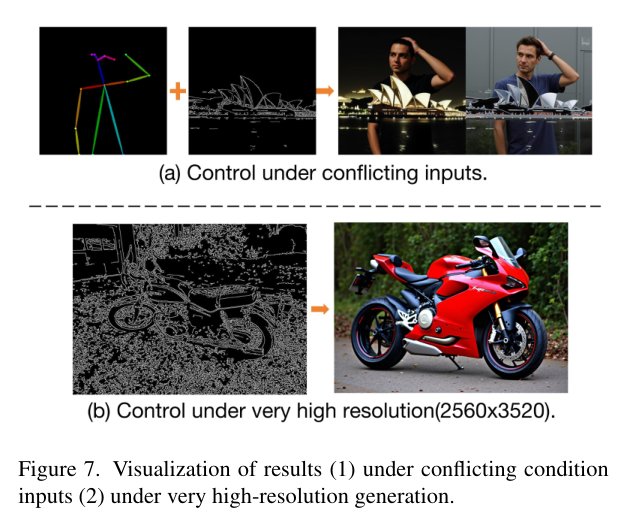
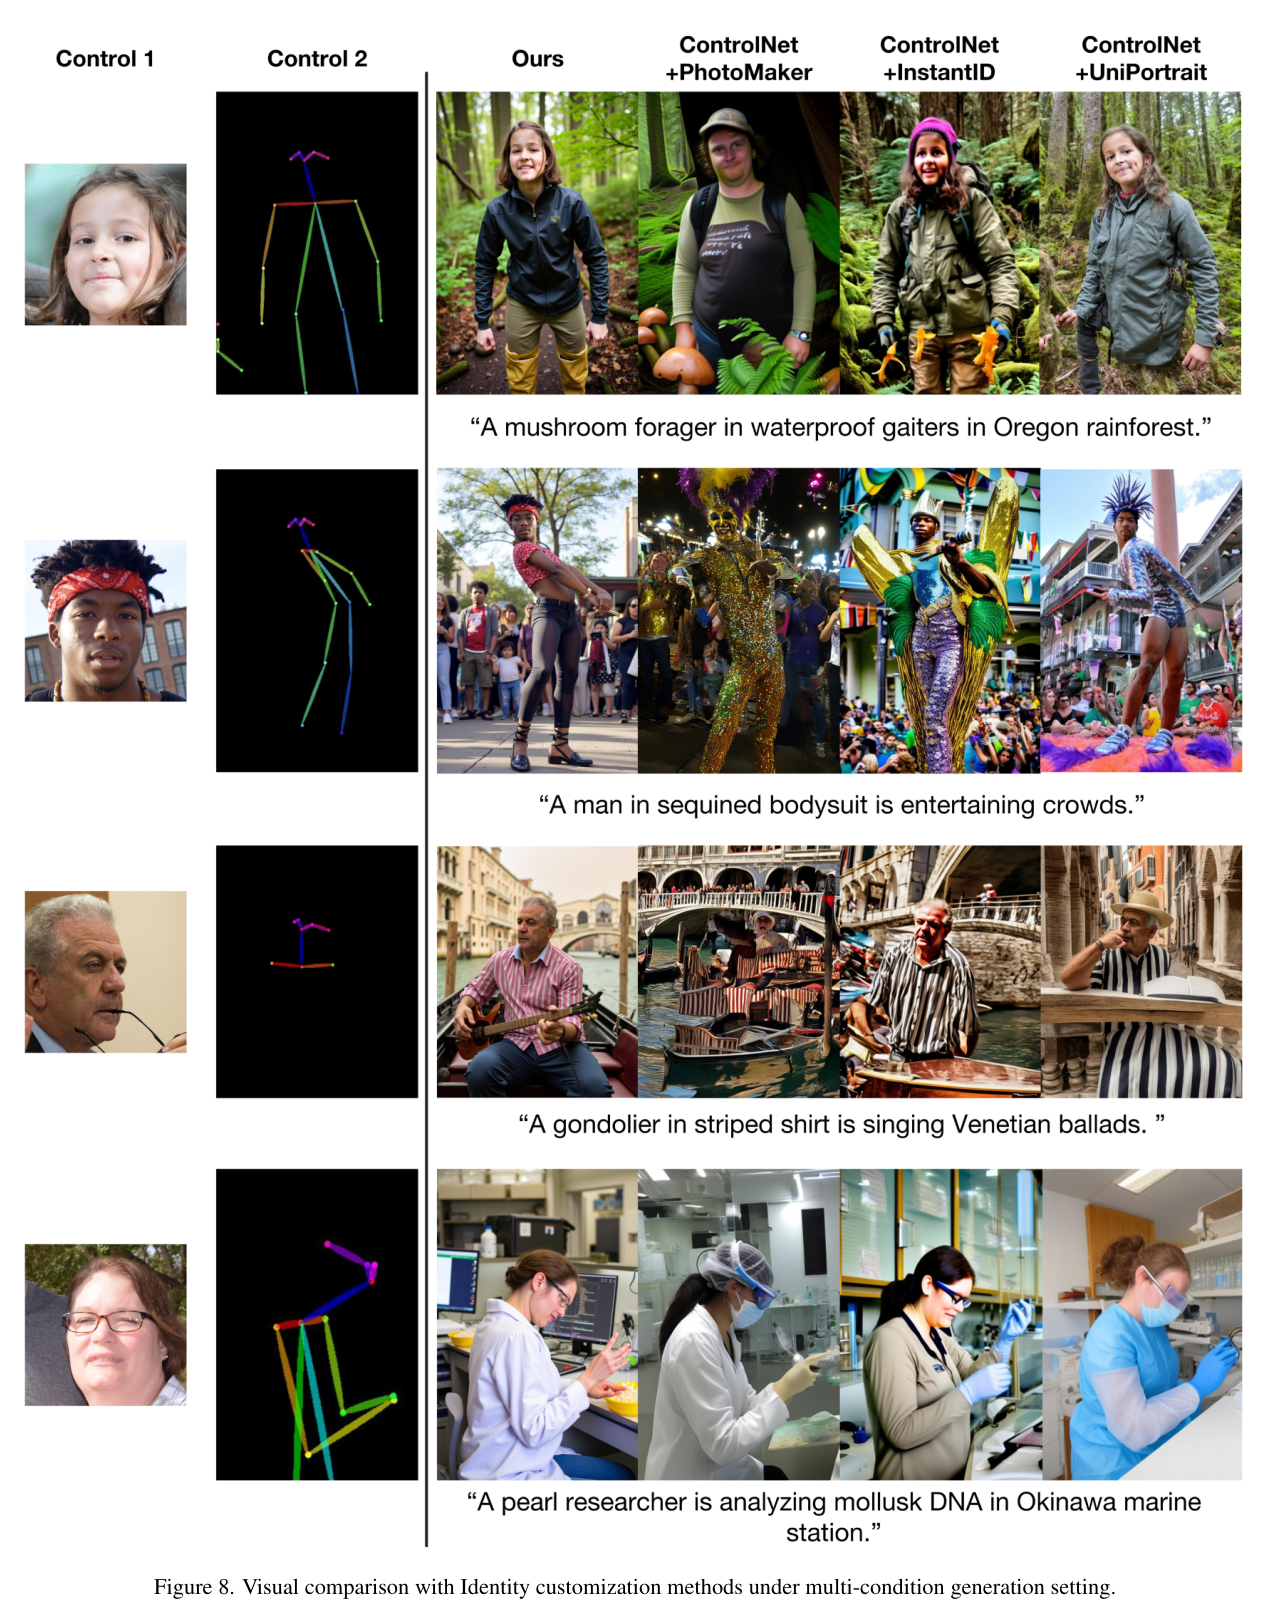
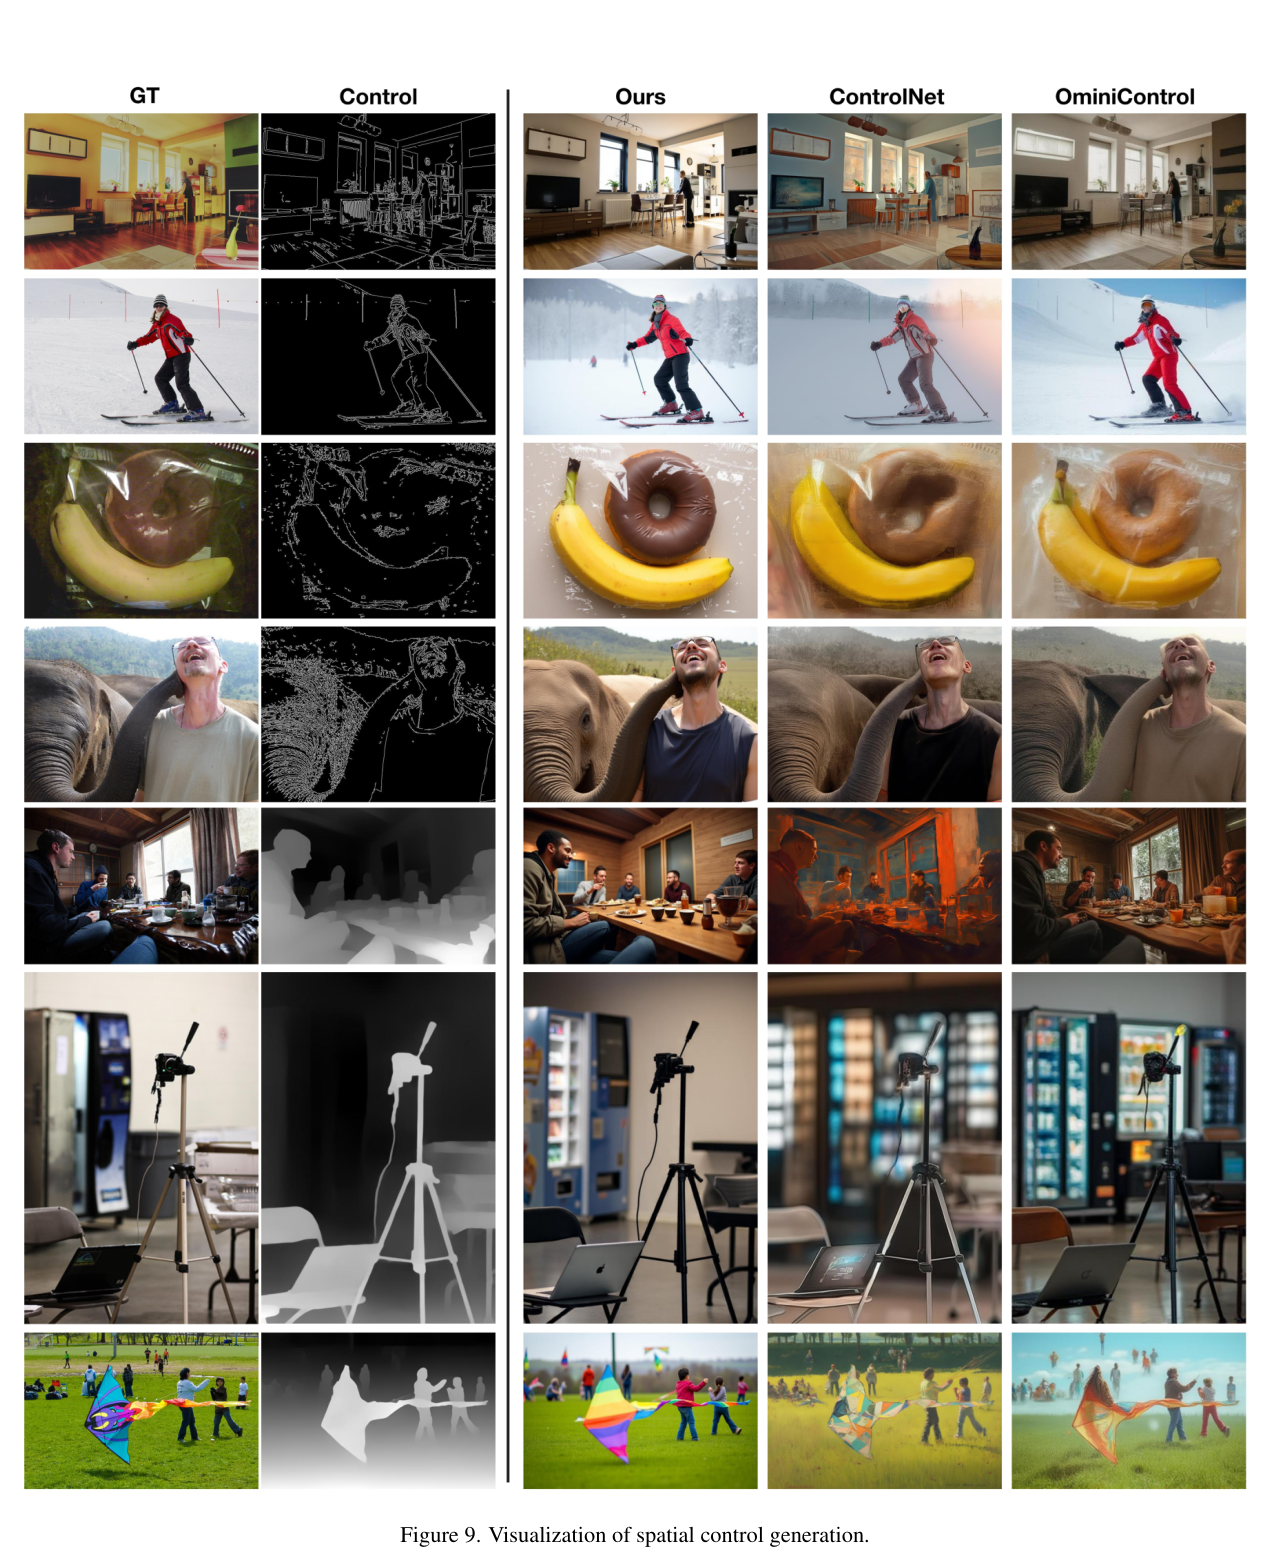
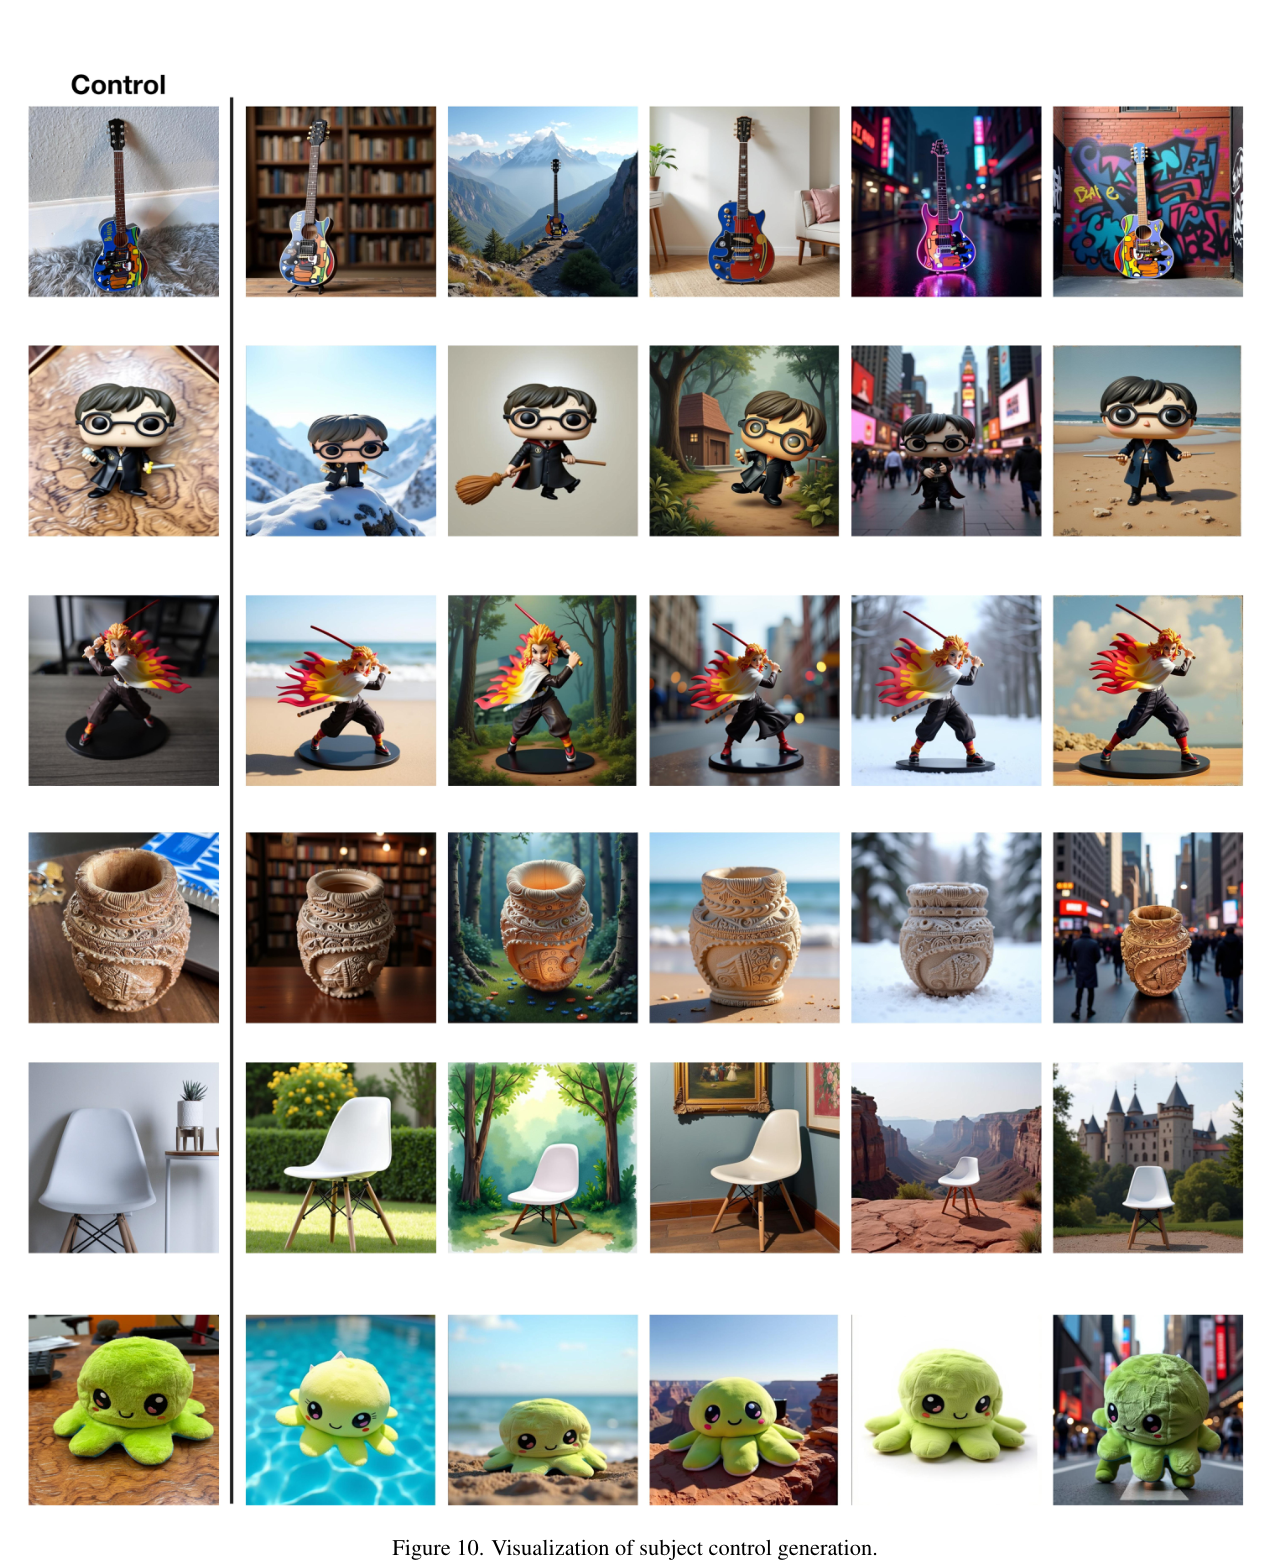
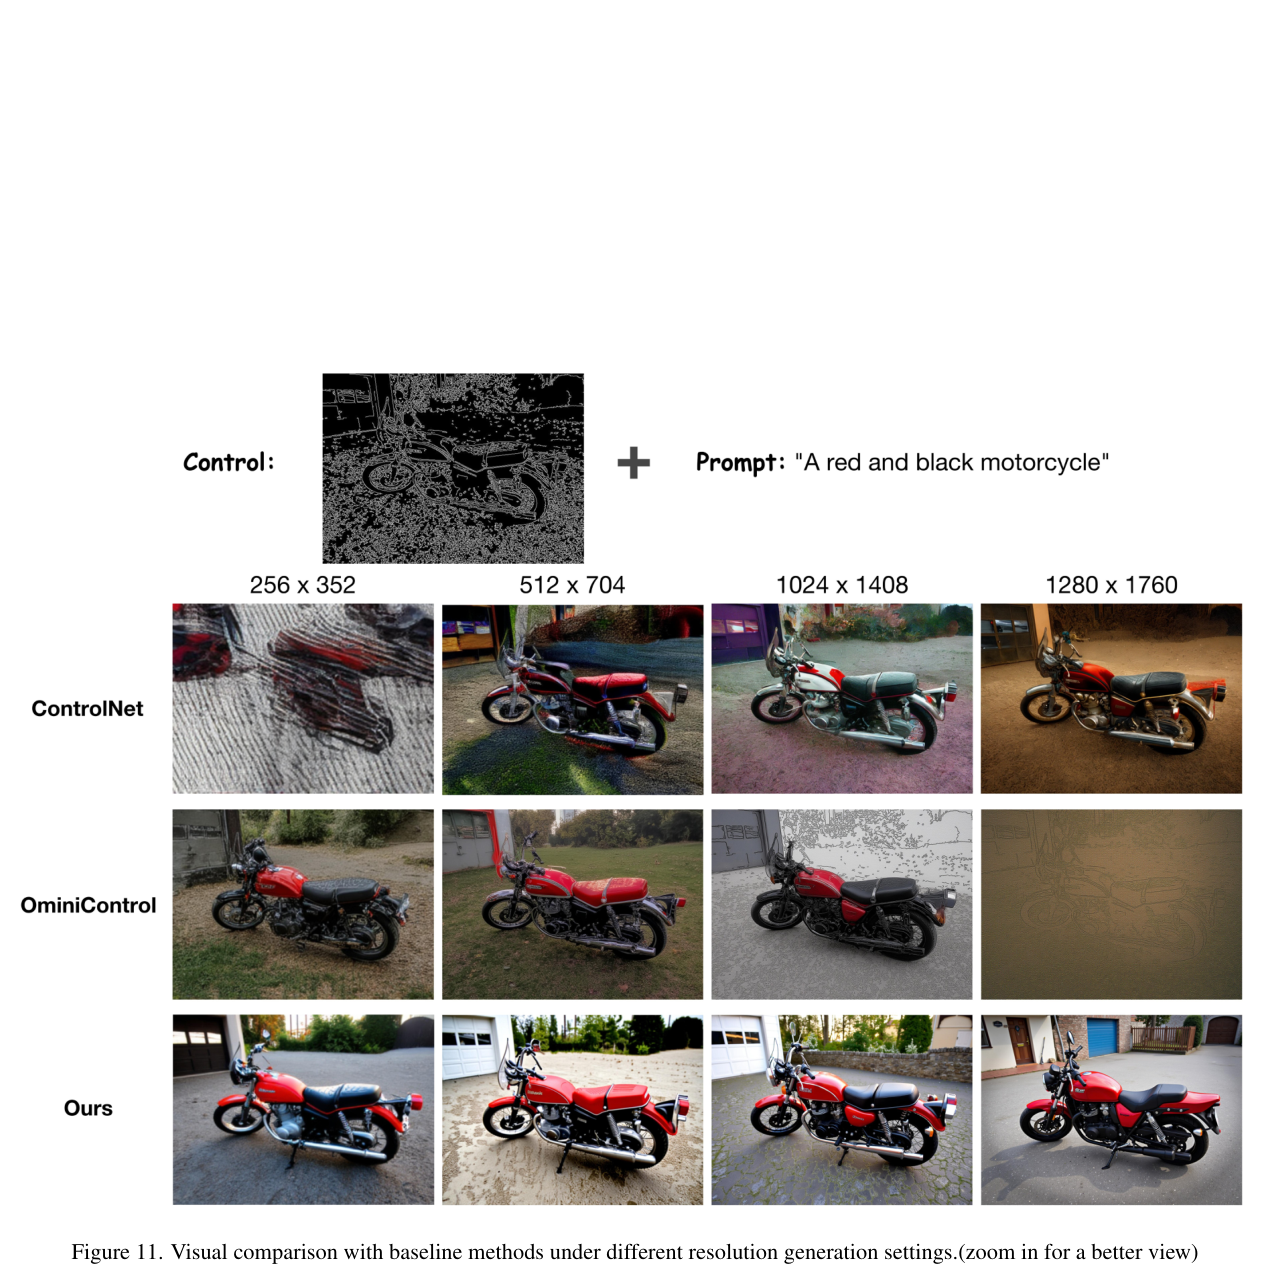
该提交日期为 2025-04-11,包含训练代码、推理管线与缓存实现。后续 Ghibli 风格模型、CFG-Zero 集成和社区节点属于论文之后的扩展,没有用于解释原论文实验设置。
训练脚本在冻结主干后统计可训练 LoRA 参数,论文 Table 1 明确注明只计算 additional module。15M 表示一个条件模块,30M 表示两个模块的线性相加;FLUX.1-dev 约 12B 主干仍参与每一步去噪计算。
缓存消除条件分支重复的 Q/K/V、条件自身 attention 与随后的条件状态计算。去噪/文本 query 仍需对拼接后的全部 key 做 attention,因此 KV Cache 没有消除所有随条件 token 数增加的注意力成本。PATP 同时减少每个条件的 token 数,两者配合才形成 Table 1 的延迟下降。
身份核查:正式 PDF 标记 Yuxuan Zhang 与 Yirui Yuan 为共同第一作者,并标记 Jiaming Liu 为通讯作者。正式版第一作者第一机构是 The Chinese University of Hong Kong;arXiv v1 的机构排列与后续 README 展示不同,应以相应版本的 PDF 为准。