CNF 很一般,传统训练却被 ODE 成本卡住
CNF 可以表示广泛的确定性概率路径,diffusion probability-flow ODE 只是其中一类。
训练时随机采样 \(t,x_1,x_0\),直接回归条件向量场,不沿完整轨迹积分。
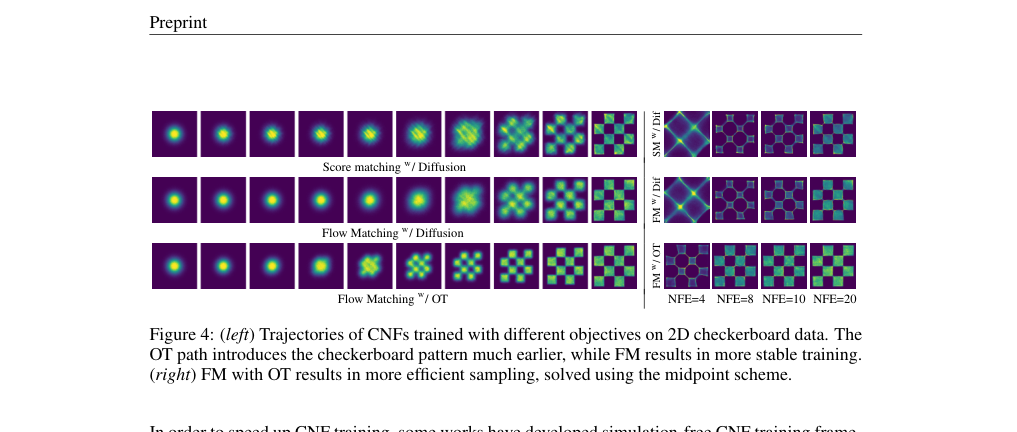
conditional OT 让均值与标准差线性变化,条件粒子沿直线匀速移动。
从密度路径到可训练的条件回归
时间 \(t\in[0,1]\) 按论文约定从噪声走向数据:\(t=0\) 对应先验 \(p_0=\mathcal{N}(0,I)\),\(t=1\) 对应数据分布 \(q\) 的平滑近似。\(d\) 是数据维度;对 RGB 图像即 \(d=H\times W\times3\)。\(\theta\) 是神经向量场 \(v_t(x;\theta)\) 的可训练参数。
CNF 与连续性方程
流映射 \(\phi_t\) 由常微分方程定义。若 \(x_0\sim p_0\),则 \(\phi_t(x_0)\sim p_t\)。
连续性方程表达质量守恒:某处密度的变化等于流入与流出的净差。验证某个向量场是否生成目标密度路径时,它给出必要且充分的判据。
边际路径与 posterior-weighted vector field
权重恰好是给定当前位置 \(x\) 与时间 \(t\) 后,数据端点 \(x_1\) 的后验密度。因此目标边际场 \(u_t(x)\) 是所有可能条件场的后验加权平均;它由所选概率路径在数学上确定,通常不能直接计算。网络 \(v_t(x;\theta)\) 是可训练近似器,CFM 用可计算的条件场监督它,使其在期望上学习 \(u_t\)。Theorem 1 将每条条件连续性方程乘以 \(q(x_1)\) 后积分,并在正则条件允许时交换时间微分、空间散度与积分,从而得到边际连续性方程。
FM 与 CFM 的关系
展开平方范数后,\(\mathbb{E}\|v_t\|^2\) 与交叉项在两个目标中相同;仅 \(\|u_t\|^2\) 与 \(\|u_t(\cdot\mid x_1)\|^2\) 的期望不同,而二者都不含 \(\theta\)。因此两个损失相差一个与参数无关的常数,期望梯度完全相同。
同一套 CFM,换一条条件路径就换一种生成动力学
标准高斯 \(x_0\) 经仿射映射后正好服从条件高斯。Theorem 3 的“unique”指给定这一个可逆 affine flow map \(\psi_t\) 时,对应的生成向量场唯一;只给定密度路径时仍可加入保持密度不变的分量,因此向量场一般不唯一。
Diffusion path
VE 与 VP 的噪声→数据路径来自常用扩散过程的时间反转。VP 采用 \(\alpha_t=\exp(-T(t)/2)\),其中 \(T(t)=\int_0^t\beta(s)ds\)。所得条件场与 diffusion probability-flow ODE 一致。
Conditional OT path
均值与标准差均线性变化,\(\sigma_{\min}\gt0\) 保留末端平滑。训练样本的目标速度与时间无关。
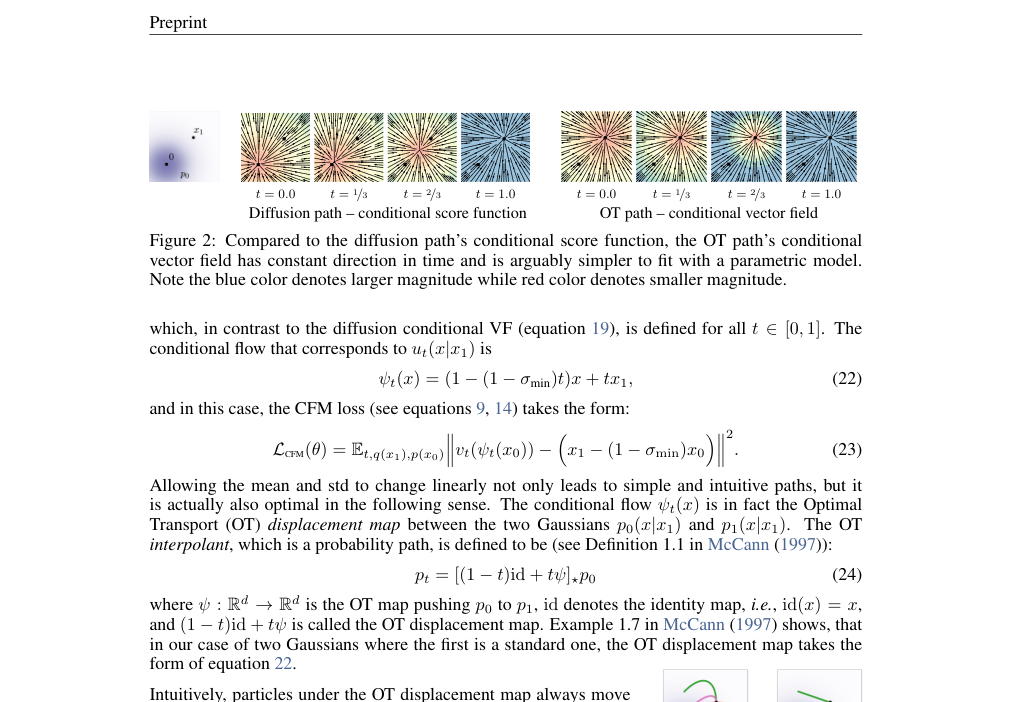
\(\sigma_{\min}\) 使 \(p_1(x\mid x_1)\) 成为以 \(x_1\) 为中心的窄高斯,因此最终边际 \(p_1\) 是数据分布与小高斯核的卷积,只近似 \(q\)。论文的条件 OT 路径在 \(t=0\) 精确等于标准高斯,并在 \(t=1\) 保留可控平滑误差。正文与附录没有公开实验采用的具体 \(\sigma_{\min}\) 数值,复现时不能自行把某个现代实现的默认值当作原论文设置。
训练免数值模拟,采样和似然仍要解 ODE
一次训练迭代
- 采样数据 \(x_1\sim q\) 与时间 \(t\sim\mathcal{U}[0,1]\)。
- 采样噪声 \(x_0\sim\mathcal{N}(0,I)\)。
- 由 \(\psi_t(x_0)\) 直接构造中间点。
- 计算解析条件速度,最小化均方误差。
无需先生成从 0 到 1 的完整轨迹,也无需反向传播通过 ODE solver。
生成与评估
- 生成:从标准高斯出发,数值积分 \(dx/dt=v_t(x)\)。
- 似然:从数据端反向积分状态与 log-density ODE。
- 论文默认 dopri5,绝对与相对容差均为 \(10^{-5}\)。
“simulation-free”限定于训练目标;采样、likelihood 和 NFE 测量仍依赖 ODE 数值积分。
CNF likelihood 与 Hutchinson trace estimator
反向积分时同时更新样本状态与累计 divergence。直接计算 Jacobian trace 对图像维度昂贵,Hutchinson estimator 使用独立的零均值、单位协方差探针 \(z\),以一次 Jacobian-vector product 给出无偏 trace 估计;该探针与生成初态 \(x_0\sim p_0\) 是不同随机变量。附录证明在 ODE 精确积分及可交换期望与积分的条件下,得到的是 \(\log p_1(x_1)\) 的无偏估计;对该估计取指数一般不会得到 density 的无偏估计。
这里 \(\phi_1\) 是神经 ODE 从 \(t=0\) 到 \(t=1\) 的 flow,\([\phi_1]_{\ast}p_0\) 是它把标准高斯 \(p_0\) 推到训练数据坐标后得到的密度;\(\varphi\) 是另一项确定性的像素缩放映射,把训练坐标 \(y\in[-1,1]\) 映射为量化像素 \(x\in[0,256]\)。\(d=H\times W\times3\) 是图像标量维度。缩放 Jacobian 对每个维度贡献 7 bits。报告的离散数据似然还使用 uniform dequantization,并用 \(K\) 个样本的 log-mean-density 估计,具体数值见 Table 4。
完整结果:质量、似然、求解成本与感知失真权衡
所有自训的 FM-OT、FM-Diffusion、SM-Diffusion 使用相同架构、超参数和 epoch;正文说明部分 baseline 可额外训练到更好收敛。FID 与 NFE 均以 50,000 个样本平均。CIFAR-10 与 ImageNet 32/64 使用 TensorFlow GAN 指标实现,ImageNet 128 使用 guided-diffusion 评测脚本。
Table 1 · 无条件生成、似然与 NFE
| Model | CIFAR-10 | ImageNet 32 | ImageNet 64 | ||||||
|---|---|---|---|---|---|---|---|---|---|
| NLL↓ | FID↓ | NFE↓ | NLL↓ | FID↓ | NFE↓ | NLL↓ | FID↓ | NFE↓ | |
| DDPM | 3.12 | 7.48 | 274 | 3.54 | 6.99 | 262 | 3.32 | 17.36 | 264 |
| Score Matching | 3.16 | 19.94 | 242 | 3.56 | 5.68 | 178 | 3.40 | 19.74 | 441 |
| ScoreFlow | 3.09 | 20.78 | 428 | 3.55 | 14.14 | 195 | 3.36 | 24.95 | 601 |
| FM w/ Diffusion | 3.10 | 8.06 | 183 | 3.54 | 6.37 | 193 | 3.33 | 16.88 | 187 |
| FM w/ OT | 2.99 | 6.35 | 142 | 3.53 | 5.02 | 122 | 3.31 | 14.45 | 138 |
| ImageNet 128 model | NLL↓ | FID↓ |
|---|---|---|
| MGAN | — | 58.9 |
| PacGAN2 | — | 57.5 |
| Logo-GAN-AE | — | 50.9 |
| Self-conditioned GAN | — | 41.7 |
| Unconditional BigGAN | — | 25.3 |
| PGMGAN | — | 21.7 |
| FM w/ OT | 2.90 | 20.9 |
CIFAR-10 的 FM-OT FID 为 6.35,来自论文自身统一架构控制实验;不能与 DDPM 原论文 3.17 的不同训练配置直接替换。ImageNet 128 的 FM 模型比 ADM 模型约大 25%,训练 500k iterations、batch 约 1.5k;作者按处理图像数量估算少 33%,没有提供等硬件墙钟时间比较。
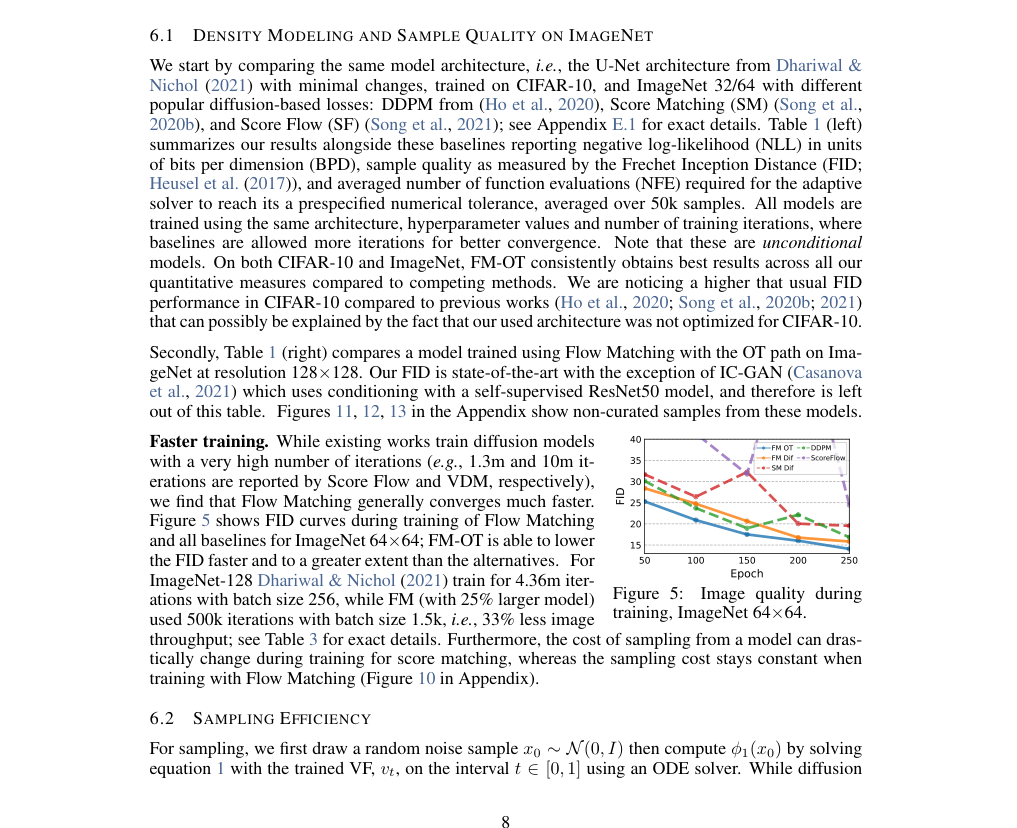
Table 2 · ImageNet 64→256 超分辨率
| Model | FID↓ | IS↑ | PSNR↑ | SSIM↑ |
|---|---|---|---|---|
| Reference | 1.9 | 240.8 | — | — |
| Regression | 15.2 | 121.1 | 27.9 | 0.801 |
| SR3 | 5.2 | 180.1 | 26.4 | 0.762 |
| FM w/ OT | 3.4 | 200.8 | 24.7 | 0.747 |
FM-OT 在 FID 与 IS 上超过 SR3,同时 PSNR 与 SSIM 更低。结果展示感知质量与逐像素失真的权衡,不能概括为所有指标全面领先。
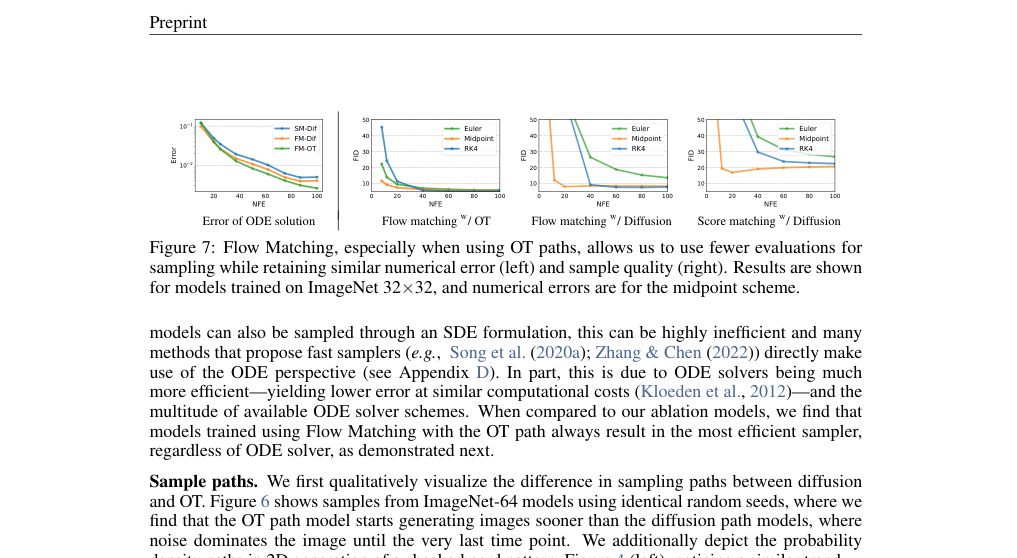
Table 3 · 全部训练配置
| Setting | CIFAR-10 | ImageNet 32 | ImageNet 64 | ImageNet 128 |
|---|---|---|---|---|
| Channels | 256 | 256 | 192 | 256 |
| Depth | 2 | 3 | 3 | 3 |
| Channel multiple | 1,2,2,2 | 1,2,2,2 | 1,2,3,4 | 1,1,2,3,4 |
| Heads | 4 | 4 | 4 | 4 |
| Head channels | 64 | 64 | 64 | 64 |
| Attention resolution | 16 | 16,8 | 32,16,8 | 32,16,8 |
| Dropout | 0.0 | 0.0 | 0.0 | 0.0 |
| Effective batch | 256 | 1024 | 2048 | 1536 |
| GPUs | 2 | 4 | 16 | 32 |
| Epochs | 1000 | 200 | 250 | 571 |
| Iterations | 391k | 250k | 157k | 500k |
| Learning rate | 5e-4 | 1e-4 | 1e-4 | 1e-4 |
| Scheduler | Polynomial Decay | Polynomial Decay | Constant | Polynomial Decay |
| Warmup | 45k | 20k | — | 20k |
Optimizer 为 Adam:\(\beta_1=0.9,\ \beta_2=0.999\),weight decay 0,epsilon \(10^{-8}\)。CIFAR-10 与 ImageNet 32 使用 float32;64/128/256 使用 mixed float16。文中“Polynomial Decay”具体实现是从 \(10^{-8}\) 线性 warmup 到峰值,再线性下降至 \(10^{-8}\)。
Table 4 · uniform dequantization 的 NLL / BPD
| Model | CIFAR-10 | ImageNet 32 | ImageNet 64 | ||||||
|---|---|---|---|---|---|---|---|---|---|
| K=1 | K=20 | K=50 | K=1 | K=5 | K=15 | K=1 | K=5 | K=10 | |
| DDPM | 3.24 | 3.14 | 3.12 | 3.62 | 3.57 | 3.54 | 3.36 | 3.33 | 3.32 |
| Score Matching | 3.28 | 3.18 | 3.16 | 3.65 | 3.59 | 3.57 | 3.43 | 3.41 | 3.40 |
| ScoreFlow | 3.21 | 3.11 | 3.09 | 3.63 | 3.57 | 3.55 | 3.39 | 3.37 | 3.36 |
| FM w/ Diffusion | 3.23 | 3.13 | 3.10 | 3.64 | 3.58 | 3.56 | 3.37 | 3.34 | 3.33 |
| FM w/ OT | 3.11 | 3.01 | 2.99 | 3.62 | 3.56 | 3.53 | 3.35 | 3.33 | 3.31 |
Table 4 的 ImageNet 32 SM/FM-diffusion 数值与主 Table 1 存在 0.01–0.03 的差异。论文没有解释这组差异;页面逐项保留两张原表数值,不推断其具体成因。
复现时真正需要固定的细节
模型与数据
- 图像 U-Net 基于 Dhariwal & Nichol (2021),完整通道配置见 Table 3。
- 数据为 CIFAR-10 与 ImageNet 32/64/128;超分为 ImageNet validation 64→256。
- 中心裁剪并缩放;32/64 采用 downsampled ImageNet 预处理。
- 无条件模型没有文本 prompt、few-shot 或 classifier guidance。
训练与数值计算
- VP diffusion 使用 \(\beta_{\min}=0.1,\ \beta_{\max}=20\)。
- diffusion 训练与采样时间截断 epsilon 均为 \(10^{-5}\)。
- dopri5 默认 atol=rtol=\(10^{-5}\),torchdiffeq。
- uniform dequantization 的 \(K\) 按 Table 4 各数据集设置。
附录 Figure 编号占位
[Original Figure 8 Placeholder]
VP diffusion conditional vector field,用于和正文 Figure 2 的 conditional score 及 OT conditional vector field 对照。
[Original Figure 9 Placeholder]
ScoreFlow 与 DDPM 在二维 checkerboard 数据上的 CNF 轨迹,采用与 Figure 4 相同的学习率与其他超参数。
[Original Figure 10 Placeholder]
CIFAR-10 训练期间,score-diffusion、FM-diffusion、FM-OT 使用 dopri5、容差 \(10^{-5}\) 时的采样 NFE。
[Original Figures 11–13 Placeholder]
ImageNet 32、64、128 的非精选 FM-OT 无条件生成样本,分别位于 PDF pp.22–24。
[Original Figures 14–15 Placeholder]
ImageNet validation 的 64→256 FM-OT 超分辨率结果,位于 PDF pp.25–26。
[Original Figures 16–17 Placeholder]
相同初始噪声下的固定 NFE 样本:Figure 16 为 ImageNet 128 的 10/20/40/100 NFE;Figure 17 为 ImageNet 256 的 10/20/40/60/100 NFE。附录出现 ImageNet 256 样本,不提供将 Table 3 的 128 设置直接沿用为 256 的依据。
论文证明了什么,证据还缺什么
Strengths
- CFM 等价性把不可计算的边际场转成可采样条件监督,理论与工程接口非常清楚。
- 路径设计涵盖 diffusion,又允许脱离 SDE 直接指定概率路径。
- 相同架构控制实验同时报告 NLL、FID、NFE 与固定步求解误差。
- 附录给出 likelihood、BPD、训练配置与 dequantization 细节。
Weaknesses
- conditional OT 的简洁性没有提升为边际 global OT 性质。
- 有限网络中“更简单的回归目标”为经验解释,缺少目标复杂度或 Lipschitz 性质的定量消融。
- ImageNet 128 的跨论文比较存在模型大小与训练协议差异。
- 超分结果呈现明显 perception-distortion trade-off。
- 缺少多随机种子方差、墙钟时间和 GPU 型号。
Potential Improvements
- 学习数据相关 coupling,减少独立 \(x_0,x_1\) 配对导致的边际路径弯曲。
- 用 curvature、Jacobian norm 与 solver stiffness 直接度量路径难度。
- 联合优化路径参数与 vector field,同时控制末端平滑误差。
- 把固定 NFE 质量曲线与训练能耗放进统一计算预算。
来源、版本与证据边界
- arXiv:2210.02747:v2,2023-02-08;本页依据 28 页 PDF 全文与附录。
- ICLR 2023 官方论文页:Virtual Presentation / Top 25% Paper;官方页面列出五位作者并链接 OpenReview。
- OpenReview forum:官方标识 PqvMRDCJT9t。核查时 OpenReview 页面受到访问验证限制,会议归属由 ICLR 官方页面确认。
- 原始 PDF:公式、Figures 1–17、Tables 1–4 与附录 A–F 的直接来源。
arXiv v2 PDF 的作者顺序为 Yaron Lipman, Ricky T. Q. Chen, Heli Ben-Hamu, Maximilian Nickel, Matt Le;ICLR 官方页面把末位作者显示为 Matthew Le。归档保留 v2 的 Matt Le 写法并复用既有 People 记录。PDF 未标明通讯作者,末位作者只作为未核实候选。