论文身份与证据边界
v2 标题页把 Black Forest Labs 放在作者首位,并要求引用为 “Black Forest Labs (2025)”。其后列出 20 位个人作者;正文没有贡献声明、共同第一作者标记或通讯作者标记。
可确认信息
- 标题:FLUX.1 Kontext: Flow Matching for In-Context Image Generation and Editing in Latent Space
- arXiv:2506.15742v2,主分类 cs.GR,19 页
- 集体作者:Black Forest Labs
- 技术报告,不应写成 NeurIPS 2025 已接收论文
作者记录说明
标题页中的个人名单依次为 Stephen Batifol、Andreas Blattmann、Frederic Boesel、Saksham Consul、Cyril Diagne、Tim Dockhorn、Jack English、Zion English、Patrick Esser、Sumith Kulal、Kyle Lacey、Yam Levi、Cheng Li、Dominik Lorenz、Jonas Müller、Dustin Podell、Robin Rombach、Harry Saini、Axel Sauer、Luke Smith。
名单顺序没有被论文说明为字母顺序或贡献顺序。现有 Obsidian 将 Luke Smith 标成通讯候选,状态应保持 unverified。
研究动机:把编辑变成视觉上下文学习
论文把图像处理需求拆成两类。局部编辑要求修改有限区域并尽量保持其余内容;生成式编辑要求从参考图像抽取人物、物体或风格,在新场景与新视角中重新生成。作者认为当时的方法仍受三项问题限制:合成编辑对会继承数据生成器的偏差,多轮操作会导致人物和物体身份漂移,自回归多模态系统的推理延迟妨碍交互使用。
关系数据
训练单位是 \( (x\mid y,c) \):目标图像、可选上下文图像和文本指令。模型学习图像之间由语言指定的关系。
统一网络
有上下文图像时执行编辑或参考生成;省略上下文 token 时保留文本生成能力。
连续编辑
上一轮输出可直接作为下一轮上下文,交互速度与身份保持共同决定实用性。
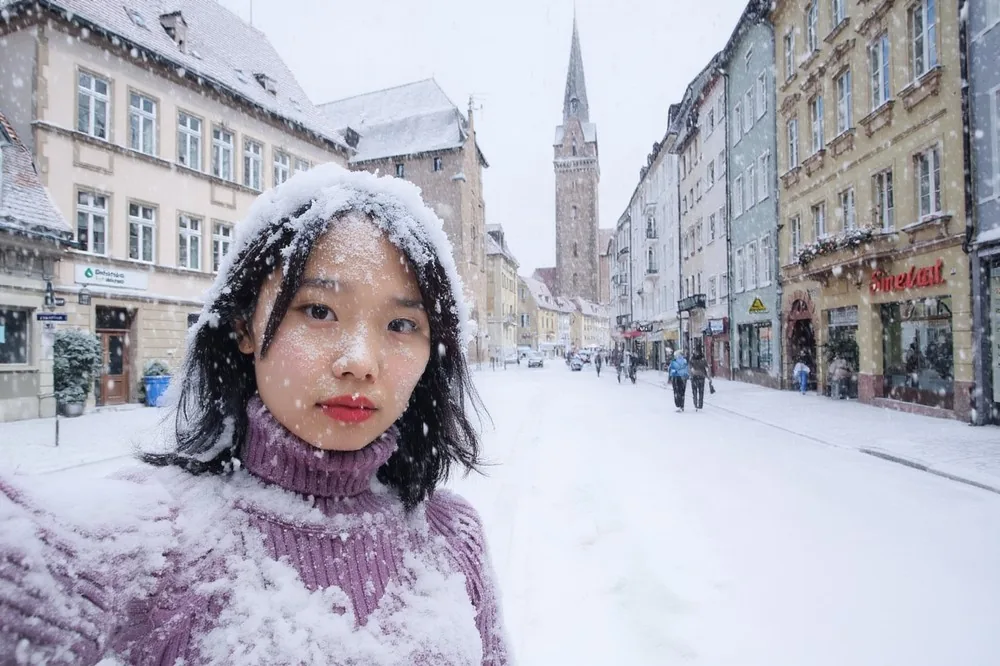
问题定义:一个条件分布覆盖两种工作模式
图像先经冻结的 FLUX autoencoder 编码成 latent token。目标图像 latent 在训练时被加噪,上下文 latent 保持干净;文本 token 进入文本分支。输出是目标序列上的 velocity prediction,经过数值求解和 VAE 解码得到图像。
VAE 编码
\(z_t\)
\([z_t;y]\)
Flow Transformer
VAE 解码
FLUX.1 基础:高容量 latent flow transformer
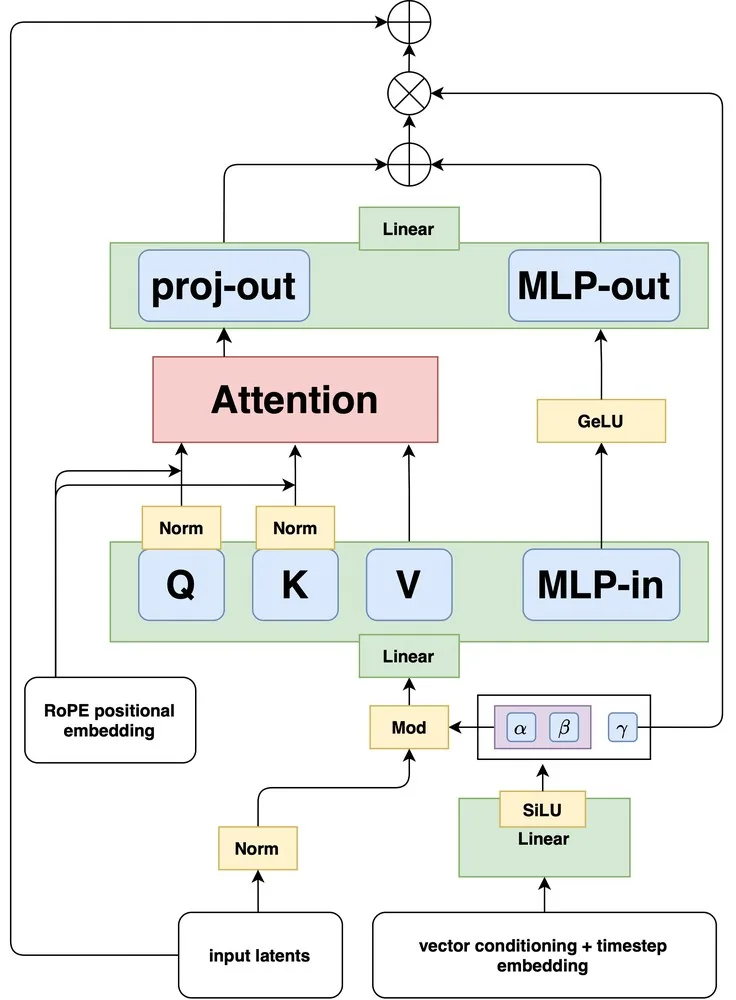
Kontext 继承 FLUX.1 的 16 通道 VAE 和混合式 Transformer。double-stream block 对图像与文本保留独立权重,通过拼接后的 attention 进行信息交换;随后把两个序列合并,进入 38 个 single-stream block。输出阶段丢弃文本 token,只解码图像 token。
位置编码
factorized 3D RoPE 为每个 latent token 分配 \((t,h,w)\)。单张目标图像使用 \(t=0\),空间坐标保留二维结构。Kontext 借用第一维作为参考图像的虚拟时间编号。
VAE
卷积 autoencoder 从头训练,包含 adversarial objective。论文给出 4,096 张 ImageNet、\(256\times256\) 重建结果。
Table 1 · VAE 重建质量(完整方法行)
| 模型 | PDist ↓ | SSIM ↑ | PSNR ↑ |
|---|---|---|---|
| Flux-VAE | 0.332 ± 0.003 | 0.896 ± 0.004 | 31.1 ± 0.08 |
| SD3-VAE | 0.452 ± 0.004 | 0.858 ± 0.005 | 29.6 ± 0.07 |
| SD3-TAE | 0.746 ± 0.004 | 0.774 ± 0.014 | 27.9 ± 0.06 |
| SDXL-VAE | 0.890 ± 0.005 | 0.748 ± 0.006 | 25.9 ± 0.07 |
| SD-VAE | 0.949 ± 0.005 | 0.720 ± 0.004 | 25.0 ± 0.07 |
Kontext 方法:沿序列维拼接,利用虚拟时间区分图像
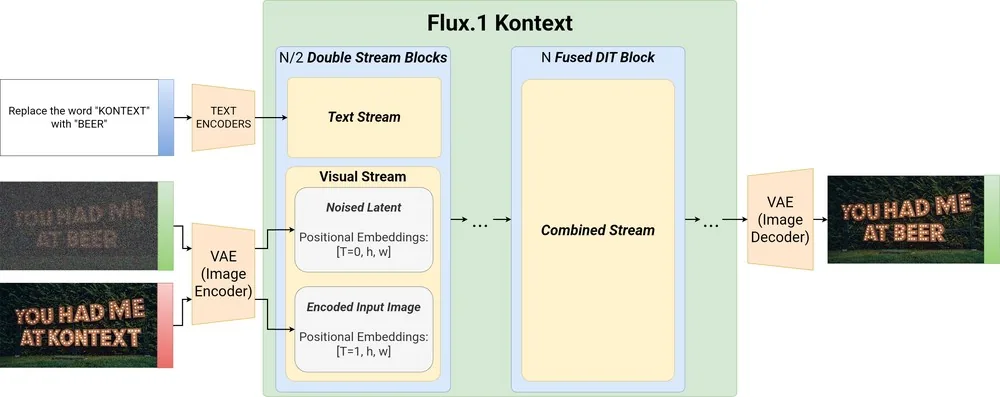
设目标 latent token 序列为 \(x\),第 \(i\) 张上下文序列为 \(y_i\)。论文把上下文 token 追加到目标 token 后面:
目标与上下文可以拥有不同分辨率和宽高比,因为它们在序列维连接。论文称早期实验中 channel-wise concatenation 表现较差;没有提供量化消融、数据规模或差值,因此这条结论属于作者报告。
支持的结构
- 不同输入与输出尺寸
- 不同宽高比
- 形式上可扩展到多参考图像
- 省略 \(y\) 后保持文本生成接口
实际训练范围
- 论文实验聚焦单张上下文图像
- [dev] 后期只训练 image-to-image
- 多图输入属于架构能力和未来方向
- 未报告 sequence length 上限与显存增长曲线
Rectified Flow 数学:速度场学习从数据到噪声的直线路径
前向路径
\(a_t,b_t\) 控制信号与噪声的混合。rectified flow 取 \(a_t=1-t\)、\(b_t=t\),得到 \(z_t=(1-t)x_0+t\varepsilon\)。沿 \(t\) 求导后,条件路径的速度是 \(\dot z_t=\varepsilon-x_0\)。边界为 \(z_0=x_0\) 与 \(z_1=\varepsilon\):训练的正向参数化从数据走向噪声。
通用 conditional flow matching 目标
Kontext 条件目标
代入 \(a_t=1-t\)、\(b_t=t\) 后,通用条件速度化为 \(\varepsilon-x\)。上下文 \(y\) 与指令 \(c\) 进入速度网络,参考 latent 在每个时间点始终保持干净,监督只作用于目标 latent。平方误差回归使 \(v_{\theta}\) 学到给定 \(y,c\) 时的条件 marginal velocity。
推理方向
采样从 \(t=1\) 的 Gaussian latent 出发,沿时间反向积分到 \(t=0\)。Euler 写法中的负号来自时间从 \(t\) 减少到 \(t-\Delta t\)。每一步都把当前 noisy target token、固定的 clean context token 和文本 token 输入模型;结束后仅保留目标 token,并由 VAE 解码成输出图像。
logit-normal timestep 采样与分辨率位移
可先从 \(U\sim\mathcal N(0,1)\) 取 base timestep \(t=\operatorname{sigmoid}(U)\),再用上式得到具有位置参数 \(\mu\) 与尺度参数 \(\sigma\) 的 \(t'\)。当 \(t\rightarrow0\) 时 \(t'\rightarrow0\),当 \(t\rightarrow1\) 时 \(t'\rightarrow1\),所以位移保留两端边界。论文训练取 \(\sigma=1\),并随分辨率改变 \(\mu\);示例 \(\alpha=3\) 对应 \(\mu=\log 3\approx1.0986\)。Kontext 实际每种分辨率的 \(\mu\) 配置没有公开。
训练、蒸馏与系统配置
训练从 FLUX.1 text-to-image checkpoint 开始,收集并筛选数百万 relational pairs。论文没有披露数据来源比例、筛选阈值、合成与真实样本比例、训练总步数、optimizer、learning rate、batch size、weight decay、GPU 数量和训练时长。
| 变体 | 训练路线 | 公开任务范围 | 规模/可用性 |
|---|---|---|---|
| Kontext [pro] | 联合 I2I + T2I flow objective,随后 LADD | 文本生成与图像编辑 | API;参数量未披露 |
| Kontext [max] | 论文只写 “uses more compute” | 文本生成与图像编辑 | API;训练细节与参数量未披露 |
| Kontext [dev] | guidance distillation 到 12B DiT;为编辑性能只进行 I2I 后期训练 | 官方模型卡定位为文本指令图像编辑 | 开放权重,FLUX.1 dev 非商业许可证 |
两类蒸馏
LADD 以 latent adversarial training 缩短 [pro] 的采样,同时抑制常规 guidance 可能造成的过饱和。论文称普通 flow model 常需 50–250 次 guided network evaluation;没有披露 [pro] 的最终 step 数。[dev] 使用 guidance distillation,使单个模型在输入 guidance scale 时近似 classifier-free guidance。
分布式训练系统
- FSDP2:all-gather 使用
bfloat16,gradient reduce-scatter 使用float32。 - selective activation checkpointing 降低峰值显存。
- Flash Attention 3 与 Transformer block regional compilation 提升吞吐。
- 安全训练包含 classifier-based filtering 与 adversarial training,目标覆盖 NCII 与 CSAM 风险。
KontextBench:真实使用案例驱动的五类编辑评测
| 任务 | 样本数 | 占比 | 需要保持的内容 |
|---|---|---|---|
| Local instruction editing | 416 | 40.55% | 未指定区域、整体身份 |
| Global instruction editing | 262 | 25.54% | 核心语义与指令一致性 |
| Character reference | 193 | 18.81% | 人物/物体身份 |
| Text editing | 92 | 8.97% | 字体、布局、周边风格 |
| Style reference | 63 | 6.14% | 风格特征与新内容控制 |
| 合计 | 1,026 | 100% | 来自 personal photos、CC art、public domain 与 AI-generated content |
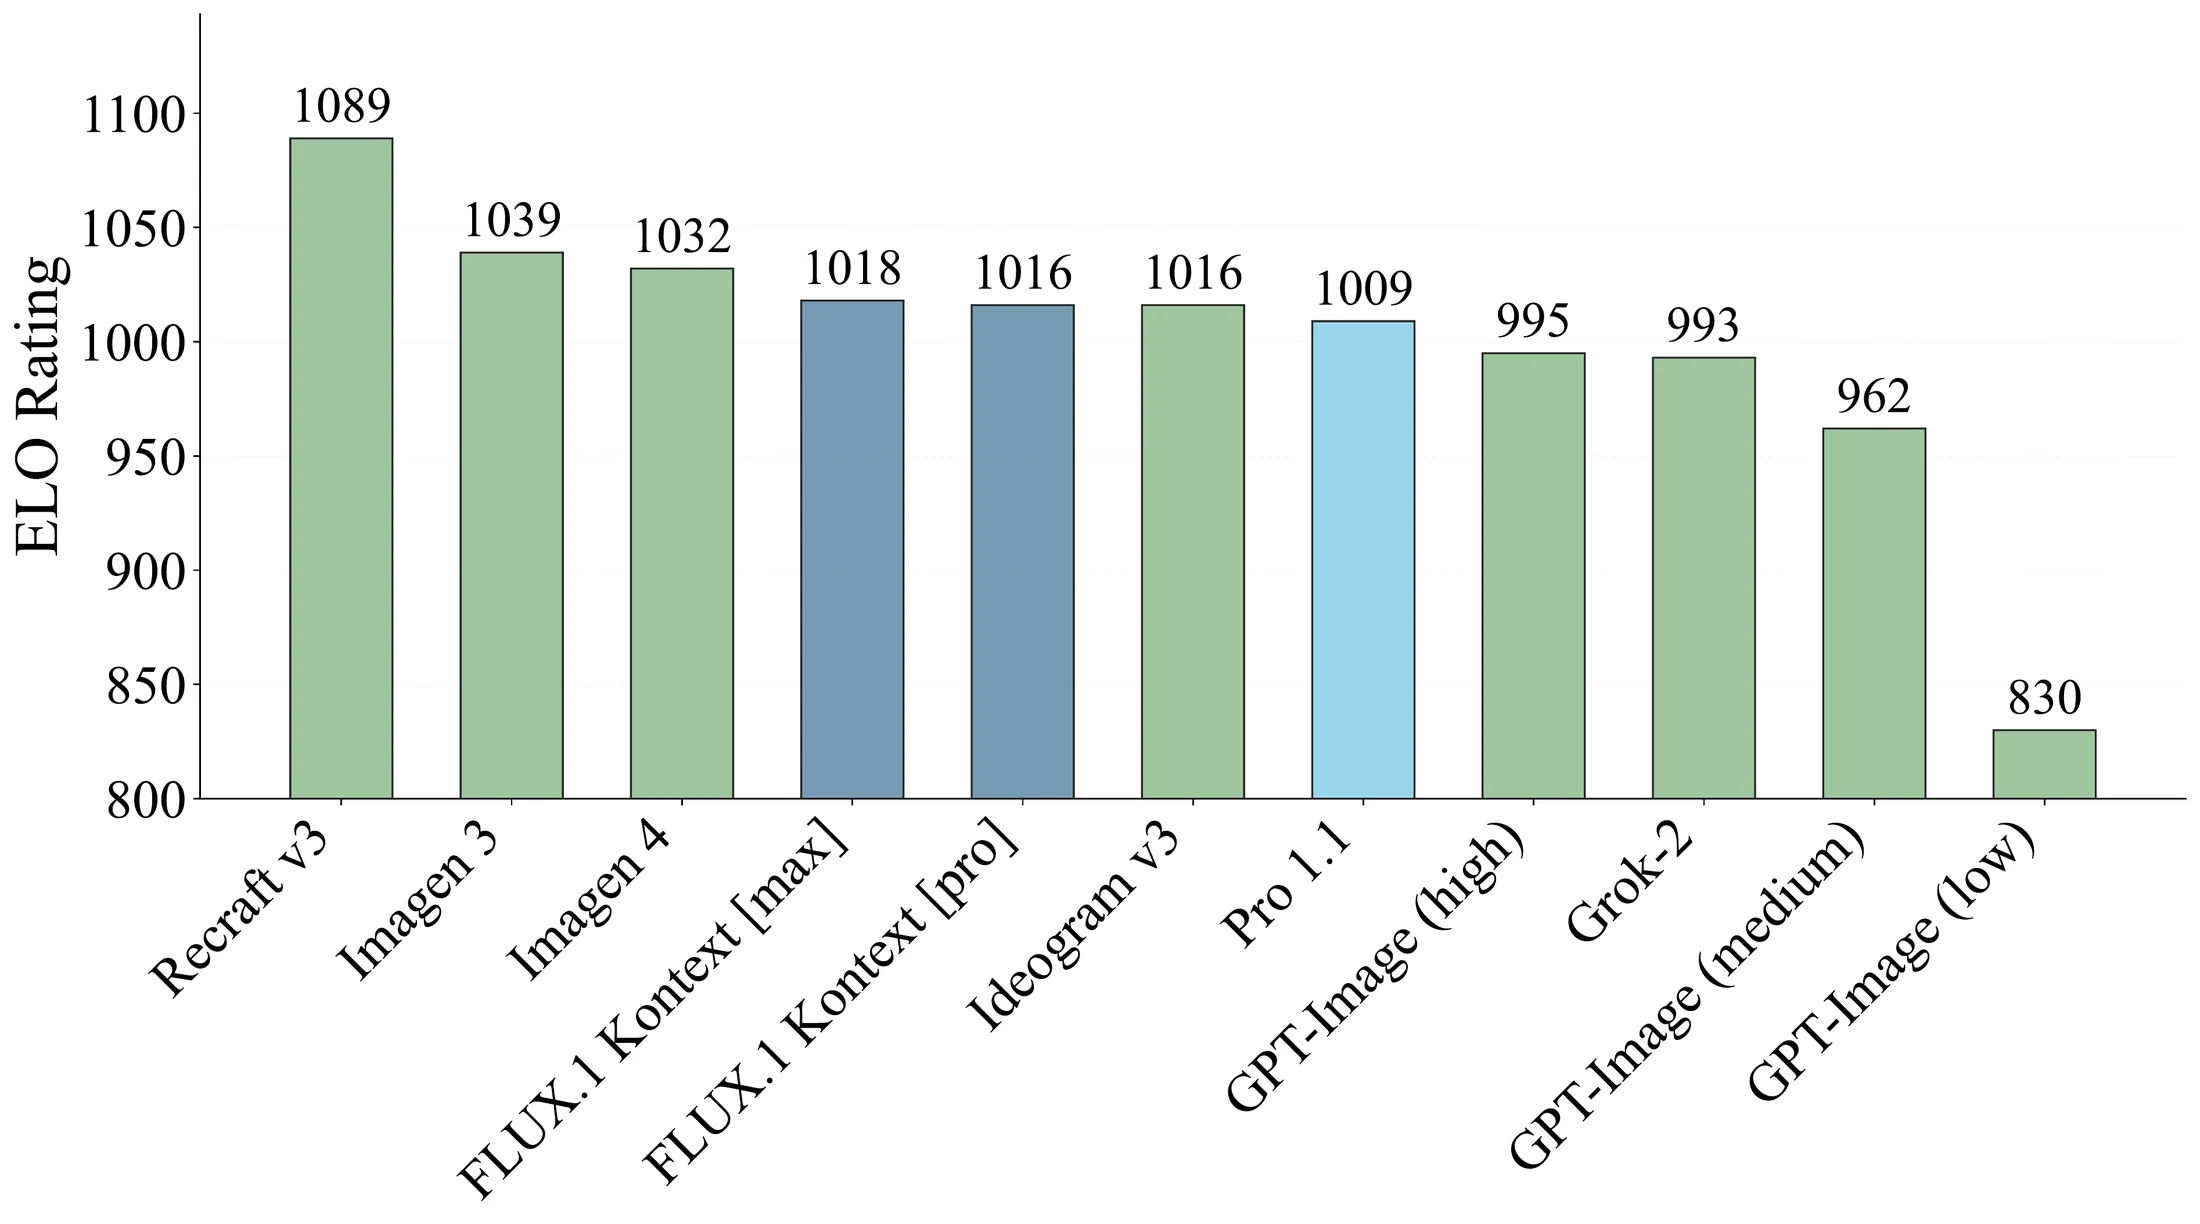
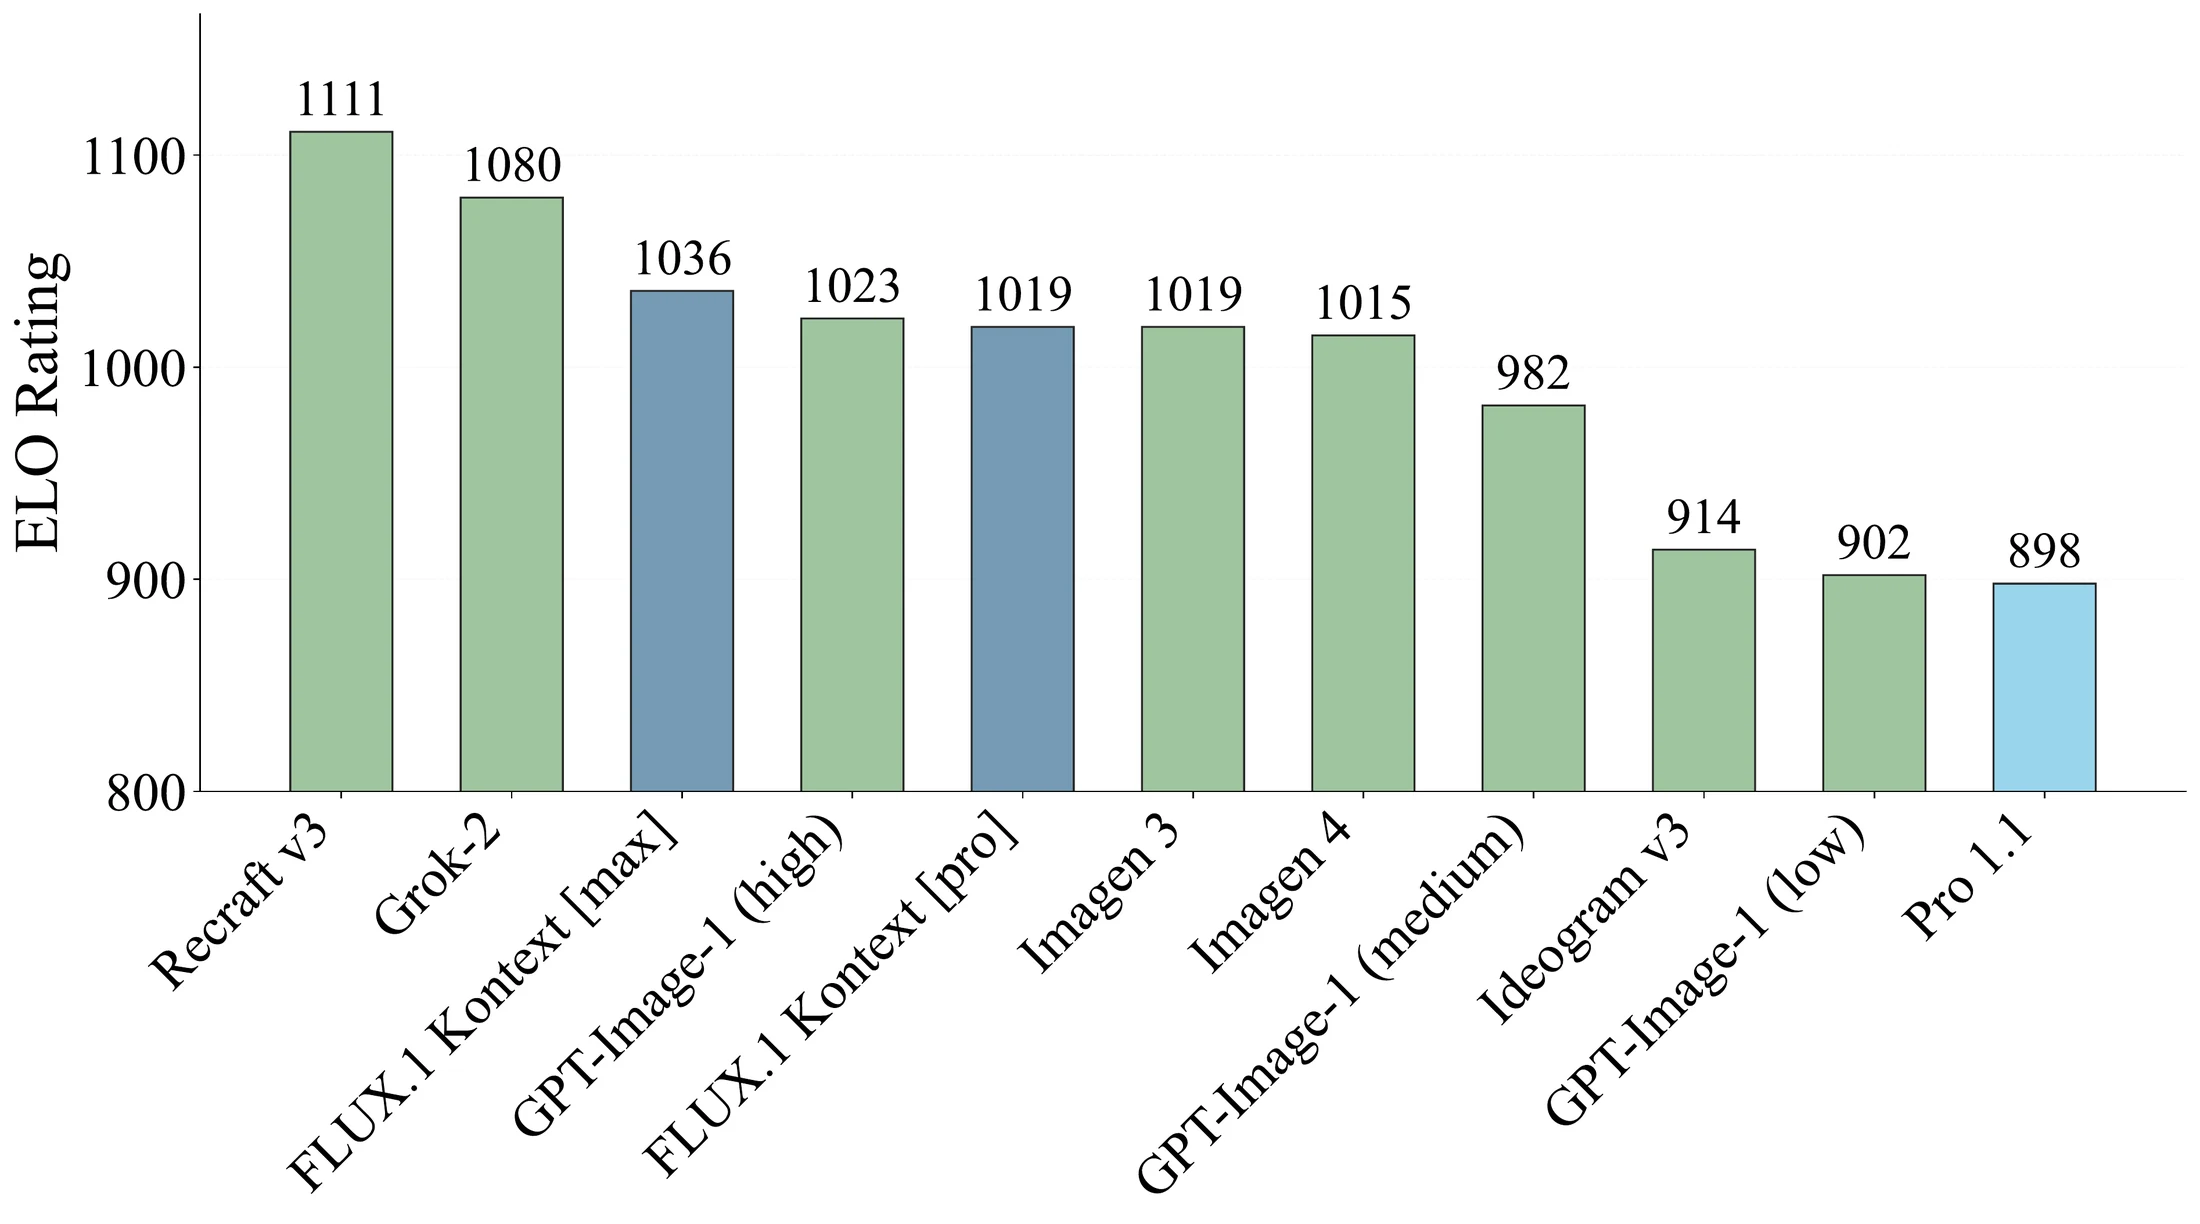
评测数据来自 crowd-sourced real-world use cases。论文计划公开 benchmark、Kontext 样本和 baseline 样本;报告本身没有提供下载地址、prompt 列表、annotator 数量、每对比较票数、配对方案和 Elo 拟合细节。
结果:速度优势明确,质量结论依赖未公开的人评协议
Figure 7 · 1024 × 1024 中位推理延迟
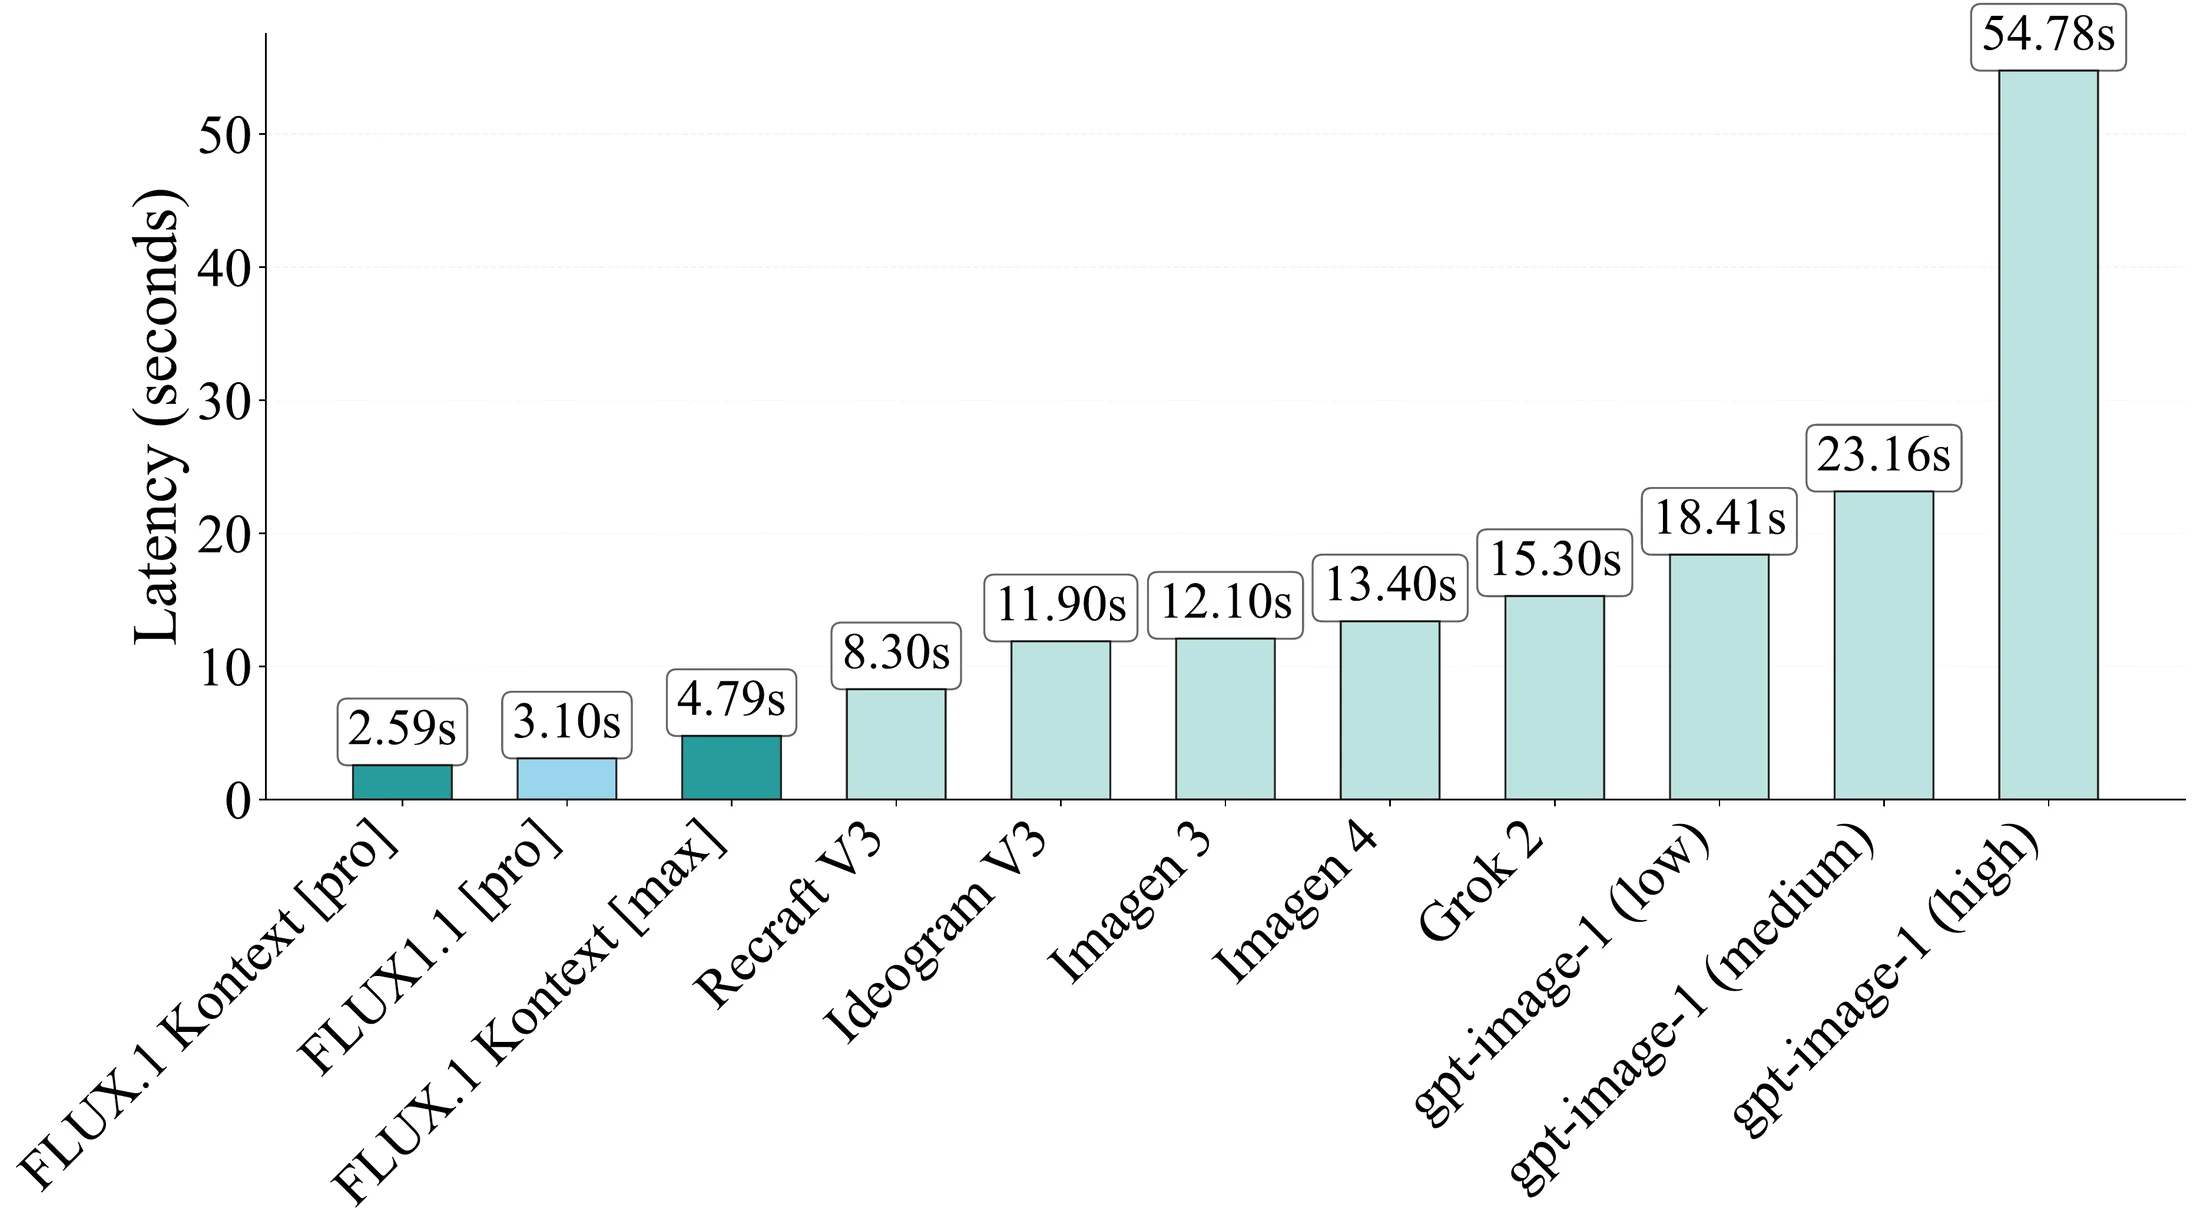
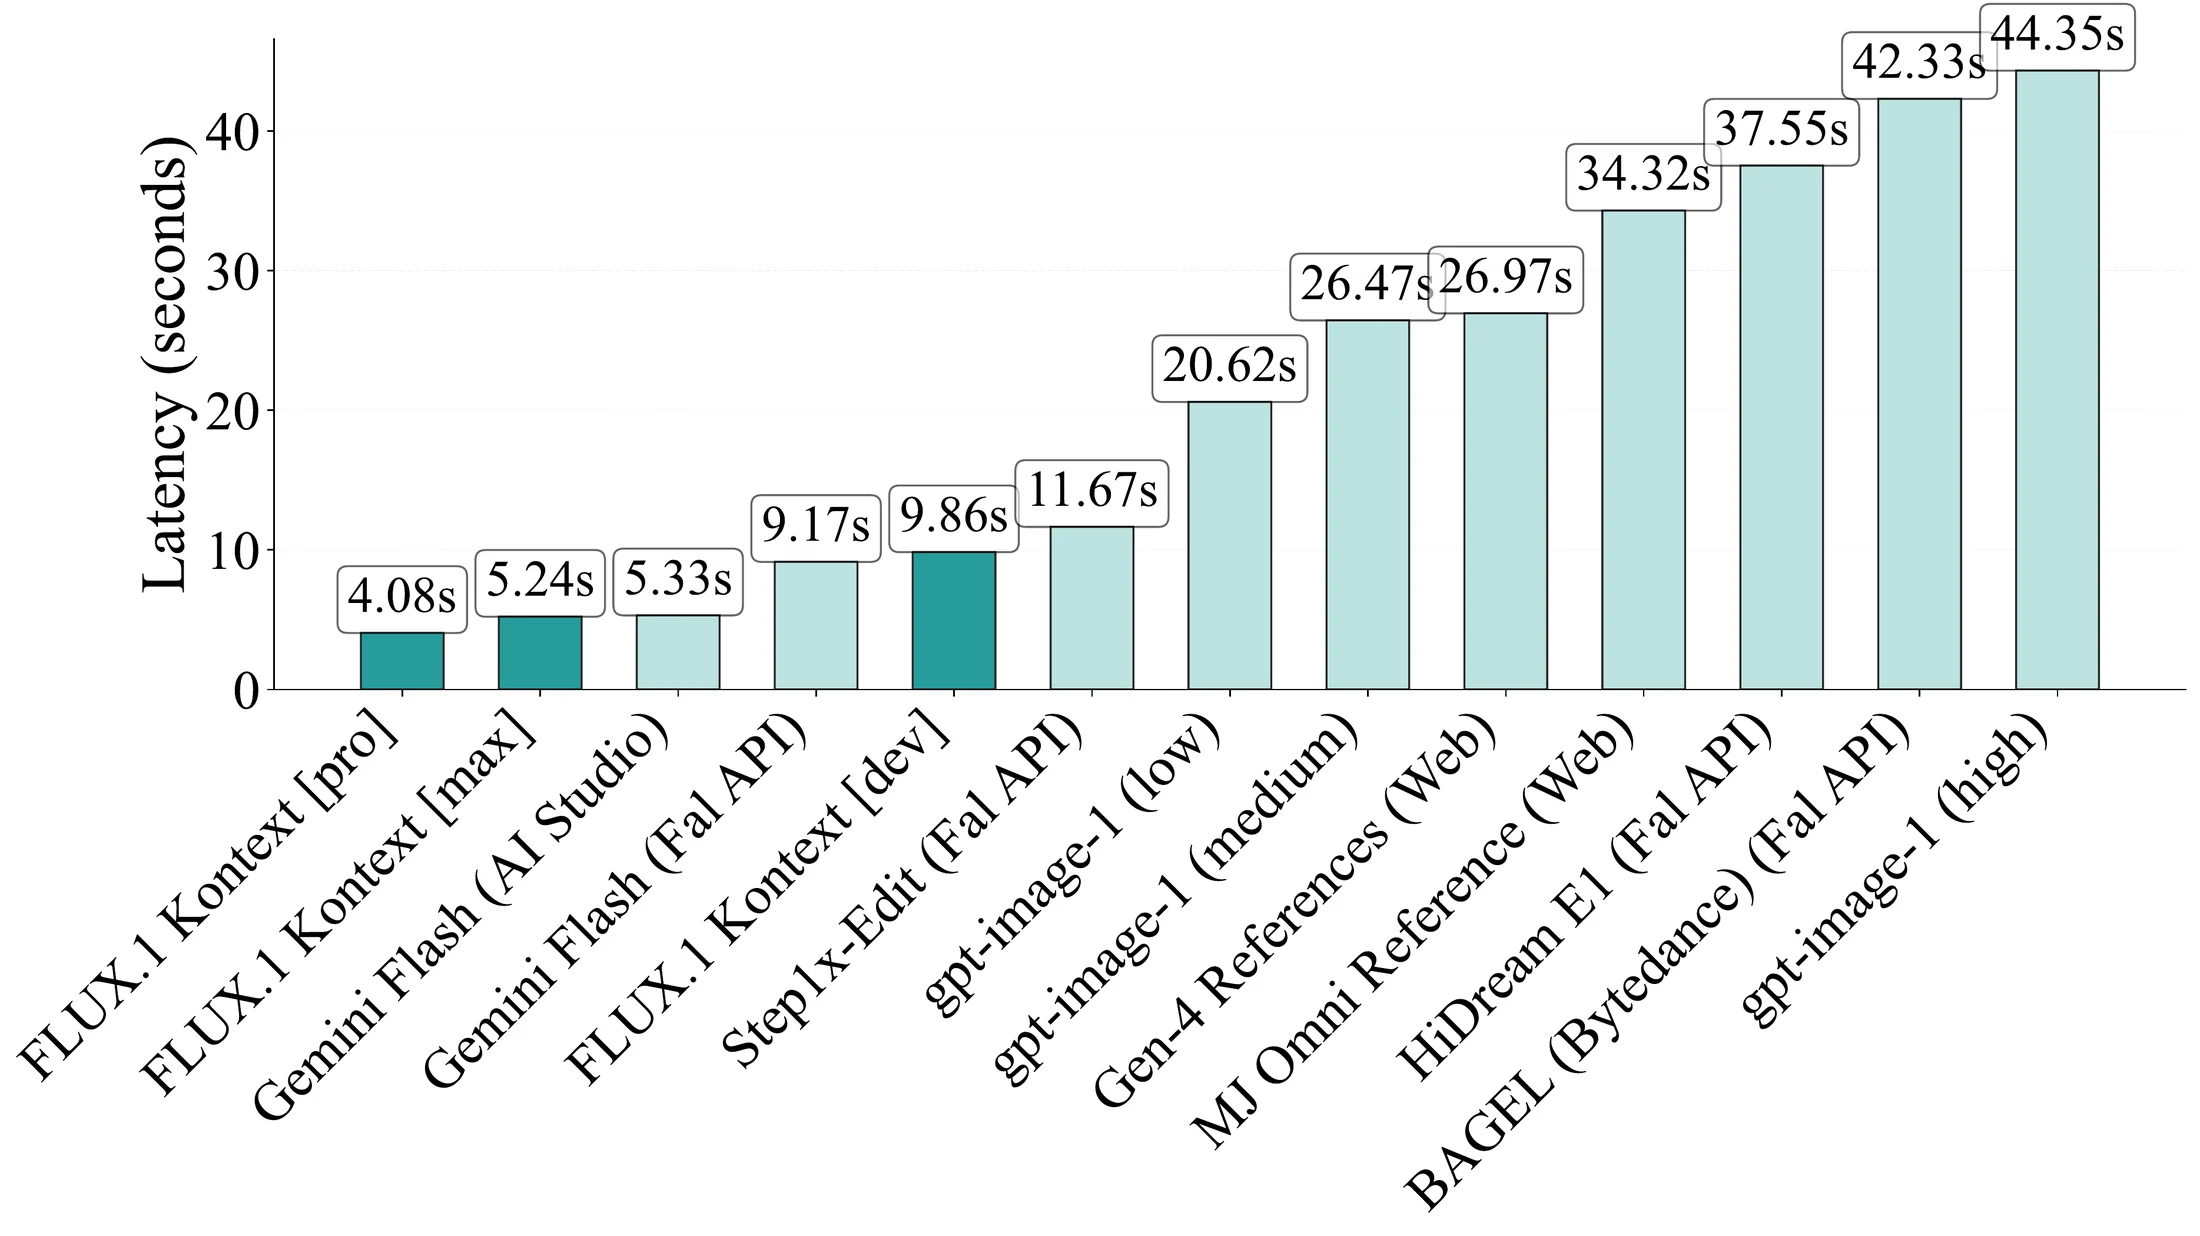
Figure 8 · KontextBench image-to-image
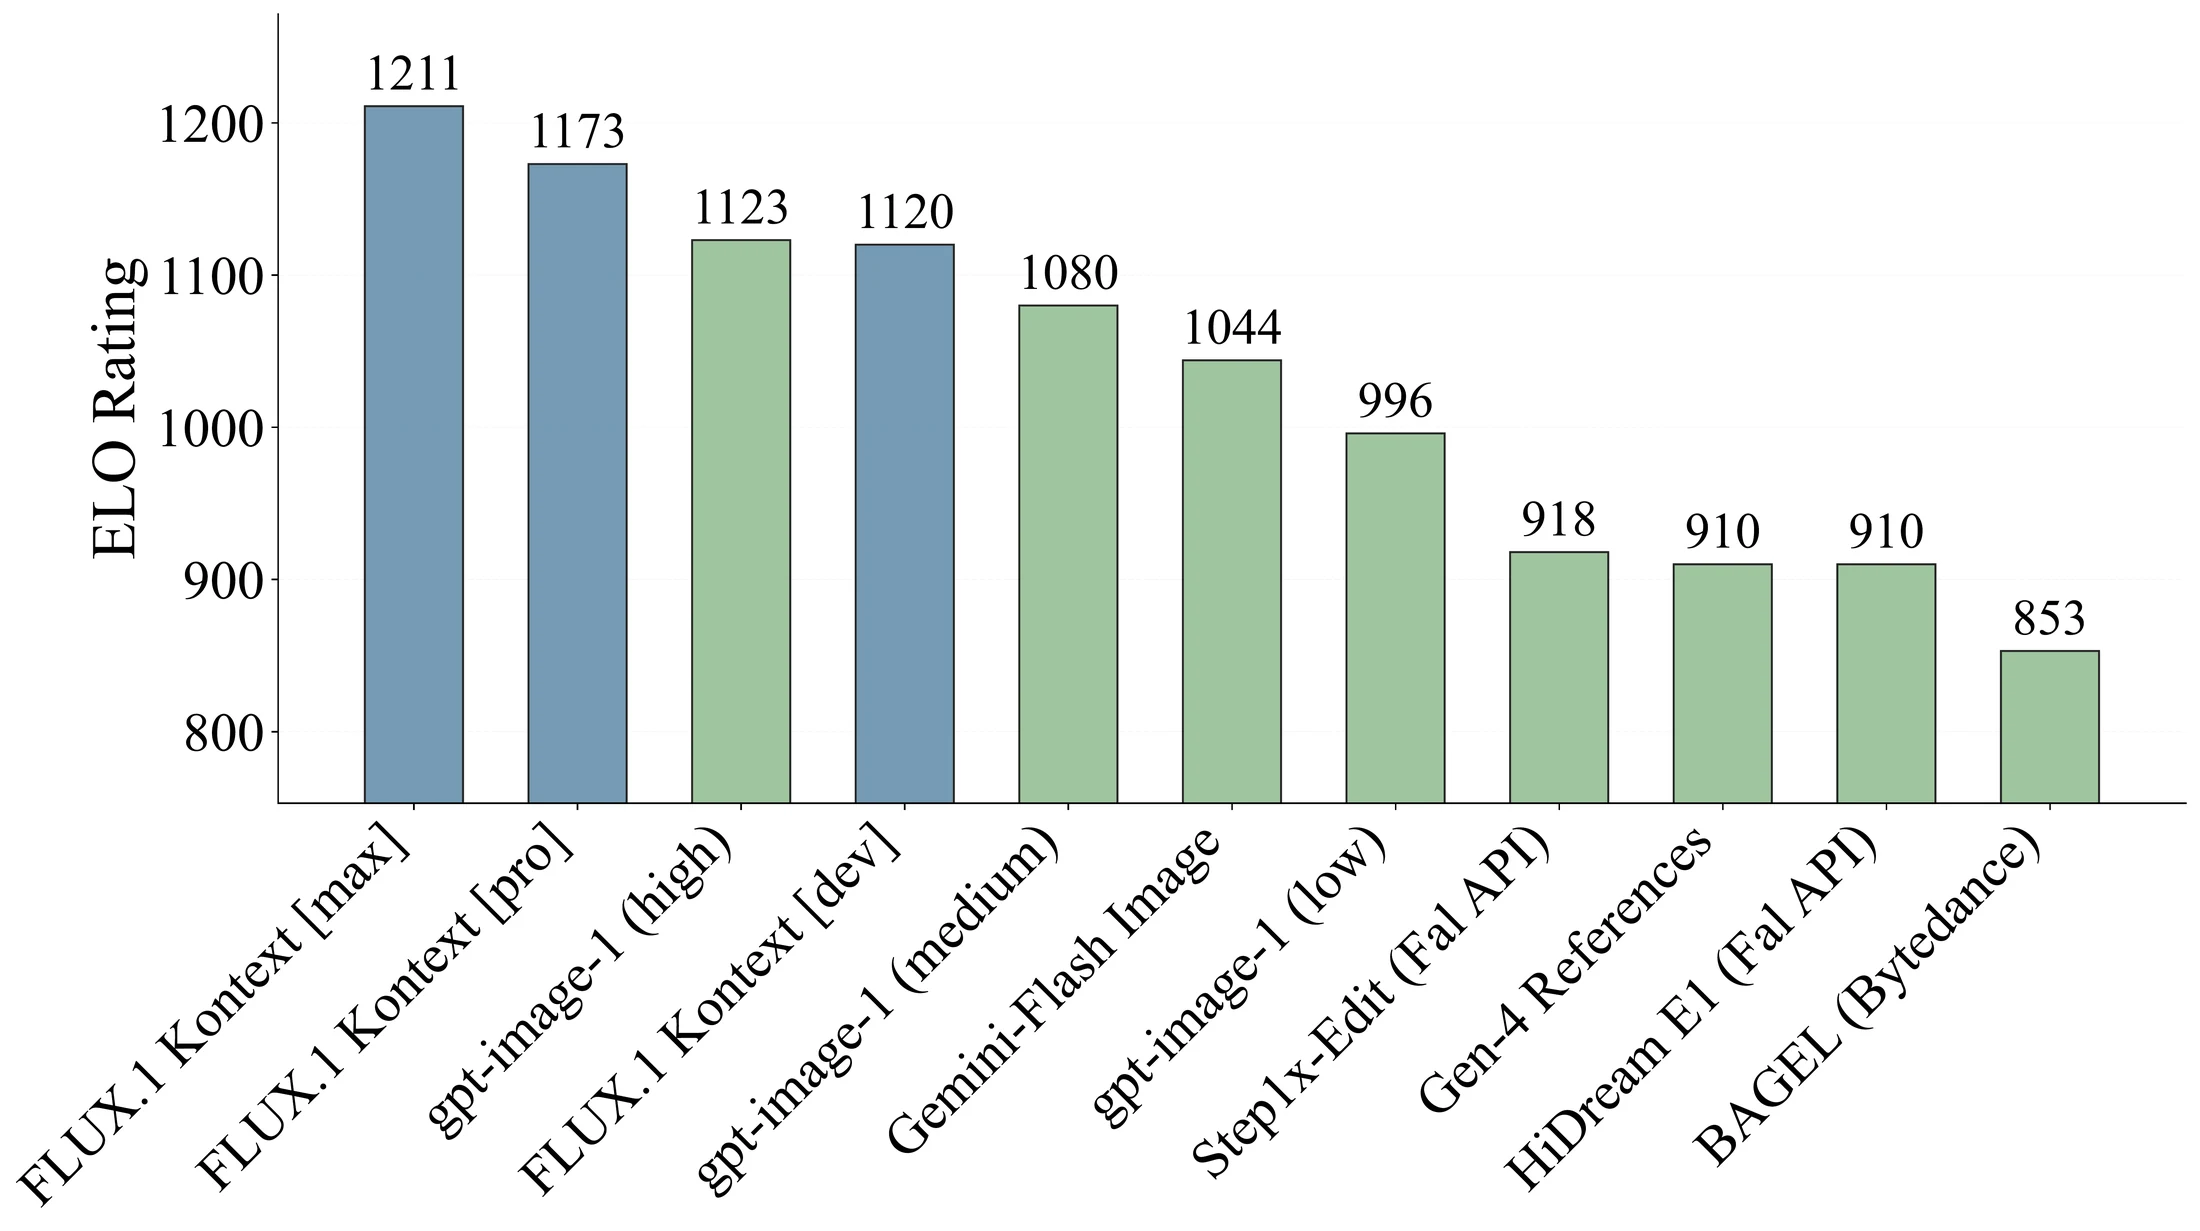
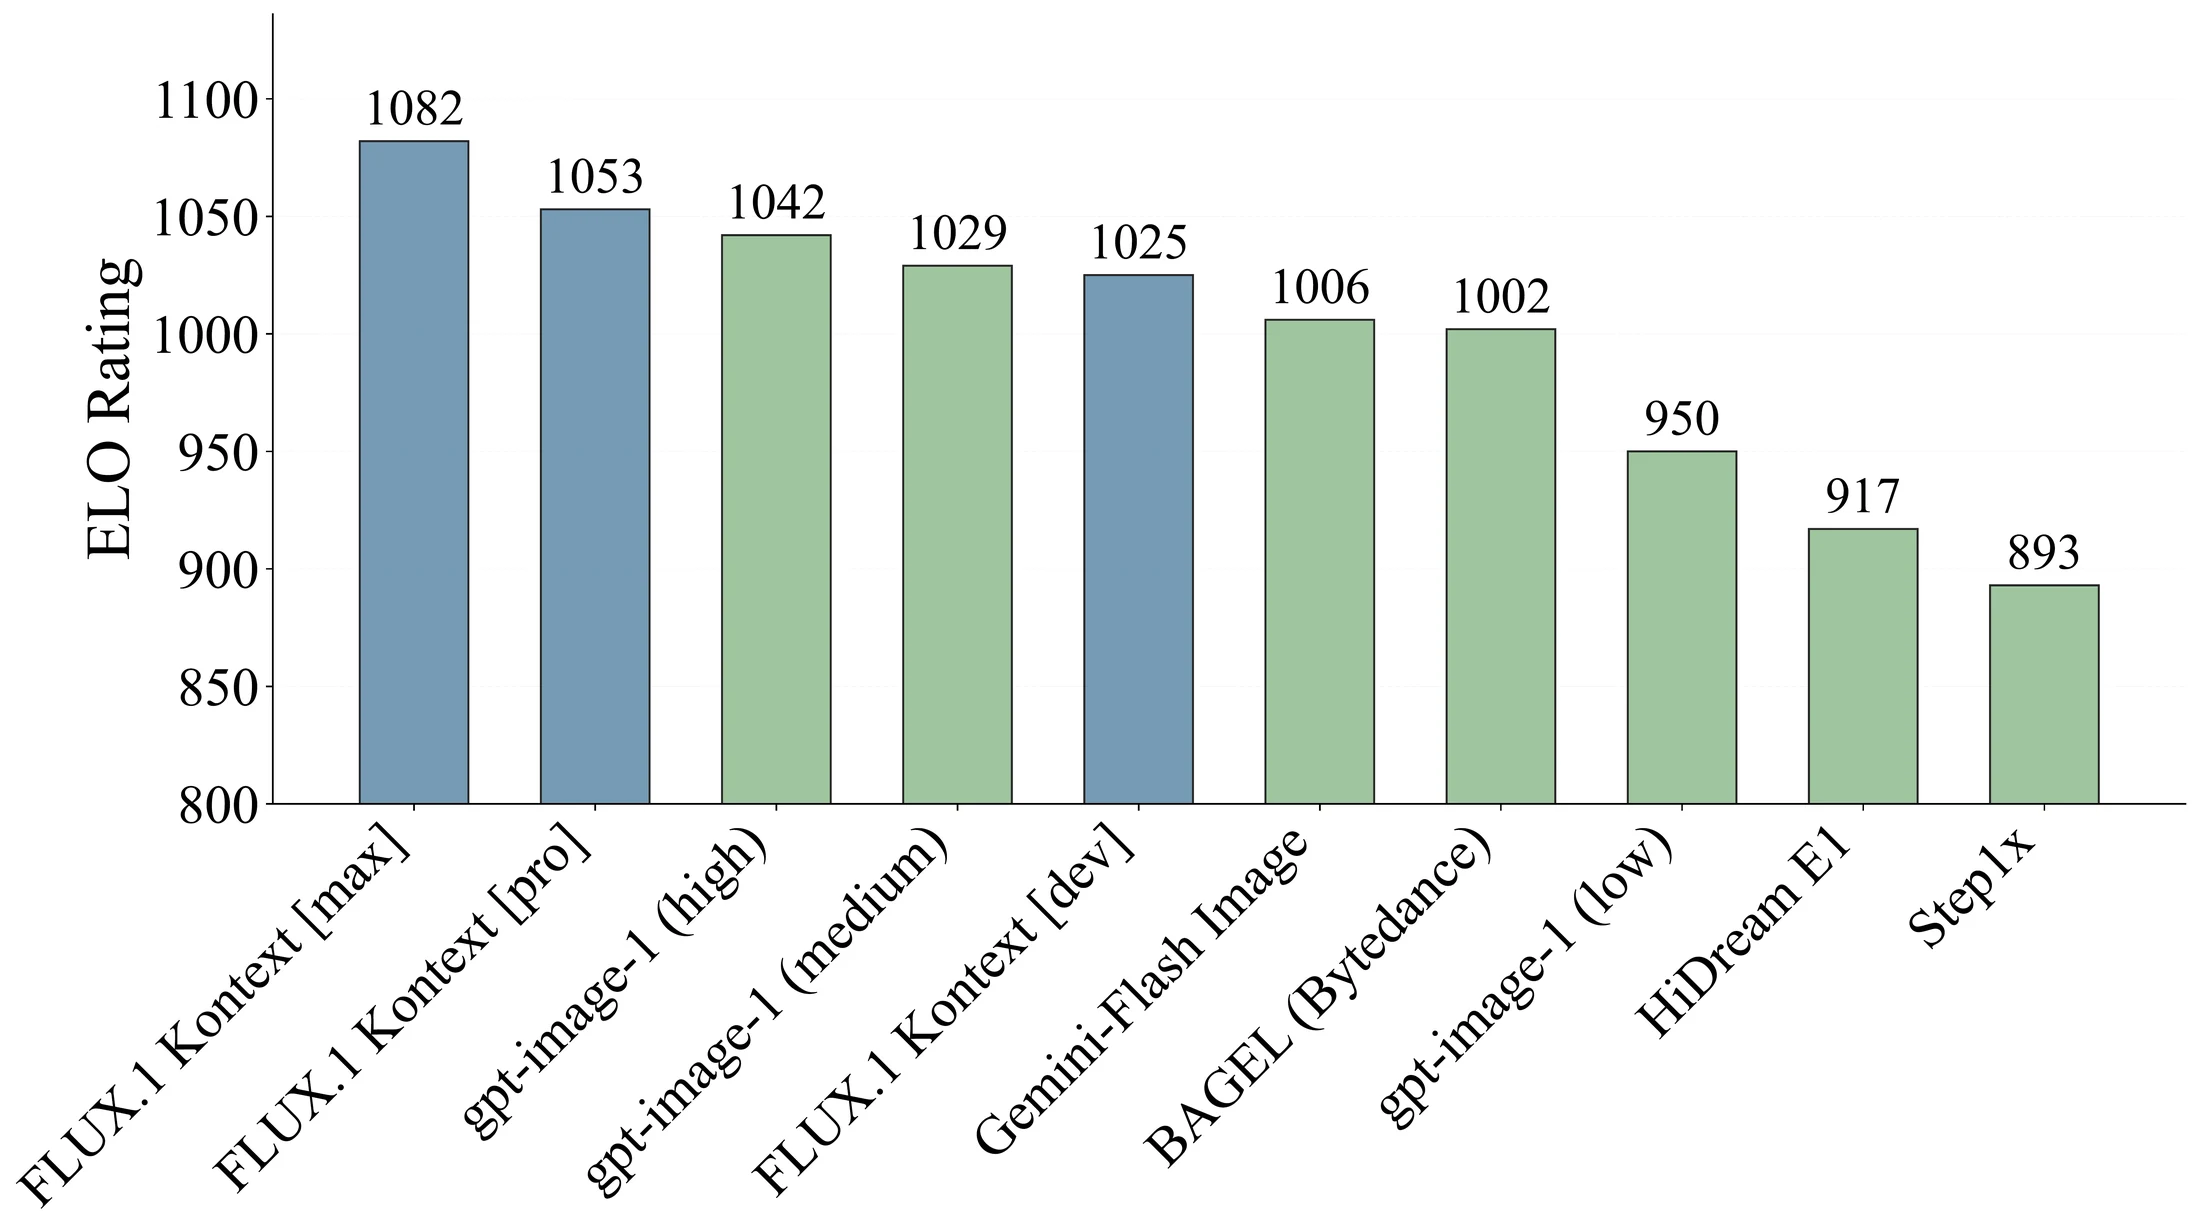
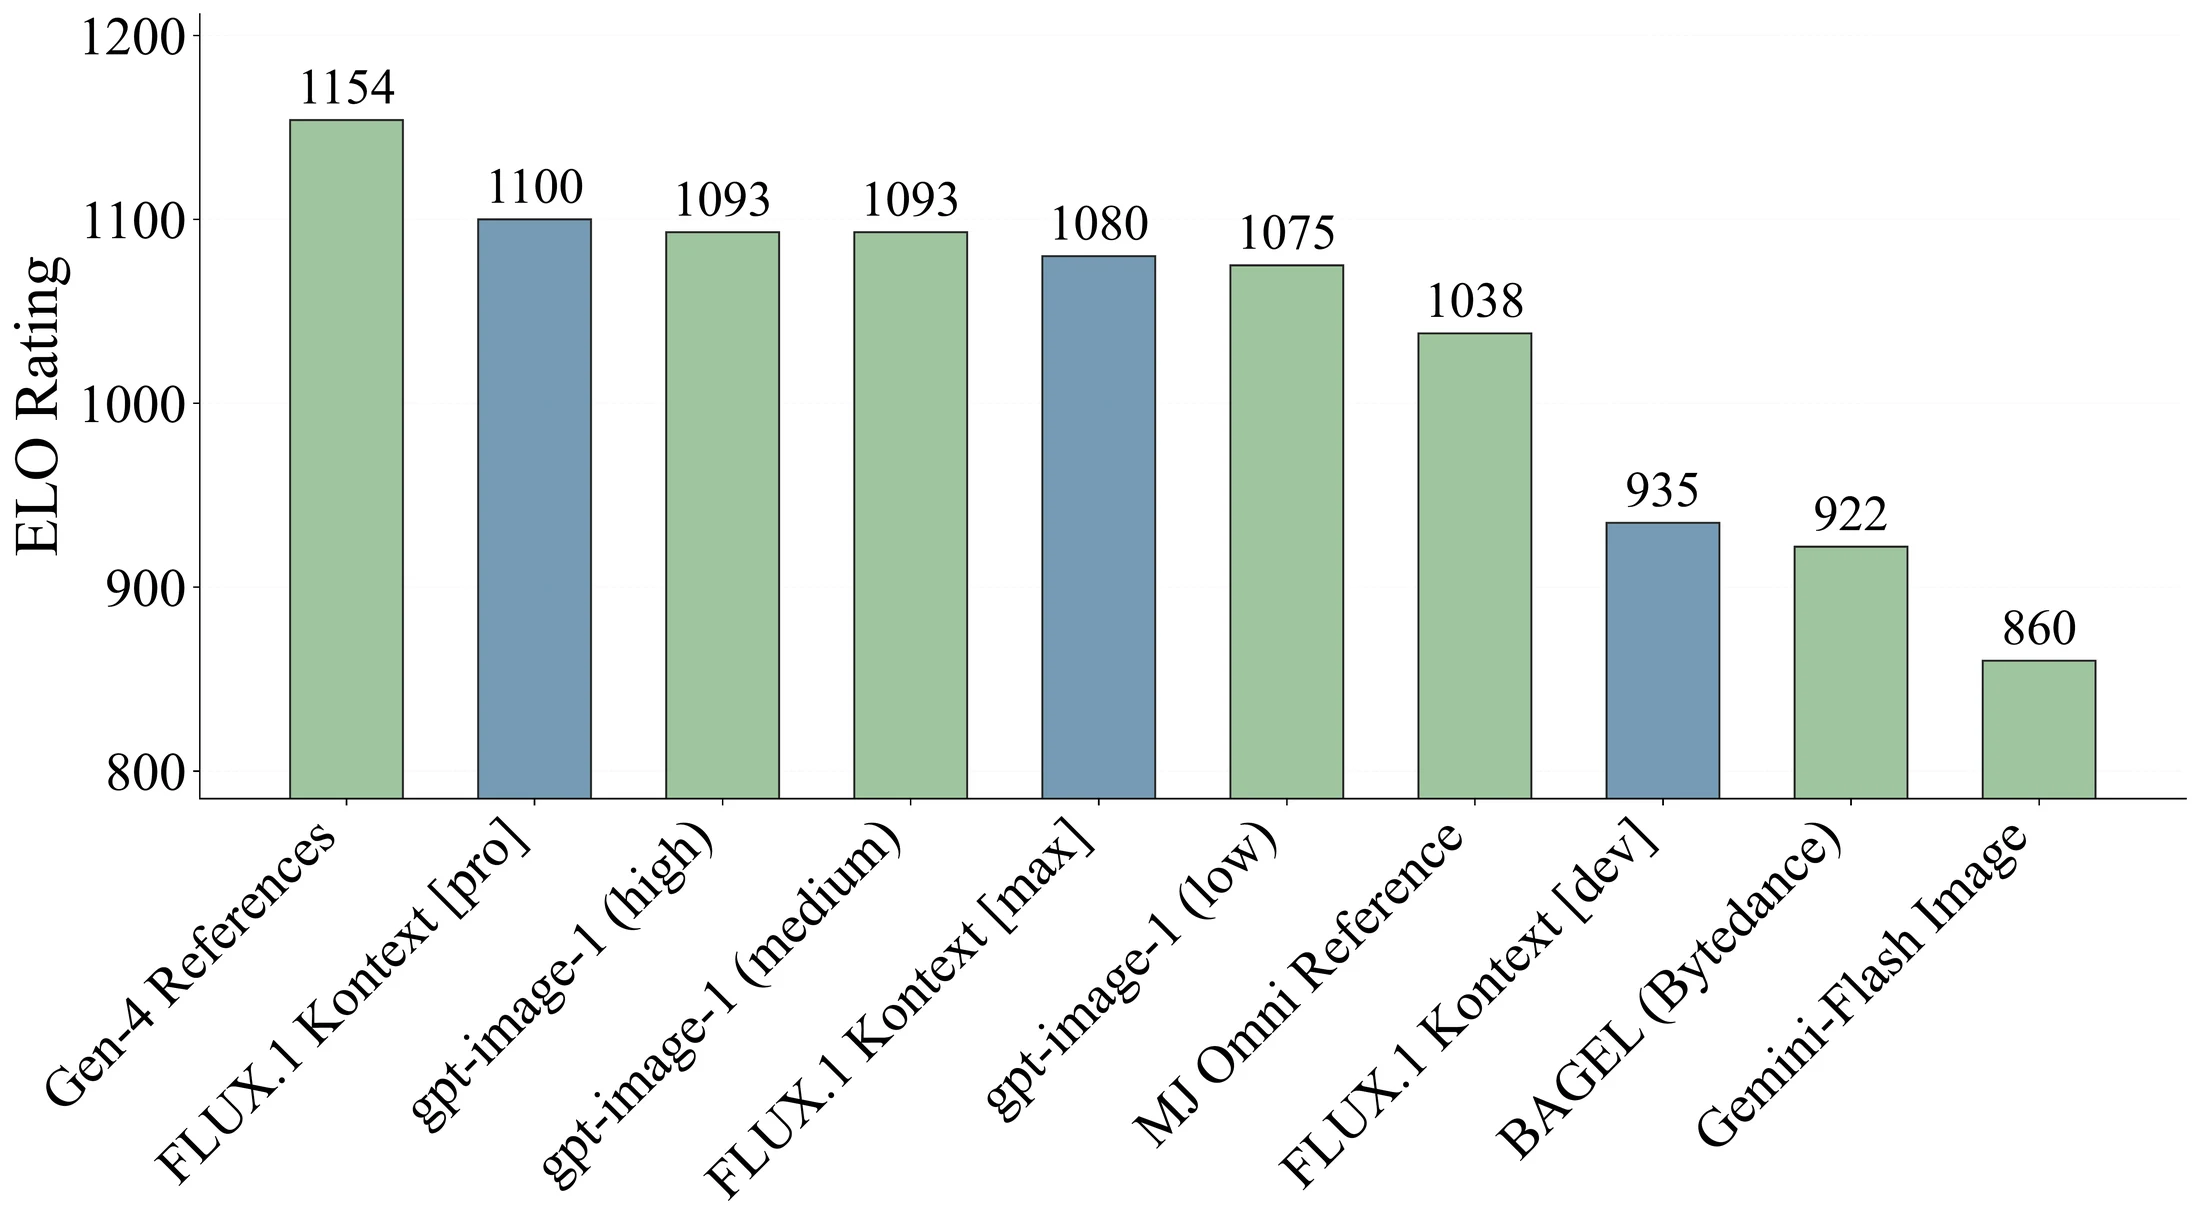
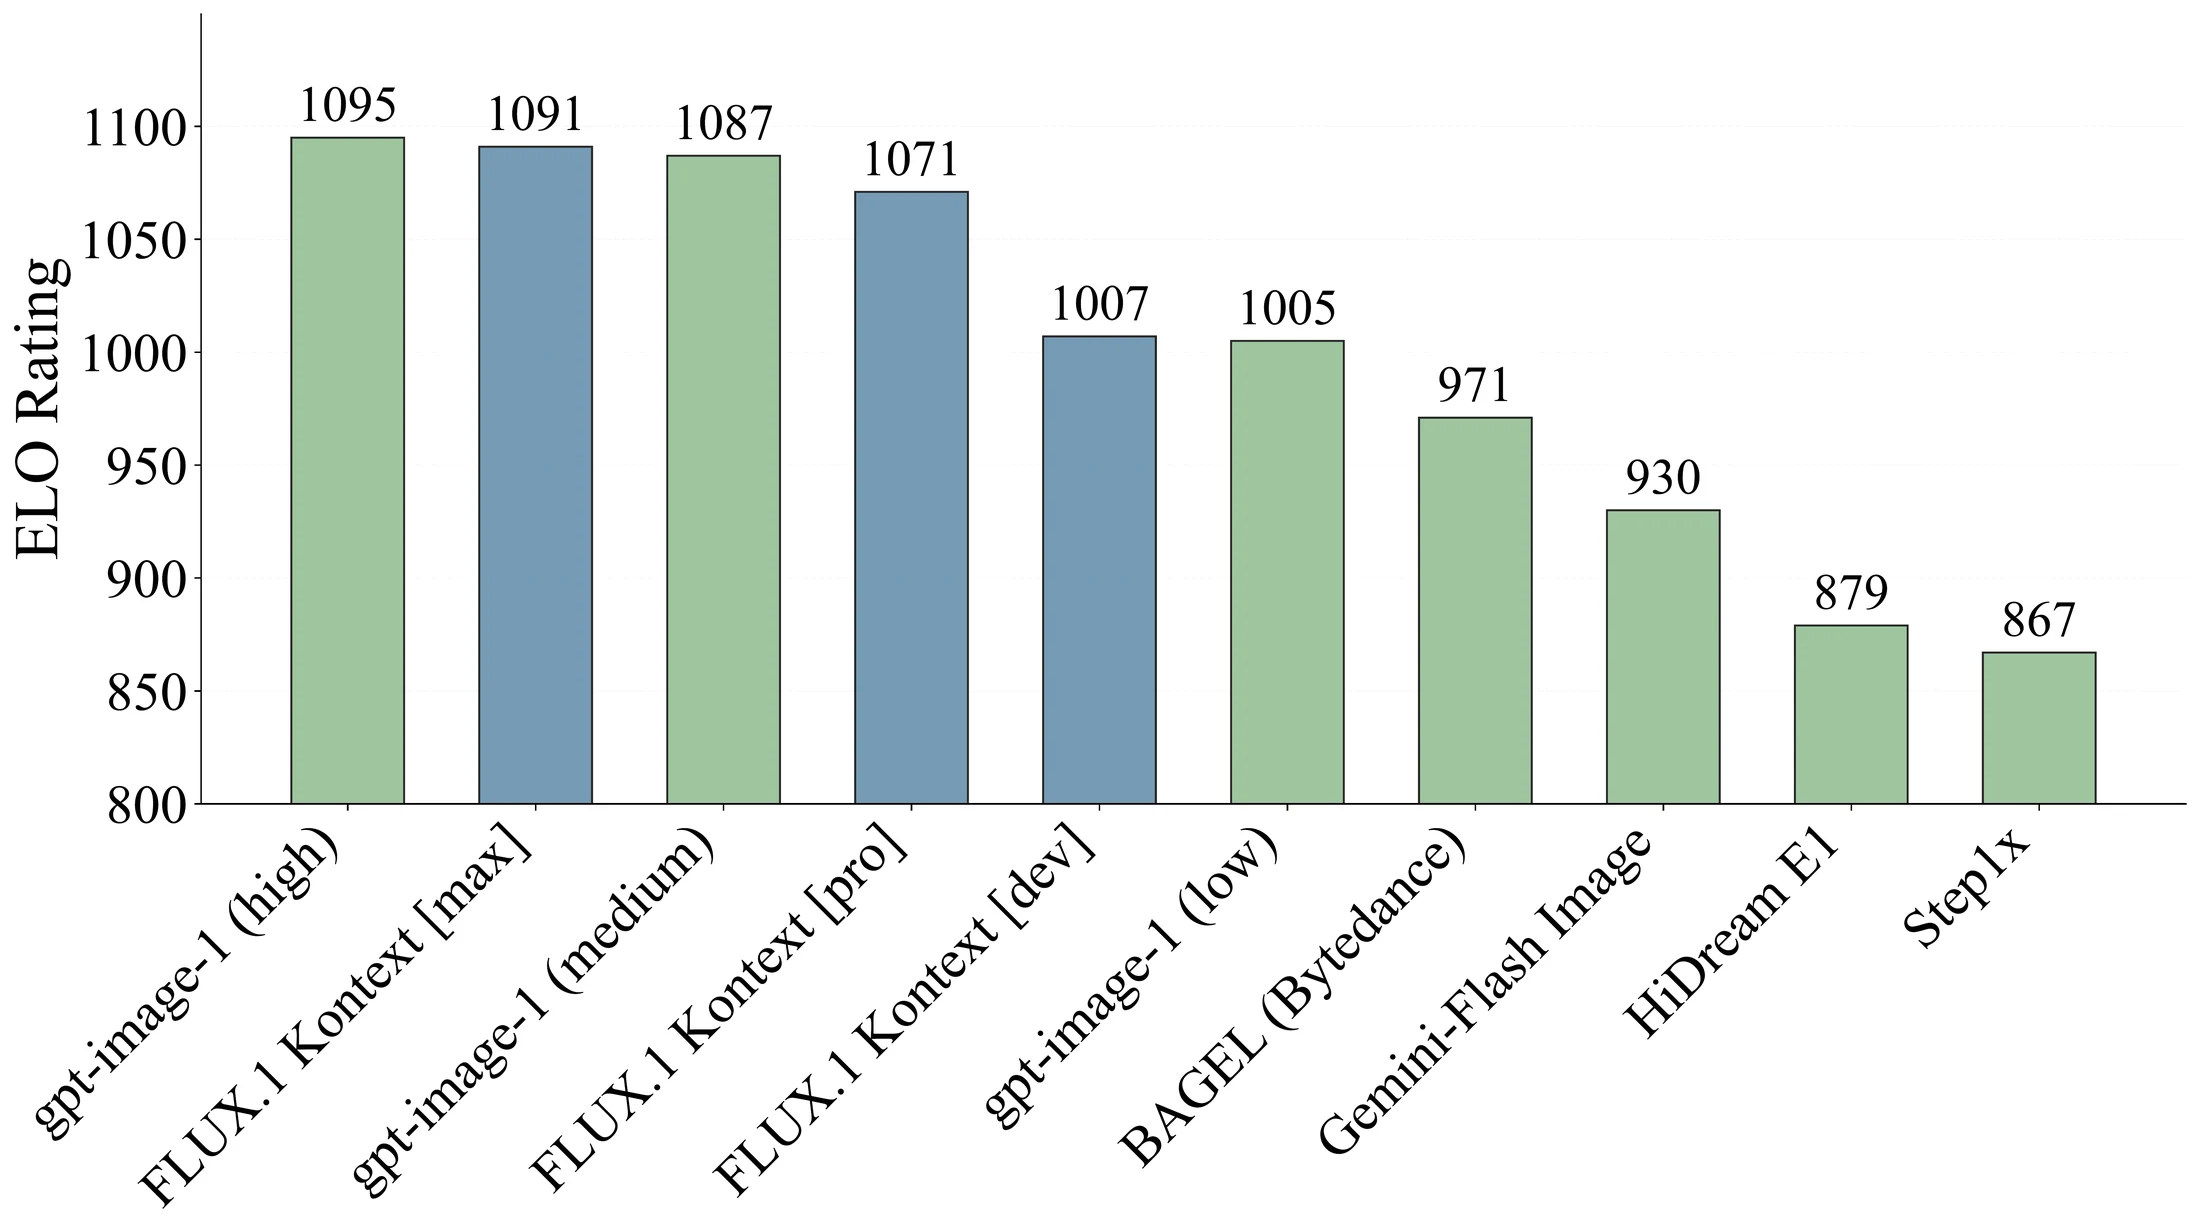
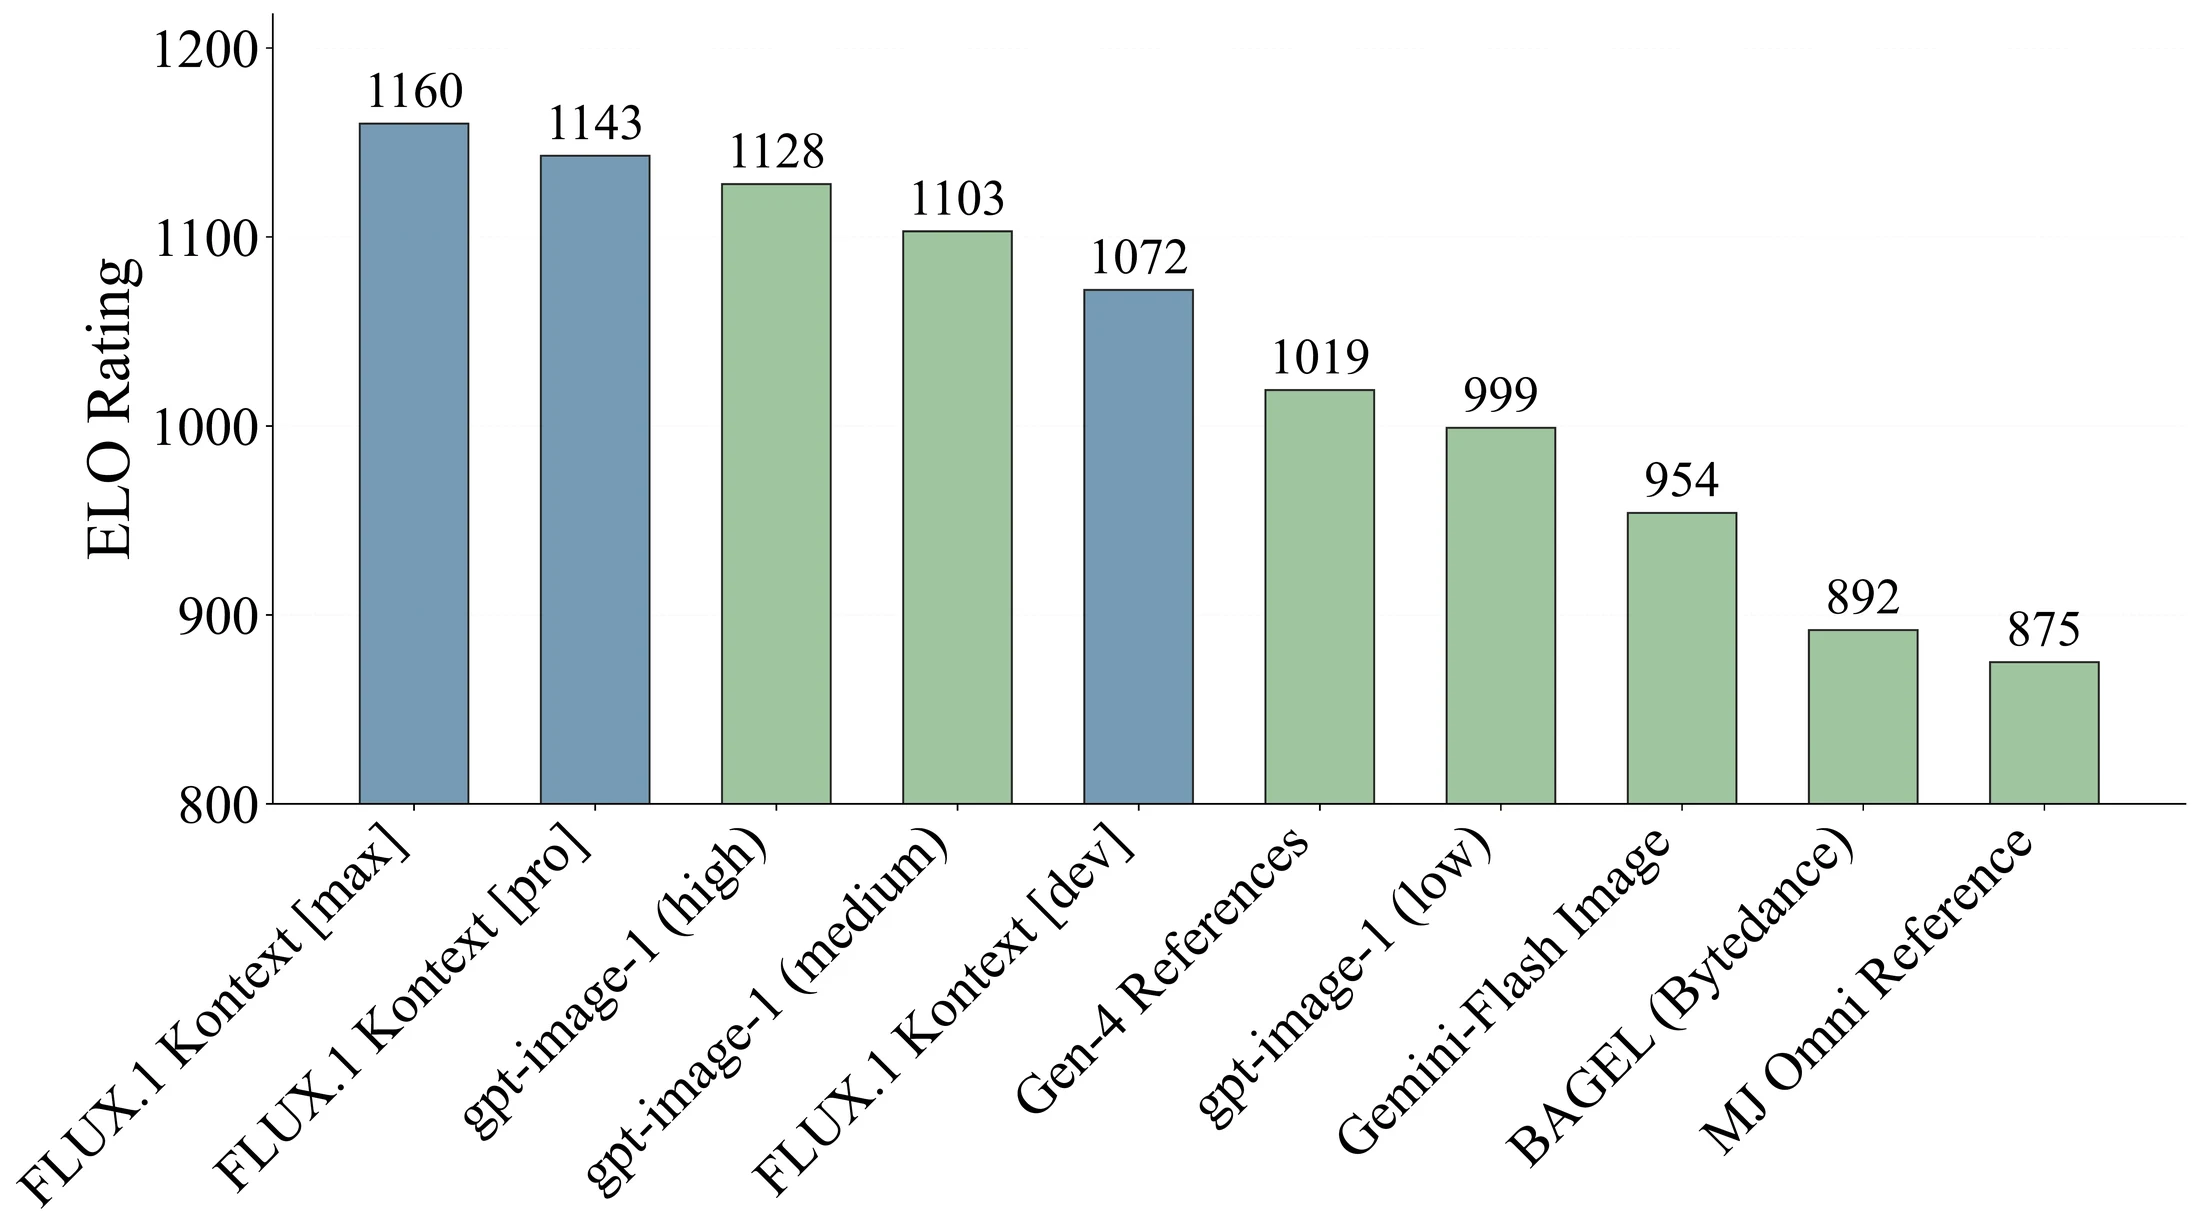
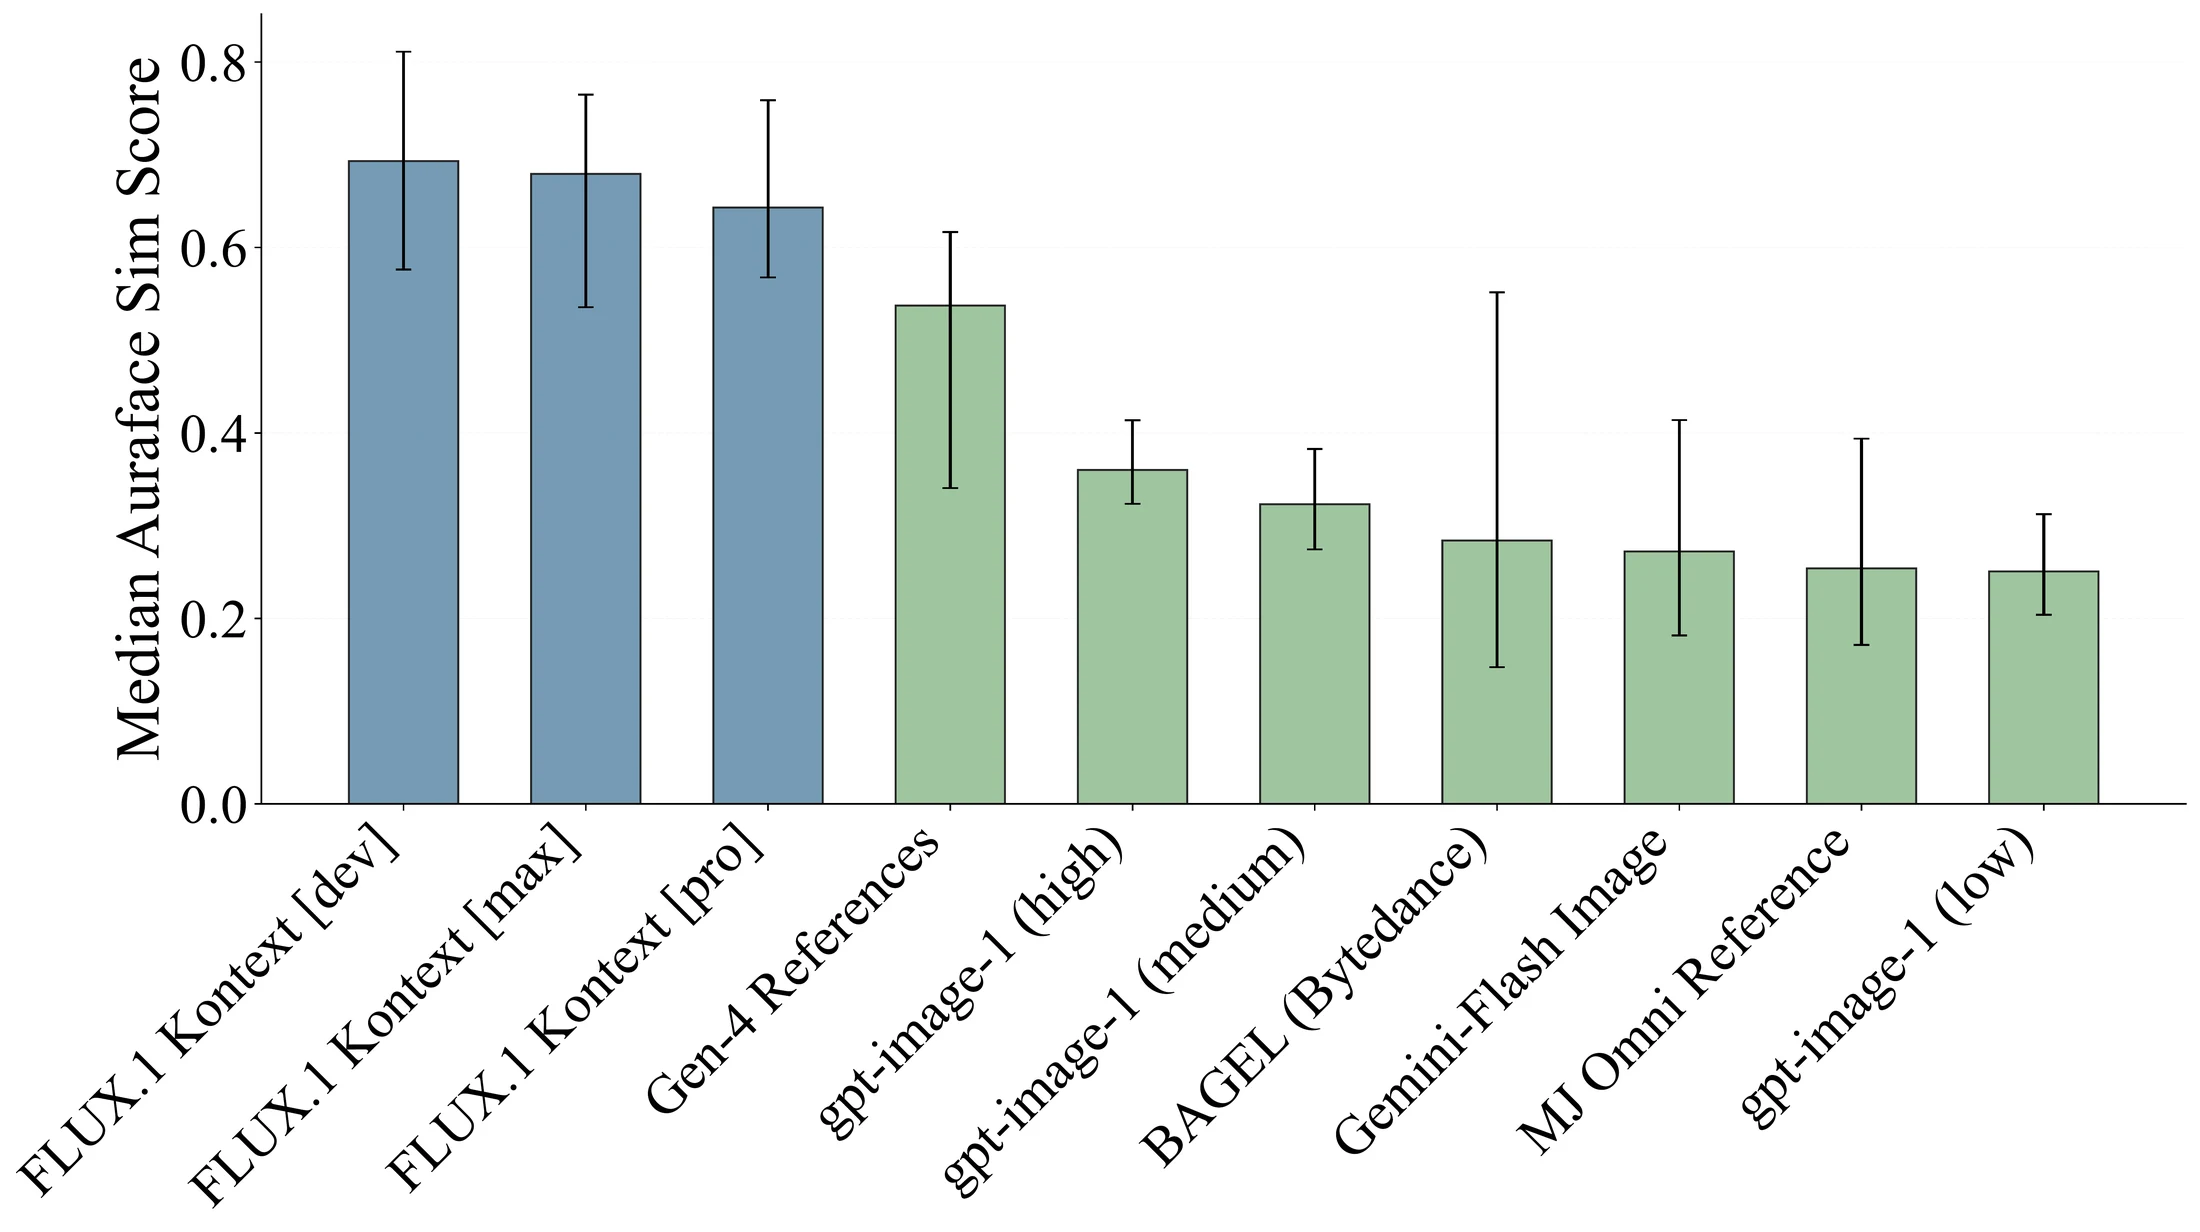
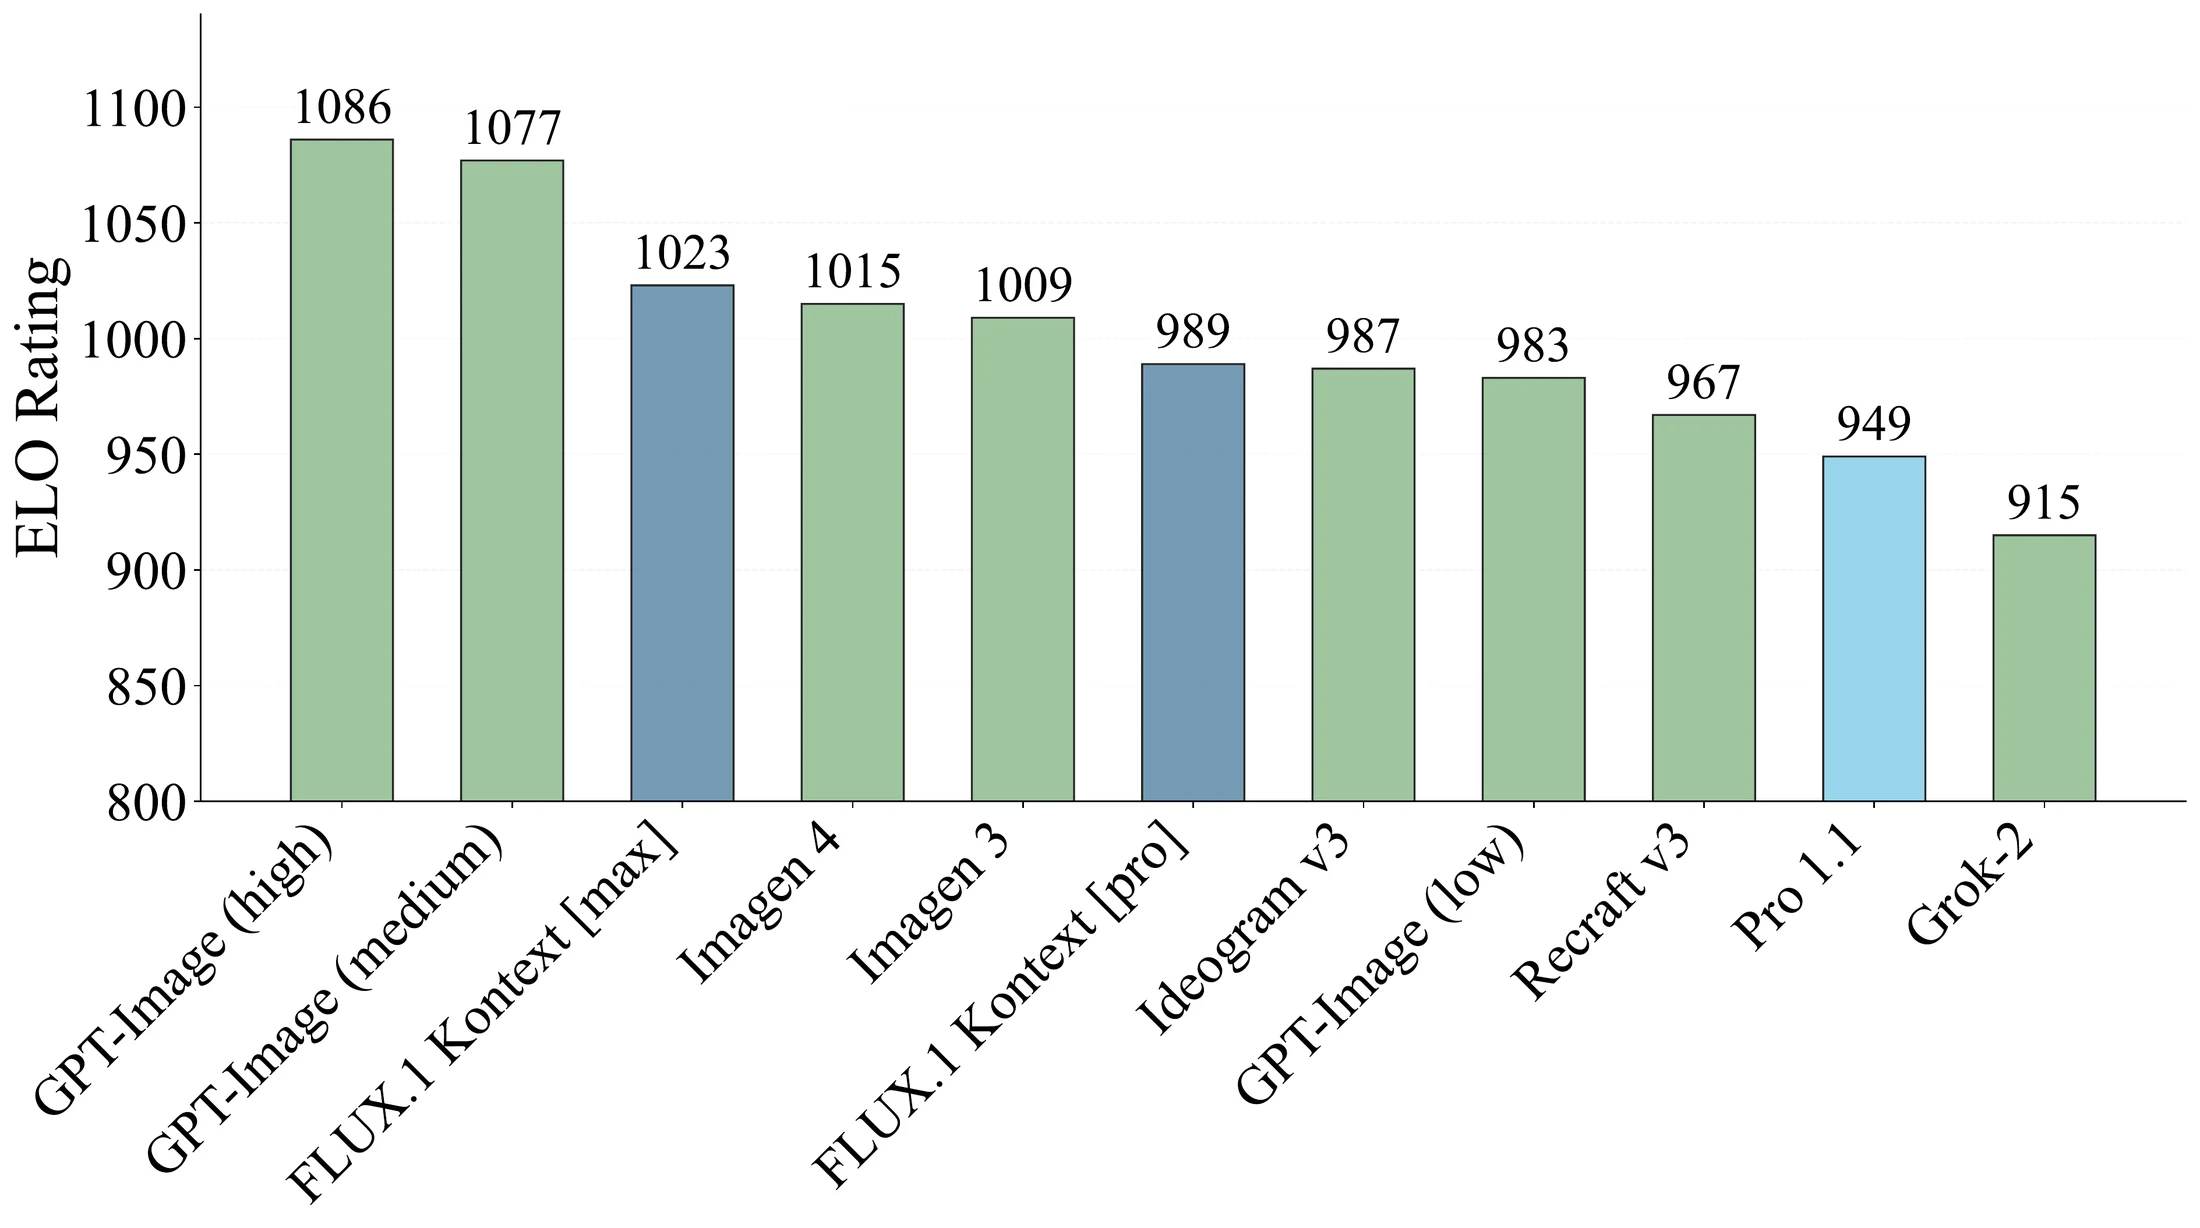
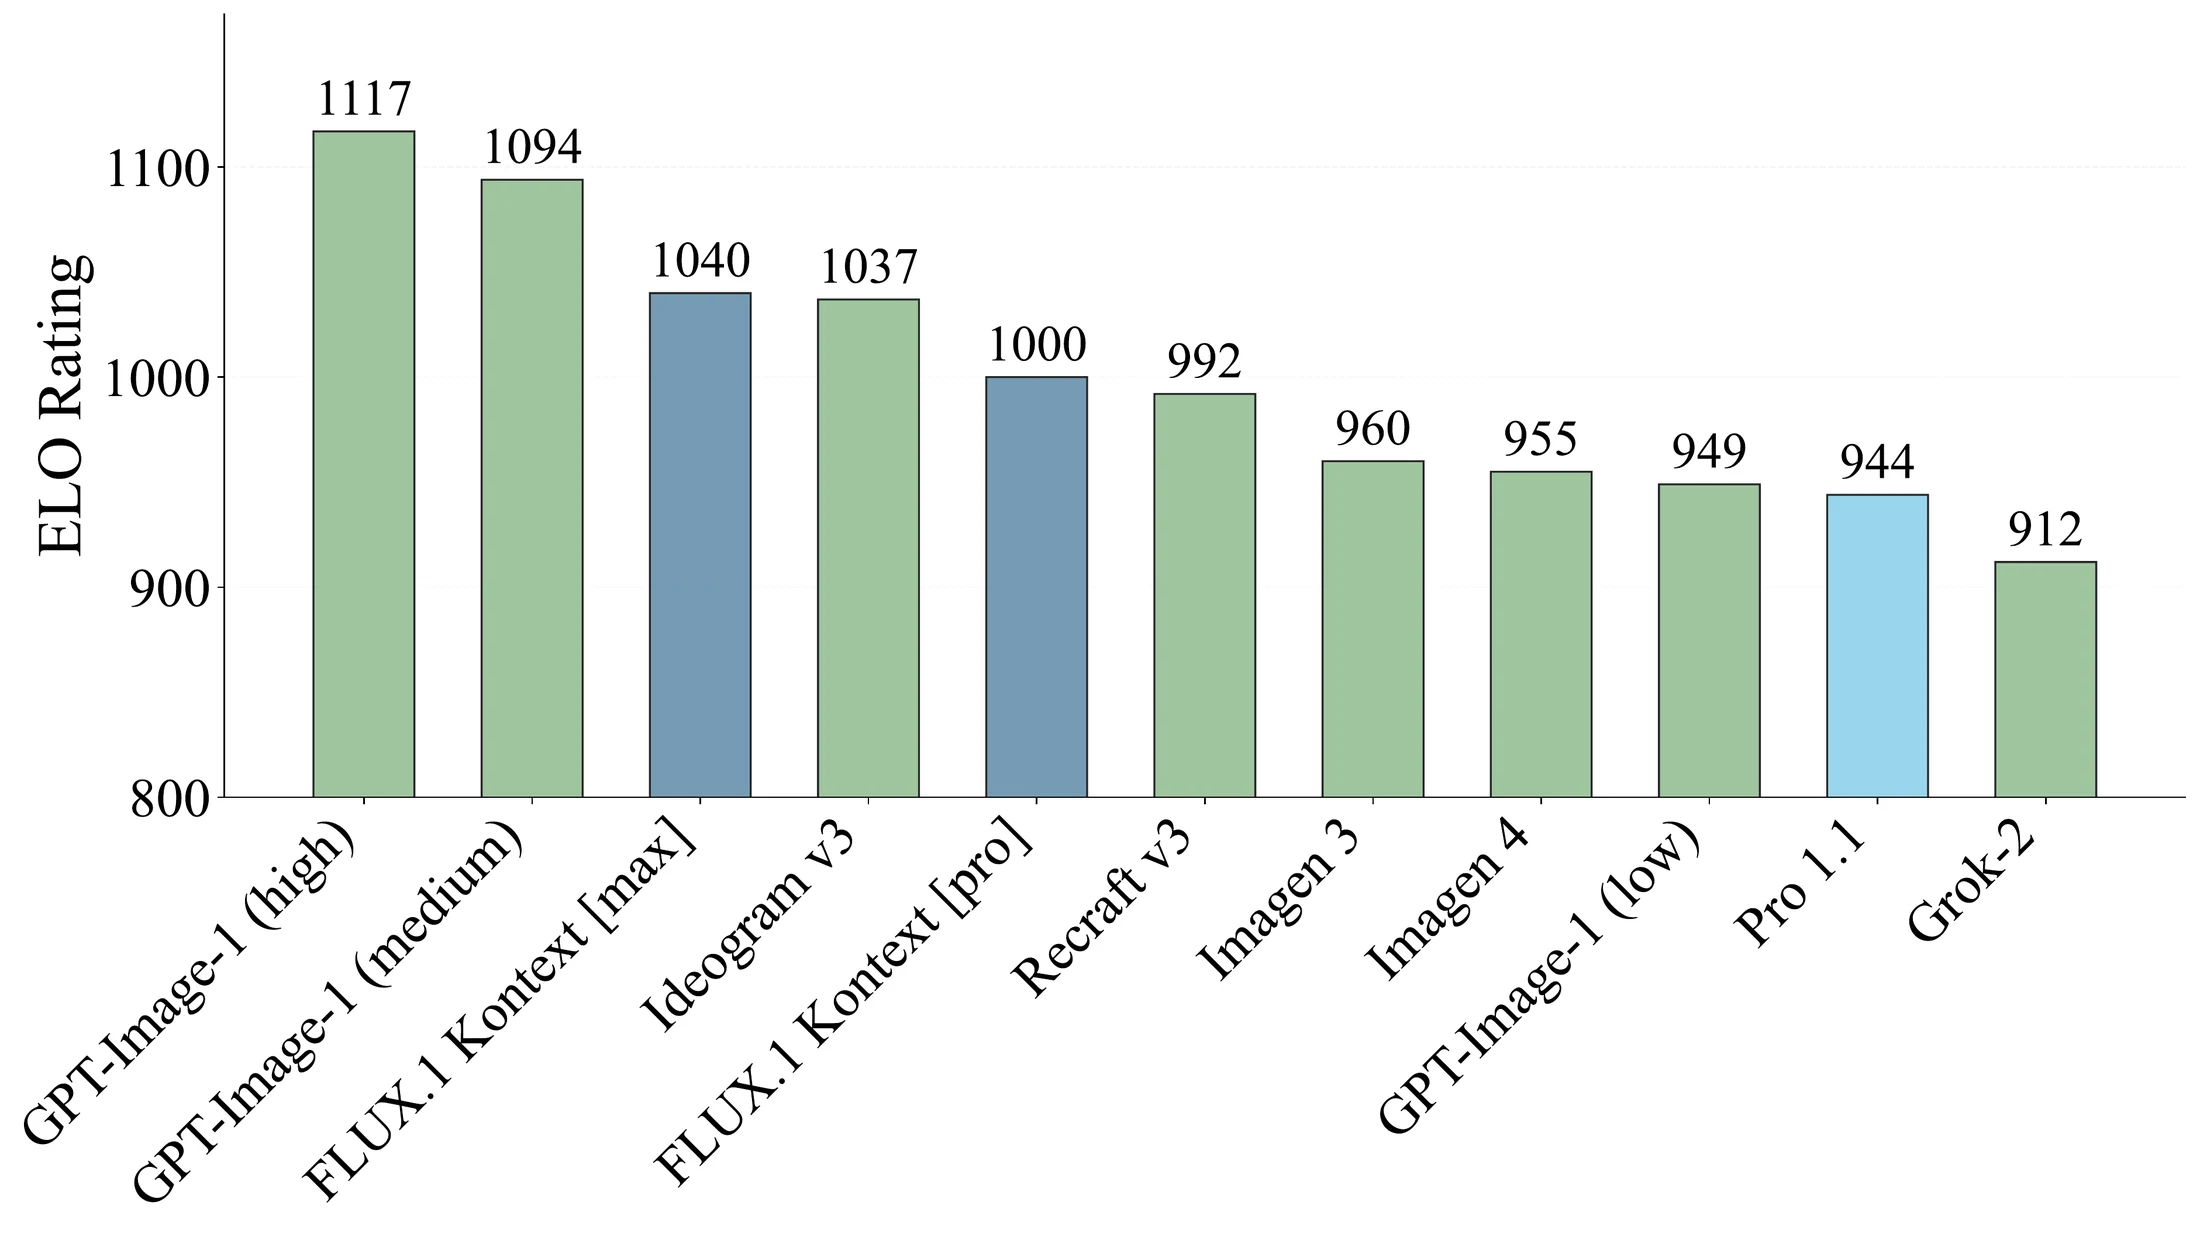
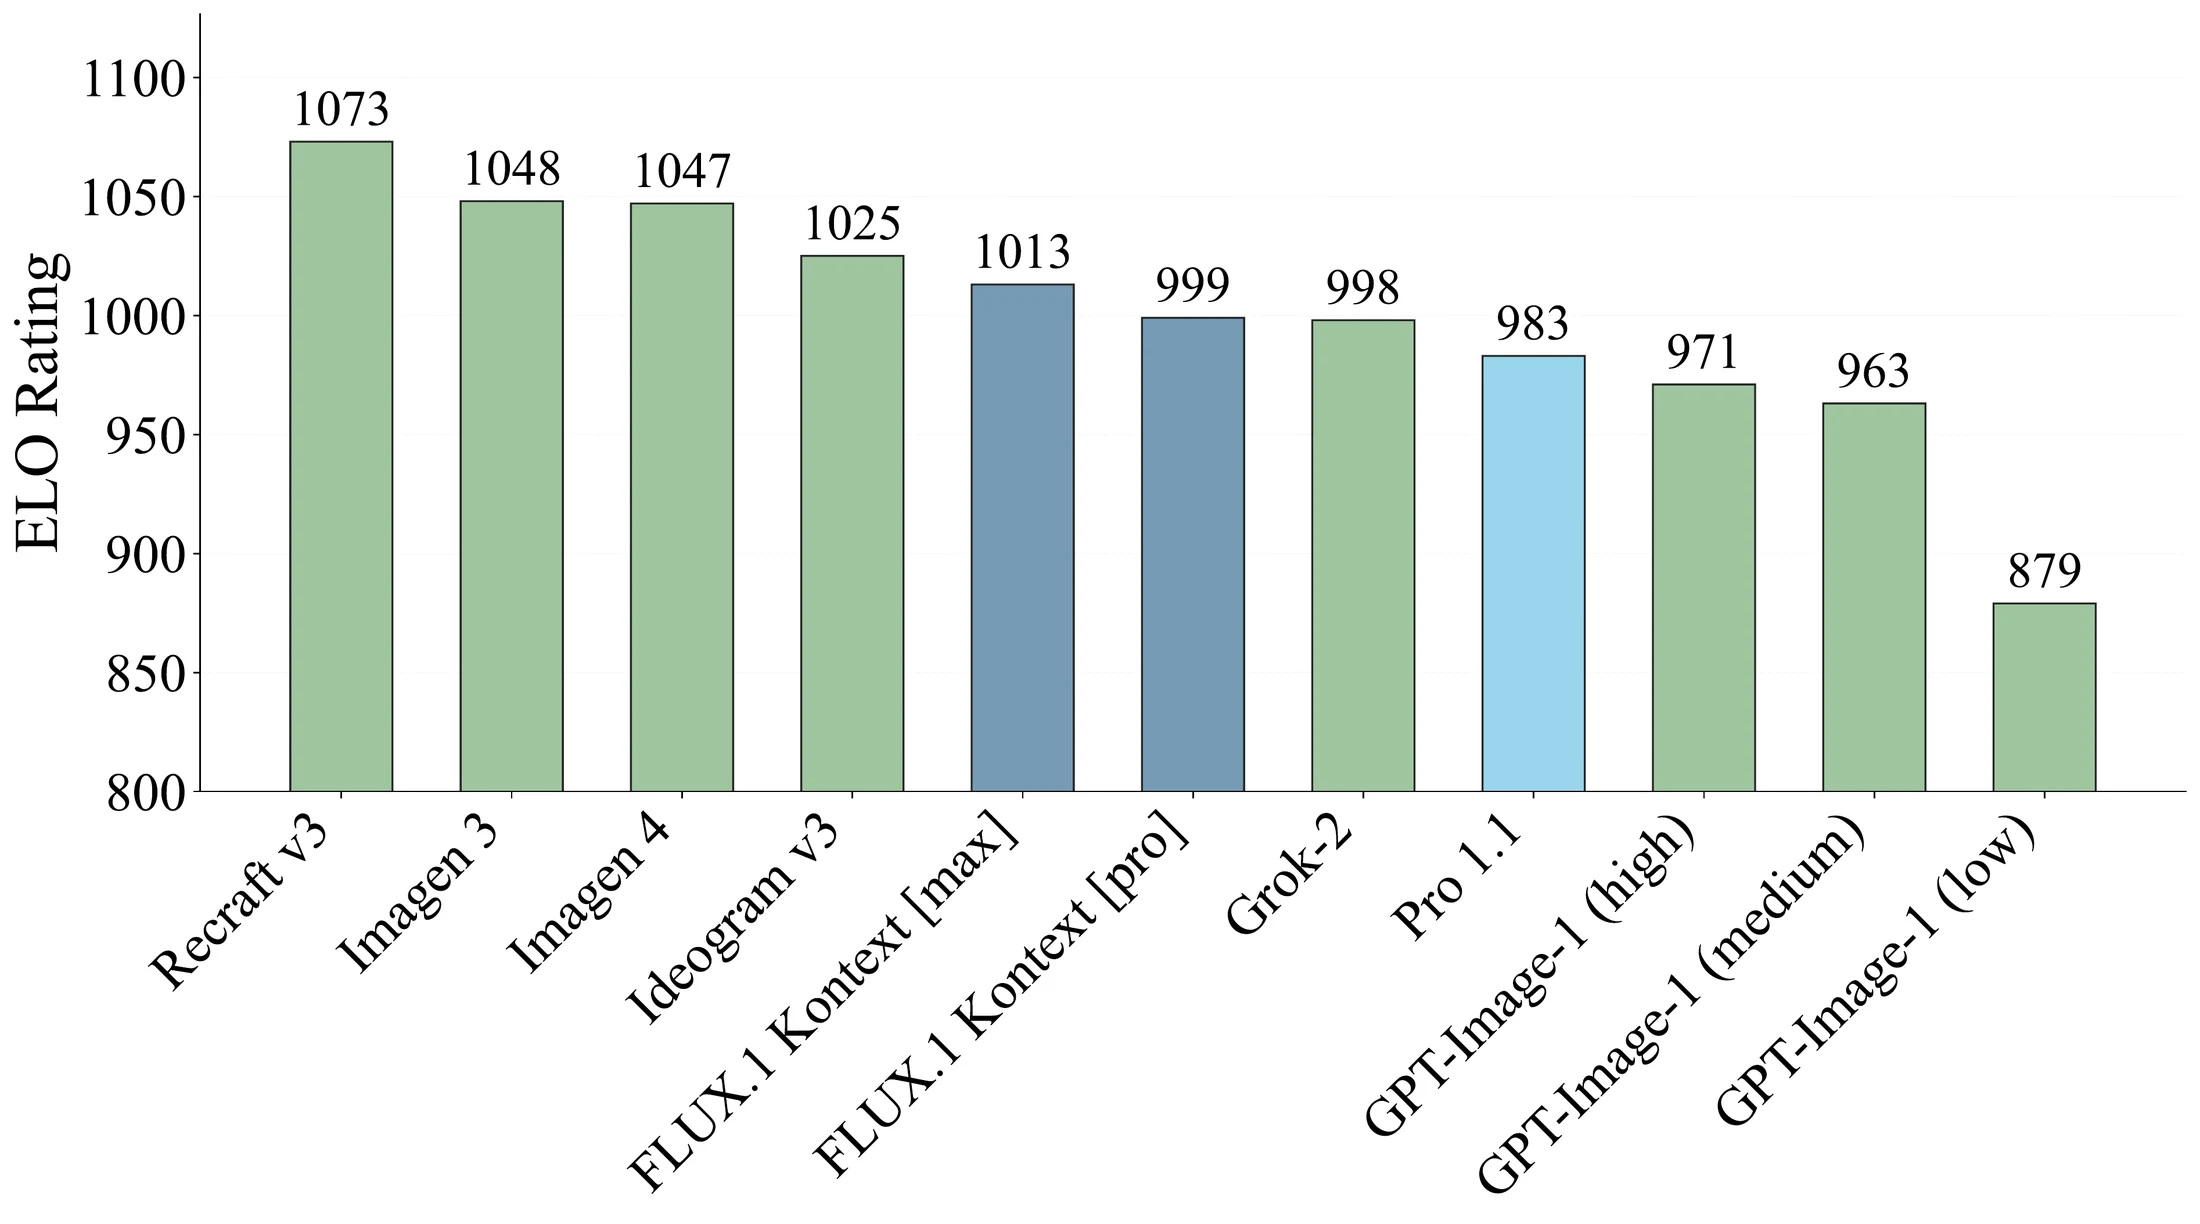
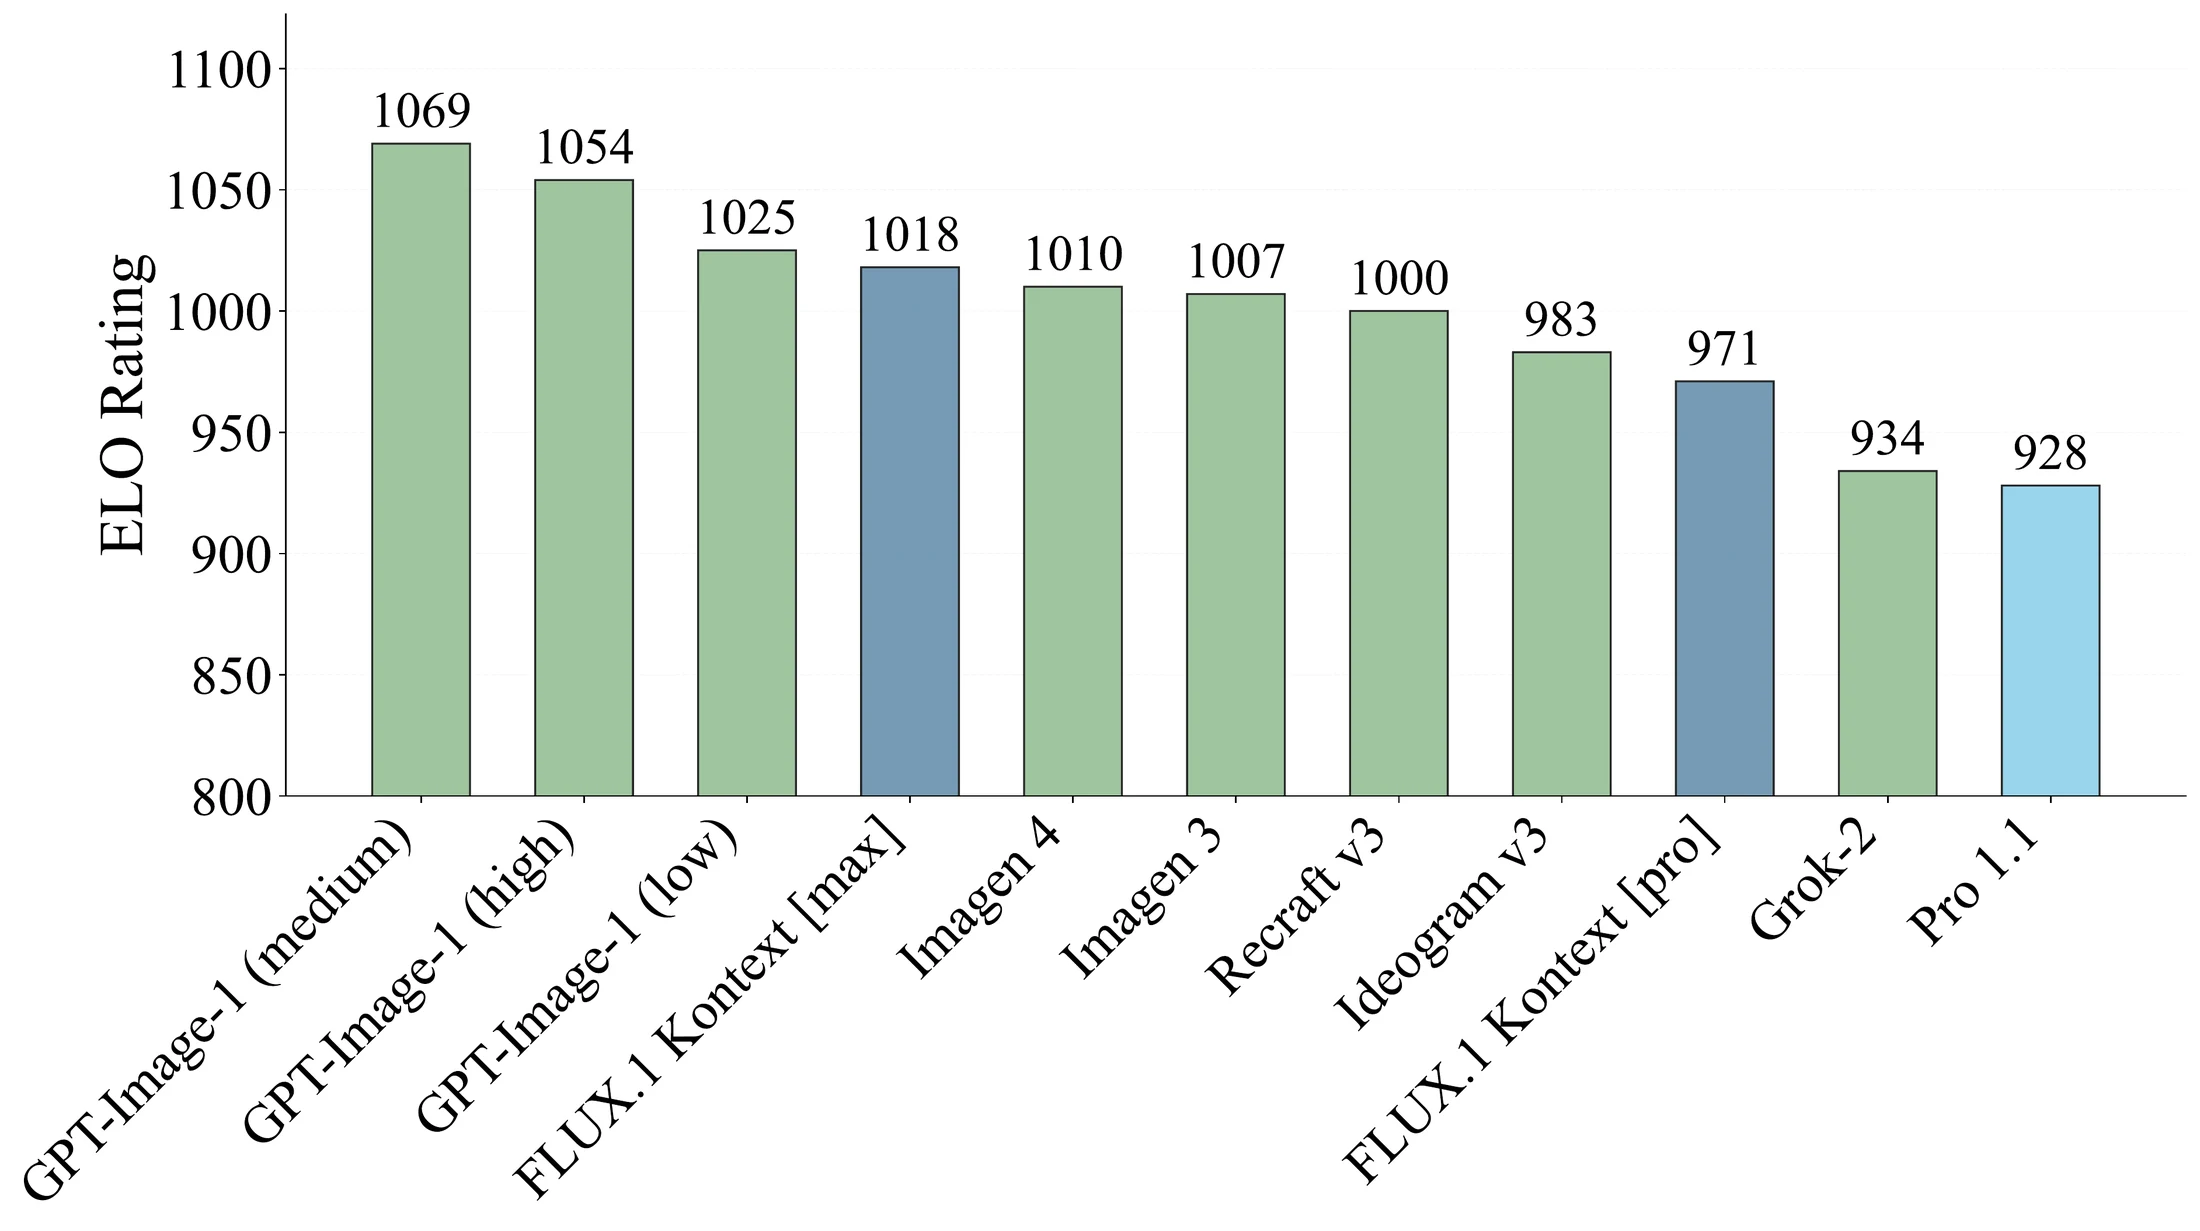
Figure 9 · Text-to-image 多维人评
多轮一致性:一个精确轨迹与三个模型的案例比较
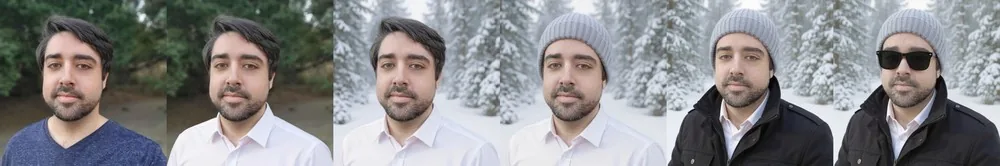
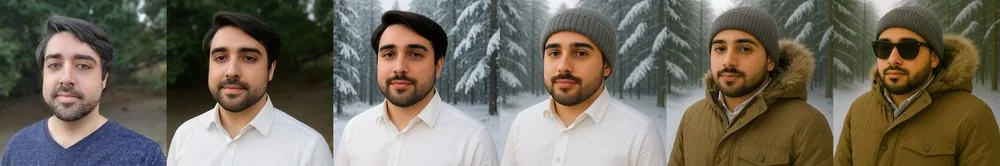
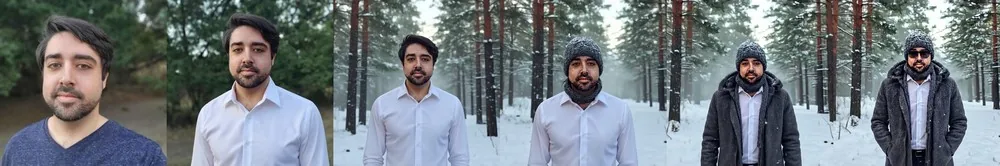
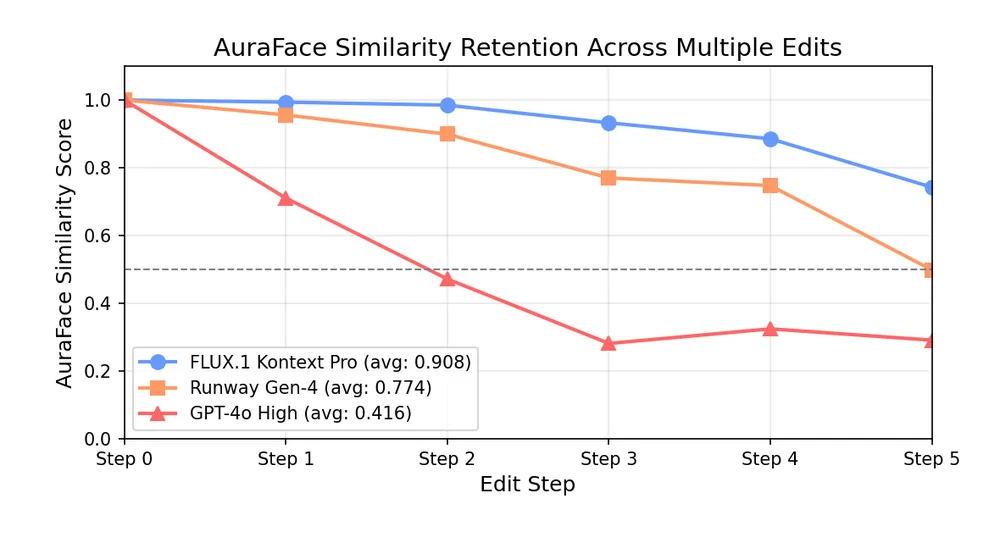
Figure 12 对同一初始图像执行相同指令序列,并用 AuraFace embedding cosine similarity 追踪身份。最后一步加入太阳镜,会遮挡脸部,因此作者预期相似度下降。
| 模型 | Step 0 | Step 1 | Step 2 | Step 3 | Step 4 | Step 5 | 论文图例平均 |
|---|---|---|---|---|---|---|---|
| FLUX.1 Kontext Pro | 1.0000 | 0.9938 | 0.9850 | 0.9328 | 0.8857 | 0.7427 | 0.908 |
| Runway Gen-4 | 1.0000 | 0.9561 | 0.8992 | 0.7701 | 0.7476 | 0.4986 | 0.774 |
| GPT-4o High / gpt-image-1 | 1.0000 | 0.7109 | 0.4720 | 0.2819 | 0.3249 | 0.2915 | 0.416 |
视觉提示与文字编辑
Paper vs. implementation:Diffusers 如何实现序列拼接
官方 Hugging Face 模型卡把 [dev] 标为 12B、BF16、guidance-distilled rectified flow transformer,并推荐 FluxKontextPipeline。以下源码核查固定在 Diffusers commit fef717ffb01f407d2637584ed936c16db908587a。
| 论文概念 | Diffusers 行为 | 含义 |
|---|---|---|
| 目标 \(t=0\) | latent_ids 第一列默认 0 | 目标 token 使用虚拟时间 0 |
| 上下文 \(t=1\) | image_ids[..., 0] = 1 | 单张参考图使用虚拟时间 1 |
| sequence concatenation | torch.cat([latents, image_latents], dim=1) | 沿 token 序列维连接 |
| 只预测目标 | noise_pred = noise_pred[:, : latents.size(1)] | 丢弃参考 token 对应输出 |
| 推荐分辨率 | 输入按宽高比选最近的预设分辨率并裁到倍数 | 实现约束来自推理管线 |
latent_model_input = latents
if image_latents is not None:
    latent_model_input = torch.cat([latents, image_latents], dim=1)

image_ids[..., 0] = 1
noise_pred = transformer(hidden_states=latent_model_input, ...)
noise_pred = noise_pred[:, : latents.size(1)]
公开推理默认值的版本边界
当前 Diffusers main 中 num_inference_steps=28、guidance_scale=3.5;模型卡示例显式使用 guidance scale 2.5。它们是软件与模型卡的当前默认/示例设置,论文没有把这些数值声明为 Figure 8/12 的评测配置。模型仓库文件受 gated access 保护,本次无法匿名读取 transformer/config.json,因此不把配置差异写成已验证事实。
image_ids 改成目标坐标是否会形成 pixel-aligned control 属于合理推演,论文和官方实现没有对此做消融。局限、失败模式与复现清单
论文已披露
- 训练从 FLUX.1 checkpoint 开始
- 数百万 \( (x\mid y,c) \) 关系对
- flow objective、LADD、guidance distillation
- FSDP2 混合精度与系统优化
- KontextBench 类别及样本数
复现仍需
- 数据来源、许可、去重与过滤规则
- optimizer、learning rate、batch、step、GPU
- LADD discriminator、loss 权重与采样 step
- 人评指令、annotator 与 Elo 计算
- 各 baseline API 版本、seed、重试和选择规则
KontextBench 的 crowd-sourced 来源提高任务贴近真实使用的可能性,同时引入抽样偏差。108 张 base image 产生 1,026 对,同一 base image 上的多条样本会相关;报告没有说明统计时是否按 base image 聚类。
Reviewer Commentary
Strengths
- 序列拼接与虚拟时间编码非常简洁
- 不同宽高比和分辨率自然兼容
- 统一 T2I/I2I,接口清晰
- 开放 12B [dev] 权重与参考实现
- 把多轮漂移和延迟纳入评测
Weaknesses
- 主 benchmark 与原始投票未公开
- 缺少核心架构和数据消融
- 训练超参数严重不足
- Figure 12 只是一条轨迹
- Table 1 的 SE/SD 描述冲突
Potential Improvements
- 按 base image 分层 bootstrap
- 报告每类 prompt 和模型失败率
- 比较 sequence/channel/cross-attention
- 测量上下文数量与 token 长度曲线
- 把多轮一致性拆成人脸、服装、背景和文本指标
证据是否支撑核心主张
页面中的原图与报告正文支持 “Kontext 在作者评测上质量有竞争力且延迟较低”。公开材料还不足以支撑跨服务的普遍速度优势,也不足以把多轮一致性优势推广到各类人物、物体与长轨迹。方法贡献的价值更多来自极简结构与强训练系统的结合;具体效果归因仍未分解。
面向程序化材质生成的研究延伸
图像上下文 → 材质程序
把参考材质渲染 token 追加到待生成的 graph token 或 node preview token,使模型同时看到视觉参考与当前执行状态。虚拟时间维可改成 reference slot。
多轮编辑 → 图结构修复
上一轮 material graph、renderer preview 和文本反馈组成下一轮上下文。需要显式约束拓扑合法性与节点参数范围,避免视觉改善伴随程序损坏。
执行反馈
将 renderer 的多视角图像、法线、roughness 与失败日志作为不同 context block,利用 slot offset 区分来源。
测试时搜索
从多个 graph edit proposal 中执行渲染,用 perceptual、结构复杂度与可编辑性 reward 选择,再把失败轨迹压缩进下一轮上下文。
关键实验应比较:共享空间坐标与分离 slot 坐标、sequence concatenation 与 cross-attention、单一预览与多视角预览、直接图生成与执行后修复。评价同时覆盖视觉相似度、graph validity、节点数、运行时、参数可控性与多轮退化。
资料来源
- Black Forest Labs et al., FLUX.1 Kontext, arXiv:2506.15742v2 — 论文正文、附录、TeX source、Figure 与 Table。
- Black Forest Labs 官方发布文章 — 模型家族定位、产品能力与官方评测说明。
- FLUX.1 Kontext [dev] 官方模型卡 — 12B、BF16、许可证、推理示例与安全说明。
- Diffusers FluxKontextPipeline 固定提交源码 — latent 拼接、image ids、推荐分辨率与核查时推理默认值。
- Esser et al., Scaling Rectified Flow Transformers for High-Resolution Image Synthesis — FLUX.1 架构与 timestep shift 背景。
- Lipman et al., Flow Matching for Generative Modeling — conditional flow matching 基础。
核查日期:2026-09-29。Figure 8/9 的图表原图来自 arXiv v2 source;数值未通过视觉估计转录。页面中的实现观察对应核查时 Diffusers main。