Paper verified
长时压缩
长度为 \(T\) 的位移序列原本需要 \(T\) 个二维场;模型保留 \(K=16\) 个低频项,以 \(K\ll T\) 的固定表示覆盖整段轨迹。
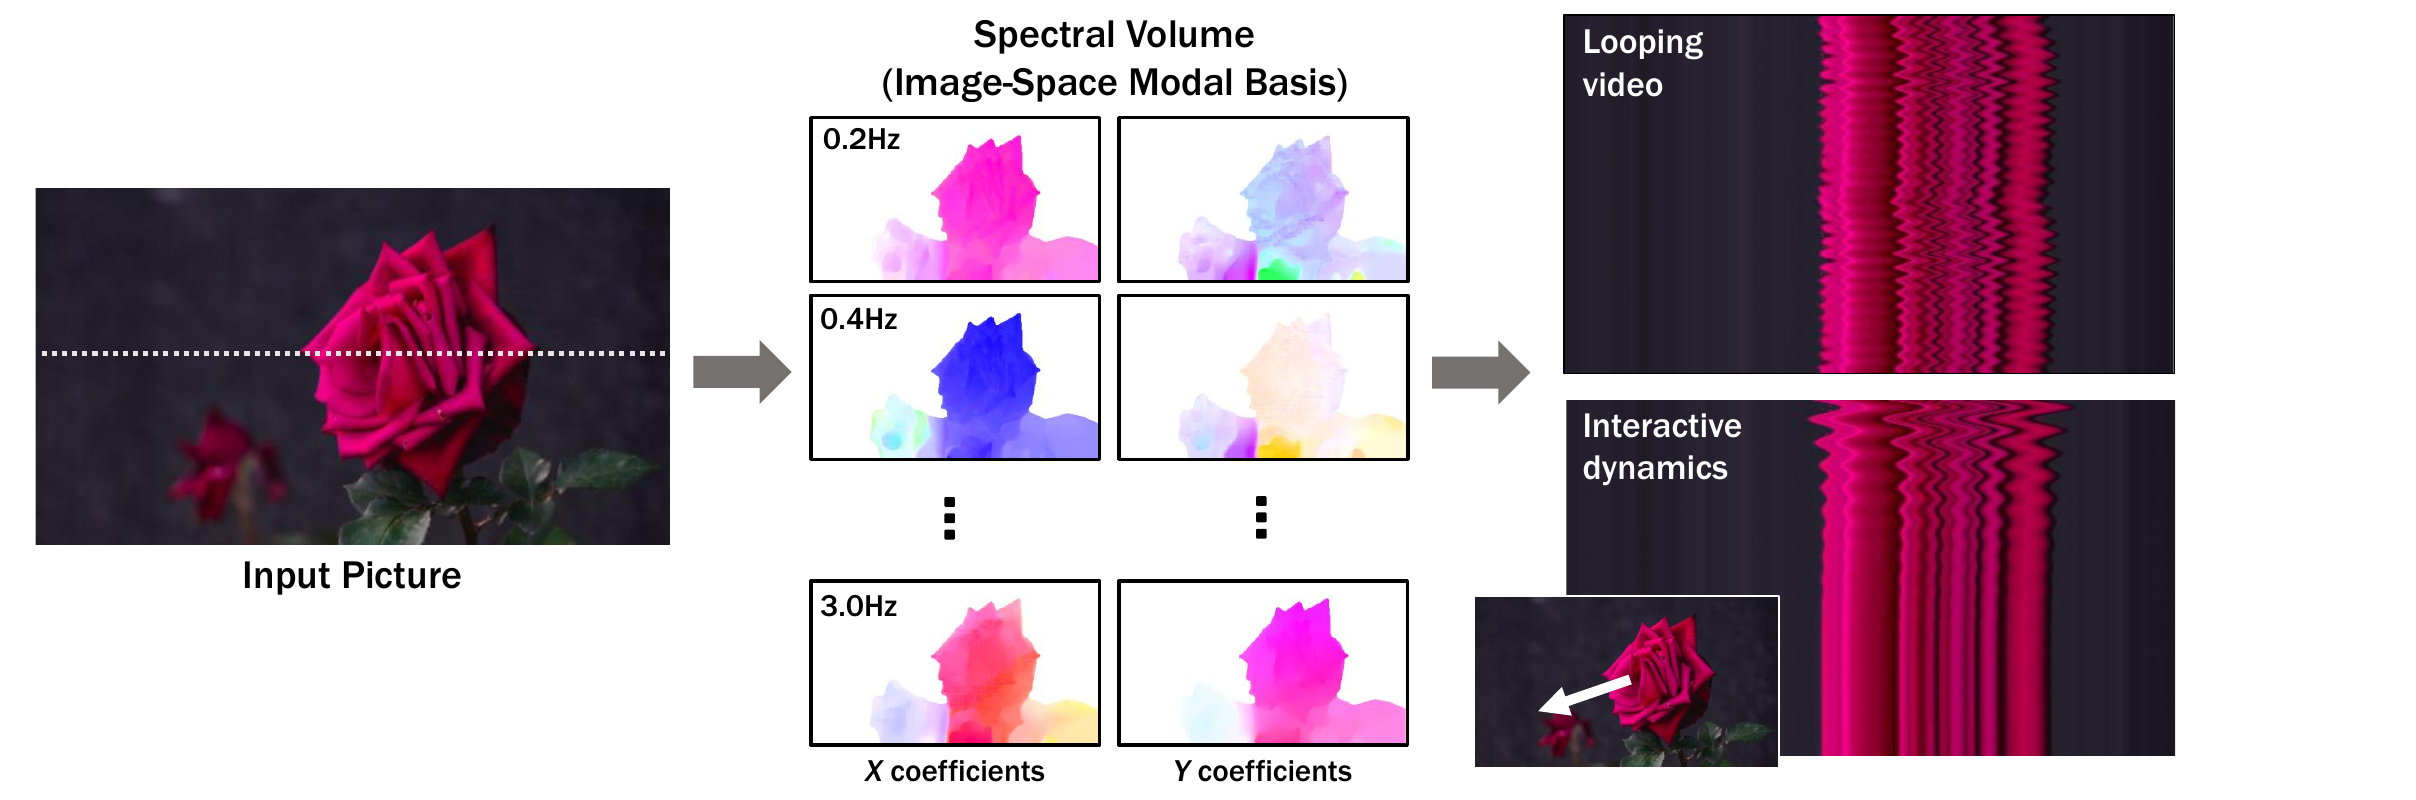
论文没有直接预测一帧接一帧的 RGB。它先预测每个像素的长时运动频谱,再把频谱还原成位移轨迹,用神经图像渲染器生成视频。这一中间表示同时支持循环动画、运动幅值编辑和拖拽交互。
适用范围集中在树叶、花朵、火焰、布料等自然、小幅、振荡运动。模型产生的是二维图像空间中的“合理运动先验”,没有恢复真实三维几何,也没有辨识质量、刚度等物理参数。
逐帧视频生成必须同时重新创造纹理与运动,误差会随时间积累。单帧光流预测只覆盖瞬时变化,也无法天然表达长周期相关性。本文把目标换成 spectral volume:每个像素未来位移轨迹的低频 Fourier 系数集合。
长度为 \(T\) 的位移序列原本需要 \(T\) 个二维场;模型保留 \(K=16\) 个低频项,以 \(K\ll T\) 的固定表示覆盖整段轨迹。
原始 RGB 图像作为唯一外观来源,生成器预测位移,再由渲染器搬运和补全特征,因而更容易保持颜色与纹理。
频谱系数可缩放、重采样并解释成 image-space modal bases。一个生成表示因此成为动画、循环和交互的共同接口。
Equation 1 是前向 warping 的理想形式。多个源像素可能落到同一目标点,目标区域也可能没有源像素,因此实际系统需要带权 softmax splatting 和补全网络。
Equation 2 把每个像素的时间轨迹变换到频域。模型只生成前 \(K\) 个低频系数,再经逆变换获得任意时刻的位移。
真实二维位移要求完整频谱满足 Hermitian 共轭对称;实际逆 FFT 还要明确 DC、Nyquist、负频率镜像、时间长度与截断频带外的补零方式。正文和补充材料只写“保留前 \(K\) 个频率并做 inverse FFT”,没有公开这些约定。复现时必须显式构造共轭负频率,并验证输出虚部为零,不能把复数位移直接交给 renderer。
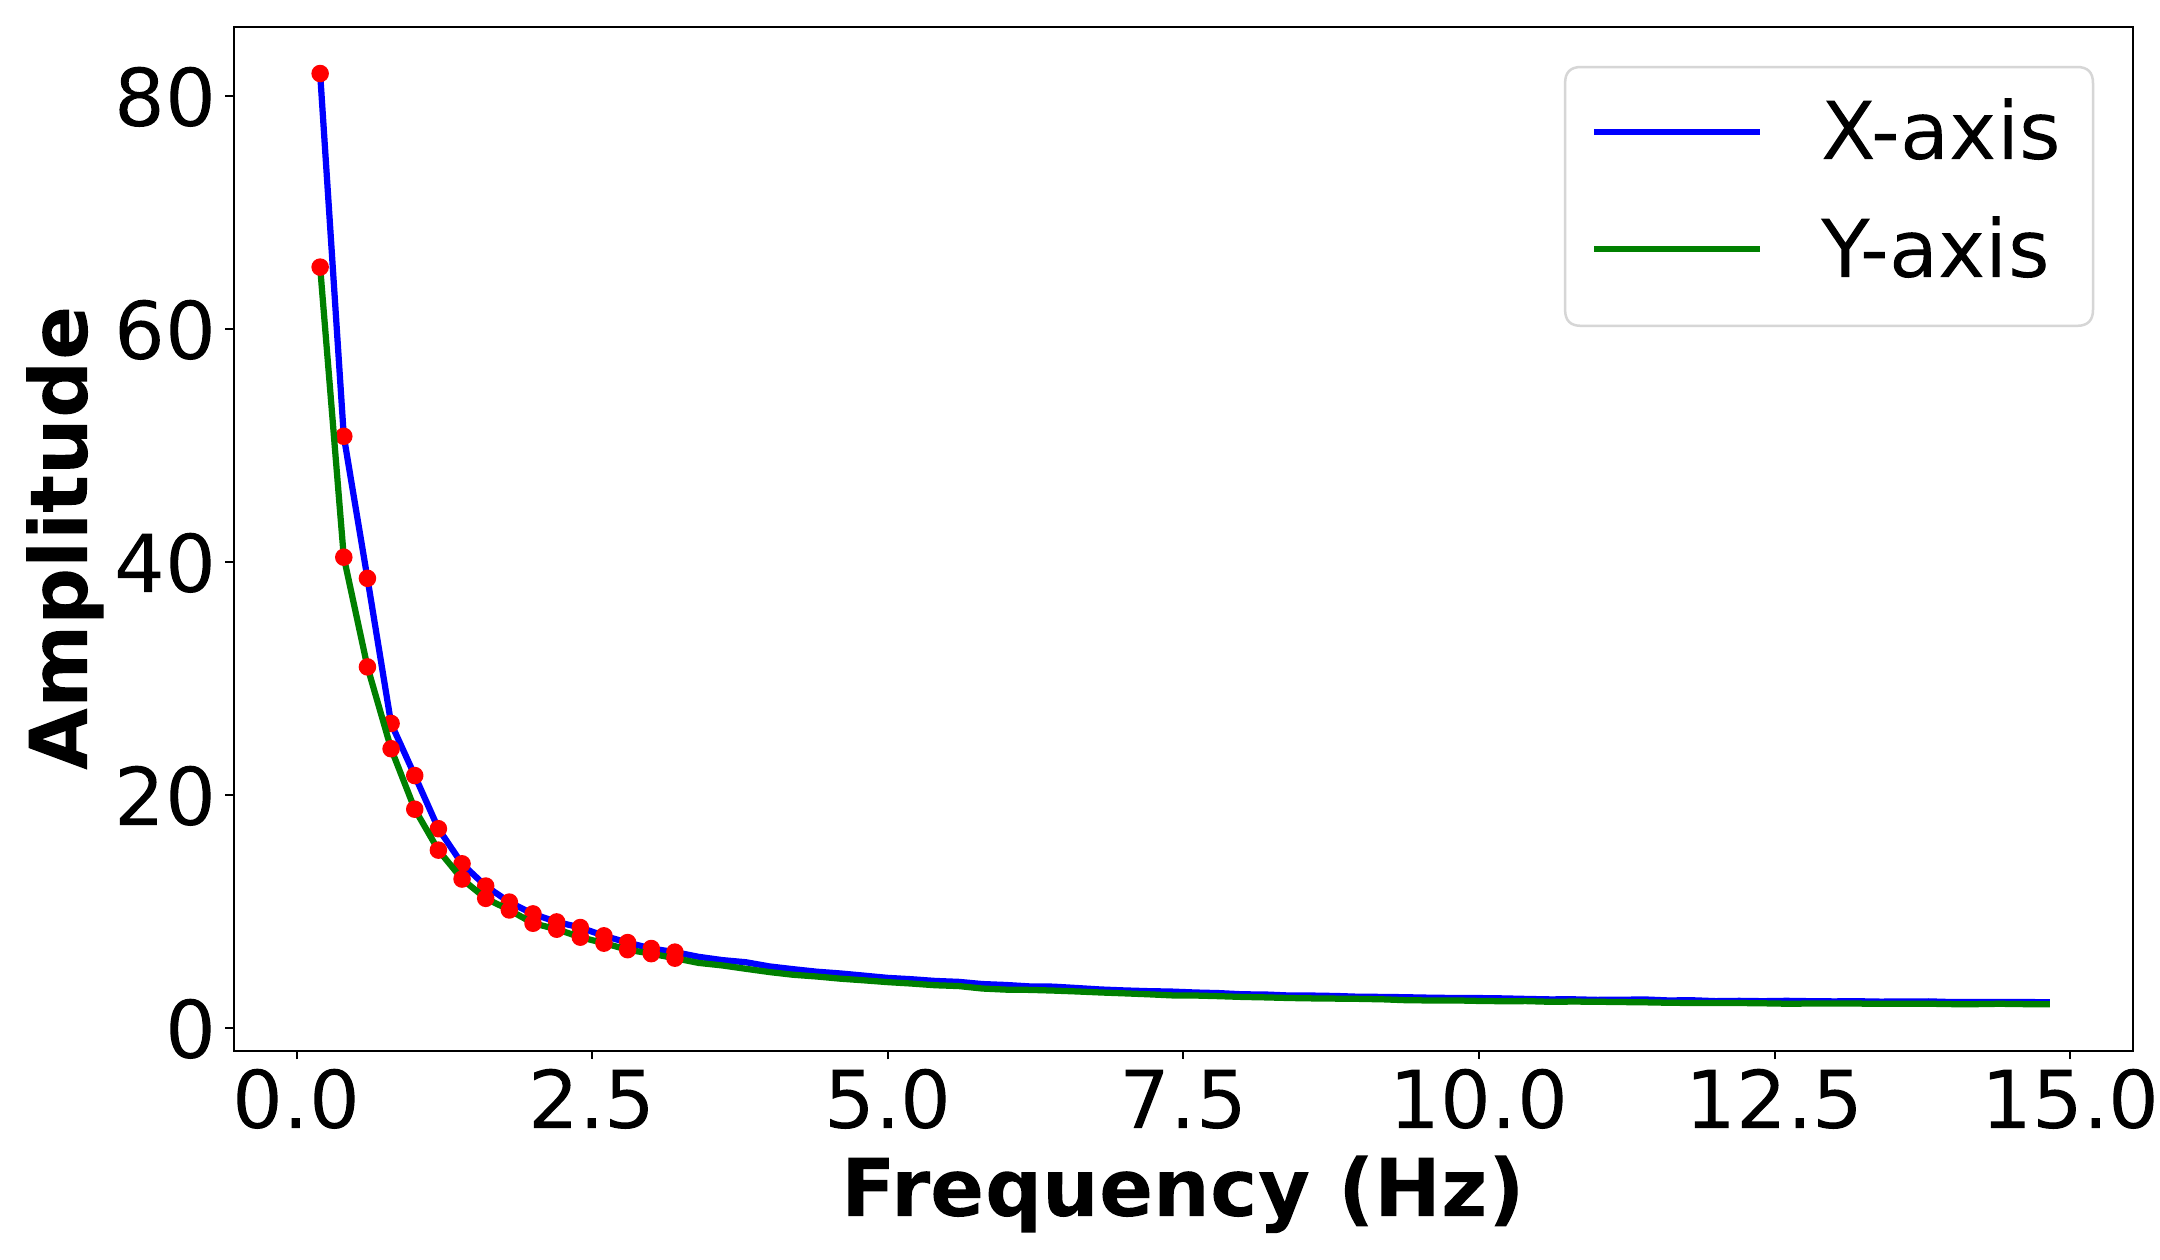
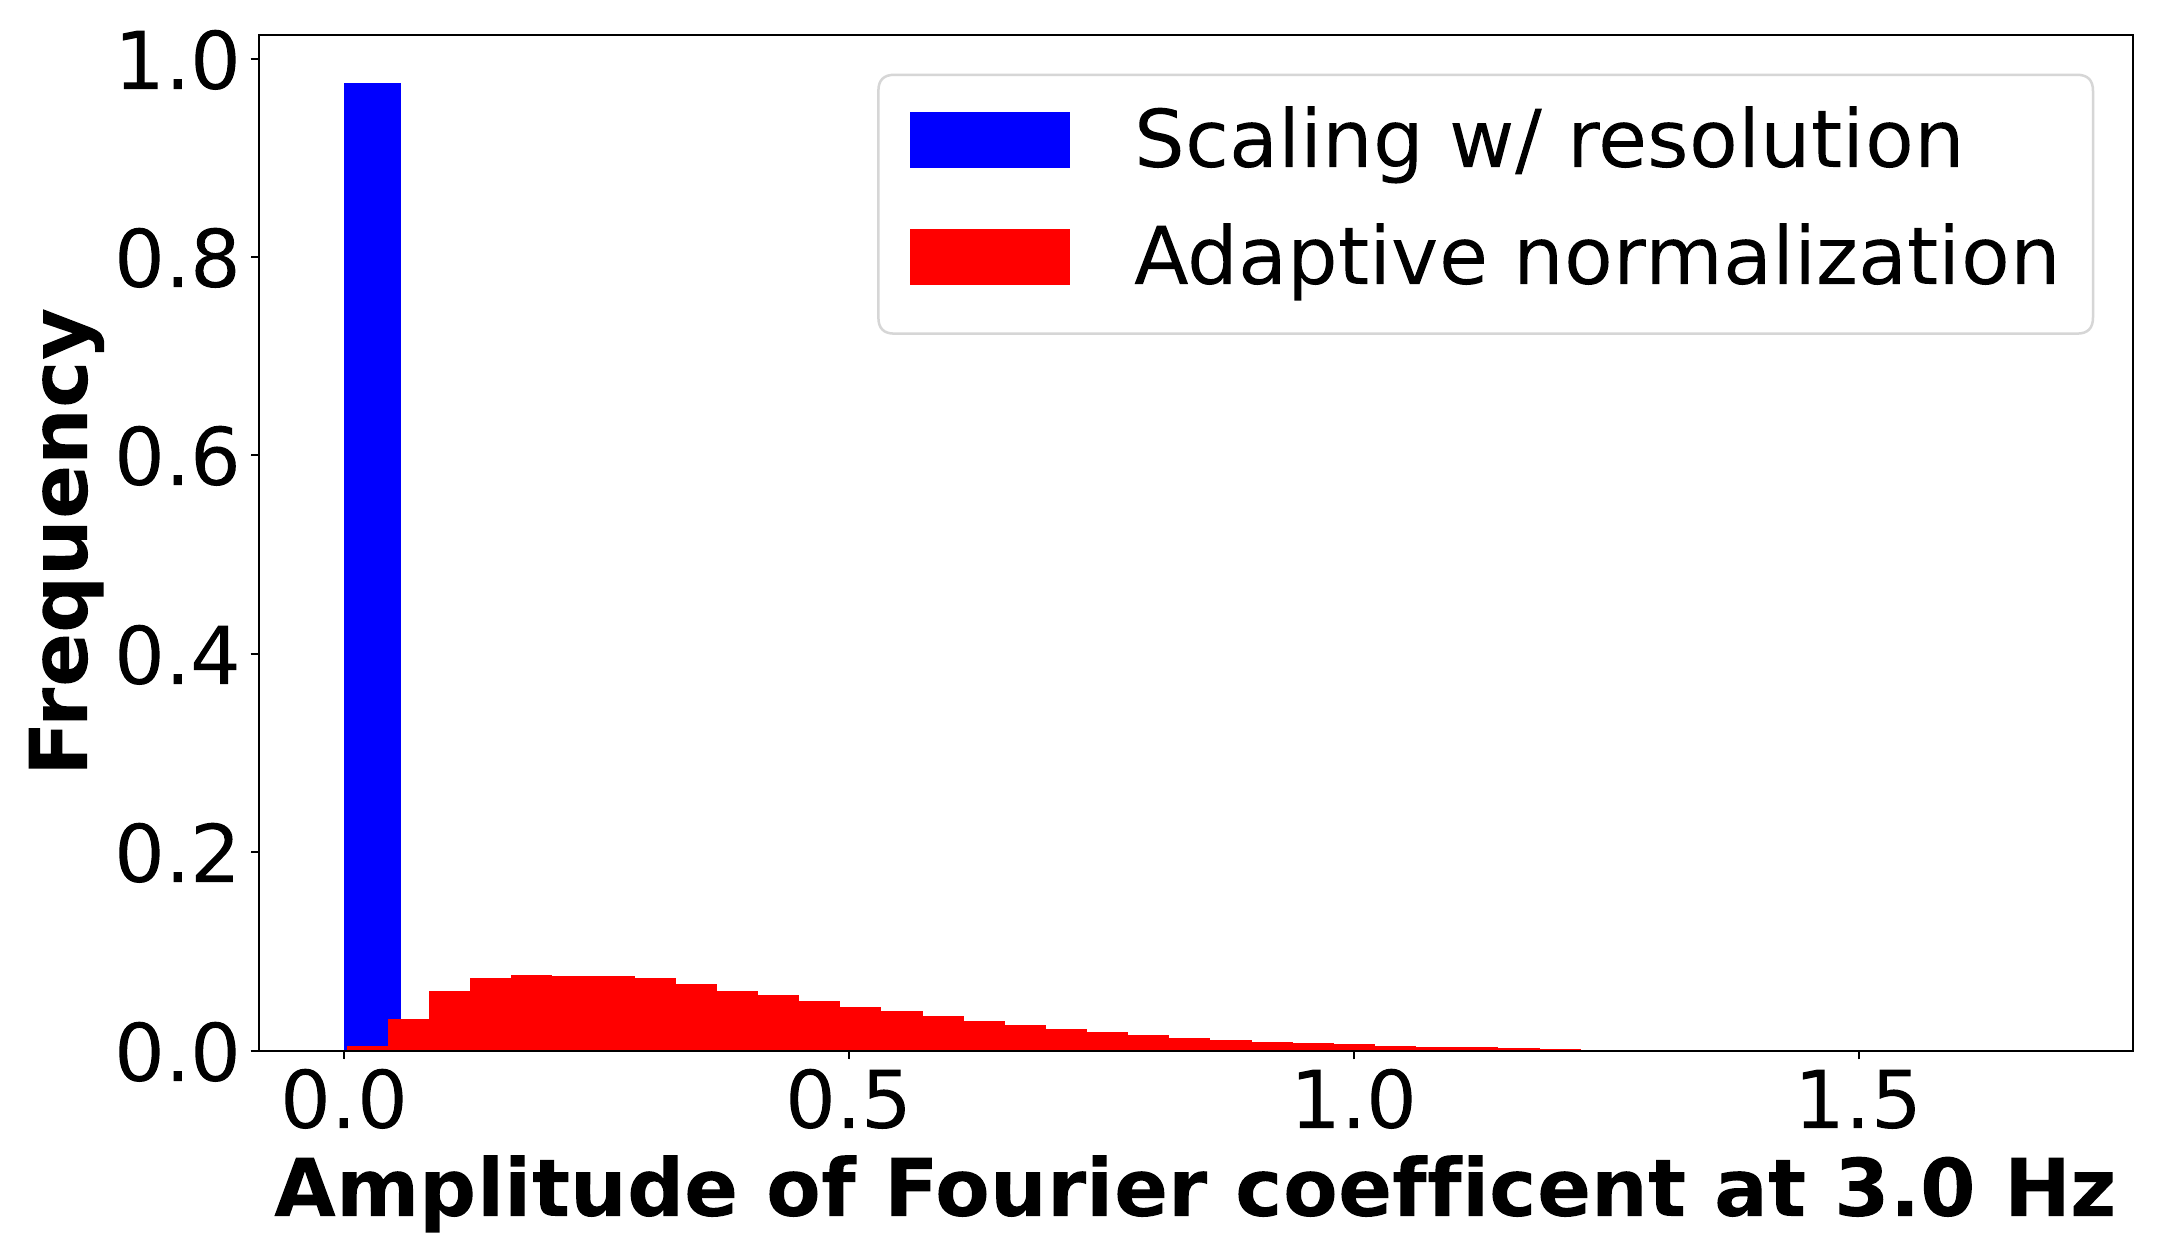
“16 个频率足够”的依据来自 1,000 个随机五秒自然振荡片段及消融实验,不能推广成任意视频运动的频谱结论。快速平移、人物动作、高频振动和非周期事件都超出该验证范围。
各频率能量跨度不同。作者对训练集中每个频率 \(f_j\) 统计 Fourier 系数幅值的第 95 百分位 \(s_{f_j}\),随后对每个实数分量做带符号平方根变换:
这一步提高小幅高频系数的数值分辨率。第 95 百分位是尺度统计量,尾部样本仍可能超过单位区间;论文将稳定训练动机表述为输出接近 \([-1,1]\),不能把它解释成 diffusion 的数学硬约束。
VAE 将每个四通道频率切片压缩到四维连续 latent。第一阶段训练共享 2D U-Net 预测单个频率切片,同时注入 diffusion 时间步 embedding 与频率 embedding。第二阶段冻结空间层,在每个 block 中插入沿 \(K\) 个频率的 attention:空间层把张量看作 \((BK,C,H,W)\),频率 attention 临时恢复为 \((B,K,C,H,W)\)。这样保留成熟的二维建模能力,同时让不同频率的相位与结构互相协调。
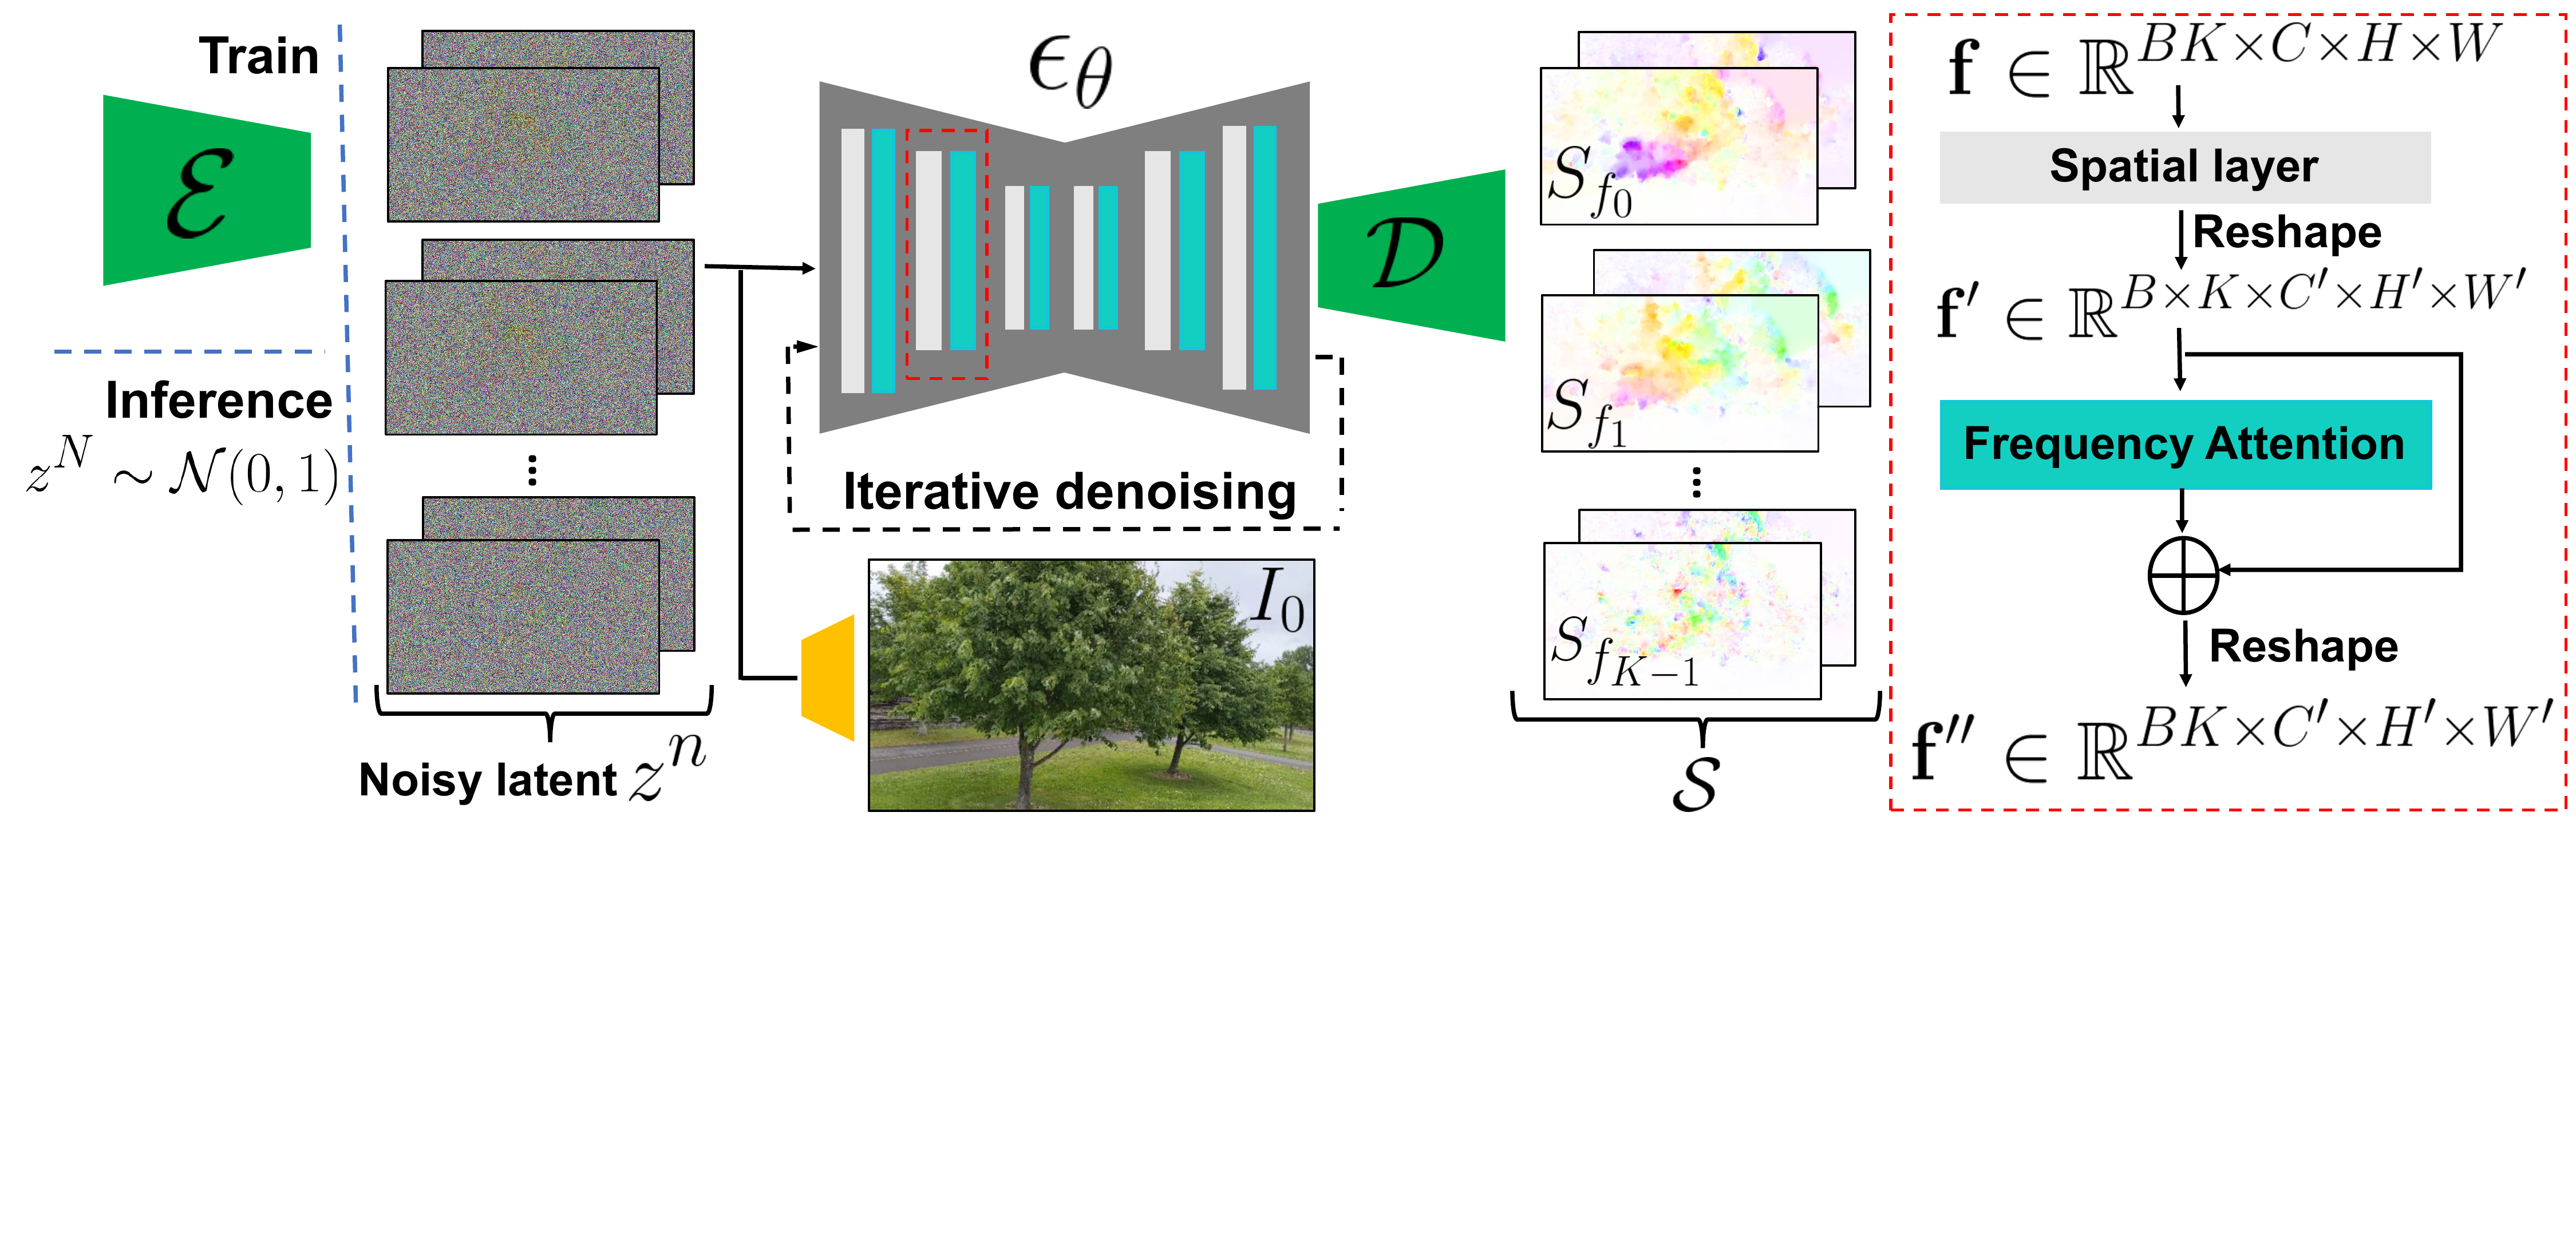
ResNet-34 从 \(I_0\) 提取 feature pyramid \(M_j\)。每个尺度都相应缩放 \(F_t\),再执行 softmax splatting:
比直接搬运 RGB 更容易处理插值、边界和细小空洞。
运动大的像素在碰撞时优先,被假定为运动前景。它是经验性的遮挡排序,没有恢复几何深度;静止前景或大幅背景会破坏该假设。
warped features 与 Gaussian noise 映射出的 style features 被送入 co-modulation StyleGAN 风格的 synthesis decoder。训练使用真实视频中的起始帧 \(I_0\)、目标帧 \(I_t\) 和真实估计位移进行 warping,以 VGG perceptual loss 监督 \(\hat I_t\)。推理时 renderer 接收 diffusion 生成的位移,因此最终误差包含运动预测误差与渲染误差两部分。
官方项目 teaser:单图生成的自然振荡动画与频谱表示。
官方交互示例:拖拽并释放后,以 modal coordinates 合成响应。
对 motion texture 在时间上插值可得到慢动作;统一缩放 spectral coefficients 可放大或减小运动幅值。外观内容仍来自输入图像。
在 DDIM 去噪中加入端点位置和速度约束;主结果使用 500 步、两次 self-recurrence。Fourier 表示本身并不保证选定离散视频段与渲染结果首尾无缝。
把预测频谱视为 image-space modal bases,对解耦的 mass-spring-damper 方程做显式积分。它生成视觉上合理的响应,没有给出真实物性标定。
循环自引导在第 \(n\) 个去噪步使用:
第一项是标准 classifier-free guidance 的论文记法,\(w=1.75\);第二项以 \(u=200\) 施加起止位置与时间速度一致性。论文使用 500 DDIM steps 和两次 self-recurrence。常见实现把 conditional scale 写成 \(s\epsilon_c+(1-s)\epsilon_u\),此处对应 \(s=1+w=2.75\)。
在 modal space 中将系统解耦,并用 Rayleigh damping \(c_i=\alpha m_i+\beta k_i\),作者设 \(\alpha=0.4,\ \beta=0.08,\ m_i=1\):
像素位移由所有预测频带合成:
补充材料 Equation 8 的 PDF 源显示位置更新使用 \(\Delta t\,\ddot q_i(t+\Delta t)\),按量纲应使用速度 \(\Delta t\,\dot q_i(t+\Delta t)\)。公开 arXiv 源包没有补充材料 TeX,也没有代码可核对。复现者应把该处视为论文排版疑点,不能悄然改写成自己的实现并声称与论文完全一致。
由于 \(S_{f_j}\) 与 \(q_{f_j}\) 都是复数,实际二维位移应取频率合成的实部,或同时加入共轭模态。论文 Equation 6 省略了 \(\operatorname{Re}\) 与共轭项,补充材料也没有给出代码约定;网页将其标记为复现缺口,不把复数和直接解释成像素位移。
官方 WebGL demo 为速度采用 mesh warping;论文定量结果与高质量示例使用前述 neural image-based renderer。两种渲染路径需要分开理解。
在线素材与作者自拍;按视频保留 10% 测试集。检索词覆盖 static shot、trees、flowers、candles、clothes、lanterns、wind、breeze 及多种植物名称。
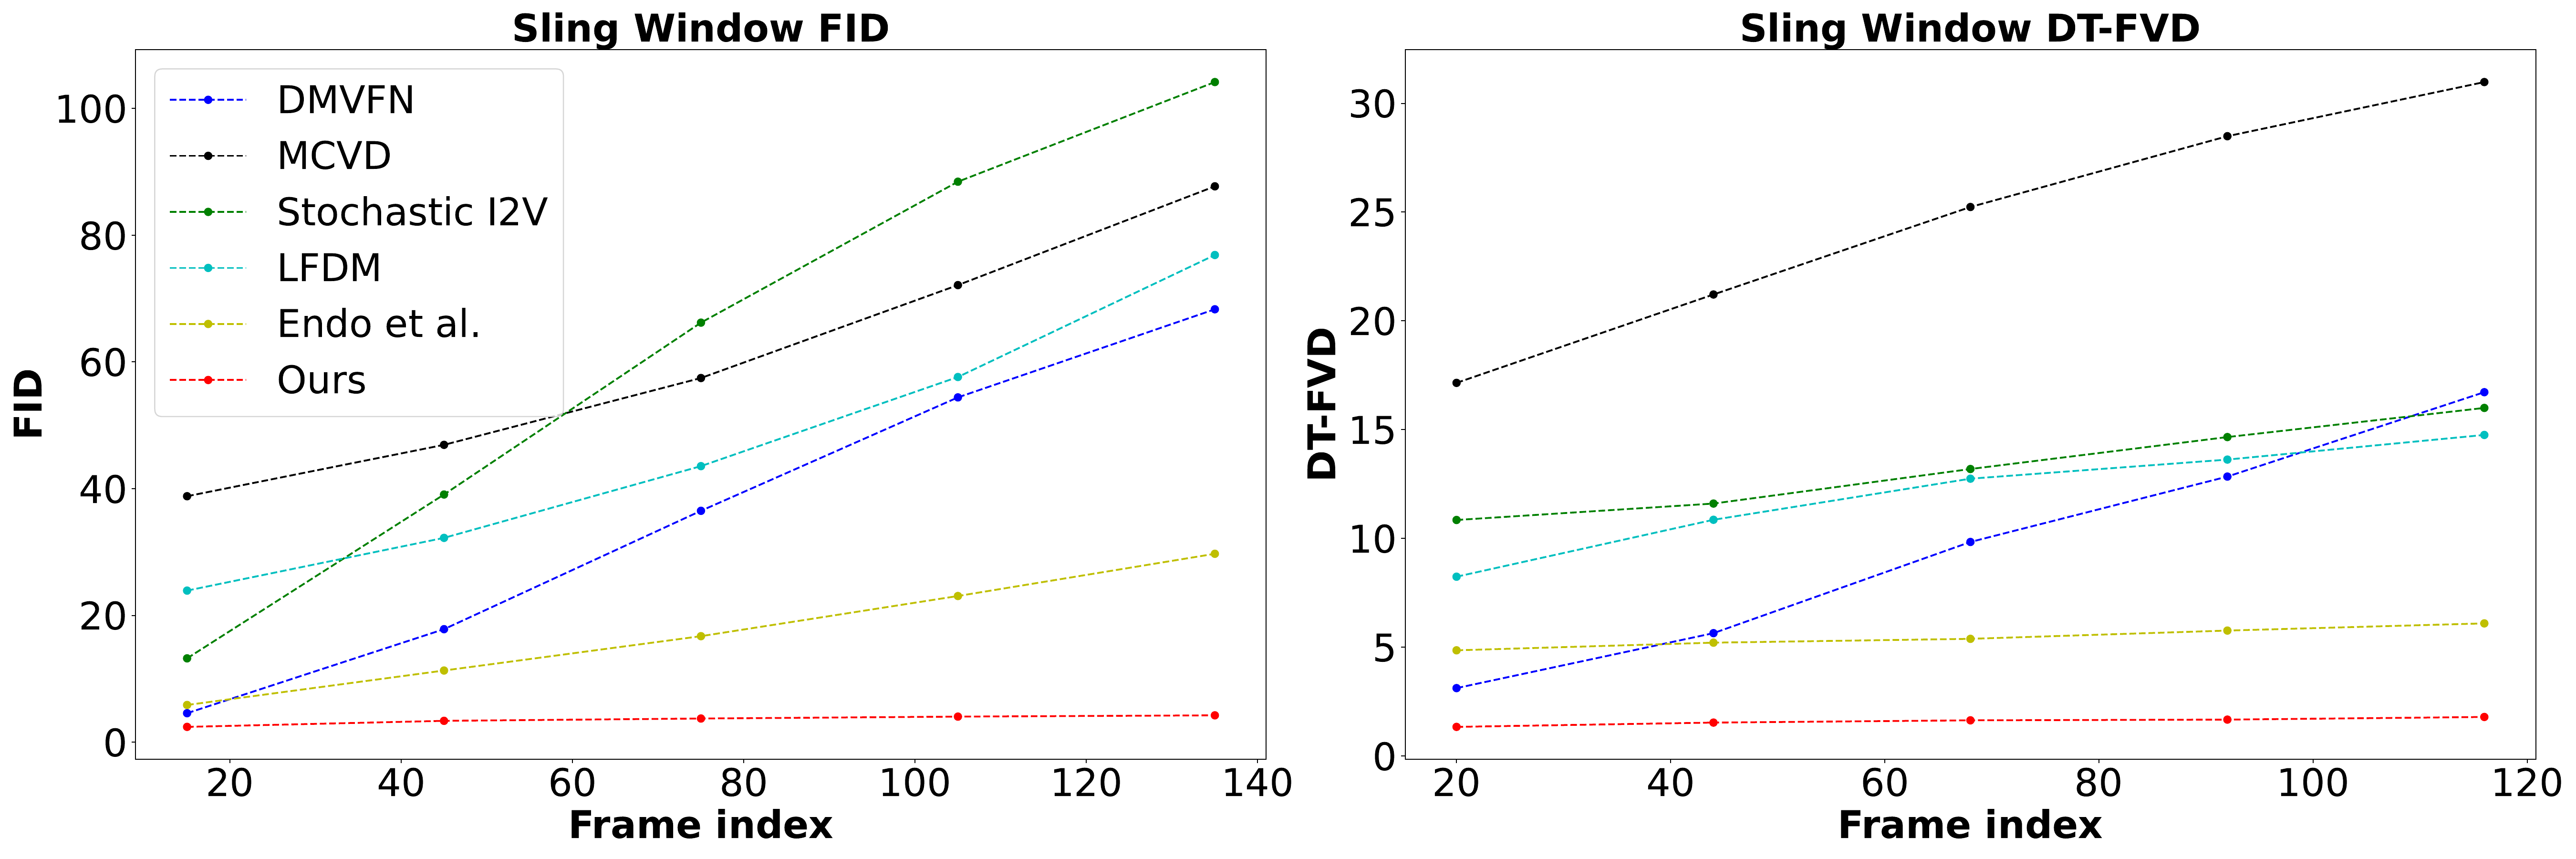
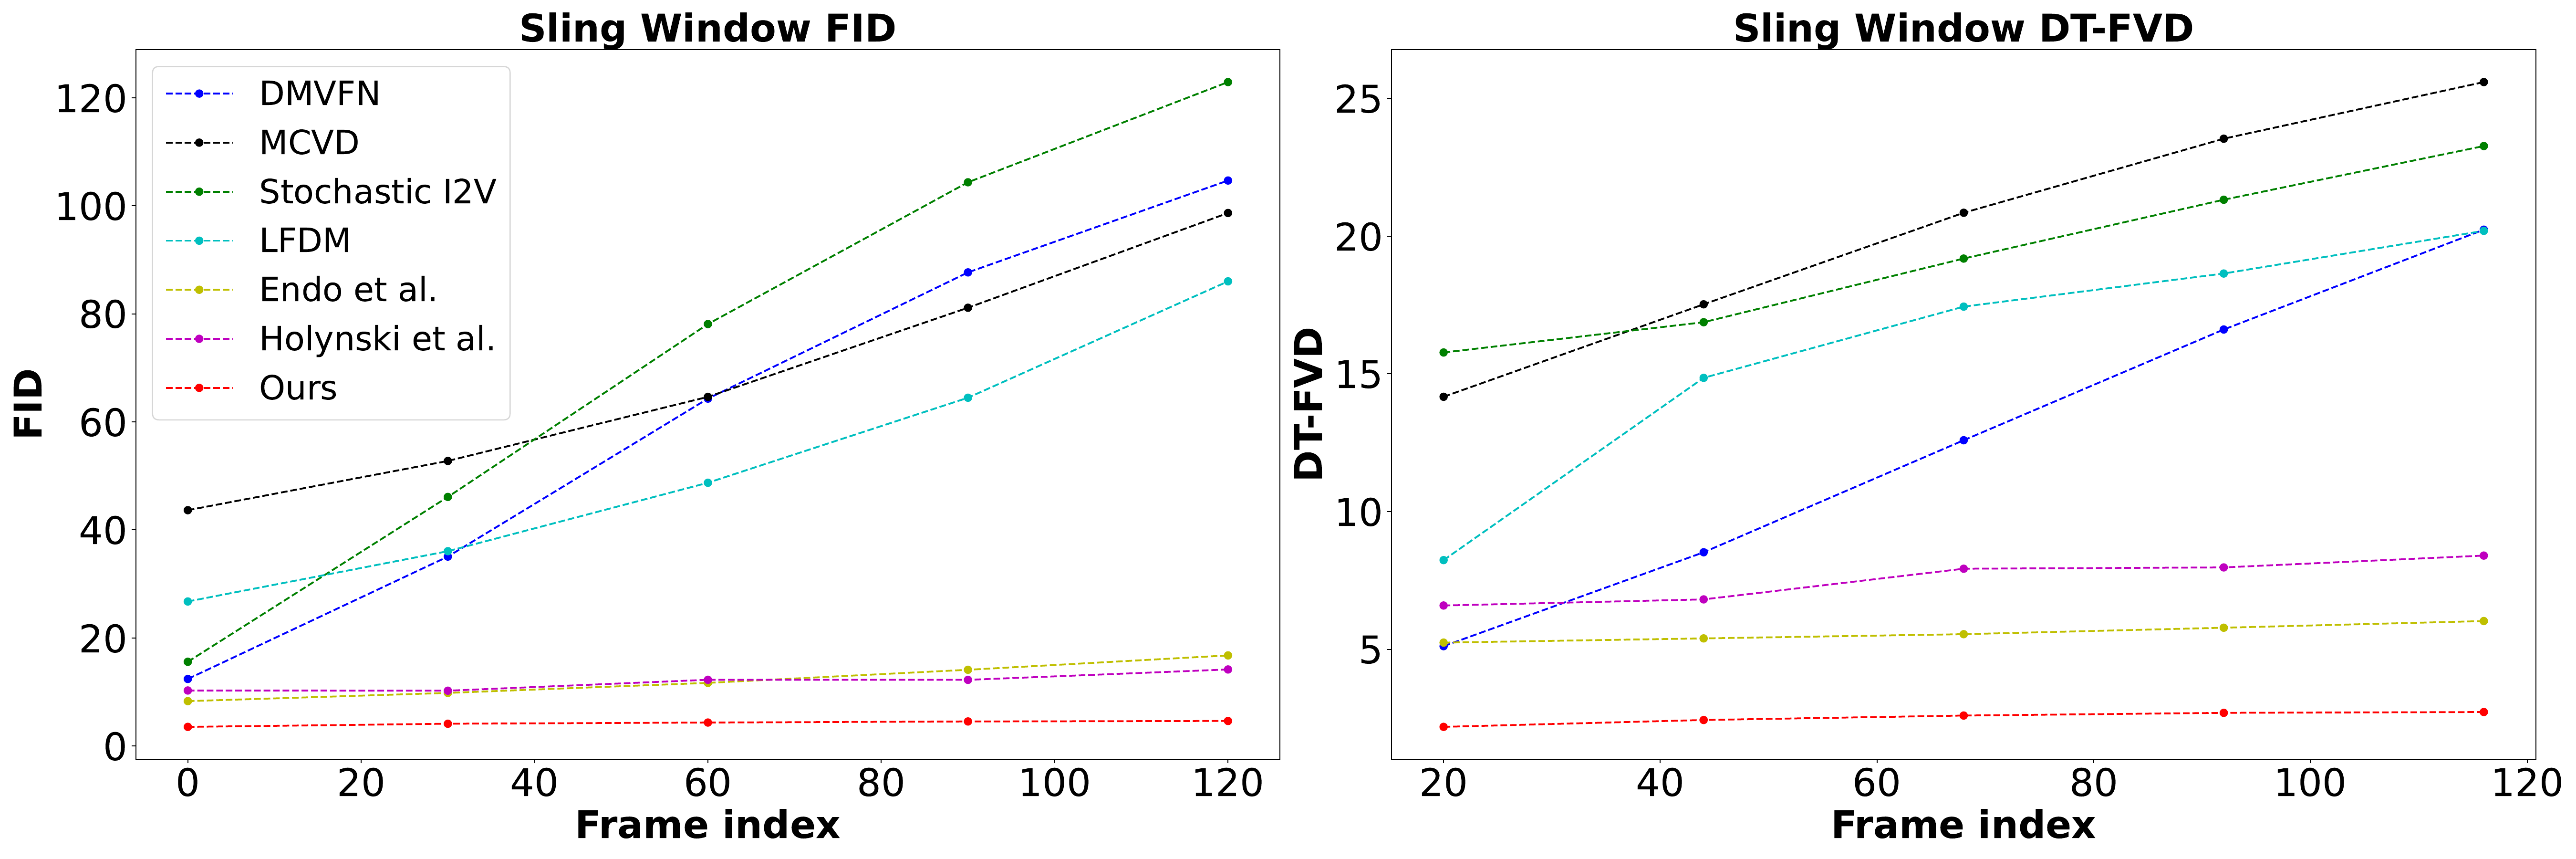
每隔十帧选一个起点,对后续 149 帧分别估计从起点到目标的位移,再沿时间做 FFT。
256×160 的 VAE 与 LDM 从头训练。512×288 示例来自预训练 inpainting LDM 微调,是另一组设置。
| 模块 | 结构 | 训练 | 关键设置 |
|---|---|---|---|
| VAE | continuous latent 4;base channel 128;multipliers 1,2,4 | L1 + multi-scale gradient + KL | 权重 1 / 0.2 / \(10^{-6}\);latent whitening |
| Motion LDM | base channel 128;multipliers 1,4,8;attention 32,16,8 | Adam;LDM 合计训练 750K steps;batch 96;LR \(5\times10^{-5}\) | 1,000 diffusion steps;square-linear schedule;MSE noise loss;补充材料没有披露两个训练阶段分别使用多少步 |
| 图像条件 | 标准 ResNet encoder 降采样到 16-channel features | 与 4-channel noisy latent 拼接 | 颜色抖动、水平翻转、缩放、±5°旋转、随机裁剪 |
| Renderer | ResNet-34 pyramid + softmax splatting + co-modulation synthesis | Adam;300K;batch 32;LR \(10^{-4}\) | VGG perceptual loss;真实 flow 训练 |
DDIM 250 步;补充材料报告每一步约 0.5 秒,因此完整频谱采样约 125 秒量级。该速度没有被称为实时。
得到 motion texture 后,神经渲染模块可实时生成帧。25 FPS 只属于 renderer,不能描述整套 diffusion pipeline。
所有旧基线都使用各自开源实现并在作者数据上重训;Holynski et al. 使用 Fan et al. 的开源实现。指标在 256×128 center crop 上计算。FID / KID 衡量单帧分布;FVD 使用 Kinetics 训练的 I3D;DTFVD 使用 Dynamic Textures Database 训练的 I3D,更贴近本文的自然运动类型。窗口 16 与 32 的值来自不同时间长度,不能把六列混成一个绝对质量分数。
| 方法 | FID↓ | KID×100↓ | FVD16↓ | FVD32↓ | DTFVD16↓ | DTFVD32↓ |
|---|---|---|---|---|---|---|
| TATS | 65.8 | 1.67 | 265.6 | 419.6 | 22.6 | 40.7 |
| Stochastic I2V | 68.3 | 3.12 | 253.5 | 320.9 | 16.7 | 41.7 |
| MCVD | 63.4 | 2.97 | 208.6 | 270.4 | 19.5 | 53.9 |
| LFDM | 47.6 | 1.70 | 187.5 | 254.3 | 13.0 | 45.6 |
| DMVFN | 37.9 | 1.09 | 206.5 | 316.3 | 11.2 | 54.5 |
| Endo et al. | 10.4 | 0.19 | 166.0 | 231.6 | 5.35 | 65.1 |
| Holynski et al. | 11.2 | 0.20 | 179.0 | 253.7 | 7.23 | 46.8 |
| Ours | 4.03 | 0.08 | 47.1 | 62.9 | 2.53 | 6.75 |
本文在六个指标上均明显优于旧基线,差距最大的是长窗口视频分布,例如 FVD32 从最佳旧基线的 231.6 降至 62.9。这个结果支持“显式长时运动表示可延缓漂移”,仍然只覆盖本数据集的振荡场景。
| 配置 | FID↓ | KID×100↓ | FVD16↓ | FVD32↓ | DTFVD16↓ | DTFVD32↓ |
|---|---|---|---|---|---|---|
| Repeat \(I_0\) | — | — | 237.5 | 316.7 | 5.30 | 45.6 |
| \(K=4\) | 3.92 | 0.07 | 60.3 | 78.4 | 3.12 | 8.59 |
| \(K=8\) | 3.95 | 0.07 | 52.1 | 68.7 | 2.71 | 7.37 |
| \(K=24\) | 4.09 | 0.08 | 48.2 | 65.1 | 2.50 | 6.94 |
| w/o adaptive norm. | 4.53 | 0.09 | 62.7 | 80.1 | 3.16 | 8.19 |
| Independent pred. | 4.00 | 0.08 | 52.5 | 71.3 | 2.70 | 7.40 |
| Volume pred. | 4.74 | 0.09 | 53.7 | 71.1 | 2.83 | 7.79 |
| Baseline splat | 4.25 | 0.09 | 49.5 | 66.8 | 2.83 | 7.27 |
| Full \(K=16\) | 4.03 | 0.08 | 47.1 | 62.9 | 2.53 | 6.75 |
频率自适应归一化、频率协调、联合 volume 预测替代方案与 baseline splat 在视频指标上都逊于完整模型。\(K=16\) 在 FVD16、FVD32 与 DTFVD32 上最佳,表明频带数量超过 16 后收益饱和。
作者写“所有简化配置更差”过于宽泛:\(K=4\) 与 \(K=8\) 的 FID / KID 略好于完整模型,\(K=24\) 的 DTFVD16 为 2.50,也略好于完整模型的 2.53。完整模型体现为整体视频质量优势,部分单项指标存在例外。
补充材料明确:35 名参与者观看从测试集随机选出的 30 个视频并回答“哪个视频更真实”。AnimateDiff 使用 Realistic Vision V2.0、DDIM inversion 与人工文本;ModelScope 使用图像输入;Gen-2 使用图像与人工描述。正文把三组结果汇总为 80.9%,没有报告置信区间、逐视频票数或参与者内一致性。
旧基线在同一数据集重训,有利于数据分布公平。大模型比较依赖各自不同输入机制与人工 prompt,且 Gen-2 是闭源服务;用户实验可以支持感知偏好,不能隔离训练数据规模、prompt 质量和模型版本的影响。
学习非 Fourier、空间自适应的基底,使模型同时覆盖振荡、非周期和局部高频事件;再用频谱稀疏或稳定性约束保持可编辑性。
显式预测 layer / depth / visibility,并把 renderer 的遮挡错误反馈到 motion sampling,可减少以运动幅值代替深度的偏差。
用少量真实视频或交互观测在测试时估计质量、刚度、阻尼,让生成先验负责初始化,观测负责校准。
本文证明:在作者收集的自然振荡数据上,频谱运动先验配合神经渲染显著改善单图动画指标与用户偏好。
把 spectral volume 当作程序化材质或动态纹理节点中的可生成控制场,可以研究可循环 shader 动画、测试时物理校准和 renderer-in-the-loop graph repair;这些方向未由本文实验验证。
版本核验日期:2026-09-29。网页中的原论文 Figures 1、2、3、6、8 来自官方 arXiv source;官方项目视频使用原站点 URL。没有将项目 demo 的 mesh-warping 输出混作论文 renderer 的定量证据。