直接学习数据 score,为什么会在图像上失效
score 是 log-density 对输入的梯度。它消除了 density 的归一化常数,允许网络直接学习一个向量场;但图像分布常被视为嵌在高维像素空间中的低维流形,ambient density 与其梯度可能不存在,训练样本又几乎不给低密度区域提供监督。
流形困难
当分布只支撑在低维集合上,\(\nabla_{\mathbf{x}}\log p_{\mathrm{data}}(\mathbf{x})\) 作为 ambient-space density score 可能没有定义。经典 score matching 的分部积分等价还要求光滑性、边界衰减和全维支撑等条件。
估计困难
训练目标按 \(p_{\mathrm{data}}\) 加权误差。低密度区域几乎没有样本,网络在那里可以给出错误向量而付出很小训练代价;随机初始化却恰好位于这些区域。
混合困难
相互分离的模式之间,score 不携带 mixture weight;普通 Langevin chain 很难穿过低密度障碍。有限步、有限步长且没有 Metropolis 校正时,这一困难更明显。
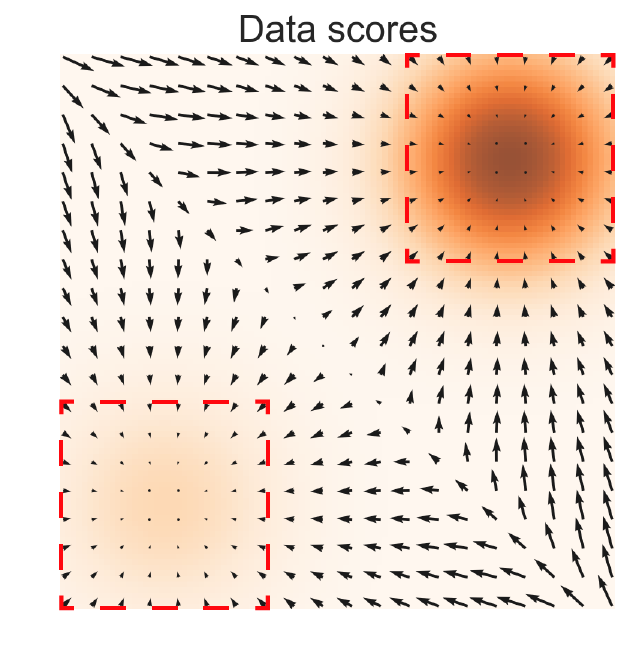
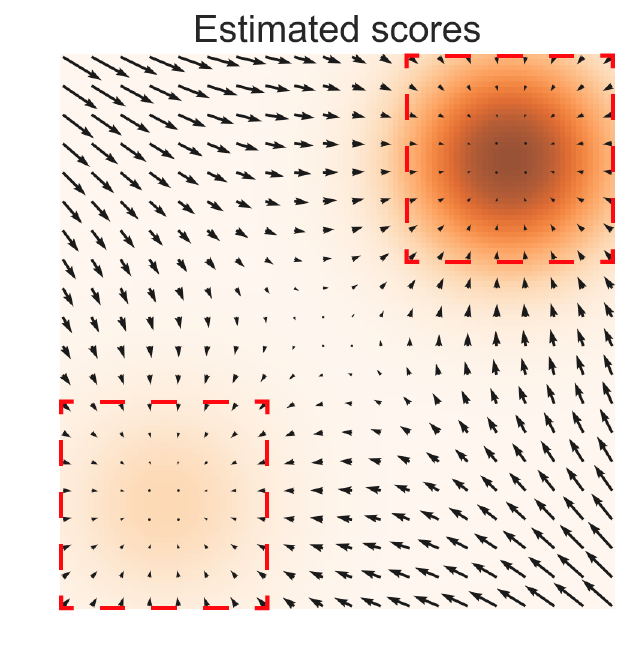
输入、输出与三种分布
从 score matching 到多尺度去噪目标
3.1 经典 score matching
它在满足正则条件时与 \(\frac12\mathbb{E}\lVert\mathbf{s}_{\theta}-\nabla\log p_{\mathrm{data}}\rVert^2\) 相差一个与参数无关的常数。trace Jacobian 对高维深网代价高,原论文因此讨论 DSM 与 SSM 两个可扩展替代。
3.2 Denoising score matching
Gaussian conditional score 是 \(-(\tilde{\mathbf{x}}-\mathbf{x})/\sigma^2\)。单个训练对的监督目标指向其干净源样本;对所有可能源样本求条件期望后,最优网络等于边际 \(q_{\sigma}(\tilde{\mathbf{x}})\) 的 score。
权重 \(\lambda(\sigma)=\sigma^2\) 来自经验观察 \(\lVert\mathbf{s}_{\theta}(\mathbf{x},\sigma)\rVert_2\propto1/\sigma\),用来平衡各尺度损失量级。这是经验假设,缺少对任意数据分布的定理保证。
3.3 Sliced score matching 的角色
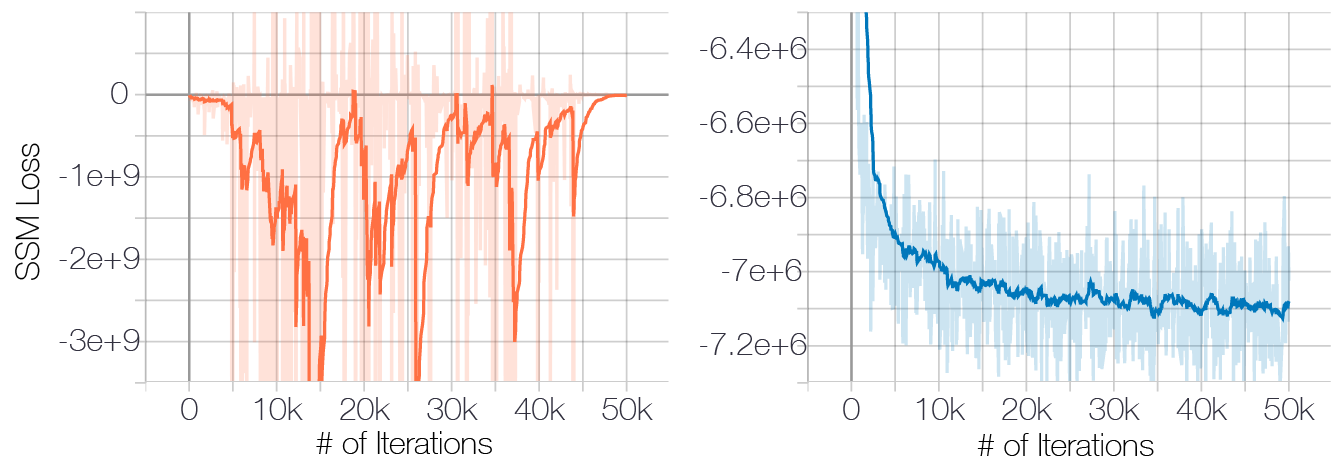
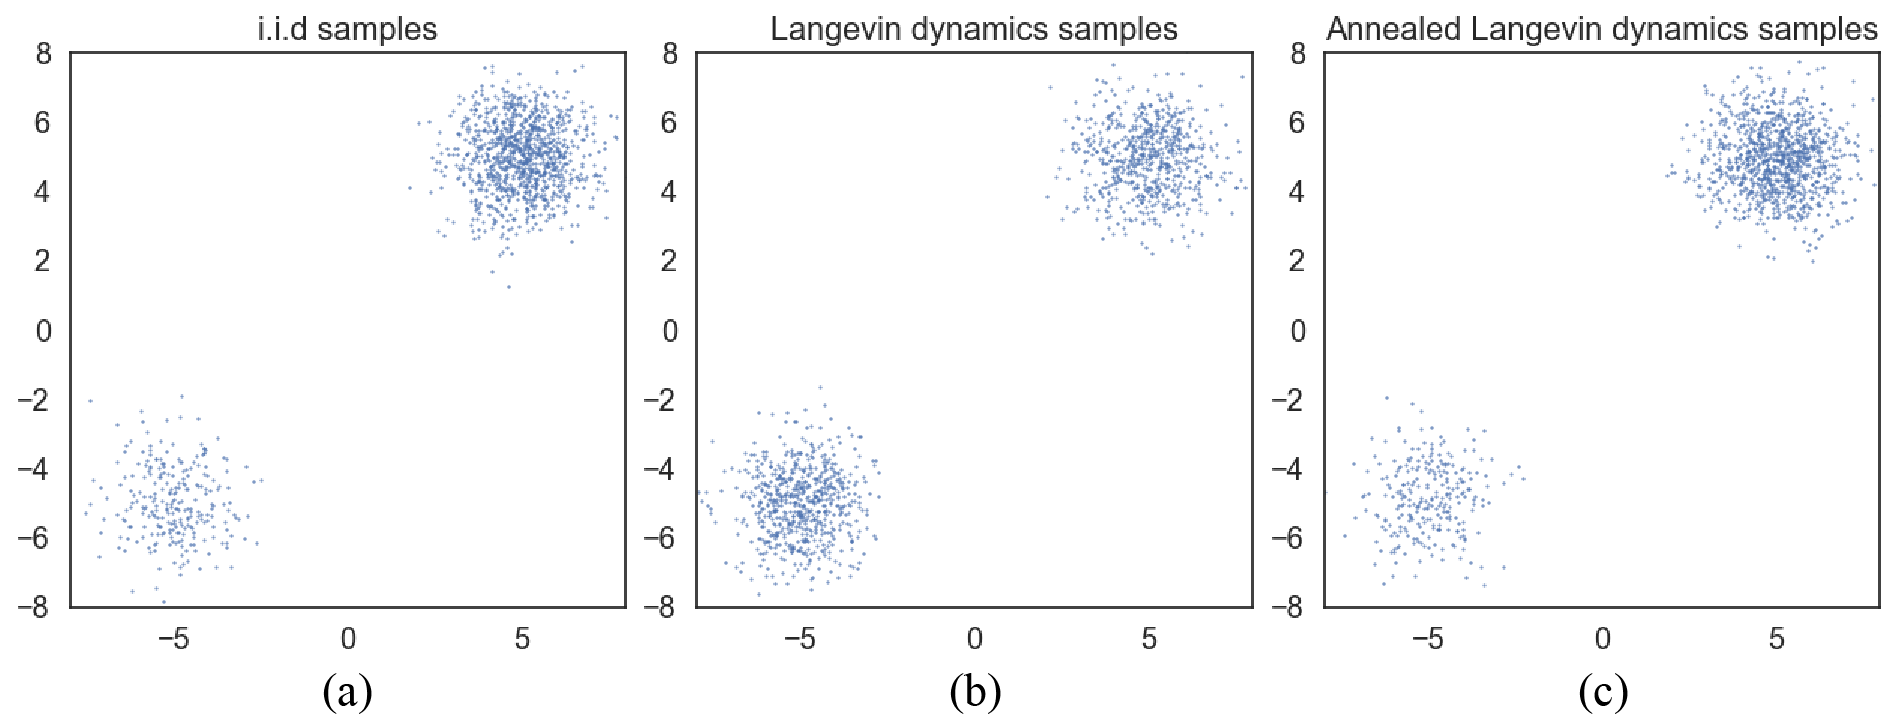
随机投影只替代 Jacobian trace 的计算,第二项仍是完整 score norm。主 NCSN 采用 DSM;SSM 用于 Figure 1、Figure 2 的诊断实验,也可训练 NCSN,但论文报告其计算约慢四倍。
训练一次随机尺度,推理逐级退火
\(\mathbf{x}\sim p_{\mathrm{data}}\)
均匀抽取 \(i\in\{1,\ldots,L\}\)。
\(\tilde{\mathbf{x}}=\mathbf{x}+\sigma_i\boldsymbol{\epsilon}\)
RefineNet 接收图像与尺度编号。
用 \(\sigma_i^2\) 平衡 loss。
4.1 Annealed Langevin dynamics
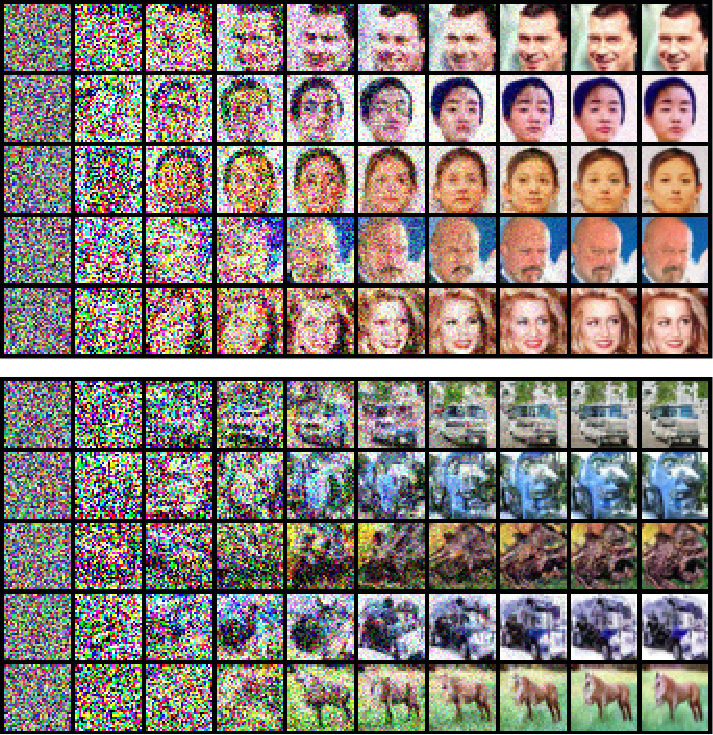
从 \(\sigma_1\) 到 \(\sigma_L\),每个尺度做 \(T\) 次更新,再把末态传给下一尺度。论文用 \(\alpha_i\propto\sigma_i^2\) 近似维持 drift 与随机噪声的相对量级:若 score norm 约为 \(1/\sigma_i\),则 \(\alpha_i\mathbb{E}\lVert\mathbf{s}\rVert^2/(4D)\) 的尺度较稳定。论文原文把向量相除写成 “SNR”,严格解释应比较期望平方范数。
RefineNet、dilation 与 CondInstanceNorm++
四级 RefineNet
使用 pre-activation residual blocks 和 U-Net 式多路径 skip。第一 cascade 为 128 filters,其余为 256;MNIST 全部减半。除第一处下采样以外,其余 residual subsampling 改为 dilated convolution,逐 cascade 把 dilation 加倍。
生成式调整
Refine Blocks 的 max pooling 改为 average pooling;所有激活使用 ELU。每个 convolution 与 pooling 前均加入 CondInstanceNorm++,包括原 RefineNet 没有 normalization 的位置。
尺度条件
噪声条件是 10 类离散编号,每类在 normalization 中拥有独立 \(\gamma,\beta,\alpha\) 参数;它不是类别标签。网络对全部尺度共享 convolutional weights。
ConditionalInstanceNorm2dPlus.forward 将代码变量 v 定义为 torch.var(means),再除以 \(\sqrt{v+10^{-5}}\),该变量表示方差。论文中的 \(v\) 表示标准差;固定提交的 ConditionalInstanceNorm2dPlus.forward 将代码变量 v 定义为 torch.var(means),再除以 \(\sqrt{v+10^{-5}}\),该变量表示方差。| 网络 / 图 | 结构 | 训练 | 硬件 |
|---|---|---|---|
| Figure 1 CIFAR score diagnostic | 5-block autoencoder ResNet;filters 32, 64, 64, 128, 128;第 2、4 block 下采样;decoder 镜像;ELU | SSM;50,000 iterations;Adam;lr 0.001;batch 128 | 1× Titan XP |
| Figure 2 toy score | 3-layer MLP;每层 128 hidden;Softplus | SSM;10,000 iterations;Adam;lr 0.001;batch 128 | 2.7 GHz Intel Core i7 |
| 主图像 NCSN | 4-cascaded RefineNet;CondInstanceNorm++;dilated convolution;ELU | DSM;200,000 iterations;Adam;lr 0.001;batch 128;每 5,000 保存 | MNIST 1× Titan XP;CelebA/CIFAR-10 2× Titan XP |
数据、协议、完整结果表与消融
| 项目 | 设置 |
|---|---|
| 数据 | MNIST 28×28;CIFAR-10 32×32;CelebA 先中心裁剪到 140×140,再缩放到 32×32;像素缩放到 \([0,1]\)。代码训练集为 torchvision MNIST/CIFAR-10 的 train=True,CelebA 使用 split=train;测试 loader 分别使用 train=False 与 split=test |
| 增强 | CelebA 与 CIFAR-10 随机水平翻转;MNIST 不翻转 |
| 噪声 | \(L=10\) 个几何尺度;\(\sigma_1=1\),\(\sigma_{10}=0.01\);每个 batch example 均匀抽尺度 |
| 采样 | \(T=100\) steps/level;\(\epsilon=2\times10^{-5}\);初始样本均匀分布于 \([0,1]\);总计 1,000 次 network evaluations |
| 稳健区间 | 作者报告 \(\epsilon\) 在 \(5\times10^{-6}\) 到 \(5\times10^{-5}\) 通常有效,并称对 \(T\) 较稳健;没有完整 sweep 表 |
| 模型选择 | MNIST 取 200k 最后 checkpoint;CelebA/CIFAR 每个 checkpoint 生成 1,000 张,按该小样本 FID 选最低者 |
| 最终评测 | 50,000 样本;OpenAI Inception Score 实现;TTUR FID 实现。论文与仓库没有明确记录最终 FID reference statistics 来自 CIFAR-10 train 还是 test split |
Table 1 · CIFAR-10 全部报告行
| 条件 | 模型 | Inception Score ↑ | FID ↓ |
|---|---|---|---|
| Unconditional | PixelCNN | 4.60 | 65.93 |
| Unconditional | PixelIQN | 5.29 | 49.46 |
| Unconditional | EBM | 6.02 | 40.58 |
| Unconditional | WGAN-GP | 7.86 ± 0.07 | 36.4 |
| Unconditional | MoLM | 7.90 ± 0.10 | 18.9 |
| Unconditional | SNGAN | 8.22 ± 0.05 | 21.7 |
| Unconditional | ProgressiveGAN | 8.80 ± 0.05 | — |
| Unconditional | NCSN (Ours) | 8.87 ± 0.12 | 25.32 |
| Conditional | EBM | 8.30 | 37.9 |
| Conditional | SNGAN | 8.60 ± 0.08 | 25.5 |
| Conditional | BigGAN | 9.22 | 14.73 |
单尺度 baseline
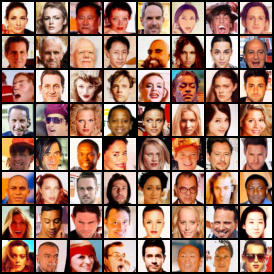
baseline 使用同一 RefineNet,仅训练 \(\sigma=0.01\) 并用普通 Langevin dynamics:\(T=1000\)、\(\epsilon=2\times10^{-5}\),计算预算仍为 1,000 次网络评估。Appendix Figures 7–8 显示样本失败。这项对照同时改变了多尺度训练与退火采样,无法分别量化两个因素的独立贡献。
Image inpainting
每个 noise level 只采一次带噪观测 \(\mathbf{y}\),之后在该 level 的每次内循环把已知像素钳回同一个 \(\mathbf{y}\)。最小尺度仍为 0.01,算法返回前没有把观测区恢复为完全干净的 \(\mathbf{x}\)。它演示任意形状 mask 的定性修复,没有 PSNR、LPIPS 或 conditional posterior 校准评测。
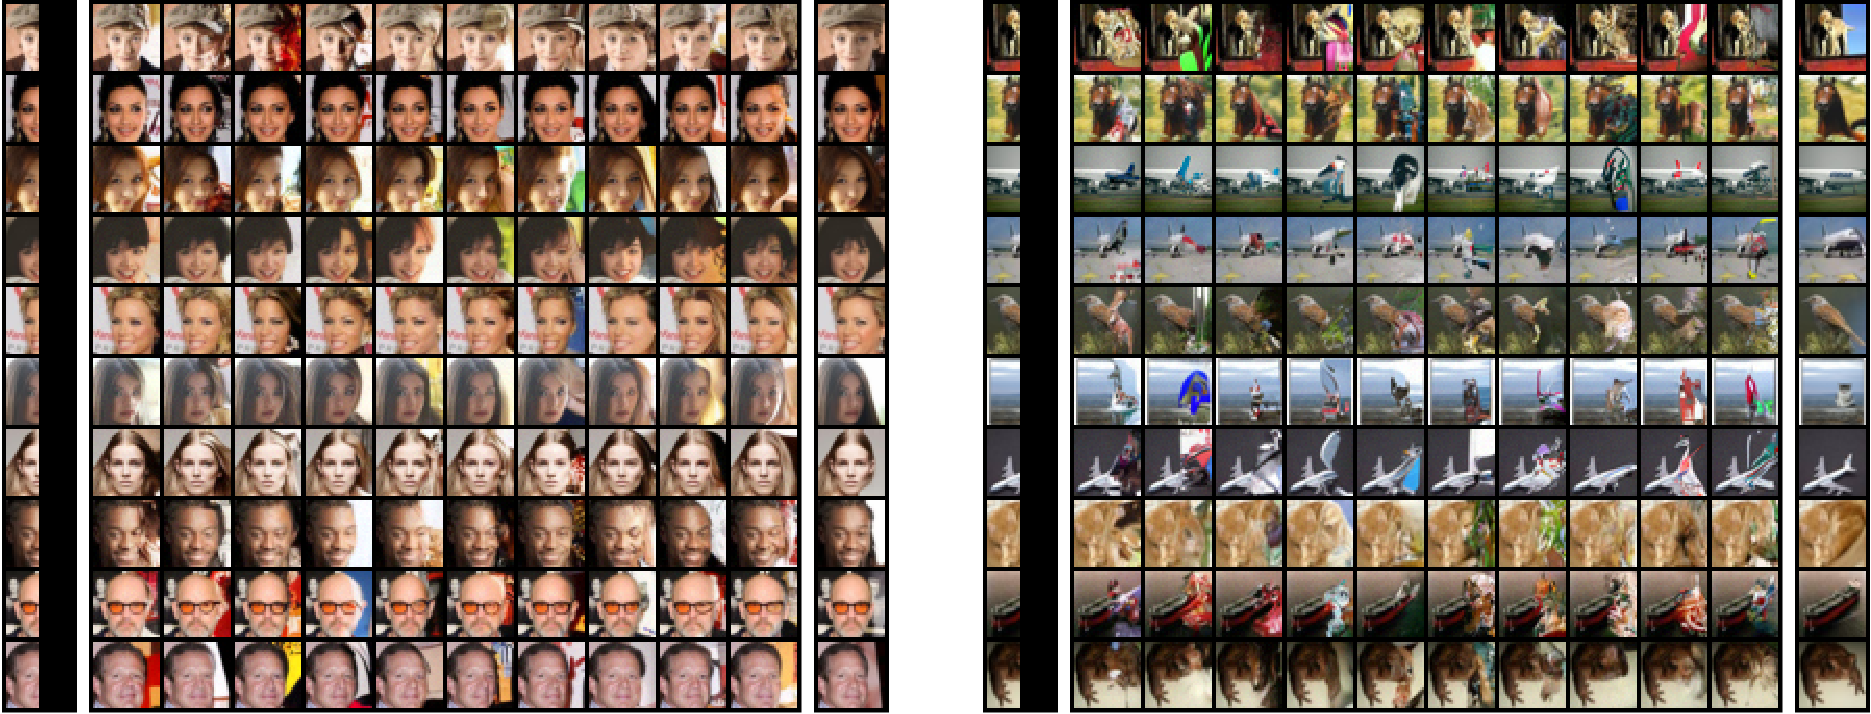
Figures 7–8 · Baseline
三个数据集的单尺度未筛选样本与完整 Langevin 轨迹。它们显示小噪声 score 无法把 uniform initialization 可靠引向数据区。
Figures 9–10 · Nearest neighbors
分别用 pixel \(\ell_2\) 与 pretrained Inception V3 feature distance 检索训练集近邻;定性上没有逐图复制,仍不足以证明零记忆或隐私安全。
Figures 11–13 · Extended samples
MNIST、CelebA、CIFAR-10 更大样本板,用于检查多样性与失败模式;没有增加新的量化协议。
Figures 14–15 · Sampling trajectories
CelebA 的扩展中间状态,展示从高噪声到低噪声的渐进细化;两图均属于同一 annealed Langevin algorithm。
Figure 16 · CelebA inpainting
扩展人脸修复样本,左列为遮挡输入,右列为原图,中间列展示同一观测的多种随机 completion。
Figure 17 · CIFAR-10 inpainting
扩展自然图像修复样本,布局与 Figure 16 相同;只提供视觉比较,没有 PSNR、LPIPS 或用户研究。
官方代码对论文算法的具体实现
| 项目 | 论文 | 官方实现 | 判断 |
|---|---|---|---|
| DSM loss | \(\sigma_i^2\) 加权 conditional score MSE | target = -(perturbed-samples)/sigma²;per-example 乘 sigma ** anneal_power,默认 power 2 | 一致 |
| noise ladder | 1 到 0.01 的 10 级几何序列 | exp(linspace(log(begin), log(end), num_classes)) | 一致 |
| 采样更新 | \(\alpha_i\mathbf{s}/2+\sqrt{\alpha_i}\mathbf{z}\) | step_size*s + sqrt(2*step_size)*z | 数学形式等价,但同名超参数数值不能直接照搬:代码 step_lr=2e-5 对应论文记号 \(\epsilon=4\times10^{-5}\);复现论文 \(\epsilon=2\times10^{-5}\) 时,代码应设 step_lr=1e-5。令 \(\eta_i\) 表示代码 step_size、\(\eta\) 表示 step_lr,对应关系为 \(\eta_i=\alpha_i/2\)、\(\eta=\epsilon/2\)。公开 inpainting 函数的默认 step_lr=8e-6,调用处显式传入 step_lr=2e-5 |
| 初始化 | uniform noise | torch.rand,范围 \([0,1]\) | 一致且代码更明确 |
| 中间 clamp | 算法未写 | 每步只对保存的预览图 clamp(0,1);latent 自身继续无约束更新 | 不改变采样状态 |
| inpainting | 通用 mask | 公开 runner 固定左半图 :16,每 level 重采 noisy observation 并在 inner steps 固定 | 论文算法通用;发布代码 demo 硬编码半图 |
| 优化器 | Adam,lr 0.001 | beta1 0.9、weight decay 0、AMSGrad false;未显式覆盖 beta2,使用 PyTorch 默认 0.999 | 代码补齐正文缺项:PyTorch Adam 默认 beta2=0.999、epsilon=1e-8 |
| 版本边界 | 原始 NCSN 2019 | 仓库 README 提醒后续 NCSNv2 与 SDE 已稳定化 | 这些后续改进不属于本文实验 |
证据层级
- 极小 Gaussian perturbation 让 Figure 1 的 SSM 训练曲线更稳定。
- 多尺度 NCSN + annealed Langevin 在三个 32px 数据集产生清晰样本。
- CIFAR-10 报告 IS 8.87 ± 0.12、FID 25.32。
- 单尺度 baseline 在相同 network-evaluation 预算下定性失败。
- 任意形状 mask 可通过每步观测钳制完成定性修复。
- 多噪声尺度同时改善 score estimation 与 Langevin mixing。
- \(\sigma^2\) loss weighting 使各尺度贡献同量级。
- 修复结果说明模型学习了有效、语义化 representation。
- 最近邻结果说明模型没有简单记忆训练图像。
- noise ladder 同时承担 support smoothing、低密度监督与采样 continuation 三个角色。
- 训练 objective 与 sampler decoupling 提供灵活性,也让有限步 sampler 的质量缺少直接训练约束。
- FID checkpoint 只用 1,000 样本筛选,选择噪声可能影响最终结果。
- 把离散 noise ladder 写成连续时间 SDE,并联合设计训练权重与数值求解器。
- 学习可校准 conservative score field,显式测量 curl 与可积性。
- 对 structured graph 或程序使用 execution-aware corruption 与 constrained score updates。
- 用 renderer 或任务指标在 test time 修正 score trajectory。
审稿视角
Strengths
- 准确指出 naïve score generation 的两个核心障碍。
- 训练无需 adversarial loop 或模型内 MCMC。
- 单网络共享多尺度,目标简单且可直接 minibatch 优化。
- toy、CIFAR、MNIST、CelebA 与修复任务构成多层证据。
- 附录给出架构与主要训练配置,官方代码公开。
Weaknesses
- 生成每张图需要 1,000 次串行网络评估。
- 核心单尺度对照没有析分训练尺度与采样退火贡献。
- sampling bias、mixing 与 score error 没有定量诊断。
- 图像仅为 32px,CelebA/MNIST 缺少可比数字。
- inpainting 只有定性结果。
- 直接向量场没有 conservative constraint。
Reproducibility
- Adam 的 beta2、数值 epsilon 只可从框架默认值推知。
- 训练与测试 loader 的划分可由官方代码核实;最终 FID reference statistics 的训练集或测试集来源没有明确记录。
- 1,000 样本 checkpoint selection 方差未报告。
- toy Figure 3 的主文和附录 noise endpoints 冲突。
- 缺少训练时长、模型参数量与独立重复训练。
资料、版本与图表来源
- NeurIPS 2019 正式论文页:论文、supplement、审稿与作者回复入口。
- arXiv:1907.05600v3,2020-10-10:本页正文、附录与 Figure 1–17 的主要来源。
- 官方 NCSN 实现:固定核查 commit
7f27f4a16471d20a0af3be8b8b4c2ec57c8a0bc1,用于 loss、noise ladder、采样更新、图像修复与配置核查。 - Hyvärinen, Estimation of Non-Normalized Statistical Models by Score Matching, JMLR 2005:Eq. 1 的基础。
- Vincent, A Connection Between Score Matching and Denoising Autoencoders, Neural Computation 2011:DSM 等价的基础。
- Song et al., Sliced Score Matching, UAI 2019:SSM 目标及 Figure 1–2 的估计工具。